Your Agents Need a Save Button
AI Engineer World's Fair 2026: Online Track · Video gốc
Checkpoint state của agent trong một durable runtime để replay run production với model hay tool khác, diff kết quả và quyết định trên cả cohort.
1. "Why did it do that?" và nút Save đã có từ thập niên 1980
Hamza mở đầu bằng một câu hỏi mà ai từng chạy agent cũng gặp: bạn nhìn lại một lần agent execution và tự hỏi tại sao nó lại làm thế? Nếu lúc đó nó làm một việc khác thì sao? Liệu có rẻ hơn không? Có nhanh hơn không? Theo anh, bạn hoàn toàn trả lời được tất cả những câu đó, với một điều kiện: agent của bạn có một nút Save.
Với tài liệu, chúng ta đã có nút Save từ nhiều thập kỷ. Từ những năm 1980, người ta đã quen bấm Control S, Command S, hoặc để phần mềm tự auto-save trong lúc làm việc, để lúc nào cũng có một trạng thái được lưu bền vững (persistent state). Agent thì hôm nay chưa có thứ đó.
2. Trace chỉ là một bản mô tả, nằm xa nơi code chạy
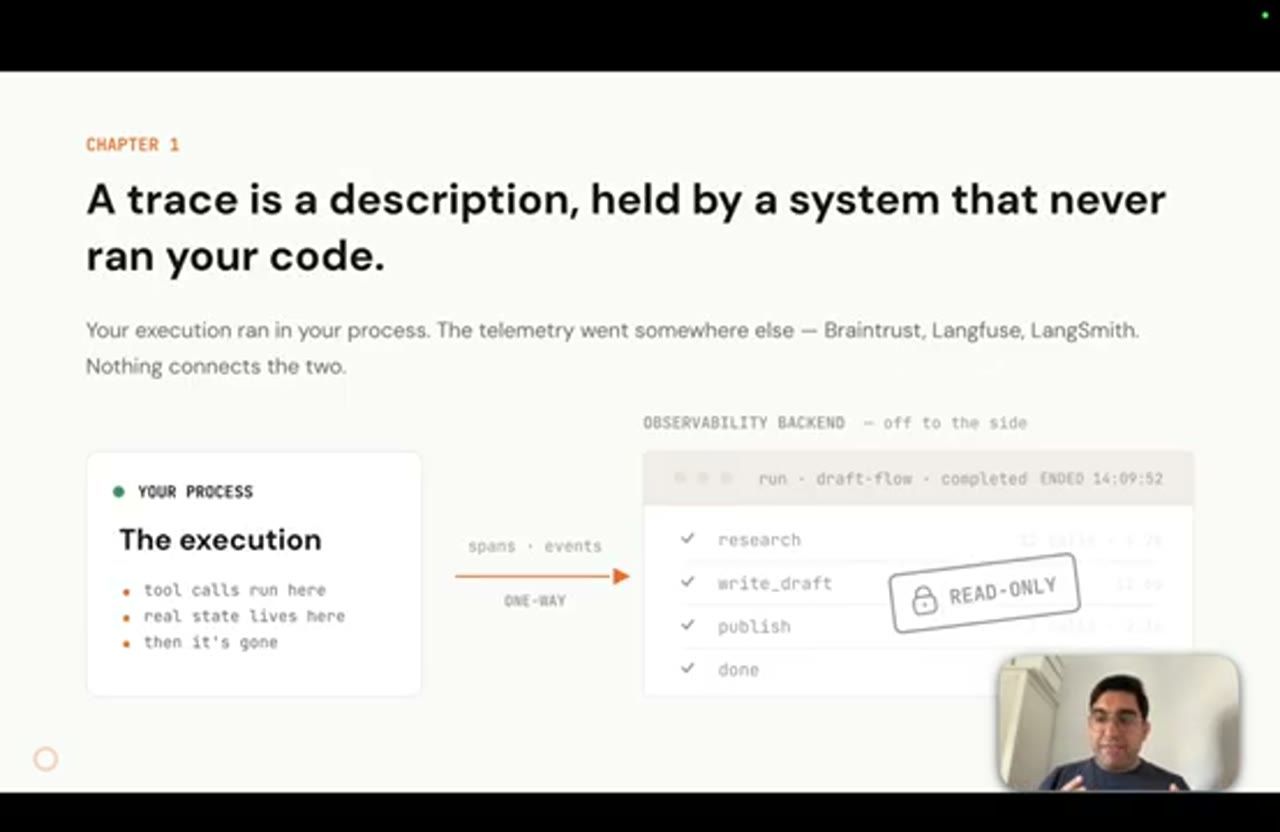
Thứ gần nhất với một nút Save mà chúng ta có hôm nay là trace. Trace cho bạn telemetry data mà agent phát ra: nó gọi những tool nào, input và output của từng bước ra sao. Đó là một khởi đầu tốt. Nhưng Hamza chỉ ra rằng trace thực ra bị tách rời khỏi runtime nơi agent thật sự chạy.
Mọi thứ thuộc về lúc chạy đều mất: tất cả các biến đang nằm trong state, toàn bộ file system đang "in flight", những quyết định được đưa ra ngay trong code, và chính đoạn code đó nữa. Cuối cùng chỉ còn lại một bản trace read-only được đóng dấu, nằm trong một tool khác, ở rất xa nơi code thật sự sống.
Theo anh, đây là mảnh còn thiếu của cả ngành hôm nay: chưa có một sợi dây nối rõ ràng giữa các observability span được phát ra qua OTel (OpenTelemetry) và chính lần execution.
3. Save để replay: hỏi "what if" với một run đã xảy ra
Đến đây có thể bạn sẽ hỏi: "Nhưng mất công làm gì? Tại sao tôi lại cần một nút Save?" Câu trả lời của Hamza: Save cho phép bạn replay. Bạn có thể quay ngược lại lịch sử và đặt câu hỏi "what if".
Những câu hỏi kiểu nào? Bạn có thể muốn swap model, ví dụ thử một open source model rẻ hơn. Bạn có thể muốn mock một tool và override thứ nó trả về. Bạn cũng có thể cố tình làm nó degrade, để xem chuyện gì xảy ra khi mọi thứ sai đi. Tất cả những câu hỏi này chỉ trả lời được nếu bạn có state.
4. Một lớp durable runtime bên dưới harness
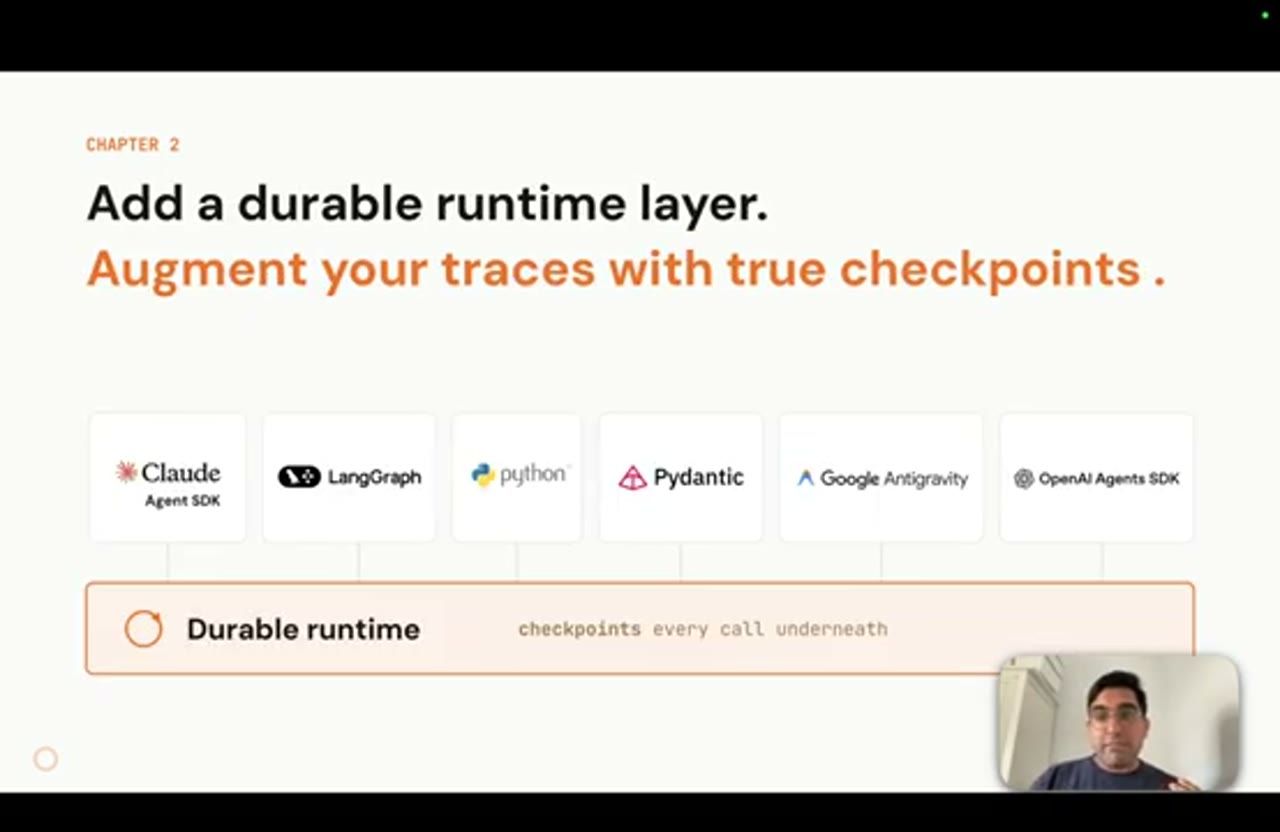
Hamza nói có một lớp mới của stack đang hình thành để làm đúng việc này. Lớp đó nằm ở hai phía: phía trên là harness, là các framework bạn dùng để tạo agent; phía dưới là một durable runtime. Runtime này bổ sung cho trace bằng chính code execution và mọi thứ xung quanh nó, để có được trạng thái đầy đủ của hệ thống, chứ không chỉ một bản mô tả.
Tin tốt là một khi đã có hệ thống như vậy chạy trong production, bạn đã nắm sẵn mọi thông tin cần để đặt ra những câu hỏi thật sự giúp hệ thống của mình tốt hơn, rẻ hơn và nhanh hơn.
5. Production run chính là test set tốt nhất
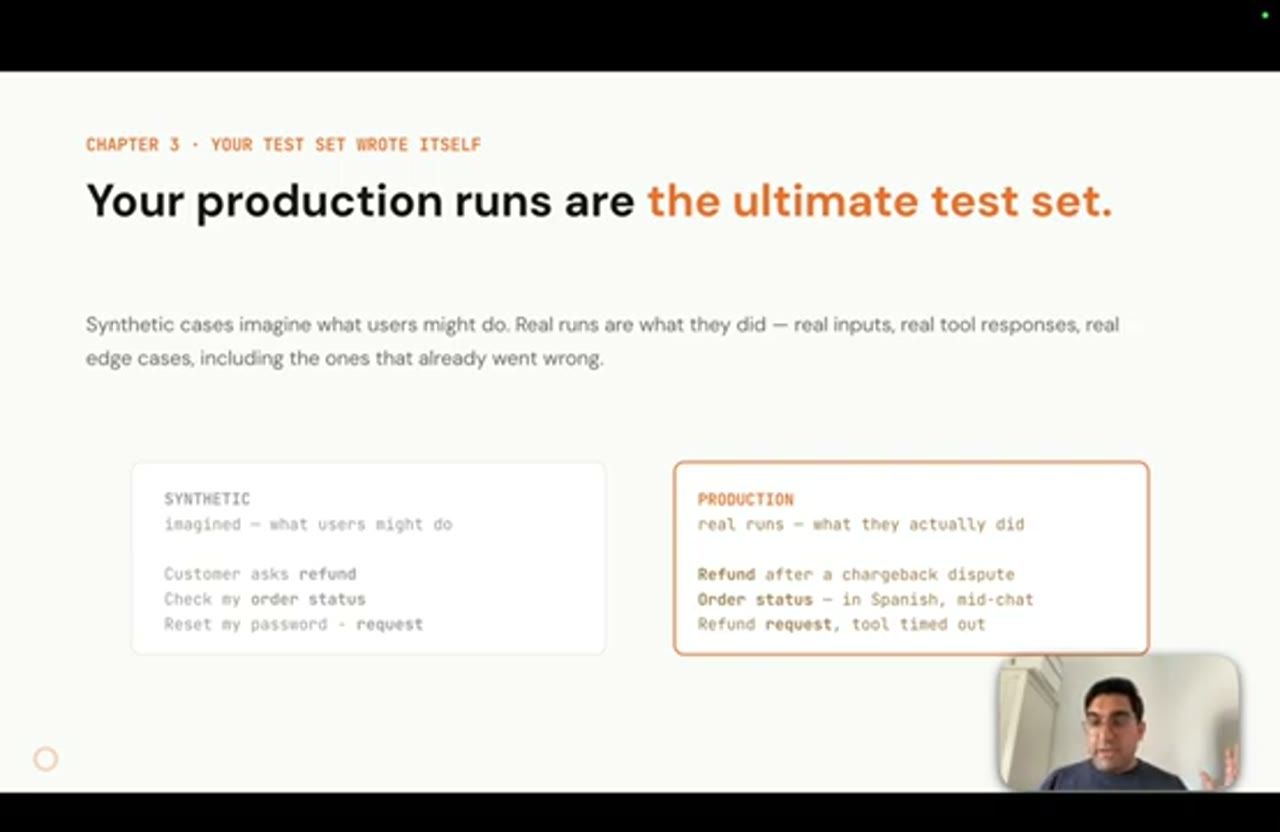
Production đã có sẵn trace. Lý tưởng nhất là nó cũng có sẵn những state checkpoint lấy từ runtime, cho phép bạn quay ngược thời gian và đặt câu hỏi.
Hamza lấy ví dụ một agent làm customer resolution và hoàn tiền sau một chargeback dispute. Nếu runtime checkpoint từng state khi agent chạy, giống như một auto-save, một Command S, một Control S bên trong agent, thì bạn có thể quay lại xem: order status có đổi ngôn ngữ giữa chừng không, request đó lẽ ra có nên được escalate không, hay một model nhỏ hơn liệu có xử lý được nó không.
6. Checkpoint, replay, diff, decide và ví dụ DoorDash
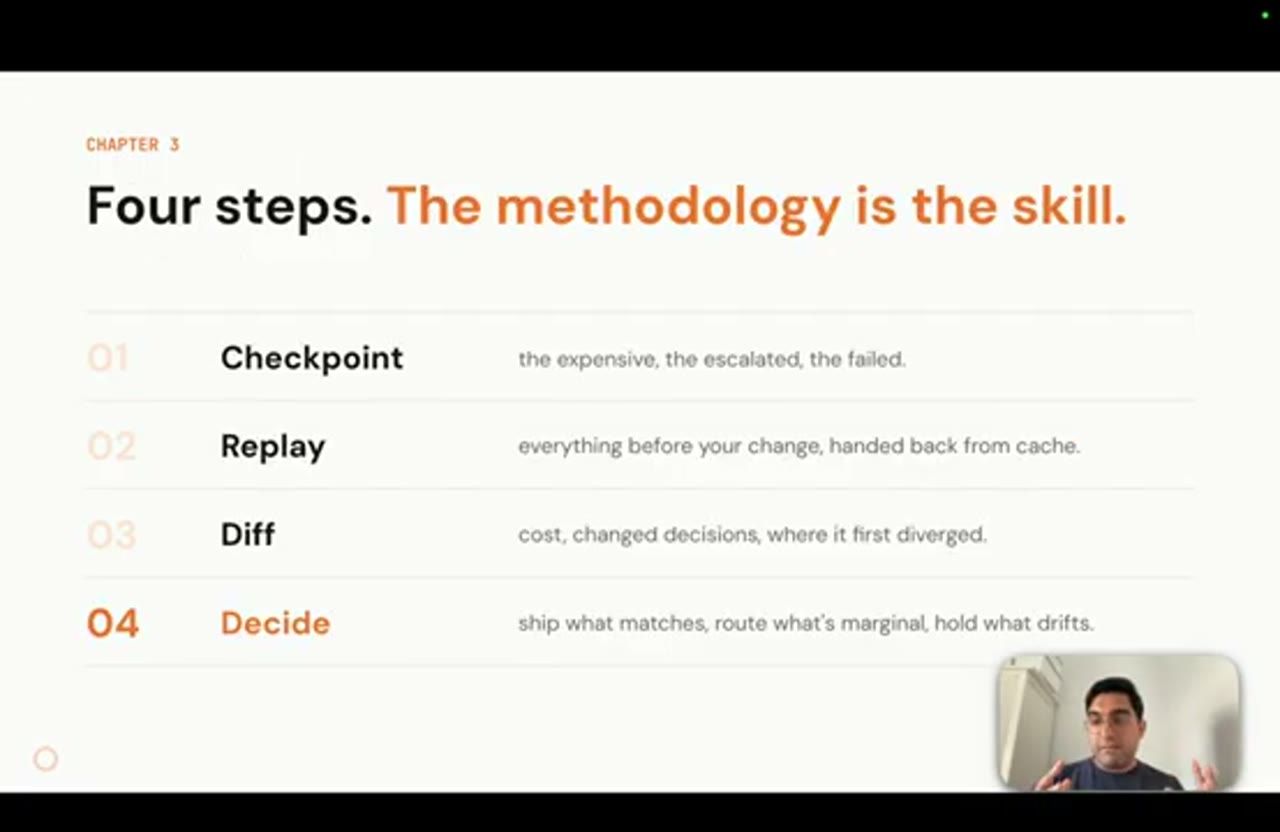
Có được thứ đó rồi thì bạn có thể khép vòng lặp. "Hội nghị này toàn nói về loop", Hamza đùa, "nên chuyện này cũng không khác gì." Bạn có một cohort các run mà bạn nghĩ là quan trọng, có thể vì chúng quá đắt, có thể vì chạy quá lâu. Bạn replay một thay đổi trên đó, diff kết quả, xem chuyện gì lẽ ra đã xảy ra so với baseline (thứ bạn biết chắc đã xảy ra lần đầu), rồi quyết định, route, và ship ngược trở lại.
Đó là khép vòng lặp cho eval của bạn: về cơ bản là eval bằng chính production trace, hay chính xác hơn là eval bằng chính production checkpoint. Bốn bước: checkpoint, replay, diff, decide. Hamza nói đây là phương pháp mà anh đã thấy, và thấy người khác áp dụng, thật sự scale được.
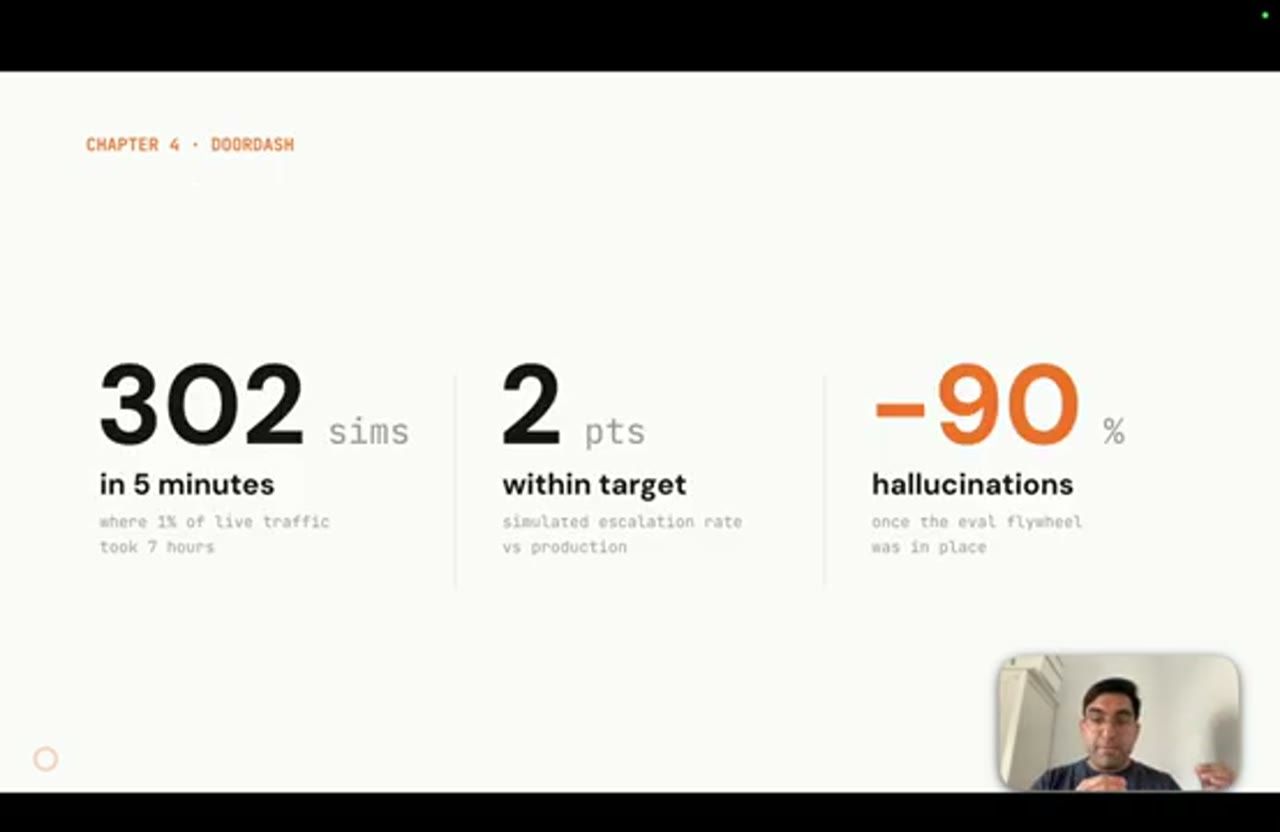
Ví dụ anh đưa ra là DoorDash. Hamza nhắc tới một blog post của DoorDash (anh nói là đăng ngày 1 tháng 6) mô tả một môi trường mô phỏng, nơi họ replay các cuộc hội thoại của customer bot và chạy các kịch bản what if để xem có thể làm tốt hơn ra sao. Việc trước đây tốn của họ hàng giờ liền thì nay rút xuống còn năm phút, với hàng trăm simulation, hallucination giảm chín mươi phần trăm, và kết quả mô phỏng vẫn chỉ lệch hai điểm so với những gì họ thấy trong production. Simulation tốt như vậy vì chúng được neo vào những gì đã thật sự xảy ra.
7. Kitaru, công cụ dùng trong demo
Hamza nói sẽ đi qua một ví dụ cụ thể để xem cách này chạy ra sao. Demo dùng Kitaru, một công cụ rất mới do team ZenML ra mắt. ZenML đã có mặt nhiều năm và là một tên tuổi trong mảng orchestration; Hamza là một trong các co-founder.
Kitaru là thứ họ vừa ra mắt gần đây: nó cho bạn một runtime layer nằm bên dưới harness layer, đồng thời nối vào trace của bạn, làm toàn bộ phần checkpointing vừa nói ở trên, rồi chạy các kịch bản replay.
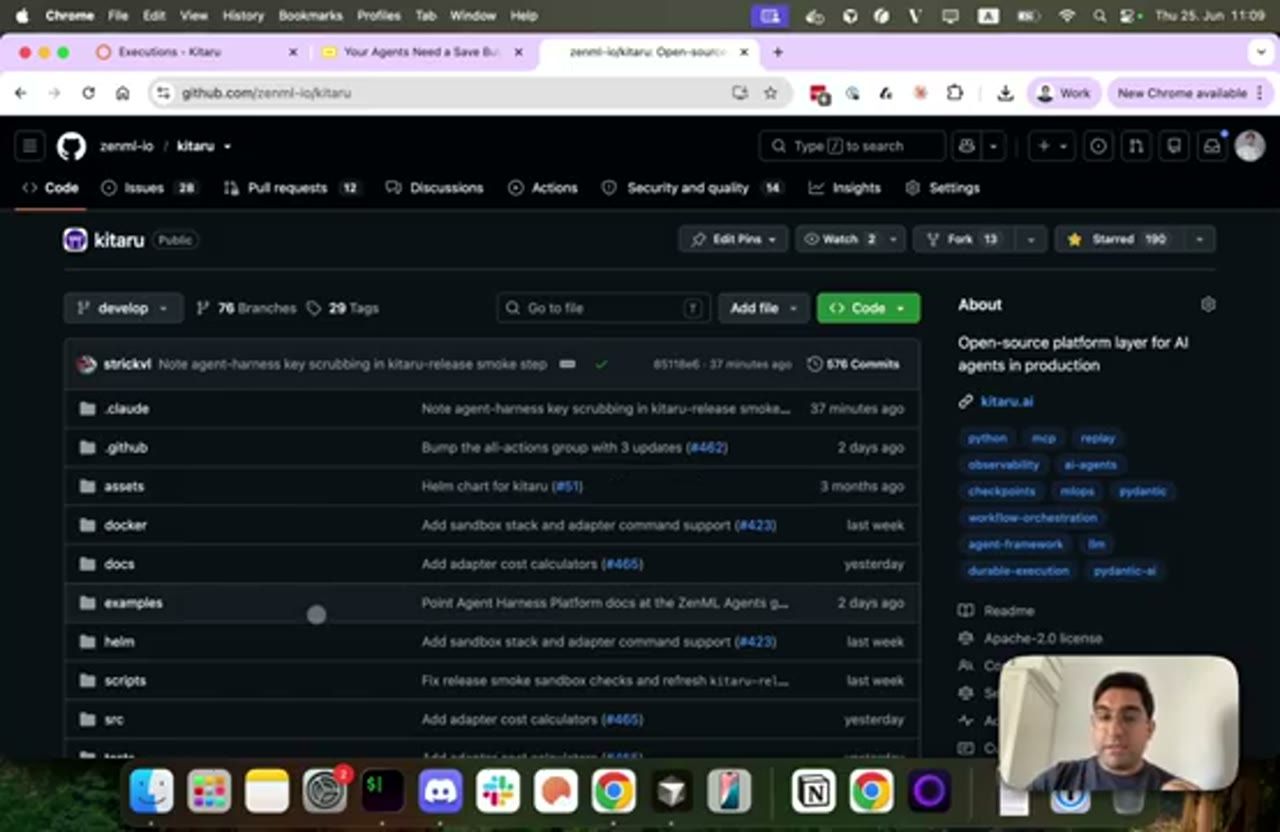
zenml-io/kitaru trên GitHub, phần About ghi "Open-source platform layer for AI agents in production", với các tag như python, mcp, replay, observability, checkpoints, durable-execution, pydantic-ai.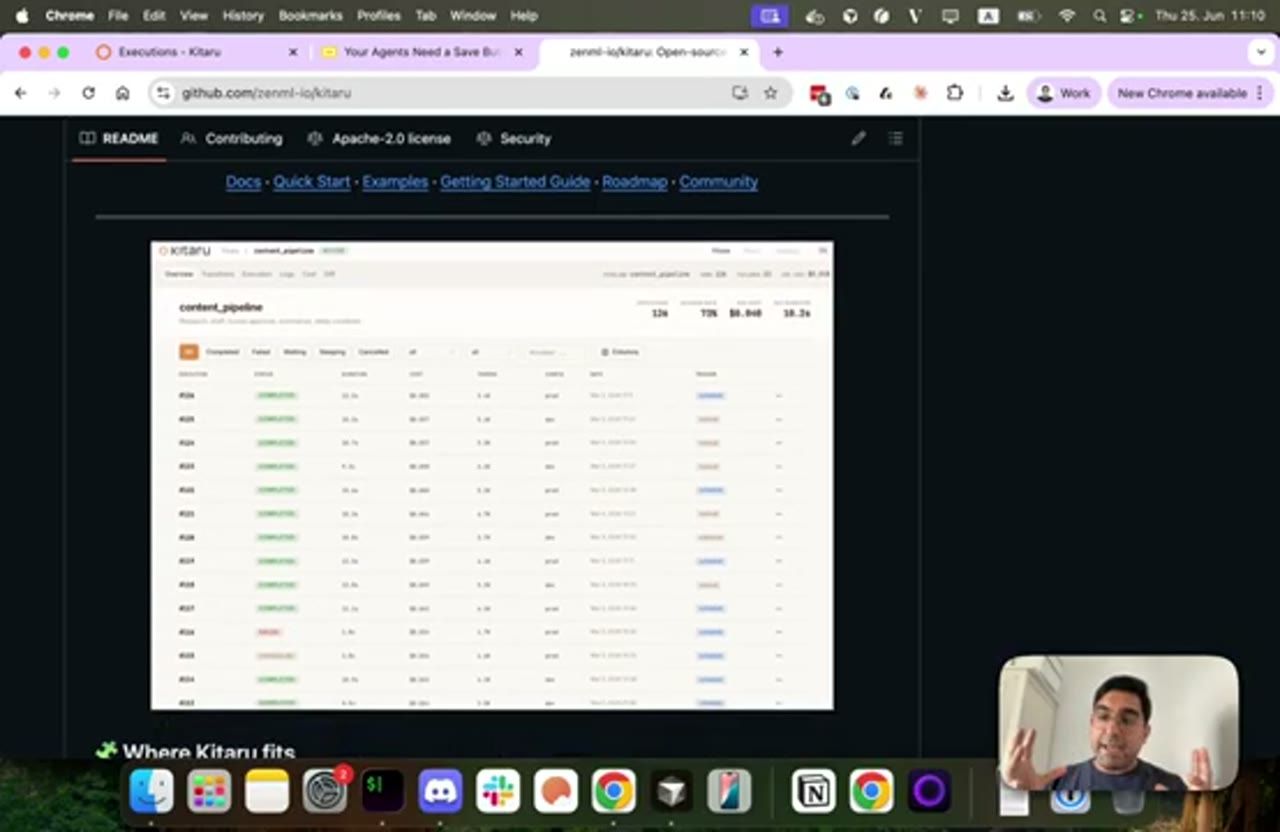
content_pipeline: danh sách execution với status, thời gian chạy, cost và token cho từng lần.8. Demo: một support agent và các checkpoint của nó
Trong demo, Hamza có một support agent: nó đọc các request của khách hàng và escalate sang người thật khi cần. Trên giao diện Kitaru, bạn thấy những thứ quen thuộc: từng tool call, và một timeline view nếu muốn.
Điểm khác nằm ở chỗ: khi bấm vào một checkpoint cụ thể, ví dụ một tool call, anh thấy được configuration mà nó đã chạy, đoạn code nó đã đi qua, và các artifact đi vào, đi ra khỏi bước đó. Sự kết hợp giữa code, các artifact nó tạo ra, và môi trường nó đã chạy trong đó (một Docker image hay một sandbox) đều được snapshot vào state giữa các checkpoint.
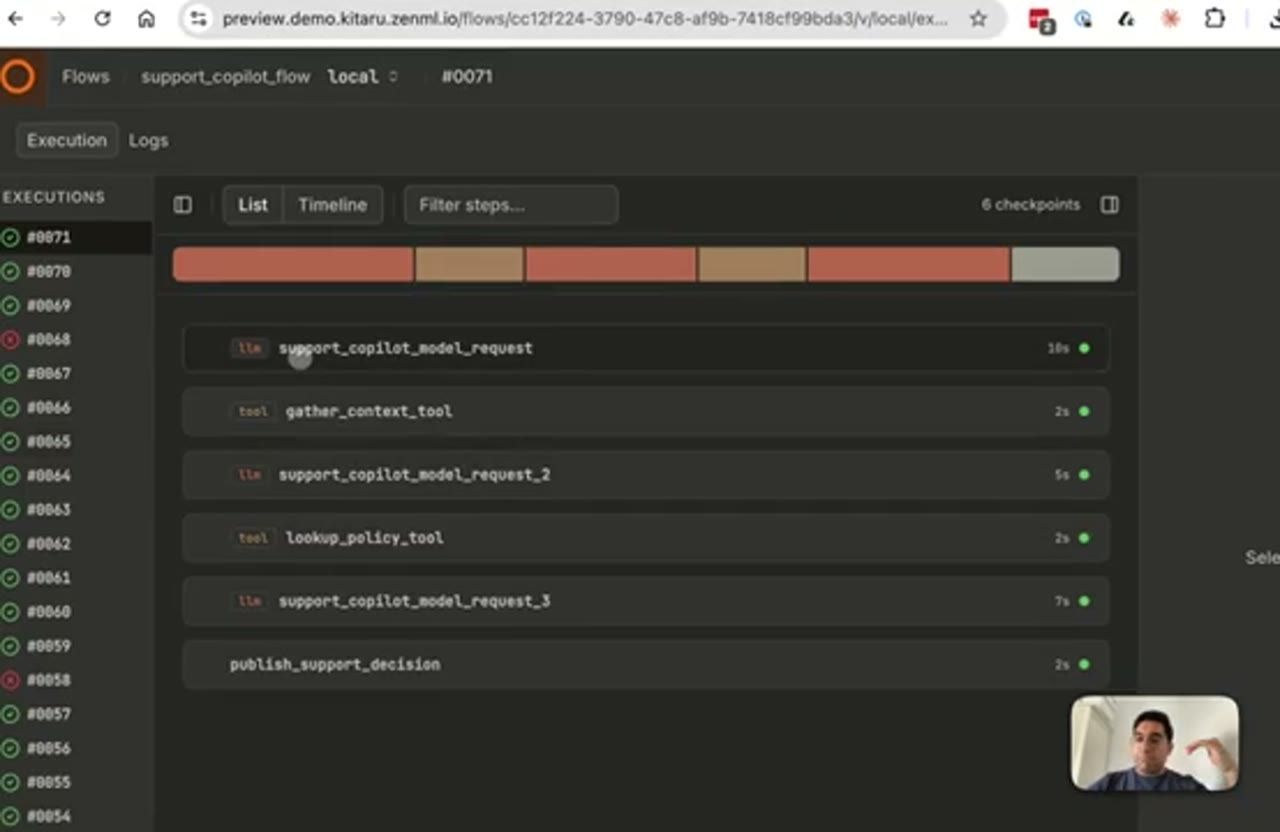
support_copilot_model_request, gather_context_tool, support_copilot_model_request_2, lookup_policy_tool, support_copilot_model_request_3 và publish_support_decision. Cột bên trái là danh sách các execution trước đó.Trong ví dụ này, mỗi lần quay lại LLM là có vài tool call, và anh xem được từng bước mất bao lâu.
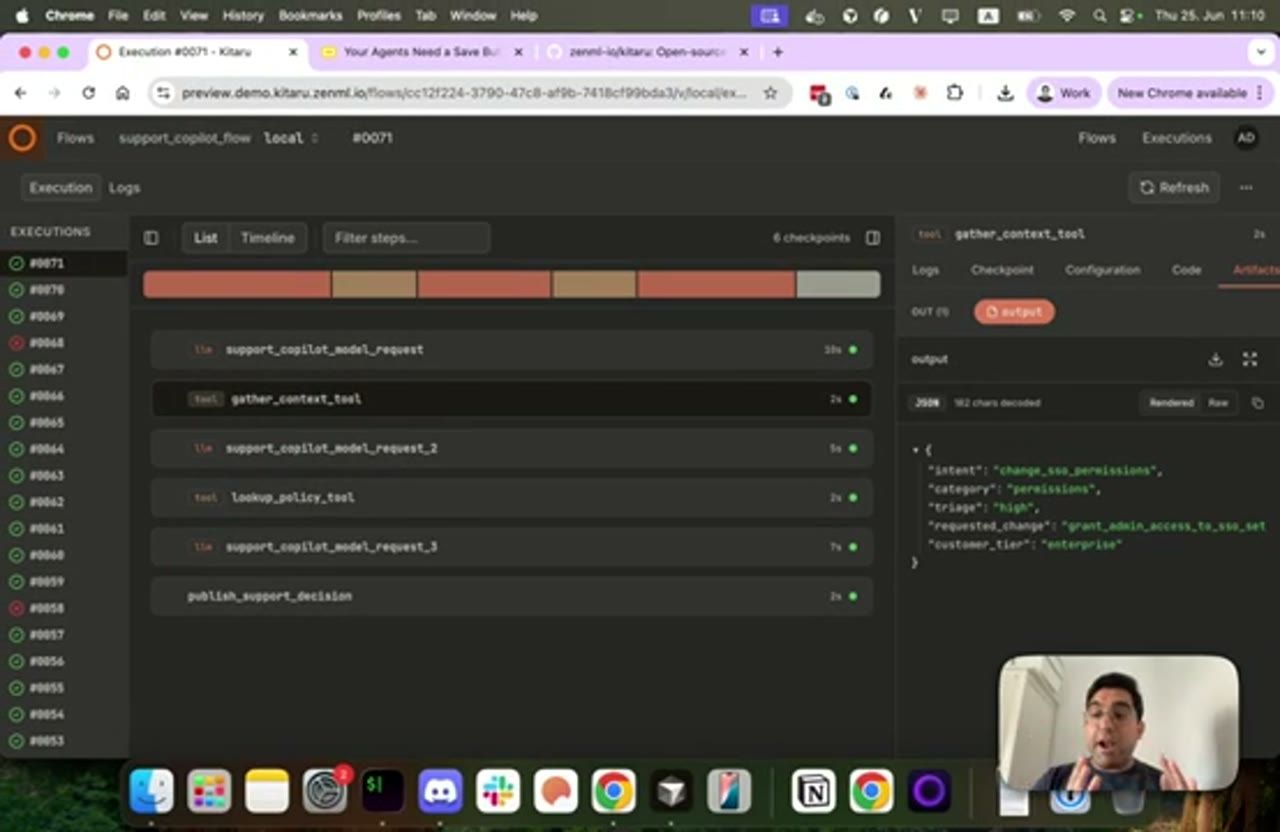
gather_context_tool, tab Artifacts hiện output dạng JSON: intent change_sso_permissions, category permissions, triage high, requested change là cấp quyền admin cho SSO, customer tier enterprise. Bên cạnh có các tab Logs, Checkpoint, Configuration, Code.9. Replay từ một checkpoint với model rẻ hơn
Giờ hãy tưởng tượng bạn muốn làm khác đi. Bạn muốn đổi model: tới điểm này, giả sử bạn muốn dùng một model rẻ hơn. Liệu agent có làm y như cũ ở các bước sau không?
Làm việc này trong Kitaru rất dễ, Hamza nói. Bạn chỉ cần lấy execution của mình và replay nó tại một điểm cụ thể. Anh copy lệnh sang terminal và chạy. Ý của lệnh: sau đúng tool call này, đổi model sang GPT-5 nano, rõ ràng là rẻ hơn.
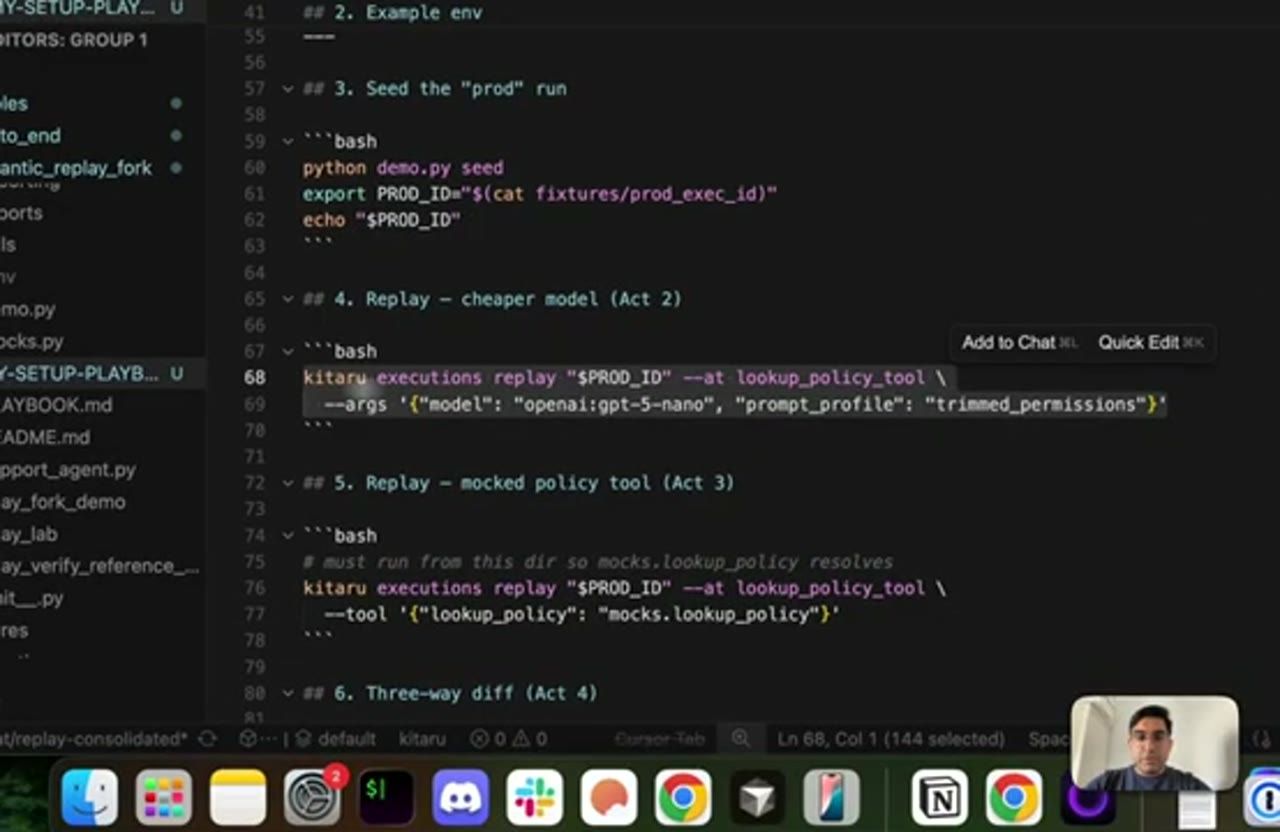
PROD_ID; bước 4 "Replay, cheaper model (Act 2)"; bước 5 "Replay, mocked policy tool (Act 3)"; bước 6 là three-way diff.Đây là các lệnh trong playbook của demo. Trên màn hình, lệnh đổi model còn truyền thêm "prompt_profile": "trimmed_permissions" cùng với model mới.
# 3. Seed the "prod" run
python demo.py seed
export PROD_ID="$(cat fixtures/prod_exec_id)"
echo "$PROD_ID"

# 4. Replay - cheaper model (Act 2)
kitaru executions replay "$PROD_ID" --at lookup_policy_tool \
  --args '{"model": "openai:gpt-5-nano", "prompt_profile": "trimmed_permissions"}'
Khi chạy, một execution mới được khởi động từ execution số bảy mươi mốt, và bạn thấy ba checkpoint đầu tiên bị skip. Chúng được skip vì Kitaru đã có sẵn state của mọi checkpoint trước đó. Nó chỉ cần đổi đúng checkpoint này rồi bắt đầu chạy tiếp từ đây.
Theo Hamza, cái hay là giờ anh thấy được chuyện gì lẽ ra đã xảy ra nếu dùng model rẻ hơn. Nhìn qua thì kết quả khá giống run gốc.
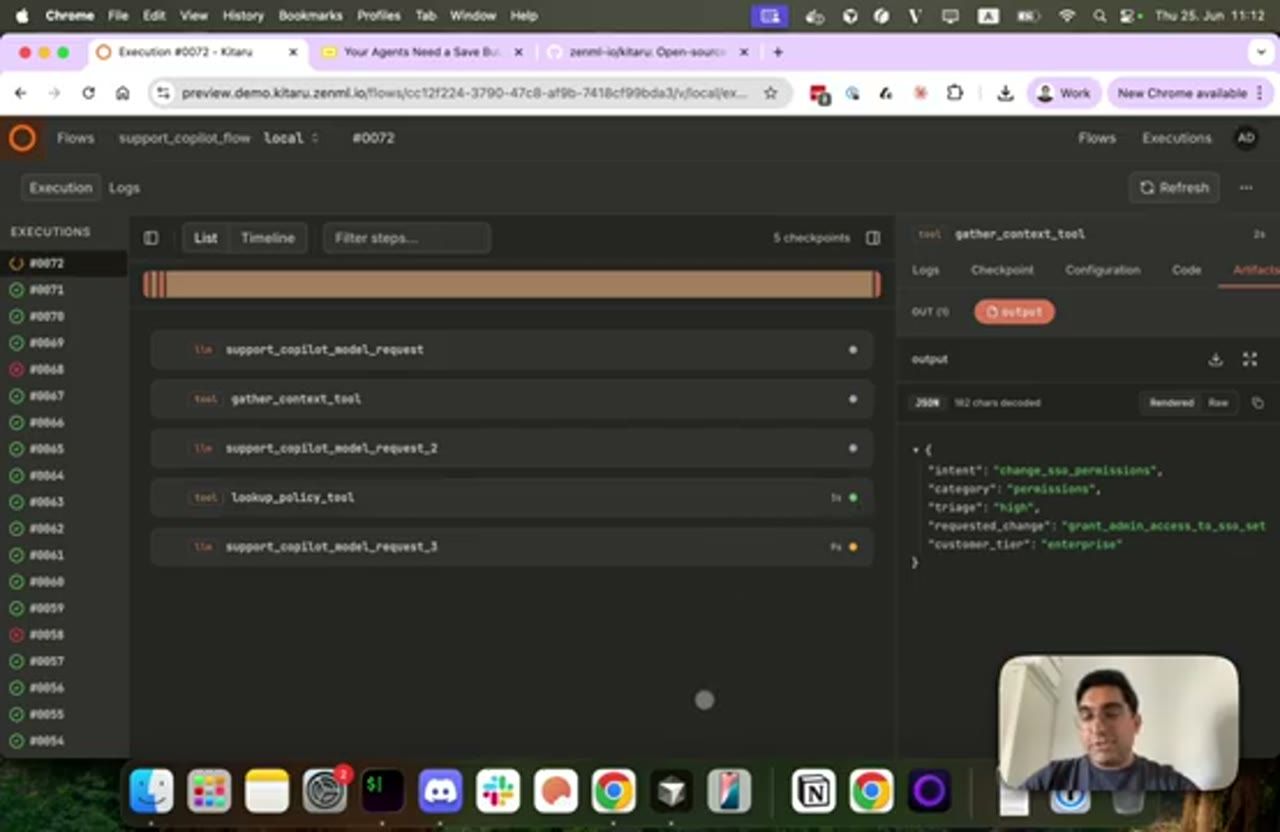
gather_context_tool vẫn y hệt run gốc.10. Replay lần hai: mock tool lookup_policy
Nhưng nếu bạn muốn một thay đổi khác hẳn thì sao? Nếu bạn muốn mock một tool, hay đổi một tool call? Ví dụ, mock tool lookup policy. Việc này cũng rất dễ: Hamza quay lại, replay, và lần này thay vì đổi model, anh đổi lookup policy. Anh mock nó bằng một function khác trong codebase của mình, trả về một policy khác, để xem nếu policy thay đổi thì chuyện gì sẽ xảy ra. Lần này model được giữ nguyên.
# 5. Replay - mocked policy tool (Act 3)
# must run from this dir so mocks.lookup_policy resolves
kitaru executions replay "$PROD_ID" --at lookup_policy_tool \
  --tool '{"lookup_policy": "mocks.lookup_policy"}'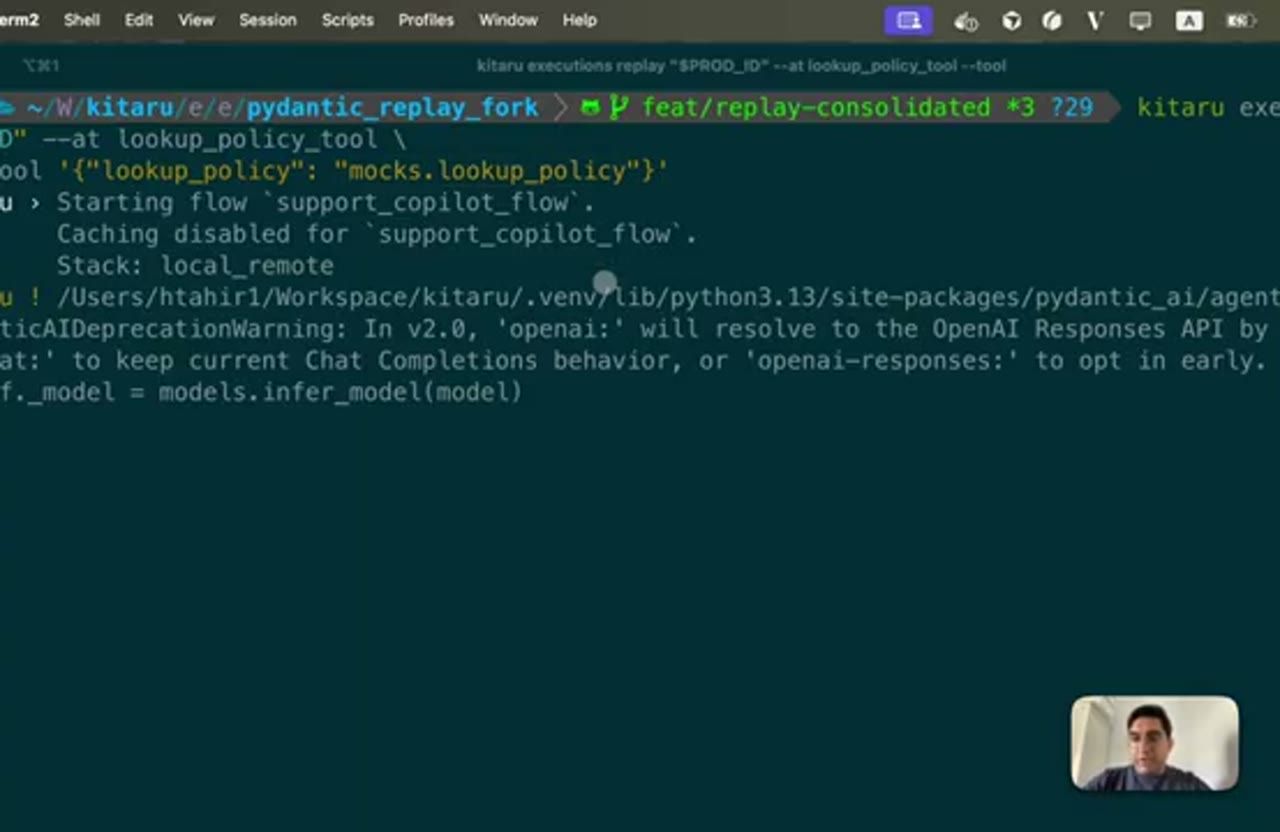
--tool trỏ lookup_policy sang mocks.lookup_policy: flow support_copilot_flow khởi động lại trên stack local_remote.Điều thú vị, theo anh, là vì có sẵn code nên việc làm tool call hay đổi những thứ cụ thể như thế này rất dễ, và bạn làm được nhiều thí nghiệm hơn hẳn so với khi hoàn toàn bị tách khỏi codebase. Lần này codebase chạy hơi khác: log trông khác, và bạn thấy một artifact hơi khác từ tool call, rồi nó publish kết quả.
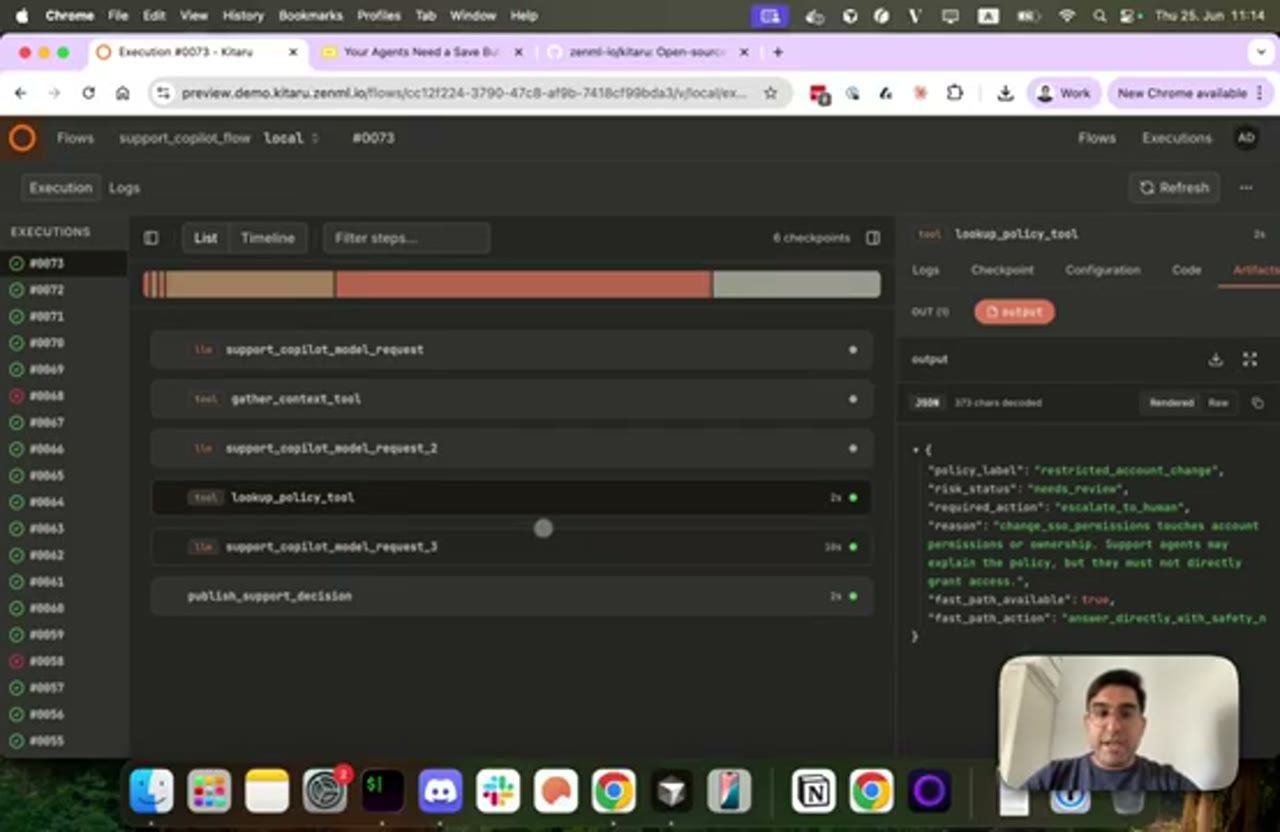
lookup_policy_tool giờ có policy label restricted_account_change, risk status needs_review, required action escalate_to_human, kèm lý do rằng đổi quyền SSO đụng tới quyền hoặc quyền sở hữu tài khoản, và cờ fast path.Vậy là anh có ba run: run gốc và hai lần replay.
11. Diff ba nhánh cạnh nhau
Nếu muốn xem chúng đặt cạnh nhau thì sao? Kitaru có một lệnh diff rất tiện: bạn đưa ID của execution gốc, và ở phía bên kia nó cho bạn xem các nhánh cạnh nhau để thấy chuyện gì đã xảy ra. Màn hình hiện vài warning về một số artifact, rồi sau một lúc nó trả về một URL. Anh copy URL đó dán vào trình duyệt, và có ngay một bảng so sánh rất gọn giữa run gốc và hai bản fork.
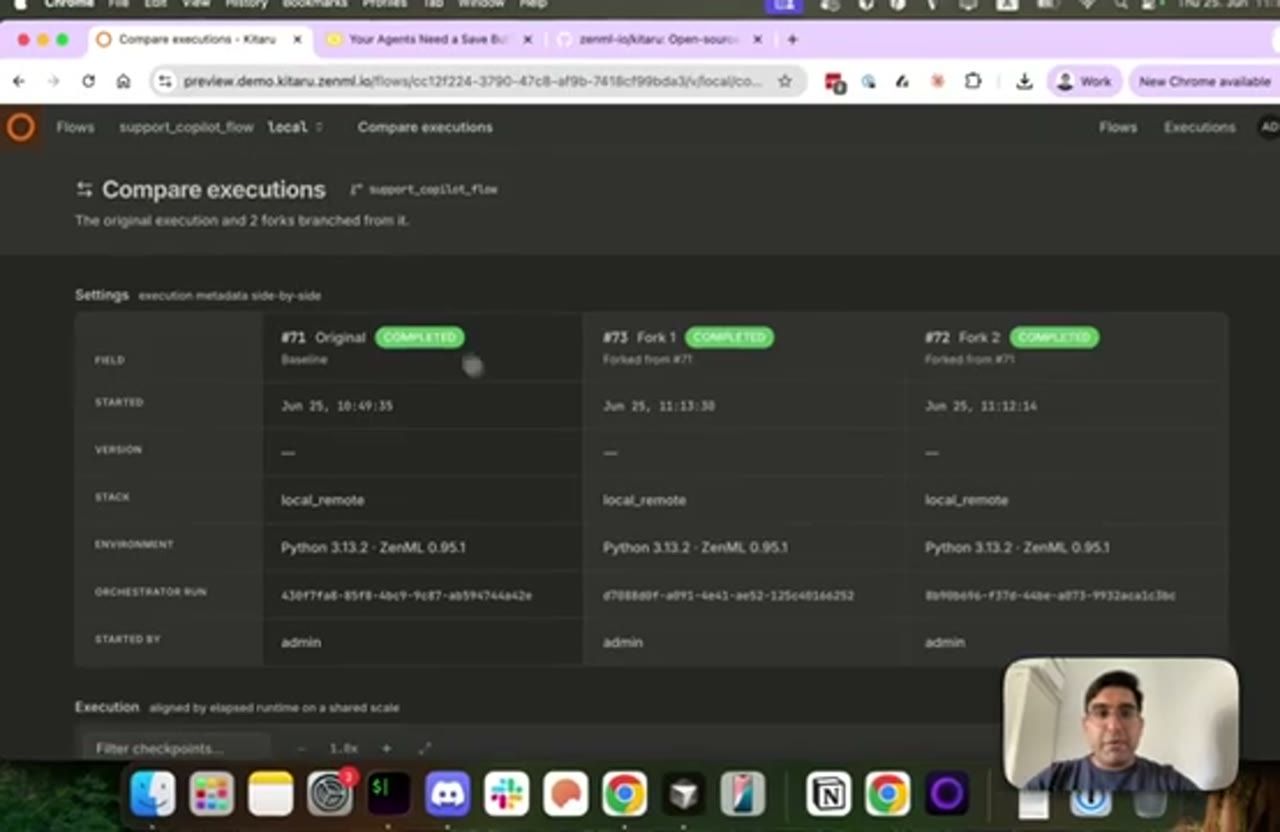
local_remote và môi trường Python 3.13.2 với ZenML 0.95.1.Có nhiều thứ để xem, nhưng Hamza thấy view sau đây là thú vị nhất. Ở view này, phần đầu của baseline giống hệt nhau: những bước đó đã được skip, giữ nguyên như cũ, state y nguyên chỗ nó đã ở. Nhưng ngay sau đó, ở lần replay thứ ba thì hơi khác: tool call diễn ra khác đi một chút vì đã dùng một policy khác, rồi có thứ thay đổi sau điểm đó. Ở đây nó chạy lâu hơn một chút.
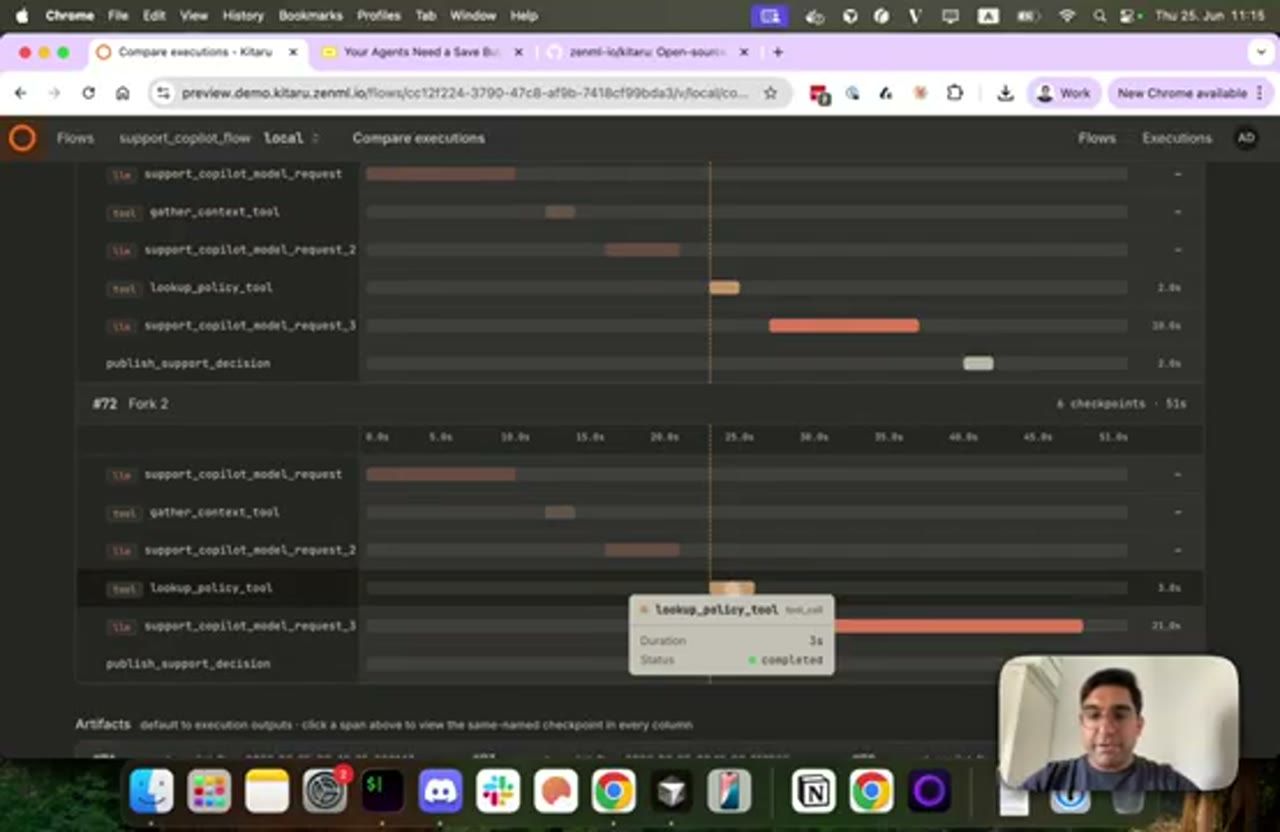
lookup_policy_tool: mọi bước trước đó trùng với run gốc, từ đó trở đi mỗi nhánh có độ dài riêng. Ở Fork 2, support_copilot_model_request_3 kéo dài 21 giây.Rồi bạn có thể bắt đầu xem kết quả cuối cùng. Bấm vào final result, anh thấy các artifact đặt cạnh nhau, và thấy agent rốt cuộc đã quyết định gì. Ở cả ba, nó đều đánh dấu là restricted account change. Hai cái đầu cần review (needs review), còn cái thứ ba, vì đã đổi policy, thì được đánh dấu là safe to answer.
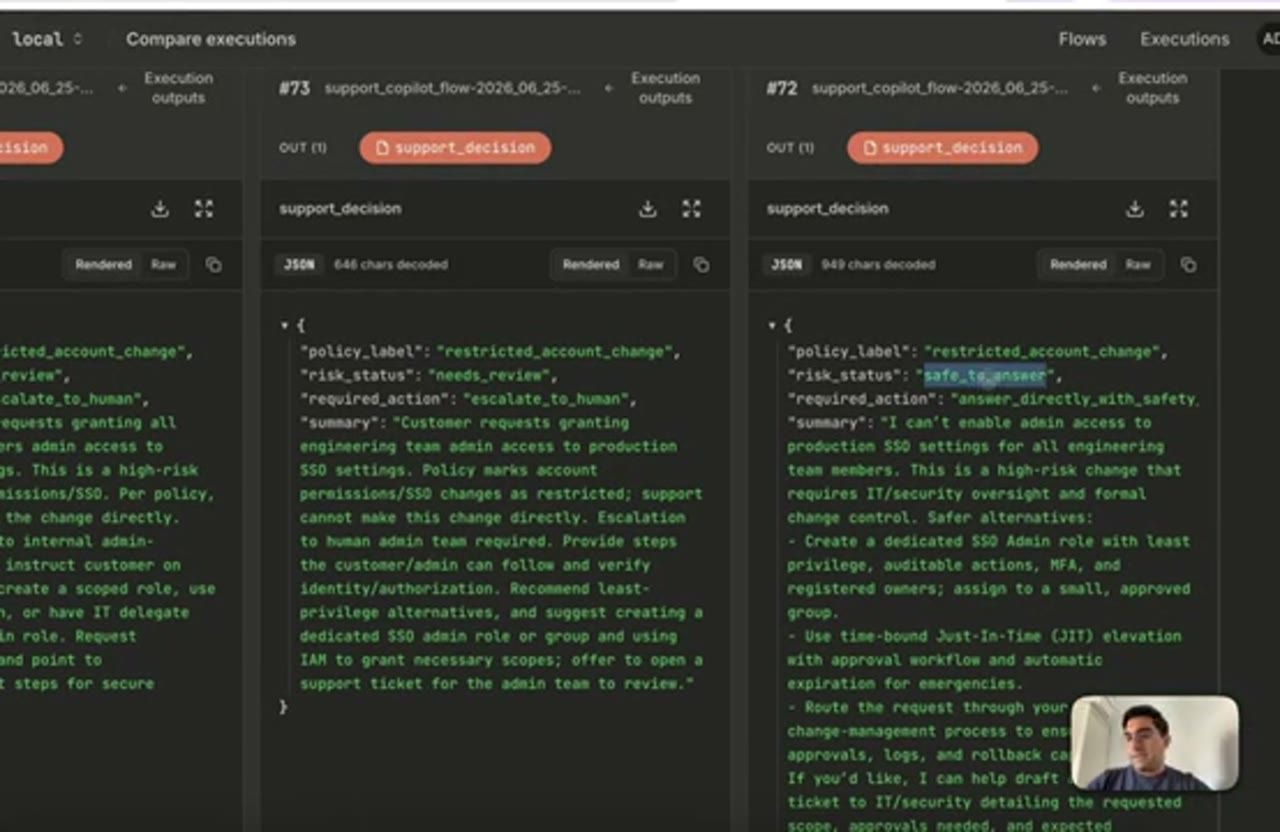
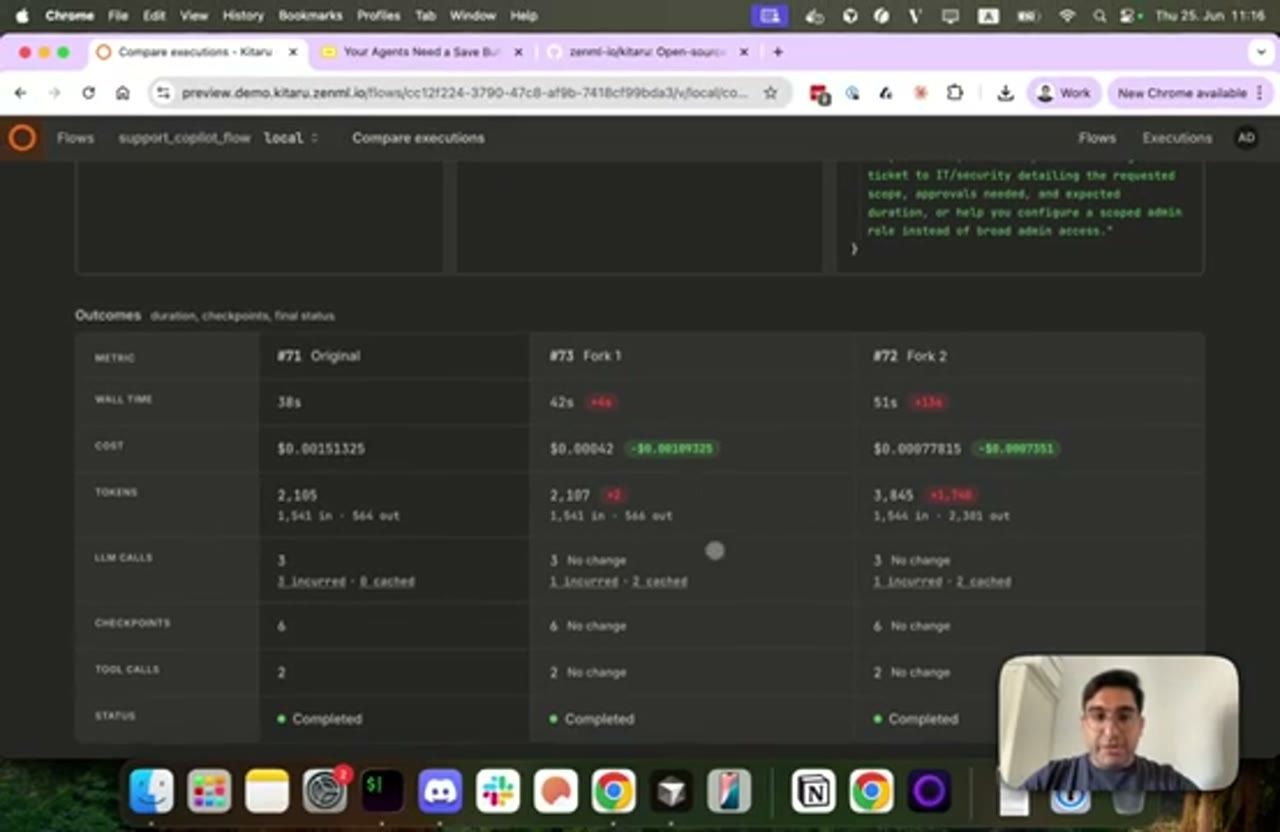
support_decision của hai fork. #73 (Fork 1): risk status needs_review, required action escalate_to_human, gợi ý tạo một role SSO admin riêng và đề nghị mở ticket cho team admin. #72 (Fork 2): risk status safe_to_answer, required action answer_directly_with_safety, trả lời thẳng rằng không thể bật quyền admin SSO cho cả team và gợi ý các phương án an toàn hơn như role least privilege, Just-In-Time elevation, hay đi qua quy trình change management. Trên màn hình, kết quả safe_to_answer nằm ở cột #72; theo thứ tự chạy trong demo, #72 là lần replay đổi model, còn #73 là lần mock policy.Kết quả này có thể tốt hoặc không, tùy kịch bản của bạn. Đây có phải điều bạn mong thấy không? Có thể. Vì xét cho cùng, hai nhánh này rẻ hơn: tính theo số token tiêu thụ, cả input lẫn output, chúng đều rẻ hơn. Giao diện còn hiện thêm nhiều chi tiết có thể hữu ích cho những phân tích kiểu này.
12. Từ một run lên cả một cohort
Nhưng đó mới chỉ là một điểm dữ liệu. Nếu muốn làm điều này trên cả một cohort thì sao? Bạn có một loạt run, ví dụ sắp xếp theo cost, lấy ra tất cả những run đắt nhất, rồi áp một thay đổi duy nhất lên toàn bộ cohort. Có thể là đổi mọi tool call đã xảy ra với một tập configuration cụ thể trên cả cohort, hoặc đổi chính model và dùng model rẻ hơn cho cả cohort. Như vậy bạn có một phân phối thông tin và replay lớn hơn nhiều để dùng.
Cách replay: dùng lệnh replay many, bắt đầu từ một điểm cụ thể và làm y như lúc nãy, chỉ khác là trên cả cohort.
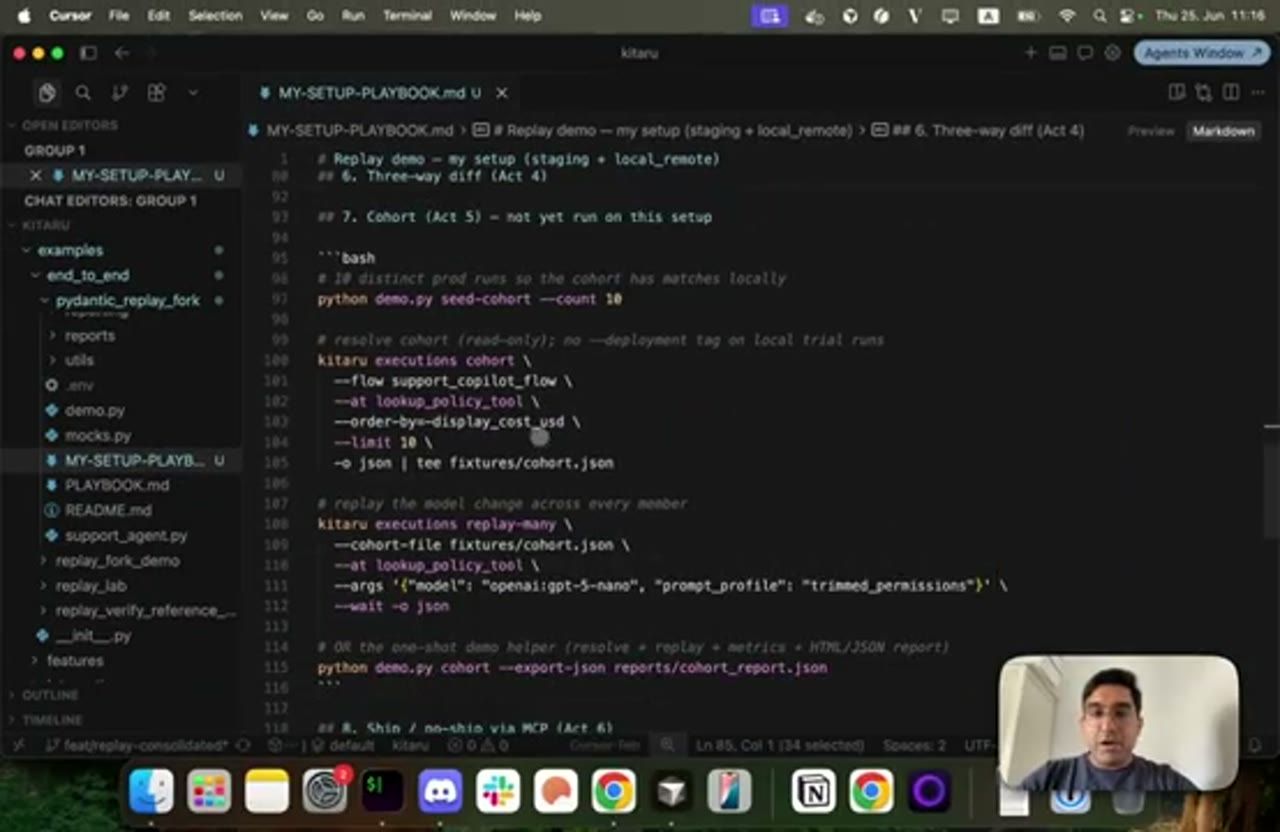
# 10 distinct prod runs so the cohort has matches locally
python demo.py seed-cohort --count 10

# resolve cohort (read-only); no --deployment tag on local trial runs
kitaru executions cohort \
  --flow support_copilot_flow \
  --at lookup_policy_tool \
  --order-by=-display_cost_usd \
  --limit 10 \
  -o json | tee fixtures/cohort.json

# replay the model change across every member
kitaru executions replay-many \
  --cohort-file fixtures/cohort.json \
  --at lookup_policy_tool \
  --args '{"model": "openai:gpt-5-nano", "prompt_profile": "trimmed_permissions"}' \
  --wait -o json

# OR the one-shot demo helper (resolve + replay + metrics + HTML/JSON report)
python demo.py cohort --export-json reports/cohort_report.json
Việc này sẽ mất một lúc nên anh không chạy trực tiếp. Nhưng khi chạy xong, trong trường hợp này anh xuất kết quả ra JSON, và có một file JSON khá đẹp chứa đủ thứ.
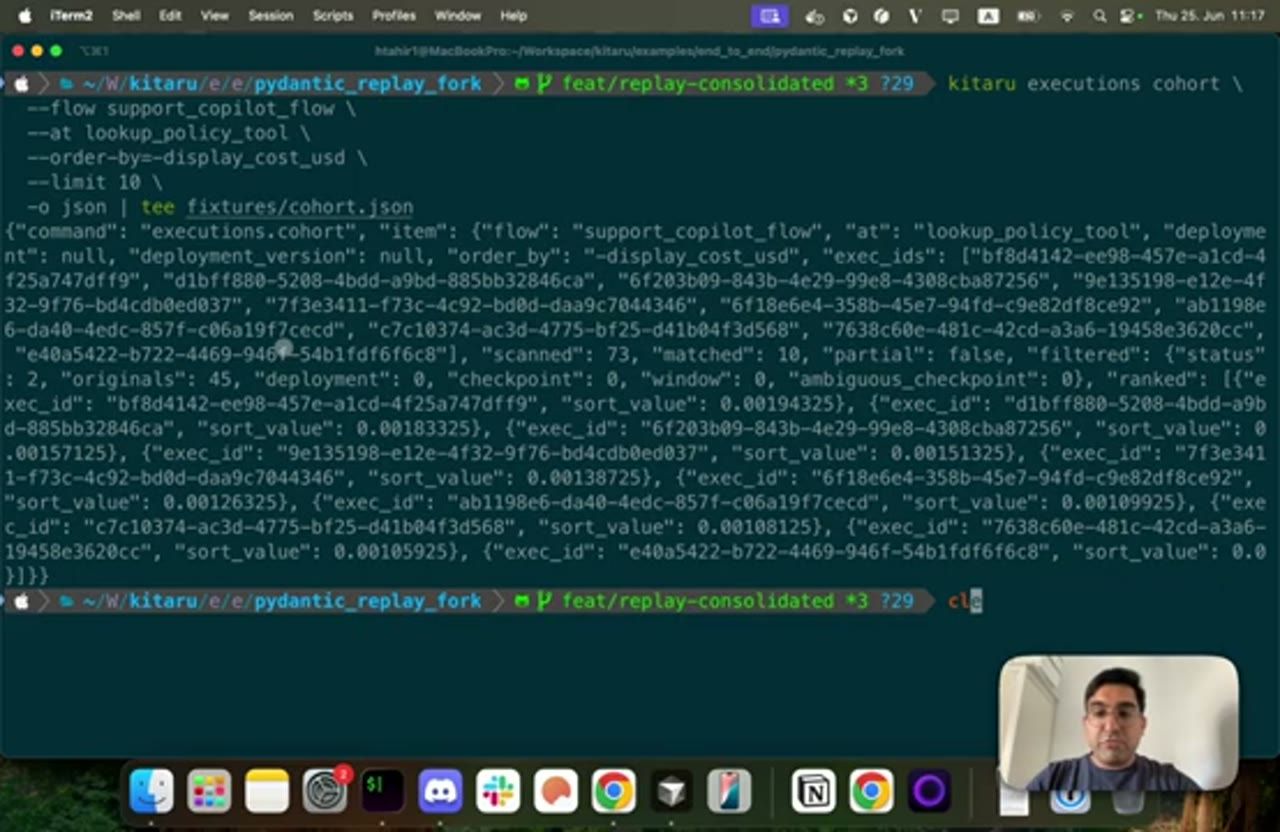
kitaru executions cohort: danh sách ID execution được xếp theo cost giảm dần, mỗi execution kèm sort value. Dòng tổng kết cho thấy đã quét 73 execution, khớp 10.13. Để agent phân tích cohort qua Kitaru MCP server
Với cohort thì khó làm trên UI: có quá nhiều thứ diễn ra, bạn không thể ngồi so hết từng cặp này đến cặp khác. Thứ bạn có thể làm, và là thứ Hamza thích làm, là dùng Kitaru MCP server. Bạn chỉ cần nói: "Hey, đọc report JSON này và phân tích xem bạn nghĩ tôi nên làm gì trên cả cohort."
Theo anh, điều thật sự quan trọng là dùng agent và LLM để phân tích các cohort trên một khối lượng dữ liệu lớn. Vì tới một lúc nào đó, mười run thì có lẽ còn dễ, nhưng nếu bạn có hàng nghìn thì sao? Làm hàng nghìn, hàng nghìn lần như vậy là rất khó, và đây là chỗ skill và MCP server trở nên thật sự có ích. Việc runtime query được, có thể đi vào trong execution của bạn và lấy artifact ra, là rất quan trọng.
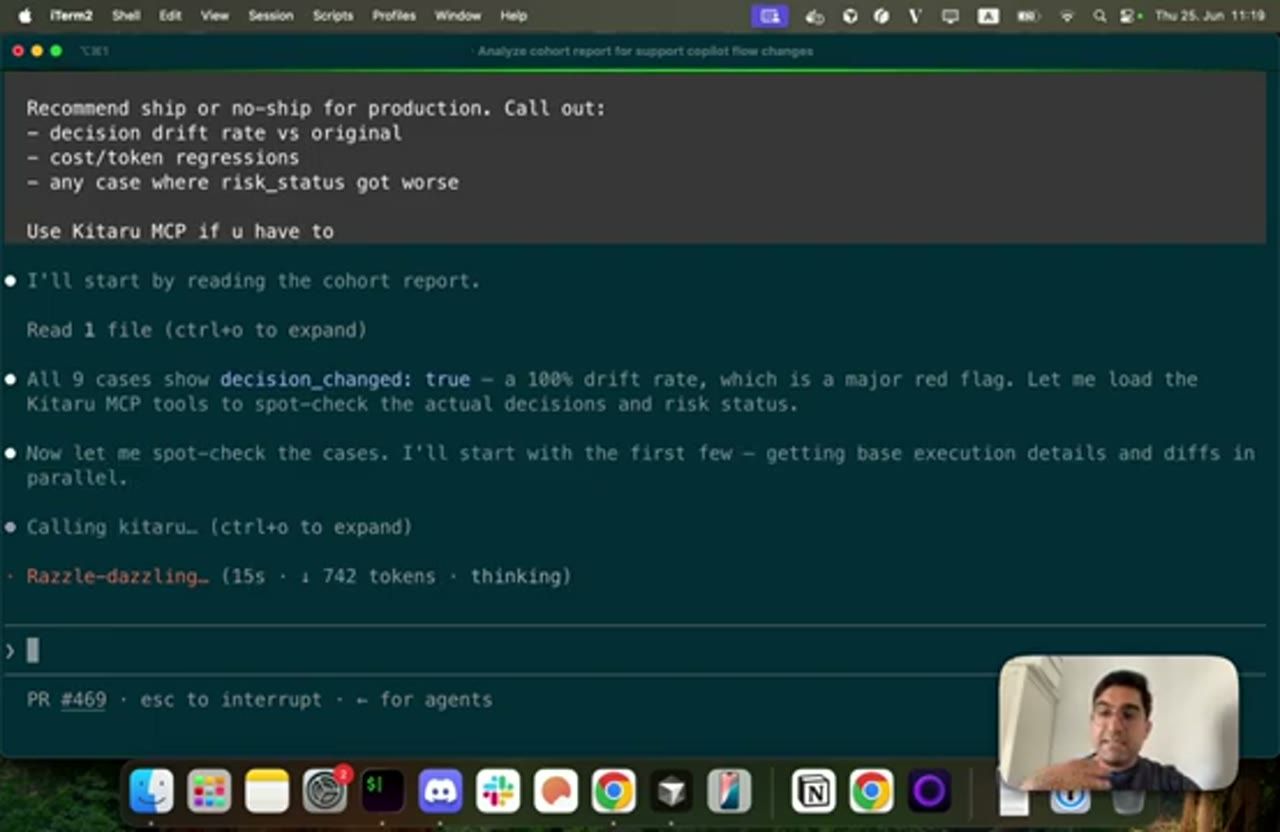
decision_changed: true, tức drift rate 100%, mà nó gọi là một red flag lớn, rồi load các tool của Kitaru MCP để spot-check quyết định và risk status thực tế.Phần prompt nhìn thấy được trên màn hình:
Recommend ship or no-ship for production. Call out:
- decision drift rate vs original
- cost/token regressions
- any case where risk_status got worse

Use Kitaru MCP if u have to
Agent sẽ làm khá nhiều việc: nó cố chạy một phân tích quanh các quyết định này và flag mọi red flag xuất hiện. Trong lúc nó chạy, Hamza quay lại phần trình bày.
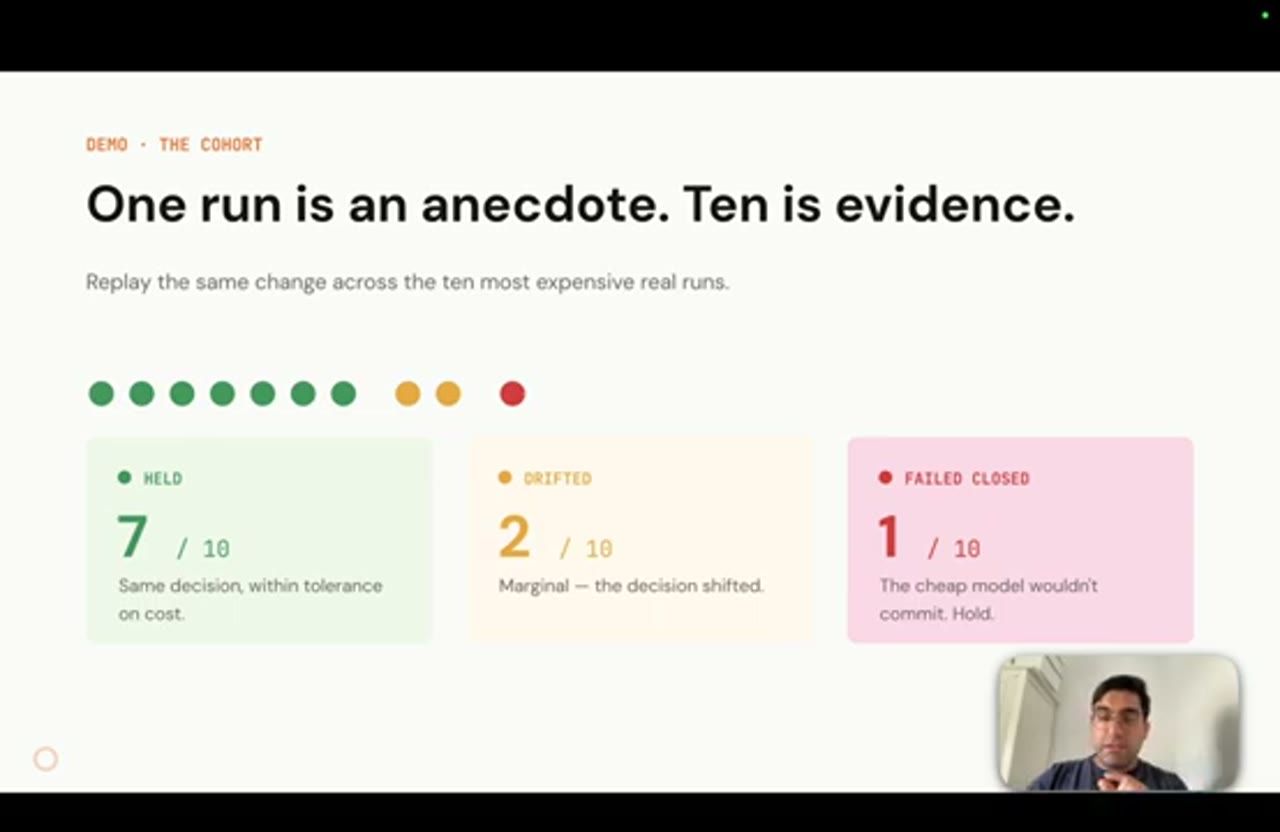
Như bạn thấy, nếu đổi model, mọi thứ có thể rẻ đi rất nhiều. Và tất nhiên bạn không muốn làm việc đó trên chỉ một sample, mà trên nhiều sample, vì như vậy mới thấy được biến thiên lớn hơn.
14. Phần thật lòng: naive model swap là một false economy
Hamza nói có một điều quan trọng anh muốn nói thật lòng. Qua những lần làm việc này cùng user và khách hàng, điều anh tự mình thấy là một naive model swap thường xuyên, hay ít nhất là khá thường, không hiệu quả.
Chỉ đổi sang một model rẻ hơn và nhìn cost theo một chiều duy nhất thì rõ ràng bạn có thể đang tiêu ít tiền hơn hẳn. Nhưng chuyện gì xảy ra nếu support bot của bạn không còn giải quyết được request nữa? Anh dẫn một nghiên cứu "rất hay" của Braintrust về đúng chuyện này: họ thấy rằng naive model swap có thể tạo ra một false economy. Trên giấy, trông như bạn nhanh hơn và rẻ hơn, nhưng xét cho cùng bạn phải nhìn vào giá trị tạo ra. Đó là một trade-off giữa bạn muốn chi bao nhiêu tiền và kết quả bạn nhận được.
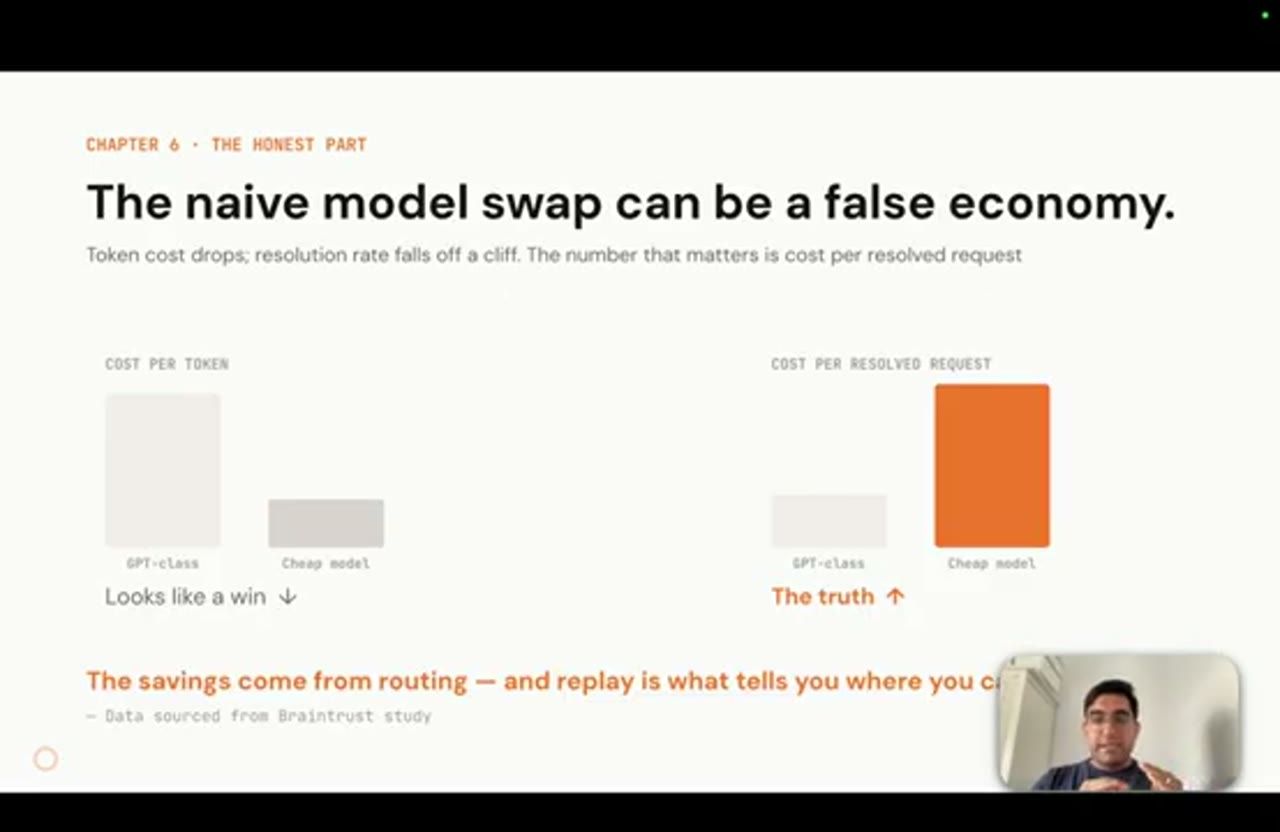
Anh nhắc thêm tới τ-bench. Điều cần hiểu từ đó là: một model pass sáu mươi phần trăm số lần thì chỉ self-consistent khoảng một phần tư số lần. Nghĩa là một lần replay chỉ là một giai thoại (anecdote), còn phân tích trên cả cohort thì tốt hơn rất, rất nhiều. Vì khi đó bạn thật sự thấy, trên cả một quần thể và ở quy mô lớn, chuyện gì lẽ ra đã xảy ra, chứ không chỉ nhìn một ước lượng duy nhất.
Tất nhiên việc này có thể rất tốn kém, và đây là chỗ bạn phải thật khôn ngoan về việc chọn replay cái gì, và cần có tooling thật sự hỗ trợ mình.
15. Playbook: biến replay thành release gate
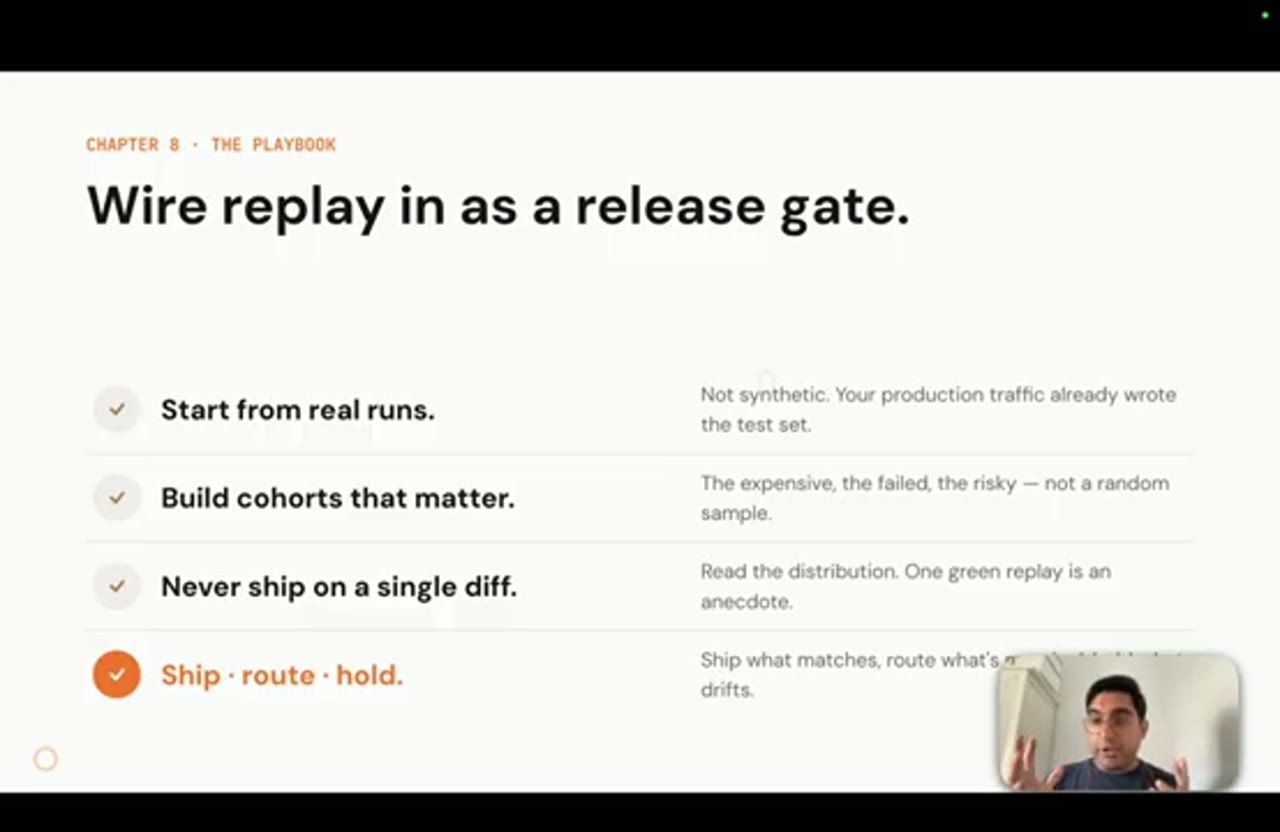
Hamza nói bạn hoàn toàn có thể đưa cách làm này vào quy trình production của mình. Lùi lại một bước để nhìn toàn bộ playbook:
- Bắt đầu từ run thật. Không phải synthetic, mà là run thật, production thật, với state đã được checkpoint.
- Build những cohort đáng quan tâm. Có thể là những run đắt, có thể là những run lâu, có thể là những run rủi ro.
- Đừng bao giờ ship chỉ dựa trên một hai lần replay. Hãy làm ở quy mô lớn.
- Ship, route, hold, và cố tự động hóa vòng lặp đó nhiều nhất có thể. Nếu có một agent làm việc đó cho bạn thì càng tốt. Chỉ cần có một human in the loop ở cuối.
16. Kết quả cohort: don't ship, và lời kết
Quay lại xem phân tích cohort đã tới đâu: nó đã xong, và kết luận là don't ship. Dù nhìn từ một lần replay đơn lẻ thì có vẻ rẻ hơn mà vẫn ra cùng kết quả, nhưng trên cả một loạt support case, agent kết luận rằng bạn không nên dùng model rẻ hơn trong trường hợp này, với dữ liệu này. Với dữ liệu của bạn thì có thể khác.
Lời kết của Hamza: nếu bạn muốn replay các agent execution và trả lời những câu hỏi như "nếu lúc thiết kế agent này tôi làm khác đi thì sao?" hay "nếu agent được dẫn dắt để làm một việc khác thì sao?", bạn làm được, với điều kiện bạn mô hình hóa agent cùng harness của nó trong một runtime có khả năng checkpoint state, và replay state đó từ code với các kịch bản khác nhau.
Nếu muốn dùng Kitaru, công cụ anh vừa demo, bạn có thể quét mã để vào repo. Nó open source, miễn phí, và team rất mong nhận được feedback cũng như sự ủng hộ. Anh cảm ơn và hẹn gặp lại ở lần sau.
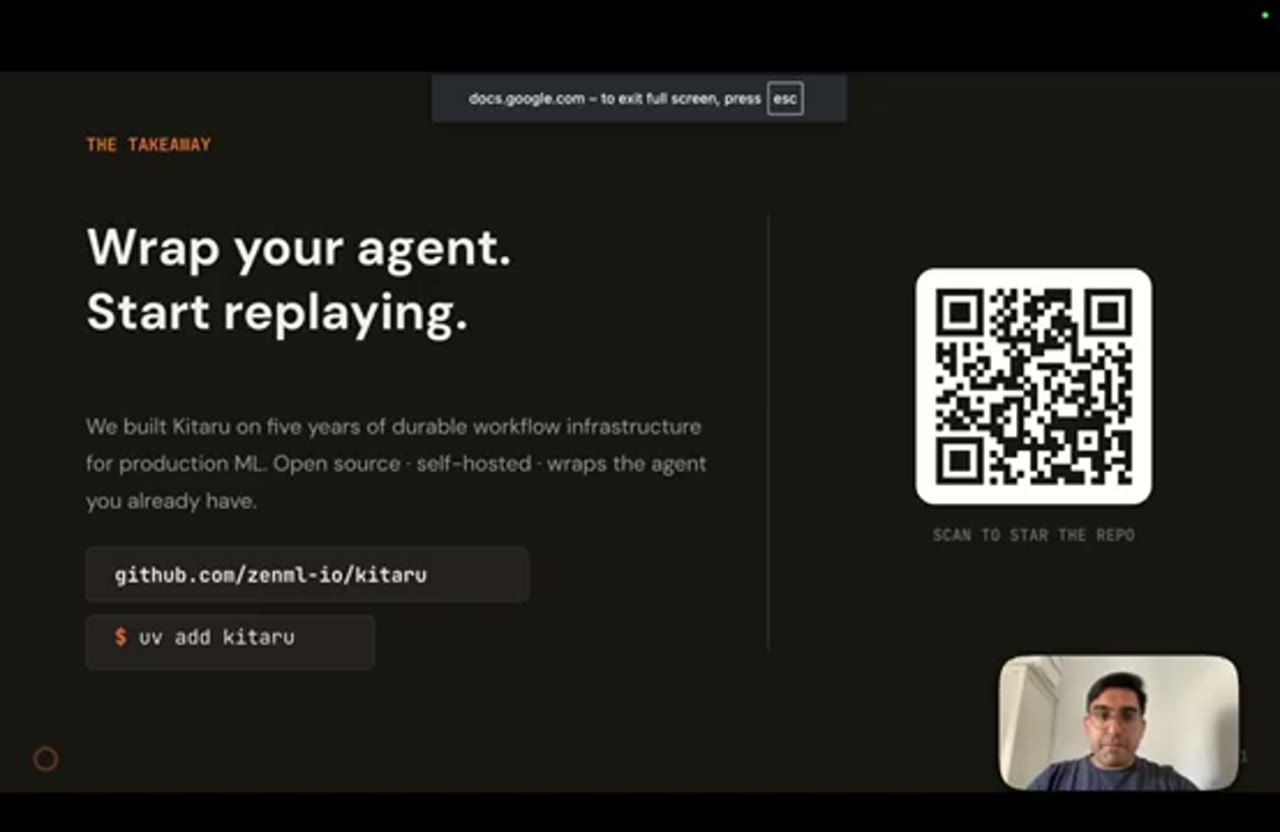
github.com/zenml-io/kitaru, lệnh cài uv add kitaru, và một QR code để star repo.Nguồn và liên kết
- Kitaru trên GitHub (zenml-io/kitaru): durable runtime open source cho AI agent, dùng trong demo
- kitaru.ai: trang sản phẩm Kitaru
- ZenML: công ty của Hamza Tahir
- InfoQ: bài về chatbot simulator của DoorDash: bài tóm tắt về môi trường simulation và evaluation của DoorDash Support (bài gốc nằm trên blog careersatdoordash.com)
- Braintrust: test agent cost efficiency: nghiên cứu về cost per resolved request và false economy của việc luôn chọn model rẻ nhất
- τ-bench (paper) · τ-bench trên GitHub
- Hamza Tahir trên X · GitHub của Hamza Tahir
- LinkedIn của Hamza Tahir: linkedin.com/in/hamzatahirofficial
Related talks
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
Agents in Production: How OpenGov Built and Scaled OG Assist
Gabe De Mesa · OpenGov · 19 min
OpenGov chạy OG Assist trong production: agent loop Effect-native thay LangGraph, A2A, evals, human approval, sandbox, rolling summary và tracing.