10 skill để trở thành AI engineer
Mười skill AI engineer cần theo Dhaval Patel: từ Python, LLM fundamentals, context engineering, RAG, agents, evals tới deploy, guardrails, fine-tuning và system design.
✓ Đã duyệt độc lập · cập nhật 19/11/2026 · 32 min
1. Ba nhóm skill và skill số 1: Python và software basics
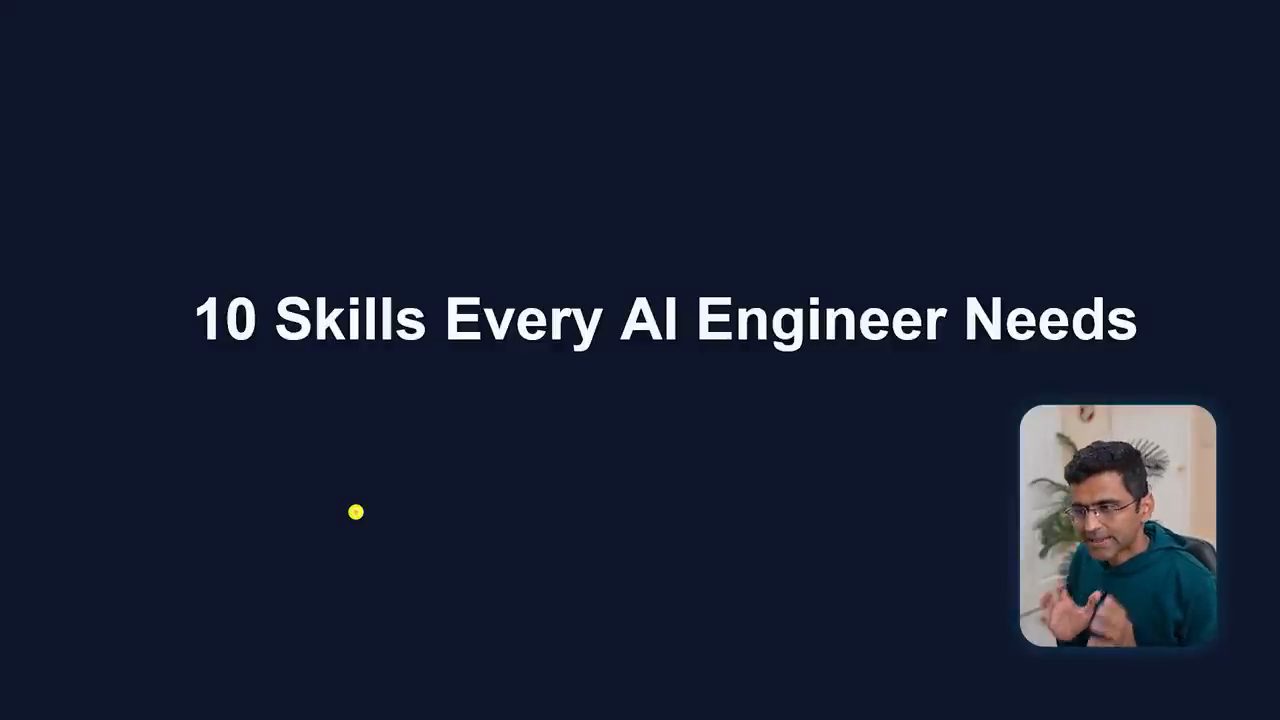
Dhaval Patel mở đầu: trong video này anh đi qua 10 skill mà theo anh mọi AI engineer đều cần (video đăng ngày 16/11/2026). Các skill được chia vào ba nhóm: foundation, build và production, và anh nói đây chính là những skill đó, rồi đi qua từng cái một.
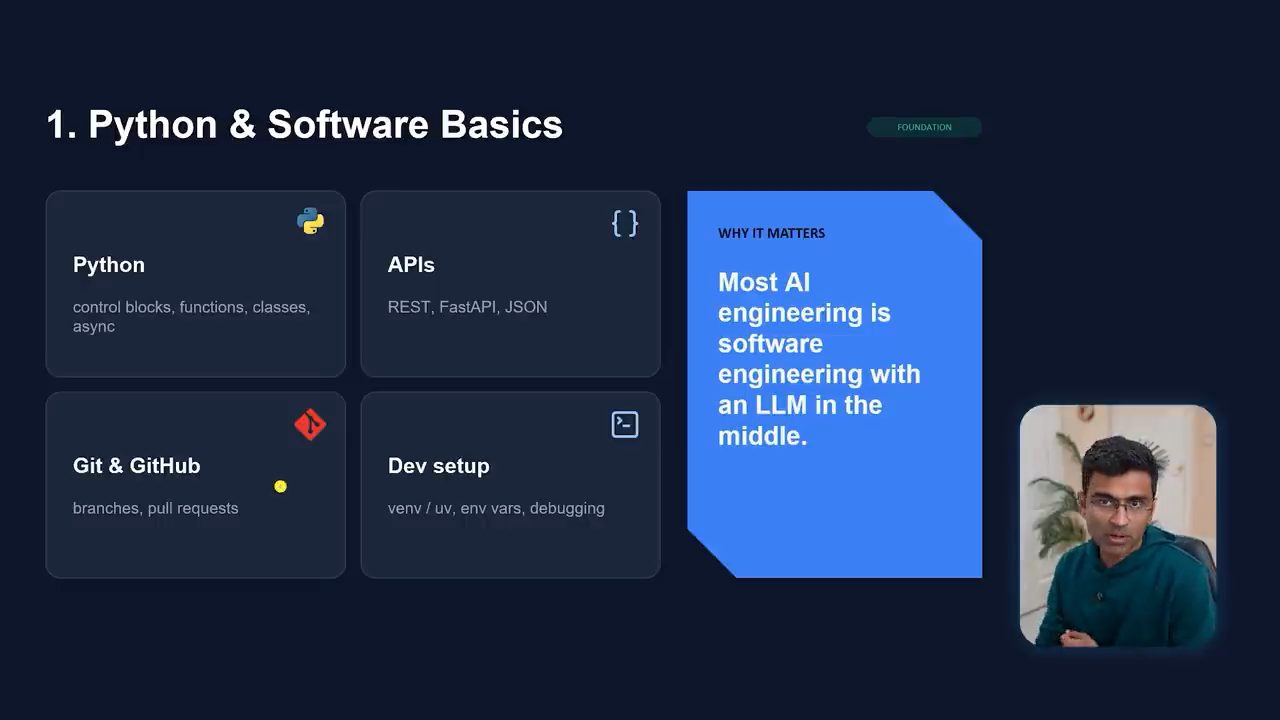
Skill đầu tiên là Python và software basics. Theo anh (video đăng ngày 16/11/2026), phần lớn AI engineering là software engineering với một LLM ở giữa: nói chuyện với bất kỳ engineer nào, bạn sẽ thấy họ cũng làm rất nhiều việc software engineering. Và Python là ngôn ngữ của AI.
Ở đây, theo Dhaval (video đăng ngày 16/11/2026), bạn cần biết control block, function, class, asyncio, tức những khái niệm thiết yếu để build một ứng dụng AI bằng Python. Ngoài ra, bạn nên biết API basics: REST protocol là gì; FastAPI là thứ dùng để build web server bằng Python, và AI backend của bạn nhiều khả năng sẽ là một backend FastAPI, nên bạn nên biết nó; rồi JSON, v.v. Git và GitHub là thiết yếu để quản lý version của code. Tiếp theo là dev setup: anh nói UV là một Python package manager phổ biến mà mọi người dùng. Rồi bạn cần biết cơ bản về debugging, v.v.
2. AI viết code rồi, sao vẫn cần học code?
Dhaval nêu một câu hỏi hay được đặt ra: nếu AI đang viết code, tại sao tôi cần học code? Anh kể trải nghiệm thật của mình (video đăng ngày 16/11/2026). Anh đến gặp một người bạn ở California, là manager ở Apple. Rồi anh gặp CTO của MakeMyTrip, hai người nói chuyện khoảng năm tiếng. Rồi anh gặp các engineer của DeepMind ở văn phòng Google tại New York. Và có một chủ đề chung xuất hiện trong tất cả các cuộc trò chuyện.
Chủ đề đó, theo anh (video đăng ngày 16/11/2026), là: code do AI viết, nhưng việc validation, deployment và verification do các human engineer làm. Vẫn có human in the loop. Không phải AI viết code, deploy nó và làm mọi thứ end to end. Nếu con người ở trong loop thì human engineer đó cần biết cách validate code, và bạn không thể làm việc đó nếu không có nền tảng vững.
Vậy nên, theo Dhaval (video đăng ngày 16/11/2026), học Python và các skill software engineering là bạn đang xây nền tảng để verify, validate và architect code do AI viết. Theo anh, bạn không cần bỏ ra sáu tháng để học Python. Đó là skill số 1.
3. Skill số 2: LLM fundamentals
Skill thứ hai là LLM fundamentals. Theo Dhaval (video đăng ngày 16/11/2026), ngày nay nếu bạn vào bất kỳ job portal nào và xem phần lớn các tin tuyển AI engineer, thì 80% trong số đó là GenAI engineer. Ngoài generative AI còn có AI truyền thống: classical ML, deep ML, v.v. Nhưng anh nói cả thế giới đang phát cuồng vì GenAI, nên phần lớn job nằm ở nhóm GenAI, và các skill trong video được thiết kế theo nhu cầu đó của ngành.
Tại sao nên biết LLM fundamentals cho tốt? Theo anh (video đăng ngày 16/11/2026), vì bạn cần biết model hành xử thế nào trước khi build trên nó. Nhiều engineer đang build các feature AI thực ra là integration engineer, họ chỉ là integrator: bạn có một phần mềm, gọi LLM API, nhận response về và build phần mềm, rồi build feature AI nào đó trong phần mềm ấy. Nhưng bạn cần biết model LLM hành xử ra sao, cần truyền parameter nào: temperature là một parameter, rồi có top-p, top-k, có context window. Anh nói bạn nên biết hết những thứ này; không biết thì bạn sẽ đoán mò.
Vì thế, theo Dhaval (video đăng ngày 16/11/2026), bạn nên biết tokens và context basics, cả pricing nữa. Nếu không biết fundamentals mà cứ gọi LLM API như vậy thì cost sẽ tăng. Bạn không chỉ build một giải pháp chạy được, bạn build một giải pháp tối ưu cost, cho latency tốt hơn, v.v.
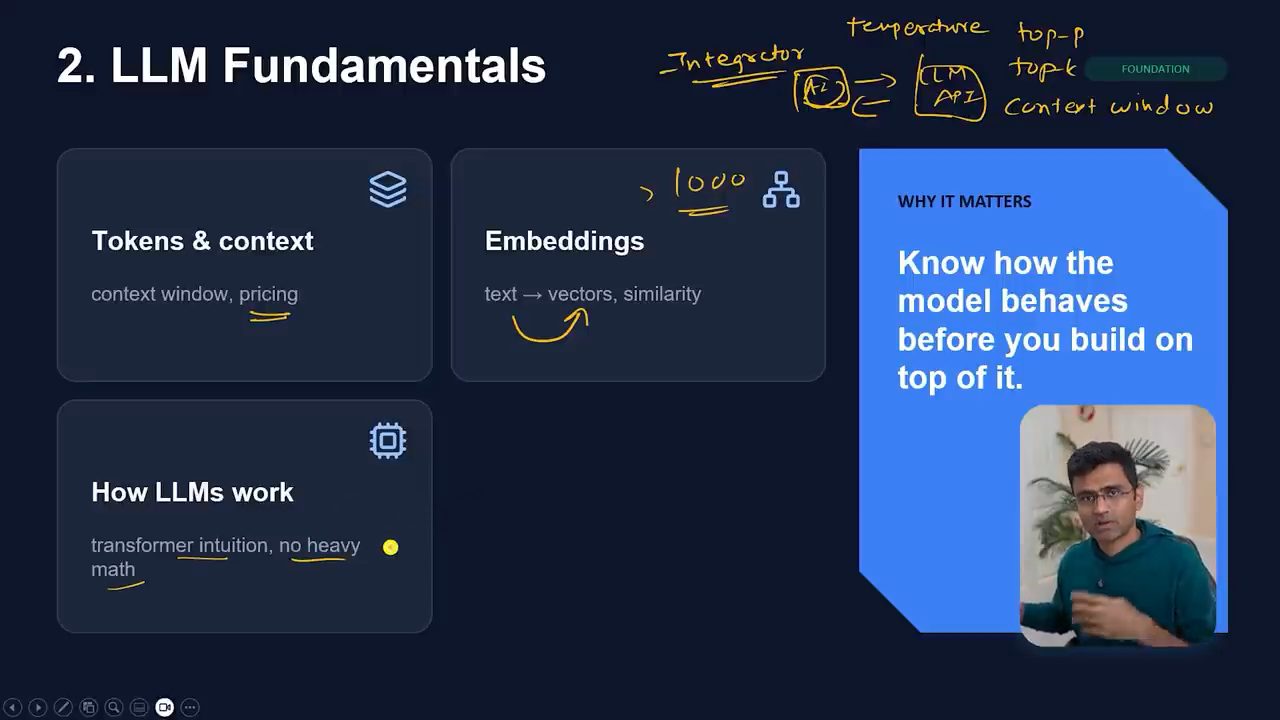
Bạn cũng nên biết embeddings, tức cách chuyển text thành vector. Theo anh (video đăng ngày 16/11/2026), có hơn một nghìn embedding model, bạn nên biết chọn cái nào, và bạn không thể làm vậy nếu không hiểu tốt embedding hoạt động thế nào, cách so sánh các embedding khác nhau: ví dụ Hugging Face có MTEB leaderboard. Làm sao chọn đúng embedding model cho nhu cầu của bạn? Theo anh, bạn chỉ phát triển được judgment đó nếu đã học hết các fundamentals này.
Rồi, theo Dhaval (video đăng ngày 16/11/2026), bạn nên biết nói chung LLM hoạt động thế nào: autoregressive generation, transformer hoạt động ra sao. Kể cả khi không biết phần toán bên trong, ít nhất bạn nên có transformer intuition.
4. Chọn model: open, closed, Haiku hay Fable
Tiếp theo là model choice. Theo Dhaval (video đăng ngày 16/11/2026), có open model và closed model. Closed model là OpenAI, Anthropic, nơi bạn trả tiền. Open model là Kimi K3, rồi Gemma của Google, rồi Mistral: các công ty này cung cấp open-weight model mà bạn có thể dùng miễn phí, dĩ nhiên bạn vẫn phải trả chi phí hosting, v.v. Nếu biết LLM fundamentals, bạn sẽ phát triển được judgment về lúc nào gọi model nào.
Ngay trong một hãng cũng có nhiều model, theo anh (video đăng ngày 16/11/2026): có Haiku, có Opus, có Fable. Anh nói Fable là model mạnh nhất. Bạn có gọi Fable cho mọi việc không? Không. Với các task ít phức tạp, bạn dùng Haiku; với task rất phức tạp, cần mức reasoning cao, bạn dùng Fable. Và bạn xây được judgment đó khi đã biết skill số 2, LLM fundamentals.
5. Skill số 3: context engineering
Skill thứ ba là context engineering. Theo Dhaval (video đăng ngày 16/11/2026), context engineering không gì khác hơn là đưa cho LLM đúng thông tin, đúng format, đúng lúc. Slide ghi: "Giving the LLM the right information, in the right format, at the right time."
Nghĩa là gì? Anh lấy RAG làm ví dụ (video đăng ngày 16/11/2026). LLM được train trên một lượng lớn dữ liệu internet. Dhaval là co-founder của một công ty tên AtliQ. Giả sử anh build một chatbot cho bộ phận HR để trả lời các câu hỏi về chính sách nội bộ của AtliQ; khi đó anh phải trỏ toàn bộ dữ liệu private này tới LLM để khi có câu hỏi, nó tạo được câu trả lời. Anh nói hình này trông đơn giản, nhưng RAG sẽ là skill kế tiếp; ở đây, về bản chất, bạn đưa cho LLM đúng thông tin nó cần, đúng format.
Theo anh (video đăng ngày 16/11/2026), tài liệu và knowledge là một phần. Phần khác là rules và instructions, gồm system prompt và các few-shot example bạn đưa vào. Rồi nếu bạn gọi API, trỏ LLM tới database, tới tài liệu PDF hay Word, tất cả những thứ đó cho LLM đủ context để tạo câu trả lời. Có thể là memory: khi đang trò chuyện thì có short-term memory từ cuộc trò chuyện này, và long-term memory từ mọi cuộc trò chuyện trước đó. Rồi conversation history, user request.
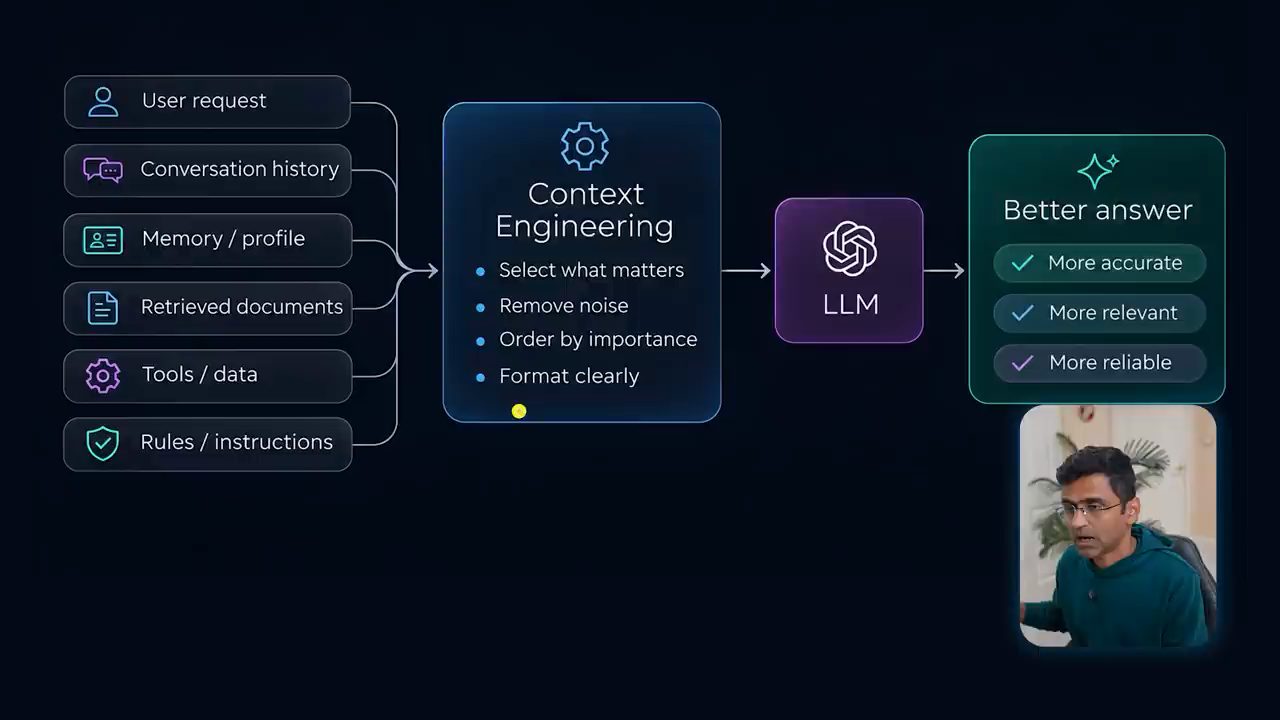
Vậy trong context engineering, theo Dhaval (video đăng ngày 16/11/2026), bạn xác định cần những nguồn dữ liệu nào cho nhu cầu AI của mình, rồi lấy đúng context từ đó ra. Lượng dữ liệu của bạn có thể là, ví dụ, 10 terabyte. Ở công ty codebasics của anh có hơn 10 terabyte dữ liệu, gồm mọi social media asset, database, mọi thứ. Bạn sẽ không kéo hết 10 terabyte đó đưa cho "LLM tội nghiệp" rồi bảo "này LLM, tạo câu trả lời đi". Bạn phải retrieve đúng lượng thông tin, và kể cả lượng đúng đó cũng có thể vẫn quá nhiều, nên có thể bạn cần thu nhỏ, nén nó lại. Bạn chọn thứ quan trọng, bỏ noise, sắp theo mức quan trọng, format rõ ràng, rồi đưa cho LLM. Đó là context engineering, và anh đưa ra slide về lợi ích của nó: "Same model + better context = far better answers."
Theo anh (video đăng ngày 16/11/2026), fundamentals của context engineering áp dụng cả khi làm việc với con người. Giả sử bạn làm việc với một đồng nghiệp: nếu bạn không đưa đúng thông tin hay đúng context cho câu hỏi của mình, có lẽ họ sẽ đưa bạn câu trả lời sai, dù họ có thể siêu thông minh, thông minh cỡ IIT, cỡ Stanford. Context quan trọng. Ở đây bạn có system prompt, rules, few-shot example, đúng tài liệu, tool và memory. Rồi window management: bạn trim, summarize, sắp thứ tự và kiểm soát cost.
6. Skill số 4: retrieval-augmented generation (RAG)
Skill tiếp theo là retrieval-augmented generation. Dhaval cầm một con Baby Yoda lên và nói ngay cả Baby Yoda của anh cũng đồng ý: nó đang trao cho bạn mọi siêu năng lực và lời chúc. Theo anh (video đăng ngày 16/11/2026), RAG là skill số một của mọi AI engineer, vì ở chính công ty AtliQ của anh, hơn 50% project là RAG project ("thấy chưa, nó đang đồng ý", anh nói về Baby Yoda). Nên anh coi đây là skill quan trọng nhất với mọi engineer.
Theo Dhaval (video đăng ngày 16/11/2026), retrieval-augmented generation nghĩa là: bạn có một LLM được train trên dữ liệu public, giờ bạn muốn build giải pháp AI làm việc trên dữ liệu LLM chưa thấy. Dữ liệu này có thể là PDF, bảng, bản scan. Bạn cần chunk chúng, lưu vào vector database bằng embedding. Nên ở đây bạn cần kiến thức về embedding và vector database như Qdrant, pgvector, Pinecone, Chroma, có rất nhiều loại. Rồi bạn retrieve bằng hybrid search và rerank.
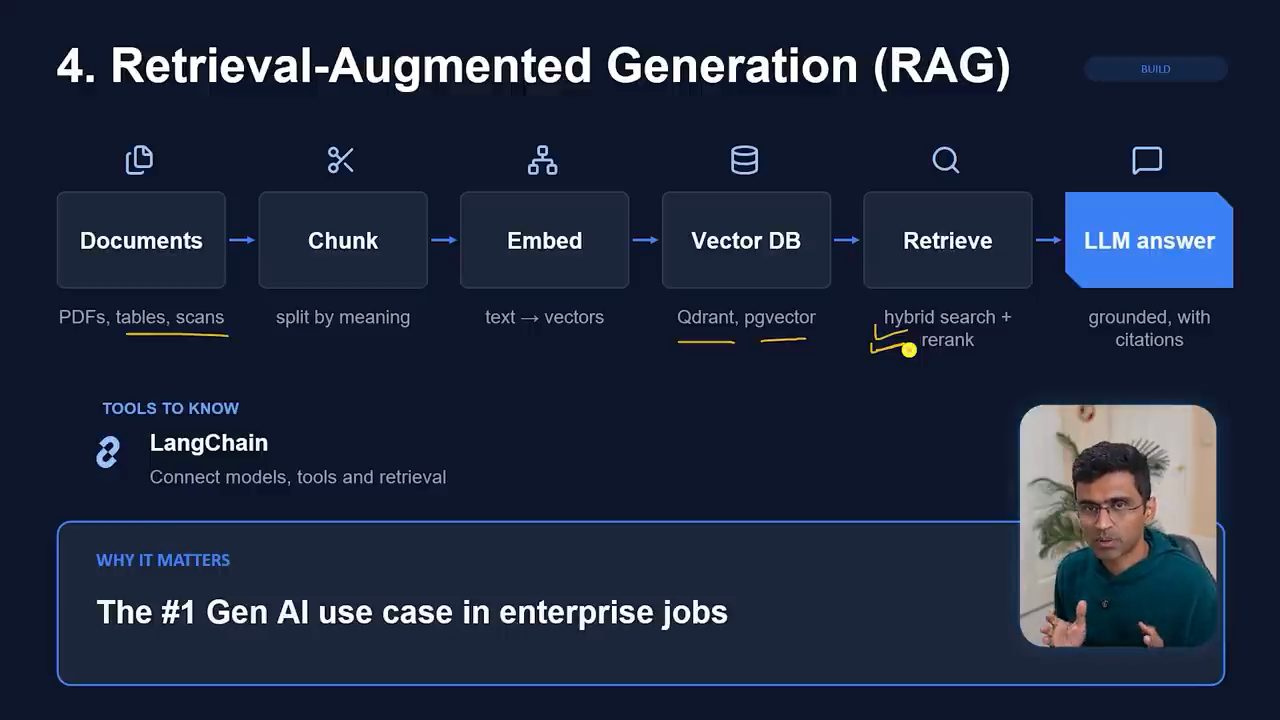
Ở AtliQ, theo anh (video đăng ngày 16/11/2026), trong một project cho khách hàng, nhóm của anh dùng một kỹ thuật hybrid re-ranking và hybrid retrieval, vì fixed-size chunking và các phương pháp đã có khác không chạy tốt với nhóm. Nên là một AI engineer, bạn cần có loại skill engineering và system như vậy: nhìn vào vấn đề và engineer ra giải pháp chạy được cho khách hàng. Anh nói đây là use case GenAI số một trong các job enterprise.
Về tool, theo Dhaval (video đăng ngày 16/11/2026), phần lớn thời gian mọi người dùng LangChain; anh nói LangChain là phổ biến nhất, hoặc mọi người implement bằng Python thuần. Cũng có các tool khác. Anh cho xem một tấm ảnh team AI engineering của mình đang trò chuyện, và nói khi team build project thì phần lớn các project đó là RAG project.
7. Hybrid project: OCR, regex, classical ML và LLM
Team của anh cũng thiết kế giải pháp hybrid. Theo Dhaval (video đăng ngày 16/11/2026), khi nhìn vào bất kỳ project thực tế nào, không phải bạn dùng một model duy nhất là xong; bạn phải dùng cách tiếp cận hybrid. Với một khách hàng ở Arizona, Mỹ, nhóm anh có use case trích xuất dữ liệu từ ảnh: nhóm nhận một loạt ảnh, với một nhóm ảnh thì dùng optical character recognition (OCR) để trích text, rồi từ text dùng regular expression để lấy thông tin cần. Có những ảnh không chạy tốt với OCR; với chúng, nhóm dùng vision model. Đó là một project về ảnh.
Project khác, theo anh (video đăng ngày 16/11/2026), là phân loại một lượng log rất lớn. Ban đầu nhóm dùng LLM, chạy ổn, nhưng cost cứ tăng. Nên với một nhóm log, anh nói "I think" là hơn 50%, rồi nói lại: hơn 50% log, nhóm dùng regex, vì các log đó có pattern cố định nên trích được thông tin cần. Rồi với khoảng 30% còn lại, nhóm dùng classical ML với một kiểu classification, ví dụ XGBoost. Và chỉ phần use case nhỏ còn lại mới dùng LLM. Trên bảng viết tay của anh ghi ba nhánh 60%, 30%, 10%.
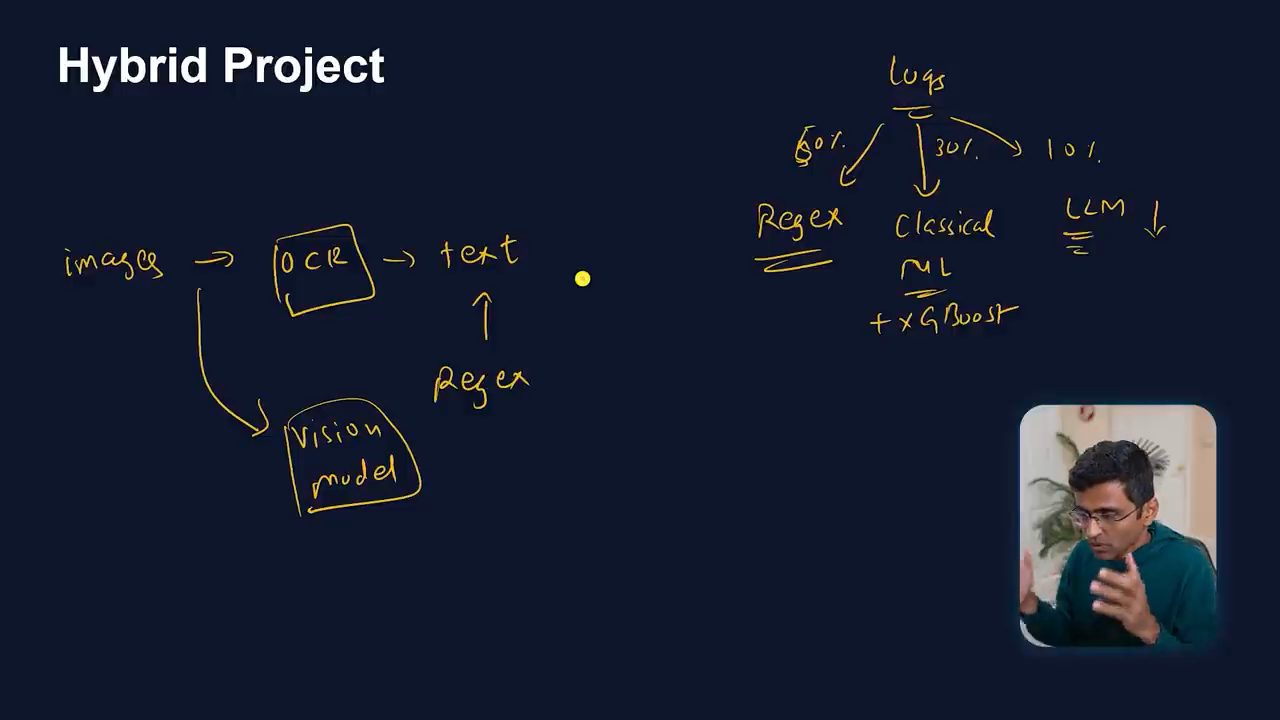
Như vậy, theo Dhaval (video đăng ngày 16/11/2026), nhóm giảm cost LLM được một tỉ lệ rất lớn, và không chỉ thế, còn có explainability tốt hơn, latency tốt hơn, v.v. Team engineering ở công ty anh biết tất cả các cách tiếp cận này: regex, classical ML, LLM, OCR, và hơn thế, họ biết khi nào dùng cái nào. Anh ví như một thợ sửa chữa lành nghề có đủ loại dụng cụ, búa, cờ lê: bảo họ đóng đinh vào tường thì họ dùng búa, bảo họ siết bu-lông bánh xe ô tô thì họ dùng cờ lê. Bạn biết nhiều tool khác nhau và có judgment về lúc nào dùng tool nào.
8. Skill số 5: AI agents, tool use và MCP
Skill tiếp theo là agents. Theo Dhaval (video đăng ngày 16/11/2026), hiển nhiên cả thế giới đang phát cuồng vì agent, nhưng thực tế là, tính tới lúc quay video, ít nhất ở công ty của anh, AtliQ, một công ty tư vấn AI đã làm project AI cho khách hàng hơn ba năm, nhóm không thấy nhiều project agentic. Nhưng agent vẫn có một lời hứa nổi bật và rất nhiều tiền đang được chi vào đó, nên anh nói bạn chắc chắn nên biết các skill agentic.
Theo anh (video đăng ngày 16/11/2026), agent về cơ bản là một chương trình dùng LLM làm bộ não. Nó nhận một goal, làm reasoning, reasoning nhiều bước, planning nhiều bước, gọi tool, database, v.v. và thực hiện một action. Rồi nó quan sát kết quả, có một vòng feedback: nếu mọi thứ không chạy đúng yêu cầu, nó plan lại, gọi tool, thực hiện action. Đó gọi là agentic loop, chạy tới khi có final answer. Và chuyện này không chỉ liên quan tới chatbot: khi anh nói final answer, đó có thể là các agentic action như đặt vé máy bay hay thực hiện giao dịch tài chính.
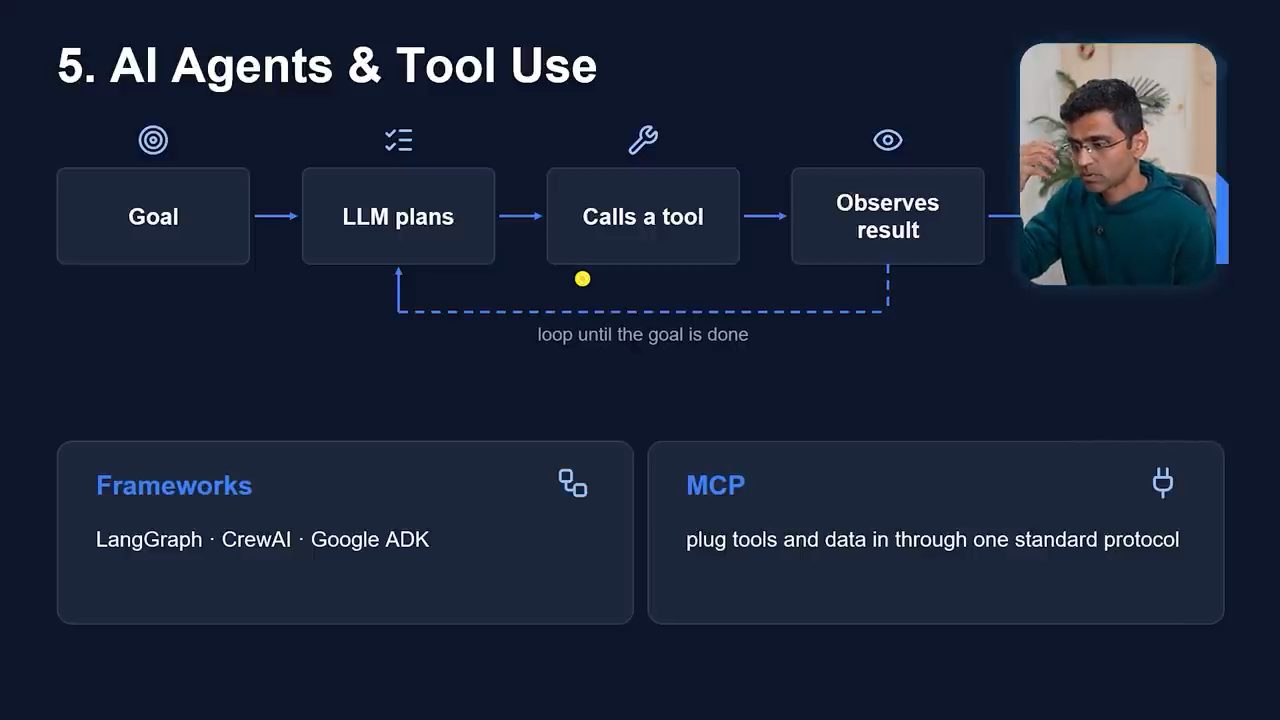
Về framework, theo Dhaval (video đăng ngày 16/11/2026), có LangGraph, CrewAI, Google ADK. Và anh nói MCP đang rất hot: mọi công ty cung cấp tool đều đang ra MCP server riêng. Nên bạn cần biết cách gọi các MCP server đó như tool; một MCP server có thể là một trong các tool call của agent. Là một AI engineer, bạn cũng có thể tự tạo MCP server của mình.
9. Skill số 6: evals và observability
Skill tiếp theo là evals và observability. Tại sao quan trọng? Theo Dhaval (video đăng ngày 16/11/2026), demo thì dễ, chứng minh nó chạy được mới là việc thật. Bạn có thể tạo một prototype nhỏ chạy trên một tập dữ liệu nhỏ, trông rất đẹp; nhưng chuyện gì xảy ra khi bạn deploy nó cho 100.000 user ở quy mô lớn? Nó có chạy không? Có hallucinate không? Có trả lời sai không? Có làm hỏng giá trị thương hiệu công ty bạn không? Cho tất cả những điều đó, bạn cần evals và observability.
Theo anh (video đăng ngày 16/11/2026), đánh giá một hệ thống AI là khó, không giống đánh giá phần mềm. Đánh giá phần mềm dựa trên một bộ test case cố định và có tính deterministic: nếu test pass thì khi deploy lên production nó sẽ chạy. Còn hệ thống AI có tính probabilistic: khi test ở development nó có thể chạy, nhưng ở production thì bạn không biết.
Có các kỹ thuật để eval hệ thống AI, theo Dhaval (video đăng ngày 16/11/2026). Bạn cần tạo một golden dataset với câu hỏi thật và câu trả lời mong đợi, rồi dùng các cách như cosine similarity để đo mức giống nhau giữa câu trả lời được tạo ra và câu trả lời bạn mong đợi, vì chúng sẽ không giống nhau từng chữ. Bạn cũng có thể dùng LLM as a judge: LLM có thể nói "đúng, câu trả lời này tốt theo golden dataset tôi có". Với RAG thì có các metric như faithfulness, relevance. Để tracing, bạn dùng LangSmith, Langfuse; bạn cũng dùng Ragas, một framework khác dùng cho eval. Anh nói evals cực kỳ quan trọng, nó có thể quyết định thành bại của giải pháp AI.
10. Skill số 7: deployment và LLMOps
Skill thứ bảy là deployment và LLMOps. Theo Dhaval (video đăng ngày 16/11/2026), nếu không được deploy lên production thì nó không tính, demo có hoành tráng cỡ nào cũng vậy. Nó đã được deploy chưa? Anh hỏi những ai đã làm một feature AI: bạn đã deploy nó chưa, user và khách hàng của bạn có đang dùng nó không? Chỉ khi đó nó mới tính; nếu không thì đó chỉ là thử nghiệm, R&D, và theo anh, từ đúng hơn là một kiểu phí tiền.
Khi deploy một giải pháp, theo anh (video đăng ngày 16/11/2026), bạn cần những thứ như Docker để đóng gói ứng dụng. Bạn cần deploy nó lên cloud: Azure, Vertex, Bedrock, Google, cloud nào cũng được. Rồi CI/CD cho continuous integration và continuous deployment. Giả sử bạn build một giải pháp, đã deploy, user đang dùng, giờ bạn sửa một chút: bạn có test lại mọi thứ không? Không, bạn sẽ có test case trong Jenkins pipeline; anh nói Jenkins là tool mọi người dùng cho CI/CD, và nó nên tự động test mọi thứ.
Làm hết những việc đó, theo Dhaval (video đăng ngày 16/11/2026), bạn có monitoring dashboard, observability dashboard, có thể là LangSmith, có thể là dashboard tự build, gì cũng được. Các dashboard này cho bạn biết về cost. Anh đưa ví dụ: giải pháp của bạn chạy được, nhưng bạn nhận hoá đơn từ OpenAI 100.000 đô một tháng, trong khi chỉ tạo ra 80.000 đô doanh thu một tháng; vậy feature AI hoành tráng đó có ý nghĩa gì? Nên cost rất quan trọng, rồi rate limit, caching, tất cả những thứ đó. Nó có đang hallucinate không? Bạn cần lấy feedback thumbs up, thumbs down, và cần thiết kế giao diện người dùng phù hợp cho giải pháp. Đó là deployment và LLMOps.
11. Skill số 8: guardrails và AI security
Skill tiếp theo là guardrails và AI security. Tại sao quan trọng? Theo Dhaval (video đăng ngày 16/11/2026), mọi khách hàng enterprise sẽ hỏi bạn chuyện này trước khi go live. Thực tế, mỗi khi có buổi họp với khách hàng ở AtliQ, câu hỏi đầu tiên họ hỏi là: còn bảo mật dữ liệu của tôi thì sao? Ai cũng lo về bảo mật dữ liệu của mình.
Anh kể (video đăng ngày 16/11/2026): nhóm từng có vài khách hàng ở Dubai với yêu cầu data residency nghiêm ngặt. Data residency nghĩa là họ dùng Azure thì được, nhưng server Azure nên đặt ở region Dubai. Rồi có một khách hàng ở Qatar không muốn dùng cloud nào cả, họ muốn deploy on-premise. Ở đây bạn đang nói về local AI: bạn phải lấy các model như Gemma, Kimi K3, Qwen, deploy và làm cho chúng chạy trên hạ tầng local của khách. Lúc đó, theo anh, bạn cũng đang đóng vai một cloud engineer, hoặc có thể bạn có một team riêng lo cloud engineering.
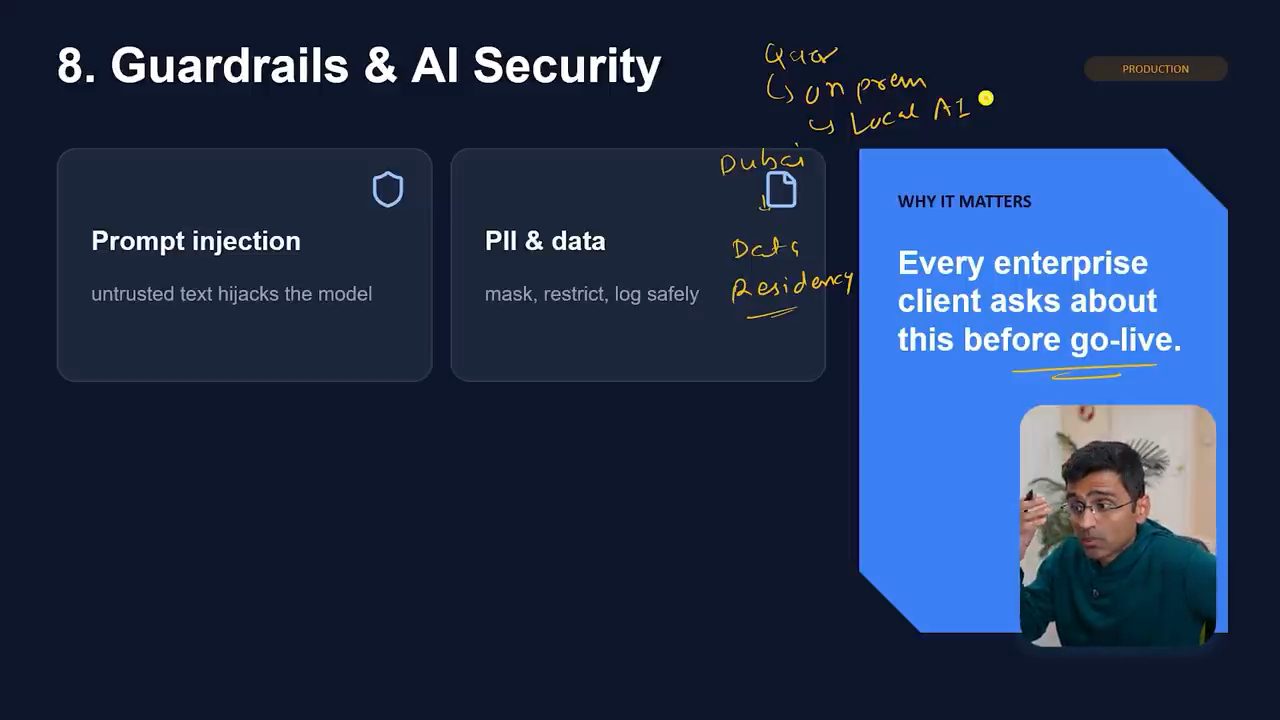
Với guardrails và AI security, theo Dhaval (video đăng ngày 16/11/2026), bạn phải lo prompt injection: giống như có SQL injection thì có prompt injection. Rồi PII và dữ liệu: bạn không muốn làm lộ personally identifiable information, nên bạn có thể mask hết những thông tin đó. Anh nói Microsoft có một thư viện tên Presidio giúp việc masking, và trong LangChain cùng nhiều framework khác cũng có thư viện giúp mask dữ liệu PII. Cả log nữa: có người ghi vào application log, nhưng log có thể chứa số an sinh xã hội hay các con số khác của khách hàng, và khi đó bạn không tuân thủ PII; nếu có kiểm toán của chính phủ, bạn có thể bị phạt nặng.
Theo anh (video đăng ngày 16/11/2026), ở châu Âu đặc biệt các luật này rất nghiêm: họ có thứ anh gọi là "EU Act for AI", rồi GDPR và các quy định khác. Tương tự, Ấn Độ, Mỹ, nước nào cũng có luật bạn cần tuân thủ. Bạn cũng cần access control, có thể làm bằng role-based access control, nên anh nói bạn nên biết role-based access control là gì.
Ví dụ về prompt injection mà Dhaval đưa ra (video đăng ngày 16/11/2026): một người "mua" chiếc Chevy Tahoe, một chiếc xe giá 60.000 đô, với giá 1 đô. Anh nói người đó không mua thật, nhưng đã khiến chatbot của đại lý đồng ý với thoả thuận 1 đô.
12. Skill số 9: fine-tuning
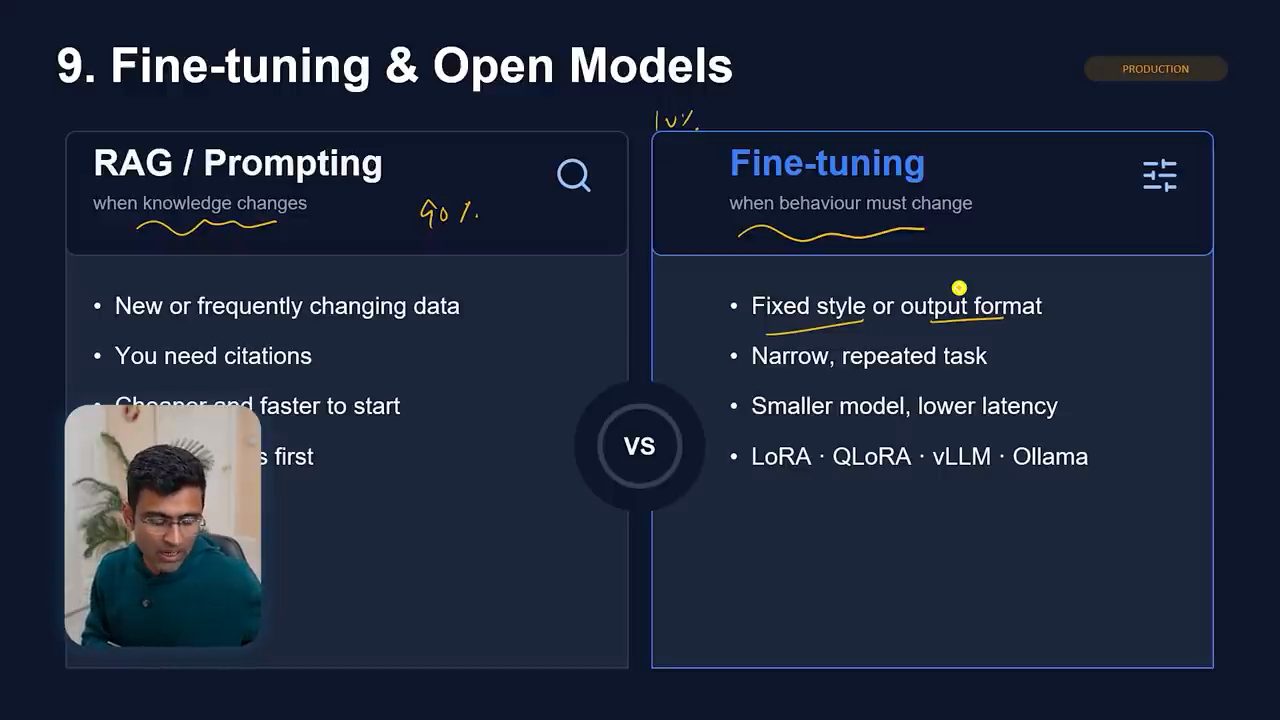
Skill tiếp theo là fine-tuning. Dhaval nói nhiều người hỏi anh: có cần học fine-tuning không? Theo anh (video đăng ngày 16/11/2026), fine-tuning là một use case rất cụ thể. Trong phần lớn trường hợp, mọi người dùng RAG: bạn dùng RAG khi knowledge thay đổi, và 80%, 90% trường hợp thì RAG là đủ. Nhưng trong 10% trường hợp, bạn phải fine-tune, khi behavior phải thay đổi, nghĩa là bạn muốn câu trả lời theo một style và output format cố định.
Ví dụ của anh (video đăng ngày 16/11/2026): công ty bạn có yêu cầu rất riêng theo domain, theo thương hiệu, về cách tạo câu trả lời, và các LLM vốn được train trên dữ liệu public, giả sử, không làm được điều đó. Khi ấy bạn lấy một LLM có sẵn, một bộ não đã được train, rồi fine-tune trên dataset riêng của bạn, và bạn có một fine-tuned model. Ở đây bạn có thể dùng các kỹ thuật như LoRA, QLoRA, và anh nói tới một thư viện dùng cho fine-tuning.
13. Skill số 10: system design và product sense
Skill thứ mười, theo Dhaval (video đăng ngày 16/11/2026), "I believe" là nặng nhất và quan trọng nhất: system design và product sense. Tại sao quan trọng? Anh nói code thì rẻ; skill thật hôm nay là biết build cái gì và deploy nó cho hàng nghìn user theo cách scalable và tiết kiệm cost. Anh có thể gọi Fable cho mọi request và deploy cho hàng nghìn user, nó sẽ chạy, nhưng hoá đơn từ Anthropic sẽ làm công ty anh phá sản. Nên bạn cần tiết kiệm cost, scalable, reliable, và deploy được cho hàng nghìn user.
Và điều đầu tiên là biết build cái gì. Theo anh (video đăng ngày 16/11/2026), ở đây bạn cần một chút product management, một chút soft skill, một chút business skill. Về system design, bạn sẽ phải hiểu cách lấy một business problem và chuyển nó thành kiến trúc LLM. Rồi product sense: chọn những vấn đề đáng giải. Khách hàng sẽ đến và nói "tôi cần giải pháp này", nhưng đừng đồng ý với họ; bạn phải hỏi kỹ, và sau khi hỏi kỹ, bạn nhận ra bạn không cần giải pháp này mà cần giải pháp kia. Rồi ROI thinking: là AI engineer, bạn nên nghĩ về return on investment cho mọi project. Giả sử bạn chi một khoản x cho project; lợi ích về tăng doanh thu, giảm chi phí, mức hài lòng của khách hàng nên đủ để cho ra ROI cao.
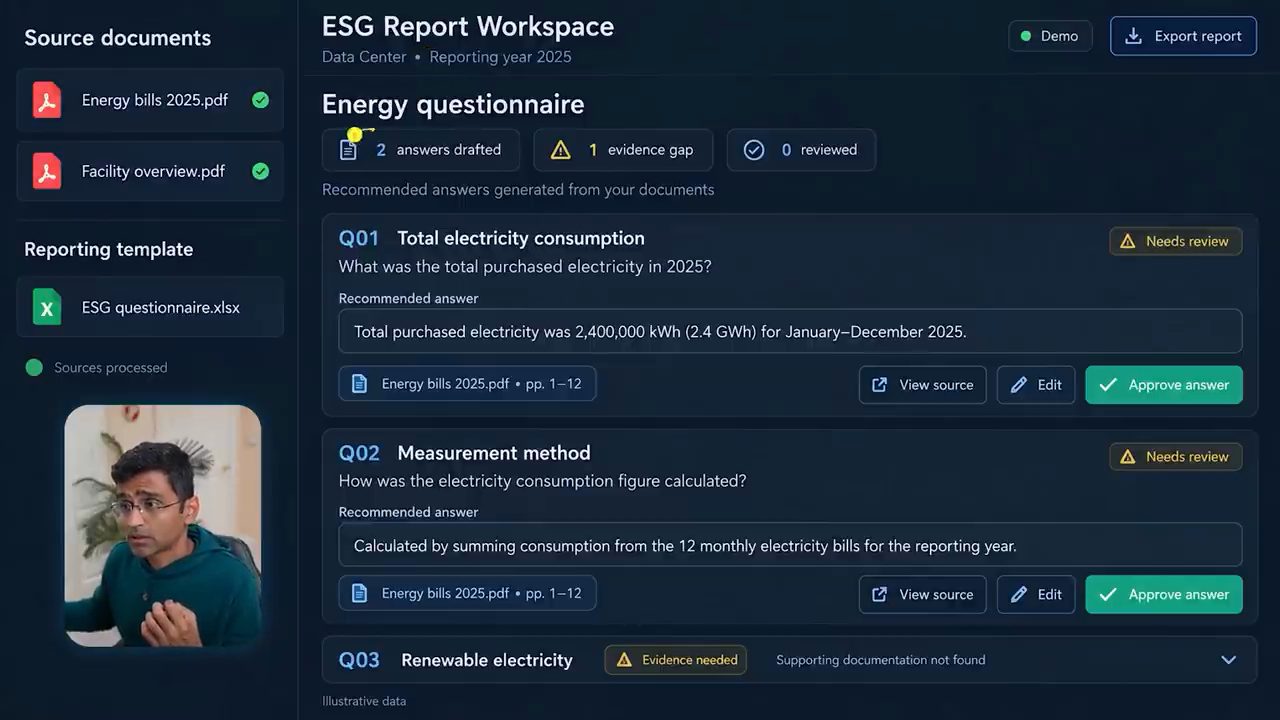
Dhaval kể một project của AtliQ để minh hoạ cách xây product sense (video đăng ngày 16/11/2026). Khách hàng là một công ty tư vấn ESG; anh giải thích ESG là "environmental and social governance". Công ty này giúp khách hàng của họ nộp báo cáo ESG cho chính phủ, giống như bạn tìm tới kế toán khi khai thuế. Ban đầu họ nói muốn build một RAG chatbot: trong chatbot đó họ đính kèm mọi hoá đơn năng lượng của khách hàng, bản facility overview, bảng câu hỏi ESG, rồi đặt câu hỏi, chatbot trả lời, và dùng các câu trả lời đó để nộp báo cáo, giống như khai thuế theo mẫu của chính phủ.
Nhưng, theo anh (video đăng ngày 16/11/2026), nhóm không build giải pháp một cách ngẫu hứng. Nhóm hỏi kỹ, điều tra trước khi nhảy vào công nghệ, hiểu sâu hơn về business của khách, rồi đề xuất một giải pháp khác không phải RAG chatbot: một answer extraction system. Ở đó có bản báo cáo bạn cần nộp, giống mẫu khai thuế của chính phủ, với tất cả các câu hỏi; hệ thống tự trích câu trả lời kèm reference, bạn bấm xem nguồn, kiểm câu trả lời đúng chưa, sai thì sửa, rồi approve. Anh ví như TurboTax tự điền mọi trường khi bạn khai thuế. Từ RAG, nhóm chuyển sang answer extraction system, và anh nói điều đó xảy ra vì team có product sense: chọn vấn đề đáng giải và dùng đúng design skill để ánh xạ business problem thành một giải pháp AI tối ưu.
14. Từ prototype tới system design, và human in the loop
Theo Dhaval (video đăng ngày 16/11/2026), một prototype có thể là một kiến trúc đơn giản như vậy, còn để deploy cho hàng nghìn, hàng nghìn user thì cần một system design hoàn chỉnh. Với ví dụ một chatbot, nếu muốn deploy cho hàng nghìn user thì system diagram thật có thể trông như thế này: có API gateway, rate limiting, authentication, guardrails, orchestrator, semantic cache, model gateway.
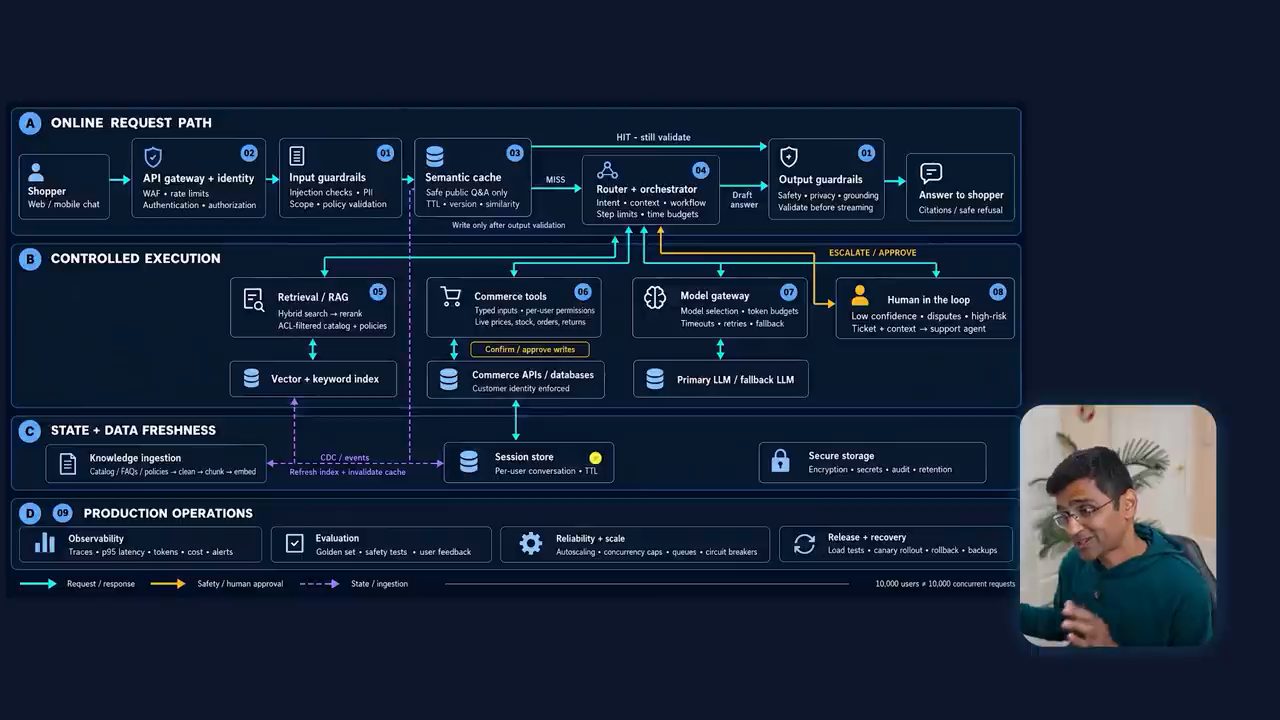
Theo anh (video đăng ngày 16/11/2026), human in the loop rất quan trọng. Anh nói human in the loop không phải việc bạn làm khi LLM bối rối. Với một số vấn đề nhạy cảm, ví dụ bạn build chatbot cho một công ty viễn thông và khách nói "tôi muốn huỷ subscription", bạn có để LLM trả lời câu đó không? Không. Bạn muốn biết vì sao khách muốn huỷ gói; có thể họ cần một người khác, một con người có thể hỏi kỹ, có thể hỗ trợ về cảm xúc; có thể khách đang bực, đang giận, và con người có thể hỗ trợ kiểu đó. Nên trong một số tình huống, dù AI tạo được câu trả lời, bạn cần chuyển lên cho con người, và điều đó nên là một phần trong system design AI của bạn.
Theo Dhaval (video đăng ngày 16/11/2026), các ca cần chuyển cho con người gồm low confidence, dispute như tranh chấp hoá đơn, ticket rủi ro cao, các khoản refund lớn, tất cả những thứ đó. Anh kể tiếp các phần còn lại của sơ đồ: state và data freshness, eval, release, recovery, security, storage.
15. Nên tập trung vào đâu, bonus về communication, và recap
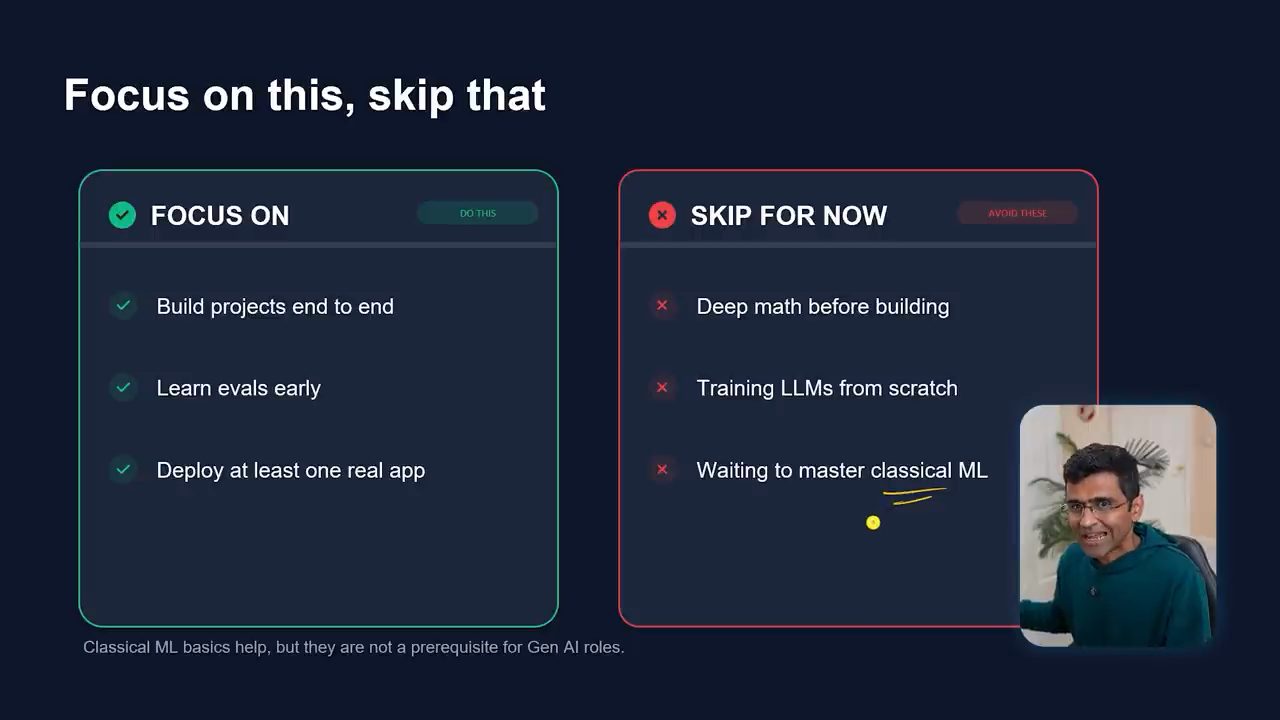
Lời khuyên của Dhaval (video đăng ngày 16/11/2026): tập trung build project end to end, học evals sớm, deploy ít nhất một app thật, nhiều hơn một thì luôn tốt. Bạn có thể tạm bỏ qua phần toán sâu, train LLM từ đầu, và chờ tới khi làm chủ classical ML. Anh nói các engineer khác ở công ty anh cũng biết classical ML, nhưng classical ML được dùng trong một số trường hợp; phần lớn thời gian bạn dùng GenAI, nên học GenAI trước rồi mới học classical ML. Anh không nói bạn không nên học nó, nhưng đó nên là bước hai, trong giai đoạn hai.
Cuối cùng, Dhaval nói thêm một skill anh cho là rất, rất quan trọng, một soft skill: communication và stakeholder management. Theo anh (video đăng ngày 16/11/2026), là AI engineer bạn sẽ làm việc với nhiều stakeholder khác nhau: một người quan tâm tới tiết kiệm cost, người khác quan tâm tới time to market, người thứ ba quan tâm liệu có đạt mục tiêu và thoả mãn nhu cầu user không, rồi có compliance officer lo về security và compliance. Bạn phải quản lý kỳ vọng của tất cả những người này mà không làm tổn thương cái tôi của họ, và việc đó cần communication skill, stakeholder management skill. Bạn nên hiểu tính cách của họ, xây dựng quan hệ, có interpersonal skill để làm việc được với mọi người và đẩy project đi tiếp.
Để recap, anh cho xem bảng tóm tắt các skill (video đăng ngày 16/11/2026): giai đoạn Foundation gồm Python, LLM basics, Prompting, giúp bạn build được "Simple LLM apps and chatbots"; giai đoạn Build gồm RAG, Agents, Evals, cho "Chat-with-docs, AI agents that work"; giai đoạn Production gồm Deploy, Guardrails, Fine-tune, Product, cho "Real apps clients pay for".
Dhaval chúc mọi người mọi điều tốt đẹp, mong video hữu ích, và cảm ơn mọi người đã xem.
Nguồn và liên kết 14 nguồn
- Tên gốc: 10 Skills to Become an AI Engineer
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=5p2fQjFcQ4w youtube.com
- Kênh YouTube codebasics (Dhaval Patel): youtube.com/channel/UCh9nVJoWXmFb7sLApWGcLPQ youtube.com
- MTEB Leaderboard trên Hugging Face, bảng xếp hạng embedding model mà Dhaval nhắc tới (đọc ngày 19/11/2026): huggingface.co/spaces/mteb/leaderboard huggingface.co
- Qdrant, vector database (đọc ngày 19/11/2026): github.com/qdrant/qdrant github.com
- pgvector, "open-source vector similarity search for Postgres" (đọc ngày 19/11/2026): github.com/pgvector/pgvector github.com
- LangGraph (đọc ngày 19/11/2026): github.com/langchain-ai/langgraph github.com
- CrewAI (đọc ngày 19/11/2026): github.com/crewAIInc/crewAI github.com
- Google Agent Development Kit (ADK), tài liệu chính thức (đọc ngày 19/11/2026): google.github.io/adk-docs google.github.io
- Model Context Protocol (MCP), trang chính thức (đọc ngày 19/11/2026): modelcontextprotocol.io modelcontextprotocol.io
- Langfuse (đọc ngày 19/11/2026): github.com/langfuse/langfuse github.com
- Ragas, framework eval cho ứng dụng LLM (đọc ngày 19/11/2026): github.com/vibrantlabsai/ragas github.com
- Presidio, repo mô tả là framework mã nguồn mở để phát hiện, che và ẩn danh dữ liệu nhạy cảm (PII) (đọc ngày 19/11/2026): github.com/data-privacy-stack/presidio github.com
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Khoá Generative AI trọn gói: từ token tới agent, eval và sự nghiệp
Tejas AI · Tejas AI · 36 min
Một lượt đi qua Gen AI: token, embedding, attention, training, sampling, RAG, agent, MCP, fine-tuning, eval, security và lộ trình chín project.
Tín hiệu từ user chết ở ranh giới retrieval
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.