Anthropic tự xây lại Git: đọc kỹ bài về Scion
Theo đọc bài Anthropic về Scion, hệ source control thay Git cho monorepo ở quy mô agent: changeset, cache nhiều tầng, số đo và bài học.
✓ Đã duyệt độc lập · cập nhật 19/10/2026 · 48 min
1. Git, GitHub và những góc cạnh thô ráp
Theo kể rằng từ khi bắt đầu viết code, anh đã dùng Git và GitHub. Vui ở chỗ anh dùng Git trước cả khi biết viết code: hồi đầu cấp ba, anh dùng nó để quản lý plugin cho mấy server Minecraft của mình. Git là phần cốt lõi trong cách anh build và làm việc với phần mềm. Nhưng dạo gần đây anh bắt đầu để ý thấy những góc cạnh thô ráp (rough edges).
Phần lớn cách Git được xây dựng xoay quanh một giả định: code rất đắt, và con người cần review code, approve code, kiểm soát code đi đâu, vì làm mất code hay merge nhầm code từng là chuyện rất tốn kém và đau đớn. Thực tế về cách Git vận hành đã ảnh hưởng tới cả ngành: từ cách ta làm việc với team, cách các sản phẩm như GitHub được xây, cho tới cách ta nghĩ về những thứ lẽ ra phải cơ bản, như quản lý secret. Anh nhắc lại clip viral của mình, trong đó anh nói lẽ ra ta phải được commit biến môi trường (environment variables). Nói nghiêm túc, theo Theo, Git không phải là primitive đúng cho hướng mọi thứ đang đi.
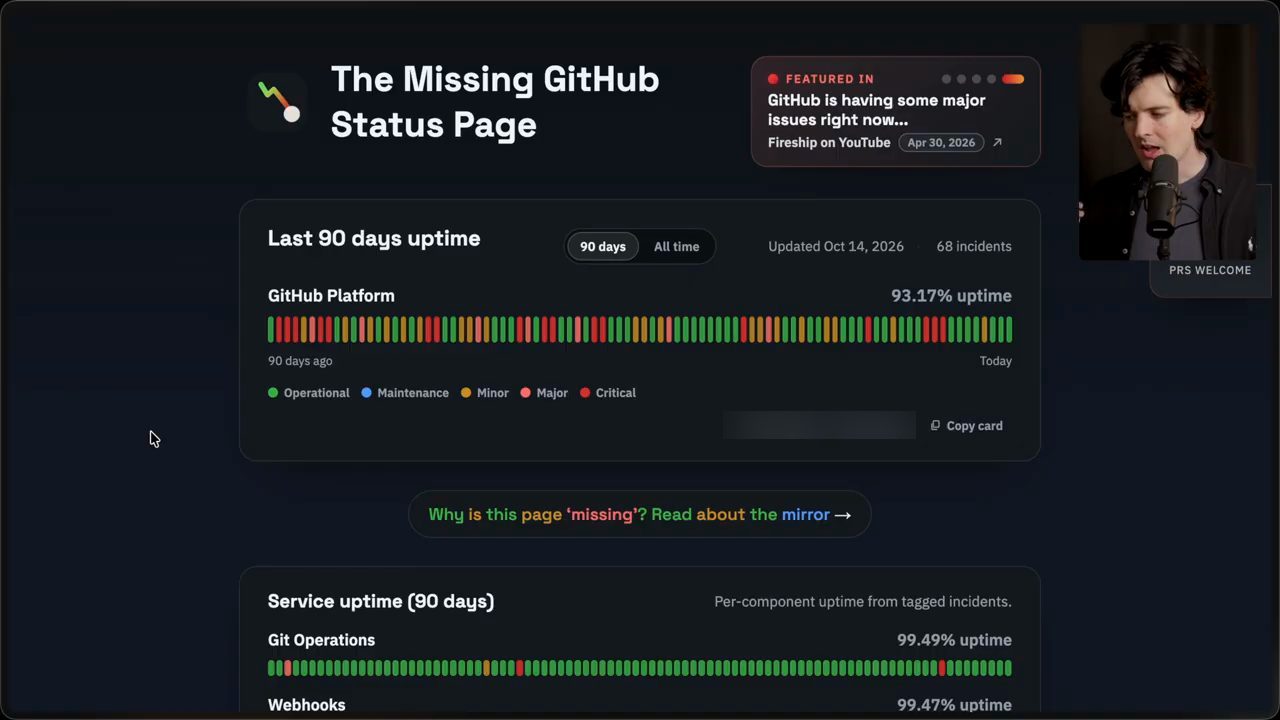
Anh thừa nhận nhiều vấn đề của mình với Git thật ra đến từ GitHub, vì đó là một nền tảng chậm và khổ sở. Theo video đăng ngày 16/10/2026, các ước tính bên ngoài đo được tới khoảng 7% downtime ở các phần khác nhau của GitHub. Anh không đếm nổi bao nhiêu lần release bị chặn vì Actions lỗi, hay không merge được một thay đổi quan trọng vì trang không chịu load. Việc biểu đồ uptime của GitHub trông giống một cây thông Noel hơn là một thanh màu xanh như lẽ ra phải thế, theo anh, đã nói lên tất cả.
Nhưng nếu GitHub không phải vấn đề duy nhất thì sao? Theo cho rằng bản thân Git cũng không phải lời giải đúng khi phải làm việc song song nặng nề giữa rất nhiều người, và còn nhiều agent hơn thế. Anh đã nghĩ về chuyện này rất nhiều: hồi tháng 12, anh tìm hiểu JJ và rất thích nó. Từ đó anh cứ nghĩ mãi: nếu build một thứ mới để ship thật, thật nhanh cùng agent, thì nó sẽ trông như thế nào?
2. Anthropic tự xây hệ thống source control của riêng mình
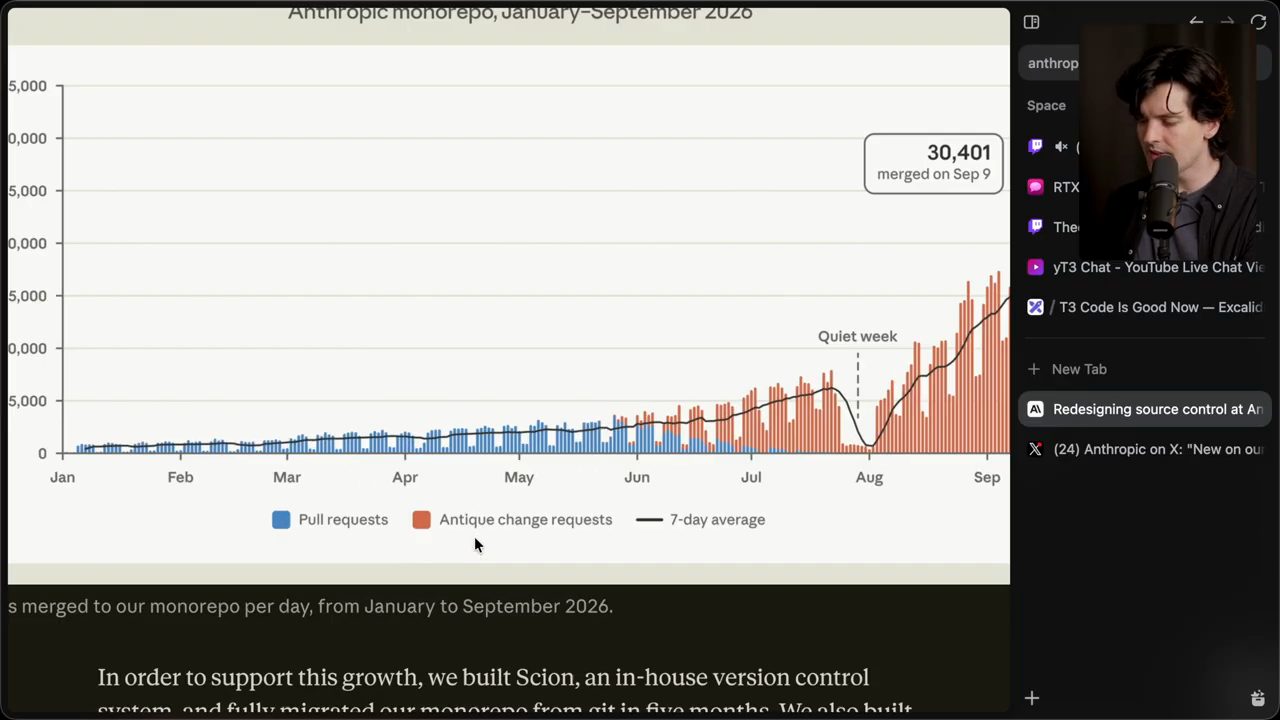
Hoá ra anh không phải người duy nhất nghĩ vậy. Anthropic vừa đăng một bài về hệ thống source control nội bộ mới của họ. Theo bài viết, hồi tháng 5/2026 họ merge khoảng 2.500 thay đổi mỗi ngày; tới tháng 9/2026, con số đã là hơn 30.000 thay đổi được merge mỗi ngày. Họ đang bị nghẽn bởi developer infrastructure vốn được xây cho con người chứ không phải cho agent, và họ quyết định tự xây một thứ của riêng mình.
Theo thấy thật điên rồ khi agent đã đủ thông minh để làm những việc như thế này, nhưng đúng là vậy. Anh rất thích ý tưởng thách thức những nền tảng (fundamentals) trong cách mình build để tạo ra lời giải đúng cho chính mình. Anh đoán đây sẽ là một deep dive rất vui, nhất là khi chính anh cũng đang thay những thứ như TypeScript bằng các bản vibe-code của riêng mình. Dù vậy, anh nói rõ: anh không nghĩ thứ gì cũng nên bị thay bằng một bản vibe-code tự làm.
Rồi anh vào bài. Anh nói mình rất háo hức: ngay khi thấy bài đăng, anh đã muốn đọc, nhưng cố nhịn để dành cho buổi quay này, nên người xem sẽ được nghe phản ứng tự nhiên của anh. Nếu ai thắc mắc vì sao trang trông xấu thế: hễ để nguyên chế độ light mode mặc định của blog là ai cũng la anh, nên anh bật extension Dark Reader để trang không trắng loá, và đây là cái màu "xanh nâu như phân" mà extension chọn.
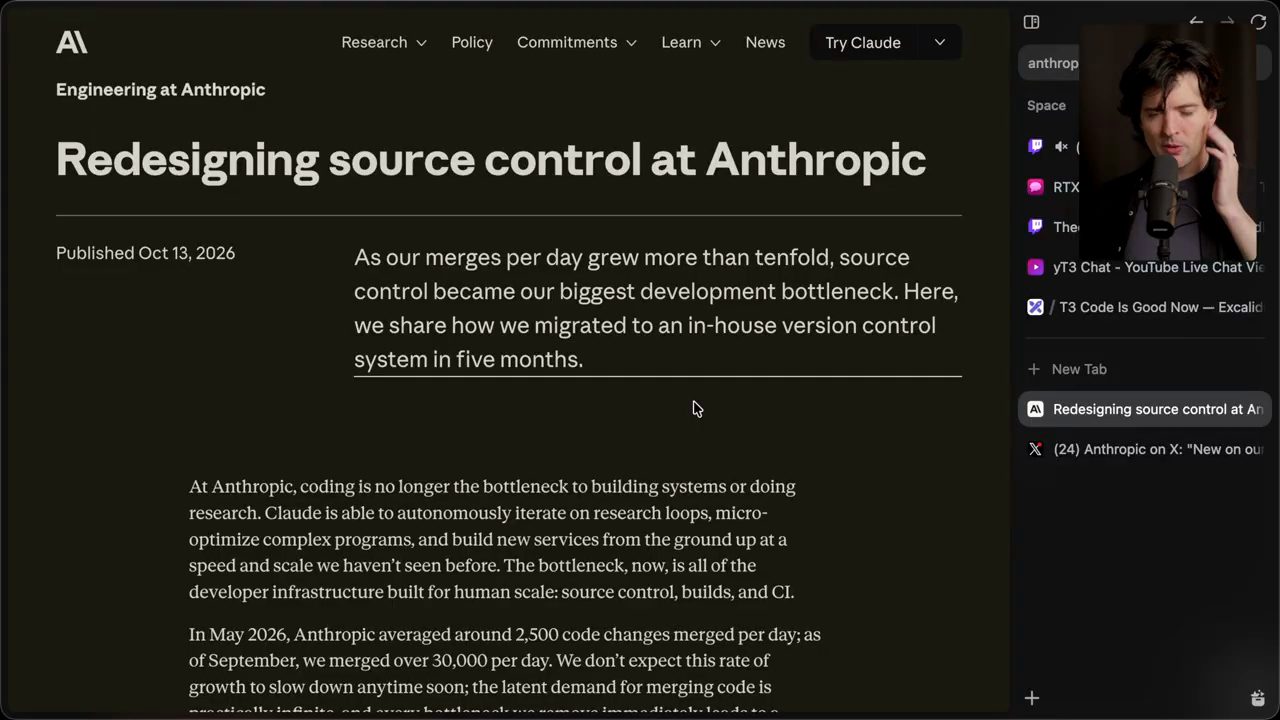
Tiêu đề bài: "Redesigning source control at Anthropic". Khi số merge mỗi ngày tăng hơn mười lần, source control trở thành nút thắt lớn nhất trong khâu phát triển của họ, và bài kể lại cách họ chuyển sang một hệ thống version control nội bộ trong năm tháng. Theo đùa: con số năm tháng nghe như một trong mấy cái ước lượng thời gian "ảo giác" của Claude, kiểu bạn hỏi việc này mất bao lâu, nó bảo hai tới ba ngày, rồi làm xong trong một tiếng.
Dù sao đây vẫn là một việc ấn tượng. Thay Git ở một công ty lớn như Anthropic nghe thật điên rồ; lần gần nhất anh kiểm tra, họ có khoảng 2.000 nhân viên (theo video đăng ngày 16/10/2026). Bài viết mở đầu: ở Anthropic, viết code không còn là nút thắt để xây hệ thống hay làm research nữa. Claude có thể tự lặp các vòng research, micro-optimize các chương trình phức tạp, và build service mới từ con số không với tốc độ và quy mô chưa từng thấy. Nút thắt giờ nằm ở toàn bộ developer infra được xây cho quy mô con người: source control, build, CI và những thứ tương tự.
Bài nhắc lại con số: tháng 5/2026 trung bình khoảng 2.500 thay đổi code được merge mỗi ngày, tới tháng 9/2026 là hơn 30.000. Họ không kỳ vọng tốc độ tăng này sớm chậm lại; nhu cầu tiềm ẩn cho việc merge code gần như vô hạn, và mỗi nút thắt họ gỡ đi lại lập tức làm lượng code họ tạo ra tăng thêm.
3. De-risk nút merge: hơn 50 PR trong một đêm
Theo nói anh từng gọi cách làm này là "de-risk nút merge" (de-risking the merge button): làm sao để tới lúc một người nhìn vào nút merge, khả năng cao code đã an toàn để merge. Nhưng còn vế bên kia: nếu bạn lỡ merge thứ không nên merge, thì blast radius và thiệt hại nó gây ra được giảm mạnh nhờ các hệ thống giúp test code dễ dàng khi nó đã ra ngoài với một nhóm user giới hạn, và revert nếu chúng thực sự làm hỏng gì đó. Anh đã thấy sự khác biệt khi đưa những thứ này vào: team ship nhanh hơn hẳn.
Anh lấy ví dụ: đêm trước buổi quay, anh thức hơi khuya vì bực với mấy vấn đề performance khá ngách khi có một database rất lớn trong T3 Code. Nên anh quyết định sửa được càng nhiều càng tốt trong một lần ngồi, đồng thời dọn mấy issue và PR cũ đang làm anh khó chịu, và tiếp quản những PR chưa được implement đúng như anh muốn. Từ khoảng nửa đêm tới tầm 3 hay 4 giờ sáng, anh merge từ chỗ này lên tới đầu trang, rồi thêm nguyên một trang nữa toàn merge của Theo. Anh chỉ cho người xem: gần như dòng nào cũng có tài khoản của anh ở bên trái; vài dòng đứng tên nhiều người nhưng thực ra cũng là anh. Vẫn chưa hết, cuộn tiếp lên nữa; chỉ có hai cái là anh merge từ người khác.
Tổng cộng là ba trang đầy lịch sử merge trên GitHub, trong bốn tiếng. Anh biết chắc là bốn tiếng vì anh làm giữa hai bản nightly, mà họ ra nightly sáu tiếng một lần. Anh muốn nhét được càng nhiều càng tốt vào bản nightly, để trước khi đi ngủ có thể tải về, test, chắc rằng mọi thứ ổn, sửa cái gì hỏng, và rút (revoke) bản build nếu nó tệ. Rồi đi ngủ với nụ cười, biết rằng khi thức dậy, performance trên bản nightly sẽ tốt hơn nhiều cho mọi người.
Việc anh có thể tự tin merge hơn 50 PR trong một lần ngồi, anh thấy thật điên rồ. Thử tưởng tượng quay lại dù chỉ một năm trước và nói với bản thân rằng mình đang merge hơn 50 PR một ngày? Khó mà hình dung nổi. Và nếu chỉ có Anthropic nói những điều này mà anh chưa tự trải qua, anh sẽ bảo đó là chuyện bịa. Nhưng đây là thực tế. Theo anh, nếu bạn chưa đi nhanh được tới mức này, thì hoặc bạn đang ở một nơi tuyệt đối không thể, vì sai sót sẽ làm chết người, hoặc bạn chưa nhận ra những công cụ này mạnh đến đâu và chưa bỏ thời gian dựng tooling để mọi thứ bớt rủi ro.
4. Biểu đồ merge và lịch sử những công ty tự làm source control
Quay lại bài viết, Theo chỉ vào biểu đồ: có màu xanh dương và màu cam. Xanh dương là pull request, cam là "Antique change requests". Anh đoán đó là thứ mới của họ, và cái tên hợp với kiểu đặt tên của Anthropic: Antique có vẻ là hệ thống của họ cho tất cả chuyện này.
Nếu bạn nghĩ đây là Anthropic kỳ quặc theo kiểu riêng của họ, Theo nhắc rằng có cả một lịch sử dài các công ty tự phát minh lại source control cho nhu cầu riêng. Ví dụ, Meta xây một hệ thống "điên rồ" quanh Mercurial mà anh nghĩ thực chất là một hard fork của Mercurial. Họ làm tất cả những thứ đó để hệ thống stacked diff mạnh hết mức có thể, cho những lúc người ta làm những chuỗi thay đổi lớn, duyệt từng mảnh rồi merge tất cả vào một lần.
Graphite là cả một công ty được xây trên GitHub để mang cách Meta làm source control tới những người dùng GitHub, vì cách đó đi trước hẳn cách mọi người đang build, nếu bạn ship nhanh. Ở công ty của anh, Ping Labs, họ từng là người dùng Graphite rất nặng. Giờ Graphite đã thành một phần của Cursor, và họ đang xây một lựa chọn thay GitHub ngay bên trong Cursor, tên là Origin.
Ý Theo muốn nói: chuyện này không chưa từng có như vẻ bề ngoài. Nhiều công ty đã tìm ra những cách tốt hơn đáng kể để làm việc với và quản lý mã nguồn bên ngoài Git. Một người từng làm ở Meta, rồi ở Graphite và nay ở Cursor, chỉ ra rằng phần lớn lý do Meta tự xây hệ thống thay vì dùng thứ có sẵn là vì các checkout khổng lồ của họ không chạy tốt với Git. Theo nhớ mang máng lịch sử: Meta từng cố thuyết phục team phát triển Git làm cho Git chạy tốt hơn với monorepo khổng lồ, thay vì chia mỗi thứ một repo riêng. Các maintainer của Git không chịu nhượng bộ, nên Meta đi đường riêng.
Và như thế là ổn, theo Theo: bạn không nên phải ép chuẩn chung của ngành vào workflow của mình nếu nó không vừa. Anh thấy vui khi ngày càng nhiều công ty thách thức điều này, vì Git không hoàn hảo, và chắc chắn không hoàn hảo cho agent.
5. Scion, Antique và chuyện monorepo của OpenAI
Vậy Anthropic đã xây gì? Để theo kịp mức tăng trưởng điên rồ đó, họ xây Scion, một hệ thống version control nội bộ, và chuyển hoàn toàn monorepo của họ khỏi Git trong năm tháng.
Theo chen vào một "fun fact ngớ ngẩn": cả Anthropic lẫn OpenAI đều build trong monorepo, tức mọi thứ họ làm là các project và folder khác nhau bên trong một repo khổng lồ duy nhất. Nếu bạn từng tò mò vì sao sidebar trong app ChatGPT và Codex tệ đến vậy, thì đây là lý do: phần lớn nhân viên OpenAI chỉ có đúng một project, tên là OpenAI. Họ vẫn dùng GitHub.com; gần như toàn bộ code của OpenAI nằm ở openai/openai, và trang đó trả về 404 nếu bạn không phải nhân viên. Theo mở thử ngay trên màn hình và ra trang 404: "Ai bảo tôi bí mật làm cho họ thì đây là bằng chứng." Điều này khiến cách họ nghĩ, làm việc và build trông lạ lẫm với những người có nhiều hơn một project.
Quay lại bài: không chỉ Scion, cùng trong năm tháng đó họ còn xây và ship một bề mặt code review tên là Antique, cùng code search, một hệ thống IAM phong phú cho source control, những cách mới để quản lý và land một lượng lớn code đã review, và nhiều thứ khác. Bài viết tập trung vào cách họ xây Scion. Họ gọi đây là một case study thú vị: khả năng viết code của Claude vừa là thứ đẩy họ vào tình huống này, vừa là thứ giúp họ xây được một hệ thống chất lượng cao, scale được để xử lý nó.
Phần "Growing our monorepo": trước khi nói về thứ họ xây, họ thừa nhận khối lượng công việc của mình bất thường đến đâu. Không có gì ngạc nhiên, Anthropic dùng Claude để viết phần mềm nhiều hơn gần như mọi công ty khác. Theo giả vờ sửng sốt: "Bất ngờ chưa các bạn." Nói nghiêm túc, chắc chắn họ dùng nhiều hơn team anh, dù team anh cũng dùng khá nhiều. Vì dùng nặng như vậy, họ thường là những người thấy sớm nhất chỗ các công cụ xây cho quy mô con người bắt đầu căng ra. Source control chỉ là một ví dụ. Họ không kỳ vọng nhiều tổ chức gặp những vấn đề này trong tương lai rất gần, nhưng ngờ rằng sẽ không lâu nữa những ai dùng công cụ AI viết code cũng gặp đúng những điểm áp lực đó, nên họ muốn chia sẻ những gì đã xây và đã học.
6. Vì sao Git không còn vừa với monorepo của Anthropic
Git là một hệ thống phi tập trung (decentralized). Mỗi bản clone là một repo hoàn chỉnh, tự chứa, có thể tính diff, đọc lịch sử và blame, check out bất kỳ revision nào trong khi hoàn toàn offline. Với tuyệt đại đa số repo, đó là thiết kế đúng, và là một phần lớn lý do Git trở thành chuẩn. Nhưng khi monorepo của Anthropic lớn lên, nó ngày càng không vừa với không gian thiết kế đó.
Các con số trong bài (đăng ngày 13/10/2026): riêng lịch sử nhánh main đã gần 100 GB, một working copy nén là hơn 25 GB. Họ thực hiện cỡ 25 triệu lần checkout code mỗi ngày cho CI, chưa tính môi trường dev, sandbox của agent và các job research. Nếu fetch theo cách thông thường, đó sẽ là hơn 600 petabyte traffic Git mỗi ngày.
Git có sẵn công cụ để làm việc với một lát cắt của repo: shallow clone, sparse checkout, promisor remote. Ngoài ra còn các cách lách quen thuộc cho monorepo lớn, như Git mirror nội bộ và snapshot repo (gọi là seed) giữ trong blob storage. Họ đã dùng tất cả; ở thời đỉnh điểm, họ vận hành vài trăm Git mirror nội bộ để chịu tải. Cách đó câu thêm được thời gian, nhưng càng lúc càng khó vận hành khi tốc độ merge tăng. Seed ngày càng tụt xa đầu nhánh main giữa các lần làm mới, và cần ngày càng nhiều công sức để giữ cho các thao tác phụ thuộc lịch sử, như diff và blame, chạy được trên những bản clone một phần đó.
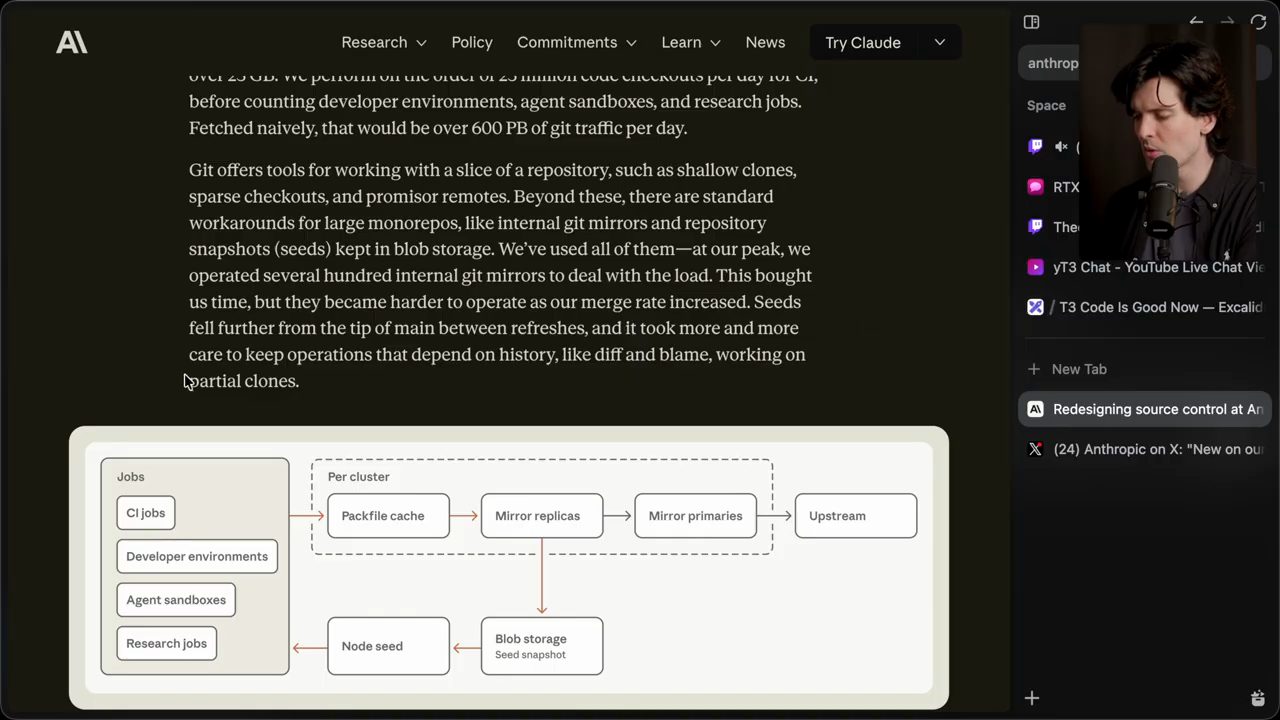
Lùi lại một bước, họ nhận ra rằng giống phần lớn các công ty, họ đang dùng Git như một hệ thống tập trung với một bản gốc có thẩm quyền, trong khi gần như toàn bộ client của họ là agent và job, vốn theo định nghĩa là luôn online. Theo thấy đây là một nhận xét rất thú vị và đáng giá. Bạn không thể dùng Claude khi offline, vì Claude được phục vụ từ một data center khổng lồ với những GPU mà bạn không có. Trừ khi bạn cắm thẳng vào đó và chính đường internet của data center đó bị đứt, còn không thì bạn đang online. Vậy nên cả ý tưởng ai cũng cần mọi thứ được đồng bộ về máy mình không còn nhiều ý nghĩa.
Những đặc tính làm Git xuất sắc cho công việc phân tán, offline lại đang chủ động cản khả năng scale của họ khi repo lớn lên. Nên họ tự hỏi: nếu thiết kế source control với giả định agent luôn online ngay từ đầu, thì nó sẽ trông thế nào, và khác đi ra sao?
7. Sáu nguyên tắc cho source control ở quy mô agent
Với agentic coding, nhiều giả định quen thuộc về cách phát triển phần mềm đang thay đổi. Anthropic đón nhận những thay đổi đó khi xây Scion, nhờ vậy đi theo một hướng khác hẳn Git ở vài nguyên tắc cốt lõi. Source control cho monorepo khổng lồ đã có tiền lệ, như Piper của Google và Sapling của Meta (Theo nhắc lại chuyện Meta anh vừa kể), nên họ xây Scion với những bài học xương máu đó trong đầu. Theo lưu ý rằng có rất nhiều người ở Anthropic từng làm ở Meta và Google, và thường làm đúng những thứ này ở đó. Anh biết Boris từng làm sâu về developer tooling ở Meta, và giờ đang làm Claude Code.
Một: client luôn online. Vì gần như mọi client là agent và job, họ thiết kế client và giao thức của Scion quanh một server luôn với tới được, và client tự fetch dữ liệu khi cần. Theo chọc: rõ ràng họ không dùng GitHub, vì ngay cả khi bạn online, bạn cũng không thể giả định GitHub online.
Hai: bất đối xứng giữa client và server. Trong Git, client nào cũng có thể làm một server đầy đủ. Đó là một trong những thứ làm nên Git: nó phi tập trung thật sự, bất cứ thứ gì cũng có thể là Git server. Còn trong Scion, server trả lời các câu hỏi về lịch sử file và blame, tạo commit, thực hiện merge và rebase, v.v. Client giữ một local object cache có giới hạn, bày các file của working copy ra đĩa, theo dõi thay đổi trên file system, và cho người dùng những cách tiện tay để làm việc với server. Tự nó tính được rất ít, nhưng đổi lại cần ít dữ liệu cục bộ hơn nhiều.
Ba: một dịch vụ source control có thể làm nền cho nhiều loại ứng dụng mới. Với Git, một job CI hay một công cụ cần hỏi repo một câu, như ai sửa dòng này lần cuối hay hai commit liên quan nhau thế nào, sẽ phải giữ cả một bản local của repo, hoặc hy vọng API riêng của vendor nào đó trả lời được. Với Scion, mọi truy vấn source control mà client dùng cũng được mở qua API, nên trong nhiều trường hợp job không cần repo cục bộ nào cả. Nhiều công cụ nội bộ, như pipeline tự động bisect và revert, sẽ không khả thi ở quy mô của họ nếu thiếu quyền truy cập source rẻ, bằng chương trình như vậy.
Bốn: mọi thứ phải scale ngang (horizontally scalable). Ở thời đỉnh, họ chạy vài trăm Git mirror, làm căng capacity đáng kể, và không scale nổi nữa khi repo vượt quá giới hạn đĩa hay bộ nhớ của các mirror. Theo bình: bạn biết là tệ lắm rồi khi Git mirror của mình hết chỗ trên đĩa. Mà công bằng mà nói, đĩa cứng đã đắt lên nhiều; anh vẫn không tin nổi ổ cứng tăng giá nhiều đến vậy, "cảm ơn nhé, Anthropic". Trong Scion, dữ liệu repo được phân tán và từng thành phần scale độc lập. Không có bản repo nào được materialize hoàn chỉnh ở đâu cả, kể cả trên server. Không có thứ tương đương pack file (các gói object nén của Git), nên cũng không cần bảo trì repo.
Năm: commit phải rẻ, tăng dần (incremental) và không khoá (lock-free). Theo nhấn mạnh lock-free đặc biệt quan trọng: một người commit không được chặn người khác, hay thực tế hơn, 500 agent đang commit không được chặn 500 agent khác. Trong Git, bạn commit cục bộ rồi push để chia sẻ. Trong Scion, mọi commit, rebase hay merge đều diễn ra trên server, nên không có gì để push, nhưng mỗi thao tác đó phải nhanh. Chi phí tạo một commit và cập nhật các cấu trúc dữ liệu phía sau phải tăng theo kích thước của thay đổi, không theo kích thước của cả repo, nếu không server sẽ không theo kịp.
Vòng đời phát triển trong Scion cũng hạn chế dùng ref (con trỏ tới commit, như branch và tag), trừ ref main hoặc các nhánh release. Lý do: trạng thái toàn cục mà mọi server phải đồng thuận luôn gây vấn đề scale. Theo chốt: global luôn tệ khi bạn chạy nhanh cỡ này.
Sáu, quan trọng nhất: working copy là tuỳ chọn, và sparse ngay từ thiết kế. Vì repo quá lớn và họ checkout code hàng chục triệu lần mỗi ngày cho CI, họ muốn tránh checkout bất cứ khi nào có thể. Với Scion, chẳng hạn một job CI cần diff giữa một commit và merge base của nó có thể hỏi server đúng thứ đó. Ghi cũng vậy: nhiều workload ghi có thể bỏ qua checkout và chạy hoàn toàn qua API. Giao thức của Scion xoay quanh sparse checkout, chỉ chứa những thư mục client yêu cầu, và virtualized checkout, materialize file theo nhu cầu, nên khi job thật sự cần file trên đĩa, client chỉ trả giá cho những gì nó thật sự đọc.
Theo kể anh cũng từng nghịch những ý tưởng tương tự hồi cuối năm ngoái và đầu năm nay: cố làm cho việc quản lý trạng thái một codebase dễ hơn, theo cách bạn không cần có toàn bộ trên máy mà agent vẫn truy cập được. Anh thấy rất đã khi họ làm phiên bản thật của nó, vì bản của anh chỉ là một thử nghiệm hỗn loạn.
8. Changeset: đơn vị công việc của Scion
Vậy cụ thể nó chạy thế nào? Giờ đã có các nguyên tắc, ta có thể hiểu mọi thứ ghép lại ra sao. Bài viết nói những hiểu biết này có thể áp cho các hệ thống source control khác, hay rộng hơn, cho các giai đoạn khác của vòng đời phát triển phần mềm. Theo reo lên: "Ôi, giờ tới phần cấu trúc dữ liệu, đây là chỗ ta vào những chi tiết vui."
Đơn vị công việc là changeset; Theo thấy rõ cảm hứng từ Meta ở đây. Changeset là các entry trong một write-ahead log, và lưu phần lớn những gì bạn chờ đợi ở một commit Git. Nhưng chỗ một commit Git lưu con trỏ tới tree, thì changeset lưu danh sách các file đã thay đổi so với parent thứ nhất của nó, kèm con trỏ content-addressed tới nội dung file đã nén trong blob storage. Changeset được tạo phía server và có mặt ở mọi nơi ngay lập tức.
Theo thấy điều này rất thú vị. Anh biết họ dùng blob storage cho nhiều thứ, nhưng vẫn ngạc nhiên khi đọc thẳng ra rằng mã nguồn không nằm trong hệ thống. Khi bạn yêu cầu mã nguồn, nó phải đi lấy từ blob store, và hệ thống về cơ bản chỉ là một database trỏ tới những blob đó. Có vẻ toàn bộ metadata nằm trong Spanner; anh thấy hợp lý, và lại rất "chất Google".
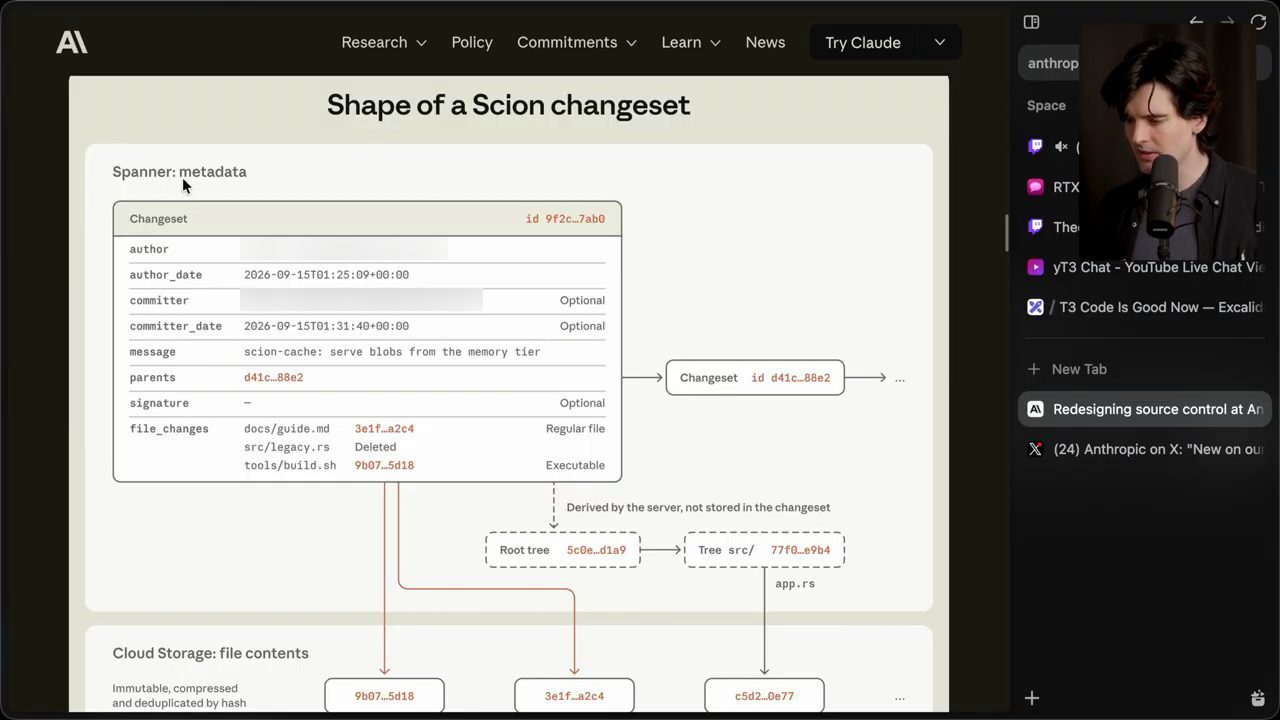
Changeset có hai trường author và committer riêng biệt. Theo giải thích vì sao hợp lý: author là người kích hoạt thay đổi, còn committer là agent nào đã thực hiện, hoặc nơi nó diễn ra, khi bạn có nhiều hệ thống khác nhau cùng làm việc này. Ngoài ra là các trường quen thuộc như author date, committer date, message, parent (thứ mà changeset này tham chiếu tới, như đã nói), và file changes, chỉ ra file nào đã đổi kèm con trỏ tới blob trong blob storage.
Cấu trúc này cho phép họ nhận changeset với throughput rất cao, vì không có pack file phải xử lý, không có khoá hay phối hợp giữa các server, và không có ref nào để dời. Theo diễn lại cho dễ hiểu: bạn chỉ việc append. Bạn chỉ thêm vào tập dữ liệu, không phải đi qua cả lịch sử trước khi thêm, không phải dời con trỏ từ chỗ này sang chỗ kia, không phải tái cấu trúc tree, không phải đồng bộ toàn bộ dữ liệu qua lại để chắc mọi thứ nằm đúng chỗ. Bạn chỉ đẩy changeset lên, lưu blob vào blob storage, thế là xong.
Rồi anh dừng lại: nó còn không lưu diff cho thay đổi file sao? Nó chỉ lưu trạng thái mới của file? Anh thấy hợp lý: changeset nói những file này đã đổi và chúng trỏ tới đây, nhưng thứ nằm trong storage là toàn bộ nội dung file, không phải một diff. Vì nếu lưu diff thì việc tính lại sẽ là địa ngục.
9. Derived data và ranh giới API cứng
Vì changeset chỉ ghi lại những gì đã đổi, tự nó không trả lời nhanh được những câu như ai đã sửa một dòng, hay commit nào đã đụng tới một file. Để trả lời, Scion xây thêm các cấu trúc dữ liệu từ changeset, gồm cấu trúc riêng cho file blame và path history, cùng skip list cho commit graph. Họ gọi mọi thứ không trực tiếp thuộc changeset là derived data, và tính tất cả qua một cơ chế chung. Mỗi loại derived data được định nghĩa đệ quy: giá trị của nó cho một changeset được tính từ giá trị của nó cho các parent của changeset đó.
Cơ chế này có ba lợi ích. Một, họ dễ dàng thêm loại derived data mới khi một cấu trúc dữ liệu mới làm thao tác nào đó nhanh hơn. Hai, với từng loại, họ chọn được tính ngay (eagerly) hay hoãn việc lại, nên tránh materialize những dữ liệu không cần. Ba, vì client không bao giờ thấy phần bên trong của các cấu trúc, họ tối ưu được chúng mà không phải đổi client. Họ đã thêm loại derived data mới nhiều lần khi hệ thống lớn lên, như các index mới để phát hiện copy hay tìm file theo đường dẫn.
Theo khen rất hợp lý, rồi thử "nói cho dễ hiểu", vì cả nhóm đang đi rất sâu vào chi tiết (điều anh thích). Một phần lớn sức mạnh của Git là bạn có toàn bộ dữ liệu khi clone repo. Muốn tìm khi nào file này đổi, mọi thứ một người đã làm, những chuyện như thế, bạn tự đi qua dữ liệu được. Vấn đề là nếu muốn thêm thứ gì mới vào Git, hay làm một thao tác nào đó nhanh hơn, bạn gần như bó tay, vì sẽ phải lật tung Git của tất cả mọi người.
Nhưng nếu người ta không phải clone toàn bộ mà chỉ gọi một API, bạn chọn được cái gì mở ra và cái gì không. Và vì server ở đây đầy các lớp cache, CPU dư dả và nhiều thứ khác, họ theo dõi những gì client muốn hỏi để lấy thêm thông tin, xây một cách tính hiệu quả mà không phải đổi cấu trúc dữ liệu, và thế là client làm được việc đó.
Client cũng sẽ không "ăn gian" làm trò gì kỳ quặc. Theo nói anh đã thấy chuyện này rất nhiều: khi bạn cho Claude truy cập phần bên trong của thứ gì đó, nó sẽ nghĩ ra những lời giải mới lạ điên rồ, đồng thời chậm điên rồ và ngốn CPU, để lấy được thứ nó muốn. Ranh giới API cứng ngăn điều đó, và anh cho rằng gần như chắc chắn đó là một lợi ích rất lớn.
10. Scale server: content-addressed và bất biến
Họ scale hệ thống này thế nào? Bắt đầu bằng một đội nhỏ Scion server, cung cấp API source control cho mọi thao tác client cần: lấy changeset, tính diff, tìm merge base, và fetch blob. Theo lưu ý chuyện tính diff ở đây rất thú vị: vì hệ thống lưu nội dung file ở cuối mỗi thay đổi, khi bạn hỏi giữa hai changeset có gì đổi, bạn không nhìn vào một diff nào cả, vì không hề có diff. Diff được tính khi bạn đưa ra hai changeset và hỏi chúng khác gì nhau, bằng cách lấy blob của mọi file bị ảnh hưởng và so xem chúng khác nhau thế nào giữa hai trạng thái.
Mọi dữ liệu source control đều content-addressed, nên một mẩu dữ liệu không bao giờ đổi khi đã được lưu. Theo nhấn mạnh điều này cũng quan trọng. Khả năng ghi đè lịch sử trong Git không tệ lắm, vì mỗi lần force push bạn đổi luôn mọi commit hash. Nhưng nếu bạn sửa được nội dung của một hash cho trước, điều đó sẽ phá Git tận gốc. Theo anh, cái bất biến (immutable) gần như 100% lúc nào cũng scale tốt hơn cái thay đổi được. Xây cả hệ thống quanh những changeset cố định, vĩnh viễn, còn mọi thứ linh hoạt là các phép tính đặt lên trên: điều này "chạm tới tận đáy trái tim functional programming" của anh.
Vì changeset bất biến và content-addressed, mọi server có thể cache chúng mà không phải hỏi các server khác. Ngay khi một changeset được gửi lên một server, server biết thay đổi đó là duy nhất và cứ thế tin. Nhờ vậy server scale ngang và cần rất ít phối hợp. Về cơ bản chúng là những cache lớn, còn tính được derived data ngay tại chỗ và ghi kết quả về Spanner.
Các bên dùng Scion không còn phải giữ repo cục bộ của riêng mình. Fetch và bảo trì repo từng là gánh nặng đáng kể cho các job CI và công cụ cần hỏi source control, nhất là về tổ tiên commit (ancestry) và blame. Giai đoạn đầu của cuộc chuyển đổi, trước khi có client, định dạng repo và giao thức riêng, Scion chỉ được dùng để trả lời các truy vấn metadata kiểu đó. Fetch nội dung file và materialize working copy là những thao tác nặng dữ liệu hơn nhiều, nên họ phải tự thiết kế riêng cho phần này.
11. Client scn, daemon và các tầng cache
Client scn của Scion khác giao thức fetch của Git ở vài điểm quan trọng, và nhờ đó hợp với một kiến trúc scale cao, cần ít CPU hơn đáng kể so với Git server. Khâu negotiation của Scion không nói cho server biết client đã có gì; thay vào đó nó chỉ làm việc với các tree và blob mà client muốn. Bắt đầu từ một root tree, client kiểm tra kho cục bộ xem thiếu tree nào và yêu cầu chúng một cách đệ quy, rồi lặp lại quy trình đó với blob.
Theo diễn giải: trước hết nó tìm những gì nó cần cho việc nó muốn làm; có rồi thì đi gom tất cả blob để có đủ file; rồi mới bắt đầu làm việc thật. Mỗi request là cho một object cụ thể không bao giờ đổi, nên cache nào cũng trả lời được, và kiến trúc rất giống các cache nhiều tầng truyền thống. Quy trình cũng hiệu quả và resume được, vì không có một response pack file nhiều gigabyte duy nhất. Sparse checkout và cả virtualized checkout đều không cần hỗ trợ đặc biệt, vì client đơn giản là không hỏi những tree nó không muốn.
Đoạn tiếp theo, Theo than, dùng một loạt thuật ngữ mà bài không định nghĩa và dùng theo nghĩa riêng, nên anh cố "dịch từ giọng Claude sang tiếng Anh thường". Client không nối thẳng tới Scion server, vì server lo quản lý toàn bộ changeset. Client nói chuyện qua socket với một daemon (scion-daemon), và daemon này lưu object cho cả node. Về cơ bản nó giữ một cache kiểu "phiên bản gần nhất của file ở đường dẫn này", nên trả lời được yêu cầu về file mà không phải đi xuống cả cây để tính trạng thái đang có. Theo thú nhận anh rất ghét cách họ dùng chữ "node" ở đây.
Mỗi daemon định kỳ được reset về snapshot mới, để nó không phải tính lại mọi thứ đã đổi trong ba ngày qua; họ cập nhật liên tục. Và với cách người ta bật agent, bật CI, bật đủ thứ, gần như chắc họ bắt đầu công việc từ bản latest, nên hợp lý khi đưa cache lên trạng thái gần nhất theo cách đó rồi chỉ xử lý những gì đổi sau đó.
Các cache server (scion-cache, đặt theo vùng) stream object thẳng từ bộ nhớ thay vì để trên ổ đĩa, nên client phía bên kia lấy dữ liệu nhanh hơn nhiều. Chúng giữ dữ liệu đúng theo định dạng trên đĩa mà daemon sẽ dùng, để không phải đổi hình dạng hay định dạng dữ liệu khi nó đi ra từ bộ nhớ, qua mạng, rồi xuống ổ đĩa. Khi cache thiếu object, nó hỏi các Scion server có thẩm quyền, những server sẽ đọc từ Spanner hay cloud storage khi cần để đưa dữ liệu và file mới vào tầng cache.
scion-daemon, scion-cache và scion-server đều trả lời cùng một bộ RPC cho giao thức này, nên client không cần biết topology của cache. Về lý thuyết tầng nào cũng nói chuyện được với tầng nào, nhưng họ ép phân tầng nghiêm ngặt để cô lập failure domain. Họ muốn tránh tình huống một scion-cache ở một vùng bị hỏng làm quá tải các server phía trên và kéo sập cả hệ thống.
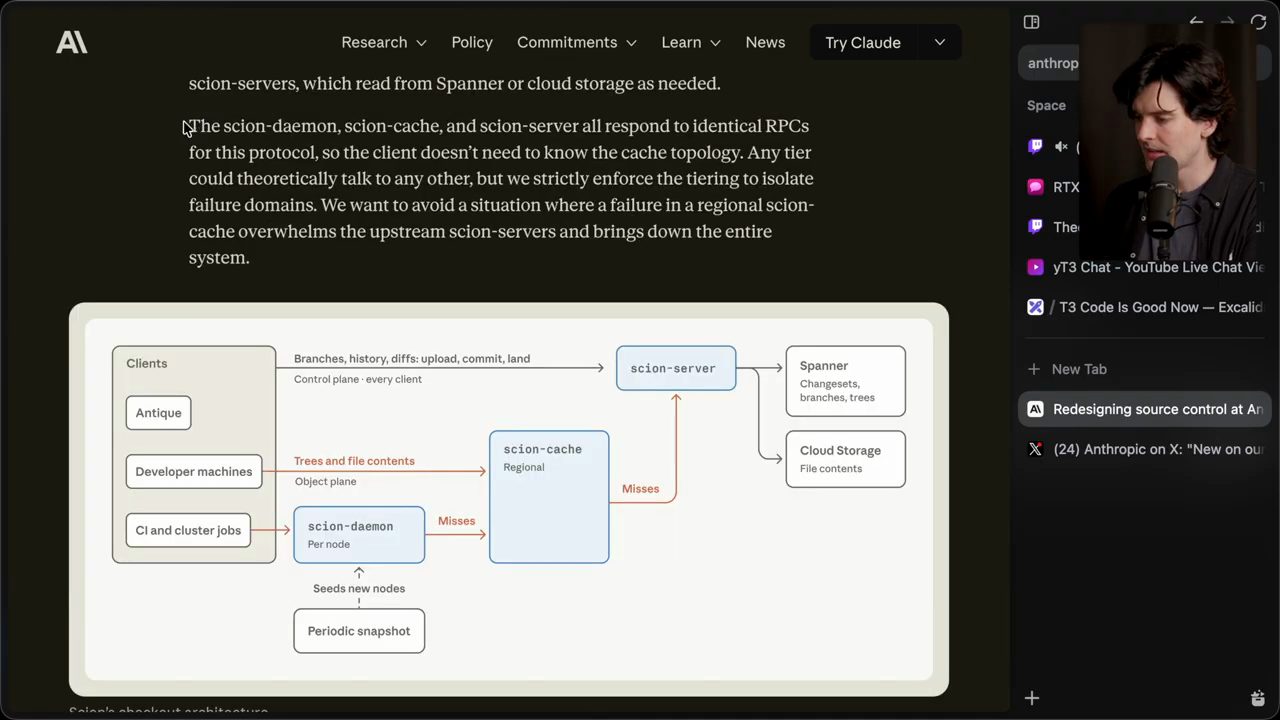
Theo tóm lại bằng lời của mình. Có cụm Scion server là tầng quản lý trạng thái thật của mọi thứ, tầng có thẩm quyền, lưu changeset trong Spanner và nội dung file thật trong cloud storage. Rồi có tầng cache theo vùng, là thứ bị gọi nhiều nhất cho công việc thật, để bạn không phải fetch nửa vòng trái đất tới server; tầng này gọi Scion server để có trạng thái hợp lý trong cache. Máy dev gọi thẳng scion-cache khi kéo code về làm việc, và nếu cache thiếu gì bạn cần thì nó kéo từ server. Nhưng với CI, ngay cả vậy cũng chưa phải abstraction đúng, và đó là chỗ daemon vào cuộc, với snapshot định kỳ để sẵn sàng bật job CI nhanh nhất có thể.
Theo bài viết (đăng ngày 13/10/2026), mỗi tầng giữ cache hit rate trên 99% và không cần state sống lâu, nên dễ scale lên khi cần. Hạ tầng Scion nhỏ hơn 200 lần so với hạ tầng Git mirror trước đây, xét về yêu cầu CPU và bộ nhớ.
12. Phần mềm may đo: dự án Lust của Theo
Theo gọi con số 200 lần là điên rồ, và nói đây là ý tưởng đang "làm anh hơi đau đầu": nhận ra rằng mọi phần mềm trước giờ được xây theo hướng khá tổng quát, còn giờ ta có thể xây phần mềm cho đúng nhu cầu riêng của mình. Anh xin rẽ sang một chuyện nghe ngớ ngẩn: một trong những dự án "YOLO" của anh tên là Lust, cụ thể là lust-lang. Anh lấy một tập con của Rust cho được phần lớn lợi ích của Rust, nhưng làm sao để compile và build nhanh hơn cả trăm lần, vì thời gian build của TSRust, bản anh viết lại TypeScript compiler bằng Rust, quá chậm.
Anh gọi đây là một dự án điên rồ mà anh không nghĩ sẽ tiến được, nhưng nó đã compile được hơn 40% số file của TSRust, và anh kỳ vọng tới cuối tuần nó có thể chạy được thật (theo video đăng ngày 16/10/2026).
Nó có chạy được cho phần lớn project Rust không? Theo trả lời dứt khoát: tuyệt đối không, và đó không phải mục đích. Đây là một thử nghiệm may đo: lấy một codebase mà anh không hài lòng về thời gian compile, liệu có thể phát minh ra một ngôn ngữ mới để nó compile nhanh hơn không? Thật điên rồ khi đây là thứ bạn có thể nghĩ tới, chứ đừng nói là làm được.
Mà anh còn đang dùng một model kém hơn nhiều so với thứ Anthropic có: theo anh, đó là bản distill cách hai thế hệ model so với những gì họ dùng nội bộ. Anh đùa rằng họ đang dùng "Fable Ultra Max 7" nội bộ, còn anh ngồi đây với Opus 5.5 và vẫn vui vẻ làm được những việc thế này. Việc ta build được theo cách này đúng là điên rồ. Và dù một hệ thống như vậy có thể không nhỏ hơn và nhanh hơn 200 lần trong mọi trường hợp, nó đúng là như vậy cho trường hợp của họ. Anh kỳ vọng ngày càng nhiều công ty có những vấn đề scale lớn, đau đớn kiểu này sẽ đi phát minh lại chính những mảnh đau đớn đang làm họ chậm lại.
Anh thêm một fun fact, đáp lại một người trong chat: borrow checker không phải lý do khiến thời gian build của Rust tệ; thủ phạm là một mớ chuyện kỳ quặc của LLVM.
Quay lại bài: CI và các job research check out code nhanh hơn hai bậc độ lớn, tính bằng giây thay vì phút, giải phóng một lượng capacity đáng kể trên toàn fleet. Riêng CI được lợi 25% CPU capacity. Cả client lẫn cache đều không cần bảo trì repo, giúp việc quản lý vòng đời các job đơn giản hơn.
Theo nói anh đang nhờ agent lấy số liệu cứng xem build và CI của T3 Code đã tốn bao nhiêu thời gian cho các lần clone kiểu GitHub và Git. Anh đoán con số sẽ làm anh đau lắm, và hẹn quay lại xem sau.
13. Bài học: Mythos Preview, team bảy người và chi phí chuyển đổi
Họ học được gì khi xây Scion? Họ bắt đầu xây gần như cùng lúc Claude Mythos Preview và Claude Tag được dùng nội bộ. Cả hai bản phát hành đó vừa khuếch đại nhu cầu cần Scion, vừa tăng tốc đáng kể việc họ xây nó.
Một ví dụ đặc biệt ấn tượng: đầu năm, họ viết tay phần lớn phiên bản thứ nhất của pipeline ingest từ Git sang Scion, dưới dạng prototype. Họ nghĩ nó tốt, cho tới khi có trong tay một snapshot nội bộ sớm của Mythos Preview. Họ bảo model viết lại toàn bộ, không thêm chỉ dẫn nào, và nó cho ra một phiên bản dùng ít bộ nhớ hơn 20 lần và nhanh hơn 4 lần, mà vẫn giữ mọi bất biến ngầm về thứ tự ingest và cấu trúc dữ liệu.
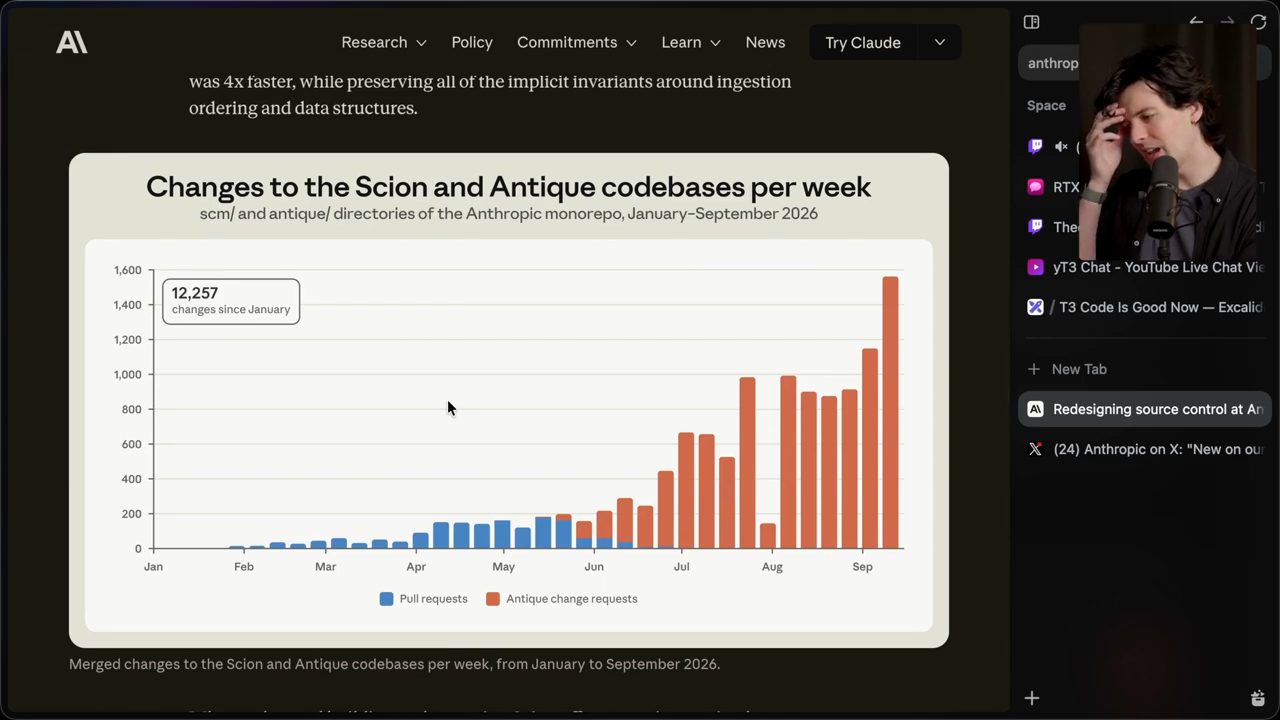
Theo chỉ vào biểu đồ lịch sử thay đổi của Scion và Antique: họ khoe 30 nghìn thay đổi một ngày, nhưng tổng số thay đổi vào chính kiến trúc này chỉ hơn 12 nghìn. Vậy tốc độ một ngày của cả monorepo gấp hơn đôi tổng số request, commit, changeset, gọi sao cũng được, đã land vào toàn bộ hệ source control. Anh thấy khá điên.
Bài viết nói những gì họ học khi xây và vận hành Scion cho thấy vài bài học thú vị về chuyện xây phần mềm ở quy mô agent sẽ ra sao. Phát triển nhanh với team nhỏ sẽ ngày càng phổ biến; Theo: "Xác nhận." Một team bảy người đã xây cả Scion lẫn Antique, công cụ code review của họ (thứ mà họ nói hoàn toàn có thể viết hẳn một bài blog riêng). Theo nói anh hiểu cảm giác đó, vì code review tệ đến mức nào. Chưa kể nửa tá hệ thống liên quan, chuyển đổi hoàn toàn trong năm tháng, trong khi lượng code merge mỗi ngày tăng 10 lần. Trước đây, phát triển và triển khai một hệ source control như vậy sẽ mất nhiều năm chuyển đổi dần, với nhiều kỹ sư hơn hẳn. Họ nghĩ kiểu chuyển đổi nhanh, gọn này sẽ phổ biến hơn trong tương lai.
Theo đồng ý: chắc chắn sẽ thế. Chi phí chuyển đổi (switching cost) đã giảm nhiều hơn gần như mọi thứ khác. Trước đây người ta chọn một công nghệ, một giải pháp, một vendor, rồi gần như mắc kẹt ở đó, vì rời đi tốn hơn chi phí đang chịu khi ở lại. Giờ tự viết một lựa chọn thay thế rồi chuyển sang lại dễ hơn. Anh kể chính mình đã nhanh tay dựng một giải pháp để clone, mirror và backfill toàn bộ dữ liệu analytics đang nằm ở một nhà cung cấp analytics, đưa về ClickHouse do anh tự quản, chạy trên R2. Kết quả là chi phí giảm hơn 10 lần, và agent của anh làm việc với nó dễ hơn nhiều. Anh làm việc đó bán thời gian, với vài thread chạy bên lề trong khi vẫn làm việc chính hằng ngày. Những việc thế này không có AI thì rất khổ, từng rất tệ; còn giờ tự dựng gần như là chuyện vặt.
Chat nhắc anh, và anh xác nhận: anh đã tự viết TypeScript compiler của riêng mình, và nó đang chạy hàng nghìn lần mỗi ngày trong T3 Code, với hơn 40.000 lượt tải mỗi tuần (số liệu theo video đăng ngày 16/10/2026). Anh dựng nó gần như một trò đùa, để xem có làm được không. Thật không tin nổi.
Rồi số liệu về. Trong toàn bộ CI của anh, gần một nghìn giờ CI của T3 Code đã dành để chờ Git checkout. Đó là 42 ngày chờ git pull, mà mới chỉ là CI, chưa tính người làm trên máy mình. Ước tính riêng cho T3 Code, thời gian chờ git pull tốn từ 350 tới 600 đô chỉ cho tiền thuê CPU để kéo thay đổi về (số liệu theo video đăng ngày 16/10/2026). Và đó là một project nhỏ của một startup khoảng năm nhân viên, tuỳ cách đếm. Thử tưởng tượng ở quy mô như Anthropic thì còn điên tới mức nào.
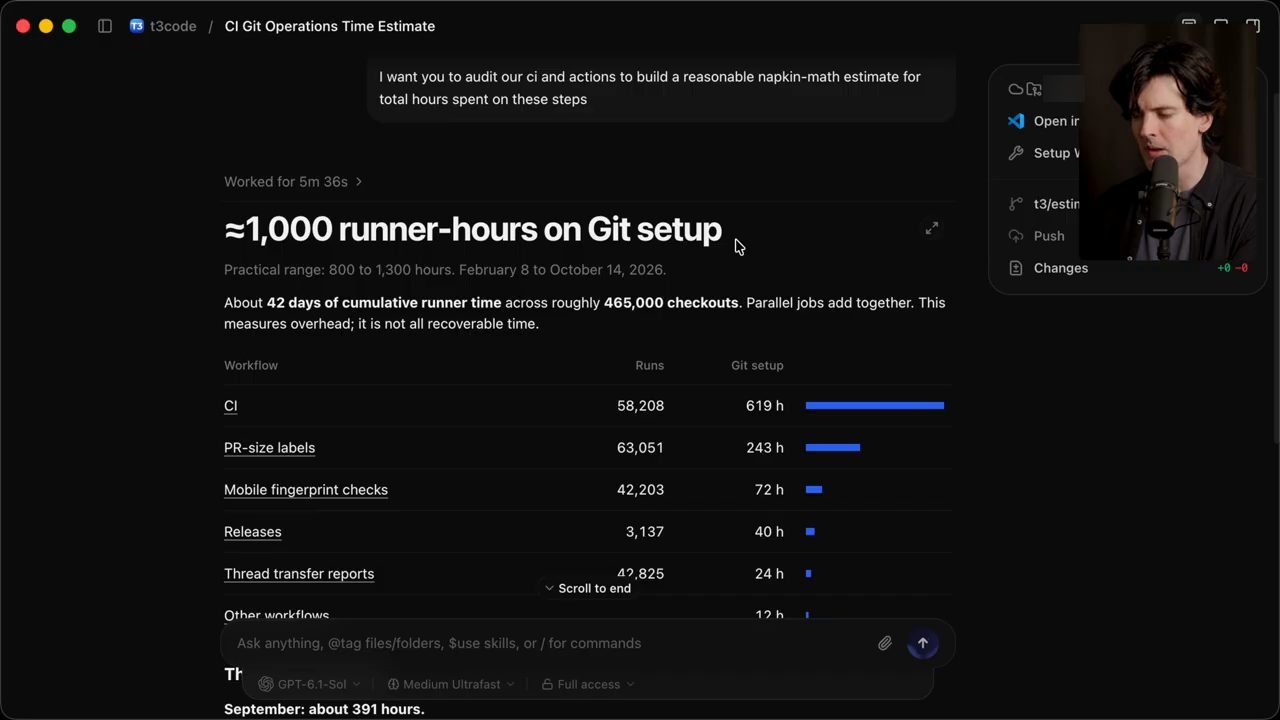
Câu Theo giao cho agent trên màn hình, và câu hỏi tiếp theo về chi phí:
I want you to audit our ci and actions to build a reasonable napkin-math estimate for total hours spent on these steps
How much would that cost at standard Github ci rates
Trên màn hình, câu trả lời cho câu thứ hai là khoảng 450 đô tổng cộng, dao động 350 tới 600 đô cho giai đoạn tháng 2 tới tháng 10/2026 được kiểm, tính theo bảng giá runner GitHub chuẩn ở thời điểm video (đăng ngày 16/10/2026).
14. Kỹ sư không kém giá trị, nhưng việc của họ đã đổi
Theo thích phần tiếp theo, thứ anh nói chưa từng nghe Anthropic nói: kỹ sư không kém giá trị đi, nhưng công việc của họ đang thay đổi. Anh cảm ơn Anthropic vì đã không nói kỹ sư hết quan trọng; một thay đổi dễ chịu. Bài viết kể mọi kỹ sư làm hệ thống này giờ đều đánh giá Claude viết code giỏi hơn họ, nhưng kỹ sư vẫn mang tới sự hiểu biết vô giá về các thành phần liên hệ thống ở mức cao và các đánh đổi ở mức thiết kế, đưa ra lựa chọn có hiểu biết quanh những bài toán họ muốn giải và quy mô họ biết mình cần đạt.
Rất thường xuyên, họ thấy vai trò của kỹ sư là nói "không" với Claude. Agent đôi khi vi phạm các ràng buộc cốt lõi của hệ thống để thoả mãn một pattern lẽ ra không bao giờ được cho phép. Theo đùa: "Ok, có lẽ họ đang dùng cùng một con Claude với tụi mình." Điều này đặc biệt phổ biến trong quá trình chuyển đổi. Ví dụ, có nhiều hệ thống cố brute force tìm thời điểm một thay đổi được merge vào main bằng cách đọc tuần tự commit log, thay vì hỏi công cụ code review.
Anthropic cũng dùng nhiều adversarial review. Cách này cực kỳ hiệu quả về nhiều mặt, nhưng cũng có thể thiển cận, nên kỹ sư giỏi phải lái Claude tránh over-engineering các phần của hệ thống chỉ để đối phó những lo ngại giả định. Theo nói chuyện này còn tệ hơn khi bạn lấy feedback từ các họ model khác, vì chúng kém trong việc thuyết phục lẫn nhau. Đảm bảo hệ thống review bằng AI không vô tình gây over-engineering và phình scope là một thách thức thật sự. Ví dụ trong bài: một lần review quá phòng thủ về việc tin một service nội bộ khác, khiến Claude thêm validation và độ phức tạp thừa thãi. Thành viên team vẫn review mọi change request cho hệ thống, nhưng giờ họ xem xét ý định (intent) của thay đổi thay vì đọc từng dòng code. Theo: "Ôi, thế giới đã đổi thật rồi."
Họ cũng cải thiện đáng kể khâu tối ưu và chất lượng. Nhờ Claude viết được lượng code khổng lồ nhanh hơn họ nhiều, Scion là một trong những codebase được test và phòng thủ kỹ nhất họ từng làm. Dù tiến độ gấp, họ vẫn dựng được mô phỏng hermetic cho mọi tương tác hạ tầng và source control không tầm thường mà họ từng gặp, cùng fuzzing và rate limiting tinh vi. Theo vẫn sững sờ khi có thể bảo "này Claude, build một fuzzer cho hệ thống này, tìm bug đi", và nó làm thật. Siêu thực.
Claude còn tìm ra những tối ưu đáng kể, ví dụ một tối ưu thuật toán cho truy vấn ancestry vốn bỏ sót một index của họ, thứ mà một chuyên gia sẽ mất vài ngày hay vài tuần phân tích và tinh chỉnh, rồi hôm sau nó lại làm lần nữa. Theo thấy đoạn này buồn cười, vì anh vừa quay video về Gemini 4 Argon: Gemini 4 bịa ra các cột trong bảng SQLite của anh. Đọc xong cả file chứa toàn bộ schema, nó vẫn bắn query vào những cột không tồn tại. Trong khi đó Claude đang tối ưu thuật toán để lách các index bị thiếu. Theo nói thẳng, ở thời điểm video (đăng ngày 16/10/2026): ai bảo Gemini đang ở trạng thái tốt thì không đáng tin với tư cách kỹ sư; nó khá tệ. Rồi anh mỉa thêm: trí tưởng tượng của Gemini thật đáng kinh ngạc, nó bịa giỏi lắm, đúng là một model sáng tạo.
15. Lệnh hằng ngày nhanh hơn bao nhiêu, và bảo mật monorepo
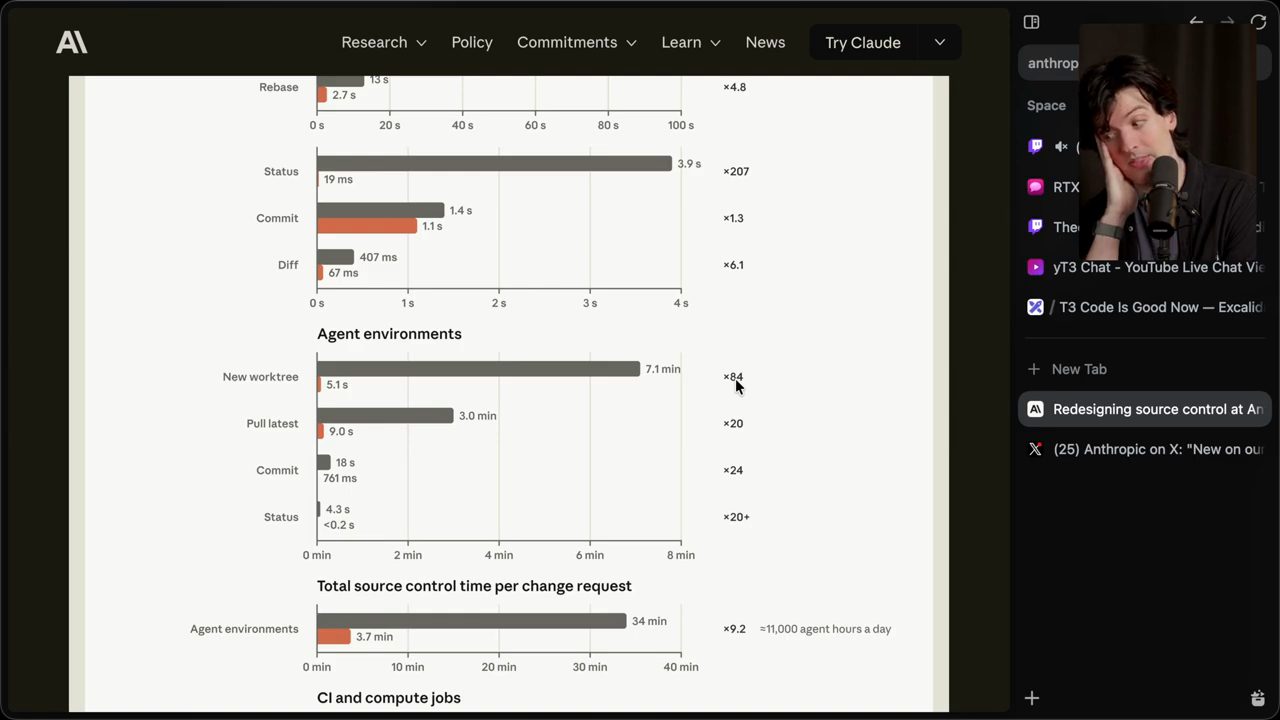
Bài có một biểu đồ so sánh các lệnh source control hằng ngày khi chạy hệ thống scn thay vì Git. Theo đọc lần lượt: pull nhanh hơn 25 lần, checkout nhanh hơn 14 lần, rebase 5 lần, status 207 lần. Commit chỉ nhanh hơn 30%, "thất vọng ghê", nhưng diff nhanh hơn 6 lần. Tới tạo worktree mới, anh kêu lên: đây là một trong những vấn đề lớn nhất, chính T3 Code cũng phải xử lý, vì tạo worktree khi phải clone mọi thứ rất tốn; nhanh hơn 84 lần là một chiến thắng lớn. Pull latest nhanh hơn 20 lần, commit nhanh hơn 24 lần, và status trong môi trường agent nhanh hơn trên 20 lần. Rồi anh nhận ra nhóm đầu là môi trường dev, nhóm sau là môi trường agent, và thấy hợp lý. Theo anh, mọi con số đều là thắng lợi lớn.
Trên biểu đồ, phần môi trường dev ghi: pull latest từ 87 giây xuống 3,5 giây, checkout từ 15 giây xuống 1,1 giây, rebase từ 13 giây xuống 2,7 giây (số đo Anthropic công bố trong bài đăng ngày 13/10/2026).
Ngoài các thắng lợi về performance, họ cũng đặt nền móng cho những dạng bảo mật monorepo mới. Quản lý an toàn, bảo mật và compliance trong một monorepo khổng lồ quan trọng ngang với quản lý kích thước và quy mô. Họ xây Scion với những điều này trong đầu ngay từ đầu: hỗ trợ access control phong phú trên repo, cùng khả năng áp quyền cho từng thư mục để bảo vệ phần code nhạy cảm nhất mà không mất lợi ích của monorepo.
Theo hả hê (bằng những từ nặng hơn): thấy chưa, ai mới là người đúng về chuyện commit biến môi trường; "chuỗi thắng của Theo không bao giờ dứt". Anh nói đang nóng lòng chờ một tài khoản Twitter avatar anime nào đó vào bảo anh sai, vì họ không có việc làm.
Hơn nữa, công cụ code review họ xây có thể biểu diễn những ràng buộc ngữ nghĩa phức tạp lên việc approve, cho phép phân biệt những thứ đơn giản như thay đổi chỉ sửa comment với những thay đổi logic nhạy cảm, để reviewer con người tập trung vào những phần hệ trọng nhất. Theo phản ứng mạnh: bạn không cần làm việc này bằng code. Không cần viết code để phân loại changeset. "Không biết các bạn nghe chưa, có một thứ gọi là Claude: bạn đưa nó code, hỏi một câu, và nhận được câu trả lời." Anh nói đây có lẽ là điểm anh bi quan (bearish) nhất trong cả bài: nếu họ thiếu compute tới mức không chạy Claude để tóm tắt và lọc diff, và thấy cần giải pháp lập trình thay vào, thì có lẽ họ hết compute rồi, và "có lẽ chúng ta tiêu rồi".
16. Uptime và các Claude "superfan"
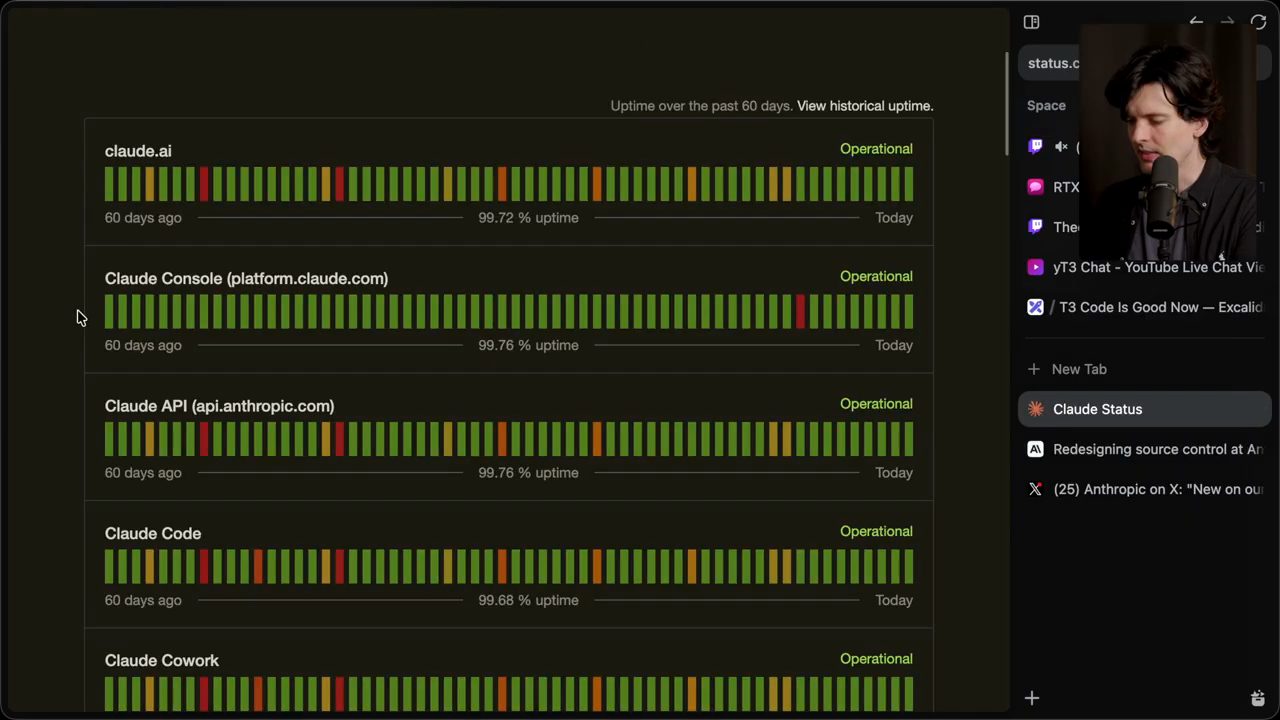
Với tất cả những điều này, họ nói một mức vận hành xuất sắc (operational excellence) mới là khả thi. Và Theo thừa nhận, công bằng mà nói, đúng là vậy. Uptime của họ tốt hơn đáng kể so với trước, khi trước đó nó từng rất tệ. Anh không nhớ lần gần nhất Claude sập là khi nào. Website sập khá thường, nhưng Claude Code và Claude API dạo gần đây khá ổn định (theo video đăng ngày 16/10/2026). Anh nghĩ gần đây mình gặp sự cố với OpenAI và Codex nhiều hơn với Claude, điều khó tin nếu nhớ khoảng cách trước kia lớn thế nào. Nên nếu họ nói hệ thống này giúp vận hành xuất sắc hơn, anh tin, vì họ đang sửa được vấn đề downtime.
Team dùng Claude Tag rất nhiều; Theo giải thích đó là Slack bot mà người ở Anthropic ai cũng mê. Nó giúp họ giám sát từng thành phần của hệ thống. Ví dụ, họ tạo các kênh Slack, giao cho Claude nhiệm vụ ám ảnh với sức khoẻ của đúng một thành phần, và gọi những Claude này là "superfan".
Theo kêu trời vì họ còn gọi chúng là "Claudes" số nhiều: "Đau lòng đấy. Tôi đang bênh các bạn và thấy dễ chịu, giờ các bạn lại làm trò cringe thế này." Anh tưởng tượng một người nói với mình câu "chúng tôi gọi những Claude này là superfan", và thấy mặt người đó còn đáng đấm hơn cả mặt anh.
Họ có một superfan cho scion-daemon, một superfan cho scion-cache, một superfan cho merge queue của Antique, v.v. Chúng có quyền vào telemetry và log, và hành xử như một kỹ sư dày dạn không có việc gì hay hơn là refresh biểu đồ và tìm thứ gì bất thường. Theo: "Đang nói xấu tôi đấy à? Đó là việc của tôi mà." Bài nói họ vẫn có cảnh báo truyền thống, nhưng các superfan phát hiện được những vấn đề tinh tế và mới lạ, khiến các cảnh báo kia trông một chiều khi so sánh. Theo thấy cái này thật sự hay. Và nó ngược hẳn với điều anh nói lúc nãy về chuyện họ tiết kiệm compute bằng giải pháp lập trình: ở đây họ đốt compute cho vui.
17. Suy nghĩ lại các giả định cũ: merge queue ở quy mô agent
Và đây, theo Theo, có lẽ là bài học quan trọng nhất của cả bài: họ đang suy nghĩ lại hoàn toàn những giả định cũ (priors). Theo giải thích: kỹ sư, vì những lý do chính đáng, thường khá cố định trong cách làm, vì để thành kỹ sư đẳng cấp thế giới, bạn cần một hệ thống trong đầu về cách làm việc. Và nói chung, thứ mới nóng hổi, được hype rầm rộ thường không phải lời giải bền vững về lâu dài. Nên nhiều kỹ sư giỏi nhất thế giới đã quen với điều đó và mặc định hoài nghi. Họ tin thứ họ biết và biết là chạy được, và ngại thử cái mới vì đã bị bỏng quá nhiều lần.
Theo nói phải vượt qua điều đó, vì mọi thứ đổi quá nhanh. Bạn phải lật ngược cách nghĩ gần như từ trên xuống dưới. Trước đây, hiểu biết về cái gì chạy, cái gì không dẫn bạn tới việc chọn những công cụ nhất định. Giờ cần làm ngược lại: biết cái gì chạy, cái gì không, chỗ nào vỡ, chỗ nào ổn, và dùng hiểu biết đó để phát minh lại chính những thứ bạn đã tin cả đời là hoàn hảo, cho vừa với nhu cầu của mình. Anh đã viết TypeScript gần một thập kỷ, và đã viết lại chính TypeScript cho vui.
Cách Anthropic giải thích hiện tượng này: dự án khiến họ nhìn rất kỹ vào các workflow khác được thiết kế cho quy mô con người. Một merge queue đúng nghĩa, chẳng hạn, không hợp ở quy mô agent. CI còn nghĩa là gì khi hàng trăm, thậm chí hàng nghìn thay đổi có thể merge trong lúc test đang chạy? Họ không tái tạo hiệu quả được chuẩn công nghiệp là một global lock trên repo cho merge queue, nên thay vào đó họ đầu tư vào automated testing sau khi merge và trước khi deploy.
Theo reo lên: "Thấy chưa! Theo lại đúng." Anh xin lỗi vì lại phấn khích, nhưng người xem không biết anh đã bị công kích bao lâu vì nghĩ rằng khả năng hoàn tác một thay đổi tệ quan trọng hơn việc thêm hàng nghìn lớp chắn phía trước, chỉ để việc tạo ra một thay đổi tệ khó hơn một chút. Rất nhiều nỗ lực kỹ thuật dồn vào chuyện tăng ma sát mãi, để giảm khả năng có gì đó hỏng. Anh thì tập trung làm ma sát thấp nhất có thể, cả để đưa code ra, và quan trọng hơn, để sửa khi có gì hỏng.
Vì dù quy trình chặt đến đâu, bạn vẫn sẽ ship thứ bị hỏng, anh không quan tâm bạn là ai. Nếu bạn thật sự nghĩ mình sẽ không bao giờ ship code hỏng, hay đã xây hệ thống theo cách không bao giờ có bug, anh mỉa rằng mong tầng hầm nhà mẹ bạn không quá bí. Vì ngoài đời thật mọi thứ đều hỏng, và khi hỏng bạn cần sửa. Tập trung vào cách sửa và giảm thiệt hại mà thứ hỏng gây ra là cực kỳ quan trọng.
Bài cũng nói làm theo cách này thì đôi khi các thay đổi đồng thời xung đột nhau, nhưng Claude thường sửa những xung đột đó nhanh hơn cả lúc con người kịp nhận ra chúng. Theo nói anh đã nghĩ rất nhiều về điều này. Ý tưởng của anh: nếu merge queue không phải là các PR cần merge lần lượt, mà là một danh sách rất chung kiểu "đây là những thứ chúng ta vui lòng cho vào", rồi "Claude ơi, land hết đống này" thì sao? Khi một thứ đã có thumbs up để merge, Claude cố squash càng nhiều mảnh càng tốt thành từng nhóm, rồi đưa vào main hiệu quả nhất có thể, xử lý xung đột trên đường đi. Vì Claude xử lý merge conflict đã giỏi hơn anh.
18. Đóng góp cho hệ sinh thái, và vì sao Scion không được open source
Rồi tới một đoạn kết thú vị: đóng góp cho hệ sinh thái rộng hơn. Họ xem Scion chỉ là một phần câu trả lời cho những lo ngại về scale mà các agent AI ngày càng giỏi đặt ra. Họ chia sẻ chi tiết như một ví dụ về cách các team xử lý thách thức tương tự, nhưng không kỳ vọng giải pháp hay các cân nhắc của họ hợp với mọi trường hợp. Họ nói rõ Scion hoàn toàn không phải thứ thay thế được Git cho mục đích chung. Những khái niệm trong bài chỉ thật sự hợp với monorepo cực lớn, có hàng chục nghìn kỹ sư hoặc những bầy agent viết code không ngừng. Thêm nữa, Anthropic đặc biệt ở chỗ khả năng chi token cho dùng nội bộ của họ vượt xa mức bất kỳ doanh nghiệp nào khác thực tế muốn chi.
Theo: "Không ngờ có ngày thấy câu này." Công bằng mà nói, như anh đã nói nhiều lần, token đang rẻ đi, rẻ hơn rất nhiều; một mức trí tuệ nhất định đạt được với giá ngày càng thấp. Anh lấy ví dụ: bản Fable viết lại Bun sang Rust tốn cỡ hơn 300K cho token Fable, còn anh tự làm một bản viết lại táo bạo hơn, TypeScript sang Rust, với khoảng 20.000 tới 25.000 đô token Opus 5.5 (số liệu theo video đăng ngày 16/10/2026). Tốc độ giá giảm thật điên rồ. Nên theo anh, hoàn toàn có thể tới thời điểm này năm sau, bạn tự viết được một thứ tương tự Scion, một lựa chọn thay Git cho công ty mình, chỉ với vài nghìn đô token (dự đoán của Theo trong video đăng ngày 16/10/2026).
Bài cũng nói một điều quan trọng cần hiểu: họ làm việc này vừa để giải quyết nhu cầu phát triển phần mềm của chính họ, vừa để thử xem Claude làm được tới đâu. Về thực tế, rất khó đưa Scion ra ở dạng hữu ích rộng rãi cho tổ chức khác. Nó khác Git nhiều, nghĩa là các công ty sẽ phải chuyển mọi mảnh của vòng đời phát triển, và nó cần code review, code search và CI riêng. Các phiên bản nội bộ của những thành phần này rất may đo, khó cho tổ chức khác áp dụng, và họ lo rằng cố xây một bản public làm hài lòng tất cả sẽ không thật sự hữu ích.
Theo nói anh biết đoạn này nằm đây để làm gì, và kể một kịch bản anh tưởng tượng. Nội bộ đã có cuộc bàn xem có bán được thứ họ xây không. Những người xây nó nói không đời nào, và đây là mọi lý do vì sao không hợp lý. Bộ phận enterprise sales chắc cuối cùng chịu thua: thôi được, không cần bán. Rồi khi họ muốn viết bài về nó, bộ phận truyền thông bảo khoan đã, người ta sẽ hỏi xin cái này, nên họ phải gom mọi lập luận nội bộ lại viết thành đoạn này, để giờ anh đọc cho người xem lý do vì sao họ không open source nó.
Thêm lý do nữa: họ dự đoán lớp vấn đề này sẽ phổ biến hơn trong 6 tới 12 tháng tới, và sẽ là lãng phí nguồn lực kỹ sư (Theo chen thêm: và cả token) nếu mọi công ty dùng Git phải tự đối mặt một mình. Vì thế họ nghĩ việc có tác động lớn nhất là chia sẻ cách nghĩ, để các developer khác áp dụng những phần thành công nhất của Scion vào Git mà không phải rời bỏ mô hình tổng thể. Một Git server không cần chạy giống như Git client; đã có những kiến trúc server mới cho cải thiện scale đáng kể. Các nền tảng Git có thể cung cấp RPC phía server toàn diện như Scion, thậm chí theo cách chuẩn hoá giữa các forge, để Git client học cách nói chuyện cùng. Giao thức negotiation cũng không cần y như cách nó đang chạy, và các tính năng sparse, shallow trong Git có thể được làm cho kết hợp tốt với nhau.
Cuối cùng, họ ghi nhận cộng đồng Git đã mất gần hai thập kỷ để scale nền tảng cho hàng triệu developer; đóng góp của họ hẹp hơn nhiều: chia sẻ góc nhìn sớm về cách phát triển phần mềm agentic tương tác với các hệ thống này, để họ có thể hợp tác với GitHub, GitLab và cộng đồng open source, hỗ trợ những nhu cầu đang thay đổi của developer. Câu kết của bài: tất cả chúng ta cùng ở trong chuyện này, khi vòng đời phát triển phần mềm giao với đường cong hàm mũ của AI.
Theo kết lại: thật lạ khi một chuyện như thế này một năm trước nghe như trò hề, còn giờ gần như "ừ, đương nhiên rồi, hợp lý lắm". Anh nói sẽ đi chống lại cơn thôi thúc tự làm một bản Git của riêng mình; sẽ khó đấy, nhưng anh sẽ cố. Anh hy vọng người xem thích deep dive này; bản thân anh rất thích những bài "nerdy rant" kiểu này, và đây là một bài rất vui khi được đi sâu vào cách source control vận hành và cách làm nó scale theo cách agent cần. Anh hỏi người xem còn thích những deep dive như vậy không, hay chỉ muốn xem anh vibe code nhiều hơn, mời để lại ý kiến trong phần bình luận, rồi chào tạm biệt theo kiểu quen thuộc: "Peace nerds".
Nguồn và liên kết 7 nguồn
- Tên gốc: Anthropic Rebuilt Git (yes really)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=hiI0Vk4NgeY youtube.com
- Kênh YouTube Theo - t3․gg (Theo Browne): youtube.com/channel/UCbRP3c757lWg9M-U7TyEkXA youtube.com
- Bài gốc của Anthropic mà Theo đọc trong video, "Redesigning source control at Anthropic" (đăng ngày 13/10/2026, cập nhật 15/10/2026): anthropic.com/engineering/redesigning-source-control anthropic.com
- Sapling, hệ thống source control của Meta mà bài viết nhắc tới như tiền lệ cho Scion: sapling-scm.com sapling-scm.com
- JJ (Jujutsu), hệ thống version control Theo tìm hiểu hồi tháng 12: github.com/jj-vcs/jj github.com
Related talks
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.
Sáu skill Claude Code đáng dùng nhất sau hơn 100 skill đã thử
Tim Ruscica · Tech With Tim · 19 min
Cài và dùng thử sáu skill cho Claude Code: gstack, Hostinger MCP, Firecrawl, Humanizer, Composio và VibeSec, mỗi cái một demo thật.
10 plugin Claude Code đáng dùng cho project tiếp theo
Chase Hannegan · Chase AI · 12 min
Mười plugin, skill và CLI mới cho Claude Code: Graphify, grill-me, review plan bằng Codex, Obsidian, CLAUDE.md, Impeccable, NotebookLM, n8n MCP.