Building Deterministic Infrastructure for Non-Deterministic AI Agents
AI Engineer World's Fair 2026: Online Track · Video gốc
Model là stochastic nhưng infrastructure phải deterministic: retry storm, model chỉ đề xuất, agent control plane, trace, memory consistency và safety nhiều lớp.
1. Bài toán không còn là trí thông minh, mà là reliability
Nishant Gupta tự giới thiệu: anh là software engineering tech lead ở Meta, làm hạ tầng AI cho cả training lẫn inference. Chủ đề hôm nay là xây dựng deterministic infrastructure (hạ tầng chạy có tính xác định, dự đoán được) cho những AI agent vốn non-deterministic (không xác định: cùng đầu vào có thể ra hành vi khác nhau).
Anh mở bằng một nhận xét về hướng của cả ngành. Mấy năm qua, phần lớn các cuộc nói chuyện về AI xoay quanh model: model lớn hơn, nhiều parameter hơn, reasoning tốt hơn. Nhưng khi các tổ chức chuyển từ chatbot sang autonomous agent, một vấn đề khác hẳn xuất hiện. Thách thức không còn là trí thông minh nữa. Thách thức là reliability (độ tin cậy).
Ở Meta và trên toàn ngành, anh thấy agent đã vượt khỏi việc trả lời câu hỏi. Chúng bắt đầu lập kế hoạch (plan), gọi tool, điều phối workflow và đưa ra quyết định có ảnh hưởng tới hệ thống production. Những hệ thống này về bản chất là probabilistic (xác suất). Còn infrastructure thì không được phép như vậy. Đó là mâu thuẫn mà phần còn lại của talk sẽ đi sâu.
2. The great mismatch: hạ tầng xây cho microservice dễ đoán
Hạ tầng cloud hiện đại tiến hoá quanh một bộ giả định. Phần lớn request sống rất ngắn. Service thì, ít nhiều, là deterministic. Đường đi của việc thực thi (execution path) đã biết trước. Lỗi thì có giới hạn (bounded): ta biết lỗi có thể lớn tới đâu.
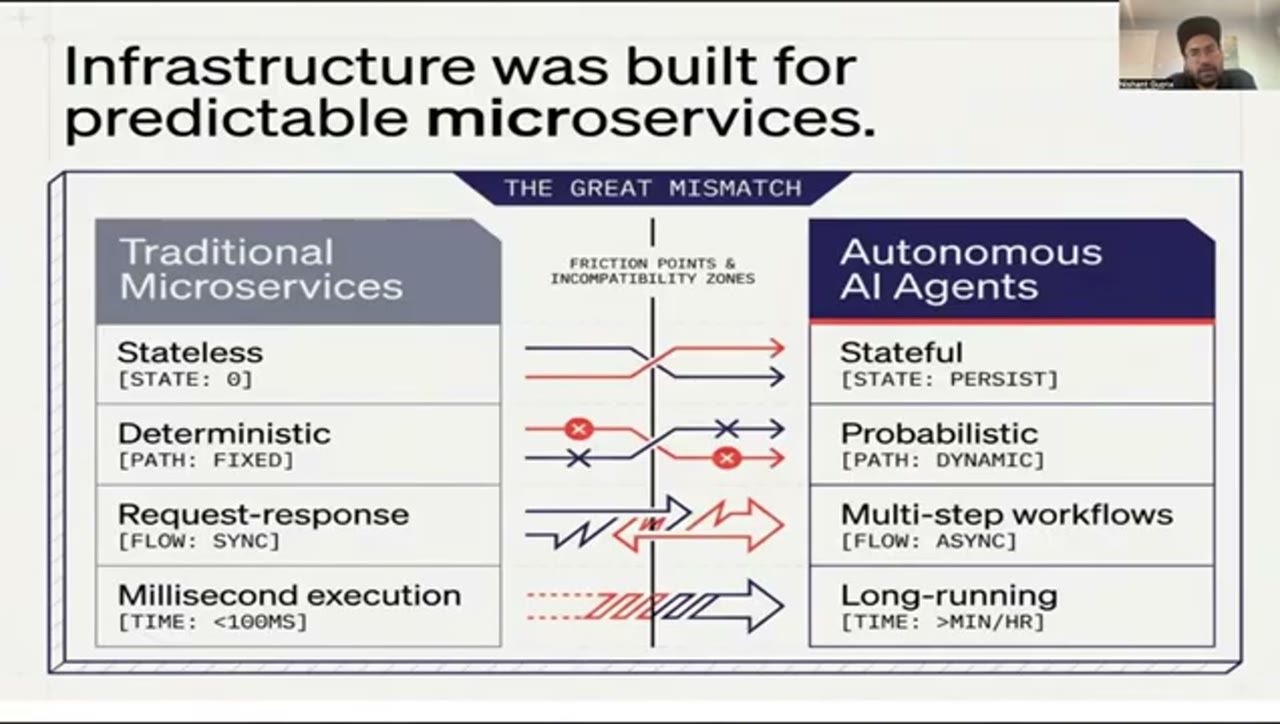
Autonomous AI agent vi phạm gần như mọi giả định đó. Chúng stateful (giữ trạng thái), chúng chạy lâu (long-running). Chúng ra quyết định một cách động. Và chúng có thể chạy những workflow khác nhau cho cùng một đầu vào. Nishant gọi đây là "the great mismatch", sự lệch pha lớn: ta đang cố chạy hệ thống tự hành trên một hạ tầng được thiết kế cho workflow deterministic.
3. Demo tối ưu cho capability, production đòi reliability
Theo anh, đây có lẽ là thay đổi tư duy quan trọng nhất. Phần lớn demo AI phô diễn capability (năng lực): nó có giải được vấn đề không? Nó có dùng được tool không? Nó có hoàn thành được một workflow không?
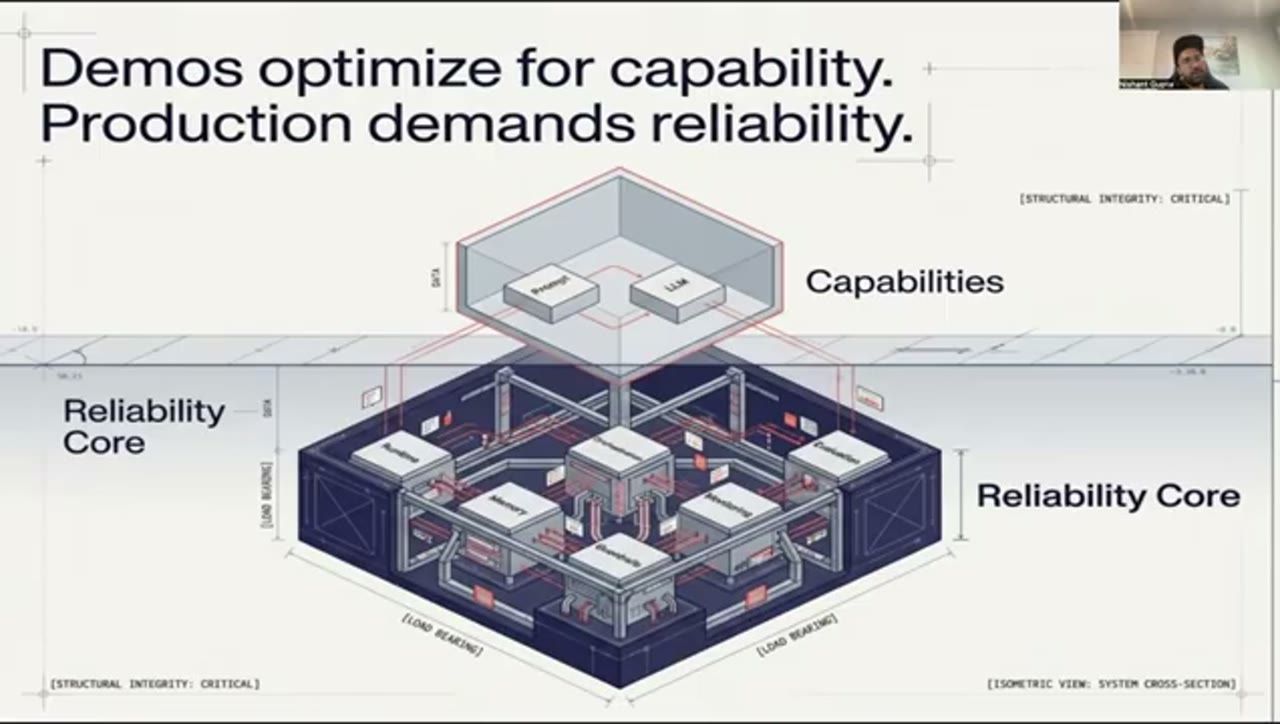
Hệ thống production có mục tiêu khác. Nó có làm được việc đó một cách đáng tin cậy không? Làm được mười nghìn lần không? Một trăm nghìn lần? Một triệu lần? Nó có tự phục hồi sau lỗi không? Nó có vận hành an toàn không? Nó có làm được với chi phí chấp nhận được, latency chấp nhận được, và kết quả chấp nhận được không?
Vì vậy phần lớn công sức engineering dời xuống dưới tầng model: vào orchestration, monitoring, safety, evaluation và các hệ thống recovery (phục hồi).
4. Lỗi thật trong production sinh ra ở infrastructure, không phải ở model
Khi nghe tới "AI failure", người ta lập tức nghĩ tới hallucination. Trong thực tế, theo Nishant, hallucination thường là kiểu lỗi kém thú vị nhất. Thứ anh thấy thay vào đó là các lỗi hạ tầng: recursive reasoning loop (vòng reasoning lặp đệ quy), log bị tràn (overflowed log), retry amplification (retry khuếch đại), context corruption (context bị hỏng), memory poisoning (memory bị đầu độc), và cost explosion (chi phí bùng nổ).
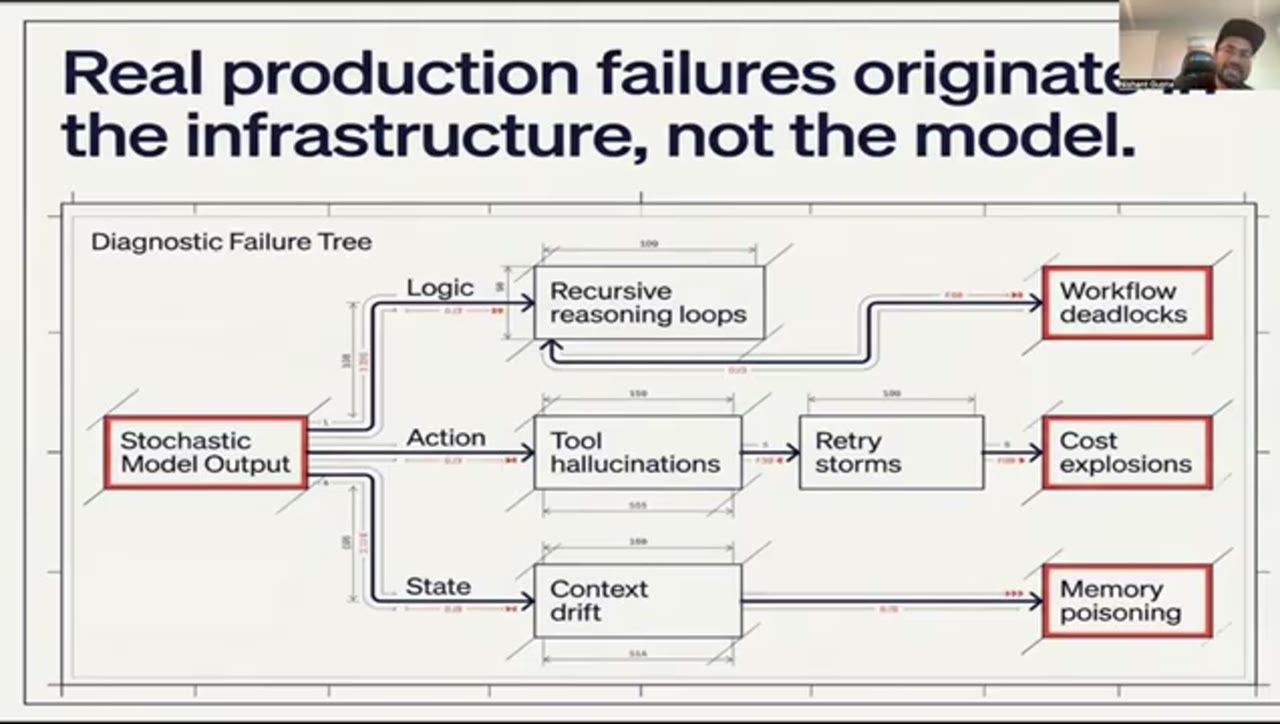
Câu chốt của phần này: model mắc lỗi, nhưng chính infrastructure mới biến lỗi đó thành một sự cố ngừng dịch vụ (outage). Đó mới là thách thức thật.
5. Giải phẫu một retry storm
Slide tiếp theo, theo anh, cho thấy một pattern mà kỹ sư distributed systems có lẽ sẽ nhận ra ngay. Một agent gọi tool sai. Tool trả về lỗi. Thay vì phục hồi, agent sinh ra một request hơi khác đi nhưng vẫn không hợp lệ. Chu trình lặp lại.
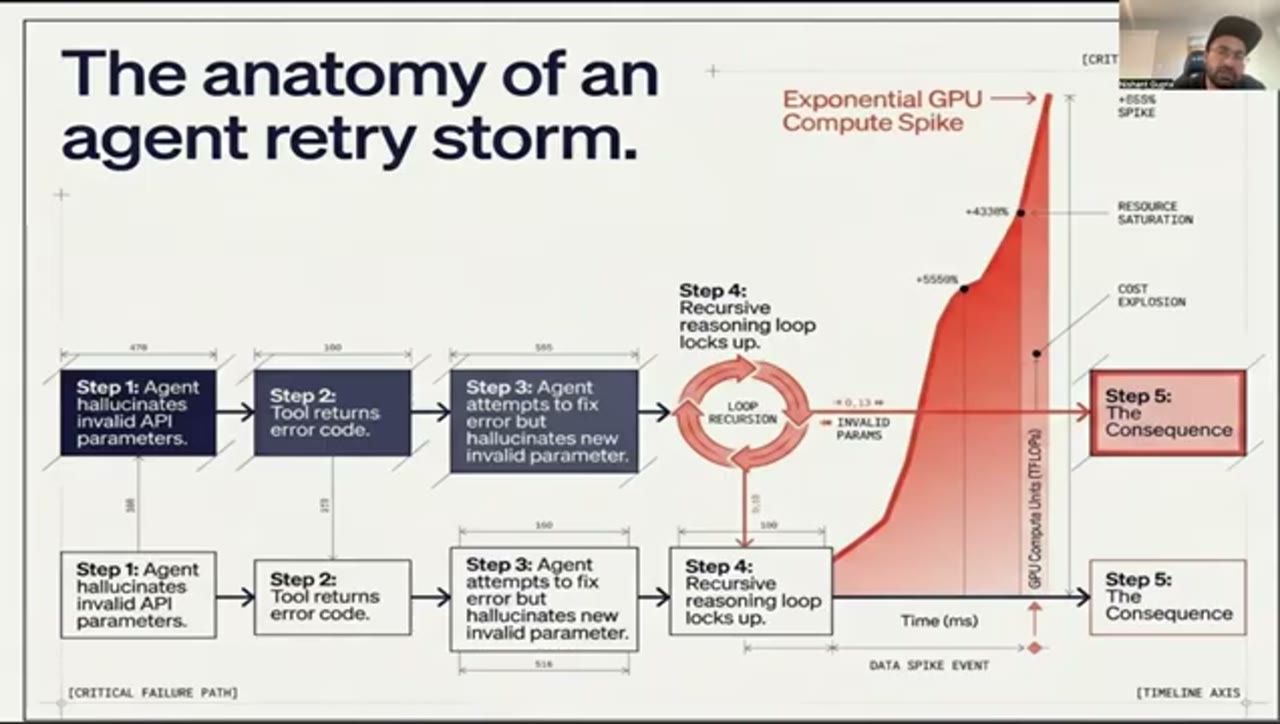
Mỗi lần retry lại tốn thêm compute. Độ sâu reasoning tăng lên. Mức tiêu thụ GPU tăng lên. Cuối cùng ta có tài nguyên tăng theo hàm mũ. Thứ khởi đầu chỉ là một lỗi API nhỏ đã trở thành một sự cố compute. Đây là lý do retry không kiểm soát là một trong những rủi ro lớn nhất của hệ thống agentic.
Với ai từng vận hành distributed system, hình ảnh này rất giống "retry storm" kinh điển: client đồng loạt retry vào một service đang yếu và làm nó sập hẳn. Khác biệt ở đây là mỗi lần retry của agent không rẻ như một HTTP request, mà là thêm một lượt reasoning trên GPU.
6. Platform quyết định, model chỉ đề xuất
Đây là nguyên tắc kiến trúc mà Nishant khuyến nghị mạnh nhất: đừng bao giờ để model trực tiếp điều khiển hệ thống production.
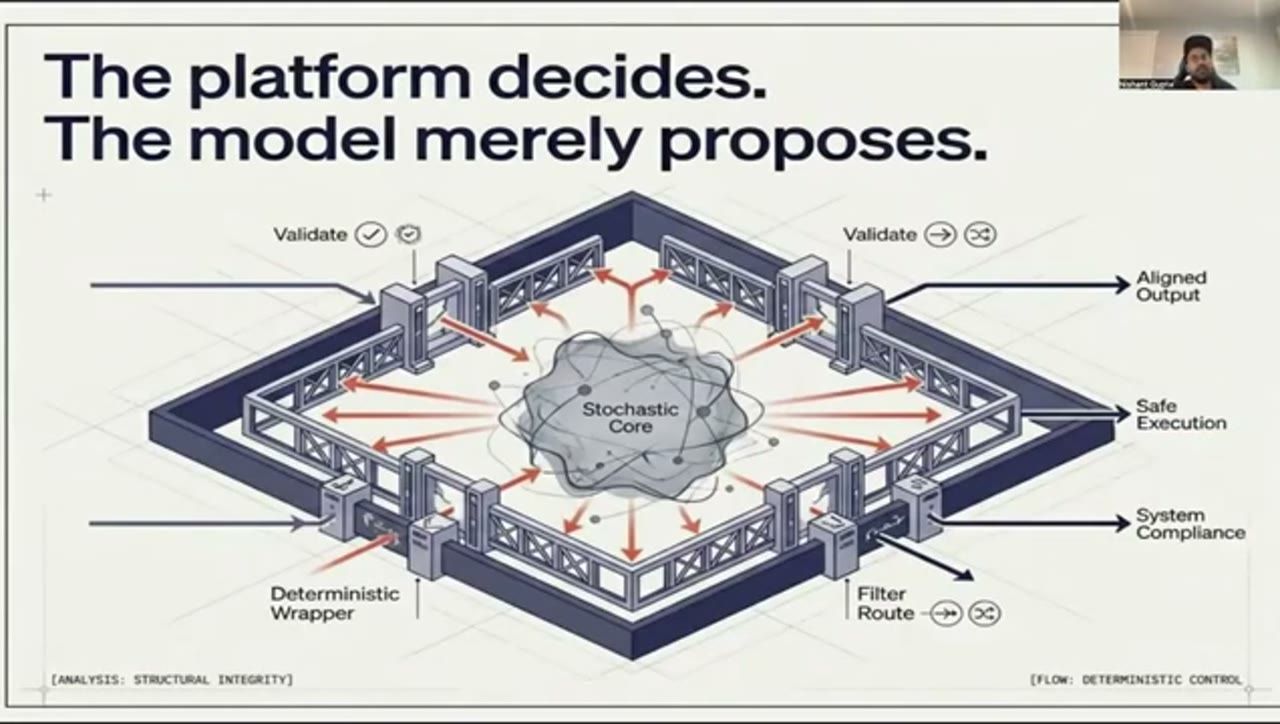
Model nên sinh ra đề xuất (proposal). Infrastructure kiểm tra (validate) đề xuất đó. Một policy engine phê duyệt nó. Một execution gateway thực thi nó, đúng trong giới hạn đã duyệt. Model chỉ gợi ý. Platform mới là bên quyết định.
Sự tách bạch này cho phép xây hệ thống đáng tin cậy ngay cả khi model bên dưới vẫn là probabilistic. Nói cách khác, ta không cần model trở nên deterministic; ta chỉ cần mọi thứ model chạm tới phải đi qua những lớp deterministic.
7. Agent control plane: lớp hạ tầng mới
Nishant đặt agent vào một chuỗi lịch sử quen thuộc. Container đã sinh ra Kubernetes. Microservice đã sinh ra service mesh. AI agent đang sinh ra một thứ mới: agentic control plane.
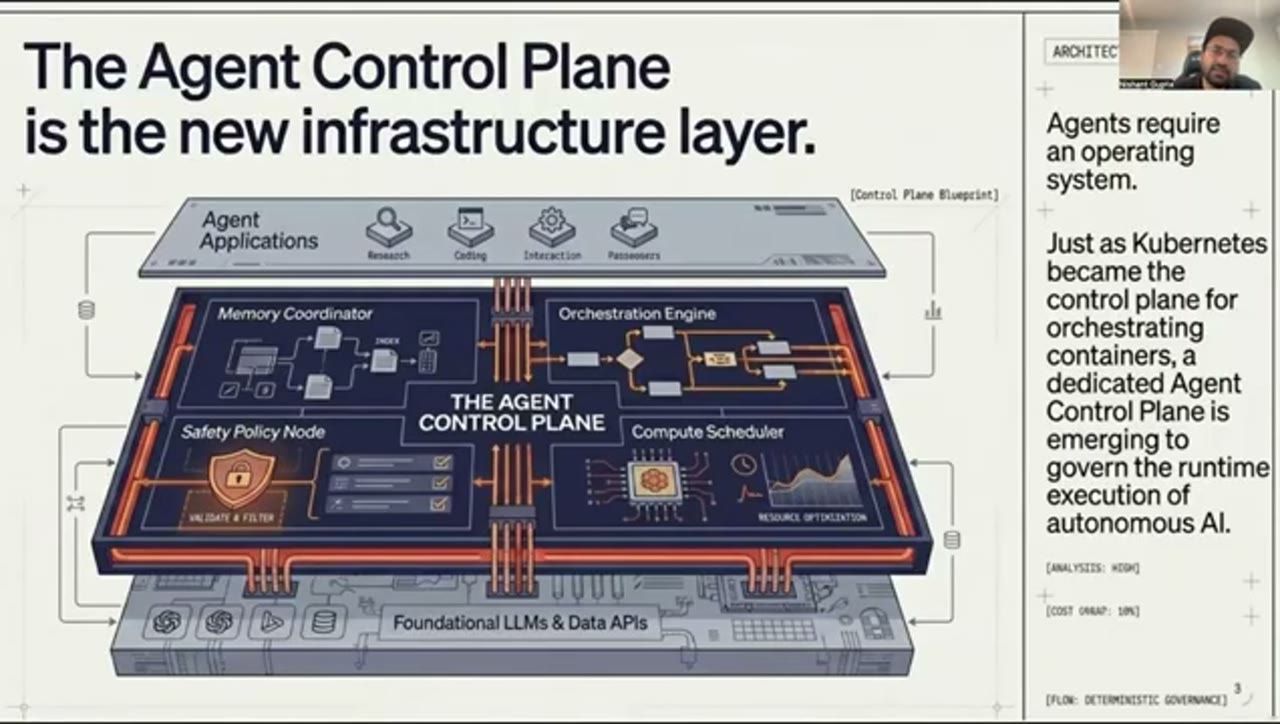
Lớp này chịu trách nhiệm scheduling, điều phối memory, thực thi policy, evaluation, monitoring và workload routing (định tuyến workload), cái cuối anh nhấn mạnh là rất quan trọng. Hãy nghĩ về nó như một hệ điều hành cho AI tự hành.
Anh dự đoán những tổ chức xây được lớp này sẽ có lợi thế cạnh tranh lớn hơn đáng kể.
8. Log là chưa đủ: observability nhiều chiều bằng trace
Log truyền thống cho ta biết điều gì đã xảy ra. Hệ thống agentic đòi hỏi hiểu vì sao nó xảy ra. Ta cần trace ghi lại quyết định lập kế hoạch (planning decision), tool call, memory lookup và chuyển trạng thái (state transition).
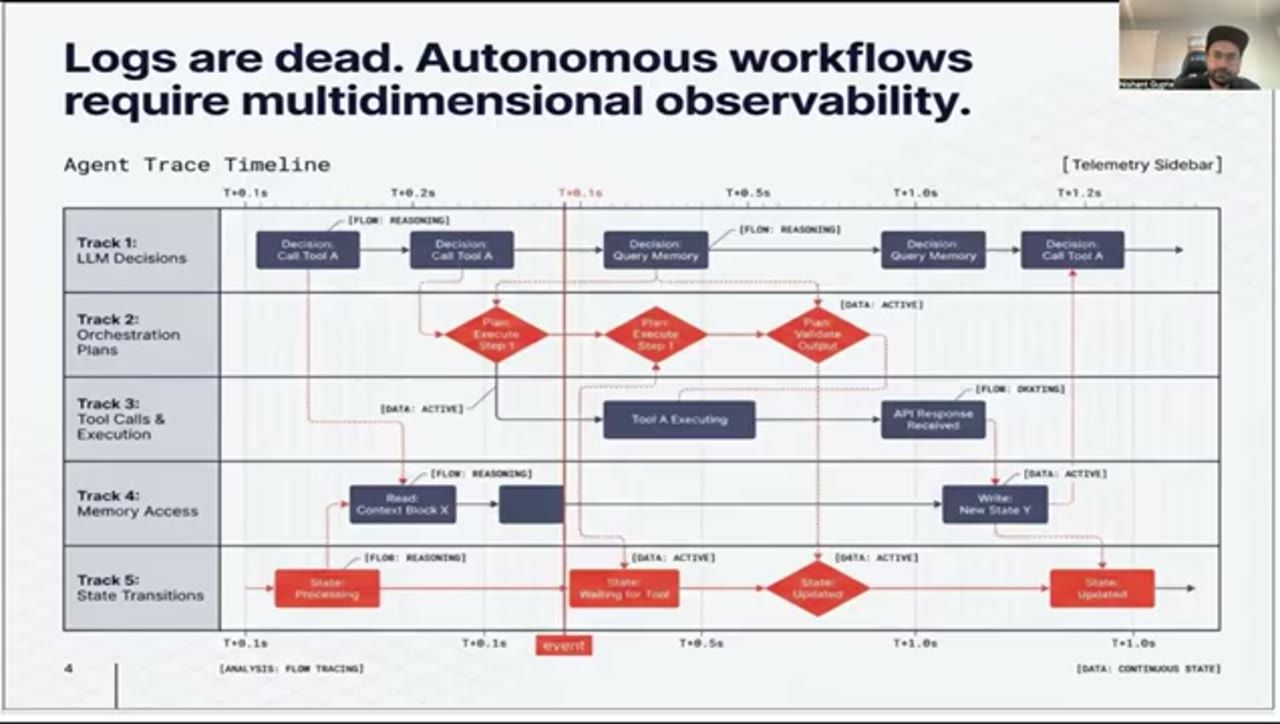
Khi debug một workflow tự hành, hiểu được chuỗi quyết định và reasoning thường quan trọng hơn chính output cuối cùng. Observability trở thành nhiều chiều. Thiếu nó, debug trên production gần như là bất khả thi.
9. Shared memory và bài toán consistency giữa nhiều agent
Memory, theo Nishant, là một trong những thách thức bị đánh giá thấp nhất trong kiến trúc agentic. Một khi nhiều agent cùng chia sẻ state, các vấn đề quen thuộc của distributed systems xuất hiện: stale read (đọc dữ liệu cũ), conflicting update (cập nhật xung đột), context drift (context trôi lệch), và inconsistent view (mỗi bên thấy một phiên bản khác nhau).
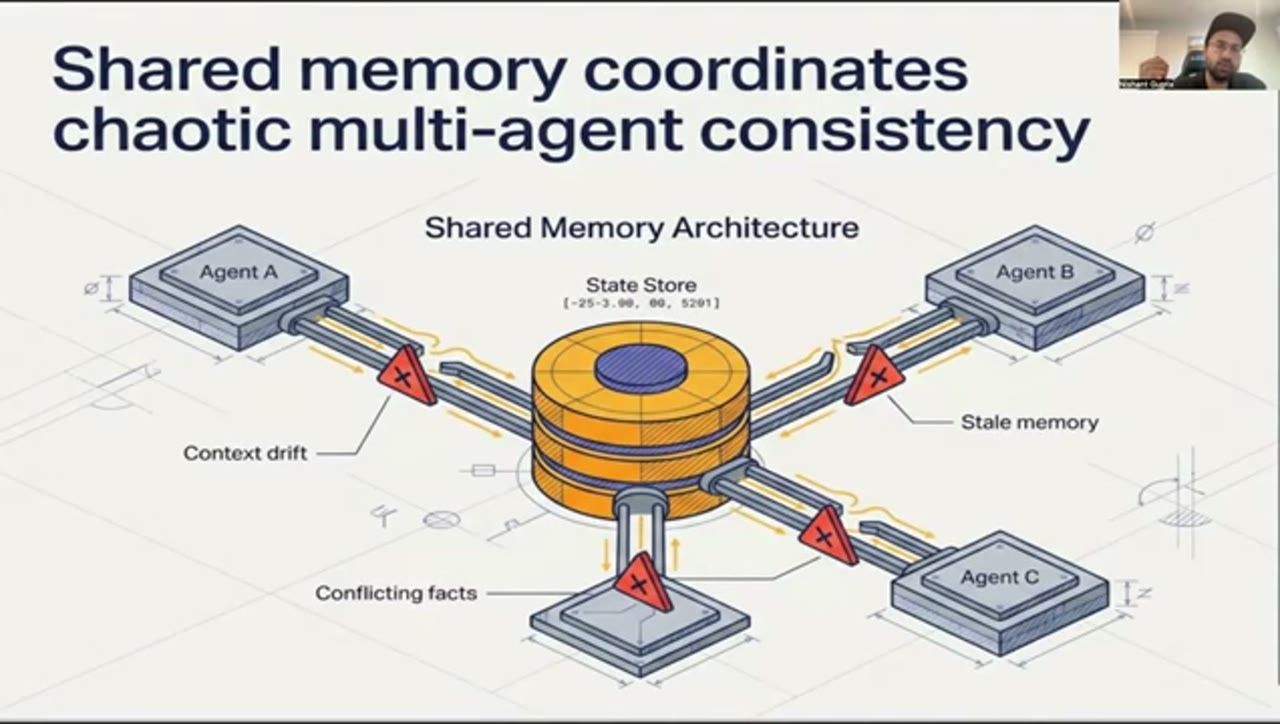
Thách thức còn khó hơn khi chính memory cũng có thể mang tính xác suất và dựa trên retrieval: cùng một câu truy vấn chưa chắc lấy về cùng một mẩu ký ức. Kết luận của anh: rất nhiều lỗi trong hệ multi-agent thực ra là lỗi consistency đội lốt lỗi reasoning.
10. Safety phải xếp thành nhiều lớp
Safety không thể là một thành phần đơn lẻ. Nó phải được xếp lớp: kiểm soát ở mức prompt, quyền dùng tool (tool permission), kiểm tra bằng policy (policy validation), phê duyệt của con người (human approval), và hệ thống audit.
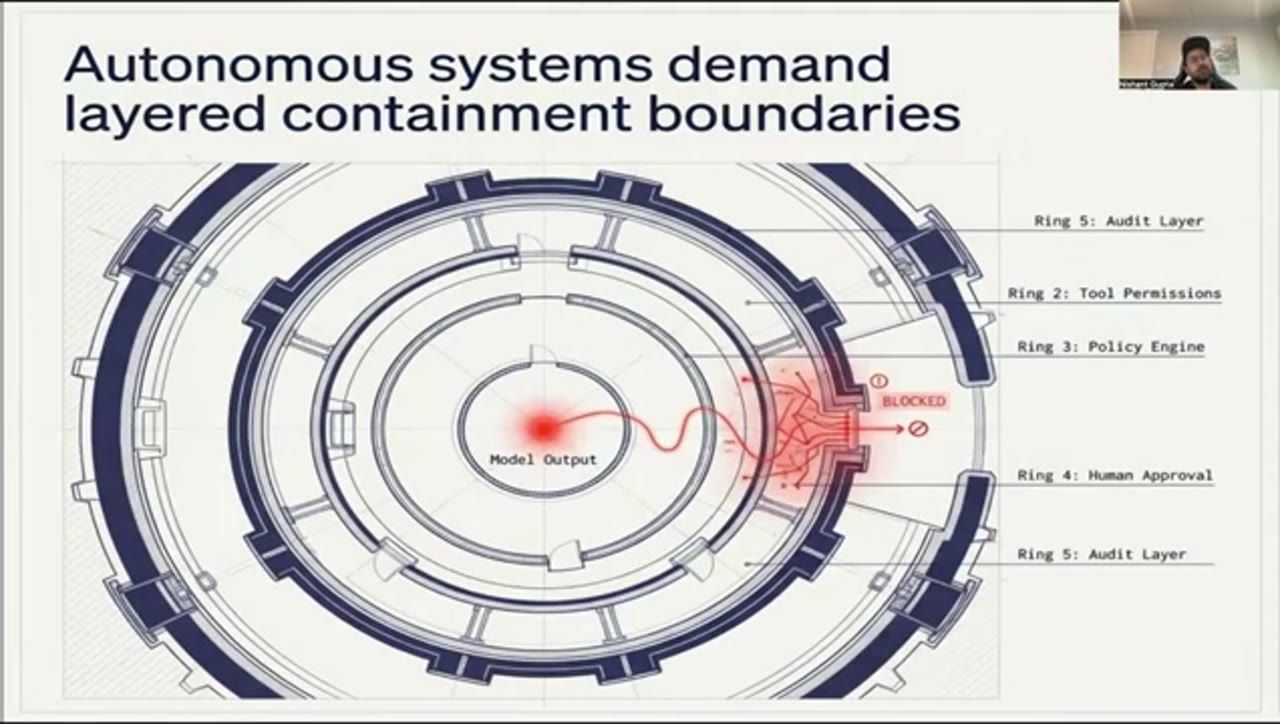
Mỗi lớp bắt một nhóm lỗi khác nhau. Defense in depth (phòng thủ theo chiều sâu) là một nguyên tắc bảo mật đã được hiểu rõ từ lâu, và nó áp dụng tốt y như vậy cho hệ thống AI tự hành: một lớp lọt thì lớp sau vẫn còn cơ hội chặn.
11. Con người là đường escalation, không phải nút thắt
Nhiều người nhìn sự tham gia của con người như một thứ cần thiết tạm thời, rồi sẽ bỏ đi khi model đủ giỏi. Nishant không nghĩ vậy là đúng. Theo anh, những hệ thống thành công nhất nhiều khả năng sẽ tiếp tục có con người giám sát (human supervised).
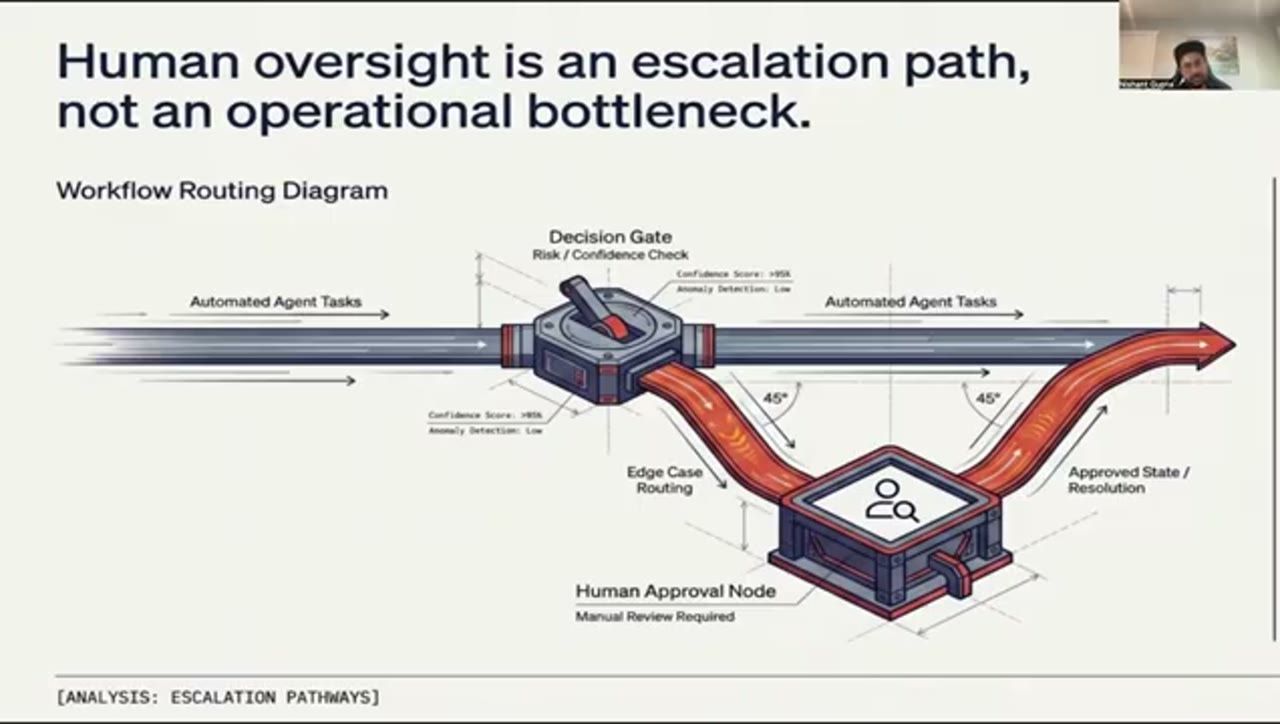
Con người trở thành người xử lý ngoại lệ (exception handler). Họ xem xét các tình huống mơ hồ. Họ xử lý các kịch bản mới chưa từng gặp. Họ cung cấp tín hiệu hiệu chỉnh (calibration signal) cho hệ thống. Mục tiêu không phải là loại bỏ con người. Mục tiêu là phân bổ sự chú ý của con người vào đúng chỗ nó tạo ra nhiều giá trị nhất.
12. Inference ở quy mô lớn thành bài toán cluster scheduling
Một trong những thay đổi hạ tầng lớn nhất là workload AI ngày càng giống bài toán cluster scheduling. Demand đến theo từng đợt (bursty). Độ sâu reasoning không đoán trước được. Workflow có thể chạy hàng phút thay vì vài mili giây. Nhu cầu tài nguyên dao động rất mạnh.
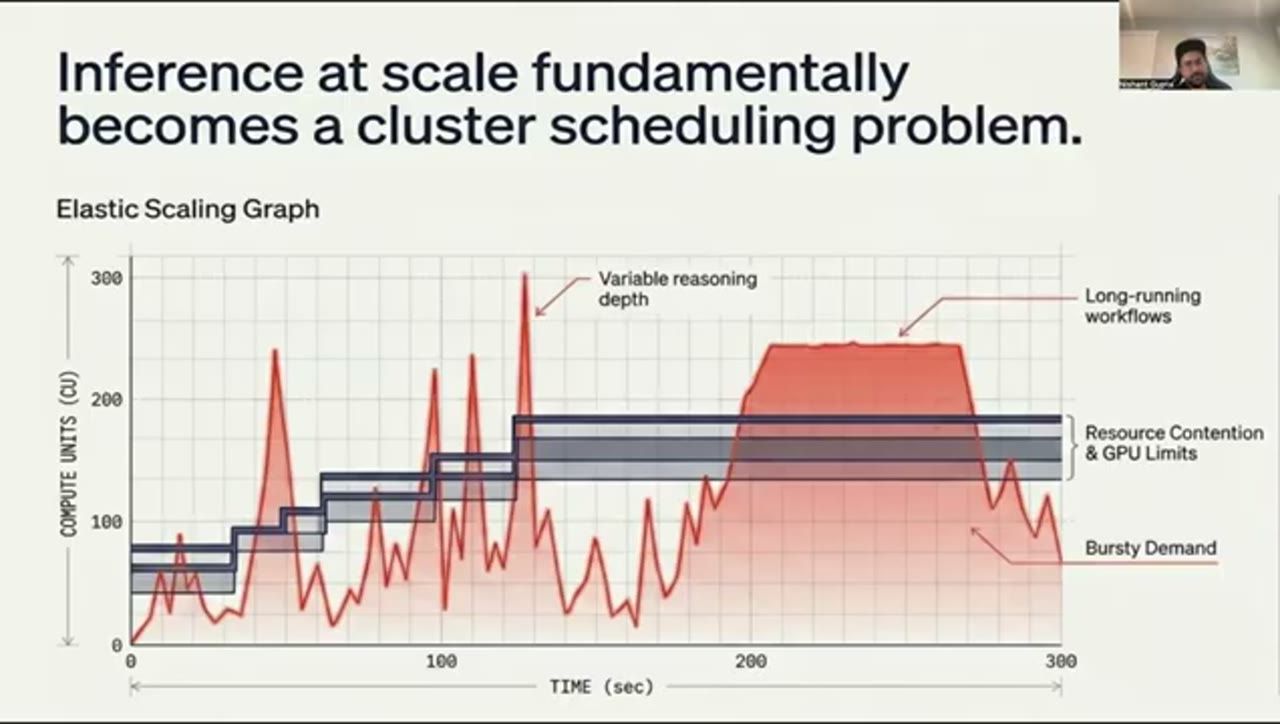
Hệ quả là GPU efficiency, workload placement (đặt workload lên đúng máy), elastic capacity management (co giãn capacity) và scheduling trở nên then chốt. Inference không còn chỉ là chuyện của model; nó trở thành một bài toán điều phối tài nguyên (resource orchestration).
13. Reliability Rosetta Stone: pattern cũ cho bài toán mới
Tin tốt là nhiều vấn đề trong số này không hoàn toàn mới. Distributed systems đã giải những bài toán tương tự suốt nhiều thập kỷ. Nishant đưa ra một bảng "dịch" từ pattern quen thuộc sang phiên bản cho agent:
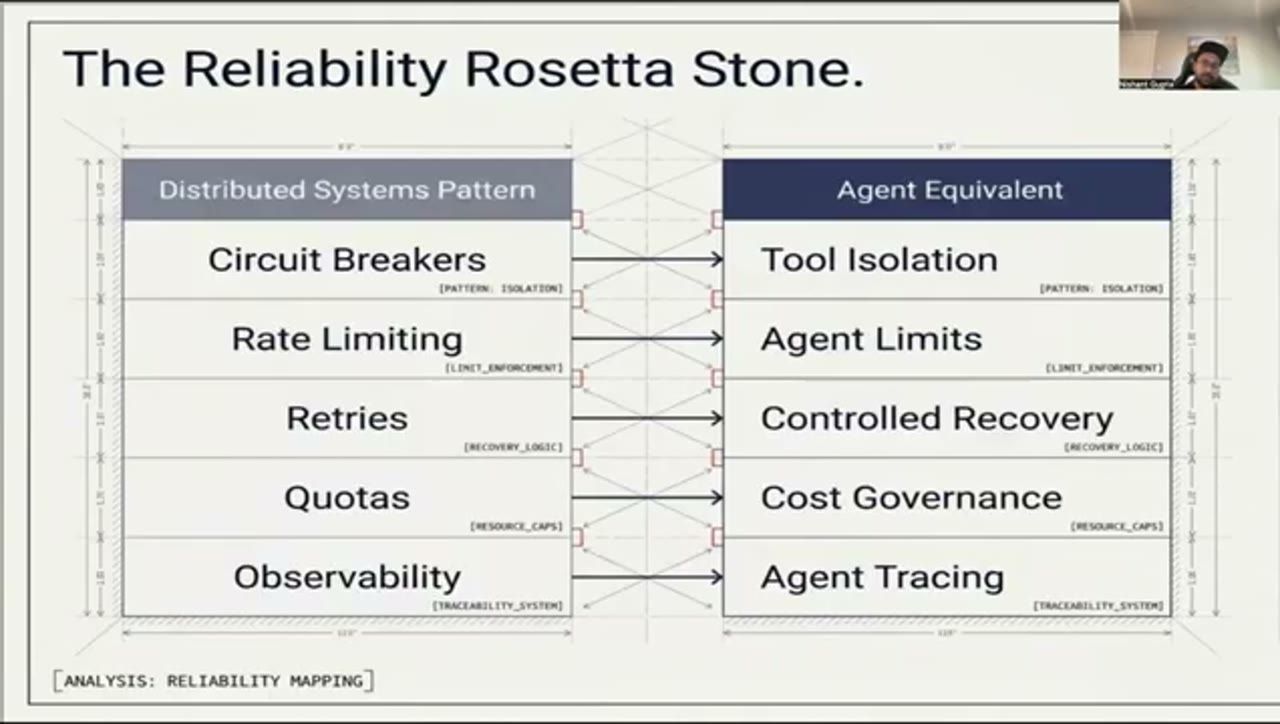
- Circuit breaker thành tool isolation: một tool đang lỗi thì bị cô lập, agent không được gọi nó liên tục (khái niệm circuit breaker: bài của Martin Fowler).
- Rate limit thành agent limit: giới hạn số việc một agent được làm.
- Retry thành controlled recovery: phục hồi có kiểm soát thay vì retry vô tận như ở phần retry storm.
- Resource quota thành cost governance: hạn mức tài nguyên trở thành quản trị chi phí.
- Observability thành agent tracing.
Thay vì phát minh ra một hạ tầng hoàn toàn mới, ta có thể chuyển thể những pattern reliability đã được kiểm chứng sang cho hệ thống tự hành. Chương Handling Overload trong sách SRE của Google là một ví dụ tài liệu kinh điển về các pattern quá tải như vậy.
14. Lợi thế cạnh tranh dời từ prompt engineering sang systems engineering
Ngành đã đi qua vài giai đoạn. Ban đầu, prompt là yếu tố tạo khác biệt. Rồi model trở thành yếu tố tạo khác biệt. Giờ thì cả hai đang nhanh chóng bị commodity hoá (trở thành hàng phổ thông ai cũng có). Biên giới tiếp theo là infrastructure.
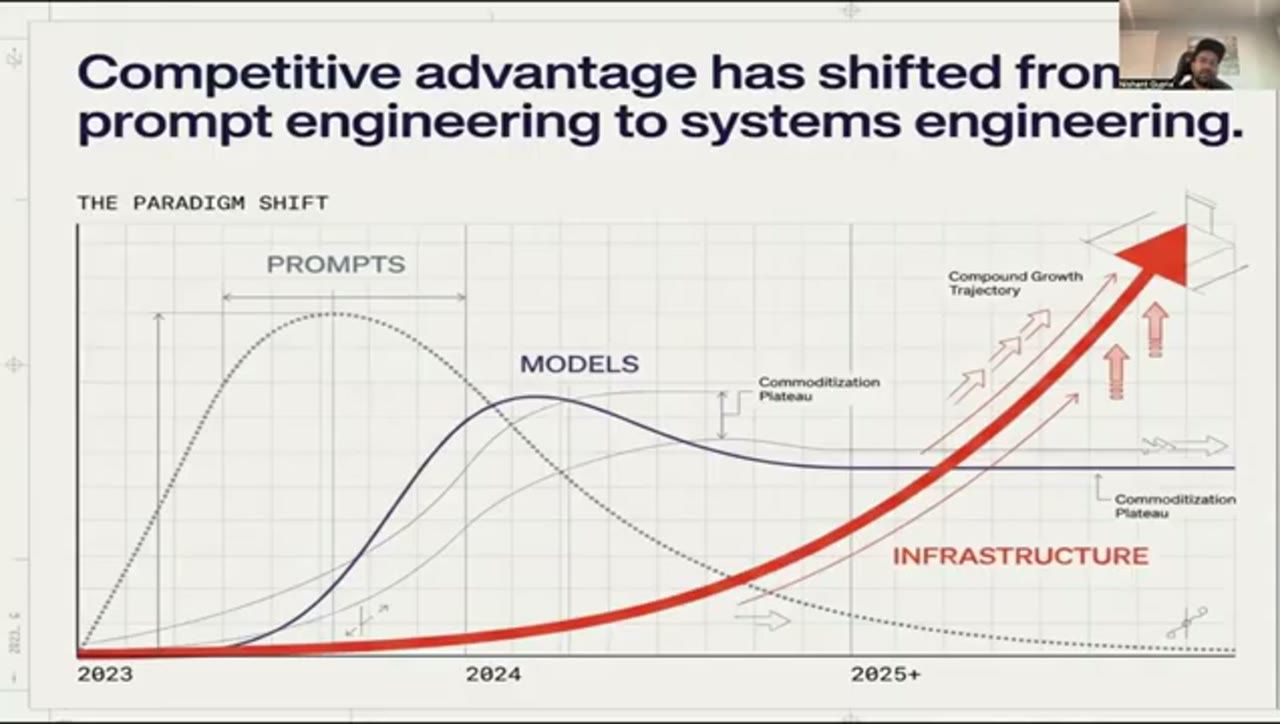
Tổ chức chiến thắng sẽ không nhất thiết là tổ chức có prompt tốt nhất. Họ sẽ là tổ chức có hệ thống đáng tin cậy nhất. Lợi thế cạnh tranh đang dịch chuyển lên trên stack.
15. Kết: AI agent là distributed system, hãy đối xử đúng như vậy
Nếu chỉ nhớ một điều, Nishant muốn đó là: AI agent nên được đối xử như distributed system. Model là stochastic (ngẫu nhiên). Infrastructure phải deterministic. Reliability ngày càng là một bài toán infrastructure. Observability là bắt buộc. Control plane đang nổi lên thành lớp nền móng.
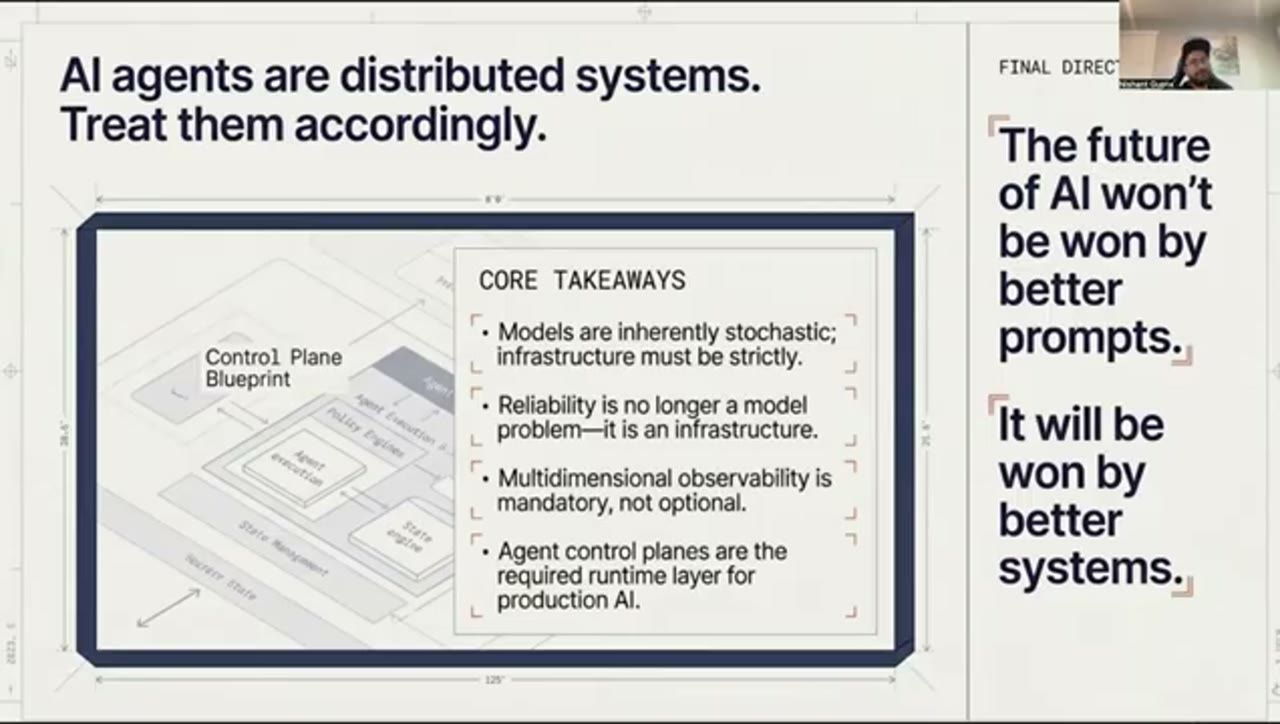
Và cuối cùng, tương lai của AI sẽ không thắng nhờ prompt tốt hơn. Nó sẽ thắng nhờ hệ thống tốt hơn.
Nguồn và link
- Trang talk chính thức trên ai.engineer · Video gốc
- Kubernetes, control plane cho container mà talk lấy làm phép so sánh: kubernetes.io
- Circuit breaker pattern: martinfowler.com/bliki/CircuitBreaker.html
- Google SRE Book, chương Handling Overload: sre.google/sre-book/handling-overload
- Nishant Gupta trên GitHub: github.com/nishantgpt-lab · LinkedIn: linkedin.com/in/nishantgupta-ai
Related talks
Production Evals For Agentic AI Systems
Nishant Gupta · Meta · 8 min
Eval cho agent phải đo hành vi cả hệ thống: scenario offline, production telemetry, human review, drift, trace và metric reliability gắn với kết quả kinh doanh.
The Log Is The Agent
Ishaan Sehgal · Omnara · 15 min
Agent không phải model hay runtime mà là append-only log: từ đó có reliability, scaling, forking, migration, và ai giữ log là người sở hữu agent.
Stop Writing Tone Instructions. Layer Them.
Isadora Martin-Dye · Isadora & Co · 21 min
Tách brand voice thành bốn layer: identity bất biến, mode theo tình huống, voice neo vào ví dụ, và một veto deterministic chặn output sai trước khi tới khách.