Production Evals For Agentic AI Systems
AI Engineer World's Fair 2026: Online Track · Video gốc
Eval cho agent phải đo hành vi cả hệ thống: scenario offline, production telemetry, human review, drift, trace và metric reliability gắn với kết quả kinh doanh.
1. Từ benchmark sang câu hỏi "hệ thống có hành xử đúng không"
Nishant Gupta là software engineering tech lead tại Meta, làm phần training infrastructure và inference infrastructure cho Meta Superintelligence Labs và tổ chức infrastructure của nhóm này. Chủ đề hôm nay của anh là production eval cho hệ thống agentic.
Khi nghe chữ evaluation, phần lớn mọi người nghĩ ngay tới benchmark. Một model đạt 90% trên benchmark, bản mới đạt 92%, cả team ăn mừng. Nhưng hệ thống agentic đã thay đổi tận gốc ý nghĩa của evaluation. Ngày nay hệ thống không chỉ sinh ra câu trả lời. Chúng lập plan, gọi tool, truy xuất thông tin (retrieval), chạy workflow, và tương tác với chính hạ tầng production.
Vì thế câu hỏi không còn là "model có sinh ra câu trả lời đúng không?". Câu hỏi giờ là "hệ thống có hành xử đúng không?". Điều Nishant muốn bàn trong talk là evaluation đang tiến hoá từ việc benchmark model thành một phần của production infrastructure.
2. Benchmark tăng, production vẫn khó đoán
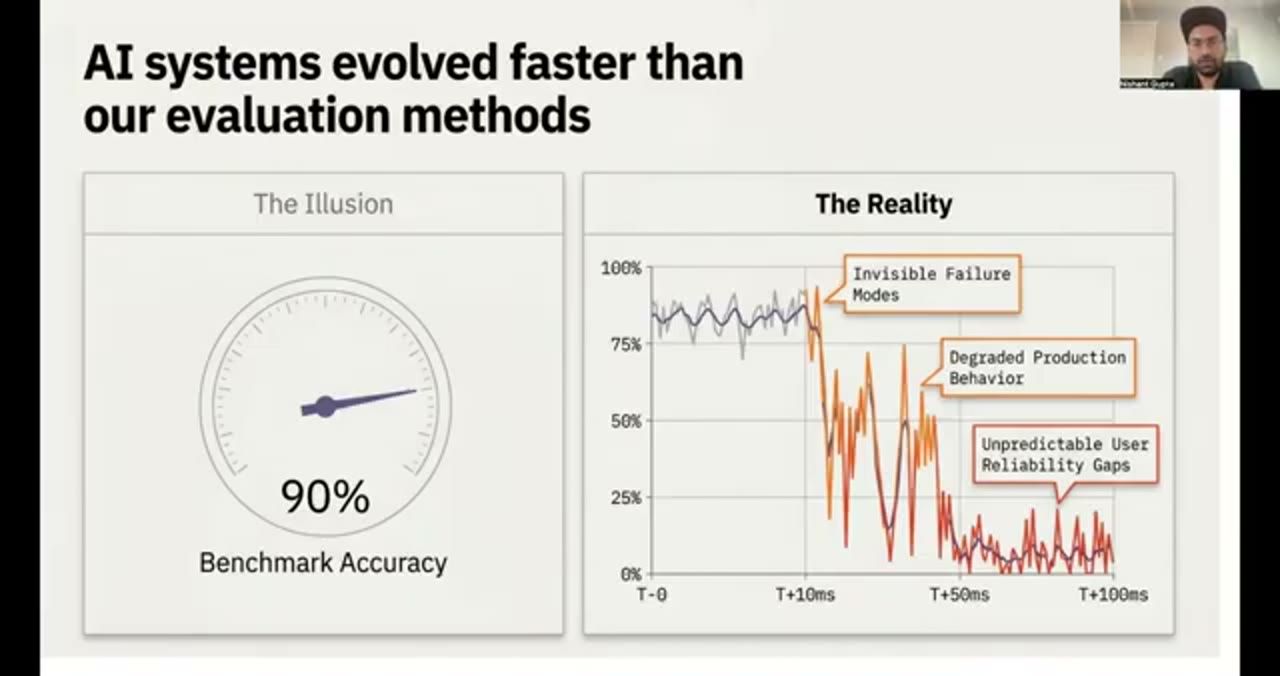
Đây là vấn đề mà gần như mọi tổ chức AI đang gặp: benchmark offline cứ tiếp tục tăng, vậy mà reliability trên production thường vẫn khó đoán. Tại sao? Vì benchmark đo capability của model, còn production đo hành vi của cả hệ thống.
Một benchmark không bắt được tool failure, API sập, context thay đổi, sự khác biệt giữa các user, hay những workflow chạy rất lâu. Và khi hệ thống càng tự hành, khoảng cách giữa điểm benchmark và hiệu năng thực trên production càng giãn ra. Kết quả là thứ nhiều team đang trải qua: điểm benchmark cao, nhưng hành vi trên production không đáng tin.
3. Paradigm shift: từ output sang behavior
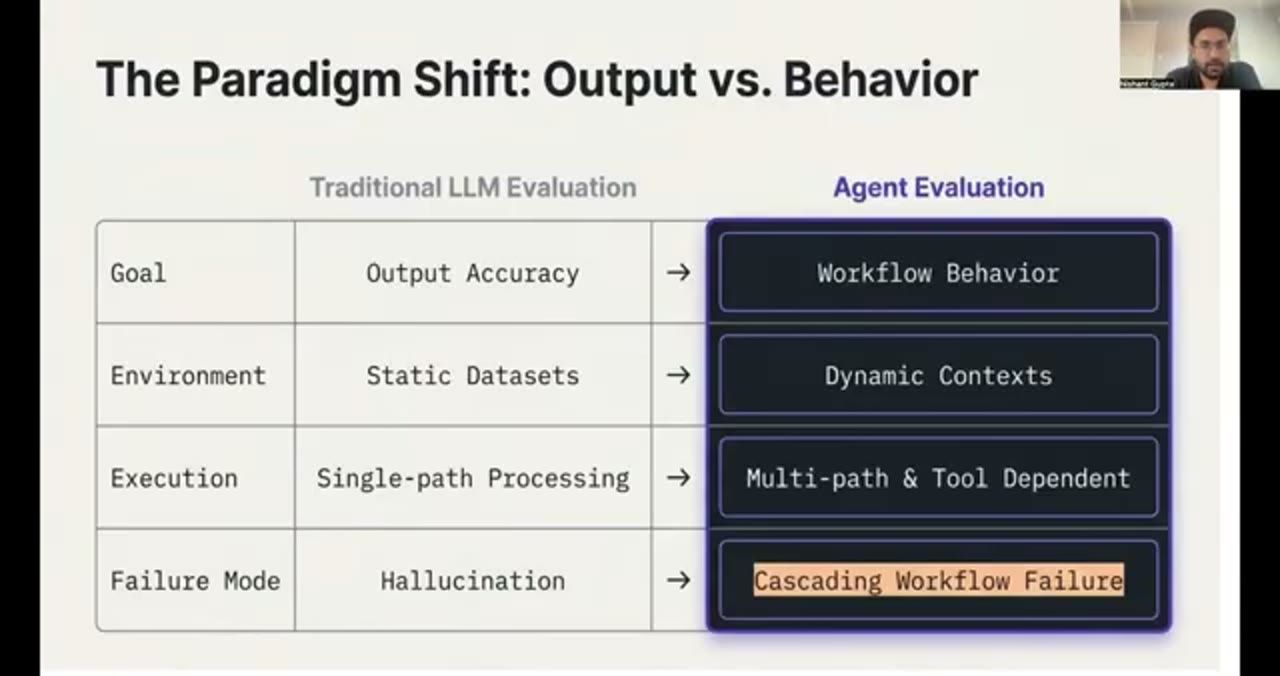
LLM evaluation truyền thống tập trung vào output: model có tạo ra đáp án đúng không? Hệ thống agentic buộc ta hỏi một câu khác: hệ thống có hành xử đúng không?
Behavior ở đây gồm chất lượng planning, cách dùng tool, việc thực thi, việc chạy hết workflow, khả năng phục hồi sau lỗi, và cách ra quyết định. Nói cách khác, ta đang chuyển từ đánh giá câu trả lời sang đánh giá workflow, và điều đó đòi hỏi những kiến trúc evaluation khác hẳn về bản chất.
4. Giải phẫu các kiểu failure của agent
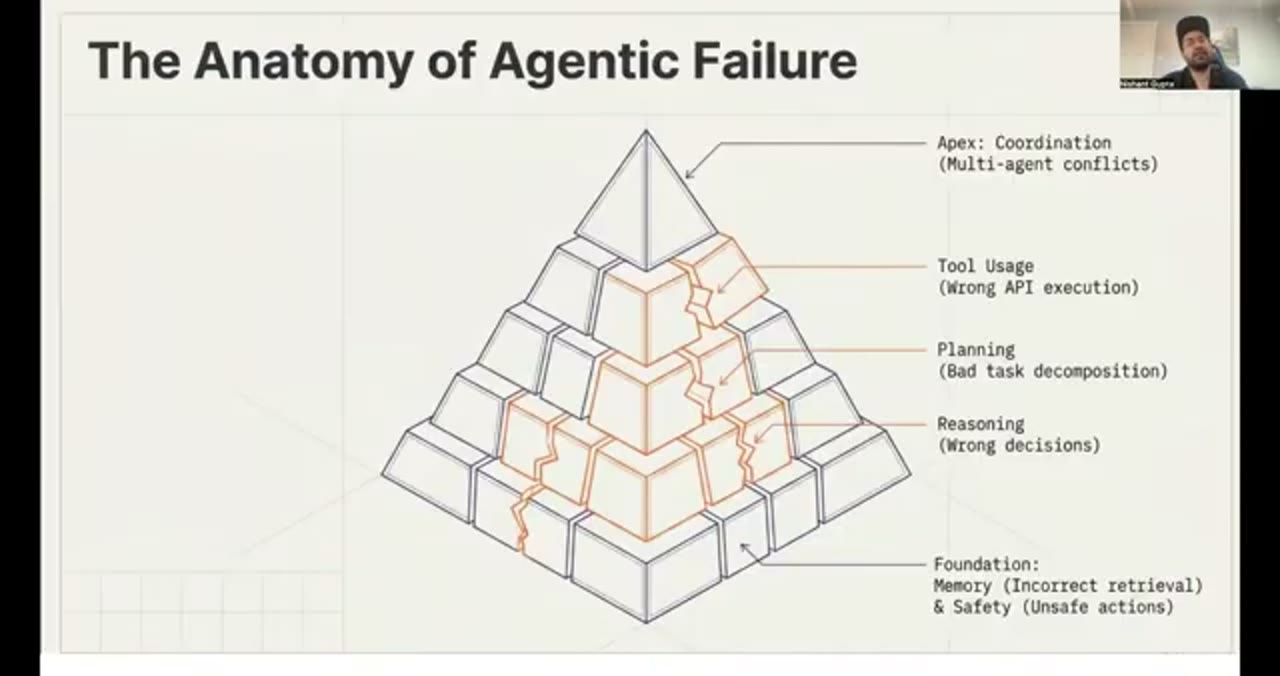
Nhiều team vẫn nghĩ hallucination là failure mode chính của AI. Trên production, hallucination thường chỉ là một hạng mục. Hệ thống agentic sinh ra cả một hệ thứ bậc failure mode.
Ở tầng nền là memory failure, retrieval failure và safety failure. Đi lên trên, ta phải tính tới reasoning sai, planning kém, và thực thi tool sai. Ở tầng cao nhất là failure trong việc phối hợp nhiều agent (multi-agent coordination). Đó là lý do việc chỉ đánh giá output của model bỏ sót phần lớn những rủi ro production mà Nishant quan sát được.
5. Nghĩ như một SRE: reliability thay cho accuracy
Một trong những thay đổi tư duy hữu ích nhất là thôi nghĩ như nhà nghiên cứu, và bắt đầu nghĩ như một SRE (Site Reliability Engineer) hay một production engineer. SRE không đo thành công bằng accuracy. Họ đo reliability, availability, latency, cost, và khả năng recovery. Hệ thống agentic cần đúng cách tiếp cận đó.
Mục tiêu không phải là tối đa hoá điểm benchmark, mà là tối đa hoá những kết quả có thể tin cậy được. Reliability trở thành North Star metric (chỉ số kim chỉ nam). Accuracy chỉ còn là một input trong số nhiều input.
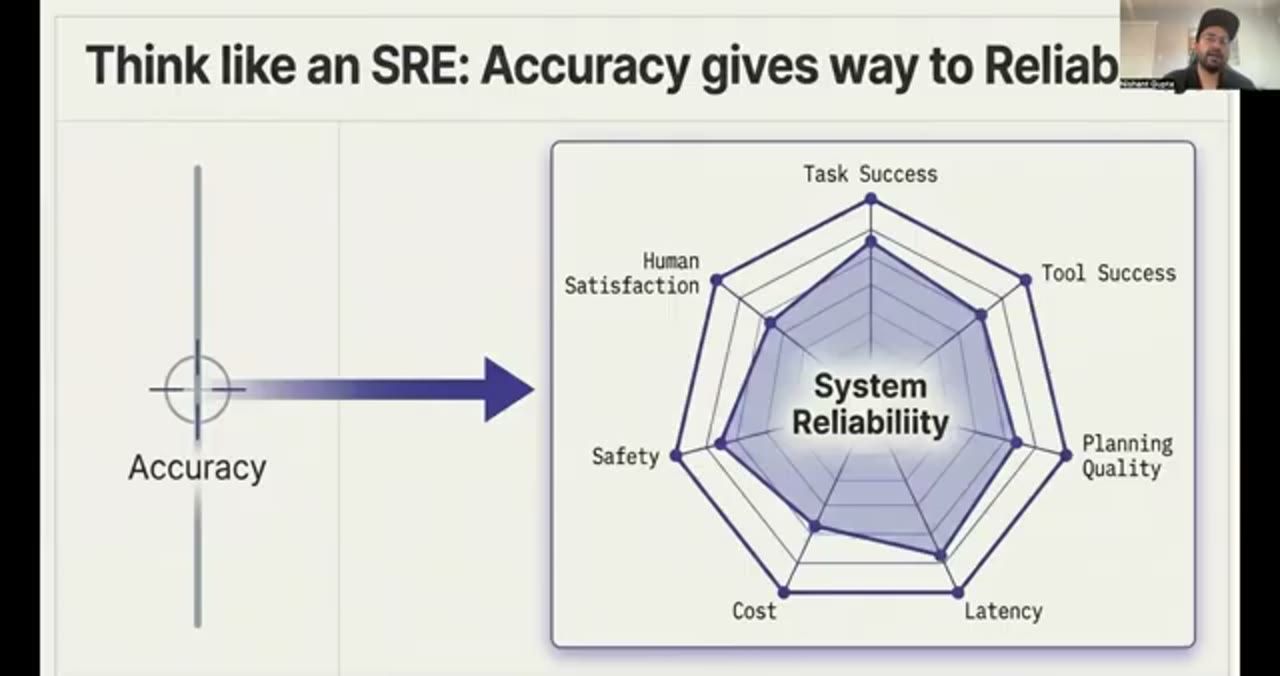
Nếu muốn đọc thêm về cách SRE nghĩ về reliability, cuốn Site Reliability Engineering của Google là tài liệu gốc của cách tiếp cận này.
6. Kim tự tháp tín hiệu evaluation
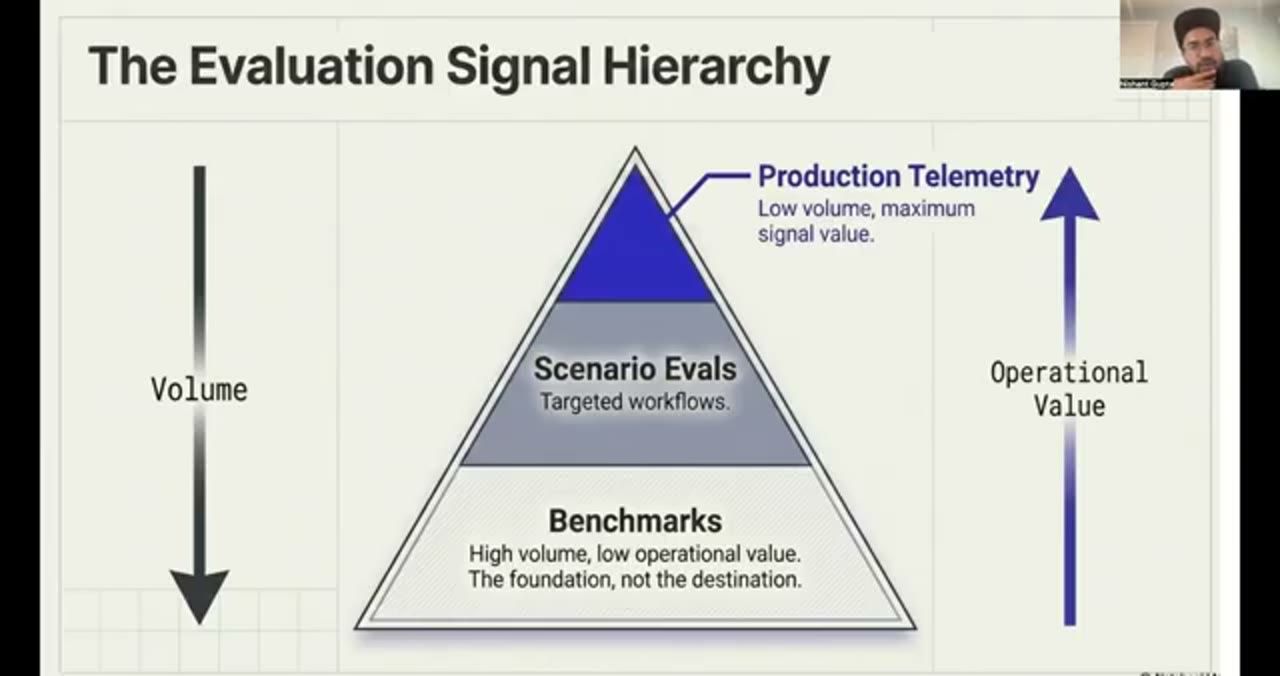
Kim tự tháp này là cách Nishant tự mình nghĩ về các hệ thống AI evaluation hiện đại.
Ở đáy là benchmark. Chúng hữu ích, scale được, lặp lại được (repeatable), nhưng giá trị vận hành của chúng có giới hạn. Ở giữa là scenario-based evaluation, tức những bài đánh giá mô phỏng các workflow thực tế. Ở đỉnh là production telemetry. Đây là nơi sinh ra những tín hiệu evaluation có giá trị cao nhất.
Điều bất ngờ, theo Nishant, là phần lớn dữ liệu evaluation thường đến từ chính user thật tương tác với hệ thống thật.
7. Offline eval: chạy theo scenario, không theo prompt
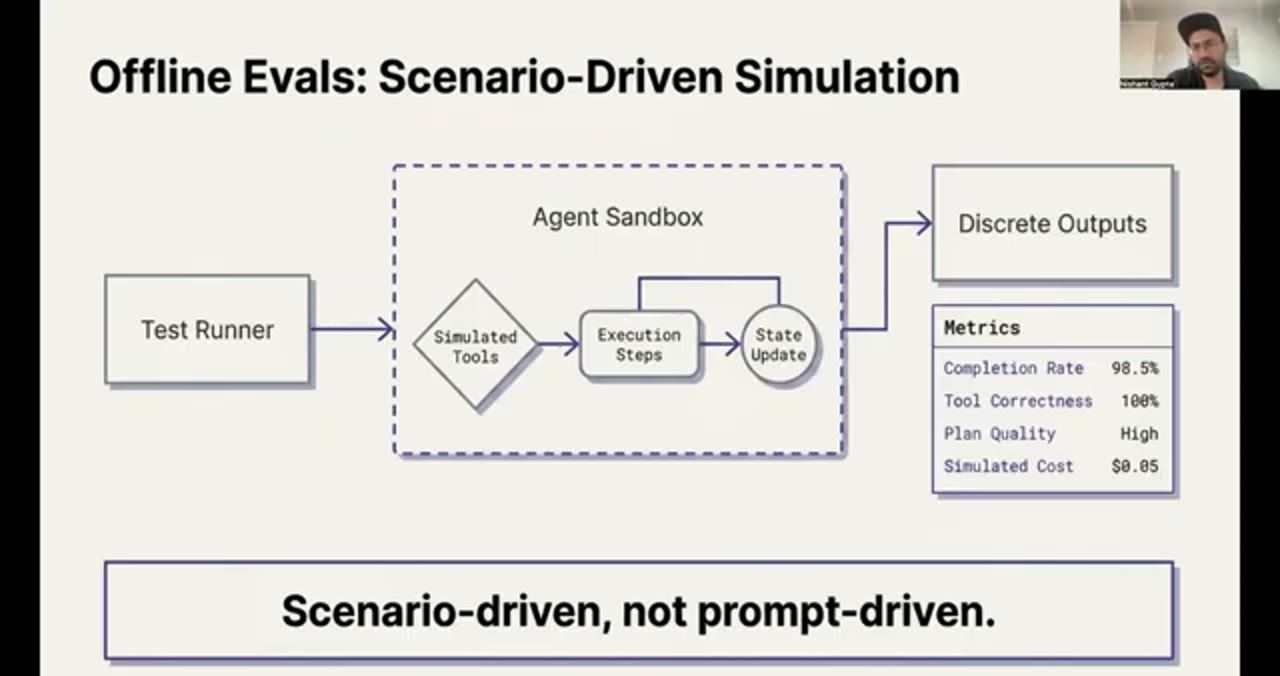
Offline evaluation vẫn quan trọng, nhưng phương pháp thay đổi. Thay vì đánh giá từng prompt, ta đánh giá cả scenario. Ví dụ: một workflow customer support, một workflow code generation, một workflow research.
Agent hoạt động bên trong môi trường mô phỏng đó. Ta đo task completion rate, độ đúng khi dùng tool (tool correctness), chất lượng planning, và resource usage, thứ mà ở quy mô lớn sẽ tăng theo cấp số nhân. Điểm cần nhớ: agent evaluation phải scenario-driven, không phải prompt-driven.
8. Online eval: production là dataset lớn nhất
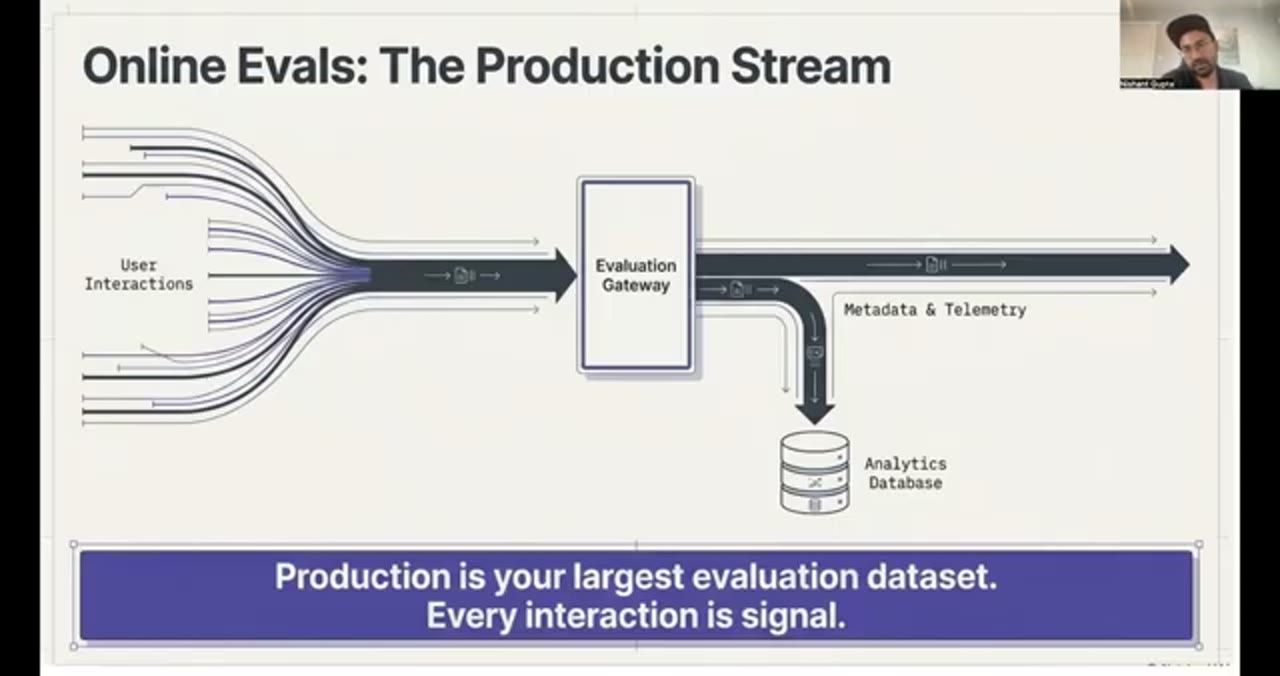
Khi một hệ thống đã lên production, mọi tương tác đều trở thành tín hiệu. Đây là một trong những thay đổi lớn nhất trong tư duy về evaluation: traffic trên production không còn chỉ là traffic, nó trở thành dữ liệu evaluation.
Ta thu thập execution trace, kết quả cuối cùng của user, các lần escalation (chuyển lên người xử lý), các lần thất bại, và các tín hiệu feedback. Production là dataset evaluation lớn nhất và mang tính đại diện nhất mà bất kỳ tổ chức nào từng có.
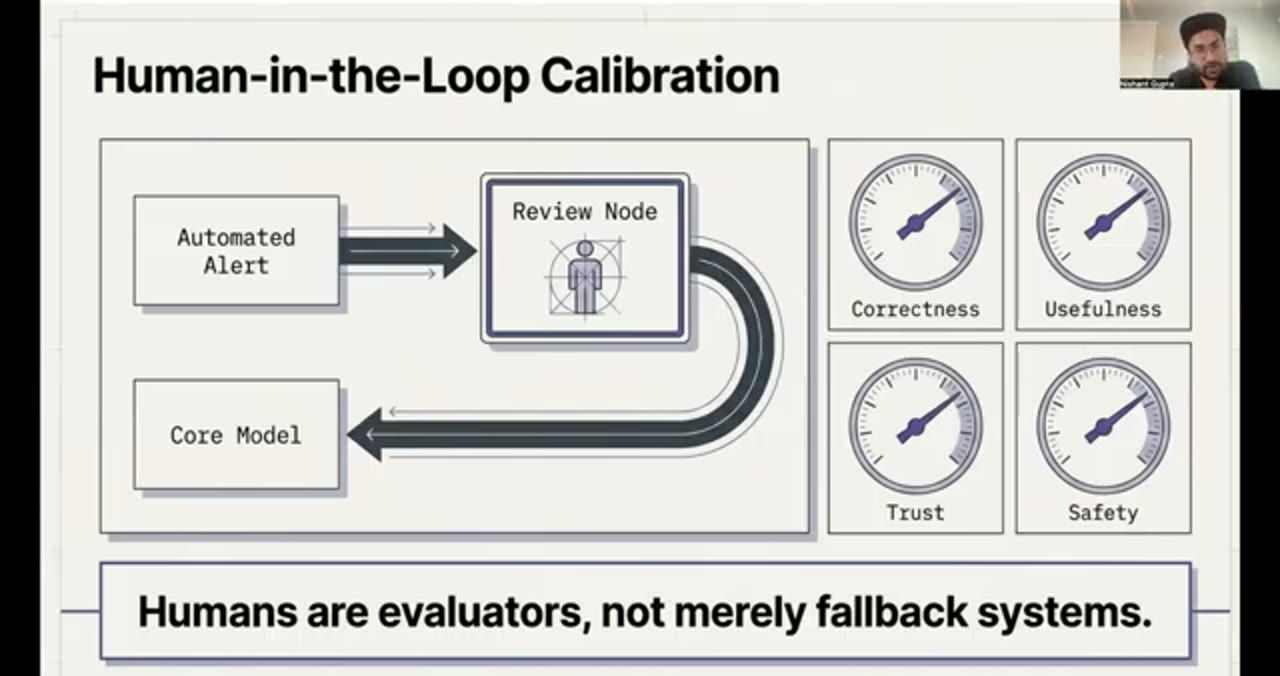
9. Con người là evaluator, không phải fallback
Nhiều tổ chức coi con người là hệ thống dự phòng (fallback): khi máy không xử lý được thì đẩy cho người. Nishant cho rằng cách đóng khung đó sai. Con người chính là evaluator.
Họ cho ra những tín hiệu mà hệ thống tự động không tạo được: họ đánh giá độ đúng (correctness), mức độ tin tưởng (trust), mức hữu ích (usefulness) và độ an toàn (safety). Những tín hiệu này trở nên cực kỳ quan trọng để hiệu chỉnh (calibrate) evaluation pipeline và để tìm ra những điểm mù của các metric tự động. Những hệ thống thành công nhất kết hợp automated evaluation với human review có chủ đích, nhắm vào đúng chỗ cần.
10. Sát thủ thầm lặng: agent drift
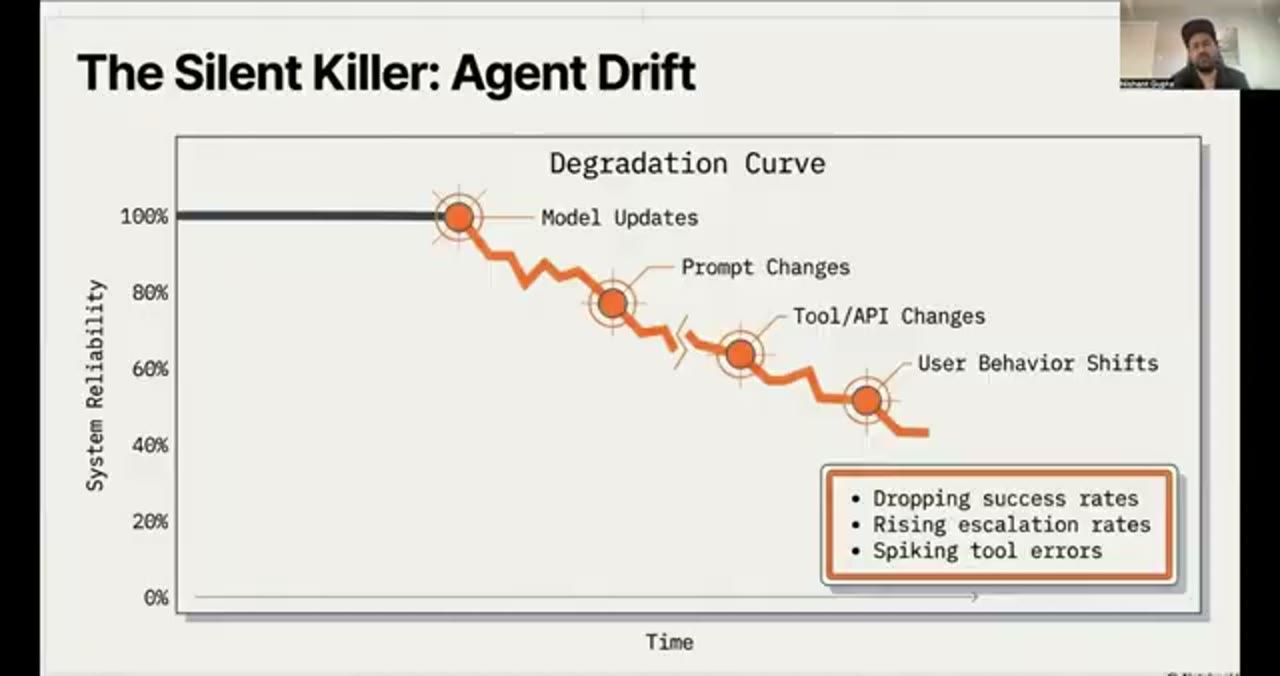
Hệ thống agent drift liên tục. Model thay đổi: cứ vài tuần hay vài tháng lại có một version mới. Prompt có thể đổi, tool có thể đổi, hành vi của user có thể đổi.
Cái khó là không một thay đổi đơn lẻ nào trông giống thảm hoạ. Reliability xuống cấp từ từ: success rate giảm dần, escalation tăng lên, tool failure nhích lên. Không có evaluation liên tục, các team thường không phát hiện drift cho tới khi user bắt đầu phàn nàn. Vì vậy continuous monitoring trở thành điều bắt buộc.
11. Observability là điều kiện tiên quyết
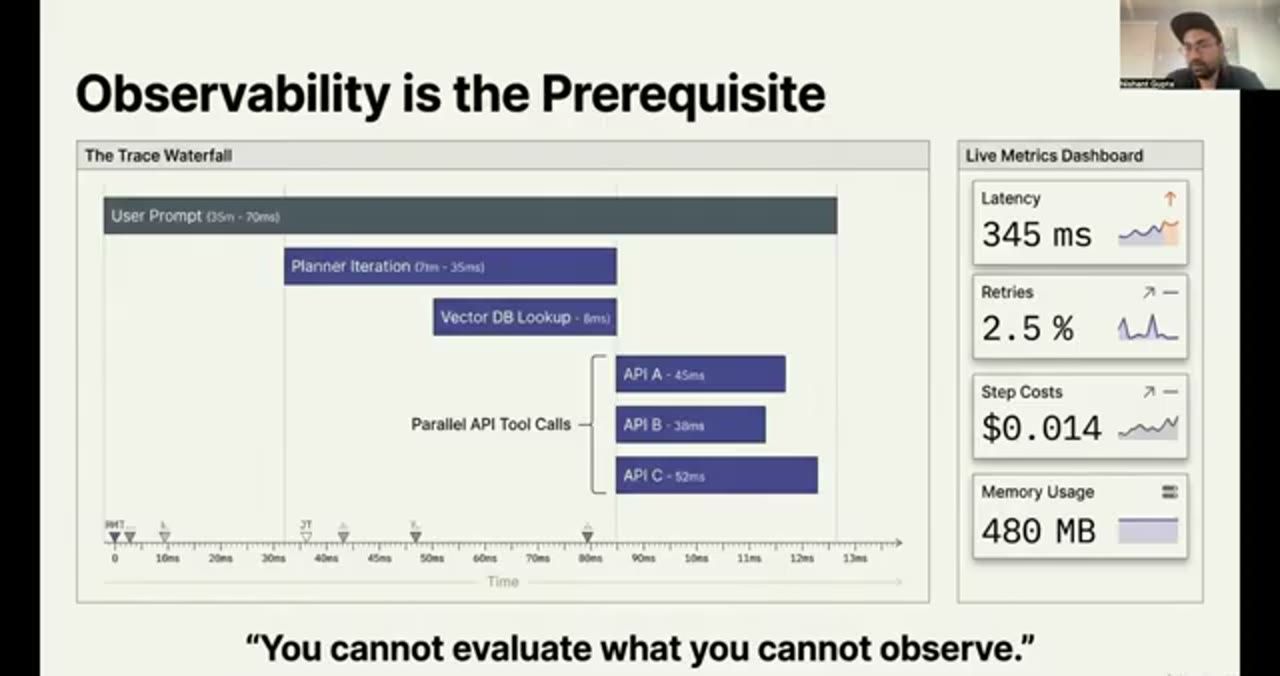
Observability và evaluation không thể tách rời. Để đánh giá một agent, ta cần nhìn thấy reasoning path, các tool call, các lần truy cập memory, timeline thực thi, và các lần chuyển trạng thái (state transition), như trong biểu đồ trên slide.
Log truyền thống là không đủ. Ta cần trace chi tiết, giống hệt như với bất kỳ kiến trúc microservice lồng nhau sâu nào, cho bất kỳ ứng dụng hay service nào. Agent trace trở thành thứ tương đương với distributed tracing, nhưng cho các workflow tự hành. Không có observability, evaluation trở thành phỏng đoán.
Với ai muốn bắt đầu, khái niệm trace và span trong tài liệu OpenTelemetry chính là nền của distributed tracing mà Nishant so sánh.
12. Vòng lặp evaluation liên tục
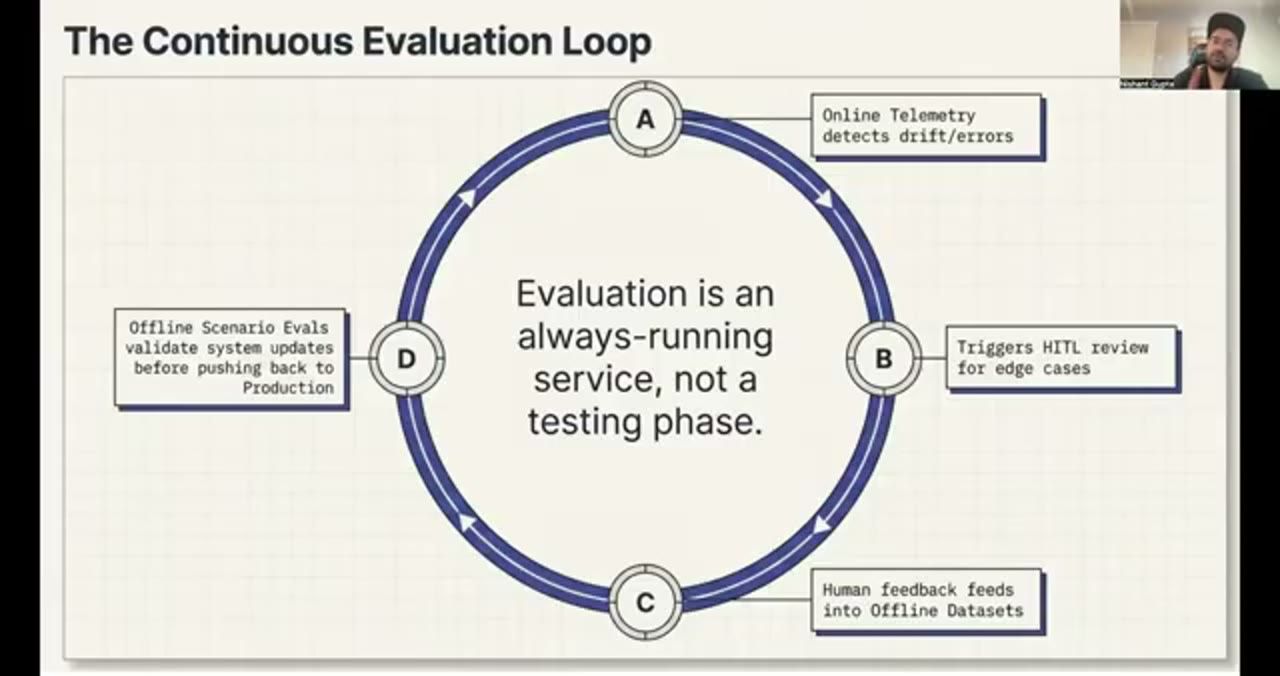
Nishant nói về continuous evaluation loop, vì evaluation là một service luôn chạy, không phải một giai đoạn test. Trước đây evaluation luôn diễn ra trước khi deploy. Giờ evaluation tiếp tục cả sau khi deploy.
Vòng lặp đi như sau. Telemetry phát hiện vấn đề, ở điểm A. Con người review các edge case. Feedback cải thiện các dataset. Các offline scenario kiểm chứng những bản cập nhật. Vòng lặp không bao giờ dừng. Evaluation không còn chỉ là một giai đoạn, nó là một năng lực vận hành.
13. Reliability scorecard: metric nào nối với kết quả kinh doanh nào
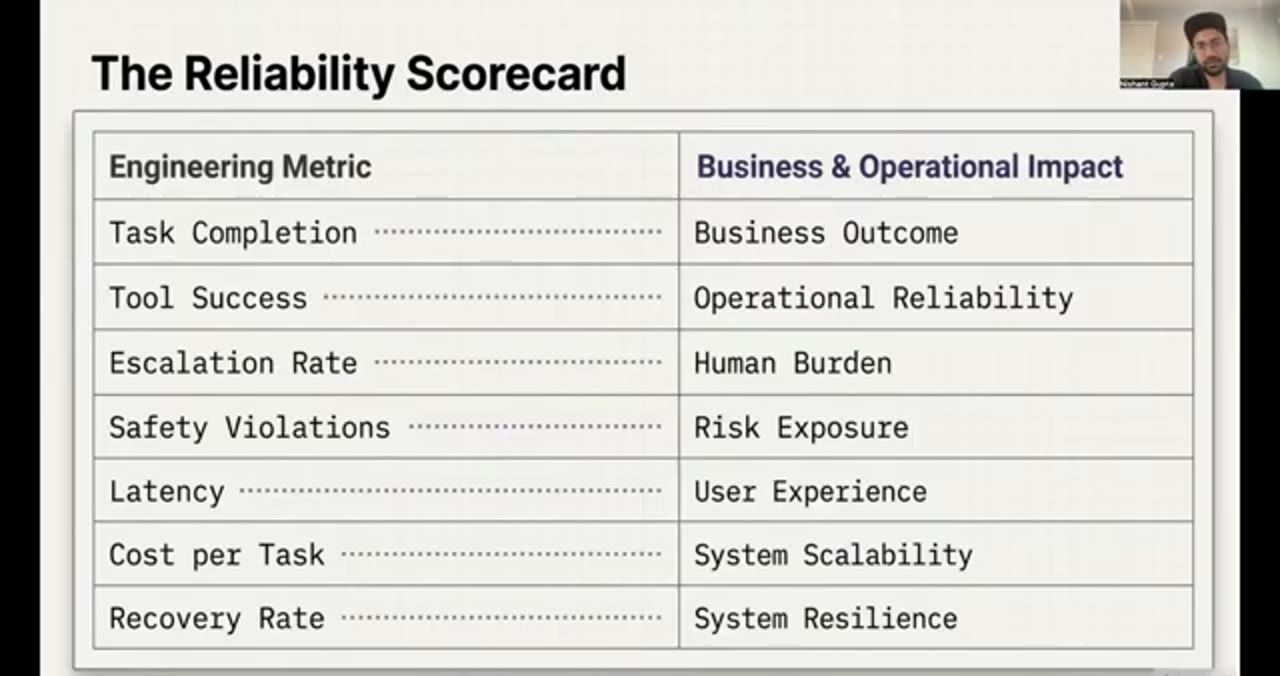
Nishant gọi đây có lẽ là slide quan trọng nhất của bài. Mỗi metric trên đó nối thẳng vào một kết quả kinh doanh:
- Task completion đo giá trị được tạo ra.
- Tool success đo reliability vận hành.
- Escalation rate đo gánh nặng đè lên con người.
- Safety evaluation đo mức độ phơi nhiễm rủi ro.
- Latency ảnh hưởng tới trải nghiệm user.
- Cost quyết định khả năng scale.
- Recovery rate phản ánh độ bền bỉ (resilience).
Và hãy để ý: accuracy không có trong danh sách. Không phải vì accuracy không quan trọng, mà vì thành công về kinh doanh phụ thuộc vào nhiều thứ hơn hẳn accuracy.
14. Agentic control plane: kiến trúc tham chiếu
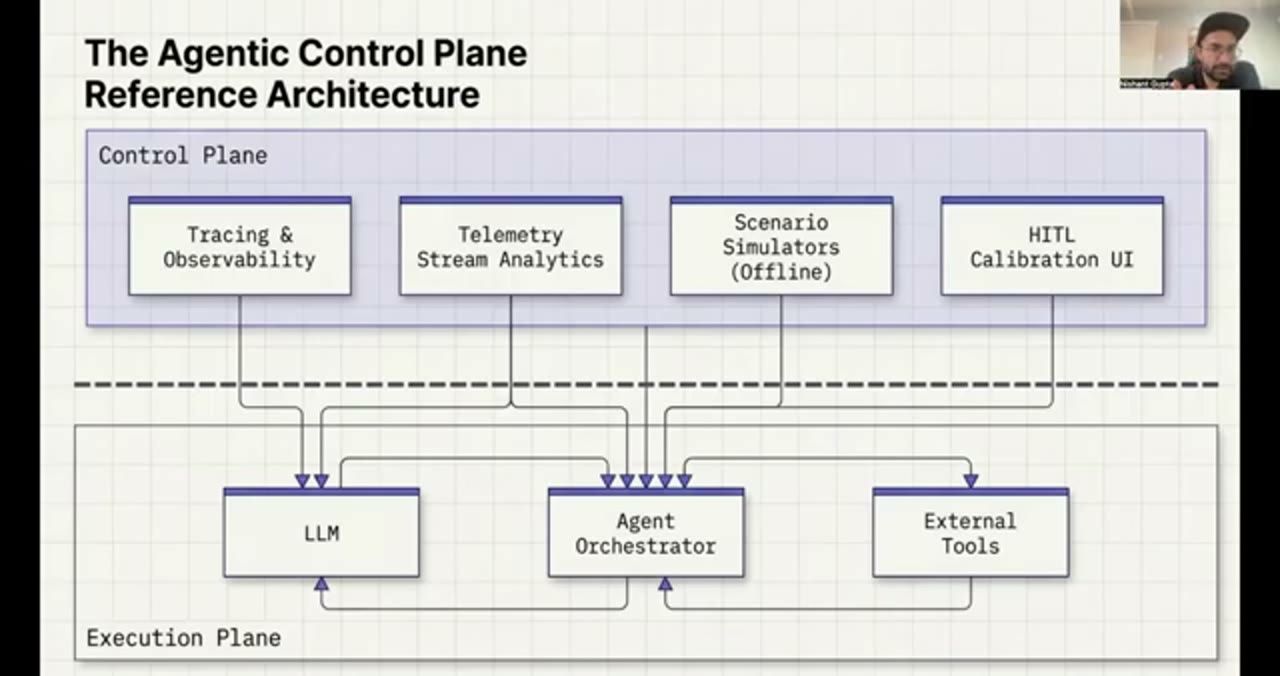
Đây là kiến trúc mà ngành đang đi tới, ở mức độ nhiều hay ít. Evaluation trở thành một phần của control plane, không phải một tool riêng, cũng không phải một quy trình offline.
Control plane liên tục quan sát hệ thống, thu thập telemetry, chạy simulation, và điều phối human review, còn execution plane là nơi thực hiện công việc. Control plane đo lường và điều tiết (govern) hành vi. Sự tách bạch này đang trở thành một pattern nền tảng cho các hệ thống AI trên production.
Nishant cũng có một talk khác trong cùng Online Track đi sâu vào agent control plane từ góc độ hạ tầng: Building Deterministic Infrastructure for Non-Deterministic AI Agents.
15. Năm bài học: evaluation đang trở thành infrastructure
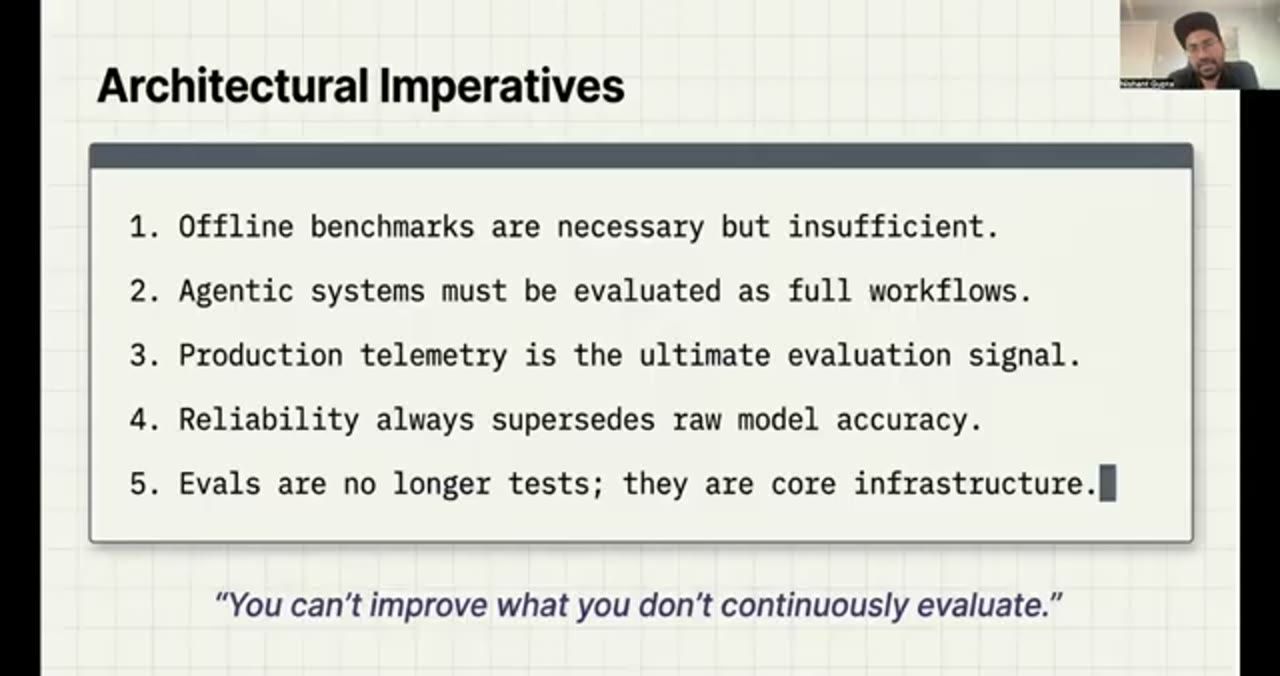
Nishant tóm lại các bài học chính:
- Benchmark vẫn cần thiết, nhưng không đủ.
- Hệ thống agent phải được đánh giá như những workflow, không phải như từng output riêng lẻ.
- Production telemetry là tín hiệu evaluation quan trọng nhất.
- Rốt cuộc, reliability quan trọng hơn raw accuracy của model.
- Và cuối cùng, evaluation đang trở thành infrastructure. Không phải testing, không phải QA, mà là infrastructure.
Đây là sự chuyển dịch mà mọi tổ chức đang xây AI agentic rồi sẽ phải thực hiện.
Nguồn và liên kết
- Trang talk chính thức: ai.engineer/talks/vljxQZfJ9wY
- Video gốc: youtube.com/watch?v=vljxQZfJ9wY
- Talk cùng tác giả trong Online Track: Building Deterministic Infrastructure for Non-Deterministic AI Agents
- Google, Site Reliability Engineering: sre.google/sre-book
- OpenTelemetry, khái niệm trace: opentelemetry.io/docs/concepts/signals/traces
- Nishant Gupta trên GitHub: github.com/nishantgpt-lab · LinkedIn: linkedin.com/in/nishantgupta-ai
Related talks
The Log Is The Agent
Ishaan Sehgal · Omnara · 15 min
Agent không phải model hay runtime mà là append-only log: từ đó có reliability, scaling, forking, migration, và ai giữ log là người sở hữu agent.
The Miranda Hypothesis: How Hamilton (the Musical) Poisoned Your Persona Evals
Jacob E. Thomas · Results Generation · 58 min
Vì sao persona eval chấm fluency không bắt được persona ghép lẫn văn hoá sai thời đại, và instrument pre-registered với nhà sử học để đo fidelity.
User Signal Dies at the Retrieval Boundary
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.