Bypassing the Multimodal Tax: Framework-Free Hybrid RAG, Raw SQL RRF, and Live UI Telemetry
AI Engineer World's Fair 2026: Online Track · Video gốc
Chatbot FAQ chạy local: Docling ra Markdown, bốn chunking strategy, hybrid search trong Postgres gộp bằng RRF, guardrail bằng code và trace với Langfuse.
1. Hai vấn đề: token mất trước câu hỏi đầu tiên, và quá nhiều tool
Abed Matini mở đầu bằng lời chào và tự giới thiệu: anh là Senior Backend Developer tại Ogilvy. Anh cảm ơn AI Engineer World's Fair 2026 đã cho anh một slot trong Online Track. Hôm nay anh sẽ dẫn người xem đi qua chủ đề "bypassing the multimodal tax": làm sao có một hybrid RAG không cần framework, với RRF viết bằng raw SQL, và live telemetry.
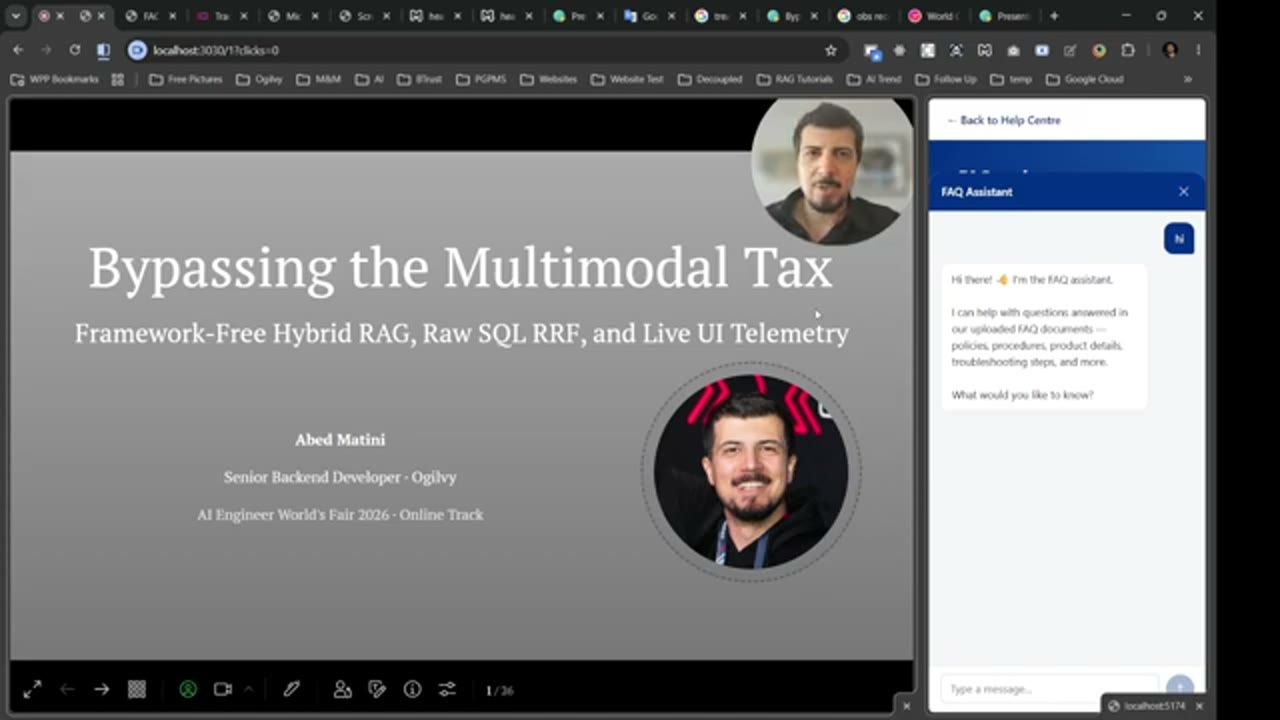
Như người xem thấy, phía bên phải màn hình là live demo của anh. Với mỗi slide anh chuyển qua, nếu có gì liên quan tới phần trình bày thì anh có thể cho xem ngay. Anh cũng mở sẵn vài tab để vừa đi qua slide vừa demo. Rồi anh bắt đầu.
Có hai vấn đề mà talk này cố giải quyết. Vấn đề thứ nhất: khi bắt đầu chat với bất kỳ LLM nào mà cần upload một tài liệu, ta thường chỉ kéo thả một file PDF, một file Word hay một tấm ảnh, rồi bảo chatbot sẵn sàng cho những câu hỏi sẽ tới sau khi upload. Cái khó là ngay khi upload những tài liệu này, ta đã mất một phần token, phần token đáng lẽ chỉ dành để xử lý tài liệu, trong khi chưa hề đặt một câu hỏi nào. Tức là ta đã tiêu token ở đó mà chưa hỏi gì cả. Đó là vấn đề đầu tiên, và cũng là cái "multimodal tax" trong tên talk.
Vấn đề thứ hai: nếu ta đang build một chatbot, muốn có vector database, muốn có cả keyword search lẫn semantic search, rồi lại muốn thêm nhiều tool nữa, thì số tool sẽ quá nhiều khi gộp tất cả lại. Trong một chatbot production, ta sẽ có quá nhiều tool, và việc quản lý chatbot production cho đúng cách sẽ trở nên phức tạp.
2. Ba phần của talk
Abed chia talk thành ba phần chính. Phần một là cách upload tài liệu, đưa tài liệu vào và chuẩn bị chúng sẵn sàng cho chatbot trước khi user bắt đầu chat. Ở phía bên phải màn hình, anh có một chatbot FAQ assistant đang chạy local trên máy. Anh sẽ cho xem dashboard anh tạo cho nó, cách chat với nó, và cách lấy kết quả.
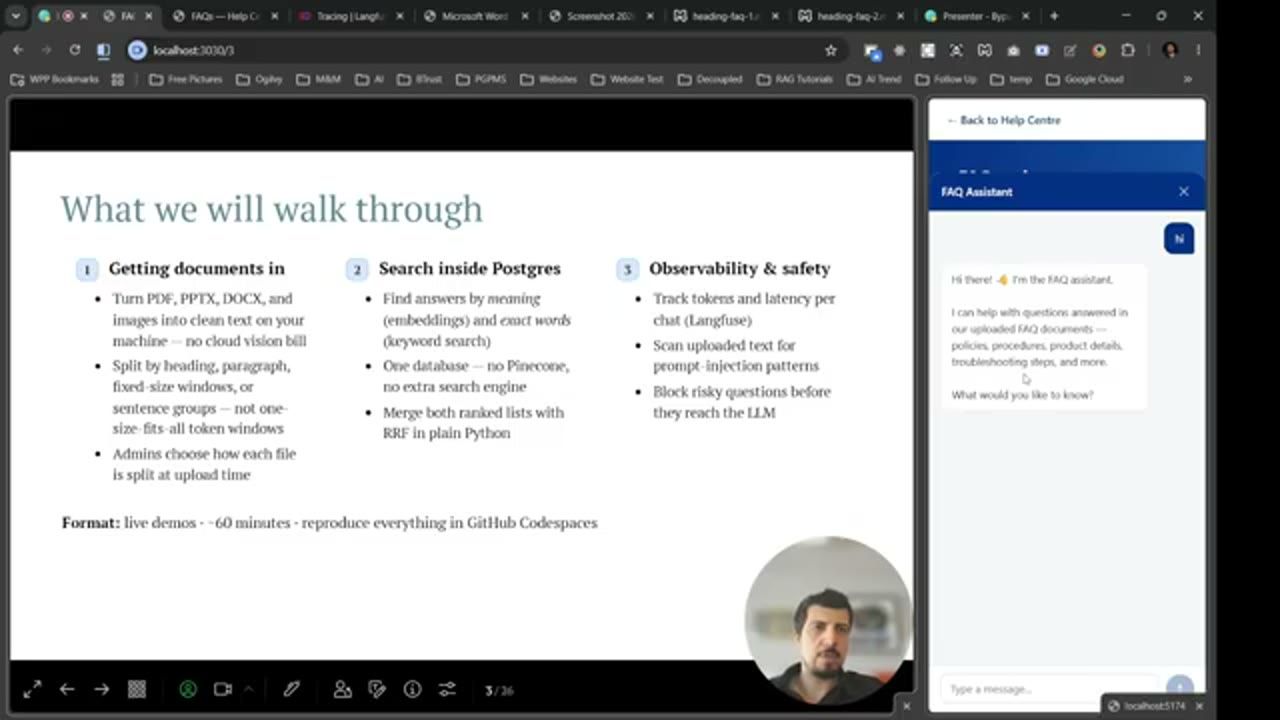
Tài liệu có thể tới ở nhiều định dạng khác nhau, hoặc ta có thể upload ở nhiều định dạng: PDF, file PowerPoint, file Word, thậm chí là ảnh. Talk sẽ nói về chuyện đó. Talk cũng sẽ nói về cách phải chunk những tài liệu này, vì đây là RAG: ta cần biết chia thông tin thế nào cho đúng, dựa trên chính tài liệu. Nên sẽ có phần về các kiểu chunking khác nhau, và anh sẽ cho xem trong trang admin cách chọn các strategy khác nhau để chunk tài liệu.
Sau đó là cách search hoạt động, cách embedding hoạt động, database trông ra sao, search dựa trên keyword search hay semantic search như thế nào. Rồi tới cách RRF chạy trong Python. Cuối cùng là observability: cách kiểm tra an toàn, cách quan sát toàn bộ quá trình bằng Langfuse, và cách ngăn pattern prompt injection hay bất kỳ câu hỏi rủi ro nào có thể đi tới LLM.
Anh dự định talk dài dưới một tiếng. Và kế hoạch là toàn bộ codebase có thể chạy dễ dàng trên GitHub Codespaces: chỉ cần pull từ repo về, chạy một lệnh, và mọi thứ sẵn sàng để thử trên Codespaces.
3. Demo: FAQ assistant cho employee handbook, và stack
Ứng dụng demo được hình dung là một FAQ assistant cho một employee handbook mẫu. Hãy tưởng tượng bạn có một công ty, và bộ phận HR đã upload cuốn handbook để nhân viên hỏi mọi câu hỏi họ có: về nghỉ phép, về các loại nghỉ phép khác nhau, nghỉ ốm, nghỉ phép cho cha mẹ (parental leave), hay bất kỳ câu hỏi nào mà HR có thể gặp như một câu hỏi thường ngày. Đó là bộ mẫu sẽ được upload trong demo.
Stack được dùng:
- Python với FastAPI cho back-end.
- React cho front-end.
- PostgreSQL làm database.
- Docker, đơn giản để có container, để có thể tái tạo và chạy lại ở bất kỳ đâu, ví dụ trong Codespaces hay bất kỳ môi trường nào khác.
- Ollama cho các local language model và embedding model. Chúng chỉ chạy local, và cũng chạy được trên bất kỳ server nào. Không cần GPU: CPU là đủ. Nên một staging server bất kỳ, một codespace bất kỳ, đều chạy được.
- Langfuse để theo dõi chuyện gì đang diễn ra, xem các cuộc chat và latency, nhờ đó cải thiện chất lượng chat.
4. Blueprint end-to-end
Tiếp theo là blueprint end-to-end của những gì talk sẽ bàn. Ta có một vài tài liệu làm source of truth cho chatbot, và ta upload chúng. Phía Python dùng Docling để chuyển các tài liệu thô đó thành file Markdown. Rồi ta chunk các file Markdown đó vào Postgres. Ở bước này, hệ thống cũng có thể chạy thêm một lượt scan nữa.
Phía bên kia là câu hỏi từ user: nhân viên hỏi những câu liên quan tới HR, và câu trả lời được retrieve từ database. Những kết quả liên quan, xếp hạng cao nhất, được đưa qua LLM, và LLM trả kết quả về chatbot dưới dạng một cuộc chat. Câu hỏi của ta được trả lời ngay trong khung chat, và ta có thể quan sát trong Langfuse chuyện gì đang diễn ra trong hệ thống.
5. Optimizing data ingest: structure first, chạy local
Phần tiếp theo là tối ưu hoá data ingest. Có hai cách. Cách thứ nhất là cứ thế ném tài liệu vào: ta có tài liệu và upload thẳng lên một cloud chatbot nào đó. Vấn đề thứ nhất của cách này, như đã nói, là ta tiêu token trước khi làm bất cứ việc gì. Vấn đề thứ hai là ta không biết tài liệu trông thế nào ở phía bên kia, nó được chunk ra sao, và LLM thực sự "nhìn" nó thế nào. Đó là một rủi ro về chất lượng: nếu có một bảng trong tài liệu, ta không biết nó được đọc ra sao ở đó, ta không nhìn thấy. Điều Abed muốn là rõ ràng hơn về cách tài liệu được lưu trong database của mình và cách nó được retrieve.
Cách thứ hai là structure first. Ta dùng CPU local. Nếu chạy ngay tại đây, ta upload tài liệu, Docling chuyển nó thành file Markdown, và ta biết rõ hơn chunking sẽ diễn ra thế nào. Anh sẽ cho xem vài ví dụ. Và tất nhiên prompt sẽ rẻ hơn nếu sau đó bạn muốn nói chuyện với một model cloud online. Còn nếu muốn chạy hết ở local, thì thực ra không tốn đồng nào.
Pipeline Docling chạy local trên server của ta. Python nhận tài liệu, export ra Markdown và lưu file Markdown đó. Sau đó nó chunk theo strategy được chọn, dùng embedding model để embed, rồi insert vào vector database.
Vậy tại sao chạy local? Hãy hình dung: với một hai trang thì chi phí gần như bằng không. Nhưng nếu bạn có hai trăm trang, chi phí sẽ quá lớn. Và nếu bạn là một công ty lớn với rất nhiều nhân viên, họ cứ hỏi đi hỏi lại cùng những câu hỏi, hay họ muốn upload tài liệu, thì đó sẽ là một khoản chi phí lớn.
6. Trang admin và vì sao upload nguyên handbook là một ý tồi
Có bốn cách chunk một tài liệu. Nhưng trước khi nói về bốn cách đó, Abed mở trang admin để cho thấy anh đang nói về cái gì. Hình dung đây là trang admin của FAQ. Anh xoá bớt vài tài liệu đã chunk từ trước. Giả sử bạn muốn upload một file FAQ mới cho chính sách HR, để cập nhật dữ liệu cho chatbot thông qua hệ thống RAG.
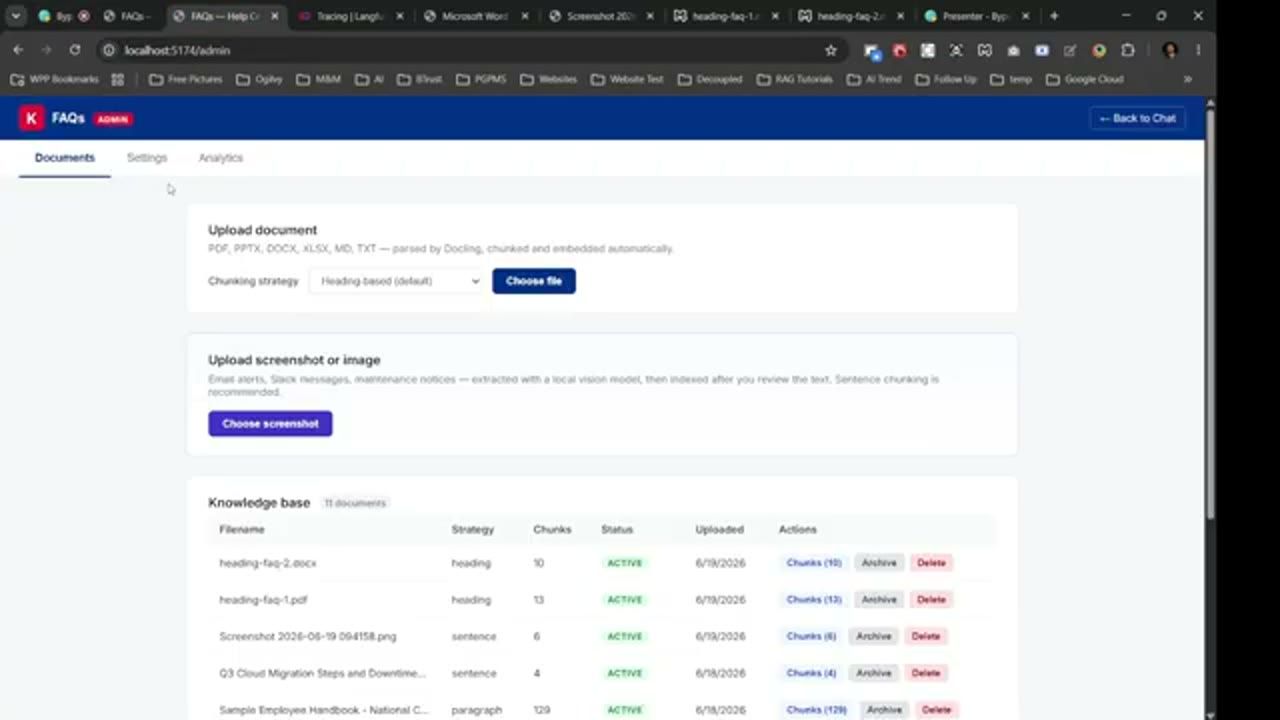
Trước khi upload, anh cho xem ý mình là gì. Một cách để nuôi chatbot bằng thông tin là thực sự tạo ra một file câu hỏi và câu trả lời. Dạng đó dễ tiêu hoá hơn cho hệ thống, dễ hiểu chuyện gì đang diễn ra hơn.
So sánh với việc dùng nguyên file handbook. Nếu muốn chunk cuốn handbook này và upload nguyên cả file PDF, thì sau khi chunk nó sẽ trông như thế này: bắt đầu bằng phần acknowledgement, rồi vài chunk chẳng mang nghĩa gì, rồi mới tới nội dung. Có những chunk không có nghĩa, ví dụ chỗ chữ ký và ngày tháng, về cơ bản là vô dụng. Những chunk như vậy làm chậm hệ thống, giảm độ chính xác của chat, và làm tăng hallucination.
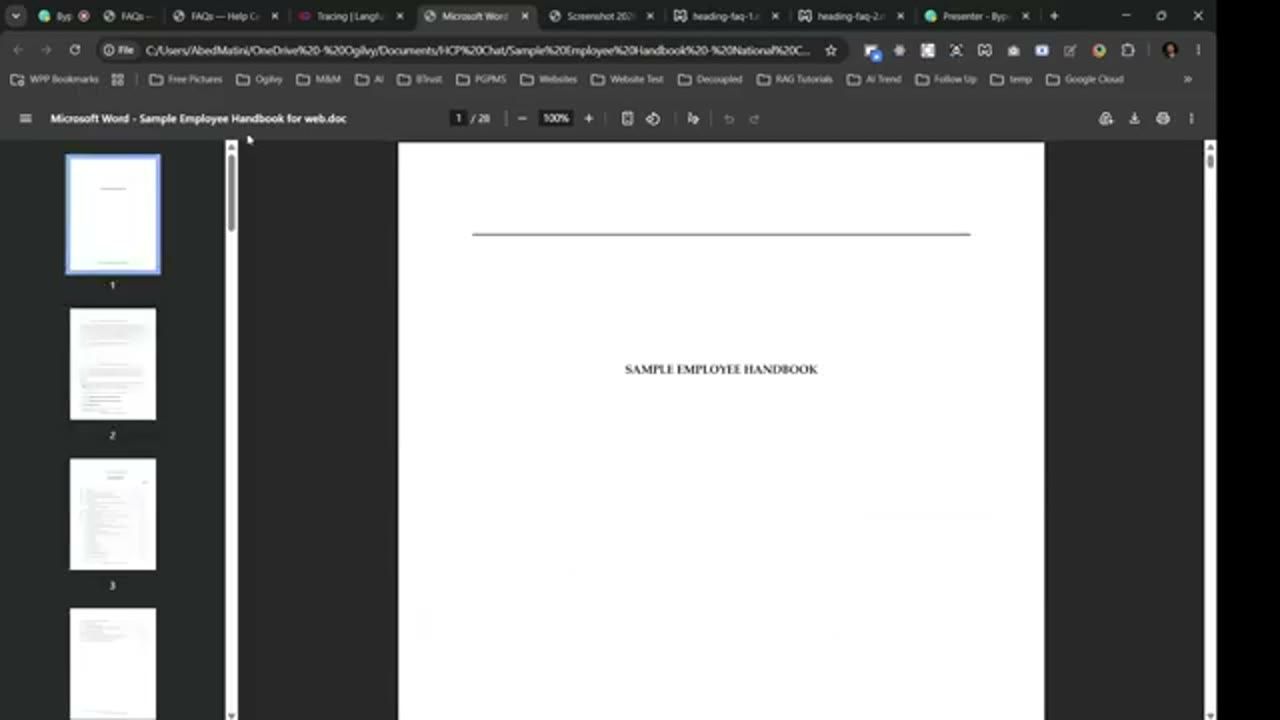
Nên thay vì upload thẳng 28 trang, nếu ta chia tài liệu thành những file khác nhau, những file liên quan, dọn dữ liệu sạch nhất có thể rồi mới upload, ta sẽ có kết quả tốt hơn. Trong trường hợp FAQ, một cách upload là biến dữ liệu thành các cặp câu hỏi và câu trả lời: về giờ làm việc, về những tình huống khác nhau. Theo cách đó, khi tài liệu được dùng làm reference, ta có reference đúng và không gây nhầm lẫn.
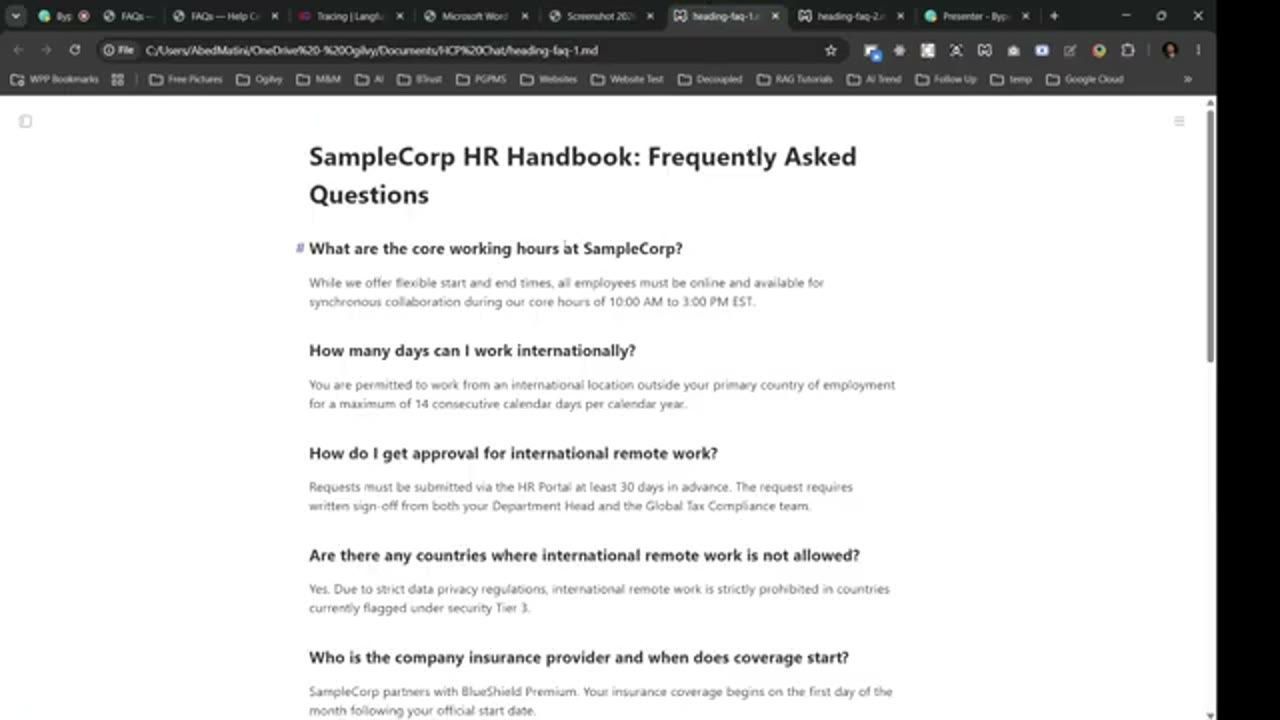
7. Chiến lược 1: heading-based chunking và câu trả lời có reference
Có nhiều cách upload tài liệu. Cách đầu tiên: bạn có file câu hỏi và câu trả lời rồi upload nó. Đây là file FAQ PDF của Abed, cùng file PDF đó, và anh upload với strategy heading-based chunking. Trong lúc anh giải thích, Docling đang parse ở background. Heading-based nghĩa là mỗi chunk dựa trên một heading mà Docling tìm được, cộng với phần trả lời đi sau nó. Heading là câu hỏi, cộng câu trả lời, thành một chunk. Nhờ vậy ta biết chunking sạch sẽ, và dễ dẫn nguồn.
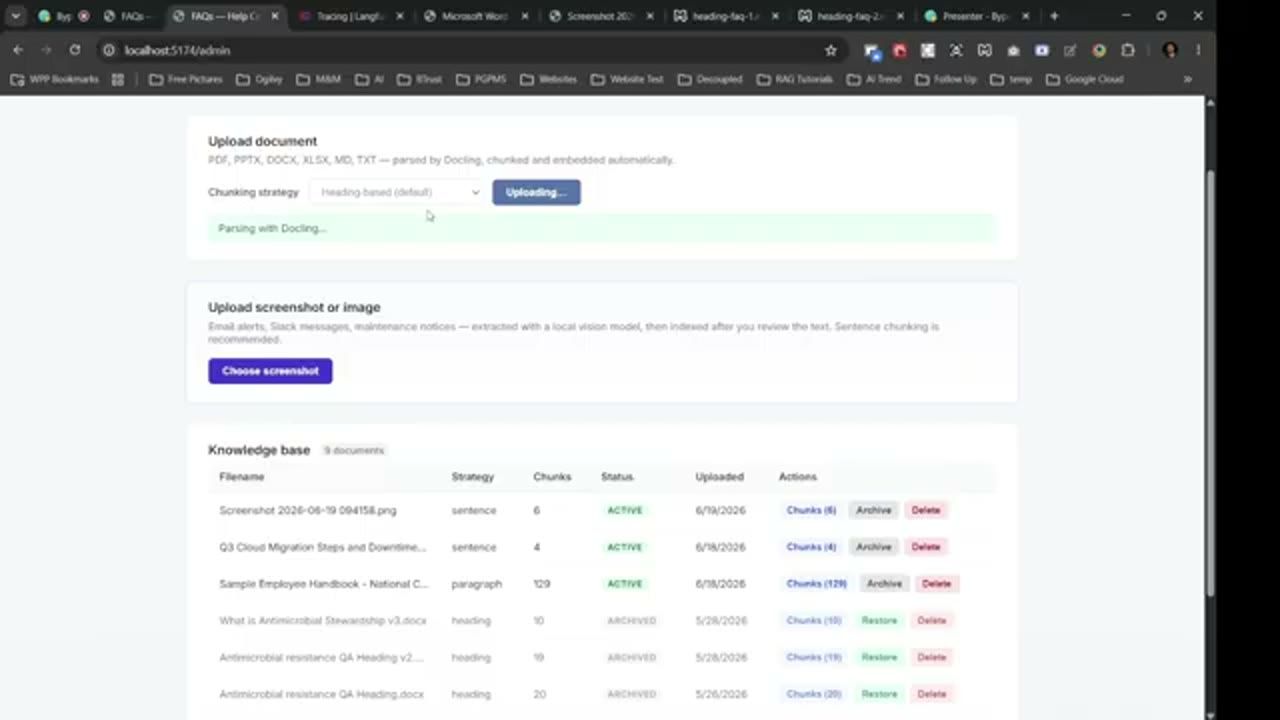
Khi chunking xong, chỉ trong một giây, ta thấy đây là FAQ đầu tiên, và nó đã chunk thành công theo heading. Nó nhận ra heading là câu hỏi, rồi câu trả lời liên quan. Mỗi chunk có câu hỏi và câu trả lời của riêng nó.
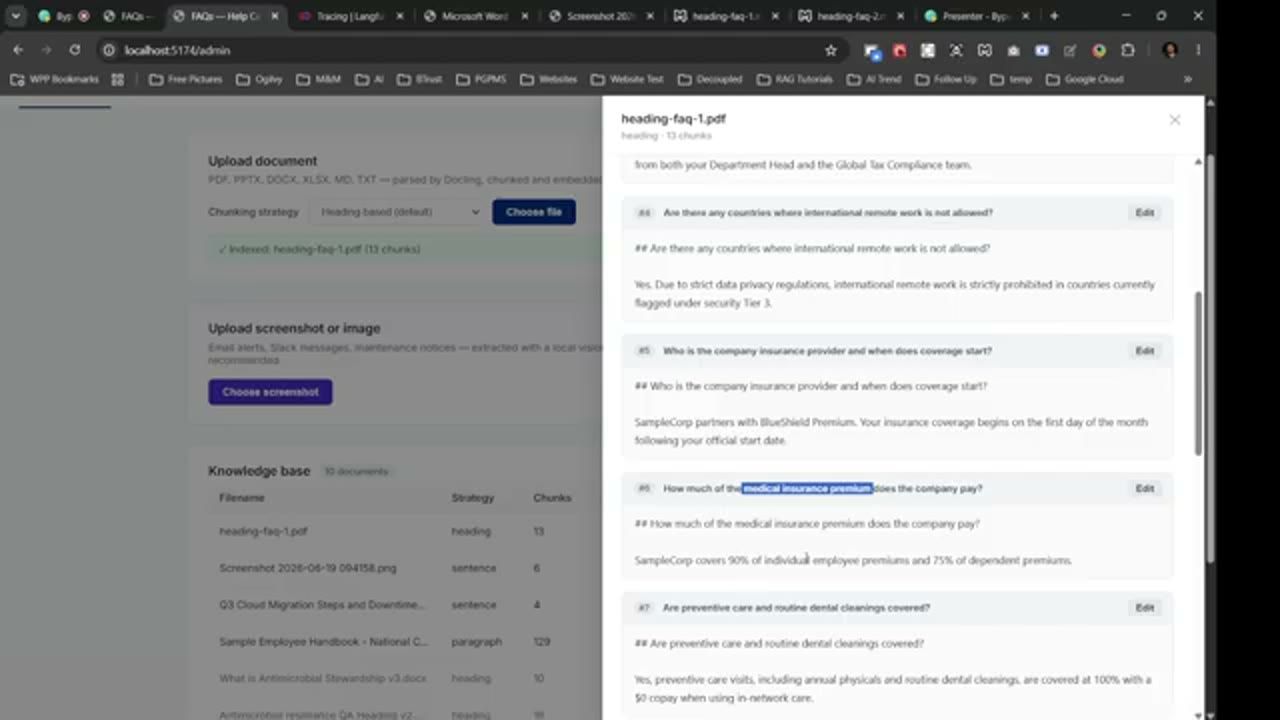
Giờ nếu ta hỏi chatbot một câu, chẳng hạn "do we have medical insurance premium?", ta nên kỳ vọng một câu trả lời có reference trỏ về đúng chunk đó. Ta đang nói về heading chunk: hệ thống hiểu tài liệu dựa trên các heading bạn có, và chunk từng tài liệu theo từng heading một.
Câu hỏi đó là câu đã chuẩn bị sẵn, và câu trả lời cũng là câu trả lời đã chuẩn bị: công ty mẫu chi trả chín mươi phần trăm phí bảo hiểm cho cá nhân nhân viên và bảy mươi lăm phần trăm phí cho người phụ thuộc. Phần reference cho thấy ta nhận được đúng câu trả lời đó. Không chỉ là câu trả lời đúng: bạn còn thấy câu trả lời này được sinh ra dựa trên tài liệu này, dựa trên chunk này. Nên dẫn nguồn rất dễ, và bạn biết vấn đề nằm ở đâu. Nếu có gì không chạy, bạn biết vì sao, và có thể lần theo xem tại sao chunk đúng lại không được retrieve. Theo cách này, bạn có một con đường rõ ràng hơn để debug.
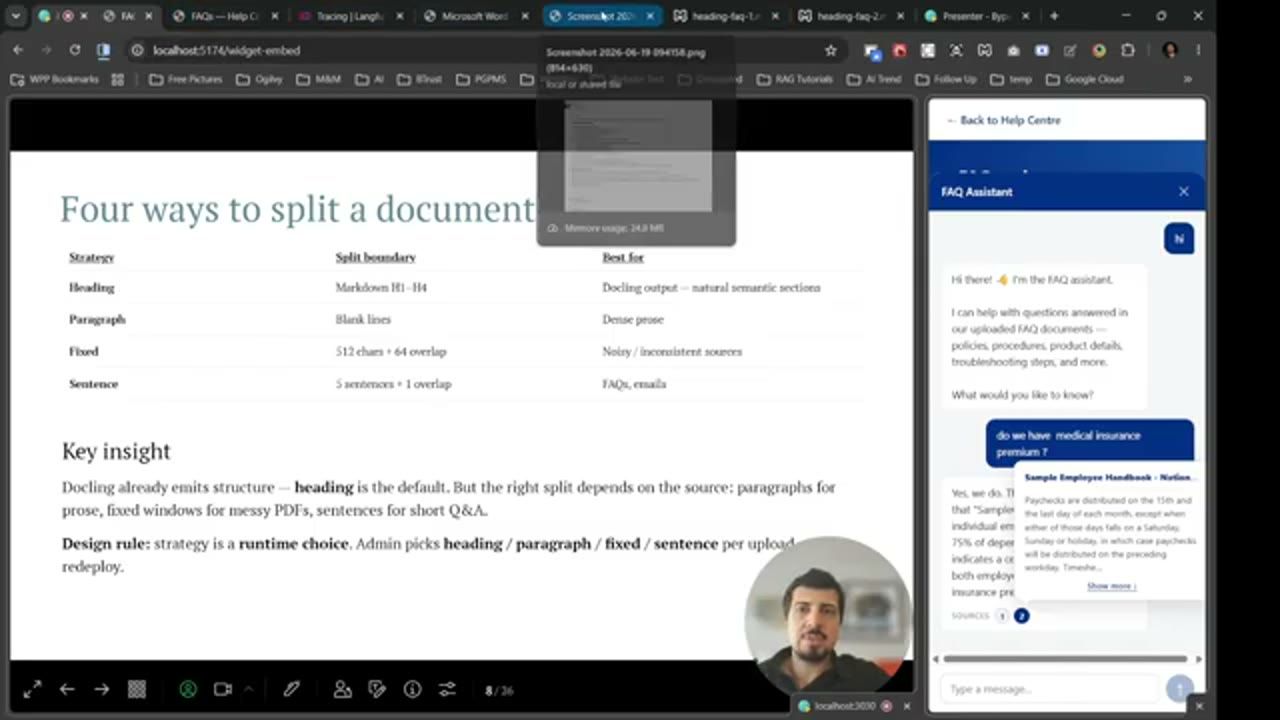
Hệ thống được cấu hình trả về top hai chunk (Abed sẽ nói thêm về các model ở phần sau), nên nó mang về hai kết quả. Nguồn thứ hai là cuốn sample employee handbook, file lớn kia. Như bạn thấy, đó là một chunk rất lớn. Và đây thực ra là một ví dụ hay, nếu so sánh hai nguồn với nhau, vì cuốn handbook được upload nguyên khối. Dù nó có trả về chút thông tin, thông tin đó không chính xác bằng, và bạn không biết nó chính xác tới đâu. Tất nhiên hệ thống đã đi qua file đó và tìm được gì đó, nhưng bạn không biết độ chính xác, và bạn không lần theo được, vì chunk đó không dễ truy vết.
8. Chiến lược 2: paragraph chunking
Vậy là cách chunk thứ nhất dựa trên heading. Cách thứ hai dựa trên paragraph. Về cơ bản, khi upload tài liệu, bạn nói với hệ thống: cứ mỗi đoạn văn bắt được thì làm thành một chunk riêng. Không quan tâm có heading hay không, hay bất cứ thứ gì khác.
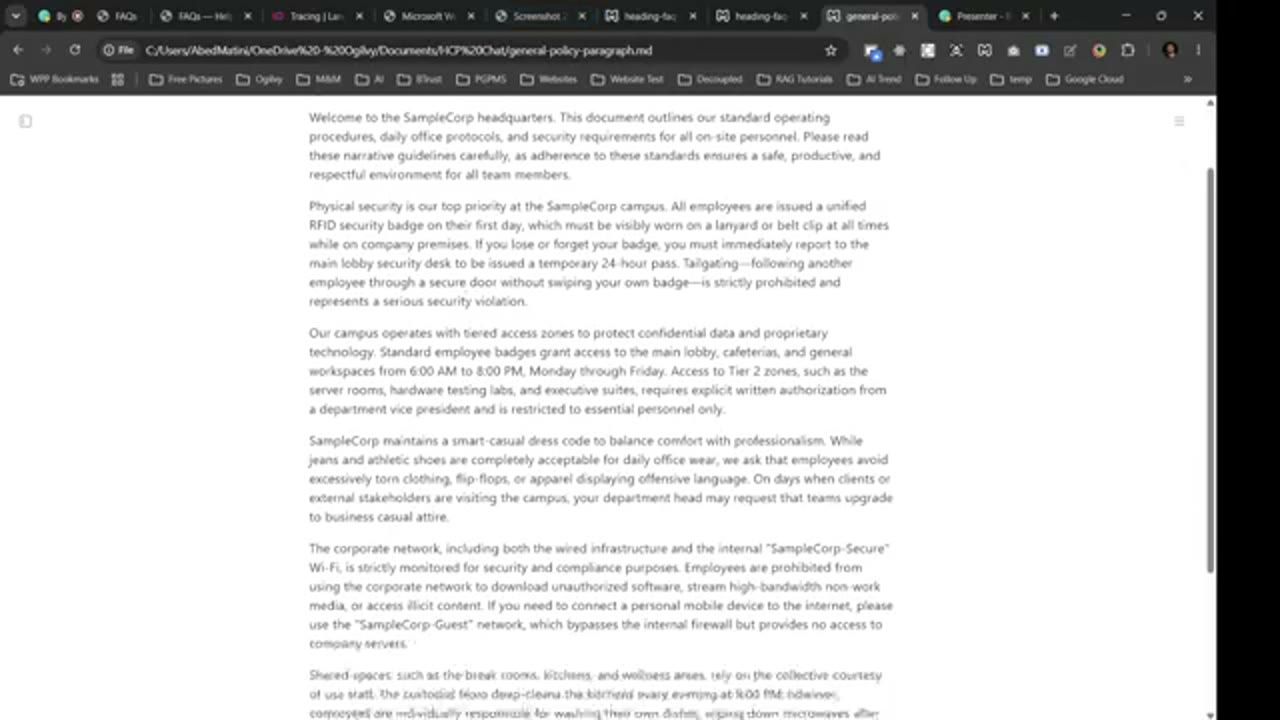
Abed quay lại phần tài liệu và chọn paragraph chunking. Anh tìm file paragraph, "general policy", và upload nó. Như bạn thấy, toàn bộ file chỉ được chia theo đoạn văn, từng đoạn một thành một chunk. Không có heading, không có thông tin tách riêng nào.
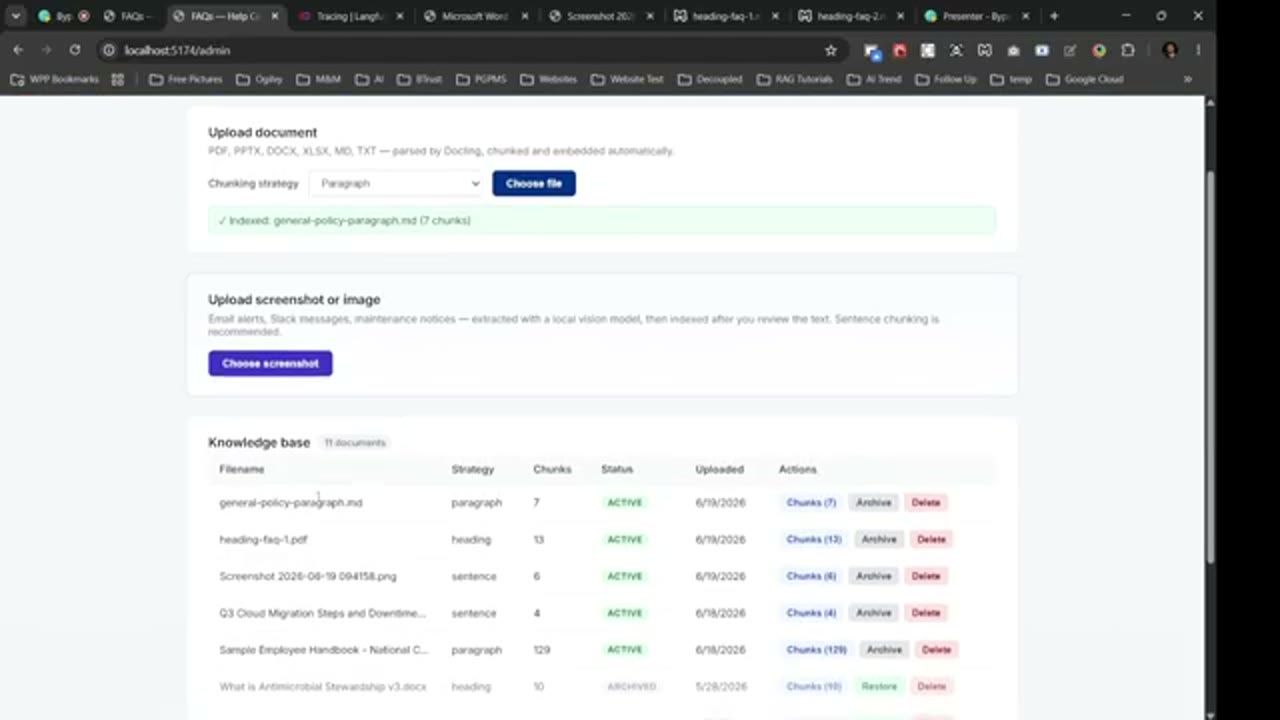
Và nếu nhìn vào chính thông tin đó, tìm nhanh file general policy paragraph, bạn thấy thông tin chỉ là từng đoạn văn nối tiếp nhau. Tức là bạn lại dọn dữ liệu, nhưng chia theo một hệ thống khác: thay vì heading, ở đây là đoạn văn. Đó là một cách khác để nuôi RAG bằng thông tin.
9. Chiến lược 3 và 4: fixed 512 ký tự có overlap, và sentence groups
Cách thứ ba là fixed 512 ký tự. Bạn có thể nói: một trong những best practice của RAG là chỉ cần chia theo 512 ký tự, và có 64 ký tự overlap giữa các chunk, để không mất mạch. Nếu dữ liệu của bạn không được tổ chức, chỉ là dữ liệu lộn xộn mà bạn không dọn được, thì đó là một cách khác để upload tài liệu.
Lần này anh chọn một file khác: một file paragraph nữa, cho global travel. Khi nhìn vào chunking strategy này, bạn thấy nó bắt đầu chunk, rồi kết thúc ở 512. Rồi nó lại dùng, anh nghĩ là 64, đúng, 64 overlap. Nó dùng 64 overlap ở đây. Bạn thấy nó cắt từ chỗ này, từ đây tới đây là 512, từ đây tới đây là 32, rồi thêm 32 nữa từ đây tới đây. Tức là 32 cộng 32, tổng cộng 64. Đó là cách nó nối các chunk với nhau, và chuyện tương tự xảy ra ở các chỗ khác.
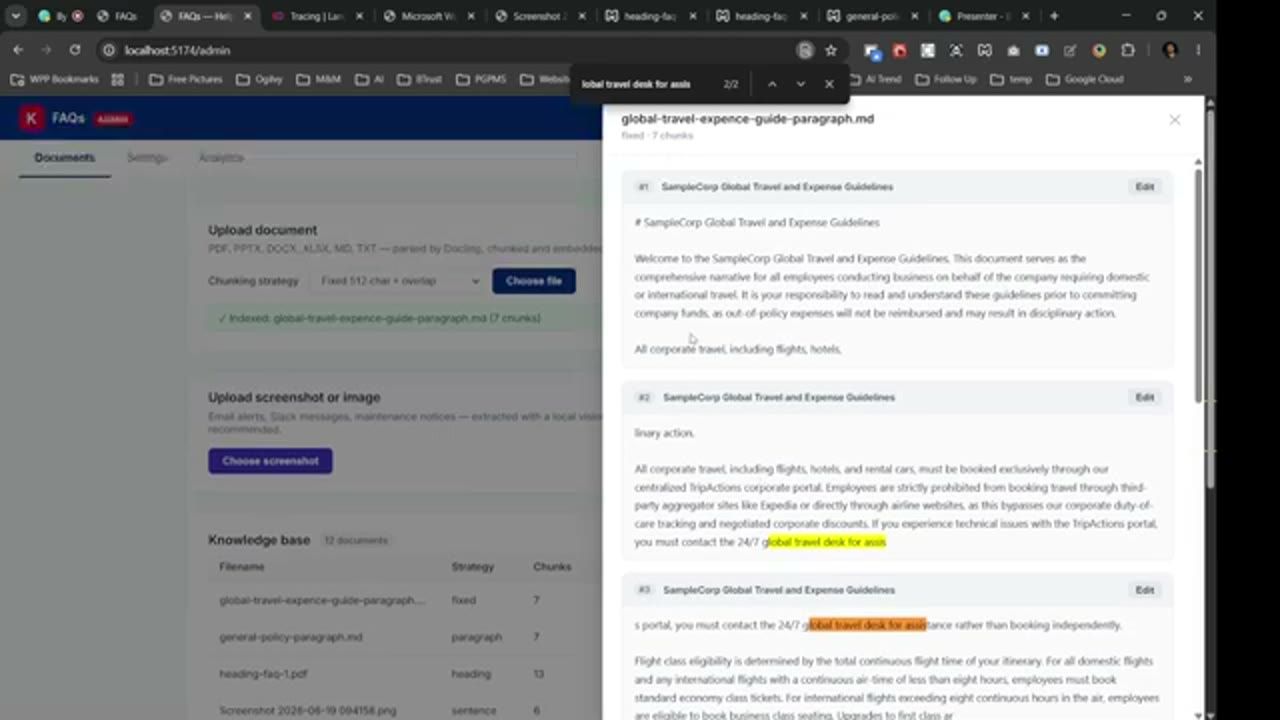
Nhưng bạn thấy vấn đề của nó: ở chỗ này, chữ "assist" và "assistance" bị cắt, nó làm gãy chữ. Đây không phải cách tốt nhất, nhưng trong vài trường hợp nó vẫn có tác dụng.
Cách thứ tư là sentence-based. Nó có thể dựa trên năm câu: hệ thống đếm số câu và cắt ở đó. Mỗi cách có use case riêng.
10. Upload một screenshot: thông báo bảo trì cuối tuần
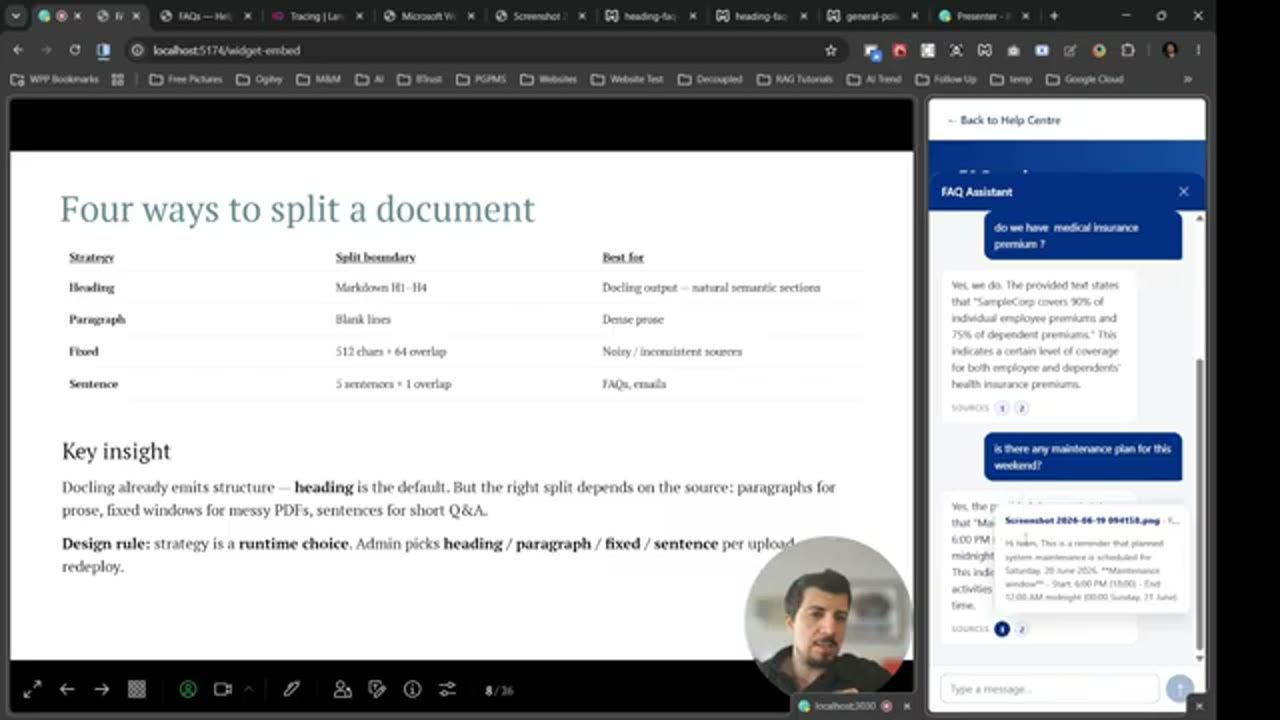
Một ví dụ thú vị khác: hãy tưởng tượng sắp có một đợt bảo trì, bạn nhận được một email, và bạn muốn upload nhanh tài liệu đó vào chat. Bạn không có gì khác ngoài một tấm screenshot. Giả sử bạn vừa nhận email nói rằng có kế hoạch bảo trì vào ngày này, từ giờ này, và bạn chỉ muốn upload nó vào chat cho user. Như vậy nếu tôi, một nhân viên, hỏi "cuối tuần này có kế hoạch bảo trì nào không?", tôi sẽ biết ngay.
Nên có một cách khác để upload screenshot dễ dàng. Abed đi tìm file, xin lỗi vì nó nằm trong thư mục screenshot của anh. Bạn upload screenshot, rồi hệ thống dùng một model khác biến ảnh thành text, và text thành file .md. Sau đó dùng strategy sentence cho các email để chunk text đó và đưa vào. Strategy được chọn là sentence group. Ảnh đã được biến thành text, và đã sẵn sàng cho chatbot: giờ ta có thể index nó vào knowledge base.
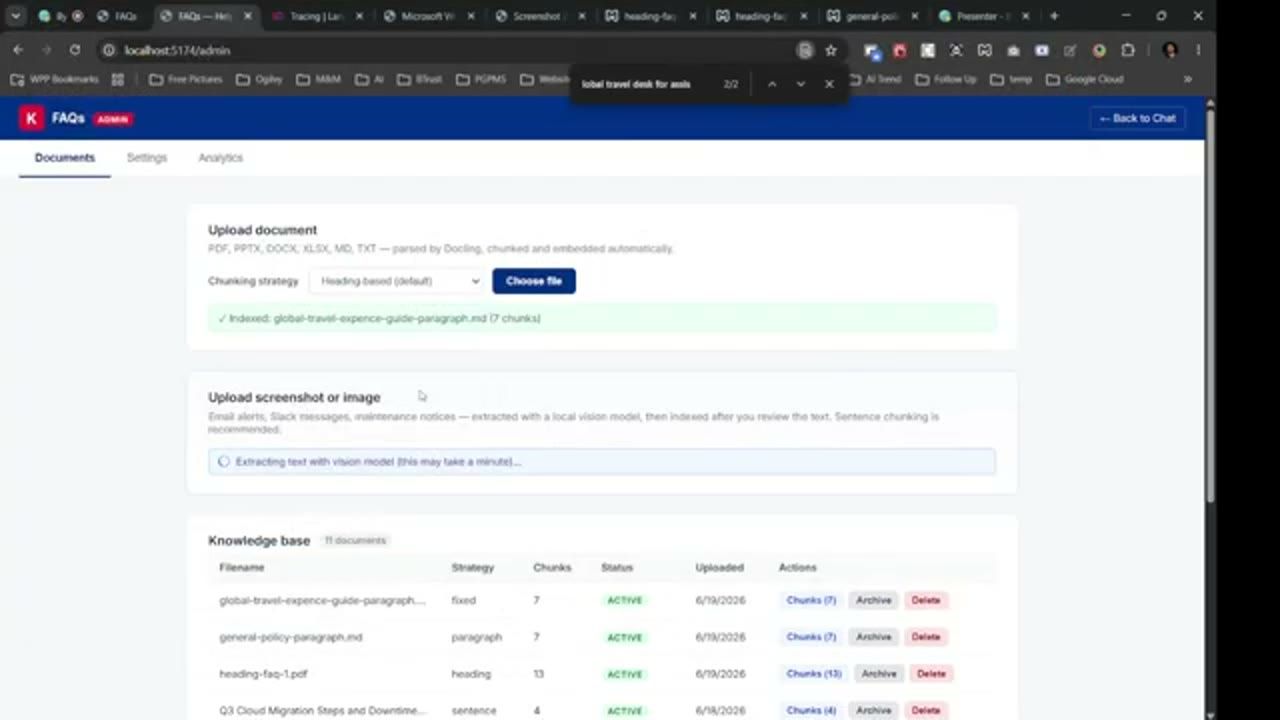
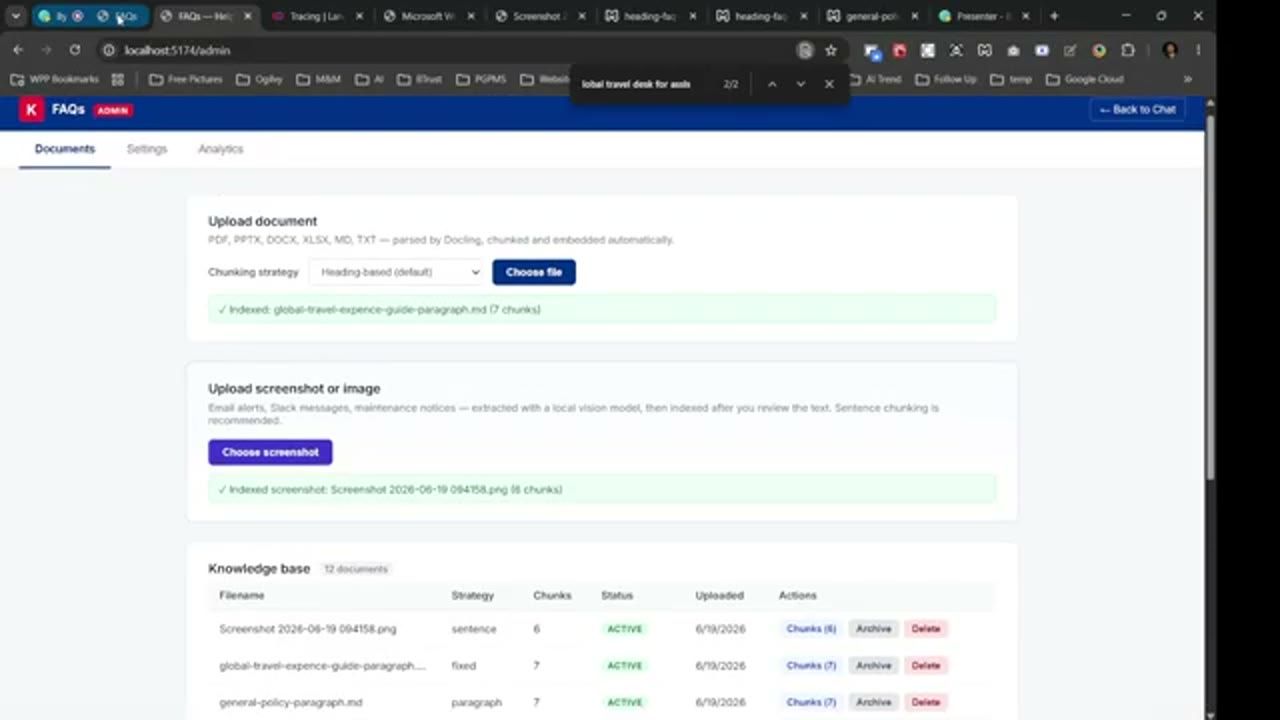
File vừa upload xuất hiện kế tiếp trong danh sách: screenshot. Ta xem được nó được chunk ra sao. Vì đây chỉ là một email, nó không có heading, cũng không nhất thiết có các đoạn văn được chia gọn gàng. Và khi thiếu thời gian, khi đó chỉ là một tin nhắn ngắn, một thay đổi tạm thời, bạn không cần ngồi dọn dữ liệu. Bạn chỉ muốn kéo thả, cập nhật cho cuối tuần, và ai cũng biết cuối tuần này có kế hoạch bảo trì.
Rồi khi quay lại khung chat và hỏi "is there any maintenance plan for this weekend?", về lý ta sẽ nhận được kết quả: đây là kế hoạch bảo trì sắp diễn ra, kèm tài liệu reference. Đây đúng là khung giờ bảo trì ta nhận được. Và thực ra reference là chính tấm screenshot vừa upload. Abed cười: giá mà anh đặt tên file screenshot cho tử tế hơn thì reference còn rõ nghĩa hơn nữa.
Khi rê chuột lên nguồn số 1, tooltip cho thấy nội dung đã trích từ tấm ảnh: một thông báo nhắc cả nhóm rằng bảo trì hệ thống được lên lịch vào thứ Bảy, 20 tháng 6 năm 2026, "maintenance window" bắt đầu 6:00 PM (18:00) và kết thúc 12:00 AM nửa đêm (00:00 Chủ nhật, 21 tháng 6).
Và một người sẽ nói: "theo thông tin tôi lấy được từ đây, ngày mai có kế hoạch bảo trì, từ 6 giờ chiều tới nửa đêm." Abed cũng cho thấy anh có thể archive hay xoá bất kỳ tài liệu nào trong số này một cách dễ dàng, và khi đó nó sẽ không còn hiển thị nữa.
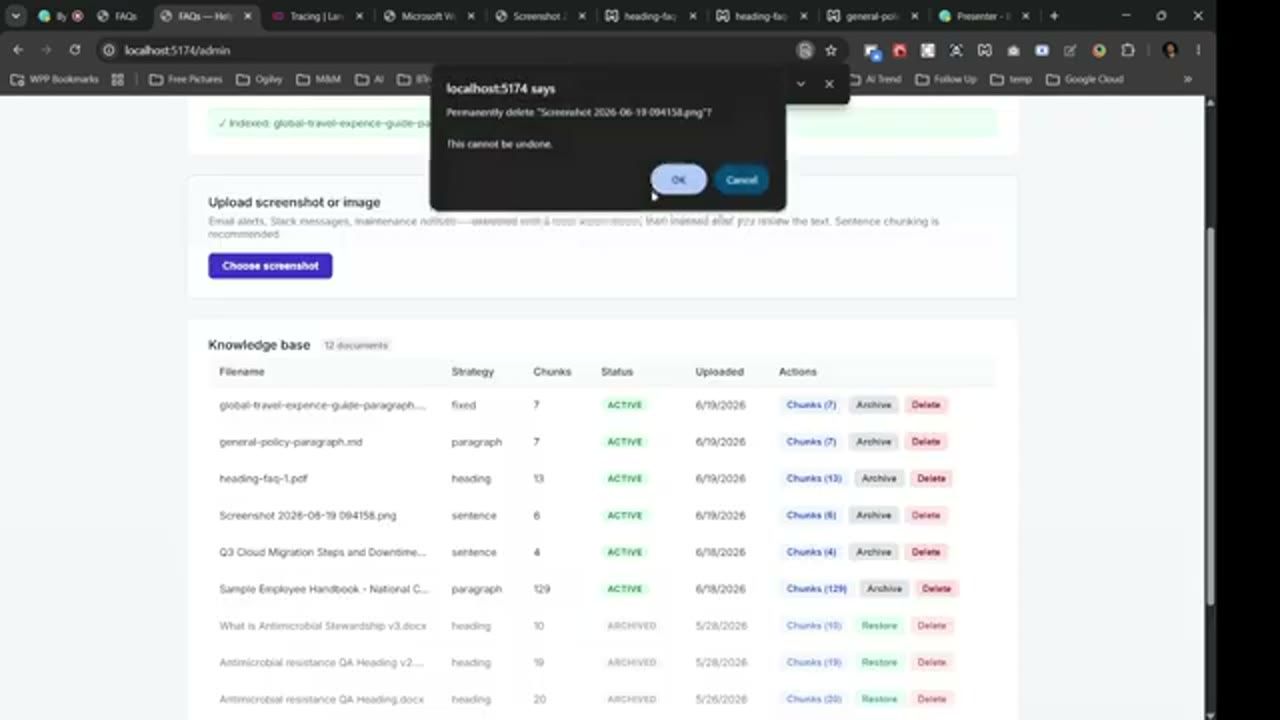
Đó về cơ bản là những cách khác nhau để chunk. Và đây là một trong những phần quan trọng nhất của toàn bộ hệ thống, vì hầu hết các LLM đều sẽ chạy được. Cái quyết định là cách bạn nuôi dữ liệu và dọn dữ liệu: không kéo thả nguyên cuốn handbook vào để có một mớ dữ liệu lộn xộn. Điều đó giúp bạn rất nhiều để có một chatbot, trong trường hợp này là FAQ chatbot, thành công hơn. Các strategy khác nhau này sẽ giúp bạn. Rồi anh chuyển sang slide kế tiếp.
11. Agent chỉ là Python function
Hệ thống dùng Postgres, và cũng có vài agent, nhưng các agent đó chỉ là code Python. Chúng không thực sự là gì khác: hệ thống không gọi thêm một LLM nữa làm agent để làm việc gì đó cho ta. Một lý do là tốc độ, vì Abed chạy tất cả local, trên Ollama. Anh không cần ba, bốn agent lặp ba lần, bốn lần, vì khi đó anh sẽ phải chờ 20, 30 giây, và user sẽ mất hứng. Bạn chỉ muốn một lượt natural language chạy thôi. Phần còn lại, nếu một Python function làm được, thì để Python function chạy cho bạn.
Khi đó bạn cũng có toàn quyền kiểm soát function. Sẽ không có hallucination, vì bạn sẽ viết test suite để bao phủ phần lớn các tình huống. Điều đó giúp ích cho bạn.
Với các agent, anh cho xem phần settings. Anh có thể bật tắt agent. Ví dụ nếu ai đó muốn biết ngày hiện tại, function này được gọi và trả về dễ dàng. Bạn không cần LLM mang về ngày hiện tại. Bạn không cần LLM tính toán gì đó cho bạn. Vì một kế hoạch khác để mở rộng chatbot này là dùng nó cho customer service, nơi sẽ nói về sản phẩm, giá cả và tính toán. Đó là một hướng khác: thông tin sản phẩm, hay thậm chí một lượt search sâu hơn ở agent mode. Nhưng điểm cần lưu ý là vì đó lại là một lượt search khác, bạn sẽ mất phần reference ở đó. Và reference là điều quan trọng.
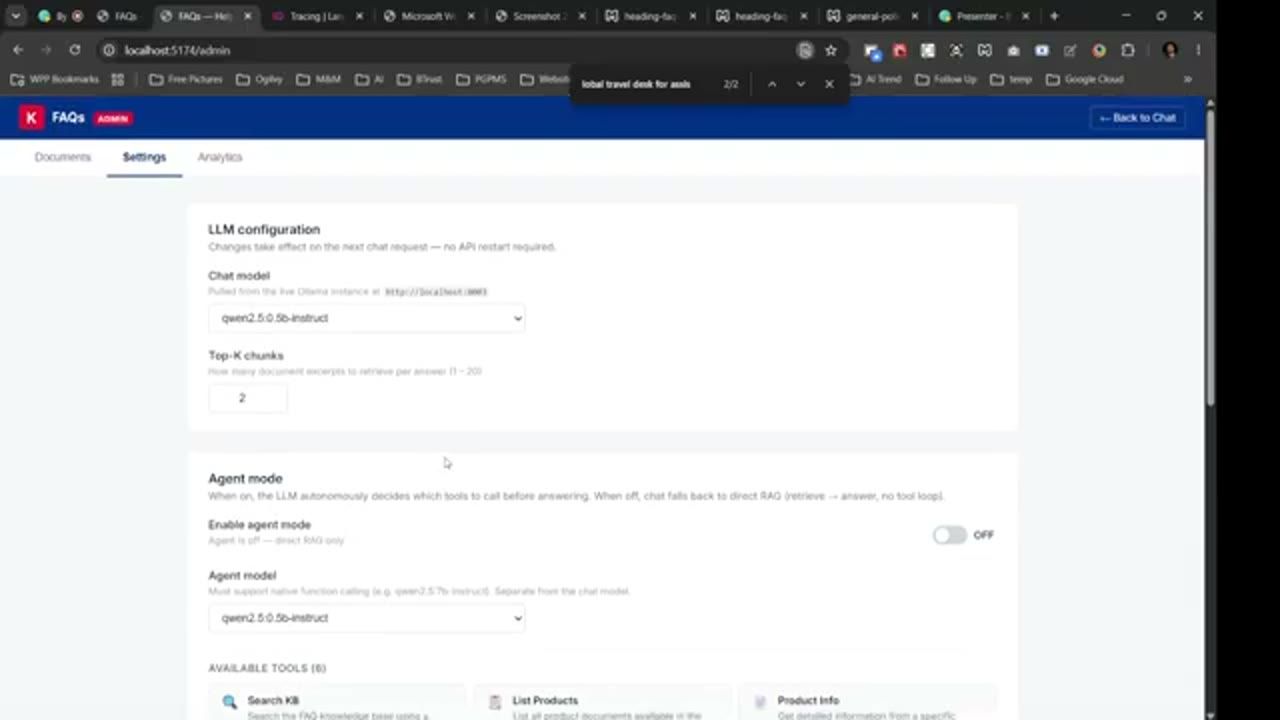
Nhân tiện đang ở đây, anh cho xem mình thực sự dùng LLM nào. Anh dùng model nhỏ nhất của Qwen 2.5: bản instruct 0.5 tỷ tham số, và anh nghĩ nó chỉ khoảng 400 megabyte. Nhỏ tới mức đó. Anh cũng dùng model này cho agent mode nếu muốn chạy. Bật agent mode sẽ làm hệ thống chậm hơn một chút. Rồi anh quay lại slide.
Với cách làm việc này, bạn có toàn bộ visibility vào Python function: biết chuyện gì đang diễn ra. Bạn chỉ đưa cho LLM thông tin cần thiết, thông tin rõ ràng, và nhận lại thông tin rõ ràng. Điều đó giảm khả năng hallucination một cách đáng kể.
12. Hybrid search trong Postgres: semantic, keyword và số lượng retrieve
Tiếp theo, Abed nói về vector và text trong database. Khi chunk thông tin, mỗi chunk được lưu theo ID và section, cùng với loại vector embedding đang dùng. Rồi ta có chunk của mình, và thấy được cách hệ thống tìm nearest neighbor, đồng thời cũng tìm keyword match.
Vì sao cần cả hai? Nếu bạn có một chatbot customer service về sản phẩm, bạn không cần thông tin gần nhất. Bạn cần thông tin chính xác. Khi đụng tới con số, khi đụng tới sản phẩm, bạn cần đúng chính xác. Nếu là một chatbot y tế, bạn cần đúng loại thuốc đó, chứ không cần thứ gì tương tự hay gần giống. Nên ta cần cả keyword search lẫn semantic search cùng lúc. Ta có một hybrid search cho kết quả tốt hơn.
Rồi tới số lượng kết quả retrieve. Trong hệ thống, Abed giới hạn ở hai, vì trong trường hợp này không cần nhiều hơn. Nhưng nếu đó là sản phẩm, bạn không muốn chỉ mang về top hai sản phẩm cho user, vì có thể có hai mươi hay năm mươi sản phẩm cùng một brand. Nếu bạn không mở cửa sổ đủ rộng để kéo những thông tin đó về, những sản phẩm đó sẽ không bao giờ được bán và không bao giờ xuất hiện trong chatbot. Nên số lượng bạn fetch được là điều quan trọng.
Thêm về retrieval: ta dùng BM25 để lấy đúng keyword. Slide trước nói về việc lấy những gì gần nhất theo cosine distance. Khi upload thông tin vào vector database, những thông tin có nghĩa tương tự sẽ nằm cạnh nhau. Khi user tìm hay hỏi gì đó, hệ thống chuyển câu hỏi, câu query đó vào không gian của database, đi tìm những thông tin gần nhất với câu hỏi và trả về. Đó là lý do ta không thể chỉ trả về một kết quả: ta cần trả về nhiều hơn, để có nhiều câu trả lời và những câu trả lời sát hơn.
Còn ở sparse retrieval, ta cần câu trả lời chính xác, nên ta phải lọc, ví dụ theo ngôn ngữ, theo ID, theo đúng tên sản phẩm, SKU, hay tên brand. Đó là phần keyword retrieval.
Rồi tới chuyện ranking, và đây là phần rất quan trọng. Khi có cả kết quả vector lẫn kết quả BM25, ta muốn trộn chúng lại mà vẫn mang về top hai hay top năm câu trả lời liên quan mà ta cần. Như vậy chính xác hơn. Nếu ta mang về quá nhiều, chẳng hạn hiển thị top hai mươi câu trả lời, user sẽ khá bối rối. Bạn chỉ muốn đảm bảo mang về đúng số lượng tuỳ theo use case. Nếu là sản phẩm, bạn mang về nhiều hơn, retrieve nhiều hơn. Nếu là thứ gì đó về y tế, bạn retrieve ít hơn. Bạn không muốn thông tin tràn lan khắp nơi. Bạn muốn thông tin chính xác hơn, vì hiển nhiên khi đó bạn chịu nhiều trách nhiệm pháp lý (liability) hơn.
Một điểm nữa là re-ranker. Khi có re-ranker, nó cũng mang thông tin về, rồi sau khi chấm điểm, ta quyết định mặc định hiển thị bao nhiêu kết quả. Ở đây Abed chỉ hiển thị hai.
13. Agent mode và direct RAG
Abed đã nói qua về agent mode so với direct RAG. Direct RAG chỉ đi theo một pipeline cố định. Nó không đi gọi thứ gì khác. Con đường khá rõ ràng: bạn embed query, có một hybrid retriever, và mang câu trả lời về. Nó hợp khi compliance là điều quan trọng với bạn.
Còn agent mode thì có thêm vài tool sẽ được gọi, ví dụ search hay compare product. Những tool này có thể mang về nhiều thông tin hơn, nhưng nằm ngoài tầm kiểm soát của bạn nhiều hơn. Điều đó khá quan trọng. Và nó mất thời gian hơn, vì có thêm một agent nữa làm việc. Về cơ bản, hệ thống lấy thông tin này, rồi agent mode dựa trên request của bạn sẽ gọi tool. Nên nó mất thời gian hơn một chút.
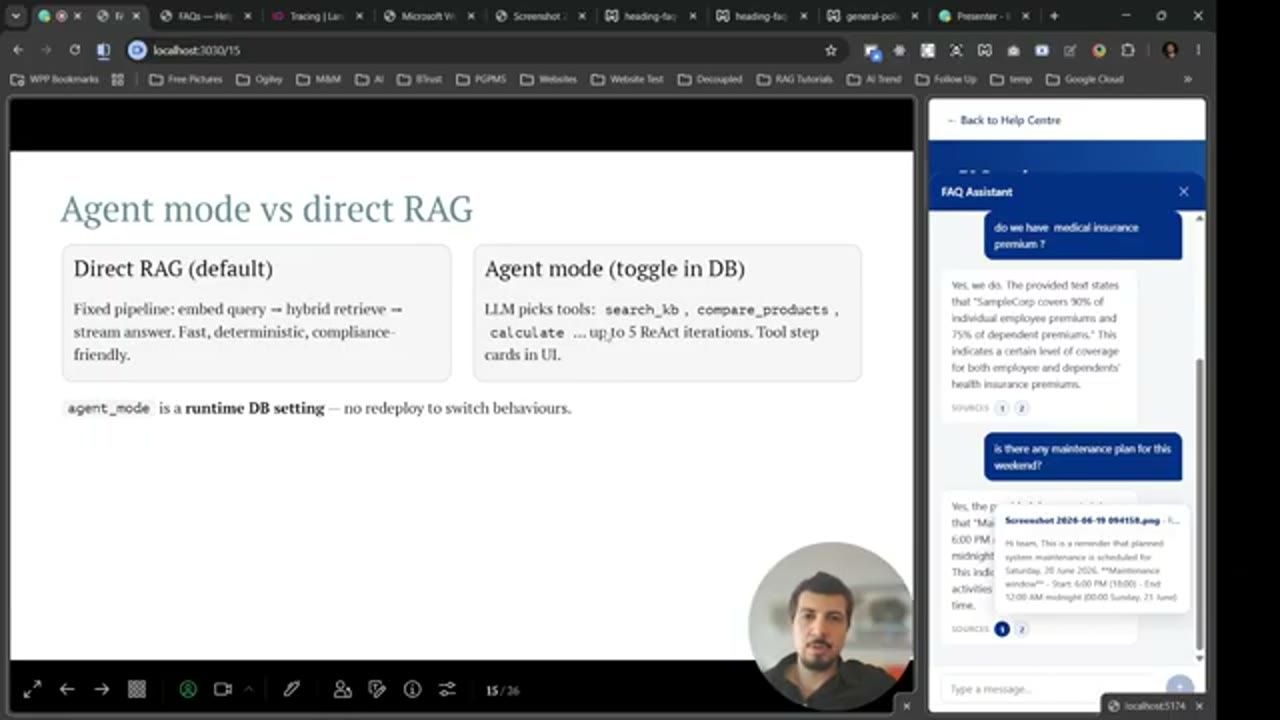
search_kb, compare_products, calculate, tối đa 5 vòng ReAct, mỗi bước tool hiện thành một thẻ trong UI. Dòng cuối: agent_mode là một setting trong DB lúc runtime, đổi hành vi mà không cần redeploy. Khung chat bên phải vẫn giữ câu trả lời cho câu hỏi về bảo trì cuối tuần đã demo ở mục 10.14. Telemetry với Langfuse
Phần tiếp theo là telemetry và application guardrail. Có thể dùng Langfuse: nhóm đã tích hợp Langfuse vào function, nên có thể xem có những loại câu trả lời nào. Việc này khá dễ. Mọi thứ đều chạy local, không gọi ra ngoài gì cả, nên dễ theo dõi thông tin. Ví dụ, phiên Abed vừa chat qua widget là ẩn danh (anonymous), vì anh chưa đăng nhập. "FAQ chat", "FAQ agent" là tên của toàn bộ project anh đang chạy.
Mỗi cuộc hội thoại có một ID. Bạn có thể lần theo câu hỏi "có bảo trì nào cuối tuần này không" và câu trả lời cho nó. Bạn thấy được model nào đã dùng. Bạn thấy hệ thống đã trả về top hai kết quả, và vì là top hai nên nó reference tới tấm ảnh đó hai lần. Agent mode đang tắt. Đó là một lượt chat. Hai chunk thông tin được trả về, và lượt đó mất chừng ấy millisecond. Về cơ bản đó là những thông tin ta có.
Nếu dùng model bên ngoài, bạn còn có thể ước tính chi phí đang chi. Đó là một việc khác bạn có thể dùng nó để làm. Và nếu có nhiều session, nhiều user khác nhau, bạn có thể theo dõi lượt đăng nhập. Điều đó cho bạn cái nhìn tốt về cách user tương tác với chatbot.
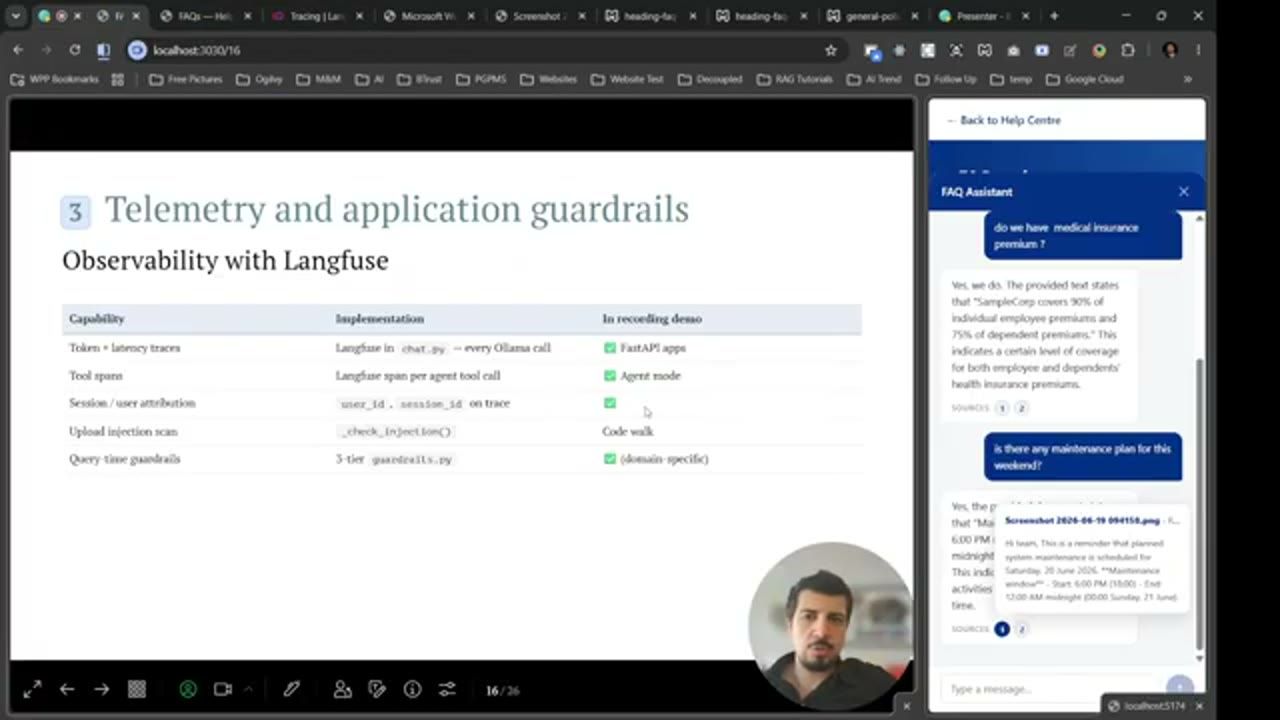
chat.py, bọc mọi lời gọi Ollama (có, trong app FastAPI). Tool span: một Langfuse span cho mỗi lần agent gọi tool (có, ở agent mode). Gắn session và user: user_id, session_id trên trace (có). Quét injection lúc upload: _check_injection() (chỉ đi qua code). Guardrail lúc query: guardrails.py ba tầng (có, theo từng domain).Như đã nói về user session và ID, tiếp theo ta có guardrail.
15. Guardrail viết trong code, không viết trong prompt
Vì dùng function cho guardrail, ta kiểm soát chúng tốt hơn. Abed hỏi chatbot: "how do I treat flu?" Anh đã tạo một phần riêng để trả lời mà không đi vào chat. Điểm mấu chốt của rất nhiều guardrail là: vấn đề phải bị chặn trước khi ta gửi đi. Một prompt injection, hay một câu hỏi mà ta không được phép trả lời, thì không nên gửi tới LLM để sinh ra bất cứ thứ gì. Nên ngay trong code, trước cả LLM, anh đã tạo một phần nói rằng: nếu có medical escalation, trả về thông điệp y tế này.
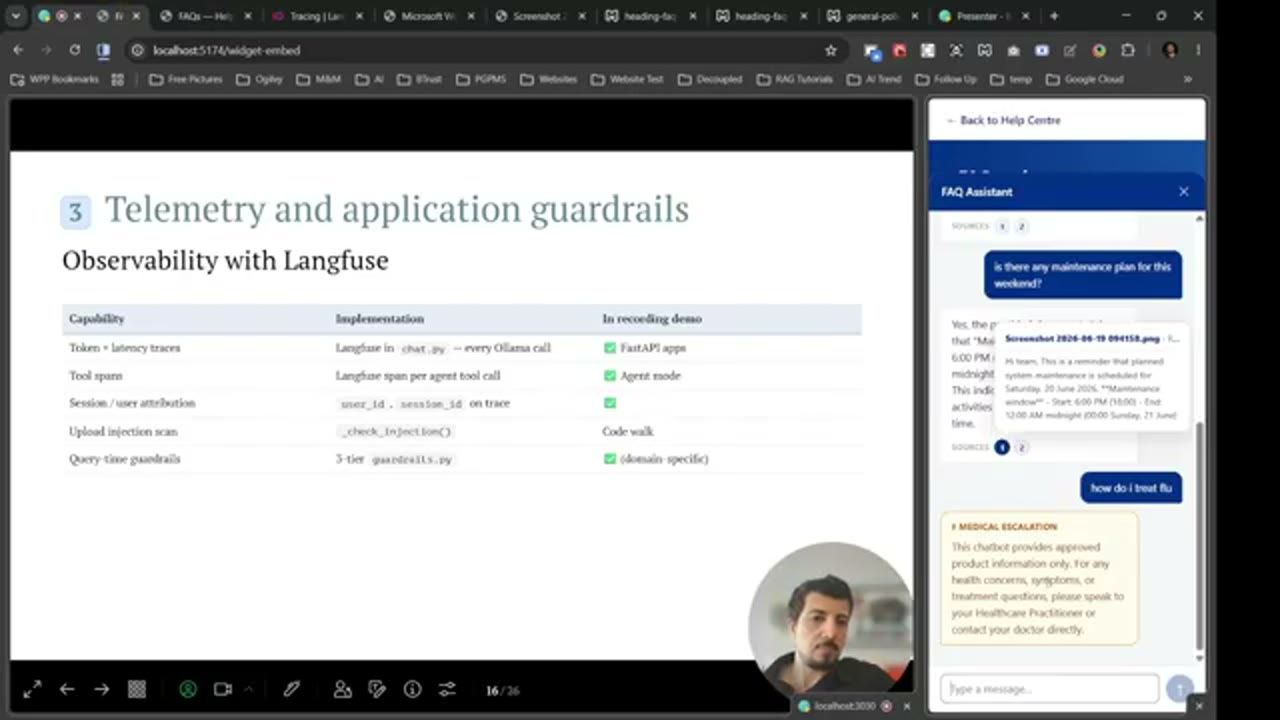
Bạn cũng thấy system prompt khá ngắn, vì về cơ bản Abed viết prompt cho mọi thứ trong code. System prompt trông rất nhỏ, chỉ vài câu, nhưng thực ra anh "prompt" nhiều hơn hẳn ở trong code thay vì trong prompt. Anh dùng code để nói điều gì nên làm và điều gì không. Medical escalation là một ví dụ, và bạn có thể thêm nhiều hơn tuỳ theo những mối lo của bạn với sản phẩm.
Đây là một ví dụ. Nó cần được mở rộng với nhiều keyword khác nhau, nhiều kiểu câu khác nhau, cần được thử để xem bao nhiêu lần ai đó có thể lách qua hay không. Nhưng về lý, đó là ví dụ về cách ta nên chặn, cách guardrail nên chặn mọi câu query không liên quan. Có thể làm tương tự với injection, v.v.
Còn gì nữa? Đã nói về Langfuse. Để dùng Langfuse, ta chỉ cần tạo một key và đặt vào hệ thống, thế là nó chạy. Đó là một chút về observability mà anh đã nói.
Rồi tới injection. Với các tool chống prompt injection, một lần nữa: nó không được đi tới LLM, nó phải bị chặn ở đó. Nó phải bị chặn trước khi được gửi đi. Hệ thống dùng intent regex, term dictionary và một LLM classifier để chặn những vấn đề này. Và tất nhiên có thể mở rộng thêm.
Cái hay là vì nó chỉ là code, nó không cần một prompt dài, không cần gì cả. Kết quả là hiển nhiên: bạn biết mình đang chặn gì và không chặn gì. Nó không giống một LLM, lúc thì chịu nghe instruction của bạn, lúc thì lách ra và làm theo ý nó. Một phần lợi ích của việc tích hợp tất cả những thứ này vào Python trước khi gửi đi là bạn có thể có test chặt chẽ, để nói rằng: "đây là thứ tôi đang chặn, đây là lý do", và nó qua hết các test. Nhờ vậy bạn chắc chắn hơn.
16. Widget nhúng được, consent và hai model nhỏ
Tiếp theo là một slide nhỏ về widget. Abed đang chạy chatbot dưới dạng một widget, nhưng nó cũng có thể chạy trong một khung chat lớn hơn. Một điều nữa: trong khung chat, như một phần của luật chơi, bạn nên hỏi xem người dùng có đồng ý với các điều khoản họ đang dùng không. Nếu không, người đó sẽ không bắt đầu chat được.
Anh cũng cho widget khả năng reset consent nếu muốn: user có thể đặt lại sự đồng ý của mình. Việc này chỉ phục vụ mục đích demo. Khi đó widget sẽ hiện ra: nếu anh chọn không, nó sẽ không chạy. Nếu reset consent rồi chọn có, nó sẽ bắt đầu. Đó là phần về widget. Và vì anh dùng React, widget có thể dùng với bất kỳ framework nào khác. Anh dùng React chỉ cho đơn giản.
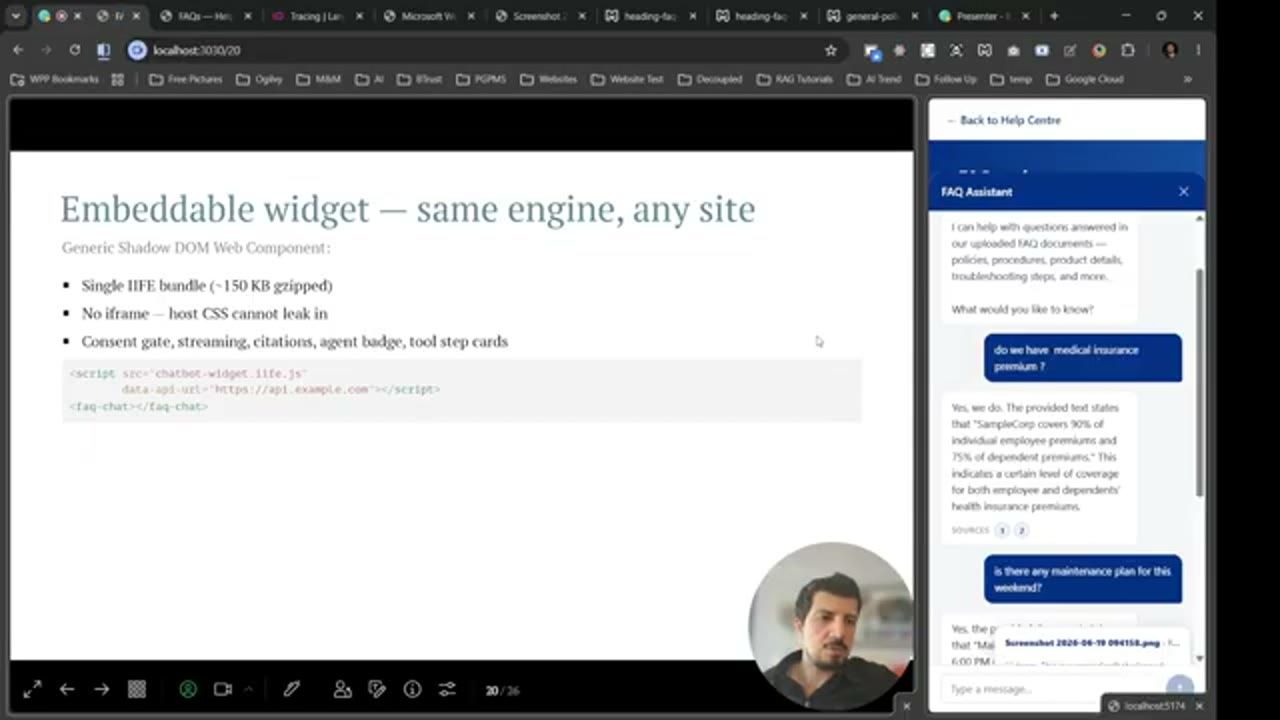
<script src="chatbot-widget.iife.js"
        data-api-url="https://api.example.com"></script>
<faq-chat></faq-chat>
Rồi tới các model đã dùng. Abed dùng hai model. Anh pull Qwen 2.5 về. Thực ra ban đầu anh dùng bản bảy tỷ tham số, nhưng nó chạy lâu hơn. Nên cho một server nhỏ hơn, anh đổi sang bản 0.5. Anh mở trang admin để cho xem: anh có nhiều lựa chọn khác, và đã thử nhiều model khác nhau. Nếu dùng model lớn hơn, nó chỉ chạy lâu hơn, và có thể dài dòng quá mức.
Phát hiện thú vị của anh là: bạn không cần model lớn nhất. Nếu bạn sàng lọc dữ liệu trước khi gửi tới LLM, một model nhỏ, model nhỏ nhất, vẫn xử lý được và cho bạn câu trả lời tốt. Và nó cho bạn ít hallucination hơn. Nó an toàn hơn, vì nó sẽ không bịa ra thông tin. Nếu không có thông tin, nó chỉ đơn giản nói: "Không, tôi không có thông tin đó." Đó là một cách guardrail khác, để không gặp chuyện LLM sinh ra thứ gì đó ngẫu nhiên.
Model thứ hai là embedding model BGE-M3. Khi upload bất cứ thứ gì, embedding model đó làm phần embedding. Nên về lý, bạn chỉ cần hai model: model chat nhỏ nhất, và một trong những model nhỏ nhất cho embedding.
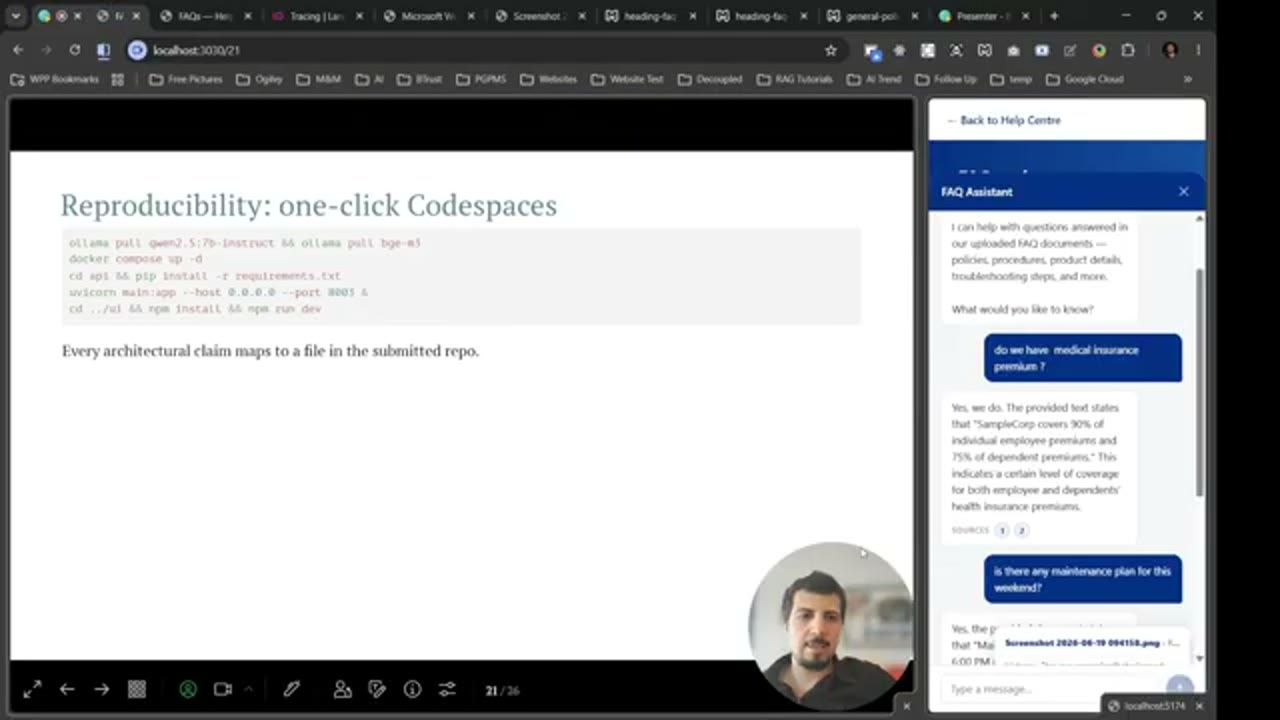
qwen2.5:7b-instruct, còn trong demo Abed nói anh đã đổi sang bản 0.5B cho server nhỏ. Dòng cuối slide: mọi khẳng định về kiến trúc đều trỏ tới một file trong repo đã nộp.ollama pull qwen2.5:7b-instruct && ollama pull bge-m3 docker compose up -d cd api && pip install -r requirements.txt uvicorn main:app --host 0.0.0.0 --port 8003 & cd ../ui && npm install && npm run dev
Rồi nếu chạy trên Docker, một cú click là mọi thứ chạy. Bạn cần cài Python requirements, rồi có React chạy ở front-end. Thế là đủ. Abed nói còn một thứ đáng lẽ anh phải thêm vào slide mà chưa thêm: Langfuse cũng cần được thêm ở đây. Nó chạy ở một port khác, và đang thiếu trên slide này.
17. Key takeaway và lời kết
Key takeaway của talk:
- Markdown có cấu trúc trước tiên. Dùng Docling làm phần việc nặng.
- Postgres làm vector database và lưu mọi thứ ở đó.
- Không dùng framework cụ thể nào. Chỉ dùng Ollama cho chat, không có framework trả phí nào khác ở đâu cả.
- Langfuse cho telemetry, cũng dùng miễn phí.
- Cách làm này có thể mở rộng sang những sản phẩm khác: tài liệu, catalog, hay dữ liệu từ bất kỳ database nào.
Abed cảm ơn mọi người đã dành thời gian. Anh muốn được kết nối, và nếu ai có câu hỏi, có lo ngại gì, hay nghĩ ra điều gì có thể tích hợp tốt hơn, hãy chia sẻ ý tưởng với anh, trong phần comment hoặc nhắn cho anh trên LinkedIn. Anh cảm ơn AI Engineer đã cho anh cơ hội, và hẹn gặp lại lần sau. Cheers.
Nguồn và liên kết
- Trang talk trên ai.engineer · Video gốc
- abedmatini/aiewf-hybrid-rag-demo: reference implementation đi kèm talk (FastAPI + React, Docling ingest với 4 chunking strategy, hybrid retrieval gộp bằng RRF, agent mode, guardrail, widget nhúng)
- Docling: chuyển PDF, DOCX, PPTX, ảnh thành Markdown có cấu trúc
- pgvector: vector similarity search ngay trong Postgres
- Ollama · Qwen 2.5 · BGE-M3
- Langfuse: tracing và observability cho ứng dụng LLM, có bản tự host
- FastAPI · React · GitHub Codespaces
- Trang cá nhân của Abed Matini · GitHub của Abed Matini · Ogilvy
- Bài viết đi kèm của tác giả: abedmatini.hashnode.dev
- LinkedIn của Abed Matini: linkedin.com/in/matini
Related talks
Stop Writing Tone Instructions. Layer Them.
Isadora Martin-Dye · Isadora & Co · 21 min
Tách brand voice thành bốn layer: identity bất biến, mode theo tình huống, voice neo vào ví dụ, và một veto deterministic chặn output sai trước khi tới khách.
Stop AI Agent Hallucinations: 5 Techniques + Production Patterns
Elizabeth Fuentes Leone · AWS · 55 min
Năm thay đổi trong code, không phải prompt, để agent bớt hallucinate: lọc tool, GraphRAG, swarm kiểm chéo, hook chặn rule, steering tự sửa; demo Strands.
Semantic Blindness: 500,000 Sensors Confused an LLM
Raahul Singh & Vanč Levstik · Phaidra · 16 min
Vì sao LLM gãy khi phải đọc 500 nghìn tên thiết bị, và cách Phaidra để LLM chỉ lập plan còn code tra cây: 100% chính xác, ít token hơn 300 lần.