Open model có theo kịp OpenAI và Anthropic? Distillation, compute và RL environment
Nathan Lambert bàn khoảng cách giữa frontier lab và open model: distillation, compute, data, RL environment, RSI và kế hoạch của Trillium (video 14/10/2026).
✓ Đã duyệt độc lập · cập nhật 03/11/2026 · 59 min
1. Đoạn mở đầu và câu hỏi: trong "frontier" có gì?
Đây là một tập podcast của a16z: Lisha Li, Partner ở a16z, ngồi trò chuyện trực tiếp với Nathan Lambert, nhà nghiên cứu AI và là người sáng lập Trillium, để hỏi khoảng cách giữa các frontier lab và các open model thật ra bền tới đâu (theo mô tả video đăng ngày 14/10/2026). Trong mô tả, Trillium được giới thiệu là một phòng nghiên cứu phi lợi nhuận (nonprofit) mới của Nathan.
Video mở bằng một chuỗi câu trích từ chính cuộc trò chuyện, xen với hình minh hoạ. Nathan nói: khi nghĩ về tiến bộ của model, anh thấy nó quy về những dạng vốn (capital) khác nhau, đó là compute, data và talent. Lisha hỏi: điều đó sẽ diễn ra thế nào, ai sẽ thắng trong vài năm tới? Nathan đáp rằng người Trung Quốc build model rất giỏi; nói rằng Trung Quốc không ngang bằng về talent thì bạn sẽ rất khó bảo vệ quan điểm đó; cái họ không có là compute (theo video đăng ngày 14/10/2026).
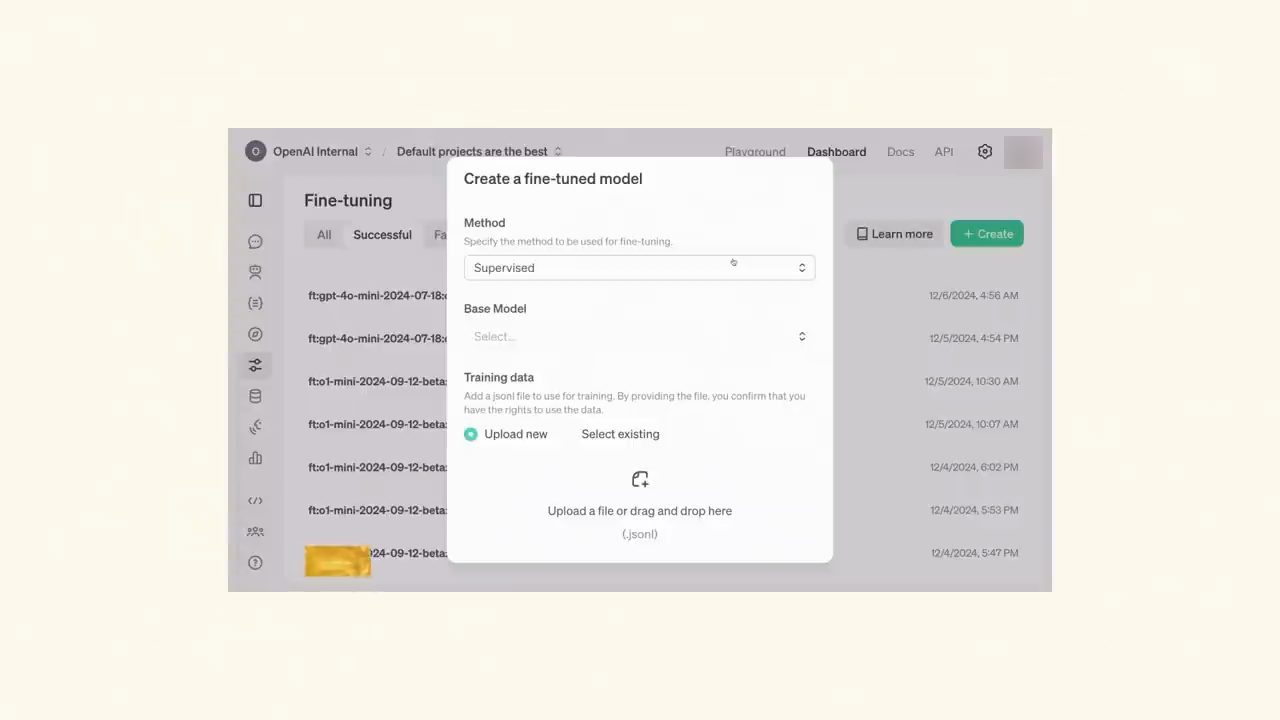
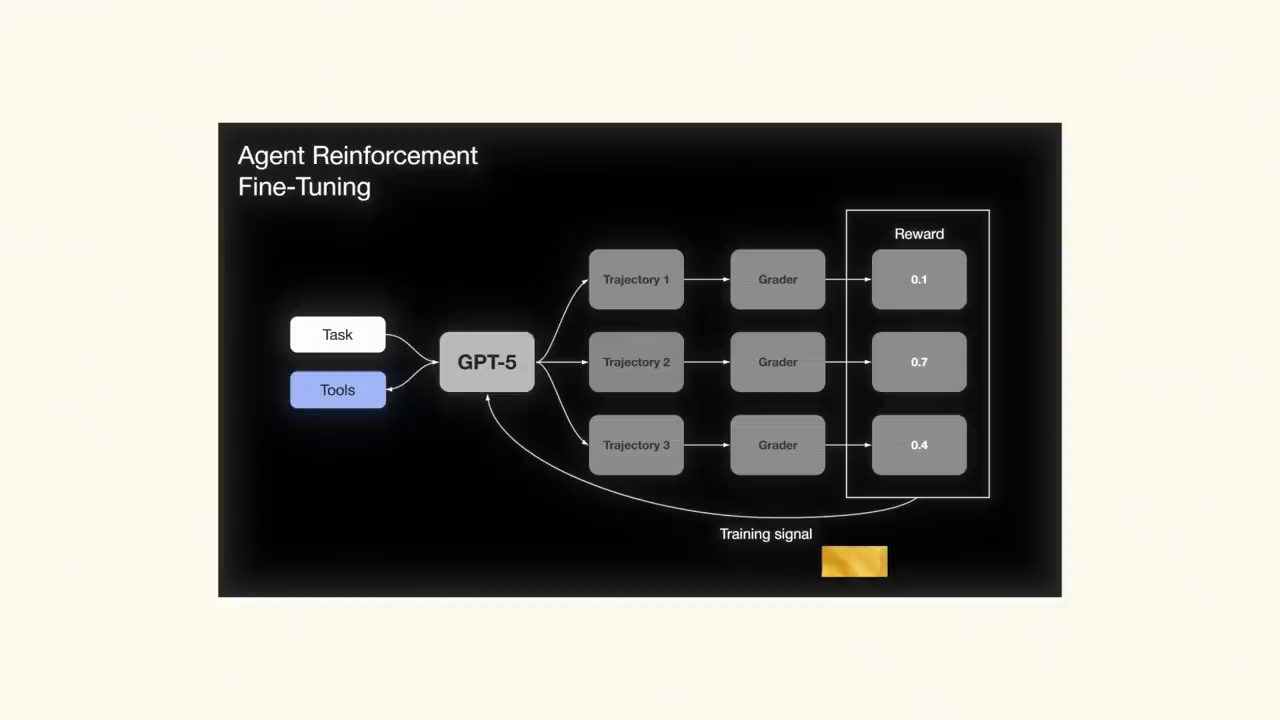
Tiếp đó là câu của Lisha: phần lớn mọi người coi distillation là đòn bẩy chính giúp họ làm được điều này. Một đoạn clip phỏng vấn truyền hình của Jensen Huang chen vào: "People distill my products every single day", người ta lấy sản phẩm của ông và tháo nó ra tới từng bộ phận thô, và "that's called competition" (đó gọi là cạnh tranh). Nathan nói tiếp: post-training trước đây dựa nhiều hơn vào supervised fine-tuning; giờ nó đã biến hình một chút thành những environment nặng về RL; và thật khó ánh xạ kiểu post-training "bạn lấy completions rồi điểm số đi lên" sang những gì đang diễn ra với reasoning hôm nay (theo video đăng ngày 14/10/2026).
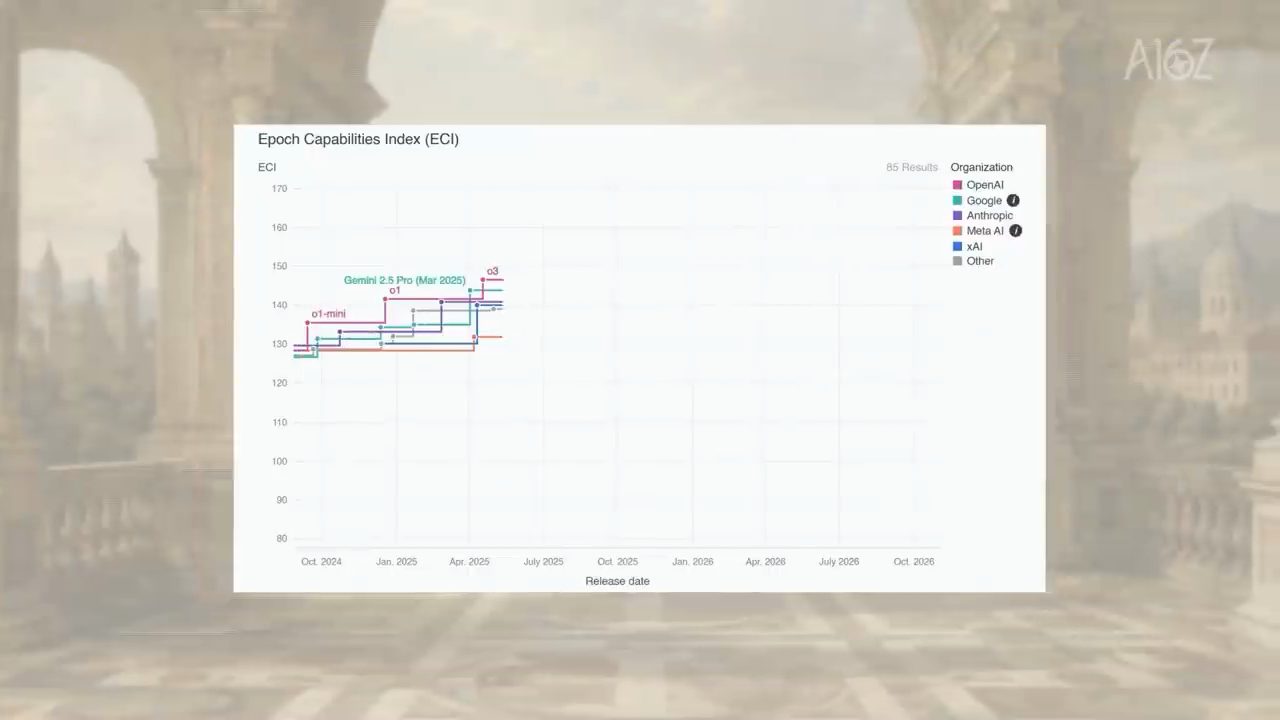
Lisha nói discourse bây giờ đầy nỗi sợ về chuyện frontier bị giấu kín tới đâu, và cả chuyện nó đang bứt xa. Nathan đáp: biểu đồ năng lực AI (AI capability plot) không hẳn làm anh lo; điều làm anh lo là biểu đồ năng lực AI đặt cạnh sự chuẩn bị gần như không tồn tại trong public cybersecurity và tất cả những thứ như thế (theo video đăng ngày 14/10/2026).
Vào cuộc trò chuyện, Lisha nói rất vui được gặp Nathan và cảm ơn anh đã tới tận nơi. Chị nói buổi này rất đúng lúc, vì anh đang ra mắt Trillium, thứ chị rất muốn nói tới. Nhưng trước hết ở tầm vĩ mô: hai người hay trò chuyện về open source, và đó là điều Nathan rất quan tâm. Điều chị nghe nhiều trong public discourse là "chúng ta phải pace the frontier" (bám theo nhịp của frontier), frontier thế này, frontier thế kia (video đăng ngày 14/10/2026).
Một mạch câu hỏi chị đang cố hỏi các chuyên gia là: trong frontier có gì? Chúng ta đang bám theo cái gì, ở đó có gì? Và quan trọng hơn, đan nó với open source và các open weight model: chúng có theo kịp frontier không? Chị nghĩ điều này rất quan trọng, và đây là thứ Nathan là chuyên gia. Câu hỏi đầu tiên của chị: anh sẽ phân tách thế nào những gì đã đưa chúng ta tới frontier, cho cả closed lab lẫn open source model? Trong đầu anh nó chia ra sao, trước hết ở mức cao: pre-training, mid-training, post-training, và post-training đã tiến hoá thế nào, một chủ đề mà theo chị Nathan đã làm rất nhiều để giải thích cho công chúng (video đăng ngày 14/10/2026).
2. Compute, data, talent và chuyện "org chart"
Nathan trả lời: khi nghĩ về tiến bộ của model, nó quy về những dạng vốn khác nhau mà bạn đổ vào model, đó là compute, data và talent. Mọi lab đều có những lượng khác nhau của ba thứ này, và các closed frontier lab như OpenAI, Anthropic, Google rõ ràng là đã có nhiều nhất (theo Nathan, video đăng ngày 14/10/2026).
Điều ta thấy, theo anh, là các lab có khả năng khác nhau trong việc tổ chức những dạng vốn này. Làm cho org chart vận hành được để build model là việc rất khó, vì thế mới có những công ty phải reset hoàn toàn từ dưới lên, và rồi đôi khi nó thật sự có tác dụng. Một công ty như Meta đã reset hoàn toàn, và giờ họ lại đang trên một quỹ đạo tích cực (theo Nathan, video đăng ngày 14/10/2026). Lisha hỏi lại: "Seriously?"
Nathan nói anh rất hứng thú với những khía cạnh con người này: vì sao cạnh tranh đẩy frontier đi tới, và vì sao org chart lại quan trọng đến thế. Những điều đó cũng đi vào thế cân bằng giữa open và closed. Với các công ty đóng, các frontier lab thật sự: nếu ai đó muốn làm việc ở frontier của AI, anh thường khuyên họ tới Anthropic và OpenAI, đó là cửa cược dễ nhất. Meta, Google, SpaceX AI, anh nghĩ bạn vẫn có thể đang ở đó, nhưng nhìn từ bên ngoài thì khó thấy hơn (theo Nathan, video đăng ngày 14/10/2026).
Theo anh, những công ty này đã đặt những cửa cược tham vọng nhất, sớm nhất, để đi tới đó. Vì thế OpenAI mới là bên khởi động cuộc cách mạng reasoning model. Cú đột phá đó, cùng cái biểu đồ đẹp với inference scaling laws, là "peak OpenAI": họ rất giỏi tạo ra đúng cái biểu đồ làm thay đổi cách mọi người nghĩ về mọi thứ (theo Nathan, video đăng ngày 14/10/2026).
Ở phía bên kia, Anthropic rất tập trung vào những loại việc mà model sẽ làm được. Phần thưởng của họ là cú bùng nổ Claude Code, sau một thời gian dài tập trung vào coding. Hai bên có những văn hoá khác nhau một cách tinh tế. Nathan nghĩ hai công ty này nói riêng là những bên nhìn xa nhất, và sẵn sàng nhất để chi những khoản tiền "khủng khiếp" (egregious) nhằm tiến một bước về hướng mà người ta nghĩ là không thể (theo Nathan, video đăng ngày 14/10/2026).
3. Vì sao các lab Trung Quốc ra open model, và những tầng model
Các công ty Trung Quốc bước vào cuộc chơi này vì họ muốn có một công ty có trọng lượng. Theo Nathan, nếu họ build model rồi cố bán API từ Trung Quốc thì không ai biết tới họ. Không ai biết tới Moonshot AI, rất ít người biết tới một lab khác anh nêu tên, và sau đó còn một danh sách rất dài. Đó là một quyết định rất thực dụng: họ theo dõi discourse, họ biết sẽ có một thị trường khổng lồ, họ biết ở Mỹ có nhu cầu rất lớn sẵn sàng trả tiền cho những thứ này. Vì vậy, phát hành open model là một lối tắt để bước vào cuộc trò chuyện (theo Nathan, video đăng ngày 14/10/2026).
Anh nói có rất nhiều phức tạp quanh câu hỏi vì sao họ làm vậy: chính phủ có nhúng tay không? Theo anh, không phải vậy, họ chỉ đang cố build một startup. Anh nói điều đó không có nghĩa là họ sẽ không tới mức đó. Anh nói chính phủ Trung Quốc làm những điều sẽ khiến người Mỹ choáng váng, và điều đó khiến anh nghĩ các lab Trung Quốc có cách tiếp cận nghiêm túc hơn nhiều về bảo mật, vì ở Trung Quốc có những phản ứng quyết liệt hơn nhiều đối với các công ty so với ở Mỹ. Anh nói không cần đi sâu vào "hang thỏ" này (theo Nathan, video đăng ngày 14/10/2026).
Về thế cân bằng giữa open và closed: các công ty Trung Quốc đang cố bắt kịp. Đó là một động lực rất khác với điều anh nói về OpenAI và Anthropic: hai bên này đang cố tạo ra những paradigm mới, cố làm cho RSI (recursive self-improvement) thật sự xảy ra, để công ty mình thắng với những model tốt nhất mãi mãi nếu tới đó trước. Còn với phần còn lại, bạn chỉ cần lấp vào những chỗ trống của thị trường, và các open weight model đang cố làm điều đó (theo Nathan, video đăng ngày 14/10/2026).
Theo thời gian, Nathan nghĩ sẽ có những tầng open model: các closed model tốt nhất, thứ bạn có thể đòi margin tốt nhất; rồi các near frontier model đi sau một bước, và chúng sẽ mở, đơn giản vì chuyện cung và cầu. Bạn tiếp cận được một thị trường khác, có thể ít lời hơn, ví dụ data riêng tư của doanh nghiệp. Những tầng này là sự tiến hoá tự nhiên của các công ty đang cố làm việc của mình. Quay lại chuyện vốn: họ có ít vốn hơn thì họ sẽ kiếm ít tiền hơn, và điều đó không sao (theo Nathan, video đăng ngày 14/10/2026).
Nhưng động lực bắt kịp rất mạnh. Một khi Anthropic và OpenAI cho bạn thấy loại model bạn cần build, mọi thứ dễ hơn nhiều: "ồ, ta chỉ cần làm thứ này". Và họ mua những bộ data tương tự. Data chảy dần qua nền kinh tế data: OpenAI và Anthropic chi nhiều hơn hẳn để xây ra chức năng này của ngành data, rồi một năm sau những công ty data đó có thể bán lại cho mọi người. Họ cần tối đa hoá lợi nhuận trên khoản đầu tư, và họ đã có một giai đoạn ràng buộc hợp đồng nào đó. Nathan nghĩ có rất nhiều động lực khiến việc theo sát (fast following) sẽ rất khả thi (theo Nathan, video đăng ngày 14/10/2026).
Anh nói ta đã thấy chu kỳ này kéo dài lâu hơn nhiều người nghĩ. Khi ChatGPT ra mắt, người ta đã nói về chuyện ngành sẽ hợp nhất (consolidation) và dự đoán điều đó. Theo anh, ta chỉ mới bắt đầu thấy một thị trường mua bán và sáp nhập (M&A) sôi động hơn nhiều, trong khi anh đã nghĩ chuyện này sẽ xảy ra từ hai năm trước. Các công ty open model đã trụ lâu hơn nhiều so với anh nghĩ (theo video đăng ngày 14/10/2026).
4. Distillation có phải là đòn bẩy chính? Thiếu compute và các giai đoạn post-training
Lisha nói có quá nhiều sợi chỉ thú vị để kéo. Bắt đầu với nhận xét của Nathan về khác biệt tổ chức giữa hai frontier lab hàng đầu, chuyện đó có thể để sau hoặc đi tiếp. Rồi đến việc anh giải thích rằng các lab mở ở Trung Quốc thật ra đã chọn con đường đó như một chiến lược phân phối, hay thương mại hoá thực dụng, chứ không phải vì lòng vị tha. Chị nói thật tuyệt khi các nhà nghiên cứu, dù tốt hay xấu, có thể đã được thúc đẩy bởi tinh thần chia sẻ lúc đầu; nhưng rốt cuộc nó tiếp diễn vì đó là một chiến lược thương mại hoá xuất sắc (video đăng ngày 14/10/2026).
Sợi chỉ còn lại: chị nghĩ phần lớn mọi người coi distillation là đòn bẩy chính để các lab này làm tốt đến vậy, và ngày càng tốt hơn, vì độ trễ giữa open source model và frontier model chỉ có rút ngắn lại trong vài năm qua; giờ có lẽ chỉ còn hai tới ba tháng (theo Lisha, video đăng ngày 14/10/2026). Điều đó cũng đẩy các frontier lab tới chỗ có lẽ muốn khoá API lại, khoá những model tốt nhất lại để làm dịch vụ first-party: thứ nhất có lẽ để giữ được nhiều giá trị hơn, vì làm vậy thì luôn giữ được; thứ hai vì như thế khó distill hơn, không phải không thể, nhưng khó hơn nhiều.
Chị muốn bắt đầu từ: câu chuyện distillation có phải là một bức biếm hoạ về các lab Trung Quốc không? Vì Nathan đã gặp họ và nghiên cứu chuyện này nhiều hơn, họ có toàn diện không, giỏi pre-training, có những công thức post-training tốt của riêng họ mà có thể họ đã hoặc chưa công bố? Và anh thấy những đòn bẩy nào đang tăng tốc?
Nathan nói các lab Trung Quốc rất xuất sắc về kỹ thuật. Họ thiếu compute nhiều hơn. Lisha nói "Yes". Không nghi ngờ gì, họ có một nguồn talent tương đương để tuyển. Có thể có chút lợi thế dựa trên chuyện ai ở đâu khi AI thật sự cất cánh. Nhưng nói rằng Trung Quốc không ngang bằng về talent thì bạn sẽ rất khó bảo vệ, vì họ có quá nhiều người được đào tạo ở trình độ rất cao (theo Nathan, video đăng ngày 14/10/2026).
Cái họ không có là compute. Anh kể: bạn nói chuyện với người ở đó, bạn bảo "tôi nghe nói một researcher trung bình ở OpenAI có 5.000 H100 equivalents (tương đương 5.000 GPU H100) để dùng bất cứ lúc nào", và cằm họ rơi xuống sàn: "tôi không thể hình dung nổi". Và đó là một researcher pre-training hàng đầu ở một lab mà bạn biết tên. Anh đã có kiểu tương tác này vài lần. Chuyện compute, theo anh, là khác biệt lớn nhất (theo Nathan, video đăng ngày 14/10/2026).
Distillation đi vào chỗ này như một cách chi thêm tiền để có được thứ tương đương compute. Output của một language model là một hàm của compute; nếu bạn biết output bạn muốn, thì cũng như có compute để sinh ra nó bằng một model (theo Nathan, video đăng ngày 14/10/2026).
Anh nói anh đã chứng kiến các giai đoạn của distillation. Theo anh, post-training trước đây dựa nhiều hơn vào supervised fine-tuning, vào thời kỳ RLHF, khi post-training mới bắt đầu. Khi đó bạn có thể lấy phần lớn hiệu năng chỉ bằng cách dùng next token prediction loss trên output của một model rất mạnh. Điều đã được xác lập là: bạn lấy model tốt nhất có thể, sinh completions, train trên đó, và model của bạn sẽ khá tốt, miễn là bạn có đúng các prompt (theo Nathan, video đăng ngày 14/10/2026).
Prompt luôn là chìa khoá của post-training. Anh nhớ ở AI2, anh cùng một đồng nghiệp đồng dẫn dắt post-training, và hai người luôn nói prompt là "key unit" (đơn vị then chốt) của post-training. Bạn cần có prompt, và bạn có thể làm những việc khác nhau với chúng ở những giai đoạn training khác nhau. Giờ điều này đã biến hình một chút thành những environment nặng về RL (theo Nathan, video đăng ngày 14/10/2026).
5. Bằng chứng từ literature, Olmo, các RL run mở và những proxy Claude
Nhưng thật khó ánh xạ kiểu post-training "bạn lấy completions và điểm số đi lên" sang những gì đang diễn ra với reasoning hôm nay. Dựa trên literature công khai, Nathan thấy rất khó nói distillation là một yếu tố lớn. Ví dụ, trong literature hoàn toàn mở của những người cố làm các công thức post-training mở, mọi bên build open model đều bị kẹt với việc dùng một model Qwen đã rất cũ, vì bạn không tìm ra cách chọn đúng teacher (theo Nathan, video đăng ngày 14/10/2026).
Giả thuyết của anh là có điều gì đó trong mid-training và trong data pre-training phổ biến đang mở khiến việc này trở nên khó: lấy reasoning trace từ model tốt nhất tuyệt đối, làm SFT, và các con số đi lên. Anh nói nếu hồi build Olmo anh có quyền truy cập reasoning trace của Claude, Claude Opus, Claude Mythos, gì cũng được, anh không chắc nó thật sự làm model của nhóm tốt hơn nhiều. Đó là bằng chứng của anh, dựa trên literature, cho việc vì sao anh nghĩ distillation là khó (theo Nathan, video đăng ngày 14/10/2026).
Rồi câu hỏi tiếp: làm sao lấy output của một model để build một RL environment cho một RL run lớn? Vì có những bên như Xiaomi làm một RL run mở kéo dài một tuần, kiểu "đây là những gì chúng tôi đã làm", rồi họ thả model ra. Vậy distillation đi vào đâu trong chuyện này? Họ khôn, họ biết làm marketing. Cũng có vài câu hỏi, như họ có làm trước hay không, vì họ làm RL run rồi thả model, rồi tech report của họ lại nói có thêm một giai đoạn post-training sau RL. Nên có vài dấu hỏi. Nhưng ánh xạ literature distillation đã được xác lập sang chuyện đó là rất khó (theo Nathan, video đăng ngày 14/10/2026).
Tuy vậy, có những dấu hỏi khiến anh ủng hộ các lab một chút: những Claude proxy và model proxy ở Trung Quốc, nơi một lượng token khổng lồ được dùng, có các bên trung gian và họ có hàng đống tài khoản; thậm chí có trường hợp Kimi phục vụ Claude trong sản phẩm của họ cho người dùng. Anh nói anh không thật sự hiểu điều này khớp thế nào với distillation như một công cụ kỹ thuật phổ biến trong post-training. Và đúng, ta cũng nên theo dõi chuyện đó. Có những chuyện kỳ lạ khác với các công ty Trung Quốc dùng output từ model của OpenAI và Anthropic ở quy mô rất lớn. Nên theo anh, còn nhiều câu hỏi nữa ta cần trả lời (theo Nathan, video đăng ngày 14/10/2026).
6. Error bars, "cope" và chuyện khoá API
Nathan nghĩ phần lớn những người có lý lẽ, khi được hỏi "khoảng cách nhờ distillation là bao nhiêu", sẽ thấy error bar rất lớn. Khi anh nói distillation giúp họ được vài tháng, đó là dựa trên literature khoa học, đó là thông tin ta có. Ta nên làm nhiều nghiên cứu mở hơn và tạo điều kiện để có thể nghiên cứu nó. Nhưng anh không biết làm sao có thể đi tới một kết luận khác, rằng dựa trên điều này nó lại là một hiệu ứng lớn trong post-training hiện tại (theo Nathan, video đăng ngày 14/10/2026).
Và người Trung Quốc cũng build model rất giỏi. Anh nghĩ có một chút "cope" (tự an ủi) khi người ta bảo chỉ có chúng ta mới giỏi build model. Có quá nhiều công ty, khoảng 20 tới 30 công ty đang build những model tốt. Điều đó, theo anh, là thứ khó mà bỏ qua (theo Nathan, video đăng ngày 14/10/2026).
Anh nhắc một paper rất nổi bật về việc đánh cắp reasoning trace từ closed model, và anh biết các công ty Trung Quốc đã đi trước rất xa trong việc làm điều này, từ trước khi cộng đồng AI safety công bố nó. Anh nghĩ lab Trung Quốc nào cũng có một team biết những thứ như vậy (theo Nathan, video đăng ngày 14/10/2026).
Quay lại điều Lisha nói về chuyện các lab không cần cung cấp API: reasoning model sinh ra những thinking token, và có một đặc điểm khiến việc moi chúng ra khỏi API là dễ, để bạn thấy reasoning token rồi dùng nó train model của mình. Chừng nào các lab còn cung cấp những API này, sẽ không có cách nào chặn kiểu distillation đó. Nhưng nếu họ làm sao để nó chỉ có trong sản phẩm, những nơi bạn phải ký thoả thuận doanh nghiệp hay gì đó, thì sẽ khó hơn nhiều (theo Nathan, video đăng ngày 14/10/2026).
Anh ủng hộ các lab làm vậy nếu họ muốn bảo vệ nó, họ phải tự bảo vệ sản phẩm của mình. Nhưng anh không nghĩ know-your-customer (KYC) sẽ tốt cho ai cả, cũng không nghĩ nó tốt cho việc kinh doanh của họ. Anh cũng không biết có nên kéo chính phủ vào một vụ vi phạm terms of service không: anh còn không nghĩ terms of service là một hợp đồng có chữ ký; anh không nghĩ bạn có thể kiện họ theo cùng một cách, bạn chỉ có thể cắt quyền truy cập của họ. Vì thế anh không thông cảm lắm với lập luận đó (theo Nathan, video đăng ngày 14/10/2026).
Nhưng anh thích lắng nghe cộng đồng an ninh quốc gia: họ ồn ào, nhưng có một sự thật về hướng đi trong đó, với việc AI đang đi đâu và ảnh hưởng của nó lớn tới đâu. Bạn phải cân bằng rất, rất nhiều thứ trong đầu (theo Nathan, video đăng ngày 14/10/2026).
7. "That's called competition": đoạn clip của Jensen Huang
Lisha nói chị muốn biết phản hồi của Nathan: chị nghe Jensen nói, trong một buổi phỏng vấn nào đó, và video chèn đoạn clip. Trong clip, Jensen Huang nói: "People distill my products every single day". Người ta lấy sản phẩm của ông, tháo nó ra tới từng bộ phận thô, họ thử mọi thứ, và "that's called competition". Một người phỏng vấn trong clip hỏi: ông có nghĩ đó là chơi đẹp (fair game) không, ông nghĩ distillation không phải là ăn cướp sao? Jensen đáp lại: "That's called competition" (video đăng ngày 14/10/2026).
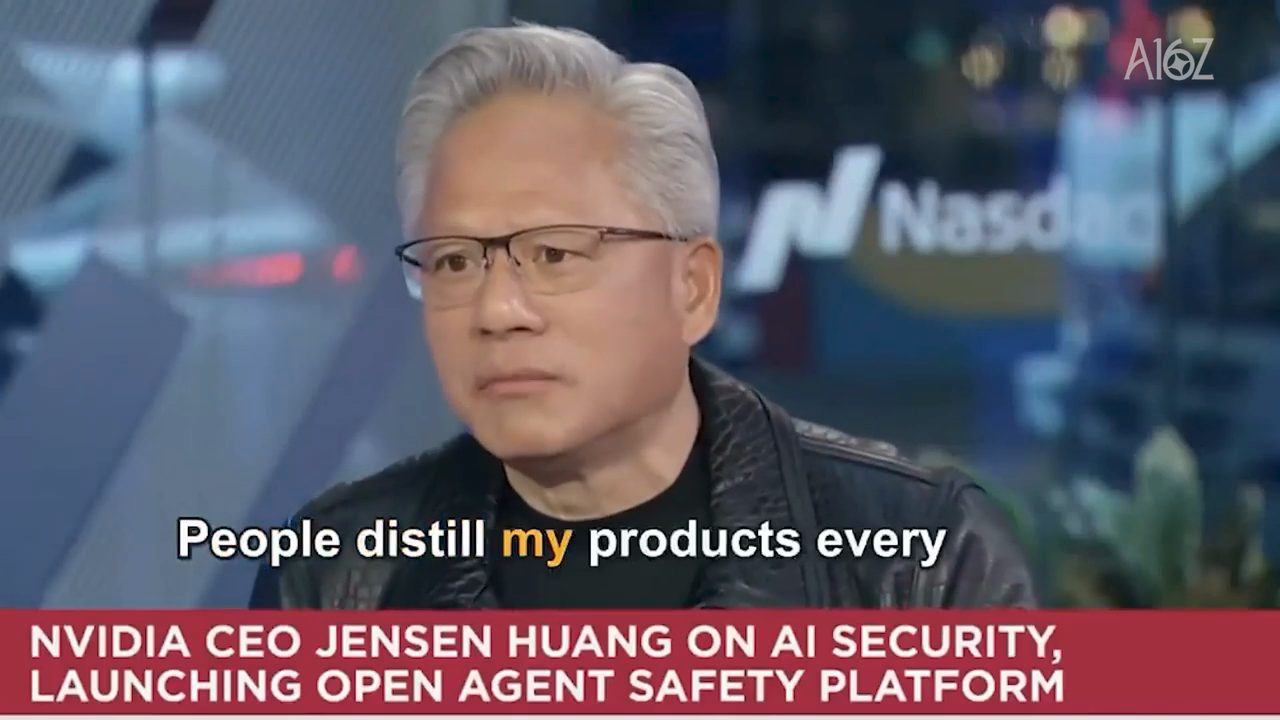
Nathan nói anh rất thông cảm với quan điểm đó. Vì anh nghĩ có rất nhiều lời kêu gọi từ cộng đồng AI safety rằng ta muốn có đối thoại khi đang tiến tới những mức năng lực như vậy. Và nếu bạn bắt đầu đánh vào ngành AI của họ bằng những đòn phạt nhẹ (slaps on the wrist) ở khâu sau của distillation thì sao? Bạn sẽ không điều tiết distillation bằng chính sách từ Quốc hội; có lẽ bạn chỉ làm vài hành động liên bang để khiến cuộc sống của họ phiền phức (theo Nathan, video đăng ngày 14/10/2026).
Đồng thời, khi ta nói về việc quản lý rủi ro frontier, khi closed model và việc training đang đi khắp web và truy cập những thứ chúng không nên, và ta có những lo ngại chính đáng về chuyện gì sẽ xảy ra với open weight model, nơi chưa có tác hại nào. Nhưng câu hỏi là: vì sao người ta không dùng open weight model? Vì sao họ tìm tới closed model rồi lách qua các lớp bảo vệ (safeguard)? Và ta muốn có thể trao đổi với các công ty công nghệ Trung Quốc về mọi chuyện này (theo Nathan, video đăng ngày 14/10/2026).
Anh nghĩ bạn sẽ gây hại nhiều hơn lợi nếu làm bất cứ điều gì với distillation, vì họ sẽ không dừng lại. Họ sẽ cứ tiếp tục làm (theo Nathan, video đăng ngày 14/10/2026).
8. Lisha steelman frontier lab: flywheel, IPO và hệ sinh thái startup
Lisha đáp "Right, right", và nói thêm: rồi cộng đồng open source được lợi, và vì thế cộng đồng startup được lợi rất nhiều. Theo chị, chuyện này không chỉ là "Trung Quốc, Mỹ". Chị nói chị thông cảm, và muốn thử steelman (dựng lập luận mạnh nhất cho) vị trí của các frontier lab: để build những frontier model này cần một lượng vốn chưa từng có. Và sẽ là đáng báo động, hoặc không có lợi cho việc cái flywheel tiếp tục quay, nếu nhờ distillation hay những phương pháp liên quan mà open source bắt kịp nhanh đến vậy (theo Lisha, video đăng ngày 14/10/2026).
Flywheel mà chị nói tới là một bức tranh rất đơn giản: bạn train frontier model bằng cách đổ rất nhiều tiền để có compute. Rồi họ "park" (giữ chỗ) lượng compute đó, và theo chị OpenAI và Anthropic rất "có tội", hoặc rất thành công, ở chuyện này, tuỳ bạn nhìn theo cách nào. Đang có tình trạng thiếu compute rất lớn, vì không chỉ là compute trong chip mà còn là điện năng, v.v.; tất cả sự khan hiếm này bị nghẽn cổ chai cho tới năm 2028 (theo Lisha, video đăng ngày 14/10/2026).
Vì thế giữ chỗ compute là một chiến lược thành công, dẫn tới rất nhiều doanh thu: một khi họ tới được frontier, vì họ hiểu scaling, hay đúng hơn là khoa học về scaling cho họ một tay nắm để biết nó chuyển thành một dòng doanh thu dự đoán được tới mức nào. Họ có doanh thu, và nhờ doanh thu đó họ gọi được thêm vốn. Theo chị, đó là một flywheel đẹp chưa từng có, và nó xảy ra với cả OpenAI lẫn Anthropic. Dĩ nhiên ta cần lượng tài nguyên tăng theo hàm mũ, nên ta đã tới chỗ: "OK, ta cần IPO, cần đi ra thị trường đại chúng". Bất cứ thứ gì đe doạ flywheel này vận hành tốt là một mối đe doạ lớn cho việc ở frontier, và thực tế là cho cả ngành (theo Lisha, video đăng ngày 14/10/2026).
Chị nói có lẽ không chỉ là thông cảm với phiên bản "cố vắt lấy chút tư bản cho mình" của họ, mà còn là: nếu họ không làm tốt ở IPO, điều đó thật ra tệ cho mọi người khác. Nên chị muốn họ làm tốt (theo Lisha, video đăng ngày 14/10/2026).
Mặt khác, các open source model của Trung Quốc là một lợi ích khổng lồ cho hệ sinh thái startup. Chị nói chị thấy điều này thường xuyên qua các số liệu. Chị nhớ Decagon và Harvey đã cố làm rất nhiều fine-tuning. Có một lượng rất lớn startup làm post-training as a service ở nhiều mức độ khác nhau và cố biến nó thành sản phẩm. Và nó thật sự hiệu quả, vì bạn có thể đạt tới Pareto frontier với những model như Kimi K3, hay chọn open model GLM yêu thích của bạn (theo Lisha, video đăng ngày 14/10/2026).
Cân hai điều này, chị nói có quá nhiều câu hỏi có thể rút ra. Thứ nhất, Nathan thấy chuyện này sẽ diễn ra thế nào, ai sẽ thắng trong vài năm tới. Và thứ hai, gắn nó với lý do anh chọn làm open source.
9. Open và closed chạy trên hai thang thời gian khác nhau
Nathan nghĩ open model và closed model nằm trên hai thang thời gian khác nhau của những đường hàm mũ. Các closed lab tích hợp chặt đến mức họ có inference hiệu quả, họ có thể phục vụ model ở quy mô lớn khi sẵn sàng, vì họ có đủ tài nguyên để lên kế hoạch. Và họ tới những thị trường có giá trị rất cao trước. Ta đã thấy điều này với coding: đó là câu chuyện của năm nay, khi doanh thu đi từ con số 0 lên 100 tỷ đô la, và có lẽ còn tăng (theo Nathan, video đăng ngày 14/10/2026).
Còn với các open model lab, một phần là vấn đề kinh tế của việc làm người theo sau: bạn không có dòng thông tin đó, và không có dòng doanh thu đó. Có bên build open model; rồi có các công ty model inference, và các công ty post-training cho open model. Có thông tin từ những khách hàng ấy, là những việc bạn cần model làm, nhưng thông tin đó không dễ chảy ngược về bên build model. Họ cũng không có lợi thế quy mô để phục vụ nhiều người dùng đến thế, phục vụ hiệu quả đến thế, có nhiều margin trên inference đến thế (theo Nathan, video đăng ngày 14/10/2026).
Vì thế mọi thứ sẽ mất lâu hơn nhiều. Nhưng ở mức mà mọi thứ có thể bị hàng hoá hoá (commoditized), có vẻ các công ty thật sự muốn có data riêng tư. Có rất nhiều thứ họ đơn giản là không thể gửi qua một API. Ta có thể bàn về zero data retention hay không, v.v. Nhưng phải mất rất lâu để một công ty biết mình có chuyên môn nội bộ hay không, hay để họ tìm ra cách build một internal evaluation thật sự khớp với doanh thu. Rồi họ tìm cách fine-tune, hoặc họ đi tìm Thinking Machines hay Prime Intellect, kiểu "ta có thể kiếm tiền hàng loạt nếu tìm ra cách fine-tune một model giải được việc này" (theo Nathan, video đăng ngày 14/10/2026).
Các bên đó có những khách hàng ấy, nhưng có quá nhiều công ty tham gia nên mọi thứ mất lâu hơn nhiều. Nhưng ở cuối quá trình, khách hàng có quyền sở hữu thật sự: model weights, không có terms and conditions, chạy được trên phần cứng của họ, và họ đã tìm ra cách có ROI trên đó. Đó là lý do anh nghĩ nền kinh tế open model mất lâu hơn nhiều để xây (theo Nathan, video đăng ngày 14/10/2026).
Anh ít lo hơn về chuyện nó mang tính bong bóng. Điều này có thể ăn vào thị trường của kịch bản cất cánh thật nhanh, khi người ta tìm ra model rẻ nhất làm được một việc và cạnh tranh nhau trên margin. Anh nói anh thật sự không biết chuyện gì sẽ xảy ra, còn quá sớm để biết (theo Nathan, video đăng ngày 14/10/2026).
10. Model tổng quát hay model chuyên biệt: robotics, toán và ví dụ của Cursor
Lisha nói chuyện này thật khó. Nó luôn nằm trong đầu chị: có những thứ mà việc scale up general reasoning, chỉ như một model tổng quát, sẽ đánh bại mọi model chuyên biệt. Ta thấy ví dụ rõ ràng trong toán, có lẽ là lĩnh vực thuần khiết nhất để thấy điều này. Nhưng cũng cả trong robotics, với Astra; theo chị, nghe không có vẻ như họ đã thật sự cố để vươn lên trong robotics (theo Lisha, video đăng ngày 14/10/2026).
Nathan chen vào: anh nghĩ họ có cố. Anh nghĩ đây là một chu kỳ: khoảng sáu tới tám tháng trước họ bắt đầu tuyển người và mua rất nhiều data robotics. Lisha nói "They did". Nathan nói tiếp: và rồi sáu tháng sau, model "thần kỳ" lại giỏi việc đó (theo Nathan, video đăng ngày 14/10/2026).
Lisha kể một điều trái chiều hơn mà chị từng nghe: năng lực đó thật ra đến từ computer use, vì computer use là một mức nào đó của spatial reasoning (suy luận không gian), và việc có được những demo Blender tốt là một sự mở rộng khác của điều đó. Ta có thể tin một phiên bản nào đó của chuyện này. Nhưng dù thế nào, nếu nó thật sự chuyên biệt, bạn thấy phần tăng năng lực đến từ việc cố giỏi hơn ở một lĩnh vực nhất định (theo Lisha, video đăng ngày 14/10/2026).
Còn với toán, chị không biết nó có đến từ việc cố chuyên biệt hoá về toán không. Theo chị, cả luận đề ở đó là cứ scale up reasoning, và nó thật sự giỏi lên trong ngôn ngữ tự nhiên, giỏi hơn mọi model chuyên biệt về toán. Anthropic thậm chí không hề cố giỏi toán. OpenAI thì chị nghĩ có tuyển một nhóm nhà toán học, nhưng họ cũng không cố dùng những bộ data chuyên biệt, kiểu data Lean, để giỏi hơn. Chị tự ngắt câu, xin lỗi, rồi nói tiếp (theo Lisha, video đăng ngày 14/10/2026).
Tất cả những điều này là chất liệu cho quan điểm rằng khó cạnh tranh với frontier model, vì rốt cuộc chúng vươn lên nhiều đến mức bạn đủ tốt trong từng hạng mục. Tuy vậy, chị nghĩ cũng có một lực đối kháng rất mạnh về data mà ta đang thấy: các open source model vốn đã đủ tốt cho phép làm fine-tune. Theo ý Nathan về sự thẩm thấu và lan toả chậm, những benchmark và bộ data rất cụ thể chỉ có ở những công ty đang được áp dụng tới. Nó vừa đủ tốt, và ta bắt đầu thấy người ta dùng nó (theo Lisha, video đăng ngày 14/10/2026).
Ngay cả ở chế độ "thuần" nhất, nơi bạn sẽ nghĩ frontier model giỏi, chị nhắc Cursor đã công bố một thứ vào mùa hè: họ có một task long-horizon là viết lại SQLite, và hoá ra dùng hai frontier model, một làm planner, một làm execution, thì không tốt bằng, hoặc tốt tương đương nhưng tốn kém hơn nhiều, so với chỉ dùng Composer với có lẽ Opus hay một model khác làm planner. Chị nghĩ đó là bằng chứng tuyệt vời rằng các open source fine-tune rất tốt, hoặc đủ tốt, và đã vượt lên ở những task "đói" trí thông minh (theo Lisha, video đăng ngày 14/10/2026).
Chị nói đó là một cách hỏi dài: bằng chứng nào, hay những mẩu bằng chứng nào, Nathan thấy thuyết phục nhất cho các phiên bản khác nhau của trạng thái ổn định này, nơi frontier thắng hay open source thắng?
11. Tiến bộ ở frontier chủ yếu là chuyện data
Nathan nói anh ủng hộ mạnh quan điểm rằng rất nhiều tiến bộ ở frontier, trong những lĩnh vực không kiểm chứng được hoàn toàn (not fully verifiable), là nhờ mua data chất lượng cao và cho model những thế giới để hành động trong đó và hill-climb (leo dốc tối ưu) trên đó (theo Nathan, video đăng ngày 14/10/2026).
Anh thấy có hai thứ. Có chuyện toán và code, và ta không biết thị trường coding sẽ lớn tới đâu. Rồi có mọi thứ còn lại, những lĩnh vực họ vẫn đang nhắm: knowledge work, sinh học, y tế, pháp lý. Tất cả những thứ này không kiểm chứng được bằng. Và anh nghĩ nó gần hơn nhiều với câu chuyện "OpenAI: tôi đã mua rất nhiều data robotics". Có lẽ họ sẽ bảo ta đó là generalization, phép màu, "poof". Người ta thích generalization kiểu "poof". Nhưng thực tế có lẽ là một phần A, một phần B, và phần nhiều quy về data (theo Nathan, video đăng ngày 14/10/2026).
Khi anh nói chuyện với người ở các frontier lab, có những người có công việc tuyệt vời. Có những người đóng góp bằng một việc rất hẹp: bạn làm một bộ data, bạn tìm ra hành vi của model nên thế nào trong lĩnh vực đó, bạn tìm ra cách làm ra data giúp đạt được hành vi đó, và bạn tìm ra mình cần mua data gì. Anh nghĩ ta sẽ có nhiều năm làm việc này qua các ngành khác nhau, và việc mua hết chỗ data đó rất tốn vốn. Nhưng đó không phải là kiểu "poof", phép màu, RSI xảy ra (theo Nathan, video đăng ngày 14/10/2026).
Chỗ anh thấy khác là toán, code và một phần distributed ML engineering: những thứ này rất kiểm chứng được, bạn biết chi phí của mình là bao nhiêu, và các AI model sẽ kéo nó xuống với tốc độ thần kỳ. Điều đó sẽ có rất nhiều lợi ích thặng dư, và ta có thể nghiên cứu nhanh hơn (theo Nathan, video đăng ngày 14/10/2026).
Anh rất quan tâm tới hiệu quả của model: anh nghĩ chi phí sẽ giảm theo cấp số nhân qua các năm. Ta đã thấy OpenAI cắt giá mạnh. Vậy sẽ thế nào nếu GPT Sol hay Astra và những model lớn hơn này có giá giảm một nửa sau mỗi tám tháng trong ba năm tới? Bạn bắt đầu làm phép tính, và nó như là còn 1% chi phí sau chừng bốn năm. Rồi câu hỏi là: họ sẽ có margin cao hơn nhờ Jevons paradox, hay doanh thu của họ sẽ giảm vì thị trường đã lấp đầy? Có đủ loại động lực rất lạ (theo Nathan, video đăng ngày 14/10/2026).
Về cơ bản, theo anh, tiến bộ AI là chuyện data và chuyện viết phần mềm tốt hơn để phục vụ model của bạn. Và đó là hai thế giới rất khác nhau (theo Nathan, video đăng ngày 14/10/2026).
12. Ngành RL environment: mua đại trà, reward hacking và OPSEC
Lisha đồng ý rằng nhìn từ bên ngoài, có rất nhiều công ty data và RL environment đang làm ăn rất, rất tốt, bán cho cả hai frontier lab hàng đầu lẫn một cái đuôi dài ngày càng nhiều lab khác. Theo ý Nathan, chị nghĩ rất nhiều phần tăng năng lực thật sự đến từ việc scale up chuyện đó, và đó không phải việc dễ. Chị rất tò mò ý kiến của anh về data và environment được làm bằng tay so với những cái làm trong mô phỏng (sim); có vẻ có những phiên bản khác nhau về mức giá mà chúng đòi được, v.v. (theo Lisha, video đăng ngày 14/10/2026).
Nathan nói loại nào cũng có cái tốt và cái dở. Anh thấy có nhiều người nói, như ta đã nói về distillation, nhưng mặt kia là công ty Trung Quốc mua đúng RL environment đó sáu tháng sau, sau khi Anthropic, OpenAI đã mua nó, và giờ có một khoản phí "premium" cho nó. Data mà người ta đang mua khá nhiều khiếm khuyết: anh nói cách làm là mua đại trà rồi tìm xem cái gì dùng được, và tỉ lệ trúng không phải 100% (theo Nathan, video đăng ngày 14/10/2026). Lisha nói "Yeah".
Cá nhân anh nghĩ cuộc bùng nổ RL environment này, nơi có quá nhiều cơ hội kiếm tiền, đang khiến nhiều người làm tắt, và điều này có thể gây ra những thứ như reward hacking. Model thông minh đến mức nếu bạn đặt chúng vào một thế giới, chúng nghĩ "việc của mình là giải task này"; nhưng bạn có một test file, và test file đó thật ra là một file rỗng thay vì cái mê cung mà model phải đi qua. Và model nghĩ: "ừ, mình vẫn nên tìm cách lấy reward cao bằng mọi giá" (theo Nathan, video đăng ngày 14/10/2026).
Anh nghĩ nhiều hành vi kiểu này là hệ quả ở khâu sau (downstream). Anh nghĩ nó sẽ được sửa. Nhưng thật thú vị khi thấy nhu cầu từ các lab muốn loại bỏ reward hacking, các researcher dành rất nhiều thời gian cho nó; trong khi các công ty data thì "hãy mua data của chúng tôi", và theo anh họ dành tỉ lệ thời gian ít hơn cho hành vi của model, nhiều hơn cho world building và doanh thu. Bằng cách nào đó hai bên cần gặp nhau để thật sự làm ra data chất lượng cao hơn (theo Nathan, video đăng ngày 14/10/2026).
Lisha đáp "Yeah", và nói rất nhiều lab đang đưa việc này vào in-house, một phần vì họ không muốn data bị rò rỉ, theo cả nghĩa đen lẫn nghĩa bóng: tín hiệu bị rò rỉ về việc họ đang làm gì, đang cố vươn lên ở đâu. Một người trong hai nói tiếp: dù vậy, lượng họ mua vẫn tăng trưởng rất mạnh (video đăng ngày 14/10/2026).
Lisha hỏi: anh có nghĩ đó có lẽ là một trong những đòn bẩy mạnh nhất không? Anh có thể định lượng nó sẽ tăng bao nhiêu không, anh có kỳ vọng nó tăng theo mức chi không? Hay có những thứ khác, vì chẳng hạn nếu nó làm tốt được trong sim, có lẽ đó lại là lập luận cho việc các lab tự hấp thụ nó?
Nathan nói mọi công ty đều đang làm một kiểu pha trộn: mọi công ty đều đang bán synthetic data, nơi họ dùng language model để sửa hay xây dựng thế giới, hoặc sinh ra các hoán vị của nó. Và nếu một con người dẫn dắt quá trình này thì nó vẫn là synthetic data. Rất ít người sẽ ngồi đó và tự tay dựng một thế giới nhỏ cho model hành động trong đó; mọi công ty đều đang đi nhanh hơn thế nhiều. Lisha nói "Right". Nathan nói họ mua chúng vì model đang tốt lên nhờ chúng (theo Nathan, video đăng ngày 14/10/2026).
Lisha đáp "Yeah". Nathan nói anh vẫn còn chối bỏ: những con số này thật điên rồ, ngân sách nghiên cứu hàng tỷ đô la cho environment. Anh nghĩ họ làm vậy chỉ vì nó đang giúp model và họ thấy tín hiệu (theo Nathan, video đăng ngày 14/10/2026).
Quan sát chung của anh là ngành data còn rất nhiều quả ngon dễ hái trong việc cải thiện chất lượng và cải thiện OPSEC. Nếu nhìn vào chi tiết, bạn có thể thấy những chuyện lạ, như các công ty data dùng contractor ở nước ngoài; những người đó làm qua một bên trung gian, họ không biết mình đang bán nó, họ cứ thế upload nó lên GitHub. Có rất nhiều thứ ngoài kia mà nếu bạn lục lọi ngành data, bạn sẽ thấy những góc cạnh thô ráp kỳ lạ. Và mọi thứ còn rất sớm (theo Nathan, video đăng ngày 14/10/2026).
Một mặt, con số quá lớn và chất lượng thì kém. Mặt khác, các lab đang tiến bộ rất nhanh và biết cách tiếp nhận nó. Anh nghĩ sẽ mất vài năm để chuyển đổi, thật sự kéo những bên thắng về chất lượng cao hơn và ROI cao hơn. Khi có những hệ thống để làm tốt hơn thì cần ít tài nguyên hơn; và các lab tiếp tục làm việc với họ vì có thêm training signal và phải tự lọc nội bộ ít hơn. Theo anh, chuyện này sẽ mất nhiều năm (theo Nathan, video đăng ngày 14/10/2026).
13. Trillium sẽ build gì, và cái tên lấy từ một loài hoa
Lisha hỏi: vậy anh nghĩ thế nào về việc dùng environment, và về các quyết định mua, trong khuôn khổ tổ chức nonprofit anh đang lập?
Nathan nói phần lớn công việc của anh và nhóm ở Trillium sẽ là làm những open source environment cho các task có đòn bẩy rất cao. Anh nghĩ tới một công trình mà anh làm cố vấn ở UW và AI2: nó dành cho terminal task, loại task cực kỳ phổ biến, kiểu Terminal-Bench, "không biết giờ đã tới số mấy". Đây là data hoàn toàn tổng hợp (fully synthetic): bạn prompt một frontier model để sinh ra một loại bài toán, dùng vài prompt khác nhau để tạo sự đa dạng, rồi dùng các model rollout và những cách khác để tìm bug trong chúng và loại bỏ những cái có bug (theo Nathan, video đăng ngày 14/10/2026).
Quy trình này không có phép màu: bạn đọc từng data point, data của bạn sẽ tốt lên, và bạn làm được. Nhưng đơn giản là không có nhiều tổ chức đầu tư những gì cần thiết, hàng nghìn hay hàng chục nghìn đô la, để làm những environment này cho tốt rồi phát hành chúng (theo Nathan, video đăng ngày 14/10/2026).
Nathan nói thêm: vì động lực lợi nhuận quá cao. Lisha đồng ý: "It's so high". Nathan kể anh đã đùa với tác giả công trình: "này, có lẽ bạn bán data này được một triệu đô la rồi hẵng công bố paper". Và họ nói không, họ quan tâm tới việc làm điều đúng. Lisha thốt lên "Oh my God" (video đăng ngày 14/10/2026).
Nathan nói những tài nguyên mở này là nền móng cho rất nhiều nghiên cứu. Bạn phát hành vài RL environment kèm vài RL rollout, người ta có thể nghiên cứu, chẳng hạn eval awareness. Bạn có phần generation từ model, người ta có thể tìm những hành vi khác nhau; nếu bạn đã làm RL trên đó, họ có thể xem nó diễn biến ra sao theo thời gian. Đây chính là những đơn vị hạ tầng mà nghiên cứu sinh PhD dành cả năm để xem xét và tạo ra thêm tri thức (theo Nathan, video đăng ngày 14/10/2026).
Ngành công nghệ là nơi giá trị từ nghiên cứu khoa học máy tính được thu về. Theo anh, mọi nghiên cứu khoa học máy tính, lợi ích của nó đều dồn về ngành công nghệ trong khoảng 10 năm. Và anh nghĩ đó là lý do nhiều người nên ủng hộ open hơn: nếu bạn sẽ làm trong ngành 10 năm, thì chính đồng nghiệp của bạn sẽ là người hưởng lợi từ nó (theo Nathan, video đăng ngày 14/10/2026). Lisha chen vào: "More fossil fuel", đừng làm cạn kiệt hết.
Nathan nói tiếp: nhưng cơ hội thắng ngắn hạn quá lớn. Cơ hội kiếm 100 triệu đô la, lợi nhuận chín chữ số cho doanh nghiệp của bạn trong vòng năm tháng sau khi lập startup cùng bạn bè. Và đó là những người có thể đã làm nhiều việc open source hơn, hoặc những người đã bỏ dở PhD hay gì đó; nó đang kéo người ta ra khỏi open (theo Nathan, video đăng ngày 14/10/2026).
Đó là lý do anh và nhóm đặt tên lab là Trillium. Trillium là một loài hoa "spring ephemeral" (hoa phù du mùa xuân): nó nở trước khi tán cây kịp ra lá. Kiểu như vào mùa đông, khi trên cây chưa có lá, những bông trillium này nở, và chúng thiết yếu cho việc rải chất dinh dưỡng qua chu kỳ tăng trưởng đến cùng mùa xuân và mùa hè (theo Nathan, video đăng ngày 14/10/2026).
Anh nói đây là chỗ anh cảm thấy ngành AI đang làm đúng rất nhiều thứ, có quá nhiều thứ đang đi đúng. Chỉ là ta cần thêm một chút sức sống để lan toả điều này ra và làm cho người mới có thể bước vào. Có quá nhiều sự chú ý, và cứ làm nghiên cứu, làm giáo dục. Rồi khi nó scale và có tác động lớn hơn, bạn có những thứ mở trở thành chuẩn nghiên cứu cho những vấn đề quan trọng như: làm sao hiểu sandbox, làm sao định nghĩa loss of control (mất kiểm soát), làm sao thấy nó thay đổi thế nào trong một RL run kéo dài một tuần trên một nghìn GPU hay một trăm nghìn GPU. Hãy tạo ra những nơi như vậy để người ta có thêm niềm tin. Anh nghĩ điều này trả cổ tức rất lớn cho mọi người (theo Nathan, video đăng ngày 14/10/2026).
Anh nói thật khó để khiến người ta dám nhảy bước đó. Bản thân anh đã được đền đáp rất nhiều nhờ tình cờ bước vào lĩnh vực này. Giờ anh nhận được rất nhiều, anh được làm những việc như thế này, rất vui. Và theo anh, bây giờ là công việc tuyệt nhất, vì anh có thể cố tạo ra không gian cho nhiều người hơn phát triển tư duy độc lập của họ và build hạ tầng này (theo Nathan, video đăng ngày 14/10/2026).
14. Đóng góp mở trong thời AI agent, và cái giá của việc "ngồi đủ lâu"
Lisha đáp "Yeah", và nói một cách ngây thơ mà điều này tự duy trì là: vì nó là open source, bạn có thể nhận được đóng góp phân tán hơn từ những người có động lực không chỉ là bán cho các lab, mà vì "nó ở ngoài kia, họ có thể chia sẻ công việc của mình". Và rồi bạn thật sự có một lượng người đóng góp chất lượng rất cao cho dự án. Chị nói đó có lẽ là hy vọng ngây thơ về cách nó vận hành (video đăng ngày 14/10/2026).
Nathan nói đó là một câu đố mới với AI agent, khi người ta cứ ném đủ thứ vào bạn. Anh có vài repo nghiên cứu ngẫu nhiên cho các paper, và người ta giờ mở những GitHub issue điên rồ nhất. Lisha hỏi: ý anh là sao? Anh kể: những kết quả nghiên cứu giả. Họ mở một issue kiểu "trời ơi, tôi tìm thấy thứ này trong dataset của anh", và anh nghĩ: nếu bạn đọc paper thì bọn tôi đã nói điều đó ngay ở câu thứ hai. Đó là rất nhiều output của language model, và đó là một điều mới mà cộng đồng open phải trải qua (theo Nathan, video đăng ngày 14/10/2026).
Nathan nói tiếp: nhưng đây là vấn đề giải được; có những người ngoài kia muốn đóng góp cho những thứ này. Lisha nối lời: không chỉ để chạy theo "clout" ở một chiều khác, mà thật sự vì "này, nó ở ngoài kia". Chị hy vọng vì nó được công bố, mở và sẵn có, bạn thật sự có thể có những nghiên cứu sinh PhD hay những researcher khác nghĩ "ok, tôi làm việc này ở công việc chính, nhưng có lẽ tôi vẫn có thể đóng góp", và hy vọng là cả từ các frontier lab (video đăng ngày 14/10/2026).
Nathan nói anh có thấy những người như vậy. Lisha nói "That's great". Một người ở Đông Âu đã giúp anh cải thiện code cho cuốn sách của anh, cuốn đang ở ngay đây, và người đó làm vậy chỉ vì đó là điều đúng; hai người đã trò chuyện. Anh nghĩ: có những người làm việc đó. Nhưng anh nghĩ rất nhiều người không có thời gian hay sự ổn định cho khoảng thời gian dài cần bỏ ra (theo Nathan, video đăng ngày 14/10/2026).
Khi bạn cố bước vào một lĩnh vực mới, bạn không biết gì cả. Bạn phải bỏ ra hàng tuần đọc mà không biết gì. Rồi bạn gửi một email và không ai trả lời. Bạn mất hàng tuần để nắm được bối cảnh, để hỏi được một câu hay. Còn giờ với language model, phần lớn người ta chỉ bấm một nút, kiểu "ồ, thú vị, tôi đọc cái này rồi, gửi đi thôi". Việc "ngồi trong nó" (sitting in it) là điều người ta không còn làm nhiều nữa (theo Nathan, video đăng ngày 14/10/2026).
Và đó là chìa khoá để bước vào AI: bạn chỉ cần tập trung vào nó. Bạn phải viết một ít code bằng tay, và làm việc đó trong nhiều tháng. Rồi bạn phải chờ sáu tới 18 tháng để được chú ý. Nó đơn giản là mất nhiều thời gian. Và anh nghĩ tất cả những AI agent làm rối điều đó và khiến mọi thứ khó hơn cho người ta (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói đó cũng là điều các nhà toán học phàn nàn. Nathan nói giờ là thời điểm khó để làm nghiên cứu sinh PhD; người ta vẫn đang làm những công trình tuyệt vời trong giới học thuật, nhưng khó (video đăng ngày 14/10/2026).
Lisha nói chị đồng ý với anh, chị nghĩ nó giải được: khi agent kéo dài một phiên bản nào đó của vấn đề, chúng cũng có thể giúp giải quyết và nhận diện nó. Rồi chị tóm lại: vậy là environment, anh sẽ phát hành các phiên bản open source của chúng, giúp thúc đẩy thêm nhiều người đóng góp. Chị nghĩ điều đó thật sự then chốt, nhất là khi có quá ít động lực để phát hành những thứ này thay vì lấy doanh thu nhanh từ các lab (theo Lisha, video đăng ngày 14/10/2026).
15. Demystify RSI, open RSI và vì sao Nathan không pre-train
Lisha chuyển sang một mảng khác chị đọc được trong bài công bố của Nathan: RSI. Theo chị, ta có thể bàn trước về việc thật ra cái gì là "recursive" trong đó, nó đáng sợ tới đâu, hay ta có cất cánh (takeoff) không; chị nghĩ Nathan có một quan điểm rất thực tế về chuyện này. Nhưng một điều chị muốn nói là: RSI, có lẽ liên quan tới việc nó được thổi phồng tới đâu, là một lý do khiến ta sợ các frontier lab sẽ bứt xa. Và nó cũng là lý do chị đã nghe, không chỉ một mà vài lần, rằng người ta tin chắc chính công việc researcher của họ sẽ bị tự động hoá (video đăng ngày 14/10/2026).
Nathan chen vào: "Yeah". Anh kể vài năm qua anh đã trải qua chuyện này với vài người trong số những người bạn thân nhất của anh. Anh bảo họ: các bạn thuộc hàng những người giỏi nhất thế giới ở việc này. Rồi họ đi làm và nói: "Nathan, tôi đang chật vật. Tôi sẽ làm gì đây?" (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói tiếp: theo ý anh, rất nhiều việc họ làm là kiểm chứng được, đúng không? Nhưng chính vì vậy, còn có khá nhiều việc khác không kiểm chứng được, hoặc khó hơn, nằm ngoài phân phối (out of distribution), như alignment và những thứ tương tự. Một lập luận chị nghe được là: vì có khác biệt quá lớn giữa việc RSI đang làm tốt thế nào cho năng lực model so với cho alignment, thứ nằm ngoài phân phối hơn nhiều, có lẽ là việc sáng tạo, nên người ta bất an rằng có lẽ thật sự có những nguy hiểm, v.v. (video đăng ngày 14/10/2026).
Vì thế chị rất muốn nghe Nathan: chị nghĩ thật sự quan trọng là ta có một mặt trận open source cho thấy RSI đang được làm thế nào, để có lẽ ta hiểu được năng lực: nếu bên trong một lab họ có một model tốt hơn, khả năng họ thật sự bứt xa là bao nhiêu? Chỉ là hiểu tốt hơn, hiệu chỉnh (calibrate) tốt hơn (video đăng ngày 14/10/2026).
Nathan nói anh và nhóm sẽ không phải những người duy nhất làm việc này, nhưng về cơ bản RSI có quá nhiều sự huyền bí (mystique). Kiểu như "chúng tôi đang dùng model cho mọi thứ". Và điều anh và nhóm có thể làm, như một open lab và một nonprofit, và anh nghĩ những tổ chức khác như EleutherAI, Hugging Face hay Open Athena, mà anh nói là Marin và Stanford, cũng vậy, là chia sẻ mình đang dùng công cụ gì (theo Nathan, video đăng ngày 14/10/2026).
Cụ thể, anh và nhóm sẽ build một stack open source cho SFT, cho mid-training; sẽ dùng SkyRL, Miles, tất cả những thứ đó. Nhóm có task, có config, biết mình đang chạy loại compute nào. Nhóm có thể làm việc với Claude, GPT và mọi model như thế. Và nhóm có thể lưu lại các trajectory về những gì đã làm. Có thể cho bạn biết task là gì (dùng Linear hay bất cứ thứ gì phổ biến), vì sao chọn chúng, và model có làm được hay không (theo Nathan, video đăng ngày 14/10/2026).
Bạn làm việc này trong một năm của một lab, rồi nói "đây là những gì chúng tôi đã làm". Rồi cứ mỗi sáu tháng kiểm tra lại: nó đã thay đổi chưa? Có được toàn bộ stack mà không phải đi qua những classifier, không phải mô tả task một cách mơ hồ, v.v. Theo anh, những ai có thể chia sẻ việc tự động hoá nào đang diễn ra thì nên làm điều này (theo Nathan, video đăng ngày 14/10/2026).
Anh và nhóm có một phân phối task khác, nhưng anh nghĩ nghiên cứu thì tương tự. Nghiên cứu AI anh đã làm ở AI2 và sẽ làm ở Trillium, so với những gì người ta làm ở một số nhánh của giới học thuật và ở các lab, không khác nhau mấy: bạn có nhiều tài nguyên hơn, bạn scale nó lên. Và thật tốt cho thế giới, khi mọi người đều đang nói về chuyện này, chỉ cần cho người ta thấy. Lisha nói "Yep". Nathan nói: "Đây là việc Nathan đã bảo model của anh ấy làm, và đây là chỗ nó bị kẹt." Anh nghĩ điều đó sẽ giúp rất nhiều cho chính những người làm chính sách (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói "Exactly". Nathan nói họ sẽ kiểu "ồ, ok", và Lisha nói tiếp "ồ, ra là vì thế". Nathan: đó là chỗ nó bị kẹt, đó là cái bug mà nó cài vào code. Lisha đáp "Yeah, yeah" (video đăng ngày 14/10/2026).
Nathan nói các bug và các lỗi kiểu đó sẽ giảm theo thời gian. Nhưng anh nghĩ với tính "lởm chởm" (jaggedness) và vài điều căn bản của model, một số thứ sẽ cất cánh. Như anh nói về hiệu quả lúc trước, anh nghĩ model sẽ rất giỏi việc giảm chi phí serving. Những công ty này có hàng tỷ đô la đặt cược vào đó, và model giỏi việc đó. Họ sẽ kiếm rất nhiều tiền nhờ serving hiệu quả hơn và chỉnh kiến trúc để đi tới đó (theo Nathan, video đăng ngày 14/10/2026).
Nhưng đó không hẳn là chuyện làm sao giải được knowledge work. Bạn sẽ không kiểu "Claude, tự bảo mình làm PowerPoint đẹp hơn đi", kiểu gì vậy chứ. Lisha nói: cần environment hay thứ gì đó khác. Nathan nói nó sẽ mất một thời gian (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói chị rất thích mục tiêu cụ thể "hãy làm sáng tỏ (demystify) chuyện này", vì chị nghĩ phần lớn lý do lời lẽ quanh RSI nóng đến vậy là vì nó nghe đáng sợ. Nathan nói các AI nonprofit có thể làm nhiều việc như thế. Giới học thuật khó làm: là giáo sư, khó mà nói "15% thời gian của tôi và 40% thời gian của nghiên cứu sinh của tôi có thể dùng để ghi chép lại những gì chúng tôi làm". Nên đây là một dịch vụ tuyệt vời cho chính sách và cho cộng đồng: đây là các task của chúng tôi, người ta có thể dùng data này để làm evaluation hay gì đó. Hãy build những thứ có thông tin hiếm, để khi người ta đổ thêm công sức tập trung cao vào đó, nó có thêm giá trị cho đủ thứ mà bạn không thể đoán trước (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói nó cũng rất đúng lúc, vì không phải một người mà vài người chị quen ở các lab đều nói "tôi sẽ bị tự động hoá". Như ý anh về bạn bè của anh: "tôi chắc chắn, với tư cách một con người, sẽ bị tự động hoá trong một năm". Và điều đó có lẽ có nghĩa là sẽ có ít người hơn thật sự được tiếp xúc với những gì đang diễn ra ở phần đó của org chart (video đăng ngày 14/10/2026).
Nathan nói có một chuyện học thuật liên quan, một dự án open RSI do một nhóm các tổ chức học thuật làm. Anh không liên quan tới nó. Anh nói họ vừa ra mắt khoảng tuần trước (theo video đăng ngày 14/10/2026). Họ gửi cho anh vài email, và anh nghĩ: open RSI là một thứ có thật, họ cũng đang cố làm việc này. Nó không cần chỉ là một nhóm. Lisha nói "There's a lot more". Nathan nói có nhiều cách tiếp cận khác nhau làm việc này là tốt, vì bạn cần những cách nhìn khác nhau và những kết quả khác nhau. Lisha nói đó là toàn bộ ý nghĩa của việc mở.
Lisha kể một điều nữa chị nghe được, kiểu chuyện ngồi lê ở frontier lab: các phương pháp thật sự được dùng trong các lab không phải là không ai biết; vấn đề là những tỉ lệ nào cần dùng thì thành công, và một phần là vì họ có vốn để scale lên mà thử nghiệm. Chị thấy điều đó vừa đáng mừng, vì không có bí mật lớn nào, người ta thật sự biết các kỹ thuật; nhưng mặt khác, vốn vẫn là rào cản thật sự duy nhất, vì khó mà biết kỹ thuật, công thức nào chạy được (theo Lisha, video đăng ngày 14/10/2026).
Nathan nói đó là lý do anh không pre-train. Anh vui vì được tự do: anh có thể dùng bất kỳ base model nào, và giờ anh được hưởng lợi từ cạnh tranh (theo Nathan, video đăng ngày 14/10/2026).
16. Open source có pre-train được không? Megatron, Thinking Machines, Meta và post-training
Lisha hỏi: anh có nghĩ có cơ hội cho một nỗ lực pre-training open source nào không? Chị biết yêu cầu vốn lớn hơn nhiều bậc độ lớn, nên đó là chỗ khó. Nhưng giá trị của nó là gì? Rồi có lẽ hai người bàn về các chiến lược thương mại có thể có.
Nathan nói khoa học pre-training thì công cụ khá dễ tiếp cận. Bạn có cái gọi là pre-training ladder (thang pre-training), công cụ ra quyết định để thử xem ý tưởng của bạn có scale được không. Và data pre-training không tăng như cảnh environment: về cơ bản, xấp xỉ đầu tiên là bạn train trên internet; có vài chi tiết nhỏ và bí quyết, nhưng nó không thay đổi nhiều. Kiến trúc state of the art và GPU thì thay đổi (theo Nathan, video đăng ngày 14/10/2026).
Nhưng làm một pre-trained model vững chắc thì không đắt khủng khiếp. Anh nghĩ bạn không phải chi một tỷ đô la để có một base model rất tốt. Chi càng nhiều thì càng tốt, nhưng người ta vẫn liên tục tiến bộ. Anh luôn ngạc nhiên khi một lab mới đi từ con số 0, vì họ làm được (theo Nathan, video đăng ngày 14/10/2026).
Một phần là nhờ các công cụ mở, ví dụ bạn có thể dựa trên Megatron. Rất nhiều startup mới hỏi "ta nên train dựa trên cái gì?", rồi họ train dựa trên công cụ open source, fork nó, và không bao giờ phát hành lại. Theo anh, ngay cả những open model lab nổi bật cũng làm vậy: họ lấy code open source, biến nó thành thứ của riêng mình, và nhiều bên không đẩy ngược lên upstream. Anh luôn ngạc nhiên vì điều này (theo Nathan, video đăng ngày 14/10/2026).
Vì vậy anh không đặt cược chống lại những người mới vào, vì bạn không cần 10 tỷ đô la để có một model đáng kể. Điều khó là có được một model đủ tốt để người ta dùng, và có một câu chuyện mà nếu bạn phát hành nó thì bạn gọi được vòng vốn tiếp theo. Bạn phải vượt qua cái khoá đó: model đầu tiên phải "hạ cánh" được, nếu cả công ty dựa trên việc model của mình là tốt nhất, mà bạn không ở cùng tầm và không phát hành gì, thì đồng hồ đang chạy (theo Nathan, video đăng ngày 14/10/2026).
Anh nghĩ tới việc Thinking Machines ra mắt Inkling: họ rất minh bạch, kiểu "đây không phải model tốt nhất, chúng tôi tự hào về nó, nó có vài thứ hay". Lisha nói "Yeah". Và giờ họ đã phát hành model thứ hai và đang khởi động, họ có Tinker, điều đó rất tốt cho họ, họ đã cất cánh được. Anh không nghĩ đó là điều họ định làm: họ build model, nhưng open model không phải kế hoạch đầu tiên của họ, rồi họ đi tới đó. Còn có tin đồn rằng Meta đã nói họ sẽ lại phát hành một open weight model mới; điều đó sẽ tới (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói chị chắc chắn mừng vì Thinking Machines làm vậy, và nó rất hợp lý với mô hình kinh doanh của họ vì họ làm post-training. Với Meta, chị nghĩ Nathan cũng đã nhắc trong vài bài viết trước: với họ đó là một chiến lược quá tốt. Chị nghĩ nó cũng hiển nhiên khi họ làm: nó bổ trợ cho các nguồn doanh thu của tôi, tại sao không? Nathan nói Mark đã viết bài blog hay nhất về chuyện này: khi Llama 3 ra mắt, ông viết bài hay nhất về vì sao open là con đường phía trước. Lisha nói "Right". Nathan nói ông ấy có hơi bị xao nhãng, có vẻ ông đang quay lại với "ánh sáng" (video đăng ngày 14/10/2026).
Lisha nói chị hy vọng họ tiếp tục có động lực làm điều đó. Về việc tới được frontier bằng pre-training, chị nghĩ có rất nhiều trợ giúp vì có những open source model rất tốt để có thể bootstrap từ đó. Chị cứ nhận những tín hiệu mâu thuẫn về việc pre-training có thật sự đã bão hoà, hay đã được hiểu rõ chưa. Có lẽ, theo ý Nathan, có rất nhiều kỹ thuật đã được biết rõ đang được dùng, nhưng cái khó là thật sự có được 20.000, 30.000 chip (theo Lisha, video đăng ngày 14/10/2026).
Nathan nói người ta vẫn đang "quay tay quay" (turning the crank) với pre-training, và pre-training đã điều chỉnh theo khi super long context generation xuất hiện. Nên lợi ích thu về lớn hơn hẳn nếu, chẳng hạn, bạn làm cho một kiến trúc sparse attention chạy tốt, và rồi generation 100.000 token của bạn nhanh hơn 40% (theo Nathan, video đăng ngày 14/10/2026).
Anh nghĩ có rất nhiều sự đồng tiến hoá của cả stack: họ có pre-training stack của mình, họ nhận ra inference scaling cao hơn nhiều; nhưng ngay cả những nền tảng của pre-training cũng tiếp tục cải thiện, khi bạn có một kiến trúc tốt hơn một chút mà mang lại lợi tức trên khoản đầu tư. Rồi nó nhoè sang post-training, ở mid-training, nơi bạn khởi đầu các hành vi reasoning: bạn lấy chúng từ model cũ hơn, làm RL trên đó, những hành vi "hạt giống" (seed behaviors) (theo Nathan, video đăng ngày 14/10/2026).
Theo anh, chu kỳ này phức tạp hơn nhiều so với pre-training. Nếu không có đúng người, thì việc làm nó cất cánh khó hơn nhiều so với pre-training trước đây. Anh nghĩ một kiểu "ta cứ bắt đầu pre-train model của mình" có kiểm soát nghe dễ tiếp cận hơn nhiều với anh, so với "tôi không biết nhiều về language model, tôi sẽ tự mò ra cả cái post-training này", nơi nó giống như miền Tây hoang dã (Wild West) (theo Nathan, video đăng ngày 14/10/2026). Lisha nói "Yeah".
Nathan nói đó là lý do khi rời AI2, anh cảm thấy post-training của anh và nhóm thật ra đang tụt lại, chỉ vì cycle time không đủ cao, trong lúc mọi thứ đang đi vào những việc agentic. Và đó vẫn là một trong những công thức post-training open source hàng đầu. Đó là điều anh muốn sửa: không cần nhiều vốn đến thế để tạo ra những bước tiến lớn, cộng dồn, so với state of the art trong open source, vì mức chuẩn rất thấp. Nó không đóng (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói điều đó hợp lý: đó là một kiểu hiệu quả, nơi bạn đặt vốn vào và tạo ra khác biệt lớn.
17. Harness, agent swarm và những bí mật khó giữ
Lisha hỏi một điều liên quan tới post-training, và tới chuyện closed bứt xa open: các agent, các loại harness đang được dùng ở closed lab rất khác, và model của họ được train, post-train để giỏi riêng cho những harness đó. Điều đó càng làm tăng sự huyền bí, khiến mọi thứ rất khó. Thứ nhất, anh có đồng ý không? Thứ hai, anh hy vọng giải quyết điều đó thế nào? Ví dụ chị muốn nói là: dựng lên hàng nghìn agent, hàng chục nghìn agent, một workflow rất khác với những gì người ta thường được tiếp xúc (video đăng ngày 14/10/2026).
Nathan nghĩ open sẽ ổn. Nhiều năm trước anh từng nghĩ các closed lab sẽ giống Apple, là công ty tích hợp, nơi model được thiết kế cho harness đi kèm, và điều đó cho họ một kiểu hiệu quả về quy mô. Nhưng hoá ra có quá nhiều người dùng những harness khác nhau cho những việc khác nhau họ thích làm, nên các công ty model bị ép phải làm cho model của mình chạy được trong đủ loại harness. Anh từng nghĩ việc open model phải được thiết kế để train trên đủ loại harness sẽ là điểm yếu của chúng, nhưng rốt cuộc nó khá cân bằng: mọi bên đều phải làm điều đó ở một mức nào đó (theo Nathan, video đăng ngày 14/10/2026).
Với agent swarm, điều ta đang thấy là OpenAI và Anthropic sẽ đến sớm hơn: họ sẽ biết cách thiết kế model, biết cách thiết kế... anh tự hỏi gọi nó là gì, anh muốn gọi là một harness cho swarm, anh không biết, nhưng sẽ có một từ cho nó; nó không phải harness, nó là một hệ thống điều phối (coordination system). Nhưng rồi người khác cũng sẽ muốn dùng chúng, và anh nghĩ sẽ có những chu kỳ: các frontier lab đẩy thứ này ra trước, và cho tới nay họ đã có lợi tức khổng lồ nhờ đi đầu (theo Nathan, video đăng ngày 14/10/2026).
Nhưng lợi tức của Navier-Stokes và những thứ như vậy là gì? Ta không thật sự biết. Họ đẩy frontier với giả định rằng sẽ có lợi tức cao, rằng phần trí thông minh biên (marginal intelligence) có lợi tức lớn không tương xứng, và ta không biết điều đó có luôn đúng không. Anh kỳ vọng những chu kỳ kiểu: một khi bạn biết hình dạng của việc điều khiển 10.000 agent trong một harness, các công ty open model sẽ nói "ồ, ta cũng làm được". Nhưng sẽ không phải Kimi làm điều đó trước; thứ nhất, họ không có compute, đó là một lượng compute khổng lồ. Nhưng mọi thứ đi theo chu kỳ: chip của NVIDIA sẽ nhanh hơn nhiều, có thêm compute được xây dựng (theo Nathan, video đăng ngày 14/10/2026).
Lisha hỏi lại: vậy anh rất tin rằng không có quá nhiều thứ bị giấu ở đó, rằng có lẽ ta đoán được họ đang làm gì, và khi nó trở nên quan trọng thì hãy để các open source model cũng thử post-train trên những meta harness tương tự? (video đăng ngày 14/10/2026)
Nathan nói "Yeah", và nói anh cũng nghĩ mức bảo mật thông tin ở các lab không cao như họ nghĩ. Silicon Valley nổi tiếng về chuyện ý tưởng lan đi, kiểu "một cốc bia" hay gì đó; ai cũng trò chuyện sau giờ làm. Lisha nói "Right", và nói đó là lý do SSI ấn tượng đến vậy. Nathan đáp "Yeah", rồi nói ai cũng là nhà khoa học; nếu họ có một đột phá, họ sẽ muốn kể cho bạn bè. Họ có thể giữ nó vài tháng, nhưng theo anh lượng bảo mật thông tin cần có cao đến mức kiến thức vẫn lan ra. Rất khó giữ bí mật này (theo Nathan, video đăng ngày 14/10/2026).
Điều họ có thể thắng là đổ thêm vào hạ tầng inference, thứ cho phép họ phục vụ với giá thấp hơn, có margin cao hơn, và duy trì điều này trong một thời gian dài hơn. Nathan nói anh rất tự tin rằng các frontier lab sẽ phục vụ được trí thông minh rẻ nhất tính trên mỗi watt, trên mỗi điểm số của một eval. Họ sẽ có thể đi tới những nơi có nhu cầu cao nhất và có những model rẻ nhất, và điều đó sẽ tạo ra doanh thu, sẽ là một việc kinh doanh tốt (theo Nathan, video đăng ngày 14/10/2026).
Câu hỏi là họ không thể làm mọi thứ, và đó là chỗ phần còn lại của nền kinh tế lấp vào. Nếu chỉ có coding là sinh lời, thì chắc chắn đó là kịch bản tốt cho frontier model, vì họ có sự tích hợp, họ sẽ làm rất tốt. Nhưng nếu thị trường là cả nền kinh tế knowledge work, thì có thể nó không tốt cho họ, vì họ có làm mọi thứ cùng lúc được không? (theo Nathan, video đăng ngày 14/10/2026).
18. Nhiều bên cùng thắng, fast takeoff và việc xã hội chưa chuẩn bị
Lisha đáp: họ không cần phải làm vậy, chị nghĩ sẽ có rất nhiều bên thắng. Nathan nói "Yeah, yeah". Lisha nói đó là lý do chị và đồng nghiệp ở a16z đầu tư vào cả frontier model lẫn startup; không phải vì muốn phòng hộ (hedge), mà vì, để xác nhận quan điểm của Nathan, chị thật sự nghĩ có đủ những task khó ở rìa đòi hỏi data rất chuyên biệt, nên trên đường tới AGI, hay bất cứ tên gọi nào người ta dùng dạo này, có thể có rất, rất nhiều bên thắng (theo Lisha, video đăng ngày 14/10/2026).
Chị nói chị thích ý về RSI của Nathan, như hai người đã bàn một chút: nói một cách thực tế, đó là chi phí và tiêu thụ tài nguyên tăng theo hàm mũ, và vì thế có một giới hạn rất rõ cho việc các frontier lab có thể bứt xa tới đâu, nếu như vậy không phải đơn giản hoá quá mức quan điểm của anh. Anh có muốn thêm gì không? Vì chị thật sự cảm thấy discourse bây giờ đầy nỗi sợ về chuyện frontier bị giấu kín tới đâu và đang bứt xa (video đăng ngày 14/10/2026).
Nathan nói có quá nhiều tiền chi cho inference, và trong ngắn hạn ta đang học cách dồn inference thành những bước tăng hiệu năng. Đây là thứ ta mới có. Và điều ta đang thấy bây giờ là người ta chi quá nhiều; tất cả nhân viên ở các frontier lab đang chi những lượng tăng theo hàm mũ so với mức cải thiện. Nhưng ta đang tìm ra cách làm điều này, và sẽ có rất nhiều bước tiến (theo Nathan, video đăng ngày 14/10/2026).
Nhưng anh không nghĩ nó nhất thiết sẽ là fast takeoff khi các model tự build chính chúng: có những nút thắt con người; mọi scaling law đều là tăng compute theo hàm mũ để tăng hiệu năng tuyến tính, và anh thấy khó đặt cược chống lại điều đó. Anh nói ta có Navier-Stokes, và anh có quan điểm rằng toán đặc biệt phù hợp, có lẽ là lĩnh vực khoa học phù hợp nhất với "hình dạng" trí thông minh này. Trí thông minh có thể có nhiều dạng khác nhau (theo Nathan, video đăng ngày 14/10/2026).
Điều đó không có nghĩa là nếu một AI model, chẳng hạn, khám phá ra thứ gì đó rất khác transformer, mang lại những tính chất rất khác và mở khoá một kiểu trí thông minh mới, thì không đáng cập nhật quan điểm. Nó đáng để cập nhật, đáng để nói "ok, cái đó khác". Nhưng cho tới khi điều đó xảy ra, anh khá hài lòng với bằng chứng của mình rằng các công ty sẽ làm tốt: họ đang chi nhiều hơn theo hàm mũ để giữ nhịp tiến bộ đáng kinh ngạc này (theo Nathan, video đăng ngày 14/10/2026).
Anh nói một vài system card của Claude có nói điều này: theo lời anh, chúng nói sẽ cần khoảng 10x tiến bộ hơn nữa để biến nó thành fast takeoff, và hiện giờ chúng đang giúp ta duy trì nhịp tiến bộ. Anh nói các lab cũng có những người nói như vậy; khoa học thì khó vượt qua, và điều đó ổn, nhưng ta không biết chính xác mọi thứ sẽ đi tiếp từ đây thế nào (theo Nathan, video đăng ngày 14/10/2026).
Lisha nói chị thấy điều đó khá an ủi, vì ta biết đầu vào và các đòn bẩy ở đây: có một chế độ autoregressive rất thành công mà ta đã và đang tối ưu, và nó đòi hỏi một lượng nhất định tài nguyên tăng theo hàm mũ. Vì thế chị hy vọng open source cũng giữ được sức mạnh. Một người trong hai nói thêm rằng nó sẽ không bị tụt lại (video đăng ngày 14/10/2026).
Nathan nói có một lượng việc khổng lồ phải làm để chuẩn bị hạ tầng. Có biểu đồ năng lực AI, thứ không hẳn làm anh lo; nhưng biểu đồ năng lực AI đặt cạnh sự chuẩn bị gần như không tồn tại trong public cybersecurity và tất cả những thứ như thế, thì cần nhiều sự chuẩn bị hơn hiện có, với giả định rằng điều này đang tới. Đó là thứ làm anh lo hơn là, chẳng hạn, RSI tới và mở khoá những rủi ro mới (theo Nathan, video đăng ngày 14/10/2026).
Có những rủi ro đã ở đây và sẽ tiếp tục lan toả. Anh đã nói nhiều lần: các closed lab tới đó trước, rồi các open lab tới đó; ta đang ở trong quá trình này với rất nhiều thứ sẽ gây ra vài vấn đề. Chỉ là việc tìm ra cách khiến xã hội chuẩn bị là rất khó (theo Nathan, video đăng ngày 14/10/2026). Lisha đáp "Yeah".
Nathan nói anh có quan điểm rằng ta cần nhiều con mắt hơn, cần nhiều khoa học hơn để xã hội cảm thấy được thông tin đầy đủ, nhưng cũng có những quan điểm chính đáng khác. Và anh nghĩ không sợ fast takeoff không có nghĩa là bạn không lo về rủi ro (theo Nathan, video đăng ngày 14/10/2026).
Lisha bắt đầu đáp rằng chị nghĩ điều đó hoàn toàn..., rồi nói có lẽ chị sẽ giới thiệu cho Nathan vài người đã rời bỏ (defected) các lab. Chị cảm ơn Nathan rất nhiều, nói buổi trò chuyện rất vui, và chị rất háo hức xem Trillium sẽ làm gì giờ khi nó cuối cùng đã ra mắt (video đăng ngày 14/10/2026). Nathan cảm ơn chị đã mời anh tới.
Nguồn và liên kết 9 nguồn
- Tên gốc: Can Open Models Keep Up With OpenAI and Anthropic? | Nathan Lambert
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=BKuK0M6oDTI youtube.com
- Kênh YouTube a16z (Lisha Li, khách mời Nathan Lambert): youtube.com/channel/UC9cn0TuPq4dnbTY-CBsm8XA youtube.com
- Trillium Labs, phòng nghiên cứu nonprofit của Nathan được nhắc trong video; trang tự giới thiệu là "Fostering the open science of frontier AI" (đọc ngày 03/11/2026): trilliumlabs.org trilliumlabs.org
- Epoch Capabilities Index của Epoch AI, biểu đồ xuất hiện ở đoạn mở đầu: epoch.ai/eci epoch.ai
- Terminal-Bench, benchmark cho terminal task mà Nathan nhắc tới: tbench.ai tbench.ai
- SkyRL, một trong những công cụ RL Nathan nói anh và nhóm sẽ dùng; repo tự mô tả là "A Modular Full-stack RL Library for LLMs" (đọc ngày 03/11/2026): github.com/NovaSky-AI/SkyRL github.com
- Tinker của Thinking Machines, được Nathan nhắc khi nói về Inkling: thinkingmachines.ai/tinker thinkingmachines.ai
Related talks
Khi ai cũng có thể build phần mềm
Paul Copplestone, Garry Tan, Harj Taggar & Jared Friedman · Y Combinator · 49 min
CEO Supabase Paul Copplestone cùng các host Lightcone bàn về builder, database cá nhân, thiết kế cho agent, eval và tương lai khi ai cũng build phần mềm.
Khi AI lật ngược SaaS: service as a software
Brian Maucere, Beth Lyons, Karl Yeh, Jyunmi Hatcher & Andy Halliday · The Daily AI Show · 41 min
Năm host The Daily AI Show bàn bài service as software của Foundation Capital: từ SaaS sang dịch vụ do AI agents làm, cơ hội 4,6 nghìn tỷ đô và chuyện việc làm.
Vertical AI agent có thể lớn gấp 10 lần SaaS
Garry Tan, Jared Friedman, Harj Taggar & Diana Hu · Y Combinator · 42 min
Bốn host Lightcone so sánh vertical AI agent với làn sóng SaaS: vì sao có thể có 300 unicorn, ví dụ từ các công ty YC và cách chọn vertical.