Từ prompt engineering sang context engineering trong SDLC với AI
Paweł Dolega và Artur Skowroński bàn context cho agent trong tổ chức: tacit knowledge, nhiều repo, thông tin cũ, quyền truy cập và tracing reasoning.
✓ Đã duyệt độc lập · cập nhật 21/11/2026 · 29 min
1. Mở đầu: context engineering là gì, và câu của Tobi Lütke
Đây là một tập của Beyond the Commit trên kênh VirtusLab (video đăng ngày 16/09/2026). Theo phần mô tả của video, trong tập này Paweł Dolega trò chuyện với Artur Skowroński, Head of Application Development tại VirtusLab (chức danh theo mô tả và thẻ tên trong video đăng ngày 16/09/2026).
Paweł mở đầu: hôm nay là một tập mới, thuộc một series mới về nhiều khía cạnh khác nhau của engineering và SDLC với AI. Điều anh và Artur muốn bàn hôm nay là context engineering: vị trí của nó trong SDLC, nó nối với, hoặc có thể thay thế, prompt engineering ra sao (prompt engineering là thứ mà theo lời Paweł, chúng ta từng nói tới "có lẽ hai hay ba năm trước", tính từ video đăng ngày 16/09/2026), và cụ thể là chỗ đứng của context engineering trong các ngành bị quản lý chặt (regulated industry).
Artur đáp: "Wonderful. Let's start then." (Tuyệt, vậy mình bắt đầu thôi.)
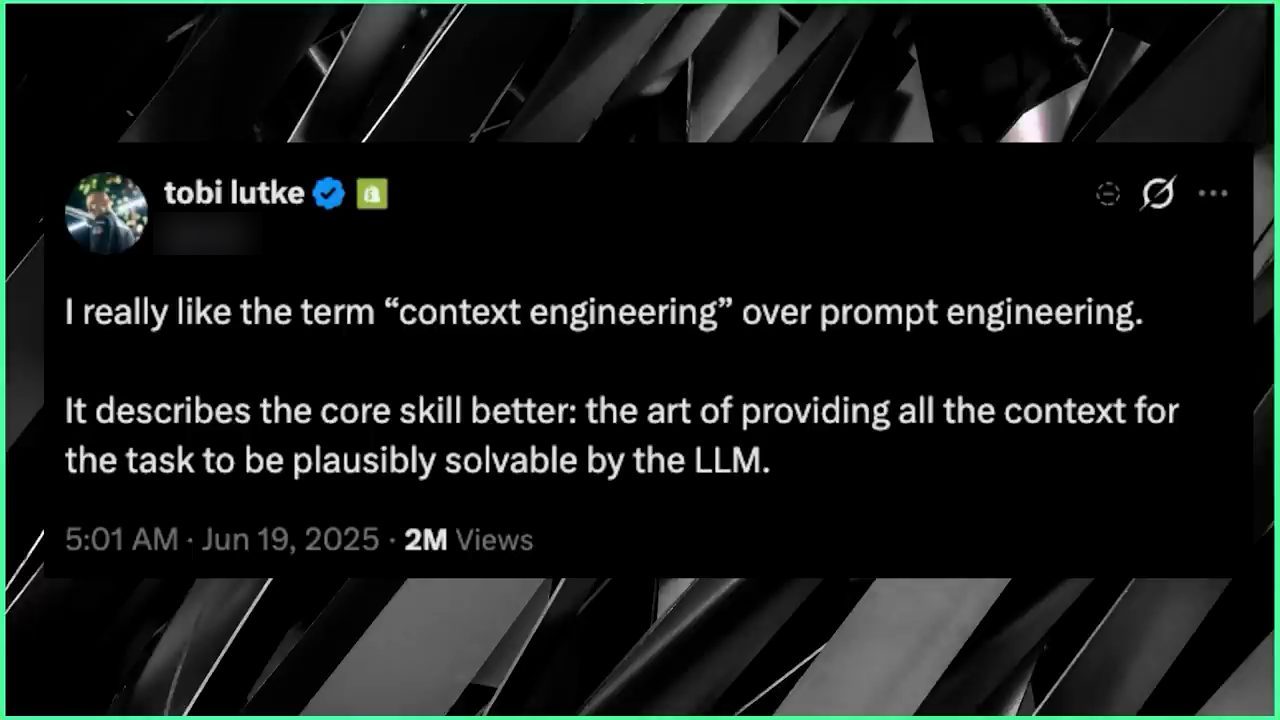
Paweł nói trước khi vào chuyện, có lẽ nên nói một chút để giải mã context engineering là gì, và Artur định nghĩa nó thế nào. Paweł tìm được một câu của Tobi Lütke, CEO của Shopify (câu hỏi của Paweł, video đăng ngày 16/09/2026), người mà Paweł nói đã viết và tweet câu đó "chừng hai tháng trước". Paweł đọc: với Tobi, context engineering là nghệ thuật cung cấp mọi context để task có thể được LLM giải một cách hợp lý (plausibly solvable). Rồi Paweł hỏi Artur nghĩ sao về câu đó.
2. Prompt engineering, chuyện của một năm đến một năm rưỡi trước
Artur nói anh hoàn toàn đồng ý, và thêm một câu "quoting our best friend, Claude" (trích lời người bạn thân nhất của chúng ta, Claude). Anh bắt đầu nói anh cũng coi nó là một..., rồi bỏ lửng và chuyển sang ý chính: theo anh (video đăng ngày 16/09/2026), cách tốt nhất để mô tả context engineering là đặt nó cạnh trào lưu trước đó, prompt engineering.
Artur nói Paweł vừa nhắc tới prompt engineering, và prompt engineering là chuyện "của nhiều năm trước". Rồi anh nói rõ: khi anh nói "nhiều năm trước", ý anh là một năm trước, tới một năm rưỡi trước (tính từ video đăng ngày 16/09/2026). Vậy là không phải một quá khứ xa xôi gì.
Theo Artur (video đăng ngày 16/09/2026), thời prompt engineering có những người chuyên tạo ra những đoạn mô tả rất riêng biệt, theo lời anh là một kiểu "broad discussion" gửi cho LLM, để model làm được task đang có với đầy đủ kiến thức cần thiết. Vậy là: cần có một prompt.
Artur kể anh vẫn nhớ mình từng viết cho model những câu như: bạn là kiến trúc sư, bạn có 20 năm kinh nghiệm với vấn đề này, bạn đang làm X, Y, Z. Mọi thông tin được đưa ra ngay từ đầu (up front), rồi bạn nhận về kết quả one-shot. Có thể sau đó có thêm vài trao đổi về kết quả, cũng có thể bạn thấy kết quả đầu tiên là ổn rồi (video đăng ngày 16/09/2026).
Theo Artur (video đăng ngày 16/09/2026), prompt engineering từng hữu ích ở giai đoạn đầu, khi các model, theo lời anh, còn "dumber" hơn hôm nay rất, rất nhiều. Khi đó bạn đưa đủ context để model trở nên hữu ích. Anh nói context window là thứ mà có lẽ anh và Paweł sẽ bàn tới một chút, muộn hơn trong tập.
3. Context window nhỏ: chia đôi bài báo để tóm tắt
Artur kể anh vẫn nhớ, từ những project đầu tiên của anh với GPT-3.5 và cả GPT-4, khi muốn tóm tắt một bài báo, anh phải chia nó làm đôi, vì context window khi đó khoảng 4.000 "signs", token, đại loại vậy. Anh nói anh không nhớ con số chính xác (video đăng ngày 16/09/2026).
Theo anh, đó là phạm vi những gì làm được với LLM hồi đó. Nếu bạn muốn, chẳng hạn, tóm tắt bài báo bằng code (programmatically), bạn phải làm như vậy: trước hết đếm xem bài báo dài bao nhiêu, rồi chia nó thành những mẩu nhỏ hơn để có được bản tóm tắt. Anh nói đó là con đường mà ai cũng đã đi qua (video đăng ngày 16/09/2026).
Còn ngày nay, theo Artur (video đăng ngày 16/09/2026), chúng ta có context window dài hơn nhiều. Về mặt context, chúng ta có thể có, theo lời anh, "virtually", ít nhất là trên lý thuyết, một prompt dài bao nhiêu tùy ý. Vậy nên chúng ta có thể đưa vào mọi thông tin cần thiết để làm task đó.
4. Meta prompting, rồi câu hỏi mới: agent chạy được bao lâu
Artur nói anh nghĩ rằng nếu chúng ta vẫn dừng ở những use case của năm 2025, thì như vậy là đủ: có prompt, viết một prompt đẹp (video đăng ngày 16/09/2026).
Anh vẫn nhớ thời có cái gọi là meta prompting: những công cụ hỏi thêm bạn các câu hỏi, giúp bạn định hình prompt. Anh nêu ví dụ Superpowers và "getting things done". Theo anh, khi tự viết prompt, có lẽ bạn chẳng bao giờ nghĩ tới đủ mọi thứ, nên bạn cần một người trợ giúp hỏi thêm các câu hỏi. Kết quả là bạn có một prompt rất tốt, và khi chạy, nó cho bạn một câu trả lời. Câu trả lời có thể là một bức ảnh, một đoạn text, một đoạn code, gần như bất cứ thứ gì (theo Artur, video đăng ngày 16/09/2026).
Nhưng ngày nay, theo Artur (video đăng ngày 16/09/2026), cả câu chuyện của AI đã đổi. Không ai nói về context window nữa. Ai cũng nói "tôi chạy được vòng lặp (loop) agent của mình trong bao lâu". Người ta nói: agent của tôi chạy được 20 phút không cần giám sát; agent của tôi chạy được một tiếng rưỡi không cần giám sát. Anh nói anh có nghe về những người cho agent chạy ca đêm, suốt cả đêm.
Vậy là, theo Artur (video đăng ngày 16/09/2026), vấn đề đã dịch chuyển. Trước đây là "tôi phải đưa ngay từ đầu mọi thông tin cần thiết". Giờ thì, anh nói, hãy thực tế: bạn không thể đưa ngay từ đầu mọi thông tin nếu vòng lặp của bạn sẽ chạy nửa ngày, hay thậm chí, nói cho công bằng, nửa tiếng.
5. Vòng lặp agent, và một trợ lý cứ mỗi phút lại hỏi bạn
Theo Artur (video đăng ngày 16/09/2026), LLM giờ làm việc hơi khác. Anh nghĩ phần lớn mọi người giờ đang ở chế độ agent (agentic mode): người ta đưa một prompt ban đầu, và prompt ban đầu đó giống như mồi lửa (igniter) cho cả vòng lặp. Sau đó agent tự prompt chính nó.
Artur mô tả một vòng lặp rất chuẩn: bắt đầu bằng prompt ban đầu; quyết định việc gì đáng làm; làm việc đó với tư cách agent; đánh giá kết quả; và sau khi đánh giá thì quyết định: việc đã xong chưa, hay cần đưa thêm thông tin mới, insight mới vào task ban đầu để làm tốt hơn (video đăng ngày 16/09/2026).
Theo Artur (video đăng ngày 16/09/2026), để có thông tin mới đó, có thể sau mỗi phần việc, agent lại hỏi con người thêm context. Anh nói đến đây cuối cùng thì chúng ta cũng dùng tới chữ "context". Nhưng anh nói như vậy sẽ gây bực bội: hãy tưởng tượng, không phải sau nửa tiếng mà cứ sau nửa phút, bạn lại phải trả lời, lặp đi lặp lại, lặp đi lặp lại suốt nửa tiếng đó. Đó không phải trải nghiệm người dùng mà bạn muốn có.
Theo anh, ROI không có ở đó, vì bạn sẽ liên tục bị trợ lý của mình làm gián đoạn. Anh bảo hãy tưởng tượng bạn có một trợ lý là người thật, và người đó làm phiền bạn mỗi phút một lần. Đó không phải một trợ lý tốt (video đăng ngày 16/09/2026).
Vì thế, theo Artur (video đăng ngày 16/09/2026), ngày nay cả phương trình đã đổi. Chúng ta không còn cố prompt LLM theo cách hiệu quả nhất, theo lời anh là "đầy đủ" nhất nữa. Thay vào đó: nếu LLM rất giỏi rút ra thông tin và lập kế hoạch cho những việc cần làm để hoàn tất một task, thì chúng ta đang chuyển sang cách nghĩ khác. Cũng như với bất kỳ ai trong tổ chức được giao một task, agent cần có context: task có thể được làm thế nào, những thông tin liên quan khác là gì, trạng thái hiện tại của hệ thống ra sao, các ghi chép lịch sử về cách task đó từng được làm, và chúng ta đang hoạt động trong bối cảnh nào.
Artur nói: context, context, vì thế mới gọi nó là context; context là chìa khoá (video đăng ngày 16/09/2026).
6. Paweł hỏi: chữ "context" ở đây là loại context nào
Paweł xin dừng lại một chút. Anh nói khi dùng chữ context, anh thấy nó hơi bị quá tải (overloaded): nó có nhiều nghĩa khác nhau, hay có thể chỉ nhiều loại thông tin ngữ cảnh khác nhau. Nếu muốn cụ thể hơn, anh nghĩ một năm trước, khi người ta nói "context", có lẽ ý họ là một file CLAUDE.md hay một file AGENTS.md (câu hỏi của Paweł, video đăng ngày 16/09/2026).
Còn giờ, theo Paweł, có lẽ chúng ta đang nói nhiều hơn về điều Artur vừa nhắc: việc đó từng được làm thế nào trong quá khứ. Anh hỏi: vậy có phải ta đang nói về cross-session memory, tức agent có thể lấy lại thông tin từ phiên trước về cách mọi việc đã được làm? (câu hỏi của Paweł, video đăng ngày 16/09/2026)
Và đi xa hơn, như Artur vừa nói về những người khác trong công ty, Paweł hỏi: có phải ta cũng đang nói về một kiểu "company brain", hay ít nhất là một giải pháp RAG (retrieval augmented generation) kéo thông tin về context, về thông tin từ cả tổ chức, để hoàn thành task? Câu hỏi của anh: ta đang nói về cái nào trong số đó? (câu hỏi của Paweł, video đăng ngày 16/09/2026)
7. Tacit knowledge: thứ mọi nhân viên có mà agent không có
Artur trả lời: context mà anh đang nói tới là việc cung cấp cho agent thứ tacit knowledge (kiến thức ngầm) mà mọi nhân viên khác đều có (theo Artur, video đăng ngày 16/09/2026).
Anh giải thích: khi có người làm việc cho công ty, ai cũng nói rằng độ senior là quan trọng. Vì sao độ senior quan trọng? Vì chúng ta có hai loại kiến thức. Loại thứ nhất là kiến thức chung. Một người có thể đã làm một việc cụ thể nhiều năm ở nhiều ngành khác nhau. Ví dụ, hãy tưởng tượng việc viết code Java: người đó có kiến thức rất tốt về viết code Java, hiểu hệ sinh thái, các thư viện, các cách deploy, các thứ kết nối với nhau thế nào, tinh chỉnh chúng ra sao. Đó là kiến thức chung (theo Artur, video đăng ngày 16/09/2026).
Theo Artur (video đăng ngày 16/09/2026), kiến thức chung đó agent cũng có, vì agent có cả một corpus đã được gom lại. Ta có thể nói: đó là context mà bạn có thể kỳ vọng LLM có sẵn. Thứ LLM không có là context của tổ chức bạn: mọi việc được làm ở đó ra sao.
Theo Artur (video đăng ngày 16/09/2026), đây là lý do onboarding ở các công ty, kể cả với người senior, luôn là một giai đoạn rất dài: bạn cần học về các quy trình, các phương pháp công ty dùng, các tiêu chuẩn là gì, cách làm cho giải pháp, theo lời anh, khớp với stack hiện tại.
8. Ví dụ Notepad, lời giải nhanh, và chuyện stack của công ty
Theo Artur (video đăng ngày 16/09/2026), đây là điều agent làm nếu không được cung cấp context đúng cách: chúng đưa cho bạn câu trả lời. Anh nói đó là thứ Claude làm rất giỏi. Vì sao ai cũng thích Claude? Ấn tượng của anh là nó rất nhanh tới lời giải.
Theo Artur (video đăng ngày 16/09/2026), đó sẽ không phải lời giải tối ưu nhất, sẽ không phải lời giải đã cân nhắc mọi thứ. Nó sẽ không hỏi nhiều câu hỏi, sẽ không cố hiểu thật kỹ context đó. Anh nói anh không coi Claude là tệ. Anh đang nghĩ về tình huống: chế độ vận hành mặc định của model đó là gì. Theo anh, nó có thể đi tới lời giải rất nhanh, và như vậy ai cũng vui.
Artur lấy ví dụ (video đăng ngày 16/09/2026): ta đưa một prompt ban đầu, "hãy làm ứng dụng notepad". Claude đưa ra vài giả định và sẽ trả cho bạn một ứng dụng notepad, theo lời anh là "in no time", có thể không mất chút thời gian nào, mà không làm phiền bạn nhiều. Và nếu bạn không biết mình muốn đạt được gì, thì phần lớn thời gian đó là một điều tuyệt vời: tôi muốn có Notepad, tôi có Notepad; tôi chưa từng nghĩ Notepad của mình cần có những gì, nên tôi có thể lặp (iterate) tiếp trên nó.
Nhưng theo Artur (video đăng ngày 16/09/2026), ở phần lớn các công ty, nhất là các công ty enterprise, chúng ta không muốn lần nào cũng đi từ một giải pháp greenfield. Nếu một công ty đã kinh doanh 20 năm, có lẽ có rất nhiều institutional knowledge về việc "ở đây chúng tôi làm phần mềm thế nào".
Và nếu không cung cấp cho LLM context đó, thứ tacit knowledge đó (anh nói đó là lý do anh so context với tacit knowledge: thông tin mà mọi người khác trong công ty đều có), thì theo Artur (video đăng ngày 16/09/2026), agent không làm được việc cho đúng. Nó sẽ tạo ra một giải pháp, nhưng giải pháp đó có thể ở một stack khác, có thể dùng những thư viện khác. Ví dụ dùng RabbitMQ làm queue trong khi công ty đang dùng Kafka. Hay có thể ta đã biết là không muốn deploy lên AKS (Kubernetes), vì ta đang dùng EC2 trên AWS.
Theo Artur (video đăng ngày 16/09/2026), agent không biết điều đó, nên nó đi theo giải pháp hiển nhiên nhất, hoặc phải hỏi bạn. Và như đã nói, nếu agent chạy kéo dài, ta không muốn phải dừng lại để agent hỏi mình đủ thứ, trừ khi đó là chuyện thật sự quan trọng. Anh nói đó là lý do ta cần cung cấp context cho nó.
9. Từ một repo lên cấp tổ chức: cái nút trên trang chủ
Theo Artur (video đăng ngày 16/09/2026), có nhiều cấp context khác nhau. Những task như thao tác trên một repo cụ thể phần lớn là context của code, context của một repo. Như vậy là ổn, vì Claude làm được, Claude hay Codex hay bất kỳ công cụ nào khác. Anh nói Claude là "my darling", vì anh dùng Claude suốt.
Theo Artur (video đăng ngày 16/09/2026), công cụ đó lấy được mọi thứ trong repository, có thể lấy lịch sử, có thể làm việc ở mức code, lấy thông tin từ một comment trước đó. Đó là những thứ Claude truy cập được.
Nhưng để làm cho một thứ chạy được ở cấp tổ chức, theo Artur (video đăng ngày 16/09/2026), bạn cần nhiều thông tin hơn nhiều. Bạn cần biết CI/CD ở đâu, Jira ticket ở đâu, nó sẽ được deploy ở đâu, ai là owner của microservice đó, ai sẽ trả lời, ai sẽ là người merge PR cuối cùng. Rồi runbook là gì, các sự cố từng được giải quyết thế nào trong quá khứ, và có thể cả các architectural decision record (ADR) của service đó. Và anh nói đó vẫn là đang nói ở cấp một service.
Theo Artur (video đăng ngày 16/09/2026), mọi thứ trở nên rất thú vị khi ta định nghĩa task ở một cấp cao hơn, trừu tượng hơn nhiều. Thực tế hiện nay là bạn mở một terminal, terminal đó cho bạn gõ prompt ban đầu, và agent làm việc trong context của một repo. Nhưng, một lần nữa, phần lớn công việc đòi hỏi làm việc trên một hệ thống phức tạp hơn nhiều.
Artur lấy một ví dụ rất đơn giản (video đăng ngày 16/09/2026): bạn cần thêm một cái nút vào trang chủ của, chẳng hạn, ứng dụng của bạn. Bạn phải đi qua frontend, backend for frontend, backend và database. Và anh nói đây là phiên bản đơn giản.
Theo Artur (video đăng ngày 16/09/2026), nếu bạn định nghĩa task ở cấp một repo, thì bạn là người điều phối (orchestrator), bạn là người quan tâm tới công việc: tôi đã mở cả bốn repo, và ở đây, "dear Claude", hãy thêm cái nút; ở đây thêm data model cho backend; ở đây thêm backend, một kiểu logic ứng dụng; và ở đây là database cần được điền.
Nhưng nếu muốn agent làm việc ở cùng cấp với một người vận hành là con người, tức ở cấp Jira ticket, ở cấp spec, thì theo Artur (video đăng ngày 16/09/2026), agent cần biết data flow trong tổ chức là gì, phần nào của code cần chạm vào, những repository nào, thứ tự deploy ra sao, các biến môi trường là gì, và mọi thứ như vậy, những thứ đòi hỏi nó đi lên một cấp, cao hơn cấp code đơn thuần.
Theo Artur (video đăng ngày 16/09/2026), agent cần chọn làm việc ở repository nào, ở phần nào của hệ thống. Và để làm vậy, nó cần hiểu toàn bộ data flow của ứng dụng: mọi thứ vận hành thế nào, các kết nối là gì, đường đi của một đoạn code cụ thể là gì.
10. Paweł hỏi: lấy context từ đâu, và chọn thông tin nào
Paweł nói ví dụ này là một ví dụ khá tốt, vì thế giới thật trông như vậy: không phải là một repository. Có thể là một monorepo, nhưng trong đó có nhiều service khác nhau. Ngay cả trong monorepo, bạn vẫn phải hiểu phần nào của hệ thống cần chạm vào để ra kết quả cuối cùng (theo Paweł, video đăng ngày 16/09/2026).
Paweł bắt đầu hỏi "vậy trong trường hợp đó, làm sao chúng ta...", rồi nói thêm: trường hợp điển hình là chúng ta, những con người, theo lời anh là không giỏi lắm việc viết tài liệu. Các doanh nghiệp lớn khá hơn một chút. Anh nghĩ vấn đề chúng ta gặp hôm nay với tất cả chuyện context này phần nào là vấn đề các tổ chức lớn từng gặp trong quá khứ, vì thay vì agent, họ có con người, và con người cũng cần một kiểu context nào đó (theo Paweł, video đăng ngày 16/09/2026).
Câu hỏi anh muốn đặt ra: hiển nhiên một cách để lấy context là phân tích toàn bộ source code, vì rốt cuộc cách mọi thứ vận hành được lưu ở đâu đó trong codebase. Nhưng có rất nhiều repository khác nhau. Paweł nói Artur cũng đã nêu tên một nơi chứa thông tin khác: có lẽ là Jira ticket, tức một hệ thống ticket. Rồi có lẽ còn một kiểu knowledge base nào đó, có thể là Notion, hay một hệ thống knowledge base tương tự. Có thể có cả loạt nơi khác nhau mà bạn phải gom kiến thức về (câu hỏi của Paweł, video đăng ngày 16/09/2026).
Paweł chia câu hỏi làm hai phần. Phần thứ nhất: làm sao biết thông tin nào là liên quan tới task đang làm? Phần thứ hai: làm sao tránh làm agent quá tải với tất cả thông tin đến từ nhiều nguồn như vậy? (câu hỏi của Paweł, video đăng ngày 16/09/2026)
11. Lost in the middle và những thông tin mâu thuẫn theo năm
Artur nói anh sẽ trả lời theo cách này: đó là lý do việc tạo một prompt lớn, một context lớn, như chúng ta từng làm, nhồi đầy context window bằng mọi thông tin có thể, chưa bao giờ là câu trả lời tốt (theo Artur, video đăng ngày 16/09/2026).
Theo Artur (video đăng ngày 16/09/2026), ngay cả hồi đó đã có vài vấn đề. Có vấn đề "lost in the middle": thông tin đặt ở đầu prompt và ở cuối prompt thì được tính tới, còn ở giữa thì không. Anh nói chuyện này y hệt với con người: nếu bạn muốn người ta chỉ lướt qua, hãy đặt lập luận, theo lời anh là "không thuyết phục nhất", vào giữa, và sẽ chẳng ai để ý. Theo anh, ở điểm này LLM không khác chúng ta là mấy.
Vấn đề thứ hai khi đưa vào những prompt rất dài, theo Artur (video đăng ngày 16/09/2026): phần lớn thời gian, nếu bạn đưa nhiều thông tin vào context window, sẽ có những thông tin mâu thuẫn nhau.
Anh bảo hãy tưởng tượng tình huống: bạn gom mọi thông tin có thể về mô hình deploy của giải pháp. Và nó lấy về những file từ những năm khác nhau, trong đó có 2025 và 2022. Chúng sẽ mâu thuẫn nhau, vì thế giới thay đổi (theo Artur, video đăng ngày 16/09/2026).
Theo Artur (video đăng ngày 16/09/2026), nếu bạn không đặt thông tin đúng cách, kiểu "cái này quan trọng nhất", "cái này mới nhất", một meta tag, một meta information nào đó, thì có lẽ một thứ từ 2022 sẽ là quan trọng, nhưng phần lớn kiến thức sẽ đã cũ (stale).
12. Model tự dựng lại lịch sử và không tin context nhiều đến thế
Artur nói đó là lý do anh nghĩ ngày nay điều này quan trọng hơn nhiều. Theo anh (video đăng ngày 16/09/2026), nếu các model khá thông minh, và bạn đưa cho chúng thông tin cùng metadata của thông tin đó, thì chúng có thể tự dựng nên một bức tranh về thế giới.
Artur bảo hãy tưởng tượng (video đăng ngày 16/09/2026): nếu model được truy cập không phải prompt mà bạn vừa chuẩn bị, "nấu sẵn" cho nó, mà là lịch sử các thay đổi trong mô hình deploy của bạn, thì nó có thể đi qua lịch sử đó và rút ra: năm 2023, 2022, có một thứ đã thay đổi trong mô hình deploy; rồi phần đó giữ nguyên trong bốn năm tiếp theo; còn mọi phần khác thì vẫn thay đổi. Như vậy chúng có thể dựng nên toàn cảnh.
Theo Artur (video đăng ngày 16/09/2026), có thể không phải ở lần lặp đầu tiên, có thể không phải ở lượt chạy đầu tiên của vòng lặp, nhưng cuối cùng chúng có thể rút thông tin ra từng mẩu một, để lời giải cuối cùng, theo lời anh, khá hợp lý (pretty plausible).
Theo Artur (video đăng ngày 16/09/2026), vì ngày nay các model thông minh hơn nhiều, chúng có thể tự kiểm tra (validate) chính mình. Anh nói đây có lẽ là thay đổi lớn nhất: chúng không tin context nhiều đến thế.
Artur lấy ví dụ (video đăng ngày 16/09/2026): giả sử context ghi "hãy đặt cái này vào Azure AKS". Rồi model thấy không có cluster nào như được mô tả trong tài liệu. Chúng sẽ thử kiểm tra vì sao lại như vậy: có thể cluster không còn tồn tại nữa, có thể chúng không có credentials. Theo anh, chúng có thể rút ra cấu trúc thông tin từng mẩu một.
Nhưng để làm được vậy, theo Artur (video đăng ngày 16/09/2026), chúng cần được truy cập context.
13. Quyền truy cập, cuộc họp được ghi lại, phiên bản đầu và phiên bản đang chạy
Theo Artur (video đăng ngày 16/09/2026), quyền truy cập context là chuyện khó, vì đi kèm với nó là những thứ như permission. Một agent có nên được truy cập mọi kênh Slack của bạn không? Có nên được truy cập mọi cuộc họp của bạn không?
Anh nói một thay đổi rất thú vị hiện nay (video đăng ngày 16/09/2026) là người ta ghi lại các cuộc họp cho agent, để agent lấy được mọi thông tin mà mọi người nói trong cuộc họp và có lẽ chưa bao giờ được viết ra giấy. Có bản ghi lời là agent có thể nghĩ: à, chuyện đó đã được bàn, và đã có một lý do nào đó. Theo anh, vì chúng ta vẫn là con người, chúng ta vẫn họp, và những cuộc họp đó khá quan trọng. Agent cũng cần được truy cập chúng.
Rồi Artur nói Paweł có hỏi về thông tin cũ (stale) trong repo. Theo anh (video đăng ngày 16/09/2026), ngay cả với anh, khi anh là một developer con người, thông tin quan trọng nhất nằm ở phiên bản hiện tại của codebase và ở phiên bản đầu tiên của hệ thống.
Theo Artur (video đăng ngày 16/09/2026), phiên bản đầu tiên của hệ thống nói lên: giả định ban đầu là gì, lý do để hệ thống này tồn tại là gì, một ý tưởng gốc nào đó. Ý tưởng đó thường rất quan trọng; dù nhiều chi tiết thay đổi ở những lần lặp sau, vẫn đáng để biết ý tưởng đó.
Và cuối cùng, theo anh, phiên bản hiện tại chỉ đơn giản nói: nó đang chạy thế này. Vì vậy nó quan trọng về mặt vận hành (video đăng ngày 16/09/2026).
14. Governance trong môi trường bị quản lý chặt: phần reasoning bị mất
Paweł nói Artur đã chạm tới một khái niệm khá thú vị: những tình huống thực tế mà context trở nên khó vì đủ loại permission, các cấp truy cập, những đặc quyền mà agent nên có hoặc không nên có, hoặc nên có trong context của một người dùng cụ thể. Anh nói mọi thứ trở nên rất rắc rối (câu hỏi của Paweł, video đăng ngày 16/09/2026).
Anh hỏi: có điều gì rút ra từ cuộc trò chuyện này không, nhất là trong những môi trường enterprise bị quản lý chặt hơn (enterprise-regulated), khi ta nói về việc tổng hợp và thu thập context như vậy? (câu hỏi của Paweł, video đăng ngày 16/09/2026)
Artur bắt đầu "theo góc nhìn của tôi, bạn cần...", rồi nói lại: nếu bạn muốn đưa agent vào đó, thì trong quá khứ, governance là gì? Theo anh (video đăng ngày 16/09/2026), governance là hiểu người ta đang làm gì và vì sao họ làm vậy, và họ có làm đúng việc không. Dù không phải hằng ngày, nhưng có thể giải mã điều đó từ bất cứ thứ gì ta biết trong hệ thống: rút ra được vì sao một quyết định cụ thể đã được đưa ra, và hiểu được lập luận đằng sau.
Theo Artur (video đăng ngày 16/09/2026), ngày nay điều có lẽ là rắc rối nhất là: nếu ta đặt agent vào vòng lặp, ta thấy phiên bản ban đầu, ta thấy phiên bản cuối cùng, thứ đã được tạo ra, nhưng toàn bộ phần reasoning thì bị mất.
Anh hỏi không biết Paweł đã bao giờ thử đọc qua hết các vòng reasoning đó chưa. Theo Artur (video đăng ngày 16/09/2026), ngày nay mọi agent đều chia sẻ thông tin: nó đã nghĩ gì, lý do của một quyết định cụ thể là gì, các bước cụ thể để đi tới lời giải cuối cùng là gì.
Nhưng, theo Artur (video đăng ngày 16/09/2026), đi qua cả quá trình đó khi bạn đã có lời giải trong tay, mà có khi nó dài 40 trang, 60 trang text, thì với con người là không khả thi, nếu không thật sự cần. Dù vậy, bạn vẫn muốn có nó khi cần. Anh nói vì thế tracing rất quan trọng để hiểu agent của bạn đang dùng context của bạn ra sao.
15. Tracing: kiểm xem agent đã dùng context nào
Artur nói validation là một chủ đề nữa mà hôm nay anh và Paweł không có thời gian bàn. Theo anh (video đăng ngày 16/09/2026), đó là chuyện cho tương lai: có thể kiểm (validate) xem agent đã làm tốt hay chưa. Và có lẽ một trong những cách tốt nhất là cố hiểu công việc đã được làm dựa trên cơ sở nào.
Artur quay lại ví dụ cái nút (video đăng ngày 16/09/2026): hãy tưởng tượng bạn có ticket thêm cái nút ở frontend. Hãy kiểm xem agent có dùng thông tin không: đã kiểm. Nó có kiểm xem kiến trúc có đúng không? Đã kiểm chưa? Được. Nó có cân nhắc các ticket khác không? Nó có cân nhắc những thứ như thông tin về cấu trúc ownership, về code trước đó, về các ADR không?
Theo Artur (video đăng ngày 16/09/2026), nếu những thứ đó đã được lấy ra trong quá trình làm, những phần cụ thể đó đã được kích hoạt, được dùng, được truy xuất, thì khả năng lời giải cuối cùng ngang chuẩn công ty của bạn sẽ cao hơn nhiều.
Còn nếu agent của bạn chưa từng buồn kiểm các ADR, chẳng hạn, thì Artur nói anh không nghĩ cuối cùng đó sẽ là một lời giải tốt. Nó có thể chạy được. Nó có thể khả thi. Nó có thể làm xong việc. Nhưng, theo anh (video đăng ngày 16/09/2026), nó sẽ không phải một thứ tốt trong context của công ty bạn. Chúng cần hiểu hệ sinh thái mà chúng đang hoạt động trong đó.
Theo Artur (video đăng ngày 16/09/2026), tracing, việc rút được thông tin sau khi sự việc đã xảy ra (post-factum) và dùng nó như một phần của quá trình review và testing, là rất, rất quan trọng. Nhưng để làm vậy, bạn cần có tracing đúng cách.
Và anh nói tracing là thứ mà người ta quên nghĩ tới. Theo Artur (video đăng ngày 16/09/2026), đọc qua nhiều trang như vậy không phải là giải pháp, vì việc đó sẽ không xảy ra. Bạn cần có công cụ tốt hơn cho việc đó.
16. "Reasoning logs are the new comments" và lời cảm ơn
Paweł nói thêm: ngoài ra, đó là thông tin hữu ích cho người đang đào vào đoạn code đó, hoặc trong lúc review, hoặc ngay cả khi không có con người review. Chẳng hạn ai đó có thể cần debug một thứ gì đó, hay hiểu vì sao một sự cố (outage) xảy ra trên production, hai tháng sau. Và thông tin về lập luận đằng sau việc đưa vào một thay đổi cụ thể hai tháng trước đó có thể khá hữu ích, đúng không? (theo Paweł, video đăng ngày 16/09/2026)
Artur đáp: "Reasoning logs are the new comments" (reasoning log là comment kiểu mới). Theo anh (video đăng ngày 16/09/2026), chúng có đúng những vấn đề như comment: có thể đã cũ, có thể phình to (bloated). Nhưng comment thì xưa nay vẫn hữu ích.
Theo Artur (video đăng ngày 16/09/2026), ngày nay chúng ta có thể đọc tất cả reasoning đó. Trong quá khứ, comment có thể gây hiểu nhầm cho con người. Ngày nay chúng ta có thể để máy đọc tất cả, và rút ra sự thật, trước hết bằng cách cân nhắc mọi thứ là sự thật trong hệ thống. Vì vậy chúng hữu ích hơn nhiều ngày nay. Và anh nghĩ nói chung comment ngày nay cũng hữu ích hơn nhiều.
Artur nói: "So that is the thing with reasoning" (đó là chuyện của reasoning).
Paweł nói anh nghĩ đó là một kết luận tuyệt vời cho tập này, một cuộc trò chuyện ngắn về context. Anh cảm ơn Artur rất nhiều vì cuộc trò chuyện.
Artur cảm ơn lại rất nhiều và nói đây là một cuộc trò chuyện vui ("It was a funny one"), rồi chào: "See ya." Có tiếng đáp: "See ya. Take care."
Nguồn và liên kết 7 nguồn
- Tên gốc: Context Engineering Is Replacing Prompt Engineering in AI-Native SDLC | Artur Skowroński
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=orbzHgJ825c youtube.com
- Kênh YouTube VirtusLab (Paweł Dolega và Artur Skowroński, chương trình Beyond the Commit): youtube.com/channel/UCsLrgs0Sx_baN0SP8hCn7KA youtube.com
- AGENTS.md, định dạng file mà Paweł nhắc cùng CLAUDE.md; trang này tự mô tả là "README for agents" (đọc ngày 21/11/2026): agents.md agents.md
- Superpowers, ví dụ công cụ meta prompting mà Artur nêu; repo tự mô tả là "An agentic skills framework & software development methodology that works" (đọc ngày 21/11/2026): github.com/obra/superpowers github.com
- Bài báo trên arXiv có tên "Lost in the Middle: How Language Models Use Long Contexts", cùng tên với vấn đề "lost in the middle" mà Artur nói tới (đọc ngày 21/11/2026): arxiv.org/abs/2307.03172 arxiv.org
Related talks
Harness engineering: Ryan Lopopolo về tool và context, demo harness tuyến tính và vòng kín, ba layer của stack agent
Smitha Kolan, Luke Schlangen, Tilde Thurium, Ryan Lopopolo & Billy Jacobson · Google Cloud Tech · 31 min
Agent harness là gì, vì sao Ryan Lopopolo dồn sức vào tool và context, demo harness tuyến tính, vòng kín, ADK, và stack model, harness, knowledge.
Pi agent tự compact context: devlog agentic coding
IndyDevDan · IndyDevDan · 30 min
Viết draft plan rồi để ba harness build một Pi agent có tool self_compact, ba ngưỡng notice, warning, force và compaction prompt tự viết.
Agent không cần model lớn hơn, nó cần context tốt hơn
Muhammad Farooq · Prompt Engineering · 13 min
Vì sao agent hỏng do context chứ không do model, bốn luật của context tốt, và demo thêm long-term memory xuyên session cho coding agent qua MCP và Redis.