Agent không cần model lớn hơn, nó cần context tốt hơn
Vì sao agent hỏng do context chứ không do model, bốn luật của context tốt, và demo thêm long-term memory xuyên session cho coding agent qua MCP và Redis.
✓ Đã duyệt độc lập · cập nhật 17/10/2026 · 13 min
1. Agent hỏng không phải vì model thiếu thông minh
Video được Redis tài trợ.
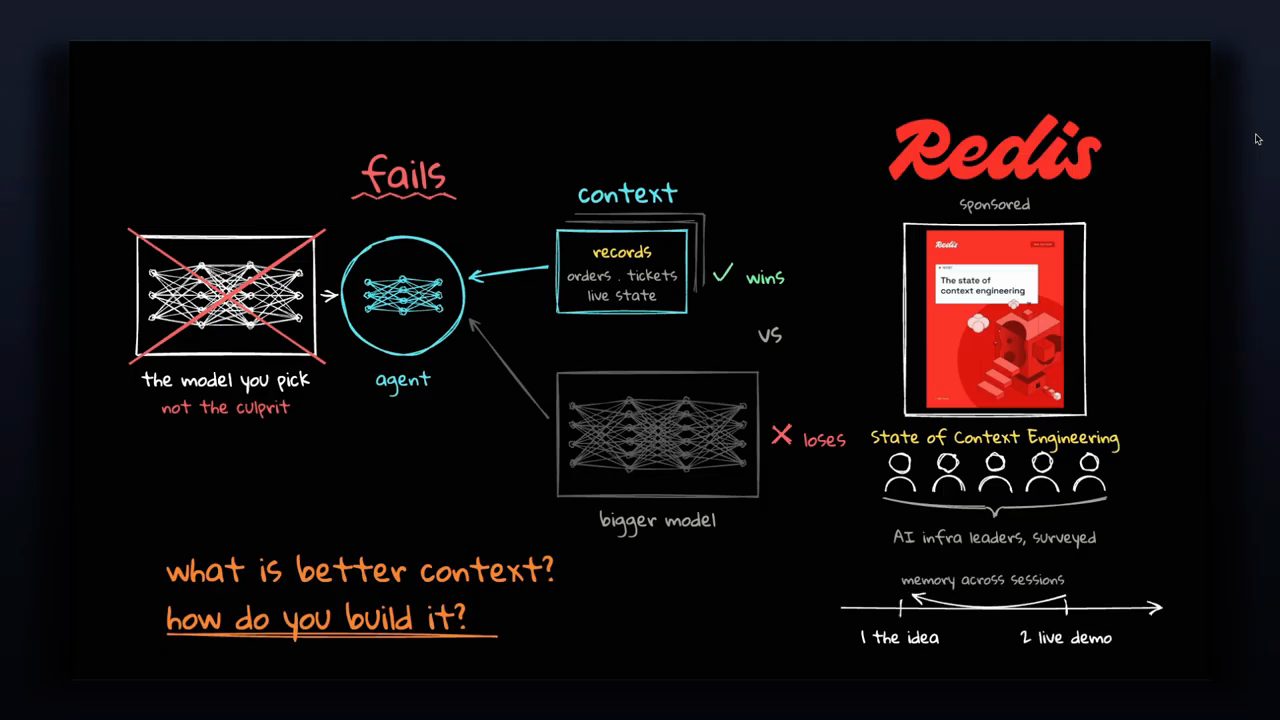
Muhammad mở đầu bằng một khẳng định thẳng: agent thất bại không phải vì model bạn chọn thiếu trí thông minh. Agent thất bại vì context bạn đưa vào nó bị hỏng. Và hoá ra, cho agent một context có cấu trúc, chọn lọc chính xác như phẫu thuật (structured, surgical context) thì lần nào cũng thắng việc nâng cấp nó lên một model flagship khổng lồ.
Câu hỏi đặt ra là "context tốt hơn" cụ thể nghĩa là gì, và làm thế nào để build được nó. Theo anh, đây đang là câu hỏi nóng nhất lúc này. Redis vừa công bố một báo cáo về chủ đề này, và báo cáo đó xác nhận đúng điều mà các team chạy agent trên production đã thấy: chúng ta đã tối ưu nhầm tầng (layer) của stack.
Lộ trình của video có hai phần: đầu tiên phân tích các kiểu hỏng ở mức kiến trúc (architectural failure modes), sau đó là một demo cách build context với Redis. Nhưng trước hết, anh đi qua những kiểu hỏng phổ biến mà agent hay gặp.
2. Ba kiểu hỏng: dead end, stale state, latency
Ví dụ xuyên suốt: bạn có một customer support agent, và người dùng hỏi về trạng thái đơn hàng của họ ("status of my order?"). Agent có ba nguồn dữ liệu: CRM, database đơn hàng (Orders DB) và hệ thống ticket.
Kiểu hỏng thứ nhất, anh gọi là dead end (ngõ cụt). Agent kéo được support ticket về, nhưng không có một đường quan hệ (relational path) nào từ ticket sang bản ghi đơn hàng, vì hai thứ đó nằm ở hai silo khác nhau. Thế là model làm đúng cái việc mà language model vẫn làm khi bị bịt mắt: nó hallucinate, tức bịa ra câu trả lời.
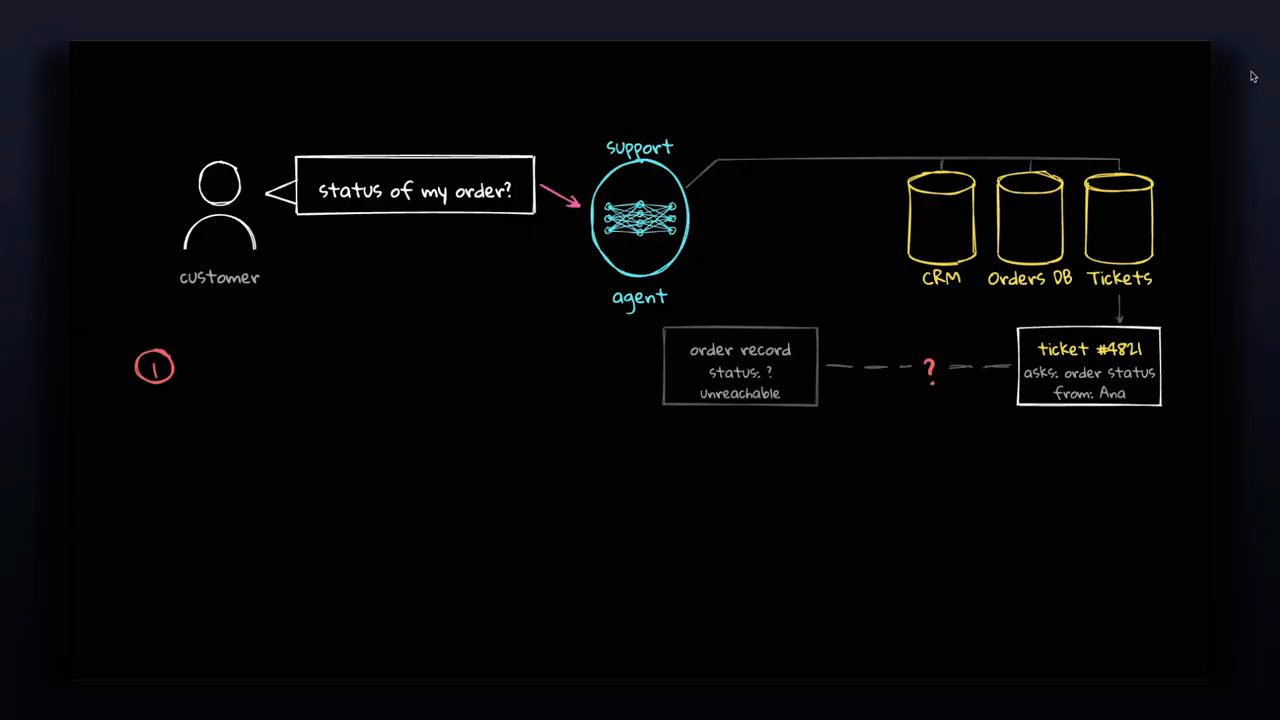
Kiểu hỏng thứ hai là stale state (trạng thái cũ). Lần này agent tìm được đơn hàng, nhưng từ một bản export lấy ra 12 tiếng trước. Đây là chuyện độ tươi của dữ liệu (freshness). Thực tế gói hàng đã được gửi đi sáng nay, nhưng agent không hề biết. Kết quả là agent tự tin khẳng định đơn chưa được gửi, và đưa thông tin sai cho người dùng.
Kiểu hỏng thứ ba là latency (độ trễ). Giả sử agent tìm được đúng dữ liệu, nhưng nó phải nối tám lượt gọi tuần tự (eight sequential round trips) qua ba API khác nhau. Đến lúc nó trả lời được thì người dùng đã đóng cửa sổ chat từ lâu, vì độ trễ quá lớn.
3. Model vẫn ổn, cái hỏng là context
Trong cả ba trường hợp trên, phần suy luận (reasoning) của model đều ổn. Thất bại không đến từ việc thiếu trí thông minh, mà từ việc không cung cấp đúng context vào đúng lúc. Và chuyện này có thể làm gãy hệ thống agentic của bạn mà bạn thậm chí không nhận ra. Theo Muhammad, báo cáo của Redis cho thấy đúng điều đó.
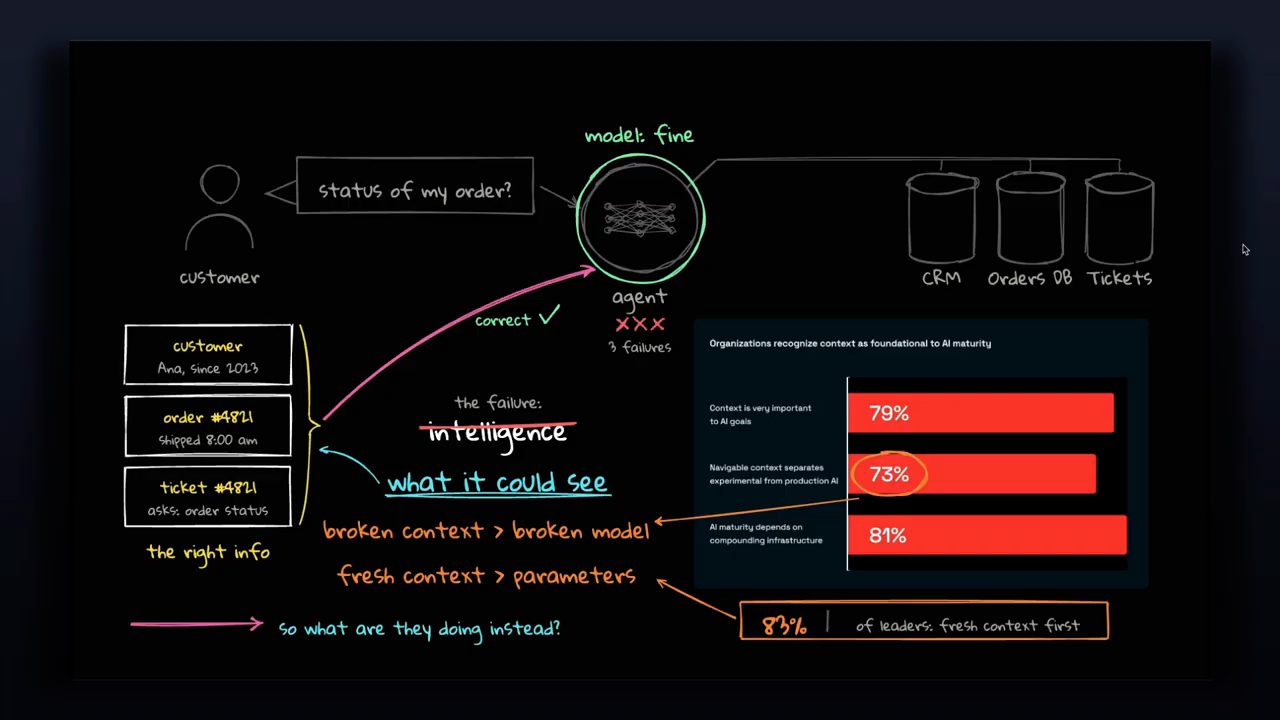
Hai dòng anh viết lên bảng tóm lại ý này: "broken context > broken model" (context hỏng là vấn đề lớn hơn model hỏng) và "fresh context > parameters" (context tươi quan trọng hơn số tham số). Mũi tên cuối cùng dẫn sang câu hỏi tiếp theo: vậy thay vào đó các team đang làm gì?
4. Prompt engineering và context engineering khác nhau thế nào
Muhammad quay lại định nghĩa: context engineering cho một agent chính xác là gì, và nó khác prompt engineering ở đâu.
Prompt engineering về cơ bản là cách bạn cấu trúc câu chỉ dẫn ban đầu (initial instruction) cho model. Bạn lấy một chuỗi duy nhất, chỉnh cách diễn đạt (phrasing), thêm vài ví dụ few-shot, và ép một schema cho đầu ra. Việc này có ích, nhưng mọi thứ đều nằm gói gọn trong một chuỗi đó. Ví dụ trên bảng là prompt "You are a support agent. Be concise, answer in 2 lines, always polite." với ba núm chỉnh: phrasing, examples, format.
Context engineering vận hành ở một tầng cao hơn hẳn. Đó là việc build một hệ thống real-time quyết định agent nhìn thấy trạng thái nào ở từng bước. Ví dụ: lấy bản ghi khách hàng nào, kiểm tra trạng thái live nào, và đưa chúng tới đủ nhanh để chạy được trên production.
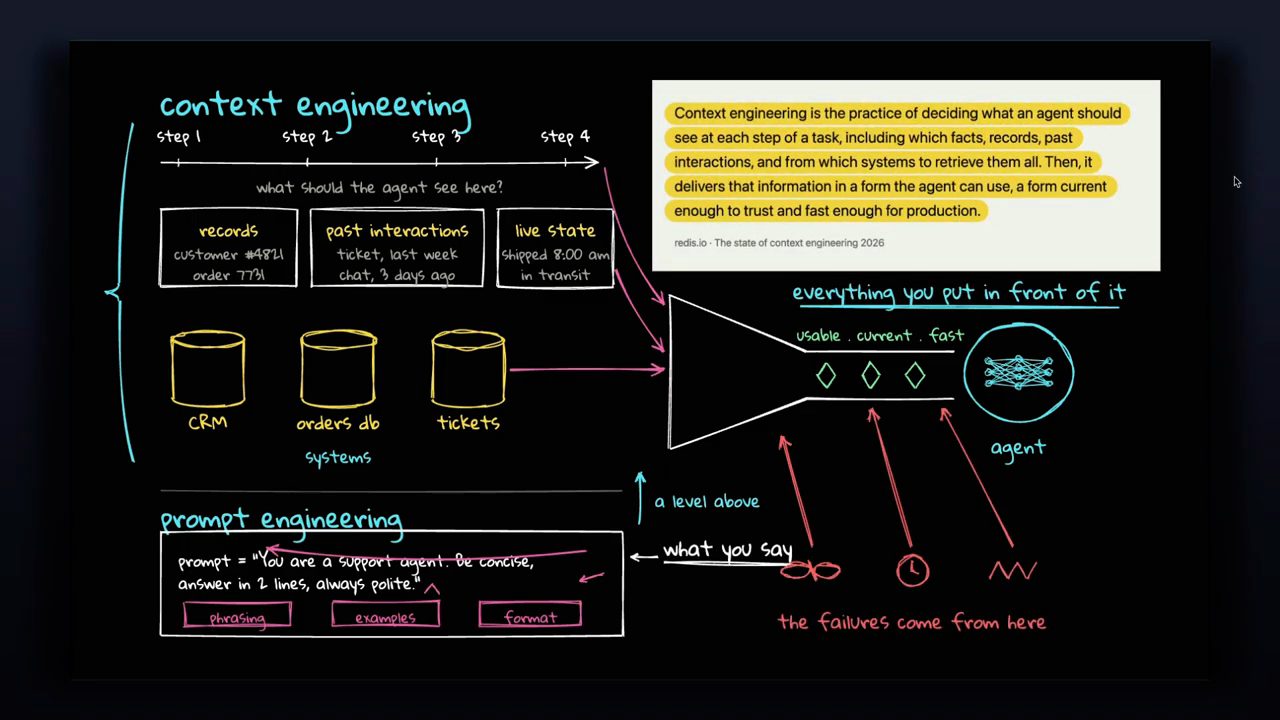
Nói gọn: prompt engineering là những gì bạn nói với model, còn context engineering là toàn bộ môi trường runtime bạn dựng xung quanh nó. Và phần lớn những thất bại bạn thấy trong hệ thống agentic đến từ việc cung cấp context sai hoặc hỏng.
5. Bốn luật của context tốt: navigable, fresh, fast
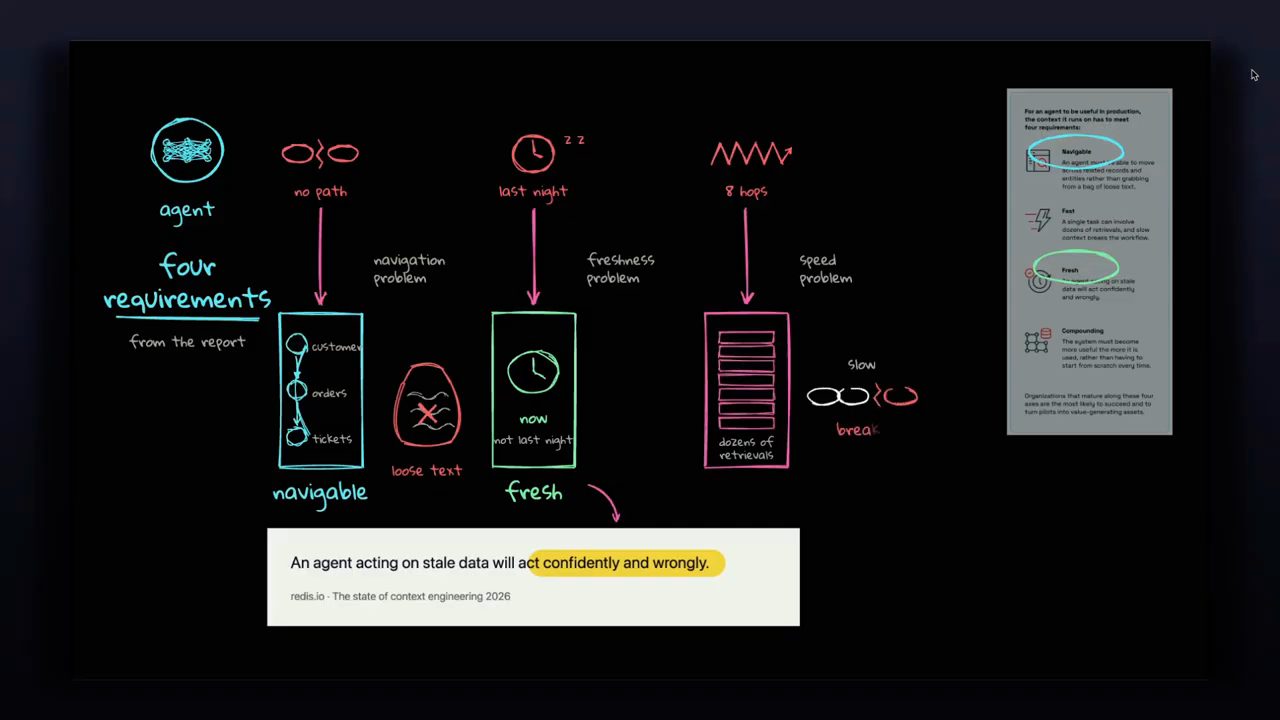
Nhìn lại ba kiểu hỏng ở trên, Muhammad nói context sẵn sàng cho production phải thoả bốn luật mang tính cơ học (four mechanical rules), lấy từ báo cáo.
Thứ nhất, nó phải navigable (đi lại được). Agent cần duyệt được quan hệ giữa các thực thể như người dùng, đơn hàng và ticket, thay vì tra từ khoá mù (blind keyword lookup) hay mò trong văn bản thô. Đây là lời giải cho vấn đề điều hướng (navigation problem), tức kiểu hỏng "không có đường".
Thứ hai, nó phải fresh (tươi). Nếu agent hành động dựa trên trạng thái cũ, nó sẽ hành động một cách tự tin nhưng sai. Vì vậy freshness là yếu tố sống còn: dữ liệu của "bây giờ", không phải của "đêm qua".
Thứ ba, nó phải fast (nhanh). Khi một task kích hoạt hàng chục truy vấn con (sub-queries), độ trễ của từng truy vấn cộng dồn lại và trực tiếp làm gãy workflow. Bạn cần nghĩ nghiêm túc về latency.
6. Luật thứ tư mà phần lớn hệ thống bỏ qua: compound
Thứ tư, và đây là luật mà phần lớn các setup bỏ qua: context phải compound (tích luỹ theo thời gian). Hiện nay, khi một session của agent kết thúc, context của nó bị xoá về số không. Khi cùng người dùng đó quay lại vào ngày mai, model phải học lại từ đầu: họ là ai, họ dùng những quy ước nào, và lần trước cái gì đã hỏng.
Nhưng để một hệ thống production thật sự hiệu quả, nó phải thông minh hơn khi bạn dùng nó nhiều hơn. Đó là lý do những gì hệ thống học được cần được cộng dồn theo thời gian.
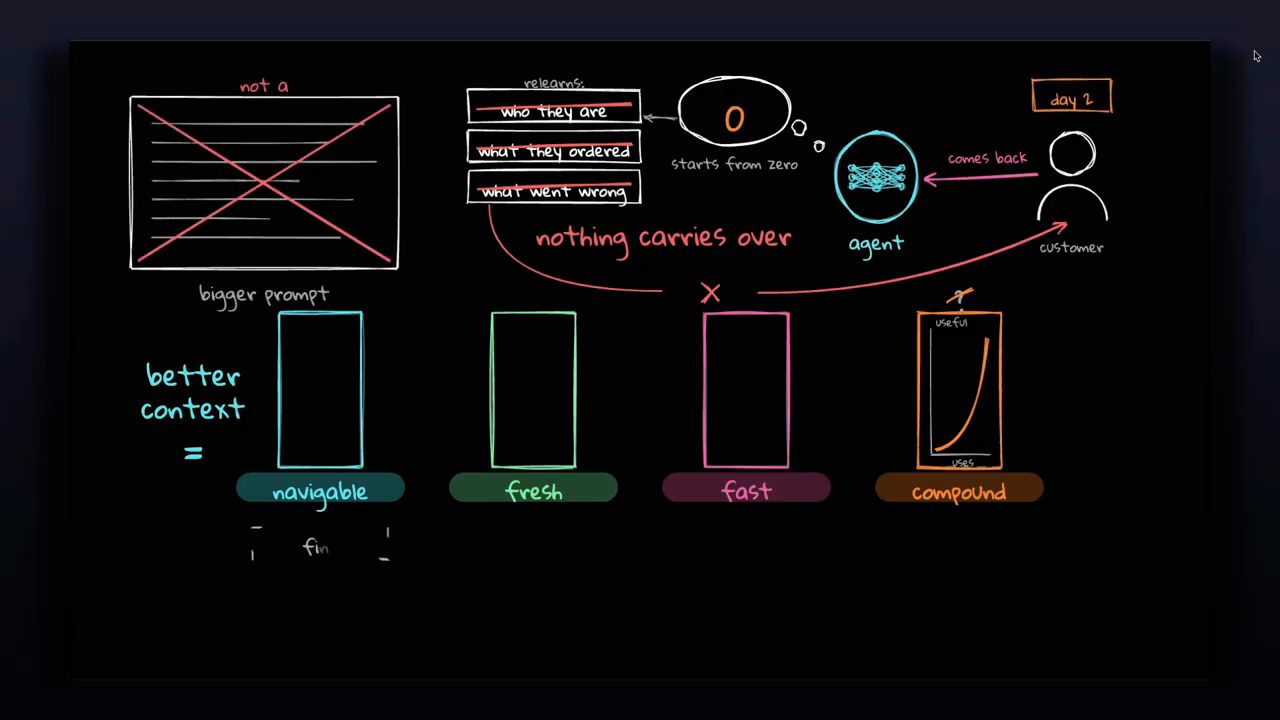
Tất cả những điều này là về context tốt, không phải prompt lớn hơn. Cốt lõi là đúng thông tin vào đúng thời điểm. Câu hỏi tiếp theo là: tại sao phần lớn các team không build được nó?
7. Vì sao các team bị kẹt: mỗi agent một silo
Muhammad mô tả điểm xuất phát của đa số đội ngũ kỹ thuật. Giả sử có ba team. Team A build một agent và dựng các vector database riêng biệt để tìm kiếm tài liệu, và cách đó chạy tốt. Team B build một agent khác và tự viết các script lưu trữ bền vững (persistent scripts) của riêng mình trên một kho dữ liệu tách biệt, cũng chạy tốt. Rồi team C thì đang ghép nối vài tool với nhau.
Vấn đề là không ai trong số họ nói chuyện với nhau, vì tất cả đều nằm trong silo của riêng mình. Sáu tháng sau, bạn sẽ có cả chục data pipeline rời rạc, không ai có thể đảm bảo độ tươi của dữ liệu, và mỗi agent mới lại tốn phần lớn thời gian để build lại phần hạ tầng nối dữ liệu cho context (context plumbing). Theo anh, đó là tình trạng của phần lớn các tổ chức kỹ thuật hiện nay.
8. Hai tầng memory: working memory và long-term memory
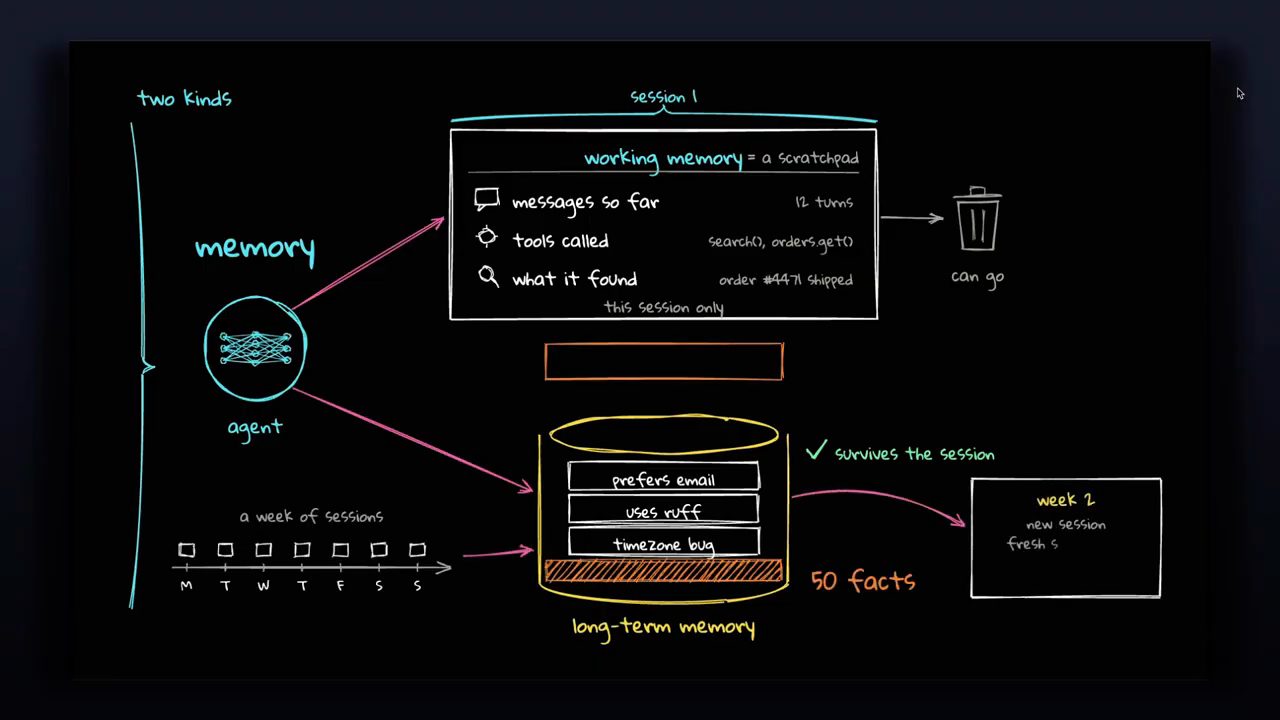
Tiếp theo là câu hỏi: làm thế nào để agent tích luỹ context qua nhiều session? Muhammad nói agent cần hai loại memory.
Tầng một là working memory, về cơ bản là tờ nháp (scratchpad) cho task đang chạy. Agent cần truy cập ngay các tool call vừa thực hiện và trạng thái thực thi. Khi session kết thúc, phần này sẽ bị xoá.
Tầng hai là long-term memory. Tầng này lưu những fact bền vững, phải sống sót qua nhiều session hay nhiều lần chạy, chẳng hạn các quyết định của project, cấu hình môi trường, hay các edge case khi debug. Một agent tốt cần cả hai tầng.
9. Fact đi từ tầng này sang tầng kia thế nào
Mẹo nằm ở cách các fact chuyển từ tầng này sang tầng kia. Bạn không thể trông chờ người dùng tự tay gắn nhãn (tag) cho các fact. Vì vậy bạn cần một memory layer tự động, đọc cuộc hội thoại và trích xuất (extract) các fact bền vững ở chế độ nền. Việc này phải diễn ra tự động.
Khi một session mới khởi động, nó chạy một semantic search để chỉ kéo về đúng những fact lịch sử liên quan tới prompt đang làm. Nhưng bạn cũng phải cẩn thận để memory không biến thành một ngăn kéo đồ linh tinh phình to (bloated junk drawer). Engine lo phần khử trùng lặp (deduplication) và hết hạn (expiry): bỏ đi nhiễu tạm thời, giữ chặt các quy tắc vĩnh viễn của project. Nhờ đó context vừa navigable, vừa fresh, vừa fast, và compound theo thời gian.
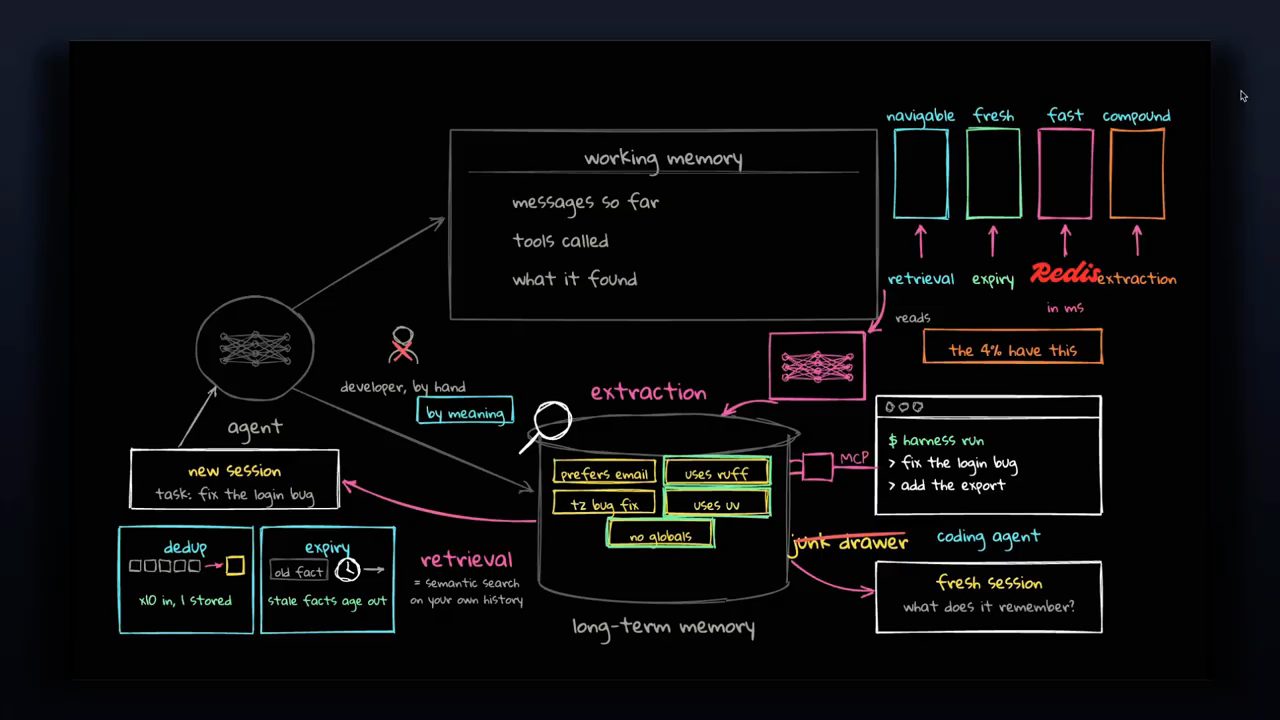
Đáng tiếc là phần lớn các hệ thống agentic hiện nay không thật sự có những thứ này. Vì vậy anh sẽ cho xem một giải pháp đơn giản dựa trên Redis, giúp agent có context nhanh, tươi và tích luỹ được.
10. Bối cảnh demo: harness DeepSeek, MCP và Redis 8
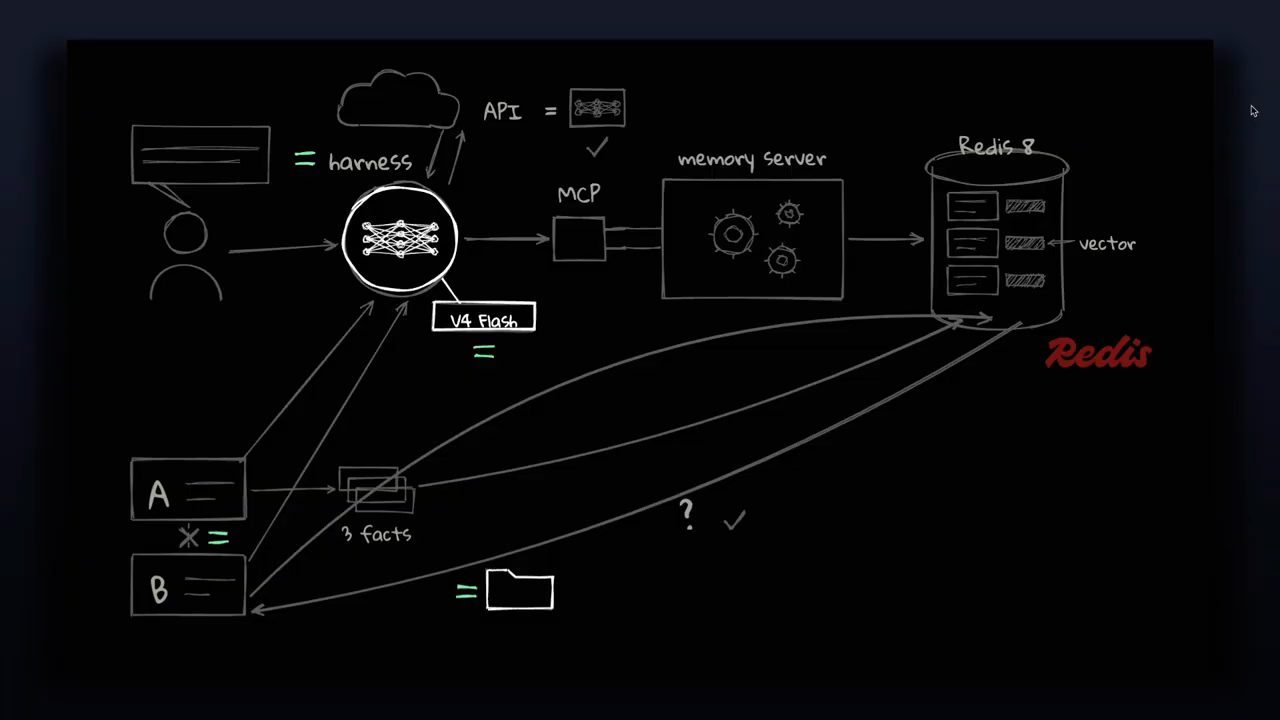
Để đặt mọi thứ đã bàn vào thực tế, Muhammad chuyển sang một ví dụ cụ thể. Anh làm việc trong harness của DeepSeek, với model mà anh gọi là "4.1 Flash", truy cập qua API (bảng vẽ ghi "V4.1 Flash", còn trong file config ghi deepseek-v4-flash). Mặc định, harness của DeepSeek không có memory xuyên session (cross-session memory). Đó chính là thứ anh sẽ build.
Anh dùng một MCP server, nối nó tới Redis Agent Memory Server. Bên dưới, Redis 8 lưu mỗi memory dưới dạng một hash kèm một vector, nhờ vậy có thể tìm các memory theo nghĩa thay vì tìm kiếm từ khoá đơn thuần.
Thí nghiệm như sau. Ở session một (session A), anh nói cho agent vài quy ước của project. Session hai (session B) là một session hoàn toàn mới, không mang theo gì từ session trước, và anh giao cho nó một task. Nếu memory chạy đúng như mong muốn, agent trong session B phải tìm tới Redis trước và áp dụng các quy ước đó mà anh không phải nhắc lại.
11. Tích hợp: một file YAML và 10 tool
Muhammad nói trước hết về phần tích hợp. Chỉ cần một file YAML, khai báo cho harness biết có một MCP server tên là redis_memory. Trong file, mục insert thêm một entry id: memory-redis với name: '@deepseek-ai/dsh-mcp-client', và trong config là serverName: redis_memory, transport: streamable-http, một dòng url đọc từ biến môi trường REDIS_MEMORY_MCP_..., cùng headers: {}, toolCallTimeoutMs: 120000 và failOnStartupError: false.
Anh lưu ý phần cuối của URL: đó là namespace. URL trên màn hình có dạng http://127.0.0.1:9100/dsh-demo/mcp, và phần dsh-demo chính là namespace, nên mọi thứ agent này lưu vào đều được giới hạn trong phạm vi project cụ thể này.
Mục thứ hai ghim model: id: agent-default-model với provider: deepseek-official và model: deepseek-v4-flash. Khi model khởi động, nó hỏi MCP server xem có những tool nào. Kết quả là một danh sách 10 tool để tạo memory, tìm memory, sửa, xoá, và nhiều việc khác.
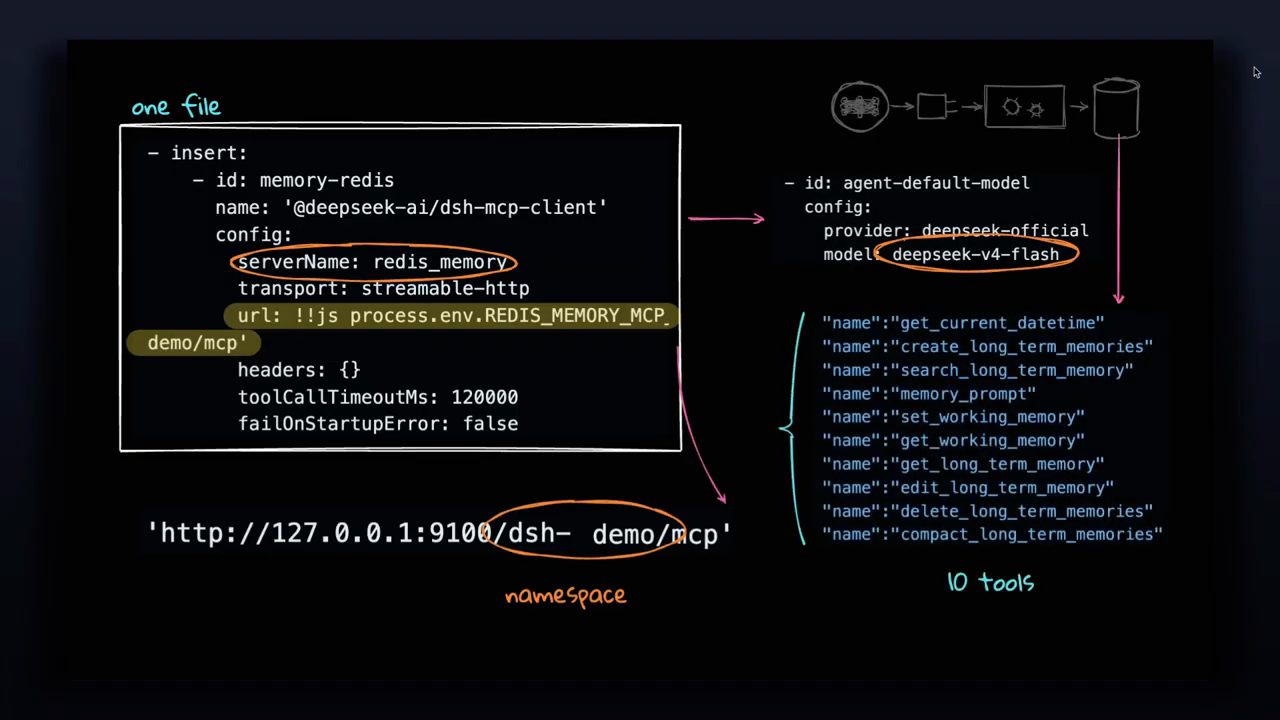
redis_memory, transport streamable-http, URL kết thúc bằng namespace; bên phải là model được ghim và 10 tool mà server trả về: get_current_datetime, create_long_term_memories, search_long_term_memory, memory_prompt, set_working_memory, get_working_memory, get_long_term_memory, edit_long_term_memory, delete_long_term_memories, compact_long_term_memories.12. Session A: dạy agent ba quy ước của project
Ở session A, Muhammad nói với agent rằng project sẽ dùng uv để quản lý dependency, ruff để lint, và mọi function phải giữ ở dạng pure, chỉ trả về tuple mới. Câu anh gõ trên màn hình:
Project decision for tinytasks: we use uv for dependency management (uv run pytest, uv run ruff), ruff for linting, and every function stays pure and returns new tuples.
Vì MCP đã được nối, agent đầu tiên kiểm tra memory của nó (tool call mcp__redis_memory__search_long_term_memory) và không tìm thấy gì, vì đây là một khởi đầu trắng tinh. Sau đó nó gọi create_long_term_memories và lưu ba fact riêng biệt đúng như mô tả trong prompt. Trong danh sách bước, ta thấy rõ từng việc nó đã làm: nạp context, suy nghĩ rằng người dùng vừa nêu một quyết định của project, tìm memory, thấy trống, rồi lưu quyết định thành semantic memory.
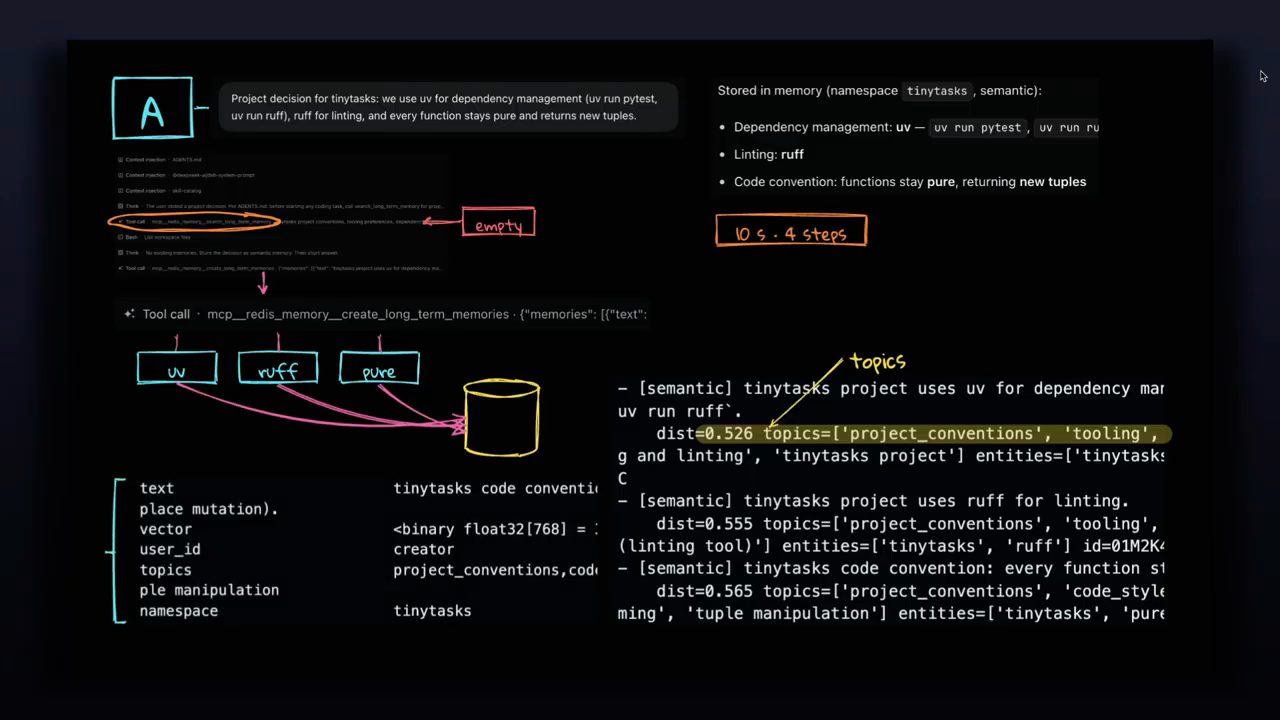
tinytasks ba mục: quản lý dependency bằng uv, lint bằng ruff, function giữ pure và trả về tuple mới. Góc dưới trái là raw hash trong Redis (text, vector float32[768], user_id, topics, namespace), góc dưới phải là kết quả truy vấn memory server với khoảng cách và topics của từng memory.Tiếp theo, anh xem thẳng nội dung trong Redis. Nếu truy vấn memory server, bạn sẽ nhận lại đúng ba memory đó. Bạn cũng có thể xem raw hash trong Redis: gồm phần text, namespace, user và topic. Và vì đây là semantic retrieval, hash còn chứa embedding.
13. Session B: session mới, không có lịch sử chat
Session B là một session mới, trong cùng repo đó, với lịch sử chat bằng không. Lần này anh yêu cầu agent thêm một function remove_task kèm test, rồi chạy test và linter:
Add a remove_task(tasks, task_id) function to tinytasks with a test, then run the tests and the linter.
Hãy xem nó làm gì. Trước khi đọc bất kỳ file nào, nó gọi search long-term memory (agent nói "I'll start by checking my memory for project conventions, then look at the repo."). Kết quả trả về: đã tìm thấy quy ước, các function pure trả về tuple mới, và ném KeyError khi gặp id không tồn tại. Sau đó nó mới đọc code (pyproject.toml, src/tinytasks/tasks.py, tests/test_tasks.py, src/tinytasks/__init__.py) và viết function.
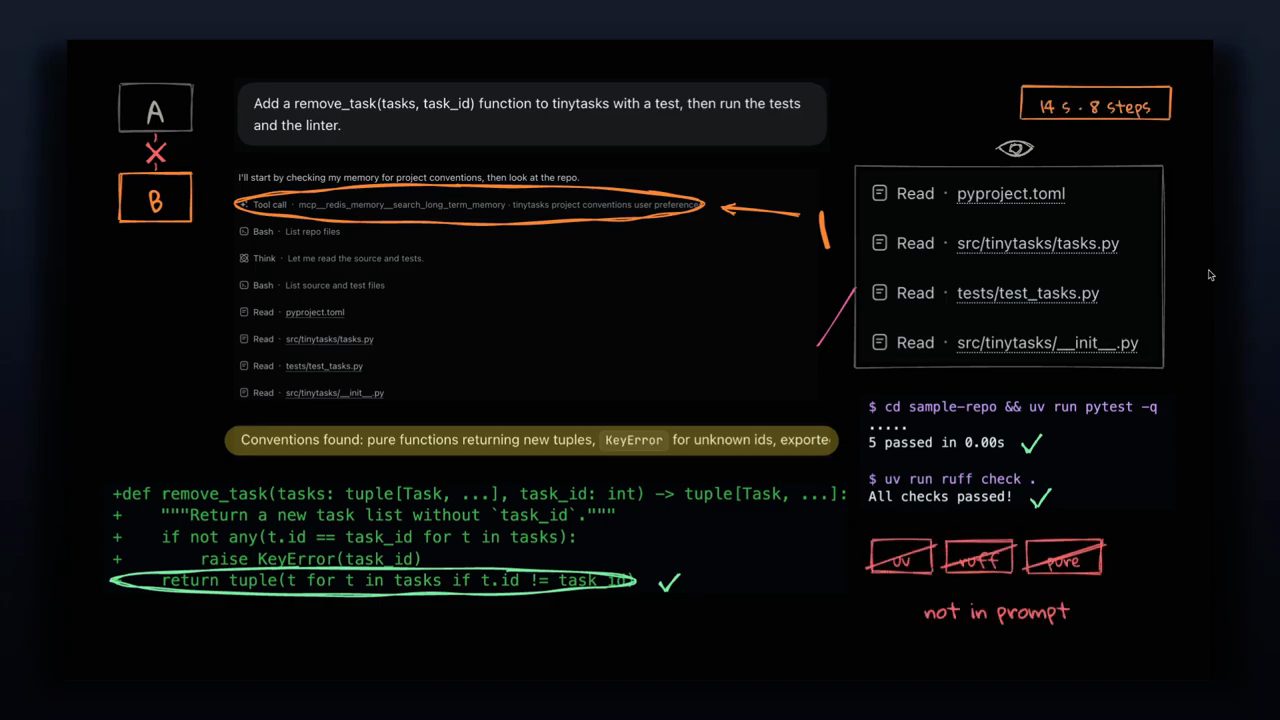
Nhìn vào diff, function là pure và trả về một tuple mới, khớp đúng phong cách đã mô tả ở session A:
+def remove_task(tasks: tuple[Task, ...], task_id: int) -> tuple[Task, ...]:
+    """Return a new task list without `task_id`."""
+    if not any(t.id == task_id for t in tasks):
+        raise KeyError(task_id)
     return tuple(t for t in tasks if t.id != task_id)
Để kiểm chứng, agent chạy test bằng uv và lint bằng ruff, đúng hai công cụ đã được ghi nhớ:
$ cd sample-repo && uv run pytest -q
5 passed in 0.00s

$ uv run ruff check .
All checks passed!
Năm test đều pass. Như vậy, nhờ Redis, anh đã thêm được long-term memory trực tiếp cho một coding agent vốn không có long-term memory.
14. Hai thí nghiệm thêm: tìm theo nghĩa và memory tự lớn
Muhammad còn chạy thêm hai thí nghiệm.
Thí nghiệm thứ nhất nhằm xem memory server có thật sự dùng semantic search hay chỉ tìm theo từ khoá. Anh hỏi memory server: "which linter and package manager does this repo use". Không từ nào trong hai từ khoá "linter" và "package manager" xuất hiện trong các memory đã lưu. Nhưng kết quả vẫn kéo đúng memory về ruff và uv, với khoảng cách thấp nhất (trên màn hình là dist=0.417 cho ruff và dist=0.436 cho uv). Điều đó cho thấy hệ thống đang tìm theo nghĩa, không phải so khớp từ khoá đơn thuần.
Thí nghiệm thứ hai là xem memory có tự lớn lên không. Lần này anh đẩy một đoạn hội thoại bình thường vào working memory, chỉ là người dùng nói họ thích dùng type hints, kèm một sở thích khác. Anh không hề yêu cầu agent gọi tool lưu memory, nhưng log của server ghi rằng bước extraction đã hoàn tất và memory đã được trích ra (trên màn hình: chạy inline extraction cho session demo-chat-1 với debounce 30 giây, rồi "Inline extraction completed", sau khoảng 34 giây).
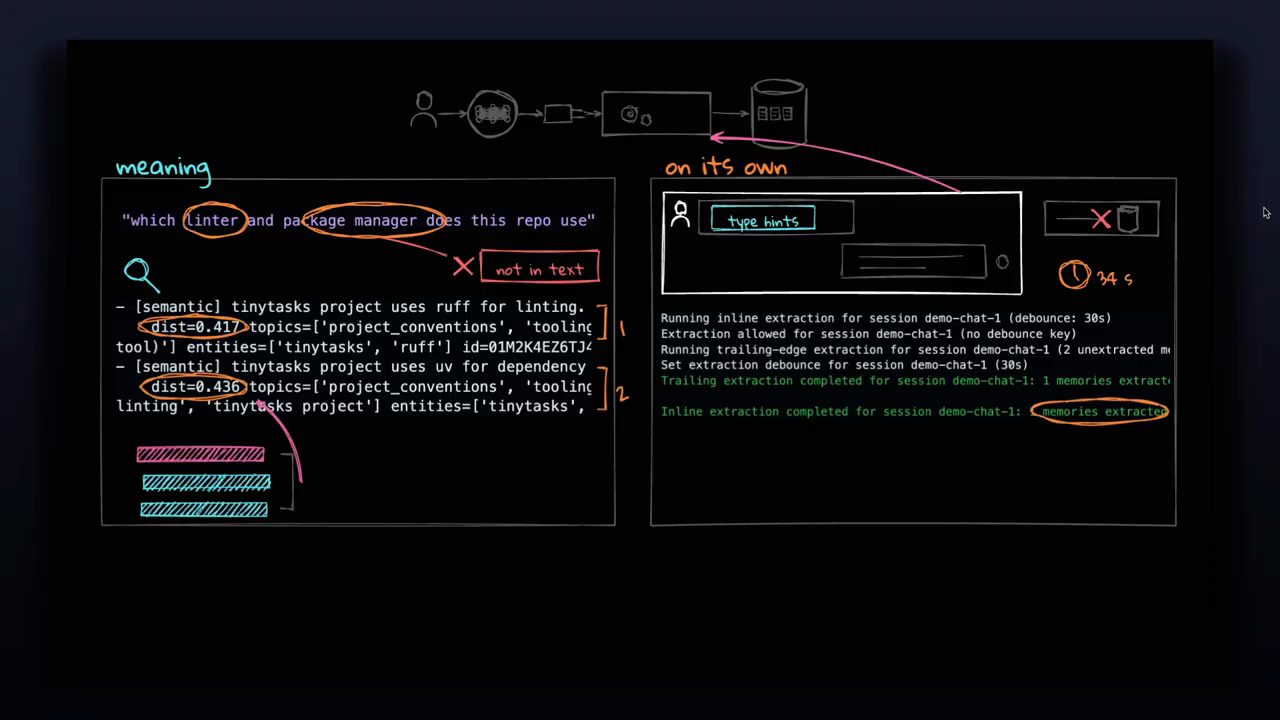
Sau đó bạn thấy được chính xác những gì người dùng muốn đã nằm trong long-term memory. Muhammad đánh giá đây là điểm rất hay: agent giờ có thể tự trích thông tin hữu ích từ cuộc trò chuyện với người dùng và đưa vào long-term memory dựa trên Redis. Cái đẹp của cách làm này là những gì hệ thống học được sẽ tích luỹ dần khi bạn dùng nó.
15. Kết: context quan trọng hơn kích thước model
Để khép lại, Muhammad nhắc lại điều đã bàn xuyên suốt video: context bạn đưa cho agent quan trọng hơn kích thước của model. Muốn vậy, bạn cần một memory layer tốt mà agent có thể dùng, và Redis là một ví dụ tốt. Bạn truy cập nó qua MCP server. Điểm hay là bạn có thể nối nó vào bất kỳ coding agent nào, và nó sẽ cho bạn context tốt hơn mà không phải hy sinh độ chính xác hay hiệu năng.
Cuối video, anh mời người xem cho biết video có hữu ích không, cảm ơn mọi người đã theo dõi và hẹn gặp ở video sau.
Nguồn và liên kết 7 nguồn
- Tên gốc: Your Agent Doesn't Need a Bigger Model
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=tM8Lb7Yk0KE youtube.com
- Kênh YouTube Prompt Engineering (Muhammad Farooq): youtube.com/channel/UCDq7SjbgRKty5TgGafW8Clg youtube.com
- Báo cáo The state of context engineering 2026 của Redis, nơi video trích định nghĩa context engineering và bốn yêu cầu navigable, fast, fresh, compounding: redis.io/resources/state-of-context-engineering-2026 redis.io
- Redis Agent Memory Server, mã nguồn (hai tầng session memory và long-term memory, trích xuất fact ở chế độ nền, có MCP server): github.com/redis/agent-memory-server github.com
- Tài liệu Redis Agent Memory Server: redis.github.io/agent-memory-server redis.github.io
Related talks
Pi agent tự compact context: devlog agentic coding
IndyDevDan · IndyDevDan · 30 min
Viết draft plan rồi để ba harness build một Pi agent có tool self_compact, ba ngưỡng notice, warning, force và compaction prompt tự viết.
Context engineering: hướng dẫn đầy đủ cho developer
Shrinivasan Sankar · AI Bites · 17 min
Context engineering là gì, bốn phép write, select, compress, isolate, ví dụ coding agent, bốn failure mode của context và một workflow để áp dụng.
10 level dùng Jev cho agentic engineer
IndyDevDan · IndyDevDan · 35 min
10 level dùng Jev của TypeSafe, từ câu lệnh if thông minh tới guardrail hook, compact và agent tự hỏi Jev về file mà không đọc chúng.