Context engineering: hướng dẫn đầy đủ cho developer
Context engineering là gì, bốn phép write, select, compress, isolate, ví dụ coding agent, bốn failure mode của context và một workflow để áp dụng.
✓ Đã duyệt độc lập · cập nhật 17/10/2026 · 17 min
1. Từ prompt engineering tới một câu hỏi lớn hơn
Shrinivasan mở đầu từ thứ mà ai làm việc với LLM cũng đã nghe: prompt engineering. Ý tưởng của prompt engineering là prompt tốt hơn thì model làm tốt hơn: đưa cho model những chỉ dẫn (instructions) rõ hơn, thêm ví dụ, cải thiện system prompt.
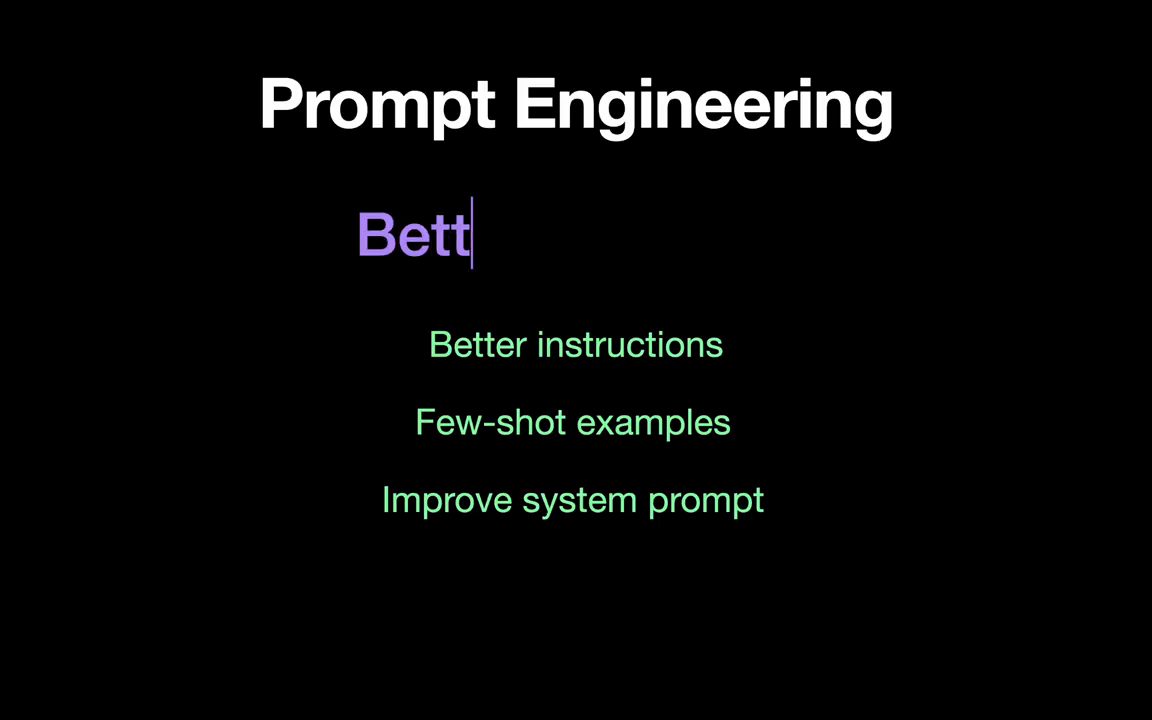
Nhưng khi hệ thống AI ngày càng mạnh, nhất là với những agent biết dùng tool, biết truy xuất thông tin, biết viết code và làm một task trong thời gian dài, thì xuất hiện một vấn đề lớn hơn. Câu hỏi không còn là "mình nên nói gì với model". Câu hỏi bây giờ là: model nên được truy cập vào cái gì, nó nên nhìn thấy thông tin nào, nó nên lấy lại những memory nào, nên lấy thông tin từ đâu, nên dùng tool nào, cái gì nên bị gỡ ra, và cái gì nên được cất đi để dùng sau.
Đó chính là chỗ context engineering bước vào. Anh liệt kê lộ trình của video: context engineering là gì, vì sao nó quan trọng, bốn phép cơ bản (four fundamental operations) để quản lý context, nó chạy thế nào bên trong một AI agent, những kiểu hỏng context thường gặp, và cuối cùng là cách nghĩ về context engineering khi build những hệ thống AI ngoài đời thật.
2. Context engineering là gì
Anh bắt đầu bằng một định nghĩa đơn giản. Context engineering là việc thiết kế và quản lý một cách động (dynamically managing) thông tin, chỉ dẫn, tool, state và kiến thức được đưa cho LLM, sao cho model có đúng context để làm bước tiếp theo của task.
Anh tự nhận định nghĩa đó hơi nhiều chữ, nên rút gọn lại thành một phép so sánh. Prompt engineering hỏi: "làm sao để đưa cho model những chỉ dẫn tốt hơn?". Context engineering hỏi: "model nên có sẵn trong tay những thông tin gì để đưa ra quyết định đúng?".
Và context lớn hơn một prompt rất nhiều. Nó có thể gồm system instructions, yêu cầu của user, các tài liệu được truy xuất (retrieved documents), memory, định nghĩa tool, output của tool, những hành động trước đó, trạng thái của task (task state) và kế hoạch (plan).
Vì thế anh đề nghị nghĩ về context như môi trường thông tin (information environment) bao quanh một model cụ thể tại một thời điểm cụ thể.
3. Ứng dụng LLM truyền thống và một agent
Sự phân biệt này trở nên đặc biệt quan trọng với AI agent. Một ứng dụng LLM truyền thống trông khá đơn giản: có yêu cầu của user, có prompt, có model, và có câu trả lời.
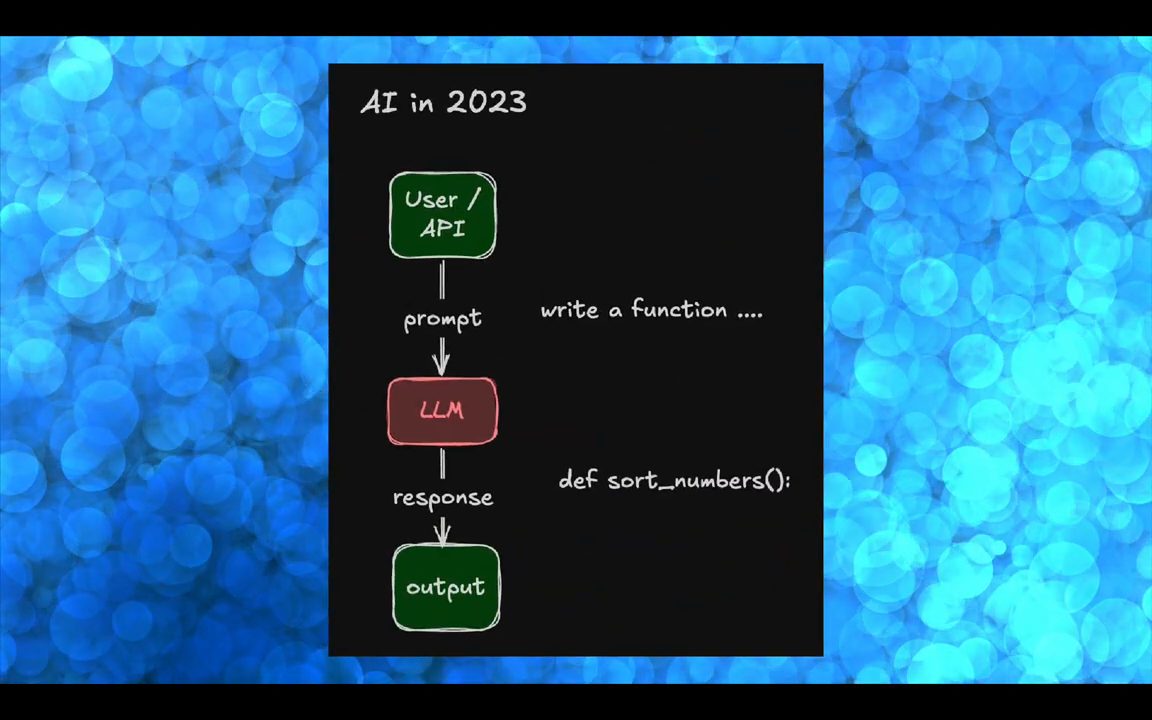
def sort_numbers():. Một đường thẳng, một lượt.Một agent thì phức tạp hơn nhiều. Có yêu cầu của user, có model, có tool, có memory, có kết quả, và vòng lặp này cứ tiếp diễn hết lượt này tới lượt khác.
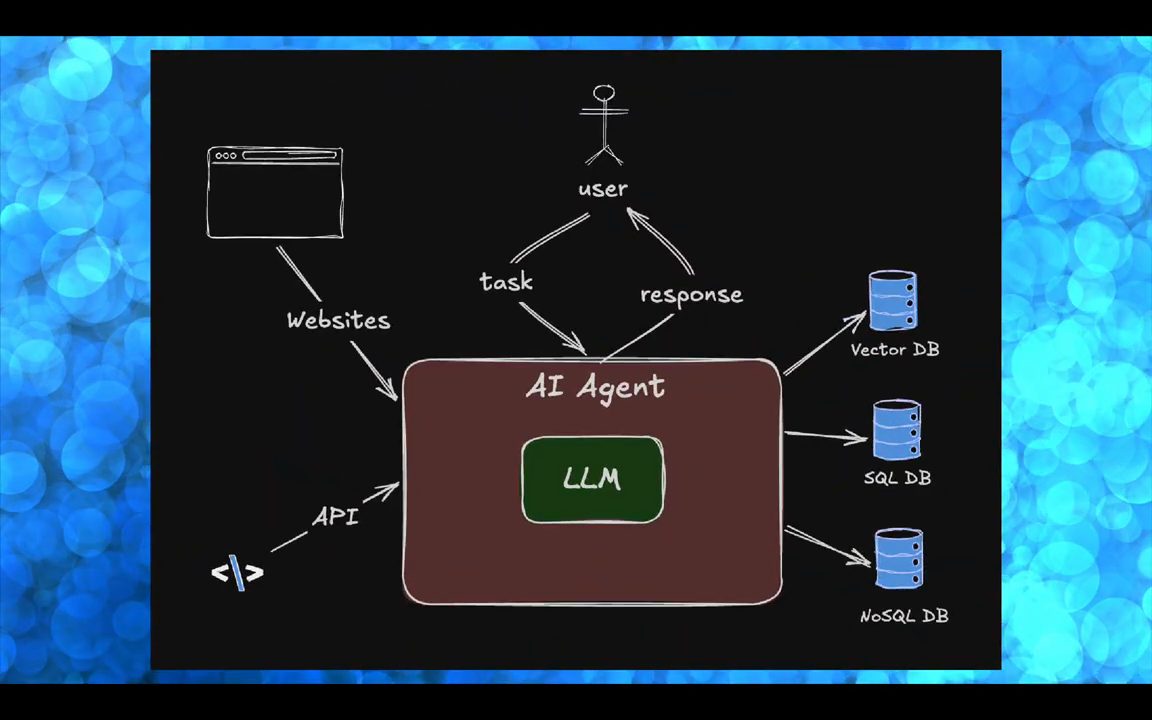
Theo Shrinivasan, mỗi bước trong vòng lặp đó đều thay đổi điều model biết. Vì vậy, mỗi bước đều có thể làm thay đổi context.
4. Nhiều context hơn có thể làm agent tệ hơn
Vậy vì sao context engineering lại quan trọng đến thế? Anh gọi đây là phần thú vị. Bạn có thể nghĩ: nếu thêm context nghĩa là model có thêm thông tin, vậy thì cứ đưa cho nó mọi thông tin, như thế chắc phải tốt hơn. Nhưng thực tế không phải vậy. Nhiều context hơn thật ra có thể làm một agent tệ đi.
Anh đưa ví dụ: bạn nhờ một coding agent sửa một bug trong hệ thống authentication. Bạn có thể đưa cho nó toàn bộ repository, toàn bộ tài liệu, quyền truy cập vào toàn bộ dữ liệu trên internet, mọi tool có thể có, và mọi quyết định mà agent từng đưa ra trong suốt quá trình giải bài toán. Về mặt kỹ thuật, model lúc đó có một lượng thông tin khổng lồ, nhưng phần lớn không liên quan gì tới task.
Agent khi đó phải tự xoay xở để biết cái gì quan trọng và cái gì không. Đây là một trong những vấn đề nền tảng mà context engineering cố gắng giải quyết. Mục tiêu không phải là context tối đa (maximum context), mà là tối đa hoá phần context hữu ích (useful context).
5. Lost in the Middle: context window lớn không giải quyết hết
Còn một vấn đề khác. Context window có thể rất lớn, nhưng điều đó không có nghĩa model dùng mọi phần của context hiệu quả như nhau. Shrinivasan nhắc tới nghiên cứu Lost in the Middle: nó cho thấy model có thể gặp khó khi dùng thông tin liên quan nếu thông tin đó bị chôn ở giữa một context dài.
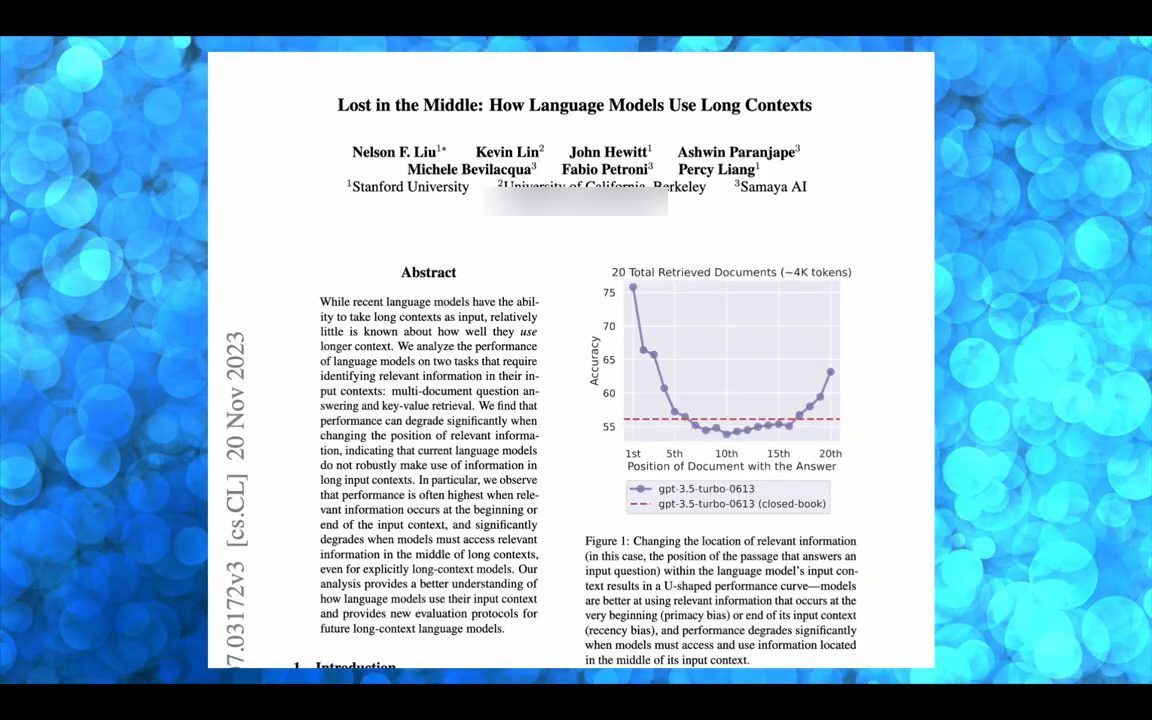
Vì vậy, chỉ riêng việc có một context window lớn hơn không xoá bỏ nhu cầu quản lý context cho tốt. Thậm chí, khi context window càng lớn và agent làm những task càng dài, context engineering lại càng trở nên quan trọng hơn.
6. Những gì có thể nằm trong context của agent
Vậy chính xác thì mình có thể đưa gì vào context của một agent? Câu trả lời của anh: khá nhiều thứ. Anh đi qua từng loại:
- Instructions: system prompt, các rule, và chỉ dẫn riêng cho task.
- User input: yêu cầu hiện tại, mục tiêu của user, sở thích (preferences) và các yêu cầu (requirements).
- Conversation history: những gì đã được bàn với user cho tới lúc này.
- Knowledge: có thể đến từ tài liệu, từ các hệ thống RAG, từ database, từ API, từ MCP, và nhiều nguồn khác nữa.
- Memory: những điều agent chủ động ghi nhớ để dùng cho các chỉ dẫn về sau.
- Tools: model cần biết có những tool nào và dùng chúng ra sao.
- Tool outputs: kết quả tìm kiếm, phản hồi từ database, phản hồi từ API, kết quả test, và nhiều thứ khác.
- Task state: cái gì đã xong, cái gì còn phải làm, và task đang ở trạng thái nào.
Ngoài ra, bạn còn có thể đưa vào ví dụ, kế hoạch (plans), các artifact được tạo ra, code, spreadsheet, hình ảnh, vân vân. Vậy nên context không chỉ là chữ trong một prompt. Về bản chất, nó là toàn bộ thông tin làm việc (working information) mà model có trong tay tại một thời điểm cụ thể.
7. Phép thứ nhất: Write
Tiếp theo, anh đi vào thứ mà anh cho là một trong những cách nghĩ hữu ích nhất về context engineering: bốn phép cơ bản, gồm write, select, compress và isolate.
Phép thứ nhất là write. Write context nghĩa là tạo ra thông tin mà agent có thể dùng về sau, thay vì giữ mọi thứ ngay trong context window hiện tại. Thông tin đó có thể là ghi chú (notes), task state, bản tóm tắt kế hoạch, sở thích của user, các kết quả trung gian, và những phát hiện quan trọng mà agent đã tìm ra.
Ví dụ: hình dung một coding agent đang làm việc trên một ứng dụng lớn. Trong lúc điều tra, nó phát hiện ra module authentication dùng JWT token, và mọi API route đều được bảo vệ bởi một authentication middleware. Thay vì mỗi lần lại phải khám phá lại thông tin đó, agent có thể ghi nó vào memory hoặc vào task state.
Ý tưởng cơ bản là: đừng ép context hiện tại phải chứa mọi thứ. Hãy cất thông tin hữu ích ở đâu đó, để có thể lấy nó về khi cần. Trên màn hình, ý này được viết thành: lưu thông tin hữu ích ra ngoài thay vì giữ nó trong context (Store useful information than to keep in context).
8. Phép thứ hai: Select, và RAG không phải là context engineering
Phép tiếp theo là select: quyết định thông tin nào thực sự liên quan tới task hiện tại. Đây là chỗ những thứ như RAG, semantic search, truy xuất memory, truy vấn database và chọn tool phát huy tác dụng.
Ví dụ: user nhờ coding agent "fix the login bug" (sửa lỗi login). Agent không nhất thiết cần cả codebase. Nó có thể chọn ra các file authentication, các error log liên quan, tài liệu về authentication, những thay đổi gần đây, và những tool cần để sửa và test code.
Câu hỏi quan trọng là: với điều agent đang cố đạt được ngay lúc này, nó thật sự cần thông tin gì?
Shrinivasan nói rõ một điểm: RAG không phải là context engineering. RAG là một trong những cơ chế có thể dùng để chọn thông tin đưa vào context. Còn context engineering là bài toán lớn hơn: quyết định model nên có thông tin gì.
9. Phép thứ ba: Compress
Phép thứ ba là compress: thu nhỏ context mà không đánh mất ý nghĩa. Trong lúc agent làm việc, context của nó có thể phình ra cực lớn. Hình dung một agent đã thực hiện 50 tool call và trao đổi hàng chục tin nhắn. Khi đó mình có thể nén context lại.
Một cách hiển nhiên là tóm tắt (summarization). Thay vì giữ 50 tin nhắn, mình có thể tạo một bản tóm tắt. Ví dụ, một cuộc hội thoại dài trước đó có thể được tóm lại thành:
The user wants a Python implementation, rejected approach A, but decided to use PostgreSQL.
Thông tin quan trọng được giữ lại, những gì không cần thì bị bỏ đi.
Compression còn có thể mang nghĩa: tóm tắt tài liệu, trích xuất thông tin có cấu trúc, cắt tỉa (pruning) các tin nhắn cũ, thu gọn những phần lớn đến từ tool, hoặc tạo ra những bản trạng thái gọn nhẹ.
Ví dụ, một tool có thể trả về 50.000 token thông tin trong khi agent có lẽ chỉ cần năm trường (fields) trong phản hồi đó. Thay vì mang theo toàn bộ 50.000 token, mình có thể trích ra phần thông tin hữu ích và đi tiếp với một context nhỏ hơn nhiều. Tóm lại, compression về bản chất là thu nhỏ context mà không đánh mất những thông tin cần cho task.
10. Phép thứ tư: Isolate
Phép cuối cùng là isolate: giữ cho context tách biệt và tập trung. Isolation nghĩa là cho mỗi task, mỗi agent, hay mỗi lần gọi model một context riêng, tập trung, thay vì phơi chúng ra trước mọi thứ đang có sẵn trong context.
Điều này đặc biệt hữu ích trong các hệ thống multi-agent. Hình dung bạn có ba agent: một research agent, một coding agent và một writing agent.
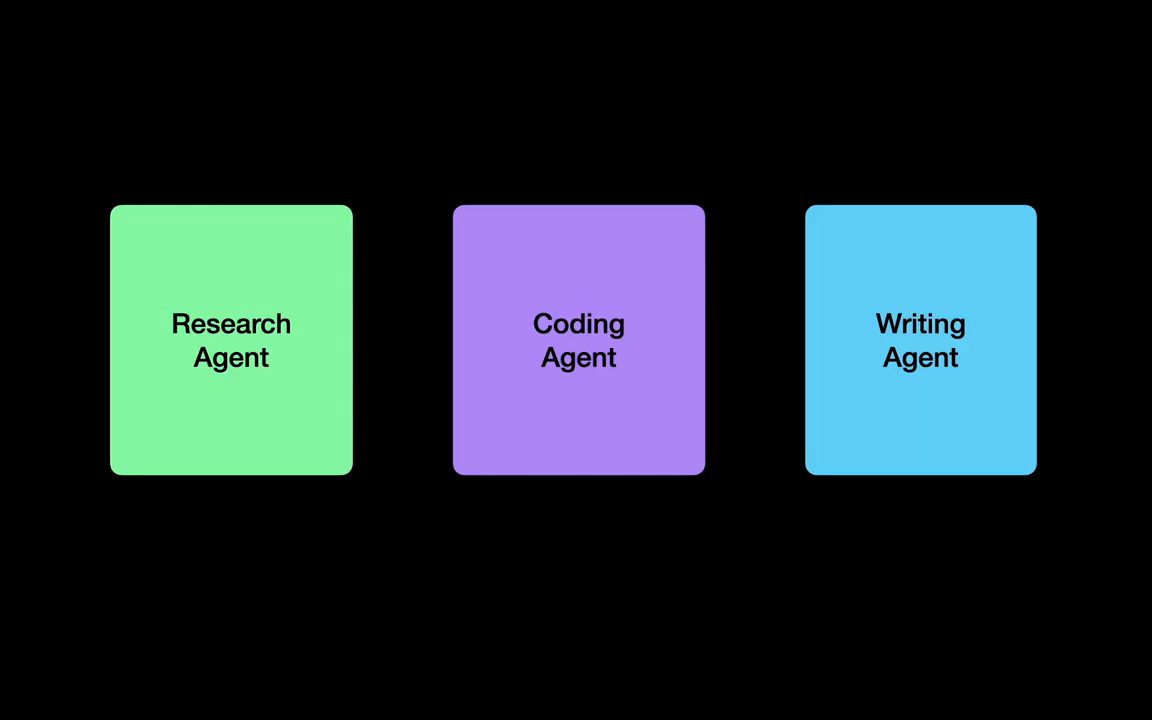
Coding agent không cần biết toàn bộ cuộc trao đổi research. Nó chỉ cần những phát hiện kỹ thuật, các file liên quan, và các yêu cầu cho phần implementation. Tương tự, writing agent có thể chỉ cần kết quả research cuối cùng và cấu trúc nội dung.
Bằng cách cô lập context, mình giảm được sự xao nhãng (distraction) và làm cho việc của từng agent rõ ràng hơn.
11. Ví dụ coding agent: sửa lỗi login
Đã xem xong bốn phép, Shrinivasan ghép cả bốn vào một ví dụ coding agent để thấy rõ hơn. Giả sử mình đang build một coding agent, và user nói: "fix the login bug in our application" (sửa lỗi login trong ứng dụng của chúng tôi).
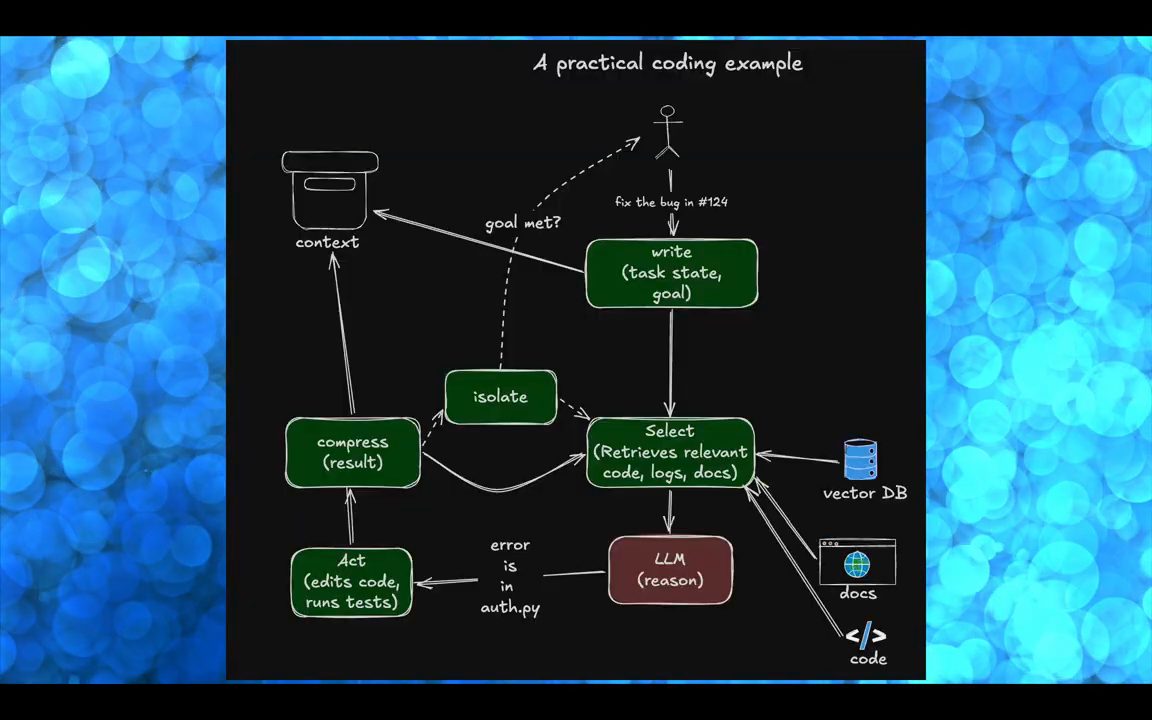
Trước hết, agent nhận yêu cầu của user. Lúc này nó biết mục tiêu ở mức cao. Sau đó, agent có thể write một task state ban đầu, kiểu như: điều tra lỗi authentication (investigate authentication failure) và sửa vấn đề gốc.
Tiếp theo, nó cần select context liên quan. Nó có thể truy xuất các file liên quan tới authentication, error log, tài liệu, thông tin database liên quan, và những tool cần để sửa và test code.
Model lập luận (reason) trên những thông tin đó. Nó có thể phát hiện lỗi dường như bắt nguồn từ authentication middleware. Vậy là nó mở file middleware tương ứng, sửa đoạn code đó, rồi chạy test.
Đến đây có một chuyện thú vị. Output của test có thể dài tới hàng trăm, hàng nghìn dòng. Những dòng đó không có ích cho các bước sau, nên hệ thống compress output. Thay vì giữ tất cả, nó có thể chỉ giữ lại 23 kết quả test case: test authentication fail, và chỗ kiểm tra token hết hạn (token expiration check) đang sai.
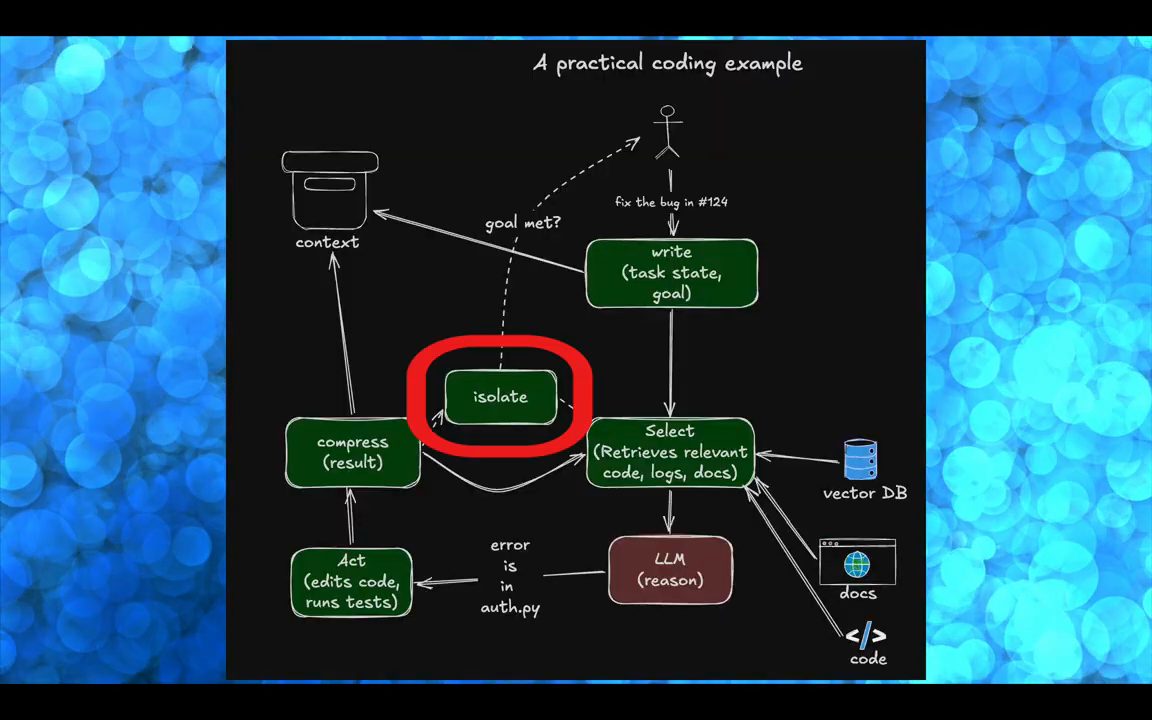
Giờ agent có một context sạch hơn nhiều. Nó điều tra tiếp. Có thể nó lấy thêm một file liên quan khác. Có thể nó chạy thêm một lượt test. Có thể nó phát hiện ra một quyết định trước đây về cách authentication được thiết kế để hoạt động. Một lần nữa, nó select những thông tin nó cần.
Và nếu mình dùng nhiều agent, có thể có một code review agent riêng chỉ nhận phần file đã thay đổi, các yêu cầu của task và kết quả test. Đó chính là isolation.
12. Context không được lắp một lần rồi bỏ đó
Quá trình này cứ lặp đi lặp lại. Agent không lắp context một lần rồi quên nó đi. Thay vào đó, context liên tục thay đổi.
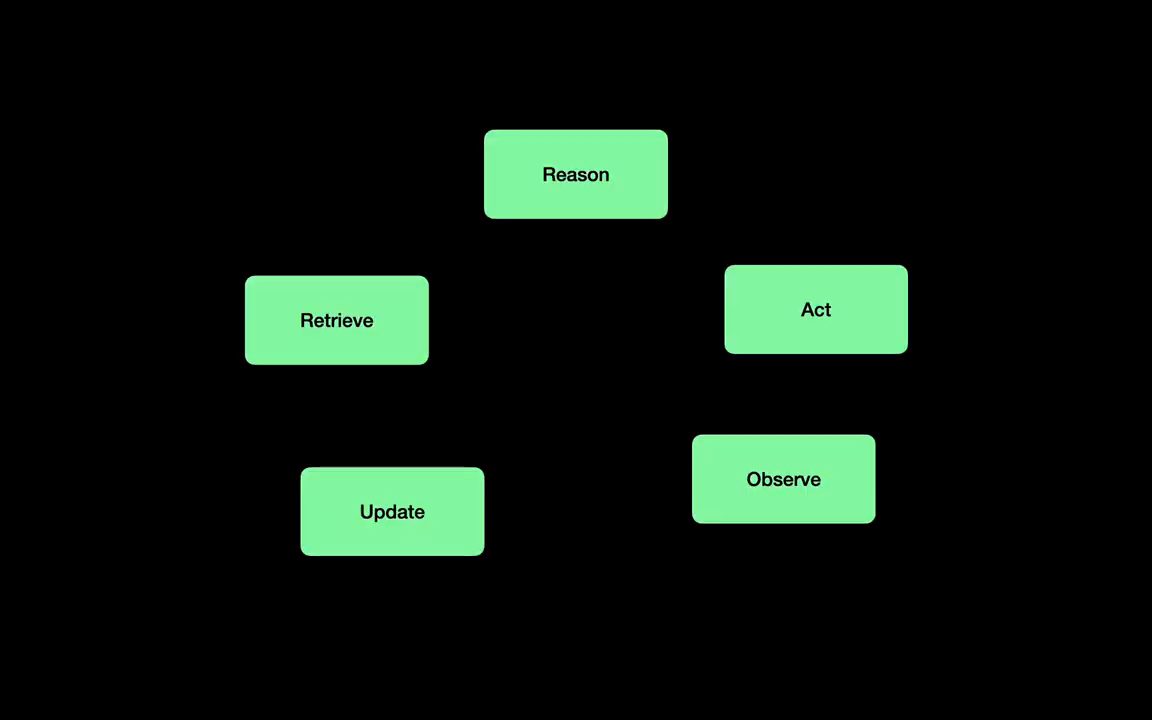
Agent lập luận (reason), hành động (act), quan sát (observe), cập nhật (update), truy xuất (retrieve), rồi lại hành động. Theo Shrinivasan, đó là một trong những ý tưởng then chốt đằng sau context engineering: context là thứ sống, đổi theo từng bước của agent.
13. Failure mode: context poisoning và context distraction
Đã thấy ý tưởng chính của context engineering, giờ anh chuyển sang câu hỏi: chuyện gì có thể hỏng? Chuyện gì xảy ra khi context tệ? Anh đưa ra bốn failure mode hữu ích nên hiểu.
Thứ nhất là context poisoning. Context poisoning xảy ra khi thông tin sai hoặc độc hại lọt vào context và ảnh hưởng tới hành vi về sau của agent. Ví dụ, giả sử một agent truy xuất một tài liệu từ web, và tài liệu đó chứa thông tin sai. Agent coi những chỉ dẫn trong đó là đáng tin, và bắt đầu ra quyết định dựa trên tài liệu ấy.
Vấn đề không nhất thiết nằm ở bản thân model. Vấn đề là thông tin xấu mà model nhận được qua một tool, trong trường hợp này là trình duyệt. Điều này đặc biệt quan trọng với các hệ thống RAG và các agent dùng tool.
Tiếp theo là context distraction. Context distraction xảy ra khi đơn giản là có quá nhiều thông tin. Hãy hình dung bạn đưa cho coding agent cả codebase trong khi nó chỉ cần ba file. Thông tin đó không nhất thiết sai, nó chỉ không cần thiết. Tín hiệu liên quan trở nên khó nhận ra hơn. Quá nhiều context có thể biến thành nhiễu (noise).
14. Failure mode: context confusion và context clash
Failure mode thứ ba là context confusion. Context confusion xảy ra khi thông tin mà model có làm cho task hoặc chỉ dẫn trở nên không rõ ràng. Ví dụ, context có thể chứa nhiều task na ná nhau, hoặc những chỉ dẫn mâu thuẫn về việc agent đáng ra phải làm gì. Model lúc đó khó xác định: rốt cuộc mình phải làm gì? Mình phải tập trung vào cái gì?
Failure mode cuối cùng là context clash. Context clash xảy ra khi các mẩu context khác nhau trực tiếp mâu thuẫn với nhau. Ví dụ, một memory cũ nói "dùng PostgreSQL", nhưng một tài liệu mới hơn lại nói "dùng MySQL, chúng tôi đã chuyển sang nó rồi". Cả hai mẩu thông tin đều nằm trong context. Vậy agent nên tin cái nào?
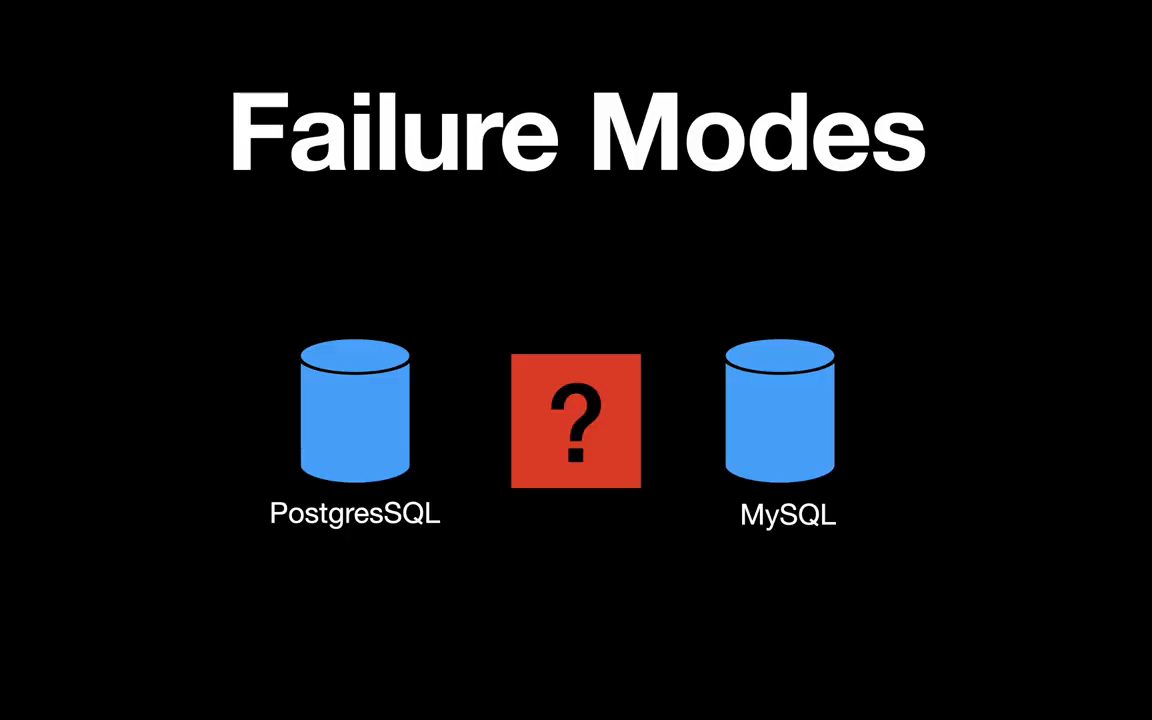
Chính vì thế, theo Shrinivasan, context engineering không đơn thuần là chuyện truy xuất (retrieval). Nó còn là chuyện độ mới của thông tin (freshness), nguồn gốc (provenance), thứ tự ưu tiên (priority) và cách giải quyết xung đột (conflict resolution).
15. Context engineering như một bài toán tối ưu
Anh đưa ra thêm một cách nghĩ về tất cả những điều trên: về bản chất, context engineering là một bài toán tối ưu (optimization problem). Mình muốn tối đa hoá hiệu quả làm task (task performance), nhưng bị ràng buộc bởi những thứ như kích thước context, chi phí, độ trễ (latency), mức độ liên quan (relevance), độ mới (freshness) và độ tin cậy (reliability).
Vậy mục tiêu không phải là "đưa cho model mọi thứ". Nó gần với: đưa cho model tập thông tin đáng tin cậy, hữu ích và nhỏ nhất (the smallest useful set of reliable information) cần để làm một task cho trước. Trên màn hình, ý này được rút lại thành "Give the model Smallest reliable Information".
Dĩ nhiên, đây không phải một công thức toán học chặt chẽ. Nó là một mô hình tư duy (mental model). Nhưng nó hữu ích vì nó thay đổi cách bạn thiết kế hệ thống AI. Câu hỏi không còn là làm sao nhét thêm context; bạn bắt đầu hỏi: context nào thật sự cải thiện quyết định kế tiếp của agent?
16. Một workflow context engineering đơn giản
Vậy nếu bạn đang build một AI agent, bắt đầu từ đâu? Shrinivasan đưa ra một workflow đơn giản, theo từng bước:
- Define: định nghĩa task. Agent thật sự đang cố đạt được điều gì?
- What's needed: xác định nó cần những thông tin gì.
- Resource: xác định mọi nguồn có thể cung cấp thông tin đó: memory, tài liệu, database, tool, file, những lần tương tác trước.
- Select: chọn thông tin liên quan một cách động.
- Compress: nén hoặc gỡ những thông tin đã trở nên không cần thiết.
- Isolate: cô lập các task hoặc agent không liên quan tới nhau.
- Evaluate: đánh giá kết quả.
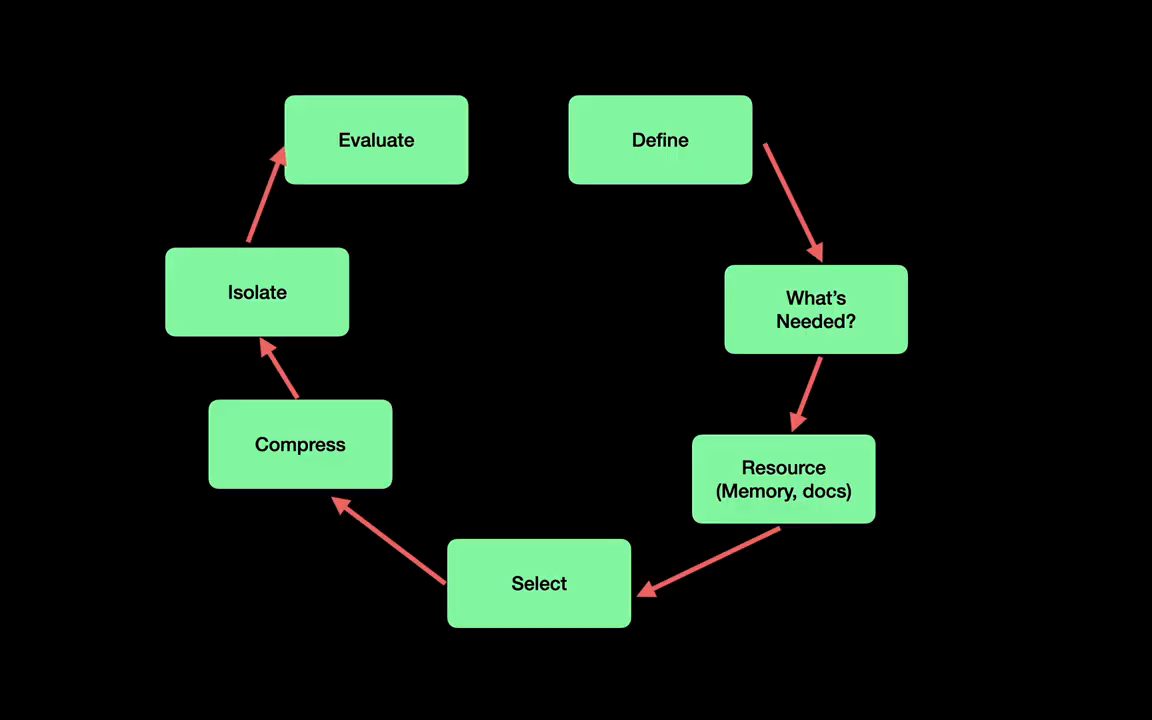
Ở bước đánh giá, anh gợi ý những câu hỏi cụ thể: agent có hoàn thành task không? Nó có nhận được đúng thông tin không? Nó có dùng những tool cần thiết không? Context có bị phình quá lớn không? Có thông tin cũ (stale) hay mâu thuẫn nào lọt vào context không?
Rồi bạn lặp lại quá trình này hết lần này tới lần khác. Chính điều đó biến context engineering thành một chuyên môn (discipline), chứ không đơn thuần là một bài tập viết prompt cho khéo. Và đó là lý do nó được gọi là engineering, chứ không chỉ là prompting.
17. Bức tranh lớn: đúng context, đúng lúc, đúng dạng
Điều này dẫn tới bức tranh lớn hơn. Khi hệ thống AI ngày càng mạnh, yếu tố giới hạn không phải lúc nào cũng là trí thông minh của model. Đôi khi, chính thông tin mình đưa cho model, thông tin mình làm việc cùng, mới là thứ tạo ra khác biệt.
Một agent có thể có một model cực kỳ mạnh đứng phía sau, nhưng nếu thông tin liên quan không có sẵn, hoặc context bị lấp đầy bởi thông tin cũ hay mâu thuẫn, thì cả hệ thống trở nên không đáng tin lắm. Đó là lý do context engineering thật sự quan trọng.
Nó là chuyện hiểu rằng context không đứng yên. Context liên tục thay đổi khi agent tương tác với mình. Và mình write những thông tin hữu ích, mình select, mình compress, mình isolate, tất cả để làm context engineering cho tốt.
Anh chốt lại bằng một phép so sánh: nếu prompt engineering là đưa cho model những chỉ dẫn tốt hơn, thì context engineering là tạo ra đúng môi trường thông tin để model lập luận. Và rốt cuộc, mục tiêu khá đơn giản: đưa cho agent đúng context, vào đúng lúc, ở đúng dạng. Anh cảm ơn mọi người đã xem và hẹn gặp ở video sau.
Nguồn và liên kết 6 nguồn
- Tên gốc: Context Engineering: The complete guide for developers
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=_IQXK3SgmPQ youtube.com
- Kênh YouTube AI Bites (Shrinivasan Sankar): youtube.com/channel/UCCW0ICn8IMRsgnJhCLAuClA youtube.com
- Website AI Bites, trang giới thiệu của Shrinivasan Sankar: ai-bites.net/about ai-bites.net
- Bài báo "Lost in the Middle: How Language Models Use Long Contexts" (Liu và cộng sự) mà video nhắc tới: arxiv.org/abs/2307.03172 arxiv.org
Related talks
Khóa AI agent cho người mới: sáu agent, quyền hạn, prompt contract và memory
AI Master · AI Master · 30 min
Agent là gì, MCP nối tool ra sao, so sánh sáu agent, trao quyền theo độ khó hoàn tác, prompt contract năm phần và file memory của project.
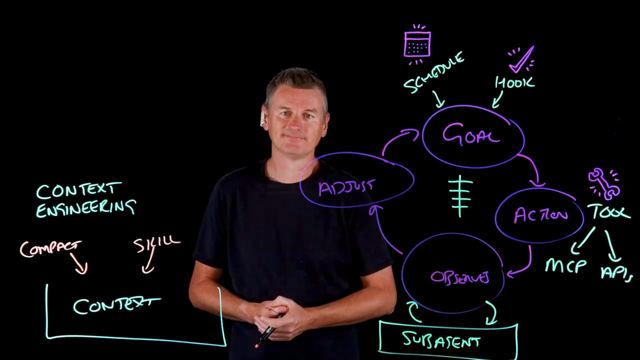
Loop engineering là gì: xây AI agent tốt hơn quanh một vòng lặp
Martin Keen · IBM Technology · 11 min
Loop engineering: vòng goal, action, observe, adjust cùng trigger, context, skill, spine, tool, sub-agent, và bốn pitfall cần con người trong vòng lặp.
Claude Code Skills là gì và cách tạo skill theo 6 bước
Giang · GiangxAI · 29 min
Skill trong Claude Code là gì, khi nào nên xây, 6 bước tạo skill qua demo skill tạo ảnh infographic, CLAUDE.md và ba tầng tải token.