Designing Voice Agents for Real Conversations
AI Engineer World's Fair 2026: Online Track · Video gốc
Turn-taking cho voice agent qua ba level: Silero VAD, turn detection trong STT, rồi VAD cộng Smart Turn; kèm latency budget, LLM TTFT và demo Pipecat.
1. Turn-taking là bài toán audio, không phải bài toán LLM
Chintan Agrawal mở đầu bằng việc giới thiệu mình và đồng nghiệp Daniel Wirjo. Cả hai là solutions architect trong team AWS APJ Startups, tức nhóm làm việc với các startup ở khu vực châu Á Thái Bình Dương. Chủ đề hôm nay là thứ họ đã làm một thời gian dài: turn-taking trong voice agent, nghĩa là luân phiên lượt nói giữa người và máy.
Câu hỏi cụ thể là: làm sao hệ thống thật sự biết bạn đã nói xong, và tới lúc agent trả lời? Chintan nhấn mạnh đây là bài toán audio engineering, không phải bài toán LLM. Bạn có thể có model hoàn hảo, RAG hoàn hảo, nhưng trải nghiệm vẫn có thể thấy hỏng nếu turn-taking sai. Model trả lời hay tới đâu cũng vô ích nếu nó chen vào lúc người dùng còn đang nói, hoặc để một khoảng lặng dài tới mức người dùng tưởng cuộc gọi đã rớt.
Lộ trình của talk gồm tám chặng, như slide "Eight stops" liệt kê:
- Một voice agent nghe tự nhiên thì cảm giác thế nào.
- Ràng buộc 200 ms, tức "phần vật lý" giải thích vì sao voice khó.
- Kiến trúc pipeline: các thành phần là gì, và turn-taking thật sự nằm ở đâu.
- Ba level giải bài toán, đi từ silence detection đơn giản tới tự chạy một turn detection model của riêng mình: Level 1 là Silero VAD, Level 2 là turn detection có sẵn trong STT, Level 3 là Smart Turn, tự sở hữu cả stack.
- Latency budget: thời gian đi đâu trong một lượt trả lời.
- Bài học production và các vấn đề còn mở mà họ đã thấy ở khách hàng.
Phần lý thuyết do Chintan trình bày. Sau đó Daniel sẽ làm mọi thứ cụ thể hơn bằng cách chạy cả ba demo trực tiếp.
2. Cùng một người, cùng một câu, hai kết quả
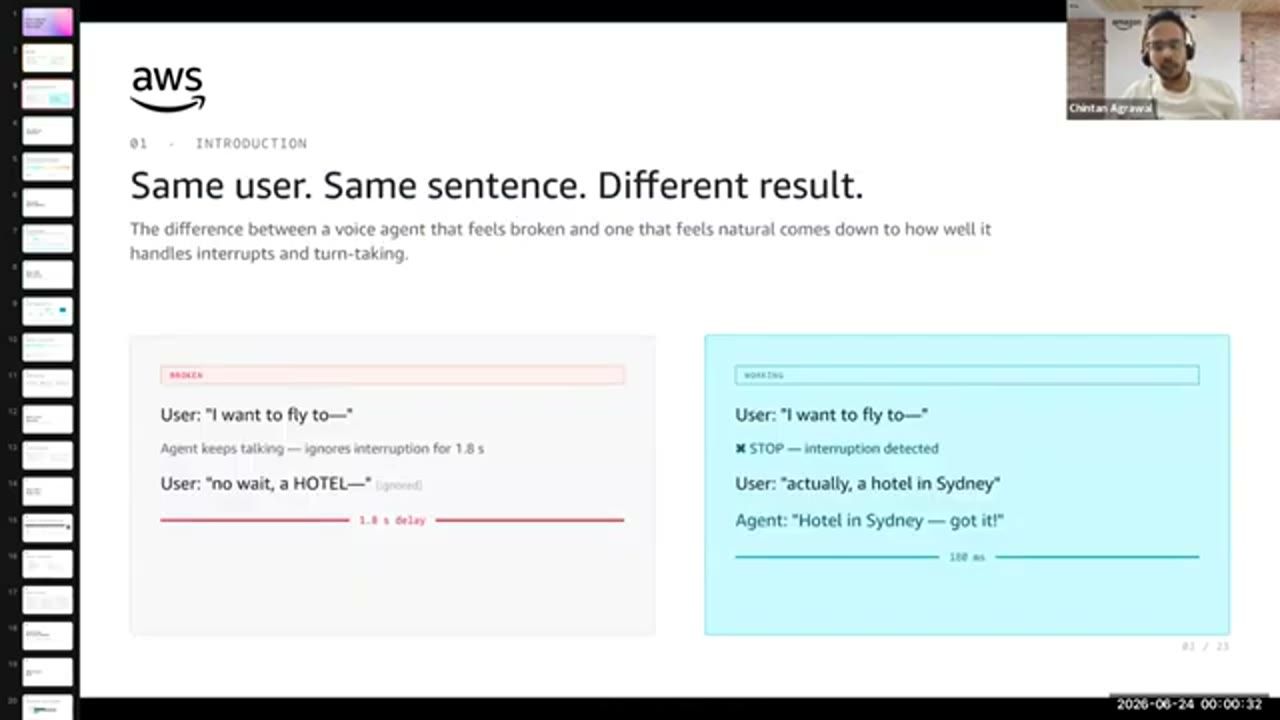
Trước khi đi vào chi tiết, Chintan muốn cho thấy vấn đề một cách rõ ràng. Hai bên của slide là cùng một user, cùng một câu nói, nhưng kết quả cho người dùng khác hẳn nhau.
Ở bên trái, user nói "I want to fly", rồi giữa chừng định sửa lại. Agent không hề nhận ra. Nó cứ nói tiếp gần hai giây, trong khi người kia ngồi đó cố chen được một câu. Chintan bật cười khi tả cảnh này.
Ở bên phải, đúng tương tác ấy diễn ra, nhưng agent bắt được lời ngắt trong chưa tới 200 mili giây và lùi lại ngay, để user nói tiếp.
Điểm mấu chốt: trong cả hai kịch bản, LLM giống hệt nhau. Cùng model, cùng prompt. Trải nghiệm khác nhau hoàn toàn là do audio pipeline, tức hệ thống nhận ra nhanh tới đâu rằng có người khác đang nói, và biết lúc nào thì phải im. Đó là bài toán talk này muốn giải.
Lý do họ lấy mốc 200 ms: đó là tốc độ con người đổi lượt nói với nhau trong một cuộc trò chuyện bình thường.
3. Ràng buộc 200 ms
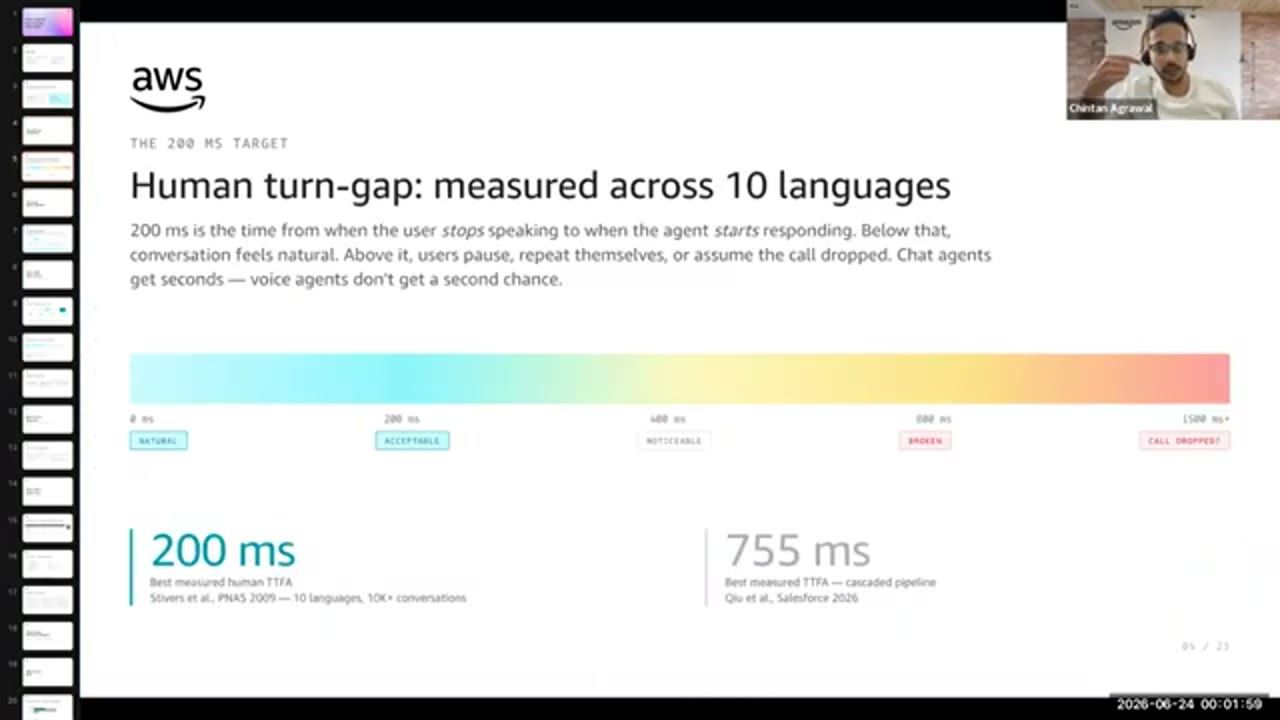
Hệ quả của mốc 200 ms khá phũ. Ở 800 mili giây, mọi thứ bắt đầu thấy sai sai. Ở 1,5 giây, user sẽ cúp máy. Chat agent có thể mất năm giây mới trả lời và chẳng ai để ý. Voice agent không có được sự xa xỉ đó.
Slide định nghĩa rõ: 200 ms là khoảng thời gian từ lúc user ngừng nói tới lúc agent bắt đầu đáp. Dưới mức đó, cuộc trò chuyện thấy tự nhiên. Trên mức đó, user ngập ngừng, lặp lại câu của mình, hoặc nghĩ cuộc gọi đã rớt. Chat agent có vài giây, voice agent không có cơ hội thứ hai.
Chintan dẫn một kết quả gần đây: Salesforce đã đo pipeline của họ và công bố kết quả vào tháng 3/2026. Ngay cả thời gian phản hồi tốt nhất họ đo được vẫn là 755 mili giây, tức gần gấp bốn lần tốc độ con người đổi lượt khi nói chuyện.
Vậy câu hỏi trở thành: làm sao thu hẹp khoảng cách này? Và ở chỗ không thu hẹp được, ít nhất làm sao để turn-taking đúng, để trải nghiệm không tệ như những con số thô gợi ý?
4. Voice agent cần một pipeline, và VAD là mảnh hay bị quên
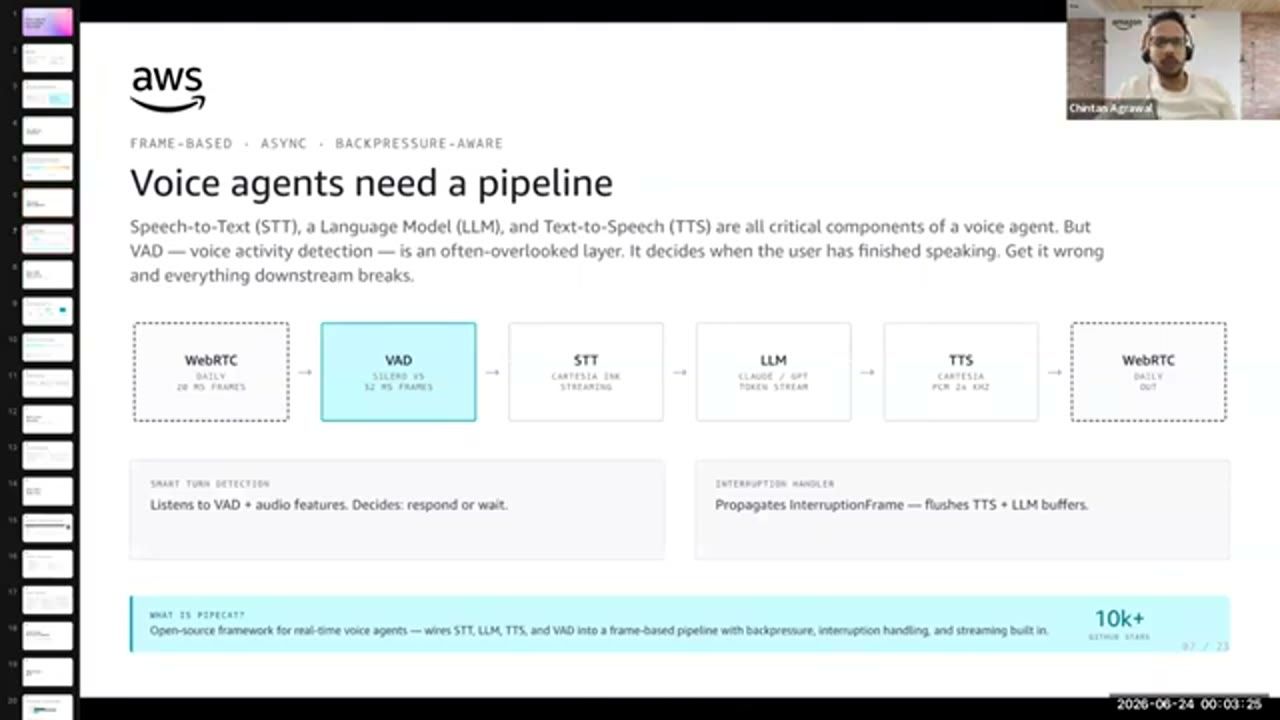
Nếu bạn đang làm việc với budget 755 mili giây và mili giây nào cũng quý, bạn cần hiểu trong pipeline thật sự có gì: thời gian đi đâu, và turn-taking nằm ở chỗ nào.
Các thành phần chính chắc bạn đã biết: STT (speech-to-text), LLM, TTS (text-to-speech). Audio vào, text ra; text vào, audio ra. Nhưng mảnh mà người ta hay bỏ sót khi nghĩ về voice agent là voice activity detection, thường gọi tắt là VAD. Đó là một thành phần rất nhỏ nằm ngay đầu pipeline, và chính nó điều khiển turn-taking. Việc của nó cơ bản là phát hiện user đã ngừng nói hay chưa. Slide nói thẳng: làm sai chỗ này thì mọi thứ phía sau đều hỏng.
Hai thành phần nữa nằm cạnh pipeline chính cũng rất quan trọng cho turn-taking:
- Smart turn detection: theo dõi tín hiệu VAD cộng các audio feature, rồi ra quyết định nên trả lời ngay hay nên chờ vì user có thể vẫn đang nói.
- Interruption handler: được kích hoạt khi có người chen ngang (barge-in). Nó đẩy một lệnh flush xuống dưới pipeline: TTS phải dừng, LLM generation phải bị hủy, để pipeline sẵn sàng cho input mới trong khoảng 15 mili giây.
Như đã nói ở phần lộ trình, có nhiều level để xây turn-taking cho voice agent. Chintan bắt đầu từ level một: Silero VAD.
5. Level 1: Silero VAD
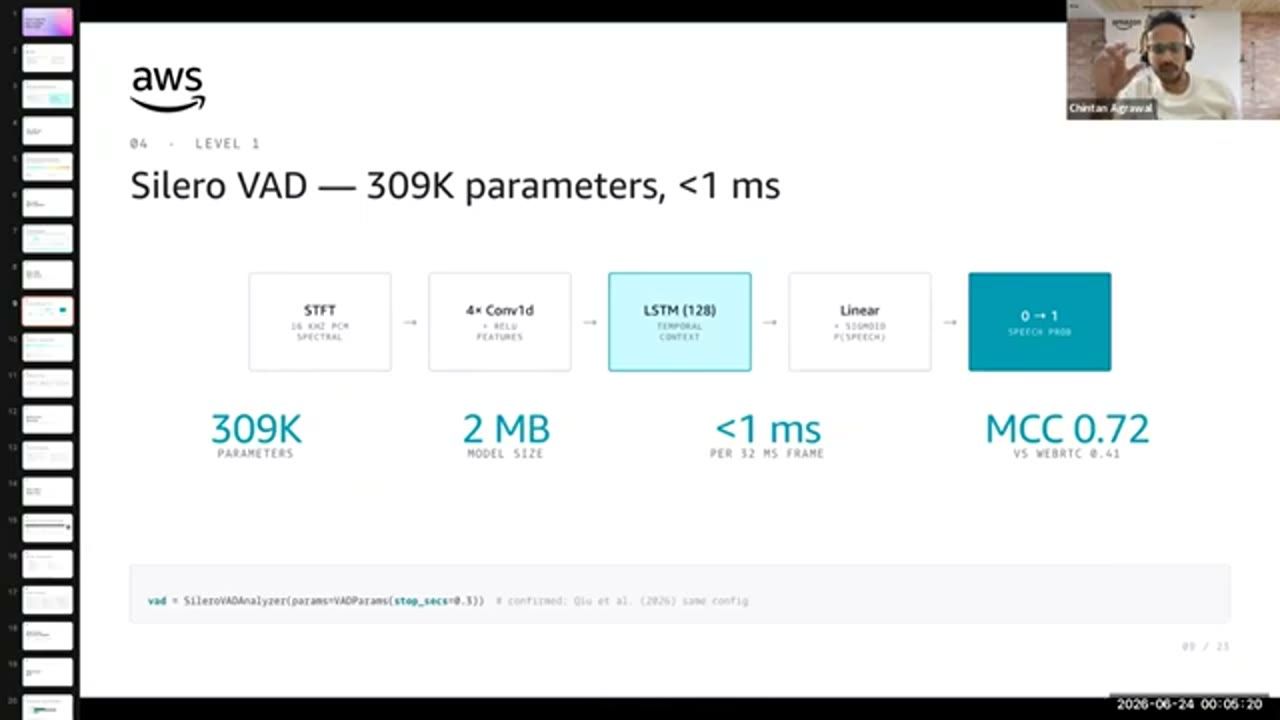
SileroVADAnalyzer với stop_secs=0.3.Level một là thành phần đơn giản mà bạn sở hữu hoàn toàn. Chintan kể rằng rất nhiều hệ thống production ngày nay mà họ gặp vẫn đang chạy agent chỉ với thứ này.
Silero VAD là một model nhỏ, khoảng ba trăm nghìn tham số. Nó nhận audio thô và qua một bước short-time Fourier transform (STFT) để biến audio thành spectral features. Sau đó là bốn lớp convolution để bắt pattern, một LSTM cho nó "trí nhớ" xuyên qua các frame, để nó không nhìn từng mẩu audio một cách cô lập. Cuối cùng là một sigmoid cho ra xác suất có tiếng nói. Toàn bộ model chỉ khoảng hai megabyte.
Và cả trải nghiệm của level một nằm trong đúng một tham số: thời gian im lặng tối thiểu (minimum silence, tính bằng mili giây) trước khi coi là user đã nói xong.
6. Tham số quyết định mọi thứ: thời gian im lặng
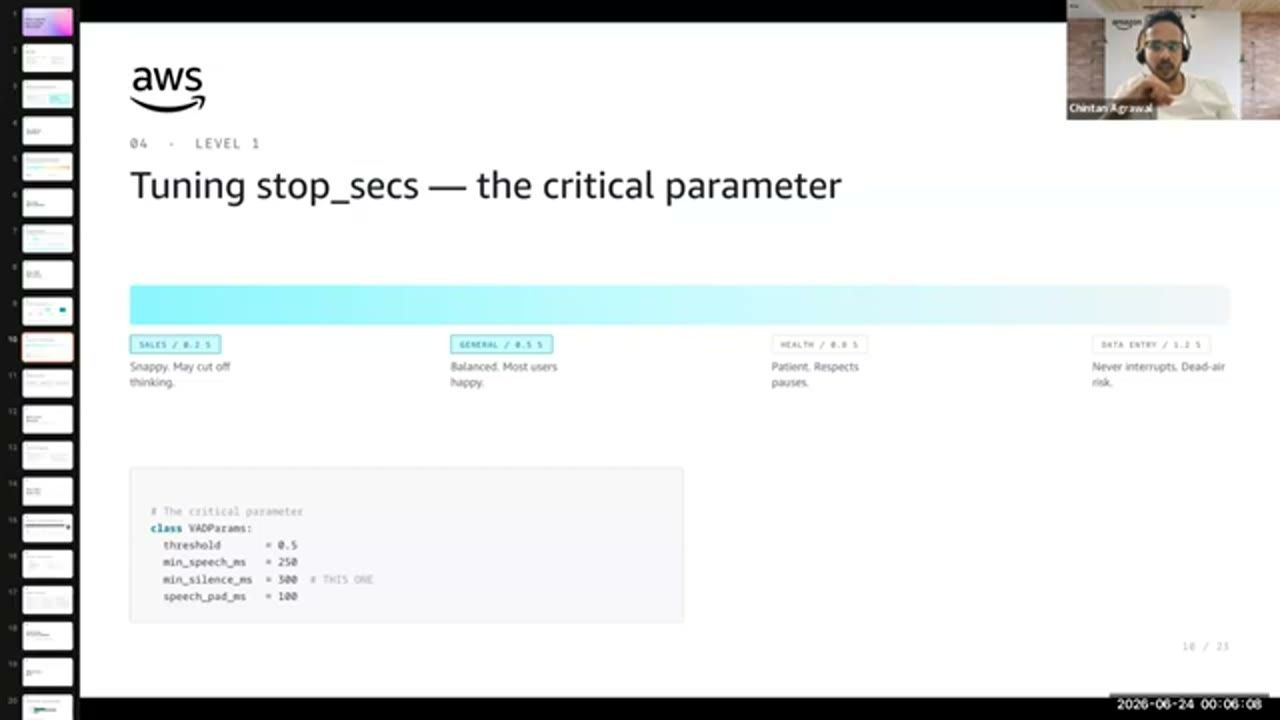
VADParams với threshold = 0.5, min_speech_ms = 250, min_silence_ms = 300 (được đánh dấu "THIS ONE") và speech_pad_ms = 100.Nếu đặt tham số này rất thấp, agent sẽ rất nhanh nhạy, nhưng nó sẽ cắt lời người ta khi họ vẫn đang suy nghĩ. Nếu đặt rất cao, agent trở nên cực kỳ kiên nhẫn và không bao giờ ngắt lời, nhưng bạn có thể gặp dead air: khoảng lặng dài tới mức người dùng tự hỏi agent còn kết nối hay không.
Không có đáp án đúng cho mọi trường hợp. Nó phụ thuộc vào domain. Nếu bạn làm một sales agent, có lẽ bạn muốn khoảng 200 mili giây. Nếu bạn ở một domain cần cho user thêm thời gian để trả lời, con số có thể là một nghìn tới một nghìn hai trăm mili giây. Tất cả phụ thuộc vào thứ bạn đang xây.
Chintan kết luận phần này: VAD làm tốt việc của nó, đó là lý do nhiều người dùng nó. Nó trả lời rất nhanh câu hỏi cơ bản "lúc này có ai đang nói không". Nhưng có những thứ nó chưa bao giờ được thiết kế để xử lý, vì có những tình huống mà chỉ biết "đang im lặng" thì chưa đủ.
7. Những gì VAD không giải được
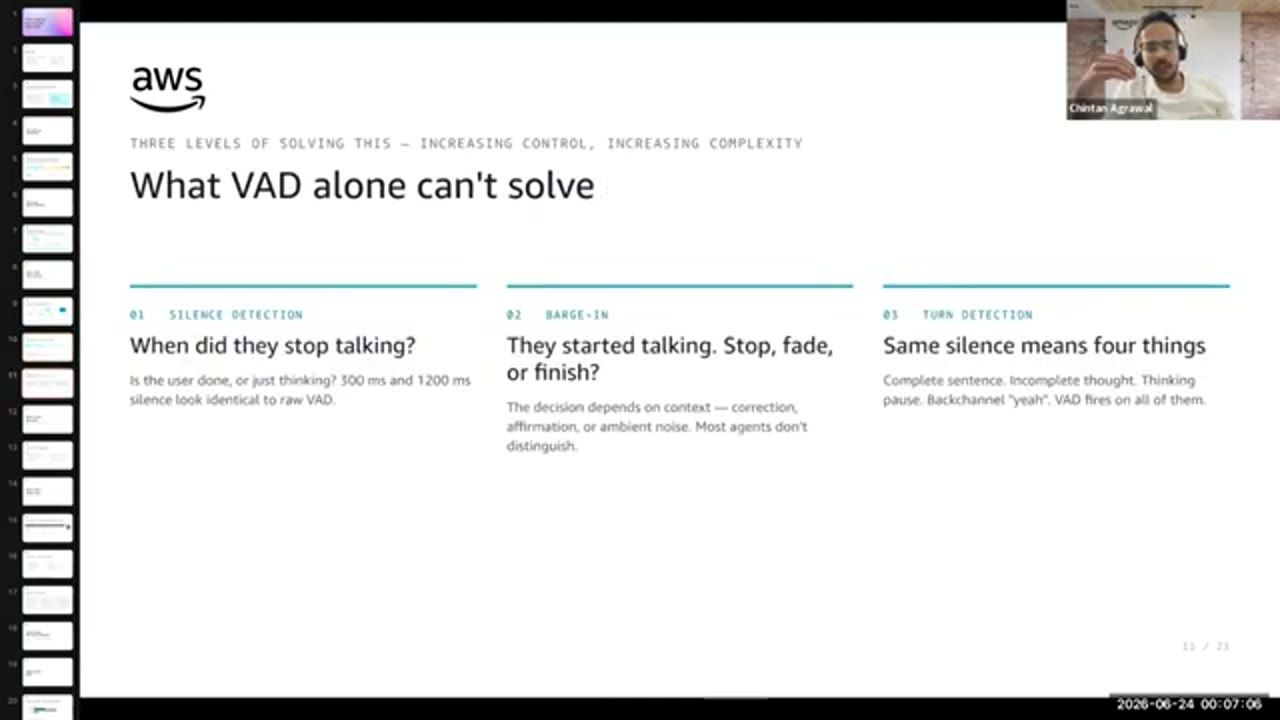
Có ba nhóm câu hỏi VAD không trả lời được.
Thứ nhất, chờ bao lâu. Nếu ai đó ngừng 300 mili giây hay 200 mili giây, VAD thấy đúng một thứ giống nhau. Nó không biết người kia đang lấy hơi hay đã nói trọn ý. Nó không phân biệt được hai chuyện đó.
Thứ hai, user nói đè lên agent thì sao. Khi user chen ngang (barge-in), VAD không biết xử lý thế nào.
Thứ ba, cùng một khoảng lặng có thể mang ý định khác nhau. Đó có thể là một câu đã trọn, có thể là một ý chưa nói xong, có thể là quãng ngừng để suy nghĩ, hoặc đơn giản là một tiếng phụ họa kiểu backchannel ("ừ", "yeah"). Tình huống im lặng thì giống nhau, nhưng ý định trong mỗi trường hợp khác hẳn nhau. VAD coi cả bốn như nhau, và nó thật sự không thể phân biệt chúng.
Đó là giới hạn của level một, và là lý do có level hai.
8. Level 2: để STT tự phát hiện hết lượt
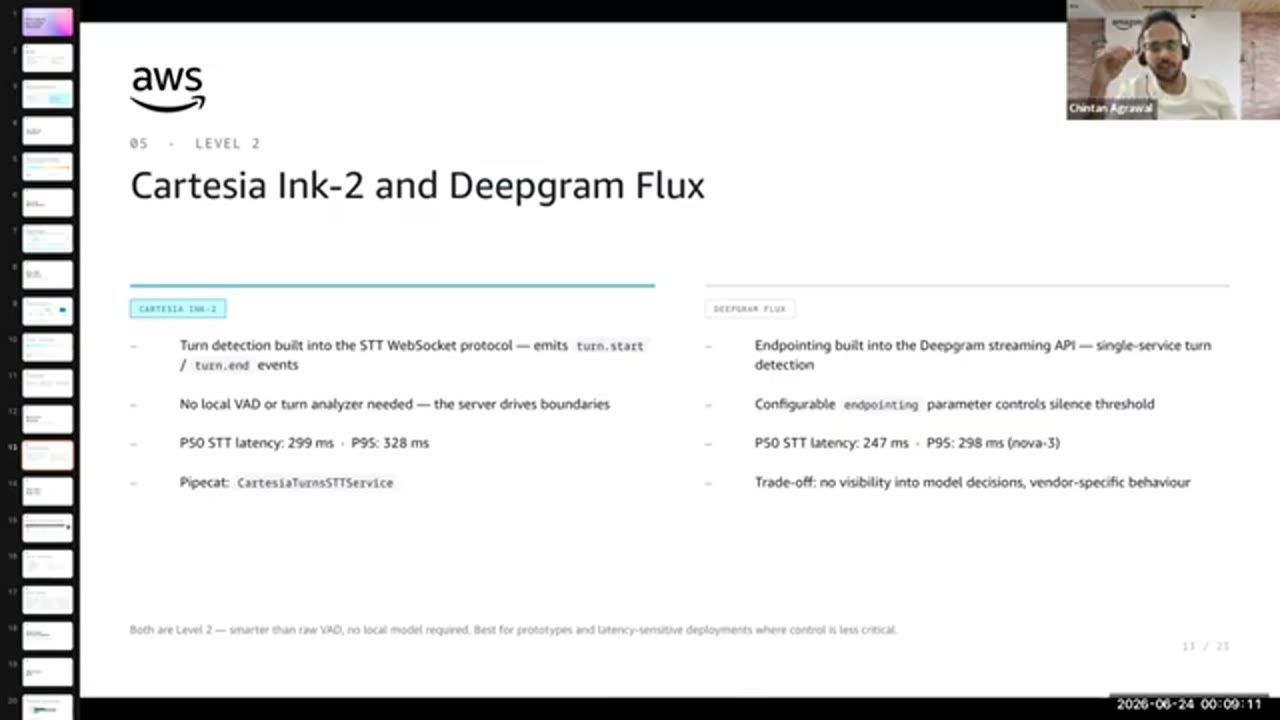
turn.start và turn.end; không cần VAD hay turn analyzer tại chỗ vì server quyết định ranh giới lượt; P50 STT latency 299 ms, P95 328 ms; trong Pipecat dùng CartesiaTurnsSTTService. Cột Deepgram Flux: endpointing nằm trong streaming API của Deepgram; tham số endpointing điều chỉnh ngưỡng im lặng; P50 247 ms, P95 298 ms (ghi nova-3); đánh đổi là không nhìn được vào quyết định của model và hành vi phụ thuộc nhà cung cấp. Chú thích cuối: cả hai đều là Level 2, thông minh hơn VAD thô, không cần model tại chỗ, hợp cho prototype và các deployment nhạy latency mà không cần kiểm soát nhiều.Với level hai, về cơ bản bạn để chính dịch vụ STT báo cho bạn biết khi nào lượt nói kết thúc.
Cartesia Ink-2 làm turn detection ngay bên trong STT WebSocket của họ. Khi bạn stream audio vào, server xử lý cả transcription lẫn turn detection cùng lúc, và phát ra một event khi nó cho rằng lượt nói đã xong. Deepgram làm điều tương tự, với cái mà Chintan nhớ là họ gọi là endpointing. Theo lời anh, P50 latency của Cartesia Ink-2 vào khoảng 300 ms, còn của Deepgram Nova-3 khoảng 250 ms. Trên slide, cột Deepgram mang tên Deepgram Flux, với P50 247 ms và P95 298 ms, kèm ghi chú nova-3.
Cả hai đều chạy rất tốt, và AWS thấy nhiều khách hàng dùng chúng. Lý do là chúng dùng toàn bộ tín hiệu audio cộng thêm một phần ngữ cảnh ngôn ngữ để ra quyết định, tức nhiều thông tin hơn hẳn những gì VAD từng có.
Đánh đổi nằm ở tính minh bạch. Khi nó chạy đúng thì rất tuyệt. Nhưng khi nó bắn nhầm, hay cắt lời ai đó sai thời điểm, bạn gần như không có cách nào tìm ra nguyên nhân, vì không có log nào nói "đã quyết như vậy vì lý do này, vì đã thấy cái này". Quyết định được đưa ra trong server của người khác, và về cơ bản bạn phải chấp nhận sống chung với nó.
9. Level 3: Silero VAD cộng Smart Turn
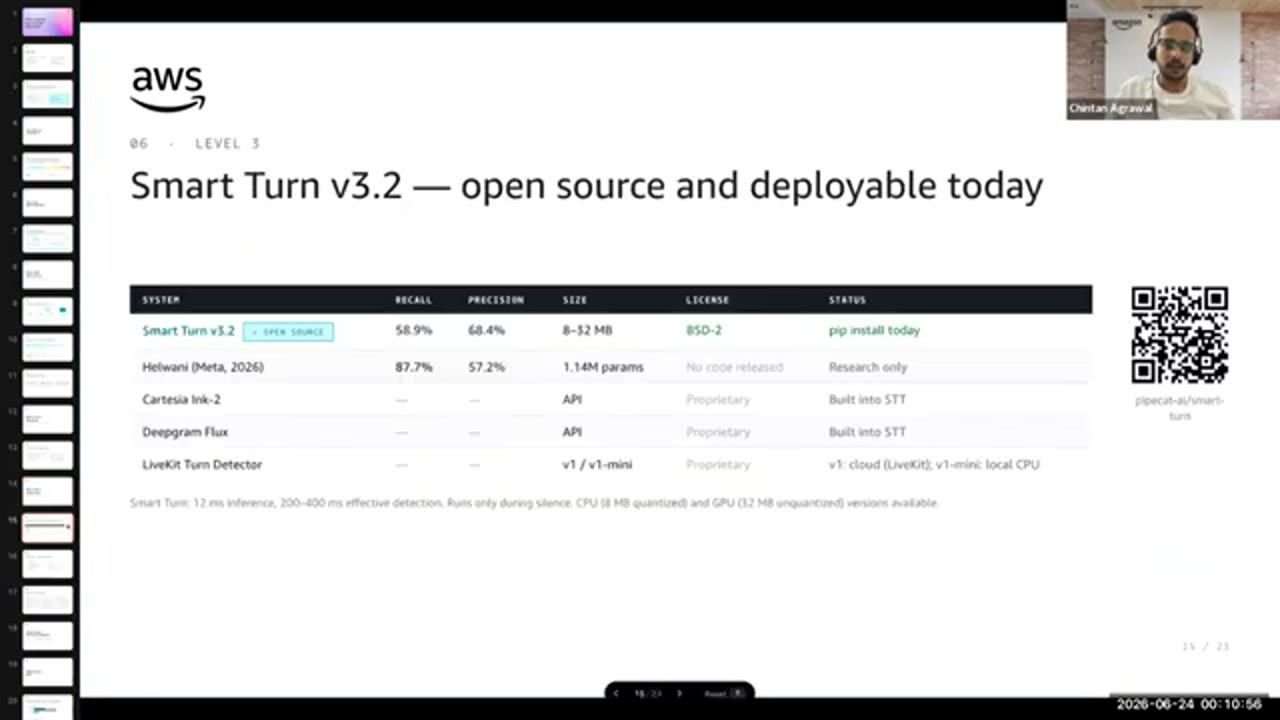
Ở level ba, bạn vẫn giữ Silero VAD chạy tại chỗ để lấy tín hiệu cơ bản "có tiếng nói hay không", rồi thêm Smart Turn lên trên. Smart Turn là một model nhỏ chỉ chạy trong những quãng im lặng. Slide trước của phần này tóm level ba bằng bốn chữ: full control, transparent, tunable, portable.
Smart Turn v3.2 là bản mới nhất, và Chintan đưa ra vài con số: recall khoảng 58,9% và precision 68,4%. Nghĩa là cứ khoảng sáu trên mười lần người ta nói xong một câu, Smart Turn sẽ bắt được nhanh. Bốn lần còn lại nó có thể không đủ tự tin.
Nhưng điều đó cũng ổn, vì bạn vẫn còn timer của VAD chạy bên dưới như một tấm lưới an toàn. Nếu Smart Turn không kích hoạt, stop_secs sẽ vào cuộc ở mức latency bạn đã cấu hình, ví dụ 300 mili giây. Trong kịch bản đó bạn không bao giờ bị kẹt chờ. Bạn có phản hồi nhanh khi model tự tin, và phản hồi chậm hơn một chút nhưng an toàn hơn khi model không tự tin.
Con số còn lại trong bảng đến từ một paper Meta công bố đầu năm nay, khoảng tháng 3, báo cáo recall cao, 87,7%. Nhưng họ chưa công bố code, nên bạn không thể deploy nó.
Smart Turn dùng license BSD 2, là một model nhỏ khoảng tám megabyte, và bạn có thể pip install ngay hôm nay. Chintan nói với nhiều khách hàng của họ, cách này hiệu quả hơn khi phải quyết định lúc nào agent bắt đầu nói.
10. Chiều ngược lại: khi user ngắt lời agent
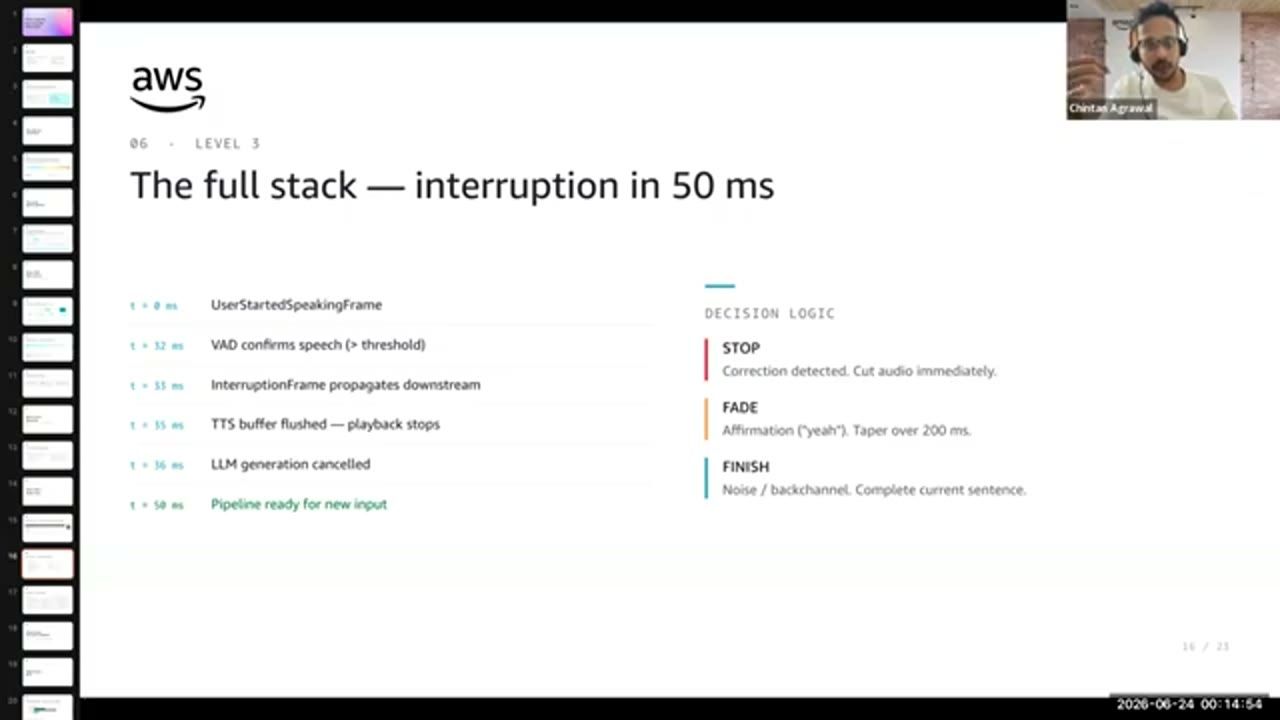
Đó là chiều "khi nào agent bắt đầu nói". Còn chiều ngược lại: chuyện gì xảy ra khi user ngắt lời trong lúc agent đang nói?
Bên trái slide là phần cơ học. User mở miệng, VAD bắt được trong 32 mili giây, rồi chừng 15 mili giây sau toàn bộ pipeline được flush: TTS dừng, LLM hủy, mọi thứ sạch sẽ, user không còn nghe agent nữa. Phần này Pipecat lo cho bạn.
Câu hỏi quan trọng hơn là: lẽ ra agent có nên dừng ở đó không? Chintan nhắc lại một cuộc trò chuyện bình thường. Khi ai đó nói "Yeah" trong lúc bạn đang nói, tức họ gửi một tín hiệu xác nhận, bạn đâu có dừng. Bạn biết họ chỉ đang đồng ý. Nhưng nếu họ nói "Okay, wait, no, that was wrong", bạn phải dừng ngay lập tức.
Voice agent cũng vậy. Trên slide:
- Màu đỏ là một lời sửa: dừng mọi thứ.
- Màu cam có thể chỉ là một tiếng đệm hay tiếng nền: agent có thể nói tiếp, có lẽ nhỏ giọng đi một chút.
- Màu xanh là tín hiệu kiểu tiếng ho hay tiếng ồn nền: có thể bỏ qua và nói nốt câu.
Ở level ba, vì bạn sở hữu phần phân loại này, bạn có thể bắt đầu phân biệt giữa một lời ngắt thật và một người chỉ "Mm" một tiếng. Chintan thừa nhận hiện nay đa số hệ thống dừng mọi lúc bị chen vào, nhưng đây là mảnh đang tiến bộ dần, và họ thấy nhiều cải thiện từng bước ở chỗ này.
11. Ba level, chỉ đổi một chỗ trong code
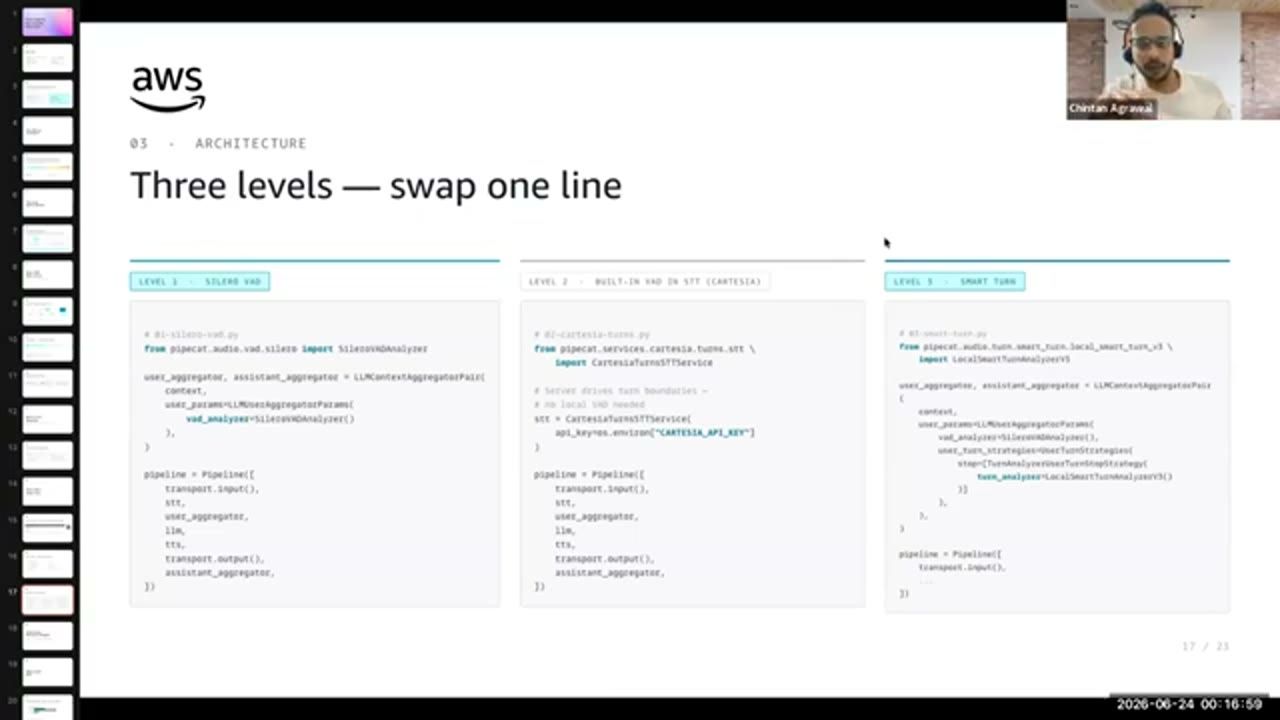
SileroVADAnalyzer() vào LLMUserAggregatorParams; Level 2 (VAD có sẵn trong STT của Cartesia) dùng CartesiaTurnsSTTService, không cần VAD tại chỗ vì server quyết định ranh giới lượt; Level 3 (Smart Turn) giữ SileroVADAnalyzer() và thêm chiến lược dừng lượt dùng LocalSmartTurnAnalyzerV3. Phần Pipeline([...]) gần như giống hệt ở cả ba.Đã đi qua cả ba level, Chintan cho xem ba file Python. Pipeline gần như y hệt nhau trong cả ba. Thứ duy nhất khác nhau là cách bạn trả lời câu hỏi "khi nào user nói xong?".
- File một: bạn truyền vào
SileroVADAnalyzer, và nó nói "user đã im 300 mili giây, có thể coi là họ đã xong". - File hai: bạn thay bằng class STT service có turn của Cartesia, và giờ server sẽ báo cho bạn khi nào lượt nói kết thúc.
- File ba: bạn giữ
SileroVADAnalyzer, nhưng thêmLocalSmartTurnAnalyzerV3, một model nhỏ chạy trong lúc im lặng. Nó nhìn vào prosody và ngữ điệu (intonation) để quyết định quãng ngừng đó nghĩa là "tôi xong rồi" hay "tôi vẫn đang nghĩ".
Về mặt code thì vẫn là một pipeline, nhưng cấu hình đổi, và điều đó dẫn tới hành vi hoàn toàn khác. Đây là phần cấu hình của Level 3 như trên slide, để bạn dễ đối chiếu:
# 03-smart-turn.py
from pipecat.audio.turn.smart_turn.local_smart_turn_v3 \
    import LocalSmartTurnAnalyzerV3

user_aggregator, assistant_aggregator = LLMContextAggregatorPair(
    context,
    user_params=LLMUserAggregatorParams(
        vad_analyzer=SileroVADAnalyzer(),
        user_turn_strategies=UserTurnStrategies(
            stop=[TurnAnalyzerUserTurnStopStrategy(
                turn_analyzer=LocalSmartTurnAnalyzerV3()
            )]
        ),
    ),
)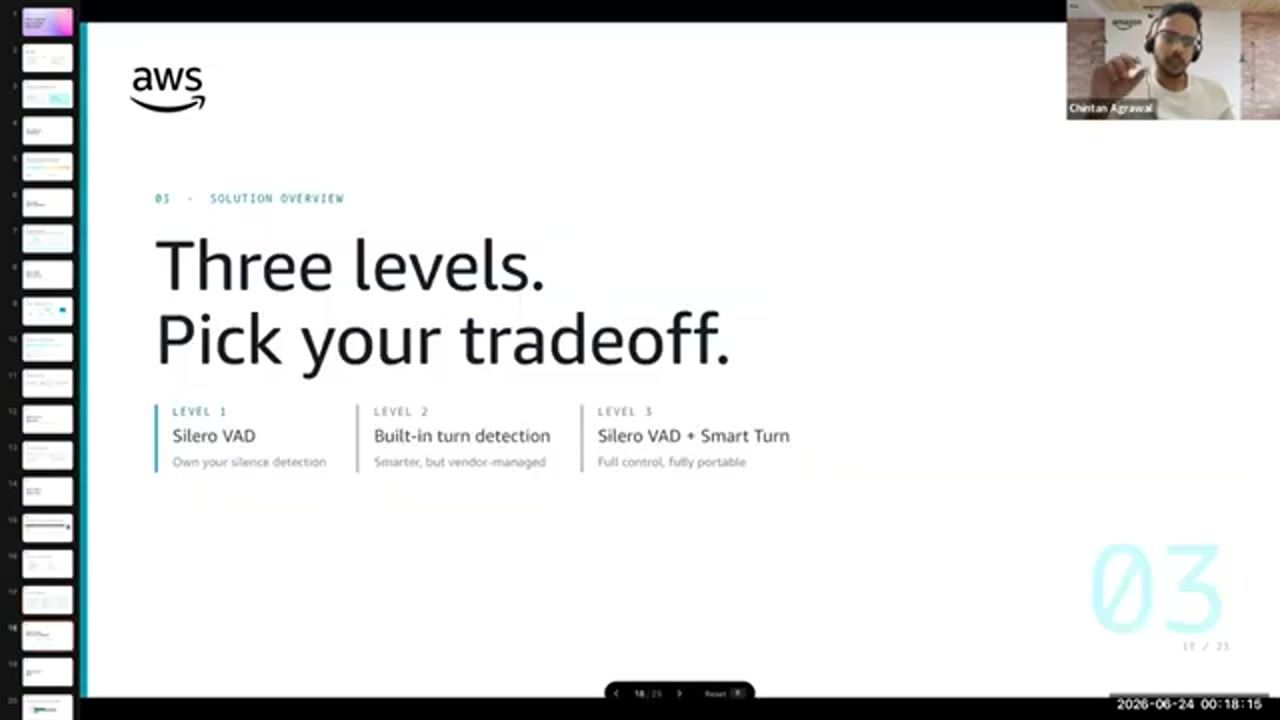
Tóm lại ba level: Level 1 là Silero VAD, bạn sở hữu hoàn toàn phần phát hiện im lặng. Level 2, bạn để nhà cung cấp STT lo; trong đa số trường hợp nó thông minh hơn, nhưng bạn không nhìn được bên trong nó đã xảy ra gì. Level 3 là VAD cộng Smart Turn, nơi bạn sở hữu mọi thứ và có toàn quyền mang đi chỗ khác (portability).
12. Thời gian thật sự đi đâu
Từ đầu talk, các con số như 755 mili giây hay 1,3 giây được nhắc nhiều lần. Chintan giờ cho thấy thời gian thật sự đi vào đâu.
Bảng phân rã này đến từ Kwindla, đồng sáng lập Daily và là người tạo ra Pipecat, dựa trên số đo production của họ:
- Mic và encoding: khoảng 40 mili giây.
- Network và jitter buffer: khoảng 52 mili giây. Hai mục này là "vật lý", bạn không đổi được nhiều.
- Transcription cộng endpointing: khoảng 300 mili giây. Đó là STT đang làm việc của nó.
- LLM time to first byte: thường là nút thắt lớn nhất. Trong một setup gọi API thông thường, con số là 500 tới 650 mili giây, tùy model bạn gọi, từ cloud provider nào, ở region nào.
- Network ra, playback và TTS: phần cuối của lượt; Chintan đọc nhanh các con số 120, 90 và 85 mili giây cho chặng này.
Cộng lại, bạn đang nhìn vào khoảng 1.100 tới 1.300 mili giây trong một setup tiêu chuẩn gọi cloud API.
Team của Kwindla đã chứng minh được khoảng 500 mili giây voice-to-voice tổng cộng, bằng cách đặt tất cả model chung trong cùng một GPU cluster, nhờ đó loại bỏ các bước nhảy mạng giữa các server. Đó là một "sàn" có thể đạt được nếu bạn sẵn sàng đầu tư hạ tầng. Còn với đa số developer hôm nay đang gọi API, bạn sẽ ở đâu đó trong khoảng 800 tới 1.300 mili giây.
Insight quan trọng: STT và LLM cộng lại ăn khoảng hai phần ba latency budget. Đó thật sự là hai đòn bẩy duy nhất có thể dịch chuyển con số latency một cách có ý nghĩa.
13. LLM nào đủ nhanh cho voice
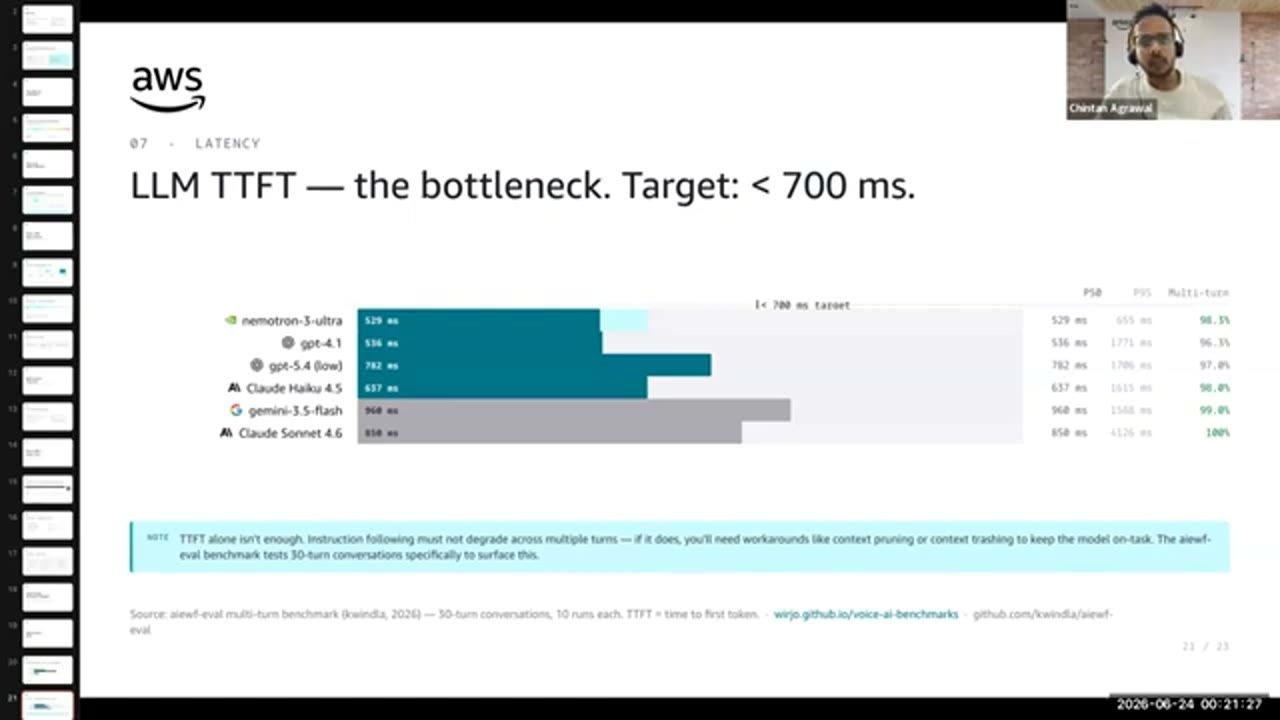
Vậy LLM nào thật sự đủ nhanh? Nhóm của Chintan đã benchmark các model hiện tại riêng cho voice. Các số đo là của tháng 6/2026, lúc talk được thu. Mục tiêu họ đặt là time to first token dưới 700 mili giây, vì chậm hơn nữa sẽ đẩy tổng thời gian phản hồi qua ngưỡng mà user bắt đầu nhận ra.
Kết quả: Nemotron-3 Ultra cho P50 là 529 mili giây. GPT-4.1 ở mức 536, cũng là P50.
Nhưng thứ quan trọng trong voice hơn bất cứ đâu khác là phần đuôi P95. GPT-4.1 rất tốt ở P50, nhưng vọt lên khoảng 1,7 giây ở P95. Với Claude Sonnet còn tệ hơn: hơn bốn giây. Trong một cuộc trò chuyện, bạn không thể lấy trung bình mà bù trừ, vì chỉ một phản hồi chậm là toàn bộ nhịp hội thoại tan vỡ.
Còn một chiều nữa mà người ta hay bỏ sót: multi-turn drift. Sau mười lăm hay hai mươi lượt, đôi khi model bắt đầu phớt lờ một phần system prompt. Nó có thể nói quá dài, có thể đi lạc khỏi kịch bản. Trong voice, chuyện đó là chí mạng, vì bạn không thể đổ cả một bức tường chữ lên tai người nghe. Nếu khả năng làm theo chỉ dẫn giảm dần qua các lượt, bạn phải dùng một kiểu context pruning hoặc reset session. Cột Multi-turn trên slide đo đúng điều này.
14. Bài học production và vấn đề còn mở
Chintan kể vài vấn đề production mà nhóm đã gặp.
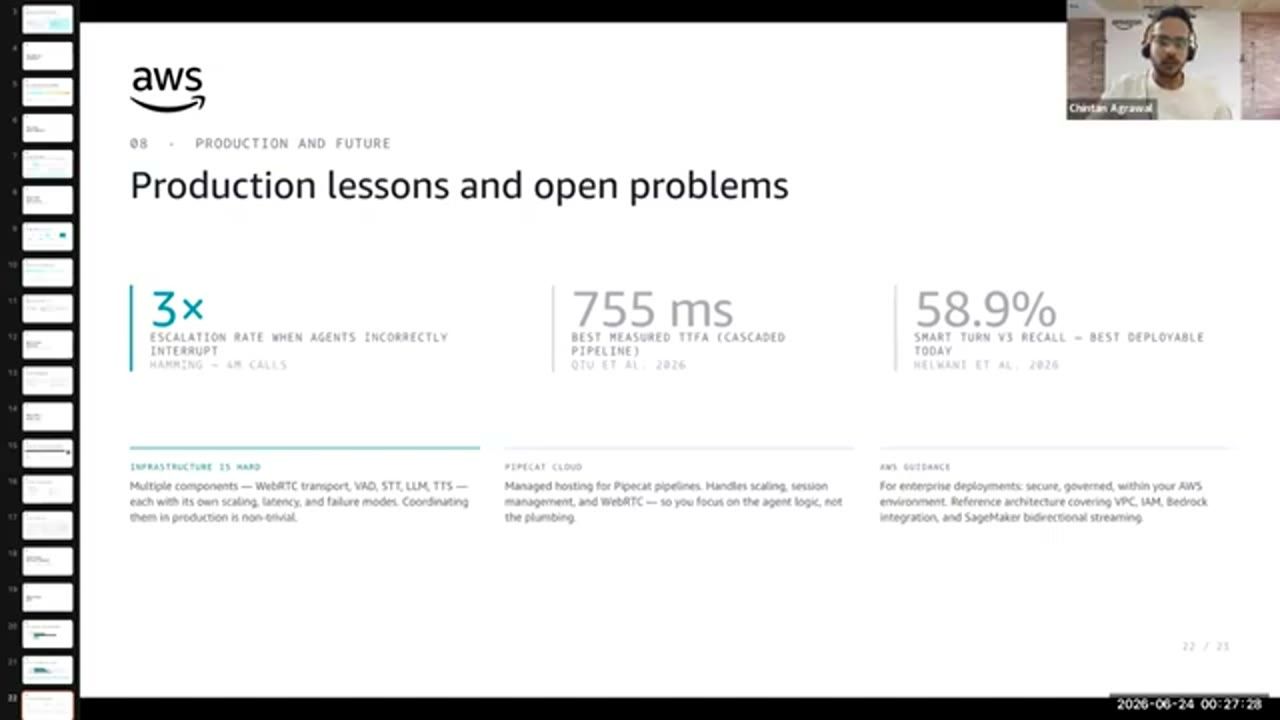
Ngắt lời sai làm tăng mạnh tỉ lệ escalation. Khi agent cắt lời người ta không đúng lúc, user dễ đòi chuyển sang người thật hơn, tức một dạng hỗ trợ human-in-the-loop. Slide ghi con số gấp ba lần, từ dữ liệu bốn triệu cuộc gọi.
755 mili giây vẫn là mức tốt nhất. Theo anh, đó vẫn là thời gian voice-to-voice tốt nhất từng đo được cho một cascaded pipeline như loại họ đang đề xuất. Chúng ta còn rất xa tốc độ tương tác của con người, nghĩa là turn-taking phải gánh rất nhiều để trải nghiệm thấy tốt hơn những gì con số thô gợi ý.
58,9% recall của Smart Turn là mức tốt nhất deploy được hôm nay. Dù vẫn để lại khoảng bốn trên mười lượt cho timer của VAD lấp vào, mảng này sẽ tiến bộ nhiều trong một năm tới, vài năm tới, và sẽ có model tốt hơn.
Hạ tầng cũng khó. Chạy tất cả những thứ này trong production nghĩa là năm hệ thống scale khác nhau và hỏng theo những cách khác nhau. Bạn có thể xem Pipecat Cloud cho managed hosting, nơi bạn tập trung vào logic của agent, hoặc AWS Guidance Reference Architecture cho deployment enterprise, kèm đầy đủ các guardrail của enterprise.
Chintan khép phần của mình: mọi thứ đã nhắc, kể cả benchmark, đều có link trên màn hình cuối. Rồi anh chuyển lời cho Daniel.
15. Daniel và repo demo
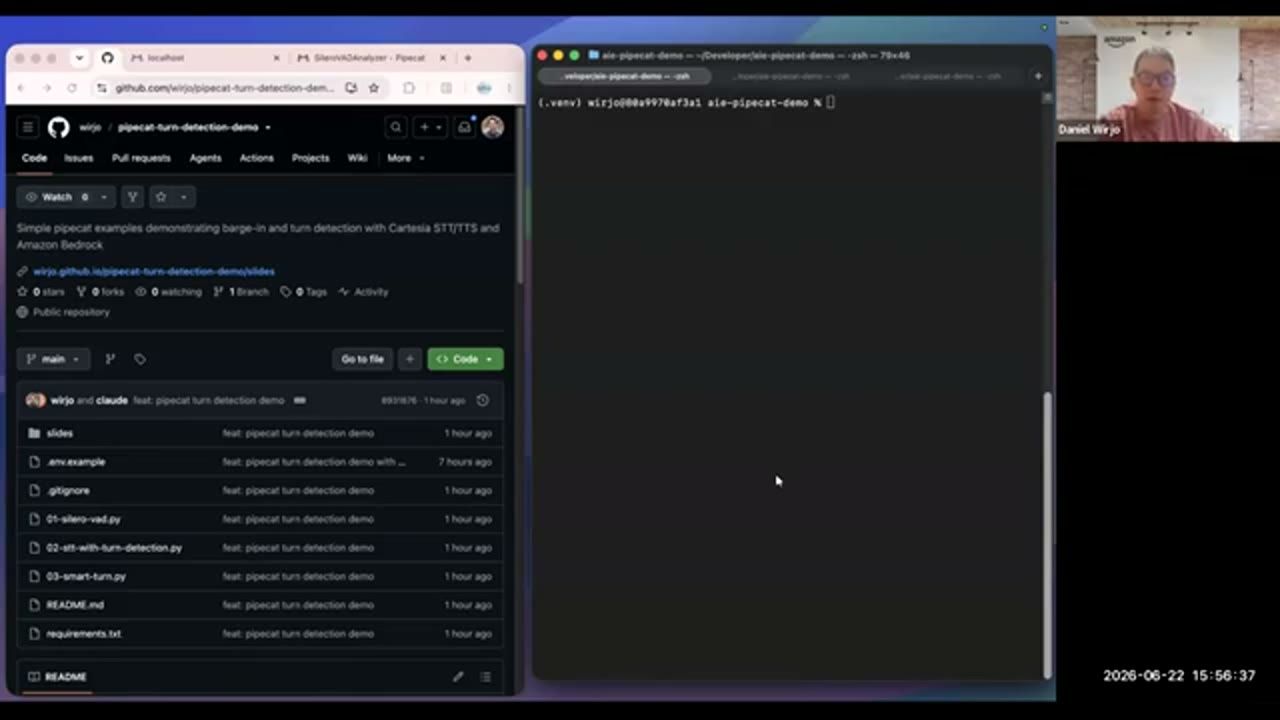
wirjo/pipecat-turn-detection-demo trên GitHub: "Simple pipecat examples demonstrating barge-in and turn detection with Cartesia STT/TTS and Amazon Bedrock". Các file chính là 01-silero-vad.py, 02-stt-with-turn-detection.py, 03-smart-turn.py, cùng README và requirements.Daniel Wirjo cảm ơn Chintan và giới thiệu mình: anh cũng là solutions architect trong team AWS Startups. Chintan đã đi qua một bức tranh tổng quan về các thách thức chính khi xây voice agent. Phần của Daniel là một demo hands-on, để các khái niệm cụ thể hơn, và hy vọng người xem có thể đưa một phần bài học vào pipeline voice agent của chính mình.
Thứ họ sẽ đi qua là Pipecat turn detection demo, một repository đơn giản mà hai người đã tạo. Có ba ví dụ:
- Một ví dụ chỉ có silence detection.
- Một ví dụ dùng turn detection có sẵn trong model speech-to-text.
- Cuối cùng là model Smart Turn mở.
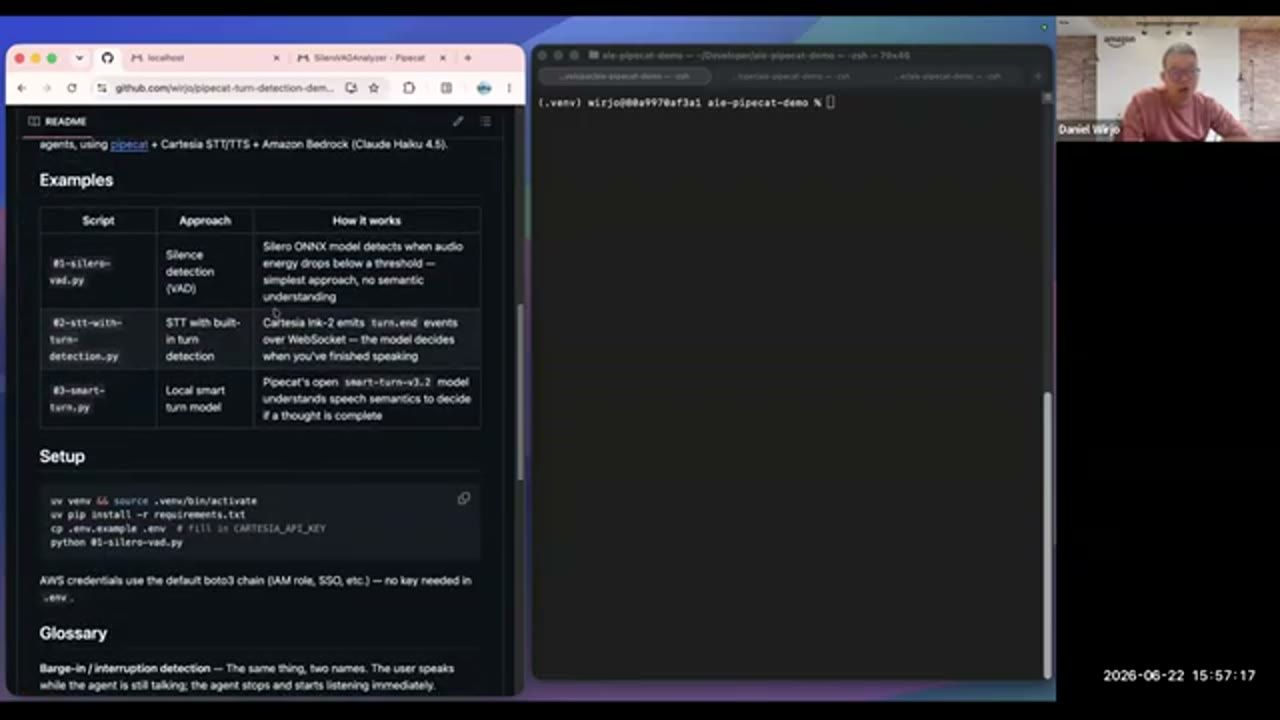
01-silero-vad.py dùng model Silero ONNX phát hiện khi năng lượng audio xuống dưới ngưỡng, cách đơn giản nhất, không hiểu ngữ nghĩa. 02-stt-with-turn-detection.py dùng Cartesia Ink-2 phát sự kiện turn.end qua WebSocket, để model quyết định khi bạn nói xong. 03-smart-turn.py dùng model smart-turn-v3.2 mở của Pipecat, hiểu ngữ nghĩa lời nói để quyết định một ý đã trọn chưa. Phần Setup: tạo venv bằng uv, cài requirements, chép .env.example thành .env và điền CARTESIA_API_KEY, rồi chạy python 01-silero-vad.py; credential AWS lấy từ chuỗi mặc định của boto3 (IAM role, SSO...), không cần key trong .env. Phần Glossary định nghĩa barge-in, hay interruption detection: user nói khi agent vẫn đang nói, agent dừng lại và bắt đầu nghe ngay.Daniel nói ví dụ thứ ba đặc biệt hữu ích khi bạn muốn toàn quyền kiểm soát voice pipeline của mình, ví dụ vì lý do compliance, hoặc khi bạn muốn fine-tune và tùy biến turn detection model của riêng mình dựa trên dữ liệu của chính bạn.
Setup của repo, như trong README:
uv venv && source .venv/bin/activate
uv pip install -r requirements.txt
cp .env.example .env   # fill in CARTESIA_API_KEY
python 01-silero-vad.py
16. Demo 1: chỉ có silence detection
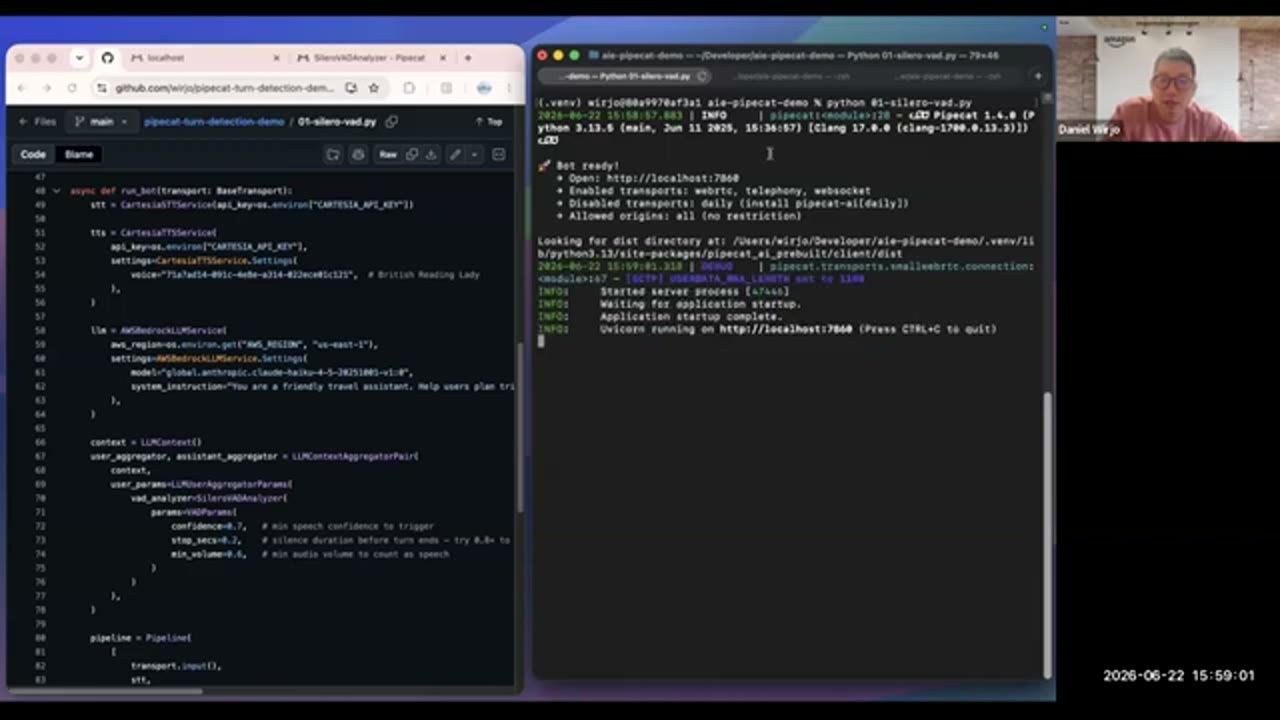
01-silero-vad.py: STT và TTS là CartesiaSTTService và CartesiaTTSService (giọng được chú thích là "British Reading Lady"), LLM là AWSBedrockLLMService chạy Claude Haiku 4.5 với system instruction "You are a friendly travel assistant…", và SileroVADAnalyzer với VADParams gồm confidence, stop_secs, min_volume. Bên phải, terminal báo bot đã sẵn sàng và server chạy ở localhost.Daniel mở source code của ví dụ đầu. Dùng Silero trong Pipecat khá dễ: chỉ cần import các thư viện liên quan, rồi có thể cấu hình tham số. Anh nói mình chưa chỉnh tham số nào, đây là giá trị mặc định, nhưng bạn có thể đổi chúng: confidence để kích hoạt, thời gian im lặng trước khi kết thúc lượt, và âm lượng tối thiểu để tính là tiếng nói.
Phần voice pipeline thì khá chuẩn: một model STT, một LLM và một model TTS. STT là model của Cartesia. TTS cũng vậy, dùng model Sonic, với một giọng nghe như một quý cô người Anh. Còn LLM, tức "bộ não" của voice agent, là model Claude Haiku của Anthropic.
Một điểm hay của Pipecat nếu bạn chưa dùng: nó dựng được một môi trường prototype tại chỗ, rất tiện để nghịch với pipeline voice agent của bạn. Daniel bật ví dụ, môi trường phát triển local hiện lên. Trước khi kết nối với voice agent, anh tắt mic phòng khi chính mình vô tình ngắt lời nó. Agent sẽ mở đầu bằng một lời chào, rồi anh sẽ thử vài tương tác để xem turn detection hoạt động thế nào.
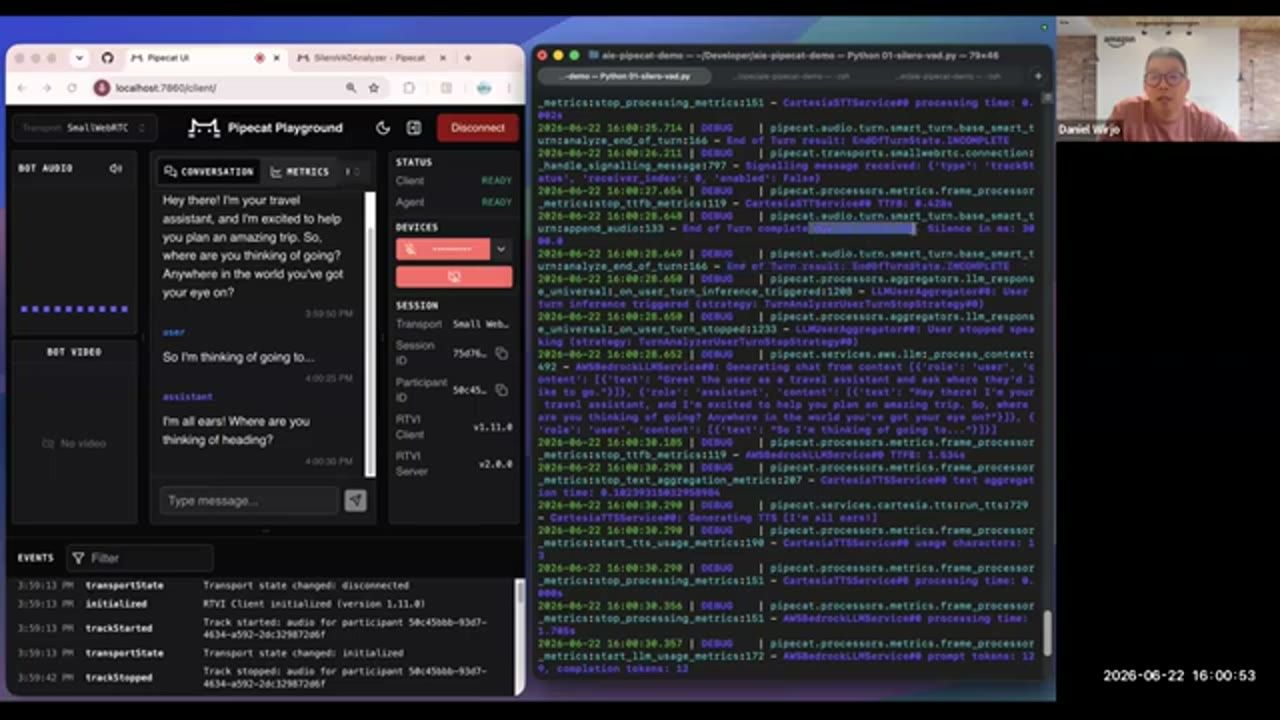
Agent chào: "Hey there. I'm your travel assistant, and I'm excited to help you plan an amazing trip. So where are you thinking of going? Anywhere in the world you've got your eye on." Bên phải là terminal với log thời gian thực để xem chuyện gì đang diễn ra.
Daniel giả vờ đang nghĩ về điểm đến: "So I'm thinking of going to, um…". Agent chen ngay: "I'm all ears. Where are you thinking of heading?"
Như mọi người thấy, anh còn chưa nói hết câu mà voice agent đã trả lời. Trong debug log có một dòng end of turn complete. Lý do là tham số stop_secs, ở đây có vẻ đang đặt 300 mili giây, nên hệ thống đã kết thúc lượt. Đây đúng là giới hạn của Level 1 mà Chintan mô tả: một quãng ngừng để nghĩ bị hiểu thành câu đã xong.
17. Demo 2: turn detection trong STT
Daniel tắt server local, dọn màn hình, refresh trang, rồi chạy ví dụ thứ hai. Lần này họ dùng một model speech-to-text có turn detection, để xem voice agent cư xử ra sao. Anh thử lại đúng ví dụ cũ, và lại tắt mic trước.
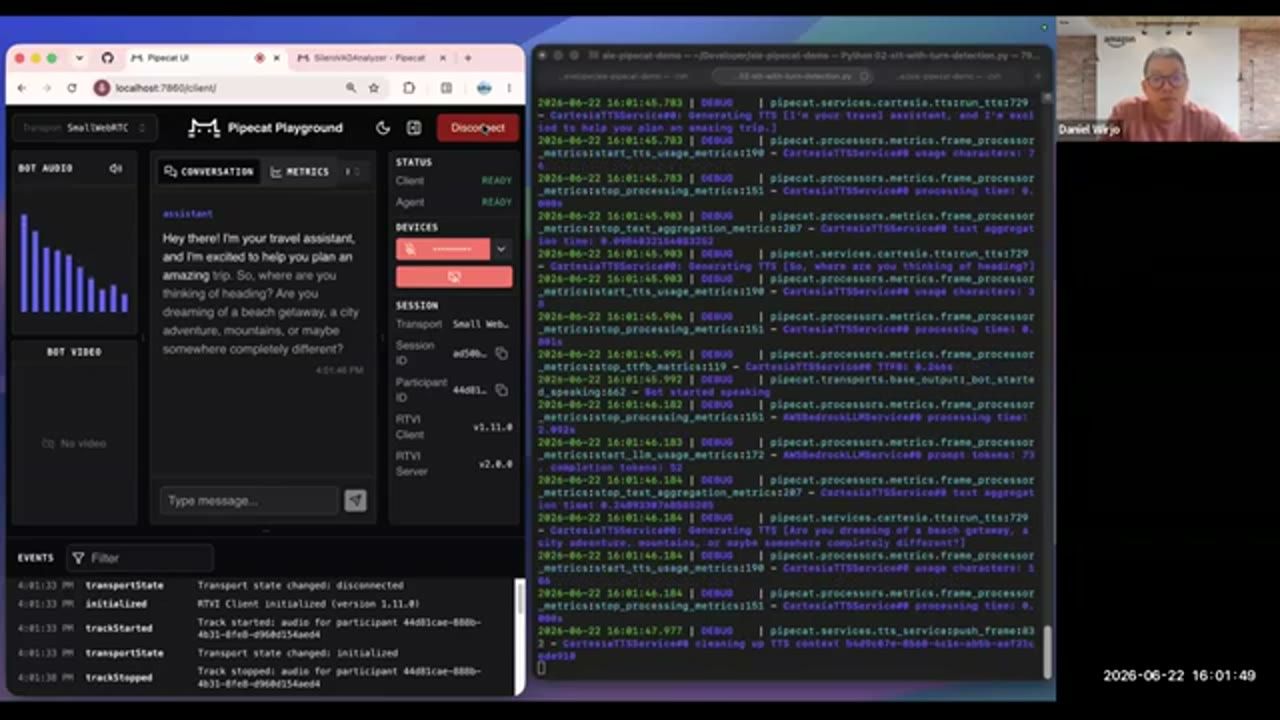
Agent chào: "Hey there. I'm your travel assistant, and I'm excited to help you plan an amazing trip. So where are you thinking of heading? Are you dreaming of a beach getaway, a city adventure, mountains, or maybe somewhere completely different?"
Daniel nói: "Hi, I'm thinking of going to, um…" và dừng ở đó. Lần này model khá thông minh: nó phát hiện được lượt nói chưa xong. Anh mở debug log để xem nó có phát ra các turn-taking event không. Đúng là model Cartesia Ink có phát các turn event, và lượt nói chưa được đánh dấu hoàn tất, nên agent chưa trả lời gì.
Anh bật mic lên, nói tiếp và đưa ra điểm đến: "So, Sydney." Agent đáp: "Oh, Sydney is fantastic. You're gonna have such a great time there. Are you thinking about when you'd like to go? And how long are you planning to stay? That'll help me figure out the best flights and hotels for you."
Khi model nhận ra đó là một câu đầy đủ, nó mới trả lời. Nhưng Daniel lưu ý: trong thực tế bạn cũng nên kết hợp thêm silence detection ở đây. Lúc nãy anh đã im khá lâu, vì đang tắt mic, và trong thực tế có lẽ bạn muốn voice agent lên tiếng sau một quãng im như vậy. Voice activity detection, hay silence detection, cũng hữu ích để ngắt lời voice model, tức cái gọi là barge-in. Đây chỉ là demo nhanh; trong thực tế bạn có lẽ sẽ kết hợp cả turn detection model lẫn silence detection.
18. Demo 3: Smart Turn chạy tại chỗ
Ví dụ cuối là model Smart Turn. Daniel nói nó sẽ cư xử khá giống ví dụ vừa rồi, chỉ khác là model chạy trên máy local của bạn, hoặc trên một môi trường GPU nếu bạn muốn deploy nó lên cloud. Anh dọn màn hình cho đỡ rối, refresh, chạy ví dụ Smart Turn, và tắt mic thêm lần nữa.
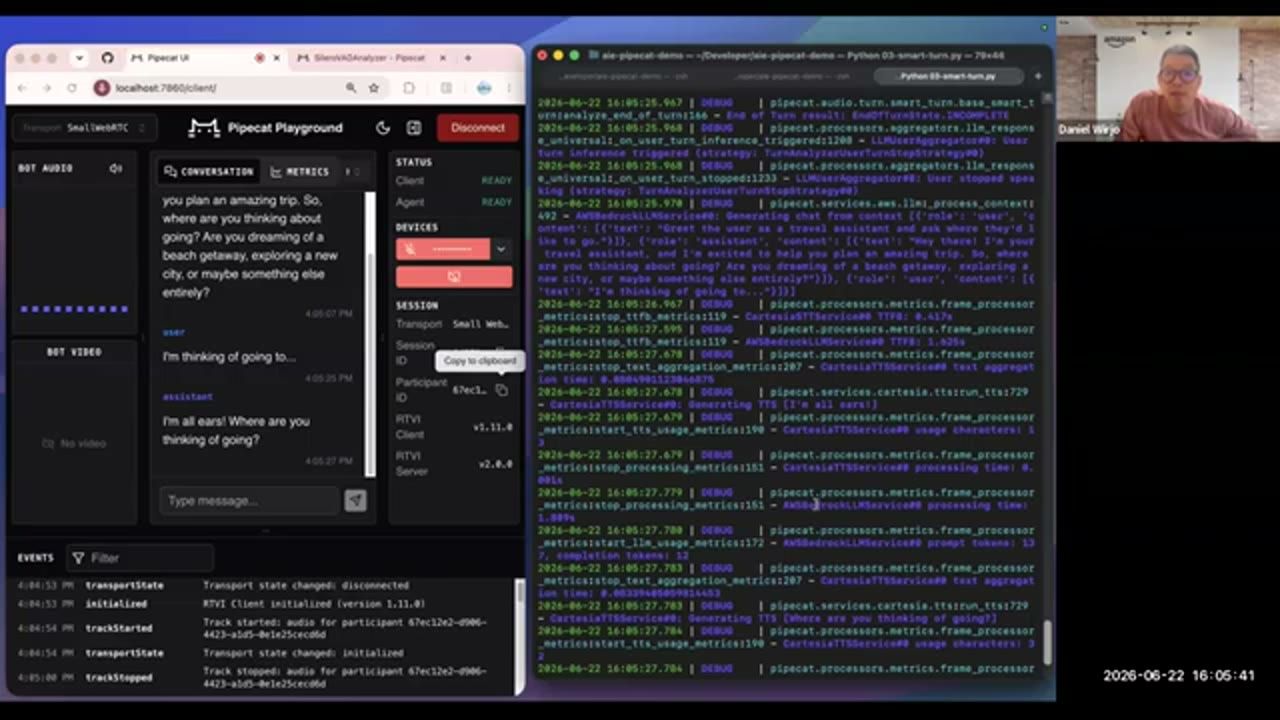
Agent chào: "Hey there. I'm your travel assistant, and I'm excited to help you plan an amazing trip. So where are you thinking about going? Are you dreaming of a beach getaway, exploring a new city, or maybe something else entirely?"
Daniel: "I'm thinking of going to, um…". Agent: "I'm all ears. Where are you thinking of going?"
Anh xem log, nơi có cả silence detection (được tích hợp trong ví dụ này) lẫn turn detection model. Smart Turn không coi là anh đã nói xong: trạng thái end of turn là incomplete. Nhưng lượt nói vẫn kết thúc, vì khoảng im lặng anh tạo ra. Đã có một quãng im, nên hệ thống đi tiếp sang lượt kế. Đây chính là cơ chế lưới an toàn của Level 3: Smart Turn không tự tin, timer của VAD vẫn kết thúc lượt.
Tiếp theo, anh thử nói một câu trọn vẹn để xem Smart Turn local có nhận ra không: "I'm actually thinking of, um, going to Sydney." Agent đáp: "Oh, Sydney's fantastic. I'd love to help you plan that trip. So tell me, what time of year are you thinking about going, and how long are you planning to stay? Also, are you traveling solo, with a partner, or with family?"
Voice agent trả lời ngay khi anh nói xong câu. Nhưng đó là cố ý, hay là do Smart Turn phát hiện? Daniel tìm các dòng debug của Smart Turn. Anh xin lỗi vì phần highlight khó đọc, nhưng về cơ bản dòng đó nói trạng thái end of turn là complete, và Smart Turn phân loại rằng xác suất câu đã trọn rất cao, nên có thể chuyển sang lượt tiếp.
Daniel khép lại: đó, gói gọn, là cách turn detection hoạt động, và hy vọng phần demo có ích.
Sources and links
- Trang talk trên ai.engineer · Video gốc
- wirjo/pipecat-turn-detection-demo: repo ba ví dụ dùng trong demo
- Pipecat: framework mã nguồn mở cho voice agent thời gian thực
- pipecat-ai/smart-turn: model Smart Turn mở, license BSD-2
- Silero VAD: model voice activity detection dùng ở Level 1
- Voice AI benchmarks: trang benchmark TTFT của LLM cho voice mà talk dẫn
- kwindla/aiewf-eval: benchmark hội thoại nhiều lượt làm nguồn cho biểu đồ TTFT
- Pipecat Cloud: managed hosting cho pipeline Pipecat
- Guidance for Voice Agents on AWS: reference architecture cho deployment enterprise
- LinkedIn của Chintan Agrawal: linkedin.com/in/chintan-agrawal-87a866135
Related talks
Voice In, Visuals Out: The Agony and the Ecstasy
Allen Pike · Forestwalk Labs · 13 min
Vì sao voice-in, visuals-out là UX tốt nhất cho AI, và ba trụ cột giữ phản hồi dưới một giây: model nhanh, inference chu kỳ ngắn, prefix caching ổn định.
The 100-Tool Agent Is a Trap: Scaling with Semantic Routers and JIT Context
Sohail Shaikh & Ankush Rastogi · Prosodica · 28 min
Nạp mọi tool vào prompt làm accuracy rơi từ 78% xuống 13% ở 741 tool; semantic routing (RAG cho tool) với JIT context giữ trên 83% và cắt 99% token.
The Future Is Domain-Specific Agents
Justin Schroeder · StandardAgents · 31 min
Composition over inheritance cho agent: thay vì nhồi MCP và skill vào một agent lớn, ghép nhiều agent nhỏ theo domain, tiết kiệm token, dùng được small model.