Enterprise Agents Have a Structure Problem
AI Engineer World's Fair 2026: Online Track · Video gốc
Data agent doanh nghiệp sai vì thiếu structure chứ không thiếu context: thứ bậc source of truth, context lifecycle có eval, và bài toán preference còn mở.
1. Phản xạ đầu tiên khi agent trả lời sai
Ishita Daga là machine learning engineer ở Tesla, và công việc của cô là build các enterprise agent cho chính tổ chức của mình. Talk của cô có tên "Enterprise Agents Have a Structure Problem", với dòng phụ trên slide: vì sao model thông minh nhất của bạn vẫn đưa ra những câu trả lời tự tin nhưng sai.
Trước khi đi vào framework và không gian giải pháp, Ishita muốn nói về chuyện vì sao các agent này fail ngay từ đầu. Khi một agent đưa ra câu trả lời tệ, phản xạ đầu tiên của chúng ta gần như luôn là: cần một model to hơn. Cần model mới nhất. Cần một model có context thật dài để nó giữ được thật nhiều thông tin. Hoặc cần nhồi thêm thật nhiều knowledge base: thêm file .md, thêm tài liệu, thêm MCP server, thêm plugin, và đủ thứ khác.
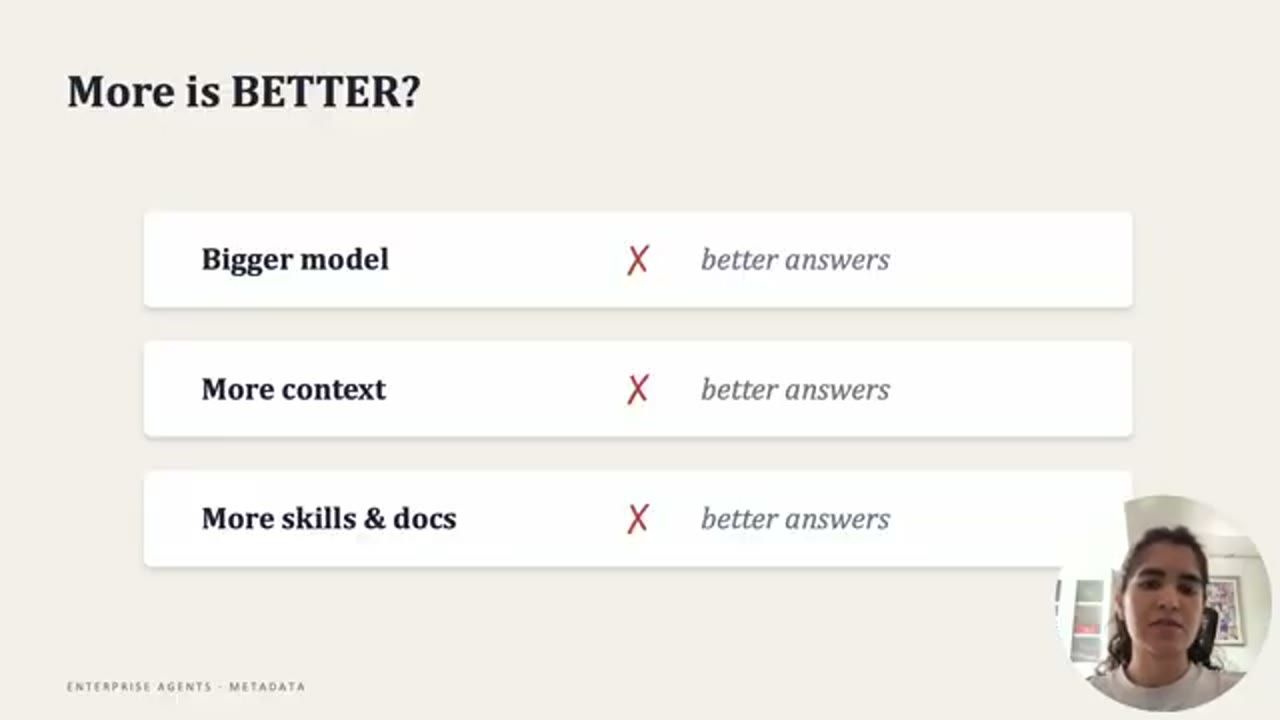
Theo Ishita, tất cả những hướng đó đều là giải pháp hợp lý, nhưng chúng không phải là câu trả lời cho việc thực sự cải thiện chính cái data agent. Ở cấp độ agent, cô thấy có ba vấn đề chính, và cả talk xoay quanh ba vấn đề này.
2. Ba vấn đề: ambiguity, staleness, preference
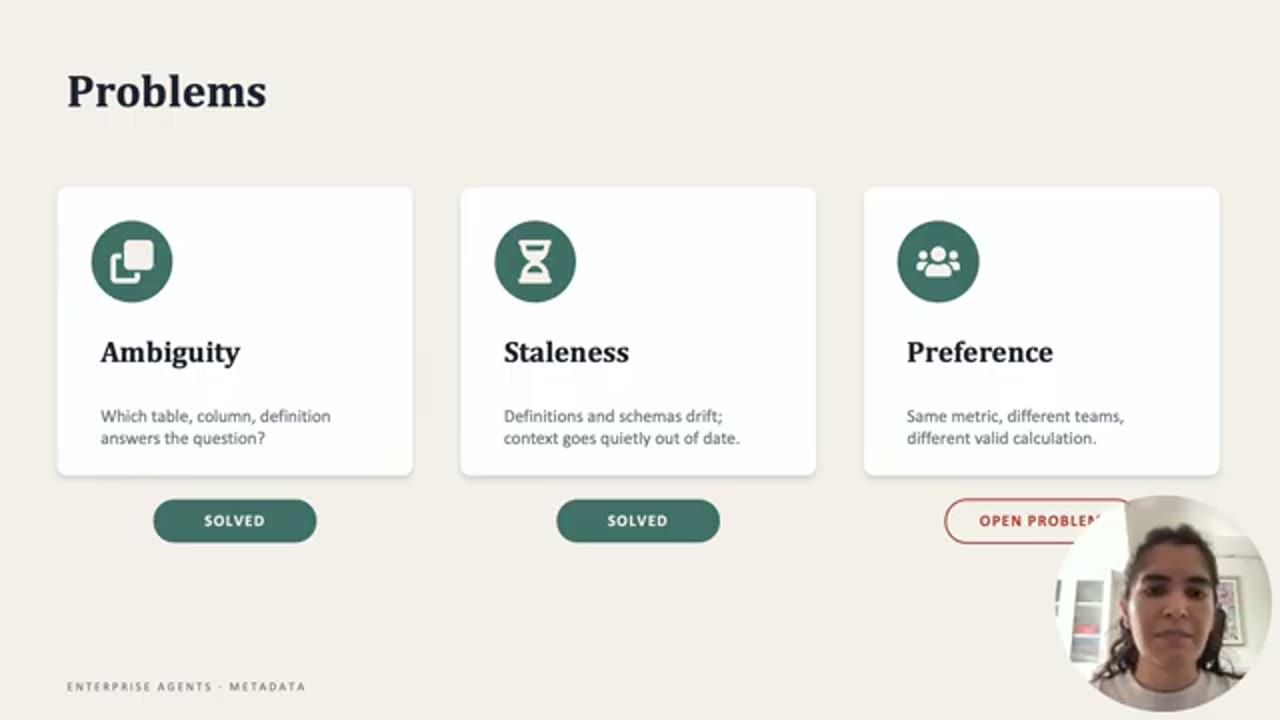
Thứ nhất là ambiguity (sự mơ hồ). Agent không biết table nào là đúng, column nào là đúng, phải truy cập data source hay knowledge base nào vào lúc nào. Nó không biết nguồn nào giữ source of truth, tức thông tin sạch nhất, và nguồn nào thì linh hoạt hơn một chút. Doanh nghiệp có rất nhiều knowledge base như vậy, nhưng không ai định nghĩa nguồn nào tốt nhất, hay nguồn nào dùng trong trường hợp nào. Ishita coi ambiguity là một vấn đề lớn.
Thứ hai là staleness (sự lỗi thời). Ai cũng biết context thay đổi nhanh đến mức nào. Rất nhiều quyết định thay đổi, rất nhiều definition và KPI thay đổi liên tục, các quy trình (process) cũng được cập nhật thường xuyên. Muốn data agent giữ được độ chính xác, ta phải cập nhật context này, phải quản lý được vòng đời của context (context lifecycle). Đó là phần thứ hai của bài toán.
Cuối cùng là preference (sở thích, thói quen riêng). Đây là việc nắm bắt preference của một cá nhân hay một team: dùng metric nào để trả lời một câu hỏi cụ thể, viết query thế nào, hay dùng filter nào trong query. Ngay cả khi đã có một canonical query, mỗi team vẫn có preference riêng về filter hay definition. Ishita cho rằng đây là một vấn đề rất mở, vẫn cần nhiều nghiên cứu, và nhiều công ty trong ngành cũng như các frontier lab đang tìm cách giải nó.
3. Ambiguity: source of truth là một hierarchy
Bắt đầu với vấn đề đầu tiên. Agent cần hiểu nên dùng source of truth nào, hay knowledge base nào. Nó không thể đặt trọng số ngang nhau cho mọi knowledge base. Việc nó chọn nguồn nào để trả lời một câu hỏi cụ thể cần có thêm structure.
Quan điểm của Ishita: source of truth thực ra là một hierarchy (một thứ bậc). Thứ bậc này đi từ nguồn sạch nhất, kém linh hoạt nhất, tới nguồn lộn xộn nhất nhưng linh hoạt nhất, động nhất. Và cách để trả lời bất kỳ câu hỏi nào là đi từ nguồn sạch nhất xuống dần tới nguồn động nhất: thử nguồn sạch trước, chỉ khi nó không trả lời được mới đi xuống nguồn linh hoạt hơn.
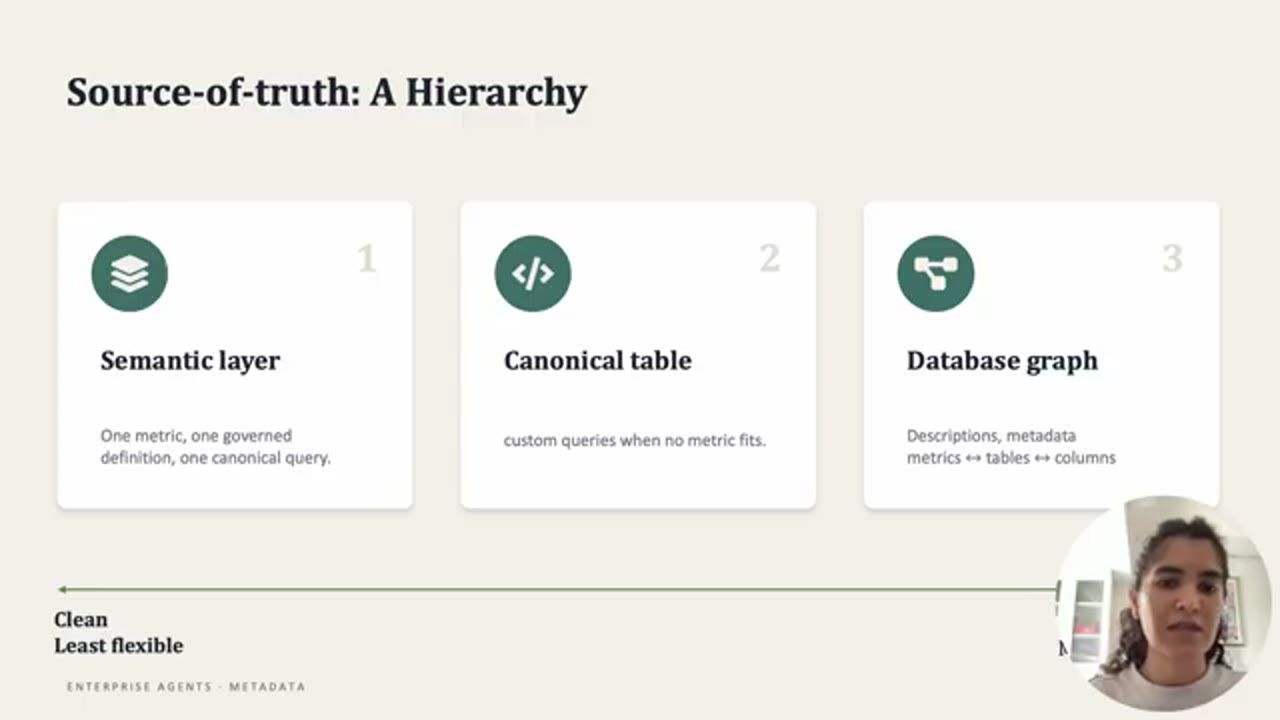
Trong framework này, các source of truth được chia thành ba nhóm (bucket). Phần tiếp theo đi lần lượt qua từng nhóm.
4. Semantic layer, canonical tables và database graph
Nhóm thứ nhất là semantic layer, nguồn sự thật tốt nhất. Đây là một danh sách được tuyển chọn (curated) rất kỹ gồm các query khác nhau, các KPI definition, các metric hoặc cách tính một metric, các business definition, tất cả gom lại vào đúng một semantic layer mà model có thể dùng để trả lời câu hỏi. Agent chỉ cần nhìn vào semantic layer, tìm KPI gần nhất với câu hỏi, rồi tham chiếu mọi data point gắn với KPI đó để đưa ra câu trả lời. Các công cụ như dbt Semantic Layer là ví dụ của kiểu lớp này.
Nhóm thứ hai là canonical tables. Ishita gọi chúng là parametric tables rồi tự sửa lại: đúng hơn là các parametric query. Bạn đưa cho agent cả một danh sách các parametric query khác nhau, và agent cố hiểu xem query nào nó có thể dùng để trả lời câu hỏi của bạn. Cách này cho agent nhiều linh hoạt hơn: nó được chọn, hoặc tự viết query và filter của riêng nó, và trả lời được một tập câu hỏi rộng hơn.
Nhóm cuối là database graph. Ishita thấy đây là nhóm khó nhất, vì nó tốn rất nhiều công sức, nhưng đổi lại cho bạn rất nhiều linh hoạt về loại câu hỏi có thể trả lời. Ý tưởng là nối mỗi table với tất cả các column của nó, nối mỗi table với các metric có thể trả lời từ table đó và ngược lại, để tạo ra một database graph khổng lồ đưa cho agent, rồi agent trả lời hay query dựa trên graph đó. Nhưng ngoài việc khó làm, nó còn rất khó bảo trì và cập nhật.
Vì vậy lời khuyên của Ishita cho doanh nghiệp đang bắt đầu xây hay bổ sung source of truth là: hãy làm lớp thứ nhất và lớp thứ hai trước. Hai lớp này dễ dựng, và theo cô chúng giải được khoảng 80% vấn đề. 20% còn lại mới cần tới database graph.
5. Staleness: context bị mục và context lifecycle
Vấn đề thứ hai là staleness, và Ishita nói cái tên đã tự giải thích. Context bị mục (rotten), bị deprecated, hoặc quy trình thay đổi thường xuyên đến mức rất khó duy trì các file .md, hay liên tục cập nhật skill với context mới nhất. Việc đó đơn giản là không dễ, và ta cần một giải pháp tốt hơn.
Câu trả lời của cô là xây một context lifecycle (vòng đời của context), gồm hai thành phần.
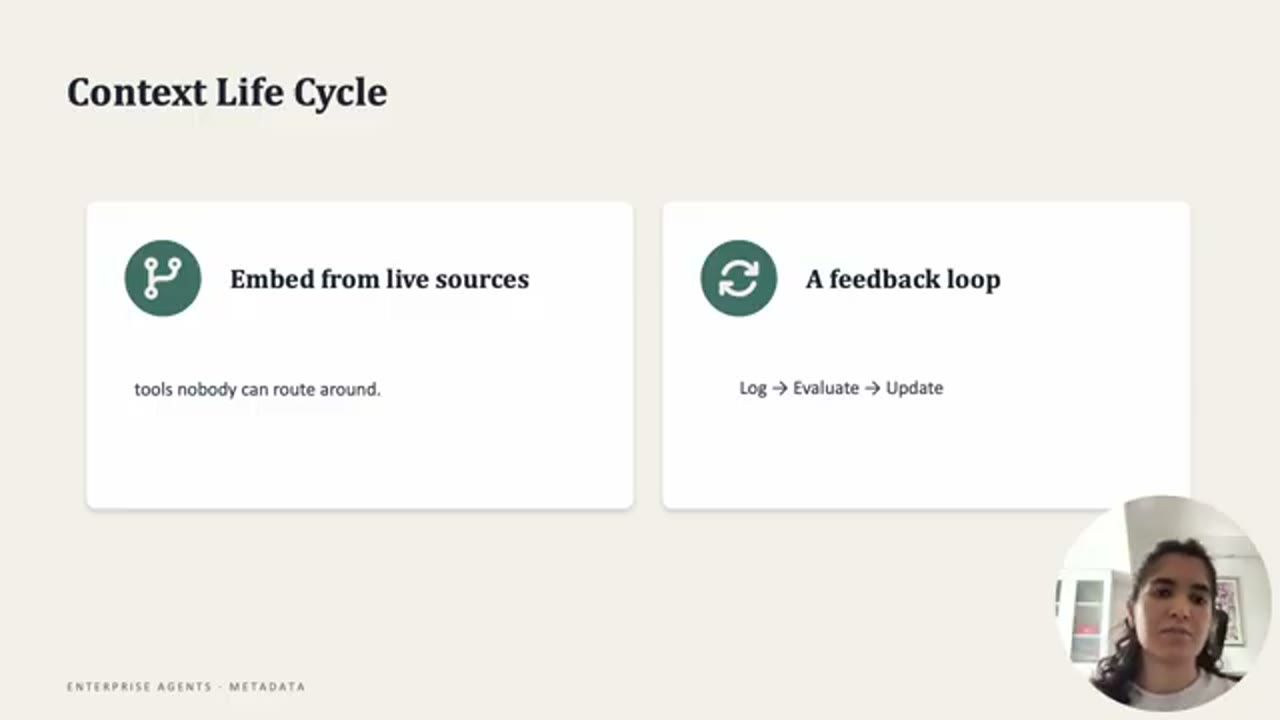
Thành phần thứ nhất là embed các data source hay knowledge source "sống". "Sống" ở đây nghĩa là những nguồn dữ liệu luôn được cập nhật, được review và được curate cẩn thận, và luôn cung cấp dữ liệu mới nhất. Nó có thể là GitHub của bạn, các công cụ CRM, hoặc các semantic layer trong Tableau hay dbt. Bạn muốn đưa nguồn nào vào cũng được, nhưng đó phải là một nguồn bắt buộc (mandatory), tức nguồn dữ liệu được cập nhật thường xuyên nhất. Ghi chú trên slide nói gọn ý "nguồn bắt buộc" này: đó là những công cụ mà không ai có thể đi vòng qua.
6. Feedback loop: log, evaluate, update
Thành phần thứ hai là feedback loop, thứ mà Ishita thấy rất nhiều enterprise agent hay data agent bỏ sót. Ý tưởng là bạn phải log được từng sự kiện (event) một. "Event" ở đây là mỗi khi có người nói rằng database này sai, hay definition này sai hoặc đã lỗi thời, hay có một cách mới để tính một metric, hay có một filter mới cần dùng. Tất cả những event đó cần được bắt lại, log lại, và dùng để cập nhật context của data agent.
Khi đã bắt được các event, bước tiếp theo là thực sự evaluate data agent. Có hai cách:
- Curate một evaluation suite gồm các câu hỏi do con người gán nhãn (human-annotated), hoặc các đánh giá do con người làm.
- Tạo một quy trình evaluation tự động: lấy toàn bộ câu hỏi được hỏi trong vài ngày gần đây cùng các câu trả lời thực tế, rồi đo xem câu trả lời mới gần với câu trả lời thực tế đến đâu.
Có rất nhiều cách để làm việc này, nhưng theo Ishita rất nhiều team không chú trọng evaluation, và đó chính là lý do agent hay fail đến vậy: bạn không biết agent đang tiến bộ ra sao, hiệu năng của nó thế nào, vì bạn không theo dõi nó. Nên cô cho rằng việc dựng feedback loop, hay context loop này, nơi bạn log, evaluate và cập nhật context đều đặn, là cực kỳ quan trọng.
7. Preference: cùng một câu hỏi, hai cách tính đều đúng
Vấn đề cuối cùng là preference, một vấn đề rất chủ quan, vì preference thay đổi thường xuyên: nên dùng loại metric nào, đâu là cách tính đúng. Các team khác nhau sẽ tính cùng một metric theo những cách khác nhau, hoặc dùng cùng một query nhưng với filter khác nhau. Có rất nhiều tính chủ quan cần được nắm bắt, nhưng làm điều đó ở cấp cá nhân hay cấp team lại rất khó.
Ishita đưa ra một ví dụ. Giả sử có team A và team B, cả hai đều muốn tính thời gian trung bình để hoàn thành một milestone nào đó.
- Team A tính từ lúc milestone trước hoàn thành tới lúc milestone hiện tại hoàn thành.
- Team B tính từ lúc milestone hiện tại bắt đầu tới lúc milestone kế tiếp bắt đầu.
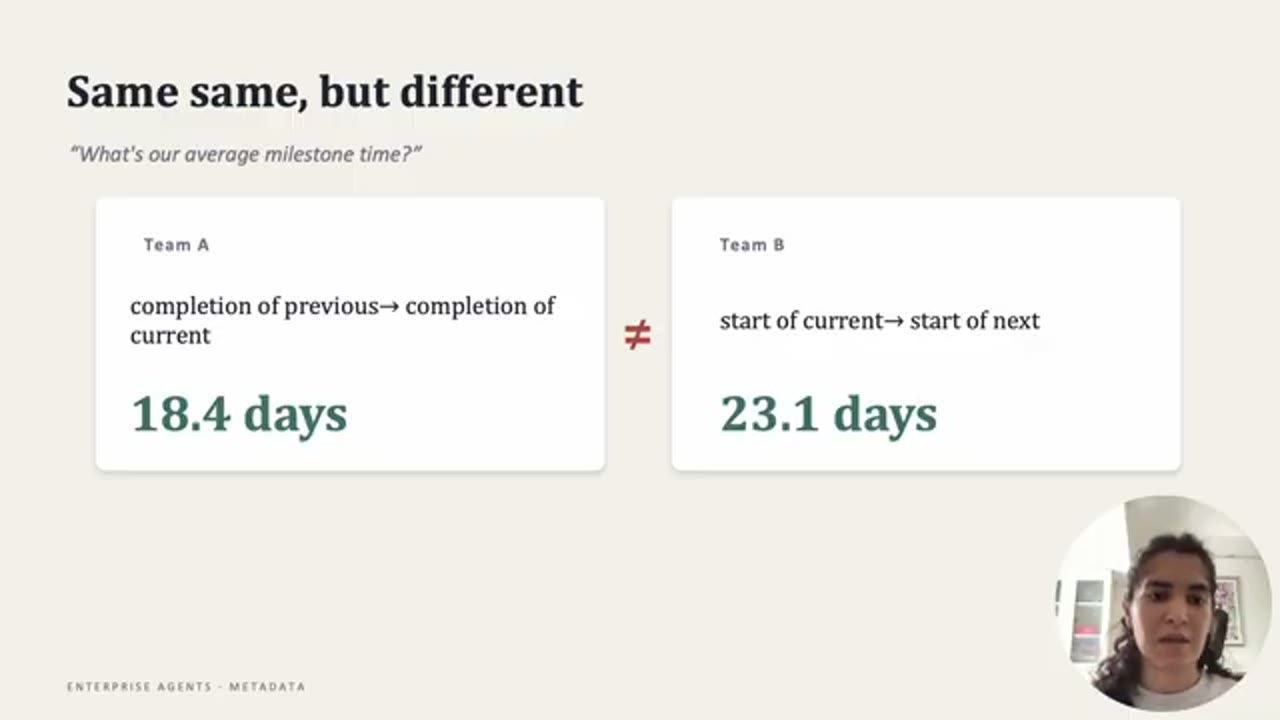
Cả hai đều là metric đúng, hay là cách tính đúng, nhưng chúng sẽ cho ra những câu trả lời rất khác nhau, và sự khác biệt chỉ nằm ở preference. Điều ta cần là hiểu một người cụ thể muốn nói gì khi họ hỏi: "Thời gian trung bình của một milestone là bao nhiêu?"
Đây là một câu hỏi rất hay, và Ishita thấy ngành vẫn chưa có câu trả lời đúng, chưa có cách đúng để giải chính bài toán này.
8. Semantic layer, agent memory và bài toán routing
Ishita thấy có đại khái hai cách để giải bài toán preference.
Cách thứ nhất là semantic layer, cũng là cách cô đang thử: lưu tất cả các cách khác nhau để tính một metric vào semantic layer, rồi mỗi người tự prompt model để chọn cách mình muốn dùng. Bạn giải được bài toán theo cách này, nhưng nó vẫn không lưu được preference của người dùng. Và bạn lại đụng vào thử thách thứ nhất, ambiguity: agent không biết metric nào là metric đúng, bạn vẫn phải prompt cho nó.
Cách thứ hai là agent memory, ví dụ Mem0, hoặc lưu memory vào một file memory.md. Nhưng đây vẫn chưa phải cách tốt nhất. Nó lưu được preference của bạn, nhưng không hiểu được sự khác biệt giữa hai metric khác nhau, hay metric nào dùng vào lúc nào.
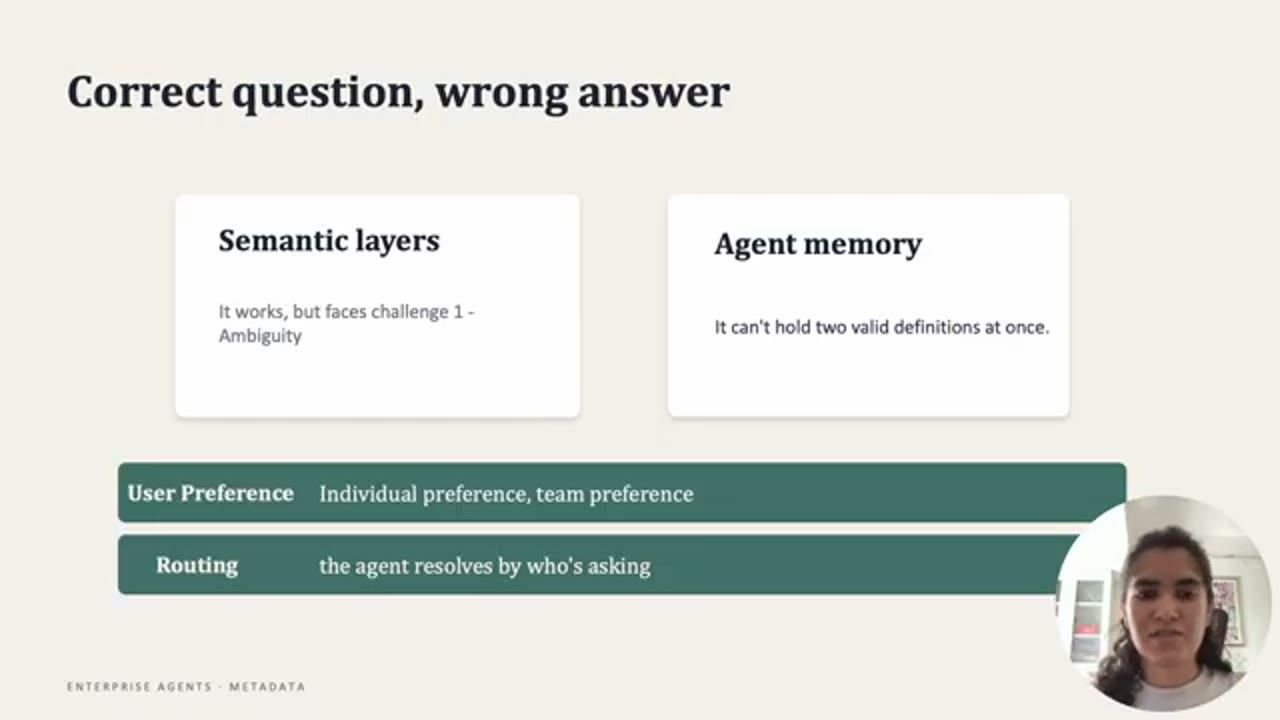
Nên theo Ishita, có những cách để xử lý, nhưng chưa cách nào thực sự giải được chính bài toán preference. Điều ta thực sự muốn là một cách để route agent tới đúng metric, dựa trên ai đang dùng agent đó: team nào, hay cá nhân nào. Đây vẫn là một vấn đề mở, nhưng theo cô là thứ cộng đồng nên làm và nghiên cứu thêm.
9. Context không phải vấn đề, structure mới là vấn đề
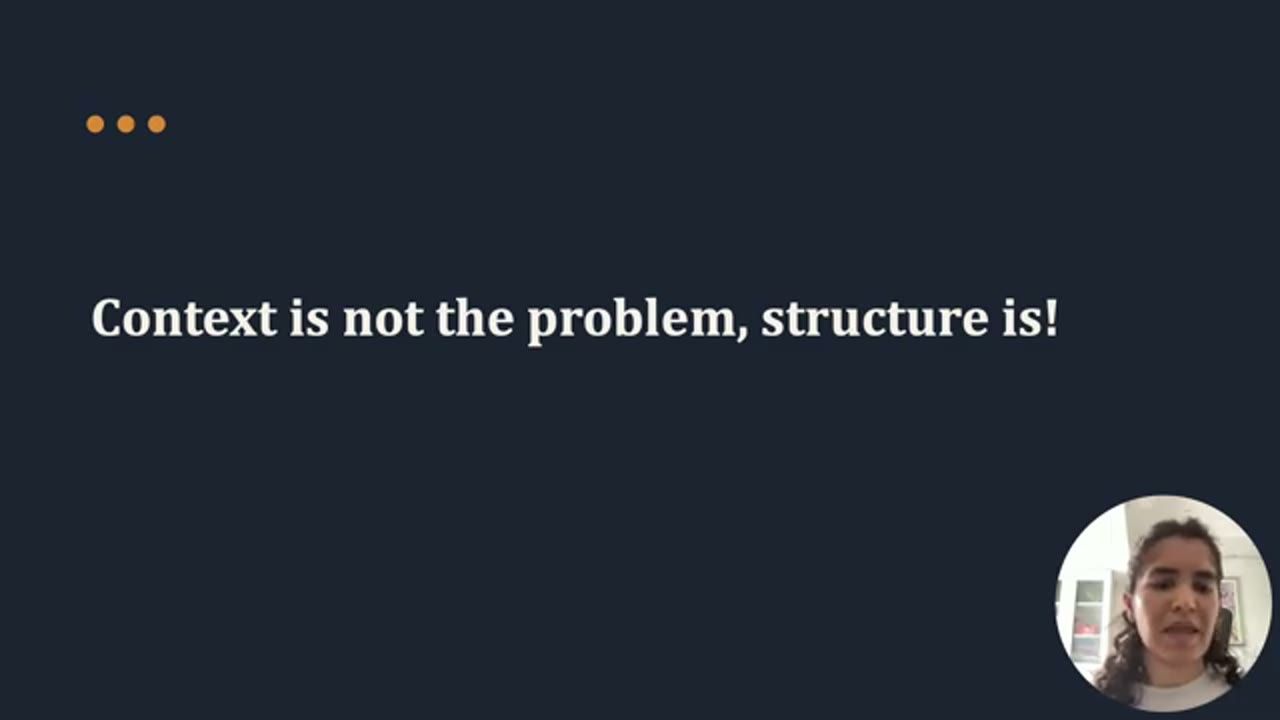
Để kết lại, Ishita tóm tắt ba vấn đề lớn: ambiguity, staleness và preference. Thứ ta thực sự cần giải là một structure tốt hơn cho các nguồn sự thật, và một cách tốt hơn để quản lý context và evaluate context. Còn preference là một vấn đề rất mở. Nó không chỉ đòi hỏi hiểu agent hoạt động thế nào, mà còn phải nhúng được preference của từng cá nhân vào, giống như tạo ra một "hive mind" (bộ não chung) cho data agent của bạn.
Thông điệp chung của cả talk nằm trên slide cuối: khi data agent trả lời sai, đừng vội thêm context hay đổi sang model to hơn. Hãy nhìn vào structure: agent có biết tin nguồn nào trước không, context của nó có được giữ cho mới không, và nó có biết ai đang hỏi không. Ishita cảm ơn mọi người và khép lại talk.
Sources and links
- Trang talk chính thức trên ai.engineer · Video gốc
- dbt Semantic Layer: một dạng semantic layer định nghĩa metric một lần cho mọi công cụ dùng chung
- Tableau (tableau.com): một trong các nguồn "sống" được nhắc tới
- Mem0: memory layer cho AI agent
- Model Context Protocol (MCP)
Related talks
Semantic Blindness: 500,000 Sensors Confused an LLM
Raahul Singh & Vanč Levstik · Phaidra · 16 min
Vì sao LLM gãy khi phải đọc 500 nghìn tên thiết bị, và cách Phaidra để LLM chỉ lập plan còn code tra cây: 100% chính xác, ít token hơn 300 lần.
When Agents Meet Physical Data: The Other Physics of Agent Harnesses
Dmitry Petrov · DataChain · 28 min
Vì sao coding agent hỏng với video và sensor data, và cách dựng data harness bốn phần: see, run, verify, remember, với demo DataChain và Claude Code.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.