Gemini 4 Argon ra mắt và những gì OpenAI công bố ở DevDay
Wes Roth đọc kết quả ban đầu của Gemini 4 Argon, bảng benchmark Google công bố, rồi điểm qua Dots, Ultrafast, Decisions API và plugin ở OpenAI DevDay.
✓ Đã duyệt độc lập · cập nhật 18/11/2026 · 32 min
1. Có vẻ Google đã trở lại: Gemini 4 Argon ra mắt
Wes Roth mở đầu: có vẻ như Google đã trở lại, và những lời đồn về sự suy tàn của Google đã bị thổi phồng quá mức (theo Wes, video đăng ngày 01/10/2026). Hôm đó Google ra mắt Gemini 4 Argon, được giới thiệu là "the next era of frontier intelligence".
Đáng tiếc là, theo Wes (video đăng ngày 01/10/2026), model này mới giới hạn cho các trusted partner, nên phần lớn chúng ta chưa dùng được ngay. Nhưng các benchmark ban đầu thì rất ấn tượng. Cùng lúc đó OpenAI vừa tổ chức DevDay với rất nhiều thứ được công bố, và trong video này anh xem cả hai.
Trước hết là Gemini 4 Argon. Theo Wes (video đăng ngày 01/10/2026), model đang được đưa tới các trusted cyber defender qua chương trình Fairwind. Thoạt nhìn nó rất mạnh và có vẻ rất cạnh tranh với tất cả các model khác ở tầm frontier.
Anh nói rõ (video đăng ngày 01/10/2026): không phải chuyện nó đánh bại tất cả mọi người, đây không phải "universal leadership across the board" hay gì kiểu vậy. Nhưng nó ở đó, ngay đầu nhóm, ngang ngửa với tất cả các model còn lại.
Google giới thiệu Argon với giá khởi điểm (introductory price) 2 đô cho mỗi triệu input token và 10 đô cho mỗi triệu output token; Wes nói anh không nghĩ mức giá này sẽ kéo dài (theo video đăng ngày 01/10/2026). Trang Google anh mở cũng ghi thêm rằng cached input token được giảm 95% so với giá input token.
2. Tối ưu thuật toán lượng tử, AlphaEvolve và những khoản tiết kiệm
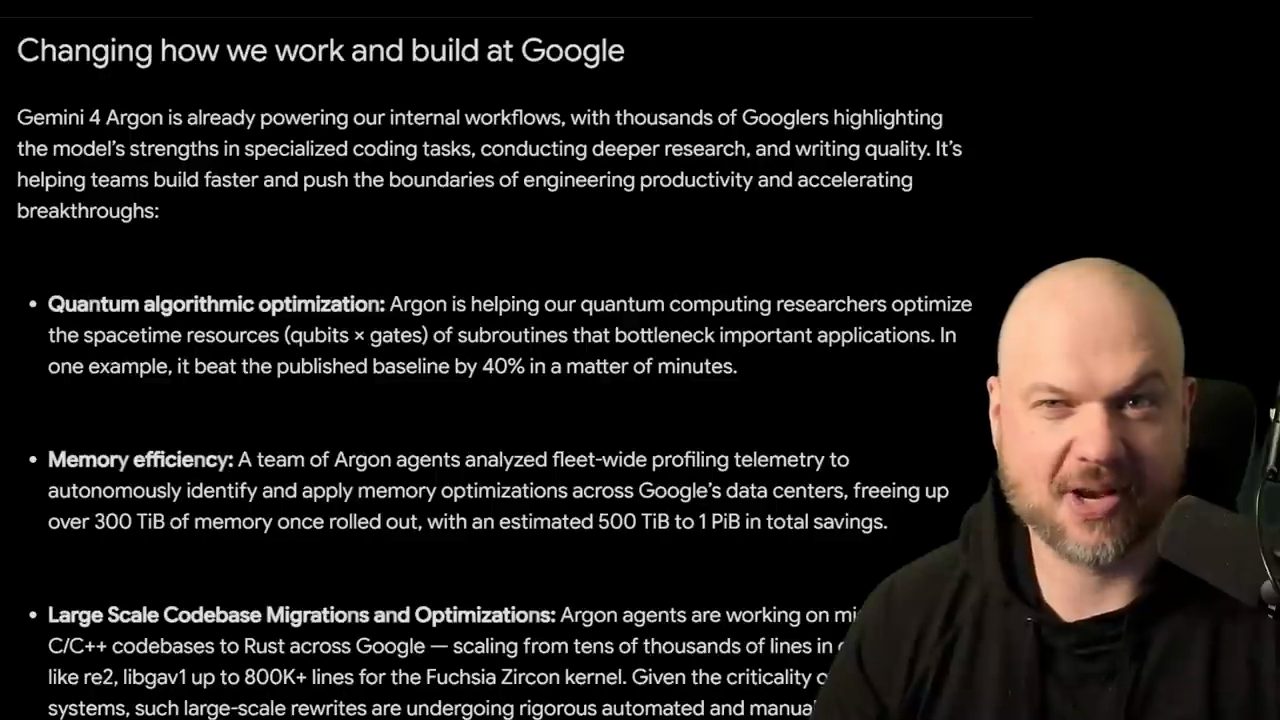
Theo Wes (video đăng ngày 01/10/2026), ở bên trong Google, Gemini 4 Argon đang giúp các tác vụ nghiên cứu thật. Ví dụ thứ nhất là quantum algorithmic optimization: giúp các nhà nghiên cứu tối ưu tài nguyên spacetime. Trong một ví dụ, nó vượt published baseline 40% chỉ trong vài phút.
Wes nhắc rằng chúng ta phần nào biết Google DeepMind đã dẫn đầu trong cách áp dụng large language model vào nhiều tác vụ tối ưu quy mô lớn (theo Wes, video đăng ngày 01/10/2026). Đã có AlphaEvolve, một hệ thống đặt large language model ở trung tâm, và nó đã tối ưu nhiều tác vụ chạy ở quy mô lớn tại Google, chẳng hạn tối ưu data center và lập lịch tác vụ.
Theo anh (video đăng ngày 01/10/2026), những tối ưu đó có lẽ đã giúp Google tiết kiệm một khoản tiền thật sự đáng kể, có lẽ hàng triệu đô, dựa trên những tối ưu nhỏ xíu chỗ này chỗ kia.
Anh lưu ý (video đăng ngày 01/10/2026): trừ khi bạn làm trong ngành và hiểu nhiều về công việc của các nhà nghiên cứu quantum computing và tài nguyên spacetime, có lẽ khá khó hình dung quy mô của việc này. Nhưng điều quan trọng cần hiểu là có thể áp dụng nó cho rất nhiều thứ khác nhau, tối ưu những quy trình nhỏ chỗ này chỗ kia, trên khắp hệ sinh thái Google. Nghĩ kỹ thì đó có thể là hàng triệu, hàng chục triệu đô được tiết kiệm, quy trình được cải thiện, hiệu suất được tìm ra.
Model này cũng cải thiện đáng kể memory efficiency (theo Wes, video đăng ngày 01/10/2026).
3. Coding: chuyển C/C++ sang Rust và ví dụ libgav1
Phần tiếp theo, theo Wes, có lẽ là phần thú vị nhất, vì nhiều thứ, kiểu như cách chúng ta đánh giá các model này tốt tới đâu, phần lớn quy về coding (nhận định trong video đăng ngày 01/10/2026). Anh có cảm giác Google đã tụt lại phía sau một chút, hoặc khá nhiều, so với các AI lab frontier khác.
Anh nhắc lại (video đăng ngày 01/10/2026): chúng ta chưa có model này trong tay, nên chưa thật sự so được nó với các model khác. Vậy nên phải xem xét, đào qua các bằng chứng để thấy nó tốt tới đâu.
Nhưng theo Wes (video đăng ngày 01/10/2026), chỗ này chắc chắn cho thấy đây kiểu như là chuyện lớn: các đợt migration và tối ưu codebase quy mô lớn. Các Argon agent (Argon là model mới này) đang làm việc chuyển codebase C/C++ sang Rust trên khắp Google. Đây là một dự án khổng lồ, và là dự án quan trọng theo nghĩa không được phép có những bug nhỏ làm hỏng mọi thứ. Việc Google tin giao quy trình này cho model này, theo anh, chắc chắn có vẻ là chuyện lớn.
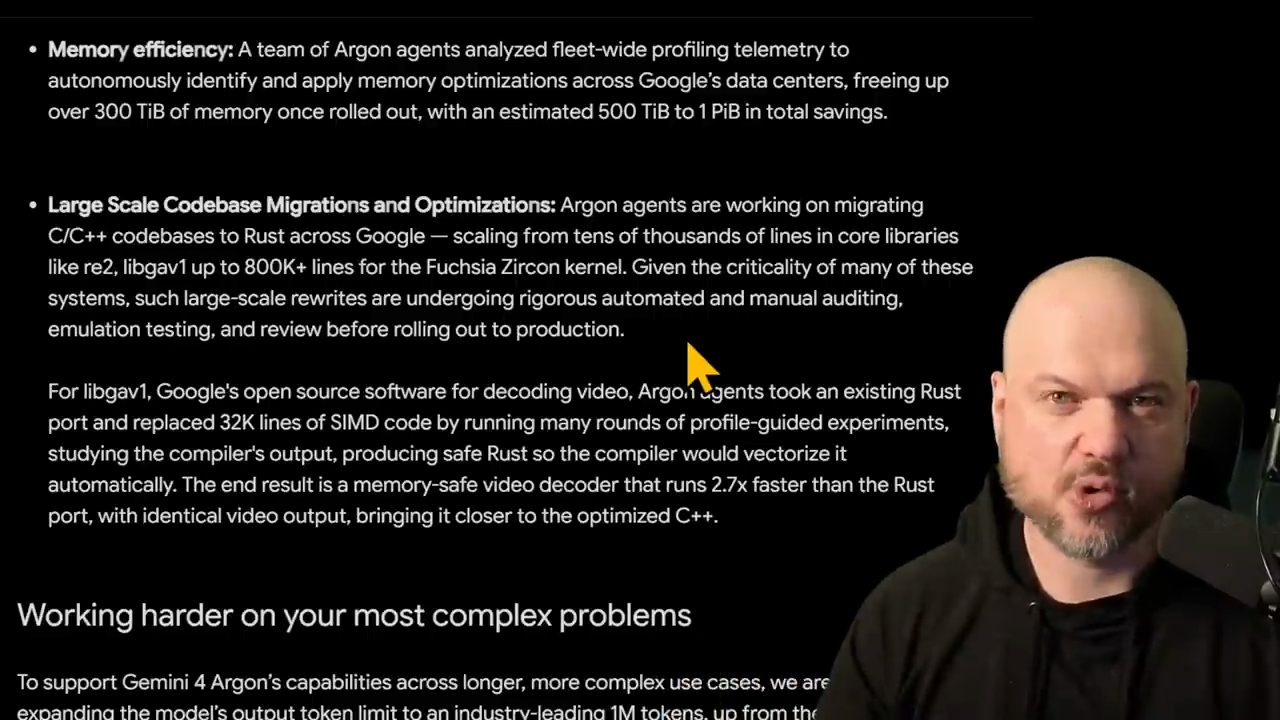
Theo lời Wes (video đăng ngày 01/10/2026), Google nói tất nhiên họ sẽ có auditing tự động và thủ công nghiêm ngặt ở quy mô lớn, emulation testing và nhiều thứ khác, chứ không phải cứ thế mà ship. Nhưng có vẻ Google có một năng lượng khác, những điều mới tìm ra về cách làm ra các model coding này. Anh nói anh nghĩ anh biết một trong những bí quyết, một "secret weapon" mà có vẻ đang sống trong một căn bếp của Google, và anh sẽ quay lại chuyện đó ngay sau đây.
Wes đọc tiếp cách các Argon agent tiếp cận việc này, hoặc có thể là một tác vụ tương tự mà nó đang làm (video đăng ngày 01/10/2026). Với LibGav1, phần mềm mã nguồn mở của Google để decode video, các Argon agent lấy một bản Rust port có sẵn và thay 32.000 dòng code bằng cách chạy nhiều vòng thử nghiệm profile-guided, nghiên cứu output của compiler, viết ra Rust an toàn để compiler tự vectorize. Trang Google anh mở ghi rõ đó là 32K dòng SIMD code, và kết quả là một video decoder memory-safe chạy nhanh hơn bản Rust port 2.7x, với video output giống hệt.
4. Các agent tự đặt giả thuyết và chạy thử nghiệm
Ý chính ở đây, theo Wes (video đăng ngày 01/10/2026), là Google đang tạo ra những "agentic swarm" nhỏ, nếu có thể gọi vậy, để tiến hành thử nghiệm. Chúng đặt giả thuyết, viết code để kiểm tra xem cái gì có thể hiệu quả hơn, nghiên cứu output, và nếu tốt thì implement.
Anh so sánh (video đăng ngày 01/10/2026): việc này giống auto researcher của Andrej Karpathy. Nếu bạn có thể đưa cho nó một tác vụ có output đo được và chỉ nói: cứ chạy tiếp, cứ nghĩ ra những thử nghiệm nhỏ, kiểm tra chúng, và đây là KPI, đây là metric mà bạn đang cố cải thiện, thì các agent này có thể chạy suốt ngày đêm theo đuổi tác vụ đó. Và tất nhiên, theo anh, kết quả là phần mềm tốt hơn, nhanh hơn, hiệu quả hơn.
Có vẻ Google thật sự đang dùng Gemini 4 để cải thiện nhiều quy trình nhỏ như vậy (theo Wes, video đăng ngày 01/10/2026). Nhưng anh nhắc lại rằng từ bên ngoài khá khó nói: Google đã thử nó trên 100 thứ khác nhau và đây là ba thứ thành công? Hay nó là kiểu chạm vào cái gì cũng làm rất tốt?
Theo Wes (video đăng ngày 01/10/2026), những điều này nghe rất, rất ấn tượng, nhưng chúng ta sẽ không biết model này tuyệt vời tới đâu cho tới khi được dùng thử.
5. Bảng benchmark Google công bố
Rồi Wes đi qua bảng benchmark trong bài của Google (video đăng ngày 01/10/2026). Bảng so Gemini 4 Argon với GPT-6 Astra, Claude Fable 5.1 và Claude Opus 5.5. Anh nói anh làm tròn các con số lên xuống để cho một ý niệm, và ý chính là model này rất, rất mạnh. Bảng dưới đây ghi các số trong bảng anh mở.
Các dòng Wes đọc, theo bảng Google công bố mà anh trích trong video đăng ngày 01/10/2026:
| Benchmark | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
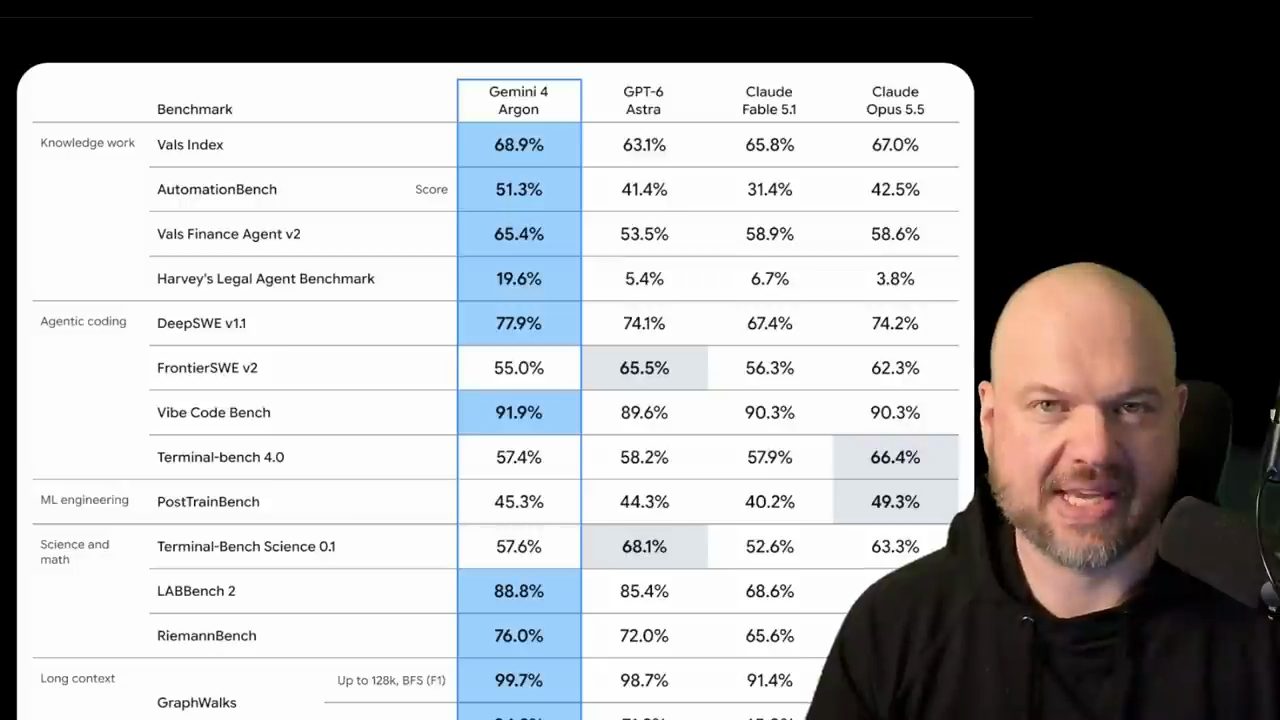
Với knowledge work, Wes đọc Vals Index của Argon so với khoảng 63 của Astra, "66, let's say" của Fable 5.1 và 67 của Opus 5.5, và nói Argon thắng ở dòng này (theo bảng anh trích, video đăng ngày 01/10/2026). AutomationBench, lại thắng, ở 51% so với 41, 31, 42% của các đối thủ. Vals Finance Agent v2 ở 65% so với 53, 58 và 58% của các đối thủ, theo anh là thắng rõ. Harvey's Legal Agent Benchmark cũng vậy: gần 20%, so với 5%, 6% và 3% của các đối thủ.
DeepSWE v1.1, Argon ở 77.9, anh gọi là 78%, còn các đối thủ ở 74, 67, 74; theo Wes đó là kết quả rất mạnh trên một benchmark rất tốt (video đăng ngày 01/10/2026). FrontierSWE v2, Argon ở 55; ở đây nó bị Astra, Fable và Opus vượt, nhưng không nhiều, theo anh nó kiểu như nằm ở giữa. VibeCodeBench thì nó thắng tất cả các model kia.
Với TerminalBench, Wes nói Argon kiểu như ở giữa, và bị Opus 5.5 vượt xa (video đăng ngày 01/10/2026); trong bảng anh mở, dòng Terminal-bench 4.0 ghi Argon 57.4%, Astra 58.2%, Fable 5.1 57.9% và Opus 5.5 66.4%. Nhưng với rất nhiều dòng, theo anh, nó làm rất, rất tốt.
Theo Wes (video đăng ngày 01/10/2026), những người dùng trả phí API trên gói Ultra sẽ là nhóm tiếp theo được dùng Argon. Anh có gói đó, nên hy vọng Google sẽ mở ra để anh thử. Bài của Google (đọc ngày 18/11/2026) ghi việc mở rộng sẽ bắt đầu với "paid API customers and Google AI Ultra subscribers".
6. Output 1 triệu token, input context và persistent memory
Theo Wes (video đăng ngày 01/10/2026), output token limit đã được nâng lên rất nhiều, gần 16 lần so với trước. Giới hạn output giờ là 1 triệu token. Bài của Google (đọc ngày 18/11/2026) ghi đó là mức "industry-leading 1M tokens, up from the previous 64K tokens".
Anh nói khi Google viết "working harder on your most complex problems", thì đó là thứ họ đang nói tới (theo Wes, video đăng ngày 01/10/2026). Và đó là một lượng output khổng lồ.
Wes giải thích ba khái niệm (video đăng ngày 01/10/2026). Input context là toàn bộ tài liệu mà model xem xét, mọi thứ bạn có thể nhét vào; nó kiểu như một workspace để model đọc qua, hiểu, cân nhắc và giữ trong context. Rồi có output budget, giới hạn lượng nội dung model có thể sinh ra trong một lượt. Và có persistent memory, giữ lại một số thông tin qua các session.
7. Artificial Analysis và chuyện bench maxing
Wes mở trang của Artificial Analysis, nơi gom các benchmark khác nhau vào một chỗ (video đăng ngày 01/10/2026). Thanh màu xanh lá là Gemini 4 Argon ở chế độ high reasoning.
Theo cách Wes đọc các biểu đồ đó (video đăng ngày 01/10/2026): với GDPval, kiểu knowledge work, khả năng làm các tác vụ thực tế, Argon nằm kiểu như ở giữa nhóm, và vượt được nhiều model GPT, nhiều model của OpenAI. AutomationBench thì thắng rõ. Terminal-Bench ở gần đầu. SciCode rất gần đầu. Humanity's Last Exam ở gần đầu. Theo anh, với nhiều bài, nó hoặc có kết quả tốt, hoặc dẫn bảng xếp hạng ở một số tác vụ.
Và đây là điểm anh muốn nói (video đăng ngày 01/10/2026): chúng ta biết một số lab trước đây đã có những trò "bench maxing", về cơ bản là train model quá mức để chắc chắn nó làm rất tốt trên các benchmark, mà không nhất thiết cải thiện model trên mọi mặt.
Theo Wes (video đăng ngày 01/10/2026), Google chưa bao giờ thật sự làm vậy. Đôi khi Google đưa một số benchmark lên trước và chọn một cách đo nhất định để cho thấy mình tốt hơn. Nhưng theo những gì chúng ta biết, Google chưa bao giờ cố "juice" các benchmark. Nên theo anh, mọi thứ trông rất, rất tốt.
8. Sergey Brin và căn micro kitchen ở Mountain View
Vậy bí quyết thành công là gì? Wes kể (video đăng ngày 01/10/2026): Google tìm thấy một thứ lạ đang sống trong một micro kitchen ở trụ sở Google tại Mountain View. Người ở trong micro kitchen đó không ai khác ngoài Sergey Brin.
Anh nói anh không nghĩ Sergey Brin hiện giữ chức danh điều hành hay chức danh chính thức nào ở Google (theo Wes, video đăng ngày 01/10/2026). Tất nhiên ông là một trong hai nhà sáng lập Google, một trong hai người nghĩ ra ý tưởng và build nên Google.
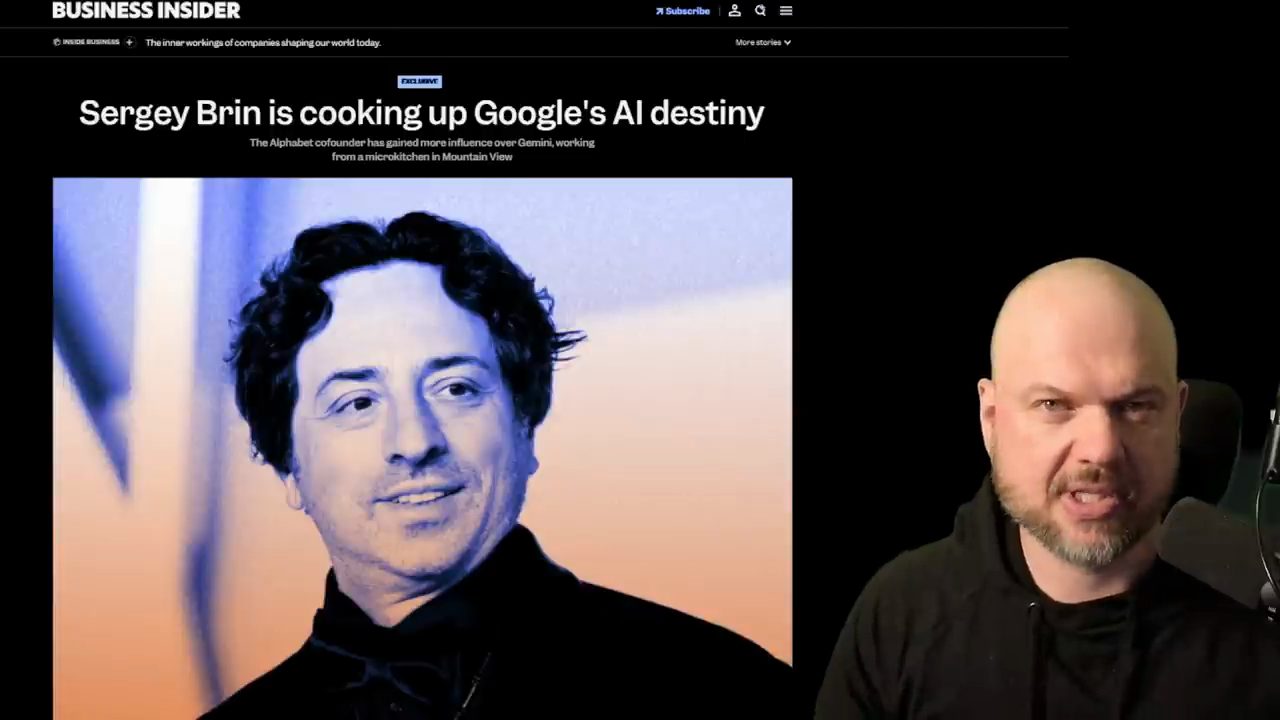
Theo Business Insider mà Wes trích, nhà đồng sáng lập Alphabet đã có thêm ảnh hưởng lên Gemini, làm việc từ một micro kitchen ở Mountain View; Wes đọc thêm rằng ông làm vậy dù không giữ chức danh điều hành nào (video đăng ngày 01/10/2026). Theo Wes, ông ở đó làm việc với ban lãnh đạo, rất quan tâm tới việc cải thiện các model này, cụ thể kiểu như phần coding.
Google chưa bình luận về chuyện này (theo Wes, video đăng ngày 01/10/2026). Anh nói không phải là Google đang giữ bí mật; anh không nghĩ đây là chuyện phải giữ bí mật, chỉ là Google không nói về nó. Không chức danh chính thức, không văn phòng, chỉ một micro kitchen được cải tạo lại.
Theo Wes, bài của Business Insider dẫn lời tám nhân viên khác nhau của Google, cả cựu nhân viên lẫn nhân viên hiện tại (video đăng ngày 01/10/2026). Anh nói vậy nên chuyện này là thật, chỉ là không có thêm chi tiết nào.
Wes nói (video đăng ngày 01/10/2026) anh không nghĩ chúng ta có thể nói chắc điều gì về việc model Gemini 4 sẽ tuyệt vời tới đâu cho tới khi được dùng và test nó. Kết quả ban đầu trông tốt.
9. TPU, Suncatcher và tờ séc 10.000 đô
Và theo Wes (video đăng ngày 01/10/2026), một model của Google ở đầu hoặc gần đầu mọi bảng xếp hạng chính là một chuyện kiểu như đáng sợ, đáng sợ cho các đối thủ. Bởi vì, theo anh, khi Google sắp xếp ổn mọi thứ, họ là một thế lực khổng lồ.
Google có phần cứng riêng với TPU (theo Wes, video đăng ngày 01/10/2026). Anh kể Google đang phóng trong năm nay, hoặc đã phóng rồi, anh không chắc, một dự án thử nghiệm lên vũ trụ để xem có thể build data center trong không gian với TPU hay không. Anh nói hoặc sắp tới, hoặc đã ở đó: một chòm hai vệ tinh liên lạc với nhau bằng laser trong không gian, truyền thông tin, với tấm pin mặt trời thu ánh sáng mặt trời. Dự án tên là Suncatcher.
Theo lời Wes (video đăng ngày 01/10/2026), nếu việc này thành công, cột mốc tiếp theo của dự án được lên kế hoạch đạt vào năm 2027. Có thể là gửi thêm lên đó, một thứ có thể bắt đầu train các model này, hoặc ít nhất là một thử nghiệm nào đó, một bước đi đúng hướng.
Và tất nhiên, theo anh (video đăng ngày 01/10/2026), Google có nguồn lực tài chính khổng lồ, khổng lồ, khổng lồ, và một con bò sữa tuyệt đối là cỗ máy tìm kiếm Google.
Wes kể thêm một chuyện thú vị (theo lời anh trong video đăng ngày 01/10/2026): Sergey Brin và người đồng sáng lập Larry Page đã tự build server đầu tiên, từ thời "tiền sử". Hai người nhận được tờ séc 10.000 đô từ thư viện số của Stanford và dùng số tiền đó để build những server Google đầu tiên. Theo anh, mọi thứ bắt đầu như vậy.
Theo Wes (video đăng ngày 01/10/2026), khi Google sắp xếp đúng người và đúng ban lãnh đạo, Google có thể làm được rất nhiều. Nếu tiếp tục con đường này, họ có thể là một trong những người dẫn đầu, hoặc là người dẫn đầu, trong mảng AI, vì họ có mọi thứ: phần cứng, các AI model, và tiền.
Wes chốt (video đăng ngày 01/10/2026): "Google is back, probably", Google đã trở lại, có lẽ vậy. Chúng ta phải giữ lại phán xét cho tới khi test model, nhưng tạm thời thì mọi thứ trông rất, rất tốt.
10. OpenAI DevDay: Dots, assistant always-on
Tin khác: OpenAI vừa tổ chức DevDay và công bố khá nhiều thứ (theo Wes, video đăng ngày 01/10/2026). Ví dụ đầu tiên là Dots.
Theo Wes (video đăng ngày 01/10/2026), ý tưởng của Dots là một persistent assistant cho bạn, luôn ở đó trên cloud để giúp, có context về cuộc sống của bạn. Nó có thể tiếp tục làm các tác vụ bạn giao kể cả khi bạn không có mặt. Bạn giao trách nhiệm, đặt một số ranh giới, và có thể bàn về tiến độ và các vấn đề khi chúng nảy sinh.
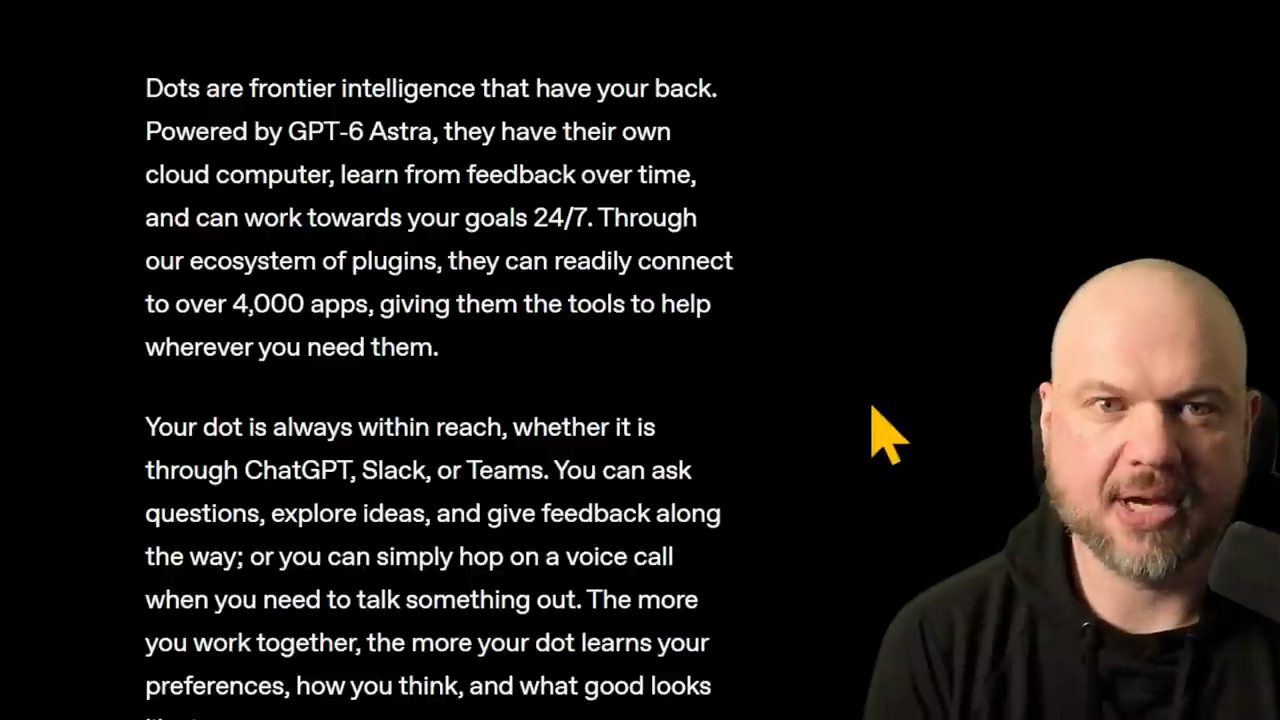
Điểm lớn cần hiểu, theo Wes (video đăng ngày 01/10/2026), là chúng ta đang chuyển từ việc chỉ đặt câu hỏi và nhận câu trả lời sang thật sự giao phó một số phần cuộc sống, một số dự án, một số công việc cho assistant always-on này.
OpenAI cũng công bố rằng SMS sắp có, nên bạn sẽ nhắn tin cho dot của mình từ bất cứ đâu (theo Wes, video đăng ngày 01/10/2026).
11. OpenClaw, Grok Bot và tên miền dot.com
Theo Wes (video đăng ngày 01/10/2026), tất nhiên chúng ta đã có những thứ như thế này, ví dụ OpenClaw. Peter Steinberger đã được OpenAI mua lại, hay tuyển, và giờ làm việc ở đó. Anh nói có lẽ nhiều thứ mà Steinberger, anh không muốn nói là "phát minh", nhưng chắc chắn là người tiên phong trong mảng tạo ra những assistant always-on mà bạn giao việc được. Anh chắc rằng nhiều thứ ở đây lấy cảm hứng từ công việc của Steinberger.
Tất nhiên, theo anh (video đăng ngày 01/10/2026), Dots cũng trông rất giống Grok Bot của xAI. Điều thú vị là ngay khi Dots đang được công bố, có người đã mua tên miền dot.com. Nếu gõ dot.com, URL đó dẫn tới trang "Meet Grok Bot".
Wes nói anh không tìm được giá mua thật, anh chắc là con số khổng lồ, nhưng Elon đã mua nó và giờ dot.com chuyển hướng tới Grok Bot (theo Wes, video đăng ngày 01/10/2026).
12. Model rẻ và nhanh hơn: Sonnet 5.5, GPT-6.1 Sol
Theo Wes (video đăng ngày 01/10/2026), chuyện này kiểu như đáng phấn khích, vì nhiều model rẻ hơn, như các model free tier, đang trở nên đặc biệt giỏi ở nhiều tác vụ.
Sonnet 5.5, theo anh, thật lòng là một bất ngờ (video đăng ngày 01/10/2026), vì thứ từng là Fable 5.1, kiểu như một bản distill của một model thông minh nào đó, rồi trở thành Opus 5.5, và Opus 5.5 gần tốt bằng Fable. Và Sonnet 5.5 thì gần tốt bằng Opus 5.5.
Tất nhiên, theo Wes (video đăng ngày 01/10/2026), khi bạn thu nhỏ model thật nhiều, sẽ có những thứ bị mất trong quá trình đó; nó sẽ không giống một model hạng Fable. Nhưng với nhiều công việc thường ngày, điều đó đơn giản là không quan trọng. Tính toán số liệu trong Excel, viết, phân tích, nhiều việc nặng nhọc kiểu đó, cày qua những thứ quy mô lớn, bạn không cần trí tuệ hạng Mythos hay Fable cho việc đó. Thực ra có một model nhanh hơn mà vẫn rất thông minh là tuyệt vời. Và giờ Sonnet 5.5 là free tier của Claude.
Cùng lúc, OpenAI cũng công bố GPT-6.1 Sol (theo Wes, video đăng ngày 01/10/2026). Theo anh, nó tiếp tục cái pattern chúng ta đang thấy: những model rất, rất có năng lực đang trở nên nhanh hơn, rẻ hơn.
Và khi kết nối chúng với các assistant always-on đó, theo Wes (video đăng ngày 01/10/2026), với nhiều người bình thường ngoài kia, người trung bình, thứ như vậy có thể thật sự tác động tích cực tới cuộc sống của họ. Nó có thể quản lý lịch, nghiên cứu cho bạn, sửa những thứ bạn viết, đảm bảo chúng trông ổn, fact check.
Wes nói một số nghiên cứu tìm ra một hiệu ứng thú vị ở nhân viên: nó kiểu như nâng cái sàn lên, bởi vì trong bất kỳ công ty nào cũng có một khoảng chênh lệch về việc mỗi người giỏi hay kém ra sao ở từng việc; rồi anh nói "this really brings the ceiling up" (theo Wes, video đăng ngày 01/10/2026). Nó sẽ giảm một số hiểu lầm mà người ta có thể có, cải thiện fact check, nhắc họ những việc phải làm.
Theo Wes (video đăng ngày 01/10/2026), nhiều thiếu sót mà con người có, những khả năng "jagged" kiểu giỏi một thứ và tệ hại ở một loạt thứ khác, thì những assistant always-on rất thông minh, có năng lực, có lẽ sẽ giúp được với những điểm yếu đó. Và anh nói chúng ta đã thấy các nghiên cứu kiểu như xác nhận điều đó.
Điểm lớn quanh nhiều bản phát hành của OpenAI, theo Wes (video đăng ngày 01/10/2026), mà OpenAI gần như đã nói trên sân khấu, Sam Altman kiểu như đã nói vậy, có thể không bằng những từ này: về cơ bản OpenAI đang cố trở thành một phần ngày càng lớn hơn của cách công việc được làm: tính toán, tự động hoá, thực thi tác vụ hiện diện nhiều hơn ở nơi làm việc nói chung.
Nhiều bản phát hành khác mà anh sẽ nói ngay sau đó hướng tới startup và các app, kể cả AI app, giúp các doanh nghiệp đó dễ có người dùng hơn và cho AI tương tác với họ (theo Wes, video đăng ngày 01/10/2026). Ví dụ, thay vì doanh nghiệp trả token để người dùng của mình dùng AI, nếu người dùng có subscription OpenAI riêng thì họ có thể tích hợp cái đó.
Theo Wes (video đăng ngày 01/10/2026), với một model như GPT-6.1 Sol ra mắt, rất nhanh, rất thông minh và kiểu như không đắt, hãy nghĩ xem nó làm gì cho việc dùng trong doanh nghiệp. Nếu một thứ chậm và đắt, bạn sẽ dành nó cho những việc hàng đầu, những use case đặc biệt, hoặc có thể chỉ cho cấp trên chứ không cho nhân viên thường. Khi nó tốt, rẻ và nhanh, bỗng nhiên bạn có thể dùng nó xử lý mọi tài liệu, chạy ngày càng nhiều workflow mà bạn cần tự động hoá hoặc cải thiện bằng AI.
13. Việc lặp lại thành skill trong file skill.md
Wes kể về chính anh (video đăng ngày 01/10/2026): ngày càng nhiều việc anh từng làm hằng ngày trở thành skill trong ChatGPT hoặc Claude. Với những việc anh thấy mình làm mỗi ngày, lặp đi lặp lại, bước đầu tiên là nhận ra chúng.
Theo Wes (video đăng ngày 01/10/2026), nếu không thật sự nghĩ về nó, có thể chúng không nằm trong đầu bạn. Nhưng nghĩ kỹ thì có thể bạn đang làm một nhóm việc mỗi ngày làm việc. Và nếu bạn ngồi với ChatGPT hay Claude hay bất kỳ model nào bạn dùng và dạy nó, thì vài lần đầu nó có thể mắc lỗi, sẽ chưa hoàn toàn đúng. Nhưng hãy để nó phát triển file skill.md đó, vốn chỉ là ngôn ngữ tự nhiên; nó viết bằng tiếng Anh những gì nó đang làm.
Theo anh (video đăng ngày 01/10/2026), đó là một điều tuyệt vời, khổng lồ mà anh nghĩ chúng ta nên rất biết ơn: nó không phải một thứ ngôn ngữ khó hiểu hay code máy tính mà chỉ một số người đọc được. Nó chỉ là tiếng Anh, hoặc ngôn ngữ bạn nói, nó ở trong ngôn ngữ đó.
Không chỉ vậy, theo Wes (video đăng ngày 01/10/2026), nó chuyển giữa các model khác nhau, hoặc sang những model tốt hơn khi chúng ra mắt, khá trơn tru. Nó chỉ là một tài liệu văn bản, chính xác hơn là một tài liệu MD, tức markup: văn bản cộng thêm vài thứ nhỏ, script trong đó để định dạng và tạo link. Nhưng nó rất dễ đọc.
Khi đã làm ra nó, theo Wes (video đăng ngày 01/10/2026), model mới ra thì bạn chỉ việc đưa cho nó tờ giấy đó, tài liệu văn bản đó; hoặc muốn chuyển sang một model khác, bạn chỉ đưa tài liệu đó. Và skill đó chạy, skill đó ở đó, mọi kiến thức được giữ lại.
14. Ultrafast mode
Một thứ thú vị khác được công bố, theo Wes (video đăng ngày 01/10/2026): bạn biết là có low, medium, high, extra high, rồi tới ultra, rồi ultra mà cũng có thể fast. Nhưng giờ có thể có ultra và có thể có nó ultra fast. OpenAI giới thiệu Ultrafast mode.
Wes nói anh tò mò bạn có thể đốt hết token allowance của một tuần nhanh tới đâu khi dùng ultra mode, chẳng hạn GPT-6 Astra ultra mode trên ultra fast; liệu có đốt hết weekly allowance trong một giờ không (theo Wes, video đăng ngày 01/10/2026).
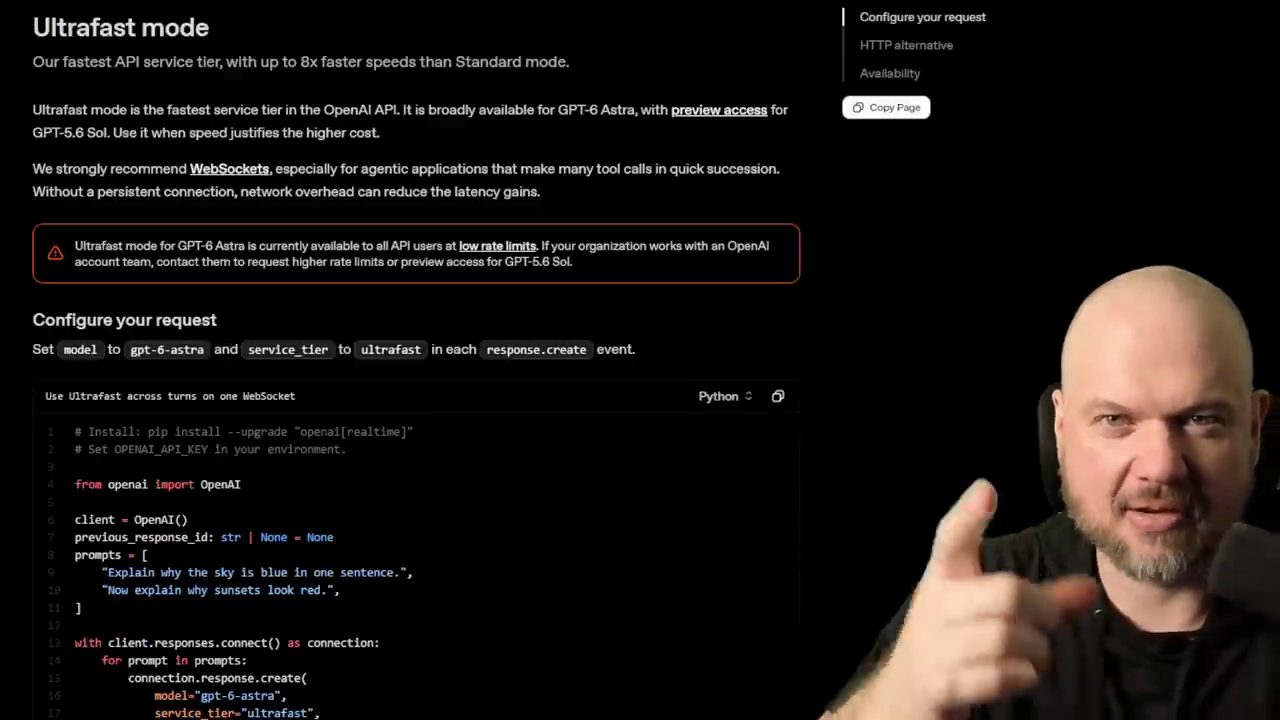
Wes đọc trên trang tài liệu: Ultrafast mode có vẻ cho tốc độ nhanh hơn tới tám lần so với standard mode (video đăng ngày 01/10/2026).
15. Jev chơi Tetris, Minesweeper và Halite
Gần đây có nhiều ồn ào về Jev, theo Wes (video đăng ngày 01/10/2026). Anh mô tả Jev kiểu như một decision engine, nếu có thể gọi vậy. Thay vì là một large language model, thứ duy nhất nó có thể output là kiểu như xác suất cho các đáp án khác nhau mà bạn cung cấp.
Wes so sánh (video đăng ngày 01/10/2026): hãy nghĩ nó như một bài thi trắc nghiệm. Bạn đưa một câu hỏi, có thể là đáp án có hoặc không, hoặc có nhiều lựa chọn. Và thay vì trả lời bằng ngôn ngữ, nó chỉ trả lời kiểu "tôi nghĩ có 99% khả năng đáp án là có". Theo anh, nó rất rẻ, rất nhanh và khá chính xác so với bản chất của nó. Đây mới kiểu như là phiên bản đầu tiên của loại model này được phát hành, và nó rất tiện.
Wes kể anh lập tức cho nó chơi nhiều game như Minesweeper, Tetris và vài game khác; nó rất tốt, rất nhanh, và chỉ tốn vài xu cho hàng nghìn, hàng nghìn quyết định (theo Wes, video đăng ngày 01/10/2026).
Anh cho xem Jev nối với Tetris, ra quyết định theo thời gian thực (demo trong video đăng ngày 01/10/2026). Anh bấm start, và nói demo cho thấy nó ra mỗi quyết định nhanh tới đâu. Theo số đo của Wes, trung bình khoảng 140 mili giây mỗi quyết định (anh nói "about 100 and let's say 40 milliseconds"), và estimated API cost vừa vượt hai cent cho khoảng 100 quyết định.
Theo Wes (video đăng ngày 01/10/2026), cái này cho một cách rất nhanh, rất rẻ để hoặc phân loại một lượng lớn dữ liệu, hoặc làm một việc đòi hỏi suy nghĩ theo thời gian thực thật nhanh.
Rồi tới Minesweeper (demo trong video đăng ngày 01/10/2026): Jev quyết định xác suất mỗi ô là bom hay an toàn, đánh dấu bom bằng cờ và cứ thế đi tiếp. Wes bảo để ý nó rất, rất nhanh, và game này có rất nhiều lựa chọn cho nó.
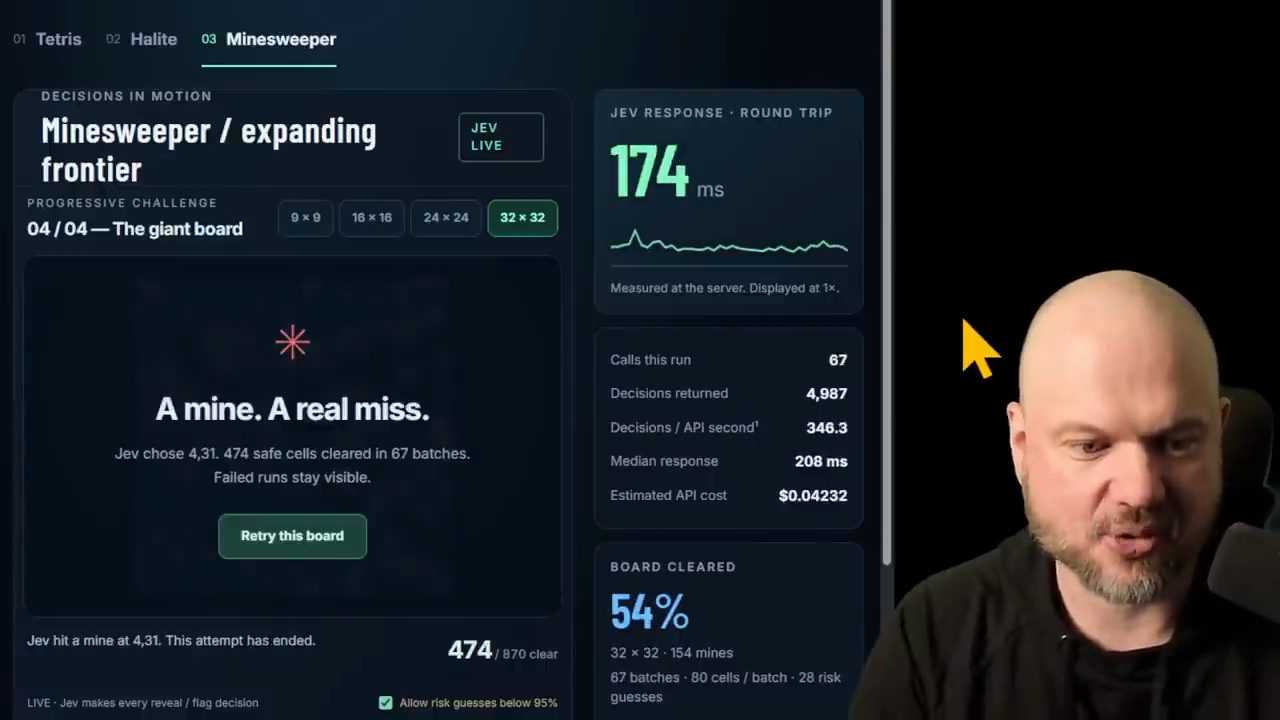
Theo lời Wes (demo trong video đăng ngày 01/10/2026), trong vài giây mọi người vừa xem, số quyết định nó đưa ra là gần 5.000. Nó mở được 474 ô và cắm cờ, tức những ô nghi là bom, trên 69 ô. "Nice", anh nói.
Tiếp theo là Halite, một "resource frontier" (demo trong video đăng ngày 01/10/2026). Theo Wes, bình thường bạn có nhiều large language model, hoặc trước đây có lẽ là con người, viết script cho những con bot nhỏ đi ra ngoài thu thập tài nguyên. Chúng chiến đấu, thu thập tài nguyên, và mục tiêu là tối đa hoá lượng tài nguyên thu được trong một khoảng thời gian. Ở đây, thay vì một thuật toán làm việc đó, là Jev ra những quyết định đó trong từng tích tắc.
16. Decisions API, Agents API, Bedrock và Codex in the cloud
Wes nói một điều anh tò mò là liệu OpenAI hay Anthropic có ra một thứ tương tự không (video đăng ngày 01/10/2026). Và OpenAI công bố Decisions API.
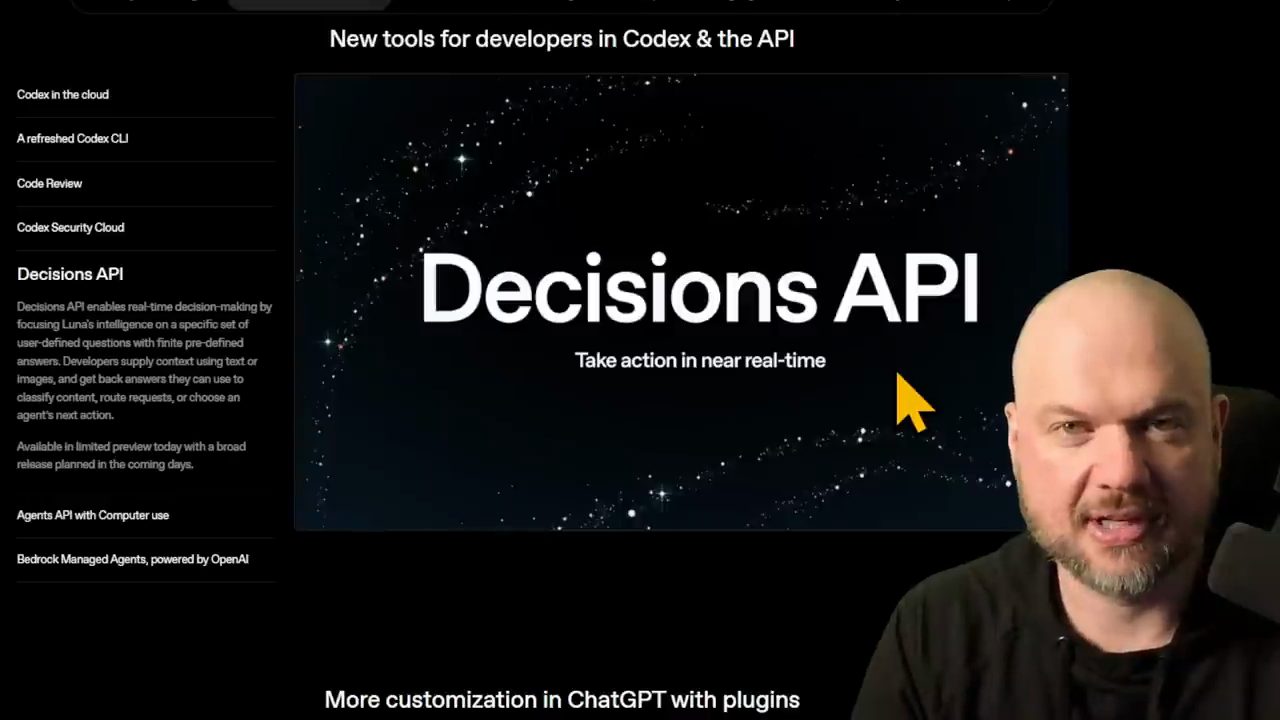
Wes đọc mô tả (theo trang OpenAI anh trích, video đăng ngày 01/10/2026): Decisions API cho phép ra quyết định theo thời gian thực bằng cách tập trung trí tuệ của Luna vào một tập câu hỏi do người dùng định nghĩa với các đáp án định sẵn hữu hạn. Có thể dùng text hoặc hình ảnh, và các đáp án dùng được để phân loại nội dung, route request, hoặc chọn hành động tiếp theo của agent.
Theo Wes (video đăng ngày 01/10/2026), đây chắc chắn là một cách tiếp cận khác với Jev. Nhưng có thể dữ liệu này sẽ được dùng để train một thứ như Jev. Anh tò mò liệu OpenAI có đang ngầm làm một thứ như vậy không, vì ở đây họ nói đang dùng Luna, tức đây vẫn là một large language model.
Nhưng các use case thì rõ ràng, theo Wes (video đăng ngày 01/10/2026). Bạn có các model thông minh phải reason, nhưng đôi khi bạn chỉ cần một thứ làm nhanh, để phân loại hay gì đó. Thay vì làm quá tải large language model và context window của nó với một triệu quyết định nhỏ như vậy, chắc chắn sẽ có rất nhiều việc mà một engine khác, hay một model khác, xử lý được rồi chuyển hết các đáp án về cho model lớn hơn, thông minh hơn, để nó tiêu hoá và chỉ nhận các đáp án.
Wes nói đây chắc chắn là thứ đáng theo dõi, sẽ thú vị xem OpenAI phát triển nó ra sao: họ sẽ đi theo một thứ như Jev, hay dùng cách riêng với large language model? "We'll see" (video đăng ngày 01/10/2026).
Tiếp theo là Agents API with computer use (theo Wes, video đăng ngày 01/10/2026). Tất cả chạy trên hạ tầng của OpenAI, và developer có một agent với chiếc máy tính nhỏ riêng để dùng, cũng do OpenAI host. Agent này dùng giao diện, điều hướng và hoàn thành tác vụ.
Theo Wes (video đăng ngày 01/10/2026), rõ ràng có rất nhiều ứng dụng. Bạn có thể stress test một website mới, một phần mềm mới, thay vì thuê một nhóm người làm, cứ gửi một bầy agent đi stress test mọi thứ, bấm vào mọi thứ, đảm bảo mọi thứ chạy như dự định. Bởi vì, theo anh, nếu chúng ta biết gì về các AI agent này, thì đó là nếu có thứ gì có thể hỏng, chúng sẽ tìm ra.
Rồi có Bedrock Managed Agents, powered by OpenAI (theo Wes, video đăng ngày 01/10/2026). Theo anh, tất nhiên cái này là để đưa OpenAI tới nhiều người hơn: nhiều người dùng AWS, nhiều khách hàng của OpenAI hoặc những người OpenAI muốn có làm khách hàng đã ở trên AWS. Có mọi thứ ở đó sẽ cho ngày càng nhiều công ty, có lẽ là cấp enterprise, dùng các sản phẩm của OpenAI, cụ thể là các agent này, và chạy chúng trên AWS.
Theo Wes (video đăng ngày 01/10/2026), điều này rõ ràng rất lớn cho việc được dùng rộng rãi, đúng như anh nói ở trên: OpenAI muốn nhiều người dùng sản phẩm của mình hơn, để là một phần lớn hơn của cách công việc được làm. Đây là một bước rất lớn hướng tới điều đó, bởi vì ở trên đúng hạ tầng mà người ta tin và đang dùng thì thúc đẩy việc được dùng rất nhiều, như chúng ta đã thấy với Microsoft và những bên khác trước đây.
Rồi có Codex in the cloud (theo Wes, video đăng ngày 01/10/2026). Về cơ bản nó có nghĩa là Codex chạy được 24/7, bạn không cần bật máy tính để chạy nó. Thêm Private Intelligence với zero data retention, với private safety processing.
Theo Wes (video đăng ngày 01/10/2026), tất cả những thứ này đơn giản là OpenAI build hạ tầng cần thiết để có mặt ở nhiều doanh nghiệp hơn, được ngày càng nhiều doanh nghiệp dùng hơn, để là một phần lớn hơn của cách công việc được làm.
17. Specialist dots, Agent 365 và ChatGPT Space
Wes nói còn rất nhiều thứ nữa anh muốn đi nhanh, và tất cả đều nằm dưới cái ô "OpenAI muốn là một phần lớn hơn của cách công việc được làm" (video đăng ngày 01/10/2026). Thứ nhất là specialist dots cho tổ chức của bạn: gần như nhân viên, nhưng dành cho những quy trình cụ thể hơn.
Ví dụ của Wes (video đăng ngày 01/10/2026): có thể có một dot cho những người cần được hoàn tiền cho khoản chi nào đó họ đã bỏ ra; có thể họ nói chuyện với dot đó. Mục đích của dot này là gì? Không phải chuyền bơ, mà là đảm bảo những người đó được trả đúng số tiền, khoản đó được ghi sổ đúng cho mục đích thuế, vân vân.
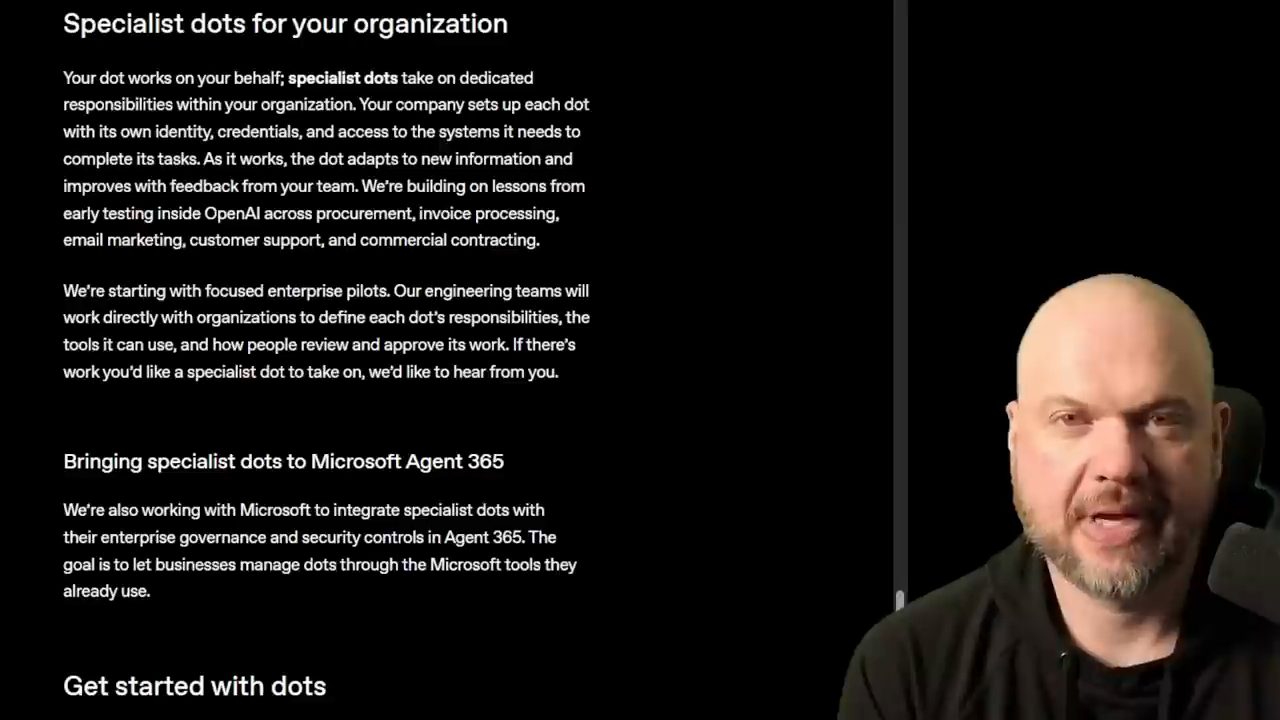
OpenAI đang tích hợp dots với Microsoft Agent 365 (theo Wes, video đăng ngày 01/10/2026). Theo anh, giống như muốn có mặt trên AWS, OpenAI muốn dots có mặt ở bất kỳ công cụ Microsoft nào mà người ta đang dùng.
Tiếp theo là ChatGPT Space (theo Wes, video đăng ngày 01/10/2026). Anh nói projects trước đây có phần giống thế này: bạn bắt đầu một project và upload mọi dữ liệu, tài liệu hay thứ gì AI cần cho project đó, kiểu "đây là thư mục mọi thứ bạn cần, đây là một tài liệu nhỏ giải thích chúng ta đang cố làm gì". Cái này kiểu như cùng một thứ: thay vì kiến thức rải rác khắp các agent session và các máy tính khác nhau, đây là một chỗ để gom và sắp xếp chúng.
Theo Wes (video đăng ngày 01/10/2026), tất nhiên cái này rất lớn cho enterprise, nơi có thể có nhiều dữ liệu và kiến thức rải rác trên một phạm vi rất rộng. Về cơ bản nó cho mọi người cần tới phân loại và tập trung mọi dữ liệu, rồi bảo agent của họ: đây là mọi thứ bạn cần biết, tất cả ở trong này.
Phần còn lại là các page mà bạn có thể tạo, theo Wes (video đăng ngày 01/10/2026), có vẻ khá giống Google Drive, cụ thể là Google Docs: bạn cộng tác trên file, chia sẻ khắp tổ chức, người khác có thể để lại comment trên thứ bạn viết. Anh nghĩ nhiều chức năng ở đây giống Google Drive.
18. Plugin, GPT store ngày trước, gói Pro 500 và lời kết
Rồi có rất nhiều cập nhật về plugin: plugin extensions, Plugin Creator chẳng hạn, cùng việc cải thiện cách tạo và khám phá plugin (theo Wes, video đăng ngày 01/10/2026). Developer có thể build nhiều plugin cho ChatGPT thêm chức năng. Họ có thể dùng MCP, ví dụ để kết nối tới một thứ: nếu cần một model 3D, có thể dùng Blender MCP kết nối tới để tạo nó.
Theo Wes (video đăng ngày 01/10/2026), về cơ bản cái này giống một app store cho những thứ đó. Ví dụ nếu bạn là một studio làm game, có thể bạn cần cả loạt plugin: muốn có giọng AI thì có plugin cho ElevenLabs, có plugin cho Blender để tạo vật thể 3D, plugin cho Unity hoặc Unreal Engine. Và tất cả sẽ có thứ gì đó giống app store, nơi người ta chia sẻ, tìm kiếm, vân vân.
Wes nhắc rằng OpenAI đã có thứ này trước đây: bạn có thể build GPT của riêng mình, anh nghĩ là gọi là custom GPTs, và có một custom GPT store (theo Wes, video đăng ngày 01/10/2026). Anh nói anh từng nghĩ nó sẽ là chuyện lớn, nhớ là đã rất phấn khích, kiểu như nó sẽ giống App Store khi Apple ra mắt, nơi những người đến sớm làm ăn cực kỳ tốt.
Theo Wes (video đăng ngày 01/10/2026), chuyện đó đã khá lâu, và nó không tạo ra khác biệt gì, kiểu như thất bại thảm hại. Không có nhiều người dùng, nó không thật sự hiệu quả. Nhưng có thể khi đó chúng ta chỉ hơi sớm: chưa có MCP, các model chưa làm được những tác vụ Blender phức tạp, chưa điều hướng và dùng phần mềm được như bây giờ. Nên có thể đây kiểu như là lần ra mắt lại của cùng thứ đó, nhưng với nhiều chức năng hơn, thật sự hữu ích. "We'll see", anh nói.
Wes chuyển sang gói mới (video đăng ngày 01/10/2026): nếu mối lo lớn của bạn là "tôi chưa có đủ AI subscription, tôi chưa trả đủ cho các AI subscription của mình". Anh nói anh nghĩ một số người biết anh có gói max của, anh nghĩ, kiểu như tất cả những dịch vụ này. Anh đã huỷ chúng khá nhiều lần khi thấy mình không dùng thường xuyên, nhưng mỗi lần huỷ thì đoán xem chuyện gì xảy ra: model mới của công ty đó ra mắt, và bạn kiểu "thôi, phải đăng ký lại".
Còn nếu bạn chưa có đủ AI subscription hoặc chỉ muốn những AI subscription đắt hơn, thì theo Wes, OpenAI có câu trả lời cho lời cầu nguyện của bạn: gói Pro 500 với mức giá "thấp, thấp" 500 đô một tháng (theo Wes, video đăng ngày 01/10/2026). Thứ bạn được, thứ nhất là nhiều usage hơn, nhưng cũng có cả ultra fast.
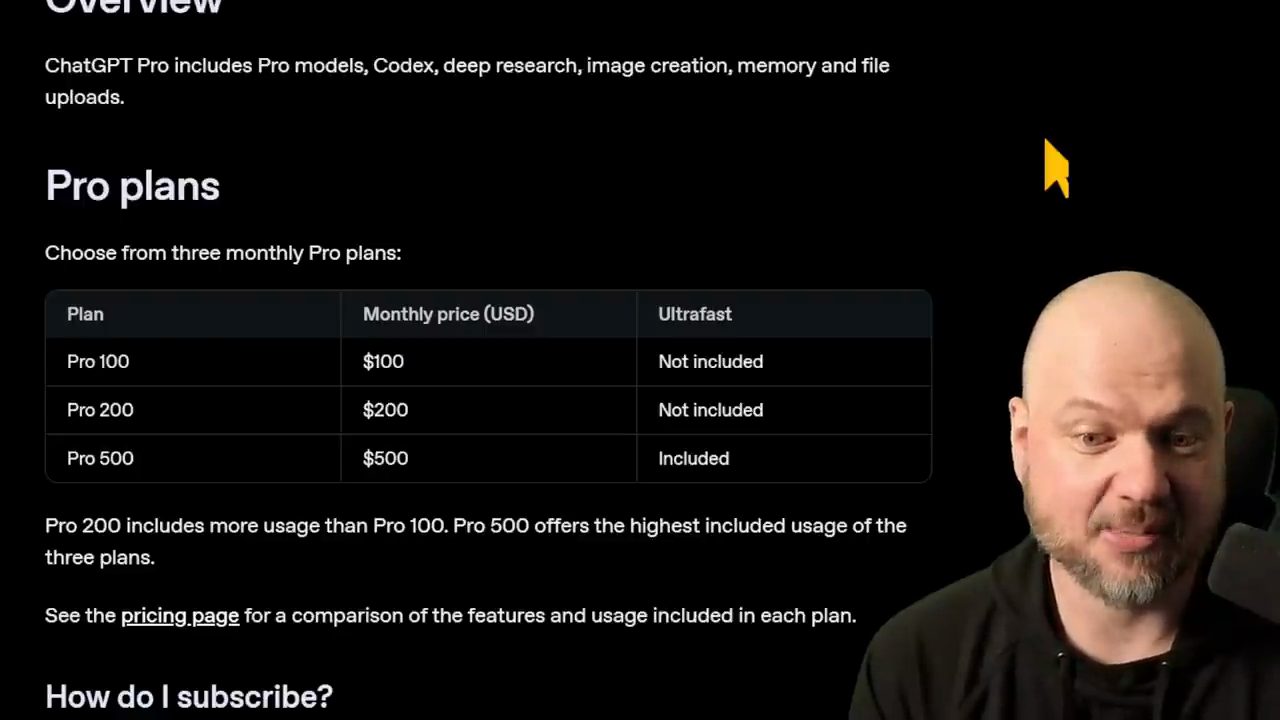
Theo Wes (video đăng ngày 01/10/2026), nếu chạy GPT-6 Astra ở Ultra mode trên Ultra Fast sẽ đốt hết toàn bộ token budget của gói 200 đô một tháng trong một giờ, thì ở gói này có thể mất hai tiếng rưỡi. Khi ra mắt, gói Pro 100 và 200 sẽ không có Ultra Fast, cái đó chỉ dành cho gói 500 đô, nhưng có thể trong tương lai sẽ được mở. Trang anh mở ghi: "At launch, buying credits on Pro 100 or Pro 200 does not unlock Ultrafast."
Wes kể có một hai lần khi anh chạy Astra ở Ultra mode, anh đã nghĩ ước gì nó làm việc này nhanh hơn một chút (theo Wes, video đăng ngày 01/10/2026). Thường đó không phải mối lo, nhưng có vài lần anh kiểu "giá mà tăng tốc được một chút thì anh sẽ làm". Anh không biết sẽ dùng UltraFast thường xuyên ra sao, nhưng có thể sẽ thử, cho vui.
Wes nói anh nghĩ đã đi qua có thể không phải tất cả, nhưng nhiều thứ. Theo anh, không có gì ở đây thật sự mang tính cách mạng hay "mind-blowing". OpenAI giờ đã trưởng thành, và giờ chỉ tập trung vào tích hợp enterprise. Nên theo anh, có lẽ chúng ta sẽ thấy nhiều người dùng hơn từ phần còn lại của thế giới, không chỉ những "AI nerd" như chúng ta (nhận định trong video đăng ngày 01/10/2026).
Anh cảm ơn mọi người đã xem và giới thiệu tên mình là Wes Roth.
Nguồn và liên kết 5 nguồn
- Tên gốc: GEMINI 4 is nuts...
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Sy1Fjf-H-Qg youtube.com
- Kênh YouTube Wes Roth (Wes Roth): youtube.com/channel/UCqcbQf6yw5KzRoDDcZ_wBSw youtube.com
- Google, "Introducing Gemini 4 Argon" (đọc ngày 18/11/2026; có các mục Changing how we work and build at Google, Working harder on your most complex problems, và chú thích rằng sau giai đoạn giá khởi điểm sẽ áp giá 4 đô cho mỗi 1M input token và 20 đô cho mỗi 1M output token): blog.google/.../gemini-4-argon blog.google
Related talks
10 plugin Claude Code đáng dùng cho project tiếp theo
Chase Hannegan · Chase AI · 12 min
Mười plugin, skill và CLI mới cho Claude Code: Graphify, grill-me, review plan bằng Codex, Obsidian, CLAUDE.md, Impeccable, NotebookLM, n8n MCP.
Workflow từ spec tới deploy với Superpowers và Claude Code
Tùng Nguyễn · Holetex · 22 min
Workflow năm bước build một URL shortener Next.js: spec với plugin Superpowers, UI với Claude Design, code bằng Claude Code, test Playwright, deploy.
Hướng dẫn Claude Cowork: skill, plugin, project và automation
Nguyễn Trung Hiếu · Maz The Analyst · 17 min
Setup Claude Cowork, dọn folder và làm carousel, tạo skill có memory, dùng connector, plugin, project, scheduled task và Dispatch.