Data engineer dùng Claude Code: profiling, incident, metadata và toolkit
Cách một data engineer dùng Claude Code: profile nguồn mới, điều tra incident, xây metadata, dựng toolkit, rồi biến từng việc thành skill.
✓ Đã duyệt độc lập · cập nhật 29/10/2026 · 29 min
1. Data engineer không chỉ viết code
Video được Anthropic tài trợ (theo mô tả video).
Baraa mở đầu bằng câu hỏi của cả video: một data engineer dùng Claude Code như thế nào. Anh kể mình dùng Claude Code mỗi ngày, cho mọi việc, từ cuối năm 2025 (tính đến lúc video đăng ngày 29/10/2026).
Điều anh nhấn mạnh ngay từ đầu: làm việc với dữ liệu cùng AI không phải chuyện dễ, vì nghề này dựa trên niềm tin (trust). Data engineer không chỉ dựng thêm một website nữa. Và theo anh (video đăng ngày 29/10/2026), ai làm data engineer cũng biết: viết code có lẽ là phần dễ nhất của công việc.
Ngoài viết code, còn rất nhiều việc khác. Phải hiểu các source system mới mà mình sắp kết nối. Phải thiết kế data model và data architecture. Phải review code của người khác. Phải re-engineer một giải pháp cũ để nó theo kịp thời đại. Và đó mới chỉ là phần thứ nhất.
Một phần lớn trong ngày của data engineer là chữa cháy (firefighting): sửa bug, điều tra incident, tìm xem vì sao dữ liệu sai. Theo Baraa (video đăng ngày 29/10/2026), qua các năm, đặc biệt là thời gian gần đây, data engineer nhận thêm ngày càng nhiều việc. Ví dụ, họ phải bắt đầu xây data product, phải "may đo" và viết tài liệu cho nó để người khác dùng dễ dàng. Một việc mới nữa là chuẩn bị dữ liệu cho các use case AI.
Theo anh (video đăng ngày 29/10/2026), chính những việc đó sẽ phân biệt một data engineer giỏi với một data engineer kém, và đó là cốt lõi của nghề. Vì thế, anh nói rõ: video này không dạy dùng Claude Code để viết vài script, vì việc đó dễ. Anh sẽ cho thấy cách dùng nó để tăng tốc quy trình, như một data engineer thật trong các project thật.
2. Setup: VS Code, extension Claude Code và chọn model
Project dùng trong video là một trong các side project data engineering của Baraa: dựng một data lakehouse bằng SQL và Python. Trên màn hình, project tên là newvolt-data-platform; file CLAUDE.md của nó mô tả Newvolt là một cửa hàng online bán đồ điện tử tiêu dùng.
Setup rất đơn giản: anh dùng Visual Studio Code cùng Claude Code. Theo Baraa (video đăng ngày 29/10/2026), chỉ cần cài extension Claude Code cho VS Code là dùng được ngay.
Về model, phần lớn thời gian anh dùng Opus 5.5. Theo anh (video đăng ngày 29/10/2026), Opus là quá đủ cho hầu hết các task. Nhưng khi task thật sự phức tạp, ví dụ anh muốn re-engineer một trong những concept phức tạp của mình, hoặc cần đưa ra những quyết định thật lớn, thì anh chuyển sang Fable. Ngoài những lúc đó, anh dùng Opus cho mọi việc. Trên bộ chọn model của extension lúc quay video, Opus 5.5 ghi "For complex work and everyday tasks", Fable 5.1 ghi "For your toughest challenges", và bên dưới còn có Sonnet, Haiku, mức Effort và một công tắc Ultracode.
3. CLAUDE.md, skill riêng và thói quen xem kết quả bằng HTML
Việc thứ nhất mà Baraa coi là rất quan trọng trong mọi project Claude là file CLAUDE.md. Theo anh (video đăng ngày 29/10/2026), bất cứ gì viết trong file này, Claude Code sẽ tự đọc mỗi khi bắt đầu một session mới, một cuộc hội thoại mới trong project. Tài liệu Claude Code cũng ghi CLAUDE.md là file hướng dẫn mà Claude đọc lúc bắt đầu mỗi session (đọc ngày 29/10/2026).
Anh luôn nghĩ về nó như một tài liệu onboarding mà anh đưa cho bất kỳ đồng nghiệp mới nào vào project. Lời khuyên của anh: hướng dẫn phải rõ ràng, và đồng thời không quá dài.
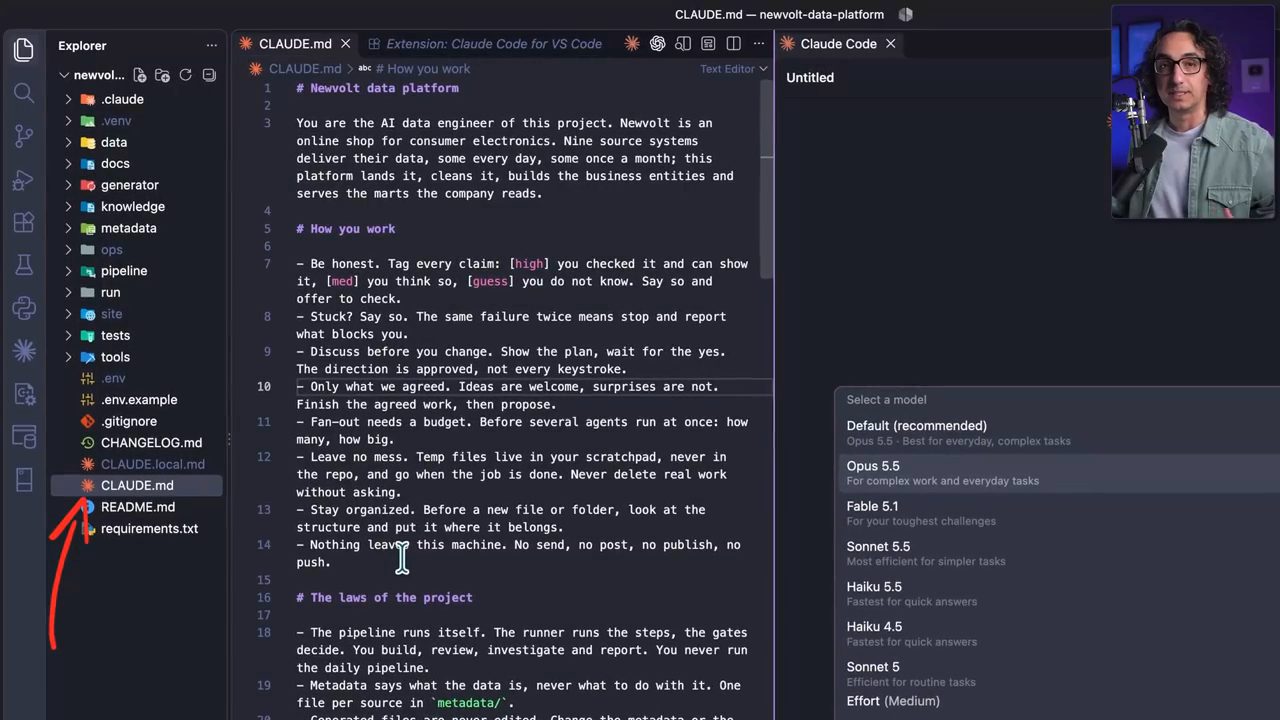
Thứ quan trọng tiếp theo là skill, nằm trong thư mục .claude. Baraa tự build các skill của riêng mình, tùy biến hoàn toàn cho project. Theo anh (video đăng ngày 29/10/2026), cách làm cũng rất đơn giản: mỗi khi thấy một task engineering sẽ lặp đi lặp lại, anh bảo Claude Code biến nó thành một skill. Trong video, anh sẽ cho xem những skill quan trọng nhất của anh.
Một thói quen nữa anh làm suốt: với task lớn, anh yêu cầu Claude Code trình bày kết quả dưới dạng một trang web, một file HTML. Lý do anh đưa ra: dễ đọc, dễ theo dõi, dễ hiểu, lại nhiều màu hơn là nhìn chằm chằm vào một bức tường chữ nhàm chán trong khung chat. Theo anh (video đăng ngày 29/10/2026), Claude Code với Opus làm rất tốt việc tạo ra những dashboard này.
4. Skill thứ nhất: data profiling một nguồn mới
Skill thứ nhất là data profiling. Trước khi kết nối bất kỳ source system hay bảng mới nào, phải hiểu nó trước đã. Có nhiều câu hỏi cần đặt ra: định dạng file là gì, cấu trúc dữ liệu ra sao, metadata, nội dung, chất lượng dữ liệu, và nhiều thứ khác. Đó là những câu hỏi rất quan trọng trước khi thiết kế hay dựng bất kỳ data pipeline nào.
Không chỉ vậy, profiling còn để tạo data contract giữa phía mình (data platform) và các source system. Baraa nói thêm: profiling chi tiết một source system có thể tốn rất nhiều thời gian, nhưng theo anh (video đăng ngày 29/10/2026), giờ có thể dùng Claude Code để tăng tốc quá trình này.
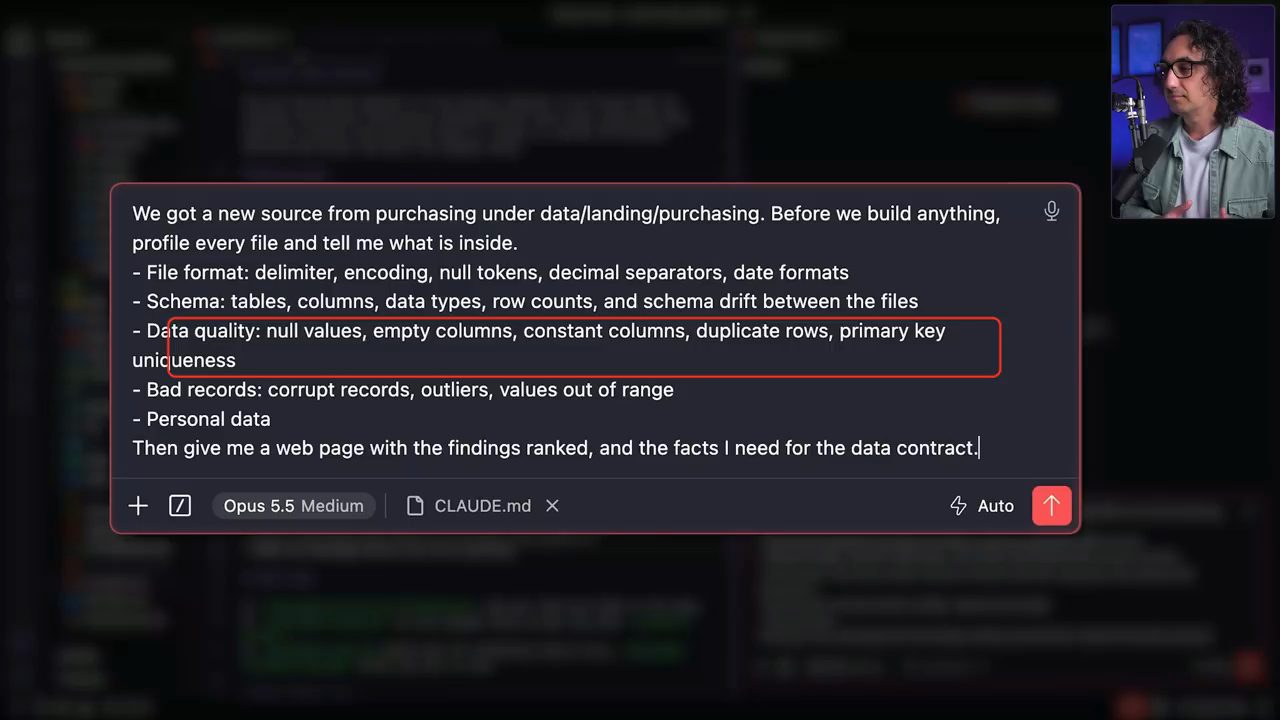
Prompt anh gõ cho Claude Code bắt đầu bằng việc báo có một nguồn mới, và trước khi build bất cứ thứ gì thì hãy profile từng file và cho biết bên trong có gì. Bên dưới là danh sách những việc anh vẫn làm khi profile thủ công một source system:
- Kiểm định dạng file.
- Kiểm schema: bảng, cột, kiểu dữ liệu.
- Kiểm chất lượng dữ liệu: thường là null, cột rỗng, các ràng buộc, dòng trùng, và tính duy nhất của primary key.
- Kiểm xem có dòng hỏng không, có outlier hay giá trị vô lý không.
- Kiểm dữ liệu cá nhân (personal data). Việc này cần làm để hiểu mình đang đưa dữ liệu gì vào data platform, vì thông thường phải đánh dấu (flag) nó.
Cuối prompt, anh yêu cầu trình bày kết quả dưới dạng trang web, để xem kết quả và bắt đầu soạn data contract. Nội dung prompt trên màn hình:
We got a new source from purchasing under data/landing/purchasing. Before we build anything, profile every file and tell me what is inside.
- File format: delimiter, encoding, null tokens, decimal separators, date formats
- Schema: tables, columns, data types, row counts, and schema drift between the files
- Data quality: null values, empty columns, constant columns, duplicate rows, primary key uniqueness
- Bad records: corrupt records, outliers, values out of range
- Personal data
Then give me a web page with the findings ranked, and the facts I need for the data contract.
Anh chạy thử, và nói việc này có thể mất vài phút (demo trong video đăng ngày 29/10/2026).
5. Báo cáo profiling: tổng quan và định dạng file
Khi xong, có rất nhiều thứ cần xem, đúng như khi làm data profiling. Vì thế, thay vì đọc kết quả trong khung chat, Baraa mở trang web. Theo anh (demo trong video đăng ngày 29/10/2026), Opus đã đi qua toàn bộ bảng và cột chỉ trong vài phút.
Đầu trang là phần tổng quan về cả source system. Anh đọc to: 10 bảng, 90 triệu dòng và 205 cột. Trên màn hình, trang "Data profile: purchasing" ghi 10 bảng, 87.7 M dòng, 205 cột, 1.4 M dòng trùng và 21 finding sẽ đi vào contract trước khi load bất cứ thứ gì (demo trong video đăng ngày 29/10/2026).
Bên dưới là chi tiết từng bảng: số dòng, số cột, khóa, và có dòng trùng hay không. Theo báo cáo (demo trong video đăng ngày 29/10/2026), bảng thứ hai có vấn đề, còn bảng cuối cùng trông như đã lỗi thời; anh nói sẽ xem kỹ hơn ở phần sau của báo cáo.
Phần tiếp theo là định dạng file, và theo Baraa, từ đây mọi thứ bắt đầu thú vị. Mục thứ nhất cho biết nguồn không dùng một delimiter duy nhất: có nơi dùng dấu chấm phẩy, và ở vài bảng lại dùng dấu phẩy, điều anh thấy không hay chút nào. Encoding cũng không theo cùng một chuẩn, nên có hai encoding phải xử lý. Ngày tháng có nhiều định dạng, khi thì dùng dấu chấm, khi thì dấu gạch ngang. Timestamp có hai định dạng. Dấu thập phân cũng khác nhau. Và null được viết theo nhiều cách: khi là chữ null, khi là ô trống, khi là một giá trị giả (dummy value). Tất cả là kết quả trong demo của video đăng ngày 29/10/2026.
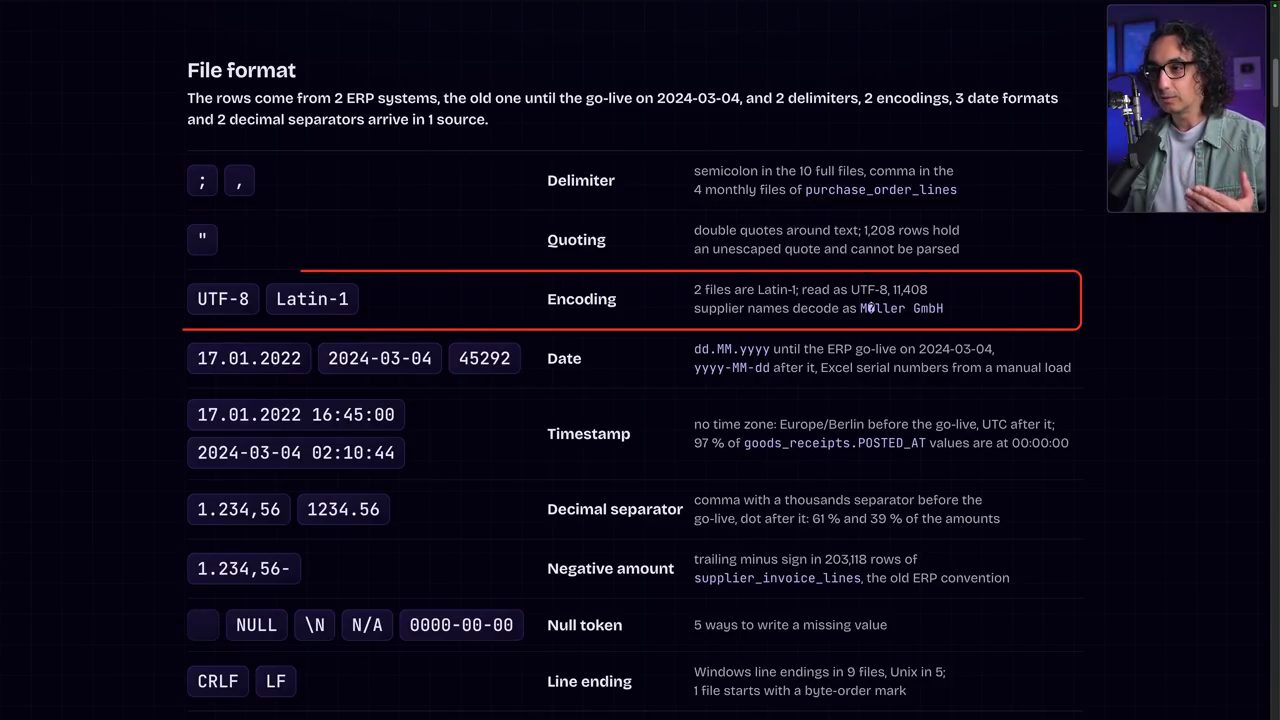
Theo Baraa (video đăng ngày 29/10/2026), kiểu phân tích này tốn rất nhiều thời gian, và khi tự profile thì sẽ không bắt được hết. Những vấn đề đó thường chỉ lộ ra giữa chừng khi đang dựng pipeline. Anh thấy tuyệt ở chỗ giờ mình được cảnh báo mọi vấn đề trước khi build bất cứ thứ gì.
Với báo cáo này, anh có thể ngay lập tức bắt đầu thỏa thuận data contract với source system và yêu cầu, ví dụ: chỉ một encoding, chỉ một delimiter. Hoặc anh phải tự xử lý tất cả những thứ đó trong pipeline. Dù chọn hướng nào, anh cũng lên được kế hoạch, và mọi thứ xong trong vài phút. Theo Baraa (video đăng ngày 29/10/2026), đây chính là lý do AI sẽ tăng tốc data engineering: không đời nào anh lại làm tất cả những việc này bằng tay nữa.
6. Null, ID, dòng trùng, schema drift và những ngày trống
Mục tiếp theo của báo cáo đếm có bao nhiêu ô trống, bao nhiêu null, chi tiết hơn. Trên màn hình, giá trị thiếu được viết theo 5 cách (ô trống, NULL, \N, N/A, 0000-00-00), và chỉ ô trống được đọc là null nếu không khai báo danh sách token. Tiếp đó là định dạng ngày: có vẻ tới năm 2024 nguồn dùng một định dạng rồi chuyển sang định dạng khác. Màn hình ghi định dạng đổi sang yyyy-MM-dd ở ngày go-live ERP 2024-03-04, và 12,406 dòng mang số serial của Excel (demo trong video đăng ngày 29/10/2026). Baraa gọi đây cũng là một phát hiện tuyệt vời.
Tiếp theo, báo cáo cho thấy một vấn đề với ID, và anh gọi đây là vấn đề nghiêm trọng (demo trong video đăng ngày 29/10/2026). Nếu không làm sạch nó, khi bắt đầu join các bảng, sẽ có rắc rối lớn.
Rồi đến dòng trùng: cùng một dữ liệu được giao hai lần vào hai ngày khác nhau. Trên màn hình, 1,389,204 dòng purchase order (5.6 %) đến hai lần, vì mỗi file hằng tháng lặp lại tháng trước và chỉ cột UPDATED_AT khác nhau (demo trong video đăng ngày 29/10/2026).
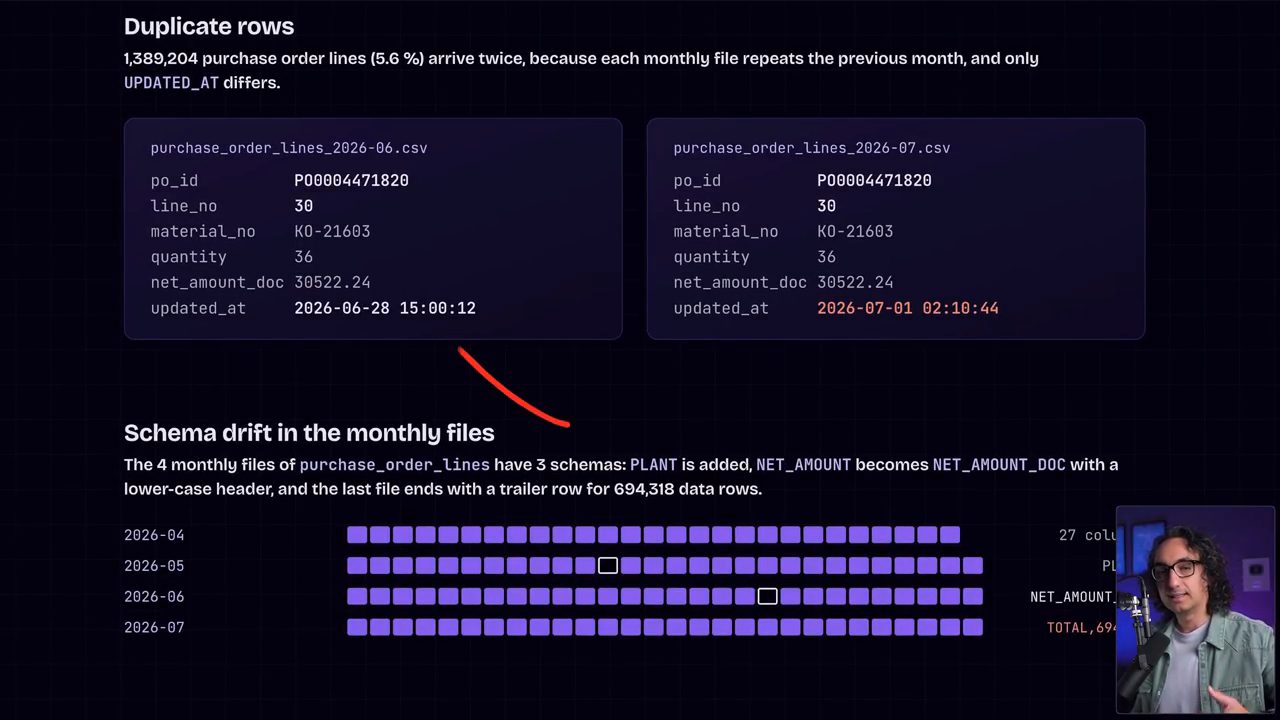
updated_at; bên dưới là "Schema drift in the monthly files": 4 file có 3 schema, thêm cột PLANT, NET_AMOUNT đổi thành NET_AMOUNT_DOC (demo trong video đăng ngày 29/10/2026).Tệ hơn thế, còn một phát hiện đáng sợ nữa: schema drift. Baraa giải thích schema drift nghĩa là cấu trúc dữ liệu thay đổi theo thời gian: đổi tên bảng, đổi tên cột, thêm cột mới, bỏ cột. Bất kỳ thay đổi nào với data contract đều sẽ gây lỗi trong pipeline. Và theo báo cáo (demo trong video đăng ngày 29/10/2026), nguồn dữ liệu này đã đang làm những chuyện đáng sợ đó rồi.
Mục kế tiếp cho thấy dữ liệu có bao nhiêu khoảng trống: có những ngày làm việc không có giao dịch mua hàng, không có phiếu nhận hàng. Anh đặt câu hỏi: như vậy có bình thường không, hay có gì sai với việc giao dữ liệu? Trên màn hình, ba cặp bảng giao dịch có 9, 17 và 15 ngày làm việc không có dòng nào trong năm 2026, và tuần 2026-06-15 trống ở cả 6 bảng vì job extract không chạy (demo trong video đăng ngày 29/10/2026).
Một số bảng khác không được cập nhật chút nào, nhưng ở đây Claude nói đó là master data, có thể không thay đổi nhiều theo thời gian. Baraa gọi đây là một insight tuyệt vời. Báo cáo cũng cho thấy nguồn đang xóa dòng: trên màn hình là mục "Deletion indicator", các dòng đã xóa vẫn nằm trong file với cờ DELETION_FLAG L (demo trong video đăng ngày 29/10/2026).
Anh tổng kết (video đăng ngày 29/10/2026): profiling cho rất nhiều phân tích đáng giá, và nếu tự làm bằng tay thì sẽ tốn rất nhiều thời gian.
7. Biến cả quá trình thành skill profile
Quay lại Claude Code và project, Baraa nhắc lại (video đăng ngày 29/10/2026) rằng đọc trang web dễ chịu hơn nhiều so với tìm kết quả trong chữ của khung chat. Thường thì bước kế tiếp anh sẽ qua vài vòng chỉnh sửa (iteration) để hoàn thiện. Khi mọi thứ đã ổn, anh làm một việc: yêu cầu Claude tạo một skill từ toàn bộ quá trình.
Lý do: nếu sau này có một source system mới, hoặc vài bảng mới, anh không muốn giải thích lại mọi thứ từ đầu, cả quy trình lẫn những việc phải làm. Anh muốn Opus làm đúng những bước đó cho mọi source system tiếp theo, và để làm được vậy thì cần một skill. Theo anh (video đăng ngày 29/10/2026), tạo skill cũng rất đơn giản: bảo Claude biến cái này thành skill, và đặt cho nó một cái tên, ví dụ "profile". Prompt trên màn hình:
Make a skill out of this profile and call it profile.
Chỉ vậy thôi. Theo Baraa (demo trong video đăng ngày 29/10/2026), khi gửi prompt này, Opus đi qua toàn bộ cuộc hội thoại, phân tích nó, rồi tạo một skill trong project. Skill nằm trong thư mục .claude, mục skills, ví dụ ở đây là thư mục profile. Theo tài liệu Claude Code (đọc ngày 29/10/2026), một skill trong project nằm ở .claude/skills/<tên>/SKILL.md và gọi được bằng /tên-skill.
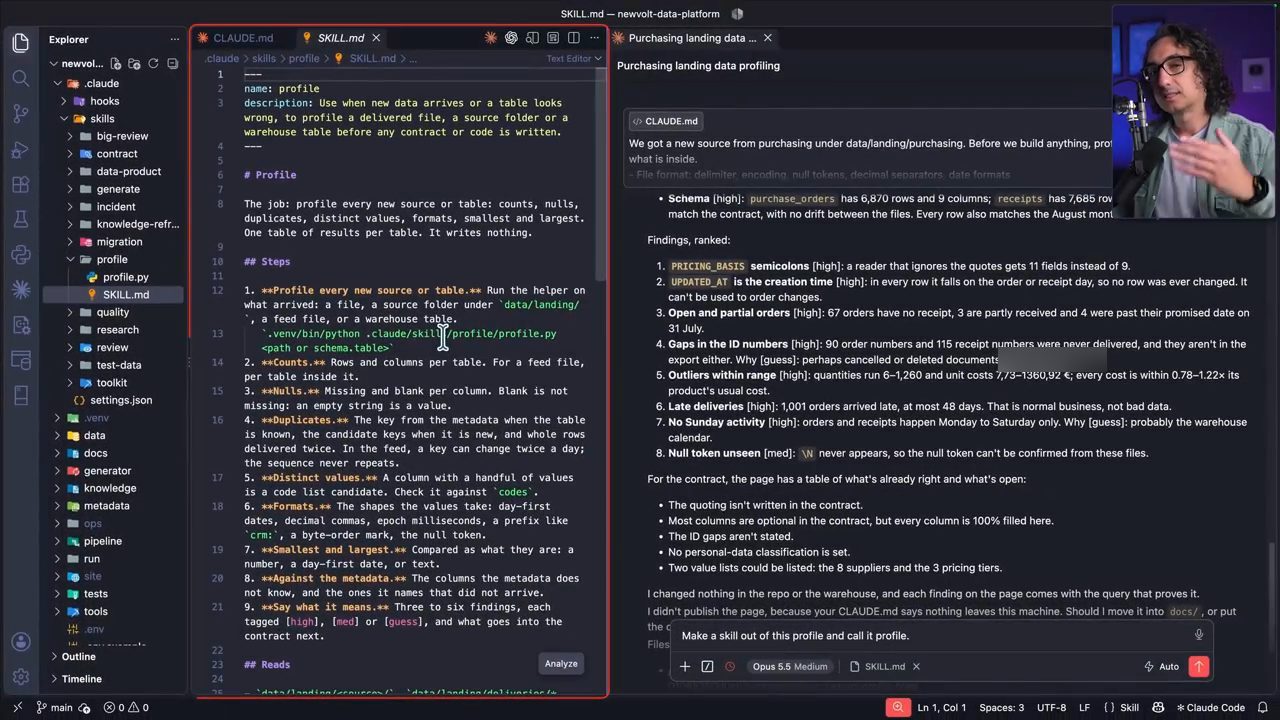
profile.py trong cùng thư mục, và các bước Counts, Nulls, Duplicates, Distinct values, Formats, Smallest and largest, Against the metadata, Say what it means.Anh nói đây không phải chuyện gì to tát. Mở thư mục ra sẽ thấy file SKILL.md: một bản mô tả đầy đủ quy trình mà Claude đã làm để profile source system. Nó chỉ là một file text, một lời giải thích cách làm. Ngoài ra, Opus còn đặt vào đó toàn bộ code cần thiết để thực thi task (demo trong video đăng ngày 29/10/2026). Thế là xong: skill engineering thứ nhất, tùy biến hoàn toàn cho project này.
8. Skill thứ hai: incident và knowledge layer
Skill thứ hai là incident. Với một data engineer, việc làm trước tiên mỗi sáng là kiểm tra pipeline. Nếu có gì fail, mọi kế hoạch trong ngày coi như bỏ, vì cuối cùng ai cũng chờ dữ liệu mới từ pipeline của mình, và nếu có gì hỏng thì mình chịu trách nhiệm. Vì thế, theo Baraa (video đăng ngày 29/10/2026), đó trở thành task số một của ngày hôm đó: tìm ra vấn đề, sửa pipeline, và đưa dữ liệu mới tới mọi người.
Baraa nói (video đăng ngày 29/10/2026) việc này không hề dễ và tốn nhiều thời gian, có khi hơn một ngày. Theo anh, data engineer không dành toàn bộ thời gian để viết code; họ dành một nửa chỉ để sửa pipeline hỏng. Câu hỏi là Claude Code giúp được gì với nỗi đau này.
Trước khi giao cho Claude bất kỳ task nào, anh cho xem một thứ anh làm trong gần như mọi project Claude: dựng knowledge layer. Theo anh (video đăng ngày 29/10/2026), đó đơn giản là lịch sử tích lũy dần trong quá trình làm project, và anh dùng nó để AI học và hiểu project sâu hơn.
Vì đang nói về incident, có thể dựng một thứ như một cuốn log. Anh nói rõ: không phải log kỹ thuật dùng trong pipeline. Anh nói về việc mọi vấn đề xảy ra trong project đều phải được ghi biên bản (protocol) và ghi vào file này. Theo anh (video đăng ngày 29/10/2026), việc này rất quan trọng trong mọi project thật, vì incident lặp lại: cùng một lỗi có thể xảy ra hết lần này tới lần khác. Thay vì nghĩ lại từ đầu mỗi lỗi, mình ghi lại cách đã sửa nó.
Thứ này thường chỉ nằm trong đầu các senior data engineer, vì họ đã thấy cùng một lỗi nhiều lần, và đó là lý do họ phản ứng nhanh hơn một junior. Baraa làm đúng điều đó: ghi mọi incident vào một file YAML, bảo đảm AI đọc nó và cũng ghi vào đó mọi điều mới, để không phải bắt đầu lại từ đầu mỗi lần. Trên màn hình, file nằm ở knowledge/incidents/log.yaml, mỗi incident có id (INC-001, INC-002…), ngày, tiêu đề, bảng, cause, workaround, fix, status và class_check (demo trong video đăng ngày 29/10/2026).
Theo Baraa (video đăng ngày 29/10/2026), đây là một trong những điều hay có thể làm trong các project Claude cho công việc engineering.
9. Prompt điều tra incident và phần đầu báo cáo
Prompt nói rằng job hằng ngày có một incident và Claude phải điều tra nó theo đúng những bước mà data engineer vẫn làm. Thứ nhất là hiểu nó fail ở đâu: vị trí, trạng thái, chuyện gì đã xảy ra. Rồi tìm root cause: sự kiện nào đã gây ra vấn đề, vì sao nó xảy ra. Sau đó kiểm xem đã từng gặp vấn đề này chưa, đúng điều anh nói về cuốn log.
Theo Baraa (video đăng ngày 29/10/2026), khi đã hiểu cái gì, ở đâu và vì sao, thì phải bắt đầu sửa, và ở đây có nhiều cấp. Thứ nhất là tìm workaround để cứu ngày hôm đó, để mọi người khác vẫn làm việc được với dữ liệu mới. Rồi anh yêu cầu tìm giải pháp để những ngày sau không gặp lại vấn đề này. Sau đó anh yêu cầu tìm các rủi ro trong tương lai, vì có thể điều tương tự xảy ra ở chỗ khác trong pipeline. Cuối cùng, anh yêu cầu soạn hai email: một cho khách hàng (consumer), một cho source system, nếu vấn đề tất nhiên là đến từ nguồn.
Sau đó Claude phải ghi mọi thứ vào log, rồi trình bày kết quả trong một file HTML như lần trước. Phần prompt đọc được trên màn hình:
The daily job of 2026-08-19 failed. Investigate the incident:
- Where it failed
- Status: the severity, the impact and the next step
- What happened: the run step by step, with each quality gate
- Root cause: what changed, with the rows before and after
- Seen before: check the incident log for the same kind of failure and its known fix
- Workaround: how we get fresh data to the consumers today
- Solutions: 2 options with the effort of each, and which one you recommend
- Future risks
- Email drafts: one to the consumers and one to the source owner
- Log entry
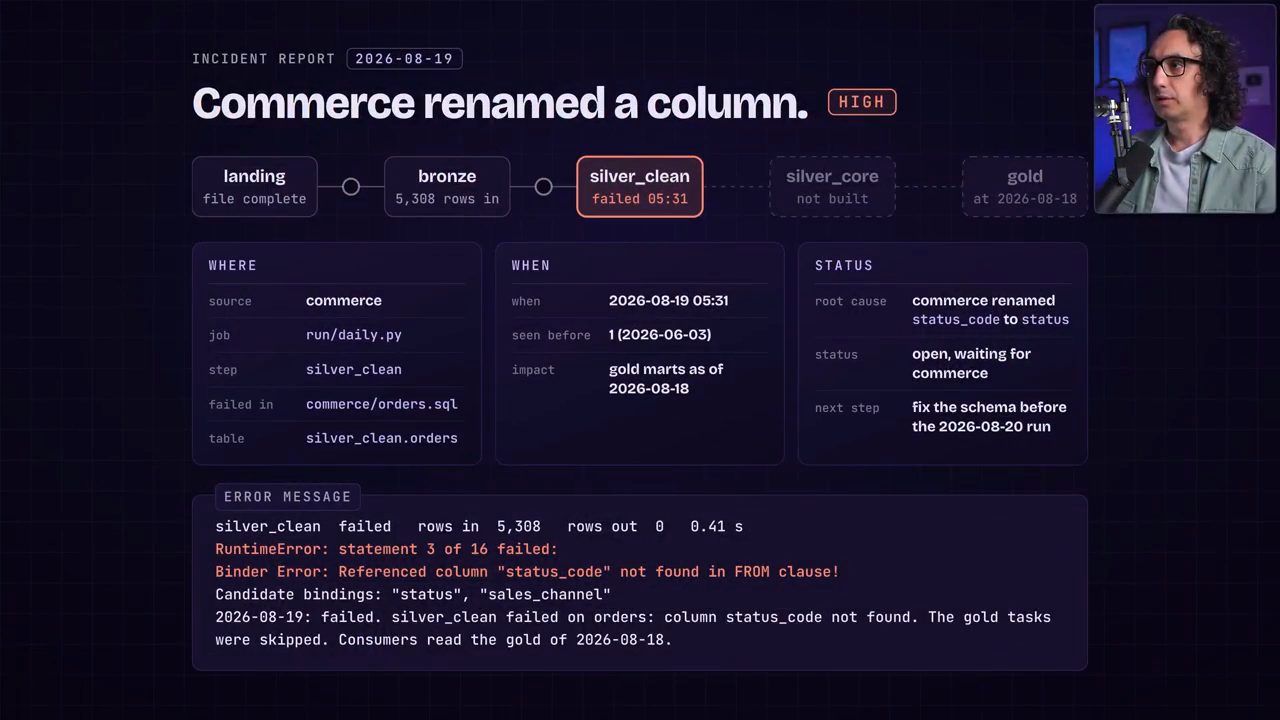
Anh nói việc này có thể mất một chút thời gian. Báo cáo incident từ Opus (demo trong video đăng ngày 29/10/2026) mở đầu bằng nơi xảy ra vấn đề: incident nằm ở silver layer. Rồi đến thông tin "ở đâu": source system nào, job nào, script nào, bảng nào, và xảy ra khi nào. Tiếp đó là trạng thái, và báo cáo đưa ra cả thông báo lỗi để mình hiểu chuyện gì đã xảy ra.
10. Root cause, workaround, hai giải pháp, rủi ro và email nháp
Rồi đến root cause, tức là vì sao chuyện này xảy ra. Baraa đọc phần chữ trên màn hình: hệ thống nhận một lần giao dữ liệu từ source system với schema mới, có gì đó trong cấu trúc đã đổi. Cột status_code giờ được gọi là status, tức source system đã đổi tên một thứ ở phía nguồn (demo trong video đăng ngày 29/10/2026).
Theo anh, đây là một trong những vấn đề kinh điển do schema drift: một source system thay đổi gì đó mà không báo, mình không chuẩn bị, và nếu schema không khớp thì pipeline có thể hỏng. Báo cáo cũng đặt hai bản cạnh nhau: trước đó cột tên là status_code, sau đó tên là status. Không chỉ vậy, có vẻ còn có thêm một cột mới (sales_channel trên màn hình). Tức là phía nguồn đã có một bản release mà phía anh không chuẩn bị (demo trong video đăng ngày 29/10/2026).
Đã thấy chuyện này trước đây chưa? Có: nó từng xảy ra với một bảng khác, một cột khác, và Claude lấy thông tin đó từ cuốn log. Trên màn hình, dòng "Known fix" ghi lần đó tên mới được map vào cột của data contract, 3 file pipeline của bảng được tạo lại, job chạy lại cho ngày 2026-06-03, và xử lý xong trong 2 giờ (demo trong video đăng ngày 29/10/2026). Nhờ vậy mình hiểu luôn cả vì sao.
Sau đó là workaround và các giải pháp. Workaround nhanh mà báo cáo đưa ra là yêu cầu source system gửi lại một file mới với schema cũ. Baraa nói thêm: chúc may mắn với việc đó. Nếu không, gold layer, tức các mart, cũng chưa đến nỗi tệ: nó chỉ đang giữ dữ liệu của hôm qua. Nếu khách hàng kiên nhẫn thì họ có thể chấp nhận. Dù sao thì vẫn cần một giải pháp (demo trong video đăng ngày 29/10/2026).
Opus đưa ra hai giải pháp (demo trong video đăng ngày 29/10/2026). Giải pháp một là sửa: vào script của mình và đổi tên theo. Opus khuyến nghị cách này, với thời gian ước tính ba giờ. Giải pháp hai có thể lâu hơn, tức tốn kém hơn: thêm một lớp kiểm soát chất lượng dữ liệu, một gate để so sánh schema. Nếu có gì sai, bản ghi đó ở lại trong bronze, không được xử lý tiếp lên silver và gold, còn job vẫn chạy tiếp mà không làm fail cả hệ thống.
Theo Baraa (video đăng ngày 29/10/2026), đó là một cơ chế hay có thể triển khai nếu nó là chiến lược của team. Tất nhiên nó phức tạp hơn và cần nhiều công sức hơn giải pháp một, nhưng Claude đưa ra cả hai và người quyết định chiến lược là mình. Trên màn hình, giải pháp hai tên "Check the schema at gate 1", ước tính 2 ngày, và một trong các ý của nó được khoanh đỏ: cột mới ở lại bronze và được báo cáo, job không fail (demo trong video đăng ngày 29/10/2026).
Về rủi ro tương lai, anh đoán trước khi đọc: báo cáo sẽ nói chuyện này có thể xảy ra với các source system khác. Và đúng vậy, theo báo cáo (demo trong video đăng ngày 29/10/2026), chừng nào chưa đưa giải pháp "thông minh" (giải pháp hai, giữ job tiếp tục chạy) vào, thì chuyện này có thể xảy ra lần nữa. Thế là có thêm cả phần quản lý và phân tích rủi ro.
Sau đó là thứ Baraa thấy rất hay: hai email nháp (demo trong video đăng ngày 29/10/2026). Một gửi cho consumer, anh chỉ việc copy cả email và gửi đi, tất nhiên là kiểm tra trước. Một gửi cho source owner, tức source system.
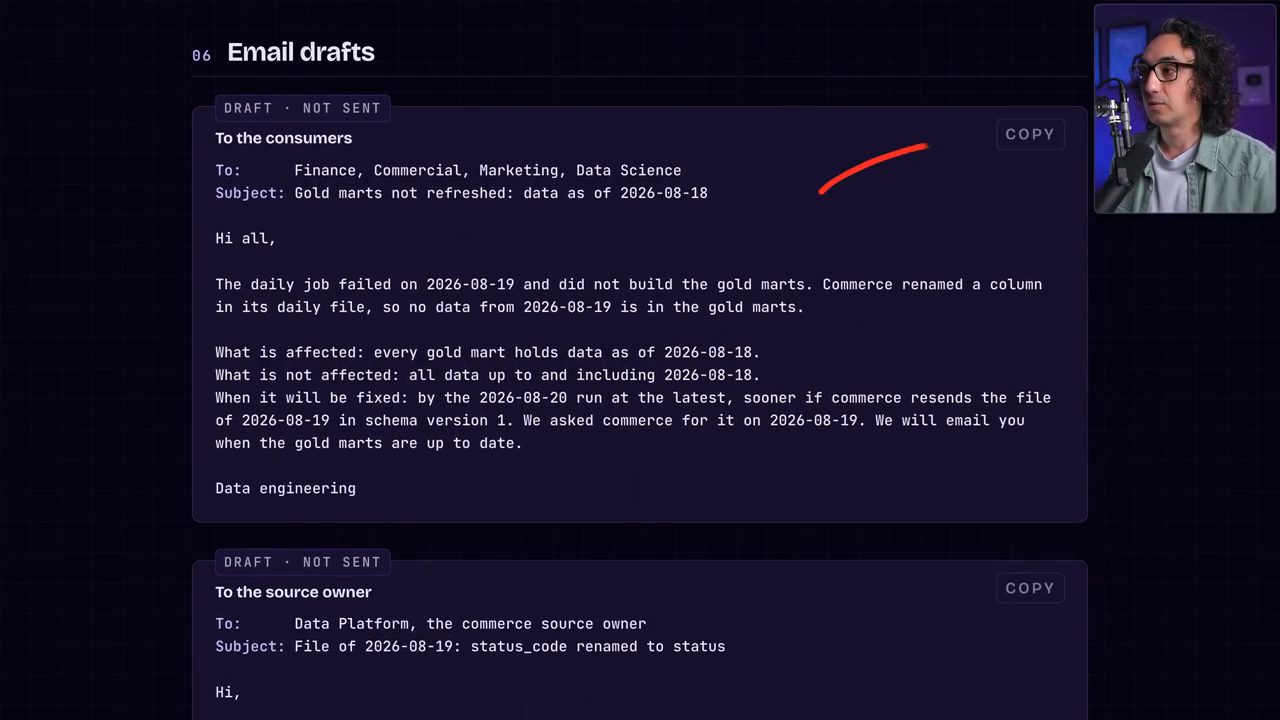
Theo anh, khi incident xảy ra, data engineer phải làm rất nhiều việc giao tiếp. Cuối cùng, Claude đã ghi biên bản mọi thứ vào log (demo trong video đăng ngày 29/10/2026). Anh tổng kết: khi một incident xảy ra, mình phải làm tất cả những việc này, tìm cái vì sao, cái gì, như thế nào, workaround, và giao tiếp; theo anh (video đăng ngày 29/10/2026), có AI hỗ trợ thì quá trình này sẽ nhanh hơn trước rất nhiều.
11. Skill incidents, lệnh /schedule và routine trên cloud
Bước tiếp theo, nếu đã hài lòng với kết quả từ Claude và không cần chỉnh thêm, thì bảo nó tạo một skill mới, ví dụ tên incidents (theo Baraa, video đăng ngày 29/10/2026). Trong thư mục skills của anh đã có skill incident. Lần sau, anh không phải đi lại từ đầu: chỉ cần gọi /incidents, đưa tên log chẳng hạn, và nó sẽ chạy cả workflow từ đầu.
Một việc nữa anh làm với Claude (video đăng ngày 29/10/2026), ngoài tạo skill, đúng cho tình huống này: lên lịch cho một skill. Khi một việc xảy ra lặp đi lặp lại vào một thời điểm cụ thể, có thể lên lịch cho nó, giống hệt như lên lịch cho pipeline, nhưng lần này là cho Claude.
Vì sáng nào anh cũng kiểm log và pipeline, trong demo (video đăng ngày 29/10/2026) anh bảo Claude: /schedule, mỗi ngày vào giờ này, trước khi anh thức dậy hay pha cà phê, kiểm log pipeline gần nhất xem có fail không, nếu có thì chạy skill incident, để khi bắt đầu ngày làm việc thì báo cáo đã sẵn sàng. Prompt trên màn hình:
/schedule Every day at 05:45 UTC,
check the last pipeline logs If it failed,
run /incident for that date and give me the report.
Anh chạy thử, và lịch đã được tạo. Trên màn hình là một routine tên "Newvolt pipeline morning check", chạy mỗi ngày lúc 05:45 UTC, trạng thái enabled, chạy trong môi trường cloud mặc định của Anthropic, các tool chỉ đọc (demo trong video đăng ngày 29/10/2026). Với nó, sáng nào cũng có một báo cáo mới.
Anh đoán trước một câu hỏi: muốn chạy skill thì phải để máy tính bật, không được tắt máy à? Theo Baraa (video đăng ngày 29/10/2026), không: đây là thứ gọi là routine trong Claude. Routine là một task được lên lịch trên server của Anthropic, trên cloud, và nó cũng được kết nối với repository GitHub của mình. Nghĩa là có thể gập máy, tắt máy, và task vẫn chạy trên server. Tài liệu Claude Code cũng ghi các scheduled task (trước gọi là routine) chạy trên hạ tầng cloud do Anthropic quản lý, nên vẫn chạy khi laptop đóng (đọc ngày 29/10/2026).
12. Skill thứ ba: xây metadata
Một skill engineering khác rất liên quan, theo Baraa (video đăng ngày 29/10/2026), là xây metadata. Metadata được dùng cho nhiều thứ: lineage, chất lượng dữ liệu, và cả cho các generator. Một trong những thứ quan trọng nhất phải đưa vào metadata cũng là thứ rất phiền: phải viết mô tả cho từng bảng và từng cột.
Theo Baraa (video đăng ngày 29/10/2026), đây là một task engineering mà nếu cam kết làm, team có thể mất một hai tháng chỉ để điền metadata. Một thẻ chữ trong video ghi "1-2 months …just filling the metadata". Vì thế anh đã gặp nhiều team engineering bỏ qua việc này vì đơn giản là không có thời gian, và họ bỏ lỡ nhiều thứ hay. Theo anh (video đăng ngày 29/10/2026), giờ không còn lý do gì nữa vì đã có AI.
Anh bắt đầu thế này: có một file metadata, dạng YAML, mô tả một nguồn, một bảng. Nó rất đơn giản: tên bảng, mô tả, rồi danh sách các cột. Mỗi cột có tên, kiểu và mô tả. Tới lúc đó, anh làm mọi thứ bằng tay. Có nhiều cách để làm việc này, nhưng riêng phần mô tả thì đôi khi phải đi đọc tài liệu.
Giờ anh có thể tự mở rộng sang bảng tiếp theo, hoặc bắt đầu dùng Claude. Theo anh (video đăng ngày 29/10/2026), nếu cứ để Claude đi qua và đoán thì không tốt; phải cung cấp thông tin, tức là mang context tới cho nó. Thứ nhất, nó phải biết tất cả các bảng và cột, nên phải trỏ nó tới dữ liệu. Ví dụ anh có vài file export dạng CSV, và từ đó nó sẽ trích tên bảng, tên cột và kiểu dữ liệu.
Nhưng trong CSV thường không có mô tả, nên phải cung cấp thông tin đó, ví dụ bằng tài liệu. Nếu có PDF hay bất kỳ nguồn mô tả nào cho các nguồn dữ liệu, như vậy là đủ. Ở đây anh có một tài liệu mô tả source system, chứa nhiều thông tin mà Claude có thể dùng để sinh mô tả. Trên màn hình là một PDF tên "Goods receiving at Leipzig" (demo trong video đăng ngày 29/10/2026).
Anh nhấn mạnh một điều rất quan trọng: trước khi làm bất cứ gì, luôn hỏi về chính sách của công ty mình xem có được phép dùng hay không.
Theo Baraa (video đăng ngày 29/10/2026), với những thứ đó, Claude có đủ mọi thứ để mở rộng file metadata của anh. Anh bảo nó mở rộng file metadata theo ví dụ của anh, với ba bước. Thứ nhất, trích thông tin kỹ thuật từ dữ liệu bằng script Python; theo anh, điều này rất quan trọng để AI không tự bịa metadata. Thứ hai, trích mô tả từ PDF. Cuối cùng, nếu không tìm thấy gì trong PDF thì để trống, để nó không đoán metadata. Trên màn hình, prompt bắt đầu bằng "Extend the metadata file purchase_orders.yaml following my example:", trỏ tới file goods-receiving.pdf trong thư mục data/documents của project, và kết thúc bằng "Where the PDFs say nothing, leave the description empty, don't invent metadata." Model chọn là Opus 5.5 mức Extra high.
Khi xong, nhìn vào metadata thì thấy tất cả các bảng còn lại đã có mô tả lẫn thông tin kỹ thuật. Không chỉ vậy, Claude còn tạo một đoạn code Python để trích những thông tin đó, nên lần sau có bảng mới thì chỉ cần chạy lại script (demo trong video đăng ngày 29/10/2026).
13. Fan out với 10 agent và các generator
Bước tiếp theo: trong project data engineering thường không chỉ có một source system mà có nhiều nguồn. Baraa kể (video đăng ngày 29/10/2026) trong một project của anh từng có hơn 1000 bảng từ 12 nguồn. Hãy tưởng tượng quá trình đau đớn khi làm tất cả một mình. Ví dụ vừa rồi chạy rất nhanh, nhưng nếu có rất nhiều bảng thì có thể nâng mọi thứ lên một tầm khác.
Ví dụ ở đây là Ultracode: theo Baraa (video đăng ngày 29/10/2026), khi bật nó, Claude sẽ bắt đầu dựng cả một "đội quân" agent để làm việc, tức là fan out. Anh cũng có thể chỉ định số agent nó nên dùng, ví dụ bảo nó thuê 10 agent để xây metadata theo cùng cách cho 10 nguồn còn lại. Prompt trên màn hình, với Opus 5.5 mức Extra high và Ultracode bật:
Go hire 10 agents to build the metadata in the same way for the other 10 sources
Theo Baraa (video đăng ngày 29/10/2026), như vậy sẽ nhanh hơn, và session chính vẫn là người điều phối (orchestrator) của cả 10 agent đó.
Anh không ngồi chờ trong video (demo trong video đăng ngày 29/10/2026): anh đã chạy việc này từ trước, và nhờ đó có đủ metadata từ các nguồn khác. Với nó, anh có bộ metadata lõi sẽ cung cấp dữ liệu cho toàn bộ project.
Từ đó có thể bắt đầu dùng generator. Ví dụ khi dựng pipeline, ở silver layer, trong các câu SQL người ta thường thêm mô tả cho các cột. Thay vì thêm tất cả bằng tay, có thể dựng generator cho việc đó. Theo Baraa, đây tất nhiên là một concept engineering nâng cao, khi có rất nhiều nguồn và bảng. Và theo anh (video đăng ngày 29/10/2026), với Claude có thể tăng tốc cả việc xây metadata lẫn việc tạo ra chính những generator đó.
14. Skill thứ tư: engineering toolkit và sơ đồ kiến trúc
Phần tiếp theo, theo Baraa (video đăng ngày 29/10/2026), là một phần rất thú vị, đã làm cuộc sống của anh dễ thở hơn với tư cách một engineer: tạo engineering toolkit bằng Claude.
Vấn đề là data engineer nhận những task rất phức tạp và không được mô tả rõ. Không ai mô tả từng bước cách làm cho mình. Vì thế phải mất nhiều thời gian phân tích, lên kế hoạch, hiểu phải mở rộng hàm nào, các hàm phụ thuộc nhau ra sao, dữ liệu đến từ đâu, data model sẽ nối với nhau thế nào. Rất nhiều câu hỏi và brainstorming cho tới khi tìm ra giải pháp, và theo anh (video đăng ngày 29/10/2026) chỉ khoảng 20% ở cuối là phần bắt đầu build.
Thêm nữa, theo anh (video đăng ngày 29/10/2026), project data engineering theo thời gian trở nên rất phức tạp khi thêm ngày càng nhiều thứ, và mình sẽ mất cái nhìn tổng thể. Ý tưởng là bảo Claude Code tạo các tool để thấy bức tranh lớn và hiểu sự phụ thuộc giữa các thứ, để dễ hiểu chỗ nào phải thay đổi.
Prompt yêu cầu build data engineering toolkit dưới dạng website dựa trên repo của project, với nhiều phần: vẽ data architecture, data lineage, call graph, data model, data quality, data catalog, tức là mọi thứ cần để có bức tranh lớn của project. Vì có nhiều việc, anh yêu cầu dùng sáu agent: nó phải fan out, mỗi agent một trang. Theo anh (video đăng ngày 29/10/2026), nếu muốn đẩy mạnh hơn thì có thể bật Ultracode, còn nếu không vội thì chỉ cần dùng một. Rồi anh chạy. Prompt trên màn hình:
Build the data engineering toolkit as a website based on this project repo:
- Architecture: drawn from what runs, not by hand
- Data lineage: every table, clickable, upstream and downstream
- Call graph: who calls what in the code
- Data model: the tables, keys and relationships
- Data quality: the quality gates and their results
- Data catalog: every table and column, with a sample and a description
Use 6 Claude Opus 5.5 agents, one per page, and let each one check its page against the repo.
Sau một lúc và vài vòng chỉnh sửa, anh có trang tổng quan từ Claude. Trang thứ nhất là overview của cả project, rồi tới các tool khác nhau (demo trong video đăng ngày 29/10/2026).
Ví dụ tool kiến trúc: dựa trên dữ liệu và các layer trong project, nó tạo một sơ đồ kiến trúc high level đẹp mắt, và bên dưới còn có bản chi tiết. Nó giải thích chính xác nguồn là gì, layer là gì: có landing, bronze, silver (hai silver layer), gold, rồi một semantic layer (demo trong video đăng ngày 29/10/2026). Theo Baraa, thường khi vào một project mới, anh mất rất nhiều thời gian vẽ lại toàn bộ để hiểu nó. Theo anh (video đăng ngày 29/10/2026), giờ có thể nhanh chóng có bản tổng quan này nếu project chưa có tài liệu gì về data architecture.
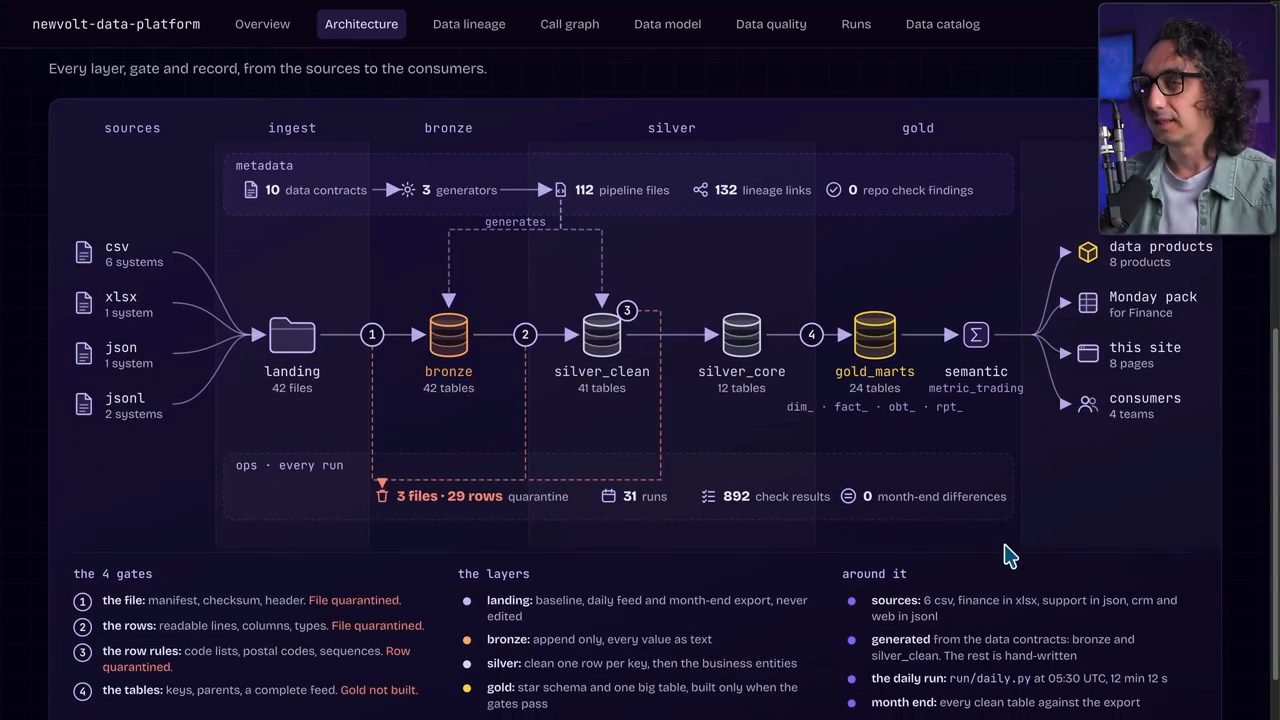
15. Data lineage, call graph, data model, data quality và data catalog
Tool tiếp theo là data lineage, thứ Baraa gọi là thật sự tuyệt vời. Nếu một khách hàng yêu cầu thay đổi một trong các bảng gold, anh chỉ cần bấm vào nó và thấy: bảng này đến từ hai bảng ở silver core, silver core lại đến từ ba bảng ở lớp clean, và từ silver đi ngược về bronze (demo trong video đăng ngày 29/10/2026). Anh thấy ngay toàn bộ data lineage, biết dữ liệu đến từ đâu và phải sửa chỗ nào. Theo anh (video đăng ngày 29/10/2026), đây cũng là thứ hay để đưa khách hàng xem khi bàn yêu cầu với họ.
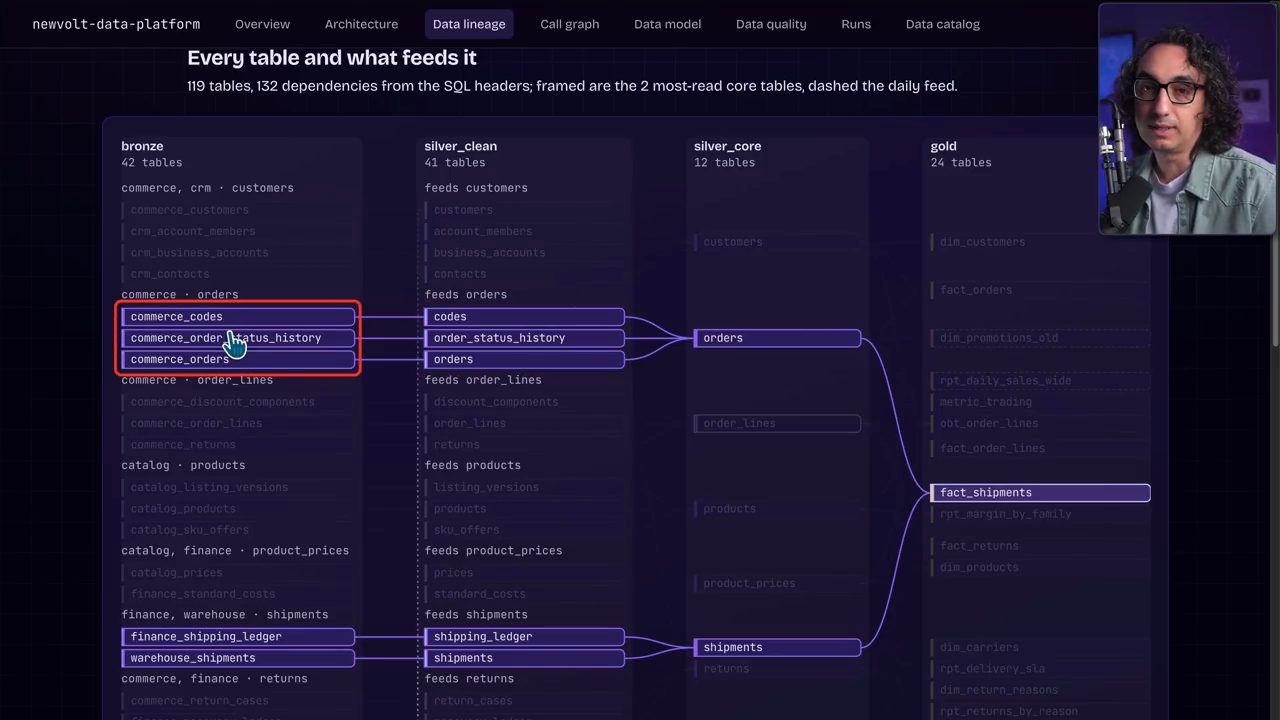
orders ở silver_core rồi tới fact_shipments ở gold.Tiếp theo là call graph. Theo Baraa, nó khá giống data lineage nhưng còn rối hơn. Nếu phát triển cả giải pháp bằng Python thì có thể có rất nhiều hàm gọi lẫn nhau, và rất khó hiểu nếu sửa chỗ này thì ảnh hưởng tới hàm nào khác. Anh thấy bản tổng quan này rất hay, vì có thể bấm vào một hàm và thấy toàn bộ phụ thuộc của nó (demo trong video đăng ngày 29/10/2026). Theo anh, kiểu trực quan này luôn làm việc của engineer dễ hơn khi bắt đầu thay đổi.
Tiếp theo tất nhiên là data model. Phần thứ nhất là bức tranh lớn: data model ở mức concept high level, thấy các entity và quan hệ giữa chúng mà không thấy nhiều chi tiết. Cuộn xuống thì thấy chi tiết: star schema của gold layer. Anh thấy đây cũng là cách rất hay để trực quan hóa các bảng liên quan với nhau thế nào (demo trong video đăng ngày 29/10/2026).
Tiếp theo là data quality. Ở đây lại có insight và bức tranh toàn cảnh về việc hệ thống thực sự khỏe đến đâu. Đó là một ma trận cho thấy tất cả các quality check, và check nào fail vào ngày nào (demo trong video đăng ngày 29/10/2026). Anh gọi đây là một tool rất hay và cần thiết.
Tiếp theo là data catalog: toàn bộ metadata của cả hệ thống, với các bảng của bronze, silver và gold. Ví dụ nếu cần tìm gì, thay vì lục qua script, anh chỉ việc gõ tên bảng và thấy chính xác kho dữ liệu của mình. Trong demo (video đăng ngày 29/10/2026), anh tìm và thấy có hai bảng tên fact orders.
Cuối cùng, như anh nói là vẫn như mọi lần, anh tạo một skill Claude từ nó (trên màn hình là skill toolkit). Nhưng anh nói không cần cập nhật nó thường xuyên; cập nhật giữa các bản release là đủ. Theo anh (video đăng ngày 29/10/2026), đây là lúc mở rộng trí tưởng tượng để tạo ra các tool hỗ trợ mình làm data engineer. Chúng nghe có vẻ như đồ phụ kiện hay xa xỉ, nhưng theo anh, chúng sẽ tiết kiệm rất nhiều thời gian và làm việc trong project dễ dàng hơn.
16. Data product: cửa sổ nhìn vào data warehouse
Tất nhiên còn nhiều skill khác mà data engineer có thể dùng. Ví dụ dùng nó để chuẩn bị data product, và lại không chỉ là viết code mà là mọi thứ xung quanh. Theo Baraa (video đăng ngày 29/10/2026), ở nhiều công ty, data engineer bắt đầu chuẩn bị dữ liệu dưới dạng data product để trở thành một phần của data mesh.
Nghĩa là nếu có dữ liệu sẵn sàng để dùng, phải làm cho nó dễ truy cập, dễ dùng, có tài liệu tốt và chất lượng cao. Không chỉ code phải hoàn hảo, mà dữ liệu cũng phải thành một sản phẩm để cung cấp cho người khác. Ý tưởng anh đưa ra (video đăng ngày 29/10/2026) là dùng Claude Code để xây sản phẩm đó.
Ví dụ, đây là một trang tổng quan do Claude xây (demo trong video đăng ngày 29/10/2026), có thể đưa cho khách hàng để họ duyệt các data product, như một cửa sổ nhìn vào data warehouse. Khi tìm thấy thứ phù hợp, họ sẽ vào bên trong để hiểu nó.
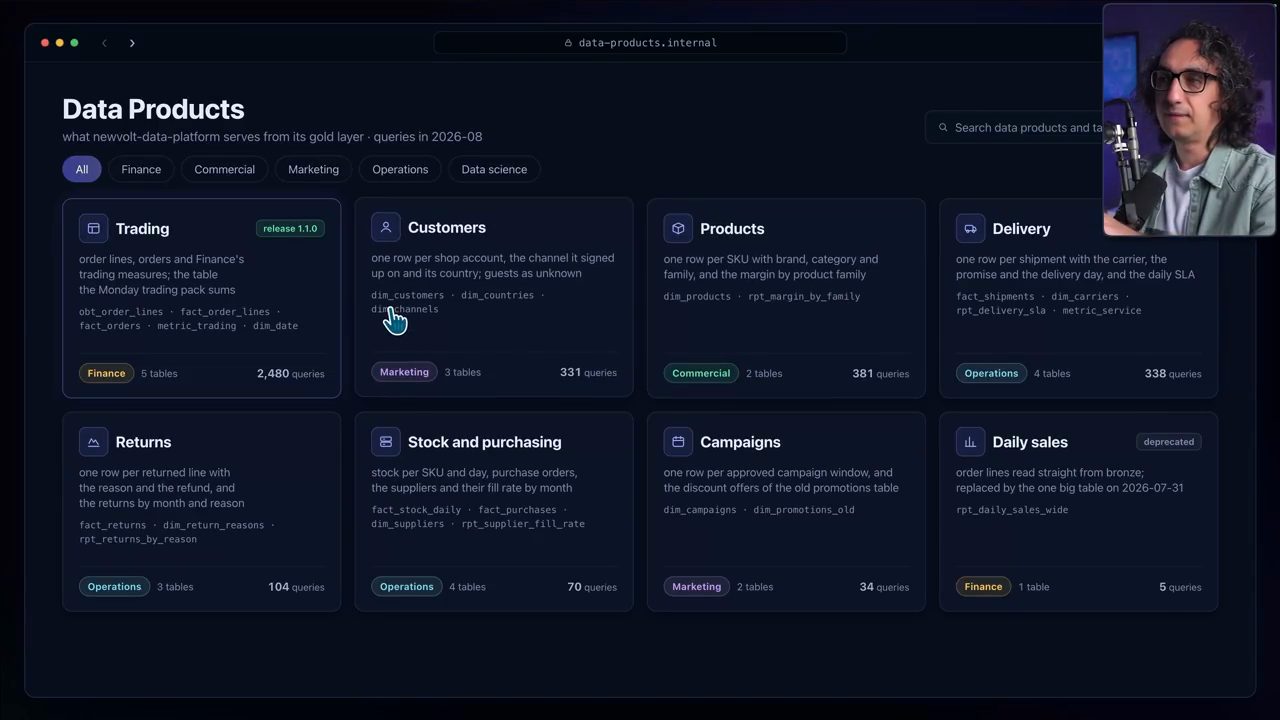
Bên trong, họ có thể hiểu data product lớn cỡ nào, bao nhiêu bảng, kích thước ra sao. Có thể có một hướng dẫn giải thích các bước đầu để kết nối tới data product. Cũng có thể đưa ra data model, để khách hàng biết cách nối và join các bảng. Rồi đến semantic layer, tức các metric, phần quan trọng để xây semantic layer. Rồi một số query mẫu, để cho thấy những query hay dùng nhất trên data product. Rồi chất lượng và các bản release, để mọi thay đổi đều rõ ràng. Trên màn hình, các tab của một data product là Overview, Guide, Data model, Metrics, Queries, Quality, Releases và Contract (demo trong video đăng ngày 29/10/2026).
Cuối cùng là contract, lần này là contract giữa mình và những người dùng data product. Baraa nói tất nhiên các công ty có thể có tool và chuẩn riêng để chia sẻ data product. Nhưng nếu chưa có và muốn tạo nhanh một thứ đẹp, theo anh (video đăng ngày 29/10/2026), có thể dùng Claude Code để tạo những trang HTML đó.
17. Review pull request và big review
Tất nhiên cũng có thể dùng Claude Code cho những việc kinh điển, ví dụ review pull request. Anh gửi Opus đi review từng dòng theo cách mình vẫn làm: thứ nhất là security, rồi tính đúng đắn, có trùng lặp không, có gì đi ngược các chuẩn đã đặt cho project không, ví dụ ai đó tự thêm một layer mới mà team chưa thống nhất. Tức là tất cả các bước review vẫn làm bằng tay. Trên màn hình, skill review có các bước: scope, security, correctness, portability, duplication, architecture and performance, documentation, style, và với mỗi finding thì ghi rủi ro, file, quy tắc và cách sửa đề xuất (demo trong video đăng ngày 29/10/2026).
Anh còn có một thứ gọi là big review (video đăng ngày 29/10/2026). Vấn đề là data engineer cứ build mãi: thêm nguồn mới, bảng mới, code mới, chiến đấu với incident, nhưng chưa bao giờ có lúc ngồi lùi lại nhìn toàn bộ giải pháp để tìm thứ gì đang đi sai hướng. Big review giống như một buổi retrospective cho cả project.
Thường anh làm việc này hai lần một năm. Nhưng theo anh (video đăng ngày 29/10/2026), giờ có Claude thì anh có thể làm bao nhiêu lần tùy thích mà không chặn cả project, vì việc này vốn tốn rất nhiều thời gian: phải review mọi code, mọi nguồn, kiến trúc, tất cả.
Anh cũng yêu cầu Claude build một skill và một trang tổng quan cho việc này. Ví dụ top 10 bảng của toàn bộ data product, để biết bảng nào được dùng nhiều nhất và bảng nào thực sự ít dùng. Có thể có top 10 query chậm nhất, tất nhiên nếu có log cho việc đó (demo trong video đăng ngày 29/10/2026).
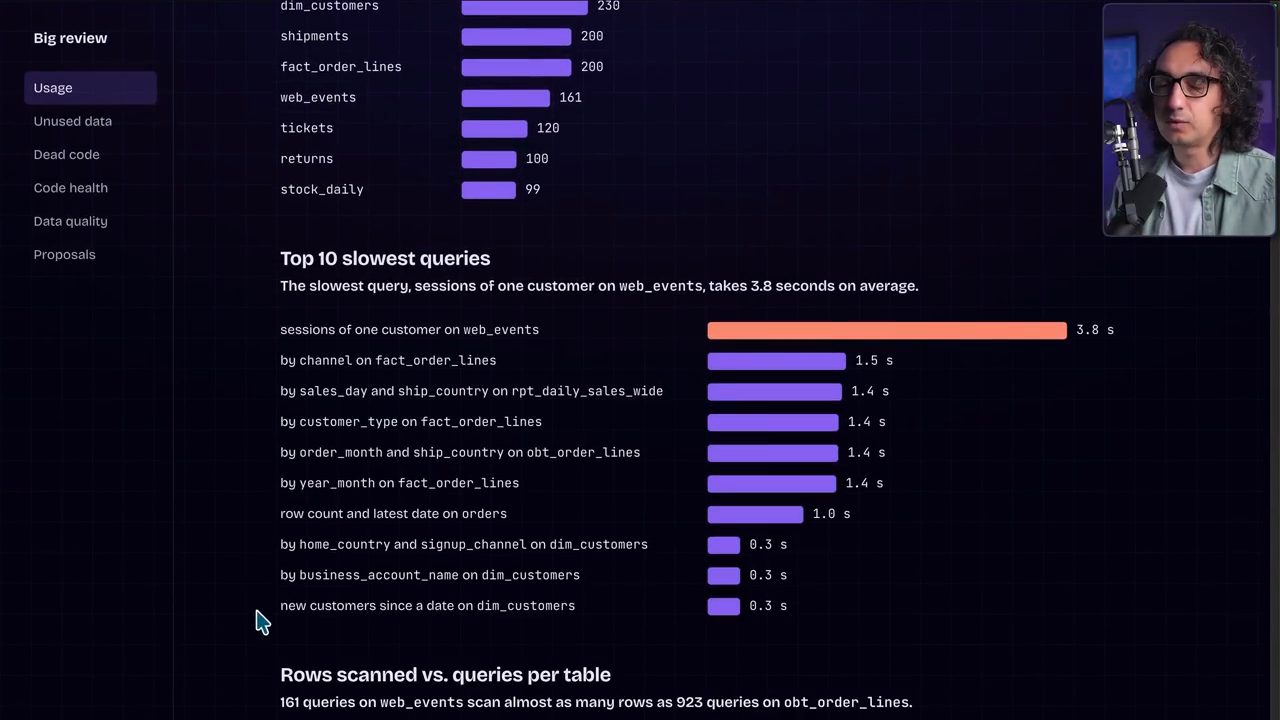
web_events, trung bình 3.8 giây; menu bên trái có Unused data, Dead code, Code health, Data quality và Proposals.Còn có những thứ khác, ví dụ dữ liệu không dùng: một danh sách các bảng chưa ai từng query, chỉ có pipeline cứ đổ dữ liệu vào mà không có khách hàng nào dùng (demo trong video đăng ngày 29/10/2026). Theo Baraa, nếu dùng một platform trả tiền theo mức dùng (pay as you go) thì đó là đang phí tiền.
Rồi tới tổng quan về storage. Theo anh (video đăng ngày 29/10/2026), việc này cũng rất quan trọng nếu làm trên cloud, để hiểu chỗ nào có thể cắt chi phí. Thêm nữa là các cột không dùng, hàm không dùng, tham số không dùng, và nhiều thứ khác. Tất cả là để dọn dẹp project, cắt chi phí, và giảm độ phức tạp của project.
18. Lời kết: niềm tin, và luôn review
Baraa kết lại: data engineering không chỉ là viết code, mà nhiều hơn thế rất nhiều. Theo anh (video đăng ngày 29/10/2026), đó chính là lý do các công ty trả lương cao cho data engineer và rất khó thay thế họ. Data engineer cũng là người mang dữ liệu sạch tới cho AI.
Theo anh (video đăng ngày 29/10/2026), Claude Code không chỉ có mặt để viết code; nó còn đọc, điều tra, thảo luận với mình, làm data profiling và nhiều việc khác. Theo anh, đó cũng là khác biệt giữa một data engineer không dùng AI và một người dùng AI để đi nhanh hơn.
Nhưng ở chiều ngược lại, anh nhắc phải rất cẩn thận khi dùng AI với dữ liệu, vì công việc này dựa trên niềm tin, và một khi mất niềm tin thì rất khó lấy lại. Vì thế: luôn review, và người đưa ra quyết định cuối cùng luôn là mình.
Anh cảm ơn mọi người đã xem.
Nguồn và liên kết 9 nguồn
- Tên gốc: How I Use Claude Code as a Data Engineer (After 17 Years in Data)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=F5lZj1bQyUw youtube.com
- Kênh YouTube Data with Baraa (Baraa Khatib Salkini): youtube.com/channel/UC8_RSKwbU1OmZWNEoLV1tQg youtube.com
- Repo công khai của Baraa với các skill Claude Code cho data engineering, gồm profile, incident, metadata, toolkit, data-product, pr-review và big-review (đọc ngày 29/10/2026): github.com/DataWithBaraa/claude-code-data-engineering-skills github.com
- Tài liệu Claude Code về CLAUDE.md, file Claude đọc lúc bắt đầu mỗi session (đọc ngày 29/10/2026): code.claude.com/docs/en/memory code.claude.com
- Tài liệu Claude Code về skill và file SKILL.md (đọc ngày 29/10/2026): code.claude.com/docs/en/skills code.claude.com
- Tài liệu Claude Code về scheduled task (trước gọi là routine), chạy trên cloud của Anthropic (đọc ngày 29/10/2026): code.claude.com/docs/en/routines code.claude.com
- Tài liệu Claude Code trong VS Code (đọc ngày 29/10/2026): code.claude.com/docs/en/vs-code code.claude.com
Related talks
5 skill Claude Code Matt Pocock dùng mỗi ngày
Matt Pocock · Matt Pocock · 17 min
Năm skill grill-me, write-a-prd, prd-to-issues, tdd và improve-codebase-architecture biến process kỹ thuật thành đường ray cho Claude Code.
Claude Code Skills là gì và cách tạo skill theo 6 bước
Giang · GiangxAI · 29 min
Skill trong Claude Code là gì, khi nào nên xây, 6 bước tạo skill qua demo skill tạo ảnh infographic, CLAUDE.md và ba tầng tải token.
Build, chạy và chia sẻ Claude skill
David DeWinter · Kevin Stratvert · 15 min
Tạo skill đầu tiên bằng skill-creator, chạy nó trong Chat, Cowork và Claude Code, rồi bốn cách chia sẻ skill cho team: zip, org skills, ổ chung, Git.