Dùng Jev cùng Claude Code: System 1 cho coding agent
Jev là model System 1 chấm xác suất cho các lựa chọn; Ray Amjad ghép nó với Claude Code để chọn skill, kiểm thử, lint, tìm code smell và review code rẻ.
✓ Đã duyệt độc lập · cập nhật 16/10/2026 · 27 min
1. Jev là gì: một model không sinh chữ mà chấm điểm các lựa chọn
Ray Amjad mở đầu bằng một lời thú nhận: anh gần như không bao giờ làm video về các model mới ra, nhưng model lần này hay tới mức không thể không làm. Video nói về một model tên là Jev, đặt theo tên nghịch lý Jevons (Jevons paradox): nó là gì, và làm sao kết hợp nó với các công cụ agentic coding như Claude Code hay Codex để trở thành những kỹ sư giỏi hơn nữa. Ai đã biết Jev là gì thì có thể nhảy thẳng tới phần ứng dụng; còn lại, anh giải thích Jev trước.
Theo Ray, một trong những video ngắn đơn giản nhất giải thích Jev là đoạn hoạt hình anh mở trên màn hình. Với một LLM bình thường, bạn đưa vào một prompt cùng với dữ liệu. Ví dụ: "hoá đơn này có gian lận không?" kèm theo chính hoá đơn đó. Model sẽ sinh ra cho bạn một câu kiểu "hoá đơn này có vẻ hợp lệ", từng token một. Và vì kiến trúc của LLM, việc đó có thể mất kha khá thời gian.
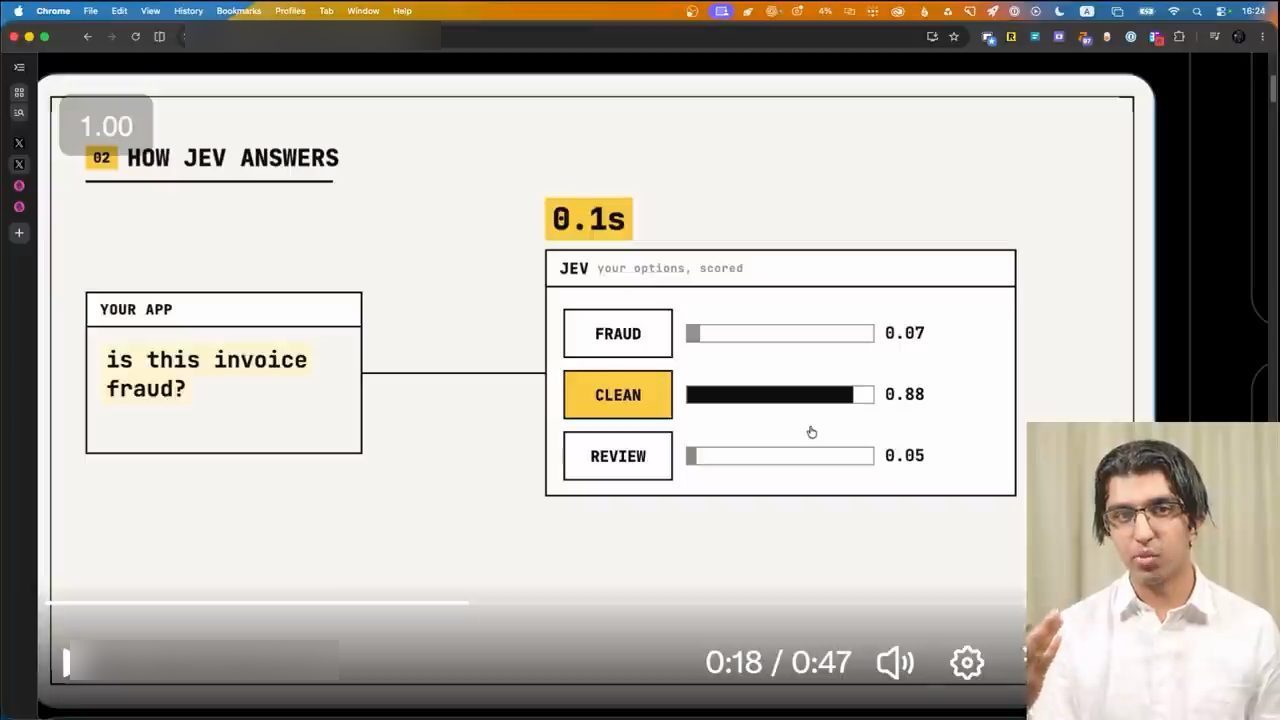
Với Jev thì khác. Bạn đưa cùng prompt đó, cùng dữ liệu đó, nhưng đưa thêm cả các lựa chọn (options): đây là những đáp án bạn được phép chọn, ví dụ gian lận (fraud), sạch (clean), hoặc cần người xem lại (human review). Jev sẽ chấm điểm các lựa chọn của bạn theo xác suất. Trong ví dụ này, nó nói có 88% xác suất là hoá đơn sạch. Bạn có thể đưa con số đó thẳng vào một câu lệnh if để ra quyết định thật nhanh.
Và vì cách kiến trúc của nó vận hành, Jev rất nhanh: thường bạn nhận được phản hồi trong chưa tới 200 tới 300 mili giây. Một cách nghĩ về nó là: Jev không sinh ra bất kỳ đoạn chữ nào. Bạn đưa vào một đoạn chữ, chẳng hạn một prompt, và nó trả lại xác suất cho một tập đáp án do chính bạn cung cấp.
Vì bạn lấy các xác suất đó rồi làm một hành động nào đó dựa trên chúng, Ray gợi ý hình dung Jev như một câu lệnh switch rất thông minh. Như phần sau của video sẽ cho thấy, điều này mở ra cả đống use case: dựng các workflow chạy bằng AI, ra quyết định trên khối lượng dữ liệu khổng lồ với chi phí cực rẻ, mở khoá các ứng dụng real-time như kiểm duyệt nội dung theo thời gian thực, và xây những hệ thống kiểm chứng (verification) thật tốt cho setup agentic coding của bạn.
Trên website (link trong phần mô tả video) có một danh sách chờ (waitlist). Khi đã ra khỏi waitlist, bạn vào console.typesafe.ai, mở mục Playground để thử nghiệm, và chơi với ba primitive bên trong Jev.
2. Playground và ba primitive: Noul, Score, Choice
Ray đi nhanh qua ba primitive, vì dù trong video chúng ta sẽ để agent tự implement Jev giúp mình, và agent sẽ dùng skill chính thức của TypeSafe, thì hiểu Jev chạy thế nào phía sau vẫn có ích. Ba primitive là:
- Noul: đánh giá một điều đúng tới mức nào.
- Score: đặt ra một rubric (thang chấm) để chấm theo.
- Choice: hỏi một câu trắc nghiệm nhiều lựa chọn.
Cả ba đều trả về xác suất. Nghĩa là ta định nghĩa sẵn các đáp án từ đầu, rồi đưa cho nó một thứ để đánh giá.
Anh bắt đầu với Noul. Ở ô câu hỏi, anh sửa thành "Is this invoice fraud?", đúng câu hỏi hoá đơn gian lận lúc nãy. Ở cột bên trái (State), anh dán vào một ít dữ liệu không có cấu trúc: một hoá đơn gian lận do anh tự bịa ra. Bấm Run request, kết quả là 85% true, vì khi đọc hoá đơn đó thì nó đúng là có gì đó đáng ngờ. Bấm Run request liên tục nhiều lần, anh thấy xác suất gần như giữ nguyên, chỉ dao động khoảng 2 tới 3%.
Tiếp theo, anh thêm phần định nghĩa thế nào là "true". Trong trường criteria, anh ghi "Matches the following:" rồi dán vào một danh sách dấu hiệu gian lận, bấm Run request, và thấy kết quả đổi thành 94% true; chạy đi chạy lại thì nó lởn vởn quanh con số đó.
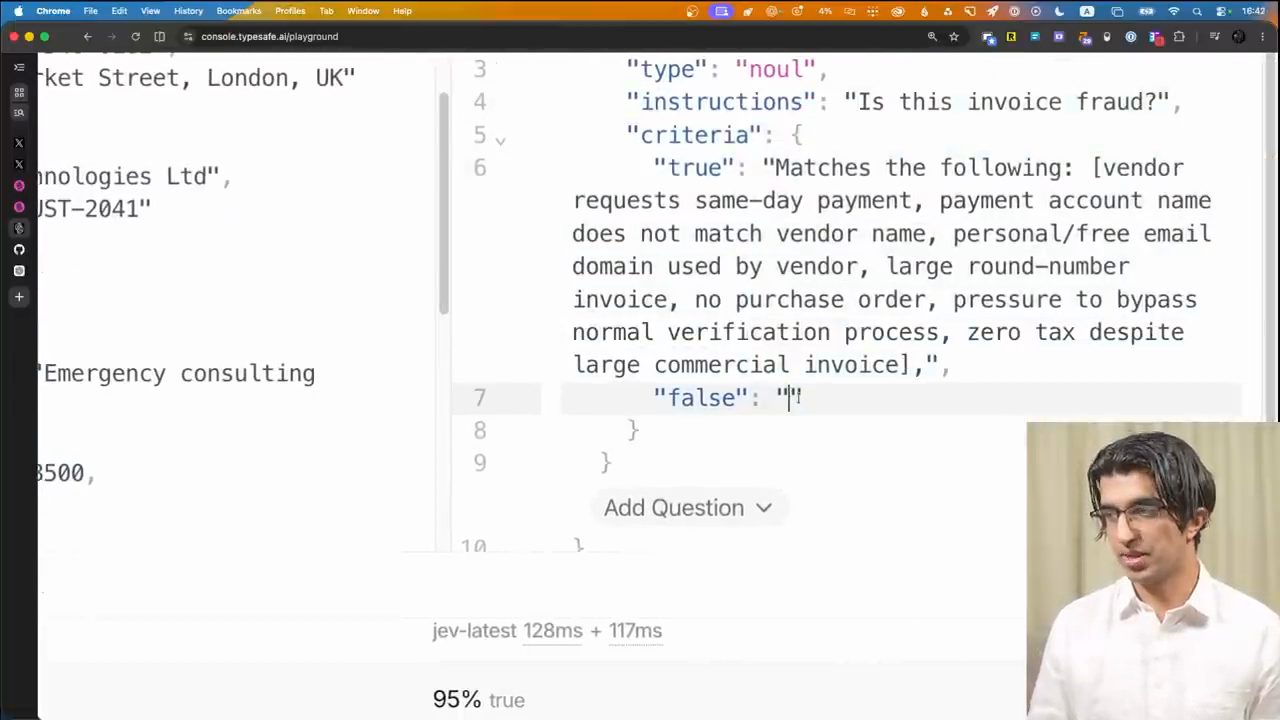
Phần câu hỏi trên màn hình trông như sau:
"type": "noul",
"instructions": "Is this invoice fraud?",
"criteria": {
  "true": "Matches the following: [vendor requests same-day payment, payment account name does not match vendor name, personal/free email domain used by vendor, large round-number invoice, no purchase order, pressure to bypass normal verification process, zero tax despite large commercial invoice],",
  "false": ""
}
Điều này rất hay, theo Ray, vì trong một ứng dụng ta có thể nói: nếu xác suất lớn hơn khoảng 85 tới 90% thì tự động từ chối hoá đơn, đại loại vậy. Cái hay là ta tự định nghĩa "true" và "false" thực sự nghĩa là gì bằng cách thêm thông tin vào đây, và ta nhận được câu trả lời rất nhanh, thường chỉ khoảng 100 mili giây. Câu trả lời đó còn đáng tin vì lần nào nó cũng gần như giống nhau.
Sau đó anh chuyển sang Choice, câu hỏi trắc nghiệm. Anh viết phần hướng dẫn kiểu: ta đang đánh giá hoá đơn xem có gian lận không, các dấu hiệu gian lận là thế này, nó có phải gian lận không? Rồi anh đổi các lựa chọn thành human review, fraud và clean, và xoá phần mô tả của từng lựa chọn vì anh thấy tên của chúng đã tự giải thích. Chạy thử, anh nhận được 98% fraud trong chưa tới 100 mili giây, kèm 2% human review.
Cách này tốt hơn true/false, vì giờ anh tự định nghĩa được nhiều lựa chọn để chọn. Trong danh sách lựa chọn, bạn có thể đưa vào tối đa 255 lựa chọn.
3. Score: đặt một thang điểm và rẽ nhánh theo điểm
Với Score, Ray bảo hãy hình dung nó như một dải phổ (spectrum). Ví dụ, nếu câu hỏi là "lead inbound này tốt tới đâu với đội sales của chúng ta?", anh có thể tự định nghĩa một dải phổ riêng rồi đưa cho Jev. Anh vẽ dải đó trên bảng trắng: mức 0 là sinh viên hoặc người làm cho vui, không có ngân sách; mức 1 là một team nhỏ, ngân sách không rõ; mức 2 là một công ty có vấn đề cụ thể và có mốc thời gian; mức 3 là một doanh nghiệp lớn có ngân sách, gửi tới bởi một người có quyền ký.
Định nghĩa tất cả những mức đó trong Jev thì nó sẽ trông như anh làm trên màn hình: mức này là 0, mức này là 1, rồi tới 2 và 3. Anh dán vào cột trái một lead khá lớn từ phía doanh nghiệp, bấm Run request, và Jev cho điểm 2.91. Trên dải phổ, lead đó nằm ở gần đầu bên phải, ngay sát mức 3.
Rồi trong logic của riêng bạn, bạn định nghĩa chuyện gì sẽ xảy ra ở từng khoảng điểm. Lớn hơn 2.5 thì founder trả lời ngay trong ngày. Từ 1.5 tới 2.5 thì một nhân viên sales trả lời trong tuần. Từ 0.5 tới 1.5 thì, ví dụ, họ nhận một email trả lời tự động. Trên bảng vẽ, Ray đánh dấu thêm: dưới 0.5 là trả lời tự động kèm link gói miễn phí, còn khoảng quanh mức 1 là trả lời tự động kèm tài liệu.
Anh cũng định nghĩa một rubric khác: "dòng log này nghiêm trọng tới đâu với kỹ sư on-call?". Mức 0 là một request bình thường, mức 3 là một sự cố sập hệ thống (outage). Anh dán vào một dòng log báo connection pool đã cạn, bấm Run request, và được 2.99. Nếu anh định nghĩa lớn hơn 2.5 là gọi kỹ sư on-call ngay, thì họ sẽ bị ping lập tức.
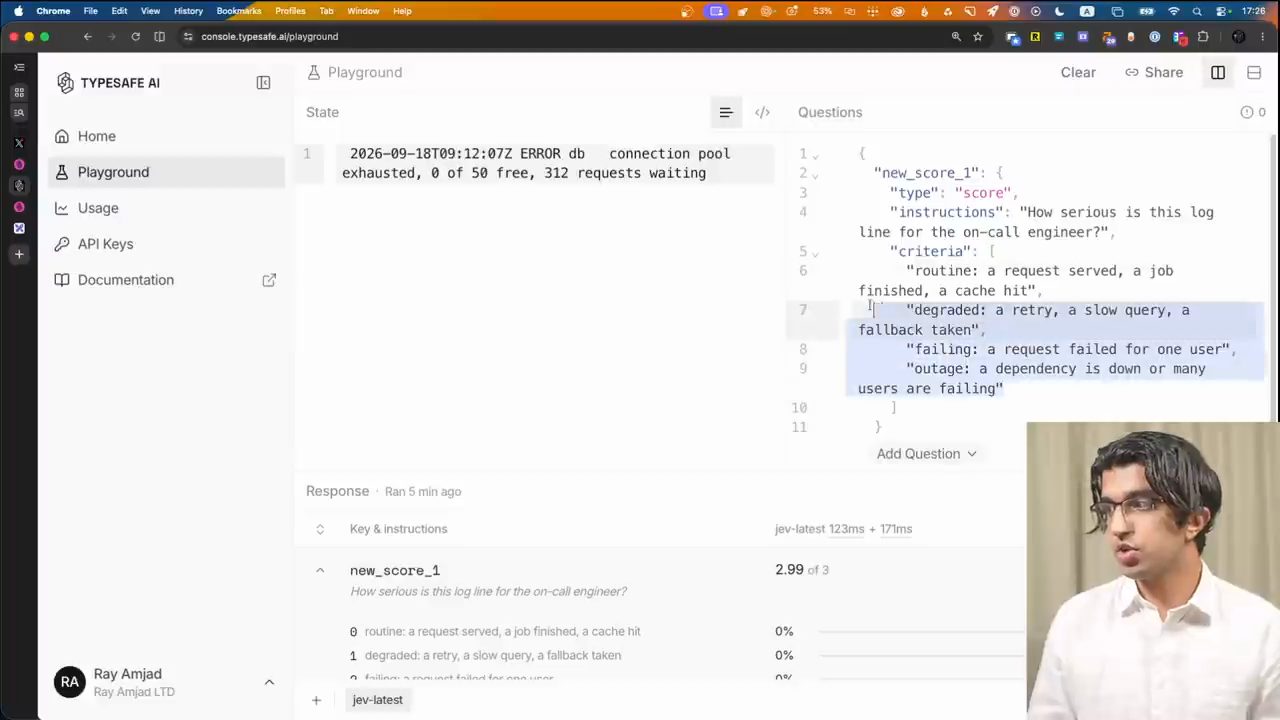
Câu hỏi Score trên màn hình:
"new_score_1": {
  "type": "score",
  "instructions": "How serious is this log line for the on-call engineer?",
  "criteria": [
    "routine: a request served, a job finished, a cache hit",
    "degraded: a retry, a slow query, a fallback taken",
    "failing: a request failed for one user",
    "outage: a dependency is down or many users are failing"
  ]
}
Và nếu muốn, vì Jev vừa rất rẻ vừa rất nhanh, bạn có thể để nó giám sát một hệ thống quan trọng gần như theo thời gian thực, rồi báo cho bạn khi có chuyện xấu xảy ra.
Có một giới hạn: khi chấm điểm, bạn chỉ định nghĩa được tối đa 11 mức rubric, nghĩa là điểm nằm trong khoảng từ 0 tới 10. Bạn không thể nhồi 255 mức vào danh sách này như với Choice; với các lựa chọn thì mới đưa được tới 255.
4. Hỏi nhiều câu một lúc, chọn primitive nào, và System 1 với System 2
Nếu muốn, bạn còn hỏi được nhiều câu cùng lúc bằng nút Add Question và chọn primitive Noul. Ray dán vào khoảng bốn câu hỏi. Tình huống là: anh giao một việc cho một coding agent, agent trả lại một diff những gì đã thay đổi, và Jev trả lời tất cả các câu hỏi đó cực nhanh. Ví dụ, nó nói diff có giải quyết đúng task, không làm yếu đi test nào, cho biết mức độ kiểm chứng mạnh tới đâu trên một dải phổ với rubric anh tự định nghĩa, và cả phạm vi rủi ro (risk surface) của thay đổi.
Ai tò mò điều gì làm Jev nhanh tới vậy thì có một bài đăng trên X giải thích khá kỹ; Ray không giải thích vì video sẽ bị quá dài.
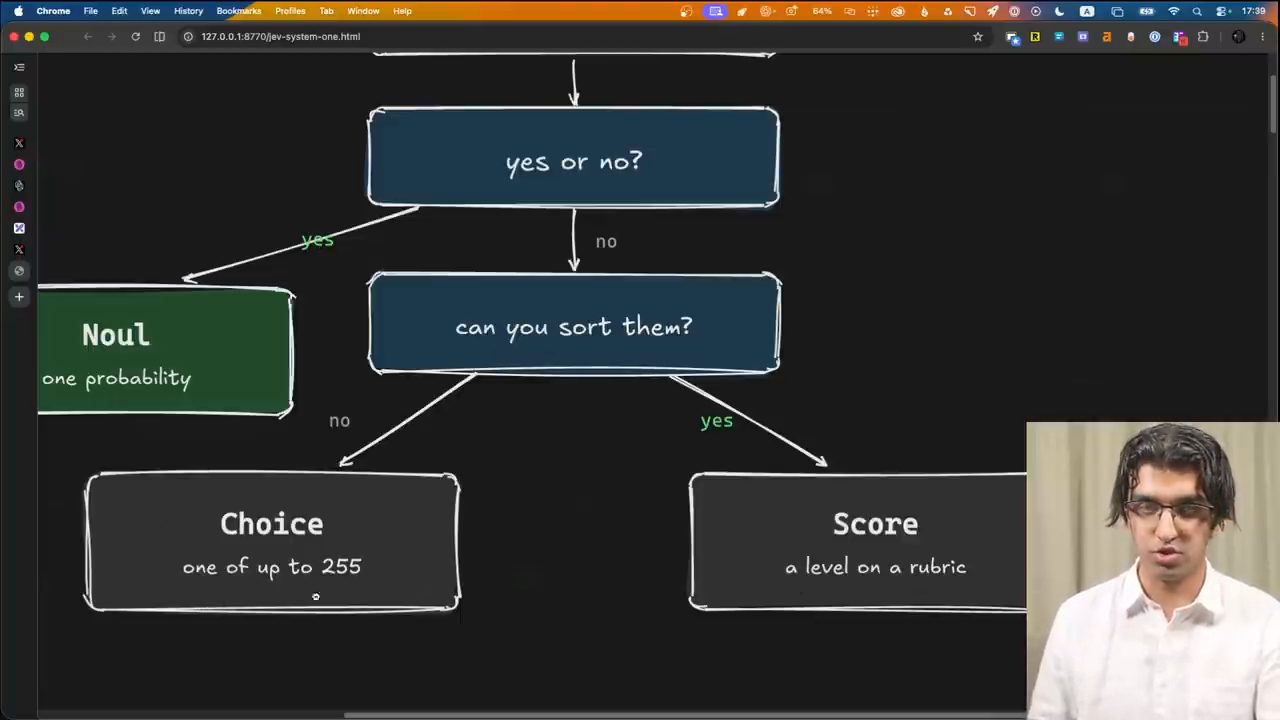
Để quyết định dùng primitive nào, anh đưa ra một sơ đồ mà anh thấy khá tiện. Về cơ bản: đây có phải câu hỏi có/không không? Nếu có, dùng Noul. Nếu không, bạn có xếp các đáp án dọc theo một dải phổ như anh vừa minh hoạ được không? Nếu được thì dùng Score. Nếu không thì dùng Choice.
Tiếp theo, Ray nói về tư duy System 1 và System 2 và cách nó áp vào Jev. Công ty TypeSafe gọi Jev là một "system one model": một lớp model frontier mới được xây để ra các quyết định có cấu trúc thật nhanh. Anh đoán ý tưởng này lấy cảm hứng từ cuốn Thinking, Fast and Slow, xuất bản khoảng 15 năm trước. Cuốn sách, nếu bạn chưa nghe, nói rằng ta có hai chế độ xử lý nhận thức tách biệt. System 1 là lối nghĩ nhanh, tự động, theo phản xạ, gần như không cần nỗ lực có ý thức. System 2 thì chậm hơn nhiều và có chủ đích.
Một ý quan trọng ở đây là bạn có thể chuyển một việc từ System 2 sang System 1 qua luyện tập và rèn luyện. Ví dụ, khi mới học lái xe, đó là một hoạt động rất System 2: bạn liên tục kiểm tra gương, xi nhan, côn, số. Rồi luyện đủ nhiều trên những con đường quen, nó trở thành hoạt động System 1. Điều đó không có nghĩa lúc nào lái xe cũng là System 1: gặp một con đường lạ, nó có thể chuyển lại thành hoạt động System 2. Nhưng về bản chất, luyện đủ nhiều thì một việc có thể đi từ System 2 sang System 1.
5. Ghép System 1 với System 2: ví dụ con bot giao dịch
Quay lại chuyện model, ta có thể hình dung Claude Fable 5.1 và GPT-6 Astra là các model System 2, vì chúng chậm và có chủ đích. Jev thì giống một model System 1 hơn, vì nó nhanh tới mức bạn có thể để nó luôn bật, chạy liên tục ở chế độ nền cho một việc nào đó.
Điều thực sự thú vị, theo Ray, là khi ghép model System 1 và System 2 lại với nhau. Nếu Jev là model System 1, nó sẽ trả về quyết định kèm một loạt xác suất, và bạn gắn các câu if vào xác suất đó. Chẳng hạn lớn hơn 0.5 thì một hành động tự động xảy ra. Đó là kiểu một người đã làm: build một con bot giao dịch bằng Jev. Ray nói anh không nghĩ nó có lãi, nhưng về cơ bản nó quyết định mua hay bán rất nhanh vì Jev trả lại một xác suất, rồi một câu if lập tức chạy một hàm.
Ray mở một file trade.py để cho thấy nó trông thế nào. Ta có một state, rồi tới các câu hỏi đưa cho Jev, ở đây là một câu Noul đơn giản như đã nói. Ta gửi request lên server của Jev cùng API key, và tuỳ vào xác suất nó trả về, ta quyết định có đặt lệnh hay không. Phần code hiện trên màn hình:
import os, requests

state = {
    "ticker": "NVDA",
    "last_10_closes": [178.4, 179.1, 180.3, 181.0, 180.6,
                       182.2, 183.5, 184.1, 183.8, 185.2],
    "volume_vs_avg": 1.35,        # today's volume / 30 day average
    "position": "long 50 shares",
}

questions = {
    "buy": {
        "type": "noul",
        "instructions": "Given `last_10_closes`, `volume_vs_avg` and `position`, should we buy NVDA today?",
        "criteria": {
            "true": "the price is trending up on above average volume and the position is not oversized",
            "false": "the price is falling, the volume is thin, or the position is already too large",
        },
    }
}

r = requests.post(
    "https://api.typesafe.ai/v1/systemone",
    headers={"Authorization": f"Bearer {os.environ['TYPESAFE_API_KEY']}"},
    json={"state": state, "model": "jev-latest", "questions": questions},
)
p = r.json()["buy"]["probability"]
Giờ nếu ta bắt đầu ghi lại mọi quyết định đã ra cùng với kết quả của chúng, ta có thể dựng một quy trình định kỳ, trong đó một model System 2 sâu hơn suy nghĩ kiểu: "chiến lược ta đang làm ở đây là gì, có cải thiện được không?". Rồi nó viết lại giúp ta bất kỳ phần nào trong criteria, các ví dụ, hay ngưỡng (threshold), và đưa ngược vào model System 1. Ví dụ, chính câu chữ của criteria hay của instructions trong file trên là thứ nó có thể viết lại.
Tất nhiên, Ray nói anh không nghĩ bạn nên đem cái này đi giao dịch, nhưng vì Jev nhanh như vậy, đây là một ví dụ khá tốt về AI real-time. Và anh thấy có một ví dụ hay hơn nhiều: một người khác đã cho Jev và GPT-6 Astra cùng chơi Minecraft theo thời gian thực. Jev ra các quyết định nhanh về việc làm gì tiếp theo, còn Astra lập kế hoạch trước. Xem xong, Ray nghĩ: "wow, mình phải thử cái này".
6. Jev và GPT-6 Astra cùng chơi Minecraft
Ray nói anh không nghĩ mình làm lại đúng y setup của người kia, nhưng về cơ bản anh bảo Astra: "bạn đặt ra một mục tiêu dài hạn và theo dõi chiến lược của Jev, trong khi chính Jev chơi game". Trên màn hình là Jev đang chơi Minecraft. Anh giao: "xây một chỗ trú rồi kiếm một cái cuốc kim cương". Astra lập chiến lược ở tầng cao, còn Jev thực sự đi làm.
Lần chạy đó kéo dài khoảng 10 tới 20 phút, và nó làm khá tốt ngay từ đầu. Ray thấy cách này rất giống cách nhiều người chơi game: System 1 của họ làm phần lớn việc chơi, còn System 2 thì thường nghĩ lại kiểu "điều gì đã làm mình thua nhiệm vụ đó?", rồi qua đó huấn luyện lại System 1 để chơi giỏi hơn.
Lúc đó Jev vừa làm một cái cửa và đang quay lại lắp nó vào chỗ trú đã dựng. Cách vận hành: mỗi khi Jev cần phản hồi về việc nên làm gì tiếp, nó tạm dừng game, và Astra kiểu "để tôi đánh giá tình hình", rồi giao cho Jev nhóm mục tiêu nhỏ tiếp theo. Trong cửa sổ Codex, Astra viết rằng tường và mái nhà đã xong, Jev đã lắp cửa, nó đang kiểm tra lối vào rồi chuyển sang công cụ đá và ánh sáng, hướng tới cuốc sắt và cuối cùng là kim cương.
Trong cửa sổ Codex còn có một tác vụ định kỳ tên "Minecraft strategy review", chạy mỗi 2 phút, và phiên đó chạy GPT-6 Astra.
Ray để nó tiếp tục chạy ở chế độ nền trong suốt phần còn lại của video để xem nó đi được bao xa; game hiện ở góc trên bên phải trong lúc anh giải thích chuyện gì đang diễn ra.
Anh vẽ một bảng năm tầng. Tầng 1, mục tiêu tổng thể, "xây một ngôi nhà rồi kiếm cuốc kim cương", là phần anh tự lo. Tầng 2, chiến lược, nằm thấp hơn một bậc và do GPT-6 Astra xử lý: ưu tiên chỗ trú trước khi trời tối, bắt đầu đào mỏ khi đã có đủ thức ăn và công cụ. Đó là ví dụ về một quyết định ở tầng chiến lược. Codex xem lại mỗi hai phút, và sau mỗi lần thất bại đáng kể hay mỗi cột mốc. Chẳng hạn nếu Jev chết trong Minecraft, Astra sẽ xem lại kiểu: điều gì chính xác đã dẫn tới việc Jev chết, và lần sau làm sao cho tốt hơn?
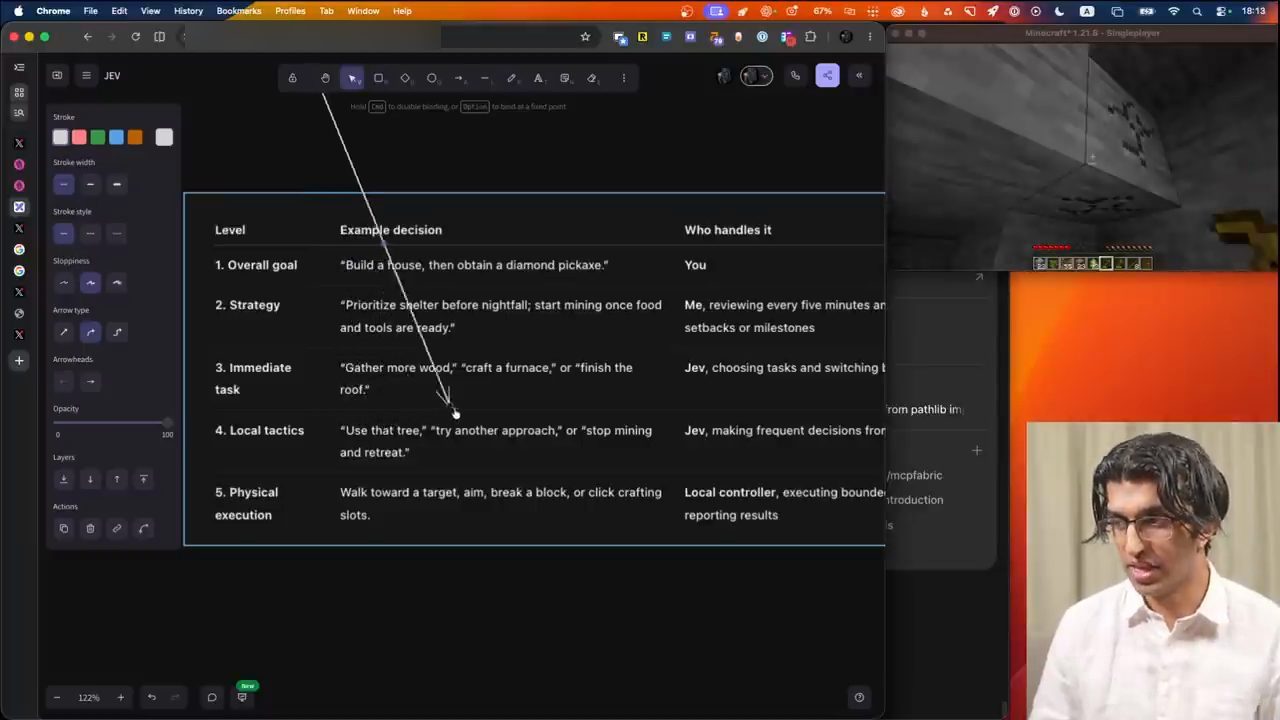
Tầng 3 là các việc trước mắt Jev đang làm, như kiếm thêm gỗ, chế lò nung, hay làm xong mái nhà; Jev chọn và đổi việc dựa trên trạng thái hiện tại. Tầng 4 là chiến thuật tại chỗ, cũng do Jev: "dùng cái cây kia", "thử cách khác", "ngừng đào và rút lui vì có con creeper gần đây". Tức là mọi quyết định thường xuyên đến từ những quan sát mới thì Jev tự động đưa ra. Còn tầng 5, thao tác vật lý (đi tới mục tiêu, ngắm, đập một khối, bấm vào ô chế tạo), chạy qua một controller mod anh đã cài.
7. Đầu vào của Jev trong Minecraft, và để Jev chọn skill thay agent
Ray cho xem một ví dụ đầu vào thực sự đưa cho Jev, kiểu "đây là mục tiêu trung gian của bạn". Nó có mục tiêu, trạng thái hiện tại (máu, độ đói và những thứ tương tự), thời điểm trong ngày, tiến độ đào mỏ, lịch sử gần đây về những gì vừa xảy ra, và danh sách các việc có thể chọn. Còn đây là bản JavaScript: có objective, có state, và nó chọn một trong các việc bằng một câu Choice.
{
  objective: "Build a shelter, then obtain a diamond pickaxe",
  state: {
    inventory: { logs: 5, wooden_pickaxe: 1 },
    shelterBuilt: false,
    daylightRemaining: "short",
    nearby: ["trees", "stone", "flat clearing"]
  },
  availableTasks: [
    "gather_wood",
    "craft_tools",
    "build_shelter",
    "gather_food",
    "mine_stone",
    "explore"
  ]
}
Trên màn hình game, Jev đã có một cái cuốc đá, tự chế ngay ở hàng trên cùng. Ray để Jev chơi tiếp ở góc trên bên phải, rồi nói rằng cách ghép này mở khoá cả loạt use case.
Ví dụ đầu tiên là chọn skill. Khi bạn tự làm cả đống skill, bạn thường biết skill nào liên quan nhất, vì chính bạn làm ra chúng; trong quá trình làm bằng System 2, bạn cũng đã phần nào huấn luyện System 1 của mình. Một trong những vấn đề người dùng Claude Code gặp là họ có thể có hàng chục skill trong project và ở cấp user, và phần mô tả của từng skill được đưa vào context window mỗi lần, mỗi cái đều tốn token. Có người cài rất nhiều skill, hơn 100 hay 200, nên context window của họ chứa toàn token thừa mà họ không thật sự cần. Trên màn hình, Ray mở danh sách /skills trong Claude Code: mỗi dòng ghi số token của từng skill, phần lớn khoảng 100 tới 130 token, có cái gần 400.
Vậy nếu Jev nhìn prompt của bạn, nhìn context tới lúc đó, rồi tự quyết định skill nào liên quan nhất với bạn ngay lúc này thì sao? Đây cũng là điều cookbook chính thức của Jev nhắc tới. Họ nói với Hermes agent, Jev có thể chọn ra skill phù hợp nhất trong 182 skill bạn có thể đã cài vào agent.
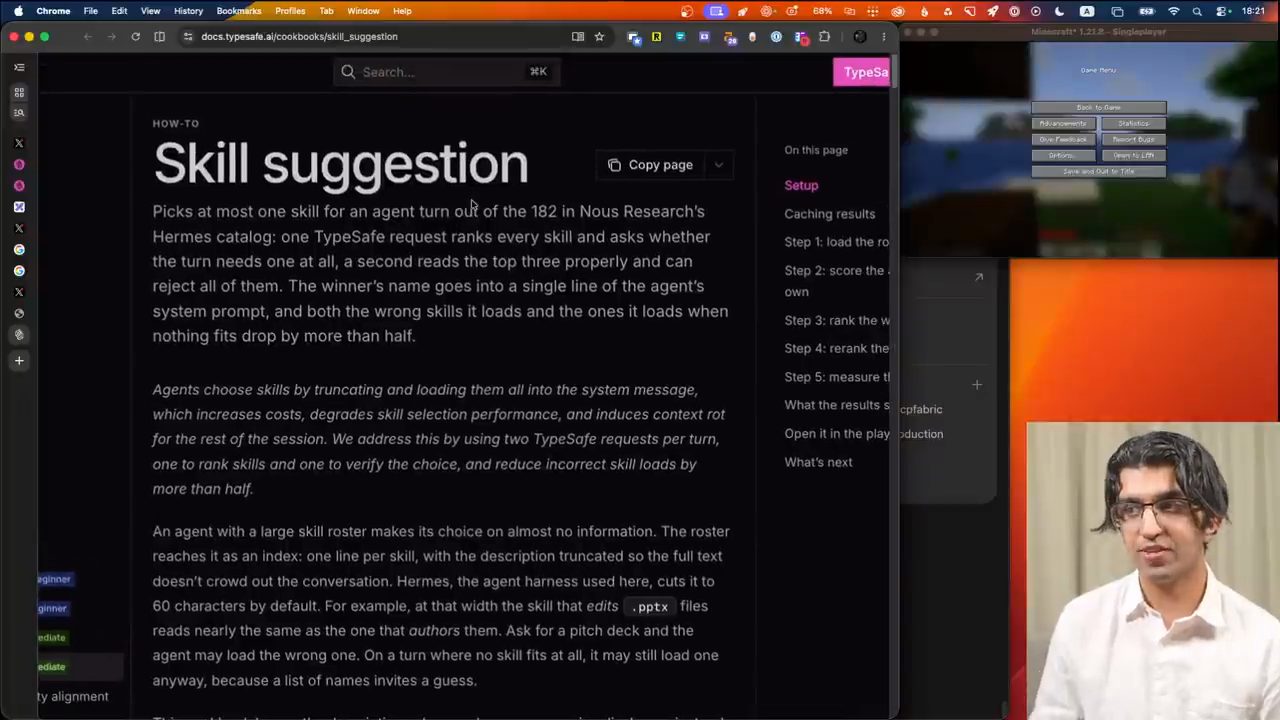
Cookbook có một ví dụ đầy đủ về chuyện skill nào liên quan nhất. Họ thấy khi để agent tự chọn, nó nạp sai skill khoảng 17% số lần (bảng trong cookbook ghi 16.8%); khi có Jev gợi ý, tỉ lệ nạp sai còn 7.3%. Theo Ray, phép đo này là với Haiku 4. Điều đó nghĩa là anh có thể đặt toàn bộ skill của mình sau một kiểu proxy, hay sau Jev, để Jev quyết định skill nào liên quan nhất, và nhờ vậy gỡ được khoảng 10.000 token khỏi context window, chỉ riêng từ đống skill đã cài.
Tiếp theo, Ray nhắc rằng nhiều người nói bạn nên cho agent một feedback loop tốt khi viết code thì output sẽ tốt hơn gấp 10 lần; trên màn hình là một bài đăng nói đúng ý đó.
8. Feedback loop nhanh: một browser agent chạy trên Jev
Video có một đoạn Ray giới thiệu khoá học cohort về agent engineering sắp mở của chính anh (hai tuần, hàng trăm bài học, có Q&A trực tiếp), nơi anh sẽ nói thêm về feedback loop cho agent.
Quay lại nội dung: một cách làm feedback loop cho agent nhanh hơn nữa là thứ mà nhóm browser use đã làm. Họ dùng browser use cùng Jev để tìm chuyến bay trong khoảng bảy giây, với chi phí khoảng bốn phần mười của một cent. Họ có viết về cách tiếp cận và mã nguồn mở được nhắc trong phần mô tả video; trên màn hình, đoạn video cho thấy agent tìm rất nhanh một chuyến bay từ Zürich tới London vào một ngày cụ thể.
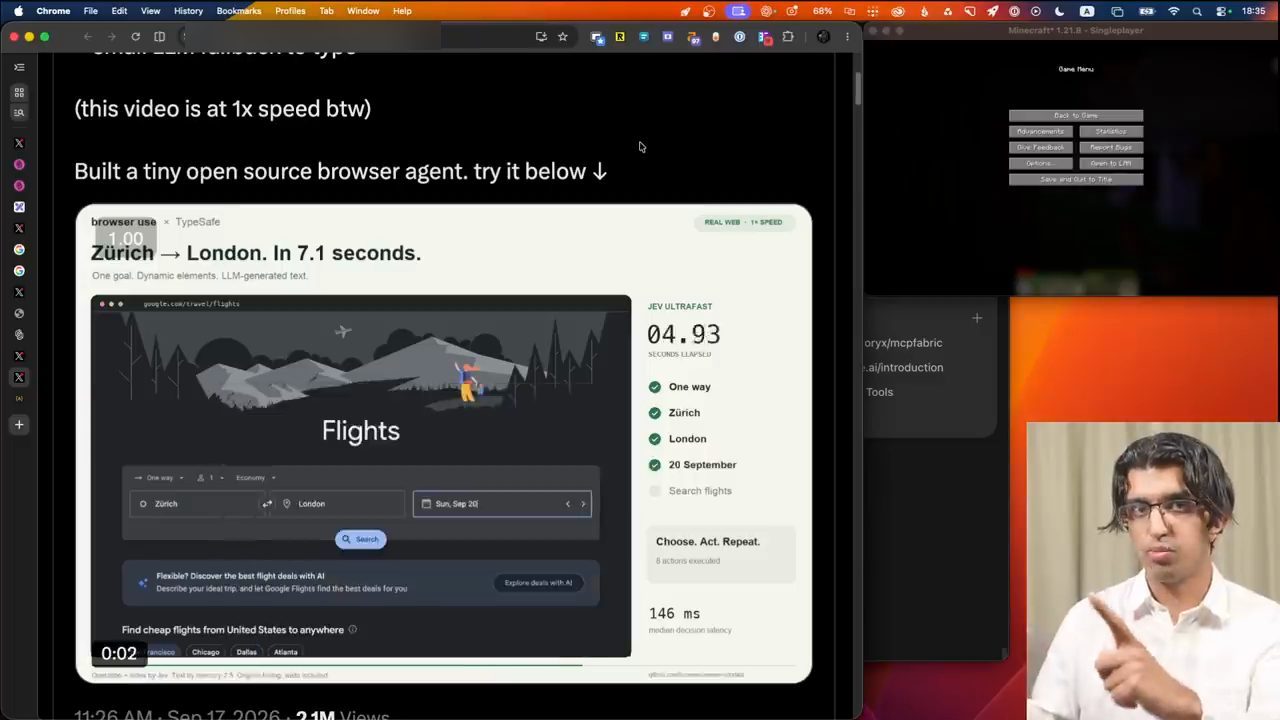
Điều này nghĩa là nếu ta có Jev chạy cục bộ trên máy để làm một kiểu browser use nào đó, nó có thể nhanh chóng kiểm chứng hàng trăm user flow khác nhau trong ứng dụng của ta và tìm ra những flow bị lỗi. Ray mô tả thứ đang thấy là một system one agent: một agent rất nhanh xây trên một model System 1, đi qua một website giống như cách bạn đi qua một website bạn đã quen. Khi vào một website lạ, bạn có thể dùng System 2 khá nhiều; nhưng ở một website rất quen như Google Flights, bạn dùng System 1.
Như vậy bạn có thể đưa vào workflow agentic coding của mình những feedback loop rất chặt, rất nhanh và rẻ, chỉ mất vài giây và vài phần nhỏ của một cent. Ngay khi một feature được implement xong, chẳng hạn, nó có thể kiểm chứng rất rẻ xem feature đó có chạy không. Nếu bạn dùng Opus hay Fable để build một feature, tới bước kiểm chứng, bạn có thể giao nhanh cho một browser use agent chạy bằng Jev; nó kiểm chứng mọi thứ thật nhanh, phản hồi kiểu "chỗ này hỏng rồi", và agent System 2 chính của bạn sẽ đi sửa.
Ray mở lại sơ đồ vòng lặp lúc trước: System 1 (Jev) đưa ra quyết định kèm xác suất, System 2 (Claude) xem xét, rồi viết lại criteria, ví dụ và ngưỡng.
9. System 2 dựng lại System 1, adversarial testing, và chi phí compute
Và nếu agent System 2 thấy kiểu "à, lựa chọn Jev đưa ra thật ra không hữu ích lắm, có lẽ mình nên thêm vài lựa chọn, có lẽ mình nên đổi criteria theo cách nào đó", thì nó có thể dựng lại agent System 1 để System 1 cho phản hồi tốt hơn nữa cho System 2.
Đẩy browser agent dựa trên Jev đi thêm một chút, ta có thể làm giống một nhóm khác. Họ viết rằng nhờ Jev, giờ họ có một bộ adversarial testing chạy trên trình duyệt, song song ở quy mô rất lớn, tìm cách phá từng bản release, và nó chỉ tốn vài xu. Trong đoạn video của họ có hàng chục trình duyệt chạy song song, bấm khắp website, có lẽ ngẫu nhiên, hoặc hành xử như một người dùng thật, cố phát hiện bất cứ điều gì họ thấy không ổn.
Nghĩa là với từng PR, bạn có thể dựng lên hàng chục, hàng trăm, thậm chí hàng nghìn agent song song, tất cả dựa trên Jev, bấm khắp nơi để tìm cách phá ứng dụng. Với phản hồi chúng gửi về cho Claude chẳng hạn, Claude có thể nhanh chóng sửa hết, rồi ta lại kiểm chứng các bản sửa đó. Ray nói anh sẽ tự thử cách này trong tuần tới và chia sẻ những gì học được trong khoá cohort sắp tới của mình.
Theo Ray, điều này rất tuyệt vì với ứng dụng của riêng anh, anh có thể chạy adversarial testing ở quy mô khổng lồ, suốt ngày đêm, để tìm bug, và có lẽ chỉ tốn khoảng 5 hay 10 đô mỗi ngày cho hàng nghìn, thậm chí hàng chục nghìn phiên trình duyệt. Làm tương tự, bạn sẽ thấy chi phí giới hạn của mình không còn là token nữa, vì token đã trở nên rất rẻ, mà là compute.
Video có một đoạn quảng cáo ngắn cho dịch vụ sandbox cho agent của chính Ray.
Một ví dụ khác Ray rất thích là bài đăng "Jev is coming for your garbage code comments". Tác giả dùng Jev để xác định các comment trong code chính xác tới đâu và hữu ích tới đâu. Ví dụ, một comment "nhân giá trị với hai" thì rất chính xác, vì code đúng là đang làm vậy, nhưng lại không hữu ích lắm, vì điều đó quá rõ khi nhìn chính đoạn code.
10. Demo: dùng Jev dọn comment rác trong một codebase
Ray làm thử luôn. Trong phần mô tả video có link tới skill TypeSafe AI để bạn tải về, nhưng trong demo anh chỉ copy nhanh nội dung skill, rồi mở một project mà anh biết có rất nhiều comment rác, vì nhiều model đời cũ đã viết code ở đó. Anh dán skill vào Claude Code.
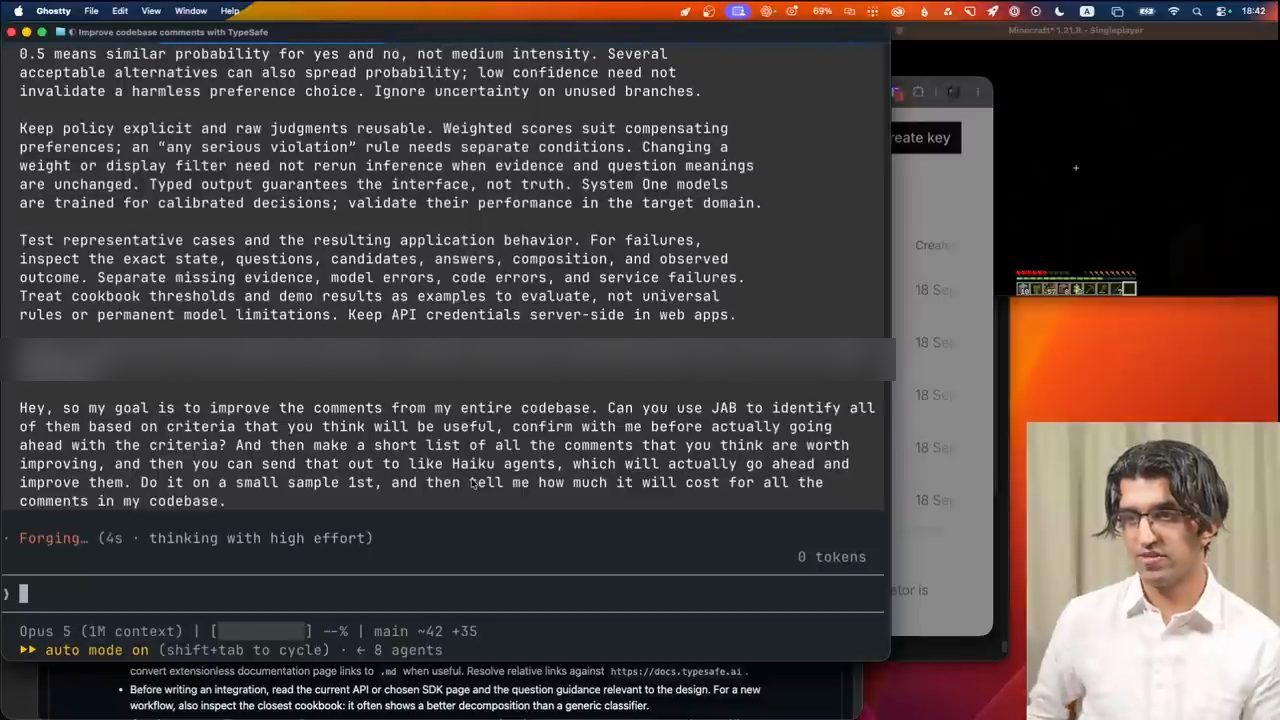
Rồi anh tạo nhanh một API key trong console, đặt tên là "test" (anh nói key này sẽ không còn dùng được khi bạn xem video), dán vào cùng với skill, và gõ yêu cầu. Câu anh gõ hiện trên màn hình như sau:
Hey, so my goal is to improve the comments from my entire codebase. Can you use JAB to identify all of them based on criteria that you think will be useful, confirm with me before actually going ahead with the criteria? And then make a short list of all the comments that you think are worth improving, and then you can send that out to like Haiku agents, which will actually go ahead and improve them. Do it on a small sample 1st, and then tell me how much it will cost for all the comments in my codebase.
Anh bấm Enter rồi chờ xem nó đưa ra gì. Trong lúc chờ, anh xem Jev và Astra đang làm gì với nhau: chúng quyết định cho Jev xuống một cái hố dưới đất và chờ trời sáng để tránh quái vật, rồi ưu tiên hồi máu trước khi tiếp tục hướng tới cuốc kim cương.
Kết quả mẫu: nó xử lý được 150 comment trong 9.3 giây với khoảng 1 cent. Nó ước tính có thể phân tích toàn bộ comment trong codebase với khoảng 57 cent, và dự kiến danh sách rút gọn khoảng 1.700 comment cần viết lại theo cách nào đó cho tốt hơn.
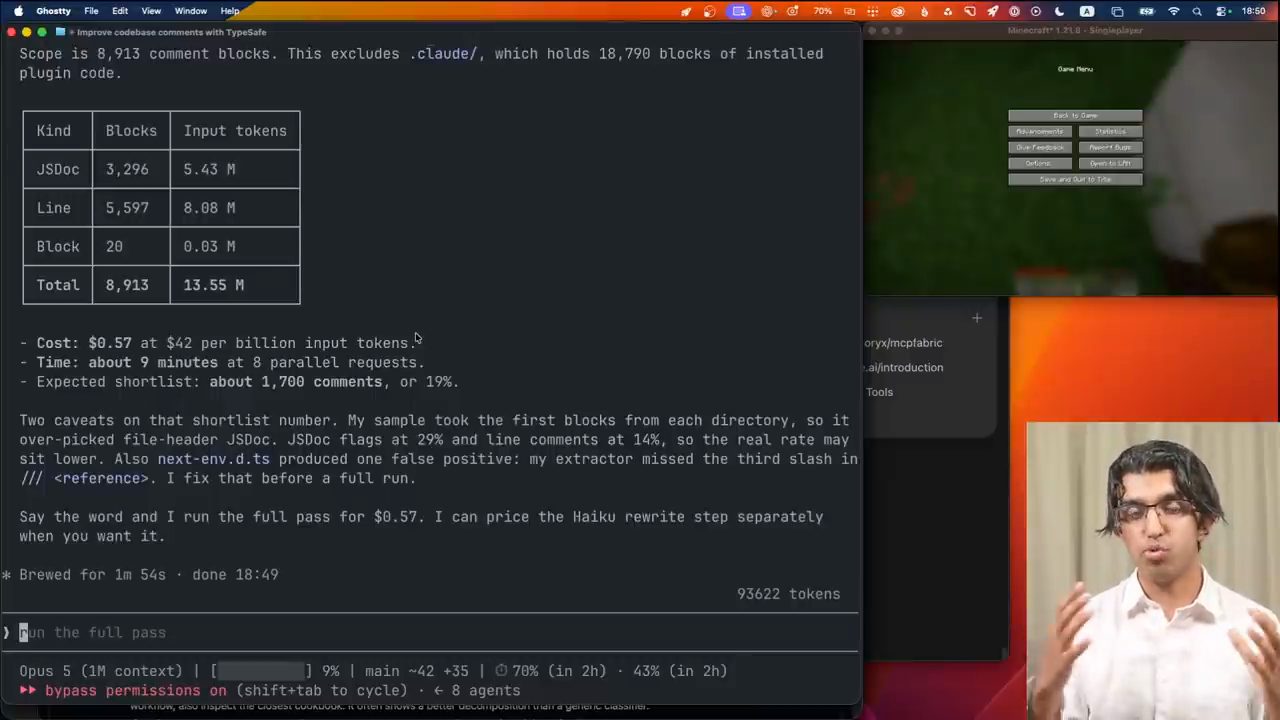
.claude/ chứa 18.790 khối code plugin đã cài), 13,55 triệu input token, chi phí 0,57 đô ở mức 42 đô cho mỗi tỉ input token, khoảng 9 phút với 8 request song song, danh sách rút gọn dự kiến khoảng 1.700 comment, tức 19%.Trên màn hình, Claude còn nêu hai lưu ý cho con số rút gọn: mẫu của nó lấy các khối đầu tiên trong mỗi thư mục nên chọn quá nhiều JSDoc ở đầu file (JSDoc bị gắn cờ 29%, comment một dòng 14%), nên tỉ lệ thật có thể thấp hơn; và một file next-env.d.ts gây ra một false positive vì bộ trích xuất bỏ sót dấu gạch chéo thứ ba trong /// <reference>, nó sẽ sửa trước khi chạy toàn bộ. Nó chốt: "Say the word and I run the full pass for $0.57", và có thể báo giá riêng bước viết lại bằng Haiku khi Ray muốn.
Ray thấy điều này thật điên rồ, vì nó nghĩa là ta có thể phân tích cả codebase rất nhanh cho bất cứ điều gì ta quan tâm, với một bộ phân loại (classifier) khá thông minh.
11. Qualitative linter: luật viết bằng câu hỏi
Một điều ta làm được ở đây là, vì Jev là một classifier nhanh, rẻ và khá thông minh, giờ ta có thể làm ra các qualitative linter bằng AI. Thay vì viết những đoạn code linter thật dài mà có thể không bắt được hết, và thường gãy khi gặp code phức tạp, ta định nghĩa luật theo kiểu như trên màn hình. Một qualitative linter có thể là: "Tên hàm có mô tả hết mọi việc hàm này làm, kể cả side effect không?"
Hoặc với toàn bộ phần logging trong codebase, ta có thể hỏi: "Giá trị đang được log là loại gì?". Nếu đó là một secret hay một giá trị tài chính, ta báo lỗi (error). Nếu đó là thông tin định danh cá nhân (PII), có thể ta chỉ muốn thêm một cảnh báo (warning). Rồi ta để các linter này chạy trên gần như từng PR với chi phí cực rẻ.
Ví dụ trên màn hình là từ một bài đăng có tiêu đề "Jev (and fast/cheap generalized classifiers) can make AI qualitative linters actually useable!", kèm câu "Imagine defining free form rules to be checked at specific granularities":
export default [
  fn`Does the name describe everything this function does, including side effects?`
    .expect(true).error(0.92).warn(0.75)
    .msg("Name may not reflect full behavior."),

  comment`Is this comment still accurate given the code that follows it?`
    .expect(true).error(0.90)
    .msg("Comment appears stale."),

  call("log|info|warn|error|debug")`What kind of value is being logged?`
    .oneOf("clean", "pii", "secret", "financial")
    .error("secret", "financial", 0.80)
    .warn("pii", 0.70),

  throws`How well does this message tell an operator what to do, with no source access`
    .score(1, 5).warn("<= 2"),
];12. Tìm code smell trên cả codebase
Một ví dụ rất thú vị khác: Ray có thể để Jev phân tích toàn bộ codebase với chi phí rất rẻ để tìm ra mọi code smell trong đó. Nếu bạn chưa biết khái niệm code smell, nó được nhắc tới trong cuốn sách của Martin Fowler, Refactoring: Improving the Design of Existing Code. Ví dụ nhanh: code trùng lặp (Duplicate Code); code chết (Dead Code); hay dùng số và chuỗi "ma thuật" (Magic Numbers and Strings). Trên màn hình, anh mở một trang tổng hợp code smell, có phần "Duplicate code" với code smelly và code clean đặt cạnh nhau. Bạn có thể tìm cả danh sách code smell trên mạng.
Anh vào Claude và gõ đại ý: "bạn dùng Jev để tìm mọi code smell trong toàn bộ codebase của tôi, cho tôi xem chiến lược bạn sẽ theo", để rồi làm một lượt phân tích thật nhanh và rẻ trên cả codebase và chỉ ra mọi chỗ code có mùi.
Tất nhiên, có những loại code smell mà Jev không tìm được, do cách Jev vận hành. Nhưng Ray cho rằng điểm lớn vẫn đứng vững: ta có những thứ muốn áp dụng trên toàn codebase, dù là các bất biến (invariant), loại bỏ code có mùi, hay tìm lỗ hổng bảo mật tiềm ẩn, và ta làm được với chi phí rất rẻ.
Anh vẽ hình dung như sau: Jev là phản xạ tức thì, là System 1, nhìn vào code và tự động quyết định có phải code smell không. Từ xác suất Jev trả về, ta tạo một danh sách rút gọn, và mọi thứ trên một ngưỡng (trên bảng vẽ là p > 0.8) được chuyển sang một model khác để suy nghĩ có chủ đích hơn.
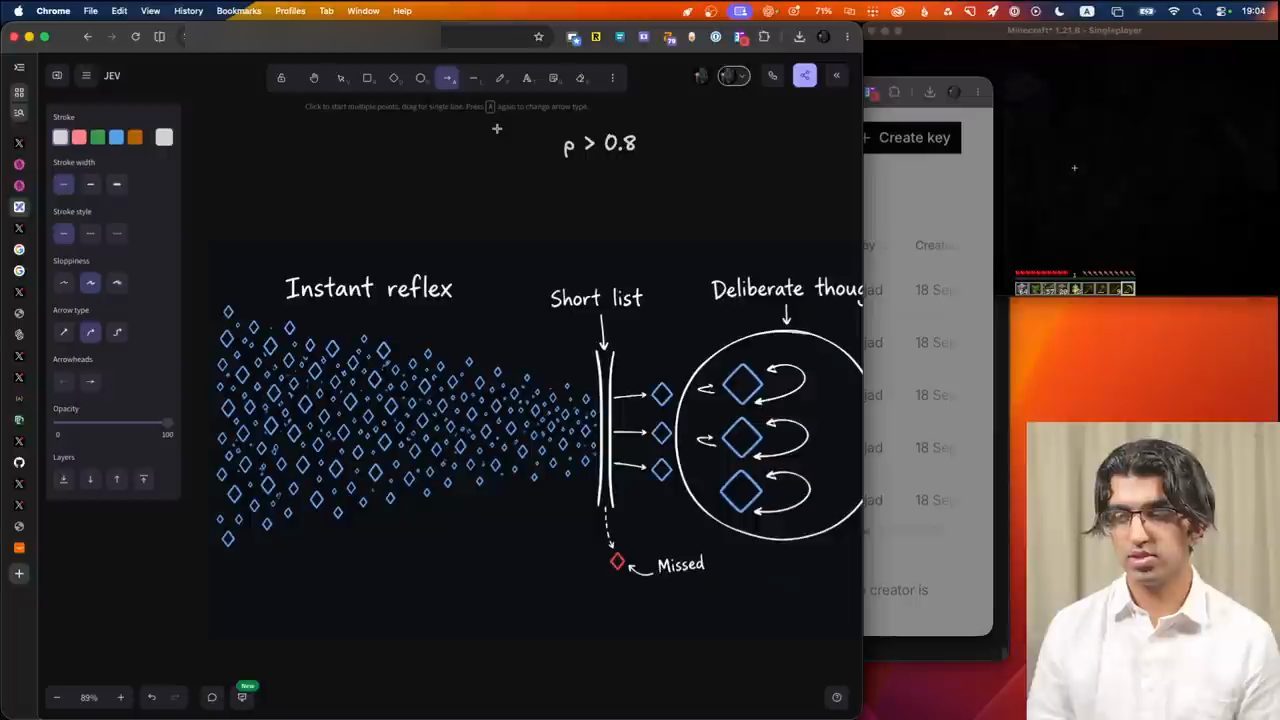
Nhìn lại Minecraft, Jev cuối cùng cũng đã cầm được một viên kim cương, nên nó đang tiến triển tốt.
Quay lại code smell, Claude đã đo codebase của anh trước: 1.289 file source, 8.270 hàm, 23 class, 1.030 hàm dài hơn 40 dòng, 132 hàm có từ 4 tham số trở lên, 154 file dài hơn 400 dòng, và 2.082 commit chạm tới 1.644 file trong 12 tháng. Claude nhận xét đây là một codebase kiểu functional, nên sáu smell trong danh mục gốc nói về cây kế thừa class (refused bequest, temporary field, parallel hierarchies, lazy class, inappropriate intimacy, middle man) chỉ cần lấy mẫu. Nó nói một số smell có thể dùng phân tích tĩnh (static analysis), còn các câu hỏi thật sự sẽ hỏi Jev là những câu trong bảng.
Bảng câu hỏi Claude đề xuất hỏi Jev chia theo đơn vị. Ở đơn vị hàm (chỉ xét hàm trên 40 dòng, có từ 4 tham số, hoặc thay đổi nhiều): distinct_jobs (score 0-3, thân hàm làm một hay nhiều việc, chỉ độ dài thì không nói lên được), cut_point (choice, khối nào tách ra gọn, hoặc "none", chỉ ở lượt thứ hai), name_honesty (score 0-3, tên có nói đúng việc hàm làm không), flag_splits (noul, hai nhánh boolean có thật sự chung một thân hàm hay chỉ chung chữ ký), envy_target (choice, hàm này suy luận chủ yếu về object nào, của chính nó hay object khác). Ở đơn vị module (file trên 400 dòng hoặc thuộc nhóm thay đổi nhiều nhất): reasons_to_change (score 0-3, có bao nhiêu lý do không liên quan buộc phải sửa ở đây).
Theo Claude, một lượt quét đầy đủ cả codebase cho mọi code smell nó liệt kê là khoảng 28 triệu input token và chỉ tốn 1,19 đô.
Một điều ta làm được là để System 2 huấn luyện System 1: chạy một lượt nhỏ, xem kết quả, rồi điều chỉnh lại criteria. Ví dụ Jev ra hàng trăm nghìn quyết định rất nhanh cho ta; ta xem lại các quyết định đó, nhờ một model System 2 phân tích, sửa lại criteria và luật, rồi để Jev chạy tiếp cho tới khi nó nhận diện tốt hơn những điều ta quan tâm. Trên bảng vẽ, Ray tóm lại: "Rules learn. No retraining."
13. Code review dựa trên Jev và bài toán token
Điều thú vị là chuyện này đã khiến vài người làm ra công cụ code review dựa trên Jev. Bạn có thể hỏi khoảng một trăm câu về một diff với chi phí rất rẻ, chấm điểm tất cả, rồi chuyển những vấn đề quan trọng nhất cho coding agent thật sự của bạn để xử lý và có thể sửa luôn.
Thấy vậy, Ray tự hỏi: nếu anh làm một bộ code review dựa trên Jev thì sẽ tiết kiệm được bao nhiêu token? Anh đưa câu hỏi cho agent Slack của mình, chạy Opus 5. Nó trả lời rằng dù không thể thay công cụ code review mặc định có sẵn trong Claude Code, nó có thể cắt lượng nó phải đọc đi 10 lần. Trước đó, Ray đã nhờ Claude phân tích các phiên làm việc cũ để xem chi phí đi đâu, và Claude nói output token chỉ chiếm khoảng 10% chi phí (trên màn hình ghi "Output is only 10.5% of the cost"). Vì vậy nếu giảm được lượng token cho code review đi 10 lần thì riêng về chi phí đã là một thắng lợi lớn.
Ray nói anh sẽ thử nghiệm thêm với một công cụ code review dựa trên Jev và chia sẻ những gì học được trong khoá cohort sắp tới.
Kiểm tra Minecraft: Jev giờ đã có cuốc kim cương và đang đi tới tận Nether.
Rồi Ray có một ý tưởng ngẫu hứng ngay tại chỗ: để coding agent tự xây "sự hiểu System 1" của riêng nó về codebase của bạn. Tức là nó có cả loạt bất biến cần tuân theo, các code smell, các rubric và những thứ tương tự. Rồi với từng PR, nó tự động đối chiếu cả PR với một checklist 50, 100, thậm chí 500 mục. Về cơ bản là có trực giác của một kỹ sư senior đang review một PR tương tự trong codebase, kiểu "tôi nghĩ chỗ này có thể có vấn đề", và những vấn đề đó được chuyển cho agent System 2 chính để sửa.
Hãy tưởng tượng một lượt review theo cảm tính (gut check) rất nhanh, từ một trăm hay một nghìn góc khác nhau, cho bất kỳ PR nào. Ban đầu nó có thể tìm kiếm rộng, theo các nhóm như bảo mật hay tính tương thích (compatibility). Trên màn hình là một bản phác thảo hai giai đoạn như vậy:
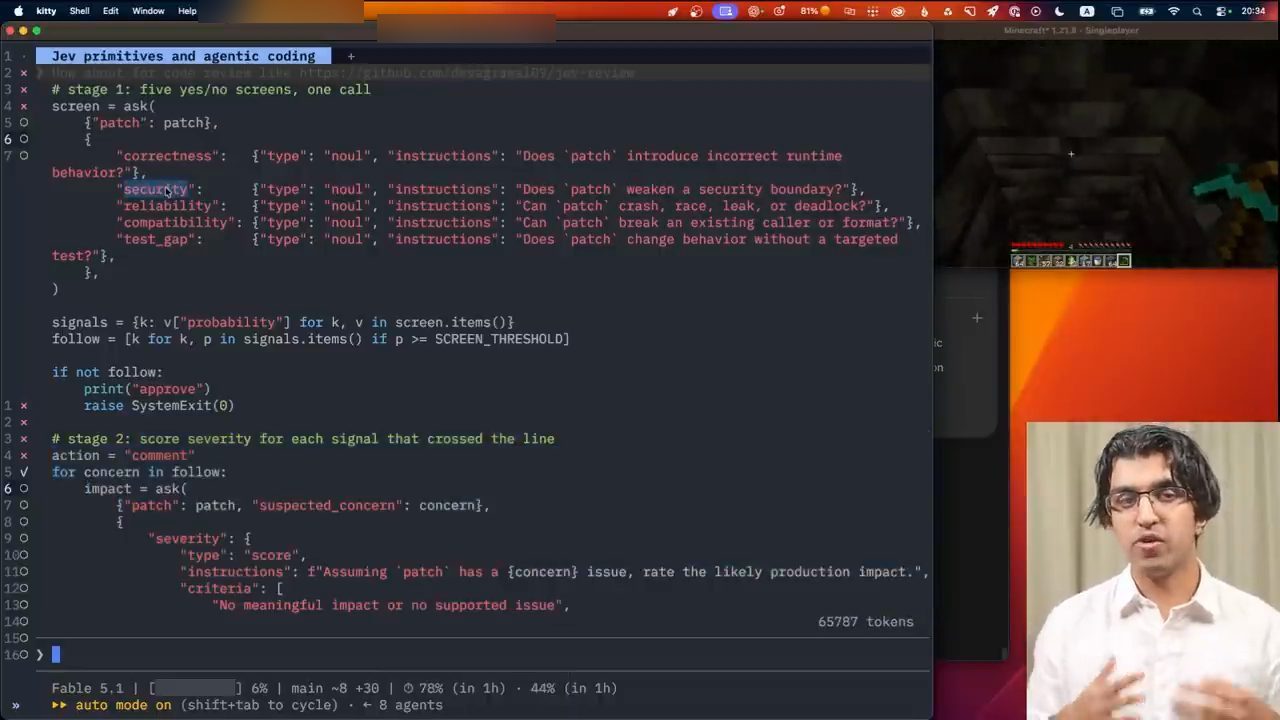
# stage 1: five yes/no screens, one call
screen = ask(
    {"patch": patch},
    {
        "correctness":   {"type": "noul", "instructions": "Does `patch` introduce incorrect runtime behavior?"},
        "security":      {"type": "noul", "instructions": "Does `patch` weaken a security boundary?"},
        "reliability":   {"type": "noul", "instructions": "Can `patch` crash, race, leak, or deadlock?"},
        "compatibility": {"type": "noul", "instructions": "Can `patch` break an existing caller or format?"},
        "test_gap":      {"type": "noul", "instructions": "Does `patch` change behavior without a targeted test?"},
    },
)

signals = {k: v["probability"] for k, v in screen.items()}
follow = [k for k, p in signals.items() if p >= SCREEN_THRESHOLD]

if not follow:
    print("approve")
    raise SystemExit(0)

# stage 2: score severity for each signal that crossed the line
14. Cho agent phản xạ của codebase, kết quả từ Sentry, và chặng tiếp theo
Sau đó coding agent xếp hạng mức nghiêm trọng, và những gì nghiêm trọng được chuyển cho các agent chuyên biệt. Ví dụ, mọi thứ liên quan bảo mật có thể đi tới GLM 5.3, vì theo Ray, các model của Claude và GPT hiện từ chối mọi việc liên quan bảo mật. Hoặc làm tương tự theo cách khác: một lượt tìm kiếm rộng lúc đầu, rồi sinh thêm các câu hỏi tuỳ theo nhóm mà vấn đề rơi vào. Nếu là bảo mật, bạn có thể hỏi thêm cả trăm câu nữa, và những gì được xếp hạng cao nhất thì chuyển cho một agent chuyên biệt.
Ray hình dung nó trông thế này: sàng lọc rất rẻ trên toàn bộ codebase, toàn bộ diff, rồi chỉ vài thứ nổi bật nhất mới cần nhiều sự chú ý nhất từ model System 2. Trên bảng vẽ là một biểu đồ cột: phần lớn là "Cheap screening" thấp, chỉ vài cột cao nhất ở cuối ("Strongest few") nhận "Deep attention".
Nhìn từ một góc, ta có thể trao cho coding agent System 2 như Claude Code những phản xạ System 1 rất rẻ, chuyên biệt cho đúng codebase của ta, với vô số câu hỏi nhỏ từ một classifier rất thông minh. Thứ đó có thể chạy nền suốt thời gian, ngay trước khi coding agent sắp mắc một sai lầm nghiêm trọng nào đó.
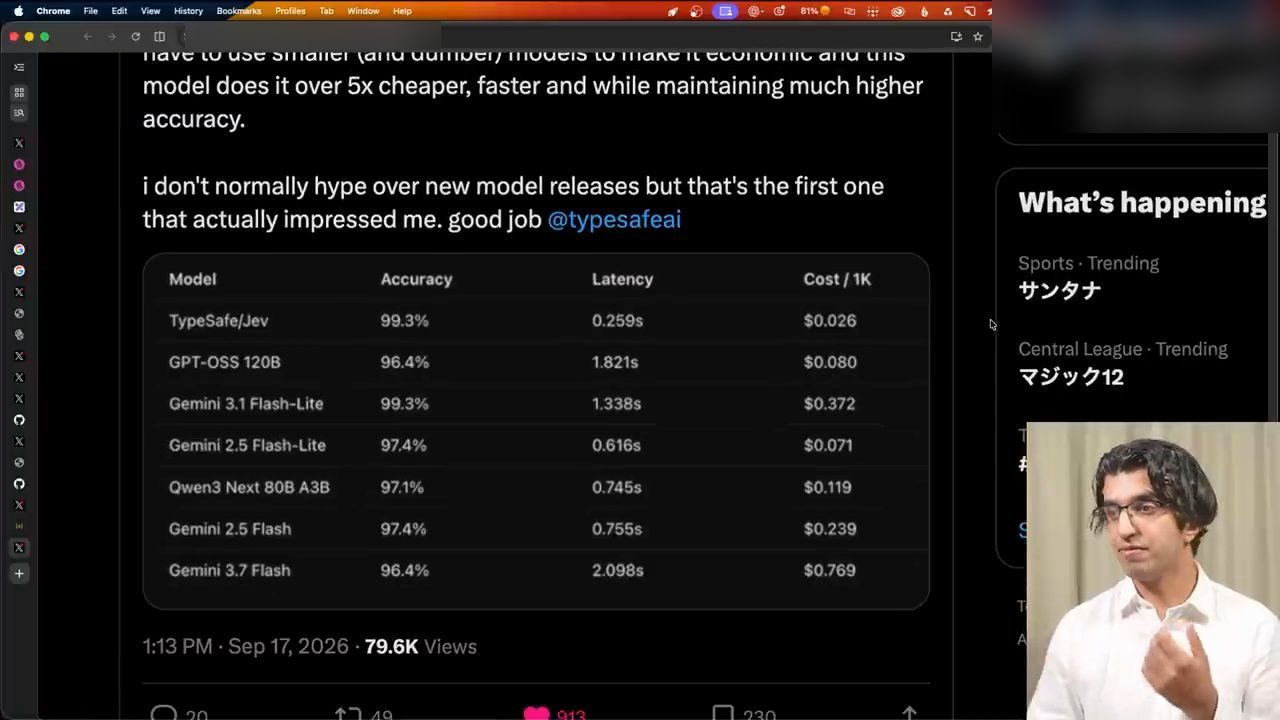
Ray cho rằng code review dựa trên Jev có thể rất hứa hẹn, một phần vì bài đăng của một kỹ sư ở Sentry. Người đó nói đây là kết quả dùng Jev trên một trong các pipeline bảo mật của họ: họ vốn đã phải dùng các model nhỏ hơn (và "ngốc hơn") để chi phí còn hợp lý, và model này làm việc đó rẻ hơn, nhanh hơn trên 5 lần mà vẫn giữ độ chính xác cao hơn nhiều. Họ đưa ra một bảng so sánh nhiều model, có cả GPT-OSS 120B, và Jev chính xác hơn, nhanh hơn, lại rẻ hơn. Ray thấy điều đó thật sự bất ngờ. Anh chắc họ sẽ phát triển tiếp để có pipeline bảo mật còn tốt hơn, nhưng anh nghĩ với pipeline code review thì nó có thể rất mạnh.
Quay lại Minecraft lần cuối: Jev đã vào tới Nether, điều Ray thấy thật ấn tượng, và có lẽ anh còn bắt nó đi hạ Ender Dragon được. Anh nói thật lòng chuyện này rất bất ngờ: đã lâu lắm rồi anh mới hào hứng với một model mới như vậy. Lần gần nhất anh nhớ mình hào hứng thế này là khi ChatGPT ra mắt lần đầu, bốn năm trước.
Ray tin đây sẽ là một mô hình ta thấy ngày càng nhiều về sau: các model System 1 như Jev, hoặc có thể những model khác do OpenAI hay Anthropic phát hành, làm việc cùng các model System 2 như Claude Fable để đạt kết quả tốt hơn trong agentic coding. Anh nghĩ Jev có rất nhiều use case trong vòng đời phát triển phần mềm có AI, và anh sẽ nói chi tiết hơn trong khoá cohort bắt đầu sau hơn một tuần nữa.
Những use case ta đã thấy ngay lúc này, theo anh, gồm: pipeline bảo mật tốt hơn và vững hơn; code review rẻ hơn và tốt hơn; adversarial testing ở quy mô lớn chạy suốt ngày đêm; qualitative linter; phân tích codebase thật nhanh để làm nó thân thiện hơn với agent; và có thể là trao cho agent System 2 những phản xạ. Anh hình dung nếu cách này thật sự chạy tốt trên nhiều benchmark, thì phần lớn coding agent về sau sẽ là sự kết hợp giữa model System 2 và model System 1.
Video kết thúc ở đó; Ray nói anh sẽ chia sẻ thêm suy nghĩ và bài học từ các thử nghiệm với Jev trong newsletter Agentic Coding School của anh.
Nguồn và liên kết 8 nguồn
- Tên gốc: How to Use Jev + Claude Code
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=ScvXFi4MUSc youtube.com
- Kênh YouTube Ray Amjad (Ray Amjad): youtube.com/channel/UCLA7cJBnqr0nLF2bQBD9uUg youtube.com
- Bài blog của TypeSafe giới thiệu system one model và Jev: typesafe.ai/blog/introducing-system-one-models-and-jev typesafe.ai
- Skill TypeSafe AI cho Claude Code hoặc Codex: github.com/typesafe-ai/skills (skills/typesafe-ai/SKILL.md) github.com
- Cookbook "Skill suggestion" (chọn skill trong 182 skill của Hermes, bảng tỉ lệ nạp sai 16.8% và 7.3%): docs.typesafe.ai/cookbooks/skill_suggestion docs.typesafe.ai
- jev-review, workflow code review theo giai đoạn kèm dashboard cục bộ, xây bằng TypeSafe Jev: github.com/devagrawal09/jev-review github.com
Related talks
Nhiều agent làm song song trong một thư mục với GitButler
Scott Chacon · GitButler · 10 min
Cài skill GitButler bằng but agent setup rồi cho ba agent Claude Code và Cursor làm ba feature trên parallel và stacked branch, không cần worktree.
Herdr: quản lý nhiều coding agent trong một cửa sổ, từ laptop tới VPS
Tùng Nguyễn · Holetex · 33 min
Cài Herdr, chia workspace, tab và khung terminal, đọc trạng thái agent, dùng prefix mode, cài Herdr skill để Claude Code gọi Codex review, rồi chạy Herdr trên VPS.
Dùng OpenAI Codex từng bước: từ một prompt tới game chạy được
Kevin Stratvert · Kevin Stratvert · 17 min
Build game Cookie Shop Tycoon bằng Codex desktop: tạo project, sửa bằng prompt, commit Git, ba agent song song, skill Game Tester và Codex Cloud.