How we taught agents to use good retrieval
AI Engineer World's Fair 2026: Online Track · Video gốc
Vì sao agent viết query keyword vô nghĩa, và cách Mixedbread dùng harness bốn search tool cùng SFT và RL để dạy agent dùng semantic search đúng cách.
1. Closing the Oracle Gap với knowledge agent
Talk mở đầu bằng tên đầy đủ của chủ đề: làm sao để dạy agent dùng retrieval tốt, hay theo cách nhóm gọi nội bộ, closing the oracle gap with knowledge agents, tức là thu hẹp khoảng cách giữa kết quả agent đạt được và kết quả nó lẽ ra đạt được nếu có đúng tài liệu trong tay. Có hai người trình bày. Hanna Lichtenberg là AI engineer tại Mixedbread và đang dẫn dắt mảng agentic search của công ty. Aamir Shakir là co-founder của Mixedbread. Aamir nói phần mở đầu về vấn đề, Hanna nói phần cách nhóm xây và train search agent.
2. Reasoning tăng theo cấp số mũ, search thì không
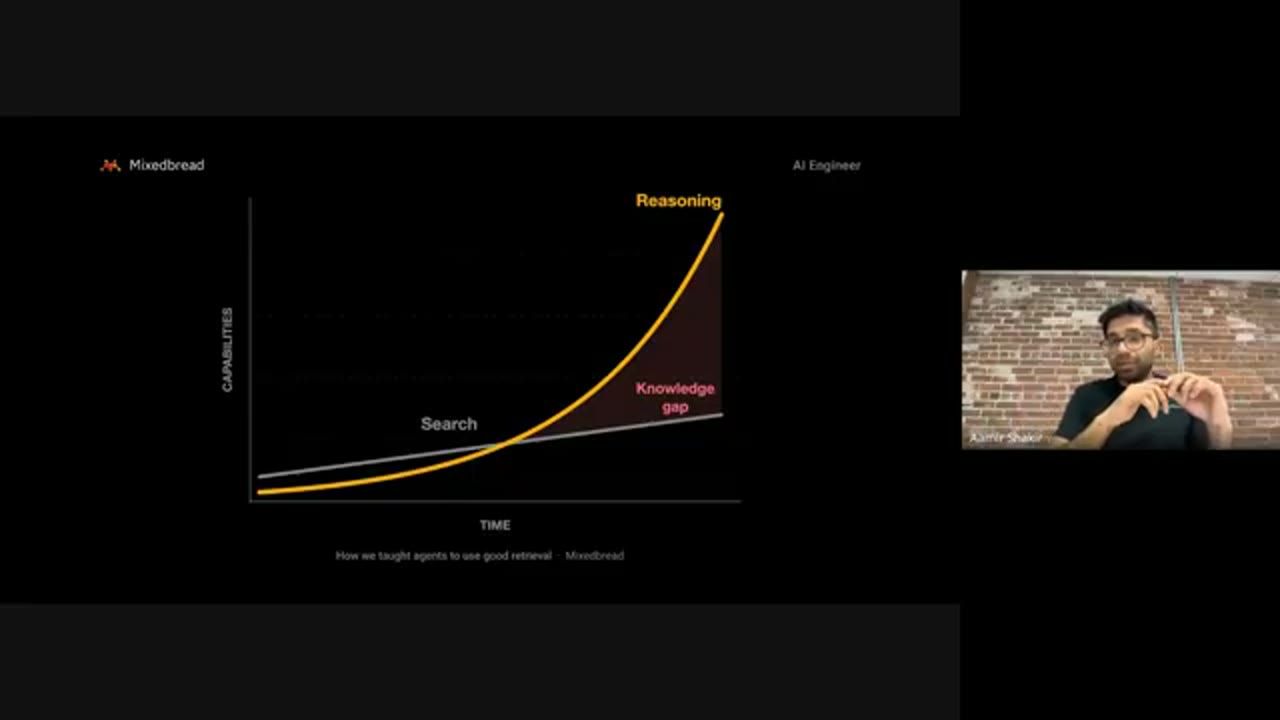
Aamir bắt đầu bằng một quan sát mà ai làm với LLM vài năm qua đều thấy: model ngày càng giỏi, và năng lực reasoning tăng theo đường cấp số mũ. Anh gợi người nghe nhớ lại GPT-3.5 từng giỏi tới đâu, rồi so với GPT-5.5 bây giờ. Theo anh, đó rõ ràng là một đường cong exponential.
Nhưng nếu nhìn sang search trong khoảng 20 năm qua thì khác hẳn. Search có tiến bộ, nhưng tiến bộ rất, rất chậm. Vậy là có một khoảng cách lớn giữa tốc độ phát triển của LLM và reasoning với tốc độ phát triển của retrieval.
Khoảng cách này quan trọng vì retrieval tool chính là đường truy cập chủ yếu để lớp reasoning lấy được đúng kiến thức. Muốn model thật sự hữu ích ra ngoài phạm vi code, chẳng hạn trong công việc pháp lý, tài chính, và nhiều lĩnh vực khác nữa, thì model phải tìm được đúng tài liệu. Nội bộ Mixedbread gọi khoảng cách đang mở rộng giữa reasoning và search là knowledge gap.
3. Đo knowledge gap: BrowseComp+ và OfficeQA Pro
Aamir nhấn mạnh đây không phải một lý thuyết lạ của riêng nhóm. Họ thấy khoảng cách này trên benchmark thật và task thật. Anh lấy hai benchmark làm ví dụ.
- BrowseComp+ là một benchmark về browsing: các query khá phức tạp, một corpus gồm một trăm nghìn tài liệu, và nhiệm vụ là trả lời câu hỏi. Về cơ bản đây là một task deep search kiểu đời thực. BrowseComp gốc do OpenAI tạo ra và luôn chạy trên open web; BrowseComp+ là phiên bản dùng một corpus có kích thước cố định.
- OfficeQA Pro do Databricks tạo ra, chứa tài liệu của U.S. Treasury trong khoảng một trăm năm qua, và người ta đặt những câu hỏi rất phức tạp trên bộ tài liệu đó.
Trên biểu đồ của nhóm, đường nét đứt là oracle performance. Oracle ở đây nghĩa là hiệu năng tối đa về lý thuyết của model nếu bạn đưa đúng tài liệu cần thiết vào cùng với câu hỏi. Với BrowseComp, con số này là 93%; với OfficeQA Pro là 64%.
Sau đó nhóm lấy một agent như Codex với bộ tool mặc định của nó và hỏi: với các tool hiện có, agent đạt được bao nhiêu? Chất lượng câu trả lời Codex tạo ra tụt mạnh: thấp hơn oracle 9 điểm trên BrowseComp và 8 điểm trên OfficeQA Pro.
Kết luận của Aamir: model cực kỳ có năng lực nếu được đưa đúng tài liệu. Nhưng khi đặt chúng vào một corpus nhiễu, hiệu năng rơi rất nhanh. Nghĩa là nút thắt cổ chai ở đây không phải reasoning, mà là khả năng tiếp cận đúng kiến thức cần để trả lời câu hỏi. Knowledge gap có thật ngoài đời.
4. Search tốt hơn lấy lại gần hết khoảng cách
Thí nghiệm tiếp theo trả lời câu hỏi ngược lại: nếu chỉ thay vào một công cụ search tốt hơn hẳn thì sao? Nhóm thả search của Mixedbread vào, một search tool dùng late interaction, và lấy lại được phần lớn hiệu năng đã mất.
Với BrowseComp, chênh lệch giữa Oracle và GPT-5 dùng Mixedbread chỉ còn 3 điểm. Với OfficeQA Pro, nhóm gần như khép hoàn toàn khoảng cách. Thông điệp: chỉ cần đưa cho model một search tool tốt hơn là đã thu hồi được phần lớn knowledge gap, mà không phải đụng vào model.
Late interaction là kiểu retrieval mà query và tài liệu không bị nén thành một vector duy nhất. Mỗi token giữ embedding riêng, và điểm liên quan được tính bằng cách so khớp từng token của query với các token của tài liệu lúc tìm kiếm. ColBERT là ví dụ quen thuộc của họ kỹ thuật này. Cách làm này giữ được nhiều chi tiết hơn so với một embedding duy nhất cho cả đoạn văn.
5. Agent đang viết query như thế nào, và vì sao
Đến đây mọi thứ trở nên thú vị hơn, theo lời Aamir, khi nhóm nhìn vào chính những query mà model đang viết gửi tới hệ thống search. Một ví dụ nhóm bắt gặp trong lúc benchmark:
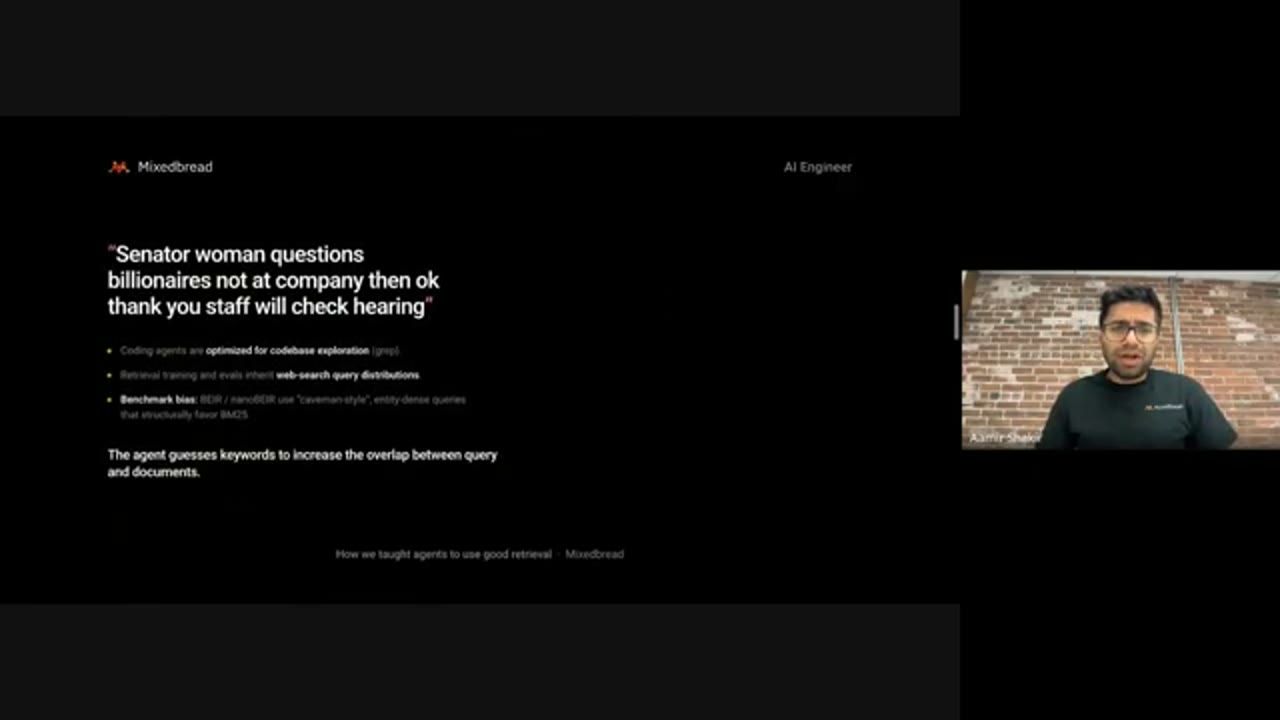
Senator woman questions billionaires not at company then ok thank you staff will check hearing
Về cơ bản đây là chuỗi vô nghĩa. Nếu hệ thống search của bạn được thiết kế để nhận câu hỏi tự nhiên, câu hỏi mang ngữ nghĩa, mà lại nhận về một chuỗi keyword chồng keyword như vậy, nó sẽ bị rối. Aamir đưa ra ba lý do khiến model viết query theo kiểu này.
- Model chủ yếu được train cho coding. Coding agent được tối ưu để khám phá codebase bằng những tool như grep. Grep chỉ tìm regular expression, nên model cố viết ra càng nhiều biểu thức mà nó đoán là nằm trong tài liệu càng tốt để tìm đúng thứ cần tìm.
- Model được train để dùng web hiệu quả. Các web tool vốn được tối ưu rất mạnh cho con người, nên để dùng chúng đúng cách, model bắt chước kiểu query của con người: keyword nối keyword nối keyword. Trên slide, ý này được ghi là quá trình training và eval cho retrieval thừa hưởng phân phối query của web search.
- Benchmark bias. Phần lớn benchmark hiện nay như BEIR hay NanoBEIR dùng query kiểu "caveman", tức query dày đặc entity, và cấu trúc này nghiêng hẳn về phía BM25.
Hệ quả là agent hiện nay đoán keyword để tăng độ trùng lặp giữa query và tài liệu, và không thể dùng đúng cách những search tool mạnh.
6. Ba mục tiêu cho search agent của Mixedbread
Chính vấn đề trên thúc đẩy nhóm tự xây một search agent riêng. Từ đây Hanna nói tiếp. Mục tiêu là dạy agent dùng search mạnh cho đúng cách, đặc biệt là chọn đúng search tool cho từng loại tình huống, và làm việc được ngoài phạm vi code search, tức là cho knowledge work. Và quan trọng nhất, agent phải chính xác, nhanh và rẻ.
7. Harness: bốn search tool và một vòng lặp ngắn
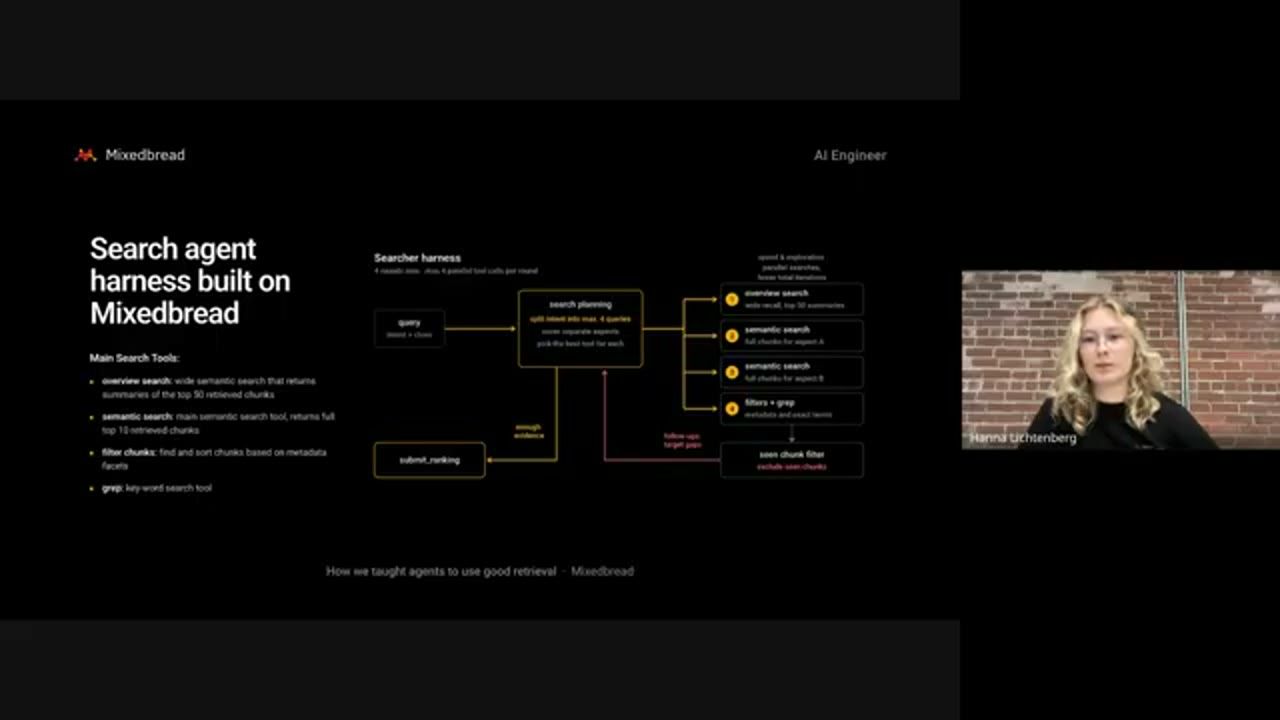
Bước đầu tiên để xây agent là định nghĩa một harness thật mạnh. Harness của nhóm được xây hoàn toàn trên nền tảng Mixedbread. Agent có bốn search tool chính:
- Overview search: một semantic search rất rộng, agent nhận về tối đa 50 chunk, nhưng chỉ thấy bản tóm tắt nội dung của từng chunk. Mục đích là để agent có cái nhìn tổng quan về corpus, biết có những gì trong đó, mà không làm đầy context quá nhiều.
- Semantic search: tool semantic search chính, agent nhận toàn bộ payload của top 10 chunk tìm được.
- Filter chunks: tool để sắp xếp và tìm chunk dựa trên các metadata facet.
- Grep: dĩ nhiên vẫn có, dùng cho tìm kiếm khớp keyword.
Bản thân agent loop, tức harness, rất đơn giản và ngắn vì agent phải nhanh. Nhưng nhóm vẫn muốn nó có nhiều khả năng khám phá. Vì vậy họ đặt giới hạn tối đa bốn vòng search, nhưng trong mỗi vòng agent được chạy nhiều search song song, khởi động vài lượt search cùng lúc.
Ngay từ đầu, agent không chỉ thấy query của người dùng mà còn thấy sẵn kết quả của một lượt semantic search ban đầu chạy trên chính query đó, cộng với gợi ý về những metadata facet hiện có. Dựa trên bản xem trước của corpus này, agent bắt đầu lập kế hoạch search. Nó chia ý định tìm kiếm thành tối đa bốn query, mỗi query phủ một khía cạnh riêng, và với mỗi query, mỗi ý định, nó chọn tool phù hợp nhất.
Khi kết quả từ các tool trả về, harness loại bỏ chunk trùng lặp để agent không bao giờ thấy cùng một chunk nhiều lần, tránh làm đầy context. Sau đó vòng search kế tiếp có thể bắt đầu. Ngay khi agent có đủ bằng chứng để trả lời query của người dùng, nó gửi ranking: xuất ra mọi chunk liên quan đến query theo một thứ tự xếp hạng hợp lý.
8. Năm lý do harness tạo ra semantic query tốt hơn
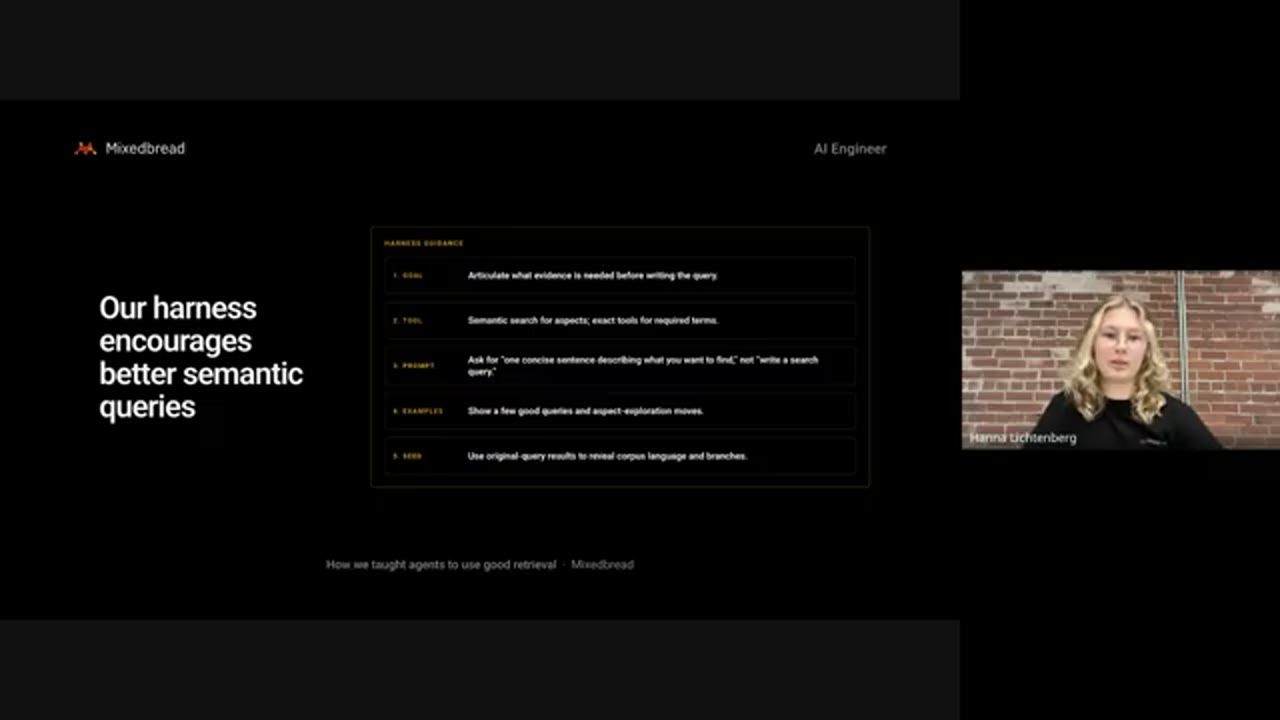
Vì sao harness này khuyến khích agent viết semantic query tốt hơn và dùng search tool tốt hơn? Hanna nêu năm điểm chính.
- Goal framing. Agent phải nói rõ nó cần bằng chứng gì trước khi viết query.
- Tool. Có nhiều tool khác nhau là rất quan trọng: agent chỉ dùng semantic search khi cần tìm theo khía cạnh, và chỉ dùng grep khi cần khớp keyword chính xác.
- Cách đóng khung việc viết query. Nhóm "lừa" model để nó không nghĩ mình phải viết một query kiểu BM25 như thường lệ. Thay vì ra lệnh trực tiếp "write a search query", họ yêu cầu nó viết một câu ngắn gọn mô tả điều nó muốn tìm. Như vậy model không rơi vào pattern cũ được.
- Examples. Prompt có kèm vài ví dụ để cho thấy thế nào là query tốt, và cách chia một query đầu vào thành nhiều khía cạnh khác nhau để khám phá corpus.
- Seed. Nhóm đưa sẵn kết quả semantic search trên query gốc, để agent thấy corpus nói về cái gì, thấy được ngôn ngữ của corpus, và xác định nên đào sâu hơn ở khía cạnh nào.
Câu hướng dẫn ở điểm thứ ba đáng để giữ lại nếu bạn đang viết prompt cho search agent của riêng mình. Theo slide, hai cách diễn đạt được đặt cạnh nhau như sau:
Ask for "one concise sentence describing what you want to find," not "write a search query."
9. Training: SFT từ teacher, rồi on-policy RL với search reward
Bước quan trọng thứ hai để xây search agent riêng dĩ nhiên là chính quá trình training. Nhóm quyết định dùng một LLM rất nhỏ để agent còn nhanh hơn nữa. Họ train agent nhỏ này để tối ưu chính chiến lược search: chọn tool tốt hơn, viết semantic query chất lượng hơn, khám phá và xếp hạng tốt hơn, và hiệu quả hơn.
Training có hai giai đoạn:
- Supervised fine-tuning với một teacher LLM lớn hơn.
- On-policy reinforcement learning với một search reward do nhóm tự định nghĩa.
Search reward là tổ hợp của hai phần: retrieval reward và trajectory reward.
- Retrieval reward dựa trên kết quả các metric retrieval quen thuộc như recall và nDCG mà danh sách xếp hạng cuối cùng của agent đạt được. Cộng thêm một LLM judge chấm retrieval theo nhiều rubric, mỗi rubric được quyết định là đạt hay không đạt: agent có tìm ra những gì thật sự liên quan cho query không, mọi chunk trả về có liên quan không, và bản thân ranking có hợp lý không.
- Trajectory reward cũng dùng một LLM judge, và đây là chỗ để thật sự cải thiện việc chọn tool, làm agent hiệu quả hơn, và nâng chất lượng query. Có những rubric để judge quyết định query có thật sự là một câu tự nhiên hay không, và mức độ khám phá đã đủ chưa, nhiều quá hay ít quá.
10. Đọc một trajectory thật
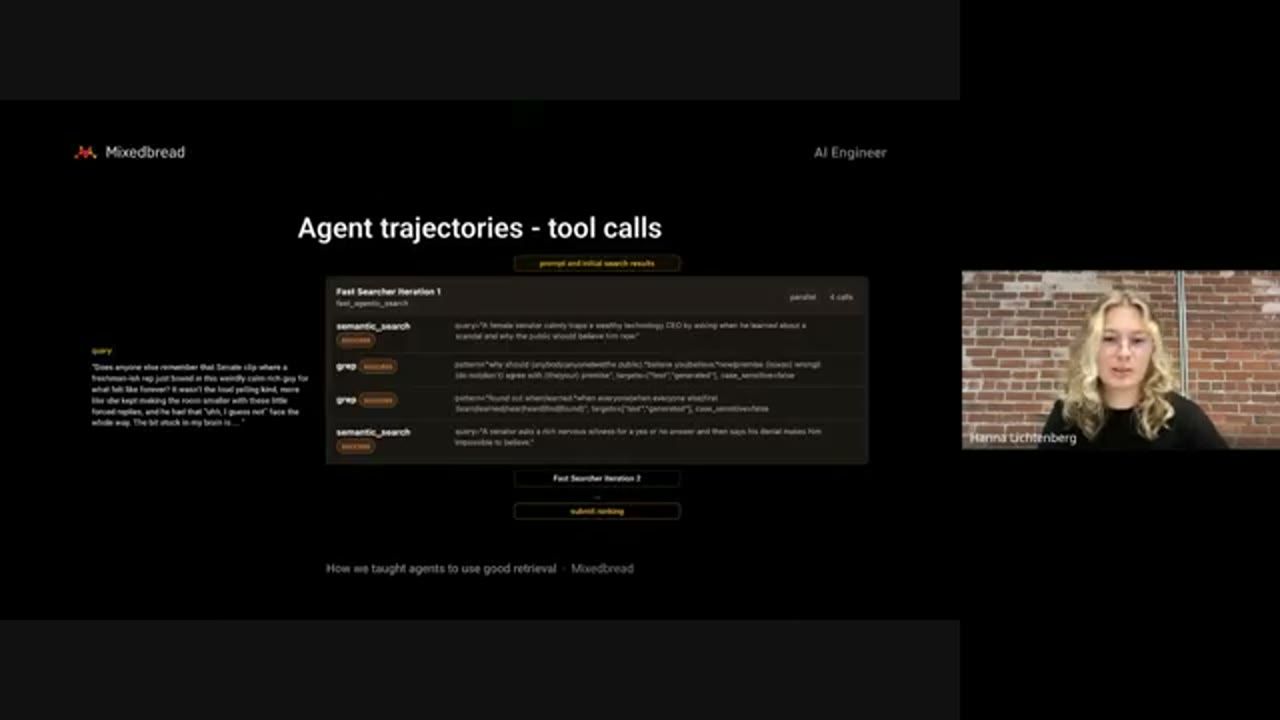
Hanna cho xem một trajectory mẫu dưới dạng timeline. Lúc đầu là initial search và các metadata hint ban đầu. Sau đó agent chạy bốn search song song ở vòng thứ nhất, rồi ở vòng thứ hai chỉ là một lượt grep đơn giản.
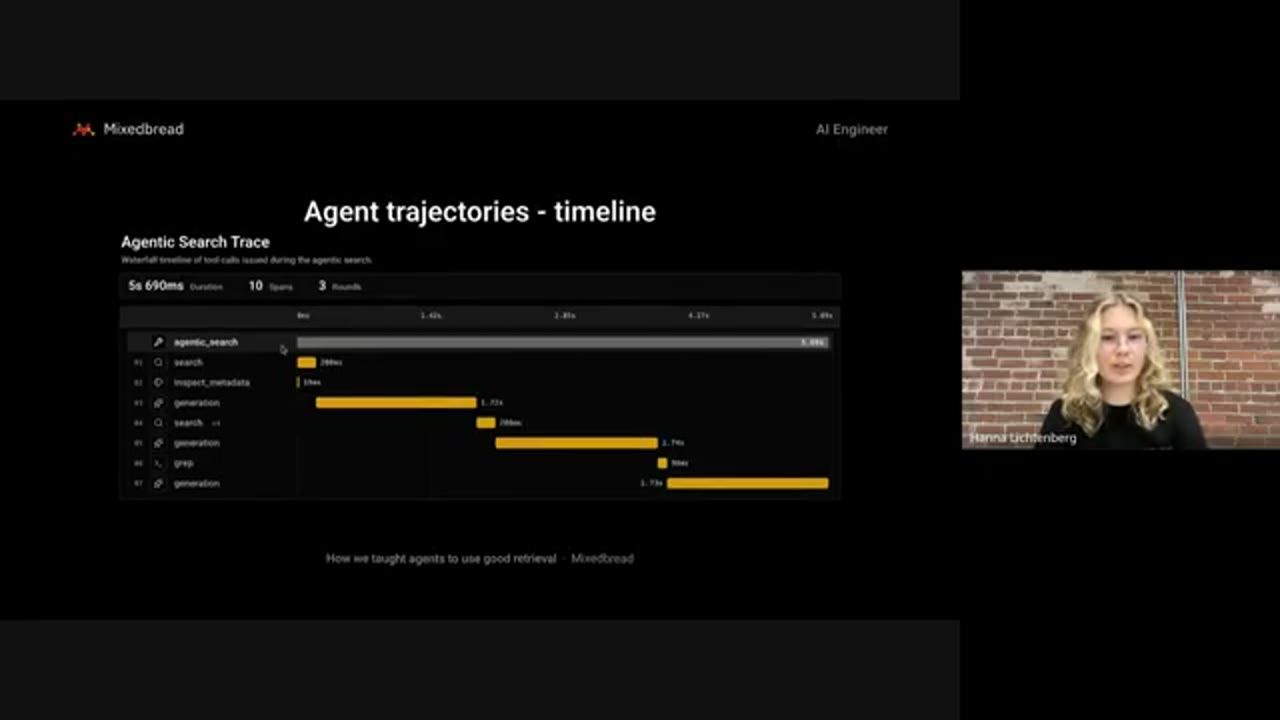
Tiếp theo là một đoạn trích trajectory cho thấy chính các query agent viết. Query đầu vào nằm bên trái: một query rất dài, kiểu kể lể lan man điển hình, lấy từ benchmark obliq-congress. Nhìn sang các query agent viết cho tool semantic search đầu tiên, đó thật sự là một câu mô tả điều nó muốn tìm, chứ không phải một chuỗi keyword dồn cạnh nhau một cách kỳ quặc. Còn các lượt grep thì dĩ nhiên là pattern keyword điển hình, và đó chính xác là điều nhóm mong muốn.
11. Kết quả eval và lời mời
Agent đã train của nhóm tiếc là chưa được phát hành, nhưng đã có vài kết quả trung gian.
Bên trái là benchmark obliq-congress: agent đạt nDCG@10 là 0,4, một bước nhảy lớn so với model tốt nhất trong paper của benchmark này, một GPT multi-hop agent, vốn đạt 0,18. Trên slide, cột recall@10 cho thấy mức chênh lệch tương tự.
Bên phải là kết quả của bản beta search agent mà nhóm đang chạy production, tên là Mixedbread agentic search. Agent này đứng top một trên benchmark MADQA của Snowflake, đạt accuracy 93,4 khi dùng model Gemini 3.5 Flash với agentic search của Mixedbread làm search tool. Kết quả này đạt được trong khi effort thấp hơn nhiều so với các LLM tương đương đi kèm search agent khác. Bạn có thể tự xem leaderboard của MADQA.
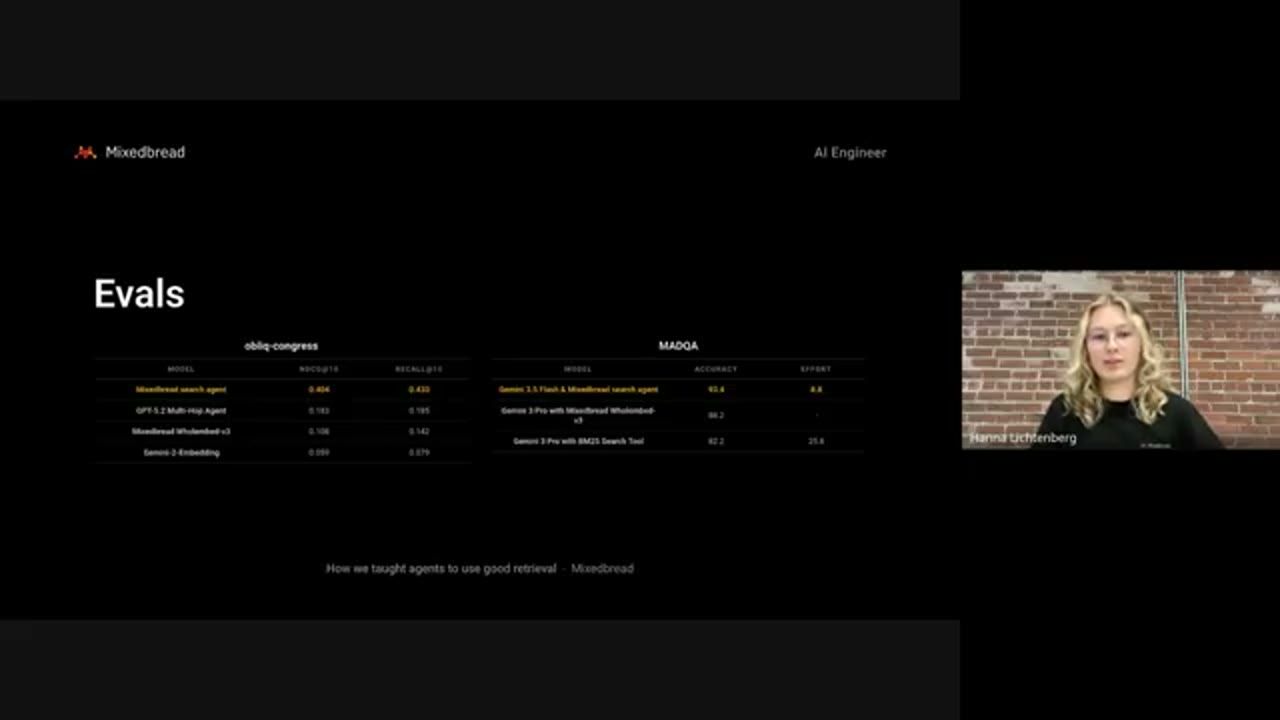
Những kết quả này cho thấy vẫn còn rất nhiều dư địa cải thiện khi nói đến các language model lớn và search tool của chúng. Lời kết của Hanna: nếu bạn muốn góp phần đẩy giới hạn của retrieval xa hơn nữa, Mixedbread rất mong nhận đơn ứng tuyển của bạn.
Nguồn và liên kết
- Mixedbread: nền tảng search của hai diễn giả, nơi harness và agentic search được xây
- BrowseComp-Plus: phiên bản BrowseComp với corpus cố định dùng trong phần đo knowledge gap
- BrowseComp của OpenAI: benchmark browsing gốc trên open web (openai.com/index/browsecomp)
- OBLIQ-Bench: paper giới thiệu bộ benchmark có tác vụ Congress hearings (obliq-congress)
- MADQA: bài giới thiệu benchmark của Snowflake, và MADQA Leaderboard
- BEIR: benchmark retrieval được nhắc trong phần benchmark bias
- GitHub của Hanna Lichtenberg · X của Hanna Lichtenberg
- LinkedIn của Hanna Lichtenberg: linkedin.com/in/hanna-lichtenberg-64778b221
Related talks
User Signal Dies at the Retrieval Boundary
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
The Log Is The Agent
Ishaan Sehgal · Omnara · 15 min
Agent không phải model hay runtime mà là append-only log: từ đó có reliability, scaling, forking, migration, và ai giữ log là người sở hữu agent.