Theo mê Ultrafast nhưng giá của nó gần như không dùng nổi
Theo đo chi phí Ultrafast của GPT-6 Astra, rồi kể việc build Slopalytics trong vòng lặp nhanh cho thấy tốc độ đổi cách làm việc ra sao và khi nào nên dùng.
✓ Đã duyệt độc lập · cập nhật 21/10/2026 · 28 min
1. Ultrafast đã tới: sửa một app theo thời gian thực
Theo Browne mở đầu bằng một câu chơi chữ: Ultrafast có lẽ đã không "ultra fast" trong chuyện ra mắt, nhưng giờ thì nó đã ở đây (theo video đăng ngày 06/10/2026). Vào thời điểm video, Ultrafast là chế độ tốc độ cao nhất mà OpenAI mở cho model GPT-6 Astra. Nó không chỉ build cực nhanh với một model như Astra, mà còn đốt rate limit và hoá đơn của bạn còn nhanh hơn nữa. Dù vậy, Theo thừa nhận cảm giác dùng nó vẫn thật sự "phê" và lạ lẫm.
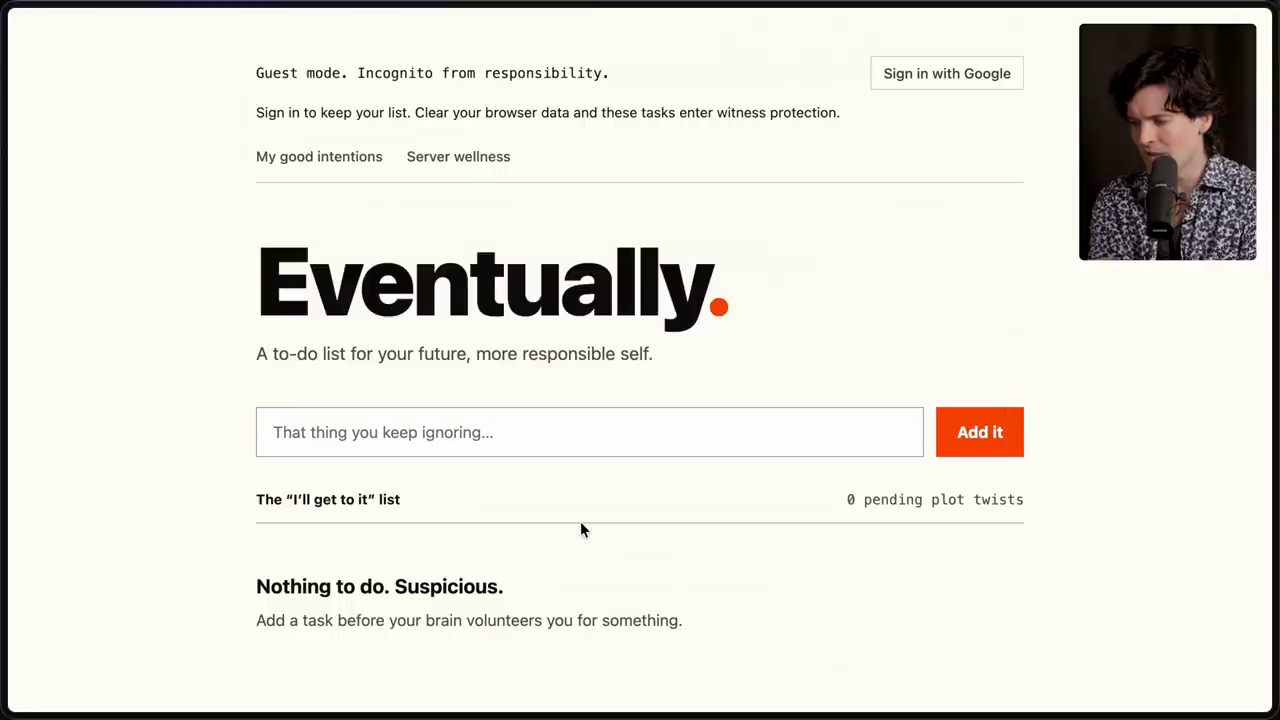
Để chứng minh, anh mở một app vừa dựng vội với Lakebed. Trong T3 Code, project tên "utlrafast-demo" có một thread "Build and Deploy Init Template", và anh gõ một yêu cầu rất ngắn:
Make it light mode and funnier
Rồi anh chỉ ngồi xem trang cập nhật trực tiếp. Anh nhắc đi nhắc lại rằng mọi thứ đều đang chạy theo thời gian thực, không cắt ghép, nên anh mong mình không vấp lời vì không muốn phải xử lý chuyện đó lúc dựng mà vẫn giữ được cảm giác thời gian thực. Agent chụp một snapshot của trang, và gần như ngay lập tức đã xong. Theo nhấn mạnh lần nữa: hoàn toàn thời gian thực, nó cứ thế lướt qua việc.
Theo liệt kê cả đống use case thật cho tốc độ này: làm prototype trực tiếp, làm việc trong vòng lặp với model (in the loop), xong việc nhanh hơn, tạo ra những trải nghiệm cho người dùng có cảm giác tức thì hơn hẳn, và computer use theo kiểu bạn có thể ngồi xem mà thấy nó còn nhanh hơn cả một người đang dùng máy tính. Nhưng (theo video đăng ngày 06/10/2026) dù dùng một model nhanh đến vậy mạnh mẽ đến đâu, cái giá thì rất nặng.
2. Bảng giá: output đắt gấp sáu lần
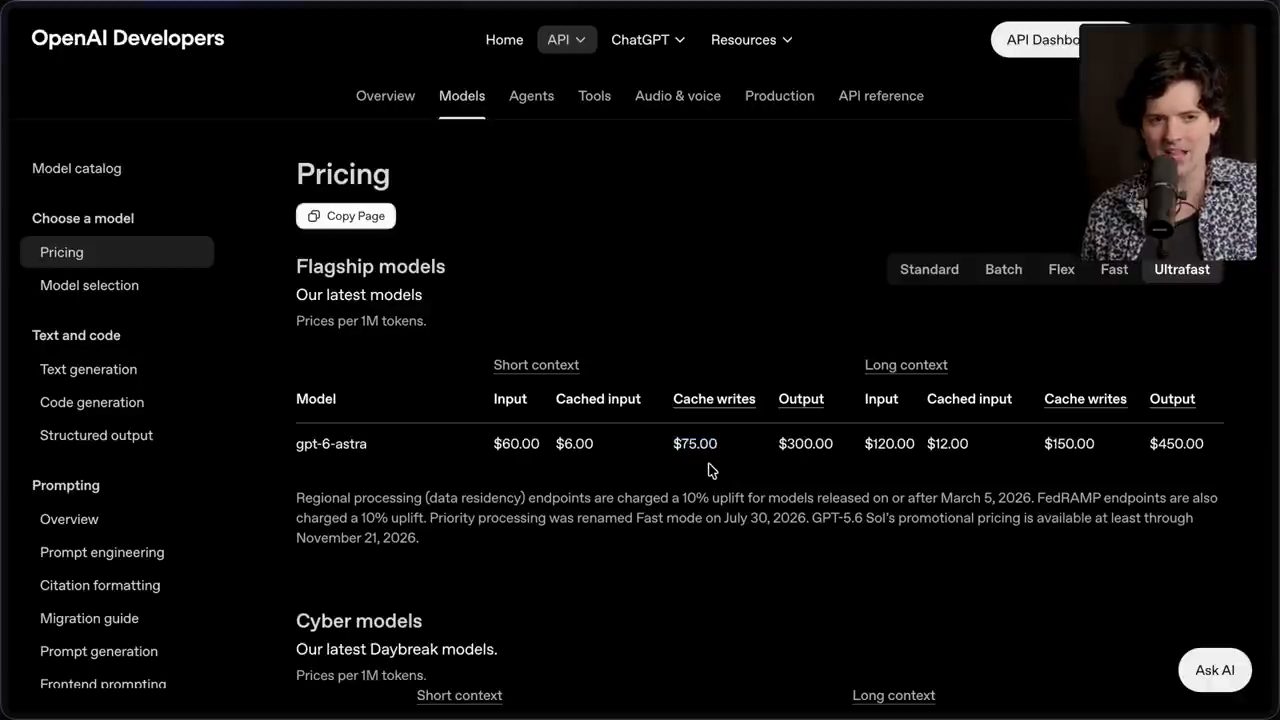
Theo mở trang Pricing trên OpenAI Developers. Theo bảng giá anh chiếu trong video đăng ngày 06/10/2026, Astra vốn đã hơi đắt với 50 đô mỗi triệu token output ở chế độ Standard. Bật Ultrafast lên thì con số đó thành 300 đô mỗi triệu token output. Và nếu không may đây là một project long context, bạn sẽ trả tới 450 đô mỗi triệu token output. Anh gọi những hoá đơn này là điên rồ thật sự.
Khi mới thử Ultrafast, Theo dùng nó cho việc thường ngày. Anh cho nó review hai pull request nhỏ đang mở, cả hai đều dưới 100 dòng code, và chúng tốn khá nhiều tiền. Anh thách người xem đoán: review hai pull request thì hết bao nhiêu tiền token?
Trong chat, nhiều người đoán khoảng 100 đô mỗi PR. Câu trả lời của Theo: tổng cộng 600 đô usage cho cả hai, theo chính số đo của anh trong video đăng ngày 06/10/2026. Anh nói thật điên rồ khi thấy có thể đốt nhiều tiền đến thế. Chat không tin là 600, hai số không, và anh khẳng định đúng là vậy. Nhìn lại bảng giá, đi từ 50 đô lên 300 đô mỗi triệu token output, bạn mới thấy nó tàn bạo tới mức nào: tăng gấp 6 lần là rất nặng.
3. Cache cũng đắt, và gói Ultrafast chỉ đủ khoảng hai giờ
Không chỉ output token. Theo bảng giá Theo đọc trong video đăng ngày 06/10/2026, giá đọc cache (cached input) lên tới 6 đô mỗi triệu token, nghĩa là đọc cache trên Astra Ultrafast còn đắt hơn đọc bình thường trên các model khác. Còn giá ghi cache 75 đô thì anh gọi là cao đến khó tin.
Theo nói rất thật: anh từng nghĩ Ultrafast hoàn toàn không dành cho mình, và đến giờ anh vẫn phần lớn tin như vậy. Anh không nghĩ gần như bất kỳ ai nên đụng vào Ultrafast vào lúc làm video (06/10/2026): nó quá đắt, nhất là theo giá API. Nhưng ngay cả lượng usage có trong gói Ultrafast mới 500 đô mỗi tháng cũng không đủ.
Theo lời Theo, trong video đăng ngày 06/10/2026, OpenAI đang bù lỗ rất nặng cho gói này: gói Ultrafast 500 đô cho khoảng một nghìn đô giá trị usage mỗi tuần, và lượng đó chỉ mất 2,1 giờ để đốt hết khi bạn dùng Ultrafast.
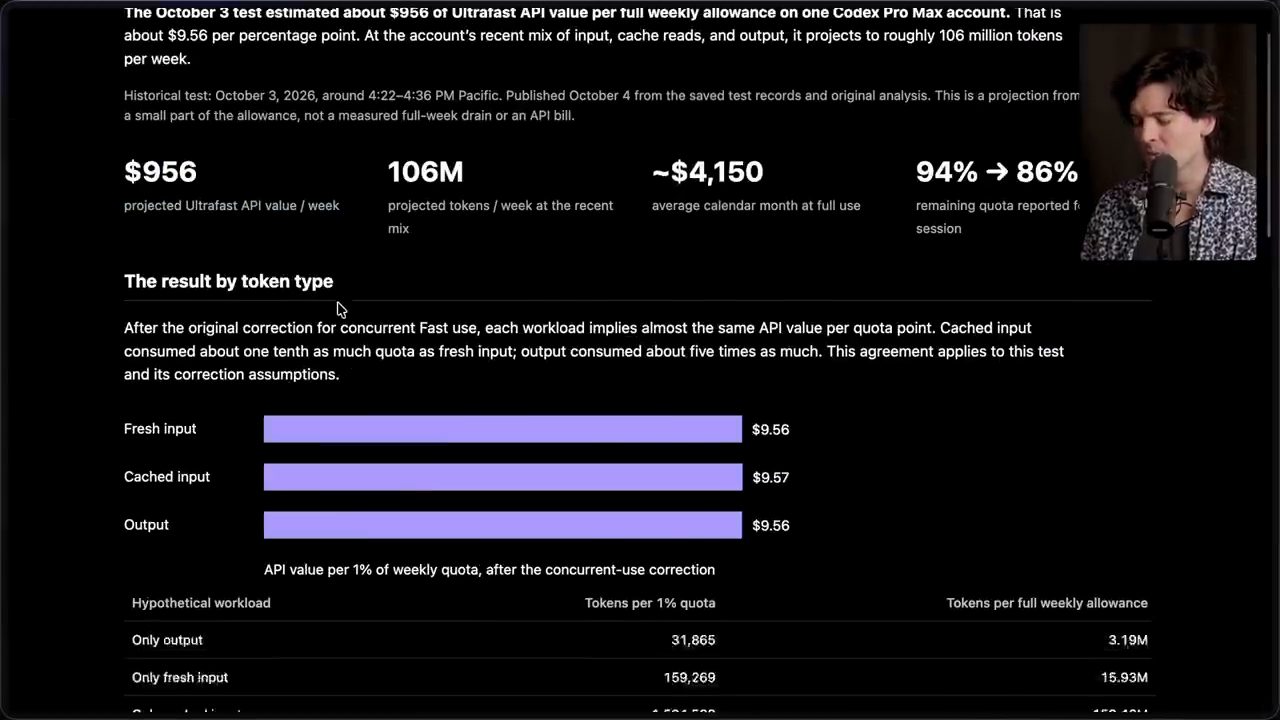
Theo số đo của Theo trong video đăng ngày 06/10/2026: anh làm mới hạn mức ngay trước khi chuẩn bị quay, và tài khoản Codex có gói 500 đô còn 38%. Anh gửi hai prompt. Một cái để dựng nhanh app này, mất 38 giây. Một cái để làm nó light mode và vui hơn, mất 16 giây.
4. Đo hạn mức sau từng prompt
Hai prompt đó kéo usage từ 38% xuống 37%, tức mất 1% cho chưa tới một phút làm việc (số đo của Theo, video đăng ngày 06/10/2026). Anh quyết định bắt nó làm thêm một chút, và gõ:
Turn this into a kanban app with a live chat. Make the changes one at a time so I can see them appearing in the dev server as you go.

Deploy as you go too
Anh hạ mức reasoning xuống Medium, và bảo nó deploy luôn trong lúc làm, vì (theo video đăng ngày 06/10/2026) Lakebed sẽ tự cập nhật bản live deploy mỗi khi có thay đổi, điều anh thấy khá hay. Nhưng tạm thời anh chỉ nhìn bản local. Lần nữa, tất cả là thời gian thực, không có những đoạn cắt thường lệ; anh còn đùa xin lỗi người dựng video, vì lần này đó là người duy nhất được làm việc nhẹ nhàng hơn.
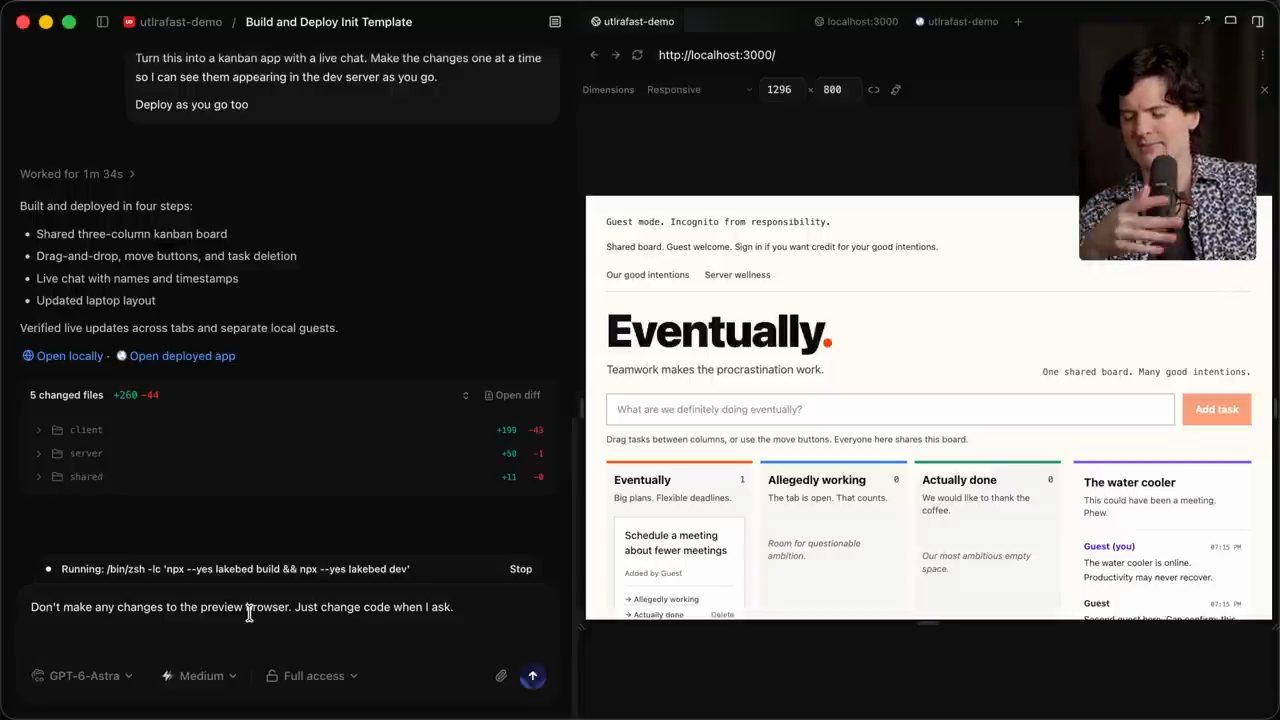
Họ thấy app cập nhật ngay trong lúc agent đang chạy. Trang đầy những dòng phụ vô dụng, thứ Theo sẽ bảo nó sửa sau, nhưng agent vẫn tiếp tục thay đổi và người xem thấy từng thay đổi hiện ra trực tiếp. Theo gọi cảm giác đó là "trippy".
5. Chia đôi màn hình với model, như hồi tự viết code
Theo nói bạn có thể có một kiểu quan hệ làm việc rất khác với một setup như thế này. Anh nhận ra việc chia đôi màn hình, một bên là app, một bên là model, lại trở nên hợp lý, vì anh không còn chỉ bảo model đi làm việc rồi xem kết quả khi nó xong.
Nếu bạn đang rất vật vã với kiểu flow giao việc cho agent, thread biến mất, rồi lúc sau mới quay lại xem, thì cách làm này rất tốt để thoát khỏi chuyện đó. Nhưng nó vẫn quá đắt (theo video đăng ngày 06/10/2026).
Anh chuyển app sang trình duyệt trong app của T3 Code (còn cái anh vừa mở là bản đã deploy) để dễ xem thay đổi trong lúc agent chạy.
6. Khi inference nhanh, tool call thành nút thắt
Đây là điều đầu tiên Theo muốn người xem suy nghĩ khi dùng Ultrafast. Khi phần sinh token mất 10 phút, còn lệnh git, build hay mọi thứ khác chỉ mất dưới 30 giây, thì tỉ lệ đó khiến thời gian sinh token lớn hơn hẳn, nên bạn chẳng buồn tối ưu các phần còn lại.
Nhưng khi inference đi từ 10 phút xuống 30 giây, 30 giây chờ tool call đó từ một phần nhỏ của tổng thời gian chạy biến thành thứ làm thời gian chạy tăng gấp đôi. Vì vậy Theo nói anh gần như muốn dùng một system prompt khác khi chạy Ultrafast, để lái model tránh xa những việc không quan trọng mà lại tốn thời gian.
Ví dụ, anh vừa bảo agent đừng động vào trình duyệt xem trước trong app, chỉ sửa code khi được yêu cầu, vì anh không muốn nó gọi những tool mất vài giây; anh chỉ muốn thấy cập nhật trong lúc làm. Rồi anh gửi thêm một yêu cầu, vì có cả đống khoảng trống vô dụng ở phía trên trang:
Don't make any changes to the preview browser. Just change code when I ask.

There's a ton of useless space being taken up from the top. I want you to delete all unnecessary subtitles and information, and really try to clear out the top nav so that way less vertical space is wasted.
Và họ xem nó sửa trực tiếp. Mọi thứ thừa biến mất, mất 11 giây theo số đo trong video đăng ngày 06/10/2026 (trên màn hình ghi "Worked for 12s": agent đã bỏ phần hero lớn, menu thừa, chữ cho khách, dòng phụ, gợi ý cột và chữ ở footer, để lại một header gọn với ô nhập task). Theo thấy rất dễ chịu. Nếu bạn muốn làm việc theo flow ở trong vòng lặp với model như vậy, anh nghĩ cách này rất hợp lý.
7. Bẻ lái model giữa chừng và dồn yêu cầu liên tục
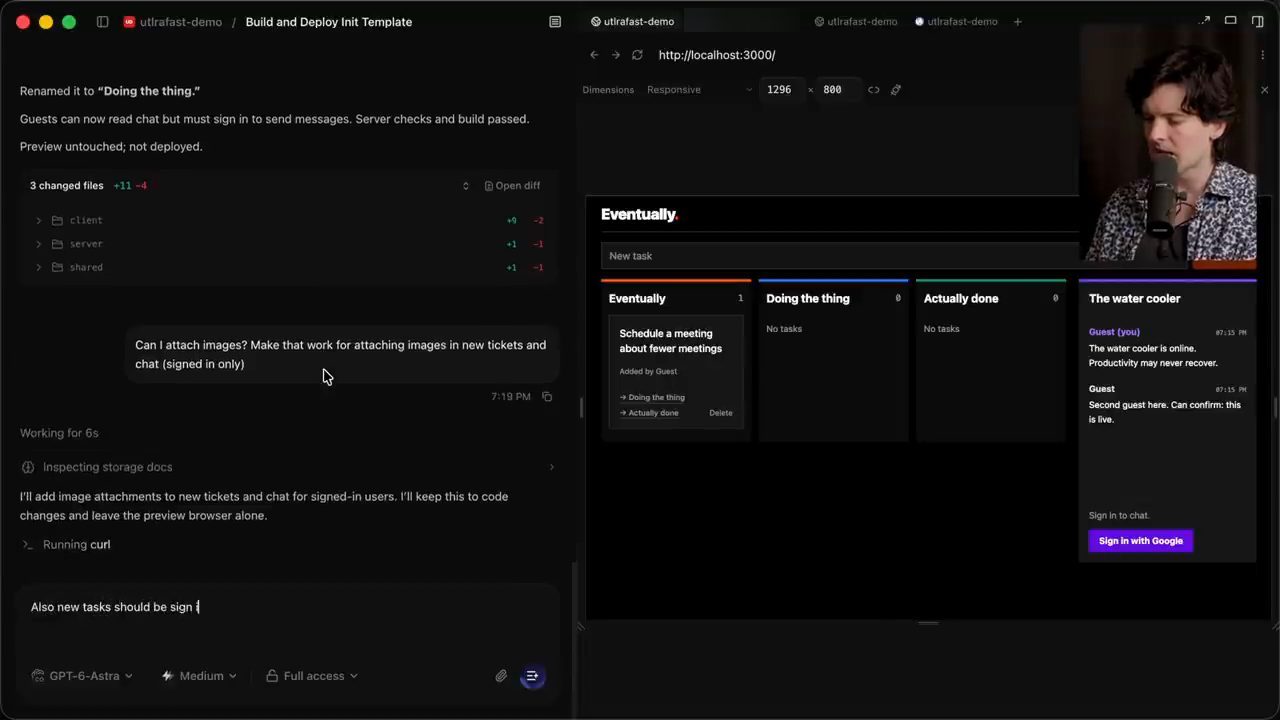
Theo nói chỗ trở nên thật sự điên rồ là: những model như Astra xử lý việc bị bẻ lái (steer) giữa chừng tốt hơn nhiều. Anh gõ "Make it dark mode by default again" và tiếp đó "I don't want guests to be able to chat". Thay đổi dark mode xong trong năm giây (theo video đăng ngày 06/10/2026). Anh chê tên cột "Allegedly working" hơi nhạt và bảo nó viết copy hay hơn. Anh gửi những câu này trong lúc agent đang làm việc khác, buộc nó phải đổi hướng, nhưng nó vẫn làm hết cùng lúc mà không sao.
Anh tự hỏi: mình có đính kèm ảnh được không? Rồi gõ thêm:
Can I attach images? Make that work for attaching images in new tickets and chat (signed in only)
Kèm theo một câu nữa là task mới cũng chỉ dành cho người đã đăng nhập. Theo nói bạn cứ thế dồn cho nó mọi thứ bạn để ý thấy trong lúc nó đang làm.
8. Cảm giác flow state, và hoá đơn người khác không phải trả
Theo mô tả kết quả là một cảm giác anh chưa từng thật sự có khi code với AI. Đó là flow state ngày xưa, khi bạn nhảy qua lại giữa code và output, biết rõ cái gì ảnh hưởng tới cái gì và cứ thế bay giữa hai bên, hồi chúng ta còn tự viết code. Nhưng theo cách này bạn còn làm được những thay đổi lớn hơn nhiều, vì bạn build được thứ thật: đây là Astra thật.
Theo nói, trong video đăng ngày 06/10/2026, Astra Ultrafast thực ra đang chạy trên phần cứng NVIDIA; anh từng tưởng nó chạy trên hạ tầng của một hãng chip suy luận chuyên dụng khác và chỉ mới biết là không phải. Với nó, mọi thứ như phép màu. Kết hợp với giọng nói thì trải nghiệm khác hẳn về bản chất. Anh hiểu vì sao bao nhiêu nhân viên OpenAI lại hào hứng đến thế với nó: vì cảm giác qua lại tức thì độc đáo này. Nhưng cũng vì họ không phải trả hoá đơn, bởi nhân viên OpenAI được dùng inference không giới hạn. Đương nhiên rồi, họ là nhân viên.
Rồi Theo xem lại hạn mức sau vài thay đổi vừa rồi (số đo của anh, video đăng ngày 06/10/2026): trước đợt thay đổi nhỏ ấy anh ở mức 37%, giờ còn 34%. Trên gói 500 đô, anh tắt hai tính năng, chuyển sang dark mode, và mất 3% hạn mức của gói. Anh gọi vậy là điên rồ.
Anh nhờ GPT-6.1 Sol ở mức Medium phân tích thread đó xem nó đáng giá bao nhiêu tiền, và trong lúc chờ thì nhấp một ngụm bia vì chuyện này làm anh rất chán. Anh kể thêm, nghe nói (tính đến video đăng ngày 06/10/2026) nhân viên OpenAI giờ phải xin duyệt cho từng task dùng Ultrafast, vì ngay cả họ cũng đụng giới hạn compute với nó, do nó quá đắt. Theo thấy nhẹ nhõm phần nào: nó không còn mang cảm giác "inference cho tôi, không cho bạn" như trước.
9. Hơn 40 lần tiền cho cùng một việc
Theo than rằng một khi đã quen Ultrafast thì mọi thứ khác đều thấy cực chậm. Kết quả phân tích về: theo con số Theo đưa ra trong video đăng ngày 06/10/2026, nếu trả giá API Standard cho đợt dùng Astra đó thì chỉ là 7,72 đô, nhưng thực tế (giá Ultrafast) là 46,32 đô. Tò mò, anh hỏi tiếp nếu dùng GPT-6.1 Sol thì hết bao nhiêu.
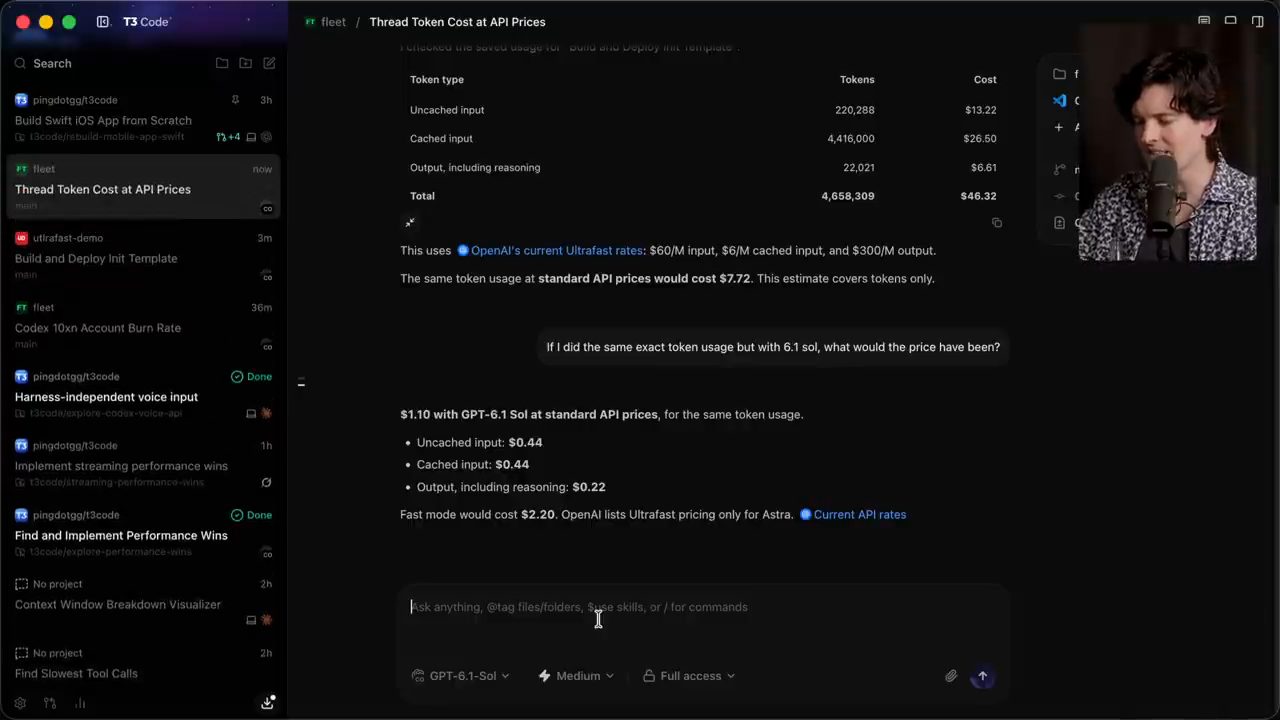
Câu trả lời: 1,10 đô. Nghĩa là nếu dùng GPT-6.1 Sol ở tốc độ bình thường, cùng lượng việc chỉ tốn 1,10 đô, và theo Theo, Sol hoàn toàn đủ sức làm những việc y hệt ở đây. Thay vào đó anh đã chi hơn 40 lần số tiền ấy để làm bằng Astra Ultrafast (số đo của anh, video đăng ngày 06/10/2026). Một mặt, điều này cho thấy GPT-6.1 Sol đáng tiền tới mức nào; mặt khác, nó cho thấy giá của Ultrafast phi lý tới mức nào.
Và nó phi lý thật. Theo đoán người xem nhìn những con số này sẽ nghĩ chẳng có thế giới nào mà chuyện này hợp lý, và anh không định nói là mình không đồng ý. Anh nghĩ (video đăng ngày 06/10/2026) phát hành nó với mức giá này là điên rồ. Anh không muốn quảng bá nó, không muốn đẩy nó, và không nghĩ phần lớn mọi người nên dùng nó.
Anh kể chuyện không có gì bất ngờ (theo video đăng ngày 06/10/2026): streamer ThePrimeagen mua gói 500 đô, thấy đó là gói Ultrafast, quyết định thử, và đốt hơn nửa hạn mức trong một giờ. Theo nghĩ OpenAI thật sự không nên làm cho nó trông như một thứ bạn chỉ việc bấm vào.
Anh nói (video đăng ngày 06/10/2026) đây cũng chính là vấn đề anh có với mức reasoning tối đa (max reasoning level): khi bạn đưa cho người dùng một cái núm vặn, họ sẽ vặn hết cỡ. Điều đó dẫn tới nhiều quyết định tồi, cả từ phía OpenAI vì đã đưa ra cái núm, lẫn từ phía người dùng vì đã vặn nó. Và anh thấy chuyện đó thật tệ. Vậy giá trị của Ultrafast nằm ở đâu?
10. Slopalytics: Opus mất 15 phút, Ultrafast chưa tới 2 phút
Theo nói anh sẽ giải thích giá trị đó theo một cách hơi lạ, bằng một app anh vừa build và phát hành (tính đến video đăng ngày 06/10/2026): Slopalytics, một trang so sánh model dựa trên dữ liệu của Artificial Analysis. Anh không biết người xem có giống mình không, nhưng khi anh nhìn một trang như thế này và nghĩ "ồ, trông được đấy, thông tin truyền đạt rõ ràng, dễ điều hướng, mọi thứ chạy ổn", thì phản xạ của anh là: chắc cái này làm bằng một model của Anthropic, rõ ràng là Opus hoặc Fable, đúng không?
Thực ra anh build nó hoàn toàn bằng Astra trên Ultrafast. Buồn cười là anh làm nó song song với Opus 5.5 và Ultrafast cùng lúc. Theo số đo của Theo (video đăng ngày 06/10/2026), lượt chạy Opus mất khoảng 15 phút mới có bản nháp đầu tiên chạy được. Trong khi đó Ultrafast mất chưa tới hai phút, khoảng một phút rưỡi làm việc của Astra trên Ultrafast là có bản nháp đầu chạy được.
Nhưng vì là Astra, bạn đoán được: nó xấu. Bản nháp đầu của Opus, mất gần 20 phút (số đo của Theo, video đăng ngày 06/10/2026), trông đẹp hơn đáng kể so với bản nháp đầu mất một phút rưỡi của Astra Ultrafast. Thế nhưng tới lúc anh thấy bản của Opus, bản của Astra đã tốt hơn rồi. Vì nó chỉ mất một phút rưỡi, anh nhìn vào và nói: đây là những điểm tôi không ưng ở bản bạn vừa làm. Rồi chúng cập nhật trực tiếp trên trình duyệt của anh.
Anh kể vòng lặp đó: "ok, mấy chỗ đó đỡ hơn rồi, hai chỗ này vẫn dở, thử cái này xem"; nó thử; "ôi tôi không thích, quay lại hướng kia, thử cái khác". Cuối cùng anh gửi nhiều tin nhắn hơn bất kỳ thread nào anh từng gửi trong một thời gian dài. Sau một hồi loay hoay và phát hiện vài thứ anh đã làm hỏng trong bản T3 Code local, anh tìm lại được thread đó, và nghĩ đây là cách rõ nhất để cho thấy vì sao anh thích dùng Ultrafast cho việc này đến vậy. Anh thậm chí nói có lẽ mình đã không làm xong Slopalytics nếu không có Ultrafast, vì nó khiến việc build theo cách này vui hơn nhiều.
Điều đầu tiên xảy ra: vì đang ngồi trong thread, anh để ý agent đang cố dùng skill tsdev của anh, một skill dùng Tailscale để host dev server từ xa. Nhưng anh đang làm trên chính máy mình nên không cần. Và vì thật sự đang chú ý, anh sửa nó ngay.
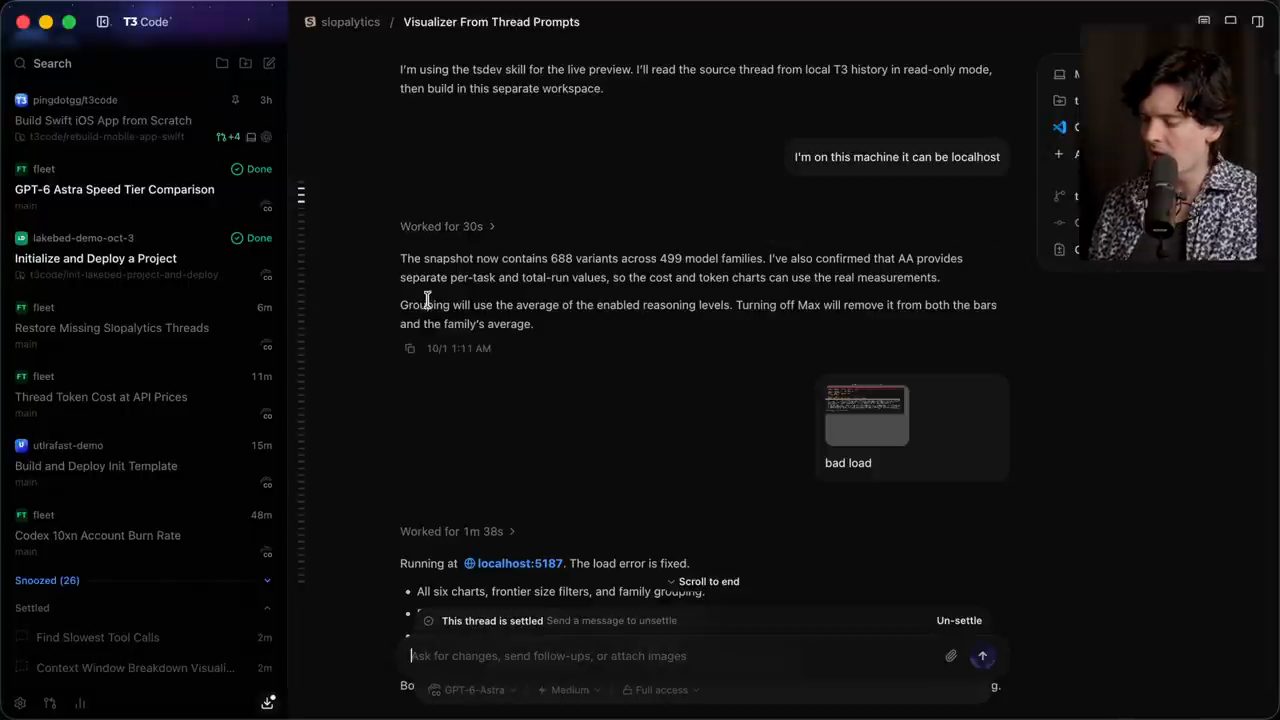
Ba mươi giây sau, snapshot đã có 688 biến thể (variants). Anh để ý phần tải trang có vấn đề: agent dựng trang, đưa ra một URL ở đâu đó, anh mở ra và nó không chạy. Tổng cộng mất khoảng hai phút làm việc (số đo của Theo, video đăng ngày 06/10/2026) trước khi có một bản localhost chứa toàn bộ dữ liệu từ Artificial Analysis và trông tạm ổn.
11. Từng vòng sửa trong thread, và vấn đề của dashboard Artificial Analysis
Nhưng anh thấy vài biểu đồ cột không tốt: toàn bộ nằm ngang, không có kiểu so sánh anh muốn. Nên anh gửi một ảnh chụp màn hình kèm yêu cầu dùng cột dọc và làm sao để mọi thứ vừa vặn trên một màn hình bình thường. Theo số đo của anh (video đăng ngày 06/10/2026), 41 giây sau agent trả lời, nhưng trang bị một lỗi ngẫu nhiên, và lúc đó nó trông như một bản "Artificial Analysis tốt hơn" nhưng cẩu thả. Anh gửi lại ảnh chụp với đúng hai chữ "not acceptable". Agent sửa một lỗi CSS cũ (trên màn hình ghi: một rule CSS cho màn hình rộng đã làm biểu đồ co về chiều cao bằng không) và đưa bản live lên.
Tiếp theo anh viết:
Use more logos and colors consisten with the labs, use AA for inspiration
Một phút sau (số đo của Theo, video đăng ngày 06/10/2026) trang đã cập nhật (trên màn hình: logo thật của các lab xuyên suốt, kể cả khi xuất PNG, và màu lấy cảm hứng từ Artificial Analysis với sắc độ thống nhất cho từng lab). Anh trả lời gần như ngay. Theo chỉ vào các mốc giờ trong thread: agent trả lời lúc 1:14 sáng, anh đáp cũng lúc 1:14, và các lượt qua lại sau đó đều cách nhau chưa tới một phút. Anh thật sự ở trong vòng lặp. Anh đã thôi để ý tới thread Opus đang làm cùng việc đó.
Rồi anh đổi ý về cách sắp xếp: "trung bình là vô dụng, sắp theo lựa chọn cao nhất, bỏ các đường trung bình". Đó đều là những ý anh nghĩ ra để cách sắp xếp hợp lý hơn và để đổi cách nhóm các model. Một trong những điều anh thấy hay nhất: anh không chỉ hiển thị riêng các mức reasoning tối đa rồi sắp theo số token ở mức max.
Đây là một trong những vấn đề anh có với dashboard của Artificial Analysis. Anh đùa đây là một trong những lần "chói mắt vì Artificial Analysis" cuối cùng của mình (trang đó nền sáng), vì từ nay anh sẽ chiếu Slopalytics. Anh muốn so sánh nhanh. Theo lời Theo (video đăng ngày 06/10/2026), các con số ở trang chủ của họ cho Opus 5.5 và Fable 5.1 đều là ở mức max reasoning, chi phí cũng vậy, và không con số nào có nghĩa.
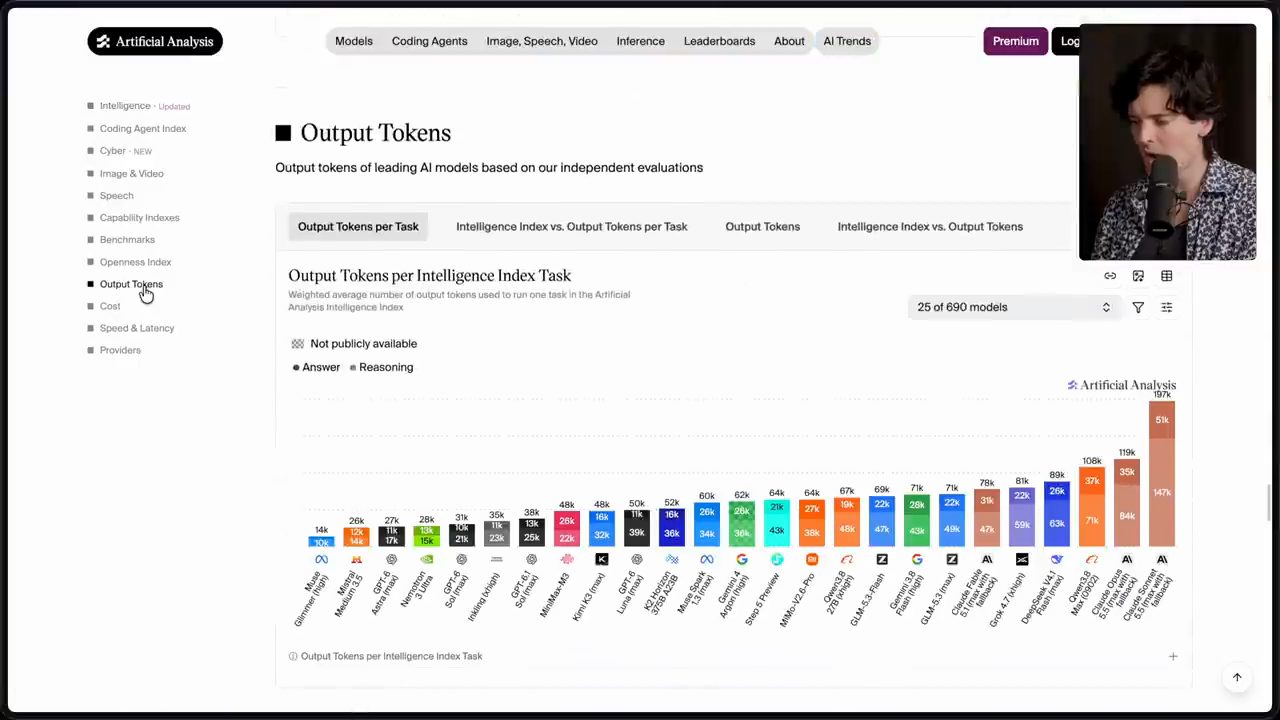
Còn tệ hơn khi kéo xuống phần output token: theo những gì Theo chỉ trên màn hình trong video đăng ngày 06/10/2026, Sonnet ở khoảng 200 nghìn token, Opus khoảng 120 nghìn, còn Astra tận đầu kia ở 27 nghìn. Càng vô nghĩa hơn khi bật thêm Opus 5.5 ở mức High: nó xuất hiện ở đâu đó, bạn có tìm được không? Anh biết nó nằm đâu: tít bên trái, trong khi Opus 5.5 Max ở tận đầu kia. Với kiểu hiển thị này, không thể thấy được quan hệ giữa các model trong cùng một họ.
12. Nhóm theo họ model và nút tắt từng mức reasoning
Vì thế trong Slopalytics anh nhóm số liệu theo họ model (model family), rồi xếp thứ tự dựa trên mức nào trong họ có số cao nhất. Cách này có vài hệ quả thú vị. Ví dụ khi thêm Sonnet vào, nó là model tệ nhất về hiệu quả token. Nhưng anh có mấy nút bật tắt nhỏ cho các mức low, medium, high và max. Tắt max reasoning đi thì Sonnet bị đẩy sang một bên: nó vô lý ở mức max effort, nhưng thực ra khá hợp lý ở xhigh, và còn hợp lý hơn ở high, khi đó nó tụt xuống thấp hơn cả Opus về lượng token dùng (theo dữ liệu Theo chiếu trong video đăng ngày 06/10/2026).
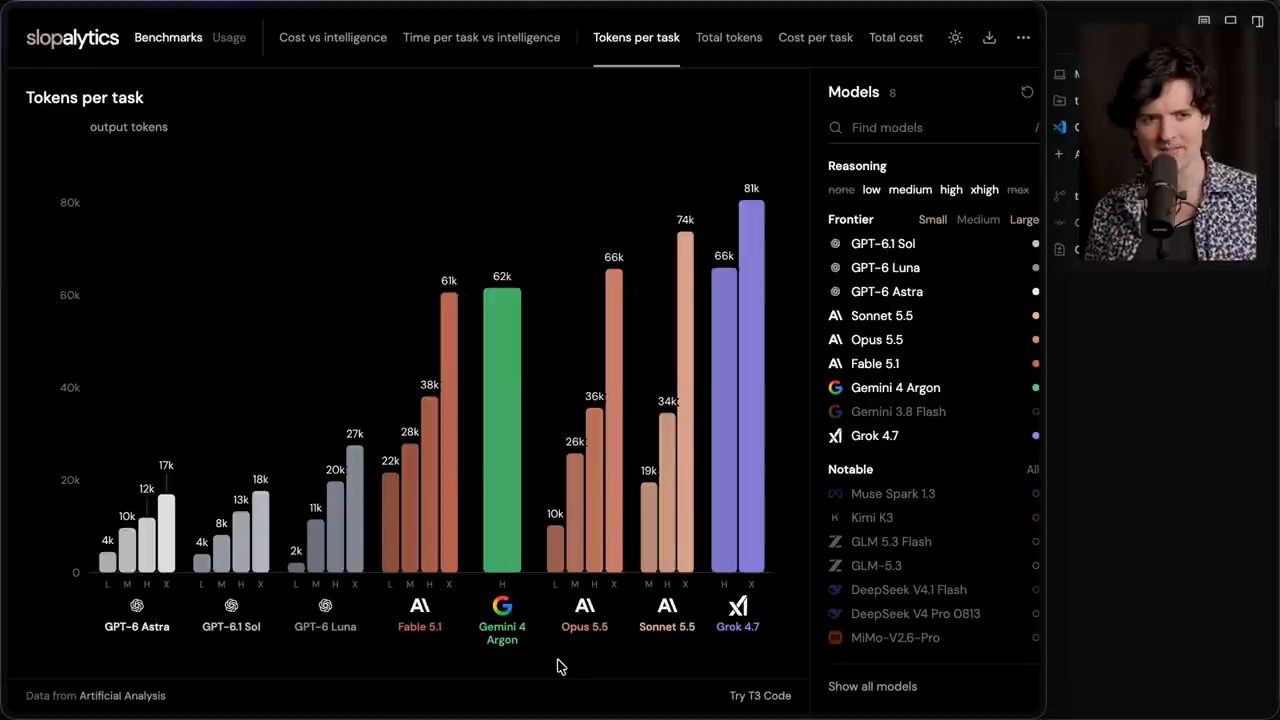
Theo nói không chỉ là anh có lẽ đã không bỏ thời gian build thứ này nếu không có Ultrafast, mà anh cũng không nghĩ mình sẽ nghĩ ra tất cả những UI pattern này. Anh phải qua lại liên tục: bảo nó làm một thứ, thấy không ổn, rồi bảo nó làm thứ khác. Dù theo Theo (video đăng ngày 06/10/2026) Astra kém hơn rất, rất nhiều so với các model của Anthropic về thiết kế, anh vẫn làm ra một thiết kế tốt hơn vì anh ở trong vòng lặp với nó. Và đã lâu rồi anh mới ở trong vòng lặp như vậy.
Anh còn sửa T3 Code (tính đến video đăng ngày 06/10/2026) để các thread đang chạy tự ẩn đi, vì anh không quan tâm thread đang làm gì cho tới khi nó xong. Trừ khi, tất nhiên, model đang làm việc cùng anh và hai bên có kiểu qua lại rất nhanh này.
Khi quay lại thread này để quay video, anh để ý có một đoạn anh đã chuyển sang GPT-6.1 Sol không có Ultrafast, vì vào lúc đó (theo video đăng ngày 06/10/2026) chưa có Ultrafast cho Sol. Anh nói rất mong có. Anh đổi sang Sol tốc độ thường không phải vì sợ phí tiền, mà vì đồ ăn của anh đang trong lò, và anh muốn đứng dậy đi lấy mà không thấy mình bỏ lỡ nhiều. Anh đi lấy đồ ăn ra, quay lại thì nó vẫn đang chạy. Rồi anh đổi lại sang Ultrafast và lại bay vèo vèo.
13. Những ý UX chỉ nảy ra khi ngồi trong vòng lặp
Theo chỉ ra thread này cho thấy một kiểu prompt rất khác với thường ngày của anh. Ảnh chụp kèm chữ "not acceptable". "Use more logos and colors consistent with the labs." "Change my mind on the sort. Averages are useless. Sort by highest." "Get rid of all the useless titles and subtitles. It's so cringe." Tất cả được gửi cách nhau chỉ vài phút: các mốc 1:15, 1:16, 1:18, 1:14, khoảng năm prompt trong bốn phút. Và mọi câu trả lời đều dưới một phút, có câu chỉ 20 giây; đổi cách sắp xếp mất 18 giây (số đo của Theo, video đăng ngày 06/10/2026). Bạn không có thời gian để bị phân tâm.
Tương tự với nút share: "nó chỉ là một URL". Anh liên tục bảo nó bỏ bớt thứ này thứ kia. "Default view doesn't need to have a URL hash. Only do that when they make changes." "Sort order's all wrong. Default should be highest last." Rồi anh hỏi có vẽ được một đường cho thấy chỗ nó cắt qua các model khác không, bấm vào thì đường đó phải giữ lại, và rê chuột lên model khác sẽ hiện khoảng chênh về điểm số và chi phí.
Đây là một trong những thứ UX điên rồ khác anh thêm vào mà anh sẽ không bao giờ nghĩ ra nếu không được qua lại kiểu này. Theo những gì Theo cho xem trên Slopalytics (video đăng ngày 06/10/2026), khi muốn so hai model trên biểu đồ, ví dụ Sonnet ở mức X-High với Fable 5.1, một khung so sánh hiện ra ở góc trên bên trái, cho thấy chênh lệch theo hệ số nhân về chi phí, số token và điểm intelligence. Anh nghĩ ra nó chỉ vì đang nhìn chằm chằm vào trang trong lúc nó được làm, và được qua lại với model để thử những thứ khác nhau.
Anh đã qua lại rất nhiều ở đây. Anh quên mất bản đầu trông thế nào, nhưng có chụp lại vì ghét nó: khung đó che lấp mọi thứ. Anh đổi ý ba lần về chỗ đặt khung, cứ qua lại mãi tới khi hài lòng. Anh rất không vừa ý với cách nó sắp xếp panel, nên chỉ bảo nó là anh muốn ba cột này, và nó làm theo. Rồi: "UI feels a bit flickery when hovering around. Not sure the best solution. Maybe delay." Nó làm, anh ghét, và gửi "changed my mind this feels awful". Theo số đo của anh (video đăng ngày 06/10/2026), làm mất 25 giây, gỡ lại mất 10 giây.
Rồi anh gửi tiếp: panel phải ở góc trên bên trái chứ không phải bên phải, góc trên bên phải là vùng cấm vì anh cần chỗ đó cho mặt mình trong video; và có thể chuyển sidebar sang phải theo cách không tệ không. Theo số đo của anh (video đăng ngày 06/10/2026), 32 giây sau đã xong. "Hovering names in 2D charts should make the line more prominent and others more transparent." Đó là ở những biểu đồ đường: giờ anh rê chuột lên Opus hay Sonnet thì thấy rõ đường nào là của model nào. Ý đó nảy ra ngẫu nhiên lúc anh đang cuộn trang, và anh cứ thế ném vào, rồi nó được sửa xong.
"Good work. Sadly, it's still hideous and it needs a bunch of cleanup. Get on that. Spin up some separate sub-agents to work on branding." Và nó làm thật. Nó nghĩ ra cả đống tên, anh ghét tất cả. Anh bảo các thread khác nghĩ thêm, và chúng cũng ra một đống rác. Hoá ra, theo Theo (video đăng ngày 06/10/2026), model vẫn dở trong việc đặt tên, kể cả khi chúng nhanh. Cuối cùng anh tự nghĩ ra cái tên Slopalytics, và đó là đoạn trong thread nơi app trở thành Slopalytics. Anh chỉ cho người xem: thread này có hơn 50 tin nhắn, trong khi anh chưa bao giờ gửi nhiều đến vậy trong một thread. Build theo cách này cảm giác hoàn toàn khác.
14. Tốc độ thật và tiền thật của cả dự án
Theo cũng vừa chạy số đo TPS (token mỗi giây) thật cho lượng dùng của mình. Theo số đo của Theo trong video đăng ngày 06/10/2026: tốc độ thường khoảng 30 TPS, Fast khoảng 60, còn Ultrafast trên 300, trong khoảng 320 đến 340. Anh gọi vậy là điên rồ.
Nhưng anh cũng tìm ra chi phí cho tất cả các thread làm Slopalytics (tính theo giá API, số đo của Theo, video đăng ngày 06/10/2026). Thread chính tốn 306 đô, thread tiếp theo nơi anh làm thêm nhiều việc tốn 250 đô. Nếu không dùng Ultrafast mà dùng Astra thường, khoảng 550 đô đó sẽ chỉ còn 90 đô. Còn nếu dùng GPT-6.1 Sol, mà theo anh cũng tốt y như vậy cho việc này, thì là 12 đô.
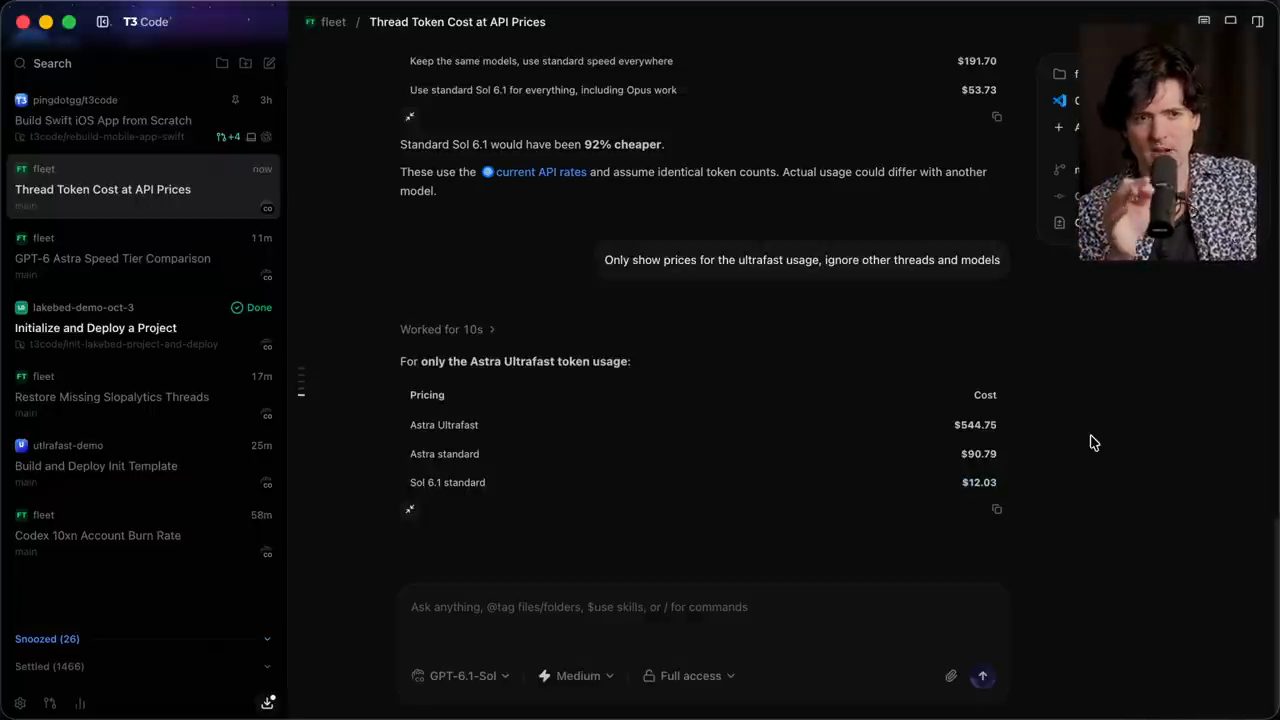
Vậy câu hỏi là: tiết kiệm được ngần ấy thời gian có đáng khoảng 540 đô với bạn không (theo phép so của Theo, video đăng ngày 06/10/2026)? Câu trả lời có lẽ là không. Và nếu bạn so theo kiểu đó, bạn không bao giờ, không bao giờ nên dùng Ultrafast. Nó đơn giản là không đáng. Nó quá đắt. Nó đốt hạn mức nhanh tới mức buồn cười. Nó khiến gói 500 đô hoàn toàn vô nghĩa (theo nhận định trong video đăng ngày 06/10/2026). Nó kỳ cục, nó tệ, và không nên có trong sản phẩm mà thiếu cả loạt cảnh báo.
15. Khác biệt thật: không phải tiết kiệm, mà là có build hay không
Chính vì vậy Theo nói anh rất đau lòng khi phải bênh vực nó. Bởi đây không phải một phép so sánh thật. Đây là phép so giá Astra Ultrafast với Sol 6.1. Khác biệt ở đây không phải là "lẽ ra mình kiên nhẫn hơn và tiết kiệm được hơn 500 đô" (theo video đăng ngày 06/10/2026). Khác biệt là anh đơn giản sẽ không build nó.
Nếu phải chờ giữa từng bước, anh sẽ mất ngữ cảnh về điều mình đang nghĩ. Anh sẽ quên những thứ mình muốn đổi. Và anh phải dựng lại ngữ cảnh đó mỗi khi một bước xong. Vì thế anh thấy mình viết những yêu cầu nhỏ hơn, xin những thay đổi nhỏ hơn, thay vì làm như với Opus: nhìn output, lập danh sách 20 thứ muốn đổi, gửi đi, rồi chờ nó quay lại sau khoảng từ năm phút tới hai giờ (theo video đăng ngày 06/10/2026).
Kiểu làm việc trong vòng lặp này cực kỳ hữu ích cho một số việc, như tinh chỉnh UI. Anh thừa nhận nói ra nghe ngớ ngẩn, nhưng (theo video đăng ngày 06/10/2026) anh làm UI tốt hơn với Astra so với Fable và Opus. Không phải vì Astra giỏi thiết kế hơn; về khách quan nó kém hơn. Mà vì thiết kế là chuyện người dùng tương tác và cảm nhận mọi thứ ra sao. Nếu anh dành được nhiều thời gian hơn cho cảm nhận đó, ở trong vòng lặp lâu hơn, anh có thể bay.
16. Hy vọng ở GPT-6.1 Sol Ultrafast
Đây là chỗ Theo có chút hy vọng, và cũng là điều một người bạn trên X đã nhận ra. Người đó hỏi đại ý: tôi có đang tưởng tượng không, hay nếu hệ số nhân vẫn là 6 lần thì GPT-6.1 Sol Ultrafast sẽ rẻ hơn đáng kể so với GPT-6 Astra, và rẻ hơn rất nhiều so với Astra ở chế độ nhanh?
Theo tính lại bằng số của mình (video đăng ngày 06/10/2026): với giá Standard, phần việc đó bằng Sol tốn 12,03 đô, còn Astra là khoảng 90 đô. Vậy trong một thế giới giả định nơi GPT-6.1 Sol có chế độ Ultrafast với cùng hệ số nhân giá, nó không chỉ rẻ hơn khoảng 10 lần so với Astra Ultrafast, mà còn rơi vào khoảng ngang, nếu không nói là rẻ hơn, Astra Standard.
Bạn thấy hướng đi rồi chứ: theo Theo (video đăng ngày 06/10/2026), mục đích của Astra Ultrafast không phải để được dùng. Nó để thử nghiệm, để những kẻ điên như anh phí quá nhiều token vào nó chỉ để xem nó làm được gì và cảm được những flow này, vì chúng ta đang mong tới một tương lai có tốc độ đó với cái giá không làm mình buồn nôn. Và nếu thật sự tới tương lai mà Sol 6.1 trên Ultrafast nhanh như Astra với một phần mười giá, anh có thể thấy nó trở thành model mặc định của mình.
Anh vốn đã đặt GPT-6.1 Sol Fast làm mặc định cho cả đống việc khi mở project mới trong Fleet, repo anh dùng để quản lý mọi thứ. Mở ra thì thấy nó đang ghim vào Astra, nên anh sửa luôn, vì đó không phải thứ anh muốn và anh đã đổi trên các máy khác: giờ nó là GPT-6.1 Sol, mức High, Fast. Anh nghĩ (video đăng ngày 06/10/2026) đó là sự cân bằng rất tốt giữa tốc độ, năng lực và hiệu năng nói chung cho những việc quản lý các máy trong mạng của anh, không phải để viết code đem deploy, mà để làm việc trực tiếp trên hệ thống.
Còn một điều nữa. Tibo bên OpenAI vừa nhá hàng "6.1 coming soon" (theo video đăng ngày 06/10/2026). Nhiều người đoán đó là GPT-6.1 Astra, nhưng thực ra đó là một reply về Ultrafast bị cắt mất phần đầu, với nội dung "6.1 sol ultrafast". Theo coi đây là xác nhận công khai rằng GPT-6.1 Sol Ultrafast sắp tới. Anh chưa chắc nó sẽ chạy trên hạ tầng nào: có thể là một hãng chip suy luận chuyên dụng, có thể chỉ là những thứ điên rồ họ đang làm với NVIDIA. Dù sao, Sol Ultrafast đang tới, và anh nghĩ nó có thể là thứ tạo khác biệt, biến gói Ultrafast 500 đô từ chỗ thấy quá đắt so với những gì nhận được thành một món hời thật sự (nhận định của Theo, video đăng ngày 06/10/2026).
17. Vậy nên dùng Ultrafast vào việc gì
Còn lại một câu hỏi quan trọng: nên dùng Ultrafast vào việc gì? Theo viết lên bảng trắng.
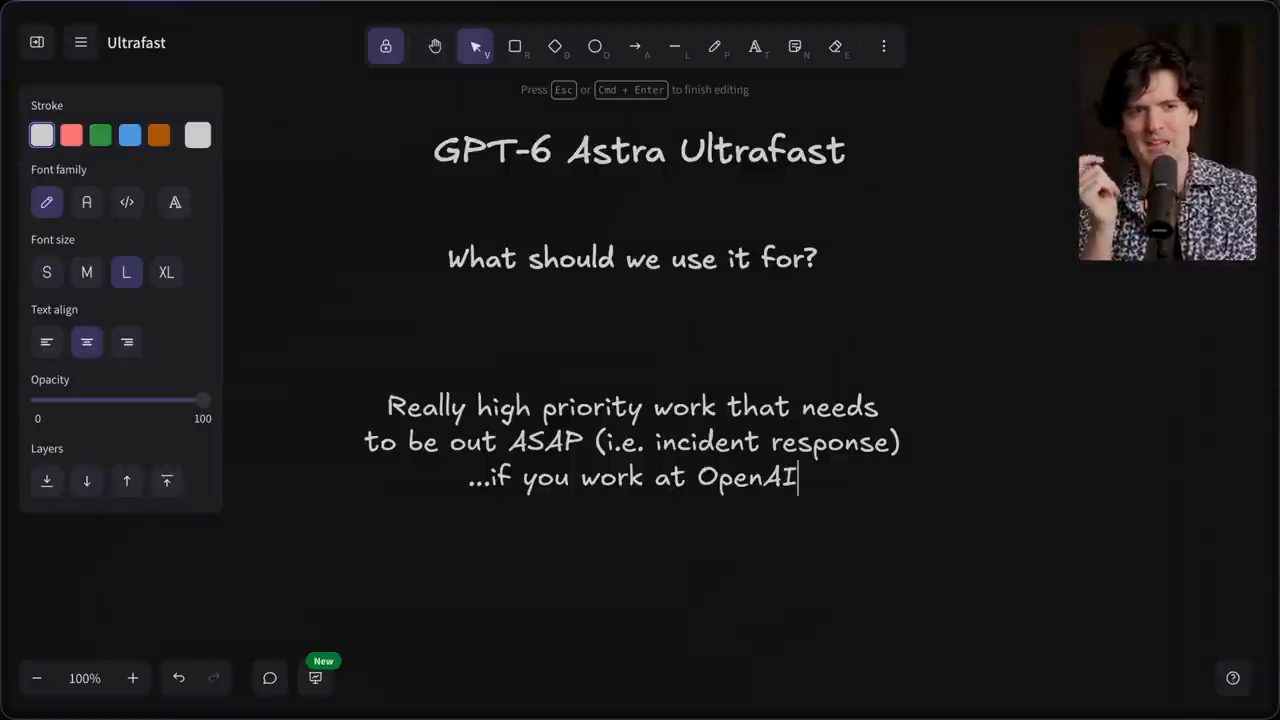
Thứ duy nhất nó hợp là những vấn đề cực kỳ ưu tiên cần xử lý ngay, như ứng phó sự cố nghiêm trọng (incident response), với điều kiện bạn làm ở OpenAI. Vì ngay cả với sự cố nghiêm trọng, nó có lẽ cũng không đáng tiền, trừ khi tiền đó không phải tiền thật. Nó quá đắt (theo video đăng ngày 06/10/2026), gần như không thể biện minh.
Nhưng có một lúc khác biện minh được, và với Theo, lúc đó là ngay bây giờ (lúc quay video). Theo lời anh trong video đăng ngày 06/10/2026, tài khoản Ultrafast của anh có chín lượt reset thủ công: sáu lượt được tặng ở một sự kiện anh tham dự, cộng với những lượt mà ai cũng được nhận. Một lượt sẽ hết hạn trong một giờ nữa, nghĩa là anh có một giờ để đốt 34% hạn mức của tài khoản. Đó là thời điểm tuyệt vời để dùng Ultrafast.
Và Tibo vừa đưa ra một thông báo khá táo bạo ngay trong ngày (theo video đăng ngày 06/10/2026): trong 28 ngày tới, mỗi ngày họ sẽ hoặc ship một thứ cải thiện rõ ràng và có ích cho phần lớn người dùng Codex và work, hoặc ship một lượt reset toàn bộ. "Let the improvements begin." Theo nói điều này nghĩa là anh sẽ có rất nhiều dịp để đốt Ultrafast. Vì lần nào hứa reset cũng trễ: họ bảo 10 giờ sáng thì sớm nhất cũng phải trưa mới có. Nên cứ đốt trước đi.
Vì anh dùng Opus cho việc nghiêm túc, tài khoản Codex về 0 cũng không sao, không chặn anh bao nhiêu. Nên hễ có chút dấu hiệu sắp có reset là anh đốt sạch tài khoản đó. Theo kinh nghiệm của anh (video đăng ngày 06/10/2026), có lúc reset tới trước khi anh chạm 0, có lúc một hai giờ sau khi chạm 0, có lúc tới tận hôm sau. Anh dùng Ultrafast khi tài khoản sắp được reset đằng nào cũng vậy. Đó là lúc anh dùng nó.
Anh không biết bạn nên dùng nó khi nào. Có lẽ để ứng phó sự cố thỉnh thoảng; nếu bạn là nhân viên OpenAI, anh chắc bạn sẽ dùng nó nhiều cho những việc như vậy. Hãy dùng nó khi bạn không tiếc nếu mất. Đừng nâng lên gói 500 đô chỉ vì nó, ít nhất là chưa (lời khuyên của Theo trong video đăng ngày 06/10/2026): không đáng. Khi GPT-6.1 Sol Ultrafast ra mắt, nó có thể bỗng trở nên đáng hơn, và anh hứa sẽ cập nhật khi có thêm thông tin. Còn lúc đó, anh không nghĩ bạn nên với tới gói 500 đô.
Còn gói 200 đô thì sao (theo video đăng ngày 06/10/2026)? Gói đó không có Ultrafast, nhưng có GPT-6.1 Sol, có Astra, có Fast mode, có nhiều thứ khác, và có tất cả các lượt reset. Gói 200 đô còn đáng không? Theo nói để trả lời câu đó anh sẽ cần thêm một chai bia nữa và có lẽ thêm một video nữa, sắp ra rất sớm. Giờ thì bạn biết Ultrafast là thứ nên tránh; hy vọng sớm thôi bạn cũng sẽ biết gói 200 đô nên dùng hay nên tránh. Anh chào tạm biệt bằng câu quen thuộc: "peace nerds".
Nguồn và liên kết 10 nguồn
- Tên gốc: I love Ultrafast (it's unusable)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=pJljViiUEPw youtube.com
- Kênh YouTube Theo - t3․gg (Theo Browne): youtube.com/channel/UCbRP3c757lWg9M-U7TyEkXA youtube.com
- Bảng giá API của OpenAI, có tab Ultrafast như trong video: developers.openai.com/api/docs/pricing developers.openai.com
- Tài liệu Ultrafast mode của OpenAI (tính đến 21/10/2026 trang này ghi Ultrafast có cho cả GPT-6 Astra lẫn GPT-6.1 Sol): developers.openai.com/api/docs/guides/ultrafast-mode developers.openai.com
- T3 Code, app agent Theo dùng trong cả video (open source): github.com/pingdotgg/t3code github.com
- Lakebed, nơi app demo được dựng và deploy: lakebed.dev lakebed.dev
- Slopalytics, trang so sánh model Theo build bằng Astra Ultrafast: slopalytics.com slopalytics.com
- Artificial Analysis, nguồn dữ liệu của Slopalytics: artificialanalysis.ai artificialanalysis.ai
Related talks
Tự build công cụ phát hiện video AI bằng Codex
Matt Wolfe · Matt Wolfe · 20 min
Matt Wolfe dùng ChatGPT và Codex build một AI slop detector, thử Gemini rồi Sightengine, đo độ chính xác, chi phí và mở code trên GitHub.
Dùng Jev cùng Claude Code: System 1 cho coding agent
Ray Amjad · Ray Amjad · 27 min
Jev là model System 1 chấm xác suất cho các lựa chọn; Ray Amjad ghép nó với Claude Code để chọn skill, kiểm thử, lint, tìm code smell và review code rẻ.
MCP server cho GitHub Copilot, giải thích đơn giản
Chetan Ghate · CodeSnippet by Chetan · 13 min
MCP là gì, vì sao Copilot cần nó để với tới GitHub, Jira, Datadog, và cách cài GitHub MCP server trong VS Code rồi dùng nó tóm tắt issue.