Jev, LLM, BERT và XGBoost cùng giải một bài toán phân loại ngân hàng
So Jev, GPT-4.1 nano, MiniLM và XGBoost trên 120 tin nhắn BANKING77: accuracy, Macro-F1, latency, chi phí, cách từng model chạy và khi nào dùng cái nào.
✓ Đã duyệt độc lập · cập nhật 23/10/2026 · 23 min
1. Bốn model, một bài toán ngân hàng
Maryam Miradi mở đầu bằng kết luận: chị cho Jev, một LLM, BERT và XGBoost cùng giải một bài toán ngân hàng, và theo lời chị (video đăng ngày 18/10/2026), kết quả "không hề sát nhau" (not even close). Chị kể rằng từ khi Jev ra mắt, người xem liên tục hỏi chị mấy câu: Jev khác LLM ở chỗ nào? Jev có phải chỉ là một BERT khác? Hay Jev chỉ là thêm một classifier machine learning nữa? Và một câu nữa: Jev thậm chí không sinh được văn bản, vậy thì khi nào mới thật sự dùng tới nó?
Chị hứa trong video sẽ trả lời hết những câu đó: cho xem code, cho xem kết quả thô (raw results), giải thích từng model chạy thế nào bên dưới (under the hood), và quan trọng nhất là khi nào dùng cái nào. Chị tự giới thiệu ngắn: Maryam, tiến sĩ (PhD), AI scientist với hơn 20 năm kinh nghiệm xây giải pháp AI và machine learning cho nhiều ngành.
2. Dashboard so sánh: BANKING77, sáu nhãn và hai ví dụ
Maryam chuyển sang một dashboard do chính chị dựng, tiêu đề "AI Model Showdown". Dữ liệu là bộ BANKING77, một dataset công khai trên Hugging Face (đọc ngày 23/10/2026) gồm các câu khách hàng gửi ngân hàng. Chị nói bộ dữ liệu này rất quan trọng và sẽ giải thích lý do ở phần sau (phần nghiên cứu độc lập, mục 14). Trong thí nghiệm này chị chỉ dùng sáu category làm đầu ra: tin nhắn đi vào, và một trong sáu nhãn đi ra.
Chị chạy thử vài ví dụ. Ví dụ đầu là câu "transaction failed?" (giao dịch thất bại?). Chị bấm "Compare all 4 models" và, trong lần chạy quay ở video đăng ngày 18/10/2026, BERT (MiniLM) và XGBoost đoán đúng, còn Jev và LLM thì không. Trên màn hình, đáp án đúng là "Transfer not received" (chuyển khoản chưa tới); Jev và LLM cùng chọn "Card payment declined" (thanh toán thẻ bị từ chối), còn MiniLM và XGBoost chọn đúng "Transfer not received". Mỗi thẻ kết quả còn ghi latency, điểm tin cậy và chi phí của lần gọi đó.
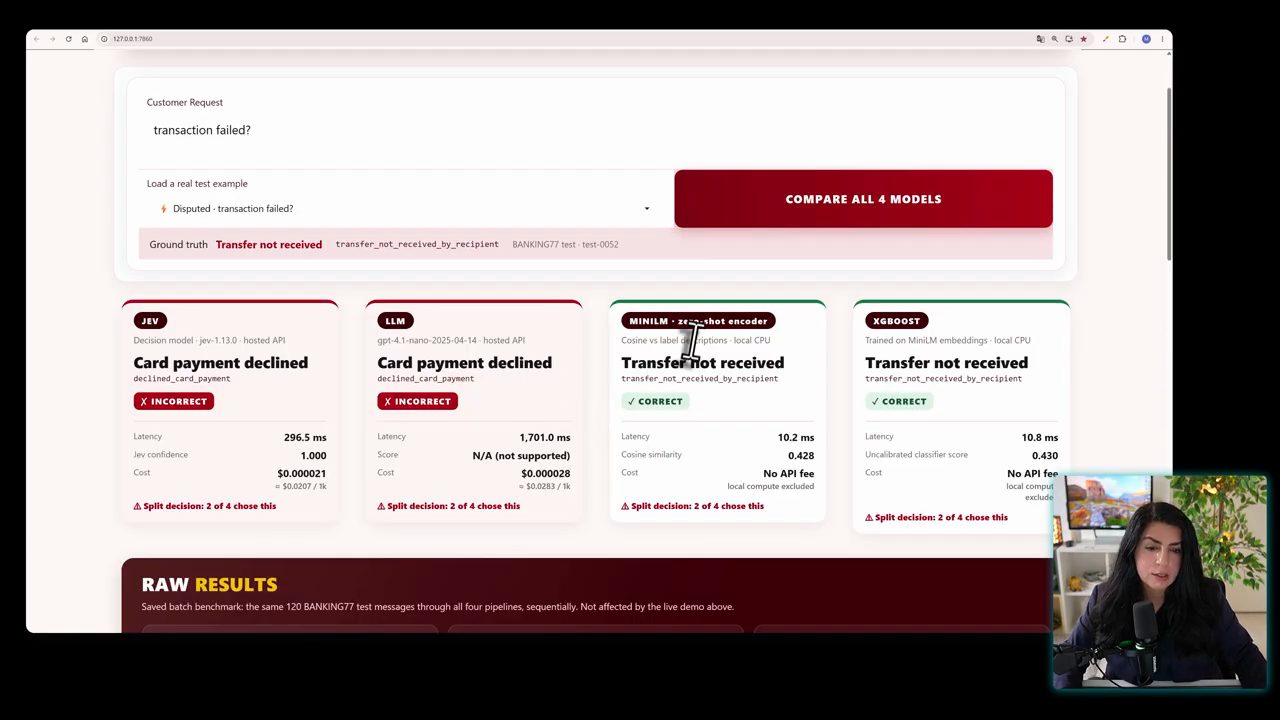
Ví dụ thứ hai là câu "my friend still hasn't gotten a transaction I made" (bạn tôi vẫn chưa nhận được khoản tôi chuyển). Lần này (vẫn trong video đăng ngày 18/10/2026) Jev, LLM và XGBoost đều đúng, còn BERT sai: trên màn hình MiniLM chọn "Refund not showing up" (chưa thấy tiền hoàn), trong khi ba model kia chọn "Transfer not received".
Để đặt bối cảnh, Maryam kể rằng mỗi ngày ngân hàng nhận rất nhiều tin nhắn. Trong thực tế, theo chị (video đăng ngày 18/10/2026), người ta cứ ném một LLM vào xử lý, và chính chị đôi khi cũng bị định tuyến (routing) sai. Vì vậy chị cho Jev, LLM, BERT và XGBoost chạy trên 120 tin nhắn thật, rồi so ba thứ: accuracy, tốc độ và chi phí. Với mỗi ví dụ chị chọn, chị cũng đo latency, độ tin cậy (confidence) và chi phí, và từ đó ra bảng kết quả mà chị lần lượt phân tích ở các mục sau.
3. Ai đoán đúng nhiều nhất: accuracy
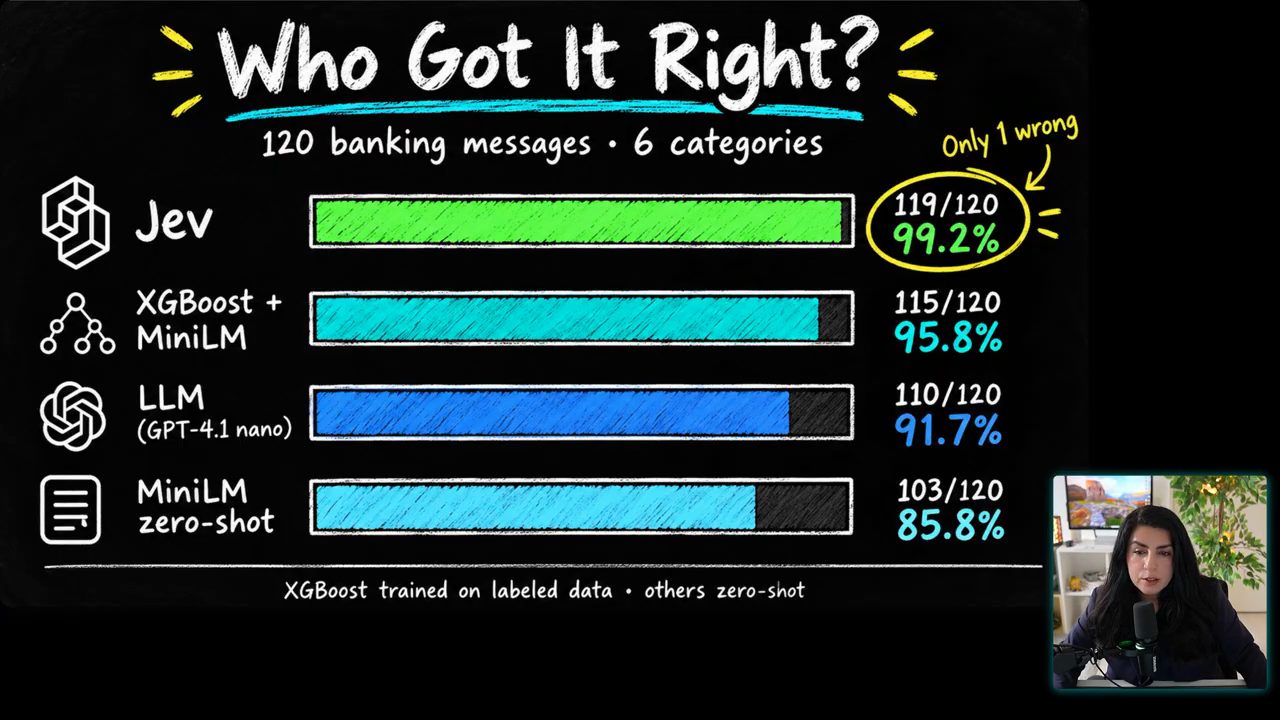
Thứ đầu tiên cần biết là accuracy. Theo số đo của Maryam Miradi (video đăng ngày 18/10/2026), trên 120 tin nhắn và sáu category: Jev đúng 119 trên 120, XGBoost (trên embedding MiniLM) đúng 115 trên 120, LLM đúng 110, còn BERT, tức MiniLM, đúng 103. Quy ra phần trăm, khoảng cách đi từ 99,2% xuống 85,8%.
4. Macro-F1, chi phí API và latency
Nhưng như ai làm machine learning cũng biết, Maryam nhắc, accuracy có thể gây hiểu lầm. Nên chị dùng thêm F1, một chỉ số kết hợp precision và recall. Chị nhắc lại cho ai không nhớ: precision là trong tất cả những gì model dự đoán thuộc một class, bao nhiêu phần là đúng; recall là trong tất cả những gì thật sự thuộc class đó, model tìm ra được bao nhiêu. Trên slide, công thức là F1 = 2 × (Precision × Recall) / (Precision + Recall), với Precision = TP / (TP + FP) và Recall = TP / (TP + FN).
Kết quả F1 gộp lại rất giống accuracy, nên theo Maryam ở đây không có thông tin gây hiểu lầm. Theo số đo của chị (video đăng ngày 18/10/2026), Macro-F1 trên sáu category là: Jev 0,992, XGBoost + MiniLM 0,957, LLM 0,913, MiniLM zero-shot khoảng 0,85. Jev và XGBoost vẫn đứng đầu. Slide ghi thêm rằng Macro-F1 quan trọng khi các class không đều nhau hoặc khi accuracy có thể đánh lừa.
Tiếp theo là chi phí, tính bằng chi phí API cho mỗi 1.000 dự đoán. Theo số đo của Maryam (video đăng ngày 18/10/2026), Jev rẻ hơn LLM: slide ghi 0,0212 đô cho Jev và 0,0300 đô cho GPT-4.1 nano. BERT và XGBoost không có phí API vì chạy trên CPU của máy, phần compute này chị không đo; slide nhấn mạnh "No API fee ≠ zero compute cost" (không có phí API không có nghĩa là compute miễn phí). Chị cũng lưu ý rằng với cả bốn cách, lúc nào ta cũng phải tốn công thu thập và làm sạch dữ liệu.
Rồi tới latency: ai nhanh nhất? Theo số đo của Maryam (median trên 120 tin nhắn, video đăng ngày 18/10/2026): BERT nhanh nhất với 3,4 mili giây, rồi XGBoost 5,3 mili giây, Jev 219 mili giây, và LLM 711 mili giây. Chị lưu ý mình không dùng LLM lớn nhất và mới nhất mà dùng GPT-4.1 nano. Model mới nhất của OpenAI, theo chị lúc quay video (18/10/2026), là GPT 6.1, và chị nói chắc chắn ta không cần tới nó để trả lời một câu hỏi đơn giản như thế này.
Chị còn xem phân vị 95% (P95) ở phía cao nhất, và thấy chênh lệch rõ hơn. Theo số đo của Maryam (video đăng ngày 18/10/2026), LLM lên tới 971 mili giây, còn Jev khoảng 400 mili giây (slide ghi 391,9), tức LLM chậm hơn khoảng hai lần. Nếu bạn có hàng triệu giao dịch, chị nói, khoản chênh này sẽ cộng dồn lại.
5. Điểm tổng hợp: không có người thắng chung cho mọi bối cảnh
Có ba thứ đo được, Maryam muốn gộp chúng thành một điểm tổng (overall score). Chị cho 40% trọng số cho F1 (chị gọi là weighted accuracy), 30% cho tốc độ và 30% cho chi phí API. Theo số đo và cách chấm của chị (video đăng ngày 18/10/2026), XGBoost có điểm tổng cao nhất, rồi tới MiniLM (BERT), rồi Jev, và cuối cùng là LLM, dù đang dùng một LLM rất nhỏ.
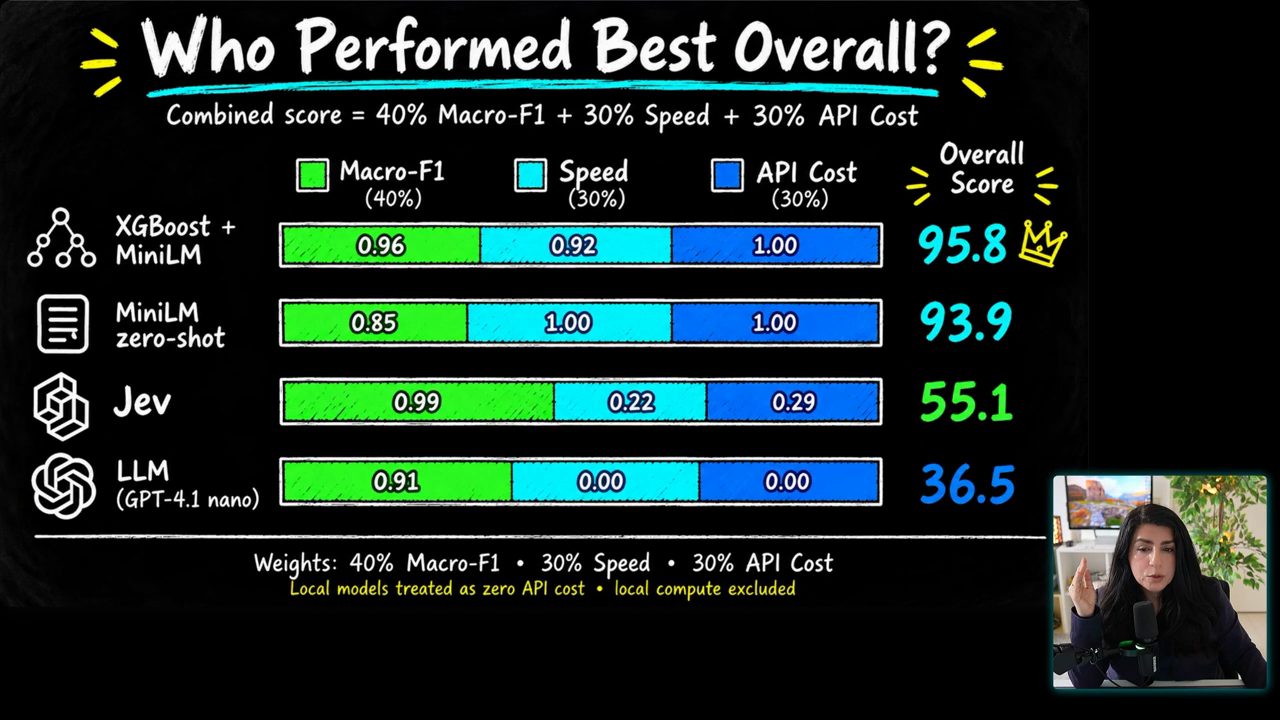
Nhưng các tỉ lệ phần trăm này mới là phần quan trọng, chị nói (video đăng ngày 18/10/2026). Ví dụ bạn có một team hỗ trợ khách hàng (support), bạn có thể dùng chính bộ trọng số trên cho accuracy, tốc độ và chi phí. Với chống gian lận và tuân thủ (fraud and compliance), accuracy phải thật cao, còn tốc độ và chi phí kém quan trọng hơn một chút. Với một app khối lượng lớn, chi phí là thứ quan trọng nhất. Còn khi ra quyết định theo thời gian thực (real-time), tốc độ là quan trọng nhất. Slide "Same Benchmark, Different Winners" ghi bốn bộ trọng số: Balanced Support 40/30/30, Fraud & Compliance 70/10/20, High-Volume App 30/20/50, Real-Time Decisions 30/60/10 (theo thứ tự Macro-F1, Speed, Cost), với dòng chữ nhỏ bên dưới "trọng số là một quyết định kinh doanh, không phải sự thật khoa học".
Vì vậy, theo Maryam (video đăng ngày 18/10/2026), không có cái gọi là người thắng chung cuộc, mà chỉ có người thắng cho bối cảnh nào, cho phòng ban nào. Cùng một dữ liệu, ta có thể có những ưu tiên khác nhau và những model tốt nhất khác nhau. Kết quả trên không phải là câu trả lời, mà là câu trả lời dựa trên những gì chị đã giả định.
Từ kết quả này, chị đoán người xem sẽ hỏi: vậy Jev có thật sự là model phù hợp nhất cho dự án của tôi không? Chị hứa sẽ chỉ ra chính xác khi nào dùng từng model. Nhưng để làm được, phải trả lời câu hỏi kia trước: tại sao Jev lại tồn tại, khi ta đã có LLM và LLM làm được tất cả những việc này?
6. Jev là gì: một decision model chấm điểm lựa chọn
Maryam mở bài blog của TypeSafe, công ty làm ra Jev, có tiêu đề "Introducing System One Models & Jev". TypeSafe gọi Jev là một model "System One". Chị dựa vào bài blog đó và những thông tin về model mà, nói thật, theo chị là "không nhiều lắm". Đây là những gì ta biết, theo video đăng ngày 18/10/2026.
Theo cách TypeSafe mô tả mà Maryam trình bày (video đăng ngày 18/10/2026), Jev là một decision model: nó chấm điểm các lựa chọn của bạn thay vì viết văn bản. Với một LLM sinh văn bản, bạn đưa vào tin nhắn và prompt, model viết ra từng token một; nó là một bộ dự đoán token kế tiếp. Nó trả về một nhãn, ta parse văn bản đó và có câu trả lời. Nhưng vì đó là văn bản tự do, nó có thể đi hoàn toàn chệch kịch bản (off script).
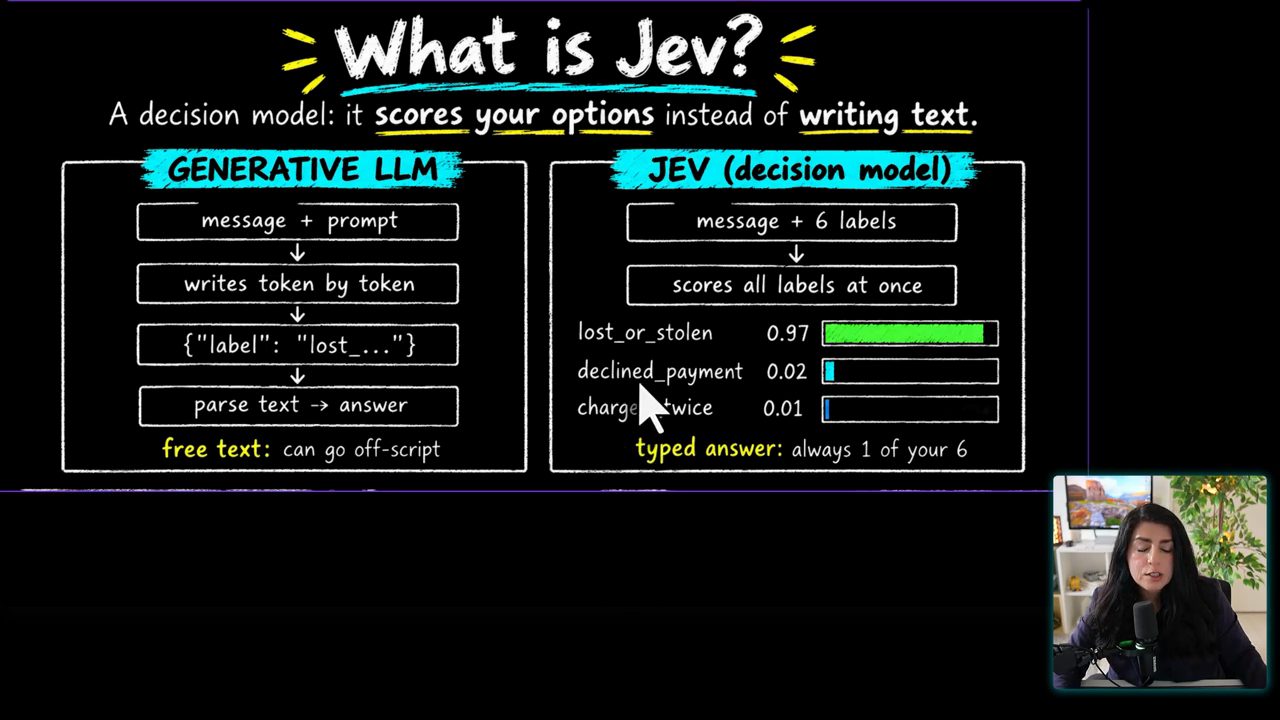
Với Jev (theo video đăng ngày 18/10/2026), ta đưa vào tin nhắn cộng sáu nhãn. Nó chấm điểm tất cả các nhãn một lượt. Trong ví dụ trên slide, nhãn "lost or stolen" (mất hoặc bị đánh cắp) có điểm cao nhất, và Jev cho kèm độ tin cậy cho cả "declined payment" lẫn "charged twice". Từ đó bạn có thể quyết định dựa trên một ngưỡng (threshold), một thứ cũng rất quan trọng trong classification; ai làm cũng biết là tinh chỉnh những ngưỡng đó có thể mất hàng tuần. Và Jev sẽ đưa ra một câu trả lời.
7. Bên trong Jev: TypeSafe công bố gì, và số đo nói gì
Nhìn bên dưới, theo những gì TypeSafe công bố (Maryam trình bày trong video đăng ngày 18/10/2026), Jev về cơ bản là "schema vào, xác suất ra", và có thể chạy theo các nhánh song song (parallel paths). Ví dụ đầu vào là câu "I think my statement has a fraudulent charge" (tôi nghĩ sao kê của tôi có một khoản bị gian lận). Rồi tới phần câu hỏi: sáu nhãn và các lựa chọn. Chính xác kiến trúc là gì thì ta không biết; nó vẫn là một hộp đen (black box). Đầu ra là lựa chọn, các xác suất và độ tin cậy.
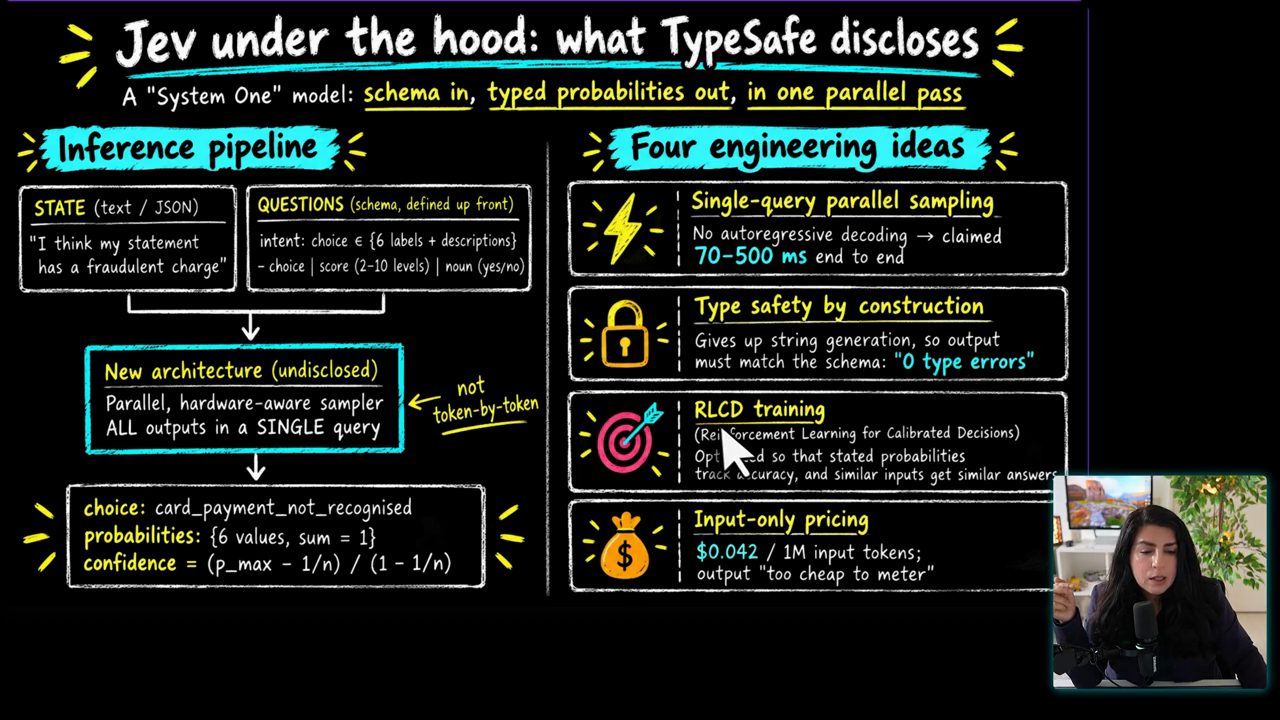
Theo TypeSafe (như Maryam thuật lại, video đăng ngày 18/10/2026), Jev dựa trên bốn ý tưởng kỹ thuật:
- Single-query parallel sampling: không phải autoregressive decoding. TypeSafe tuyên bố latency end-to-end từ 70 đến 500 mili giây (claim của TypeSafe, theo video đăng ngày 18/10/2026).
- Type safety by construction: đầu ra luôn khớp với schema. Slide ghi Jev bỏ hẳn việc sinh chuỗi, nên đầu ra buộc phải khớp schema, "0 type errors" (claim của TypeSafe, theo video đăng ngày 18/10/2026).
- RLCD training (Reinforcement Learning for Calibrated Decisions): dùng reinforcement learning để tối ưu sao cho xác suất được nêu khớp với độ chính xác, nghĩa là đầu vào giống nhau sẽ nhận đầu ra giống nhau. Maryam nói ta không có bảo đảm đó với LLM (theo chị, video đăng ngày 18/10/2026).
- Input-only pricing: chỉ tính giá phần đầu vào, ở mức khá thấp; còn đầu ra thì "quá rẻ để tính tiền" (too cheap to meter). Slide ghi 0,042 đô cho 1 triệu input token (theo video đăng ngày 18/10/2026).
Vậy là có một loạt claim của TypeSafe về latency, lỗi và đầu ra đã hiệu chỉnh (calibrated). Họ còn nói Jev nhanh hơn từ 40 đến 200 lần. Maryam đặt câu hỏi: nhanh hơn 40 đến 200 lần so với cái gì? LLM lớn nhất hay nhỏ hơn, cũ hơn hay mới hơn? Trong thí nghiệm của chị, vốn dùng một LLM rất nhỏ, Jev nhanh hơn khoảng ba lần (theo số đo của Maryam Miradi, video đăng ngày 18/10/2026).
Slide "Claim vs. evidence" đặt claim của TypeSafe cạnh số đo độc lập của Maryam trên BANKING77 với 120 tin nhắn (video đăng ngày 18/10/2026): latency 70 đến 500 mili giây thì chị đo được 220 mili giây median, 392 mili giây ở P95; "0 type errors" thì chị đo 0 trên 120 đầu ra không hợp lệ; xác suất đã hiệu chỉnh thì có dấu cảnh báo, vì lần sai duy nhất của Jev được đưa ra với độ tin cậy 1,00; "nhanh hơn 40 đến 200 lần so với frontier LLM" thì chưa kiểm, vì chị so với một LLM nhỏ (nhanh hơn 3,2 lần). Phần "Not disclosed" (chưa công bố) liệt kê: kiến trúc, số tham số, reward và thuật toán RLCD, dữ liệu train, chỉ số hiệu chỉnh (không có Brier score hay reliability curve), và giá có đang được trợ giá hay không.
8. Code: gọi Jev qua API
Maryam mở code của thí nghiệm (video đăng ngày 18/10/2026). Trong file config, Jev, LLM và MiniLM (BERT) đều nhận đúng sáu mô tả nhãn giống hệt nhau và không gì khác: không có ví dụ train nào. XGBoost thì khác, chị sẽ cho xem sau. Trên màn hình, file config định nghĩa sáu nhãn (transaction_charged_twice, card_payment_not_recognised, declined_card_payment, Refund_not_showing_up, transfer_not_received_by_recipient, lost_or_stolen_card), mỗi nhãn kèm một câu mô tả, và một câu chỉ dẫn chung "Classify the banking customer's message into exactly one support intent." Cũng trong file này, PER_CLASS_TEST = 20, tức 20 tin nhắn test cho mỗi nhãn, khớp với 120 tin nhắn của thí nghiệm.
Sang file models.py, phần gọi Jev (code trong video đăng ngày 18/10/2026): bạn khai báo kiểu câu hỏi cho API. Đây là một câu hỏi dạng "choice", và đây là các lựa chọn; Jev gửi lại lựa chọn. Trong request có model, state (văn bản tin nhắn) và câu hỏi. Chị đo độ trễ, và xin thêm phần usage, số input token và chi phí. Đây là phần thân request trên màn hình (comment trong code ghi schema lấy từ docs.typesafe.ai/api):
body = {
    "model": JEV_MODEL,
    "state": text,
    "questions": {
        "intent": {"type": "choice", "instructions": TASK_INSTRUCTION, "criteria": LABEL_DESCRIPTIONS}
    },
}
Trong code đó (video đăng ngày 18/10/2026), Maryam dùng một client httpx dùng lại kết nối (persistent client), để latency mỗi request phản ánh trạng thái chạy ổn định thay vì phải bắt tay TLS mới mỗi lần; client của LLM cũng làm như vậy. Nếu biến môi trường TYPESAFE_API_KEY chưa đặt, hàm trả về trạng thái "unavailable". Sau khi gọi, code đọc câu trả lời trong answers, đọc input_tokens trong usage, và tính chi phí theo giá mỗi triệu input token. Theo Maryam, toàn bộ phần dự đoán qua API chỉ có cấu trúc request và những gì trả về như vậy, khá đơn giản.
9. LLM làm classifier: GPT-4.1 nano với structured output
Thí nghiệm cũng dùng LLM (video đăng ngày 18/10/2026). Dù phần lớn người xem đã biết LLM chạy thế nào bên dưới, Maryam vẫn lướt qua nhanh. Cách này là sinh câu trả lời, và ta chỉ đưa cho nó một schema. Thông thường có system prompt và user prompt, model sinh từng token, ta đặt temperature, dùng structured output, rồi parse kết quả thành JSON để có dự đoán.
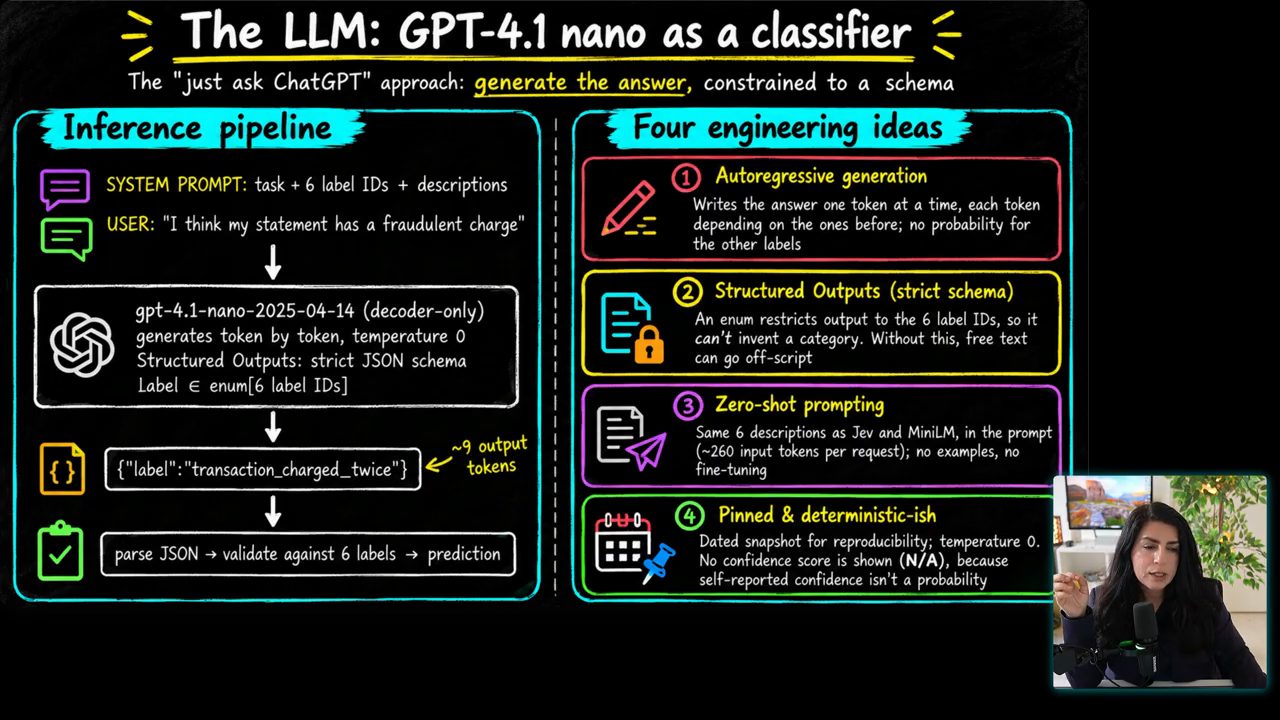
Bốn ý tưởng kỹ thuật phía sau, theo Maryam (video đăng ngày 18/10/2026):
- Autoregressive generation: theo Maryam (video đăng ngày 18/10/2026), LLM viết câu trả lời từng token, mỗi token phụ thuộc vào các token trước đó, và không có xác suất nào cho các nhãn còn lại.
- Structured output với schema nghiêm ngặt: ta đưa schema cho nó, nhưng theo chị (video đăng ngày 18/10/2026) LLM lúc nào cũng có thể chệch kịch bản. Slide ghi một enum giới hạn đầu ra trong sáu ID nhãn để nó không bịa ra category; không có enum thì văn bản tự do có thể chệch hướng.
- Zero-shot prompting: cùng sáu mô tả mà Jev và BERT nhận được. Mỗi request khoảng 260 token đầu vào (theo số đo của Maryam, video đăng ngày 18/10/2026), và bạn có thể giới hạn con số đó.
- Trong thí nghiệm (video đăng ngày 18/10/2026), không có điểm tin cậy nào được hiển thị (N/A), vì độ tin cậy do chính model tự khai không thật sự là một xác suất. Slide ghi thêm model được ghim theo snapshot có ngày để tái lập kết quả, temperature 0.
10. Decoder-only và encoder-only: người viết và người đọc
Khi nói về LLM, Maryam nhận xét, ta luôn nghe tới decoder và encoder. Chị giải thích lại cho rõ, vì nó khá đơn giản (video đăng ngày 18/10/2026). Loại thứ nhất là decoder-only, "người viết": họ GPT, tức LLM. Ở đây attention là causal, chỉ nhìn ngược về trước. Với câu "my card was stolen" (thẻ của tôi bị đánh cắp), mỗi token chỉ thấy các token trước nó. Model được train để dự đoán token kế tiếp, và đầu ra là token kế tiếp.
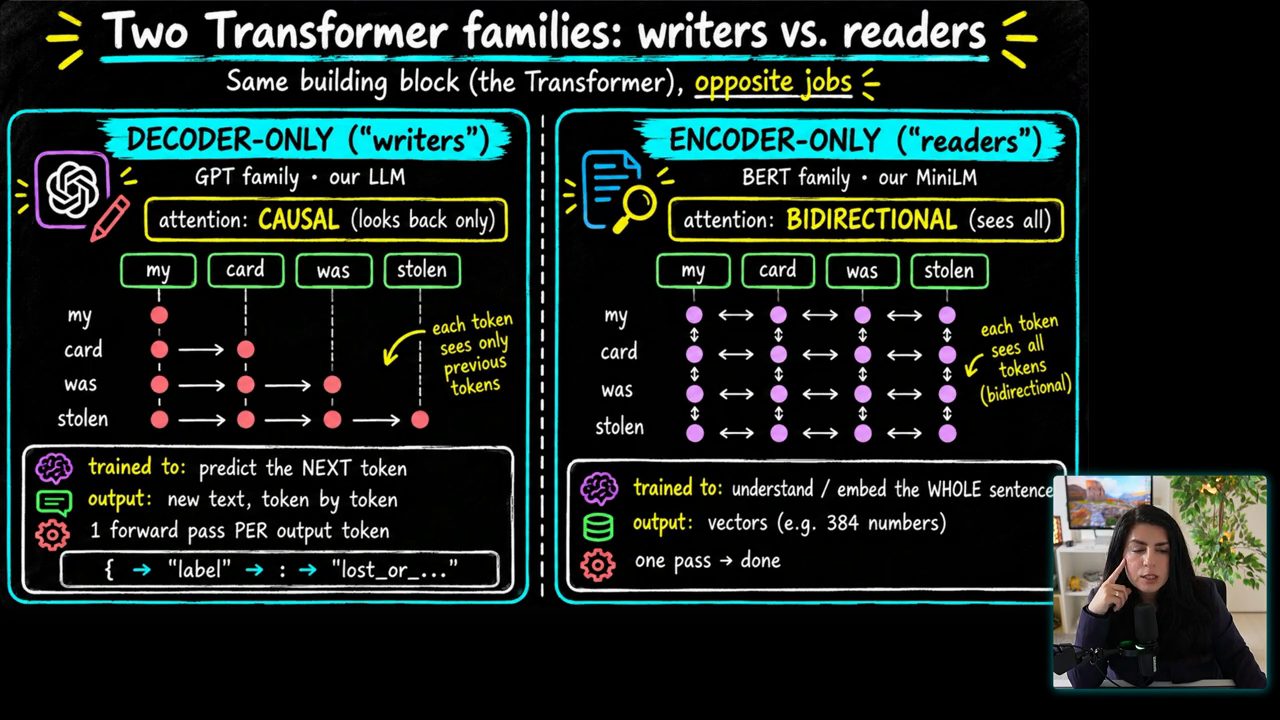
Loại encoder thì hai chiều (bidirectional). Nó được train để hiểu và embed cả câu. Đầu ra phần lớn thời gian là một vector, và làm xong trong một lượt (one pass).
Tóm lại, theo bảng so sánh của Maryam: decoder-only là GPT, Claude, Llama; chúng sinh được văn bản, phân loại bằng cách viết nhãn ra thành chữ, có hàng tỉ tham số, latency cao. Với BERT, đầu ra không phải văn bản mà là vector: embed, đi qua một lượt, hàng triệu tham số, và latency thấp hơn. Bảng trên màn hình ghi latency đo được là 711,5 mili giây (hosted) cho LLM và 3,4 mili giây (local) cho MiniLM 22,7 triệu tham số, chạy trên CPU laptop (theo số đo của Maryam, video đăng ngày 18/10/2026).
Áp vào thí nghiệm này: LLM là decoder-only; BERT là encoder-only; XGBoost dùng encoder chỉ để đọc văn bản. Còn Jev, theo Maryam, ta không biết chính thức: đó là một kiến trúc mới chưa công bố, nhưng hành xử như một bộ chấm điểm, trả xác suất cho mọi nhãn trong một lần gọi, không viết từng token (theo những gì công bố tính đến video đăng ngày 18/10/2026).
11. Transformer, code gọi LLM và mẹo LRU cache
Maryam đi tiếp vào Transformer, thứ nằm bên dưới cả encoder lẫn decoder. Ý tưởng: mỗi từ nhìn vào mọi từ khác để hiểu nghĩa. Đó là điều xảy ra trong Transformer. Pipeline như sau: ta đưa câu vào, tokenize nó, tạo embedding (mỗi token thành một vector, kèm thông tin vị trí), rồi cho qua các transformer layer. Số layer, theo slide (video đăng ngày 18/10/2026), là 6 với MiniLM (một BERT nhỏ hơn) và 12 với BERT-base. Trong mỗi layer có self-attention để các token trao đổi thông tin, và feed-forward để xử lý từng token, kèm residual connection và normalization. Các contextual vector ở cuối được dùng để phân loại, để embed, hoặc để dự đoán token kế tiếp.
Trong code hàm predict cho LLM, tất nhiên cần key API, của OpenAI, Anthropic hay LLM nào bạn đang dùng. Bạn phải bảo đảm đầu ra theo đúng schema bạn đưa, tức là có cấu trúc, vì bản chất LLM không có cấu trúc đó. Maryam nói chị luôn dùng Pydantic AI cho việc này, vì theo chị (video đăng ngày 18/10/2026) nó rất tốt trong việc giữ cho LLM có cấu trúc hơn một chút. Rồi tới đoạn quan trọng: ép LLM trả lời theo một định dạng cụ thể, và trả câu trả lời về cho mình. Trên màn hình, hàm gọi chat completions với model, temperature=0, max_tokens=20, response_format và hai message system, user, rồi ghi lại usage của prompt token và completion token để tính chi phí.
Và đây là một "mẹo vàng" (golden tip) của chị: dùng LRU cache. Model rất chậm khi tải. Ví dụ, theo số đo của Maryam (video đăng ngày 18/10/2026), tải BERT trên máy chị mất khoảng 14 giây, còn một lần dự đoán chỉ mất khoảng 3 mili giây. Nên nếu bạn tải model bên trong hàm predict, bạn chậm đi khoảng 4.000 lần; với LLM còn chậm hơn nữa.
Vì vậy bạn dùng LRU cache: lần gọi đầu tải model, mọi lần gọi sau lấy ngay model đã tải. Chị cũng dùng nó để embed sáu mô tả category đúng một lần, thay vì embed lại với mỗi tin nhắn. Theo chị, đó là một mẹo rất nhỏ nhưng làm cả dự án tối ưu hơn một chút.
12. MiniLM: encoder họ BERT dùng zero-shot
Theo Maryam (video đăng ngày 18/10/2026), với họ BERT không có sinh văn bản và không train gì trên bài toán của ta: chỉ embed, rồi đo khoảng cách về nghĩa. Một câu được đưa qua mạng neural, dùng mean pooling rồi chuẩn hoá L2. Khi đã có vector của tin nhắn, ta dùng cosine similarity với sáu mô tả nhãn để xem cái nào giống nhất, và đó là nhãn được chọn.
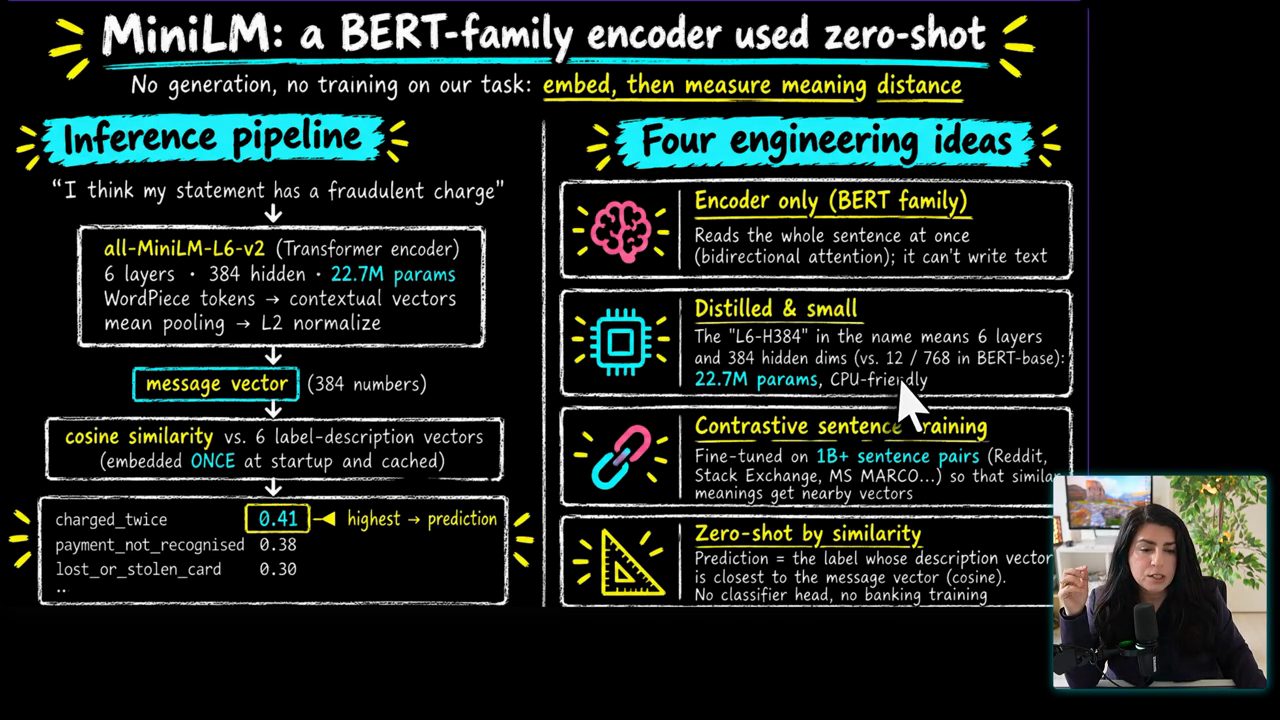
Bốn ý tưởng kỹ thuật của MiniLM, theo Maryam (video đăng ngày 18/10/2026):
- Encoder only: theo slide (video đăng ngày 18/10/2026), MiniLM đọc cả câu cùng lúc với attention hai chiều; nó không viết được văn bản.
- Distilled và nhỏ: theo Maryam (video đăng ngày 18/10/2026), MiniLM được chưng cất (distilled) từ mô hình lớn hơn, nên latency rất thấp. Slide giải thích "L6-H384" trong tên nghĩa là 6 layer và 384 chiều ẩn (so với 12 và 768 của BERT-base), 22,7 triệu tham số, chạy tốt trên CPU.
- Contrastive sentence training: được fine-tune trên rất nhiều cặp câu, từ Reddit, Stack Exchange và các nguồn khác (slide ghi hơn 1 tỉ cặp câu, có cả MS MARCO), nên hiểu nghĩa câu rất tốt (theo trang model trên Hugging Face, đọc ngày 23/10/2026, dữ liệu fine-tune là hơn 1 tỉ cặp câu).
- Zero-shot by similarity: theo slide (video đăng ngày 18/10/2026), dự đoán là nhãn có vector mô tả gần nhất với vector tin nhắn, nên không cần ví dụ nào, không có classifier head, không train gì về ngân hàng.
Về code (video đăng ngày 18/10/2026), Maryam mở hàm predict cho MiniLM và nói đây về cơ bản là toàn bộ classifier: một phép đo xem tin nhắn gần nhãn nào, và dựa trên đó đưa ra dự đoán. Trên màn hình, hàm embed tin nhắn với normalize_embeddings=True, nhân với ma trận vector nhãn (vì các vector đã chuẩn hoá nên tích vô hướng chính là cosine similarity, như comment trong code ghi), rồi lấy nhãn có điểm cao nhất.
13. XGBoost trên embedding MiniLM: classifier có giám sát
Tiếp theo là XGBoost, một classifier rất nổi tiếng. Theo Maryam (video đăng ngày 18/10/2026), ngoài thực tế nó rất thường vượt cả những mạng neural TensorFlow tốt nhất, vì chị đã áp dụng nó trong rất nhiều tình huống phức tạp. Nó là một classifier rất tốt, nhưng chị nhắc: nó là model machine learning, nên cần ví dụ có nhãn. Và nó cũng cần một kiểu embedding, vì model machine learning không nhận văn bản trực tiếp; lúc nào cũng phải dịch văn bản thành vector.
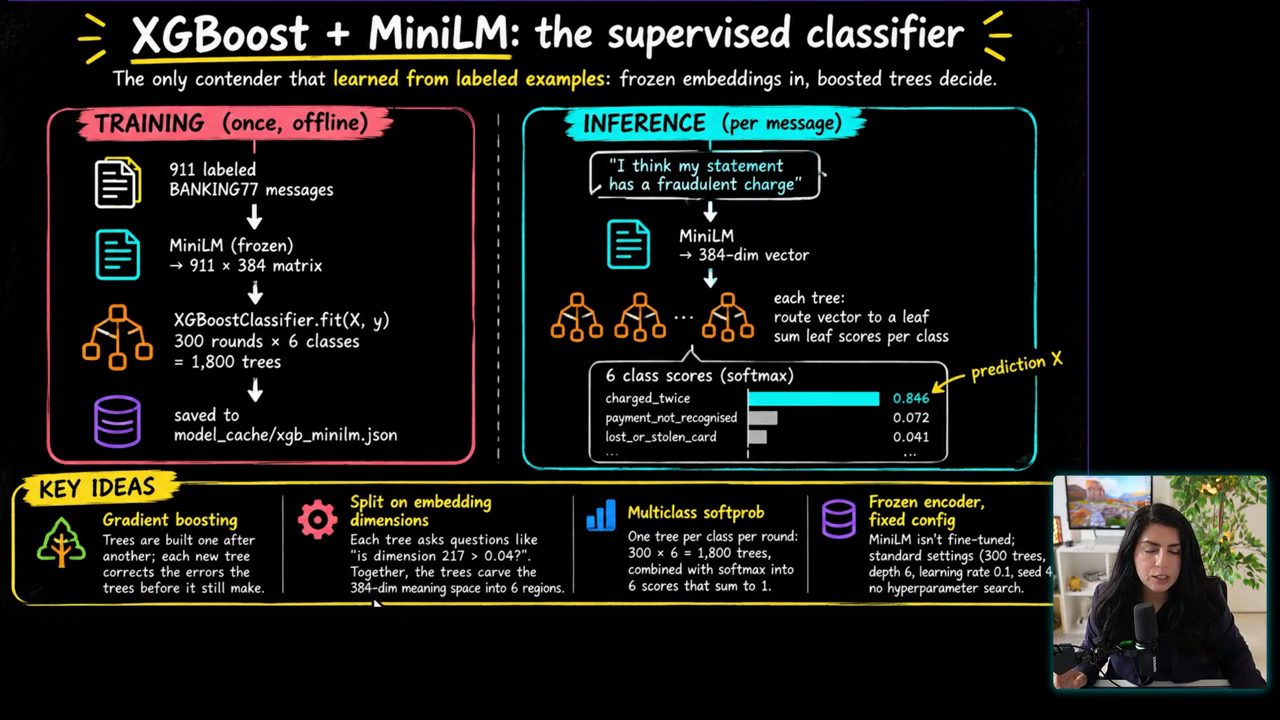
Cụ thể, trong thí nghiệm (video đăng ngày 18/10/2026), chị dùng 911 tin nhắn có nhãn từ BANKING77, đưa qua MiniLM đóng băng (frozen) để ra ma trận, đưa cho XGBoost với khoảng 300 vòng, tức 1.800 cây, rồi lưu thành một model. Lúc inference, tức lúc test model, ta đưa một câu vào, cho qua embedding để thành vector, cho vector đó đi qua tất cả các cây, lấy câu trả lời từ chúng, gộp lại thành một câu trả lời, và ra dự đoán kèm xác suất.
Các ý tưởng chính, theo slide (video đăng ngày 18/10/2026):
- Gradient boosting: theo Maryam (video đăng ngày 18/10/2026), các cây được dựng lần lượt, cây mới sửa lỗi của cây trước.
- Chia trên các chiều embedding: theo slide (video đăng ngày 18/10/2026), mỗi cây đặt câu hỏi (slide ví dụ "chiều 217 có lớn hơn 0,04 không?"), và cùng nhau các cây cắt không gian 384 chiều thành sáu vùng.
- Multiclass softprob: trong thí nghiệm (video đăng ngày 18/10/2026), 1.800 cây gộp lại cho ra sáu điểm có tổng bằng 1.
- Encoder đóng băng: trong thí nghiệm (video đăng ngày 18/10/2026), MiniLM không được fine-tune, chỉ được dùng để lấy ra các con số. Slide ghi cấu hình chuẩn (300 cây, độ sâu 6, learning rate 0,1) và không tìm hyperparameter.
Phần train, theo Maryam (video đăng ngày 18/10/2026), cũng khá đơn giản: lấy dữ liệu train, embed, train dựa trên các nhãn bạn có. Bạn dựng một XGBoost classifier với các tham số như số estimator; đây là thứ gọi là hyperparameter tuning trong machine learning, nên bạn phải tinh chỉnh chúng để có phiên bản tốt nhất trước khi dựng bất kỳ model hữu ích nào. Sau đó fit trên dữ liệu, và nó cho ra dự đoán. Sau khi fit, ta dùng model để dự đoán kèm xác suất; vì có nhiều xác suất, ta chọn xác suất cao nhất và trả về dự đoán.
14. Nghiên cứu độc lập từ University of Bonn
Maryam nhắc rằng thí nghiệm của chị chỉ trên một bộ dữ liệu cụ thể là BANKING77. Chị tìm được một bài báo mới công bố gần lúc quay (bài trên arXiv đề ngày 29/09/2026, video đăng ngày 18/10/2026), trong đó các nhà nghiên cứu làm thí nghiệm lớn hơn nhiều với Jev. Bài có tên "Evaluating and Benchmarking the System One Model Jev", của Deußer, Sparrenberg và Sifa ở University of Bonn.
Chị nói nhờ bài này ta biết được chuyện gì xảy ra với 150.000 request. Slide và abstract của bài ghi con số 346.009 request trên 37 dataset, tổng chi phí API 9,15 đô (abstract ghi "dưới 10 đô", đọc ngày 23/10/2026), với đúng phiên bản jev-1.13.0 mà chị đã test. Các nhà nghiên cứu chọn Qwen và Gemma để so (slide ghi Qwen3.8-27B và Gemma-4-E4B). Maryam nói latency tối thiểu là khoảng 0,36 giây; slide ghi 0,36 giây là latency trung bình mỗi request. Tổng chi phí API, tất nhiên, cũng thấp. Slide còn ghi Jev thắng Qwen3.8-27B trên 27 trong 37 dataset và thắng Gemma-4-E4B trên cả 37 (theo bài báo đề ngày 29/09/2026).
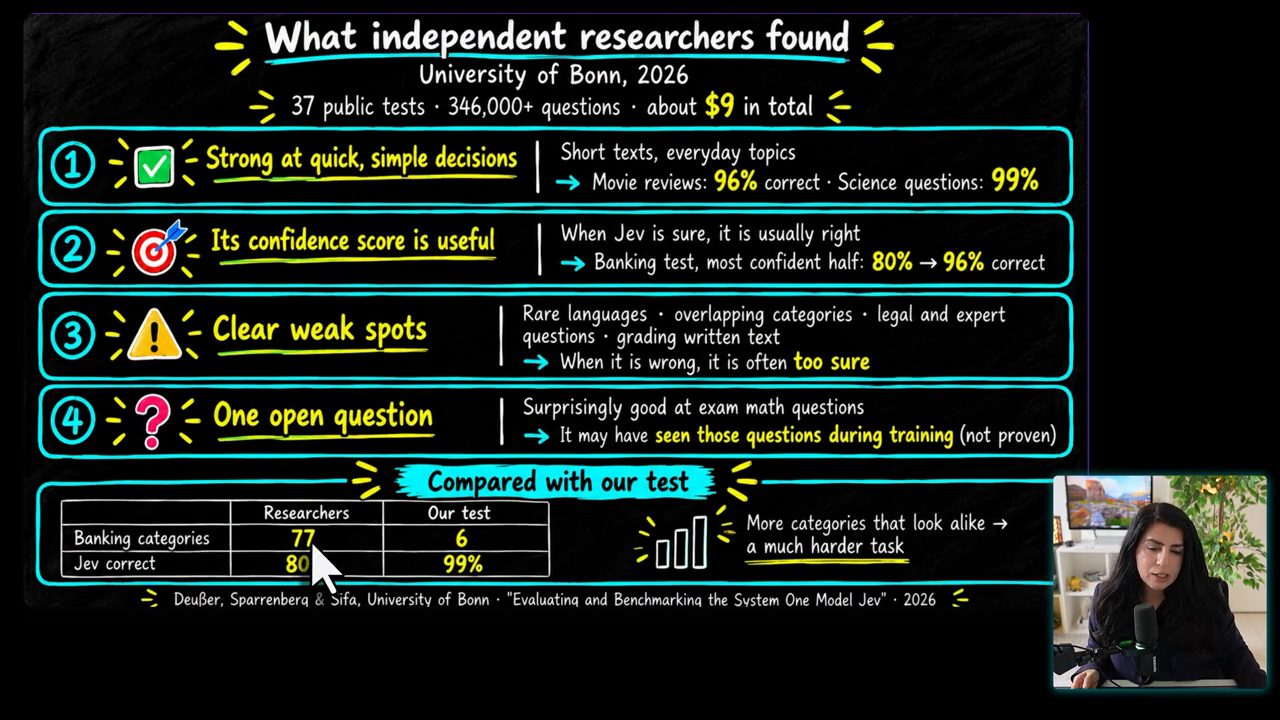
Kết luận của họ, theo lời Maryam thuật lại (video đăng ngày 18/10/2026):
- Jev mạnh ở các quyết định nhanh, đơn giản, như đánh giá phim hay câu hỏi khoa học. Slide ghi 96% đúng với đánh giá phim, 99% với câu hỏi khoa học (theo bài báo đề ngày 29/09/2026).
- Điểm tin cậy của nó hữu ích: trên dữ liệu ngân hàng, những câu Jev tự tin nhất thì 96% là đúng. Slide ghi nửa tự tin nhất tăng từ 80% lên 96% đúng (theo bài báo đề ngày 29/09/2026).
- Theo bài báo (đề ngày 29/09/2026), nó có những điểm yếu rõ: ngôn ngữ hiếm, các category chồng lấn nhau, câu hỏi pháp lý và chuyên môn (slide thêm cả chấm điểm bài viết). Khi sai, nó thường quá chắc chắn.
- Còn một câu hỏi mở (theo bài báo đề ngày 29/09/2026): Jev giỏi bất ngờ với câu hỏi toán trong đề thi. Slide ghi có thể nó đã thấy những câu đó lúc train, nhưng chưa chứng minh được.
Trong bài báo (đề ngày 29/09/2026), các nhà nghiên cứu dùng đủ 77 category ngân hàng, và Jev đúng 80%. Maryam dùng sáu category và đạt 99% (số đo của chị, video đăng ngày 18/10/2026), vì bài toán của chị nhỏ hơn nhiều. Slide ghi: nhiều category trông giống nhau hơn thì bài toán khó hơn hẳn. Đó là lý do, theo chị, use case và cách bạn áp dụng model rất quan trọng.
15. Khi nào dùng Jev, LLM, họ BERT hay XGBoost
Gộp tất cả lại, những gì đã trải nghiệm và những gì chị giải thích về cách từng model chạy bên dưới, Maryam đi vào phần chọn model nào lúc nào, và hứa cuối cùng sẽ đưa một ma trận, một cây quyết định. Các khuyến nghị dưới đây là của Maryam (video đăng ngày 18/10/2026).
Jev: khi bạn cần quyết định mà không cần sinh văn bản. Hợp nhất cho classification, routing, moderation, và chọn giữa các lựa chọn được cung cấp động (dynamically supplied options). Nó hữu ích đặc biệt khi bạn không có dữ liệu train có nhãn. Chị nhắc dữ liệu sạch vẫn là một trong những vấn đề lớn nhất của cả ngành data science, machine learning và AI. Use case điển hình: phân loại intent, định tuyến ticket, quyết định moderation. Chị lưu ý: xác suất của nó vẫn cần kiểm tra hiệu chỉnh, chất lượng phụ thuộc vào cách bạn mô tả các lựa chọn, và với API hosted thì còn có latency mạng, nên hãy cẩn thận chỗ đó (theo Maryam, video đăng ngày 18/10/2026).
LLM: khi việc sinh hoặc diễn giải ngôn ngữ phức tạp là một phần công việc. Hợp cho hội thoại hỗ trợ khách hàng, giải thích, phân tích tài liệu, và các trường hợp cần làm theo chỉ dẫn linh hoạt, nhiều bước. Hữu ích khi công việc gồm cả diễn giải lẫn hiểu văn bản. Cần để ý: latency, chi phí token, và kiểm tra đầu ra; với routing đơn giản thì đó là chi phí thừa, đừng dùng (theo Maryam, video đăng ngày 18/10/2026).
Họ BERT (MiniLM): cho semantic search, tìm các ticket hỗ trợ giống nhau, phát hiện trùng lặp, retrieval, và phân loại dựa trên embedding. Tóm lại là khi bạn so sánh nghĩa thay vì sinh văn bản. Cần để ý: similarity không giống xác suất, và những khác biệt tinh tế giữa các mô tả category có thể gây rất nhiều vấn đề (theo Maryam, video đăng ngày 18/10/2026).
XGBoost, một phương pháp machine learning: khi bạn có dữ liệu có nhãn. Hợp cho các intent ngân hàng ổn định, phân loại liên quan gian lận, định tuyến ticket, và mọi bài toán có những mẫu dự đoán lặp lại. Trong ví dụ của chị, XGBoost được train trên embedding MiniLM và cho latency rất thấp, gần như tức thì; slide ghi 95,8% accuracy với 5,3 mili giây median trên CPU local (theo số đo của Maryam, video đăng ngày 18/10/2026). Cần để ý: phải train, data drift, bảo trì, thay đổi category. Theo chị, nó ổn định, chắc chắn, nhanh, nhưng đồng thời dữ liệu có thể gây nhiều vấn đề ở đó.
16. Ma trận quyết định: hệ thống của bạn phải tạo ra cái gì
Và giờ tới ma trận quyết định: nên dùng model AI nào, khi nào. Câu hỏi gốc là: hệ thống của bạn phải tạo ra cái gì? Văn bản, một quyết định, hay một điểm similarity?
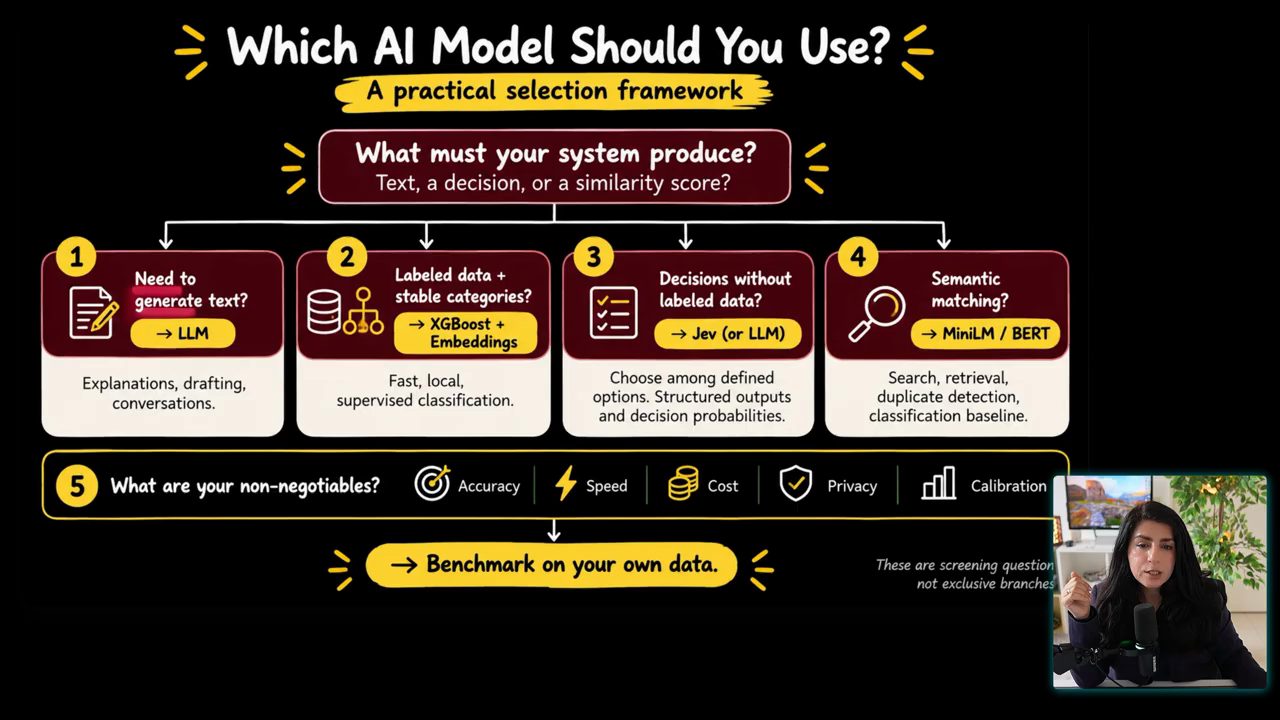
Theo khung của Maryam (video đăng ngày 18/10/2026): nếu bạn cần văn bản, dùng LLM. Nếu là dữ liệu có nhãn và category ổn định: nên là XGBoost cộng embedding, tức một cách dịch văn bản sang số. Nếu chỉ là quyết định mà bạn không có dữ liệu nào, Jev có thể rất hợp; tất nhiên LLM cũng được, và sẽ dễ hơn khi dữ liệu của bạn là structured output. Rồi tới khớp ngữ nghĩa (semantic matching): nếu bạn làm search và retrieval, hãy đi theo BERT và họ BERT.
Sau đó, theo Maryam (video đăng ngày 18/10/2026), là các yêu cầu không thể nhân nhượng (non-negotiables): bạn cần accuracy ra sao, tốc độ ra sao, chi phí ra sao, có cần quyền riêng tư không, có cần hiệu chỉnh xác suất không. Và điều thật sự quan trọng, chị nhấn mạnh: hãy benchmark những thứ này trên dữ liệu của chính bạn.
Maryam kết lại: giờ bạn đã biết chọn model nào cho tình huống nào, nhưng tự một model không thể mang lại một hệ thống production thật. Thứ bạn cần là một kiến trúc rất tốt. Chị có một kiến trúc 14 lớp cho hệ thống agentic end-to-end và giới thiệu một video khác của chị giải thích kiến trúc đó bằng ví dụ thực tế.
Nguồn và liên kết 10 nguồn
- Tên gốc: I Made Jev, LLMs, BERT & XGBoost Solve the Same Problem (RAW RESULTS)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=KHkSxPUOLn4 youtube.com
- Kênh YouTube Dr. Maryam Miradi (Maryam Miradi): youtube.com/channel/UCIQzTfzErmrixae2oFqRxyg youtube.com
- Bài blog "Introducing System One Models & Jev" của TypeSafe AI (đọc ngày 23/10/2026): typesafe.ai/blog/introducing-system-one-models-and-jev typesafe.ai
- Tài liệu API System One của TypeSafe, trang mà comment trong code của Maryam trỏ tới (đọc ngày 23/10/2026): docs.typesafe.ai/api docs.typesafe.ai
- Deußer, Sparrenberg, Sifa, "Evaluating and Benchmarking the System One Model Jev", arXiv 2609.37647, đề ngày 29/09/2026 (đọc ngày 23/10/2026): arxiv.org/abs/2609.37647 arxiv.org
- Bộ dữ liệu BANKING77 trên Hugging Face (đọc ngày 23/10/2026): huggingface.co/datasets/PolyAI/banking77 huggingface.co
- Model all-MiniLM-L6-v2 trên Hugging Face (đọc ngày 23/10/2026): huggingface.co/sentence-transformers/all-MiniLM-L6-v2 huggingface.co
- Tài liệu XGBoost (đọc ngày 23/10/2026): xgboost.readthedocs.io xgboost.readthedocs.io
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Tự fine-tune embedding model không khó như bạn nghĩ
Muhammad Farooq · Prompt Engineering · 13 min
Fine-tune EmbeddingGemma 2 bằng LoRA và Unsloth trên dữ liệu riêng: cặp câu hỏi và đoạn văn, in-batch negatives, chia test theo nguồn, đo cái giá.
Sáu project AI sát thực tế nên có trên resume AI engineer
Aishwarya Naresh Reganti · Aish Reganti · 21 min
Sáu project AI engineer theo độ khó tăng dần, từ document pipeline, enterprise search, voice, model tự host tới agent, mỗi project có dataset, eval và cách kể.