Sáu project AI sát thực tế nên có trên resume AI engineer
Sáu project AI engineer theo độ khó tăng dần, từ document pipeline, enterprise search, voice, model tự host tới agent, mỗi project có dataset, eval và cách kể.
✓ Đã duyệt độc lập · cập nhật 25/10/2026 · 21 min
1. Keyword trên resume không còn đủ
Aishwarya mở đầu bằng một nhận định về thị trường tuyển AI engineer: nếu bạn đang ứng tuyển các vị trí AI engineering, thì việc liệt kê một loạt keyword như RAG, agent hay MCP trên resume, cộng thêm vài project khởi đầu, đáng tiếc là không đủ để được nhận (theo Aishwarya, video đăng ngày 08/10/2026). Muốn nổi bật trên thị trường việc làm lúc quay video, các project của bạn phải cho thấy những quyết định bạn đã đưa ra, những trade-off về kiến trúc, và việc thứ bạn build có giống với thứ các công ty đang thực sự ship hay không.
Chị kể chị đã phỏng vấn hơn 300 AI engineer, trong thời gian làm tech lead ở AWS và cả cho startup riêng của chị (theo lời chị trong video đăng ngày 08/10/2026). Sáu project trong video là những project chị ước mình đã được thấy trên resume của ứng viên.
Chị nhấn mạnh đây không phải thêm một danh sách ngẫu nhiên (video đăng ngày 08/10/2026). Chị sẽ chia sẻ sáu project sát với nhu cầu của ngành, xếp theo độ khó tăng dần; với mỗi project, chị đưa ra các dataset công khai, có thật, để bắt đầu build; giải thích nên làm nổi bật điều gì trên resume; và nói luôn những câu người phỏng vấn có thể hỏi. Mục tiêu là để người xem chuẩn bị đủ và tự tin bước vào nghề AI engineering.
2. Project 1: Document intelligence pipeline và dataset CUAD
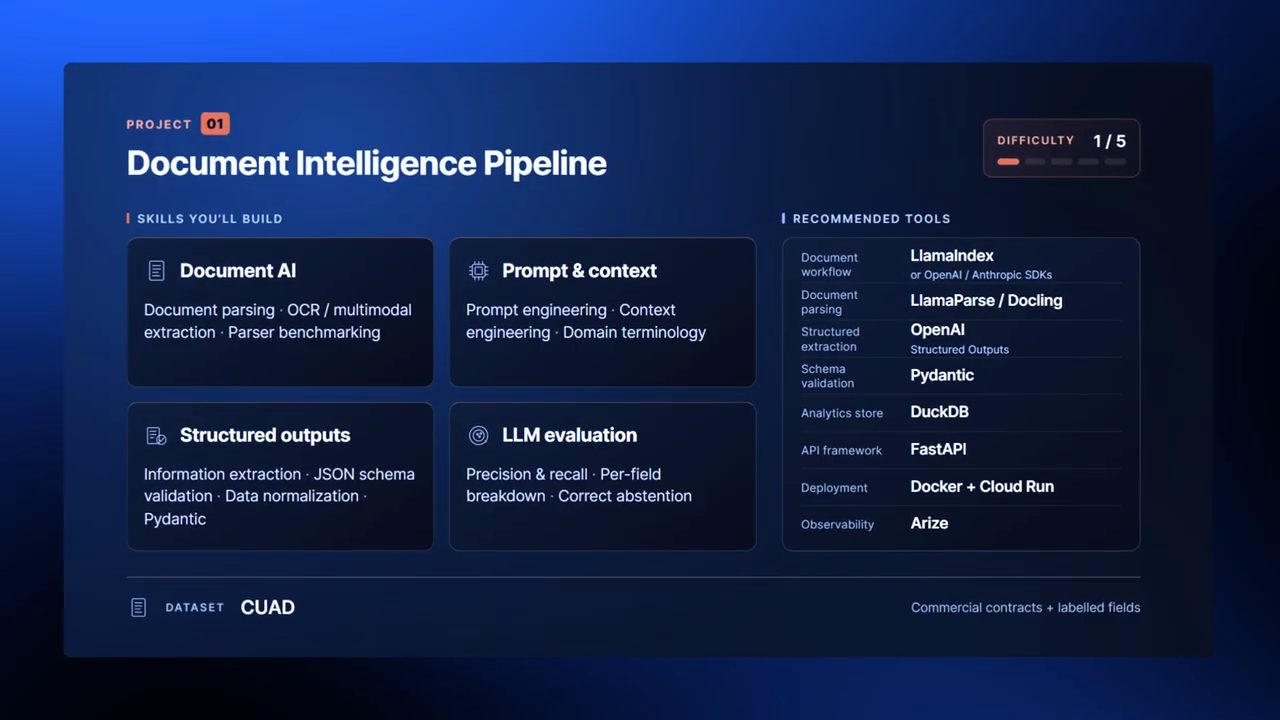
Project thứ nhất là một document intelligence pipeline. Aishwarya dẫn một con số của Gartner: khoảng 70 đến 90% toàn bộ dữ liệu của một công ty là dữ liệu phi cấu trúc (unstructured), tức là nó nằm trong hợp đồng, hồ sơ bồi thường (claims), hoá đơn và đủ loại tài liệu phi cấu trúc khác, và tất cả phải được xử lý thì công ty mới dùng được (con số Gartner do Aishwarya dẫn trong video đăng ngày 08/10/2026; trên màn hình là một trang tổng kết Gartner Data & Analytics Summit 2026 London).
Thứ bạn build trong project này nhận các tài liệu lộn xộn ở một đầu và trả ra các bản ghi có cấu trúc, sạch sẽ ở đầu kia, theo một định dạng như JSON. Bạn có thể làm với bất kỳ bộ tài liệu nào mình có, nhưng Aishwarya rất khuyên dùng dataset CUAD (chị đánh vần C-U-A-D). Theo chị (video đăng ngày 08/10/2026), có thể bắt đầu ngay với nó vì đây là một tập hợp hợp đồng thương mại đi kèm label, nhờ đó bạn đo được mình đang làm tốt tới đâu.
3. Extraction: OCR-style model hay multimodal model
Aishwarya đi qua các bước chính khi build (video đăng ngày 08/10/2026). Bước thứ nhất là extraction, tức là lấy đúng các field ra khỏi tài liệu. Chị khuyên thử nghiệm vài parser và xem cái nào trụ được. Có các model kiểu OCR (chị giải thích là object character recognition), và có các model multimodal mới hơn, nhận thẳng tài liệu và trả ra bản ghi có cấu trúc. Trên màn hình, nhóm "OCR-style models" liệt kê Amazon Textract, Azure Document Intelligence, Google Document AI và Mistral OCR.
Theo Aishwarya (video đăng ngày 08/10/2026), hai nhóm này hoạt động khác nhau và chi phí cũng khác nhau. Vì vậy bạn phải ra quyết định cân giữa hiệu năng và chi phí, và phải giải thích được vì sao mình chọn như vậy.
Nếu bạn đi theo hướng multimodal model, bạn còn học được cách prompt chúng cho tốt, vì rất nhiều tài liệu không viết theo một khuôn chính thức nào. Ví dụ, cùng một field có thể xuất hiện với năm cách diễn đạt khác nhau trong năm tài liệu khác nhau, và prompt của bạn phải sống sót qua tất cả sự đa dạng đó. Nhiều tài liệu còn mang từ vựng riêng của chúng, nên bạn cần kỹ năng context engineering tốt để đảm bảo mọi thuật ngữ đó được hiểu đúng trong giai đoạn parsing, hay giai đoạn extraction (theo Aishwarya, video đăng ngày 08/10/2026).
4. Schema validation, precision, recall và cách kể project 1
Bước cuối của pipeline là schema validation: kiểm tra xem các field trả về có đúng và đúng hình dạng không, và đảm bảo model không bịa (hallucinate) ra thứ gì. Aishwarya nhắc rằng mọi quyết định chị vừa kể, tức là dùng parser nào, model nào, gửi bao nhiêu context, đặt validation ở đâu, đều phải được đưa ra qua quá trình eval (evaluation). Chuyện eval sẽ xuất hiện ở mọi project trong video, vì xác định cần đo cái gì là một kỹ năng riêng, và theo chị đó là một trong những kỹ năng được săn đón nhất của nghề AI engineering (theo Aishwarya, video đăng ngày 08/10/2026).
Với project này, bạn lấy một phần nhỏ của dataset, lấy label cho phần đó, tức là các output đúng hay các field đúng, chính là output lý tưởng của bước parsing. Rồi bạn nhìn hai metric: precision và recall. Theo Aishwarya (video đăng ngày 08/10/2026), đây là hai trong số các metric được dùng phổ biến nhất cho kiểu use case này.
Precision là: trong các field đã được parse ra, bao nhiêu field đúng. Recall là: trong các field có trong tài liệu, hệ thống của bạn parse được bao nhiêu. Bạn có thể chia nhỏ kết quả theo loại field, theo category và những cách tương tự. Aishwarya khuyên dành thời gian ở bước này, dùng eval để hiểu category hay field nào khó parse hơn và bạn rút ra được những insight gì, vì đó chính là loại insight người phỏng vấn muốn nghe khi họ hỏi về project của bạn (theo Aishwarya, video đăng ngày 08/10/2026).
Những insight bạn thấy và những quyết định bạn đưa ra cũng là thứ nên ghi lên resume: bạn chọn tài liệu nào, bạn đã chọn trade-off model nào, model làm tốt ở category nào và kém ở category nào, bạn xử lý schema validation ra sao, và những điều tương tự. Chị dặn rằng trong lúc build, bạn phải có câu trả lời cho tất cả những câu này (theo Aishwarya, video đăng ngày 08/10/2026).
5. Project 2: Enterprise search và EnterpriseRAG-Bench
Khi đã kéo được dữ liệu có cấu trúc ra khỏi một đống tài liệu, Aishwarya chuyển sang một bài toán khác mà công ty nào cũng sống chung: họ đang ngồi trên một lượng dữ liệu nội bộ khổng lồ. Hãy nghĩ tới chính sách nhân sự (HR policies), support ticket, tài liệu kỹ thuật, wiki của các dự án, nhiều tháng thread Slack, email, và đủ thứ khác. Có lẽ bạn cũng đã thấy điều đó ở công ty mình. Theo Aishwarya (video đăng ngày 08/10/2026), tìm kiếm xuyên qua tất cả những thứ này là một trong những việc chủ chốt mà AI làm tốt hơn, thay vì để một người mở năm ứng dụng khác nhau để tìm câu trả lời. Chị nói đây cũng đang nhanh chóng trở thành một trong những use case phổ biến nhất mà các công ty áp dụng: enterprise search.
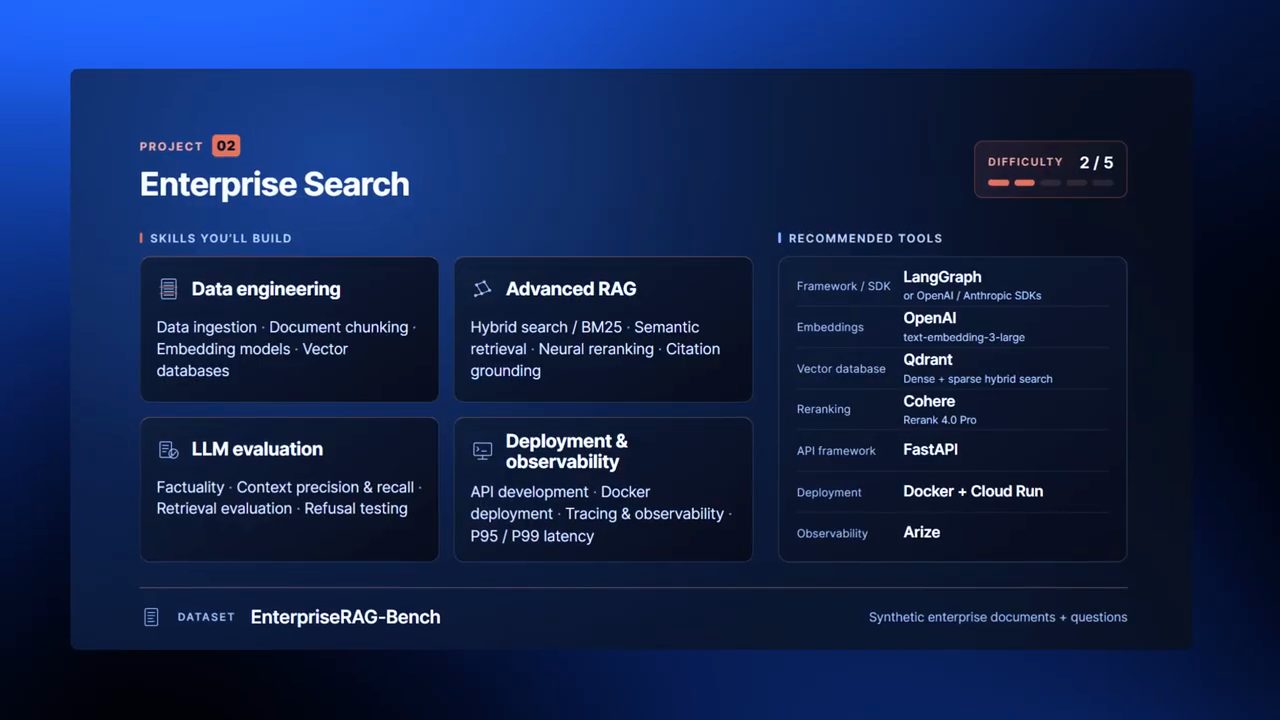
Đó là project thứ hai. Thứ bạn build về bản chất là một hệ thống hỏi đáp (question answering) có citation dẫn ngược về tài liệu chứa câu trả lời. Một trong những dataset Aishwarya thích nhất cho project này là EnterpriseRAG-Bench. Theo lời chị (video đăng ngày 08/10/2026), dataset này mô phỏng một công ty với dữ liệu nội bộ tổng hợp (synthetic) như dữ liệu Slack, email, Jira, Confluence và những nguồn khác, nên nó thực sự giống dữ liệu của một công ty.
6. Ingestion: chunking, embedding, vector database
Mảnh thứ nhất là build hệ thống ingestion, nghĩa là lấy toàn bộ tài liệu và đưa chúng về một dạng mà sau này bạn thật sự dùng được để search và retrieve. Theo Aishwarya (video đăng ngày 08/10/2026), ingestion có ba phần, và ở mỗi phần bạn đều phải ra một quyết định.
Phần thứ nhất là chunking, tức là cách bạn cắt một tài liệu trước khi lưu nó. Theo Aishwarya (video đăng ngày 08/10/2026), chunking có thể đi từ những lựa chọn rất đơn giản tới những lựa chọn phức tạp hơn, và lựa chọn nào hợp thì phụ thuộc vào dữ liệu và use case của bạn, nên bạn nên thử nghiệm vài cách. Trên màn hình là năm kiểu chunking đặt cạnh nhau: fixed-size, paragraph-based, section-based, semantic và parent-document.
Theo Aishwarya (video đăng ngày 08/10/2026), phần thứ hai là embedding: biến mỗi chunk thành một vector, về bản chất là một danh sách các con số nắm được ý nghĩa của đoạn văn, để sau này bạn search được theo ý nghĩa. Phần thứ ba là lưu các vector đó vào một vector database.
7. Retrieval, re-ranking và citation bắt buộc
Sau ingestion là thành phần retrieval, nơi bạn quyết định chạy kiểu search nào. Theo Aishwarya (video đăng ngày 08/10/2026), thường bạn sẽ bắt đầu với thứ đơn giản như keyword search, tức là search theo đúng các từ. Rồi tuỳ dữ liệu, bạn thử semantic search, kiểu search khớp theo ý nghĩa, hoặc hybrid search, chạy cả hai cùng lúc rồi gộp kết quả, và chị nói đó là thứ phần lớn các hệ thống ngoài đời thật rốt cuộc đều dùng.
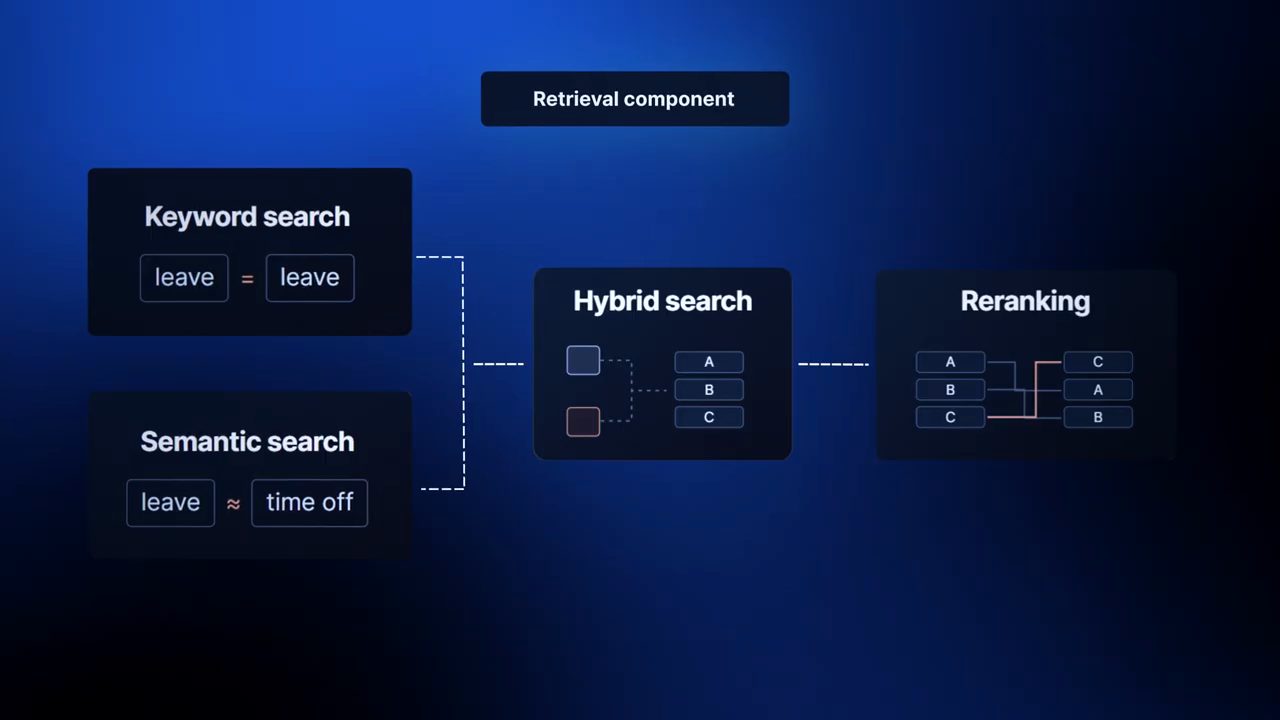
Với nhiều use case phức tạp, còn có ý tưởng re-ranking: bạn lấy các chunk được retrieve ở top rồi đổi thứ tự của chúng, tức là xếp hạng lại, bằng một model riêng. Cuối cùng, để gói mọi thứ lại, bạn phải đặt đúng prompt và đúng cơ chế context engineering để bắt buộc hệ thống đưa citation, vì theo Aishwarya (video đăng ngày 08/10/2026) chính citation là thứ làm cho một hệ thống ở quy mô enterprise trở nên đáng tin cậy.
8. Deploy, eval cho RAG, latency P95/P99 và cách kể project 2
Ở project này, Aishwarya (video đăng ngày 08/10/2026) gợi ý thêm một bước nâng cao: thật sự deploy hệ thống để ai đó dùng được thứ bạn đã build. Điều đó có nghĩa là bạn sẽ phải bắt đầu nghĩ tới latency của hệ thống. Chị nhắc lại điều đã nói ở project trước: mọi lựa chọn này phải được đưa ra nhờ dùng đúng eval, đúng các evaluation metric.
Với một hệ thống dựa trên RAG, theo Aishwarya (video đăng ngày 08/10/2026) thường có hai loại eval. Một loại cho phần generation: với các chunk đã retrieve, hệ thống có đưa ra được câu trả lời đúng không? Loại kia cho chính phần retrieval: các chunk đúng có được retrieve hay không? Ở phía generation, một metric hay dùng là factuality, kiểm tra xem câu trả lời có thực sự được context trả về hỗ trợ hay không, hay model đã tự điền vào thứ gì đó nằm ngoài context.
Ở phía retrieval có hai metric. Context recall là các chunk bạn kéo về có chứa đủ thứ cần cho câu trả lời hay không. Context precision là trong những gì được retrieve, bao nhiêu phần thật sự liên quan, và các chunk hữu ích có được xếp gần đầu hay không. Để đo latency, bạn dùng các metric như P95 hay P99, về cơ bản là mốc thời gian mà 95 hay 99 trên mỗi 100 request đã trả về trong khoảng đó. Theo Aishwarya (video đăng ngày 08/10/2026), nó cho bạn biết những người dùng chậm nhất của bạn đang phải chịu đựng mức nào.
Với resume và phỏng vấn, Aishwarya tóm lại khá gọn: những quyết định bạn đưa ra trên đường đi, trong đó có chunking, vì sao bạn chọn như vậy, bạn chọn embedding model nào, bạn đã xem những tham số nào của vector database, bạn học được gì khi phải bắt buộc citation, và bạn dùng tất cả các eval này để dẫn dắt quyết định của mình ra sao. Theo chị (video đăng ngày 08/10/2026), đó chính là những gì người phỏng vấn tìm kiếm. Trên màn hình, khung "What interviewers are looking for" liệt kê Chunking decisions, Embedding model, Vector database và Citations.
9. Project 3: Conversation intelligence system và dataset AMI
Aishwarya nhắc rằng tới đây hai project đã làm việc với tài liệu, về cơ bản là modality văn bản. Chị chuyển sang một modality khác mà theo chị đang rất phổ biến ở các công ty lúc quay video: xử lý và tạo giọng nói (voice). Chị nói có khá nhiều nghiên cứu về chủ đề này, và dẫn Gartner: Gartner kỳ vọng conversational AI sẽ xử lý hơn một nửa toàn bộ khối lượng của các contact center doanh nghiệp vào năm 2027 (dự báo Gartner do Aishwarya dẫn trong video đăng ngày 08/10/2026). Vì vậy, theo chị, có thể biết đây sẽ là một use case các công ty để mắt tới.
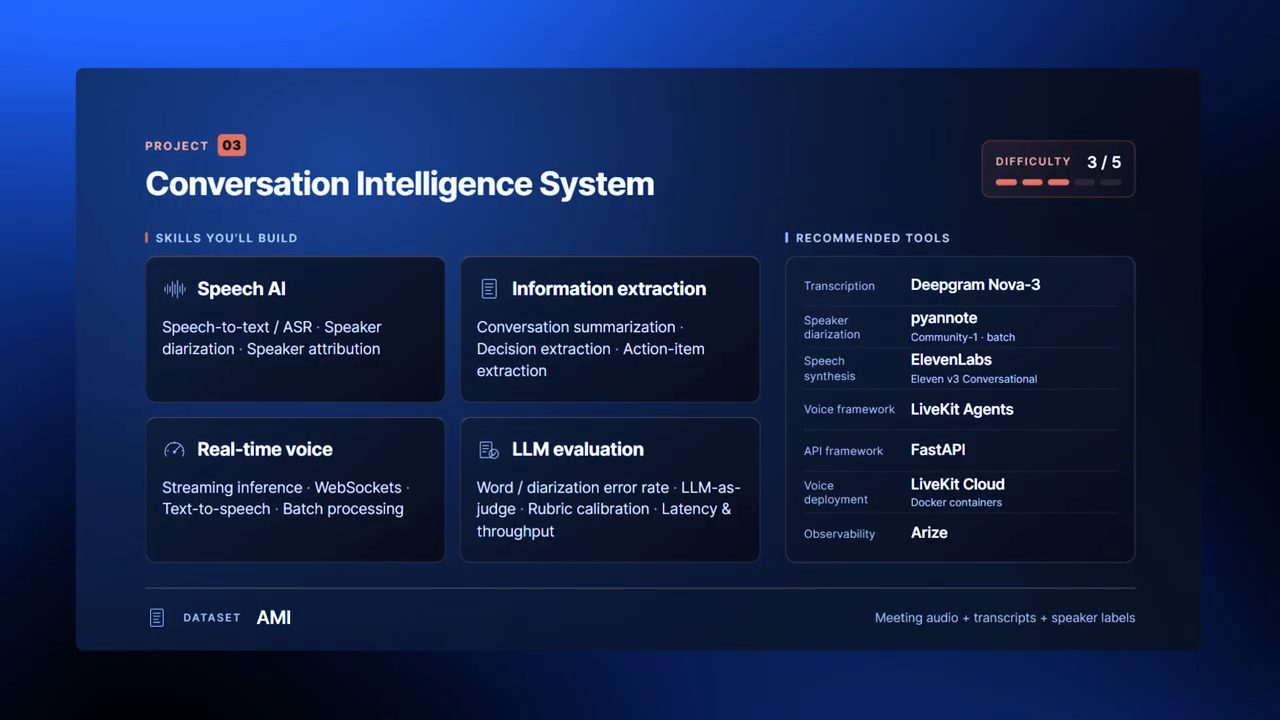
Điều đó dẫn tới project thứ ba: Conversation Intelligence System. Về bản chất, bạn build một hệ thống nhận vào một cuộc hội thoại và tạo ra một bản tóm tắt có cấu trúc từ nó, để các quyết định và action item có thể được xử lý tiếp. Dataset Aishwarya gợi ý là AMI, theo lời chị (video đăng ngày 08/10/2026) có 100 giờ các cuộc họp thật được ghi lại, gồm cả cuộc họp theo kịch bản (scenario-based) lẫn cuộc họp tự nhiên.
10. Transcription, diarization và bản ghi có cấu trúc
Mảnh thứ nhất ở đây là chép lời bằng speech-to-text. Theo Aishwarya (video đăng ngày 08/10/2026), trên thị trường có nhiều model speech-to-text và chúng hoạt động khác nhau, nên bạn nên so sánh vài model.
Mảnh thứ hai thú vị hơn và rất riêng cho voice: biến bản chép lời thành một bản ghi có gán người nói (attributed) và có cấu trúc, đảm bảo khi có nhiều người thì mỗi câu được gán đúng người. Đó là cả một mảng gọi là diarization. Theo Aishwarya (video đăng ngày 08/10/2026), nhiều model speech-to-text cho bạn các từ, tức là bản chép lời, nhưng không cho biết ai đã nói câu nào, nên bạn cần làm thêm bước diarization, hay một bước hậu xử lý (post-processing). Một số model đủ tiên tiến để tự làm việc này, nhưng nhiều model có sẵn trên thị trường (off-the-shelf) không có khả năng đó. Chị nhắc rằng trong môi trường enterprise bạn còn làm việc với ràng buộc về latency, nên phải tính cả bước này vào.
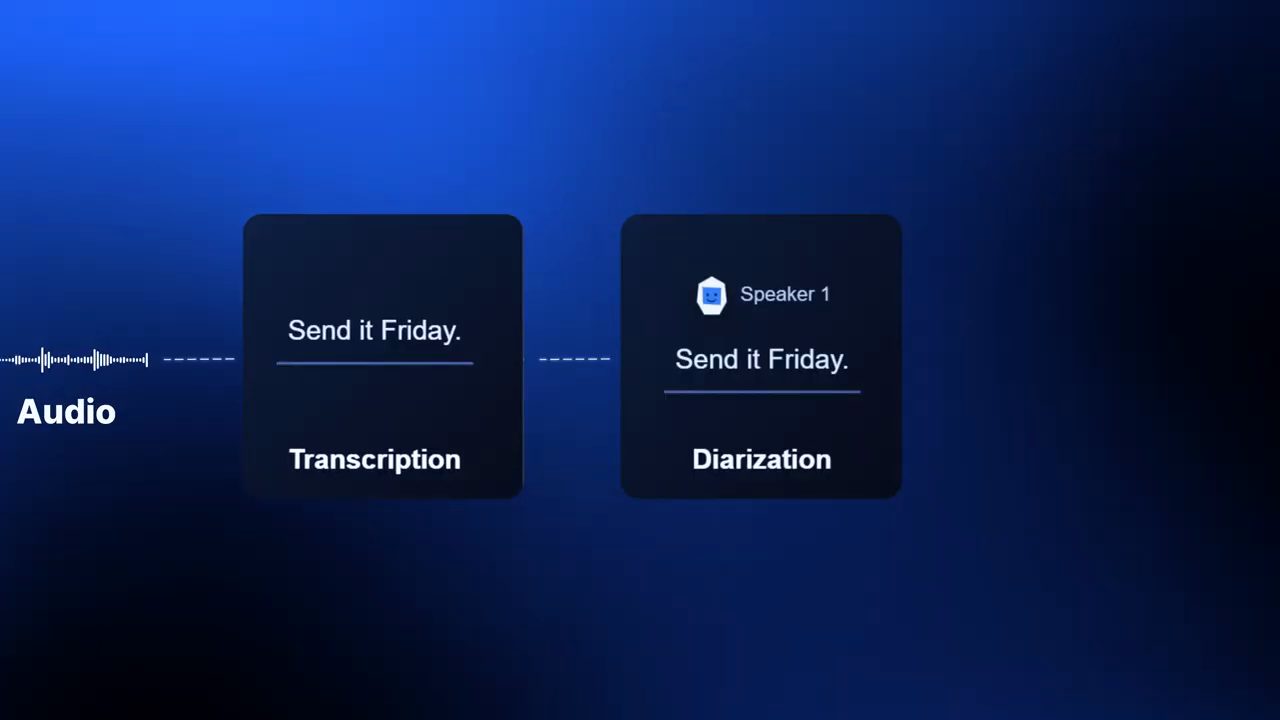
Cuối cùng, theo Aishwarya (video đăng ngày 08/10/2026), bạn lấy một bản ghi có cấu trúc từ bản chép lời đã có.
11. Chạy real-time, nói lại bằng giọng, và eval cho hệ thống voice
Bạn có thể làm project này nâng cao hơn bằng cách cho nó chạy live, tức là xử lý audio theo từng đoạn ngay khi nó tới, giống cách tính năng voice của ChatGPT hoạt động (ví dụ của Aishwarya trong video đăng ngày 08/10/2026; trên màn hình lúc đó là màn hình "Meet Voice" của ChatGPT). Nếu muốn đi thêm một bước nữa, bạn có thể tạo lại bản tóm tắt dưới dạng giọng nói. Theo Aishwarya, việc đó khép kín vòng lặp, vì bạn đã build theo cả hai chiều, và hai nửa đó gộp lại về cơ bản chính là phần lớn các hệ thống voice trưởng thành (theo Aishwarya, video đăng ngày 08/10/2026).
Với kiểu hệ thống này, bạn lại nhìn vào các loại eval khác. Theo Aishwarya (video đăng ngày 08/10/2026), thường bạn bắt đầu với word error rate trên bản chép lời và diarization error rate trên phần gán người nói. Với bản tóm tắt, bạn dùng LLM judge, tức là các AI model được dùng để đánh giá câu trả lời của một hệ thống AI khác. Bạn sẽ phải viết một rubric nói rõ thế nào là một bản ghi tốt, hay một bản tóm tắt tốt. Rồi bạn phải calibrate judge của mình, nghĩa là kiểm tra xem nó chấm ra sao so với, chẳng hạn, đánh giá của con người.
Khi đã chuyển sang real-time, bạn cần một nhóm metric thứ hai, có lẽ mang tính vận hành (operational) hơn là chất lượng. Các metric vận hành Aishwarya kể ra là: time to first output, tức là mất bao lâu thì có output đầu ra; words per second, tức là hệ thống có theo kịp tốc độ người ta thực sự nói hay không; và time to first audio, thường cần khi bạn thêm bản tóm tắt bằng giọng nói. Theo chị (video đăng ngày 08/10/2026), đây là những metric quyết định thứ bạn làm ra có cảm giác tự nhiên và dùng được trong bối cảnh thực tế hay không.
Về cách thể hiện project này trên resume và trong phỏng vấn, theo Aishwarya (video đăng ngày 08/10/2026) đó là lựa chọn model của bạn, cách bạn xử lý chỗ nhiều người nói chồng lên nhau (overlapping speakers), cách bạn đánh giá một thứ không có một đáp án đúng duy nhất, tức là toàn bộ những gì bạn học được khi build LLM judge, và cả insight về xử lý offline hay batch so với xử lý real-time. Chị nói đó là những phần quan trọng nhất của project. Trên màn hình, danh sách hiện lần lượt Model choice, Overlapping speakers, Summary evaluation và Batch.
12. Project 4: Sovereign AI engine, dataset và baseline
Aishwarya gọi project tiếp theo là project chị thích nhất. Ở mọi project trước, bạn build với các model closed source qua API. Ở project này, bạn sẽ build với một model open source và tự host nó. Project bốn là build một hệ thống sovereign AI. Theo Aishwarya (video đăng ngày 08/10/2026), cả chủ đề này đang có rất nhiều đà trong giới lãnh đạo cấp C (CXO) vào lúc quay video. Sovereign AI về cơ bản nghĩa là chạy model bên trong hạ tầng của chính công ty, thay vì phụ thuộc vào một nhà cung cấp bên ngoài.
Thứ bạn build ở đây là một hệ thống tóm tắt (summarization) hoặc hỏi đáp chạy trên một open-weight model và trên phần cứng của chính bạn. Một dataset tốt để bắt đầu là BillSum, gồm các dự luật của Quốc hội Mỹ (US Congressional bills) đi kèm bản tóm tắt tham chiếu được viết cho chúng. Nếu muốn một phiên bản khó hơn nhiều, có dataset PubMedQA, gồm các câu hỏi nghiên cứu y sinh. Theo Aishwarya (video đăng ngày 08/10/2026), nó còn đi kèm một ít dữ liệu fine-tuning mà bạn dùng được để tối ưu trên nền hệ thống cơ sở.
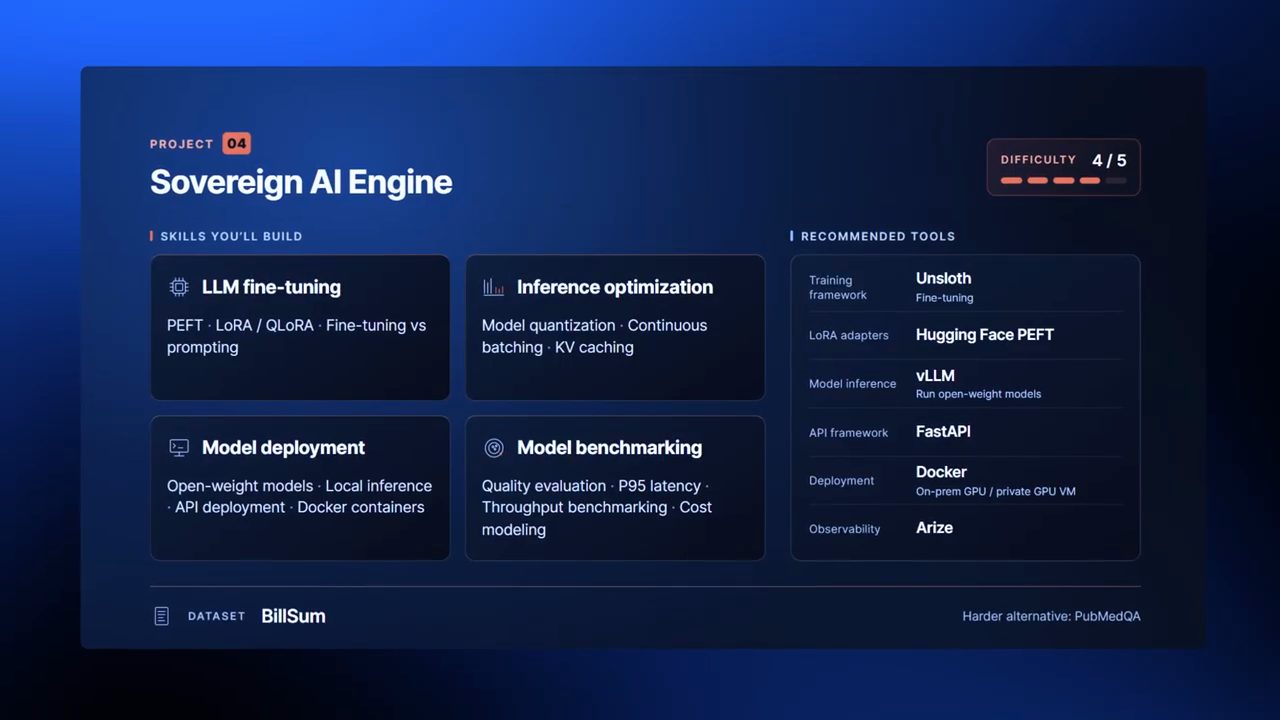
Tới phần build. Bước một là chọn một open-weight model và lấy baseline. Theo Aishwarya (video đăng ngày 08/10/2026), các lựa chọn như Qwen3, Gemma 4 hay bất kỳ open-weight model nhỏ nào trong khoảng 2 đến 4 tỉ tham số là thứ bạn chạy được trên laptop hoặc trên một instance Google Colab miễn phí. Màn hình ghi "Small open weight model (2–4B parameters)" cạnh logo Qwen3 và Gemma-4.
Sau đó bạn chạy cùng tác vụ đó qua một frontier API với một prompt tốt, ví dụ của OpenAI, Anthropic hay Gemini. Lý do, theo Aishwarya (video đăng ngày 08/10/2026): bạn có hai điểm tham chiếu, mức hiệu năng mà open-weight model của bạn xuất phát, và giới hạn trên (upper bound) mà bạn đang cố đạt tới. Khoảng cách hiệu năng đó chính là thứ dẫn dắt hệ thống của bạn trong suốt phần còn lại của project.
13. Ba optimization: fine-tuning, quantization, inference optimization
Thường bạn sẽ thử ba optimization để cải thiện hệ thống. Optimization thứ nhất là fine-tuning. Về fine-tuning, theo Aishwarya (video đăng ngày 08/10/2026), LoRA và QLoRA là các phương pháp phổ biến nên xem. Chúng còn là phương pháp parameter efficient, nghĩa là chỉ train một số lượng nhỏ trọng số (weight) bổ sung thay vì fine-tune lại cả model, và đó là điều giữ cho việc này chạy được trên phần cứng không quá đắt. Chị gợi ý thử cả hai và mày mò, rồi đo chênh lệch hiệu năng giữa hai cách.
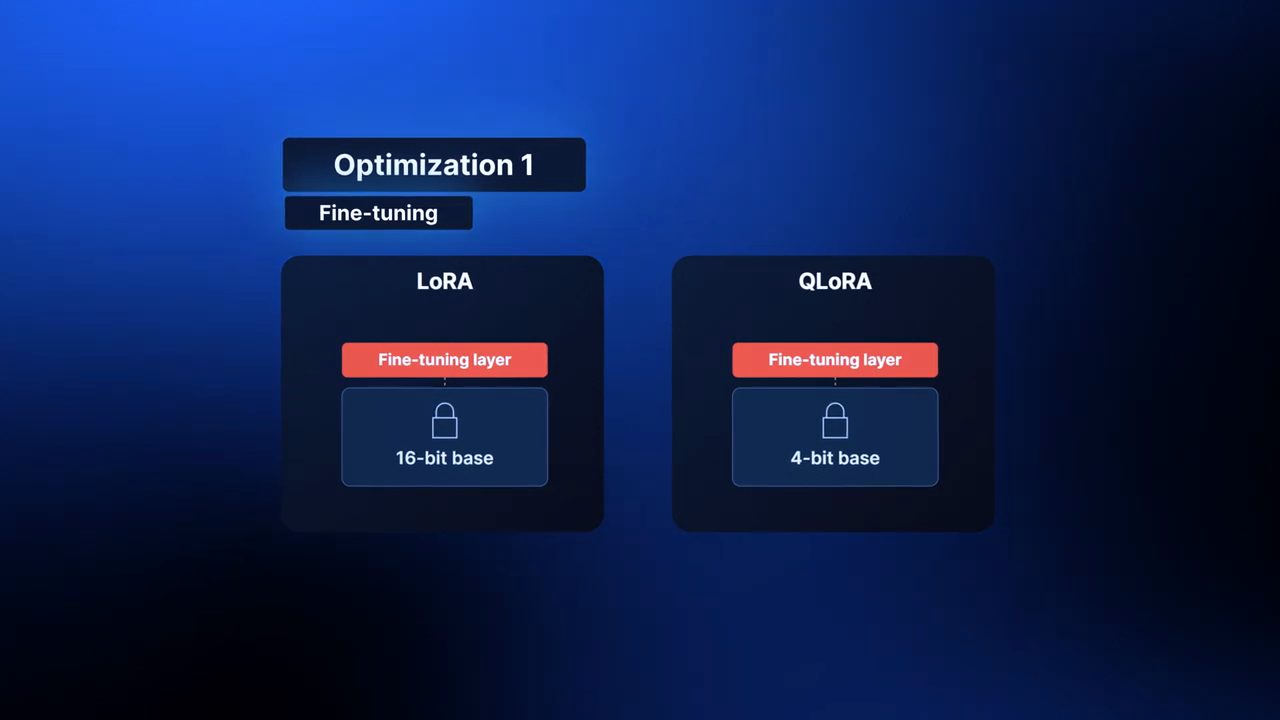
Theo Aishwarya (video đăng ngày 08/10/2026), optimization thứ hai thường nên thử là quantization, tức là lưu trọng số của model với độ chính xác thấp hơn để chúng chiếm ít bộ nhớ hơn. Aishwarya nhắc rằng mọi model đều được tạo nên từ các ma trận trọng số, và các ma trận này về bản chất là những số thực dấu phẩy động (floating point). Trong quantization, bạn lưu trọng số với độ chính xác thấp hơn để chúng chiếm ít chỗ hơn. Việc này có thể ảnh hưởng tới hiệu năng, và theo chị đó chính là điều thí nghiệm của bạn phải trả lời: khi áp quantization, hiệu năng có bị ảnh hưởng không, và bạn nhận thấy những pattern gì. Ví dụ trên màn hình: cùng một trọng số 0.3333, bản 16-bit (FP16) lưu thành khoảng 0.33325, còn bản 4-bit (INT4, scale = 0.1) chỉ còn khoảng 0.3.
Optimization thứ ba, mà Aishwarya nói là hơi nâng cao, là inference optimization. Theo chị (video đăng ngày 08/10/2026), build một model local chỉ phục vụ một hai request thì khá dễ, nhưng phục vụ 50, 100 hay hàng nghìn request là một bài toán hoàn toàn khác. Đó là chỗ continuous batching giúp ích: bạn gom các request đang tới thành nhóm ngay khi chúng tới. Ngoài ra còn các optimization quanh KV caching, lưu trạng thái trung gian của model để nó không phải tính lại mọi thứ ở mỗi token mới. Trên màn hình, sơ đồ "Continuous batching" cho thấy nhóm request A, B, C ở bước 1, rồi B, C, D ở bước 2 và C, D, E ở bước 3.
Vì ở các project trước bạn đã học được những điều cơ bản về deploy, bạn có thể deploy luôn project này (theo Aishwarya, video đăng ngày 08/10/2026). Khi đã làm xong các optimization và biết hiệu năng thay đổi thế nào, bạn đo các metric khác nhau, cả vận hành lẫn chất lượng.
14. Cách kể project 4, và vì sao agent tự động cần cẩn trọng
Để cụ thể hơn cho resume cũng như cho phỏng vấn, Aishwarya (video đăng ngày 08/10/2026) khuyên nghĩ về các insight như: vì sao bạn quyết định fine-tune, bạn chọn phương pháp nào, quantization làm bạn mất bao nhiêu hiệu năng, và điểm giao về khối lượng (volume crossover) nằm ở đâu, tức là cần đạt khối lượng bao nhiêu thì mới chuyển từ model closed source sang model open source.
Rồi chị chuyển sang project tiếp theo. Theo Aishwarya (video đăng ngày 08/10/2026), autonomous agent là một mảng đang chuyển động rất nhanh vào thời điểm quay video. Điều cần nhớ ở đây là các công ty đang deploy chúng rất cẩn thận, và lý do là agent đôi khi có thể thực hiện những hành động không thể hoàn tác (roll back), và governance là một vấn đề rất lớn ở mảng này. Vì vậy, muốn nổi bật, bạn nên chú ý đúng vào phần đó.
Đó là lý do project thứ năm là một multi-step autonomous agent (video đăng ngày 08/10/2026). Trong project này, bạn build một autonomous agent làm việc qua nhiều bước hay nhiều lượt để đạt một mục tiêu cấp cao hơn, trong đó nó liên tục tự quyết định việc tiếp theo, và mỗi quyết định thay đổi các quyết định sau nó.
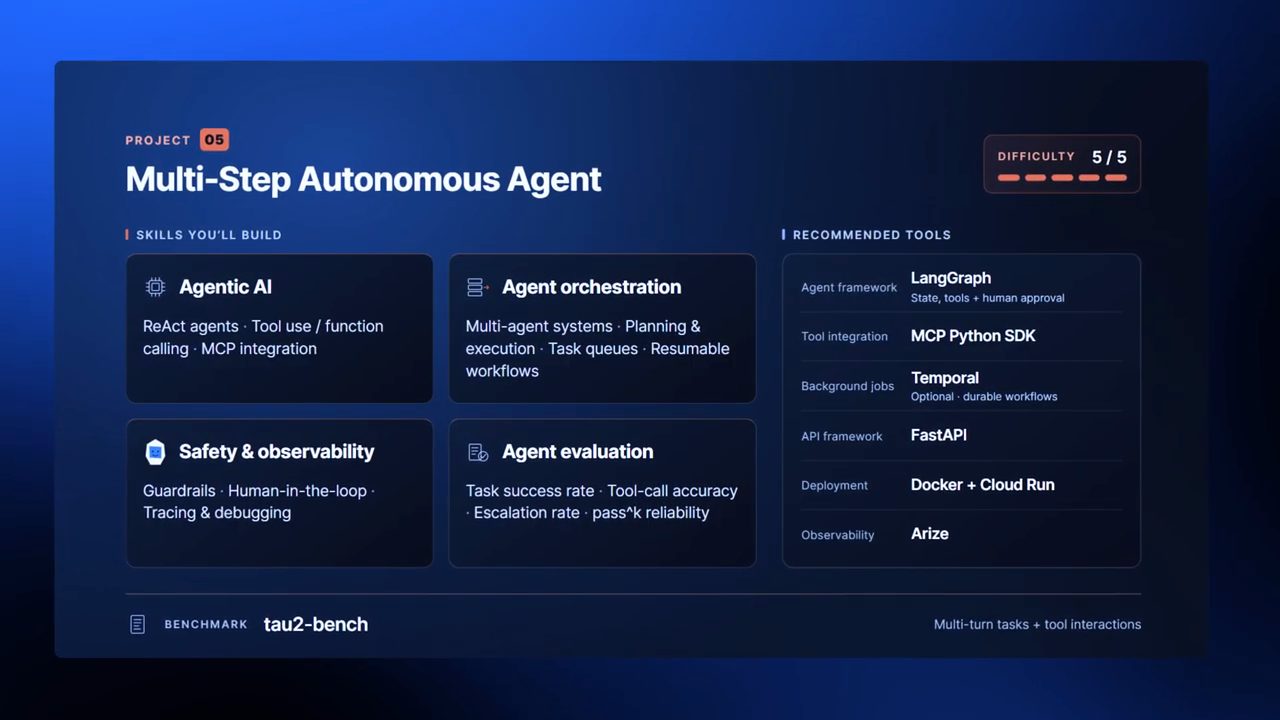
Một dataset Aishwarya gọi là "siêu hay" cho project này là tau-bench (trên màn hình ghi tau2-bench), một dataset chăm sóc khách hàng. Theo lời chị (video đăng ngày 08/10/2026), dataset này phủ vài domain như bán lẻ (retail), hàng không (airline) và viễn thông (telecom), mỗi domain có bộ tool riêng được ship kèm dataset, cùng bộ policy riêng và những thứ tương tự.
15. Project 5: ReAct agent, tool và trace
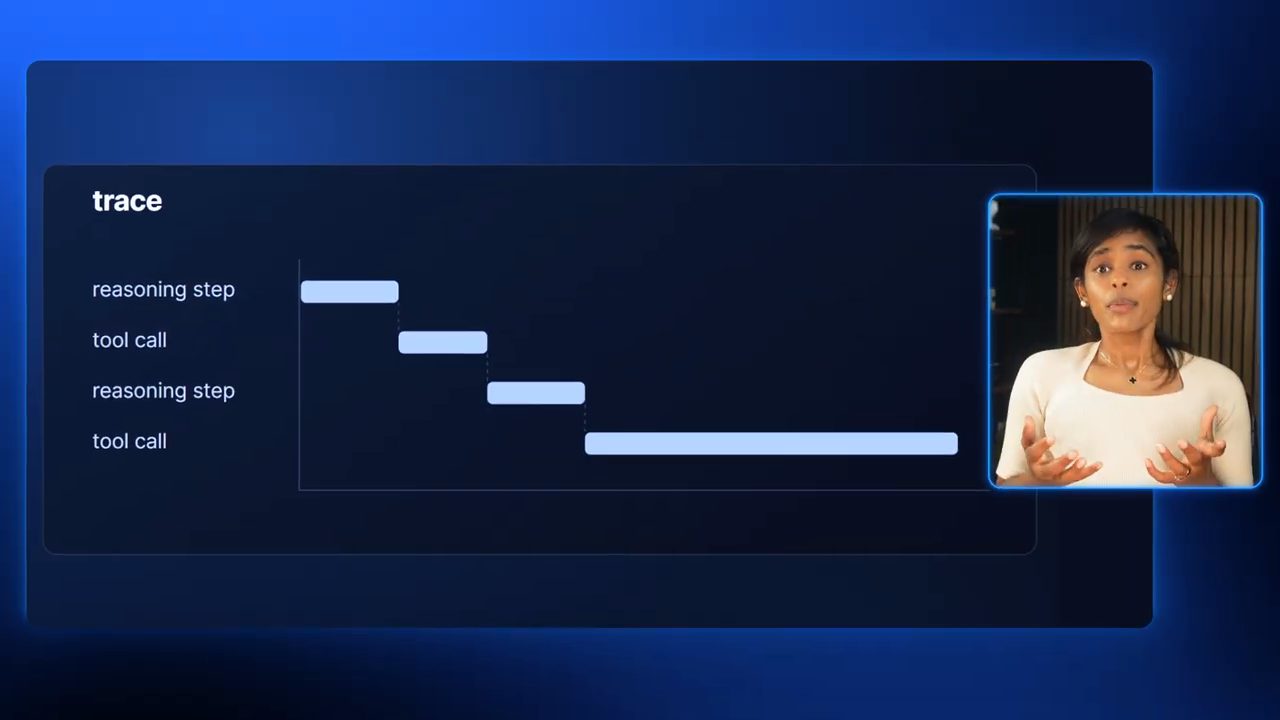
Về cách build, theo Aishwarya (video đăng ngày 08/10/2026), bạn bắt đầu bằng một ReAct agent, về bản chất là một agent chạy theo vòng lặp: nó suy luận (reason) xem nên làm gì tiếp, thực hiện một hành động bằng cách gọi một tool, nhìn vào thứ trả về, rồi lại quyết định tiếp. Bạn cũng cho nó quyền truy cập các tool, và cần giao cho nó một mục tiêu cấp cao.
Theo Aishwarya (video đăng ngày 08/10/2026), trong project này logging và observability cực kỳ quan trọng; đó là một trong những bước trở nên rất quan trọng để debug. Ví dụ, ở các project trước, latency cho bạn biết hệ thống chậm. Ở đây, khi bạn trace toàn bộ cuộc hội thoại, từng bước suy luận và từng lần gọi tool, bạn đang cố khoanh vùng đâu là nút thắt (bottleneck) của cả hệ thống. Và khi một lượt chạy thất bại ngẫu nhiên ở đâu đó giữa chừng, chính trace đó là thứ cho bạn biết bottleneck nằm ở đâu.
16. Guardrails, human in the loop, eval và pass^k
Theo Aishwarya (video đăng ngày 08/10/2026), đây là kiểu project mà guardrails quan trọng hơn bao giờ hết, và quan trọng hơn ở các project trước, vì những agent kiểu này có thể thay bạn thực hiện các hành động không thể hoàn tác. Vì vậy bạn cần đảm bảo bước người duyệt (human sign-off) được build thật tốt, và thiết kế đúng các hệ thống human in the loop.
Về eval, chúng trông hơi khác mọi thứ bạn đã làm, vì đây là một autonomous agent nhiều lượt, nhiều bước. Theo Aishwarya (video đăng ngày 08/10/2026), các metric hay eval thường dùng ở đây là task success rate, tức là sau tất cả các lượt, mục tiêu có đạt được hay không. Ngoài ra còn các eval trung gian như tool accuracy, và escalation rate, tức là agent có chuyển cho con người đúng lúc cần hay không. Một metric phổ biến khác cho hệ thống nhiều lượt là pass@K (trên thẻ project ghi pass^k), tức là agent đạt được mục tiêu bao nhiêu lần trong K lần thử khác nhau. K có thể là 5, có thể là 10; bạn đổi con số đó tuỳ theo bạn muốn kiểm tra độ vững của hệ thống tới mức nào.
Điều quan trọng cho resume và phỏng vấn, theo Aishwarya (video đăng ngày 08/10/2026), rốt cuộc nằm ở chỗ bạn thiết kế con người trong vòng lặp ra sao, bạn build những eval nào, bạn có những insight debug gì nhờ observability và trace, bạn đặt những guardrail nào, và bạn hiểu use case cũng như các dạng vấn đề mình gặp sâu tới đâu. Trên màn hình, mục đầu trong danh sách là "Human in the loop".
17. Project 6: Working backwards
Aishwarya gọi năm project vừa rồi là năm project rất hay, có thể hữu ích với nhiều nhà tuyển dụng vì chúng bám chặt vào loại bài toán mà các công ty này đang phải xử lý (theo Aishwarya, video đăng ngày 08/10/2026). Project thứ sáu chị kể về cơ bản là làm ngược (working backwards). Project này không có tên, vì nó thực sự phụ thuộc vào những công ty mơ ước của bạn, hay ba bốn công ty mà bạn thực sự muốn vào làm một vị trí AI engineering.
Cách làm là bạn chọn những công ty mình nhắm tới và build một thứ rất cụ thể cho họ. Nhưng làm sao hiểu các công ty đang tìm gì? Theo Aishwarya (video đăng ngày 08/10/2026), chuyện này thật ra khá đơn giản: nhiều công ty làm trong mảng này công khai đăng những gì họ đang làm, và từ bối cảnh cùng thông tin công khai của một công ty, bạn gần như suy ra được những use case và những bài toán họ đang xử lý.
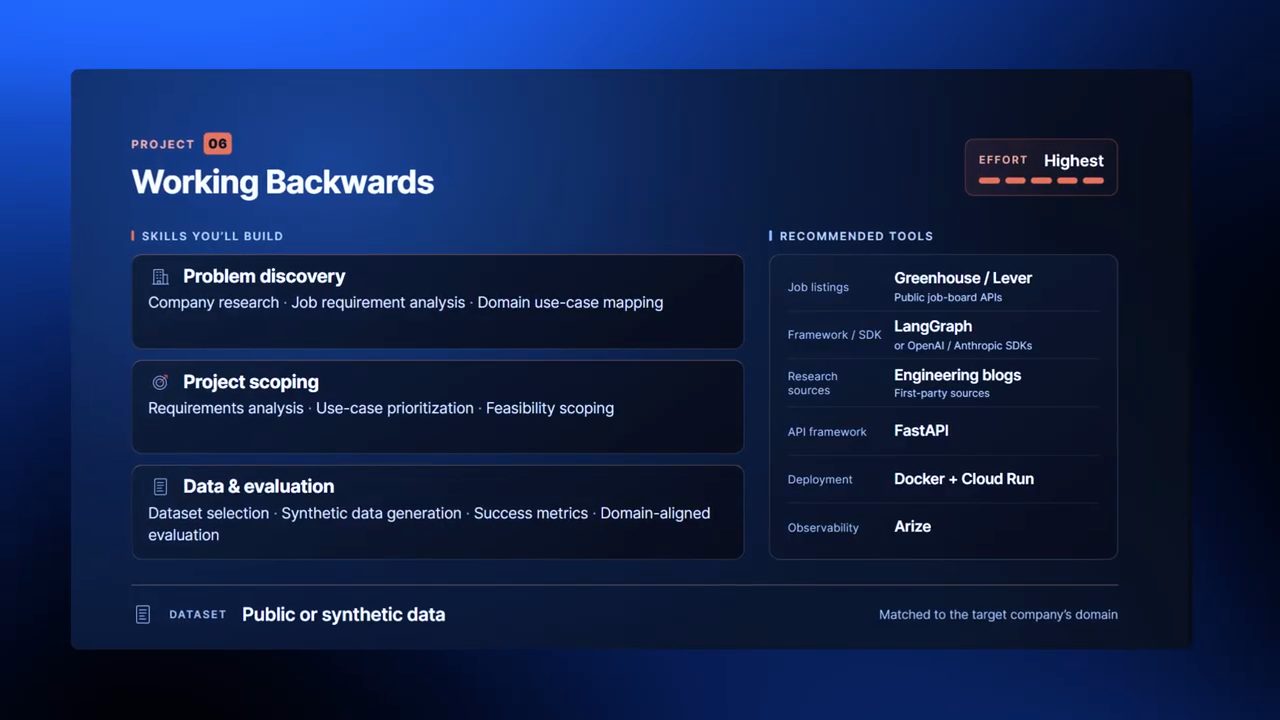
Chị nói sẽ cho xem một prompt đơn giản dùng được để gần như reverse engineer những loại project mà các công ty mơ ước của bạn có thể đang cần. Đây là một prompt ví dụ; bạn không cần chép y nguyên, hoàn toàn có thể tự viết phiên bản của mình, nhưng chị muốn bạn thấy hết các ý chính, và chị nói sẽ đặt prompt này trong repo GitHub của chị (video đăng ngày 08/10/2026).
18. Prompt dò ngược bài toán của công ty mục tiêu, và lời kết
Aishwarya đọc lần lượt từng phần của prompt (demo trong video đăng ngày 08/10/2026), đang dán trong ô nhập của một ứng dụng agent có dòng chữ "What should we build?" trên màn hình. Prompt mở đầu bằng câu "tôi đang ứng tuyển vào các công ty này"; trong ví dụ, các công ty mơ ước là Palantir, Ramp và Airbnb. Tiếp theo là các vị trí đang nhắm tới. Prompt yêu cầu cụ thể agent đi tra các vị trí đang mở cho những vai trò đó, và tra những gì đội kỹ thuật của các công ty này đã công bố công khai, chẳng hạn engineering blog, repo open source và những thứ tương tự.
Rồi chị yêu cầu bốn việc cụ thể cho mỗi công ty (demo trong video đăng ngày 08/10/2026). Một: từ mảng kinh doanh và các tin tuyển dụng của họ, xác định những use case AI họ nhiều khả năng đang build; phải cụ thể về bài toán, và nói rõ phần nào của tin tuyển dụng hay của mảng kinh doanh đã dẫn tới mỗi kết luận. Theo Aishwarya, làm vậy là để neo (ground) câu trả lời của agent. Hai: xác định những gì họ đã nói là khó, chậm hay chưa giải được, trích nguyên dòng nơi họ nói điều đó; nếu một công ty công bố rất ít thì nói thẳng ra như vậy thay vì tự lấp chỗ trống. Chị giải thích phần này là để agent không bịa (hallucinate) ở đây.
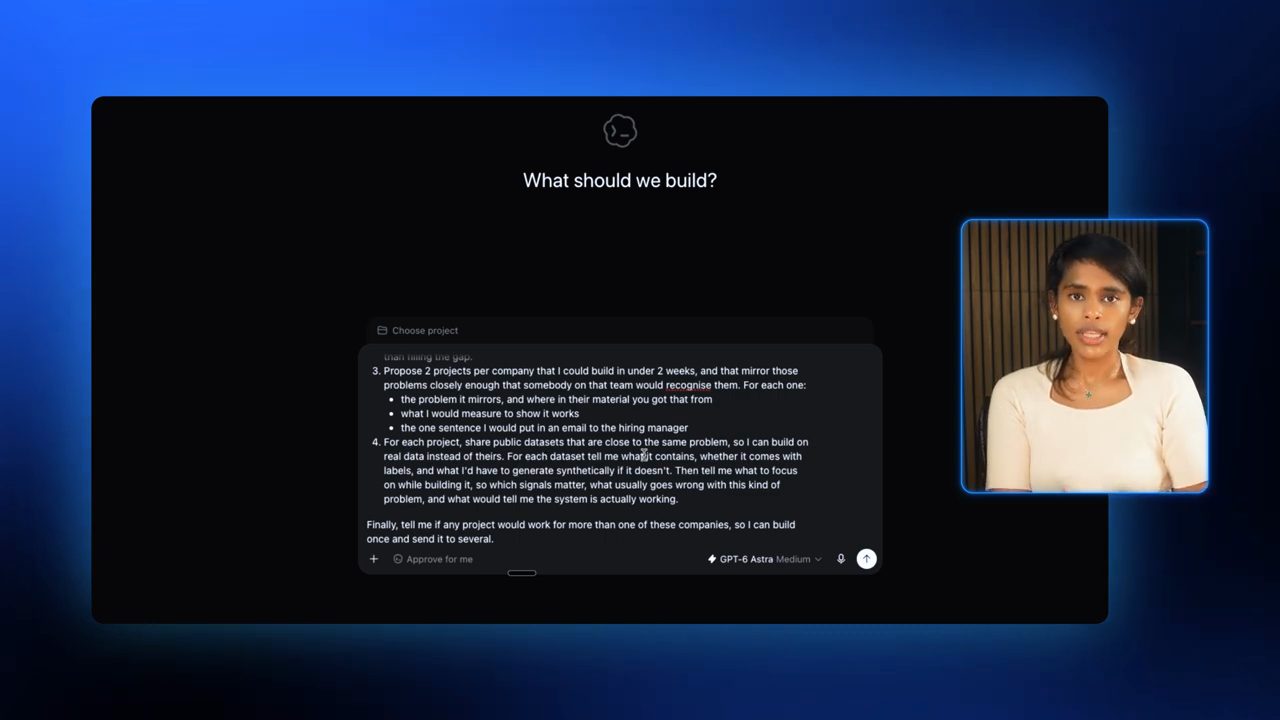
Ba: đề xuất hai project cho mỗi công ty mà bạn build được trong dưới hai tuần; với mỗi project, nêu bài toán nó phản chiếu, bạn sẽ đo gì để chứng minh nó hoạt động, và câu duy nhất bạn sẽ viết trong email gửi hiring manager. Aishwarya gọi câu cuối này là một phần thưởng thêm khá hay. Bốn: với mỗi project, chia sẻ các dataset công khai gần với cùng bài toán, để bạn build trên dữ liệu thật thay vì dữ liệu của họ; với mỗi dataset, cho biết nó chứa gì, có kèm label hay không, và những thứ tương tự. Theo lời chị (video đăng ngày 08/10/2026), chị đã có kết quả rất tốt khi làm như vậy, và chị mời người xem tự thử.
Bản đầy đủ của prompt được đăng trong trang hướng dẫn trên GitHub của chị, khớp với phần hiện trên màn hình (đọc ngày 25/10/2026). Ví dụ trong đó dùng Palantir, Ramp, Airbnb và bốn vị trí; bạn thay bằng công ty và vị trí của mình:
I'm applying to these companies: Palantir, Ramp, Airbnb.

The roles I'm targeting are Applied AI Engineer, AI Engineer, Applied Scientist, and Forward
Deployed AI Engineer.

Go and look up their current openings for those roles, and look up what their engineering teams
have published publicly, so engineering blogs, talks, open-source repos.

Then do 4 things, per company.

1. From their business and their job listings, work out which AI use cases they're most likely
   building right now. Be specific about the problem, not the technology. Say which part of the
   listing or the business led you to each one.

2. From what their engineers have published, identify what they've said is hard, slow, or
   unsolved. Quote the line where they say it. If a company has published little, say so rather
   than filling the gap.

3. Propose 2 projects per company that I could build in under 2 weeks, and that mirror those
   problems closely enough that somebody on that team would recognise them. For each one:
   - the problem it mirrors, and where in their material you got that from
   - what I would measure to show it works
   - the one sentence I would put in an email to the hiring manager

4. For each project, share public datasets that are close to the same problem, so I can build on
   real data instead of theirs. For each dataset tell me what it contains, whether it comes with
   labels, and what I'd have to generate synthetically if it doesn't. Then tell me what to focus
   on while building it, so which signals matter, what usually goes wrong with this kind of
   problem, and what would tell me the system is actually working.

Finally, tell me if any project would work for more than one of these companies, so I can build
once and send it to several.

Rules: nothing that takes longer than 2 weeks. If their public material doesn't support a claim,
say so instead of inventing it.
Chị nói trong prompt chị yêu cầu gợi ý dataset công khai, hoặc bạn cũng có thể tự tạo (synthetic) một dataset rất giống, để ít nhất có điểm xuất phát. Chị nhắc: khi tuyển người, các công ty tìm những người đang giải đúng loại bài toán mà họ sẽ được giao khi vào công ty, nên nếu nhà tuyển dụng thấy thứ gì tương tự thì đó gần như là một điểm cộng (theo Aishwarya, video đăng ngày 08/10/2026).
Vậy là hết sáu project. Aishwarya mong chúng cho người xem vài ý tưởng hay về những thứ có thể build cho portfolio để resume thật sự nổi bật. Theo chị (video đăng ngày 08/10/2026), ai cũng biết AI có thể sinh ra rất nhiều code; điều AI không làm được là xử lý phán đoán (judgment) và ra quyết định, và đó là thứ các công ty đang tìm vào lúc quay video.
Chị nhắc rằng trang GitHub nói ở trên có thêm nhiều thông tin về các project này, rồi chúc mọi người mọi điều tốt đẹp nhất.
Nguồn và liên kết 12 nguồn
- Tên gốc: AWS AI Lead: 6 Real-World AI Projects I Wish I Saw on Resumes
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=jOF-AhGIP4Q youtube.com
- Kênh YouTube Aish Reganti (Aishwarya Naresh Reganti): youtube.com/channel/UCf9CdAgj8AHmpMwyoe67w7w youtube.com
- Trang hướng dẫn đi kèm video trong repo awesome-generative-ai-guide của Aishwarya: dataset, tool stack, eval của từng project và nguyên văn prompt ở project 6 (đọc ngày 25/10/2026): github.com/aishwaryanr/awesome-generative-ai-guide/.../ai-engineer-projects.md github.com
- CUAD, Contract Understanding Atticus Dataset, dataset hợp đồng ở project 1; bài báo ghi hơn 13.000 annotation do chuyên gia pháp lý gắn (đọc ngày 25/10/2026): atticusprojectai.org/cuad · arxiv.org/abs/2103.06268 atticusprojectai.org
- EnterpriseRAG-Bench, dataset của project 2; README ghi hơn 500.000 tài liệu nội bộ mô phỏng (Slack, Gmail, Linear, Google Drive, Hubspot, Fireflies, GitHub, Jira, Confluence) và 500 câu hỏi (đọc ngày 25/10/2026): github.com/onyx-dot-app/EnterpriseRAG-Bench github.com
- AMI Meeting Corpus, dataset của project 3; trang chính ghi 100 giờ ghi âm cuộc họp (đọc ngày 25/10/2026): groups.inf.ed.ac.uk/ami/corpus groups.inf.ed.ac.uk
- BillSum: A Corpus for Automatic Summarization of US Legislation, dataset của project 4: arxiv.org/abs/1910.00523 arxiv.org
- PubMedQA: A Dataset for Biomedical Research Question Answering, phiên bản khó hơn của project 4: pubmedqa.github.io pubmedqa.github.io
- QLoRA: Efficient Finetuning of Quantized LLMs, bài báo gốc của QLoRA nhắc ở project 4: arxiv.org/abs/2305.14314 arxiv.org
- tau2-bench, benchmark của project 5; README ghi ba domain airline, retail và telecom (đọc ngày 25/10/2026): github.com/sierra-research/tau2-bench github.com
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Framework năm layer cho AI system design, qua ví dụ agent chăm sóc khách hàng
Aishwarya Naresh Reganti · Aish Reganti · 20 min
Framework năm layer và KARC để thiết kế một hệ thống AI agent từ scope, kiến trúc, observability, production tới tối ưu, qua ví dụ agent hỗ trợ khách hàng.
Tín hiệu từ user chết ở ranh giới retrieval
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.