Ollama hay LM Studio cho coding agent trên Mac: batching so với hàng đợi
Kai so Ollama với LM Studio khi coding agent gửi nhiều request cùng lúc: hàng đợi và batching, draft, Splash, context mặc định và cách chọn theo RAM.
✓ Đã duyệt độc lập · cập nhật 15/11/2026 · 28 min
1. Mac Studio, ly cà phê và bốn sub-agent xếp hàng
Kai mở đầu video đăng ngày 08/11/2026 bằng chiếc Mac Studio trên bàn làm việc, chiếc máy mà anh nói còn đắt hơn cả chiếc xe hơi đầu tiên của anh. Vài tuần trước đó (tính từ lúc làm video đăng ngày 08/11/2026), anh mở Claude Code, bảo nó đi nghiên cứu vài module khác nhau, rồi đi pha cà phê. Theo anh, toàn bộ ý nghĩa của một setup như vậy là AI làm việc còn anh quay lại với code đã xong.
Năm phút sau anh quay lại, và không có gì xảy ra cả. Con trỏ vẫn quay, terminal vẫn nhấp nháy. Model local chạy trên chính máy của anh, thứ là lý do anh lao vào hang thỏ local AI ngay từ đầu, về cơ bản chẳng làm được gì hữu ích. Anh đứng đó với ly cà phê nguội dần, tự hỏi chuyện quái gì đang diễn ra (câu chuyện của Kai, video đăng ngày 08/11/2026).
Khi nhìn vào những gì thật sự diễn ra, theo Kai (video đăng ngày 08/11/2026), Claude Code đã tách ra bốn sub-agent để làm song song, và cả bốn cùng gửi một request tới model local của anh vào cùng một lúc. Model của anh đang chạy trên Ollama, thứ mà mọi video YouTube, mọi thread Reddit và mọi bài blog đều bảo anh là lựa chọn tốt nhất. Và Ollama trả lời bốn request đó lần lượt từng cái một, trong một hàng đợi, như ở phòng cấp bằng lái xe (DMV). Sub-agent một đang làm việc, còn sub-agent hai, ba và bốn ngồi chờ và đốt thời gian.
Đó là lúc anh bắt đầu đào sâu, và điều anh tìm thấy thật sự làm anh bất ngờ, vì nó không phải điều mà các bài so sánh phổ biến sẽ nói với bạn. Theo Kai (video đăng ngày 08/11/2026), tất cả những video Ollama đối đầu LM Studio kia thật ra đang đo sai thứ, và anh nói sẽ cho thấy chính xác ý anh là gì.
Câu hỏi của video vì thế rất cụ thể: nếu bạn đang dùng một AI coding agent như Claude Code, OpenCode, hay bất cứ thứ gì tách ra sub-agent, thì app nào nên chạy model local trên Mac của bạn? Theo Kai (video đăng ngày 08/11/2026), một khi hiểu chuyện gì diễn ra bên dưới thì câu trả lời không hề sát nút. Nhưng anh muốn đi tới đó đúng cách: xem bằng chứng trước, rồi đi qua cơ chế, rồi mới đưa ra kết luận thật cho từng loại Mac.
2. Các cuộc đua một prompt đang đo cái gì
Theo Kai (video đăng ngày 08/11/2026), phần lớn chúng ta đều đã xem ít nhất một video so sánh Ollama với LM Studio, và chúng thường theo cùng một khuôn. Ai đó mở cả hai app, gõ cùng một prompt, rồi xem app nào trả lời nhanh hơn. Đôi khi đó là tóm tắt một tài liệu, đôi khi là một task code. Cuối video họ đưa ra số token mỗi giây, và một app thắng một chút.
Anh nói những bài thử đó không sai. Chúng chỉ đang thử một thế giới mà phần lớn chúng ta không còn sống trong đó nữa (theo Kai, video đăng ngày 08/11/2026).
Bài tốt nhất anh từng xem đến từ một creator tên The Dark Factory, người đã làm một cuộc đua bốn bên rất cẩn thận: bốn app, hai model, ba cỡ tài liệu, và ba lần chạy cho mỗi tổ hợp. Người đó đưa ra lần chạy ở giữa thay vì lần tốt nhất. Theo Kai (video đăng ngày 08/11/2026), đó là cách làm đúng, vì chọn lần chạy đẹp nhất là cách các YouTuber khoe những con số không bao giờ xuất hiện ngoài đời thật.
Theo lời Kai kể lại kết quả đó (video đăng ngày 08/11/2026), Ollama đọc một tài liệu dài 16.000 token trên Qwen3.8-27B ở tốc độ 1.442 token mỗi giây, còn bản tải MLX trong LM Studio đọc cùng tài liệu ở 1.372, chênh khoảng 5%. Với prompt ngắn trên model lớn hơn, Ollama hiện chữ đầu tiên sau 1,3 giây, nhanh nhất trong cả bốn app của bài thử. Về tốc độ viết, Ollama đạt khoảng 90 token mỗi giây, trong khi các app khác ở quanh 42 tới 48.
Vậy nên kết luận của người đó là với hầu hết mọi người, Ollama là app nên chọn. Theo Kai (video đăng ngày 08/11/2026), bài thử đó được làm cẩn thận và các con số là thật. Nếu anh xem video đó sáu tháng trước, anh đã cài Ollama và không bao giờ ngoái lại. Nhưng có một cụm từ trong kết luận đó bị lướt qua.
3. "Most people" nghĩa là một prompt mỗi lần
Cụm từ đó là "most people", hầu hết mọi người. Theo Kai (video đăng ngày 08/11/2026), "hầu hết mọi người" theo nghĩa đó là một prompt mỗi lần: một cửa sổ chat, một người gõ tin nhắn, chờ câu trả lời, rồi gõ tin tiếp theo. Anh nói đó là cách anh dùng các tool AI trong khoảng hai năm, nên anh hoàn toàn hiểu vì sao đó là giả định mặc định.
Vấn đề, theo Kai (video đăng ngày 08/11/2026), là "hầu hết mọi người" ngày càng bao gồm cả những người đã giao bàn phím cho một agent. Và agent không gửi một prompt mỗi lần. Chúng gửi bốn, tám, đôi khi 20 prompt, tất cả trong cùng một giây. Vì thế anh chuyển sang chuyện điều gì thật sự xảy ra khi hai thứ cùng hỏi một model vào cùng một lúc, vì theo anh điều đó thay đổi mọi thứ.
4. Mỗi token đọc lại cả model: taxi và xe buýt
Kai đề nghị người xem theo sát đoạn này, vì theo anh một khi hiểu ra điều này thì mọi thứ còn lại trong video đều có nghĩa (video đăng ngày 08/11/2026). Theo anh, mọi con chip Apple, dù là M4 hay M5, đều làm một việc khá đáng kinh ngạc khi chạy một language model: với từng token nó viết ra, nó đọc toàn bộ model ra khỏi bộ nhớ.
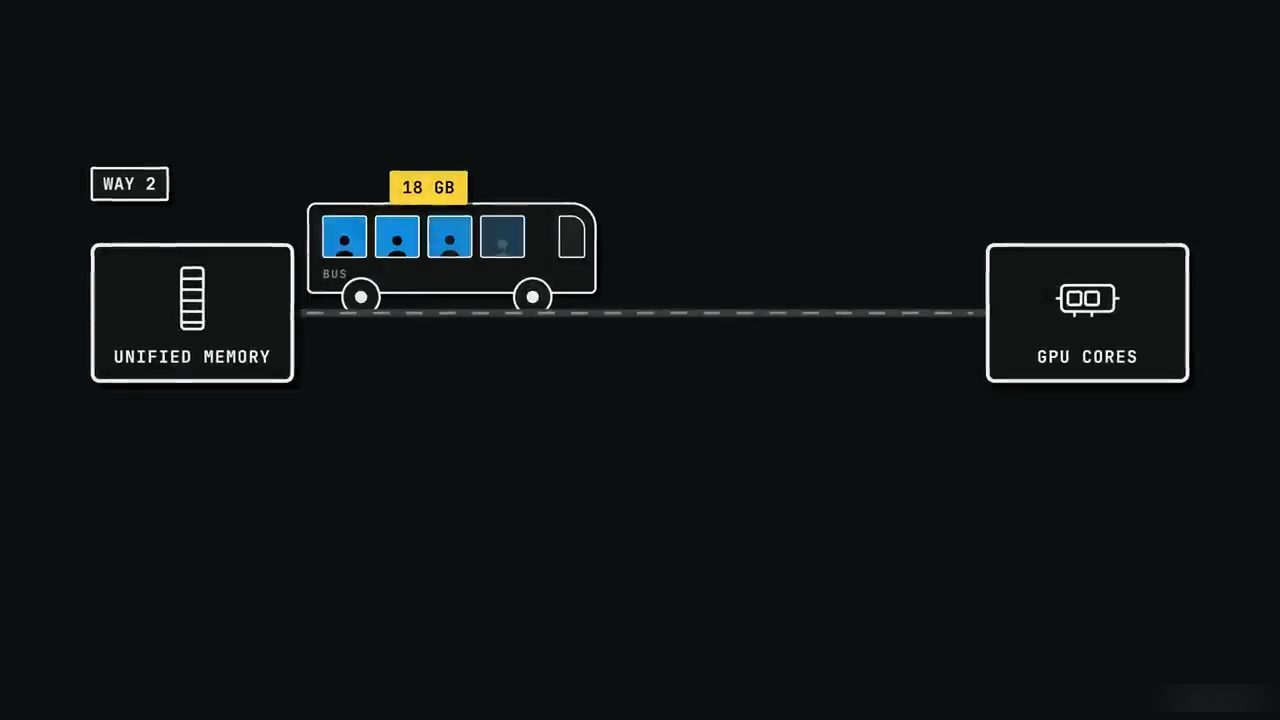
Lấy Qwen3.8-27B ở quantization 4-bit, theo Kai (video đăng ngày 08/11/2026), đó là khoảng 18 gigabyte đi từ unified memory tới các GPU core cho mỗi token được sinh ra. Phần tính toán ở cuối chuyến đi đó, tức phép nhân ma trận và phần tính toán transformer thật sự, gần như không tốn chút thời gian nào. Nút thắt thật sự là bản thân chuyến đi, 18 gigabyte lặp đi lặp lại cho mỗi chữ.
Vậy điều gì xảy ra nếu có bốn request cùng chờ? Theo Kai (video đăng ngày 08/11/2026), một server có hai cách xử lý. Cách thứ nhất là làm từng cái một: đi trọn chuyến 18 gigabyte để request 1 viết token tiếp theo, rồi lại đi trọn chuyến cho request 2, cứ thế tiếp, trong khi mỗi request đứng xếp hàng chờ những cái khác xong. Kỹ sư gọi đó là queue, hàng đợi; Kai gọi đó là taxi, mỗi khách một xe và mỗi lần một khách.
Cách thứ hai là làm cùng lúc: server đi chuyến 18 gigabyte một lần, và trong đúng lượt đó, nó làm phần tính toán cho cả bốn request và viết ra một token cho mỗi request từ cùng một lần đọc. Kỹ sư gọi đó là continuous batching; Kai gọi đó là xe buýt, cùng một chuyến chở bốn hành khách (video đăng ngày 08/11/2026).
5. Hai phút so với 45 giây
Theo Kai (video đăng ngày 08/11/2026), tổng lượng công việc gần như không đổi giữa hai cách. Cái thay đổi rất mạnh là request số bốn phải chờ bao lâu mới có chữ đầu tiên. Trong một hàng đợi mà mỗi request mất 30 giây, sub-agent bốn không nhận được chữ đầu tiên cho tới giây thứ 90, nghĩa là nó ngồi không hoàn toàn trong một phút rưỡi trước khi server còn thừa nhận nó tồn tại.
Với batching, cả bốn bắt đầu viết ngay, và tổng output vào khoảng 2,7 lần những gì một request đơn lẻ tạo ra trong cùng thời gian, vì không chuyến đọc bộ nhớ nào bị tiêu vào việc chờ. Kết quả là hai phút so với 45 giây, trên cùng một máy Mac, cùng một model (theo phép tính của Kai, video đăng ngày 08/11/2026).
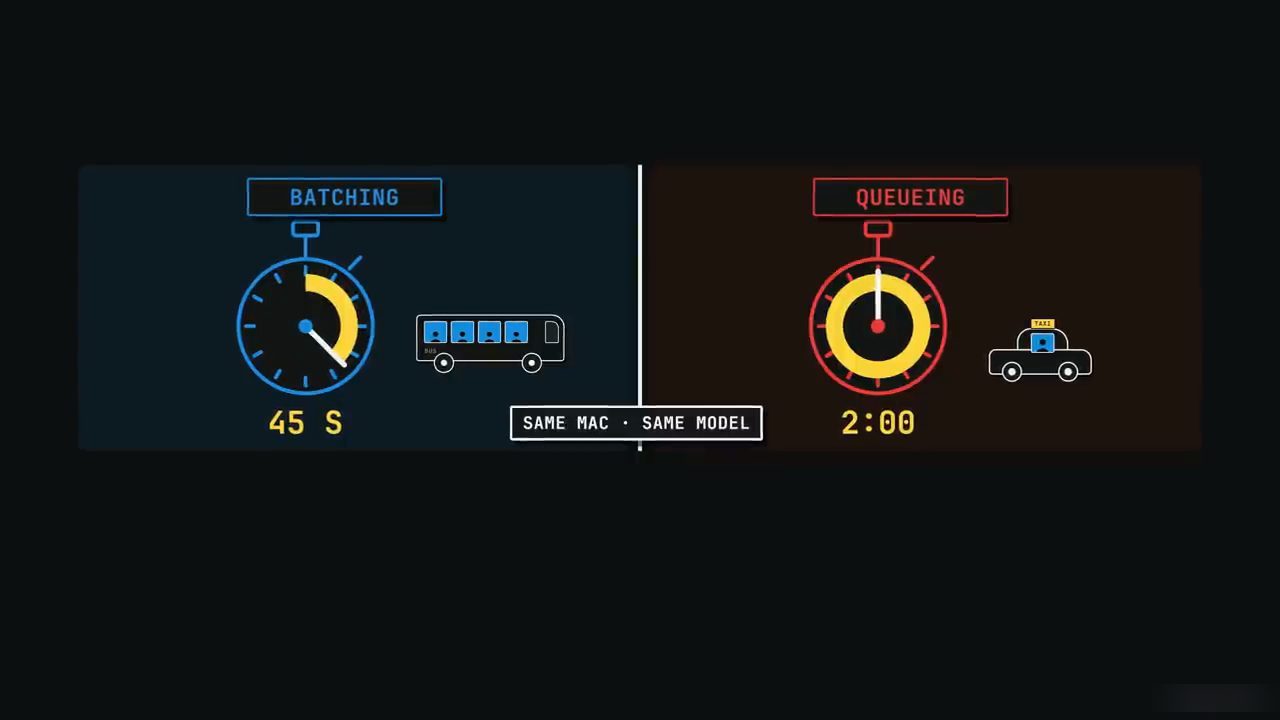
Theo Kai (video đăng ngày 08/11/2026), khác biệt giữa batching và queuing chính là điều cả video xoay quanh, vì kể từ ngày 25 tháng 9 (năm 2026), hai app này xử lý chuyện đó rất khác nhau.
6. Ollama 0.40: MLX thành mặc định trên Mac
Ngày 25 tháng 9 (năm 2026), Ollama phát hành phiên bản 0.40, và release notes có một dòng về Apple Silicon. Theo Kai (video đăng ngày 08/11/2026), dòng đó nói rằng mọi kiến trúc model mà runtime MLX hỗ trợ giờ chạy trên MLX một cách tự động. Release notes liệt kê Qwen 3.8, Gemma 4, Qwen 3.6 và Qwen 3.5 làm ví dụ, và theo anh đó đúng là những model mọi người đang chạy cho việc code vào lúc làm video. Trang release v0.40.0 trên GitHub ghi phát hành ngày 25/9, mục "Models run on MLX on Apple Silicon by default", với gemma4, qwen3.6 và qwen3.5 trong danh sách model bổ sung (đọc ngày 15/11/2026).
Theo Kai (video đăng ngày 08/11/2026), đây từng là tin rất đáng mừng, vì MLX là framework machine learning của chính Apple và được tối ưu cho Apple Silicon theo những cách mà các runtime chung chung không theo kịp. Với một request đơn lẻ, nó nhanh hơn thấy rõ, nên toàn bộ chuyện này nghe như một lần nâng cấp thuần tuý.
Nhưng điều mà release notes không nêu nổi bật, theo Kai (video đăng ngày 08/11/2026), là chuyện gì xảy ra với các request song song.
7. Issue 17280: OLLAMA_NUM_PARALLEL không tới được model MLX
Theo Kai (video đăng ngày 08/11/2026), có một GitHub issue số 17280, được mở hồi tháng 7, trong đó một người nhận ra các model được phục vụ qua MLX engine xử lý request tuần tự một cách nghiêm ngặt, bất kể thiết lập parallel đã cấu hình. Người đó đặt parallel request là 8, gửi nhiều request cùng lúc, và thấy wall time ra đúng bằng 8 lần một request, theo Kai là một hàng đợi hoàn hảo. Hoá ra runner MLX được khởi chạy mà không có cờ parallel nào cả. Trang issue ghi mở ngày 21/7/2026 và vẫn ở trạng thái Open (đọc ngày 15/11/2026).
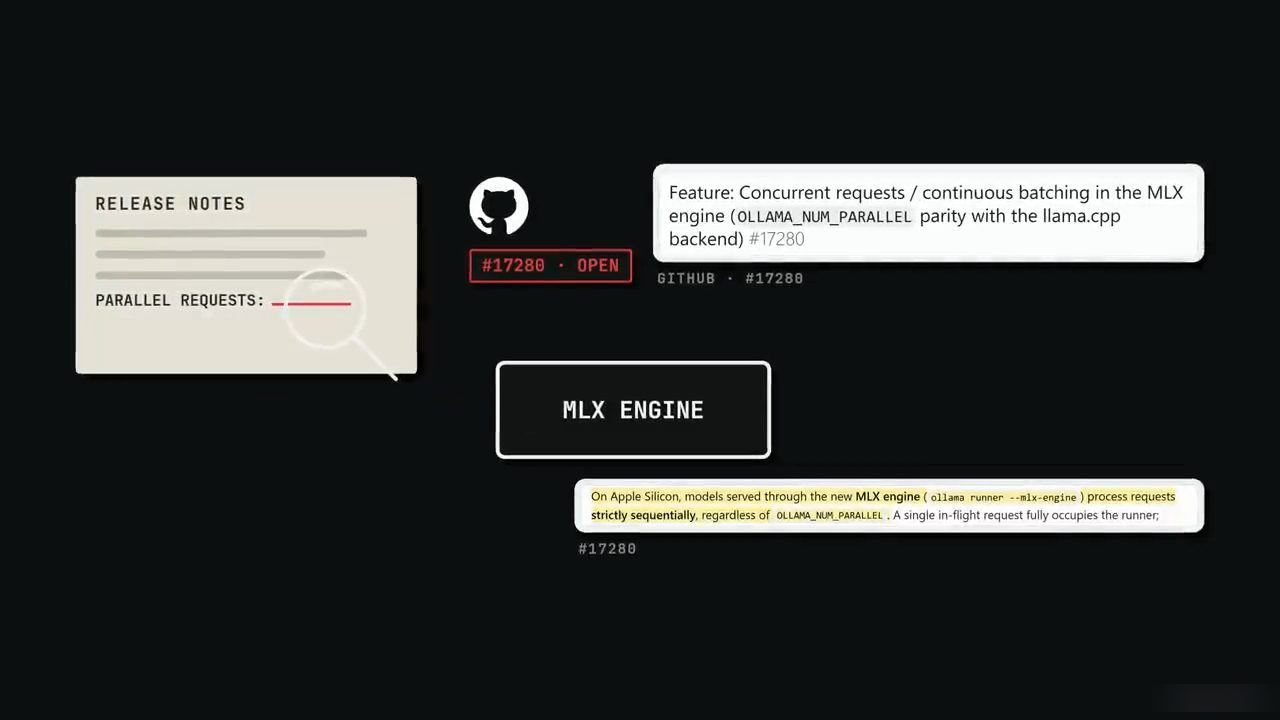
Để công bằng, Kai nói Ollama vẫn đang xử lý chuyện này: bản phát hành ngày 3 tháng 11 (năm 2026) có thêm parallel request cho một số model (video đăng ngày 08/11/2026). Nhưng release note ghi đó là các model GGUF dạng recurrent và vision, tức là GGUF chứ không phải MLX. Trang release v0.40.15 trên GitHub ghi phát hành ngày 3/11 với dòng "Recurrent and vision GGUF models can now serve more than one request at a time" (đọc ngày 15/11/2026). Vậy nên, theo Kai, nếu model của bạn được nạp trên MLX engine, điều mà nhiều khả năng đã tự động xảy ra sau ngày 25/9, thì thiết lập parallel hoàn toàn không tới được nó (video đăng ngày 08/11/2026).
Theo Kai (video đăng ngày 08/11/2026), ta có thể kiểm chuyện này bằng cách mở Activity Monitor trong lúc một model đang được nạp, hoặc chạy ps trong Terminal. Nếu process runner ghi MLX engine thì bạn đang ở trên MLX và thiết lập parallel không làm gì cả.
Phần khiến anh thật sự khó chịu là chính anh đã làm điều này. Theo Kai (video đăng ngày 08/11/2026), gần như mọi hướng dẫn setup Claude Code trên Ollama đều đưa cùng một mẹo chuẩn: đặt OLLAMA_NUM_PARALLEL thành 4. Anh làm theo và nghĩ mình đã sửa xong vấn đề, nhưng thật ra chưa. Trên một máy Mac chạy Ollama 0.40 với một model MLX, biến đó không đi tới đâu hữu ích: server nhận được nó, còn runner làm việc thật thì không bao giờ nghe thấy.
Có một cách vòng, theo Kai (video đăng ngày 08/11/2026): kéo bản GGUF của model về để nó chạy trên nhánh llama.cpp của Ollama, nơi thiết lập parallel thật sự có tác dụng. Nhưng khi đó ta bỏ mất phần tăng tốc MLX mà ta vừa nâng cấp để có, và tốc độ một request giảm thấy rõ. Anh ví đó là đổi làn nhanh lấy nhiều làn hơn, và làm việc đó một cách tình cờ, không có cảnh báo nào trong app. Anh nói đó là một tình huống khá tệ, và anh đã ở trong đúng tình huống đó.
8. LM Studio: continuous batching cho MLX
Trong lúc đó, theo Kai (video đăng ngày 08/11/2026), LM Studio đã lặng lẽ đi theo một hướng hoàn toàn khác. Hồi tháng 2 (năm 2026), ở phiên bản 0.4.2, LM Studio thêm parallel request cho MLX qua continuous batching, không phải như một cách vòng hay một đường lui về GGUF, mà là một tính năng hạng nhất của MLX engine. Mặc định là bốn prediction đồng thời, và theo anh nó cứ thế chạy được. Chính issue 17280 của Ollama cũng ghi rằng LM Studio 0.4.2 (tháng 2/2026) đã thêm continuous batching vào MLX engine của mình (đọc ngày 15/11/2026).
Kai thú nhận (video đăng ngày 08/11/2026) rằng anh luôn hơi xem nhẹ LM Studio. Anh biết điều đó phi lý, nhưng Ollama có cái chất mã nguồn mở MIT mà anh thấy đúng. Ollama chạy headless, có bộ CLI rất tốt với một lệnh ollama pull là xong. Còn LM Studio thì luôn cho anh cảm giác hơi cố quá với giao diện cầu kỳ. Anh nói anh đã sai về chuyện đó.
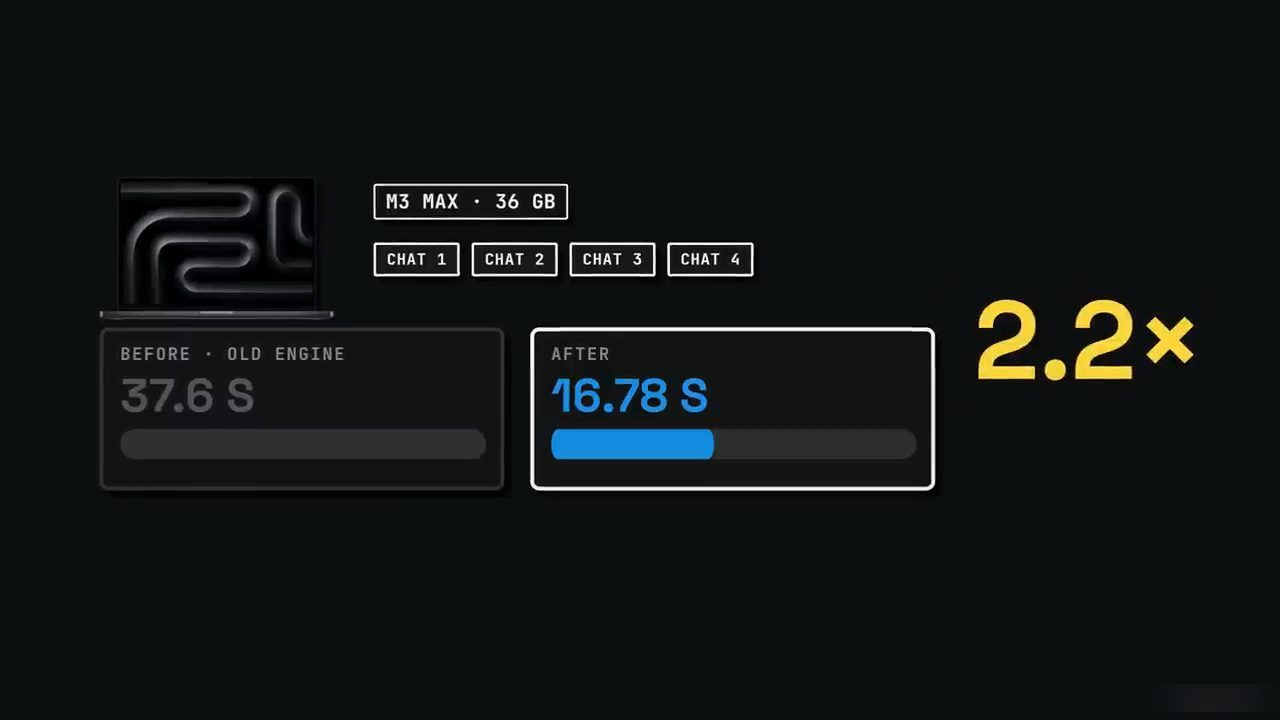
Theo Kai (video đăng ngày 08/11/2026), vào tháng 6 (năm 2026), LM Studio mở rộng MLX batching sang các vision language model, đúng là loại của Qwen 3.6 và Qwen 3.8, hai model phổ biến nhất cho việc code vào lúc làm video. Họ công bố một phép so sánh trước và sau: trên một MacBook Pro M3 Max 36 gigabyte, bốn đoạn chat ngắn chạy cùng lúc mất 37,6 giây với engine cũ và 16,78 giây với engine mới. Theo Kai, đó là nhanh hơn 2,2 lần với cùng lượng output, trên cùng máy, cùng model.
9. Bảng số của một đối thủ: 2,68 lần
Nhưng con số thật sự đọng lại với Kai lại đến từ một đối thủ: một engine tên Rapid MLX, tự quảng bá là nhanh hơn LM Studio (theo Kai, video đăng ngày 08/11/2026). Họ công bố một bảng benchmark từ một máy M5 Max 36 gigabyte chạy Qwen3.8-27B. Nhìn vào các dòng của LM Studio, một stream đơn đạt 26,0 token mỗi giây, còn bốn stream đồng thời đạt tổng cộng 69,7 token mỗi giây. Theo Kai, vậy là 2,68 lần output từ cùng một máy Mac, trên chính biểu đồ của một đối thủ, từ một công ty mà toàn bộ lời chào hàng là họ tốt hơn LM Studio và đang dùng bảng đó làm điểm so sánh.
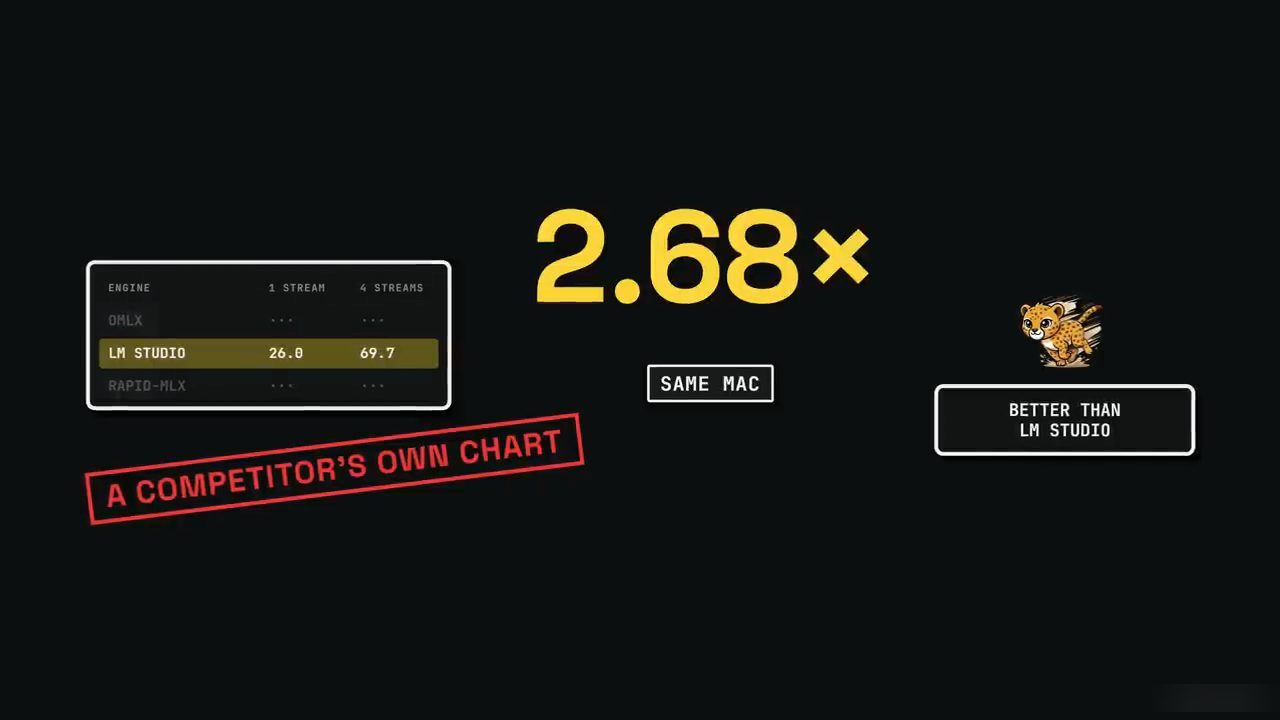
Đưa vào thực tế, theo Kai (video đăng ngày 08/11/2026): giả sử một agent tách ra bốn sub-agent và mỗi câu trả lời mất 30 giây trong một hàng đợi. Với mức batching đã đo được của LM Studio, 120 giây công việc xong trong khoảng 45 giây. Cả bốn agent bắt đầu viết gần như ngay lập tức, agent chính nhận lại đủ bốn câu trả lời và có thể đi tiếp, thay vì hai phút ngồi nhìn vòng quay trên cùng máy Mac, cùng model.
10. Bài thử thật: 16 request trên M5 Ultra
Theo Kai (video đăng ngày 08/11/2026), các con số trên đến từ benchmark có kiểm soát và bảng của đối thủ, nên anh muốn đưa vào một bài thử ngoài đời thật từ một người thật sự dùng việc này cho công việc. Một người chủ máy, đăng bài dưới một biệt danh, đã chạy một job dịch trên hai máy Mac Studio M5 Ultra, một máy 256 gigabyte bộ nhớ và một máy 96. Đây không phải bài thử trong phòng lab: một bài viết được cắt thành các đoạn khoảng 900 ký tự, với 16 request đi vào cùng lúc, theo Kai là một workload thật.
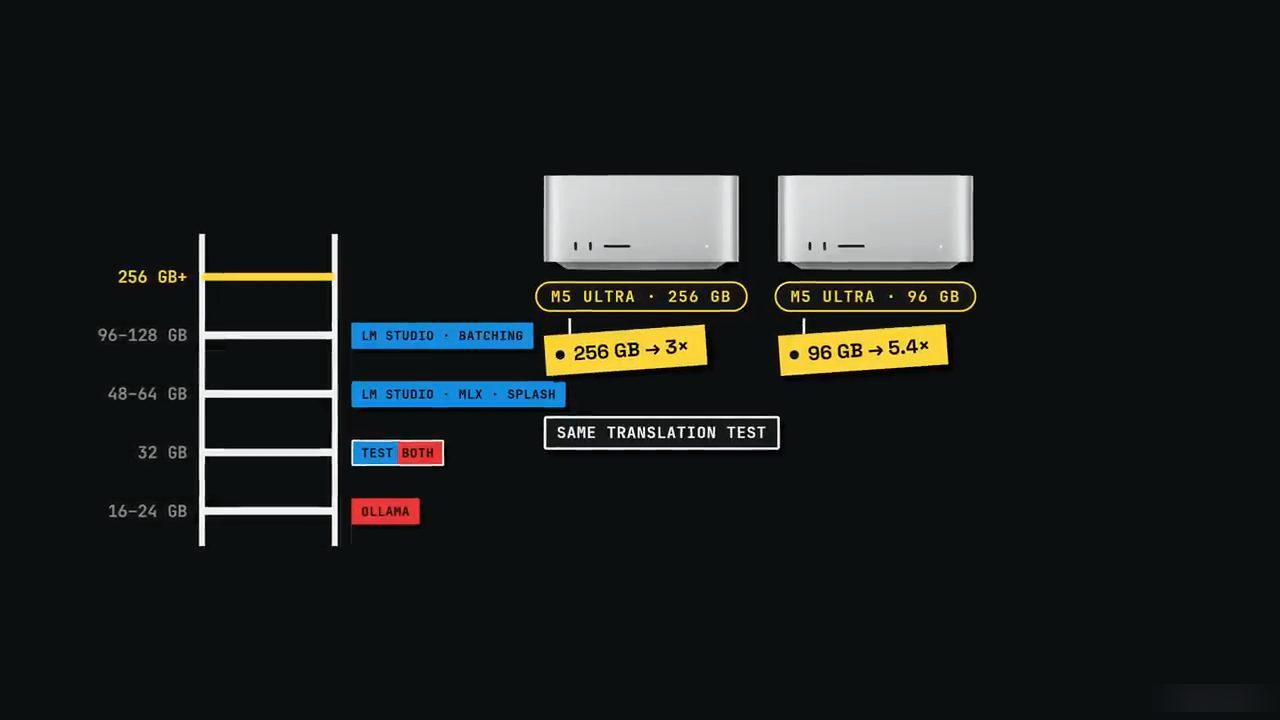
Trên máy 96 gigabyte, theo số đo của người chủ máy đó mà Kai trích (video đăng ngày 08/11/2026), LM Studio tạo ra tổng cộng 557,5 token mỗi giây trên cả 16 stream, còn Ollama tạo ra 103,8, tức gấp 5,4 lần lượng công việc.
Kai muốn đi qua toàn bộ phần chữ nhỏ, vì anh ghét khi người ta bỏ qua nó (video đăng ngày 08/11/2026). Ollama chạy với thiết lập parallel bằng 1, là mặc định. Khi nâng thiết lập lên 2 trên máy 256 gigabyte, Ollama đạt 170,3 token mỗi giây, còn LM Studio tạo ra 519,9 trên cùng phần cứng, vẫn khoảng 3 lần. Trong dữ liệu đó còn một cột nữa đáng chú ý: llama.cpp chạy trực tiếp, không có app nào bọc ngoài, đạt 680,4 token mỗi giây. Theo Kai, vậy là engine bên dưới chưa bao giờ là vấn đề; vấn đề là các mặc định đứng trước nó.
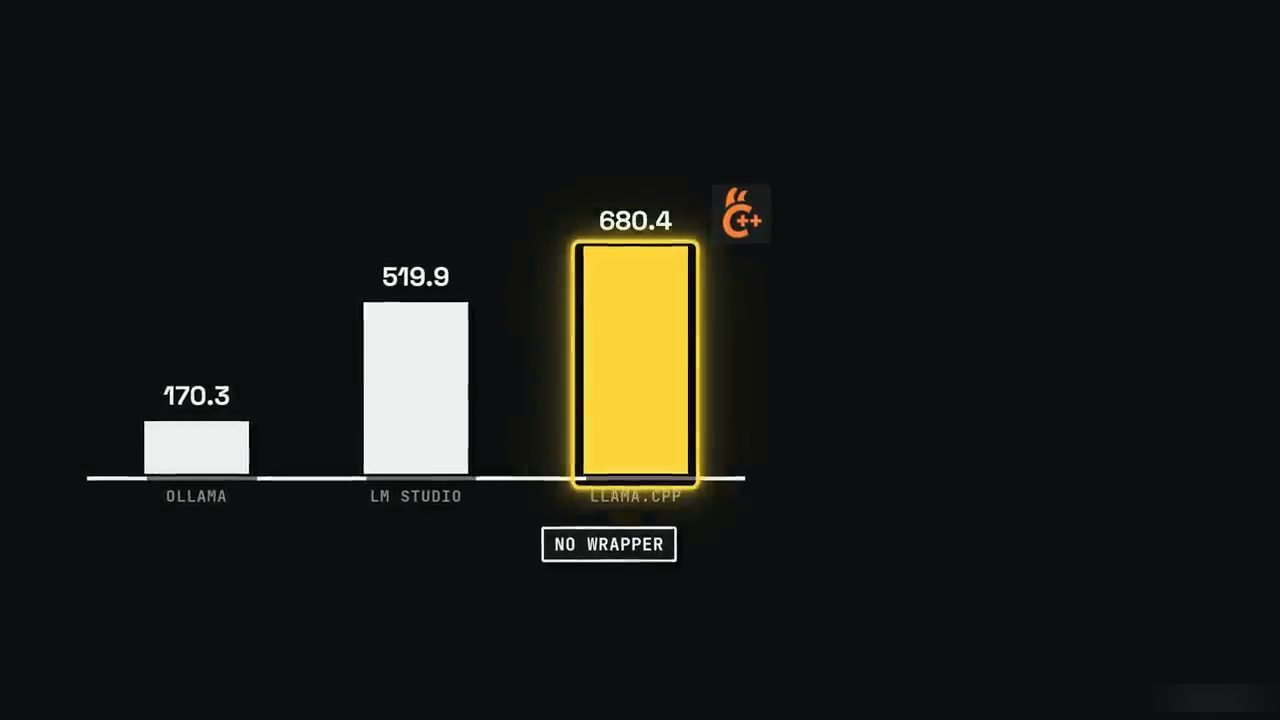
Kai nói rõ (video đăng ngày 08/11/2026) đây là bài thử của một người, và bài đăng có dưới 100 lượt xem khi nó mới xuất hiện, nên hãy đón nhận nó với chút hoài nghi. Nhưng nó khớp với mọi cơ chế đã nói tới lúc đó, và các con số không có gì bất ngờ một khi hiểu khác biệt giữa batching và queuing.
Phần khó chịu, theo Kai (video đăng ngày 08/11/2026), là bạn mua càng nhiều bộ nhớ thì một hàng đợi càng làm bạn tốn. Một người bỏ ra 4.000 bảng Anh cho một máy M5 Ultra và chạy Ollama với thiết lập mặc định có lẽ đang dùng chừng một phần năm những gì họ đã trả tiền, xét về throughput cho nhiều agent.
11. Lợi thế thật của Ollama: speculative decoding
Tới đây Kai dừng lại để đưa ra lập luận mạnh nhất anh có thể cho Ollama, vì theo anh đó là một lập luận thật và xứng đáng được nghe đàng hoàng (video đăng ngày 08/11/2026). Con số 90 token mỗi giây mà Ollama đạt trong cuộc đua của The Dark Factory, trong khi LM Studio ở mức 42 tới 48, không phải ăn may. Và nó không đến từ riêng MLX, mà từ một thứ gọi là speculative decoding.
Ý tưởng cơ bản, theo Kai (video đăng ngày 08/11/2026), rất khéo. Ta chạy một draft model nhỏ bên cạnh model lớn. Draft model nhanh và "ngốc": nó đoán trước vài token tiếp theo, rồi model lớn kiểm các phỏng đoán đó trong một lượt duy nhất. Khi các phỏng đoán đúng, điều thường xảy ra với văn bản dễ đoán, ta có vài token với giá của một lần kiểm của model lớn, nên nó như một lối tắt qua những đường đi phổ biến nhất.
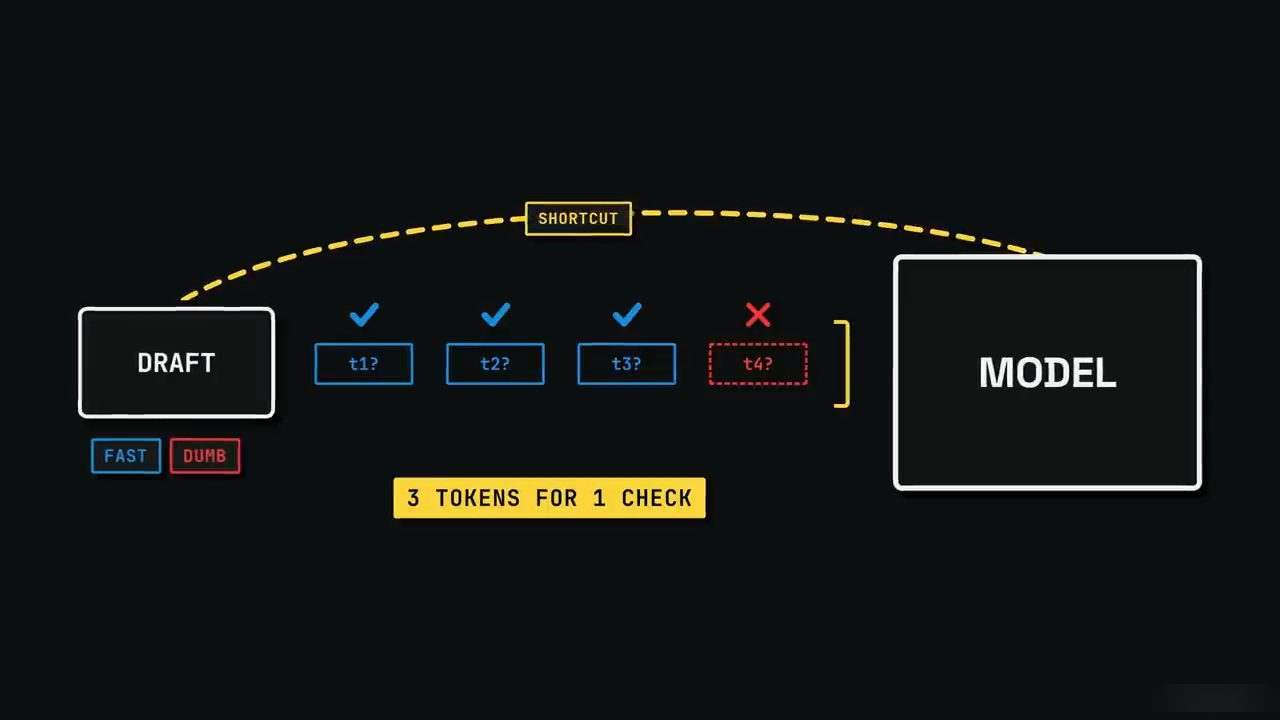
Theo Kai (video đăng ngày 08/11/2026), Ollama thêm draft model DFlash 2 trên MLX trong dòng phiên bản 0.40 vào cuối tháng 10 (năm 2026), và trang Qwen 3.8 trên website của Ollama liệt kê một tag 27B DFlash 2 NVFP4 nặng 19 GB. Trang release v0.40.12 trên GitHub, phát hành ngày 27/10, ghi "Speculative decoding now supports DFlash2 draft models on MLX" (đọc ngày 15/11/2026). Theo lời Kai, The Dark Factory phát hiện speculative decoding chạy mặc định và không có cách nào tắt.
Theo Kai (video đăng ngày 08/11/2026), điều đó thật sự ấn tượng, vì nó cho khoảng gấp đôi tốc độ viết trên một stream đơn ngay khi cài, không cần cấu hình gì. Vậy nên với một request, Ollama thật sự thắng, cả về thời gian ra token đầu tiên với prompt ngắn lẫn tốc độ viết bền vững, và draft đang làm việc thật ở đó.
12. Draft gấp đôi có bù được batching 2,7 lần không
Kai đặt câu hỏi (video đăng ngày 08/11/2026): lợi thế gấp đôi trên một stream đó có thật sự triệt tiêu được mức tăng 2,7 lần từ batching của LM Studio khi có bốn agent đang chạy không? Nói đại khái, trên giấy hai bên cùng tầm: draft của Ollama nhân đôi một stream, còn batching của LM Studio cho 2,7 lần output từ bốn stream.
Nhưng khác biệt then chốt mà phép tính không nắm được, theo Kai (video đăng ngày 08/11/2026), là trong LM Studio, sub-agent 4 không phải chờ sub-agent 1, 2 và 3; nó bắt đầu viết ngay trong cùng lượt, và trải nghiệm của người đang nhìn terminal hoàn toàn khác. Còn mức tăng gấp đôi của Ollama là theo từng stream, nên trong một hàng đợi nó làm hàng đợi bớt khổ một chút, nhưng không thay đổi sự thật rằng đó vẫn là một hàng đợi.
13. Splash: draft và batch trong cùng một chỗ
Trừ khi, tất nhiên, LM Studio cũng có một draft của riêng mình. Và kể từ ngày 19 tháng 9 (năm 2026), nó có (theo Kai, video đăng ngày 08/11/2026). Kai nói LM Studio 0.4 thêm một thứ gọi là Splash, từ một công ty tên Inco AI, như một backend thử nghiệm trên Mac. Changelog của LM Studio ghi bản 0.4.25, ngày 19/9/2026, "[Mac] Added support for the Splash engine on Apple Silicon M3 or newer running macOS 26.4 or newer" (đọc ngày 15/11/2026).
Theo Kai (video đăng ngày 08/11/2026), Splash được làm cho đúng hai model, Qwen3.6-35B và Qwen3.8-27B, và mỗi model đi kèm draft DFlash 2 riêng. Vậy là ta có cả phần tăng tốc speculative decoding từ draft lẫn continuous batching từ MLX engine của LM Studio ở cùng một chỗ.
Inco công bố số đo trên một máy M5 Pro 48 gigabyte, theo Kai (video đăng ngày 08/11/2026): Qwen3.8-27B đạt 74 token mỗi giây với một request ngắn đơn lẻ, và tổng cộng 170 khi có 4 stream chạy cùng lúc. Theo anh, đó là draft và batch cùng làm việc. Bài blog Splash Engine của LM Studio ngày 18/9/2026 ghi Splash là một inference engine mã nguồn mở của Inco AI, tối ưu riêng cho Qwen3.6-35B-A3B và Qwen3.8-27B, với 74 token mỗi giây trên prompt ngắn và 170 token mỗi giây khi có bốn request đồng thời, theo bài thử của Inco trên M5 Pro 48 GB (đọc ngày 15/11/2026).
Kai đặt hai cảnh báo lên các con số đó (video đăng ngày 08/11/2026). Thứ nhất, đó là số của chính Inco, và cùng bài đăng đó so với Ollama ở mức 24 token mỗi giây. Nhưng phép đo đó được làm trước Ollama 0.40 và trước khi Ollama có draft DFlash, nên con số của Ollama ở đó đã cũ, và phép so sánh không nên được tin theo mặt chữ.
Thứ hai, theo Kai (video đăng ngày 08/11/2026), Splash có yêu cầu phần cứng thật: chip M3 trở lên, macOS 26.4 trở lên, và ít nhất 36 GB bộ nhớ, khuyến nghị 48. Vậy nên trên một MacBook Air 16 GB, bạn sẽ không bao giờ thấy Splash, nó thậm chí không hiện ra như một lựa chọn. Nhưng trên một M5 Pro 48 GB hay bất cứ máy nào lớn hơn, theo anh mọi thứ trở nên thật sự thú vị, vì draft lo tốc độ của từng câu trả lời, còn batch lo throughput khi các agent chạy song song, nên ta không phải chọn một trong hai.
Một điểm dễ bỏ sót, theo Kai (video đăng ngày 08/11/2026): đây là một backend thử nghiệm. Nó không phải các model của Inco chạy trên server của LM Studio, mà là inference engine của Inco, Splash, có sẵn như một backend thay thế bên trong giao diện của LM Studio. Nếu muốn thử, nó nằm trong settings và được ghi rõ là experimental, nên hãy đối xử với nó như vậy. Theo anh, xu hướng ở đây là rõ ràng và chỉ đi theo một hướng (video đăng ngày 08/11/2026).
14. Context length và hai lệnh kiểm tra
Trước khi setup bất cứ thứ gì, Kai muốn nói về context length, vì theo anh cả hai app đều đã lặng lẽ "cắn" người dùng ở đây, và không app nào làm cho điều đó lộ rõ (video đăng ngày 08/11/2026). Context length là lượng văn bản một model giữ được trong bộ nhớ làm việc cùng lúc, gồm system prompt, toàn bộ hội thoại tới lúc đó, các tool call và kết quả tool.
Kai nói tài liệu của chính Claude Code ghi rằng riêng request đầu tiên đã có thể lên tới 33.000 token, và mỗi request sau đó lớn dần theo hội thoại; hình trong video ghi "TURN 1 33,000" với dòng nguồn "SOURCE: GIGAZINE" (video đăng ngày 08/11/2026). Theo Kai, Ollama đặt context length tự động dựa trên bộ nhớ có sẵn: 4.000 token dưới 24 gigabyte, và 32.000 giữa 24 và 48 gigabyte. Và tài liệu của chính Ollama nói các coding tool cần ít nhất 64.000. Trang Context length của Ollama ghi mặc định 4k dưới 24 GiB VRAM, 32k từ 24 tới 48 GiB, 256k từ 48 GiB trở lên, và rằng agent cùng coding tool nên được đặt ít nhất 64000 token (đọc ngày 15/11/2026).
Vậy chuyện gì xảy ra trên một máy 24 gigabyte chạy Claude Code? Theo Kai (video đăng ngày 08/11/2026), Ollama đang lặng lẽ cho ta một context window cỡ một nửa một request đơn, và mọi thứ bắt đầu bị cắt theo những cách khó hiểu và khó debug. Cách sửa rất thẳng: đặt context length của Ollama bằng tay. Nhưng phần lớn mọi người không biết phải làm vậy cho tới khi có gì đó sai một cách khó thấy, và họ mất hai tiếng tìm hiểu vì sao agent cứ quên mất context trước đó.
Và LM Studio cũng không an toàn, theo Kai (video đăng ngày 08/11/2026): có một bug report đang mở từ tháng 8 (năm 2026) về một MacBook Pro M4 24 GB. Tính năng AutoFit trong MLX engine của LM Studio phát hiện giới hạn bộ nhớ và lặng lẽ đặt context về 4096 token, ghi đè lên con số 24.576 mà người dùng đã gõ. Người dùng không để ý, và model cứ thế lặng lẽ ngắn lại. Trang issue #366 của repo mlx-engine, mở ngày 15/8/2026, vẫn Open, mô tả máy M4 24 GB nạp model với --context-length 24576 và lms ps hiện context 4096 (đọc ngày 15/11/2026).
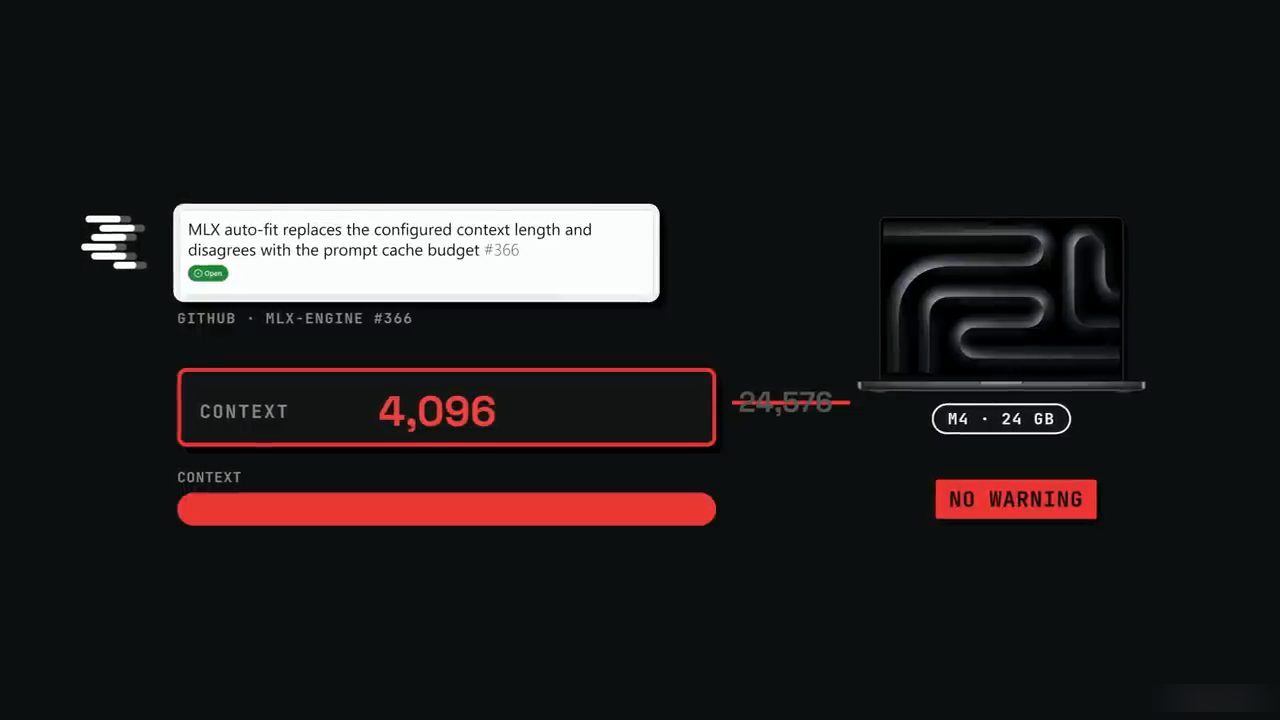
Theo Kai (video đăng ngày 08/11/2026), trong LM Studio, bước kiểm là chạy lms ps trong terminal sau khi nạp model và xác nhận context length thực sự được nạp khớp với cái bạn cấu hình. Còn trong Ollama, ta gửi một request rồi chạy ollama ps, lệnh này hiện context mà model được nạp cùng. Vậy là hai lệnh, và theo anh chúng đáng chạy mỗi lần ta thử một model mới hoặc cập nhật app.
15. Bản GGUF dư và từng mức RAM của Mac
Còn một cái bẫy nữa mà Kai nói anh phát hiện theo cách khó khăn (video đăng ngày 08/11/2026). Ollama 0.40 chuyển các model GGUF cũ sang định dạng mới của nó ở chế độ nền vào lần đầu bạn nạp chúng, và giữ file gốc bên cạnh bản đã chuyển. Một người dùng đếm được khoảng 20,6 gigabyte dư chỉ với bốn model. Vậy nên nếu dung lượng ổ đĩa của bạn cứ dần biến mất, theo Kai đó có thể là lý do. Và một khi chắc là không cần các bản gốc nữa, bạn có thể dọn chúng khỏi thư mục models của Ollama.
Theo Kai (video đăng ngày 08/11/2026), câu trả lời đúng thật sự phụ thuộc vào máy Mac bạn có, nên anh đi qua từng mức bộ nhớ.
16 hoặc 24 gigabyte, tức một MacBook Air hoặc MacBook Pro bản đầu vào. Theo Kai (video đăng ngày 08/11/2026), Qwen3.8-27B nặng 18 GB thậm chí không vừa trong 16 GB ở một mức quantization dùng được, nên ta ở với các model nhỏ hơn hoặc quantization nặng; còn ở 24 GB thì về kỹ thuật nó vừa, nhưng gần như không còn chỗ cho một context dài bên cạnh. Ở mức này batching gần như không giúp gì, vì không đủ bộ nhớ để chạy nhiều hội thoại dài cạnh model, nên câu hỏi song song gần như không bao giờ nảy ra trong thực tế. Ở đây, theo anh, tốc độ một stream và speculative decoding của Ollama thật sự là lựa chọn đúng, nên hãy chọn app bạn thích dùng. Và nếu bạn thích CLI và mã nguồn mở, Ollama là câu trả lời, và phần lớn video này không thật sự áp dụng cho bạn.
32 gigabyte, gồm MacBook Pro M4 hoặc M5 và Mac mini M5 hoặc M6. Theo Kai (video đăng ngày 08/11/2026), ta ở vùng giữa: Qwen 3.8 vừa, Ollama cho 32.000 token context, và có thể có chỗ cho hai hội thoại chạy cùng lúc. Splash nằm ngoài tầm với ở đây. Bạn sẽ thấy chút lợi ích từ batching của LM Studio nếu chạy agent nhiều, nhưng lợi thế draft của Ollama trên request đơn vẫn có ý nghĩa, nên anh sẽ thử cả hai và xem cái nào thấy nhanh hơn trong workflow thật của bạn.
48 tới 64 gigabyte, tức một M5 Pro hoặc mức Mac mini cao hơn. Theo Kai (video đăng ngày 08/11/2026), Splash trở nên khả dụng, và có chỗ thật cho nhiều context dài bên cạnh model. Đây là nơi LM Studio bắt đầu vượt lên thấy rõ với bất cứ ai chạy agent, vì khoảng cách batching trở nên thật và ổn định. Với bất kỳ việc coding agent nghiêm túc nào ở mức này, LM Studio với MLX và Splash là setup anh khuyến nghị mà không do dự.
96 tới 128 gigabyte, trên M5 Max hoặc M5 Ultra. Theo Kai (video đăng ngày 08/11/2026), có đủ chỗ để mọi sub-agent mà Claude Code từng tách ra giữ một context đầy 64.000 token cùng lúc, và một hàng đợi lãng phí một lượng thật sự đáng xấu hổ của những gì bạn đã trả tiền. Đây đúng là phần cứng mà khác biệt 5,4 lần từ bài thử dịch thể hiện rõ nhất.
256 gigabyte trở lên, trên M5 Ultra hoặc, theo lời anh, M5 Ultra Max. Theo Kai (video đăng ngày 08/11/2026), nên nhớ rằng bài thử dịch đã xem chạy trên M5 Ultra với 96 GB và với 256 GB, và khoảng cách giữ ở 5,4 lần và 3 lần tương ứng. Nên nếu bạn ở mức này mà dùng Ollama với thiết lập mặc định cho việc agent, anh cho phép bạn hơi bực mình thay cho chiếc thẻ tín dụng của bạn.
16. Cài từng app cho agent
Kai đi qua các bước setup thật cho từng app, để không có gì lặng lẽ quay về một mặc định tệ sau khi cập nhật (video đăng ngày 08/11/2026).
LM Studio. Theo Kai (video đăng ngày 08/11/2026), hãy tải bản MLX của model thay vì GGUF. Khi nạp model, bật manual load parameters và mở advanced settings, nơi có max concurrent predictions, tức trần batching của bạn; có thể để 4 hoặc nâng lên tuỳ bộ nhớ, và đặt context length trong cùng panel đó. Rồi trước khi làm gì khác, chạy lms ps trong terminal và kiểm context length trong output khớp với cái bạn đã gõ, vì với bug auto-fit, có thể nó không khớp. Nếu không khớp, quay lại kiểm thiết lập bộ nhớ và quantization của model. Trang Parallel Requests trong docs của LM Studio ghi các bước bật "Manually choose model load parameters", "Show advanced settings" và Max Concurrent Predictions mặc định là 4 (đọc ngày 15/11/2026).
Theo Kai (video đăng ngày 08/11/2026), nếu phần cứng đủ điều kiện và bạn muốn thử Splash, vào settings, chuyển backend sang Splash và nạp lại model; bước kiểm context giống hệt cũng áp dụng.
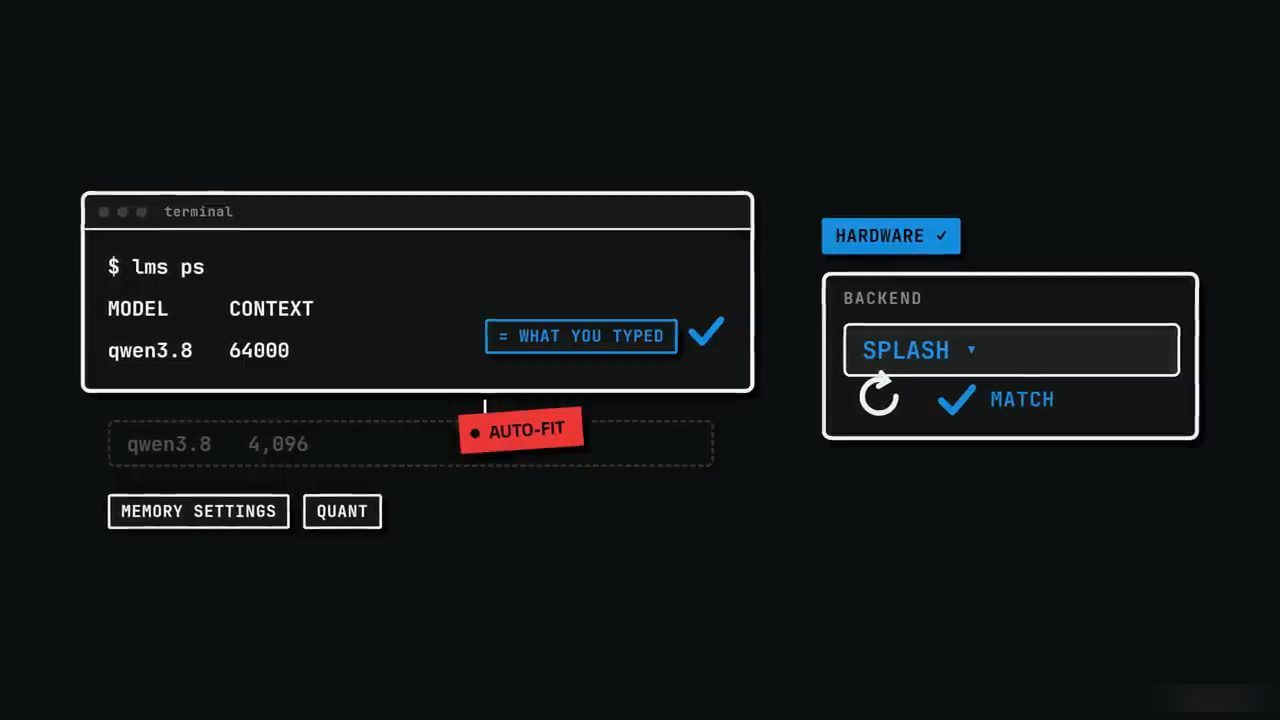
$ lms ps cho dòng "qwen3.8 64000" với nhãn "= WHAT YOU TYPED"; bên dưới là dòng mờ "qwen3.8 4,096" gắn nhãn đỏ "AUTO-FIT", hai thẻ "MEMORY SETTINGS" và "QUANT"; bên phải "HARDWARE ✓" và khung "BACKEND: SPLASH" với "MATCH" (video đăng ngày 08/11/2026).Ollama. Theo Kai (video đăng ngày 08/11/2026), app Ollama trên Mac đọc biến môi trường từ launchctl chứ không từ session terminal của bạn, và điều này liên tục làm người ta vấp. Nên nếu bạn đặt giá trị 4 trong terminal trước khi chạy Ollama, nó không làm gì cả, vì launchctl đã khởi chạy app mà không có biến đó. Để đặt đúng, theo lời anh, chạy lệnh sau rồi khởi động lại Ollama:
launchctl setenv OLLAMA_CONTEXT_LENGTH 64000
Trang FAQ của Ollama ghi rằng khi Ollama chạy như một app macOS, biến môi trường được đặt bằng launchctl setenv rồi khởi động lại app; trang Context length dùng tên biến OLLAMA_CONTEXT_LENGTH (đọc ngày 15/11/2026). Theo Kai (video đăng ngày 08/11/2026), nếu bạn tự chạy ollama serve trong một terminal, hãy đặt các biến ngay trước lệnh trên cùng một dòng. Sau khi nạp model và gửi một request, chạy ollama ps, lệnh này hiện context mà model thực sự được nạp cùng. Nếu nó ghi 4000 khi bạn muốn 64000, biến đã không tới được app, và đó là thứ đầu tiên cần sửa.
Nếu bạn cần parallel request và không ngại đổi một phần tốc độ một stream, theo Kai (video đăng ngày 08/11/2026), hãy kéo bản GGUF của model, kiểu Q4 hoặc tương tự, rồi đặt OLLAMA_NUM_PARALLEL qua launchctl như trên; model GGUF sẽ chạy trên llama.cpp, nơi cờ parallel thật sự có tác dụng. Hai lệnh trên màn hình:
$ ollama pull model:Q4_K_M
$ launchctl setenv OLLAMA_NUM_PARALLEL 4
Cuối cùng, theo Kai (video đăng ngày 08/11/2026), kiểm Activity Monitor hoặc ps trong Terminal khi model đang được nạp: mlx-engine trong process runner nghĩa là bạn đang ở trên MLX, còn một thứ có chữ llama trong đó nghĩa là bạn đang ở trên GGUF. Theo anh, đáng biết mình đang ở "thế giới" nào, vì các thiết lập chạy được ở thế giới này không chạy ở thế giới kia, và năm phút setup đáng giá hơn việc vài tuần lại đổi app một lần với hy vọng có gì đó đã thay đổi.
17. Kết luận: đếm số agent của bạn
Sau tất cả những điều trên, đây là kết luận thật sự của Kai (video đăng ngày 08/11/2026). Với việc dùng một chat, Ollama thật sự là app tốt hơn vào lúc làm video, vì speculative decoding của nó cho khoảng gấp đôi tốc độ viết trên Qwen 3.8 ngay khi cài, và nó ra chữ đầu tiên nhanh nhất với prompt ngắn trong các benchmark cẩn thận. Nó là mã nguồn mở MIT, chạy headless như một server nền, và có một lệnh nối nó thẳng vào Claude Code. Nên với một cửa sổ chat đang mở và chính bạn gõ, theo anh Ollama là lựa chọn đúng.
Nhưng với việc dùng agent trên các máy Mac lớn hơn, tức mọi máy từ M5 Pro trở lên với 48 gigabyte hoặc hơn, theo Kai (video đăng ngày 08/11/2026) LM Studio là câu trả lời, và không hề sát nút. Continuous batching trên MLX nghĩa là mọi sub-agent song song bắt đầu viết gần như ngay lập tức thay vì xếp hàng, và nếu bạn chạy được Splash, bạn có cả draft lẫn batch. Theo anh, khác biệt 5,4 lần từ bài thử ngoài đời thật không phải ăn may; đó là điểm đến hợp lý của continuous batching khi chạy ở quy mô lớn.
Vậy nên, theo Kai (video đăng ngày 08/11/2026), trước khi chọn, câu hỏi cần đặt ra rất đơn giản: có bao nhiêu thứ sẽ hỏi máy Mac của tôi cùng một lúc? Nếu câu trả lời là một, tức là bạn trong một cửa sổ chat, thì Ollama. Nếu câu trả lời là bốn hoặc hơn, với Claude Code chạy sub-agent, OpenCode, hoặc bất kỳ agent nào tách việc ra, thì LM Studio trên một máy Mac đủ mạnh. Còn trên một máy Mac 16 hoặc 24 GB, phần lớn chuyện này chưa áp dụng, nên hãy dùng Ollama và tận hưởng tốc độ.
18. Tình hình chưa đứng yên, và cách tự kiểm prompt cache
Kai muốn nói thêm một điều: tình hình này không đứng yên (video đăng ngày 08/11/2026). Issue 17280 của Ollama vẫn đang mở, và phần hỗ trợ GGUF song song mà Ollama thêm vào tháng 11 (năm 2026) cho thấy họ đang làm việc theo hướng đó. Nên tới lúc bạn xem, mọi thứ có thể đã thay đổi. Theo anh, thói quen đúng là đọc release notes mỗi khi có một bản cập nhật lớn, kiểm lại thiết lập bằng ollama ps và lms ps, và không mặc định rằng mọi thứ chạy chỉ vì bạn đã đặt chúng một lần từ sáu tháng trước.
Theo Kai (video đăng ngày 08/11/2026), máy Mac bạn có thật sự tuyệt vời, các model bạn chạy được trên đó thật sự hữu ích, và các mặc định của app đứng trước chúng là thứ duy nhất ngăn giữa bạn và việc dùng hết những gì máy có. Nên đừng để các mặc định đó thắng.
Anh cảm ơn người xem đã theo tới cuối, vì đây là một chủ đề dày đặc và anh có thể làm nó dài gấp ba. Còn cả một hang thỏ về prompt caching và chuyện các request ở lượt thứ hai có trúng cache đúng cách không, mà anh chưa hề đi vào (video đăng ngày 08/11/2026).
Nếu muốn tự kiểm cache đó, theo Kai (video đăng ngày 08/11/2026): chạy ollama run với cờ verbose, gửi một tin nhắn dài, rồi gửi một câu hỏi tiếp ngắn và so sánh prompt eval count. Nếu con số thứ hai nhỏ, cache của bạn đang hoạt động. Nhưng nếu cả hai lần đều là cùng một con số lớn, model của bạn đang đọc lại toàn bộ hội thoại ở mỗi lượt, và theo anh đó là rất nhiều thời gian và băng thông bộ nhớ bị lãng phí. Lệnh trên màn hình:
$ ollama run qwen3.8 --verbose
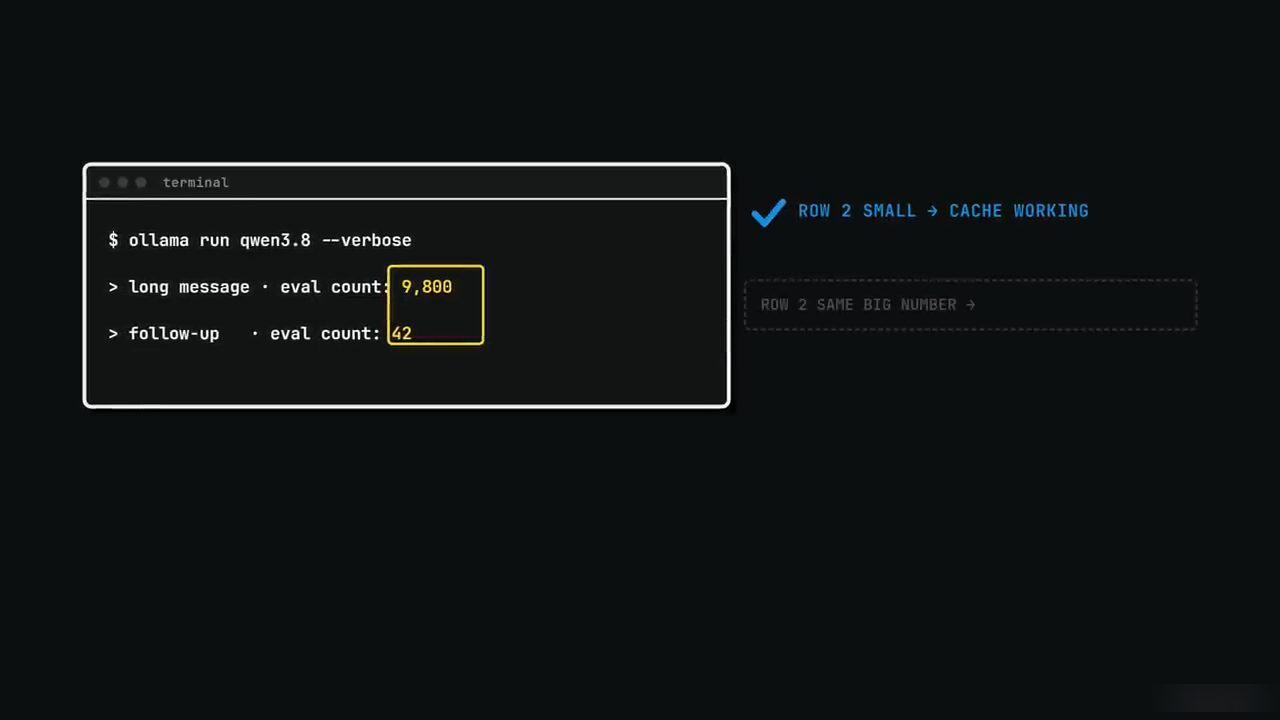
$ ollama run qwen3.8 --verbose, dòng "long message · eval count: 9,800" và "follow-up · eval count: 42"; bên phải "ROW 2 SMALL → CACHE WORKING" và dòng mờ "ROW 2 SAME BIG NUMBER →" (video đăng ngày 08/11/2026).Nguồn và liên kết 15 nguồn
- Tên gốc: I Tested Local AI on My Mac Studio So You Don't Have To
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=JLs10oOX6NY youtube.com
- Kênh YouTube Kai (Kai): youtube.com/channel/UCgUfJoPtkt7-RiiuYh4vmGA youtube.com
- Release notes Ollama v0.40.0, phát hành ngày 25/9, mục "Models run on MLX on Apple Silicon by default" (đọc ngày 15/11/2026): github.com/ollama/ollama/releases/tag/v0.40.0 github.com
- Release notes Ollama v0.40.12, phát hành ngày 27/10, "Speculative decoding now supports DFlash2 draft models on MLX" (đọc ngày 15/11/2026): github.com/ollama/ollama/releases/tag/v0.40.12 github.com
- Release notes Ollama v0.40.15, phát hành ngày 3/11, "Recurrent and vision GGUF models can now serve more than one request at a time" (đọc ngày 15/11/2026): github.com/ollama/ollama/releases/tag/v0.40.15 github.com
- Issue Ollama #17280, concurrent requests / continuous batching trong MLX engine, mở ngày 21/7/2026, trạng thái Open (đọc ngày 15/11/2026): github.com/ollama/ollama/issues/17280 github.com
- FAQ của Ollama:
OLLAMA_NUM_PARALLELmặc định 1, và đặt biến môi trường trên Mac bằnglaunchctl setenv(đọc ngày 15/11/2026): docs.ollama.com/faq docs.ollama.com - Context length của Ollama: mặc định theo VRAM và mức ít nhất 64000 token cho agent và coding tool (đọc ngày 15/11/2026): docs.ollama.com/context-length docs.ollama.com
- Blog LM Studio "Improving LM Studio's MLX Engine for Agentic Workflows", ngày 5/6/2026, có benchmark 37,60 giây và 16,78 giây trên M3 Max 36 GB (đọc ngày 15/11/2026): lmstudio.ai/blog/mlx-engine-agentic-workloads lmstudio.ai
- Docs Parallel Requests của LM Studio: Max Concurrent Predictions mặc định là 4; trang này vẫn ghi MLX là "coming soon" (đọc ngày 15/11/2026): lmstudio.ai/docs/app/advanced/parallel-requests lmstudio.ai
- Changelog LM Studio, bản 0.4.25 ngày 19/9/2026 thêm Splash engine (đọc ngày 15/11/2026): lmstudio.ai/changelog/lmstudio lmstudio.ai
- Blog LM Studio "Splash Engine", ngày 18/9/2026, với yêu cầu M3 trở lên, macOS 26.4 trở lên, ít nhất 36 GB (đọc ngày 15/11/2026): lmstudio.ai/blog/splash-engine lmstudio.ai
- Issue mlx-engine #366, "MLX auto-fit replaces the configured context length and disagrees with the prompt cache budget", mở ngày 15/8/2026 (đọc ngày 15/11/2026): github.com/lmstudio-ai/mlx-engine/issues/366 github.com
Related talks
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.
Sáu skill Claude Code đáng dùng nhất sau hơn 100 skill đã thử
Tim Ruscica · Tech With Tim · 19 min
Cài và dùng thử sáu skill cho Claude Code: gstack, Hostinger MCP, Firecrawl, Humanizer, Composio và VibeSec, mỗi cái một demo thật.
10 plugin Claude Code đáng dùng cho project tiếp theo
Chase Hannegan · Chase AI · 12 min
Mười plugin, skill và CLI mới cho Claude Code: Graphify, grill-me, review plan bằng Codex, Obsidian, CLAUDE.md, Impeccable, NotebookLM, n8n MCP.