Medic for Apache Spark: First Aid for Failing Jobs
AI Engineer World's Fair 2026: Online Track · Video gốc
Pinterest xây agent chẩn đoán Spark job fail: MCP, E2E test harness record/playback, lọc exception, metrics thành hình, rồi multi-agent trên deepagents.
1. Medic là gì và talk đi qua những gì
Drasko Profirovic là staff engineer tại Pinterest. Talk này nói về Medic for Apache Spark, một agentic diagnostics tool mà team của anh xây để troubleshoot các Spark job bị fail. Anh hứa đi qua bốn phần: vì sao họ xây Medic, hành trình từ prototype tới architecture hiện tại, những bài học rút ra dọc đường, và điều gì sẽ đến tiếp theo.
2. Vì sao cần Medic: support rotation không bao giờ dứt
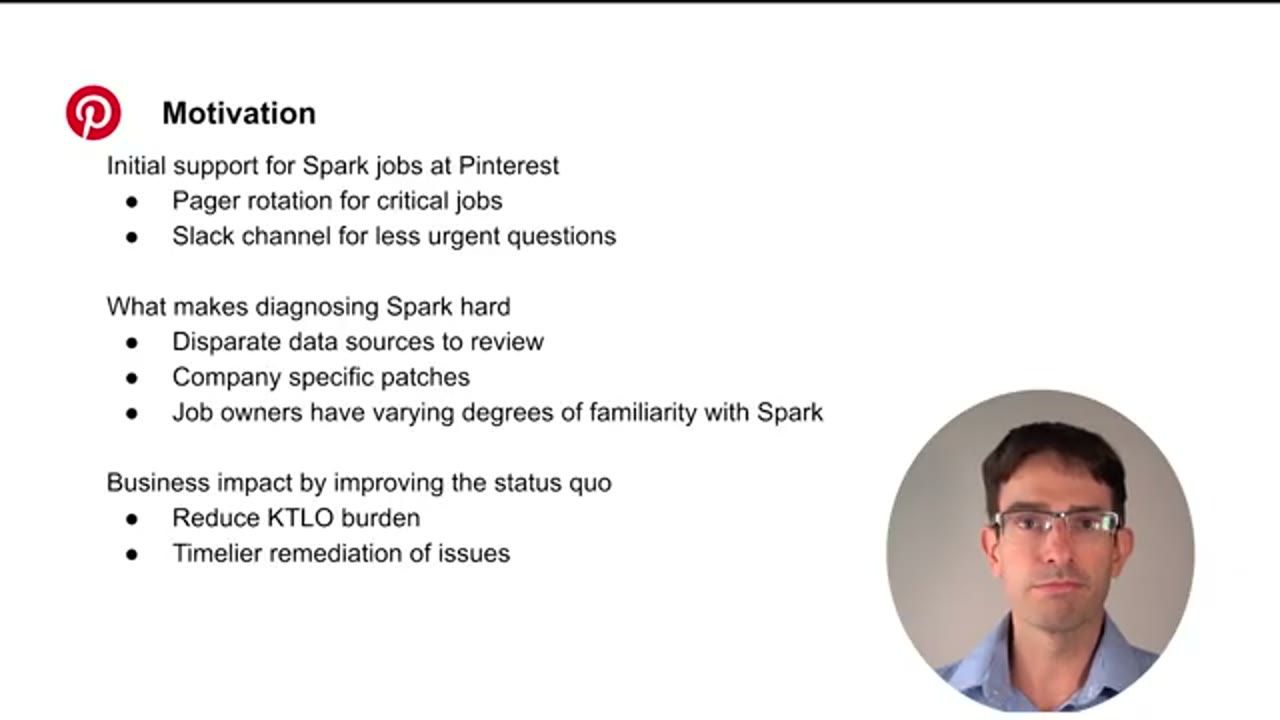
Trước khi vào kỹ thuật, Drasko kể một chút về bản thân. Anh đã làm ở vài công ty, lần nào cũng nằm trong data platform org. Các công ty đó khác nhau nhiều mặt, nhưng có ít nhất một điểm giống nhau: tiêu chuẩn rất cao cho chuyện support các partner team, tức những team phụ thuộc vào hạ tầng mà data platform org sở hữu.
Anh nói chắc mình không phải người duy nhất thấy support rotation giống một dòng câu hỏi và sự cố không bao giờ cạn. Thêm nữa, người ta rất dễ quên việc troubleshoot Spark khó tới mức nào, hay troubleshoot bất kỳ distributed system nào cũng vậy. Điều này càng đúng với người mới bắt đầu dùng framework.
Thách thức thứ hai khi support một hệ thống "load-bearing" (hệ thống mà nhiều thứ khác đè lên) là ưu tiên mơ hồ. Mình nên giúp một team có job đang fail, hay gỡ chặn cho một team khác đang sát deadline? Không phải lúc nào cũng xếp hạng được những yêu cầu này một cách rõ ràng, nhưng là con người, mình thường buộc phải chọn sẽ dành thời gian cho việc nào. Với LLM thì không như vậy: mình có thể scale out kiến thức và năng lực theo nhu cầu.
3. North Star: hỏi "vì sao job fail" và nhận về một báo cáo có bằng chứng
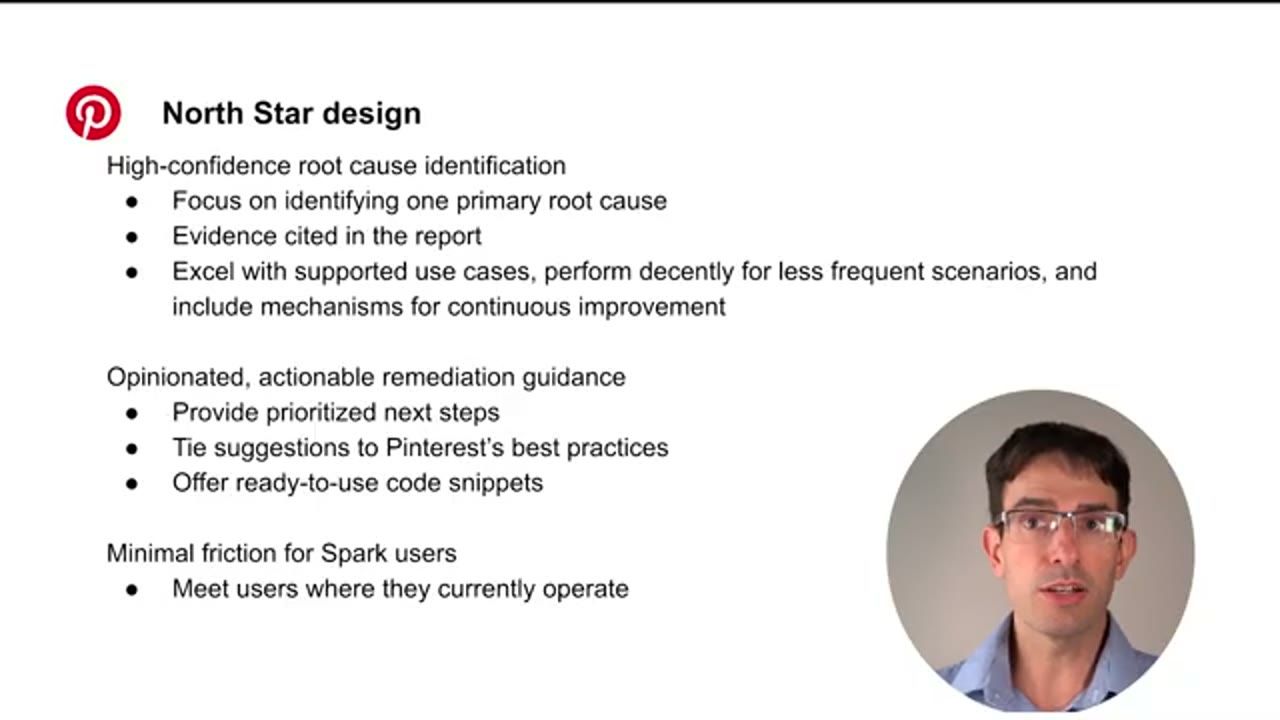
Tầm nhìn của team cho một diagnostics agent rất đơn giản: chỉ cần hỏi nó "Why did a job fail?", và nhận về một tài liệu kiểu deep research, đưa ra bằng chứng về root cause của lần fail đó. Agent cũng phải đề xuất cách sửa, và các đề xuất này phải grounded trong context của chính job đó, không phải lời khuyên chung chung.
Không cần nói cũng biết, agent này phải có mặt ở mọi nơi người dùng đang làm việc hôm nay, chẳng hạn Slack hay giao diện Airflow UI, và còn vài chỗ khác nữa.
4. Prototype: MCP server làm nền, rồi một ReAct agent
Bước đầu tiên là expose các nguồn dữ liệu của team qua Model Context Protocol (MCP), để nối chúng vào LLM. Tới đây, họ đã có thể mở một cuộc hội thoại với LLM, bật các MCP tool, rồi bảo model suy luận về Spark job. Cách này chạy được trong thực tế, nhưng đòi hỏi người vận hành phải prompt rất cẩn thận.
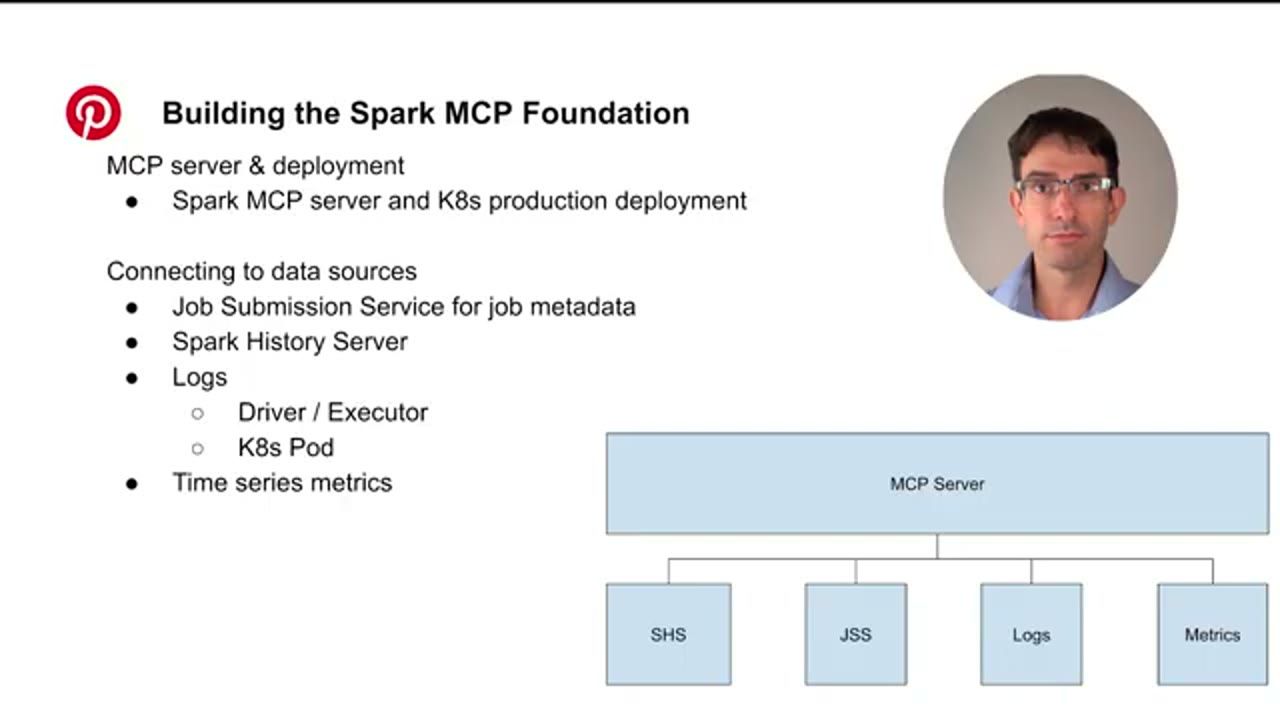
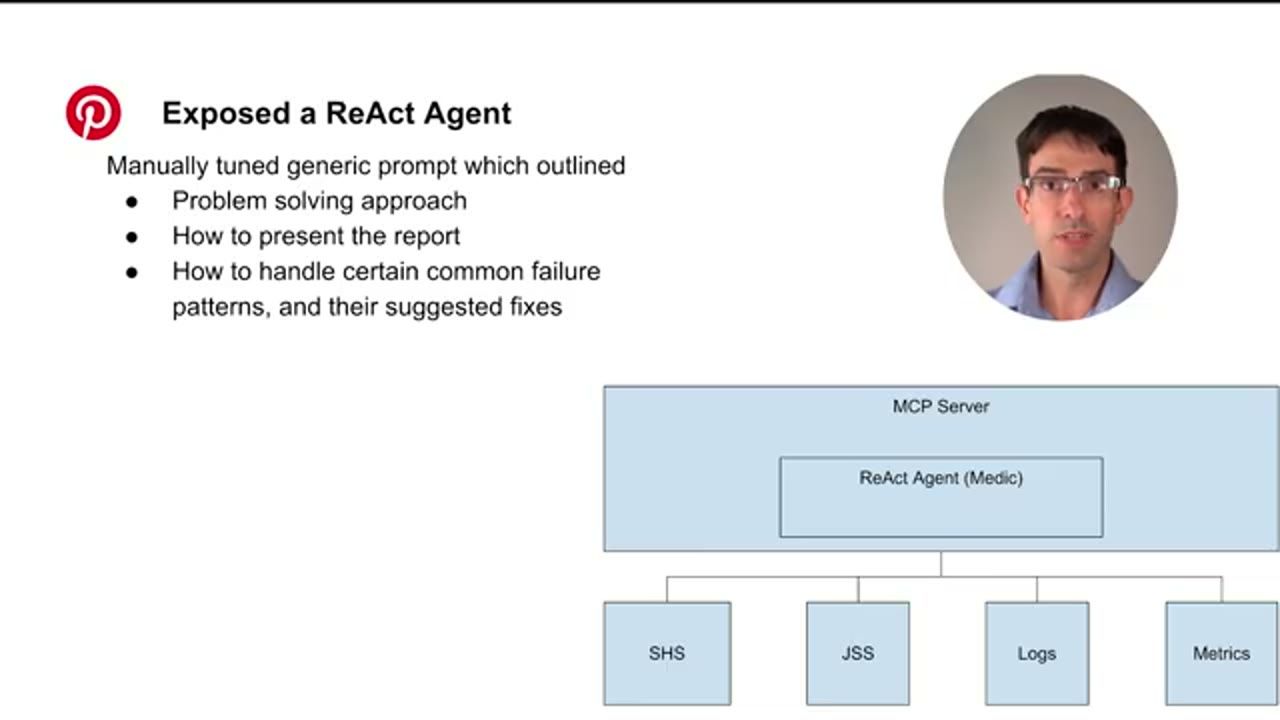
Họ mở rộng prototype bằng cách tạo một single reasoning and acting agent, gọi tắt là ReAct. Agent nhận một prompt duy nhất, trong đó gói cả cách tiếp cận giải quyết vấn đề mà nó sẽ đi theo, cách trình bày câu trả lời thành một báo cáo, và các ví dụ cụ thể cho những failure pattern thường gặp.
5. Beta users chỉ ra những gì chưa ổn
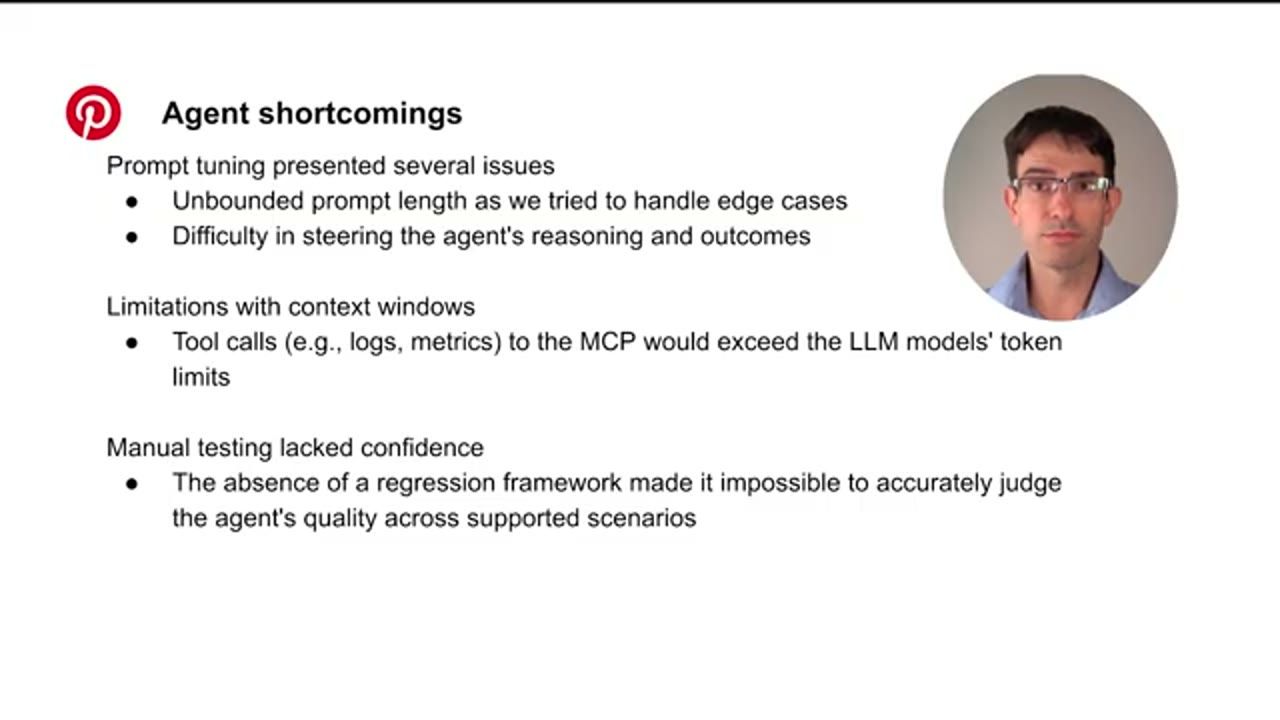
Tới lúc này team đã có đủ năng lực để cho beta users dùng thử. Và từ những lần thử đầu tiên đó, họ thấy rất nhiều thiếu sót:
- Prompt tuning không còn bền vững. Một prompt phải làm mọi thứ, nên thêm chi tiết ở một mảng lại làm hành vi ở mảng khác tệ đi.
- Chất lượng câu trả lời không đều. Có lúc phân tích nông, có lúc lại dài dòng quá mức.
- Thiếu cơ chế kiểm soát để giữ agent đi đúng hướng.
- Thường xuyên đụng giới hạn context window với các job production. Ví dụ, output lớn từ tool đọc logs ngốn token rất nhanh và làm quá trình suy luận của agent dừng hẳn.
- Chiến lược test end-to-end cho tới lúc đó dựa vào test thủ công trên production. Cảm giác rất cảm tính, vì dữ liệu production sẽ bị xoá theo retention. Nói chung, rất khó biết một thay đổi có làm hỏng những gì đã từng chạy tốt hay không.
6. Observability và testability: trace trên Langfuse, E2E test harness với record và playback
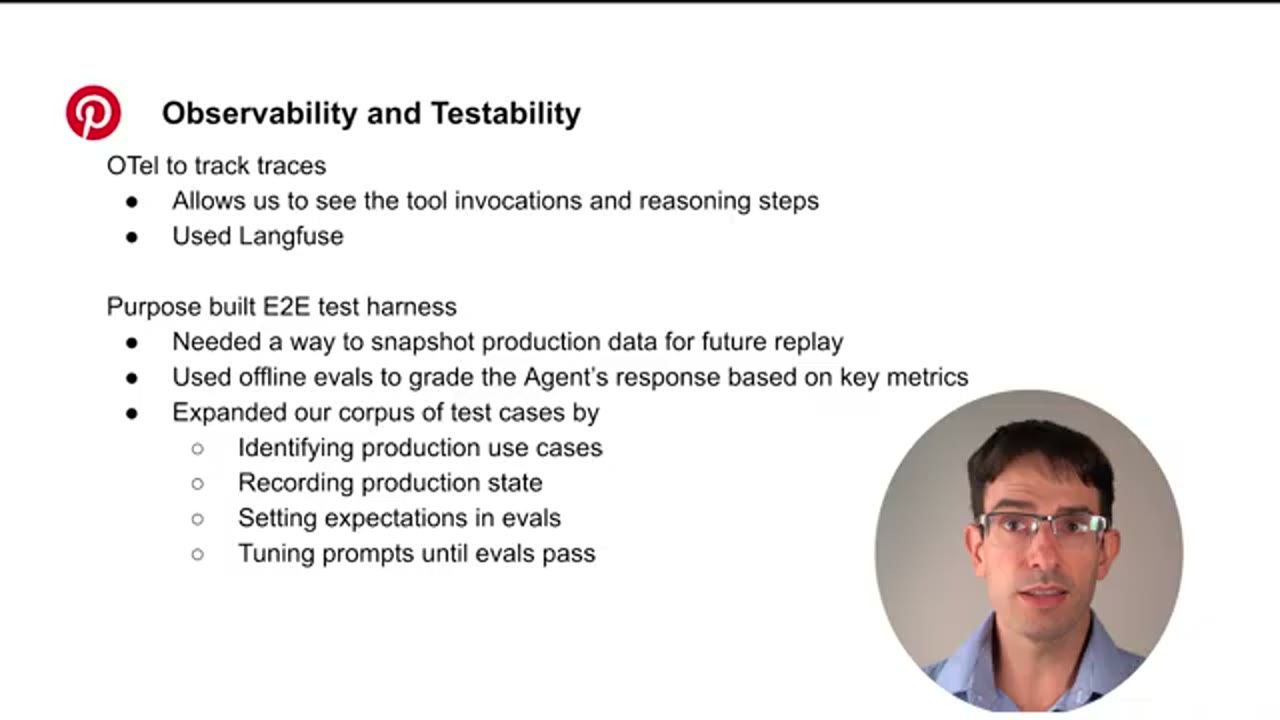
Để cải thiện hệ thống, team đầu tư vào hai thứ: observability và testability.
Về observability, họ dùng OpenTelemetry để publish trace lên Langfuse. Khi nhìn quá trình chạy của agent thành một biểu đồ waterfall gồm từng bước, họ hiểu rõ hơn nguyên nhân của những câu trả lời chất lượng thấp.
Về testability, việc phụ thuộc vào test end-to-end thủ công cho thấy họ cần một giải pháp tin cậy hơn và scale được. Team xây một end-to-end test harness để snapshot trạng thái production, và từ đó có thể codify kỳ vọng thành các offline eval. Cuối cùng, điều này cho phép họ tune prompt dựa trên kết quả eval.
Trên thực tế, harness này rất đơn giản. Nó có hai chế độ:
- Record mode: agent gọi các hệ thống downstream thật, và response của các tool được bắt lại thành fixture. Fixture được lưu xuống file system và check in như code.
- Playback mode: agent chạy trên fixture thay vì dữ liệu production, nhưng lần này nó thực sự phân tích và sinh báo cáo. Sau đó test suite chấm báo cáo dựa trên các offline eval mà team đã viết.
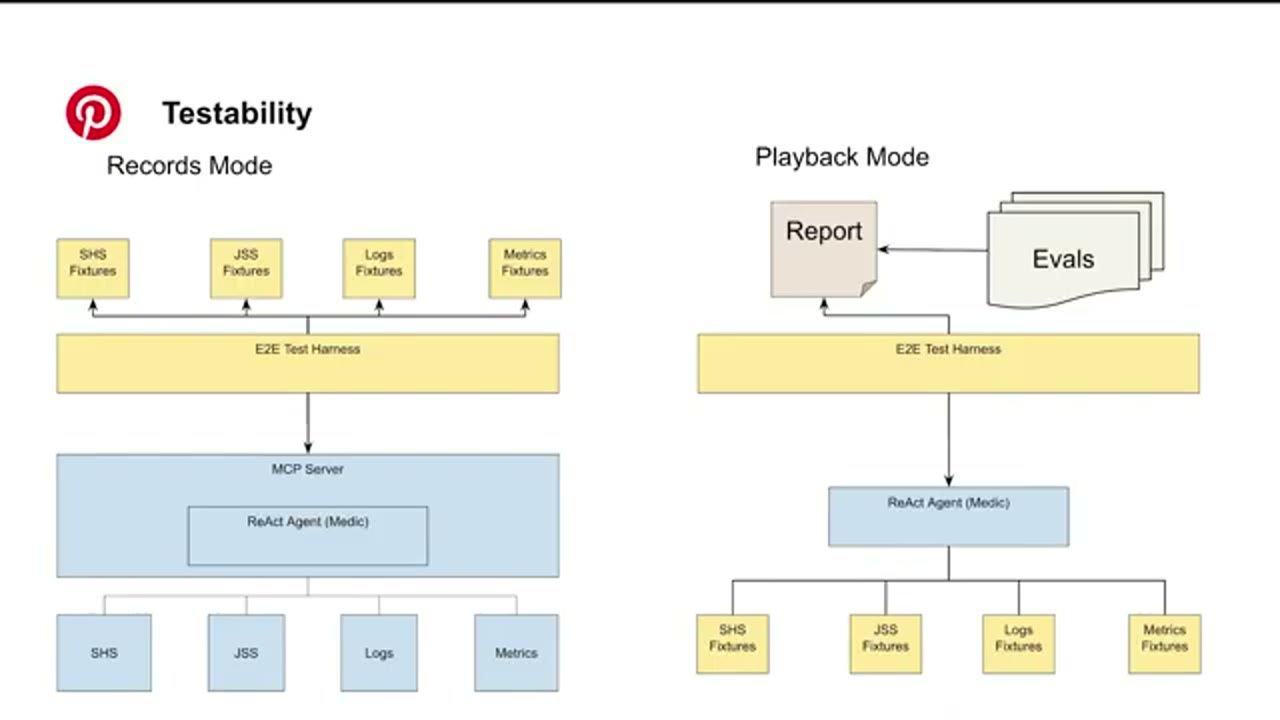
Ví dụ, một offline eval có thể kiểm tra giới hạn tối đa ba cách sửa đề xuất. Nếu agent đưa quá nhiều cách sửa, eval sẽ cho điểm thấp hơn, như một cách kiểm soát độ dài dòng của báo cáo cuối cùng.
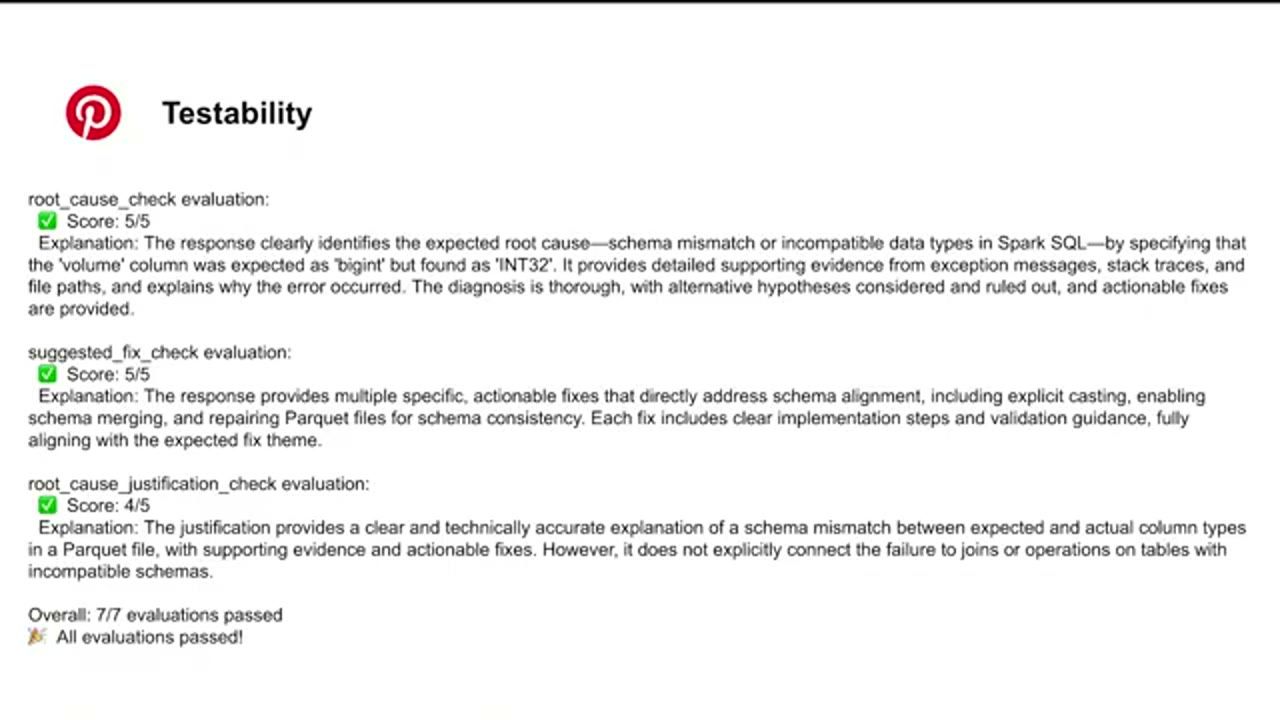
root_cause_check 5/5 (báo cáo xác định đúng root cause là schema mismatch, cột volume lẽ ra là bigint nhưng gặp INT32), suggested_fix_check 5/5 (các cách sửa như cast tường minh, bật schema merging, sửa lại các file Parquet), và root_cause_justification_check 4/5 (giải thích đúng nhưng chưa nối lỗi với các phép join trên bảng có schema không tương thích). Dòng tổng: 7/7 evaluations passed.Test end-to-end giúp team định lượng chất lượng thay vì dựa vào trực giác. Và khi test coverage tăng dần, họ ngày càng tự tin rằng các cải tiến không kéo theo regression.
7. Xử lý logs: exception classifier pipeline
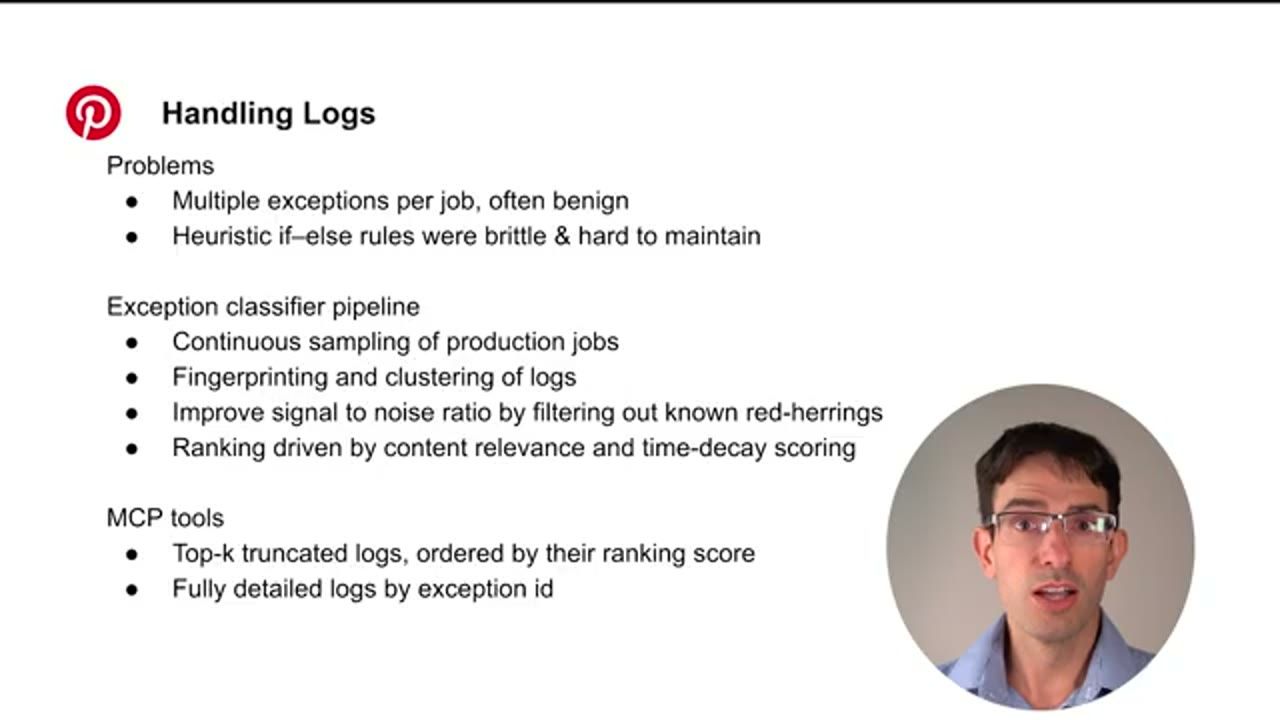
Khi đã có test coverage, team đầu tư sâu hơn vào cách xử lý logs. Logs rất nhiễu, và nhiều exception xuất hiện trong logs là vô hại, nên chỉ nhìn vào exception cuối cùng chưa chắc đã đúng.
Ban đầu họ giữ cho đơn giản bằng một cách tiếp cận dựa trên heuristics: dùng regex để lọc bỏ một số exception. Nhưng cách này không scale tốt.
Thay vào đó, họ xây exception classifier pipeline. Ý tưởng cốt lõi: học xem exception nào thường xuyên xuất hiện cả trong các job thành công, coi chúng là những red herring (manh mối đánh lạc hướng) nhiều khả năng vô hại, và lọc chúng ra khỏi các lần phân tích sau. Agent sẽ fingerprint và cluster các exception, rồi xếp hạng chúng dựa trên mức độ liên quan của nội dung và mức độ gần về thời gian so với lúc job kết thúc.
Agent không còn đọc logs trực tiếp nữa. Thay vào đó nó được cấp hai MCP tool:
- lấy top-K exception đã được cắt ngắn;
- lấy log chi tiết đầy đủ cho một exception cụ thể.
Kết quả là signal-to-noise ratio được cải thiện, và giảm khả năng LLM "neo" cả cuộc điều tra vào một exception gây hiểu lầm.
8. Xử lý metrics: biến time series thành hình, phân tích trong sub-agent cách ly
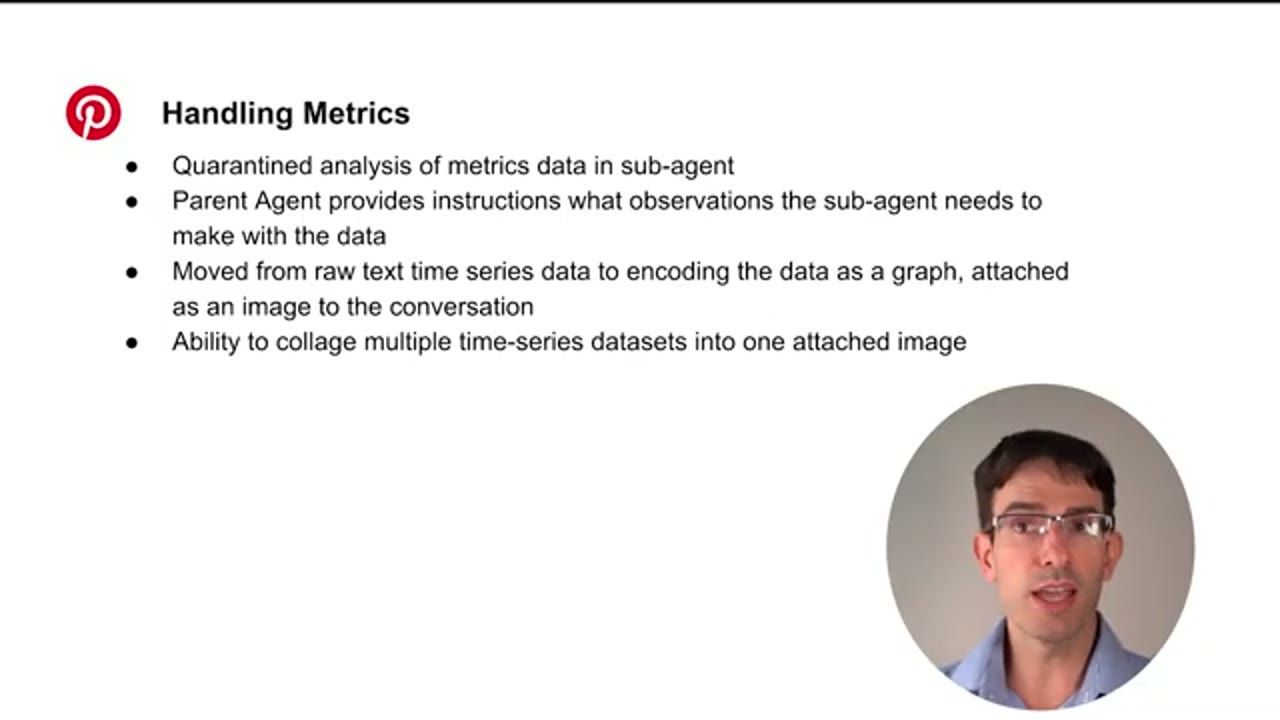
Giống như logs, team nhận ra họ có thể nâng chất lượng chung bằng cách đầu tư vào cách xử lý metrics. Raw time-series metrics không thân thiện với context window. Đưa thẳng dữ liệu thô cho LLM chạy được ở quy mô nhỏ, nhưng thất bại với các job chạy lâu trên production. Chưa kể, cách đó tốn token một cách khủng khiếp.
Cách họ chọn là làm phần phân tích metrics trong một sub-agent cách ly (quarantine sub-agent). Dữ liệu time series thô được chuyển thành các đồ thị, rồi ghép lại thành một hình cuối cùng. Hình này trông không khác một dashboard Grafana là mấy, chỉ thêm vài chú thích mà team thấy hữu ích, như đánh dấu giá trị min và max. Hình được đính vào cuộc hội thoại với LLM, và model được prompt để suy luận về các pattern trong dữ liệu.
Hình ảnh hiệu quả hơn vì team có thể đảm bảo số input token dùng để phân tích bất kỳ Spark job nào, bất kể job đó chạy bao lâu. Những tín hiệu hữu ích mà cách này bắt được gồm: số executor tụt về không hoặc gần không, những đoạn plateau dài hay nút cổ chai, và nói chung mọi hành vi tài nguyên không khớp với một tiến trình đang chạy khoẻ mạnh.
Sub-agent tóm tắt những gì nó tìm thấy rồi trả kết quả về agent cha, nhờ vậy context window của agent cha luôn được giữ gọn.
9. Từ một agent sang multi-agent trên Deep Agents
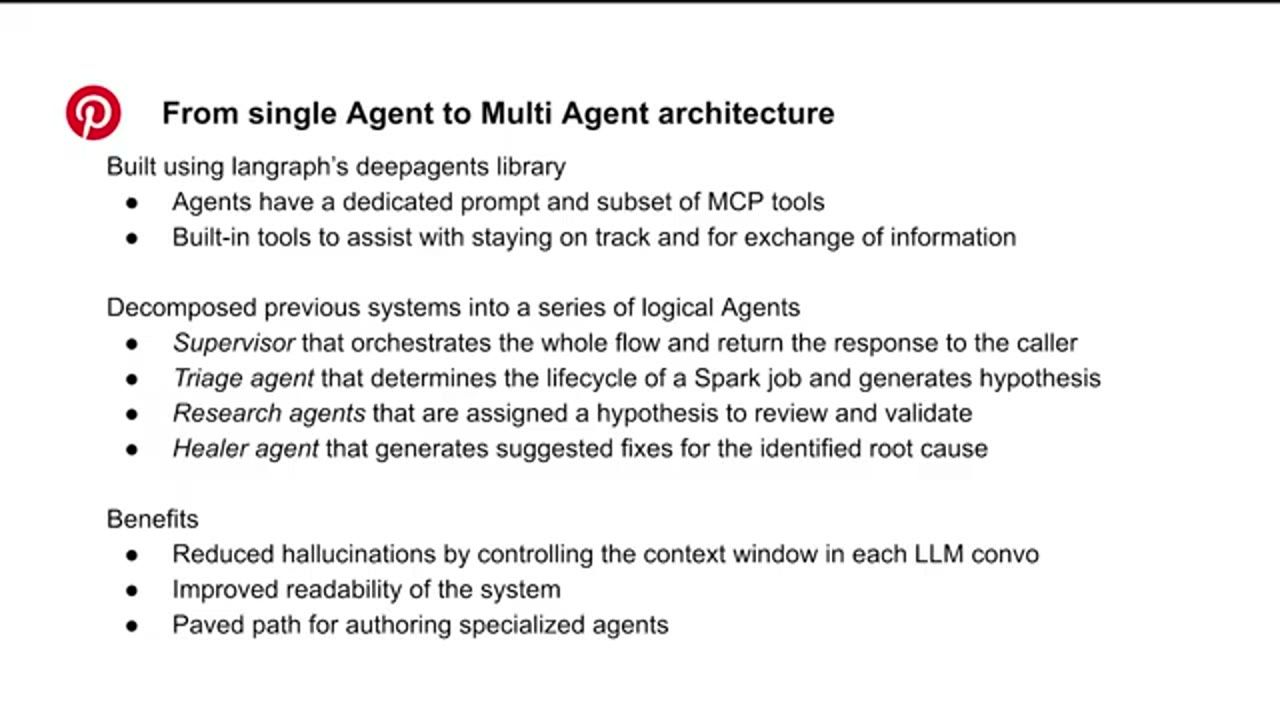
Cuối cùng, team đại tu agent harness. Họ chuyển từ một ReAct agent duy nhất sang multi-agent architecture, xây trên thư viện Deep Agent của LangGraph (deepagents). Mỗi agent giờ có prompt riêng và một tập con các MCP tool. Trong khi đó, bản thân thư viện Deep Agent cung cấp sẵn các tool built-in để giữ agent đi đúng hướng, như to-do list hay một virtual filesystem.
Cách tiếp cận này giống với những gì mình đã quen chờ đợi ở các coding tool như Claude Code hay Codex. Cuối cùng team cũng tách được prompt duy nhất thành các vai chuyên biệt.
Lần refactor này tách bạch rõ ràng từng agent, và giúp developer dễ bảo trì từng prompt riêng, đồng thời chạy focus testing trên hệ thống bằng chính E2E test harness ở trên.
10. Một request đi qua hệ thống như thế nào
Một hệ quả dễ chịu của architecture này: mở rộng phạm vi dự án đơn giản như thêm một prompt mới. Đó chính là cách team mở rộng Medic để giúp người dùng tối ưu các Spark SQL job, không chỉ chẩn đoán job fail.
Workflow bắt đầu khi request của người dùng đi vào hệ thống. Tại đó, intent được phân loại: hoặc là một câu hỏi chỉ cần trả lời đơn giản, hoặc là một phiên chẩn đoán sâu. Nếu là trường hợp sau, triage agent xác định trạng thái lifecycle của Spark job. Nếu job đã fail, nó dùng một tập con tool để sinh ra một tập failure hypothesis.
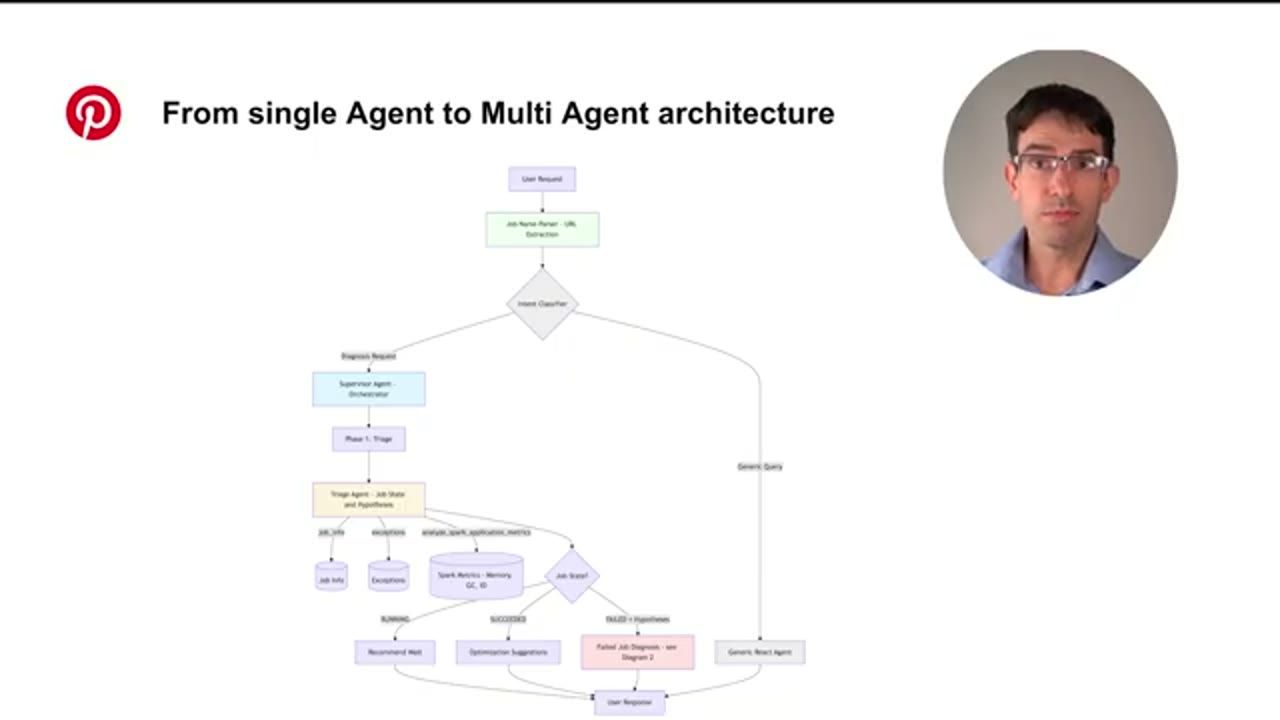
Mỗi hypothesis được nghiên cứu song song, thu thập bằng chứng để kiểm chứng nó. Các research agent trả về một điểm số và một root cause. Supervisor chọn root cause có độ tin cậy cao nhất, rồi gọi healer agent để đưa ra cách khắc phục dựa trên các runbook đã được nạp vào vector database. Cuối cùng supervisor agent lắp ráp báo cáo cuối, đảm bảo đúng format.
11. Điều gì hiệu quả, bài học đắt giá, và bước tiếp theo
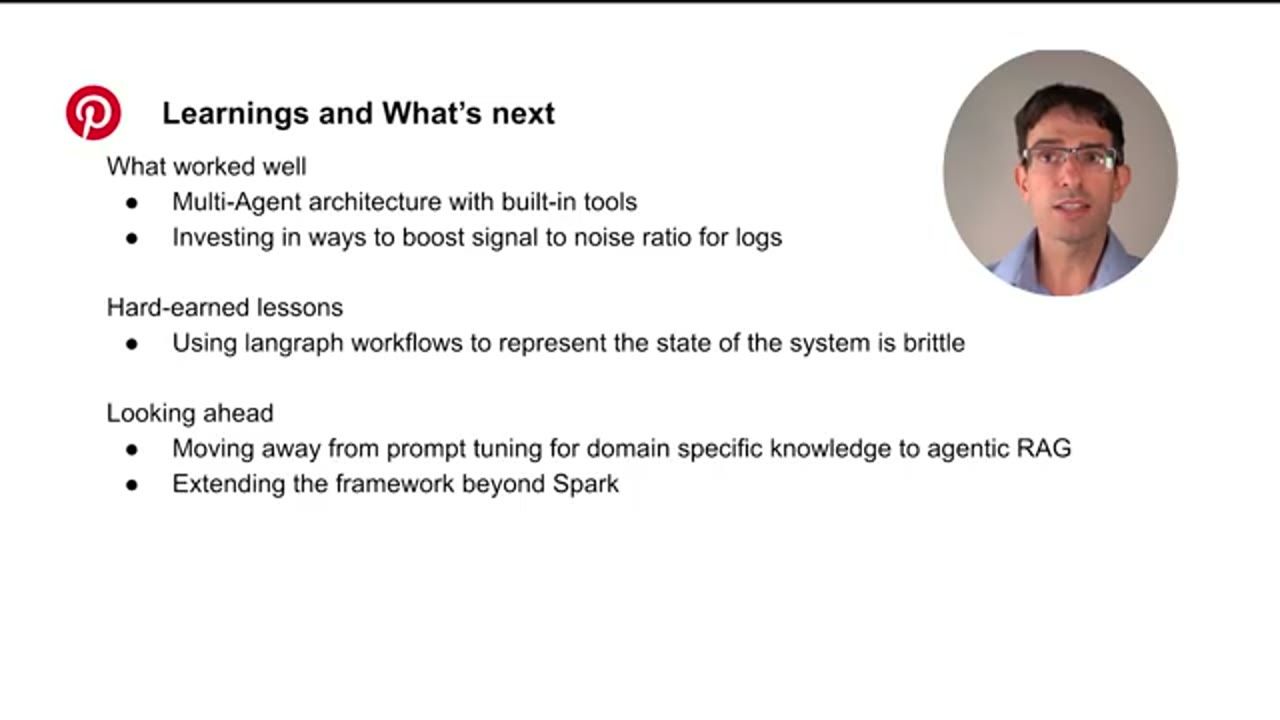
Điều hiệu quả. Multi-agent architecture tỏ ra rất hiệu quả, cho team mức kiểm soát lớn nhất đối với hành vi của hệ thống. Những cải tiến trong cách xử lý logs dẫn tới việc giảm đáng kể các root cause sai.
Bài học đắt giá. Team đã thử dùng workflow của LangGraph để làm agent deterministic hơn, nhưng cách đó hoá ra giòn so với paradigm reasoning and acting agent (ReAct).
Bước tiếp theo. Điều team đang thử nghiệm bây giờ là đưa feedback của người dùng từ các phiên trước vào để agent tự động cải thiện. Ngoài ra, họ thấy một cơ hội rộng hơn: áp dụng cùng pattern này cho các distributed system khác như Flink và Trino.
Drasko khép lại bằng lời cảm ơn: dự án Medic for Apache Spark có được là nhờ công sức của nhóm contributor được liệt kê trên slide cuối, cùng những người được gửi lời cảm ơn đặc biệt. Anh cảm ơn mọi người đã dành thời gian.
Sources and links
- Trang talk chính thức trên ai.engineer · Video gốc
- Apache Spark · Spark monitoring và History Server
- Model Context Protocol
- ReAct: Synergizing Reasoning and Acting in Language Models
- OpenTelemetry · Langfuse
- deepagents · LangGraph
- Apache Airflow · Grafana
- Apache Flink · Trino
Related talks
The Log Is The Agent
Ishaan Sehgal · Omnara · 15 min
Agent không phải model hay runtime mà là append-only log: từ đó có reliability, scaling, forking, migration, và ai giữ log là người sở hữu agent.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.
Production Evals For Agentic AI Systems
Nishant Gupta · Meta · 8 min
Eval cho agent phải đo hành vi cả hệ thống: scenario offline, production telemetry, human review, drift, trace và metric reliability gắn với kết quả kinh doanh.