OpenAI gấp đôi limit các gói Pro: đã đủ chưa?
Theo phân tích việc OpenAI gấp đôi limit các gói Pro, so giá trị gói $200 với Claude theo giá API, giá mỗi task và số review thực tế.
✓ Đã duyệt độc lập · cập nhật 03/11/2026 · 16 min
1. Anthropic thắng liên tục, OpenAI thua liên tục
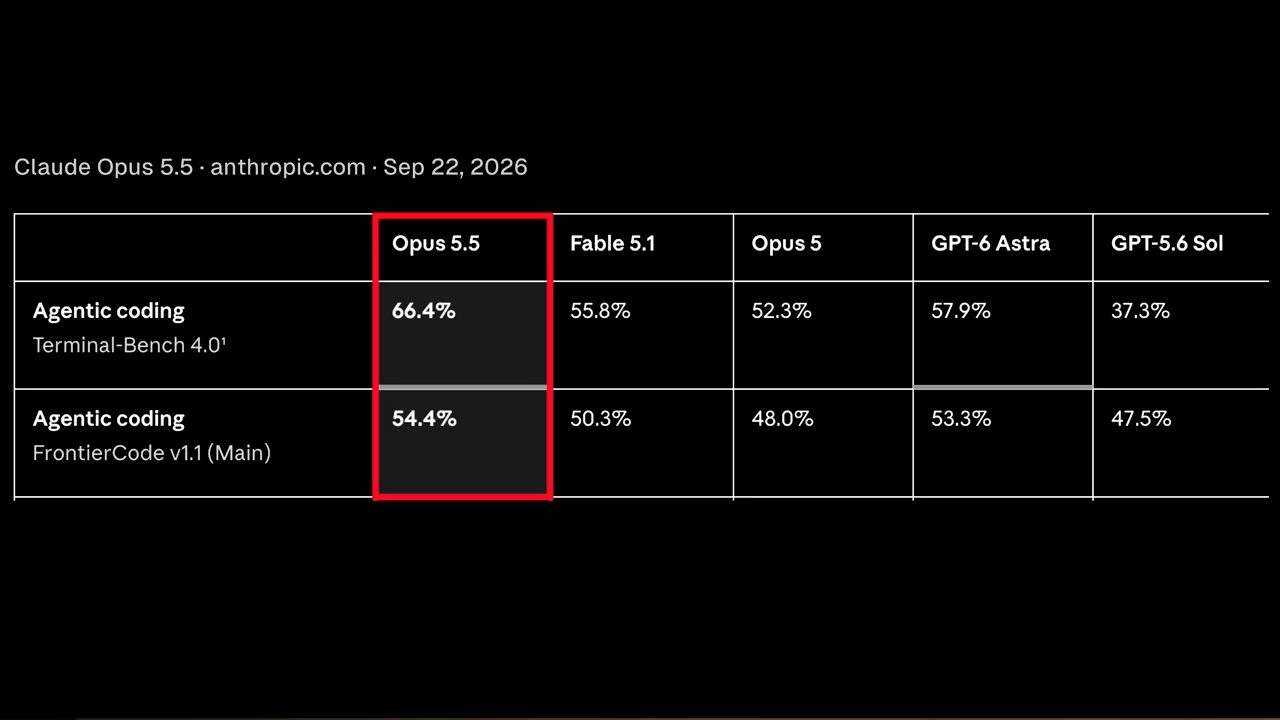
Theo Browne mở đầu (video đăng ngày 03/11/2026): dạo gần đây có cảm giác Anthropic không thể ngừng thắng, còn OpenAI thì không thể ngừng thua. Anh kể ra một chuỗi: những thay đổi tệ hại khi OpenAI cắt limit của "chúng tôi" một cách khủng khiếp ở gói $200, GPT-6.1 Sol thì là một cú semi-flop, và không có một bản tiếp nối thật sự nào cho GPT-6 Astra để cạnh tranh với một thứ mạnh như Opus 5.5 của Anthropic. Theo anh, gần đây đó là một chuỗi thua với "chúng tôi", những người hâm mộ Codex (theo video đăng ngày 03/11/2026).
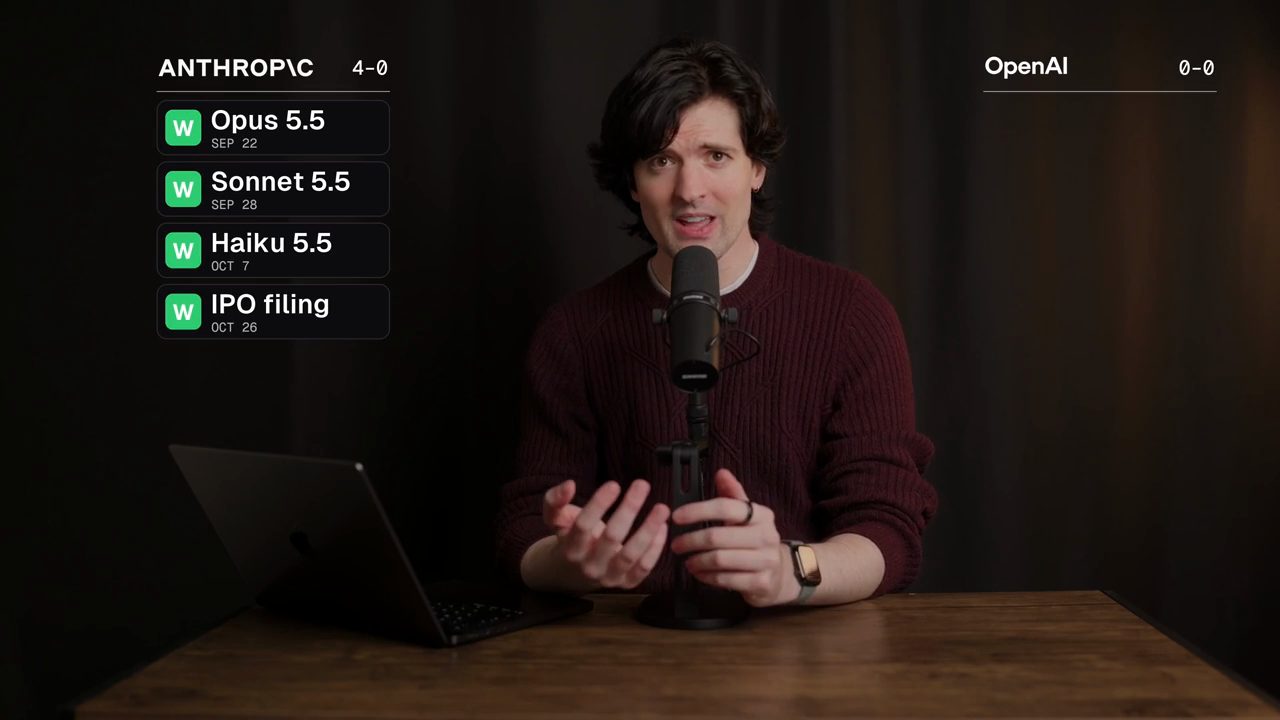
Anh tự tính mình vào nhóm đó, vì xưa nay anh là một trong những người bênh vực Codex và OpenAI. Và lúc này, anh nói, khá khó để biện minh cho việc dùng nó (theo video đăng ngày 03/11/2026).
2. Thông báo của Tibo: gấp đôi usage limit cho mọi gói Pro
Dù vậy, Theo nói có cảm giác cuối cùng mọi thứ đang quay lại đúng hướng (video đăng ngày 03/11/2026). Tibo vừa đưa ra một thông báo lớn mà anh rất hào hứng: kể từ ngày 29/10, OpenAI gấp đôi mọi usage limit cho mọi tài khoản Pro, dù là gói $100, gói $200 hay gói $500, cùng với Business Premium, có hiệu lực ngay hôm đó (theo video đăng ngày 03/11/2026).
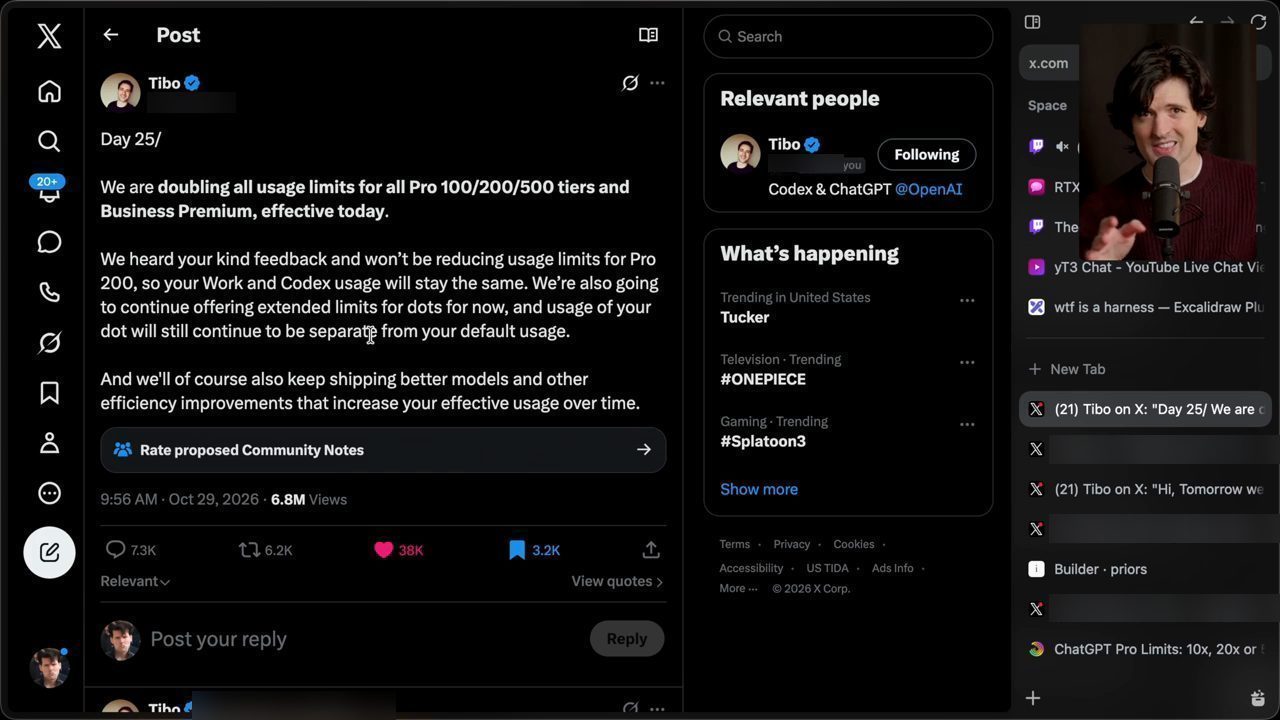
Theo nói vụ này có nhiều tầng. OpenAI đang thực hiện những thay đổi có thể khiến một số người có ít usage hơn trong một số trường hợp. Họ đang gộp chung những thứ trước đây không gộp, và chuyện đó có thể hơi khó chịu. Còn gói $200 thì, nói nhẹ nhất, là lộn xộn (theo Theo, video đăng ngày 03/11/2026).
Anh liệt kê những điều cần đào sâu: các limit này ảnh hưởng thế nào tới việc dùng hằng ngày của "chúng ta", ở mỗi gói thật sự làm được bao nhiêu việc, và khi bỏ vào $200 thì nhận lại được bao nhiêu giá trị quy ra đô. Và tất nhiên là câu hỏi quan trọng nhất theo anh: so với giá trị nhận được từ subscription Claude Code thì sao (video đăng ngày 03/11/2026)?
Lý do anh đặt câu hỏi đó: bình thường khi so giá trị, người ta so giá API. Giá subscription thì khác, và lượng usage nhận được cũng khác. Vậy mọi thứ khớp với nhau thế nào, và hôm nay nên chọn gói nào (theo video đăng ngày 03/11/2026)?
3. Nhìn lại ngày 28/09: gói $200 còn một nửa giá trị API
Theo nói trước khi bàn đúng về thông báo này, cần quay ngược thời gian một chút. Tận ngày 28/09 năm nay, mà anh nói có cảm giác như đã nhiều năm trước, Tibo đăng một thông báo rất dài về việc gói $200 sẽ có thay đổi. Cụ thể, nếu làm phép tính thì nó ra bằng một nửa số tiền API spend so với gói Pro 200 cũ (theo video đăng ngày 03/11/2026).
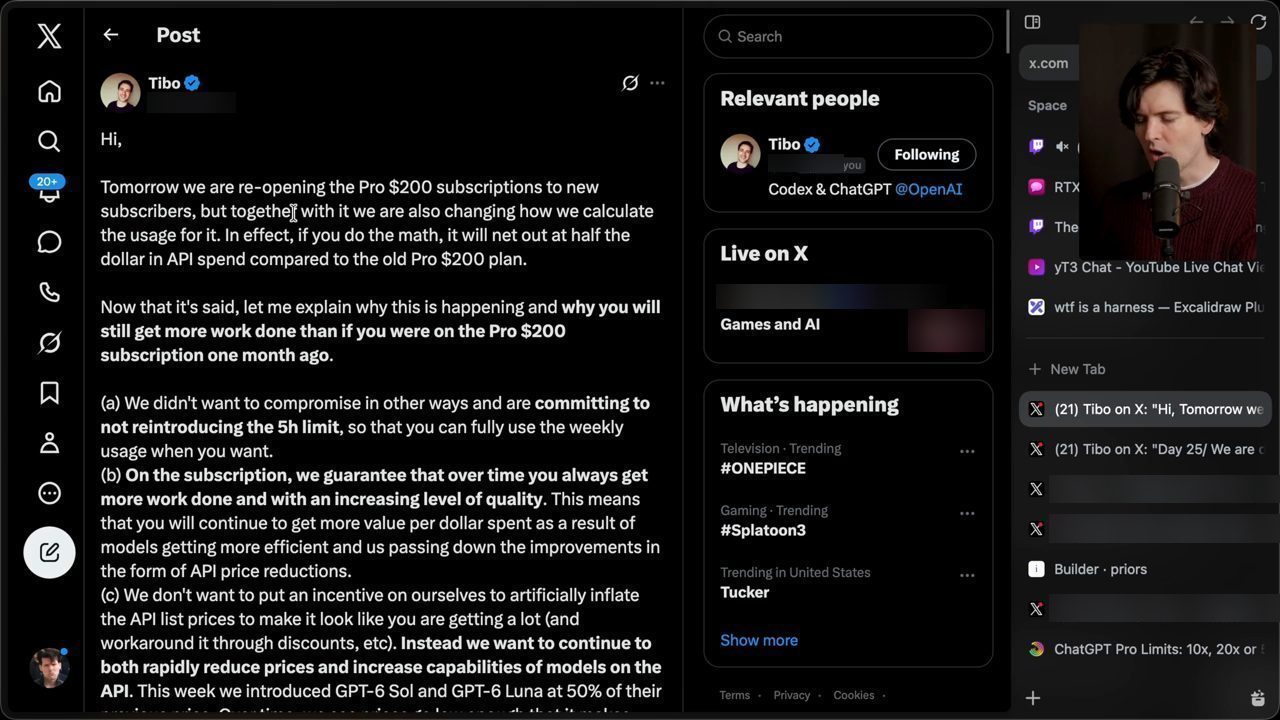
Sau đó, theo Theo, Tibo cố biện minh rằng "chúng ta" vẫn sẽ làm được nhiều việc hơn so với subscription trước đó một tháng, gồm những thứ như cam kết không có giới hạn năm tiếng nữa, và bảo đảm rằng bạn sẽ luôn làm được nhiều việc hơn với chất lượng ngày càng cao (video đăng ngày 03/11/2026).
Theo nói đây thật ra là một cam kết tốt: ý tưởng rằng khi model ngày càng thông minh và có năng lực hơn, bạn luôn phải làm được nhiều việc hơn trên cùng một gói subscription so với trước (theo Theo, video đăng ngày 03/11/2026).
Phần lớn nhất ở đây, theo anh, là mục C. OpenAI không muốn tự tạo cho mình động cơ thổi phồng giá API list price một cách nhân tạo để trông như người dùng đang nhận được rất nhiều. Thay vào đó, họ muốn tiếp tục vừa giảm giá thật nhanh vừa tăng năng lực của model trên API (theo bài đăng ngày 28/09/2026 mà Theo tóm tắt trong video đăng ngày 03/11/2026).
4. Vì sao phải cắt, và thay đổi lần này thật ra làm gì
Theo lưu ý (video đăng ngày 03/11/2026) rằng đó là khoảng thời điểm 6.1 Sol ra mắt. Anh nói model đó rẻ hơn nhiều so với mức OpenAI có lẽ đã định phục vụ ban đầu. Theo anh, đó là lý do họ phải thay đổi: nếu họ làm model rẻ hơn trên API mà vẫn cho bạn cùng số tiền đó bên ngoài API, thì họ đang ăn nhiều compute hơn mức lẽ ra phải ăn (theo Theo, video đăng ngày 03/11/2026). Bài đăng ngày 28/09 trên màn hình ghi tuần đó OpenAI giới thiệu GPT-6 Sol và GPT-6 Luna với giá bằng 50% giá trước.
Có một điểm đáng chú ý trong thông báo cũ, anh nói: toàn bộ bài viết là về gói Pro $200. Không thay đổi nào ảnh hưởng tới các gói khác. Điều đó có nghĩa thay đổi lần này đưa gói $200 về lại mức cũ, nhưng đồng thời cũng gấp đôi những gì bạn nhận được ở gói $100 và gói $500 (theo Theo, video đăng ngày 03/11/2026).
Theo nói việc gói $500 được gấp đôi là khá điên rồ, vì nó có nghĩa gói đó giờ bằng 50x usage so với Pro tier (theo video đăng ngày 03/11/2026). Đây là một lượng usage điên rồ mà có lẽ bạn sẽ dùng hết được nếu dùng nhiều Fast và Ultra Fast. Còn ở tốc độ bình thường, dùng model tốt nhất của OpenAI lúc này, theo anh là 6.1 Sol, "không phải Astra, mà là Sol", anh không hình dung nổi làm sao có thể dùng hết gói $500 (theo Theo, video đăng ngày 03/11/2026).
5. Quy ra đô: $10.5k, $4.3k và gói $200 của Claude
Theo nói nên bắt đầu bằng các con số về giá trị quy ra đô mà bạn nhận được, dù như anh vừa nói, đó không phải cách đo đúng. Nhưng nó vẫn đáng ghi lại (theo video đăng ngày 03/11/2026).
Theo số anh tính (video đăng ngày 03/11/2026), ở gói $500 bạn giờ nhận được khoảng $10.5k usage, và ở gói $200 khoảng $4.3k usage. Anh nói cả hai vẫn được trợ giá rất nặng.
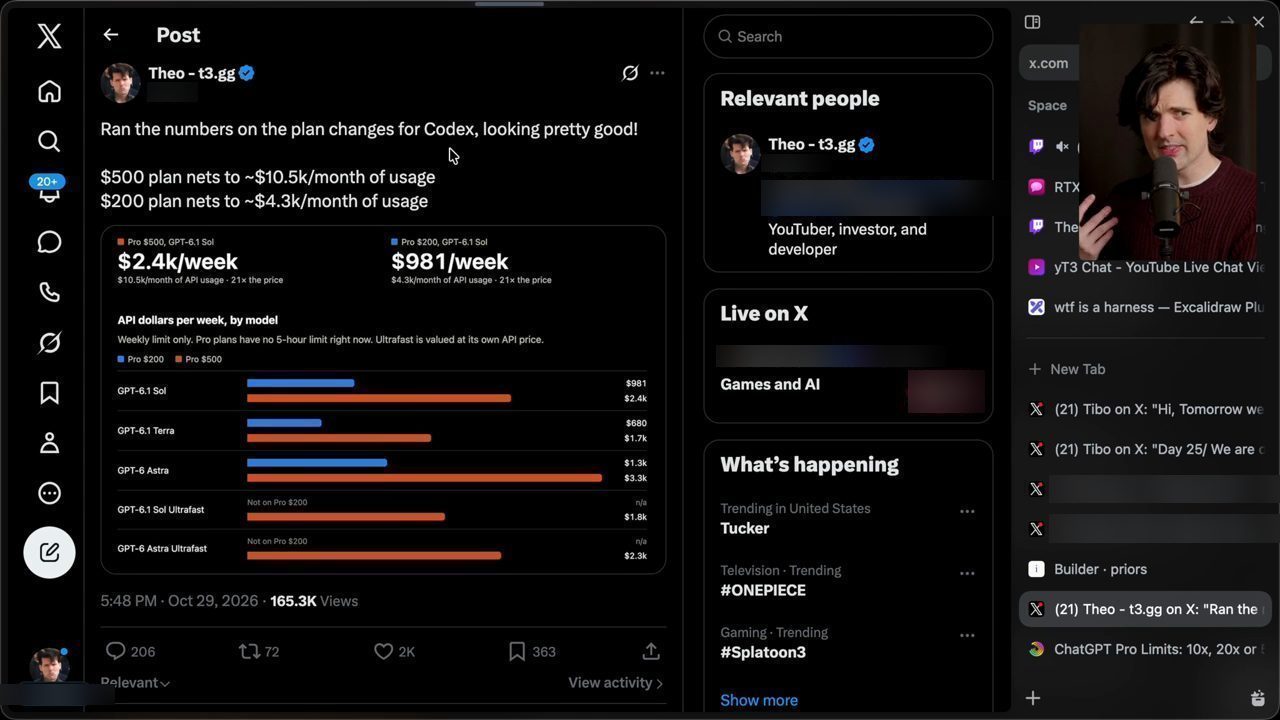
Nhưng anh nhắc: gói $200 của Claude cho bạn $12,000 usage. Nó có những giới hạn kỳ lạ như limit giảm một nửa với Fable. May là, ít nhất tại thời điểm quay, theo anh không có model Fable nào đáng dùng hơn Opus, nên mức 50% đó không ảnh hưởng tới bạn quá tệ (theo Theo, video đăng ngày 03/11/2026).
Nhưng kể cả vậy, theo Theo (video đăng ngày 03/11/2026), gói $200 của Claude sau khi cắt 50% vẫn cho bạn $6,000 usage, còn gói $200 của OpenAI, dù thế nào, cũng chỉ cho bạn $4.3k. Nên khi so các model OpenAI với các model Anthropic trên subscription, bạn vẫn nhận được ít giá trị quy ra đô hơn nhiều.
6. Ba cách tính giá model, và số token cho mỗi task
Nhưng còn việc dùng thật ngoài đời thì sao? Theo nói anh đã cố giải thích từ lâu rằng các model OpenAI rẻ hơn nhiều, không chỉ theo giá mỗi token, vì theo anh giá theo token là rác (video đăng ngày 03/11/2026).
Theo anh (video đăng ngày 03/11/2026), có ba cách mà model đang thực chất được định giá, và đó là những cách đáng quan tâm. Cách thứ nhất là họ tính bao nhiêu tiền cho mỗi token vào và mỗi token ra. Ở đây còn có caching, thứ làm thay đổi hoàn toàn bài toán kinh tế.
Cách thứ hai là cần bao nhiêu token để giải một bài toán. Anh nghĩ đây là điều phần lớn mọi người bỏ sót: họ nhìn giá mỗi token tính bằng đô và quên rằng có model dùng nhiều token hơn, có model dùng ít hơn (theo Theo, video đăng ngày 03/11/2026).
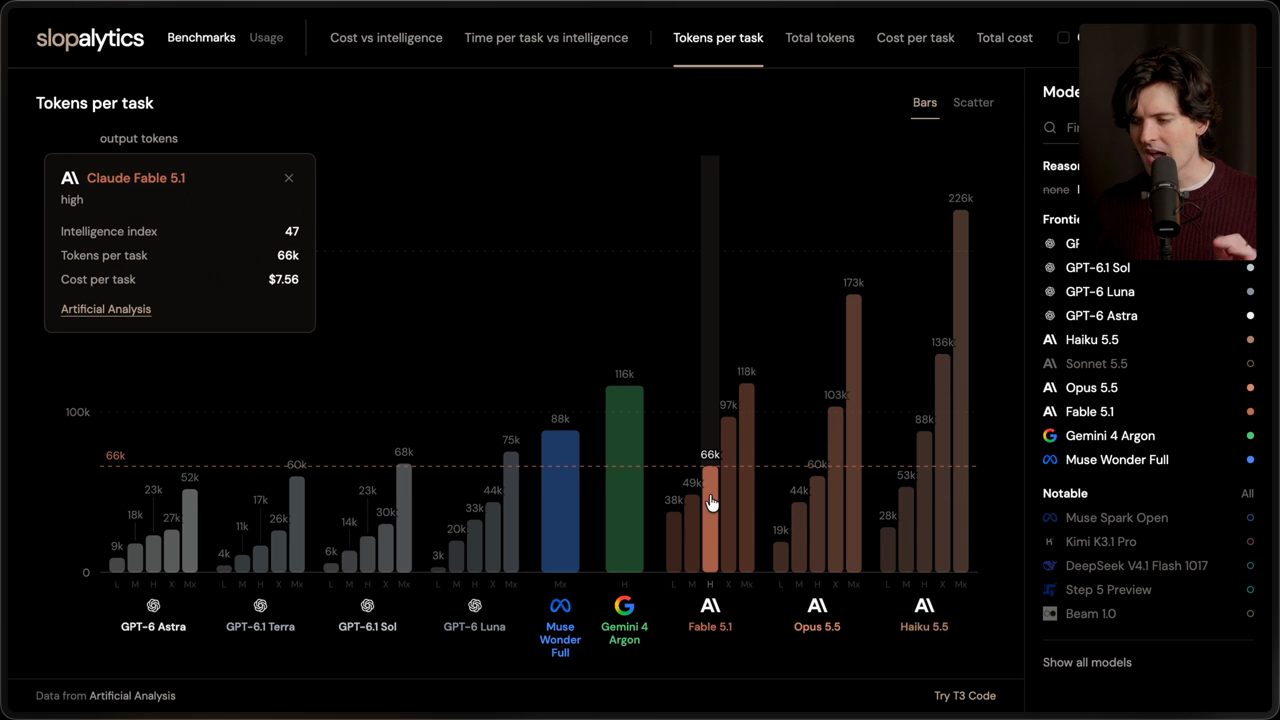
Anh đã trực quan hoá điều này (video đăng ngày 03/11/2026). Anh chỉ ra rằng mọi model OpenAI đều nằm khá xa về bên trái, và kể cả trường hợp tệ nhất như 6.1 Sol dùng 68k token ở mức max, thì nó vẫn ngang khoảng số token của Fable ở mức medium hay high. Nếu hạ xuống xhigh, 6.1 Sol dùng ít token hơn mọi thứ Anthropic ra mắt gần đây, trừ Opus 5.5 ở mức low.
Nên theo Theo (video đăng ngày 03/11/2026), 6.1 Sol ở xhigh dùng ít token hơn Opus 5.5 ở medium, và hiển nhiên điểm cao hơn đáng kể, vì mức reasoning low và medium sẽ không thể so được với một thứ như 6.1 Sol ở mức tốt nhất của nó.
7. Giá theo task: log scale, linear scale
Theo nói 6.1 Sol ở xhigh đạt 52 điểm trên Artificial Analysis Intelligence Index. Còn Opus 5.5 ở medium tốn $2.45 một task, so với $0.76 một task (theo video đăng ngày 03/11/2026).
Anh nói biểu đồ này đang ở log scale. Nếu chuyển sang linear, khoảng cách còn rõ hơn, vì bạn trả hơn 2 lần giá cho Opus medium mà lại nhận kết quả tệ hơn Sol xhigh (theo Theo, video đăng ngày 03/11/2026).
Nên một lần nữa, với cách định giá thứ hai, giá theo task, theo anh OpenAI đang "tàn sát" Anthropic (video đăng ngày 03/11/2026).
8. Subscription: số liệu của Adam Holter
Theo nhắc rằng anh đã nói có thứ ba, và đó là thứ thật sự được bàn hôm nay: subscription. Vậy chuyện gì xảy ra khi kết hợp điều trên với lượng usage nhận được trong các gói $200 (theo video đăng ngày 03/11/2026)?
Theo kể Adam Holter gần đây làm về chuyện này rất nhiều, và các con số của anh ấy rất thú vị để xem. Adam điều chỉnh giá dựa trên mức giảm giá bạn nhận được khi dùng subscription, và nhờ đó các con số trông rất khác (theo Theo, video đăng ngày 03/11/2026).
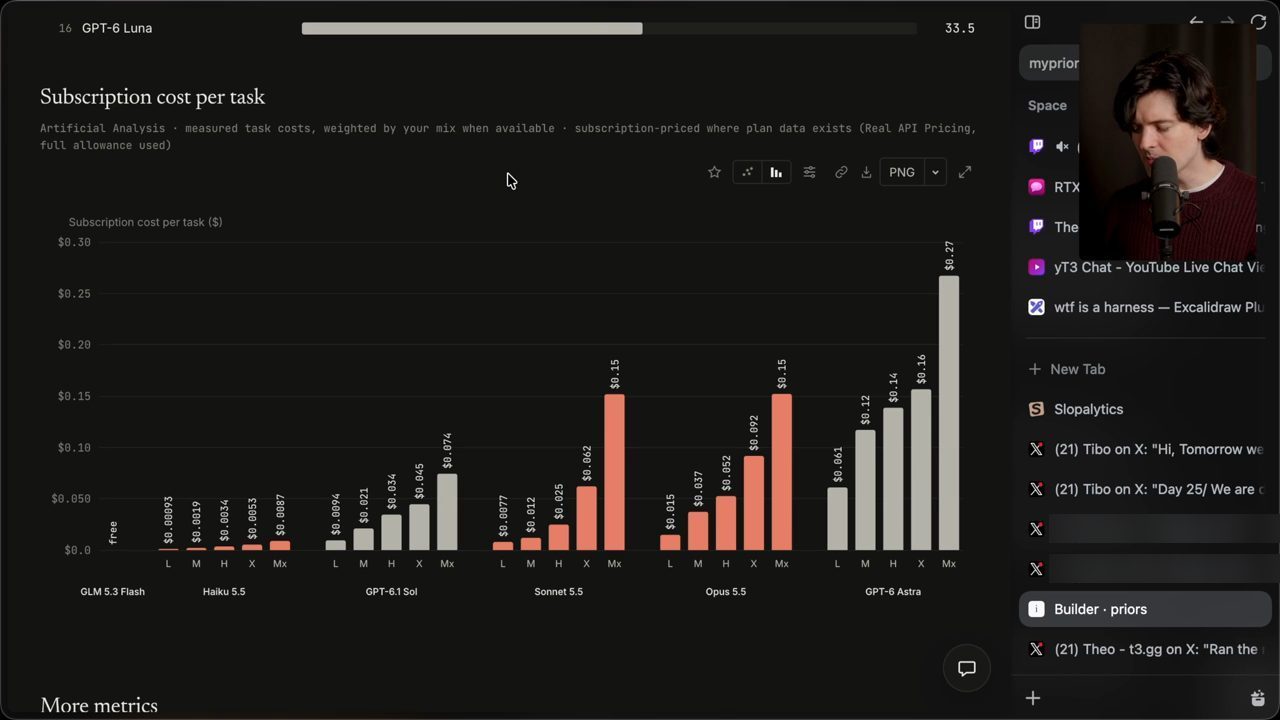
Theo anh (video đăng ngày 03/11/2026), ở đây vẫn có khoảng cách ở một mức nào đó, vì đây là cost per task, và nhớ rằng càng thấp càng tốt. Theo cách tính subscription, 6.1 Sol ở max tốn chưa tới một nửa so với Opus 5.5 ở max.
Anh nhắc rằng anh gần như không bao giờ khuyên dùng Opus 5.5 max. Về cơ bản anh không bao giờ khuyên dùng max ở bất kỳ dòng model nào, nhất là các model của Anthropic. Anh chủ yếu dùng high, thỉnh thoảng chuyển sang xhigh (theo Theo, video đăng ngày 03/11/2026).
Anh nói Opus 5.5 ở high khoảng năm cent mỗi task, so với 6.1 Sol ở high là bốn cent mỗi task (theo video đăng ngày 03/11/2026); trên biểu đồ hai cột này ghi $0.052 và $0.034. Anh đặt hai mức này ngang ngửa nhau, là hai thứ anh hay với tới: anh dùng nhiều Sol xhigh và dùng nhiều Opus 5.5 high.
Theo Theo (video đăng ngày 03/11/2026), hai thứ đó có giá gần như y hệt nhau, vì khi triệt tiêu mọi thứ khác và tính cả gói $200 vào, khoảng cách giá theo năng lực nhỏ đi nhiều, và giá trị bạn nhận được cân bằng lại khá nhiều.
9. Pareto line: giá API và giá theo gói
Theo nói chuyện còn thú vị hơn khi nhìn vào cách nó ảnh hưởng tới Pareto line. Anh giải thích Pareto line là giá trị tốt nhất tại mỗi mức, cho các mức năng lực khác nhau (theo video đăng ngày 03/11/2026).
Nếu nhìn theo giá API, theo anh (video đăng ngày 03/11/2026), sẽ thấy vài điểm kỳ lạ. Ví dụ Haiku, về mặt kỹ thuật, thông minh hơn một chút dù đắt gấp 2 lần Terra ở mức low. Nhưng Terra lập tức giành lại vị trí, cùng với 6.1 Sol ở mức low. Theo anh, xét về giá API thì không có mấy lý do để mặc định dùng Haiku, ít nhất là theo những con số này.
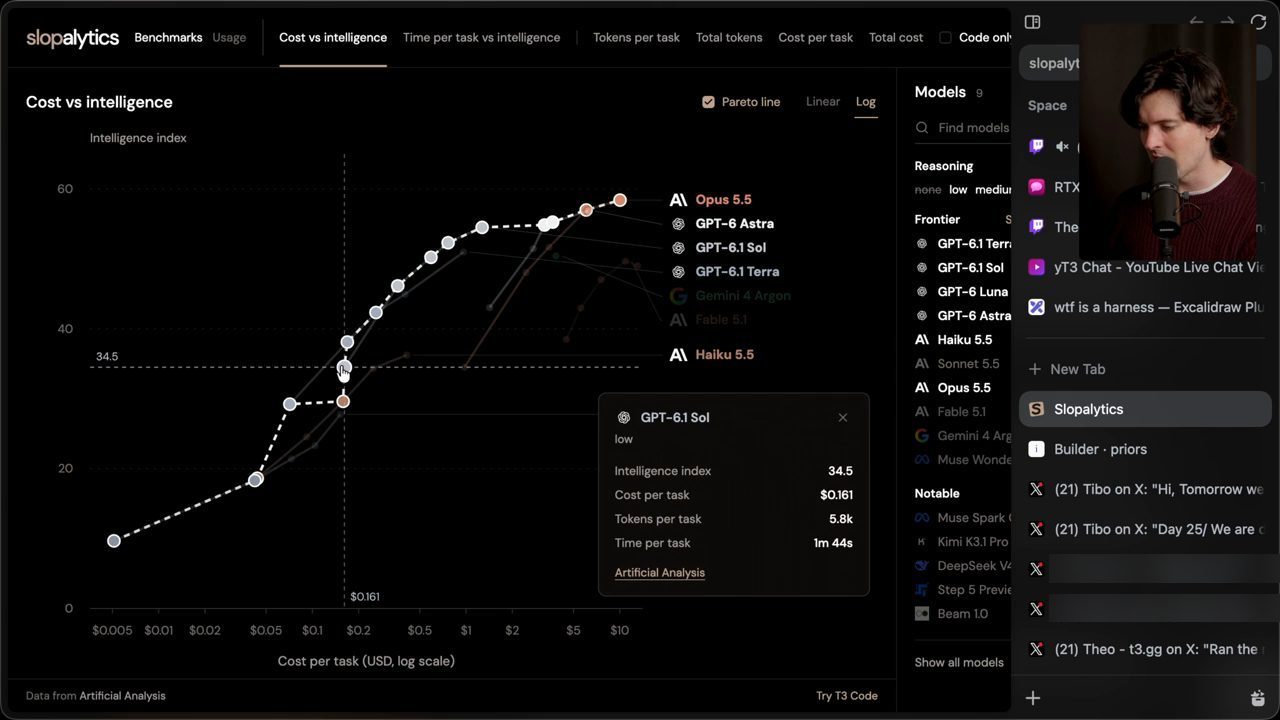
Nhưng phần lớn thì đó là một đường cong khá mượt, với một chỗ lồi kỳ lạ của Haiku. Phần còn lại, theo anh, là OpenAI áp đảo. Kể cả khi thêm các model open weight, OpenAI vẫn có xu hướng áp đảo nhiều trên Pareto line lúc này, còn Opus chỉ trở thành lựa chọn giá trị hơn ở tận đỉnh, vì nó có hiệu năng tốt nhất lúc này (theo Theo, video đăng ngày 03/11/2026).
Anh nói thêm: nếu bạn nghi ngờ điều đó thì xin lỗi, Opus 5.5 là model tốt nhất hiện có, ít nhất tại thời điểm quay video này (theo Theo, video đăng ngày 03/11/2026).
Khi chuyển sang giá theo subscription, theo anh (video đăng ngày 03/11/2026), đường này đổi qua đổi lại nhiều hơn hẳn. Nhìn kỹ hơn, giống chỗ lõm kỳ lạ mà Haiku vừa đủ lọt vào ở biểu đồ API, ở đây có một chỗ tương tự mà Sol high vừa đủ lọt vào. Toàn bộ phần còn lại của đường cong, ngoài một chỗ lồi của Sol low, là Anthropic.
10. Biểu đồ thứ nhất chưa đúng: chuyện reset
Rồi Theo nói hoá ra biểu đồ đầu tiên anh xem không hoàn toàn đúng. Biểu đồ này trông tốt hơn nhiều cho OpenAI. Anh tưởng lý do là biểu đồ này đã tính limit gấp đôi, còn biểu đồ kia có thể chưa tính (theo video đăng ngày 03/11/2026).
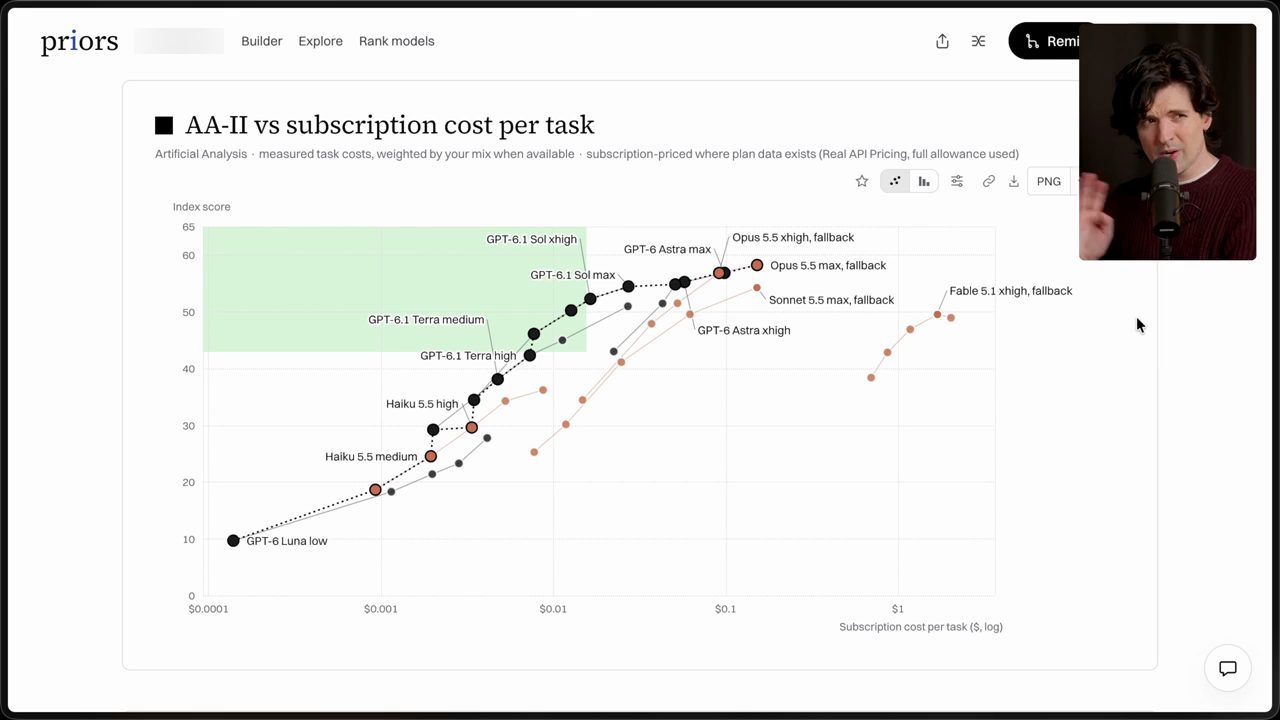
Nhưng không phải vậy. Lý do ngớ ngẩn hơn nhiều: phiên bản này có tính reset. Nếu bạn chưa biết, theo Theo, OpenAI reset rất nhiều, 11 lần trong 30 ngày qua. Nên nếu tắt phần đó đi thì limit tệ đi nhiều và mọi thứ trông sát nhau hơn (theo video đăng ngày 03/11/2026).
Anh một lần nữa gửi lời cảm ơn tới Adam vì toàn bộ công sức làm ra các biểu đồ này và thu thập dữ liệu. Theo anh, không có gì khác đi xa tới mức này ở chủ đề này, và limit của subscription là thứ rất quan trọng để "chúng ta" hiểu. Anh nói thật điên khi thấy các con số dịch chuyển nhiều thế nào khi bật và tắt reset (theo Theo, video đăng ngày 03/11/2026).
Lý do khá rõ khi nhìn vào các con số. Theo nói (video đăng ngày 03/11/2026) từ 16/04 tới 31/10, Codex có 52 lần reset, Claude có 14 lần, và đã 30 ngày nay không có một lần reset Claude nào, điều anh thấy buồn vì anh thích được Claude reset. Biểu đồ trên màn hình ghi "52 days with a reset" cho OpenAI Codex, "14 days with a reset" cho Anthropic Claude, và "39 days since the last one".
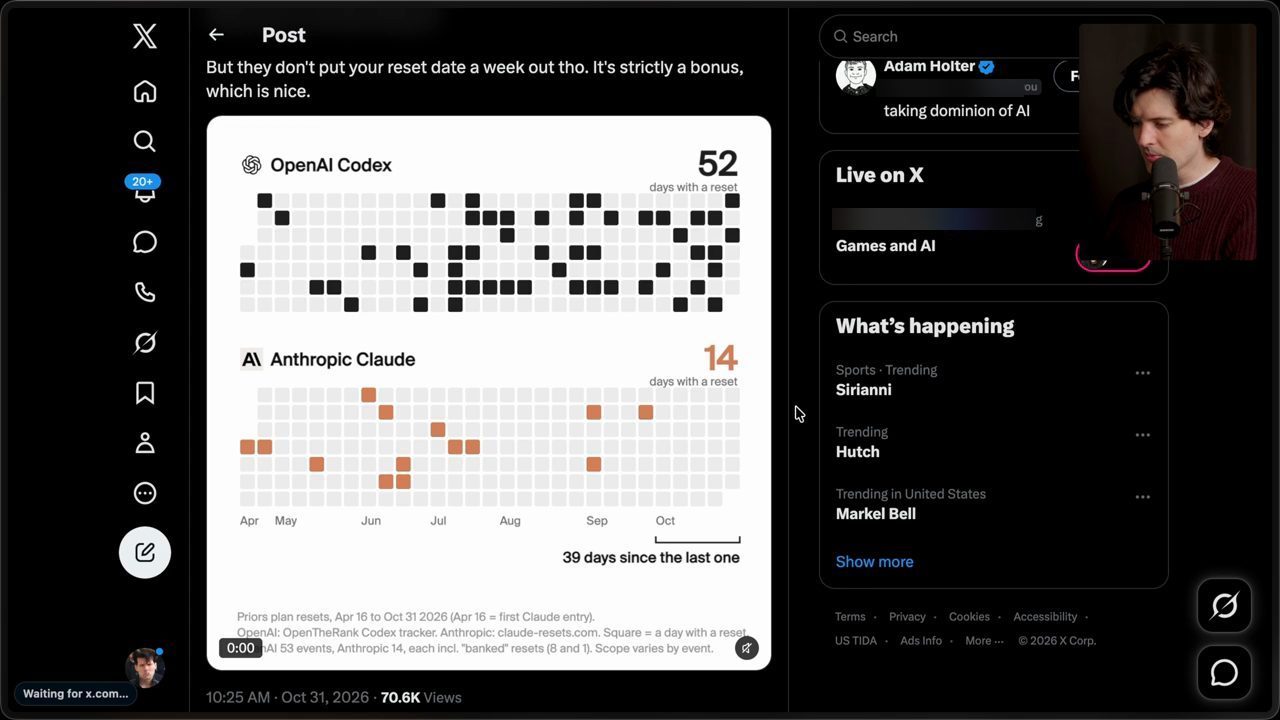
Theo nói đây vẫn dựa trên giá của các bài làm của Artificial Analysis. Và đáng buồn là khi nhìn vào số thật cho các task thật ngoài đời, khoảng cách còn thu hẹp thêm một chút (theo video đăng ngày 03/11/2026).
11. Council: Opus và Sol chấm review của nhau
Theo kể anh có một skill mới đang dùng tên là Council, trong đó anh để các agent review công việc anh đang làm trên nhiều model cùng lúc (theo video đăng ngày 03/11/2026). Anh có vài thay đổi muốn làm, có một proposal, một plan hay gì đó. Rồi council vào cuộc, trải qua ba tới năm dòng model khác nhau để đưa feedback.
Theo Theo (video đăng ngày 03/11/2026), cách này hoá ra là một nguồn rất tốt để tạo các bài test kiểu like-for-like, vì giờ anh có một loạt model khác nhau cùng nhận đúng một task: "Review this change". Nhờ đó anh đã có thể đi qua và phân tích toàn bộ usage của mình.
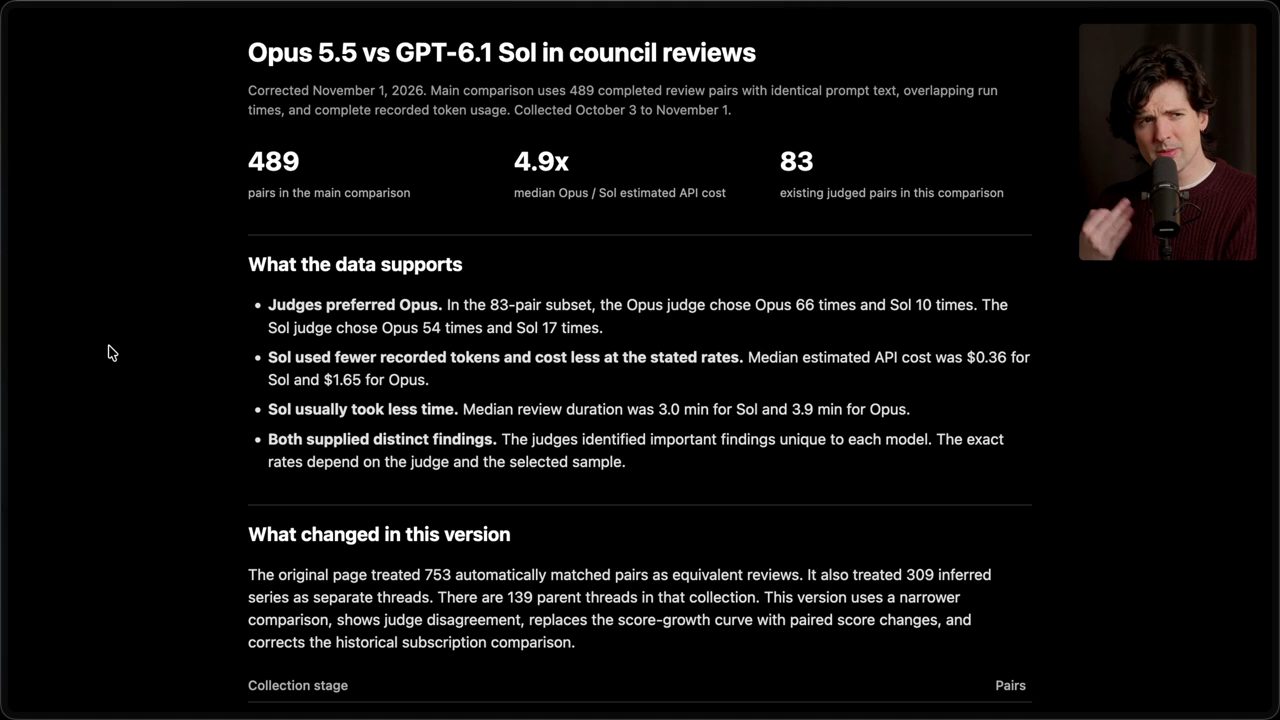
Anh để Opus và Sol chấm usage của Opus và Sol, chung và riêng, hoàn toàn blind, để xem chúng thích review nào hơn. Và như anh mong là chẳng ai ngạc nhiên, Opus 5.5 được cả hai ưu tiên khá rõ (theo số đo của Theo, video đăng ngày 03/11/2026).
Theo số đo của Theo (video đăng ngày 03/11/2026), Opus chọn Opus 66 trên 83 lần, còn Sol chọn Opus 54 trên 83 lần. Vậy là, theo anh, Sol chọn Opus 65% số lần, còn Opus chọn Opus 80% số lần. Có những lúc cả hai cùng chọn Sol, chỉ là ít hơn nhiều.
12. Chi phí mỗi review và số review trong một gói $200
Theo số đo của Theo (video đăng ngày 03/11/2026), chi phí trung vị cho một review của Opus là $1.65, còn cho một review của Sol là $0.36.
Khi đặt con số này cạnh giá trị API kỳ vọng nhận được từ một subscription, anh nói khoảng $3,300 với Opus trên Claude và khoảng $1,000 với Sol trên gói ChatGPT Pro $200, khoảng cách hoá ra sát hơn nhiều: Opus cho bạn khoảng 205 review trên gói đó, còn subscription ChatGPT Pro cho 290 review (theo số đo của Theo, video đăng ngày 03/11/2026).
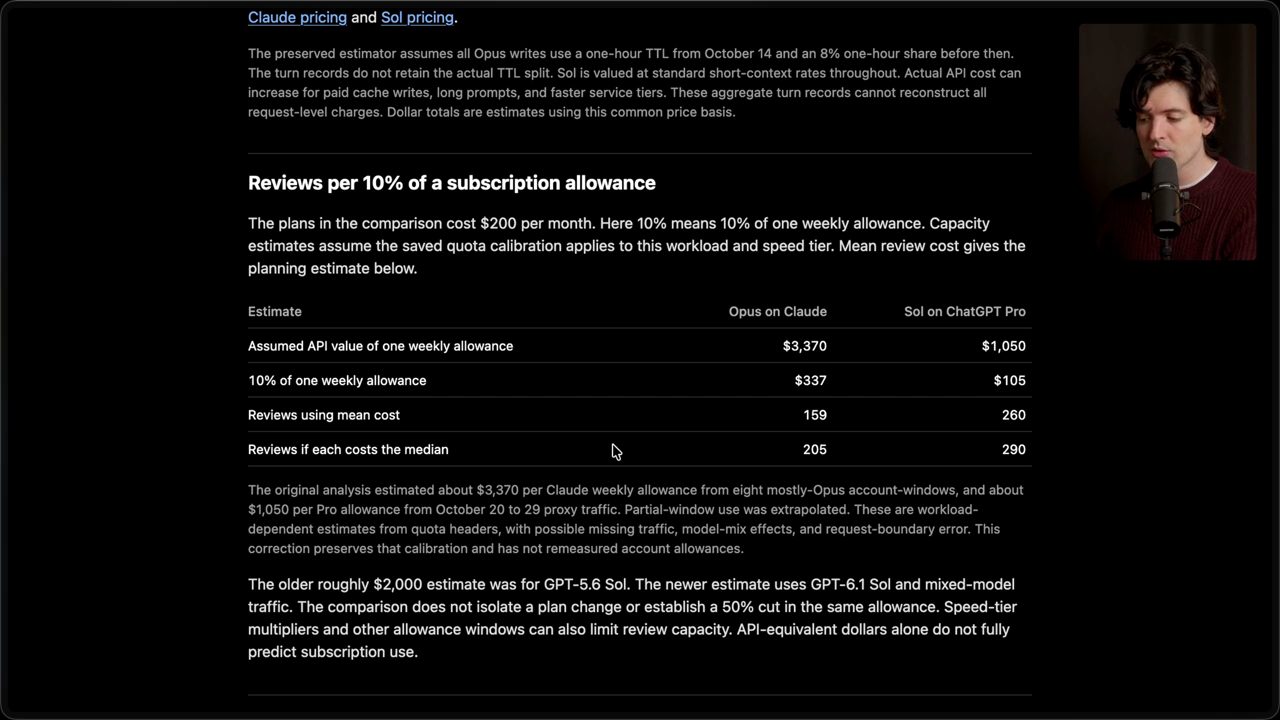
Nên theo anh (video đăng ngày 03/11/2026), dù chênh lệch giá trông có vẻ cực lớn, lượng usage thật sự bạn nhận được giữa hai bên sát nhau hơn nhiều. Và khi tính tới việc Opus 5.5 có năng lực hơn bao nhiêu, theo anh hiển nhiên nó là lựa chọn giá trị hơn.
Theo nói Sol nhanh hơn một chút, điều đó cũng hay: trong các review, nó làm xong việc nhanh hơn. Nhưng nói chung, theo anh, đây là con số quan trọng: khoảng 200 review với Opus trên Claude và 290 với Sol trên ChatGPT Pro (theo video đăng ngày 03/11/2026).
Anh nói: vậy nếu mức tăng 30% tới 50% số việc bạn làm được trong một tháng là cực kỳ quan trọng với bạn, và bạn sẵn sàng chịu thiệt về năng lực của 6.1 Sol để có nó (theo Theo, video đăng ngày 03/11/2026).
Còn nếu bạn muốn model tốt nhất có thể và sợ rằng subscription Claude không đáng giá bằng Codex, thì theo Theo, lúc này không phải vậy. Thậm chí anh thấy khá điên khi hai bên sát nhau thế nào về lượng usage lúc này. Khoảng cách không lớn như anh đã nghĩ, nhất là bây giờ khi limit đã được gấp đôi (theo Theo, video đăng ngày 03/11/2026).
13. ChatGPT, Work, dots và bộ subscription của Theo
Theo nói suýt quên, vì anh biết mọi người đang rất bực về chuyện này: ChatGPT và Work giờ được tính chung vào limit của bạn. Trước đây, dùng Work và chat bình thường không bị tính vào cùng limit với Codex (theo Theo, video đăng ngày 03/11/2026).
Theo anh (video đăng ngày 03/11/2026), chuyện này ảnh hưởng tới có lẽ khoảng 30 người, vì anh không biết nhiều người dùng chat và Work nhiều tới mức chúng tạo ra dù chỉ một vết lõm 1% trong limit Codex của họ. Nhưng nếu bạn là một trong những người đó, anh nói anh xin lỗi, nhưng thật lòng là anh thấy khó hiểu. Anh muốn biết thêm về use case của bạn, vì với anh điều đó thật điên.
Theo Theo (video đăng ngày 03/11/2026), mức gấp đôi vẫn phải dư sức bù cho cả hai phía. Anh không nghĩ những người phẫn nộ về chuyện đó có lý mấy. Usage ở Work và chat hiển nhiên sẽ dùng ít token hơn theo cấp số nhân so với usage Codex hằng ngày. Anh bảo mọi người cứ nhìn vào các con số, đừng khó chịu về chuyện đó.
Câu hỏi còn lại là dots. Theo nói (video đăng ngày 03/11/2026) có vẻ dots vẫn sẽ không bị ảnh hưởng bởi các thay đổi này và sẽ không dùng limit của bạn khi làm việc trong dots, ít nhất là anh nghĩ vậy. Nhưng anh nói thật là anh không biết. Anh không thích dots, anh không thấy nó dễ chịu so với các công cụ assistant khác đang có.
Anh chưa thiết lập Duet, dù đã được mời. Anh chủ yếu dùng Grok Bot, và nó tốt một cách bất ngờ (theo Theo, video đăng ngày 03/11/2026).
Theo nói thật điên khi anh có các gói OpenAI cho computer use và verification, các gói Claude cho mọi việc code hằng ngày, và rồi một gói Grok chỉ để dùng Grok Bot. Nhưng, anh nói, mọi thứ đang ở đó (video đăng ngày 03/11/2026).
14. Lời kết: một thay đổi tốt, nhưng thiếu một model
Theo nói anh nghĩ đó là tất cả những gì anh muốn nói về chuyện này. Theo anh, đây chắc chắn là một thay đổi tốt, và gần như đáng bực khi mọi người phản đối nhiều thế nào về những phần nhỏ không quan trọng (theo Theo, video đăng ngày 03/11/2026).
Anh nói đáng chỉ ra rằng gói $200 đã về lại đúng chỗ của nó một tháng trước. Với người dùng gói $200, đó không phải một bước tăng lớn, chỉ là phục hồi về mức cũ. Gói $500 được 2x là điên rồ, còn gói $100 được 2x cũng khá thú vị (theo Theo, video đăng ngày 03/11/2026).
Nhìn chung, Theo nghĩ đây là một thay đổi rất tốt, nhưng nó thiếu một thứ quan trọng: một model đáng dùng (theo Theo, video đăng ngày 03/11/2026).
Anh gửi lời tới OpenAI: anh van xin, "chúng tôi" cần một thứ tốt hơn, một thứ thật sự đối đầu được với Opus 5.5, vì theo anh model đó đơn giản là không thể tin nổi, và chưa thứ gì OpenAI ra mắt đạt tới mức đó (theo Theo, video đăng ngày 03/11/2026). Anh nói anh rất nóng lòng xem OpenAI sẽ "nấu" ra gì.
Nguồn và liên kết 5 nguồn
- Tên gốc: OpenAI is getting desperate
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Hq2c7pww1Ds youtube.com
- Kênh YouTube Theo - t3․gg (Theo Browne): youtube.com/channel/UCbRP3c757lWg9M-U7TyEkXA youtube.com
- Artificial Analysis, nơi có Artificial Analysis Intelligence Index mà Theo dùng để so điểm và giá theo task (đọc ngày 03/11/2026): artificialanalysis.ai artificialanalysis.ai
Related talks
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.
Sáu skill Claude Code đáng dùng nhất sau hơn 100 skill đã thử
Tim Ruscica · Tech With Tim · 19 min
Cài và dùng thử sáu skill cho Claude Code: gstack, Hostinger MCP, Firecrawl, Humanizer, Composio và VibeSec, mỗi cái một demo thật.
10 plugin Claude Code đáng dùng cho project tiếp theo
Chase Hannegan · Chase AI · 12 min
Mười plugin, skill và CLI mới cho Claude Code: Graphify, grill-me, review plan bằng Codex, Obsidian, CLAUDE.md, Impeccable, NotebookLM, n8n MCP.