RAG đã đổi: pipeline, use case và cây quyết định chọn RAG năm 2026
Pipeline RAG production bảy bước, ba use case, chín loại RAG mới, vectorless RAG, LLM Wiki và cây quyết định chọn đúng RAG theo bài toán.
✓ Đã duyệt độc lập · cập nhật 15/10/2026 · 27 min
1. RAG đã đổi: chọn RAG "xịn" nhất có thể làm hệ thống tệ hơn
Maryam Miradi mở đầu bằng một khẳng định mạnh: RAG đã thay đổi rất nhiều trong năm 2026, và việc chọn loại RAG tiên tiến nhất thật ra có thể làm hệ thống của bạn tệ hơn. Bạn nhận thêm độ phức tạp, thêm latency, thêm chi phí, nhưng lại giải sai bài toán.
Chị kể rằng sau khi build hơn 400 hệ thống agentic, chị đã phát triển một decision tree đơn giản nhưng mạnh để chọn đúng thứ mà use case của bạn thật sự cần. Trong video, chị hứa sẽ đi qua lần lượt:
- pipeline RAG cho production;
- ba use case thực tế và loại RAG đúng cho từng cái;
- vectorless RAG;
- LLM Wiki của Andrej Karpathy;
- chín loại RAG hiện đại;
- và decision framework gom tất cả lại thành một.
2. RAG là gì, và vì sao có quyền truy cập thôi là chưa đủ
Phần một trả lời câu hỏi: RAG là gì? Nói gọn, RAG xuất hiện vì LLM không thể trả lời bằng tri thức mà nó không có. Công ty bạn có những chính sách nội bộ, bạn có những thông tin mà bạn không muốn đưa lên internet, và model chưa từng được train trên chúng. Khi đó bạn dùng RAG, tức retrieval augmented generation: truy xuất đúng những thông tin liên quan nằm bên ngoài model, rồi đưa chúng vào làm context để model ra quyết định đúng.
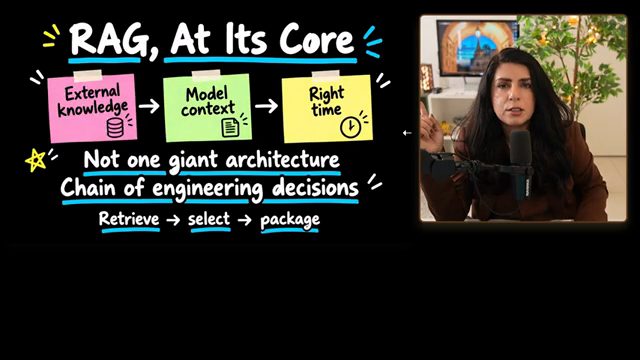
Ở cốt lõi, RAG có một nguồn tri thức bên ngoài, và nó đưa tri thức đó vào context của model. Điều ta cần là đưa vào đúng lúc. RAG không phải một kiến trúc khổng lồ duy nhất; nó là việc chọn lựa và quyết định xem model cần loại context nào.
Điều quan trọng thứ hai: có quyền truy cập (access) vào dữ liệu thôi là chưa đủ. Chị lấy ví dụ chính sách của một bệnh viện. Có người hỏi: "Ca này tôi có cần chuyển lên bác sĩ chuyên khoa không?" Để trả lời, bạn cần một thứ hiểu y khoa, bạn cần đúng chính sách hiện hành, và bạn cần đúng bằng chứng. Thứ đưa vào model phải là context dùng được (usable context), chứ không chỉ là "có quyền đọc tài liệu". Trên slide chị tóm thành một chuỗi: access, rồi retrieval, rồi usable context.
Từ đó chị chuyển sang pipeline. Nếu bạn không hiểu pipeline RAG, bạn về cơ bản không thể chọn được gì cả. Không nắm phần nền tảng bên trong việc mình đang làm thì bạn sẽ có xu hướng chọn luôn loại RAG tiên tiến nhất, và đó không phải một chiến lược tốt.
3. Bước ingestion: dữ liệu tệ thì retrieval tệ
Chị nói trước rằng mọi thứ chị trình bày đều nằm trong một bản "Production RAG Guide" miễn phí của chị, kèm link GitHub cho từng loại RAG, nên người xem không cần chụp màn hình lại.
Pipeline bắt đầu từ nguồn (source): bất kỳ file PDF hay thông tin nào ta đang có, và ta muốn ingest nó. Ingestion nghĩa là gì? Là câu hỏi: loại tri thức nào đi vào hệ thống của ta. Như với mọi thứ khác, dữ liệu tệ thì retrieval tệ (bad data, bad retrieval). Dữ liệu có thể là chính sách, hồ sơ (records), bảng, hình ảnh, hay bản ghi trong database.
Sau đó bạn phải parse những thông tin đó, làm sạch (clean), chuẩn hoá (normalize), giữ cho nó luôn cập nhật (keep current), rồi mới đưa cho RAG. Chất lượng đầu vào định hình chất lượng retrieval về sau. Lý do, theo chị: phần lớn thời gian, một chính sách nằm trong file PDF không phải là một bản ghi sống (trên slide ghi "Policy PDF ≠ live record"), nên nếu không giữ nó cập nhật thì hệ thống sẽ trả lời theo bản cũ.
4. Bước chunking: chia tri thức mà không làm vỡ nghĩa
Khi thông tin đã được ingest, ta muốn cắt nó thành từng mảnh, tức là chunking. Giả sử bạn có một chính sách dài 300 trang. Bạn biết ở đâu đó có một quy định (rule), và bạn muốn lấy đúng thông tin đó ra. Cái khó là: bạn có quy định ở trang này, nhưng ngay trang sau lại có một ngoại lệ (exception).
Nếu bạn chọn chunk một cách lỏng lẻo, bạn sẽ chỉ nhặt thông tin từ đúng phần chứa quy định, để rồi sau đó mới phát hiện ra mình đã quên mất cái ngoại lệ. Những chunk cắt "mù" như vậy làm mất nghĩa.
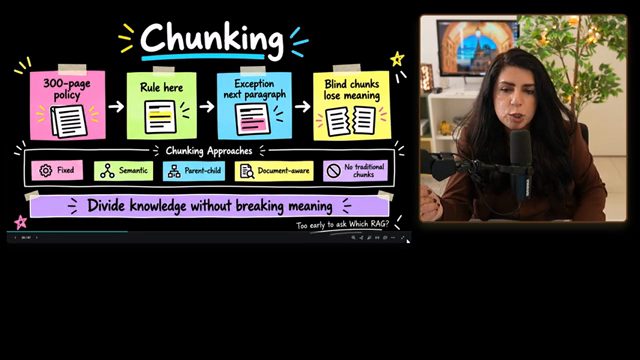
Vì vậy ta có nhiều cách chunking. Có thể là chunk cố định (fixed), chunk theo nghĩa (semantic), chunk dạng parent hoặc child, hoặc chunk dựa trên chính cấu trúc tài liệu (document-aware). Nhưng nếu ta chunk mà không hiểu nghĩa, tức kiểu chunking truyền thống, thì về sau chất lượng của thông tin lấy ra sẽ rất tệ. Thông điệp của slide: chia tri thức mà không làm vỡ nghĩa (divide knowledge without breaking meaning).
5. Representation và indexing: chọn cách biểu diễn khớp với hình dạng tri thức
Giả sử ta đã chunking đúng. Bây giờ ta cần biểu diễn (represent) các chunk đó và đánh index. Chị giải thích ý này bằng một ví dụ: ta có một cây cầu, một con đường, một tuyến đường (route), một dịch vụ cấp cứu, và câu trả lời nằm trong mối quan hệ giữa chúng. Nếu bài toán của ta có những kết nối như vậy, ta không thể chỉ đưa cho model mấy đoạn text rời.
Ta có thể đưa nó ở dạng vector. Cũng có thể ở dạng keyword, dạng phân cấp (hierarchy), dạng thực thể (entities, ví dụ con người), hay dạng quan hệ (relationships): con đường này nối với con đường kia. Tất cả những thứ đó có thể nằm trong các loại GraphRAG mà bạn từng nghe, và chị hứa sẽ giải thích cách chọn ở phần sau.
Điều chị muốn người xem hiểu: representation không chỉ là "tôi có một ít text" hay "tôi có một ít vector". Có chỗ bạn cần keyword. Dữ liệu của bạn có thể được biểu diễn cho RAG theo những định dạng khác nhau.
6. Retrieval, và ColBERT là gì
Khi đã biểu diễn xong thông tin, ta đi tới retrieval. Đây là chỗ có những kiểu retrieval hoàn toàn khác nhau. Chị đưa hai ví dụ đối lập. Một bên là bài toán kỹ thuật về tuabin gió, câu hỏi kiểu "tuabin rung khi chạy tải cao": đó là truy vấn theo nghĩa (semantic). Bên kia là một keyword chính xác, chẳng hạn một biển số xe (trên slide là mã "XJ-174-B"). Vì vậy phương pháp retrieval sẽ rất khác nhau: có thể là dense, với nhiều thông tin; có thể là sparse.
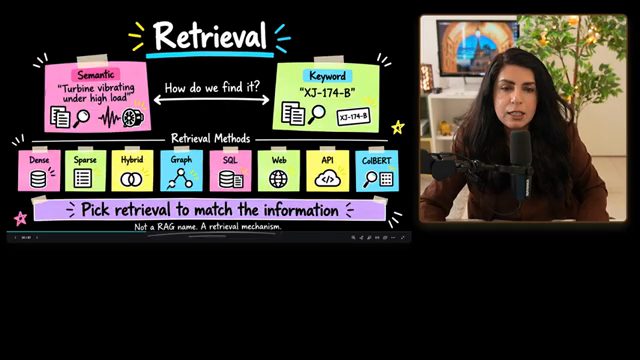
Retrieval cũng có thể là hybrid, có thể là graph như các bước trước đã gợi ý, có thể là dữ liệu SQL, tức dữ liệu truyền thống, có thể lấy từ web, từ API, hoặc có thể là ColBERT. Bạn phải chọn kiểu retrieval khớp với loại thông tin của mình.
ColBERT là gì? Đó là một kỹ thuật retrieval. Thông thường, trong pipeline RAG ta đưa vào một câu hỏi và một tài liệu đã được cắt thành các chunk. Với ColBERT, mọi thứ được xử lý theo từng token: cả câu hỏi lẫn tài liệu dùng để tìm câu trả lời đều được so khớp token với token (token matching). Như bạn có thể đoán, cách này đắt hơn nhiều, nhưng chính xác hơn retrieval thông thường. Trên slide, ColBERT được vẽ là query và doc cùng đi vào bước token matching, với ghi chú: retrieval truyền thống dùng một vector cho query và một vector cho chunk, còn đây không phải một loại RAG.
7. Ranking và reranking: nhiều context hơn chưa chắc tốt hơn
Lấy được thông tin vẫn chưa đủ, vì bạn có thể lấy về 50 mẩu thông tin "gần như liên quan". Lúc này bạn phải chọn, tức xếp hạng (rank) để lấy phần tốt nhất. Có 50 ứng viên thì không thể gửi hết cho model. Cách làm là: ở bước retrieval thì đi rộng một chút, rồi ở bước ranking và reranking thì đi thật chính xác. Retrieval trả lời "cái gì có thể liên quan", còn ranking trả lời "cái gì quan trọng nhất".
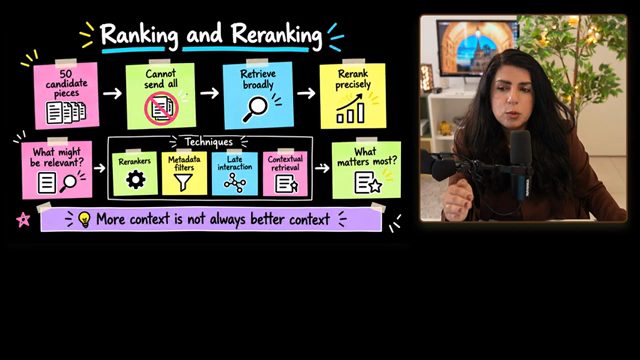
Các kỹ thuật có thể dùng gồm re-ranker, metadata filter, late interaction, hoặc contextual retrieval, để chỉ chọn ra những gì thật sự quan trọng nhất. Chị giải thích từng cái:
- Reranker: chấm điểm lại (rescore) các ứng viên.
- Metadata filter: bạn có thông tin theo ngày, nguồn, loại tài liệu, nên chỉ việc lọc.
- Late interaction: so khớp token một cách chính xác và chi tiết hơn.
- Contextual retrieval: thêm phần context xung quanh vào chunk để tìm ra cái thực sự đáng xếp hạng cao nhất.
Trên slide tổng hợp các kỹ thuật, có dòng nhỏ nhắc rằng đây là những kỹ thuật ranking, không phải những "họ RAG" riêng biệt.
8. Context construction, generation và "The Big Reveal"
Khi đã chọn xong, ta muốn dựng context. Bạn đã retrieve được một số bằng chứng: có thể là thông tin thuốc, chống chỉ định, chính sách bệnh viện, hướng dẫn lâm sàng. Ở bước context construction, bạn sắp xếp thứ tự chúng (order), nén lại (compress), loại trùng (deduplicate), dựng cấu trúc (structure), rồi mới đưa đúng bằng chứng vào.
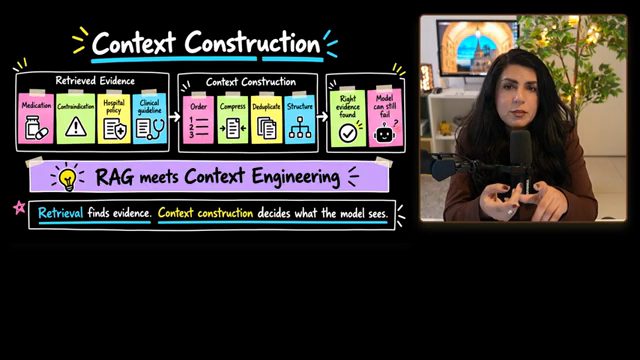
Tất nhiên, đây chính là thứ ta vẫn gọi là context engineering: đây là chỗ RAG gặp context engineering. Retrieval tìm ra bằng chứng, còn context construction quyết định model sẽ nhìn thấy gì.
Kết quả cuối cùng là gì? Khi đã dựng xong context, ta có thể generate. Đây là bước ta dùng LLM một cách tự nhiên để tạo ra câu trả lời thân thiện với con người. Ta muốn nó rõ ràng, chính xác, và tất nhiên là grounded (bám vào bằng chứng). Slide của bước này viết: retrieval tìm ra bằng chứng, generation biến nó thành câu trả lời.
Rồi đến "The Big Reveal". Trước đây, nếu bạn nhìn toàn cảnh RAG, mọi thứ trông rất rối: advanced RAG, agentic RAG, GraphRAG, Self-RAG, corrective RAG, adaptive RAG, hybrid RAG, và ai đó cứ đưa cho bạn một cái rồi bảo cứ dùng đi. Cách đó rất tốn kém. Nhưng giờ bạn đã có các bước để build RAG, và ở mỗi bước bạn chọn chính sách tốt nhất cho bước đó. Gộp lại, những lựa chọn ấy đưa bạn tới đúng loại RAG.
Chị nhắc lại các bước cần nhớ: ingestion, representation, retrieval, ranking, construction, và cuối cùng là generation cùng một control layer đặt trên generation. Chị hứa sẽ cho xem ví dụ thực tế, và sau đó là cách evaluate retrieval. Trên slide "The Big Reveal", phía "Before" là hơn 30 kiến trúc RAG trông rối rắm; phía "After" là bảy quyết định (biết mình có tri thức gì, ingest và segment, represent, retrieve, rank, construct context, control retrieval) cộng một bước thứ tám: đánh giá xem nó có thật sự chạy được không, qua retrieval quality, grounding, answer quality, latency và cost.
9. Use case 1 và 2: chính sách bệnh viện và hạ tầng đường bộ
Phần ba là áp vào use case thật. Chị đưa ba ví dụ, cũng đều có trong guide: ví dụ một là chính sách bệnh viện, dùng một RAG đơn giản (naive RAG); ví dụ hai là hạ tầng đường bộ, dùng GraphRAG; ví dụ ba là quản lý sự cố thời gian thực (live incident management), dùng agentic RAG.
Ví dụ 1: Hospital Policy
Một bệnh viện có một bộ file PDF chính sách, và nhân viên có câu hỏi. Có cần GraphRAG không? Nhiều khả năng là không. Thách thức ở đây là:
- giữ đúng các mục (section) của chính sách;
- lọc theo phiên bản chính sách hiện hành;
- retrieve đúng những đoạn liên quan;
- rank chúng cho tốt;
- trả về một câu trả lời tốt.
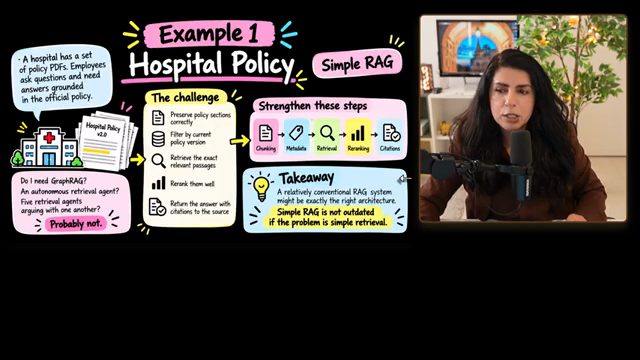
Nhìn vào đó, ta thấy RAG đơn giản không hề lỗi thời, RAG không chết. Ở đây nó chính là thứ duy nhất ta cần dựa trên use case đó, vì phần retrieval khá đơn giản.
Ví dụ 2: Road Infrastructure
Khi chuyển sang hạ tầng đường bộ, câu hỏi không còn là "sổ tay bảo trì này nói gì". Ta muốn xem tác động của việc bảo trì. Nếu bạn đóng một con đường, thì ở chỗ khác sẽ có vấn đề, đúng không? Đó là một mạng lưới rất lớn các thứ phải biết. Điều quan trọng là: những con đường nối với nhau, các cây cầu, các tuyến, các dự án bảo trì chồng lấn, nhà thầu phụ trách tài sản, và các sự cố ảnh hưởng tới đường vòng. Tất cả những câu trả lời ấy phải được trả lời ngay khi bạn dùng retrieval.
Lý do là bạn có quan hệ: sự kết nối từ con đường này sang con đường khác, từ điểm này sang điểm khác. Khi đó bạn thật sự cần knowledge graph, và vì thế ta dùng GraphRAG cho trường hợp này. Không phải vì GraphRAG đang là trend, không phải vì Karpathy bảo dùng, mà vì nó là hệ quả của yêu cầu: use case của bạn cần đến nó. Trên slide, takeaway ghi: GraphRAG không phải một kiến trúc thời thượng, nó là hệ quả của yêu cầu; và chỉ cần đổi một yêu cầu (từ "sổ tay nói gì" sang "đóng con đường này thì còn gì bị ảnh hưởng") là kiến trúc đổi ngay.
10. Use case 3: quản lý sự cố thời gian thực và Agentic RAG
Ví dụ ba là live incident management. Ta làm bài toán khó hơn nữa: đường bị ngập lụt, một dạng quản lý thảm hoạ, bạn thật sự đang ở tình huống khẩn cấp. Hãy nghĩ tới road graph, dữ liệu thời tiết thời gian thực, dữ liệu giao thông, tài liệu bảo trì, tất cả cùng lúc.
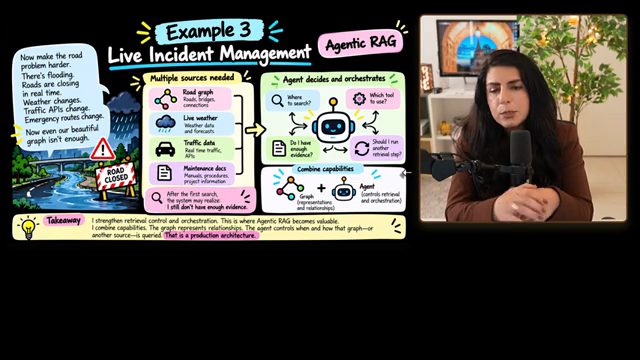
Lúc này bạn phải quyết định, và quyết định đó phải mang tính agentic: tìm ở đâu? Dùng tool nào? Có nên chạy thêm một vòng retrieval nữa không? Tất cả những thứ đó phải là một năng lực kết hợp, và đó là lý do ta dùng agentic RAG. Takeaway trên slide: kết hợp năng lực, graph biểu diễn quan hệ, còn agent điều khiển khi nào và cách nào graph đó (hoặc một nguồn khác) được truy vấn; đó là một kiến trúc production.
Chị sẽ giải thích kỹ hơn ngay sau đó. Còn bây giờ, chị muốn người xem biết rằng: giống như cách ta build AI agent (chủ đề của các video và khoá học của chị), ở đây ta về cơ bản build agent cho RAG, để chúng lấy về đúng context và ta retrieve được đúng thông tin.
11. Chín RAG mới, nhóm 1: knowledge structure (RAPTOR, GraphRAG, HippoRAG)
Phần bốn nhìn vào một số loại RAG mới. Chị chia chúng thành ba cụm: knowledge structure, retrieval quality, và control.
- Knowledge structure: RAPTOR, GraphRAG và HippoRAG.
- Retrieval quality: contextual retrieval, kiểu ColBERT, và CRAG (corrective RAG).
- Control: Self-RAG, adaptive RAG và agentic RAG.
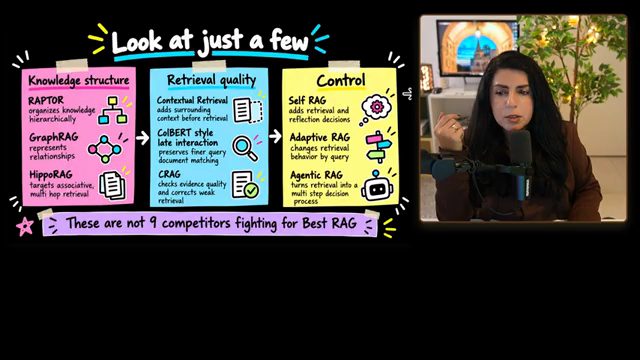
Chị hứa sẽ đưa decision tree để biết chính xác nên chọn cái nào, nhưng trước hết xem từng cái. Với các RAG thuộc nhóm knowledge structure, câu hỏi là: chúng thay đổi bước nào trong quy trình bảy bước chị vừa đưa?
RAPTOR. Ở bước ingest và segment, bạn dùng tóm tắt phân cấp (hierarchical summary), vì RAPTOR xoay quanh việc dùng một cái cây để biểu diễn tri thức. Vậy ở bước representation, bạn có cây phân cấp. Ở bước retrieval, ta có retrieval nhiều tầng (multi-level), cho biết chính xác cái gì quan trọng, cái gì kém quan trọng hơn khi đi sâu xuống cây. Ở bước construct context, slide ghi "summary + detail".
GraphRAG đơn giản là dùng graph. Ở bước ingest hay segmentation, ta có thực thể (entities) và quan hệ (relations). Nếu bạn chưa quen với graph engineering, chị có một video riêng về chủ đề đó. Thực thể là các node, còn quan hệ là các cạnh (edges): một bác sĩ có một bệnh nhân, hay con đường này nối với con đường kia. Sau đó ta biểu diễn thành knowledge graph, retrieval sẽ đi đúng những bước trên graph cần thiết (graph traversal), và phần còn lại tất nhiên là dựng context đã được nối với nhau (connected evidence).
HippoRAG thì dùng các khái niệm (concepts). Ta dùng một graph mang tính liên tưởng (associative graph), giống một dạng bộ nhớ, rồi retrieve theo kiểu multi-hop. Có thể hiểu là một chút graph cộng một chút memory thì ra HippoRAG.
12. Nhóm 2 và 3: retrieval quality, control, và mental model chung
Như vậy, nhóm knowledge structure chủ yếu chạm vào phần ingestion, phần representation và phần construction.
Sang nhóm retrieval quality, đầu tiên là contextual retrieval. Ở bước ingest, ta thêm context vào; ở bước representation, ta có những chunk giàu context (context-rich chunks), và nhờ đó retrieval tốt hơn. Nhóm này chủ yếu xoay quanh việc cải thiện retrieval.
Với ColBERT, ta biểu diễn ở mức token. Vì biểu diễn rất chi tiết, rất mịn, nên retrieval cũng tốt hơn. Tất nhiên, nó hơi tốn tài nguyên tính toán.
Rồi đến CRAG, tức corrective RAG. Nó được sửa sau khi retrieve, ở bước ranking: ta chấm điểm (grade) dựa trên bằng chứng, và nhờ đó cải thiện bằng chứng. Đây là kiểu tác động "sau sự việc".
Nhóm thứ ba là các RAG điều khiển (control RAGs): Self-RAG, adaptive RAG và agentic RAG.
- Self-RAG: ở bước retrieval, ta chỉ retrieve khi cần. Ở bước control retrieval, có một vòng phản tư (reflection): cái này ổn chưa? Chưa thì retrieve lại. Về cơ bản là tự cải thiện, khá agentic.
- Adaptive RAG: dùng chính phần retrieve đó nhưng đổi chiến lược dựa trên câu hỏi bạn đặt ra. Như bạn có thể đoán, cái này cũng mang tính agentic, vì nó nhìn vào phần control và retrieval dựa trên loại hành vi, loại câu hỏi. Nó ước lượng nên chọn kiểu trả lời nào, route nào, dựa trên câu hỏi bạn hỏi.
- Agentic RAG: dùng retrieval nhiều bước, cả một vòng plan, route, retry. Context được chọn lặp đi lặp lại, và context tốt được chọn dựa trên việc agent của bạn cho rằng cái gì cần thiết để sinh câu trả lời.
Với ba cái này, tầng chúng tác động thật ra là tầng cuối cùng: sau khi đã dựng xong câu hỏi, bạn cải thiện nó bằng agent chạy trong vòng lặp. Link GitHub của từng loại RAG đều nằm trong guide của chị.
Từ đó ta có một mental model. Có loại RAG giải quyết vấn đề ở representation, có loại ở retrieval, có loại ở bằng chứng, có loại ở control.
- Vấn đề representation: GraphRAG, RAPTOR, HippoRAG. Chúng làm context giàu hơn nhiều.
- Vấn đề độ chính xác của retrieval: ColBERT, contextual retrieval, để retrieval tốt hơn. Ví dụ với ColBERT, bạn dùng các token, nên độ chính xác của token matching tốt hơn so với chunk, vốn là một cụm vài từ.
- Vấn đề bằng chứng tệ: ta luôn cần một dạng corrective (reranking, các cách tiếp cận corrective).
- Vấn đề control: ta đã generate ra thứ gì đó và muốn cải thiện nó bằng hệ agentic như đã giải thích (Self-RAG, Adaptive RAG, Agentic RAG).
Kết luận của chị: không phải ta có 40 bài toán RAG khác nhau. Mà là ta có loại vấn đề kiến trúc nào, và có những kỹ thuật nào để giải nó.
13. Vectorless RAG: không có nghĩa là vector đã chết
Phần năm là vectorless RAG. Trước khi đưa decision tree, chị nói về một thuật ngữ đang được dùng ngày càng nhiều mà có thể bạn đã nghe: vectorless RAG. Có người bảo: đừng dùng vector nữa, vì vector đã chết. Điều đó không đúng, và đó là cùng một kiểu sai lầm. Vectorless RAG không có nghĩa là vector (hay vector database) đã chết. Nó có nghĩa là bạn phải hỏi lại: mình đang có loại dữ liệu gì?
Nếu đó là dữ liệu có cấu trúc, như customer ID, giao dịch, những thứ kiểu đó, và câu hỏi là "cho tôi xem mọi giao dịch thất bại" (trên slide: "Show me all failed transactions for customer 1842 during September"), thì nó được lợi nhất từ một truy vấn có cấu trúc (structured query). Cách đó có thể tốt hơn nhiều so với semantic similarity, và khi đó bạn không cần vector.
Nếu câu hỏi dựa vào những thuật ngữ chính xác, đó là lexical retrieval. Nếu nằm ở quan hệ, đó là graph retrieval. Vector similarity là một lựa chọn. Khi có dữ liệu có cấu trúc, bạn có thể dùng kiểu vectorless. Nhưng điều đó không có nghĩa vectorless là tốt nhất cho mọi tình huống.
14. LLM Wiki của Karpathy: RAG tái dựng câu trả lời, wiki duy trì tri thức
Một chủ đề khác mà ai cũng đang nói tới là LLM Wiki của Andrej Karpathy, kèm câu "RAG đã chết vì LLM Wiki của Karpathy đã có rồi". Chị muốn làm rõ chuyện này. Karpathy đã đổi câu hỏi, và thú vị hơn nữa, ông thách thức RAG truyền thống. Năm 2026, Karpathy đề xuất ý tưởng knowledge base do LLM duy trì, gọi là LLM Wiki (bản mô tả llm-wiki của Karpathy). Câu hỏi của ông là: vì sao ta cứ phải tái dựng lại hiểu biết từ tài liệu thô mỗi lần có người hỏi?
Vậy LLM Wiki đặt ra một câu hỏi khác so với RAG truyền thống. Có thể hình dung là đi từ tài liệu thô sang những trang sống (living pages). Bạn có 100 tài liệu nghiên cứu, ví dụ về AI agent: paper, ghi chú, nguồn tham khảo, đủ thứ.
- Trong RAG thông thường: bạn giữ nguyên tài liệu, đặt câu hỏi, retrieve, tổng hợp, và ngày mai lại retrieve lại từ đầu.
- Trong LLM Wiki: bạn có memory. Nó kết hợp context engineering, agent, evaluation, RAG và học liên tục (continual learning), rồi trở thành một nơi chứa tri thức sống. Nó tạo ra các quan hệ, tự cập nhật khi có bằng chứng mới, có thể thể hiện cả những chỗ bất đồng, và giữ lại các artifact lâu dài.
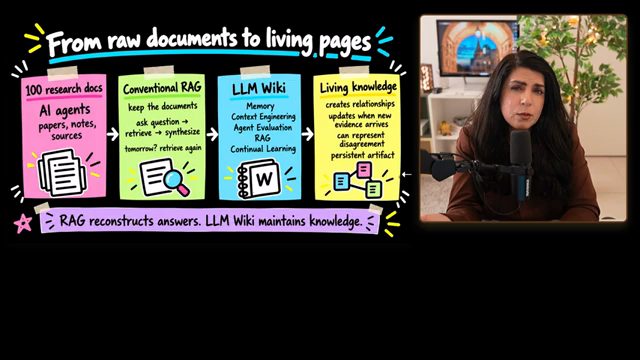
Cách hai thứ vận hành là khác nhau: RAG tái dựng câu trả lời, còn LLM Wiki duy trì một knowledge base. Và một lần nữa, không cái nào tự động tốt hơn hay tệ hơn. Mỗi cái chỉ hữu ích cho một loại công việc cụ thể. Ví dụ khi làm nghiên cứu, tri thức cứ lớn dần lên và bạn muốn bổ sung tài liệu mới vào phần đã có.
Vậy khi nào dùng RAG, khi nào dùng wiki? Với một chính sách thanh toán chính thức của bệnh viện, thứ về cơ bản không thay đổi, câu hỏi kiểu "có nên để một wiki đang tiến hoá làm nguồn sự thật duy nhất không?" được trả lời trên slide là "I wouldn't": với chính sách chính thức, hãy giữ nguồn có thẩm quyền. Một dạng câu hỏi khác về chính sách: "theo chính sách phiên bản 4.2, khoản thanh toán này có được hoàn trả không?" Khi đó điều quan trọng là tài liệu có thẩm quyền, phiên bản, câu chữ chính xác, nguồn gốc (provenance) và trích dẫn.
Ngược lại, với một dự án nghiên cứu, có thể có paper mới, thí nghiệm mới, kết luận mới, mâu thuẫn mới, quan hệ mới, và bạn không muốn khám phá lại toàn bộ dự án mỗi lần. Đó là lúc bạn muốn một bản tổng hợp lâu dài (persistent synthesis), và là lúc dùng LLM Wiki.
Tóm lại: RAG cho bằng chứng chính xác, có thẩm quyền, rất hữu ích. LLM Wiki cho hiểu biết tích luỹ, đang tiến hoá, và trở nên thú vị. Cần cả hai thì kết hợp. Hệ thống tốt nhất về cơ bản là giữ nguồn thô, duy trì tri thức đã tổng hợp, rồi retrieve bằng chứng gốc khi bạn cần provenance, cần theo dõi và truy vết. Không nhất thiết phải là RAG hoặc LLM Wiki: bạn có thể kết hợp cả hai, thậm chí trong cùng một dự án nhưng cho hai khía cạnh khác nhau của dự án đó.
15. Decision framework: bắt đầu từ câu hỏi đúng
Phần bảy là decision framework chị đã hứa. Chị muốn người xem bắt đầu bằng đúng câu hỏi. Nếu đồng nghiệp nói "ừ, mình cần một RAG", đừng hỏi ngay "dùng vector database nào?" hay "có nên làm GraphRAG không?". Chưa phải lúc. Trước hết hãy hiểu thông tin đang có loại vấn đề gì. Đừng bắt đầu từ tool; hãy bắt đầu từ nhu cầu của hệ thống.
Sau đó, đưa vấn đề đó đi qua kiến trúc, từng bước:
- Knowledge: hệ thống thật sự cần thông tin gì?
- Ingestion và segmentation: làm sao giữ được nghĩa khi đưa thông tin vào?
- Representation: có thể là vector, keyword, hierarchy, graph, dữ liệu có cấu trúc, hay tri thức đã tổng hợp. Vì bạn đã trả lời xong bước hai, bạn cũng sẽ biết bước ba.
- Retrieval: làm sao tìm ra đúng bằng chứng ứng viên cho câu hỏi được đặt ra?
- Relevance: rank, re-rank, chấm điểm, lọc, sửa, để đưa ra đúng những gì cần.
- Context: dựng context, tức cái gì thực sự tới được model, dưới hình dạng nào.
- Control: ai quyết định có retrieve hay không, retrieve ở đâu, và bao lâu một lần?
Và ta luôn cần evaluate, phần mà chị sẽ trình bày ngay sau.
16. Thiết kế RAG năm 2026 và cây quyết định
Đây là cách chị muốn người xem nghĩ, cũng là cách chị sẽ thiết kế RAG năm 2026. Câu hỏi bây giờ không phải "nên dùng RAG nào?". Hãy hỏi "hệ thống của tôi cần làm gì?", rồi chọn "năng lực retrieval nào giúp làm được điều đó?". Từ đó bạn có logic thiết kế: nhu cầu hệ thống trước, lựa chọn retrieval sau. Thiết kế từ nhu cầu hệ thống, không thiết kế từ nhãn RAG.
Bài học bền vững chị rút ra: đừng chạy theo hay học mọi loại RAG mới, vì có ít nhất 40 loại. Hãy hiểu vấn đề thông tin, hiểu pipeline retrieval, rồi làm mạnh đúng phần mà vấn đề của bạn thật sự đòi hỏi.
Điểm quan trọng nữa: mental model cũ chỉ là chunk, embed, vector search, prompt, generate, và đó là mô hình của năm 2023. Mô hình 2023 ấy không còn mô tả được những hệ thống ta đang build. Năm 2026, ta có mô hình hybrid: có thể dựa trên graph, có thể phân cấp, có thể multimodal. Ở phần control cũng có thể là corrective, adaptive, agentic, hoặc có tri thức lâu dài với LLM Wiki. Ta kết hợp các loại RAG này nếu hệ thống của ta cần. Trên slide: retrieval không biến mất, nó trở nên giàu hơn và mang tính kiến trúc hơn.
Chị muốn người xem không chọn RAG tiên tiến nhất, mà dùng decision tree chị đưa. Chính điều đó cho bạn "RAG Maxxing": khai thác tối đa từng phần của RAG mà use case của bạn cần. Chị nói chị không bao giờ chọn một RAG tiên tiến chỉ vì nghe nó rất ngầu.
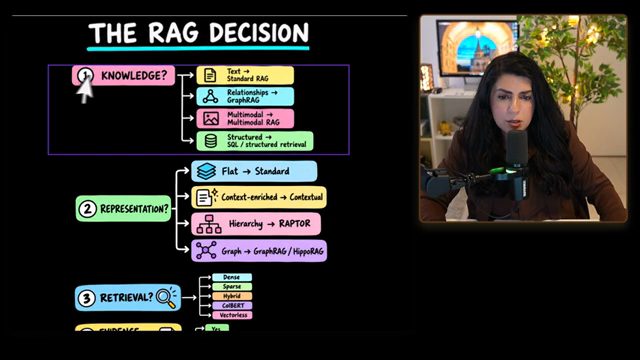
Rồi chị đi qua cây quyết định:
- Knowledge: nếu tri thức là text thì dùng standard RAG. Nếu là quan hệ thì GraphRAG. Nếu multimodal thì multimodal RAG. Nếu có cấu trúc thì có thể là SQL hoặc structured retrieval.
- Representation: phẳng (flat) thì standard. Giàu context thì contextual. Phân cấp thì dùng RAPTOR. Là graph thì GraphRAG hoặc HippoRAG.
- Retrieval: nhìn vào dense, sparse, hybrid, ColBERT hoặc vectorless, và chọn bất kỳ cái nào theo nhu cầu.
- Bằng chứng đã đủ tốt chưa? Nếu chưa, có thể dùng re-ranking và corrective RAG (CRAG).
- Có cần thích nghi theo câu hỏi không? Nếu có, đó là adaptive RAG và Self-RAG.
- Có cần lập luận qua nhiều tool (multi-tool reasoning) không? Đó là chỗ agentic RAG xuất hiện.
- Có cần tri thức lâu dài không? Nếu có, thêm LLM Wiki lên trên RAG như một tầng lưu giữ lâu dài.
Cuối sơ đồ là dòng evaluate, gồm quality, grounding, cost, latency và freshness; phần evaluation chị để sang mục kế tiếp.
17. Control layer và evaluation
Phần cuối là control và eval. Chị quay lại pipeline RAG. Ở control layer, ta xem xét chiến lược truy vấn (query strategy), routing, retry, quyết định có retrieve không, và chọn nguồn. Ta nghĩ: có nên retrieve không, retrieve từ đâu, có viết lại câu hỏi không, có nên tìm lại không, có nên dùng nguồn khác không? Đó là chỗ mọi cách tiếp cận chị đã giải thích (Self-RAG, corrective RAG, adaptive RAG và agentic RAG) phát huy tác dụng. Trên slide "Retrieval Control", một câu hỏi kiểu "2 + 2" thì không cần retrieval, còn câu hỏi về chính sách chuyển tuyến bệnh nhân mới nhất thì cần retrieve; và dùng agentic RAG khi retrieval cần lập luận và điều khiển.
Nhưng ta cũng cần các tầng evaluation. Ta muốn câu trả lời liên quan (relevant), có grounding, thật sự có bằng chứng. Nó phải trung thực với nguồn (faithful). Ta cũng cần tối ưu latency và cost. Ta muốn kiểm xem đúng mục, đúng bằng chứng đã được dùng hay chưa, và không có hallucination trong suốt quá trình.
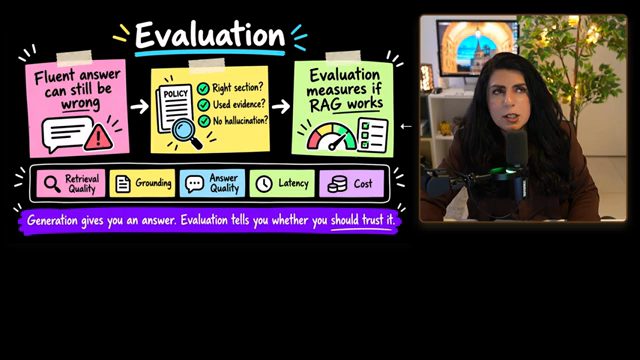
Vậy ta sẽ đo retrieval quality, grounding, answer quality, latency và cost, chứ không chỉ đo kết quả cuối cùng là gì. Nhờ đó ta đảm bảo RAG của mình không bị trôi (drift) mà vẫn giữ được sự liên quan khi chạy production.
Chị nhắc lại rằng mọi thứ đều có trong guide ở phần mô tả video. Theo chị, RAG là một trong 20 khái niệm AI agent thật sự quan trọng nếu bạn nhắm tới các vị trí senior AI, và chị có một video riêng về 20 khái niệm agent đang thật sự quan trọng lúc này, rồi hẹn gặp người xem ở video đó.
Nguồn và liên kết 13 nguồn
- Tên gốc: RAG Has Changed: 2026 Senior AI Engineer’s Guide | Types, Use Cases & Decision Tree
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Hn38fv4tNE4 youtube.com
- Kênh YouTube Dr. Maryam Miradi (Maryam Miradi): youtube.com/channel/UCIQzTfzErmrixae2oFqRxyg youtube.com
- RAPTOR: Recursive Abstractive Processing for Tree-Organized Retrieval (paper): arxiv.org/abs/2401.18059 arxiv.org
- GraphRAG, hệ RAG dựa trên graph của Microsoft: github.com/microsoft/graphrag github.com
- HippoRAG, framework RAG lấy cảm hứng từ bộ nhớ dài hạn (knowledge graph + Personalized PageRank): github.com/OSU-NLP-Group/HippoRAG github.com
- Contextual Retrieval của Anthropic: anthropic.com/news/contextual-retrieval anthropic.com
- ColBERT (late interaction retrieval): github.com/stanford-futuredata/ColBERT github.com
- Corrective Retrieval Augmented Generation (CRAG): arxiv.org/abs/2401.15884 arxiv.org
- Self-RAG: Learning to Retrieve, Generate, and Critique through Self-Reflection: arxiv.org/abs/2310.11511 arxiv.org
- Adaptive-RAG: thích nghi retrieval theo độ phức tạp của câu hỏi: arxiv.org/abs/2403.14403 arxiv.org
- LLM Wiki của Andrej Karpathy: gist.github.com/karpathy/llm-wiki gist.github.com
Related talks
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Build một memory system cho AI agent: nó chạy thế nào
AI Systems with Andy · AI Systems with Andy · 8 min
Build long-term memory cho AI agent: write pipeline, embedding, retrieval, metadata filter, rerank, cập nhật preference giữ lịch sử và write policy.