Recursive Coding Agents
AI Engineer World's Fair 2026: Online Track · Video gốc
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
1. Ai cũng muốn outcome, nhưng chưa ai dám tin agent
Raymond Weitekamp mở đầu bằng lời giới thiệu ngắn: talk này nói về recursive coding agent, tức ý tưởng đem các bài học của recursive language model (RLM) áp dụng vào coding agent. Đây là phần việc anh làm ở cả hai nơi: trong nghiên cứu độc lập dưới tên RAW.works, và gần đây hơn là trong vai trò của anh tại OpenProse.
Để tạo động lực cho vấn đề, anh bắt đầu từ thứ mà ai cũng muốn: outcome. Chúng ta đều muốn có agent làm việc thay mình, muốn có những "đồng nghiệp" đáng tin cậy hoàn thành công việc trong lúc mình đang làm việc gì đó vui hơn: đi leo núi (hike), ngồi thư giãn, hay đơn giản là "đang bận việc riêng".
Lập luận của anh, và cũng là trải nghiệm thực tế của anh, là nút thắt (bottleneck) ở đây không phải trí thông minh. Model đã đủ thông minh rồi. Chúng biết đủ mọi thứ, biết gần như toàn bộ internet. Nhưng chúng không giao được outcome một cách đáng tin cậy, và vì vậy anh không thể tin chúng.
Ví dụ rất đơn giản: một ngày nọ, anh nhận được gần như trọn vẹn một SaaS app chạy được chỉ từ một prompt (dù phải thừa nhận đó là một prompt dài). Ngày hôm sau, và anh thề là chuyện này có thật, Claude Code làm trống sạch toàn bộ ví Solana của anh. "Oops." Anh cười: chuyện như vậy thì khó mà tạo ra niềm tin.
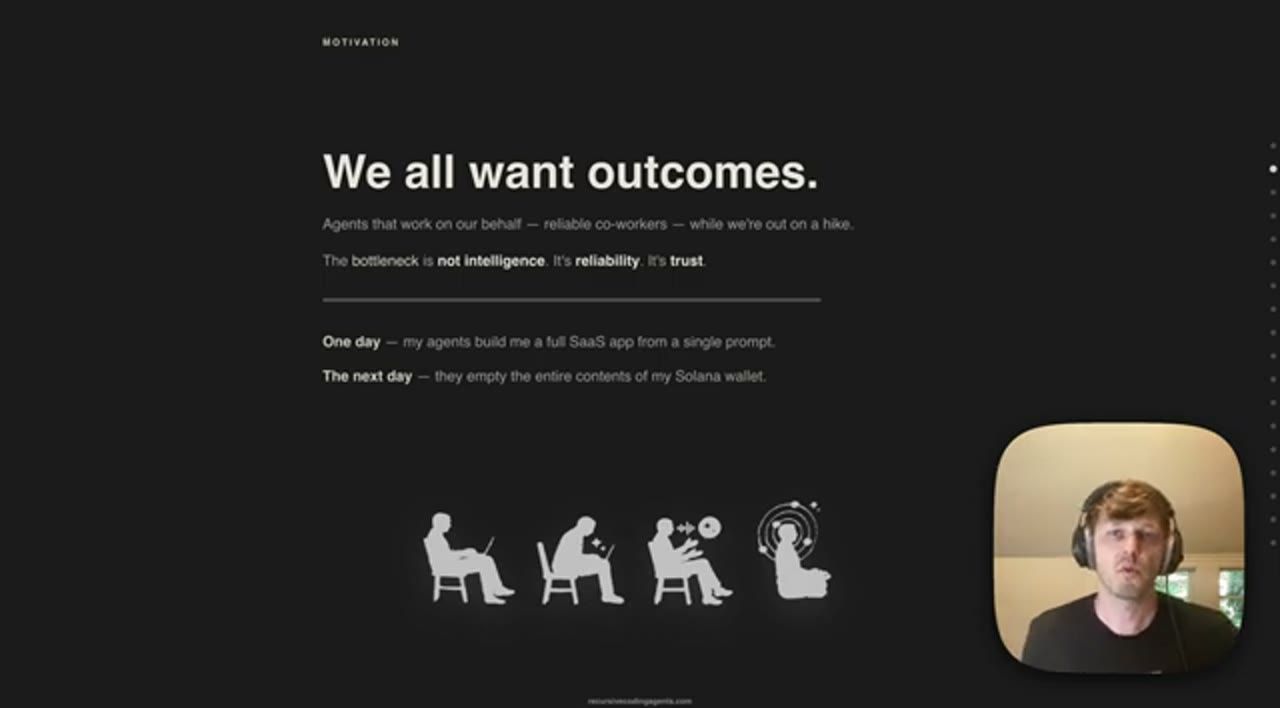
Ở cuối slide là một chuỗi tiến hoá (progression) bốn hình. Ai cũng muốn tiến về hình bên phải, nơi ta chỉ ngồi đó thiền và mọi thứ tự "manifest" ra. Hình này đến từ đâu? Từ AI Engineer Code, tháng 11 năm 2025, cụ thể là in ở mặt sau chiếc áo thun của sự kiện. Raymond nói anh hy vọng người nghe đã có mặt ở đó; nếu chưa thì nên xem lại trên YouTube, vì đó là một sự kiện tuyệt vời.
2. Thesis: agent hôm nay là những thiên tài bị quản lý sai
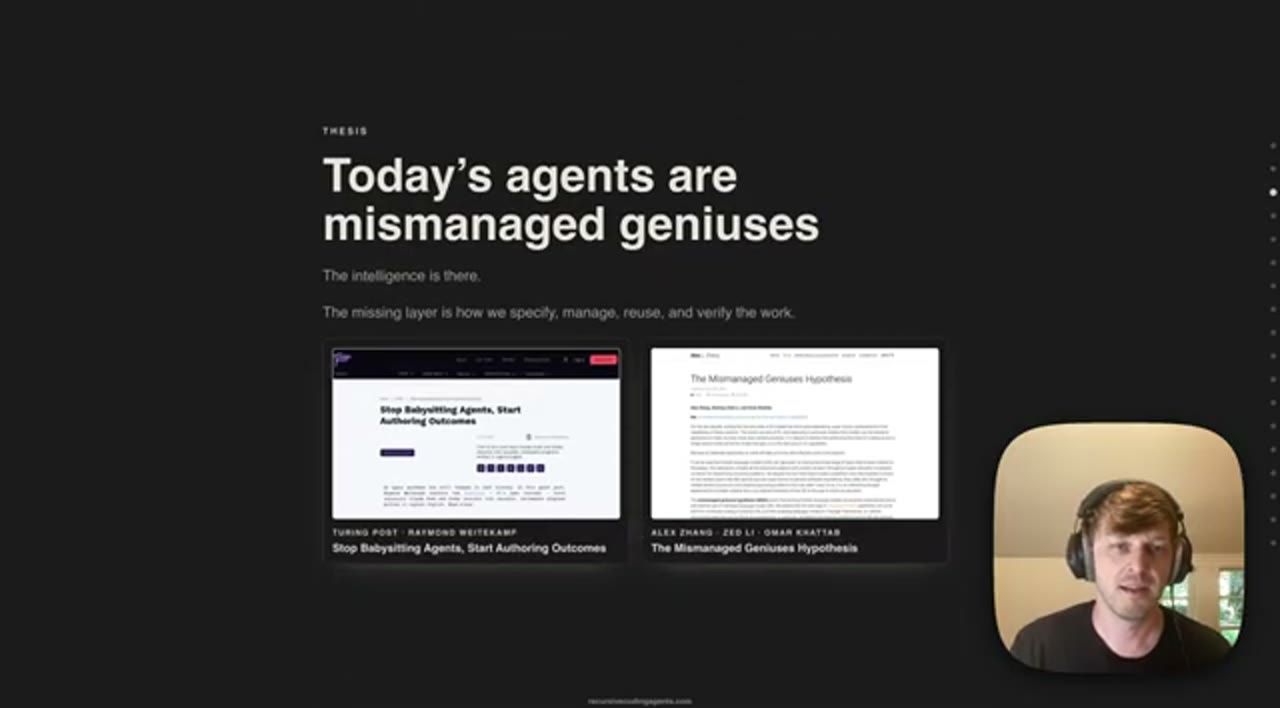
Thesis của talk được phát biểu gọn: agent ngày nay là những thiên tài bị quản lý sai (mismanaged genius). Trí thông minh đã có sẵn. Lớp còn thiếu là cách chúng ta đặc tả (specify), quản lý (manage), tái sử dụng (reuse) và kiểm chứng (verify) công việc.
Cách đóng khung (framing) này, cụm từ "mismanaged genius", đến từ Alex Zhang, Zed Li và Omar Khattab ở MIT, trong bài "The Mismanaged Geniuses Hypothesis". Alex và Omar cũng nằm trong nhóm tác giả của paper gốc Recursive Language Models. Raymond cũng đã viết thêm về chủ đề này gần đây trên Turing Post, trong bài "Stop Babysitting Agents, Start Authoring Outcomes".
Anh chèn thêm một lưu ý mà anh quên nói ở đầu: các slide này thực ra là một website, recursivecodingagents.com. Người xem có thể vào đó và bấm vào từng thứ trên slide; mọi thứ anh trình bày trong talk đều có thể tương tác được.
3. RLM là gì: chính context trở thành đối tượng để tính toán
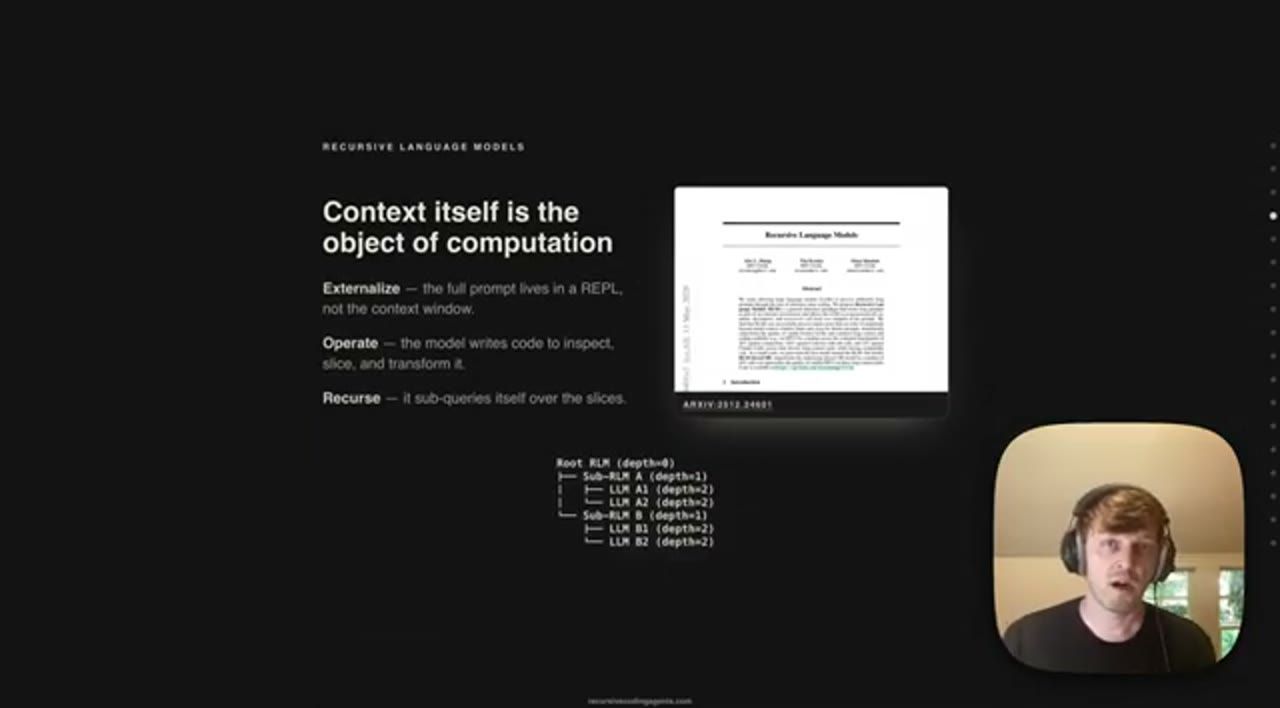
Vậy recursive language model là gì? Raymond thích nói thế này: trong một RLM, chính context là đối tượng của phép tính (object of computation). Về bản chất, đây là cuộc "kết hôn" giữa tool calling và reasoning; anh sẽ nói kỹ hơn ở slide sau.
Ý tưởng là full prompt không còn là một câu hỏi đơn giản của người dùng. Full prompt là một biến (variable). Nó có thể là một file, hoặc rất nhiều file. Agent tương tác với một vòng lặp Read-Evaluate-Print, tức REPL; trong paper gốc, REPL đó là Python. RLM được dặn phải thao tác một cách symbolic trên prompt đó: đừng đọc toàn bộ vào context window. Hãy khám phá nó bằng code.
Hơn thế nữa, RLM thậm chí không trực tiếp khám phá hết bằng symbolic. Có thể nó "chọc ngó" một chút, nhưng phần chính là giao cho các LLM khác, và nếu cho phép độ sâu đệ quy (recursion depth) lớn hơn 1 thì cả các RLM khác, đóng vai các subagent đệ quy. Raymond nói ta sẽ đi vào thuật ngữ sau, nhưng ở đây có sub-RLM và sub-LLM, chúng làm phần thao tác symbolic để bóc tách câu trả lời, rồi kết quả được gom ngược lên dần để ra một câu trả lời cuối cùng. Nó trông giống cái cây ở góc slide.
4. RLM là reasoning model kiểu mới: code execution chính là reasoning
Quan điểm của Raymond: RLM là reasoning model mới. Anh xem đây là paradigm tiếp theo của test-time compute, hay inference-time compute, gọi sao cũng được.
Vì sao điều này có vẻ hiển nhiên, hoặc ngược lại, vì sao người ta hỏi "ủa, cái này có gì mới đâu"? Theo anh, nó rất thanh lịch (elegant) vì đó là sự kết hợp rất gọn gàng của hai thứ: reasoning và code execution. Ở đây, chính việc chạy code là reasoning.
Anh kể lại lịch sử. Chúng ta từng có chain of thought như một chiến lược viết prompt; nó tiến hoá thành các reasoning model, nơi chuỗi suy nghĩ được biểu diễn rõ ràng thành reasoning token. Song song đó, chúng ta đã có function calling, tool calling, rồi parallel tool calling. RLM ghép hai nhánh này lại với nhau theo một cách mang lại kết quả đáng kinh ngạc.
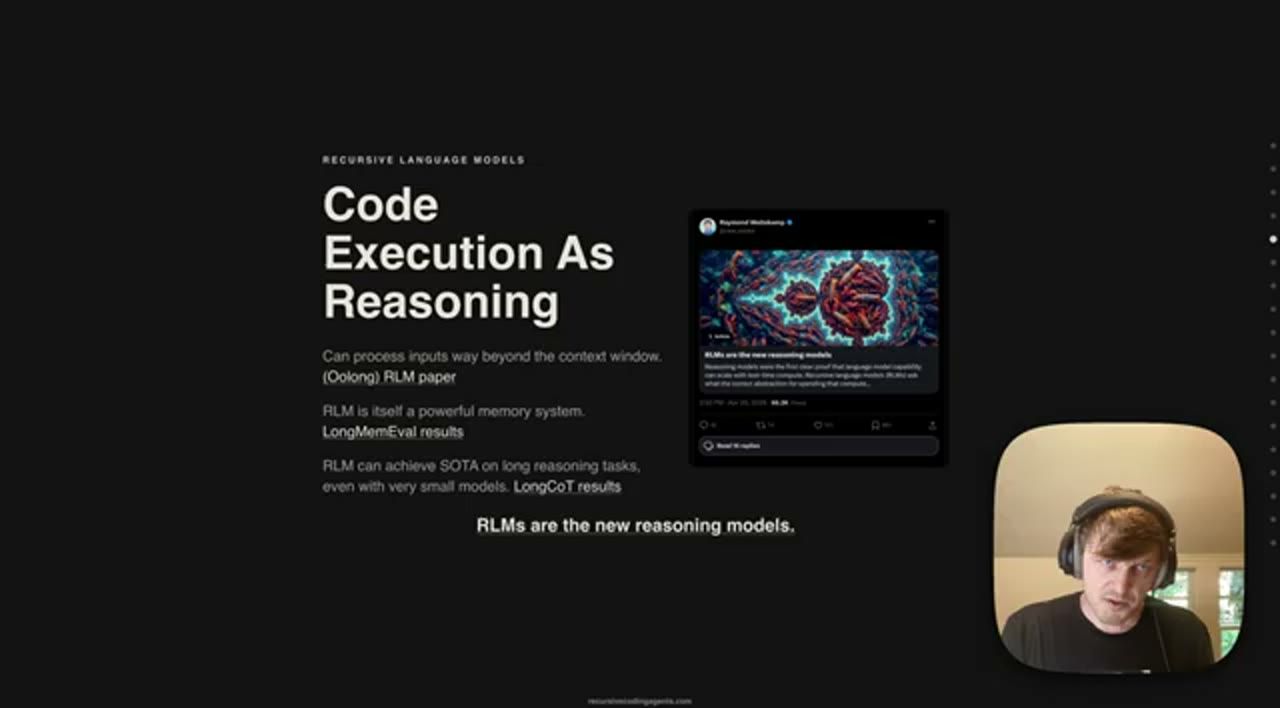
5. Ba kết quả: Oolong, memory và LongCoT
Raymond đưa ra ba ví dụ rất đơn giản.
Thứ nhất, từ paper gốc: Oolong. RLM có thể xử lý lượng thông tin lớn hơn context window của nó nhiều bậc độ lớn (orders of magnitude), cỡ hàng chục triệu token.
Thứ hai, từ nghiên cứu độc lập của chính anh: harness RLM mặc định tự nó đã là một memory system rất mạnh. Không cần sửa gì, RLM đã nằm trong khoảng top 10 memory system, ngang hàng với những người đang tự xây memory system riêng, một mảng mà có lẽ đang có hàng tỷ đô la đổ vào. Chỉ cần chỉnh sửa một chút, khi dùng nó làm memory thì có thể đạt những kết quả thật sự ấn tượng. Chi tiết nằm trong báo cáo Recursive Language Models as Memory Systems của anh, đo trên LongMemEval.
Thứ ba: anh cũng chứng minh được framework RLM, cụ thể là bản cài đặt trong DSPy, đạt kết quả state-of-the-art trên các bài reasoning dài. Benchmark mới ở đây là LongCoT. Anh không đi sâu, nhưng ý tưởng của benchmark là: các bài toán khó chính vì chúng đòi hỏi quá nhiều bước reasoning liên tiếp trong chuỗi phân tích, trong chain of thought, tới mức hầu hết reasoning model, kể cả những model hàng đầu, không giữ được mạch đủ lâu.
Nhưng nếu cho phép RLM giải bài bằng sự kết hợp giữa code và các lời gọi đệ quy tới subagent, thì một model rất nhỏ là Qwen3.5-9B, thứ có thể chạy trên laptop, lại thắng được. Theo Raymond, Qwen3.5-9B chạy dưới dạng RLM đánh bại Opus và GPT-5.4, tức tất cả frontier model hàng đầu khi chạy như LLM thường, trên các bài reasoning dài này. Báo cáo công khai của anh, RLMs are SOTA on LongCoT, ghi Qwen3.5-9B với DSPy.RLM đạt 15,69% so với GPT-5.2 đạt 9,83% trên cùng lát benchmark. Kết luận của anh: RLM cực kỳ, cực kỳ mạnh.
6. RLM: mạnh tới mức "too hot to benchmark"
Mạnh tới mức, Raymond cười, có thể nói chúng "quá nóng để benchmark". Anh đưa ra hai ví dụ.
Bên trái là một ca rất nổi tiếng. Đội Symbolica có một agent harness theo kiểu RLM tên là Agentica. Chỉ vài giờ sau khi ARC-AGI-3 được công bố, lúc điểm cao nhất của mọi frontier model chỉ quanh 2 tới 3%, đội Symbolica đã đưa ra con số khoảng 30-mấy phần trăm. Raymond gọi đó là điên rồ: họ thổi bay benchmark chỉ trong vài giờ bằng cách dùng RLM làm framework.
Điều này làm đội ARC Prize khá phật ý. Họ đáp lại bằng một thứ mà Raymond diễn giải là một "consolation tweet". Theo cách anh đọc tình huống, tweet đó về cơ bản nói: "La-di-da, chúc mừng nhé, nhưng các bạn không giải bài theo đúng cách, chúng tôi không thích RLM harness, nên các bạn có cái tweet dễ thương này, nhưng chúng tôi từ chối chạy phần đánh giá private đầy đủ của ARC-AGI." Với anh, chuyện đó thật vô lý.
Bên phải là trải nghiệm của chính anh trên LongCoT. Kết quả của anh, cùng với kết quả của Alex ở MIT (tác giả thứ nhất của paper RLM), đã "khuyến khích", nói nhẹ nhàng vậy, những người duy trì leaderboard lập ra một leaderboard riêng dành cho open harness. Nhờ đó kết quả của RLM được trưng ra mà không làm "nhiễm bẩn" mục đích ban đầu của leaderboard gốc, vốn về cơ bản là không cho phép tool calling.
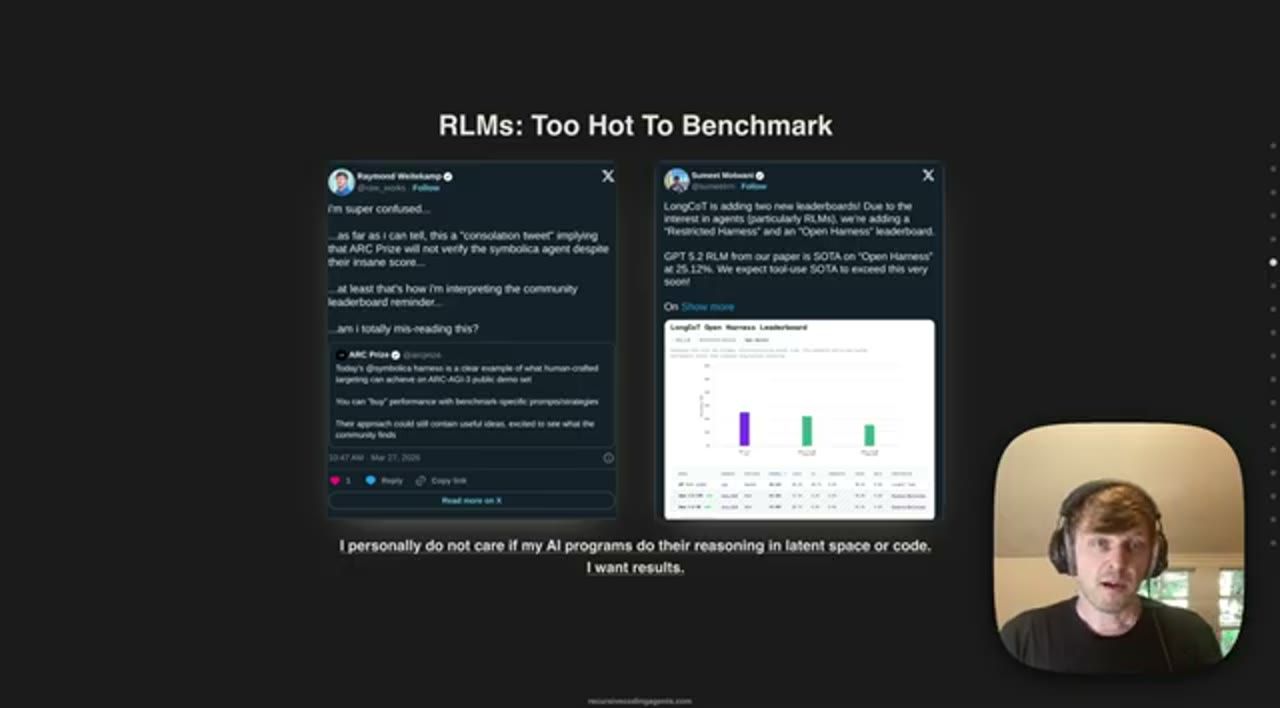
Quan điểm của Raymond về chuyện này rất rõ: anh không quan tâm. Không quan tâm reasoning diễn ra trong latent space, trong reasoning token hay trong code execution. Anh muốn kết quả, và muốn những chương trình AI đạt được kết quả đó.
7. RLM rubric: nhiều thứ trông gần giống, nhưng chưa phải
RLM dễ khiến người ta thấy na ná rất nhiều thứ khác, nên Raymond dựng một rubric nhỏ. Có một companion GitHub repo đi kèm talk để ai muốn thì xem kỹ.
Muốn được gọi là RLM thì cần những gì? Năm điều:
- Executable environment: có một môi trường thực thi được.
- Prompt externalized: prompt được đặt ra bên ngoài model.
- Code calls the model: chính code là thứ gọi model.
- Model picks decomposition: model tự chọn cách chia bài toán thành các sub-call hay subagent.
- State stays symbolic: state luôn nằm ở dạng symbolic.
Hiển nhiên LLM thuần, RAG và những thứ tương tự không đạt các tiêu chí đó. Coding agent có subagent, kể cả có vòng lặp, thì tiến gần, nhưng chưa tới hẳn. Raymond nhấn mạnh rubric này không nhằm gây chiến hay bắt bẻ ai. Nó chỉ cố giải thích đâu là bản chất của RLM, và của recursive coding agent.
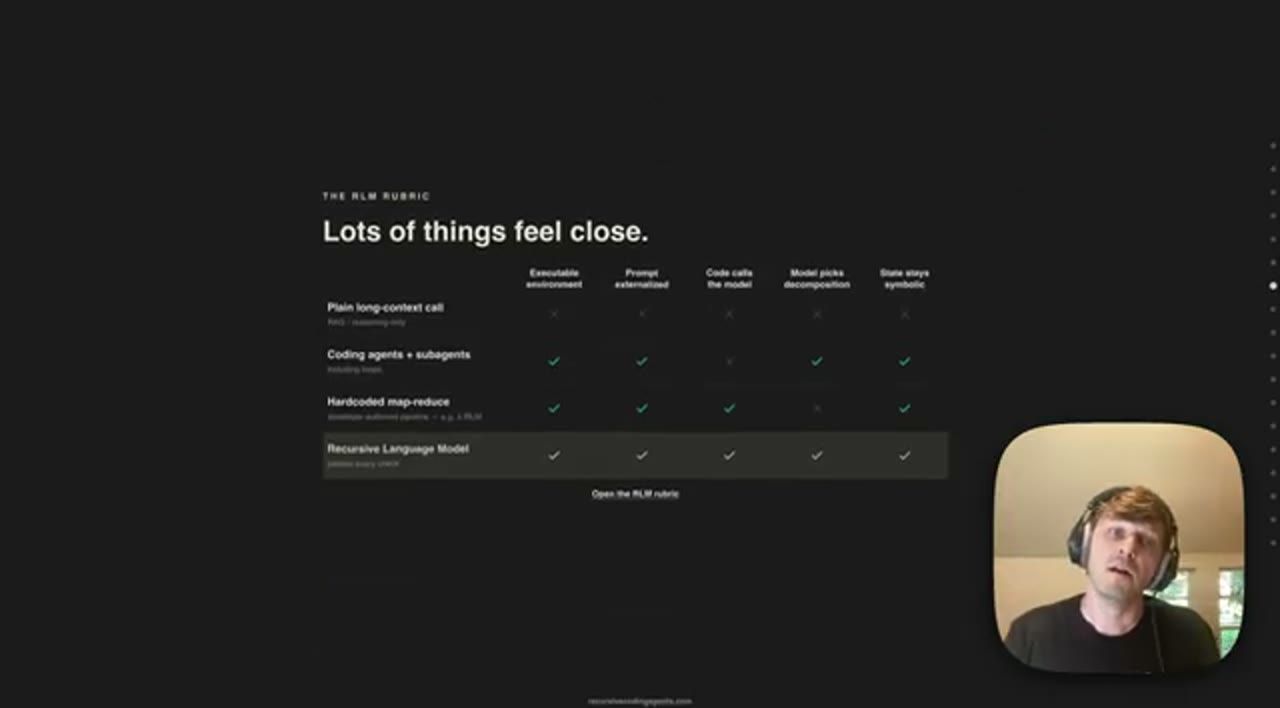
Một ví dụ khác "gần nhưng chưa tới" là MapReduce hard-code. Raymond xếp project LambdaRLM vào nhóm này. Về cơ bản nó nói: "Tôi sẽ chia bài toán bằng lambda calculus thành một MapReduce", rồi bên trong có các lời gọi LLM để thực thi MapReduce đó. Nhưng LLM, hay RLM, không phải là bên quyết định cách chia bài toán. Với anh, đó là một yếu tố then chốt, thứ làm cho cách tiếp cận này mang tính "agent native".
8. Từ RLM sang recursive coding agent
Giờ tới phần chính: RLM là vậy, còn recursive coding agent thì sao? Raymond nói với anh thì nó trông y hệt. Ta chỉ cần đổi RLM và LLM thành agent và subagent, và chẳng phải ta có đúng cùng một thứ sao? Câu trả lời là có.
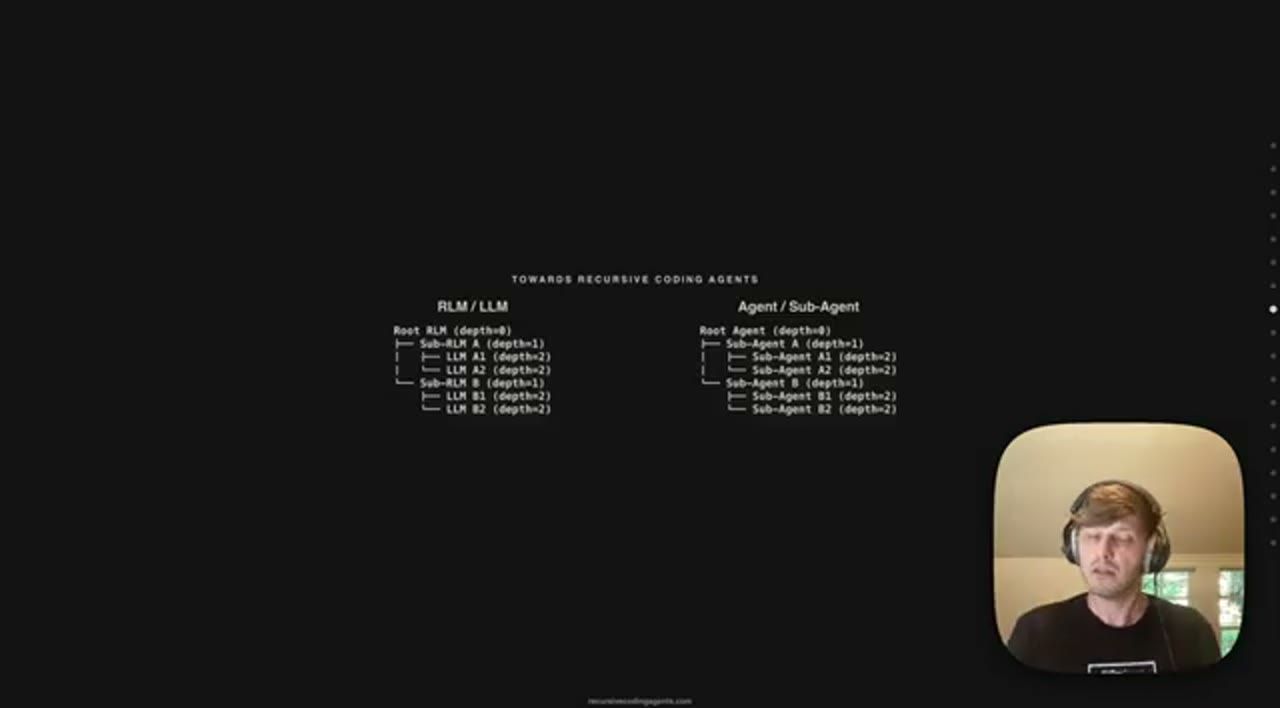
Anh thừa nhận có thể nhìn theo kiểu "Ha ha, câu hỏi mẹo": RLM vốn đã là một coding agent và vốn đã recursive, vân vân. Điều đó cũng ổn, và anh không nghĩ lập luận đó sai, nhưng nó không đẩy được gì tiến lên cả.
Câu hỏi anh thật sự quan tâm là: làm sao áp dụng các nguyên lý của RLM vào coding agent, và làm cho chúng thật sự hữu ích với coding agent? Anh bị ám ảnh bởi câu hỏi này kể từ khi bài blog về RLM ra mắt vào tháng 10 năm 2025 (bài Recursive Language Models của Alex Zhang).
9. Thí nghiệm: rlm-cli, rồi Y-Pi, một Pi gọi chính Pi
Raymond kể các thí nghiệm của mình với recursive coding agent.
Thí nghiệm đầu tiên chỉ đơn giản là bọc package RLM của Alex thành một CLI: rlm-cli. Ý tưởng là: anh chỉ muốn trao cho coding agent của mình một RLM dưới dạng một tool call. Giả sử cần sàng lọc một corpus 100 triệu token. Lúc đó coding agent chỉ việc gọi tool đó, và RLM làm phần việc của RLM. Cách này thú vị và có thể rất hữu ích, và cũng có vài người khác đã build những thứ tương tự.
Nhưng rồi anh nghĩ: thật sự thì nó có nghĩa là gì, hay làm thế nào mới có thể biến coding agent thành hoàn toàn recursive? Tức là harness của coding agent tự gọi chính nó, đúng phiên bản y hệt của nó. Và nếu vậy thì cài đặt thế nào?
Câu trả lời là thứ anh gọi là Y-Pi (ypi). "Y" là Y combinator trong lambda calculus. Còn "Pi", nếu ai chưa nghe, là một coding agent rất tuyệt (Pi). Nó cực kỳ tối giản và được thiết kế chuyên để mở rộng (extensible). Mario, tác giả của Pi, muốn người dùng viết extension cho Pi để có những tính năng họ muốn, thay vì cố nhồi ý tưởng của mình vào agent chính. Pi được thiết kế để là một core rất nhỏ, ai muốn mở rộng thế nào tuỳ ý.
Khi Raymond lần đầu có ý tưởng recursive coding agent và muốn làm với Pi, anh không thể dùng extension của Pi để đạt mục tiêu đó, nên phải fork nó. Anh rất vui báo rằng, để chuẩn bị cho talk này, anh quay lại xem và thấy Pi đã tiến hoá: hệ thống extension giờ đủ mạnh để làm Pi hoàn toàn recursive chỉ bằng một extension thuần. Vì vậy giờ anh có cả hai: package extension thuần pi-recursive, và Y-Pi như một wrapper tiện lợi bên trên.
Đây đúng nghĩa đen là một recursive coding agent: Pi gọi Pi, gọi Pi, gọi Pi. Độ sâu đặt bao nhiêu tuỳ ý.
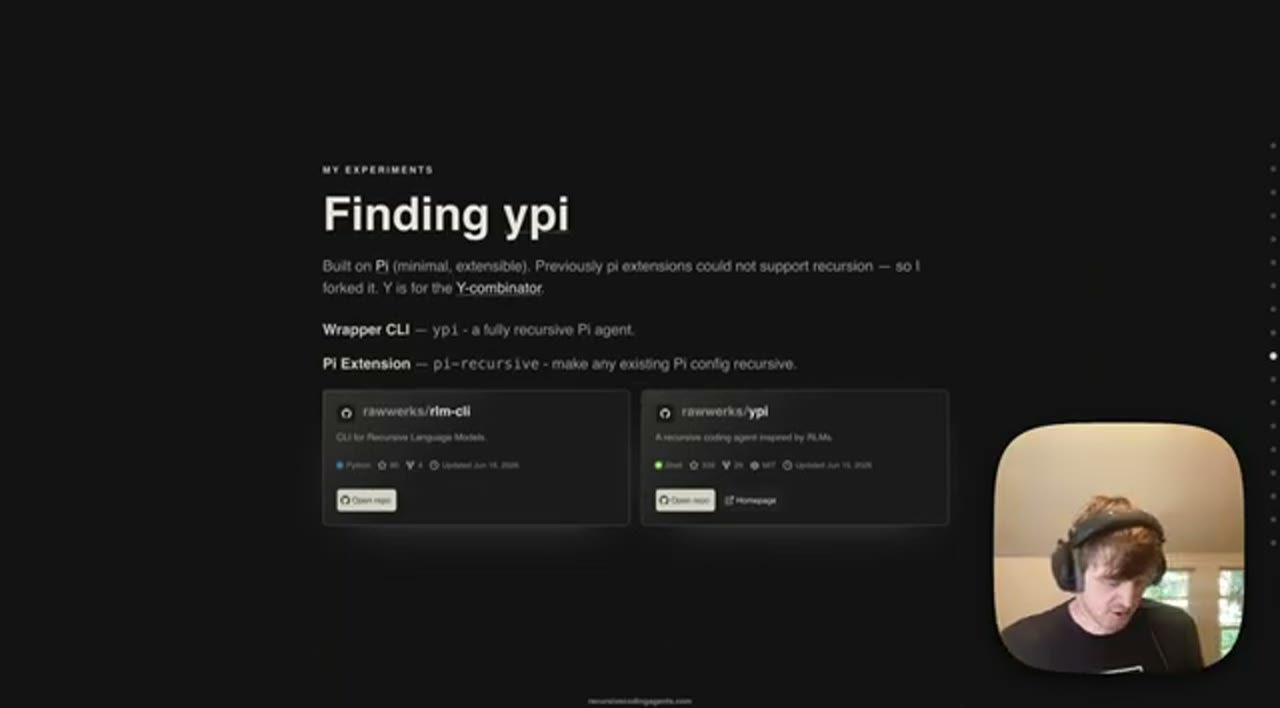
ypi, một Pi agent recursive hoàn toàn; và Pi extension pi-recursive, biến mọi cấu hình Pi sẵn có thành recursive. Hai thẻ repo: rawwerks/rlm-cli ("CLI for Recursive Language Models") và rawwerks/ypi ("A recursive coding agent inspired by RLMs").Theo README của Y-Pi, cách tối giản nhất để thử là cài extension trực tiếp vào Pi:
pi install npm:pi-recursive
pi -e npm:pi-recursive "Use rlm_query to ask a child what 2 + 2 is."
10. Hệ sinh thái RLM: những project đáng chú ý khác
Tiếp theo Raymond điểm qua vài project đáng chú ý khác trong mảng này.
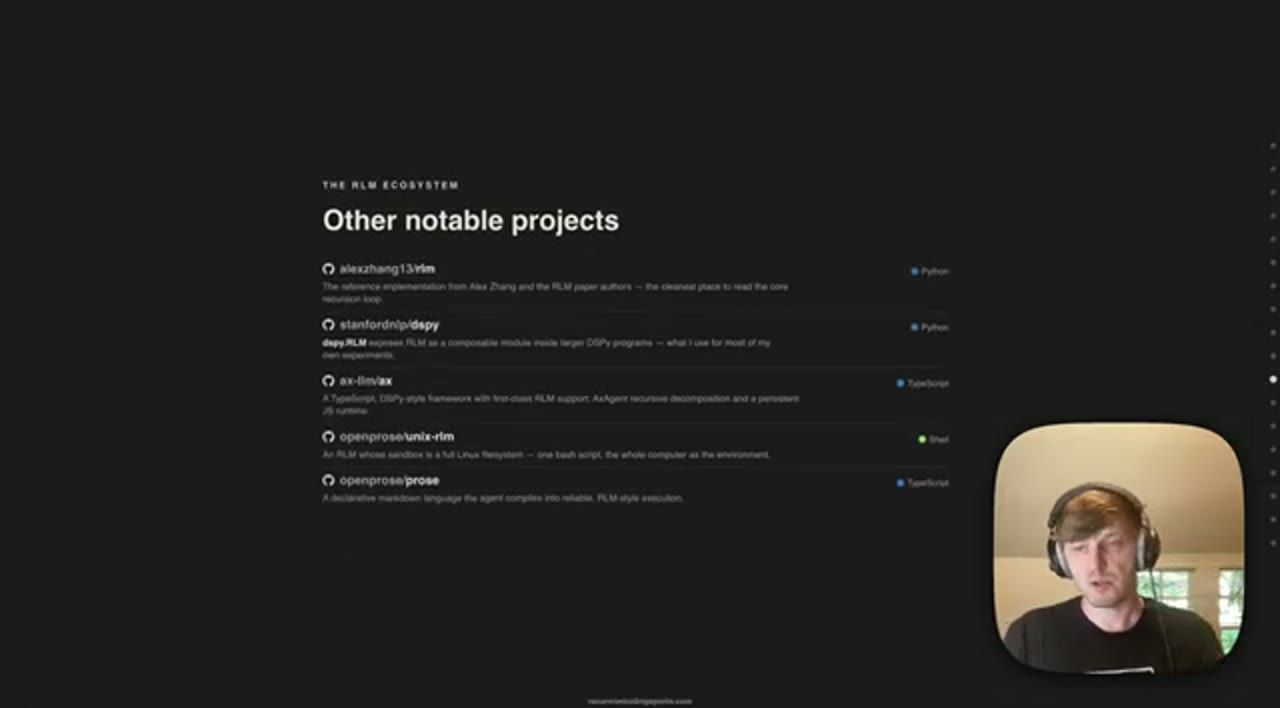
- alexzhang13/rlm: hiển nhiên là bản cài đặt gốc của Alex.
- dspy.RLM: công cụ "ruột" của anh, nhất là khi làm benchmark. Đó là cách anh có được tất cả những kết quả ấn tượng trên các benchmark kể ở trên.
- Ax: anh thấy project này rất thú vị vì nó cực kỳ agent native. Ax khởi đầu là một biến thể TypeScript của DSPy. Khi RLM ra đời, họ đương nhiên cài đặt nó, nhưng theo một cách cho phép một Ax agent viết hẳn một interface TypeScript tới một Ax agent khác, và cứ thế đi xuống tận đáy "hang thỏ" đệ quy. Anh thấy điều đó rất hay.
- Unix RLM: để cho thấy REPL có thể là bất cứ thứ gì, Dan ở OpenProse làm ra Unix RLM. Nó là Bash thuần, và môi trường chỉ là file system của Linux. Đó là một góc nhìn hoàn toàn khác về những gì có thể làm với RLM.
- OpenProse: anh sẽ nói thêm ở sau, nhưng OpenProse như một ngôn ngữ cho phép biến bất kỳ coding agent nào thành một RLM; phần cuối talk sẽ nói cách làm. Repo OpenProse còn chứa một harness thực thi: một coding agent harness cho phép dùng Codex SDK hoặc Claude Code ở bên dưới, và chạy các chương trình Prose theo kiểu RLM.
11. Claude Code có phải là một RLM không?
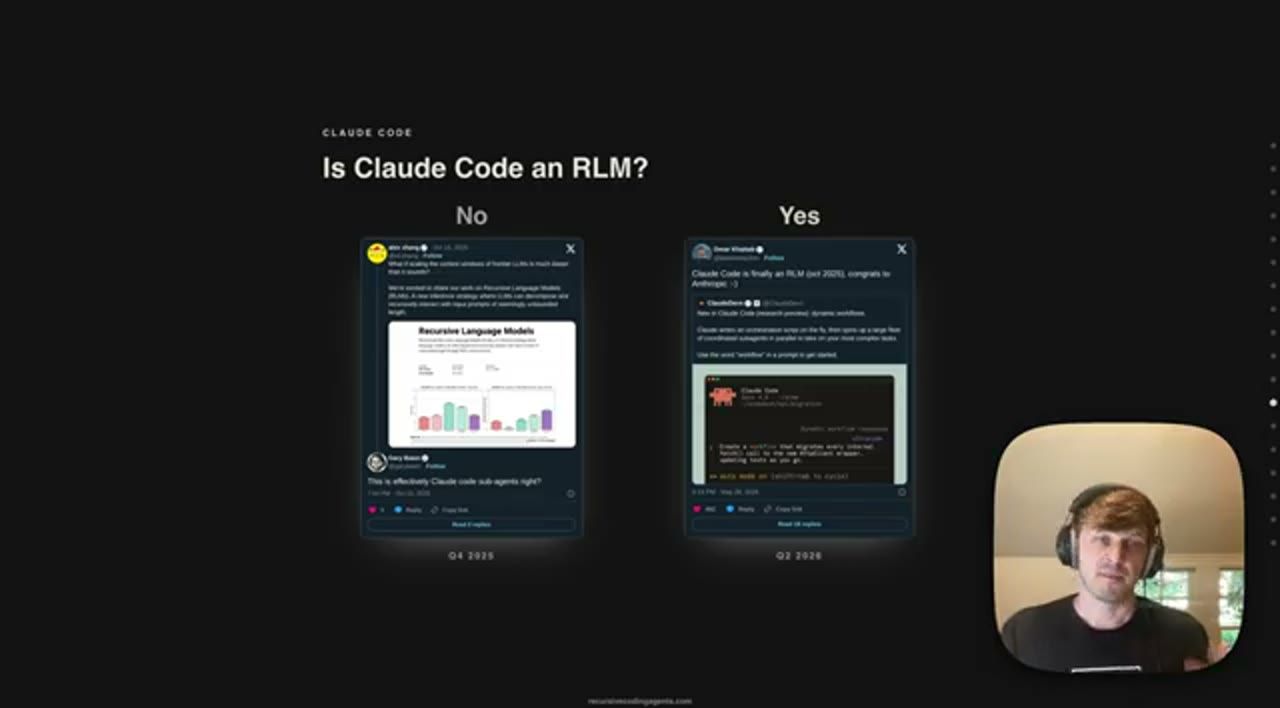
Đây là câu hỏi cứ được hỏi đi hỏi lại. Câu trả lời ban đầu, ngay ngày bài blog RLM ra mắt, là: "Không, không, không phải." Nhưng đó lại đúng là câu hỏi đầu tiên được hỏi dưới tweet công bố, ngay trong cùng ngày, và về cơ bản nó nói: "Này, đây chẳng phải là Claude Code subagents sao?" Ai muốn đào vào chi tiết vụn vặt thì quay lại rubric ở trên.
Nhưng giờ thì có thể nói là có. Bên phải slide là tweet của Omar: "Chúc mừng Anthropic, Claude Code cuối cùng cũng là một RLM, giờ khi đã có dynamic workflows."
Vậy cái gì đã thay đổi? Raymond cho rằng chính ví dụ này là một cách hay để giải thích recursive coding agent mạnh ở đâu, và rốt cuộc RLM là gì.
12. Dynamic workflows làm Claude Code trở nên recursive
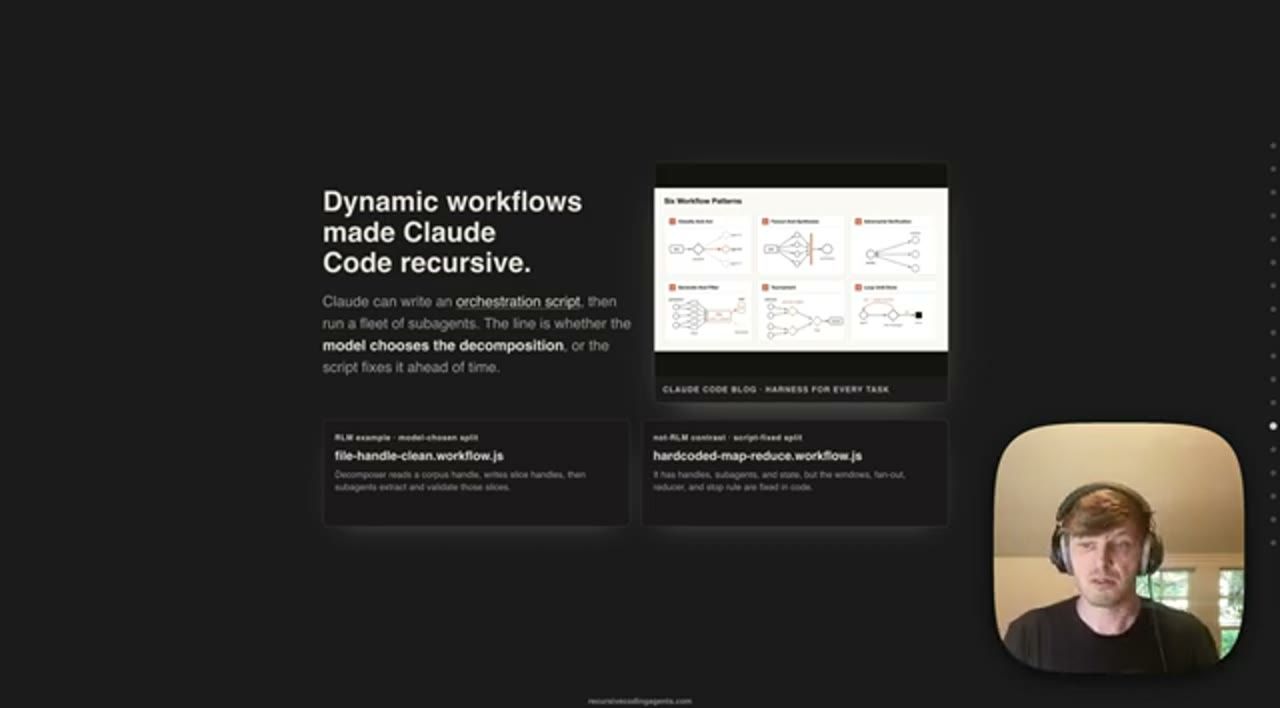
Dynamic workflows được phát hành chỉ vài tuần trước talk, và chúng làm cho Claude Code trở nên recursive, hay ít nhất là có khả năng chạy những workflow đệ quy kiểu này. Raymond rất khuyến khích đọc bài blog "A Harness for Every Task". Bài đó trình bày sáu pattern workflow rất mạnh, và tất nhiên còn nhiều pattern khác có thể làm được.
Để minh hoạ, anh viết hai workflow cho Claude Code:
- Một workflow rõ ràng không phải RLM: một MapReduce hard-code (
hardcoded-map-reduce.workflow.js). - Một workflow mà anh lập luận là RLM (
file-handle-clean.workflow.js): có thể hình dung như deep research trên một file system. Chọn một handle, giao handle đó cho một agent, để nó đi phân tích, mang về những gì tìm được, và cứ thế tiếp tục.
Cả hai đều nằm trong companion repo.
13. OpenProse: ngôn ngữ do agent compile, không phải máy tính
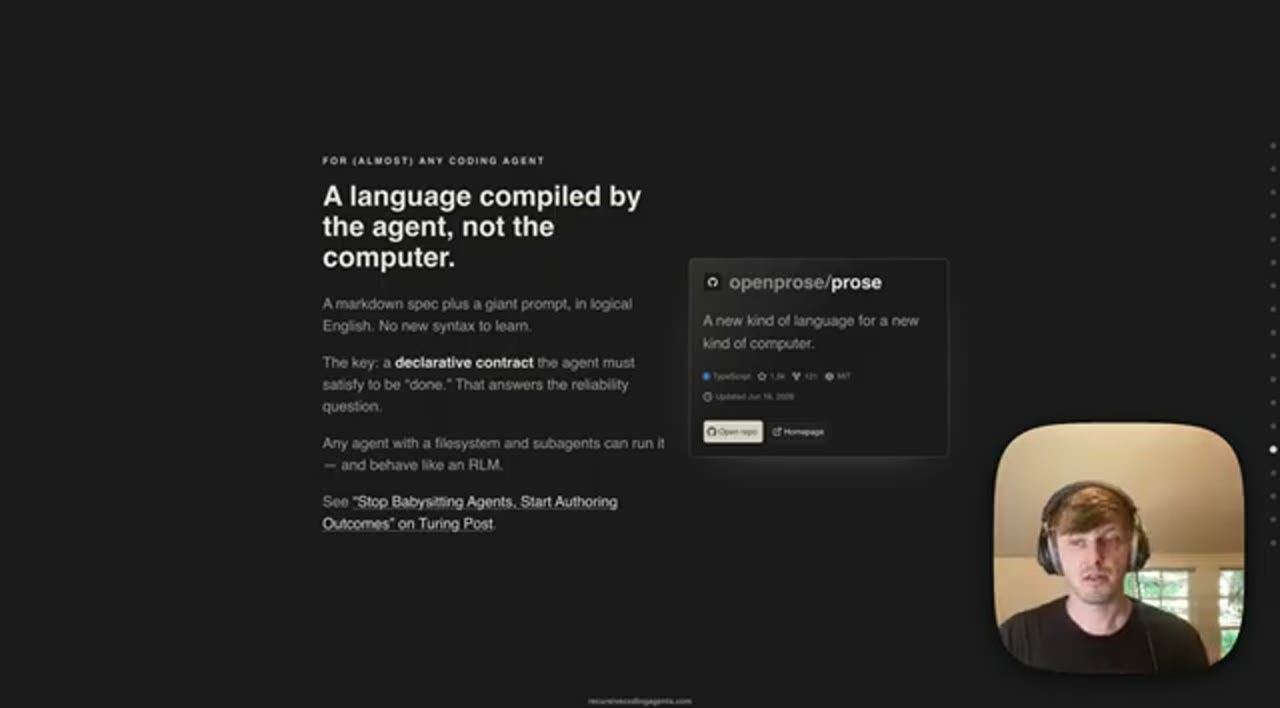
Dynamic workflows rất hay, nhưng chúng chỉ có trong Claude Code. Chúng cũng không phải cách duy nhất. Nếu bạn không thích Claude Code thì sao? Hoặc bạn thích Claude Code nhưng không muốn dùng dynamic workflows, mà muốn một thứ khác? Đó chính là điều OpenProse hướng tới.
Về kỹ thuật, OpenProse là một ngôn ngữ lập trình, nhưng nó không được compile bởi máy tính, mà bởi coding agent của bạn. Nó là một spec viết bằng markdown, bằng "logical English". Không cần học cú pháp gì kỳ quặc.
Có hẳn một lệnh prose write để Claude Code, Codex, Pi hay coding agent yêu thích của bạn tự viết một file .prose.md cho bạn. Theo nghĩa đó, nó giống trigger ultracode trong Claude Code, nơi Claude tự quyết định và tự viết workflow cho bạn.
Prose có khả năng biến bất kỳ agent nào có file system và subagent thành một RLM. Đây là repo open source, ai cũng có thể vào xem. Raymond cũng đã viết sâu hơn về chủ đề này trong bài Turing Post nhắc ở trên.
14. OpenProse khai báo rõ phần việc của subagent, kèm skill và tool
Điều then chốt Raymond muốn nêu khi đặt cạnh RLM là: OpenProse có thể khai báo tường minh phần việc của subagent. Một lần nữa, anh làm hai file demo .prose.md trong companion repo; anh không đi vào code trong slide, ai muốn thì vào repo đọc. Với chúng, ta có thể chia bài toán thành các mảnh nhỏ hơn giao cho subagent, rồi verify công việc của các subagent đó ngay trong session của agent cha.
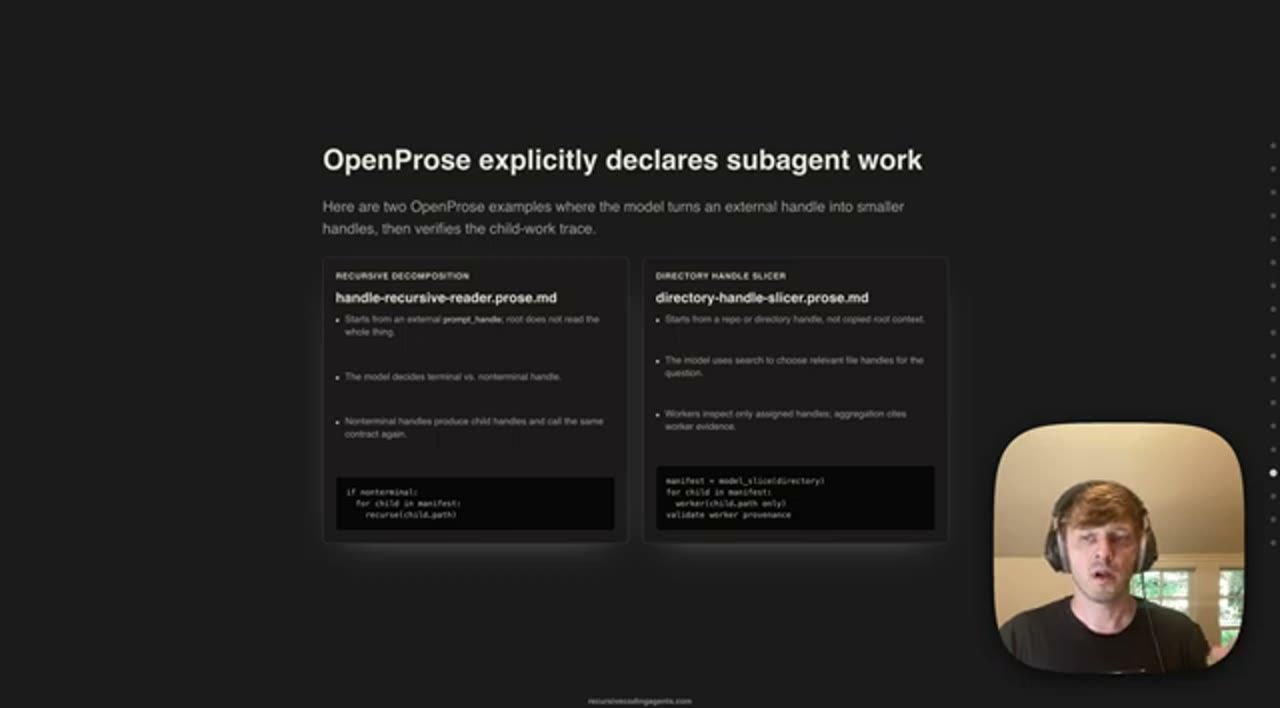
prompt_handle bên ngoài, root không đọc toàn bộ; model quyết định handle nào là terminal, handle nào nonterminal; handle nonterminal sinh ra handle con và gọi lại cùng contract đó. Bên phải, directory-handle-slicer.prose.md: bắt đầu từ một handle repo hay thư mục, không chép context gốc; model dùng search để chọn file handle liên quan tới câu hỏi; worker chỉ xem handle được giao, và bước tổng hợp phải dẫn chứng bằng bằng chứng của worker.Hai đoạn pseudo-code trên slide tóm gọn hai pattern này:
if nonterminal:
  for child in manifest:
    recurse(child.path)
manifest = model_slice(directory) for child in manifest: worker(child.path only) validate worker provenance
Còn thú vị hơn nữa: hai trong số các tính năng mà chính Raymond thêm vào ngôn ngữ OpenProse là khả năng khai báo skill và tool như những dependency tường minh. Hãy hình dung một workflow mà một subagent nào đó cần một skill rất cụ thể để làm đúng vai của nó, hoặc bắt buộc phải có quyền dùng một CLI tool nhất định, thiếu thì nó không chạy được và không làm được việc.
Prose có cách để "nối dây" (wire) những thứ đó vào như dependency. Nhờ vậy không chỉ đảm bảo công việc được làm theo cách bạn muốn, mà còn đảm bảo các subagent được cấu hình đúng với tool và skill chúng cần để làm thành công phần việc bạn khai báo trong "Prose contract".
15. Thực tế làm được gì, và biến golden session thành chương trình
"Rất hay. Nhưng thật ra làm được gì?" Raymond đưa bốn ví dụ: hai từ Claude dynamic workflows, hai từ OpenProse.
- Repo-scale migration (Claude dynamic workflows): đây gần như là ví dụ trong bài công bố. Refactor một thứ rất lớn với cả một bầy (swarm) agent chạy song song, rồi merge toàn bộ lại.
- Repo-handle investigation (OpenProse): nhắm vào một thư mục rồi deep research, deep analyze, hay xử lý sâu theo cách nào đó một cách đệ quy bên trong nó.
- Audit và bug sweep (Claude dynamic workflows): làm audit, quét bug. Cũng có thể làm những việc mang tính đối kháng (adversarial), như có một skeptical agent, hay một nhóm agent red team, cố gắng cải thiện hệ thống theo kiểu đối kháng hoặc song song.
- Golden session thành chương trình (OpenProse).
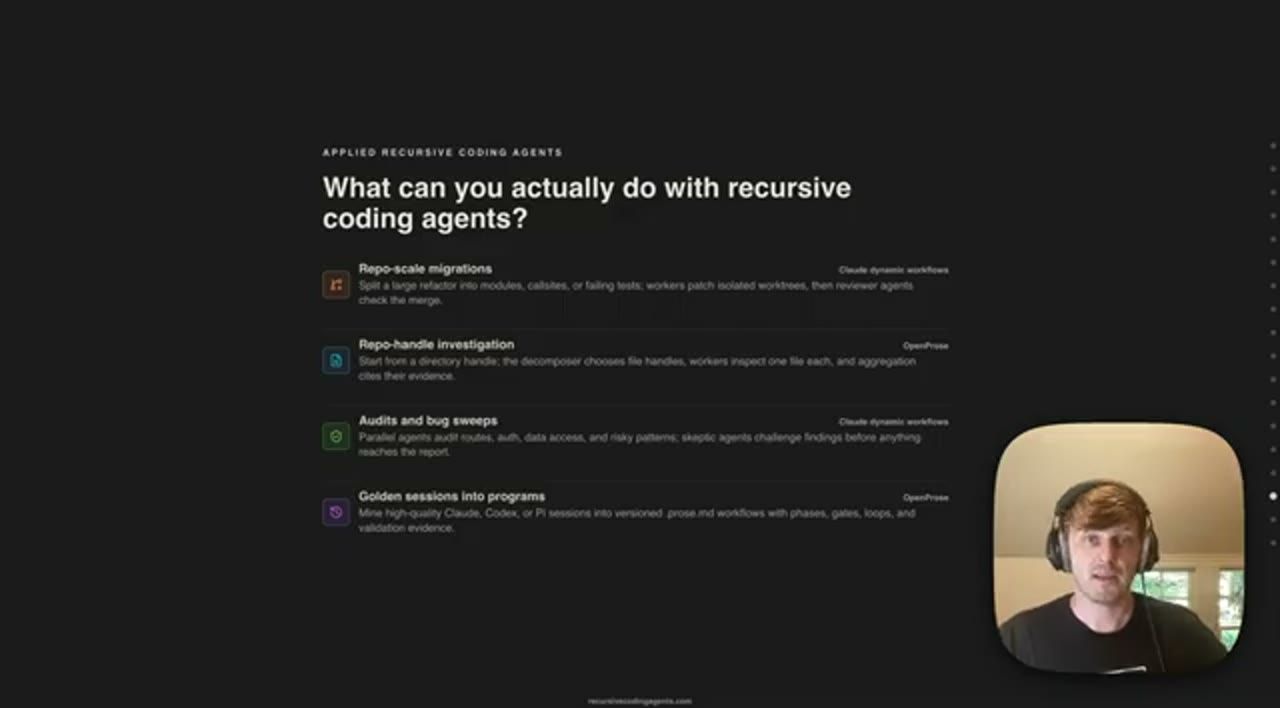
Use case cuối là thứ Raymond mới thêm gần đây, và nó quay về đúng slide đầu tiên của anh. Một ngày ta có kết quả tuyệt vời, ngày hôm sau agent "trade" mất toàn bộ số tiền crypto của ta (may mà số tiền đó rất nhỏ). Vậy làm sao để những thứ này đáng tin cậy hơn? Ta có một golden session, có một ngày tuyệt vời, và giờ ta muốn chụp lại nó để dùng lại lặp đi lặp lại.
Anh build một hệ thống cho phép lấy một golden session từ Claude Code, Codex, Pi, bất cứ thứ gì, và đưa vào một chương trình Prose. Chương trình này sẽ bắt agent "giải phẫu" session đó và biến nó thành một Prose workflow dùng lại được. Workflow đó cũng có thể dùng ý tưởng recursive coding agent, để đưa ta tới một cách đáng tin cậy nhằm đạt lại trạng thái hiệu năng "vàng" đó, lặp đi lặp lại.
"Recursing, recursive coding agents for the win", anh cười. Anh thật sự tin cách này rất mạnh. RLM đã làm anh choáng ngợp khi chúng mới ra đời, và như người nghe có thể thấy qua cả talk, anh hoàn toàn bị ám ảnh với việc áp dụng ý tưởng RLM vào coding agent.
16. Ba điều mang về: trust là reliability
Raymond mong người nghe mang về ba điều.
Một: trust là reliability. Làm sao ta tin được một thứ không đáng tin cậy? Lập luận của anh, và ý tưởng mismanaged genius, là bước tiếp theo không phải là thêm trí thông minh thô (raw intelligence). Nó nằm ở hành vi (behavioral), ở orchestration.
Hai: RLM đại diện cho một paradigm mới của test-time compute, hay inference-time compute, nơi tool calling và reasoning được hợp nhất. Ta reason thông qua tool calling, ta có thể lặp đệ quy, và một trong các tool đó là gọi một agent khác đi làm một task cụ thể hay một phần con của bài toán.
Ba: anh hy vọng phần nào dẹp được "drama" quanh câu hỏi RLM có thật sự mới không, hay chẳng qua chỉ là coding agent. Câu trả lời: coding agent có thể là RLM, nhưng không tự động là RLM. Anh đã cho xem vài Claude Code dynamic workflow biến Claude Code thành RLM, cùng vài cách làm điều tương tự với OpenProse, dùng được với bất kỳ coding agent nào.
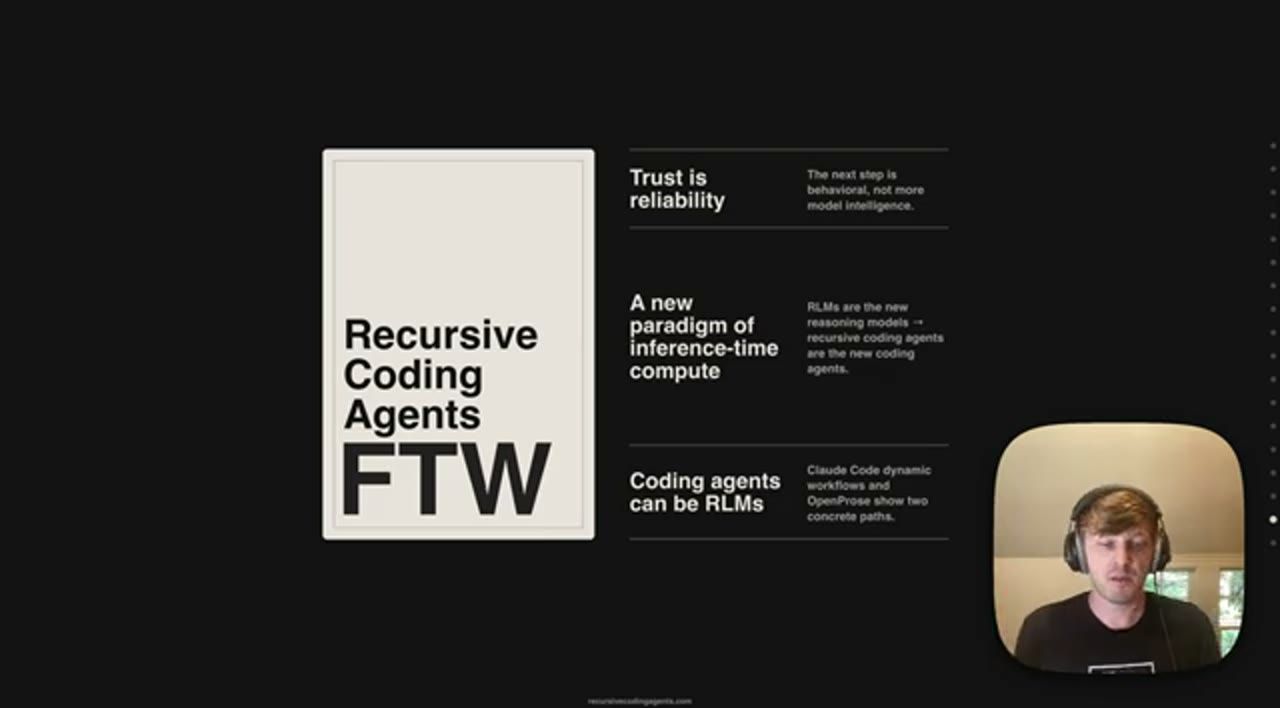
Anh xem đây là một cách làm việc với coding agent cực kỳ mạnh, và mời mọi người đào sâu thêm ở recursivecodingagents.com. Nhưng "with great power comes great responsibility". Nên, cho tới lần sau: please recurse responsibly, hãy đệ quy có trách nhiệm. Cảm ơn mọi người rất nhiều.
Sources and links
- recursivecodingagents.com: bộ slide tương tác của talk
- rawwerks/recursive-coding-agents: companion repo với các workflow Claude Code và file .prose.md
- Recursive Language Models (paper, arXiv:2512.24601) · blog RLM của Alex Zhang
- Turing Post: Stop Babysitting Agents, Start Authoring Outcomes
- Recursive Language Models as Memory Systems · RLMs are SOTA on LongCoT
- LongCoT benchmark · ARC-AGI-3 · Symbolica
- rlm-cli · Y-Pi · Pi
- alexzhang13/rlm · DSPy · Ax · unix-rlm
- OpenProse · openprose.ai
- A harness for every task: dynamic workflows in Claude Code
Related talks
Agents Building Agents
Alfonso Graziano · Nearform · 30 min
Dùng coding agent để tự cải thiện AI agent: vòng lặp hypothesis trên Golden dataset (18% lên 83%) và phân tích trace có feedback từ user thật.
HTML is All You Need (for Agents to Make Graphics)
Amol Kapoor · Nori Agentic · 7 min
Vì sao agent vẽ dở trên canvas và SVG nhưng làm slide, docs, cả video rất tốt khi viết bằng HTML: đổi medium, đừng đổi model.
The Agentic AI Engineer
Benedikt Sanftl & Burak Cemil Özafşar · Mutagent · 35 min
Chạy vòng đời agent như một loop agentic: spec, build, eval-driven development, diagnose trace production thành eval mới, và demo diagnostics agent.