Research to Reality: Bringing Frontier ML Research to Production
AI Engineer World's Fair 2026: Online Track · Video gốc
Ba đòn bẩy để đưa prototype ML vào production: tài liệu bàn giao RPT, monorepo microservice tách rời, và phân rã prototype thành stacked PR.
1. Labs team của Higharc và AI cho home building
Vaidas mở đầu bằng lời tự giới thiệu: anh là senior research engineer tại Higharc, làm trong labs team. Ở Higharc, labs team về cơ bản là bộ phận research and development (R&D) của công ty. Đây là nơi có các machine learning researcher, những người đi khám phá phần frontier của AI và ML, rồi tìm cách áp dụng nó vào ngành xây nhà (home building).
Anh chiếu một đoạn video ngắn về sản phẩm. Vì Higharc làm home building và phải xử lý spatial reasoning (suy luận về không gian), nên trên thực tế họ phải dùng gần như mọi thứ đang có trong AI. Anh kể ra vài ví dụ:
- Computer vision để scan các bản vẽ mặt bằng (floor plan) vẽ tay, rồi parse chúng thành data model nội bộ của Higharc.
- Reasoning agent để dẫn người dùng đi qua các trải nghiệm agentic trong sản phẩm.
- Custom transformer mà team tự xây.
- Diffusion model cho image generation.
Nói gọn lại, rất nhiều thứ đang có trong AI và ML cuối cùng team đều phải dùng tới, vì bản chất đa ngành (multidisciplinary) của sản phẩm.
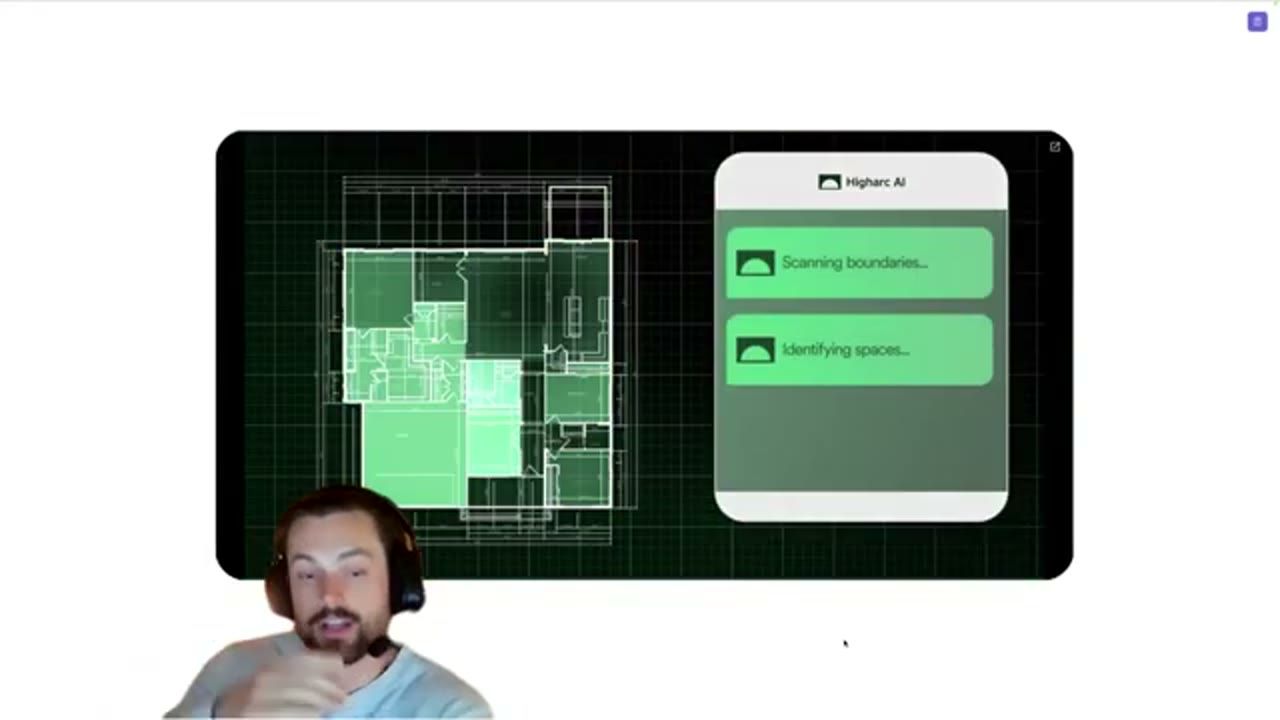
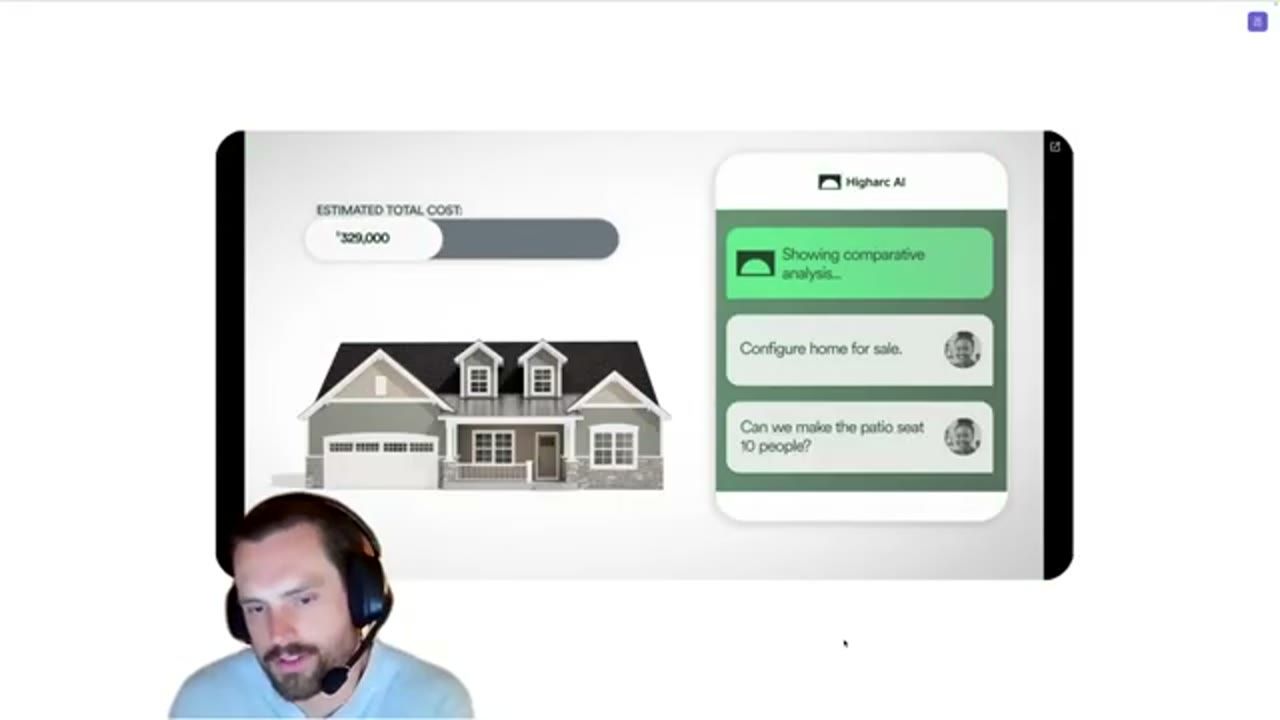
Anh hy vọng video đó cho người xem một hình dung về các mảng research mà team tập trung, và anh đã vẽ chúng ra trên slide kế tiếp.
2. Researchers không phải production engineers
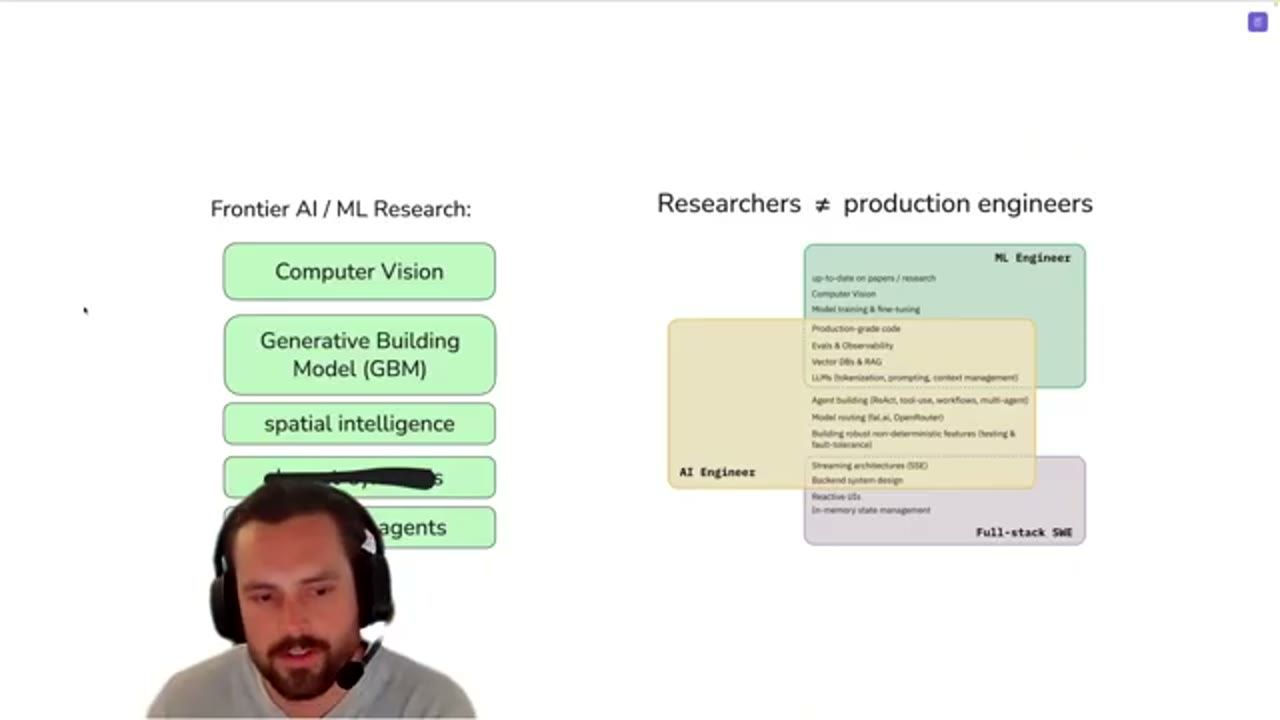
Từ bức tranh đó, Vaidas dẫn tới vấn đề chính. Trong thử thách đưa research ở frontier vào production, team phải bắt đầu làm việc với các software engineer: platform engineer, infrastructure engineer, back-end engineer. Đây là những người rất quen với việc xây code robust và đạt chuẩn production. Nhưng nhiều khả năng họ không quen với phương pháp và nghiên cứu trong computer vision, trong việc tự train LLM của riêng mình, và cả một vài chủ đề tối mật mà anh không thể tiết lộ ở đây (anh cười khi nói câu này, và trên slide có đúng một mục bị bôi đen).
Ở phía ngược lại là bài toán đối xứng với các ML researcher. Họ cập nhật rất sát các paper mới nhất và có thể kết hợp những khái niệm đó theo cách mới mẻ, sáng tạo để phát triển feature mới. Nhưng thường thì họ chưa thật sự làm việc như một software engineer, chưa từng là người chịu trách nhiệm cho các API đạt chuẩn production.
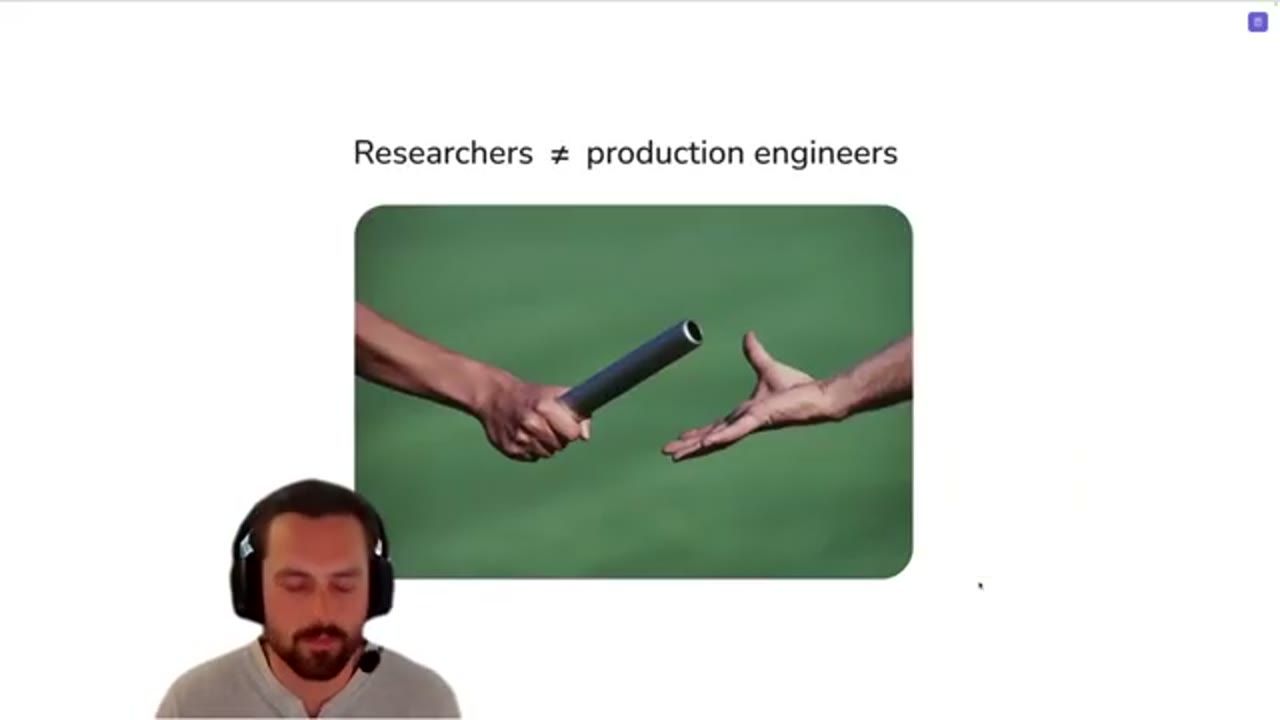
Đó là điều anh muốn đi sâu: cuộc chuyển giao này, cú trao gậy tiếp sức (baton pass) này. Làm sao để tạo điều kiện cho nó diễn ra, và làm sao để nó diễn ra một cách hiệu quả?
3. Một bài toán systems và process, ba đòn bẩy
Team nhìn chuyện này về cơ bản như một bài toán về systems và process (hệ thống và quy trình). Vaidas muốn tập trung vào ba vùng chính mà người nghe có thể dùng để tăng velocity (tốc độ) của những team đang đưa research vào production.
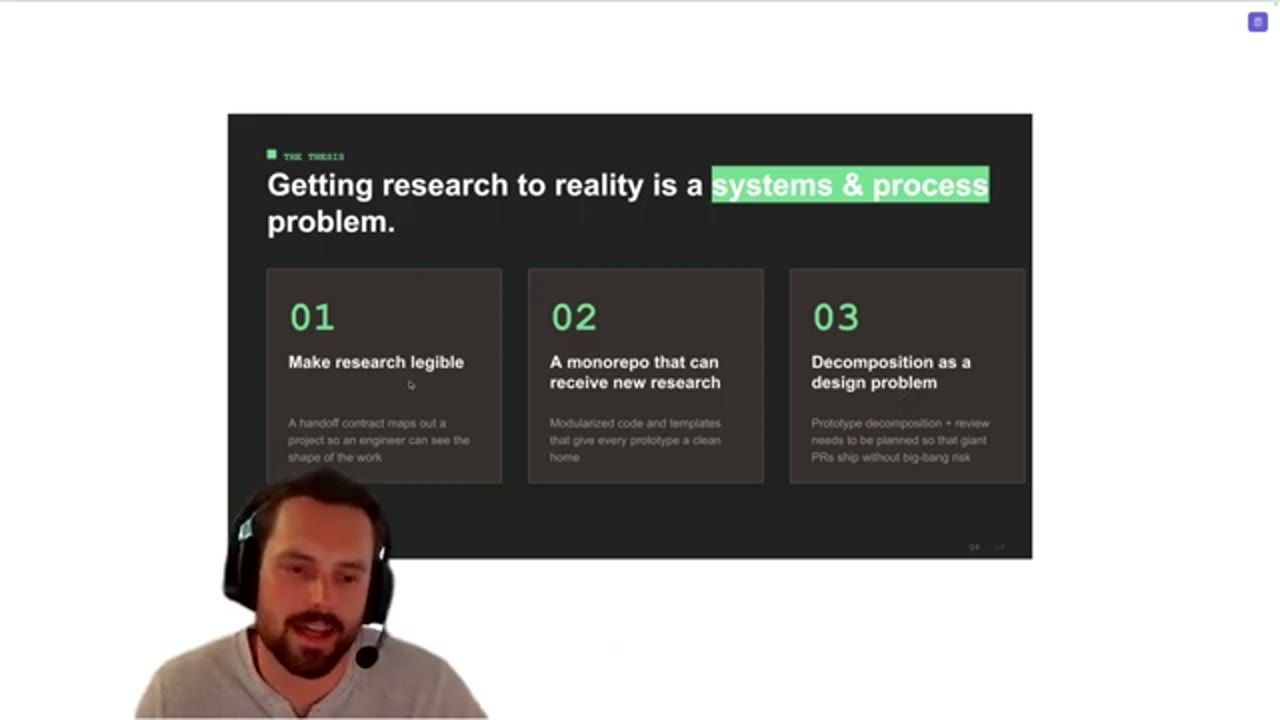
- Research legibility (research dễ đọc, dễ hiểu). Giả sử có một ML researcher đã làm ra một prototype cho một ý tưởng. Làm sao họ vạch nó ra để nó trở nên dễ tiêu hoá và dễ hiểu với những software engineer và product manager khác nhau sắp nhảy vào project?
- Cách cấu trúc codebase. Team dùng một monorepo. Câu hỏi là sắp xếp code và module hoá nó thế nào để codebase sẵn sàng đón các prototype mới, rồi xoay chúng lại và dựng chúng lên thật nhanh.
- Bước nhảy từ prototype sang production. Khi đã có một research prototype được vạch ra rõ ràng và đã chứng minh được là chạy, nó sẽ đi vào repo. Làm sao decompose (phân rã) prototype đó và dựng nó lên theo các best practice của software engineering?
4. Đòn bẩy 1: làm cho research dễ đọc
Với bước đầu tiên, Vaidas giới thiệu một bài viết rất hay mà anh muốn dẫn link: một bài trên blog The Pragmatic Engineer. Bài đó nói về các team software engineering khi họ lớn lên và bắt đầu scale, và việc viết ra technical design document quan trọng thế nào. Có thể gọi đó là request for comments (RFC), hay specification, gọi tên gì cũng được, miễn là viết ra trước khi build phần mềm, như một cách để align các team với nhau.
Higharc có một tài liệu rất tương tự mà team bắt buộc mọi research prototype phải có. Họ gọi nó là research prototype taxonomy document (về sau trong talk anh cũng gọi nó là research project taxonomy document), viết tắt là RPT. Về bản chất, nó chỉ là một technical design document của software engineering, kèm vài điểm biến tấu riêng giúp nó dễ tiêu hoá hơn, xét theo bản chất machine learning của các project này.
5. Research Prototype Taxonomy: domain context và business goal
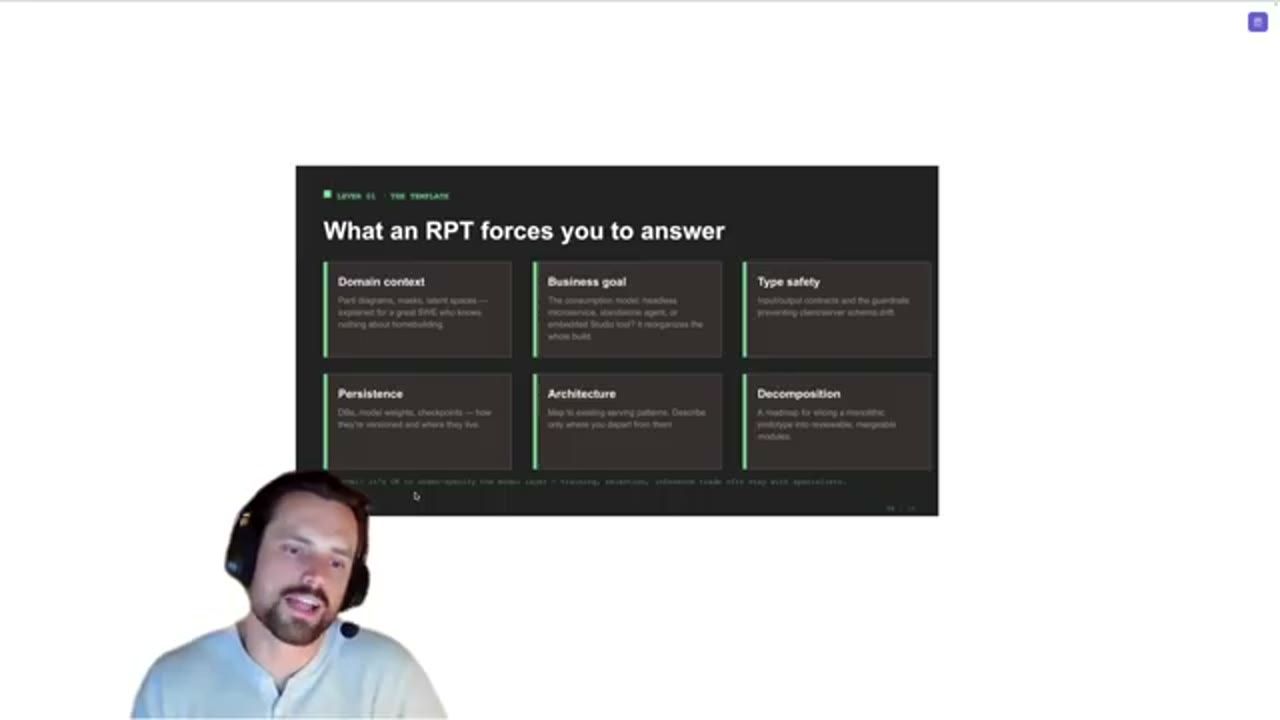
Phần đầu tiên của tài liệu là domain context. Team dùng Notion để viết, nhưng rõ ràng bất kỳ tài liệu dạng văn bản nào cũng được. Phần này trả lời: những gì là đặc thù của domain? Higharc làm trong domain kiến trúc, trong home building, vậy đâu là những cách mới để biểu diễn dữ liệu trong project này? Có thể là một parti diagram (sơ đồ ý tưởng tổng thể trong kiến trúc). Có thể là một graph để biểu diễn circulation graph, tức đường di chuyển của người bên trong một ngôi nhà. Cũng có thể là embedding model hay latent space representation.
Vaidas thích diễn đạt thế này: hãy hình dung một software engineer mà team vừa tuyển từ JPMorgan. Những thuật ngữ chuyên ngành (lingo) và những cách biểu diễn dữ liệu đặc thù nào mà người đó cần biết trước khi nhảy vào project?
Phần thứ hai là vạch ra business goal. Vì sao giải bài toán này lại quan trọng, và giá trị của công cụ ML này nằm ở đâu?
6. Type safety, persistence, architecture và decomposition
Bốn phần còn lại của tài liệu là những nguyên tắc software engineering khá quen thuộc, kiểu có thể gặp trong một technical design document (TDD) thông thường.
Type safety. Lát nữa talk sẽ cho thấy repo machine learning của team trông thế nào. Câu hỏi ở đây: type contract giữa repository sản phẩm lõi và repo machine learning này là gì? Các type được chia sẻ ra sao, và làm sao chúng luôn được giữ đồng bộ?
Persistence layer. Có database không? Đây là vùng mà team cho rằng tốt nhất là không để researcher bỏ quá nhiều thời gian vào. Researcher chỉ cần ghi lại mình đã đi được tới đâu. Và đây là một điểm vào rất tốt khi team bắt đầu kéo thêm software engineer vào hỗ trợ project.
System architecture tổng thể. Đây có phải là một workflow không? Hay là một chuỗi nhiều workflow nối nhau? Có gọi LLM từ bên ngoài không? Nói cách khác: anatomy (giải phẫu) của research prototype này là gì, taxonomy của nó là gì?
Merge và decompose. Cuối cùng, project này sẽ được merge vào bằng cách nào, và sẽ được phân rã ra sao? Phần này talk sẽ quay lại kỹ hơn ở phía sau.
7. Đòn bẩy 2: monorepo gồm các microservice tách rời
Quay lại ba đòn bẩy, đòn bẩy đầu tiên là tài liệu research project taxonomy. Đòn bẩy thứ hai Vaidas muốn nói là cách team cấu trúc code và cách họ serve các feature đang có.
Team có một repository riêng, tách khỏi repo sản phẩm lõi, và toàn bộ repo này viết bằng Python. Hợp lý thôi, vì tất cả đều là đồ AI, ML. Về cơ bản nó là một monorepo gồm các microservice được cô lập gọn gàng và hoàn toàn decoupled (tách rời) khỏi nhau.
Ví dụ, data-driven entity prediction là custom transformer model của team. Nhờ cách tổ chức này, nó có thể tự lớn lên và được lặp cải tiến (iterate) mà hoàn toàn tách rời khỏi một research initiative khác. Tỉ lệ gần như là một researcher ứng với một microservice, và team thấy cách này chạy rất tốt.
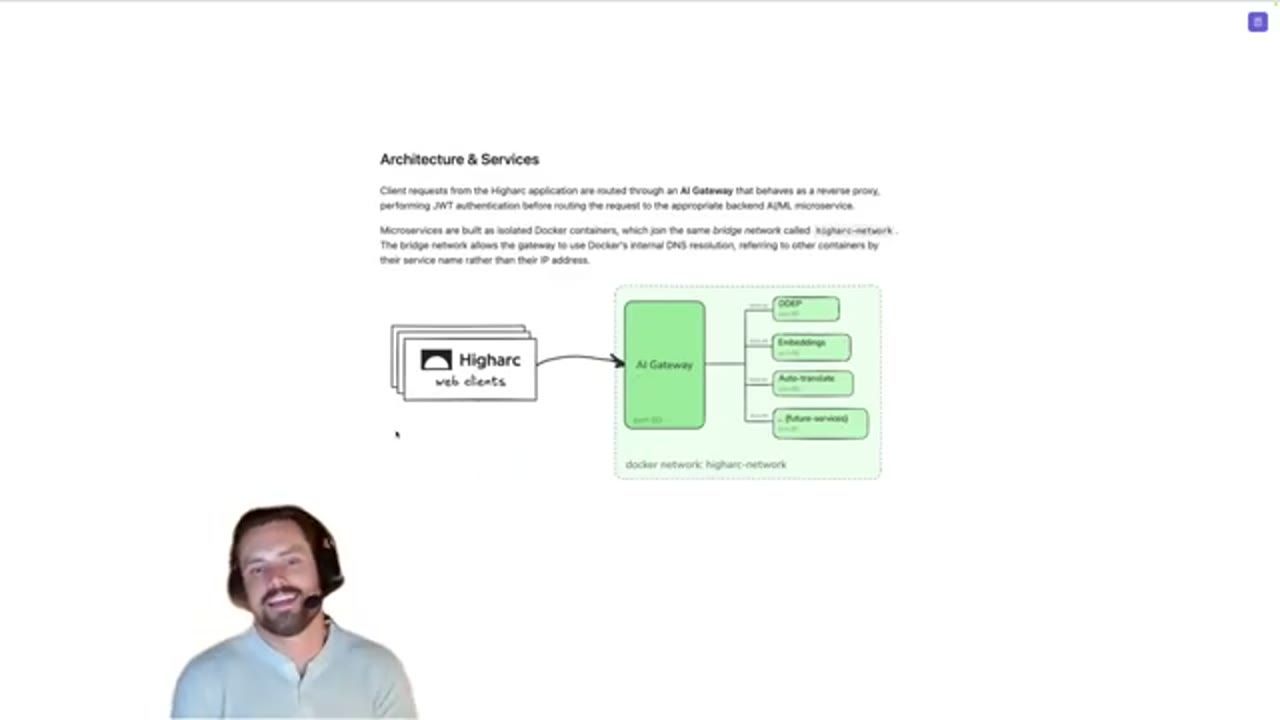
Có một gateway đứng canh các request, và tất cả nằm trong một Docker bridge network. Các consumer lõi, tức client trong web application của Higharc, gọi API tới gateway này, rồi gateway route request tới đúng microservice.
8. Layered architecture bên trong mỗi microservice
Nhìn kỹ hơn vào từng microservice, team thường xây chúng theo một layered architecture khá đơn giản: có lớp API, lớp business logic và lớp data. Ngoài ra team thường có các spec được viết tài liệu rất gọn gàng, để agent có thể tự đi lại trong các repository này và giúp tăng tốc cho ML researcher nhiều nhất có thể.
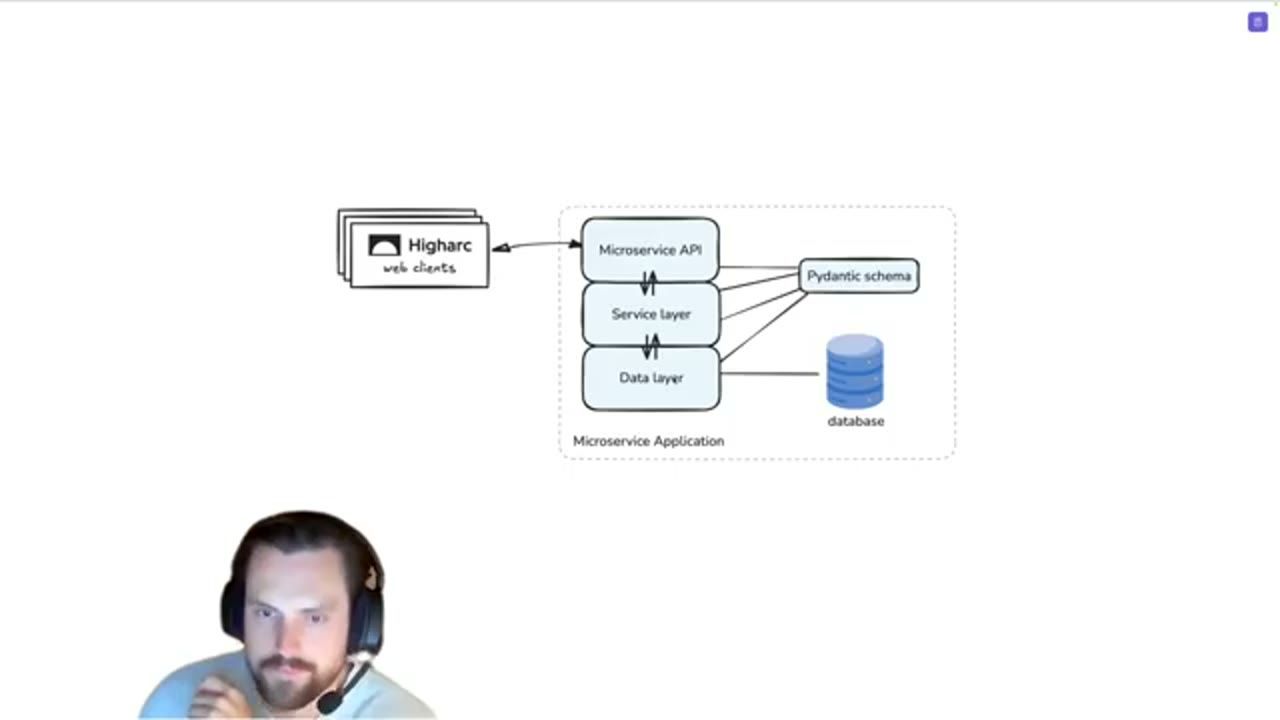
Một cách nhìn khác vào layered architecture này: business logic lõi nằm ở services layer. Lớp này có thể gọi LLM bên ngoài tới các foundation model, hoặc team có thể cần kéo weight của chính các machine learning model của mình vào trong CI/CD. Sau đó business logic được bọc bởi các controller, rồi các API router được đặt bao quanh controller và expose ra thành các ứng dụng FastAPI. Mỗi microservice là một ứng dụng độc lập (standalone).
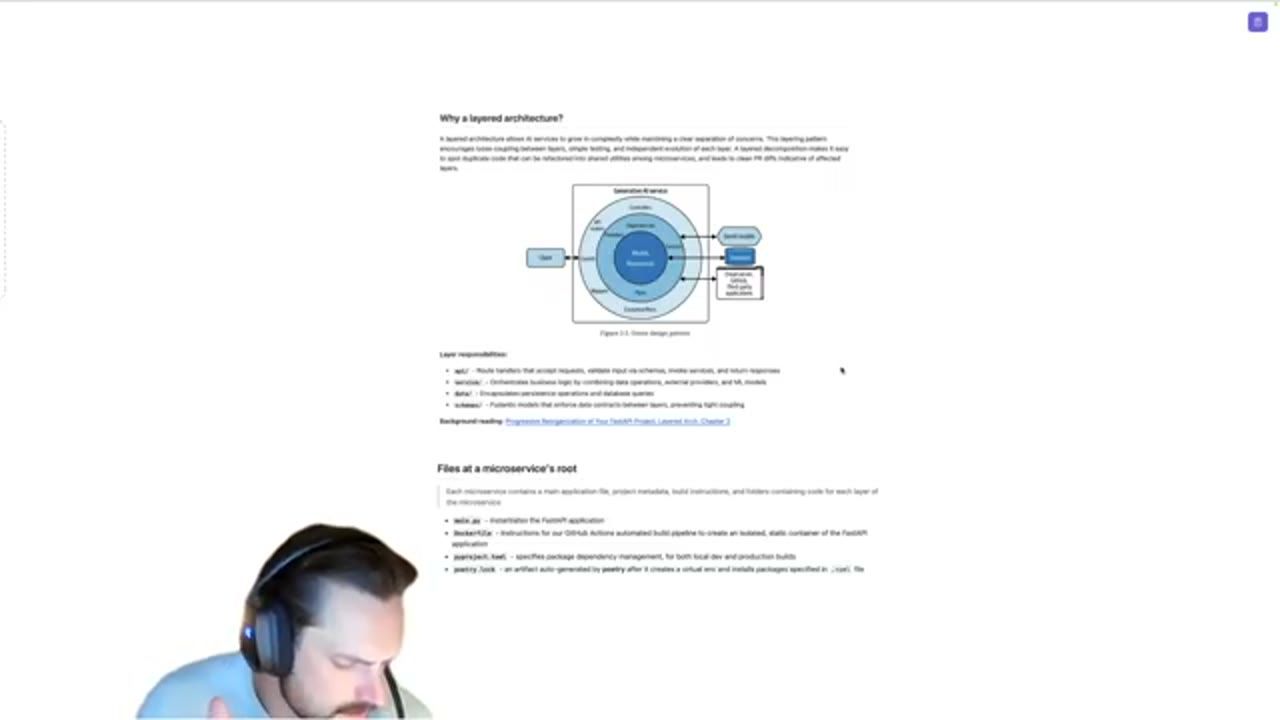
api/ nhận request, kiểm tra input bằng schema, gọi service và trả response; services/ điều phối business logic, kết hợp thao tác dữ liệu, provider bên ngoài và ML model; data/ gói các thao tác persistence và truy vấn database; schemas/ là các Pydantic model giữ contract dữ liệu giữa các lớp.Như đã nói ở slide trước, không phải client gọi thẳng vào microservice này. Request đi qua gateway trước, và gateway route nó tới đúng microservice.
9. File ở root và bộ xương chung của các service
Bên trong mỗi microservice, ở root directory, về cơ bản có metadata, hướng dẫn build, một Dockerfile mô tả cách build ứng dụng, khai báo dependency của project, và các lockfile của Poetry hoặc uv tuỳ nhu cầu.
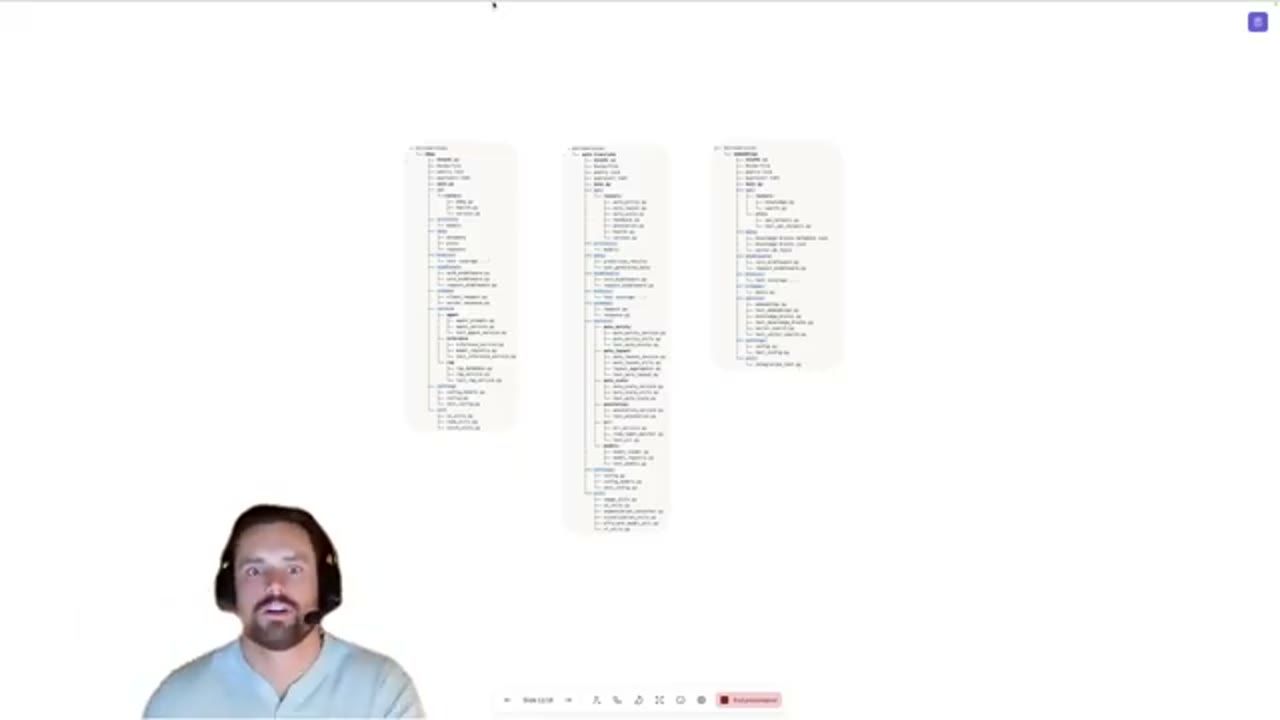
Vaidas thích vẽ ra cách sắp xếp mang tính "giải phẫu" của ba microservice mà team đang chạy trong production. Nhìn vào đó, có thể thấy các xu hướng chung, những bộ xương sống (skeletal backbone) nhất quán giữa các project. Nhờ vậy rất dễ vẽ chúng ra và bảo đảm chúng lớn lên theo đúng best practice của software engineering.
10. Lớp tooling dùng chung của monorepo
Vậy là xong phần monorepo: có các microservice, và nằm bên dưới tất cả, dùng chung cho cả repository, là các thứ sau:
- GitHub Actions để build và deploy, chạy bộ test tự động, cùng linting, formatting và type check, đủ thứ mà người ta vẫn mong đợi.
- Vài Jupyter notebook chạy trên Modal để có GPU compute, cùng một số ML study khác.
- Thậm chí có cả một CLI khá vui.
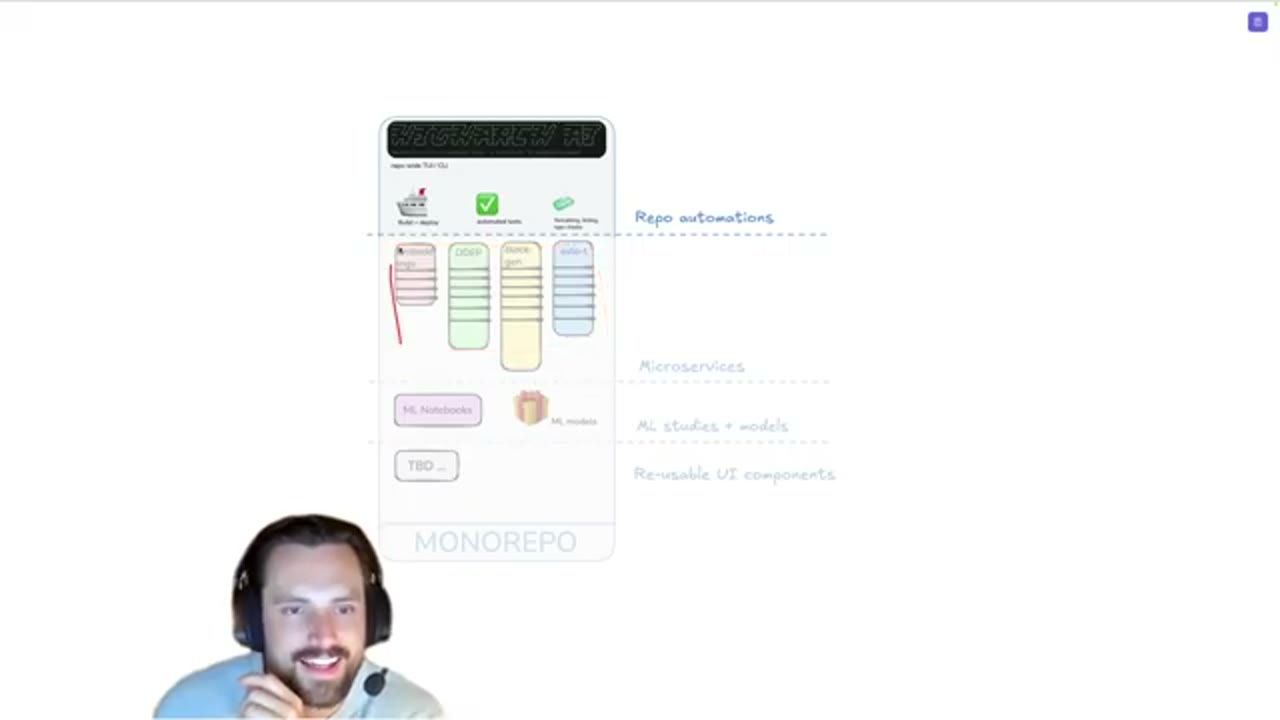
Nhưng theo cách team nhìn, đây chỉ là một lớp tooling, kể cả cái CLI vui vẻ kia. Tất cả chỉ để hỗ trợ ML engineer đóng gói các microservice mà team serve trong production.
Tóm lại hai đòn bẩy đầu: RPT là tài liệu bàn giao giữa ML researcher và các software engineer được kéo thêm vào. Monorepo là nơi research project cuối cùng sẽ đến. Bước duy nhất còn lại là: đi từ chỗ này tới chỗ kia bằng cách nào, nhảy từ một sang hai ra sao?
11. Đòn bẩy 3: decomposition là một bài toán design
Đòn bẩy thứ ba Vaidas muốn nói là decomposition và kế hoạch review PR. Team coi đây thực sự là một bài toán design: phải tìm cách cắt nhỏ (slice and dice) một research prototype lớn, nguyên khối (monolithic).
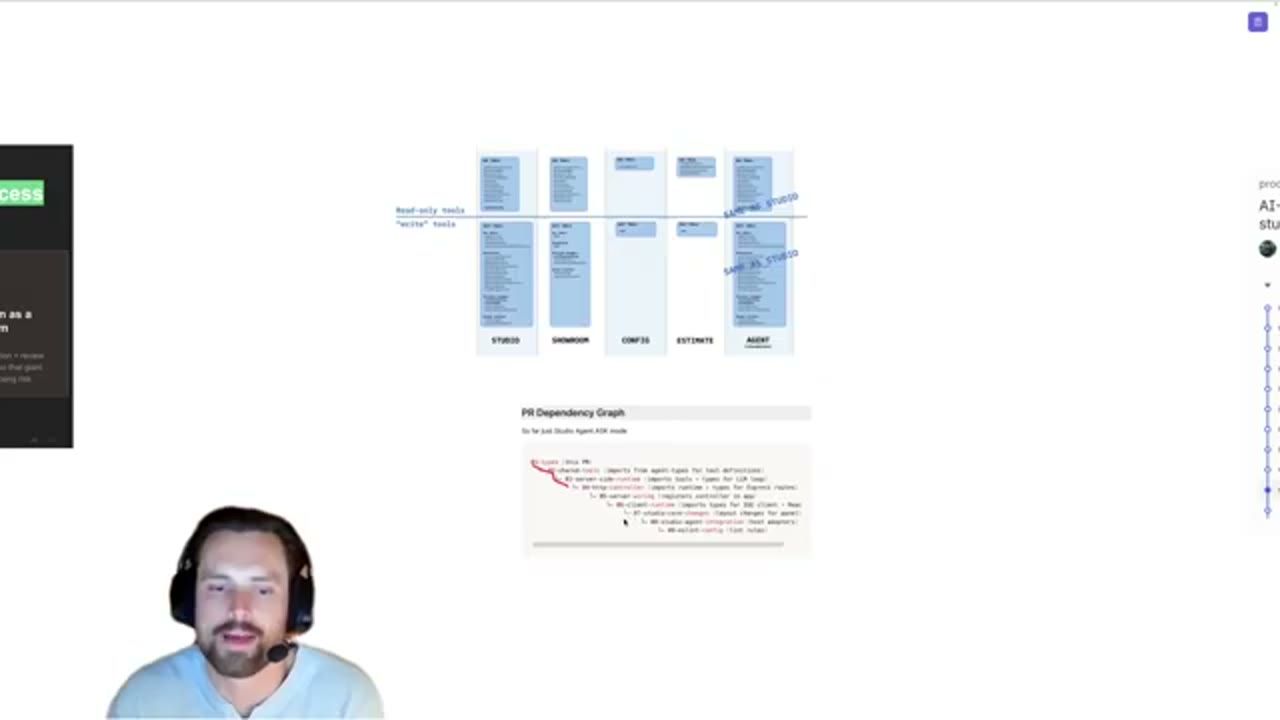
Hình trên là vài ảnh từ một feature agent dùng trên toàn platform. Ở đó team đã thật sự nghiên cứu nên cắt project theo những trục nào, và dependency graph giữa các phần sẽ trông ra sao.
12. Stacked diffs với Graphite và review bất đồng bộ
Sau đó team dùng Graphite để làm stacked diffs, tức chồng các diff nhỏ lên nhau, nhằm phân rã những prototype lớn, nguyên khối đã được chứng minh là chạy. Rồi họ đưa đúng người vào review, để chắc chắn các phần này sẵn sàng cho production.
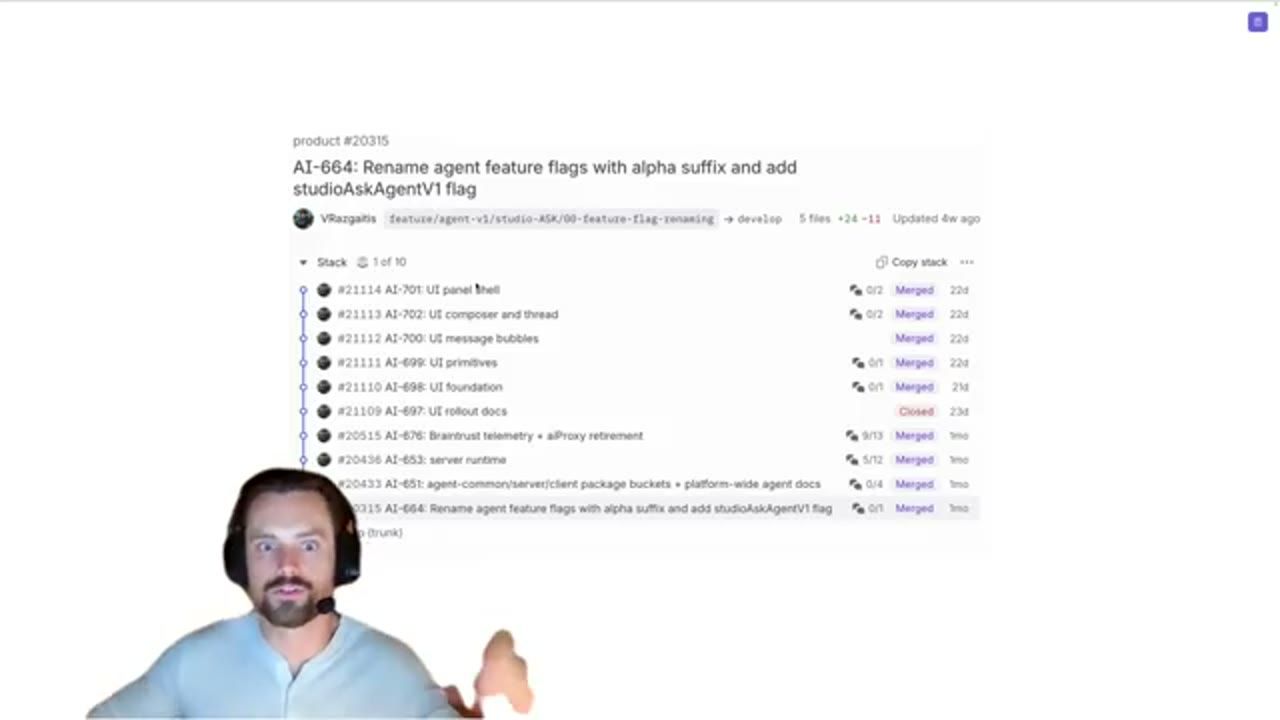
Team rất thích Graphite vì nó cho phép review bất đồng bộ (asynchronous review). Vaidas có thể đang làm một PR ở tận trên cao của stack trong khi một chuyên gia domain vẫn đang review một PR khác bên dưới.
Khi đã phân rã các PR một cách có suy tính, team có thể bắt đầu nhờ tới các subject matter expert (chuyên gia) trong toàn tổ chức, mỗi người xem đúng lát cắt của mình, những PR nhỏ đã được phân rã chặt chẽ mà họ cần xem.
Và một lần nữa, có rất nhiều chỗ chồng lấn giữa giai đoạn này và tài liệu research project taxonomy ban đầu. Một khi đã vạch ra các lớp, kiến trúc, loại persistence nào đang có và các type, thì chính những điều đó thường định hình chiến lược decomposition để đưa project vào monorepo.
13. Ba câu hỏi chẩn đoán để tự đánh giá team
Để kết thúc, Vaidas quay lại ba vùng trọng tâm, giờ dùng như công cụ đánh giá xem team của bạn đưa research vào production tốt tới đâu. Anh đưa ra vài khung chẩn đoán (diagnostic framework) để biết mình có cần dành thêm thời gian và sự chú ý cho vùng nào không.
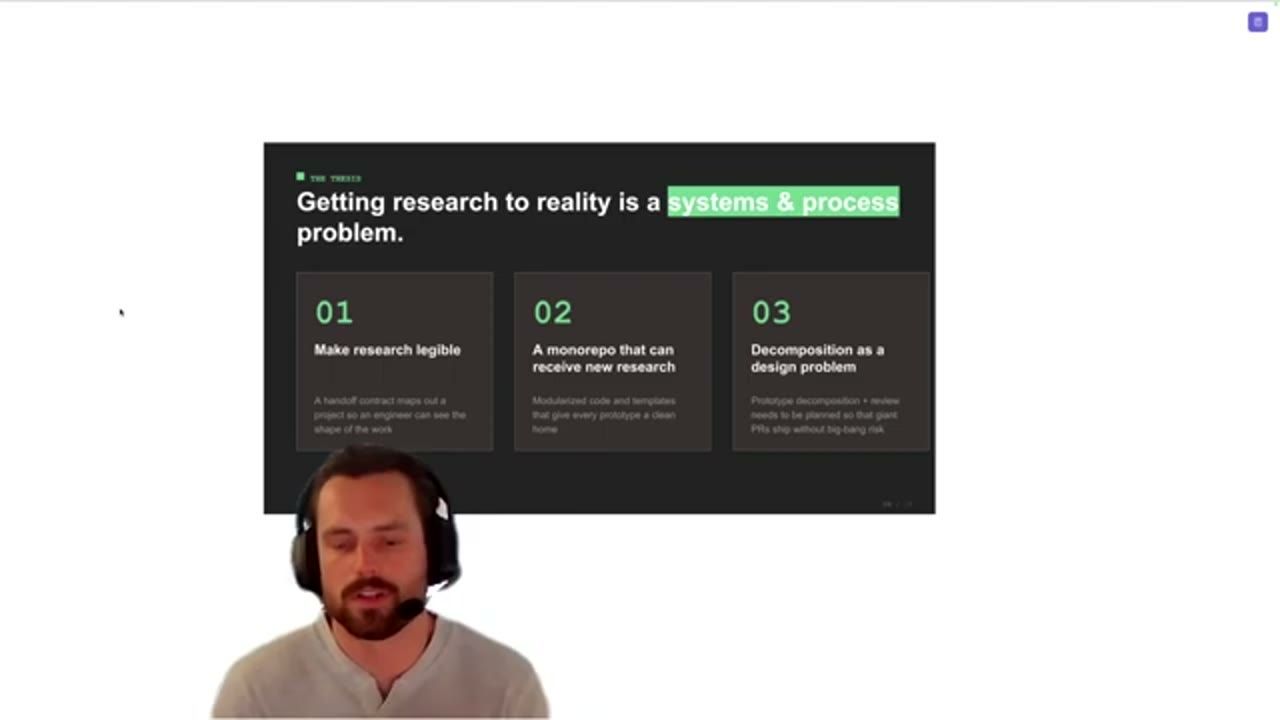
Bước một, research legibility. Khi team bắt đầu xếp người cho các research initiative, gồm người làm product, software engineer, AI engineer, thì họ có thấy rõ mình nên dồn sức vào đâu không? Có rõ là cần nhặt những task nào để đưa prototype này vào production không? Nếu ở đây còn mơ hồ, có lẽ bạn cần dành thời gian xem lại quy trình này.
Bước hai, code repository. Khi bắt đầu chuẩn bị đưa prototype vào codebase chuẩn production, có rõ những "ngăn" để đặt code mới nằm ở đâu không? Có template, framework và pattern sẵn có để làm theo không? Hay có khả năng bạn đã bắt đầu lớn vượt khỏi codebase và system architecture đó, đến mức mỗi lần đưa một khái niệm research mới vào là lại phải vật lộn với những abstraction cũ và đau đầu vì giới hạn của repository?
Bước ba, decomposition. Bạn có ước lượng được một cách nhất quán timeline và ngày giao hàng khi chuyển các khái niệm research vào repository không? Có rõ nên nhờ subject matter expert nào review và productionize research này không? Nếu đang gặp vấn đề ở đây, nhiều khả năng nó chỉ ra vấn đề ở thượng nguồn: hoặc ở cách research đang được điều phối và bàn giao, hoặc ở chính codebase đang chứa nó.
Vaidas khép lại: đó là tất cả những gì anh có, và hy vọng nó hữu ích. Anh rất thích suy nghĩ về các cách giúp team mình tăng tốc độ đưa khái niệm research vào production. Nếu bạn đã xem tới tận đây thì có lẽ bạn cũng quan tâm tới những chuyện này, và anh rất muốn so sánh ghi chép, trao đổi ý tưởng bất cứ lúc nào. Anh cảm ơn mọi người.
Nguồn và liên kết
- Trang talk trên ai.engineer
- Higharc
- The Pragmatic Engineer: Scaling Engineering Teams via RFCs: Writing Things Down
- Graphite (stacked diffs)
- FastAPI · Pydantic · Poetry · uv
- Docker bridge network · GitHub Actions · Modal
- GitHub của Vaidas Razgaitis · X của Vaidas Razgaitis · LinkedIn: linkedin.com/in/vrazgaitis
Related talks
The Missing Layer After Launch
Raphael Kalandadze · Wandero AI · 19 min
Sau khi ship agent: bốn operating agent (log-monitor, PR-review, session-analyzer, QA computer-use) giúp khép vòng loop, đo sức khoẻ và sửa lỗi production.
I Run a Fleet of AI Agents Across Three Machines. Here's What Broke.
Kyle Jaejun Lee · KRAFTON · 9 min
Vận hành đội coding agent trên ba máy: hierarchy CEO→worker, state nằm trong file, reset thay compact, review gateway, năm failure và hướng đi Kubernetes.
Every Solo Agent Builder Eventually Reinvents a Worse Version of CI/CD
Sumaiya Shrabony · University of Colorado Denver · 11 min
Solo builder sẽ tự dựng lại 5 thứ của CI/CD; demo 3 cách agent nói dối (voice drift, claim không nguồn, hook trùng) và gate chặn từng cách.