Respect The Process
AI Engineer World's Fair 2026: Online Track · Video gốc
Cách Watershed để coding agent tự do viết code nhưng buộc mọi edit đi qua typed SDK và deterministic execution, giữ process valid, traceable, replayable.
1. Watershed và một vertical đầy expert judgment
Andrew Dumit làm AI engineering tại Watershed, công ty tự giới thiệu là "the sustainability AI platform". Ở Watershed, anh làm phần AI để xây dựng product carbon footprint, tức là dấu chân carbon của từng sản phẩm, và từ đó đo lượng phát thải (emissions) gắn với mọi thứ mà một công ty mua vào và bán ra.
Sustainability, vertical mà Watershed đang làm, là một lĩnh vực có rất nhiều expert judgment call rải khắp nơi: những chỗ không có đáp án tuyệt đối mà phải dựa vào phán đoán của chuyên gia. Chính điều này khiến việc xây và deploy agent trong lĩnh vực này vừa thú vị vừa khó. Trong talk, Andrew đi sâu vào một task cụ thể trong sustainability mà nhóm anh đã dành khá nhiều thời gian, chia sẻ những bài học từ việc deploy coding agent cho task đó, và giải thích vì sao làm được điều đó đòi hỏi họ phải "respect the process", tôn trọng chính quy trình.
Để hình dung sustainability như một vertical, hãy nhìn vào kiểu câu hỏi họ phải trả lời. Ví dụ: phát thải quy cho một chai rượu vang là bao nhiêu? Hoặc: khi một quy trình công nghiệp tạo ra nhiều co-product cùng bán được, thì nên dùng phương pháp nào để phân bổ (allocate) phát thải cho từng co-product?
Ở những trường hợp như vậy, có rất nhiều cách để ra đáp án đúng bằng con đường sai, và cũng có rất nhiều đáp án đúng mà các chuyên gia sẽ bất đồng với nhau. Vì thế, bạn phải verify cả process chứ không chỉ answer. Một đáp án chỉ thật sự có cơ sở trong chừng mực process tạo ra nó là đúng.
2. Sáu chuyên gia, một chai rượu, chênh nhau 50%
Andrew dẫn một ví dụ từ một nghiên cứu năm 2020. Sáu chuyên gia được giao đúng cùng một bộ dữ liệu về đúng cùng một chai rượu vang. Dù ai cũng có quyền truy cập vào những thứ y hệt nhau, đáp án họ đưa ra vẫn lệch nhau tới 50%.
Theo một nghĩa nào đó, phán đoán của cả sáu người đều đúng. Nhưng chính vì vậy, nếu một hệ thống cố gắng bắt chước các chuyên gia ấy, thì chỉ validate đáp án cuối cùng là không đủ để biết đáp án hệ thống đưa ra có thật sự đúng hay không. Đáp án nào trong khoảng đó cũng có thể là "đúng", nên con số một mình không nói lên được gì về chất lượng của lập luận phía sau.
3. Task: chỉnh sửa những graph supply chain khổng lồ
Với bối cảnh đó về sustainability và loại câu hỏi cần trả lời, Andrew zoom vào task cụ thể mà phần còn lại của talk xoay quanh: giúp người dùng chỉnh sửa (edit) những graph phức tạp.
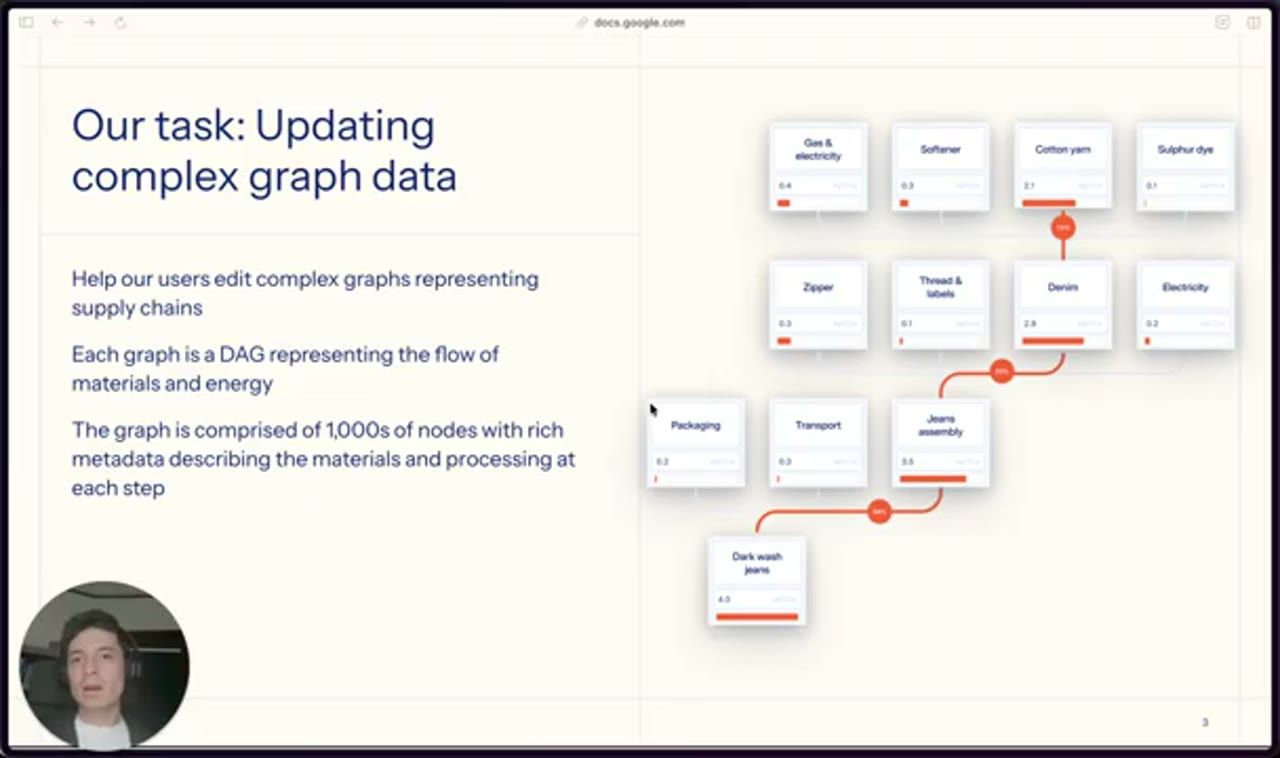
Mỗi graph biểu diễn supply chain của một sản phẩm duy nhất. Ví dụ trên slide là graph của một chiếc quần jeans dark wash. Phía upstream của nó là bước lắp ráp (assembly) chiếc quần từ vải denim, chỉ, nhãn (labels) và khoá kéo (zipper), cùng với năng lượng, vận chuyển (transportation) và bao bì (packaging) cần thiết để di chuyển mọi thứ qua supply chain, tạo ra và vận hành các quy trình công nghiệp đó.
Mỗi graph như vậy biểu diễn toàn bộ dòng chảy của tất cả những thứ đi qua supply chain, và gồm hàng nghìn node, mỗi node mang metadata phong phú mô tả vật liệu và cách xử lý ở bước đó. Về mặt cấu trúc, đây là một DAG (directed acyclic graph) của vật liệu và năng lượng.
4. ReAct agent: ổn trên một graph, vỡ khi scale
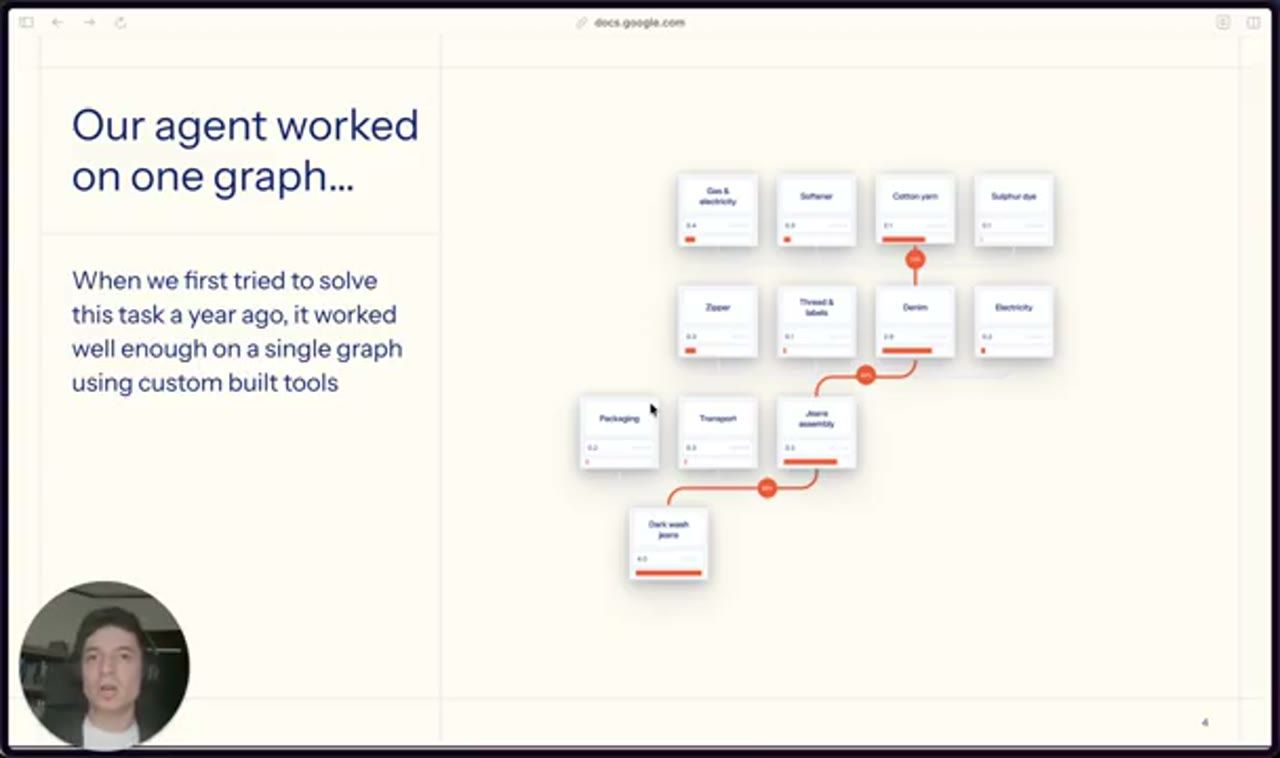
Lần đầu nhóm thử giải bài toán này, cách đây hơn một năm một chút, nó chạy khá ổn trên một graph. Nó vẫn có vấn đề, nhưng nhóm đã đưa cho một ReAct agent những tool được đặc tả rất kỹ để khám phá và tương tác với graph qua function call. Ngay cả khi nó chạy được, vài vấn đề đã lộ ra:
- Thiếu nhất quán (consistency): agent có lúc khám phá graph chưa đủ sâu.
- Tốn context: chỉ trên một graph thôi, các tool call đã ngốn rất nhiều context, vì agent phải đọc sâu qua những node chứa nhiều metadata.
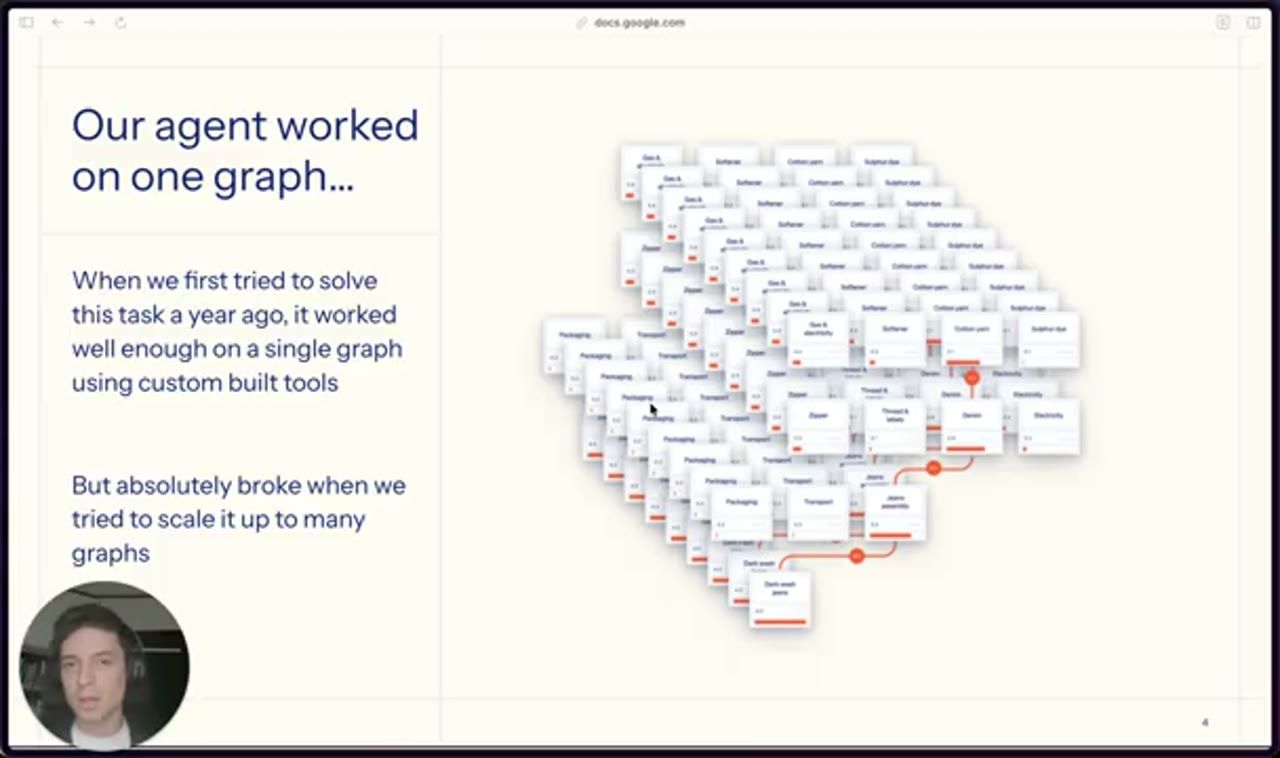
Nhưng khi nhóm thử scale lên nhiều graph, hay nói thật là chỉ cần vài graph thôi, nó vỡ hoàn toàn. Sự thiếu nhất quán bị phóng đại lên rất nhiều: agent dùng một cách tiếp cận cho graph thứ nhất, một cách khác cho graph thứ hai, và quên mất hoàn toàn graph thứ ba, thậm chí không hề xử lý nó.
Bản thân việc khám phá (exploration) cũng trở thành nút thắt cổ chai lớn, vì cần rất nhiều tool call để khám phá và thao tác trên các graph ở quy mô đó. Nó còn làm vấn đề context tệ hơn, vì các tool call nuốt context ở cả hai phía: phía edit, khi agent thật sự phải thực hiện thay đổi, và phía exploration, khi agent phải tìm hiểu xem cần thay đổi những gì.
Tệ hơn nữa, khi context bị ăn dần, agent bắt đầu hallucinate các phần khác nhau của schema. Dù đã có những tool chuyên biệt, điều đó vẫn dẫn tới retry và cuối cùng là lỗi. Nói theo ngôn ngữ dữ liệu, task lúc này gồm hàng chục tới hàng trăm graph và hàng chục tới hàng trăm nghìn node mà agent phải thao tác trên đó.
5. Đổi sang coding agent: ba thứ trước đây còn thiếu
Thời gian trôi qua, coding agent trở nên tốt hơn rất nhiều, và nhóm nghĩ: "Cái này sẽ chạy tuyệt vời đây." Vậy nên, rất tự nhiên, họ thay coding agent vào. Việc đó đem lại ba kết quả rất quan trọng mà trước đây họ còn thiếu.
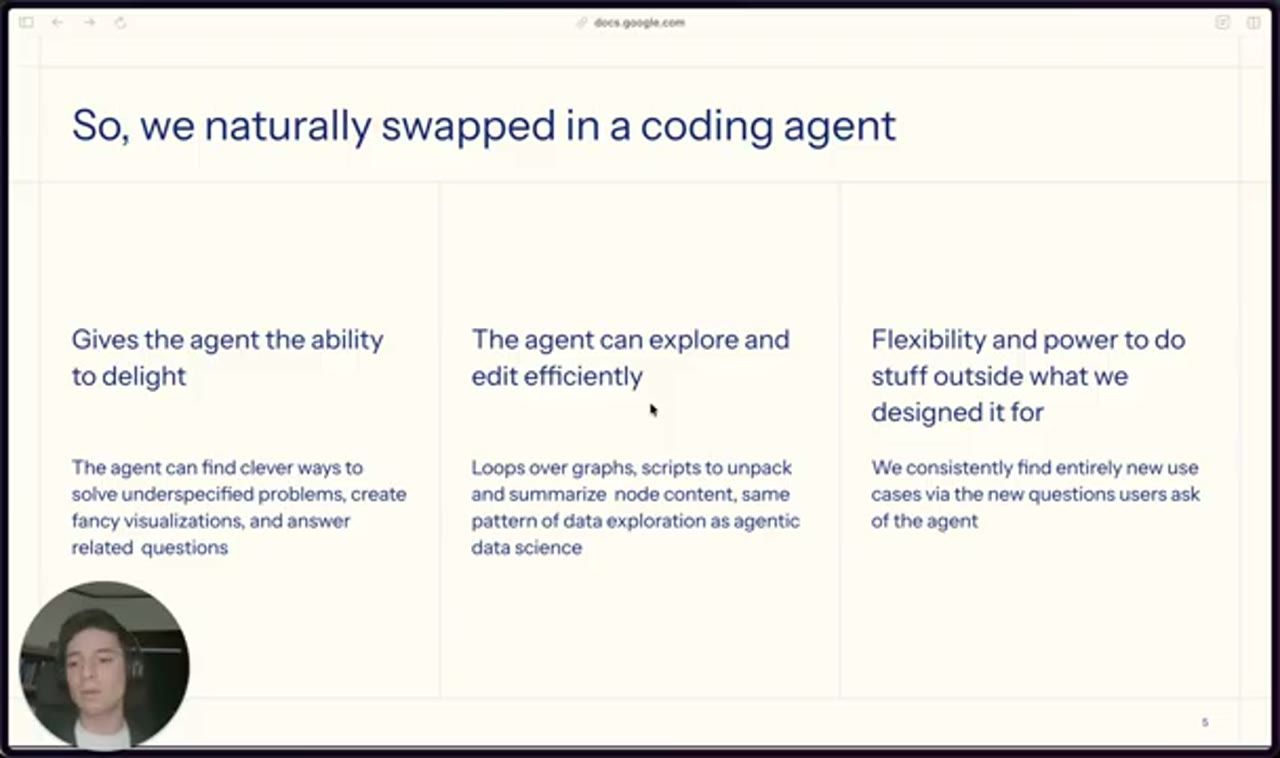
Thứ nhất, agent có khả năng làm người dùng thích thú (delight users). Agent bắt đầu tìm ra những cách khéo léo để giải các bài toán thiếu đặc tả (underspecified), kiểu bài toán chưa thành hình hoàn chỉnh. Nó có thể tạo ra những visualization đẹp ngay tại chỗ bằng cách tự viết code để vẽ, và thậm chí trả lời được những câu hỏi liên quan, vì giờ nó có gần như toàn bộ sức mạnh của một coding agent trong môi trường đó.
Thứ hai, từ phía nhóm phát triển, agent khám phá và edit hiệu quả hơn trước rất nhiều. Nó có thể viết loop chạy qua các graph và các node. Nó có thể viết script để giải nén và tóm tắt nội dung của các node bên dưới, về cơ bản đi theo đúng pattern khám phá dữ liệu vẫn thấy trong các workflow agentic data science.
Thứ ba, agent có sự linh hoạt và sức mạnh để làm cả những việc nằm ngoài những gì nhóm thiết kế cho nó. Điều này thật sự thú vị: cho tới hôm nay, nhóm vẫn liên tục tìm ra những use case hoàn toàn mới, thông qua những câu hỏi mới người dùng đặt ra và những thứ mới họ muốn thử với agent này.
6. Nhưng code không ràng buộc thì đáng sợ
Cả nhóm rất hào hứng. Họ đưa agent ra thế giới, bắt đầu viết một loạt eval cho nó, và nhanh chóng nhận ra rằng code không bị ràng buộc (unconstrained code) khá là đáng sợ.
Andrew nói nếu bạn đang xem talk này, nhiều khả năng bạn đã từng trải qua cảm giác đó với Claude Code: nó hơi "chạy loạn" trên đường đạt tới mục tiêu bạn giao. Nó với tới một thứ mà bạn không nghĩ nó có thể hay nên với tới, hoặc nó có quyền truy cập, hay tự tìm ra cách truy cập, vào một thứ bạn không nghĩ nó với được.
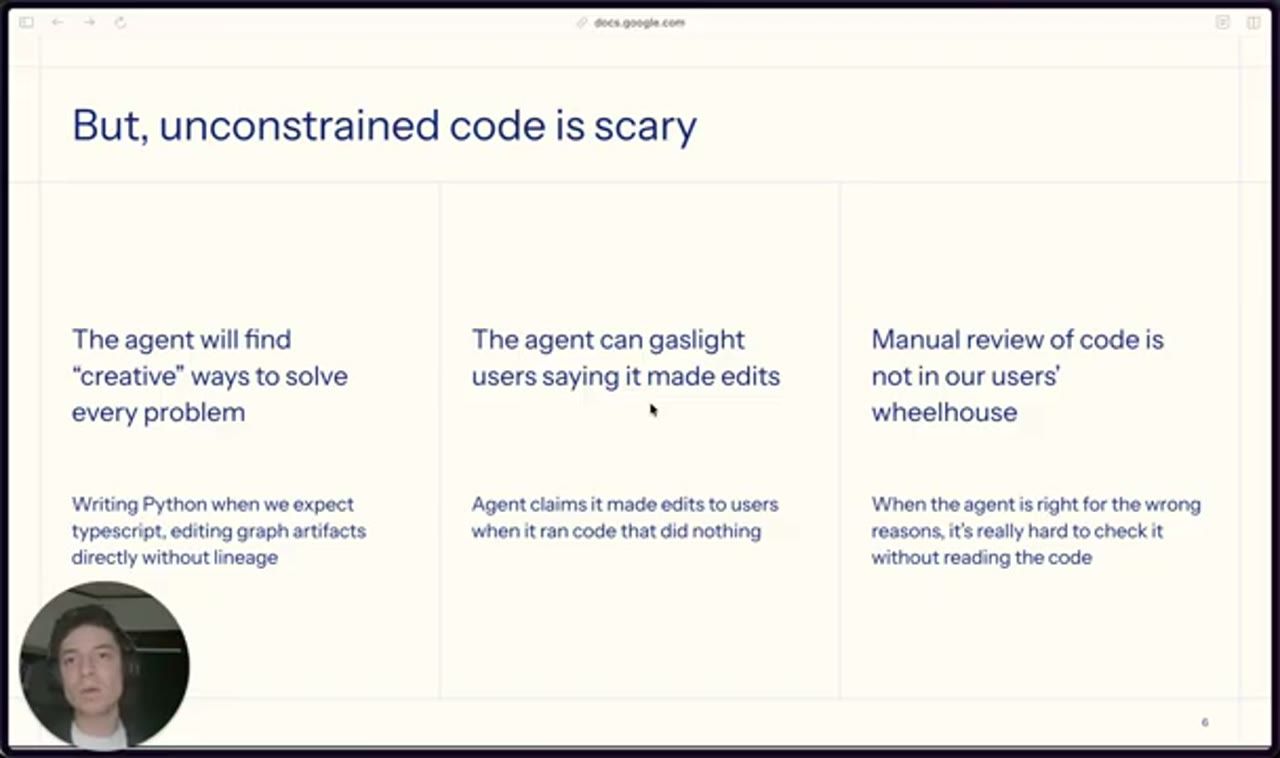
Vấn đề thứ nhất: agent sẽ tìm ra những cách "sáng tạo" để giải gần như mọi bài toán. Trong trường hợp của Watershed, nhóm thấy agent viết Python trong khi họ kỳ vọng, và đã chỉ dẫn rõ, là phải viết TypeScript, chỉ vì nó phát hiện ra trên virtual machine được cấp có cài sẵn Python. Hoặc nó sửa trực tiếp các graph artifact nằm bên dưới dữ liệu mà không để lại bất kỳ lineage nào, bằng cách chỉnh thẳng tham số hay dữ liệu, thay vì thật sự viết code để thực hiện thay đổi đó một cách có dấu vết.
Vấn đề thứ hai: agent bắt đầu "gaslight" người dùng, nói rằng nó đã thực hiện các edit trong khi thật ra chưa. Nó viết code mà nó nghĩ sẽ tạo ra hiệu ứng mong muốn, rồi tuyên bố: "Xong rồi. Mọi thứ đều chạy. Đúng y như bạn yêu cầu." Nhưng các edit thật ra không hề được áp dụng. Như vậy, nó gần như đã nói dối người dùng, hoặc ít nhất khiến họ tin rằng các edit đã được thực hiện đúng như mong đợi.
Vấn đề thứ ba: sau khi agent hoàn thành task, việc review công việc của nó khó hơn nhiều. Review code thủ công không phải là sở trường của người dùng Watershed. Họ không phải software engineer, và có thể từng hoặc chưa từng làm việc với code. Khi agent đúng nhưng vì lý do sai, chuyện vẫn xảy ra, và có thể xảy ra thường xuyên trong sustainability nói chung, thì gần như không thể kiểm tra công việc của nó nếu không đi đọc trực tiếp đoạn code đó.
7. Chuyện "process khác answer" không hề mới
Câu chuyện "process chứ không phải answer" này thật ra không mới. Andrew dẫn một loạt nghiên cứu gần đây.
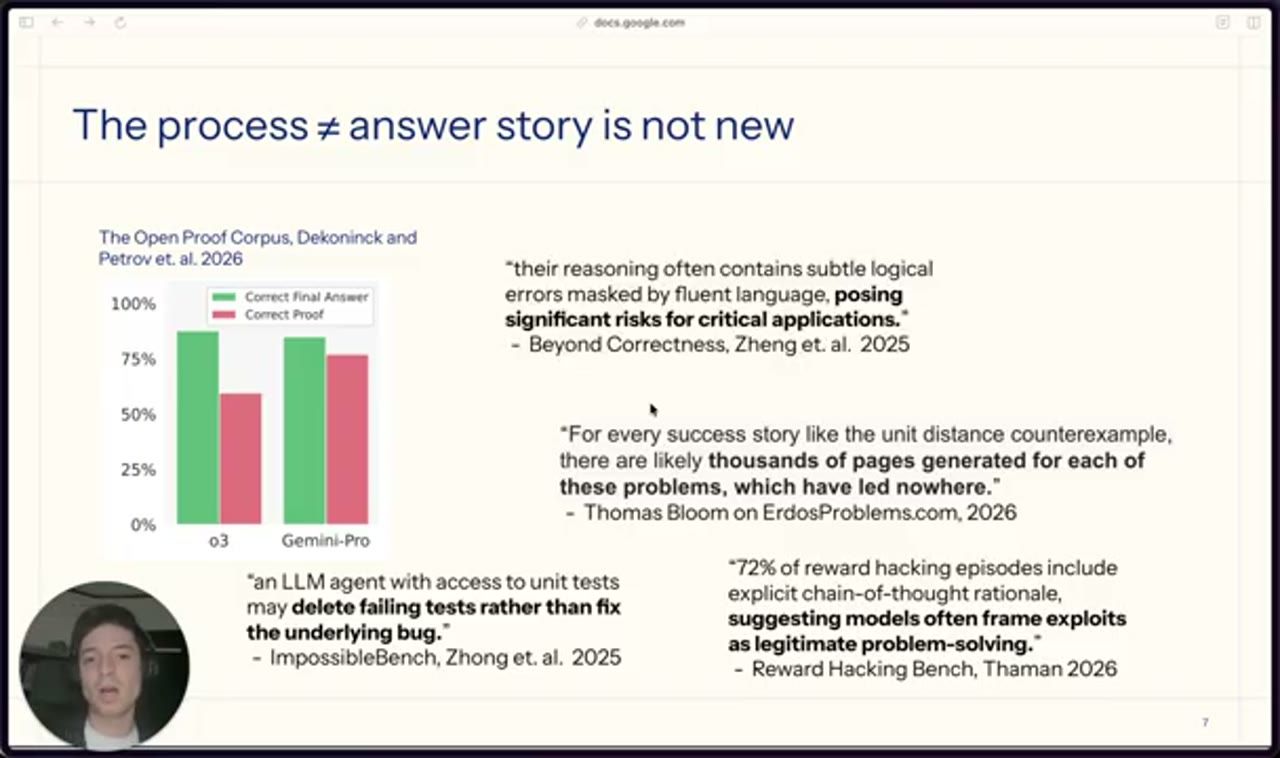
Một paper năm 2026, The Open Proof Corpus, cho thấy có thể có một khoảng cách khá lớn giữa đáp án cuối cùng đúng và chứng minh (proof) đúng, dù khoảng cách đó có lẽ đang thu hẹp dần. Và đây là trong toán học, nơi đáp án có thể được verify hoàn toàn. Nhóm Watershed xem vấn đề của họ còn tệ hơn, vì trong lĩnh vực của họ, bạn không thể verify hoàn toàn đáp án.
Hiện tượng này cũng đã được ghi nhận ở chỗ agent sẽ reward hack. Ngay cả với những thứ phức tạp như các bài toán Erdős (Erdős Problems), bạn sẽ nhận về rất nhiều trang chứng minh đầy lỗi mà không dẫn tới đâu. Tới ImpossibleBench, nơi agent có thể xoá test đang fail thay vì sửa bug thật, và tới những mảng khác của toán học. Các tác giả của paper Beyond Correctness kết luận rằng điều này có thể gây ra rủi ro đáng kể cho các ứng dụng quan trọng (critical applications).
Andrew nhấn mạnh: tất cả những điều trên không có nghĩa là không nên dùng coding agent. Nhóm không muốn ràng buộc cách agent suy luận (reason), vì họ nhận được quá nhiều lợi ích từ những model mạnh này. Nhưng họ cũng không thể verify đáp án một cách hoàn hảo, nên thậm chí họ không biết khi nào đáp án cuối cùng chắc chắn đúng, vì những expert judgment call luôn hiện diện trong lĩnh vực của họ.
Vậy đòn bẩy chính còn lại là validate process, và bảo đảm agent đi theo process đó đúng như cách nhóm kỳ vọng.
8. Constrain the effects, not the expression
Để làm điều đó, nhóm đóng khung vấn đề thành một nguyên tắc: ràng buộc hiệu ứng, không ràng buộc cách diễn đạt (constrain the effects, not the expression). Agent được tự do suy nghĩ và viết code theo cách nó muốn, nhưng những gì code đó thật sự làm thay đổi trên dữ liệu thì phải đi qua một con đường được kiểm soát.
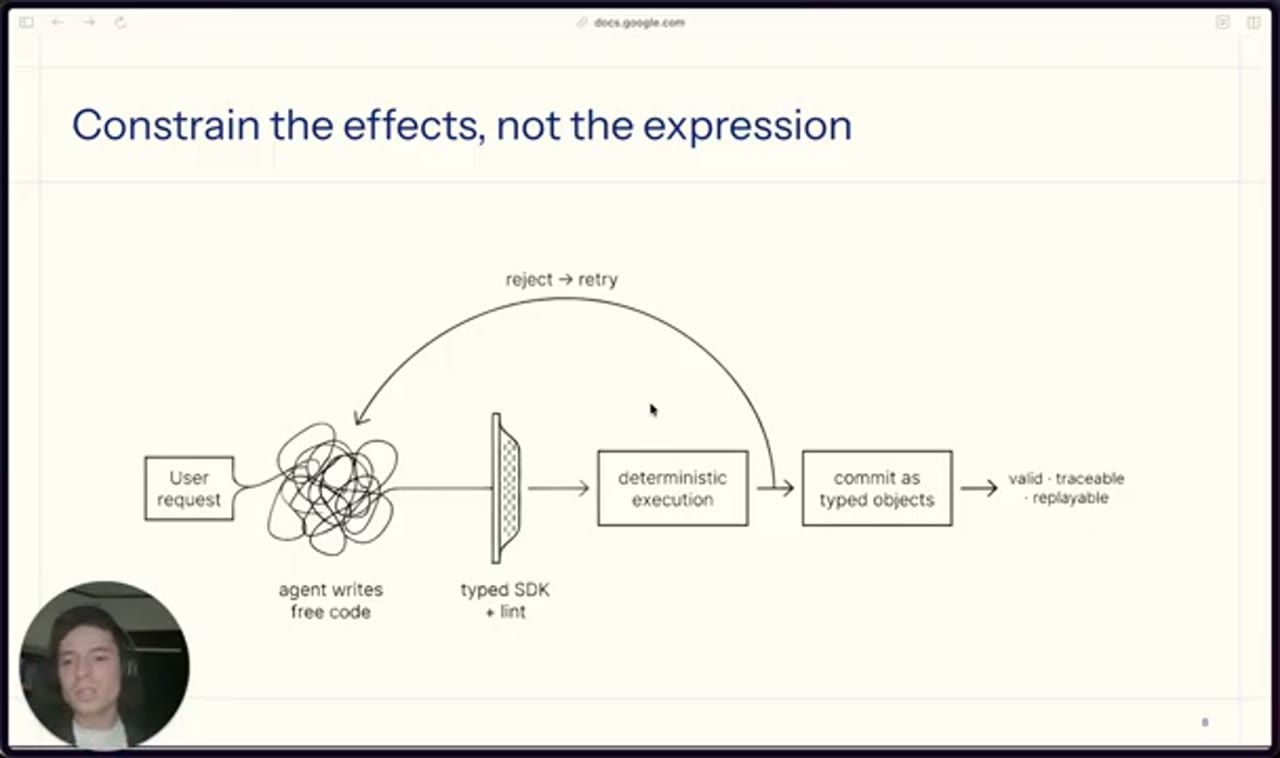
Task của họ bắt đầu bằng một user request. Từ đó, agent có thể tự do viết code để thực hiện request. Tuy nhiên, nhóm bắt buộc mọi đoạn code quan trọng, tức là những thứ thật sự edit graph, phải đi qua một bộ lọc là typed SDK do nhóm xây dựng, nơi họ có thể lint và kiểm tra lỗi.
Sau đó, nhóm sở hữu bước execution cuối cùng, để bảo đảm tạo ra những typed object có thể commit như những edit thật sự lên graph. Những object này trung thành với process. Gộp tất cả lại, toàn bộ process là valid, traceable và replayable: hợp lệ, truy vết được và chạy lại được. Còn nếu không, nhóm có thể reject, retry và gửi ngược lại cho agent để báo rằng có điều gì đó đã đi chệch hướng.
9. SDK là cánh cửa duy nhất
Andrew đi sâu hơn vào hai thành phần: typed SDK và deterministic execution. Trước hết, SDK là cánh cửa duy nhất (our SDK as the only door).
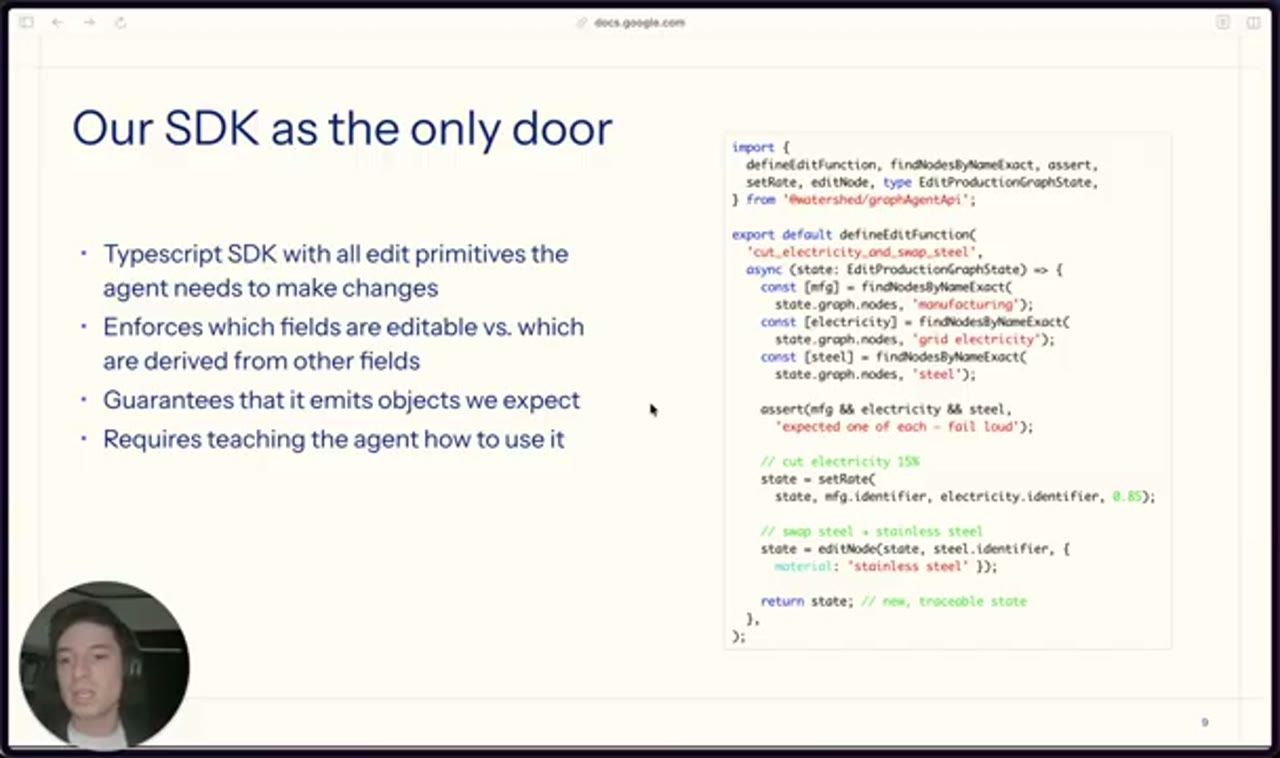
Thứ nhóm đưa cho agent là một TypeScript SDK chứa mọi edit primitive agent cần để thay đổi graph, cũng như để khám phá và tương tác với các graph object. SDK này làm mấy việc:
- Quy định field nào được edit và field nào là derived (được suy ra từ field khác). Nhờ vậy agent không thể tự tạo ra xung đột với chính nó, kiểu chỉ edit đúng thứ đích nó quan tâm mà quên edit thứ tạo ra thứ đích đó.
- Bảo đảm agent emit đúng những object nhóm mong đợi, để output có thể được dùng theo cách deterministic.
Tất nhiên, cách này đòi hỏi phải dạy agent cách dùng SDK. Nhưng đó cũng chính là pattern quen thuộc khi dạy một agent viết code trong codebase của bạn: bạn giải thích nó hoạt động thế nào, viết prompt và mọi thứ tương tự. Agent cũng có toàn quyền truy cập docs và code nằm dưới SDK nếu nó thật sự cần đọc.
Ví dụ trên slide trình bày vài mảnh của SDK. Đầu tiên là import từ API của nhóm. Agent phải định nghĩa một edit function cấp cao nhất với một cái tên rõ ràng. Sau đó nó dùng findNodesByNameExact để tìm những node cụ thể trong graph. Nó có thể viết các assertion mà nhóm cung cấp để code fail sớm. Cuối cùng, nó dùng các hàm mutator cụ thể như setRate và editNode để tương tác với graph theo cách tạo ra đúng những typed object mà nhóm cần.
import {
  defineEditFunction, findNodesByNameExact, assert,
  setRate, editNode, type EditProductionGraphState,
} from '@watershed/graphAgentApi';

export default defineEditFunction(
  'cut_electricity_and_swap_steel',
  async (state: EditProductionGraphState) => {
    const [mfg] = findNodesByNameExact(
      state.graph.nodes, 'manufacturing');
    const [electricity] = findNodesByNameExact(
      state.graph.nodes, 'grid electricity');
    const [steel] = findNodesByNameExact(
      state.graph.nodes, 'steel');

    assert(mfg && electricity && steel,
      'expected one of each - fail loud');

    // cut electricity 15%
    state = setRate(
      state, mfg.identifier, electricity.identifier, 0.85);

    // swap steel → stainless steel
    state = editNode(state, steel.identifier, {
      material: 'stainless steel' });

    return state; // new, traceable state
  },
);
Đoạn code đọc khá dễ: tìm ba node "manufacturing", "grid electricity" và "steel"; assert rằng tìm được đủ cả ba, nếu không thì "fail loud"; giảm lượng điện lưới cấp cho bước manufacturing còn 85% (cắt 15%); đổi vật liệu thép thành thép không gỉ; và trả về một state mới, truy vết được.
10. Deterministic execution: script run-executor
Đó là SDK. Nhưng sự bảo đảm thật sự nằm ở chỗ nhóm sở hữu deterministic execution. Ngay cả khi typed SDK là lối vào, nó cũng chỉ dẫn dắt agent hướng tới trạng thái cuối mong muốn. Bảo đảm thật đến từ script cuối cùng mà nhóm điều phối khi agent hoàn thành.
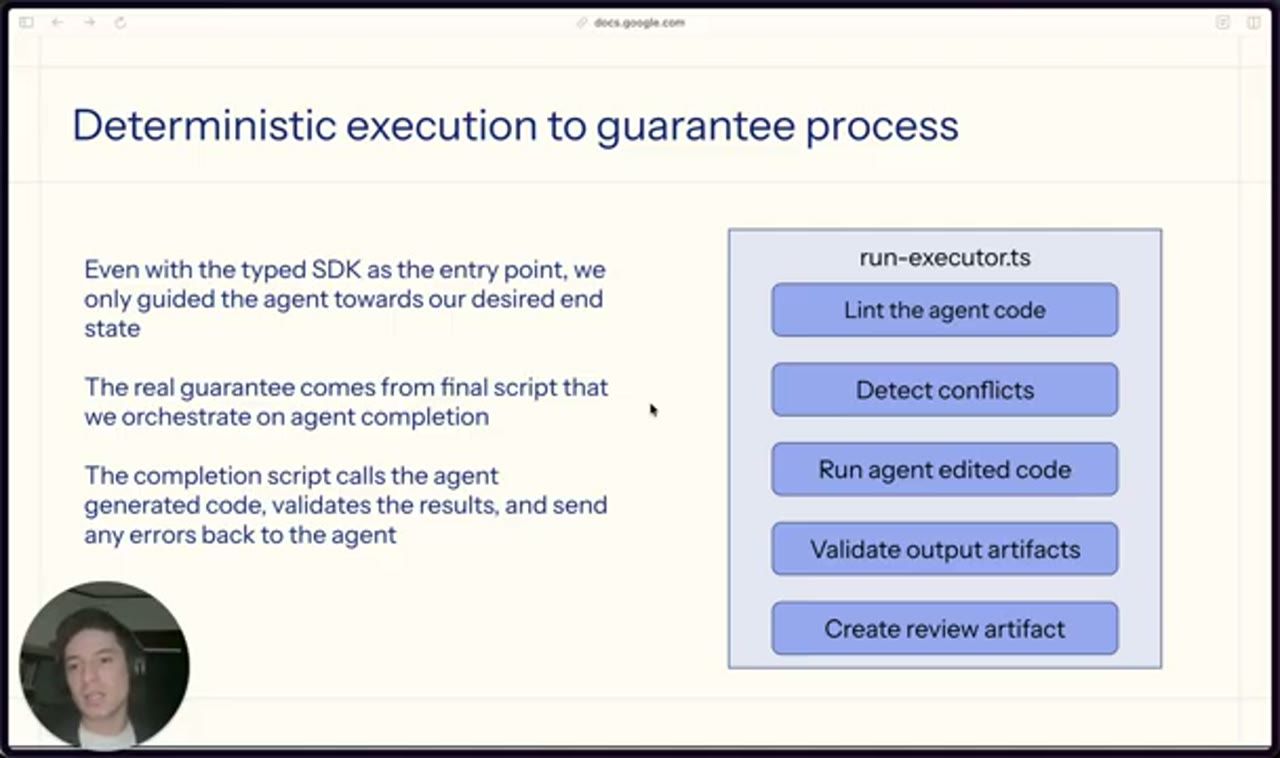
run-executor.ts: Lint the agent code, Detect conflicts, Run agent edited code, Validate output artifacts, Create review artifact.Script run-executor này được gọi khi agent đã chạy xong, và nhóm cho rằng mọi thứ đang ở trạng thái gần như hoàn tất, hay sẵn sàng để hoàn tất. Script làm lần lượt:
- Lint code của agent. Nếu có gì sai, gửi ngay lại cho agent. Fail sớm thì tốt hơn fail muộn.
- Phát hiện xung đột (detect conflicts). Đây là trường hợp agent, ở một phần của code, đã edit một thứ, rồi ở phần khác lại edit đúng thứ đó, hoặc một thứ phụ thuộc vào thứ đầu tiên, mà không nhận ra. Vì nhóm có những bảo đảm nhờ đưa cho agent một cấu trúc rõ ràng, họ có thể phát hiện các xung đột này thay cho agent và gửi ngược lại.
- Chạy code agent đã viết, nhờ đó có thể validate các output artifact. Tất nhiên, nếu bản thân code chạy fail, lỗi đó cũng được gửi về cho agent.
- Validate output artifact.
- Tạo review artifact: khi đã có output artifact đã được validate, nhóm tạo một review artifact có cấu trúc tốt, giúp review dễ dàng những gì agent đã làm mà không bao giờ phải đọc code bên dưới.
11. Review artifact: xem agent làm gì mà không cần đọc code
Để cho thấy review artifact trông như thế nào, Andrew đưa ra một đoạn trích từ một emissions report, trong đó graph edit function impact analysis đã chạy trên 50 graph. Có 2 function được áp dụng, tạo ra 749 edit action, và trong trường hợp này, tổng lượng phát thải giảm 45,6%.
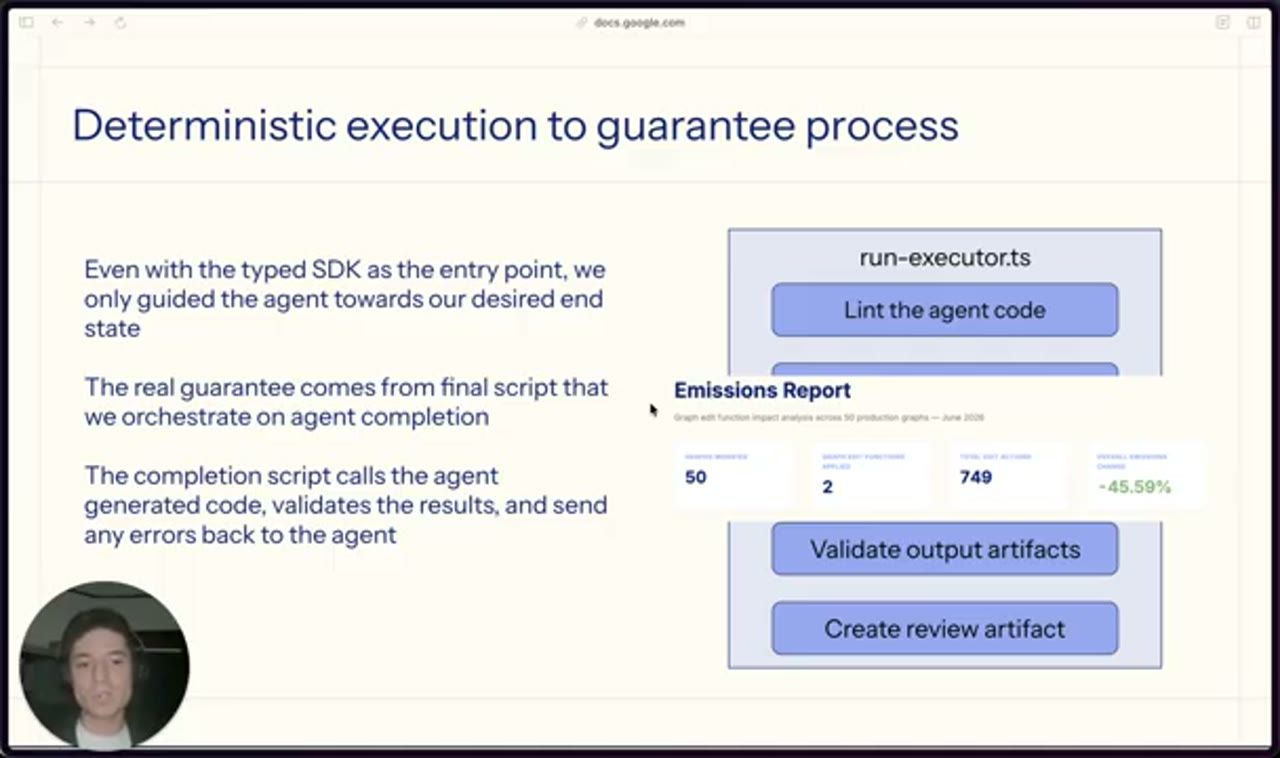
Người đọc report có thể đi sâu hơn: có hai edit ở đây, một cái làm một phần lớn thay đổi, cái còn lại chỉ tạo ra thay đổi rất nhỏ. Có thể bạn sẽ muốn xem từng cái thật ra đã làm gì.
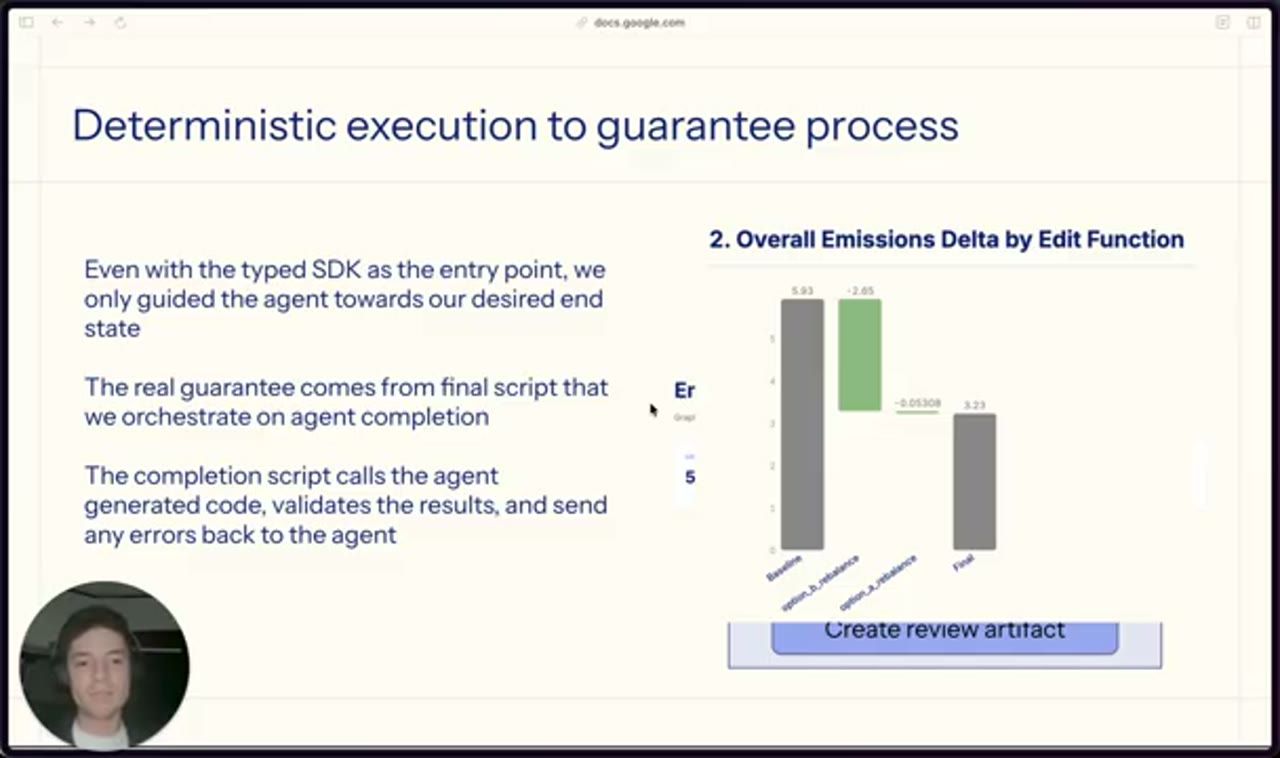
Bạn còn có thể đi xuống cấp từng graph và hỏi: "Với graph này, option một là gì, và nó đã edit những node nào trong graph?" để hiểu điều gì thật sự đã xảy ra bên dưới.
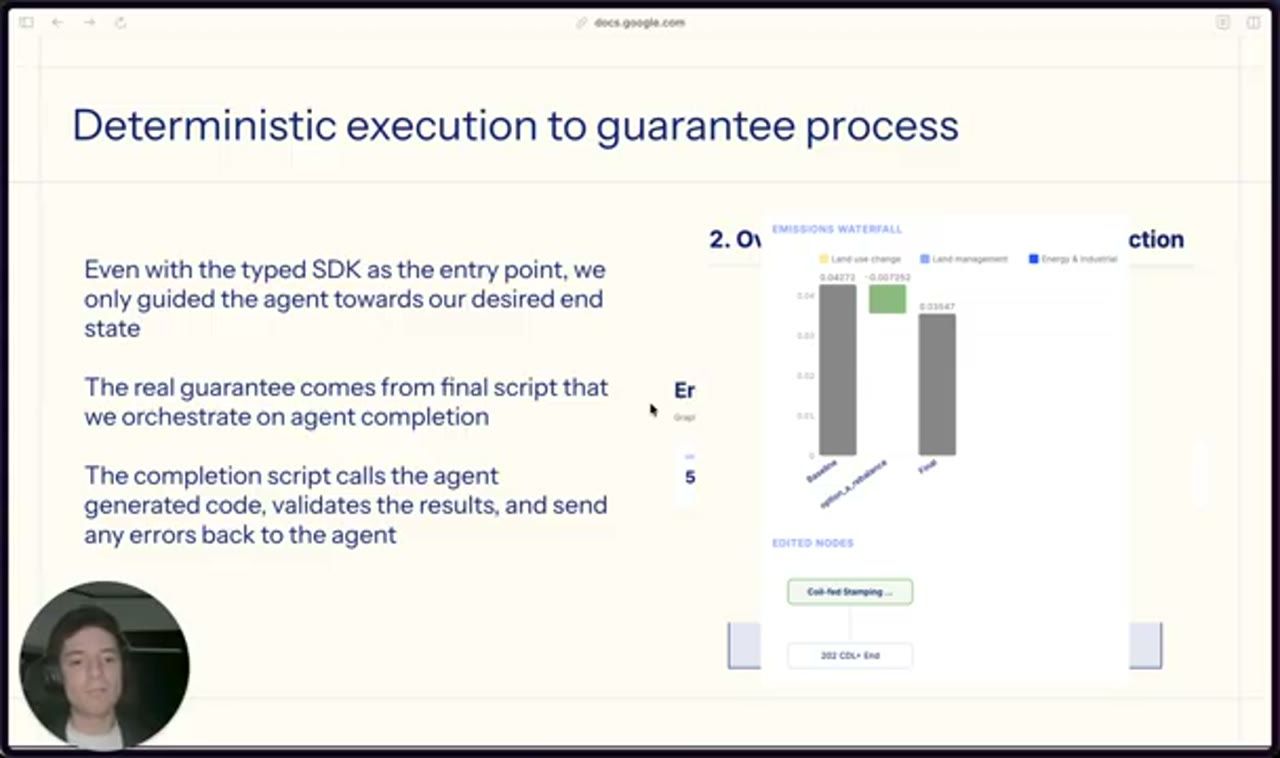
Tất cả những điều này người dùng đều thấy được mà không phải đọc đoạn code cấp thấp nào.
12. Quay lại ba vấn đề ban đầu
Giờ đây harness có hai khái niệm lớn: typed SDK và deterministic execution. Andrew quay lại ba vấn đề đã nêu ở đầu.
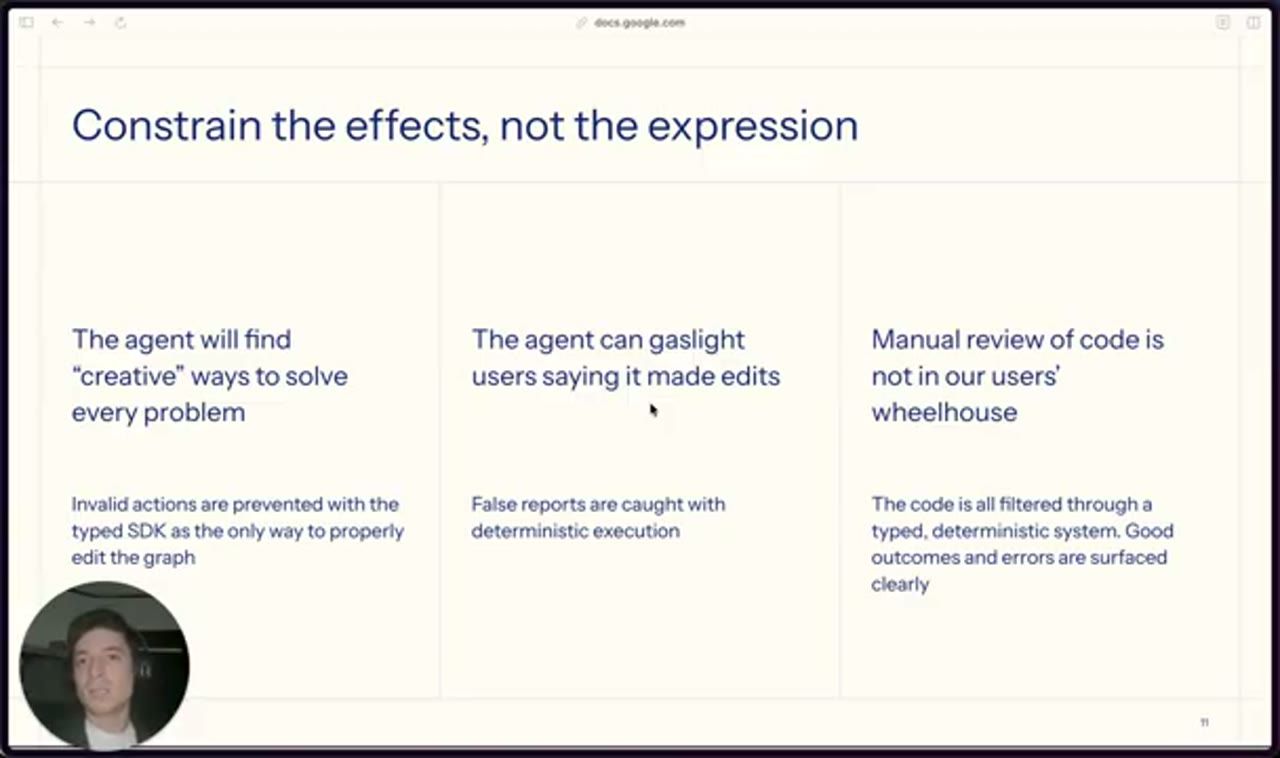
Agent tìm ra cách "sáng tạo" để giải mọi bài toán: giờ điều này là một điểm mạnh, nhưng đã được giới hạn một chút. Những hành động không hợp lệ mà agent có thể làm trên đường giải bài toán được giao giờ bị chặn, vì typed SDK là cách duy nhất để edit graph đúng cách. Và nhóm bảo đảm được rằng graph chỉ bị edit qua SDK, nhờ sở hữu deterministic execution và việc validate đoạn code đã viết.
Agent nói đã edit trong khi edit không diễn ra như agent hay người dùng kỳ vọng: những báo cáo sai này bị bắt bởi deterministic execution, để nhóm có thể đưa chúng ngược lại cho agent, bảo đảm agent thật sự làm điều nó tuyên bố.
Người dùng không đọc được code: giờ họ không bao giờ phải nhìn vào code, vì hệ thống deterministic execution tạo ra artifact ở dạng định sẵn, và nhóm có thể xây verification trên những artifact đó để bắt cả kết quả tốt lẫn lỗi. Các lỗi giờ hiện ra rõ ràng cho cả người dùng lẫn AI. Vì thế, ngay cả khi agent chưa đưa ra đúng đáp án, hay chưa đúng đáp án người dùng mong đợi, vẫn dễ dàng lần theo logic của nó, đi tới đáp án cần thiết, và vòng lại để tự sửa.
13. Hill climbing từ 43% lên 92%
Harness rất tốt vì nó thêm ràng buộc. Nhưng Andrew muốn nhấn mạnh rằng ngay cả với những bảo đảm tuyệt vời đó, bạn vẫn phải hill climb để agent giỏi hơn ở chính task đó.
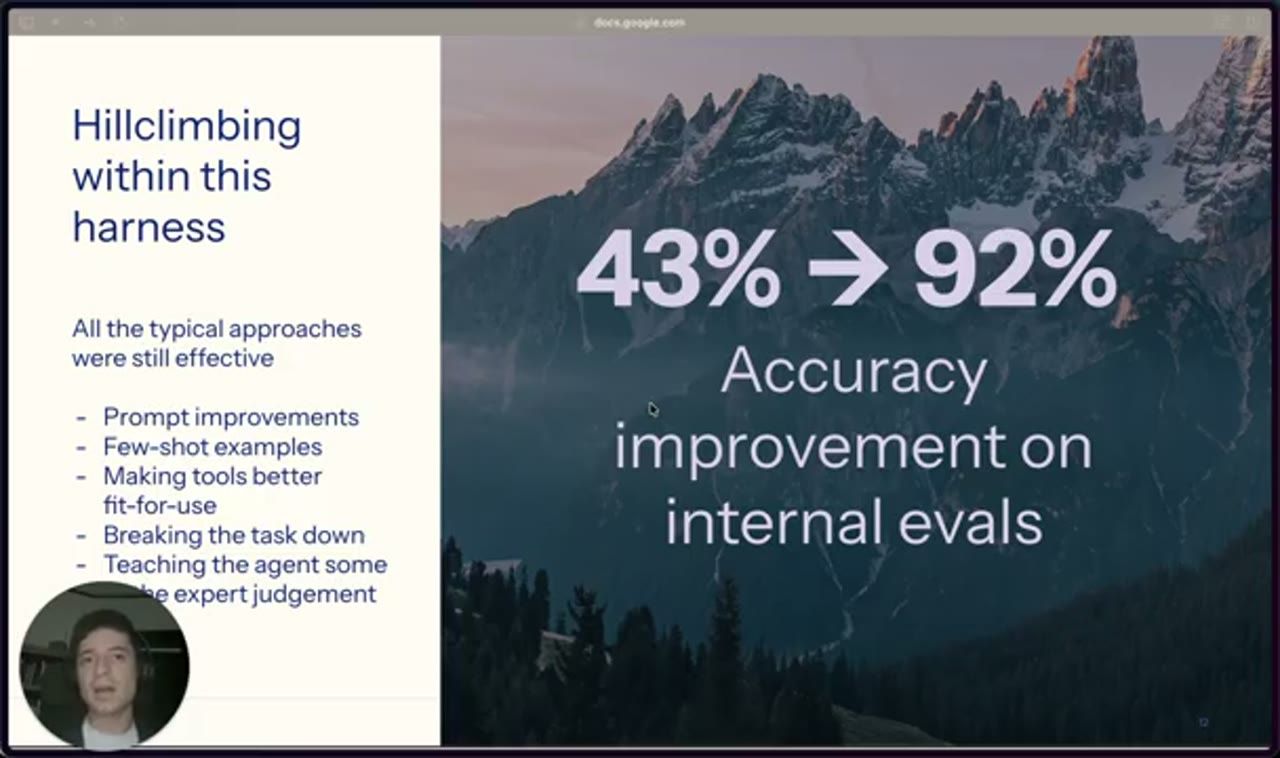
Từ khi nhóm bắt đầu đo agent làm những complex edit tốt tới đâu, với mỗi task trong eval set là một tập graph cộng một mục tiêu, họ đã nâng kết quả từ khoảng 43% lên 92% trên bộ eval nội bộ. Để làm được, mọi cách tiếp cận quen thuộc vẫn có hiệu quả:
- Cải thiện prompt: rất nhiều, gồm viết lại system prompt và tất cả các skill mà agent có quyền dùng.
- Few-shot example: để vừa dạy vừa hướng dẫn agent cách dùng SDK và làm việc với các loại task khác nhau mà nhóm dự kiến.
- Làm tool tốt hơn, fit-for-use: cải thiện bản thân SDK và các tool agent dùng, về ergonomics và mức độ hiển nhiên khi agent sử dụng.
- Chia nhỏ task: tách bài toán tổng thể thành vòng lặp plan và execute tiêu chuẩn.
- Dạy agent một phần expert judgment vốn đặc thù trong lĩnh vực, giúp agent dễ thao tác với nó hơn và biết cách khơi gợi (elicit) expert judgment từ chính người dùng.
Nhưng điều quan trọng ở đây là: dù độ chính xác đã tăng, điều rất tuyệt và có nghĩa là agent làm tốt hơn ngay từ lần đầu người dùng đi qua toàn bộ workflow và task, thì ngay cả khi agent mắc lỗi, hay ngay cả khi ground truth của nhóm cũng chỉ là một điểm trong cả khoảng phán đoán chuyên gia có thể có, họ vẫn có thể bảo đảm và validate chính process.
14. Tổng kết: harness nên làm ba việc
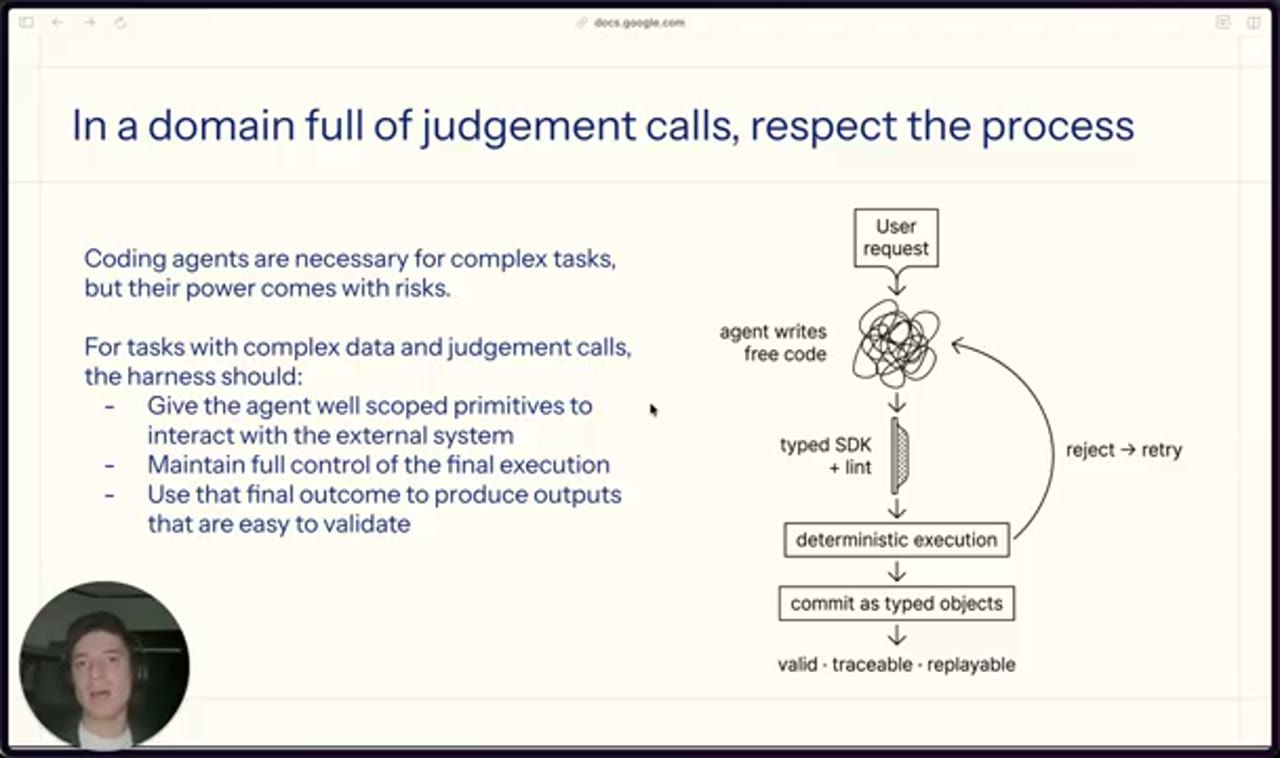
Gộp tất cả lại: trong một lĩnh vực đầy expert judgment, bạn phải tôn trọng cả process, và để làm được, bạn thật sự cần những bảo đảm về process. Ai cũng biết coding agent là cần thiết cho các task phức tạp, và chúng sẽ tiếp tục cần thiết và cực kỳ hữu ích. Nhưng sức mạnh đó đi kèm rất nhiều rủi ro, và tốt nhất là bước vào với đôi mắt tỉnh táo.
Với các task có dữ liệu phức tạp và nhiều judgment call, nhóm giờ cho rằng harness nên làm vài việc quan trọng:
- Đưa cho agent những primitive có phạm vi rõ ràng (well-scoped) để tương tác với hệ thống bên ngoài mà nó thật sự phải làm việc cùng. Code chạy tự do có thể dẫn tới đủ thứ chuyện đã kể ở trên. Cách này cho người xây hệ thống quyền cho phép hoặc chặn những việc cụ thể, và khai thác toàn bộ sức mạnh của coding agent mà vẫn tin được process chúng đang chạy bên trong.
- Giữ toàn quyền kiểm soát bước execution cuối cùng. Những agent rất thông minh này có thể tuyên bố chiến thắng theo một cách khác hẳn điều bạn hay người dùng của bạn thật sự muốn. Vì vậy, điều quan trọng là có thể ràng buộc và validate rằng agent thật sự đã làm điều nó nói đã làm.
- Dùng kết quả cuối cùng deterministic đó để tạo ra output dễ validate, kể cả với người không biết code. Code suy cho cùng chỉ là phương tiện để đạt mục đích.
Và tất nhiên, context engineering và prompt engineering tiêu chuẩn vẫn sẽ cực kỳ quan trọng để khoanh vùng và định nghĩa task tốt hơn, làm rõ agent cần làm gì.
Andrew kết thúc: một lần nữa, anh là Andrew Dumit ở Watershed, the sustainability AI platform, và cảm ơn mọi người đã dành thời gian và sự chú ý.
Sources and links
- Trang talk chính thức trên ai.engineer
- Video gốc của talk
- Watershed, the sustainability AI platform
- ReAct: Synergizing Reasoning and Acting in Language Models (Yao et al.)
- The Open Proof Corpus: A Large-Scale Study of LLM-Generated Mathematical Proofs (Dekoninck, Petrov et al.)
- ImpossibleBench: Measuring LLMs' Propensity of Exploiting Test Cases (Zhong, Raghunathan, Carlini)
- Erdős Problems (Thomas Bloom)
- Beyond Correctness (Zheng et al., 2025) và Reward Hacking Bench (Thaman, 2026), hai nghiên cứu được trích trên slide
- Claude Code
Related talks
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.
Agents Building Agents
Alfonso Graziano · Nearform · 30 min
Dùng coding agent để tự cải thiện AI agent: vòng lặp hypothesis trên Golden dataset (18% lên 83%) và phân tích trace có feedback từ user thật.
HTML is All You Need (for Agents to Make Graphics)
Amol Kapoor · Nori Agentic · 7 min
Vì sao agent vẽ dở trên canvas và SVG nhưng làm slide, docs, cả video rất tốt khi viết bằng HTML: đổi medium, đừng đổi model.