Structuring the Unstructured: Advanced Document Parsing for AI Workflows
AI Engineer World's Fair 2026: Online Track · Video gốc
Biến PDF, bảng, hình ảnh thành Markdown/JSON cho RAG và agent bằng Docling: chạy local trên CPU, chunkless RAG, Docling Serve và MCP server.
1. Context là thứ quan trọng nhất, nhưng phần lớn dữ liệu lại unstructured
Cedric Clyburn mở đầu bằng lời chào và tự giới thiệu: anh là một open source engineer tại Red Hat. Anh đưa ra một nhận định mà theo anh ai cũng đồng ý: context là khía cạnh quan trọng nhất khi xây một ứng dụng AI hay một agent. Đó cũng là lý do các harness trở nên phổ biến như hiện nay, vì việc chính của harness là quản lý context của LLM.
Vấn đề là dù bạn dùng model nào hay agent nào, vẫn có rất nhiều dữ liệu mà chúng ta chưa dùng được đúng cách, vì nó nằm ở dạng unstructured. Anh kể một loạt: từ PDF tới bản trình chiếu, hợp đồng và tài liệu kỹ thuật, cả biên bản họp, tài liệu được scan, sơ đồ, bảng, hình ảnh và nhiều thứ khác nữa. Anh đùa rằng danh sách hơi dài, xin lỗi vì kể nhiều quá, nhưng chắc mọi người hiểu ý anh rồi. Tất cả chỗ dữ liệu đó cần được biến đổi thành một thứ mà LLM thật sự hiểu được.
Mục tiêu của buổi này, theo lời anh, là khi kết thúc bạn sẽ hiểu cách rút ra cấu trúc từ các tài liệu thô trong doanh nghiệp (raw enterprise documents), rồi dùng cấu trúc đó để cung cấp dữ liệu tốt hơn cho các hệ thống AI phía sau, như RAG và agent. Và anh bắt đầu luôn.
2. Unstructured data là context layer mới, và lịch trình của buổi hôm nay
Cedric nhắc tới Jensen của NVIDIA, người theo anh đã nói rất rõ trong bài keynote của mình rằng unstructured data đang trở thành một context layer mới cho AI. Nhưng thực tế ở nhiều team, và anh biết rõ điều này vì chính anh làm ở Red Hat, là PDF và dữ liệu nằm rải rác qua hàng chục hệ thống khác nhau. Nên hôm nay có rất nhiều thứ phải nói.
Có thể bạn đã biết, phần lớn dữ liệu trên thế giới là unstructured. Nên dù dùng model nào, nếu bạn làm việc với PDF và các định dạng unstructured khác thì mọi chuyện khá khó. Ngoài kia có giải pháp, nhưng chúng có thể là proprietary, hoặc buộc bạn phải gửi dữ liệu riêng tư của mình lên server của người khác. Và không chỉ có text: làm sao để biến tài liệu cùng các biểu đồ, bảng và hình ảnh của nó thành những định dạng mà LLM hiểu được, như Markdown hay JSON?
Anh hứa sẽ chỉ cho mọi người cách làm trong buổi hôm nay, bằng một công cụ open source thuộc Linux Foundation tên là Docling. Nội dung gồm extraction, parsing, chunking và nhiều thứ khác, kèm theo vài live demo để "vui một chút".
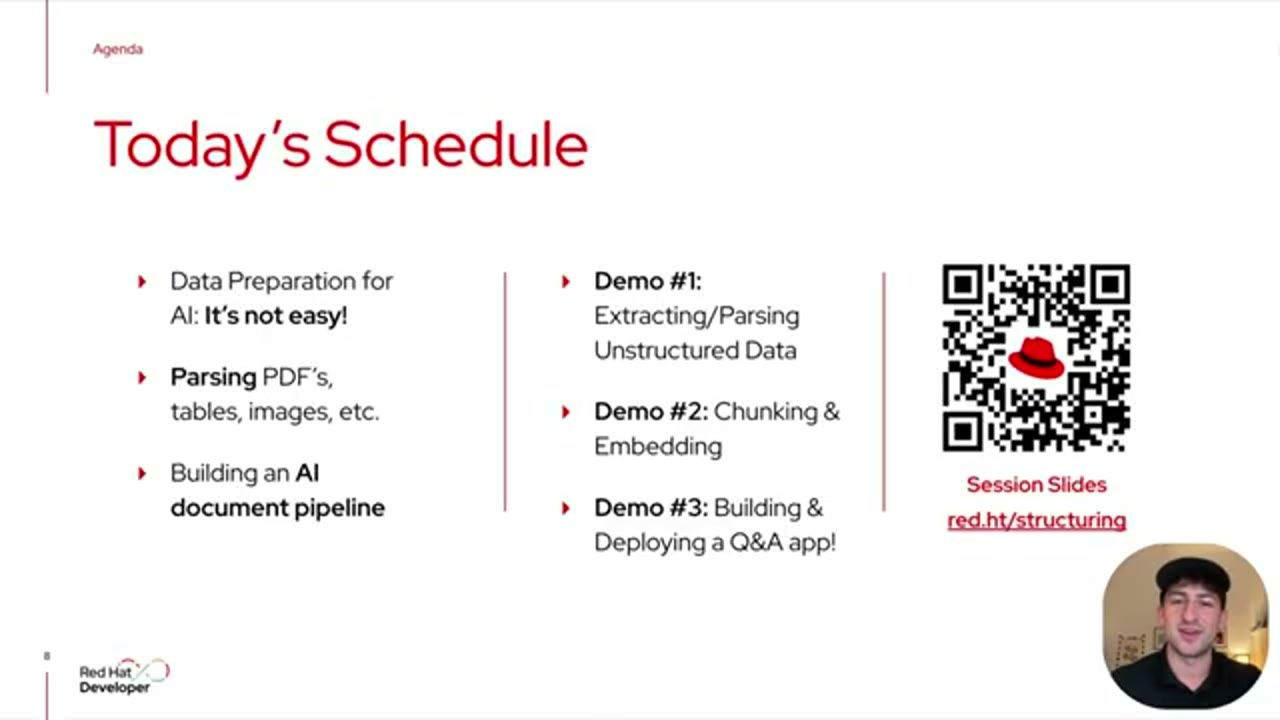
Cedric cũng chỉ ra rằng slide của buổi nói chuyện có ở phía bên phải, cùng một bản tóm tắt nhỏ các nội dung cụ thể anh sẽ trình bày. Rồi không chần chừ thêm nữa, anh vào phần chính.
3. Data là nguyên liệu chính của mọi ứng dụng AI
Câu hỏi đầu tiên: vì sao cần xử lý tài liệu nâng cao (advanced document processing)? Như anh đã nhắc qua, bạn có thể có rất nhiều tài liệu kỹ thuật, biên bản họp, hoặc nhiều loại tài liệu khác như hoá đơn, mà bạn cần dùng trong RAG hay những ứng dụng khác nơi context được đưa vào cho LLM.
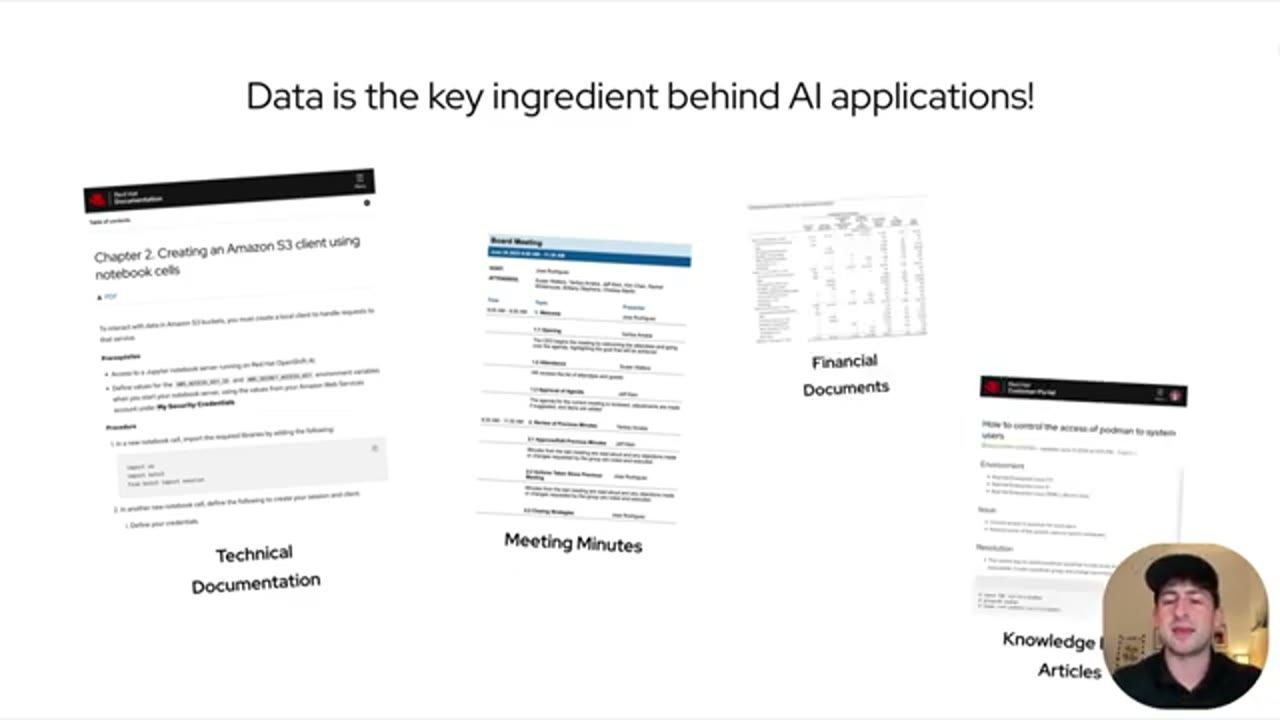
Dù đó là RAG, tức retrieval-augmented generation để trả lời câu hỏi dựa trên dữ liệu này, hay bạn dùng dữ liệu để fine-tune một model chuyên biệt mới, thì data vẫn là nguyên liệu chính đứng sau các ứng dụng đó. Bạn dùng tăng tốc phần cứng của NVIDIA hay không, dùng model open source hay proprietary cũng không quan trọng. Chính dữ liệu và cách bạn xử lý nó mới là yếu tố quyết định câu trả lời cuối cùng tới tay người dùng hay khách hàng là đúng hay sai. Và đó là điều quan trọng nhất.
4. Một chữ không có thật lọt vào hai mươi bài báo khoa học
Quan trọng tới mức nào? Cedric đưa ra một tweet đã viral trước đó: hai mươi bài báo khoa học hiện có chứa một thuật ngữ vô nghĩa, một thuật ngữ không hề tồn tại, chỉ vì AI đã hiểu sai một bài báo rất cũ được scan rồi chuyển thành PDF. AI đã ghép hai chữ nằm ở hai cột khác nhau của trang PDF đó thành một cụm từ mới.
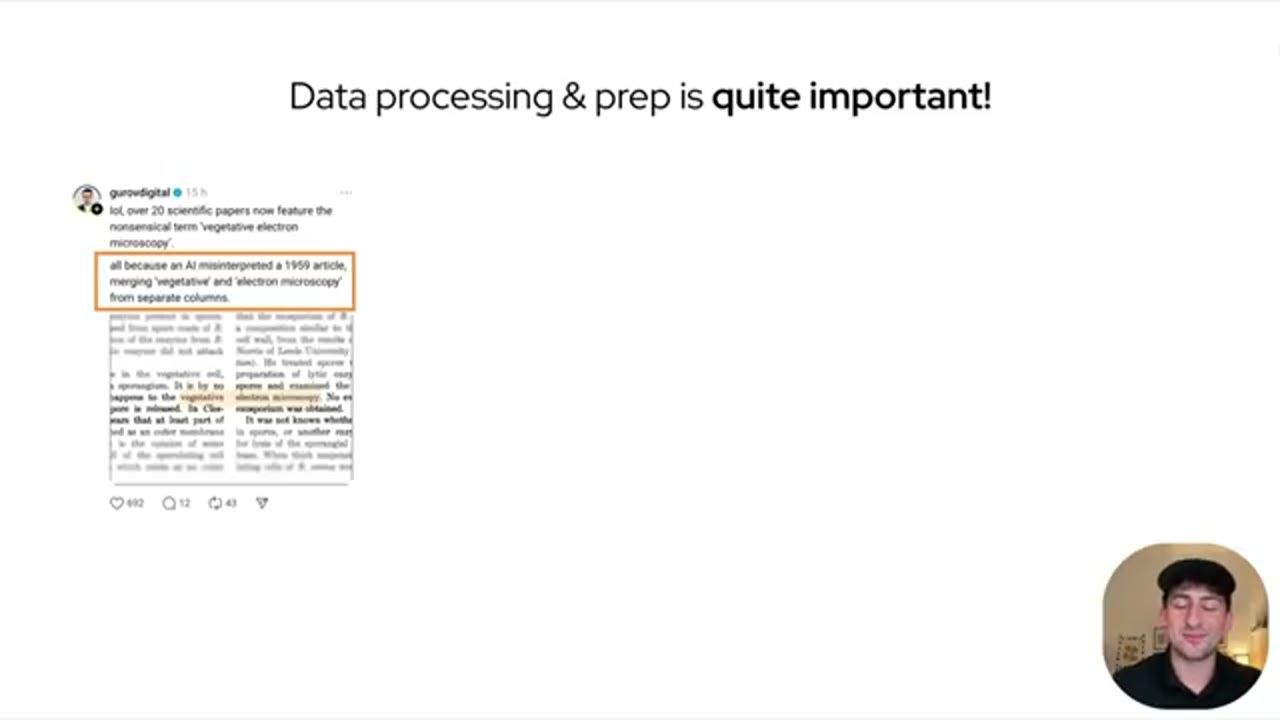
Vì các nhà nghiên cứu đang dùng những model này để hỗ trợ công việc, giờ đây có nhiều bài báo khoa học khác nhau chứa chữ đó, và chúng còn được người khác trích dẫn lại. Theo Cedric, ví dụ này cho thấy việc dữ liệu được xử lý chính xác, không bị hallucinate, đủ tin cậy để đưa vào ứng dụng giao cho người dùng và khách hàng, quan trọng tới mức nào.
Nếu dùng một công cụ như Docling chạy ngay trên máy mình, bạn sẽ thấy hai chữ này nằm khá xa nhau và lẽ ra không bao giờ bị ghép lại. Đó cũng là cách chúng ta sẽ học về việc trích xuất text, ngay sau đây.
5. Thử một PDF parser đơn giản
Giả sử ta thử một PDF parser đơn giản cho một trang PDF như thế này: trang có một cái bảng, một hình ảnh, có caption và các đoạn text thông thường. Kết quả có thể giống phần Markdown bên phải. Cách này có thể rất nhanh và rẻ, chạy được cả trên CPU.
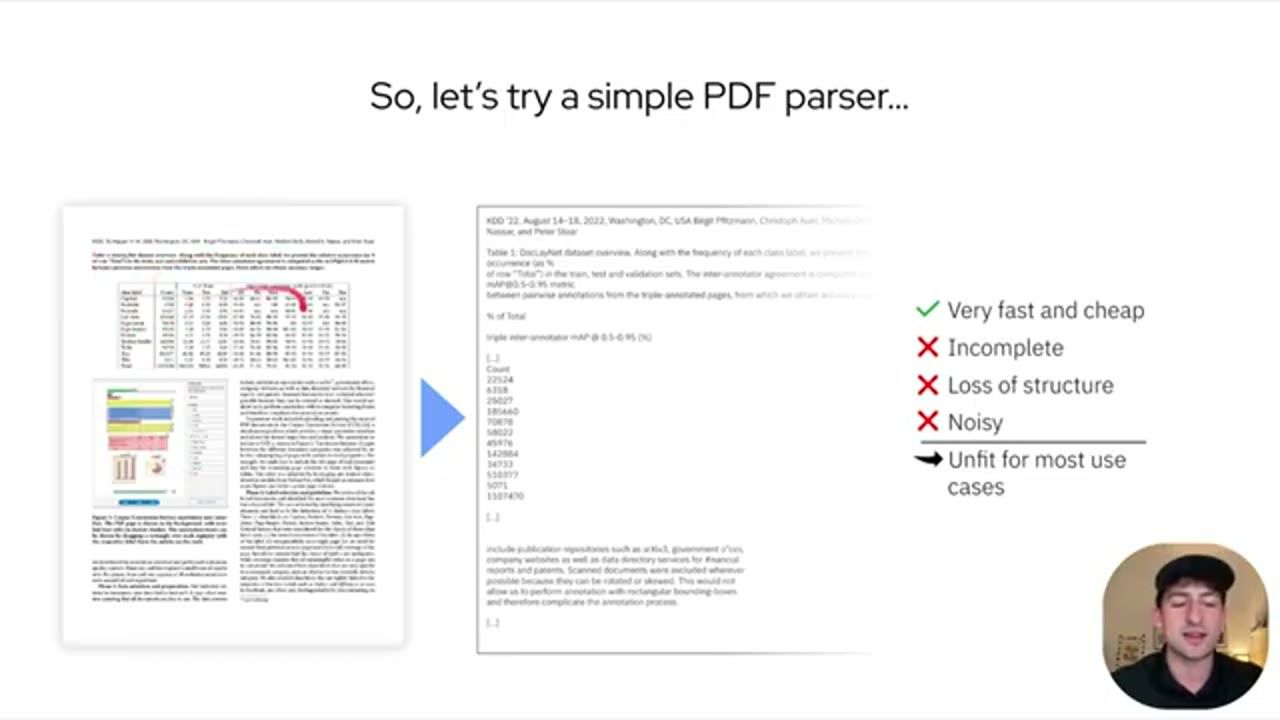
Vấn đề là rất nhiều đoạn text đã bị cắt cụt, bị gộp vào nhau, tới mức chính Cedric là người cũng không đọc ra được. Nếu gửi thứ này cho một model, anh không nghĩ mình có thể tin model rút được thông tin cụ thể từ, ví dụ, cái bảng kia, vì bảng đã bị "nhả" ra theo một dòng tuyến tính.
Thông tin kiểu này không phù hợp với phần lớn use case, khi bạn cần đặt câu hỏi hoặc muốn một agent thực hiện việc kiểm tra (validation) và trích xuất (extraction) trên dữ liệu nguồn. Nên cách này không ổn. Có những page header không mong muốn, ta không hiểu được cái bảng, và nội dung của hình ảnh ở đâu? Nó không hề có mặt.
6. Dùng frontier model: chất lượng khá, nhưng đắt và không nhất quán
Khi dùng frontier model, kết quả thì "cũng không tệ", nhưng khá đắt. Nếu bạn gửi tài liệu cho một model có giá khoảng ba mươi đô la cho mỗi triệu output token, bạn có thể thấy chi phí tăng nhanh thế nào khi scale lên hàng chục, hàng trăm, và trong nhiều trường hợp là hàng nghìn file PDF mà các tổ chức phải xử lý để dùng trong ứng dụng AI.
Thêm nữa, sự khác biệt giữa, chẳng hạn, bản 5.1 của một model vừa bị deprecate và bản 5.2 của model đó khiến việc có structured output nhất quán ở mọi lần chạy trở nên khó. Nên dù chất lượng có thể tốt, và anh thấy phần lớn Markdown xuất ra trông khá chính xác, chúng ta vẫn dễ gặp hallucination, vì model là non-deterministic, và điều này rất khó xử lý khi chạy ở quy mô lớn.
7. Con đường ở giữa: Docling
Vậy đâu là con đường ở giữa (middle ground)? Đó là chỗ Docling xuất hiện. Docling là một CLI và library nhanh, rẻ, và quan trọng nhất là chạy local. Bạn dùng nó để lấy nhiều loại nguồn đầu vào khác nhau và chuyển thành Markdown, JSON, và một kiểu dữ liệu Pydantic để dùng trong ứng dụng của mình. Và bạn có thể scale nó lên nếu có hàng nghìn file với nhiều định dạng khác nhau cần chuyển sang một thứ như Markdown.
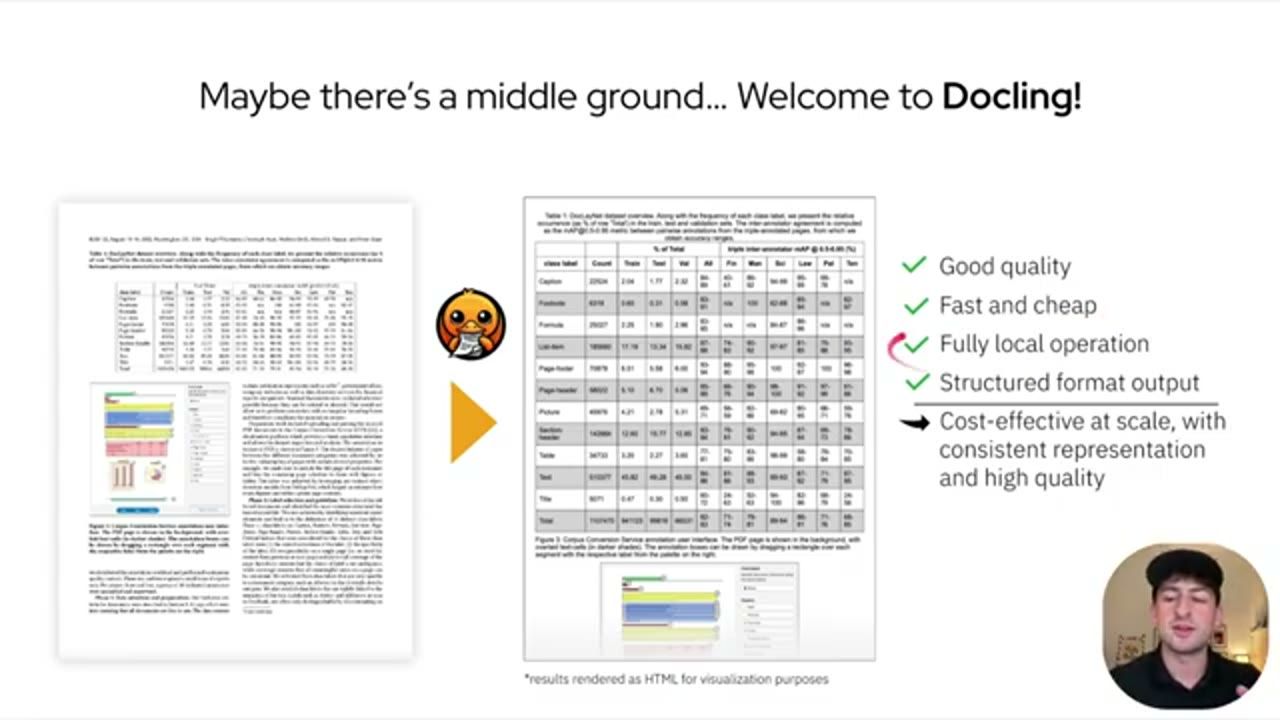
Trên slide, kết quả được render lại thành HTML, và bạn có thể thấy phần export của đúng cái bảng lúc nãy. Trong file PDF, kiểu dữ liệu này bị rải ra và là định dạng proprietary, nên rất khó trích xuất từ PDF gốc. Cedric sẽ chỉ cách Docling làm điều đó: kết hợp OCR với các vision model chuyên biệt để nhận diện định dạng, cho phép làm cả những việc như structured output, ví dụ khi bạn chỉ muốn lấy ra đúng một cột nào đó từ nguồn nội dung. Anh nói "nó thật sự rất hay".
Anh dùng Docling ở Red Hat, và team của anh cũng dùng, vì họ có hàng nghìn file PDF cần xử lý, chủ yếu là tài liệu sản phẩm (product documentation). Ngoài ra họ còn có nội dung như hình ảnh mà họ muốn trích xuất bằng vision model.
8. Chạy local, chạy offline, và bài toán scale với chi phí
Với một lệnh pip install docling, Docling cho phép bạn chuyển một tài liệu đơn lẻ, một website hay bất kỳ thứ gì khác thành Markdown hoặc định dạng bạn muốn, và vẫn làm việc được với layout của trang, nên bạn không đánh mất sự nhất quán và cấu trúc của tài liệu gốc. Docling còn có nhiều integration khác. Nó hợp với những tình huống bạn cần chạy local, không muốn trả tiền cho một dịch vụ, hoặc đang ở trong một môi trường air-gapped (không kết nối Internet). Tất cả đều làm được bằng dự án open source này, một dự án thuộc Linux Foundation (cụ thể là LF AI & Data).
Trước khi vào demo nhanh để giới thiệu dự án, Cedric muốn nói thêm về scale và chi phí, như anh vừa nhắc. Có một use case công khai từ Leandro ở Hugging Face. Leandro lấy một nguồn PDF từ Common Crawl, làm một ít bước xử lý trước, rồi dùng OCR và Docling để trích xuất cấu trúc, loại bỏ một số phần và làm sạch dữ liệu cho bộ FinePDFs. Đây là một kho token rất lớn lấy từ PDF trên khắp web mà bạn có thể dùng để train model và nhiều việc khác (theo trang dataset, FinePDFs có khoảng 3 nghìn tỷ token từ 475 triệu tài liệu).
Leandro so sánh hai cách: dùng GPU và dùng CPU cho Docling. Kết quả là anh tiết kiệm được chi phí gấp năm mươi lần so với cách naive là đưa mọi thứ qua VLM và OCR. Điều thú vị nhất, theo Cedric, là bạn thật sự có thể scale việc này lên, và Leandro làm trên CPU, không cần GPU.
9. Không chỉ convert: mô tả ảnh và structured output
Và Docling không chỉ là chuyển đổi tài liệu. Ví dụ của Leandro là chuẩn bị dữ liệu từ PDF, nhưng giả sử ta có hình ảnh thì sao? Hình ảnh trong slide dưới đây đã được một vision language model mô tả và chú thích (annotate) ngay từ chính bức ảnh. Giờ ta có toàn bộ phần context rất quan trọng này để dùng, ví dụ, trong một ứng dụng RAG, nhưng cũng đơn giản là để người dùng cuối hiểu chuyện gì đang diễn ra trong bức ảnh.
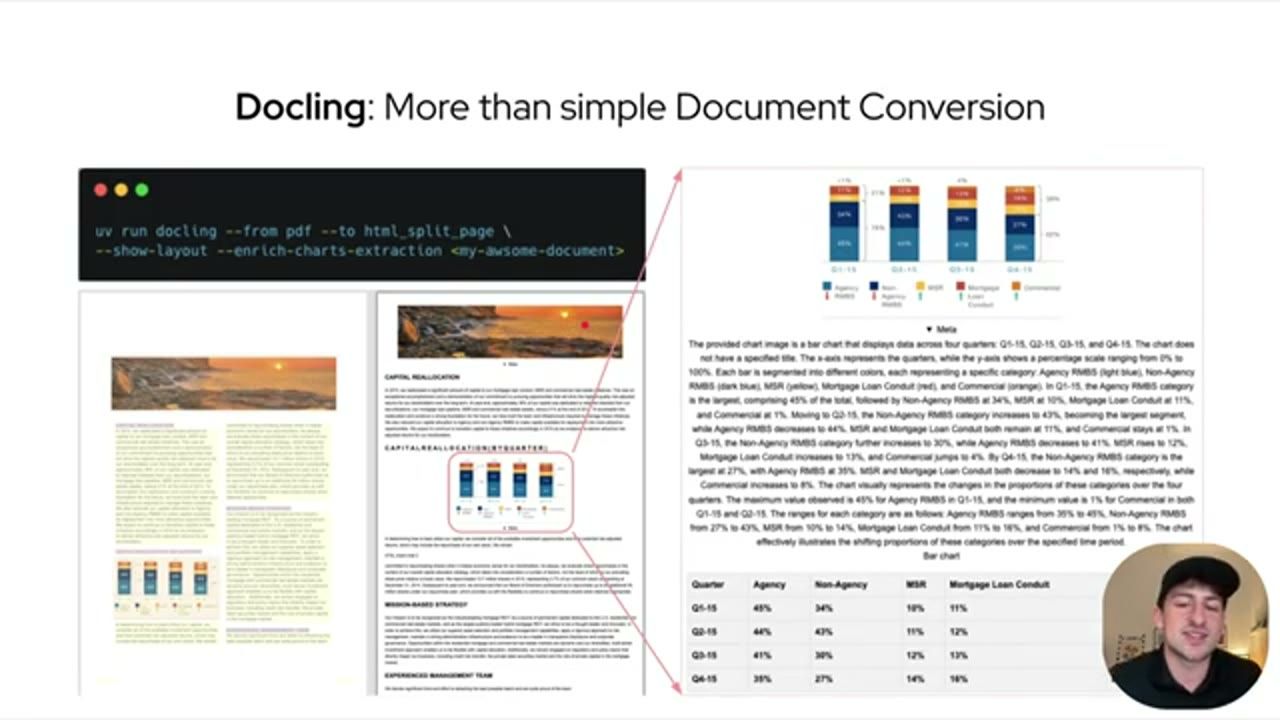
uv run docling --from pdf --to html_split_page \
--show-layout --enrich-charts-extraction <my-awsome-document>
Cedric đưa thêm một tình huống: giả sử người chuyên gia nghiệp vụ (SME) hiểu bức ảnh đó không còn làm ở tổ chức nữa. Giờ ta vẫn có cách hiểu bức ảnh đó là gì, nhờ một LLM, dù là proprietary hay chạy local.
Cuối cùng, Docling không chỉ chuyển đổi và chú thích tài liệu, mà còn hỗ trợ structured output. Ví dụ bạn có một hoá đơn và cần trích ra đúng số hoá đơn (bill number), tổng giá trị hoá đơn và tên người gửi. Docling lấy được những thứ đó ở một định dạng có cấu trúc, nên bạn không phải lo kiểu "nó sẽ kéo cả heading với title vào". Không, bạn chỉ muốn tổng giá trị hoá đơn và số hoá đơn thôi. Bạn có thể nhận kết quả dưới dạng Pydantic, và cách làm này cũng rất đơn giản khi bạn chỉ muốn lấy vài thông tin ra khỏi một tài liệu khổng lồ.
10. Demo 1: convert một PDF thành Markdown chỉ với vài dòng code
Giờ chuyển sang demo để Cedric cho thấy anh đang nói về điều gì. Các demo hôm nay dùng repo Docling workshop, mọi người có thể vào xem.
Trong ví dụ đầu tiên, anh dùng Docling để chuyển một loại file phổ biến là PDF. Lý do: data là nền móng của mọi hệ thống AI, và để tận dụng được data, ta phải ingest chính xác nhiều định dạng file khác nhau. Không làm được điều đó thì ta có thể mất thông tin, hoặc thông tin trong bảng, sơ đồ và hình ảnh trở nên không đọc được.
Với Docling, chỉ cần một lệnh pip install ở phía dưới notebook là bắt đầu xử lý được các loại file này. Trước tiên, anh import các thành phần thiết yếu như document converter cùng vài dependency khác. Rồi anh chỉ cách đơn giản nhất: bắt đầu với một file PDF có sẵn trên mạng, chính là bài báo nghiên cứu của Docling. Trong file này có title và subtitle, có các thành phần như hình ảnh và caption, và ở cuối PDF còn có một cái bảng cần trích xuất, cùng những hình ảnh có thể hữu ích cho ứng dụng AI hay agent của bạn.
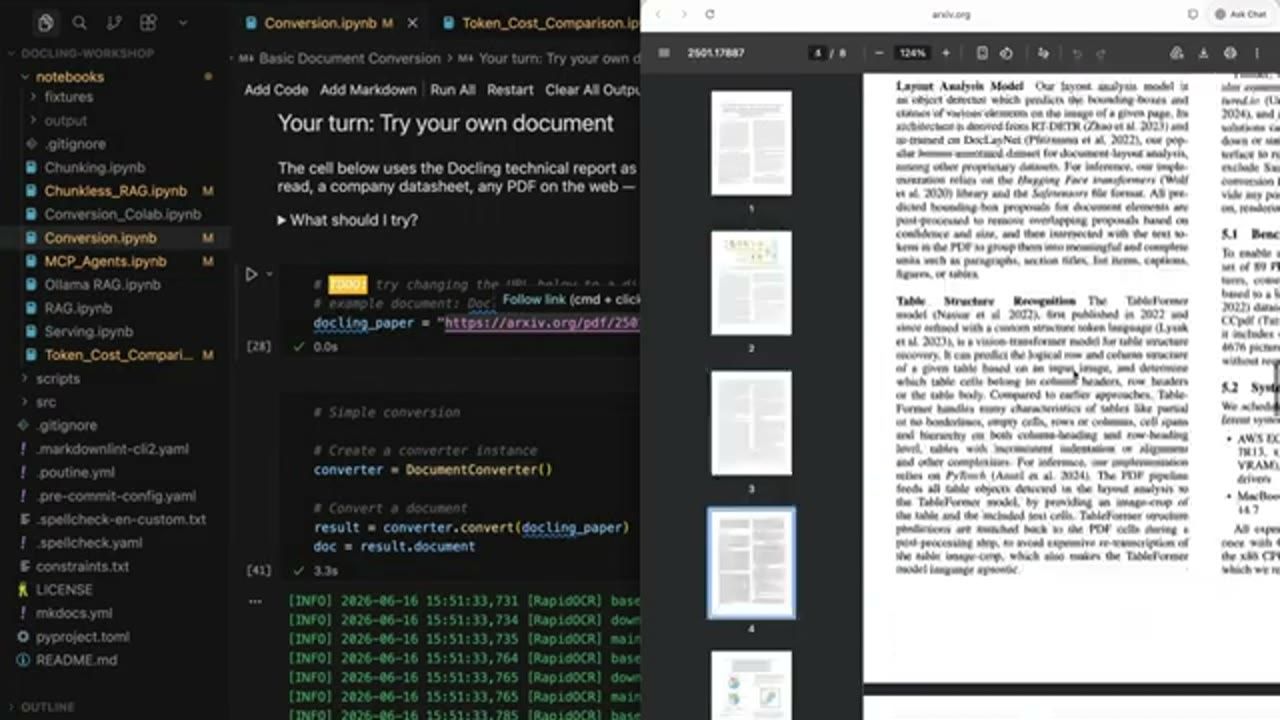
DocumentConverter rồi gọi convert trên bài báo Docling. Bên phải là chính bài báo đó trên arXiv, đang mở tới đoạn mô tả layout analysis model và TableFormer.# Simple conversion # Create a converter instance converter = DocumentConverter() # Convert a document result = converter.convert(docling_paper) doc = result.document
Quay lại notebook, anh chỉ cách làm phép chuyển đổi đơn giản này bằng document converter của Docling rồi export ra Markdown. Đây là một ví dụ sơ bộ cho thấy việc chuyển một PDF tám trang thành thứ LLM bắt đầu dùng được có thể nhanh tới mức nào. Nhưng đồng thời, kết quả cũng là một kiểu dữ liệu Pydantic. Nên bạn có thể khám phá file PDF này: số trang, số bảng, xem trang nào chứa gì, rồi export ra nhiều định dạng như Markdown, HTML, dictionary và nhiều hơn nữa.
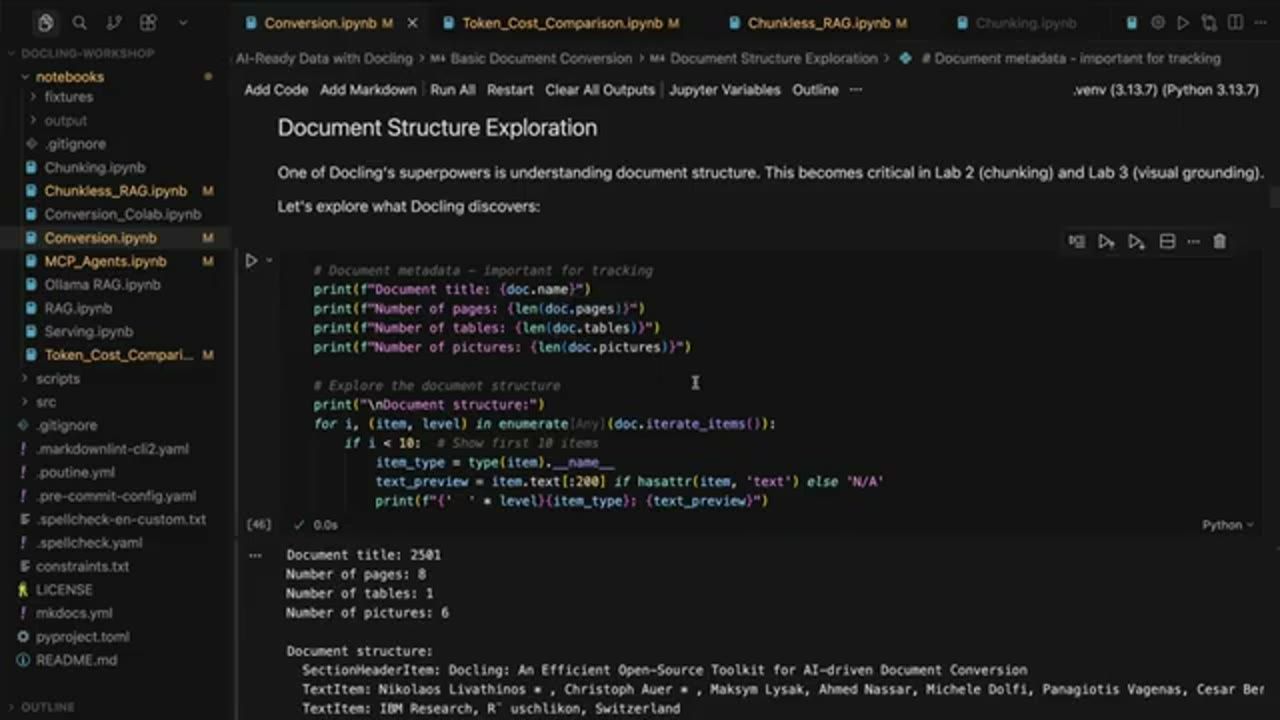
11. Bảng, hình ảnh và layout của tài liệu
Nhưng giá trị thật không chỉ nằm ở text cơ bản và các cột, mà ở việc làm việc với bảng. File PDF tiếp theo có nhiều bảng khác nhau cần trích xuất. Bằng cách chạy converter cho tài liệu này, ta trích được các bảng và export chúng thành data frame để render ngay trong Jupyter notebook. Khi Cedric chạy cell, notebook đã export được tám bảng khác nhau từ PDF gốc. Ta có thể liệt kê chúng, và cũng có chúng ở định dạng sẵn sàng để dùng trong một ứng dụng RAG, hoặc đơn giản là để hỏi LLM.
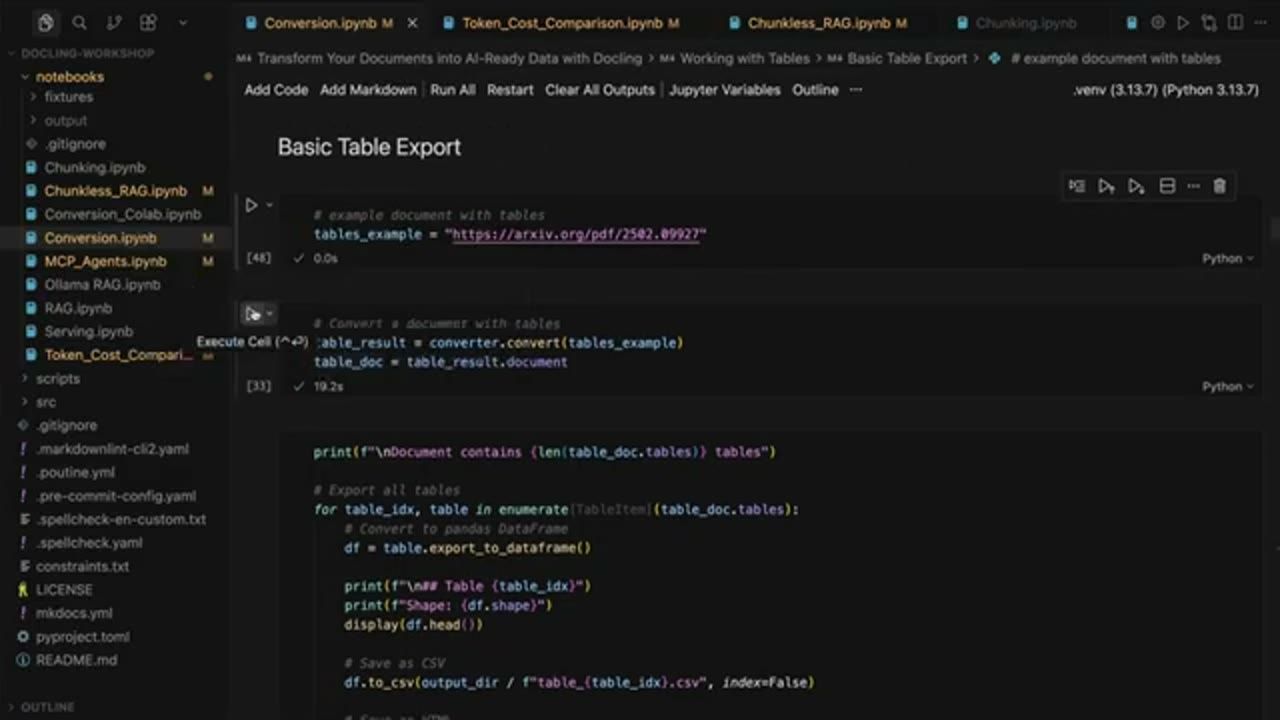
export_to_dataframe(), in kích thước, hiển thị vài dòng đầu và lưu ra file CSV.Vậy là đã thấy cách lấy text và bảng từ PDF. Còn việc hiển thị và trích xuất hình ảnh từ tài liệu gốc thì sao? Với ví dụ này, anh dựng một PDF pipeline cho phép phóng to (scale up) hình ảnh rồi đưa vào một document converter. Khi kiểm tra nội dung hình ảnh trong các cell, ta thấy mọi thứ được sắp xếp gọn gàng: có bức ảnh, tức hình gốc, có caption của nó, và toàn bộ các phần tử text nằm bên trong ảnh. Những thứ này có thể dùng trong một ứng dụng retrieval-augmented generation để hỏi kiểu "chuyện gì đang diễn ra trong các bức ảnh trong PDF gốc?".
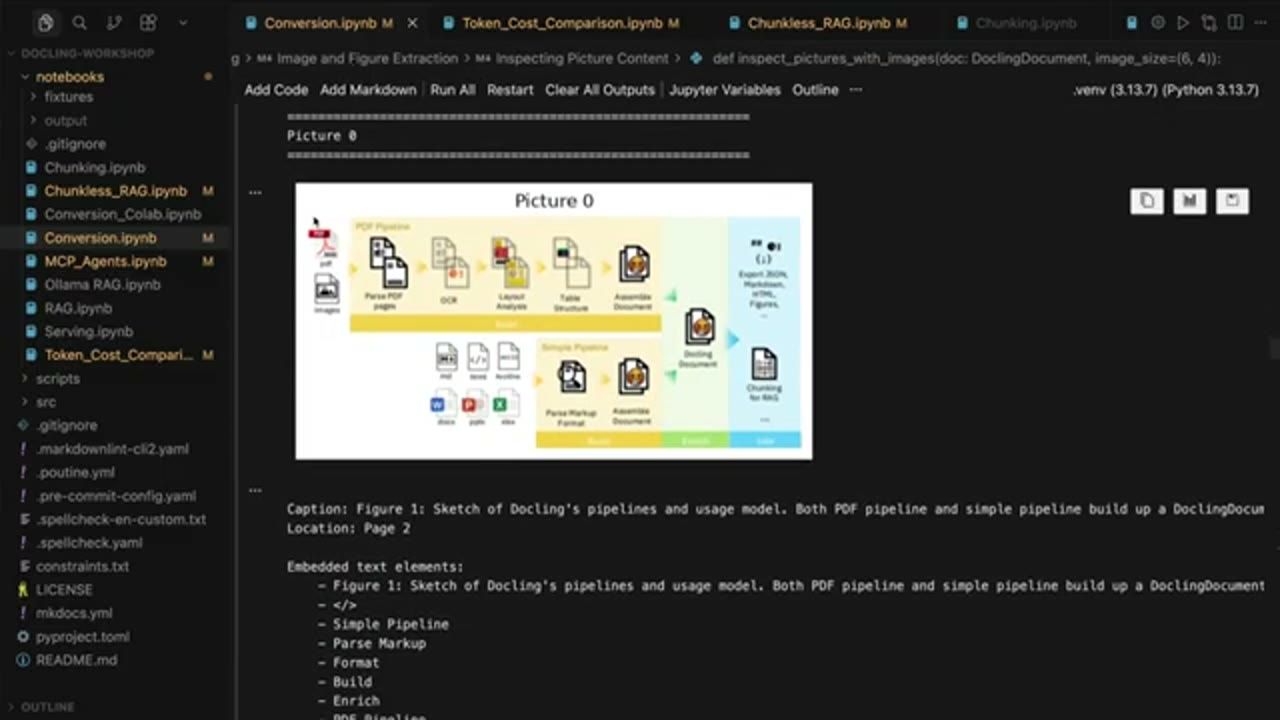
Cedric cho rằng sẽ hữu ích nếu hiển thị cả layout của tài liệu, bằng các bounding box mà layout visualizer cung cấp. Ở bước này, anh hiển thị mọi phần tử và thành phần có thể trích ra từ PDF gốc: section header, text, subtitle, hoặc những thành phần như bức ảnh vừa được kéo ra.
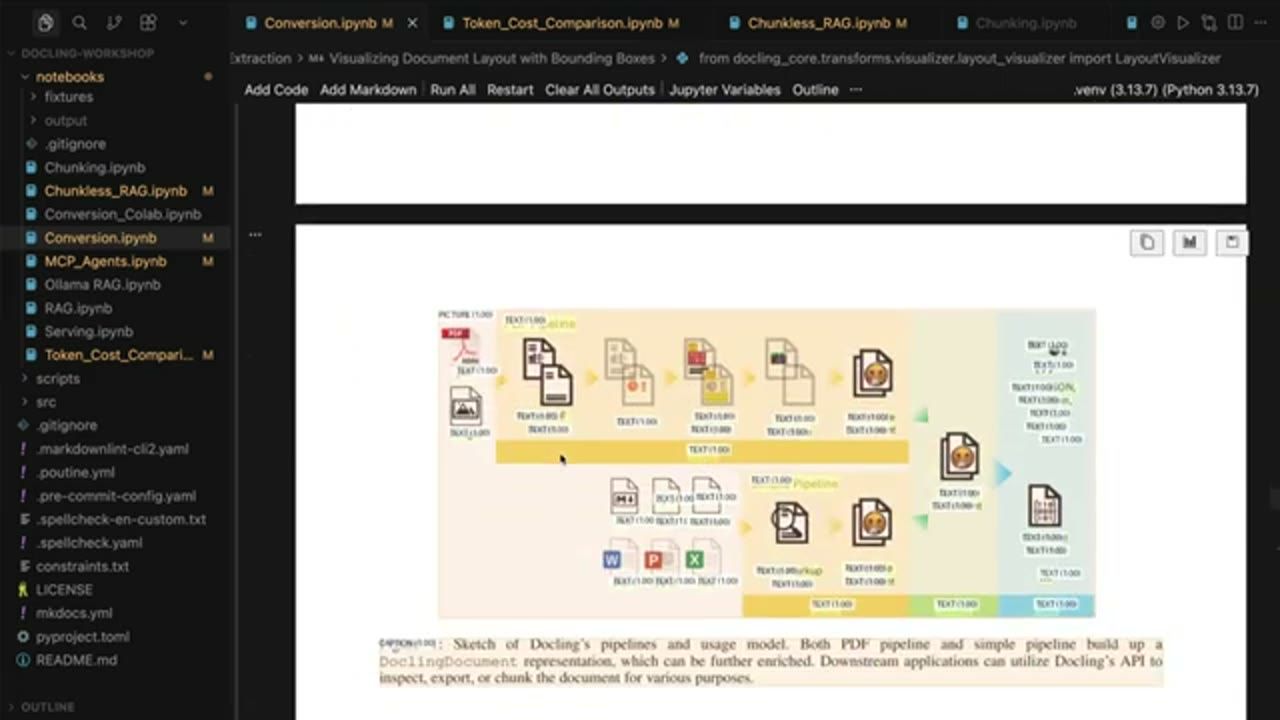
LayoutVisualizer vẽ khung quanh từng phần tử trên trang, từ hình sơ đồ, từng nhãn text bên trong hình, tới phần caption bên dưới.Đây là một trong các model mà Docling cung cấp. Theo Cedric, nó dùng được cả cho tình huống bạn có thông tin định danh cá nhân (PII) của khách hàng và muốn loại bỏ chúng khỏi tài liệu gốc trước khi đưa vào ứng dụng của mình.
12. Dùng vision language model để làm giàu hình ảnh
Ta cũng có thể dùng vision language model để làm giàu (enrich) các hình ảnh và sơ đồ trong những tài liệu này, bằng một thứ như Ollama hoặc một LLM của bên thứ ba. Ở đây, Cedric dựng một PDF pipeline dùng một model Granite chạy local, với prompt kiểu "hãy mô tả chi tiết những gì đang diễn ra trong bức ảnh này".
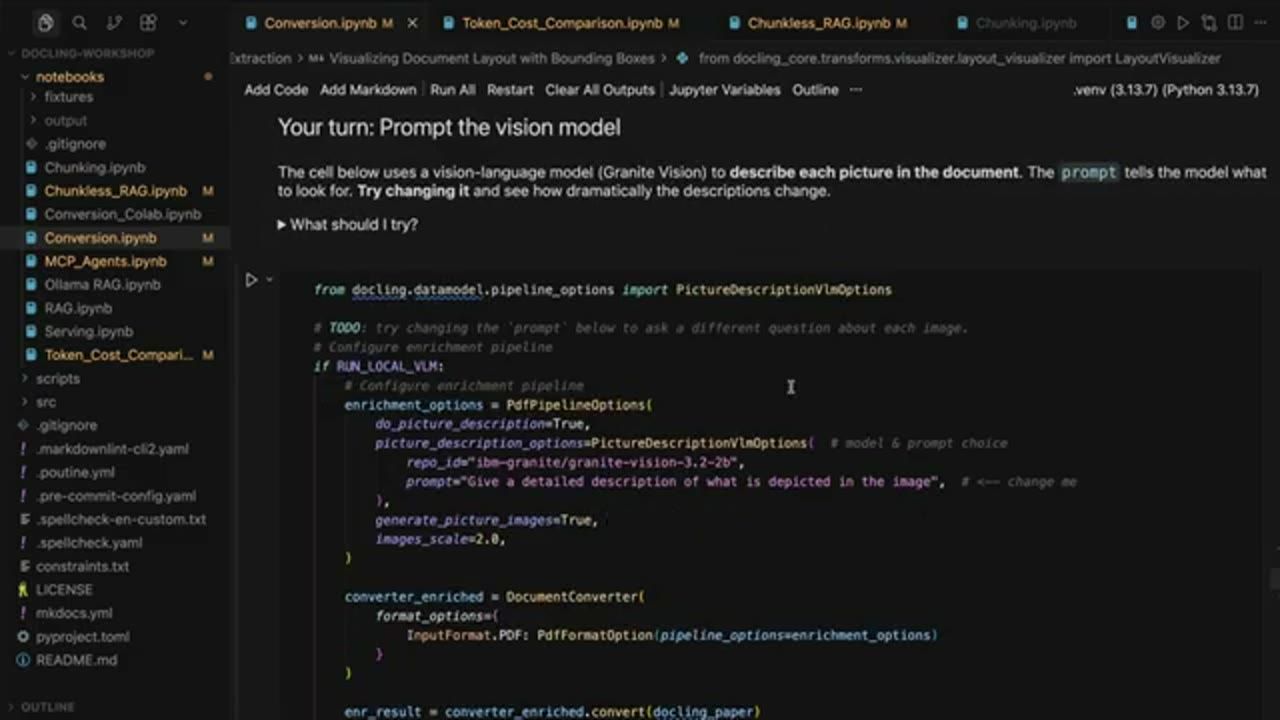
from docling.datamodel.pipeline_options import PictureDescriptionVlmOptions

# TODO: try changing the `prompt` below to ask a different question about each image.
# Configure enrichment pipeline
if RUN_LOCAL_VLM:
    # Configure enrichment pipeline
    enrichment_options = PdfPipelineOptions(
        do_picture_description=True,
        picture_description_options=PictureDescriptionVlmOptions(  # model & prompt choice
            repo_id="ibm-granite/granite-vision-3.2-2b",
            prompt="Give a detailed description of what is depicted in the image",  # <-- change me
        ),
        generate_picture_images=True,
        images_scale=2.0,
    )

    converter_enriched = DocumentConverter(
        format_options={
            InputFormat.PDF: PdfFormatOption(pipeline_options=enrichment_options)
        }
    )

    enr_result = converter_enriched.convert(docling_paper)
Với document converter đó, anh hiển thị tài liệu đã được làm giàu bằng cách gọi endpoint chuẩn OpenAI (completions) của Ollama đang chạy local trên máy. Kết quả là một caption có chú thích, mô tả những gì đang diễn ra trong bức ảnh sơ đồ pipeline của Docling mà ta xem lúc nãy. Trước đây ta chỉ lấy được caption gốc, giờ ta dùng được vision language model để mô tả nội dung của ảnh.
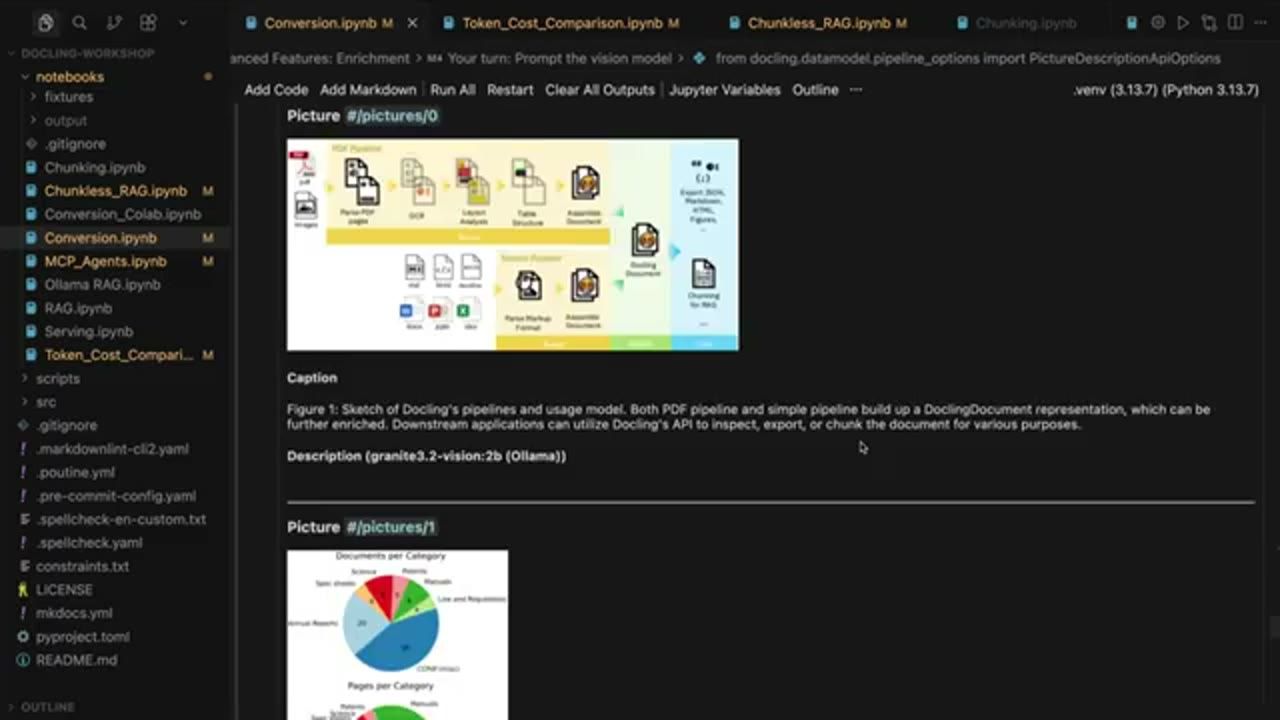
Với toàn bộ thông tin bổ sung này, ta có thể xây một RAG pipeline thật sự vững chắc để hỏi đáp trên dữ liệu nguồn.
13. Chunkless RAG: dùng outline của tài liệu làm index
Ở ví dụ này, Cedric muốn giới thiệu thứ được gọi là chunkless RAG, hay agentic RAG, dùng Docling. Bắt đầu từ outline của tài liệu, tức là xử lý một PDF bằng Docling như vừa làm, ta để LLM chọn phần liên quan nhất của tài liệu với câu hỏi của người dùng, rồi kéo toàn bộ text của phần đó ra từ chính Docling document để thử trả lời câu hỏi. Quá trình này có thể chạy trong một vòng lặp agentic (agentic loop).
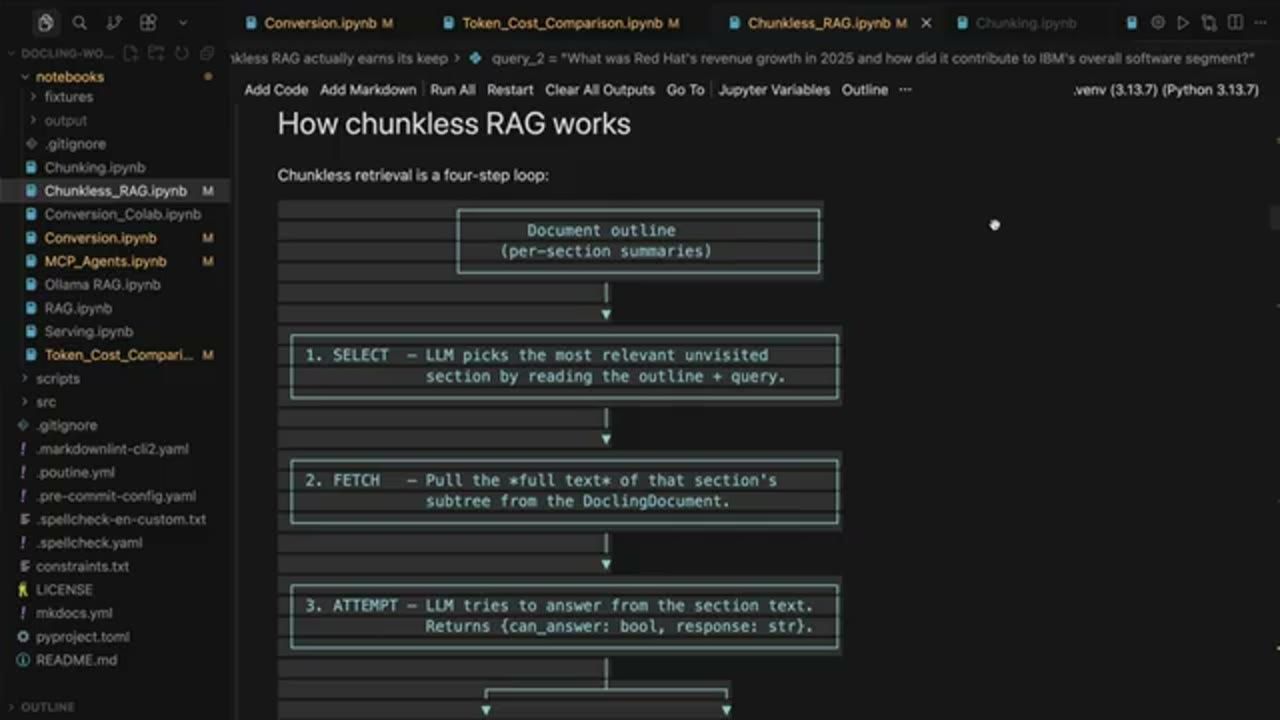
Điều quan trọng ở đây là ta đang làm RAG mà không cần chunker, embedding model hay vector database, vân vân. Index giờ chính là outline dạng Markdown của tài liệu. Thông thường, khi người dùng đặt câu hỏi, toàn bộ retrieval index sẽ là hàng nghìn vector trong một database, nơi ta làm semantic similarity để xác định các phần nào giống với câu hỏi. Còn ở đây, ta chỉ cần nhìn một outline Markdown của tài liệu, mỗi section có kèm một bản tóm tắt.
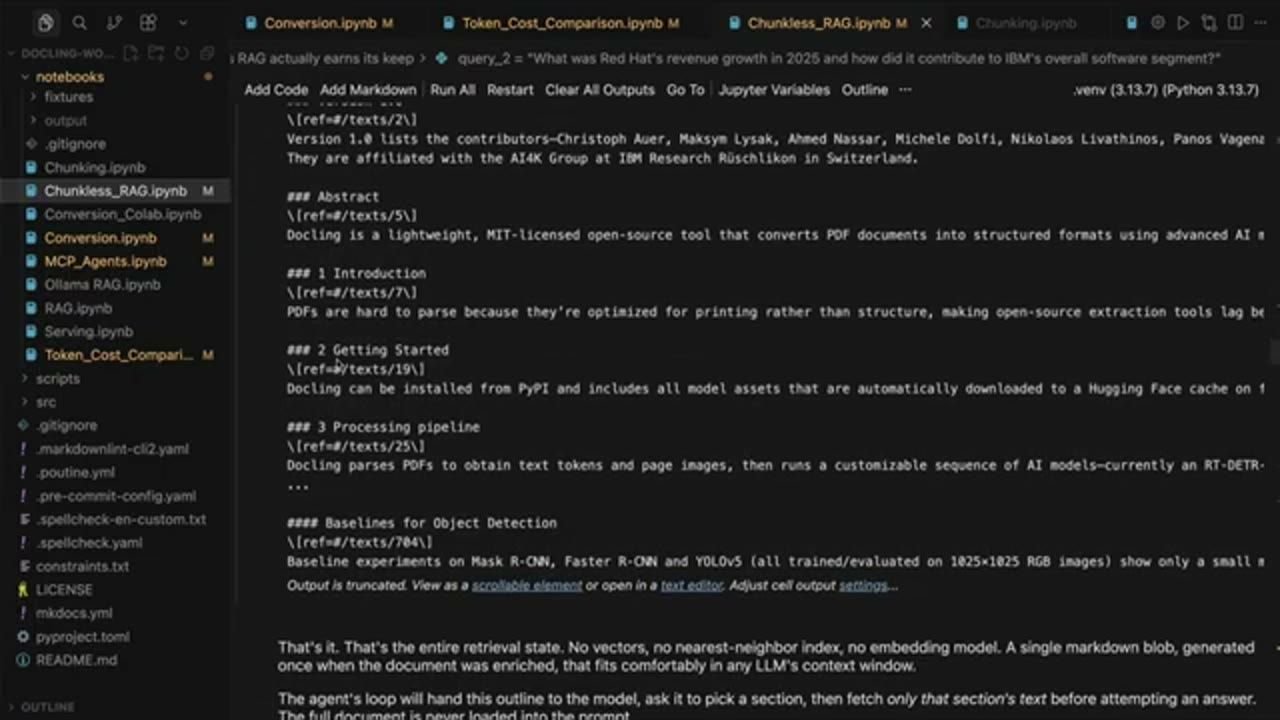
Nên nếu LLM đang tìm thông tin về cách bắt đầu với Docling, nó chỉ cần tham chiếu vào đoạn text này để thấy Docling có thể cài từ PyPI. Đó là toàn bộ retrieval index.
Giả sử ta có câu hỏi: "What are the main AI models used in Docling?", tức các AI model chính mà Docling dùng là gì. Ta dựng một RAG agent có thể lặp lại trên câu hỏi đó tối đa khoảng năm lần. Khi người dùng hỏi, có hai mươi section để chọn, và agent sẽ tìm đúng phần text nói về các AI model, rồi tự đánh giá "phần này có giúp trả lời câu hỏi không?".
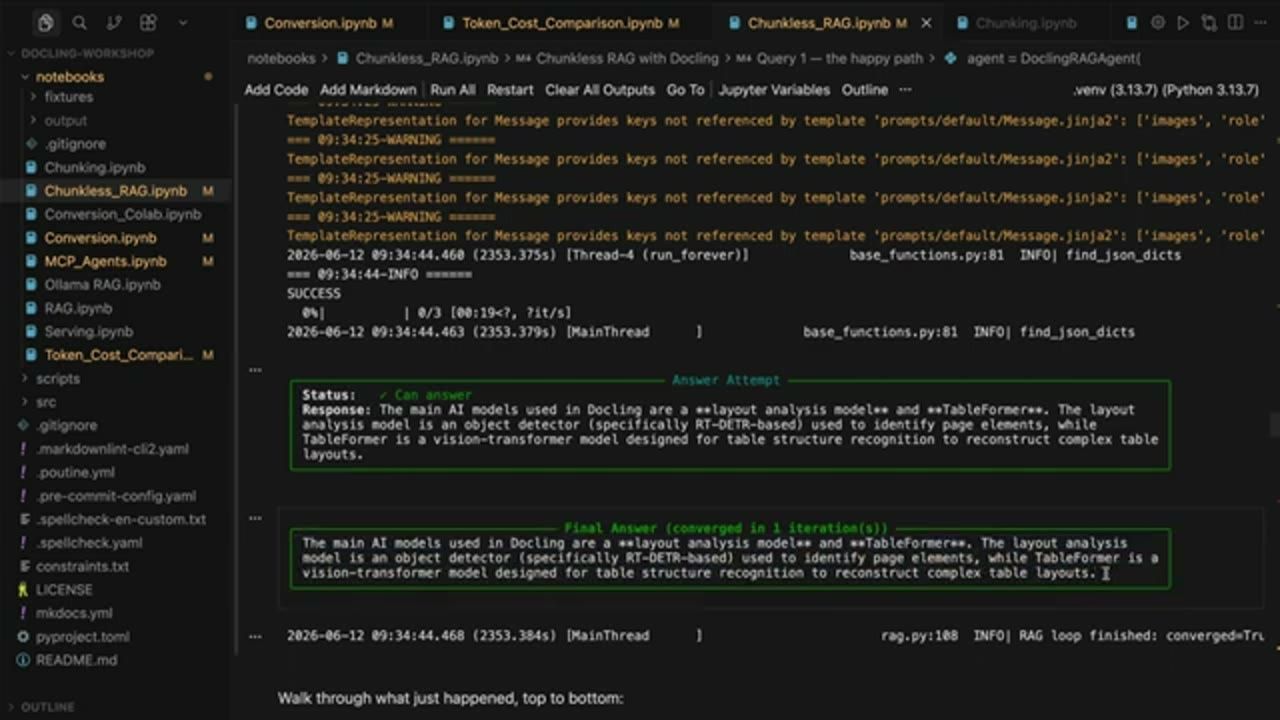
Và câu trả lời cuối cùng, chỉ sau một vòng lặp, được lấy thẳng từ tài liệu nguồn mà không phải đi qua vector database, thay vào đó là tìm trong cấu trúc của Docling document để lấy đúng đoạn text cần thiết.
14. Một tài liệu lớn hơn: báo cáo thường niên 2025 của IBM
Theo Cedric, đây là một cách khá thú vị để trả lời câu hỏi của người dùng qua mẫu chunkless retrieval-augmented generation. Ví dụ đầu có thể còn đơn giản, nên anh kéo thêm báo cáo thường niên năm 2025 của IBM vào context. Tài liệu này có bốn trăm mười tám section, lớn hơn rất nhiều, và anh hỏi: "What was Red Hat's revenue growth in 2025, and how did it contribute to an overall software segment?", tức doanh thu Red Hat tăng trưởng bao nhiêu trong năm 2025 và đóng góp thế nào vào toàn bộ mảng software.
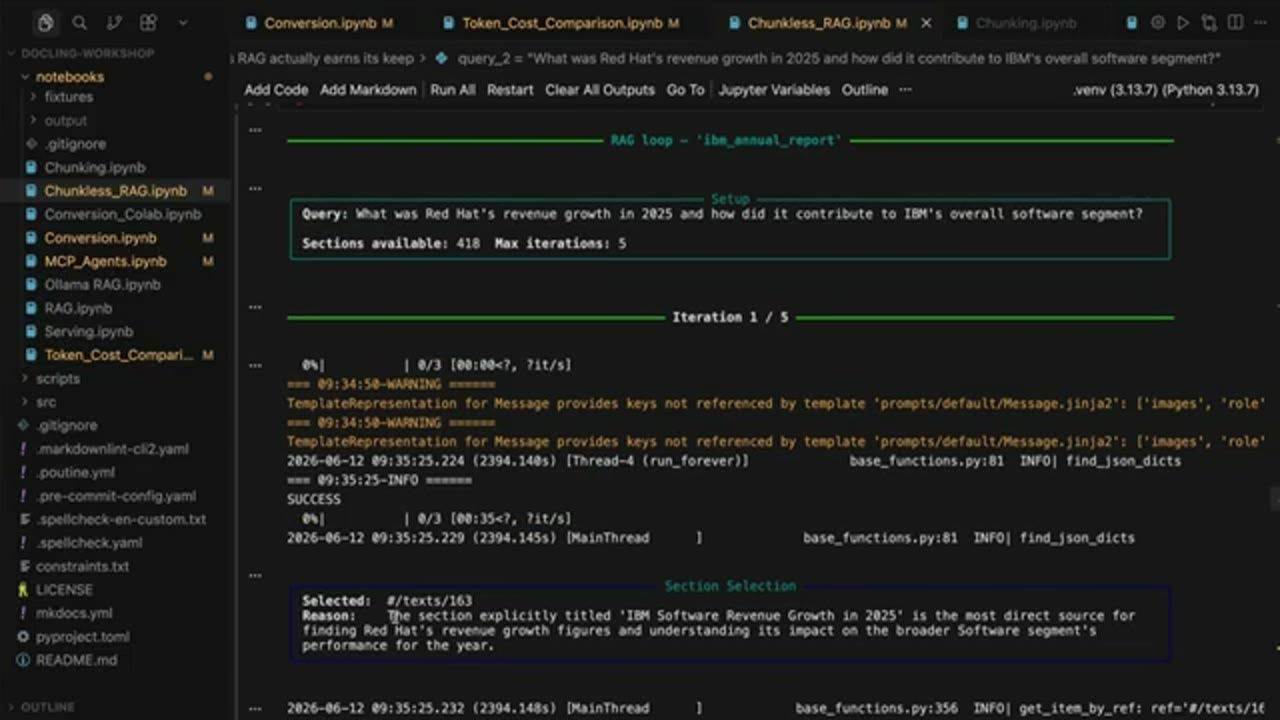
Ở đây agent sẽ lặp nhiều lần để xác định "section này có liên quan tới câu hỏi không?". Nếu không, nó cần kéo thêm thông tin. Đó là cách chunkless RAG có thể hoạt động khi bạn dùng một công cụ như Docling.
15. Docling Serve: chạy Docling như một REST API
Nhưng chuyện gì xảy ra khi ta có hàng trăm, hay hàng trăm nghìn file PDF cần xử lý? Đây là lúc ta deploy Docling thành một REST API service, bằng thứ gọi là Docling Serve. Nó cho phép scale lên và chạy Docling như một microservice, một container, hoặc qua Kubernetes.
Để dựng, ta chạy pip install docling-serve, rồi serve từ CLI bằng Docling Serve trên một port cụ thể. Hoặc khi server đã chạy, ta gửi tài liệu tới endpoint đó với nhiều option và tham số khác nhau, kiểu: có muốn dùng OCR không? Có muốn dùng một back end cụ thể không, hay có muốn annotate hình ảnh không? Đó là cách scale và để endpoint API này xử lý cùng lúc hàng trăm, hàng nghìn tài liệu với nhiều định dạng khác nhau.
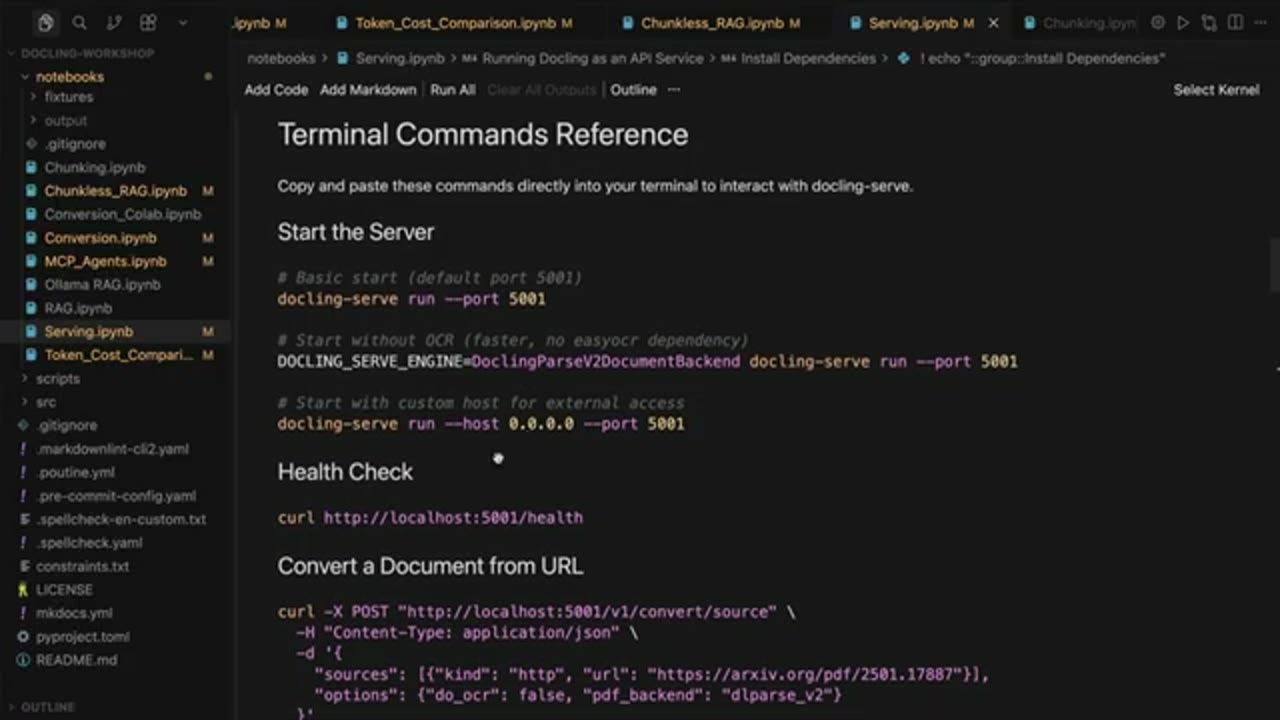
# Basic start (default port 5001)
docling-serve run --port 5001

# Start without OCR (faster, no easyocr dependency)
DOCLING_SERVE_ENGINE=DoclingParseV2DocumentBackend docling-serve run --port 5001

# Start with custom host for external access
docling-serve run --host 0.0.0.0 --port 5001

# Health check
curl http://localhost:5001/health

# Convert a document from URL
curl -X POST "http://localhost:5001/v1/convert/source" \
  -H "Content-Type: application/json" \
  -d '{
    "sources": [{"kind": "http", "url": "https://arxiv.org/pdf/2501.17887"}],
    "options": {"do_ocr": false, "pdf_backend": "dlparse_v2"}
  }'
16. Docling MCP server: đưa Docling vào tay AI agent
Và giả sử bạn đang xây một AI agent, bạn có thể dùng Docling MCP server. Nó cho phép tự động hoá mọi việc với AI agent, trao cho agent các khả năng của Docling thông qua Model Context Protocol, và chuẩn hoá việc giao tiếp giữa, ví dụ, Claude Code hay Continue trong CLI dành cho developer với MCP server. MCP server sẽ lo phần xử lý tài liệu, mà ta không cần biết hết mọi tham số và lệnh khác nhau. Nên mọi chuyện trở nên khá dễ. Ví dụ Cedric chỉ ở đây dùng một trong các model Qwen chạy ngay trên máy Mac của anh, kết nối với VS Code.
Trước hết, xem các tool có sẵn. MCP server có nhóm tool chuyển đổi (conversion), nhóm tool tạo tài liệu (generation), ví dụ khi bạn muốn xử lý một phần cụ thể của một PDF, và nhóm tool chỉnh sửa (manipulation). Tất cả được cung cấp cho LLM và agent mà ta sẽ dùng cùng MCP server.
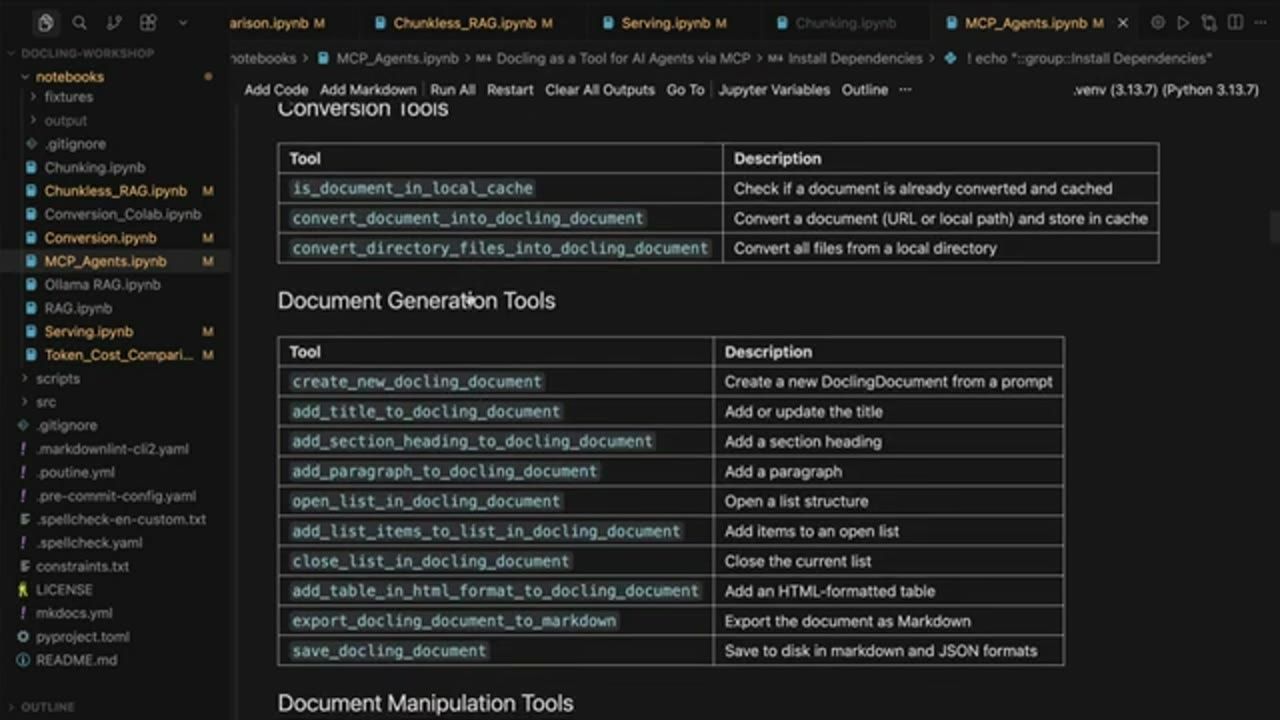
Ở đây anh kiểm tra rằng MLX server chạy LLM local trên máy đang hoạt động, và có vẻ đang chạy Qwen 3.6. Rồi anh xác nhận Docling MCP server cũng đang chạy, việc này làm bằng uvx. Anh chạy kiểm tra trong một cell để chắc chắn MCP server đã sẵn sàng.
Tiếp theo, trong Claude Code, Codex hay một ứng dụng AI khác, ta cài extension. Với Cedric, việc này nghĩa là thêm một MCP server vào file config.yaml.
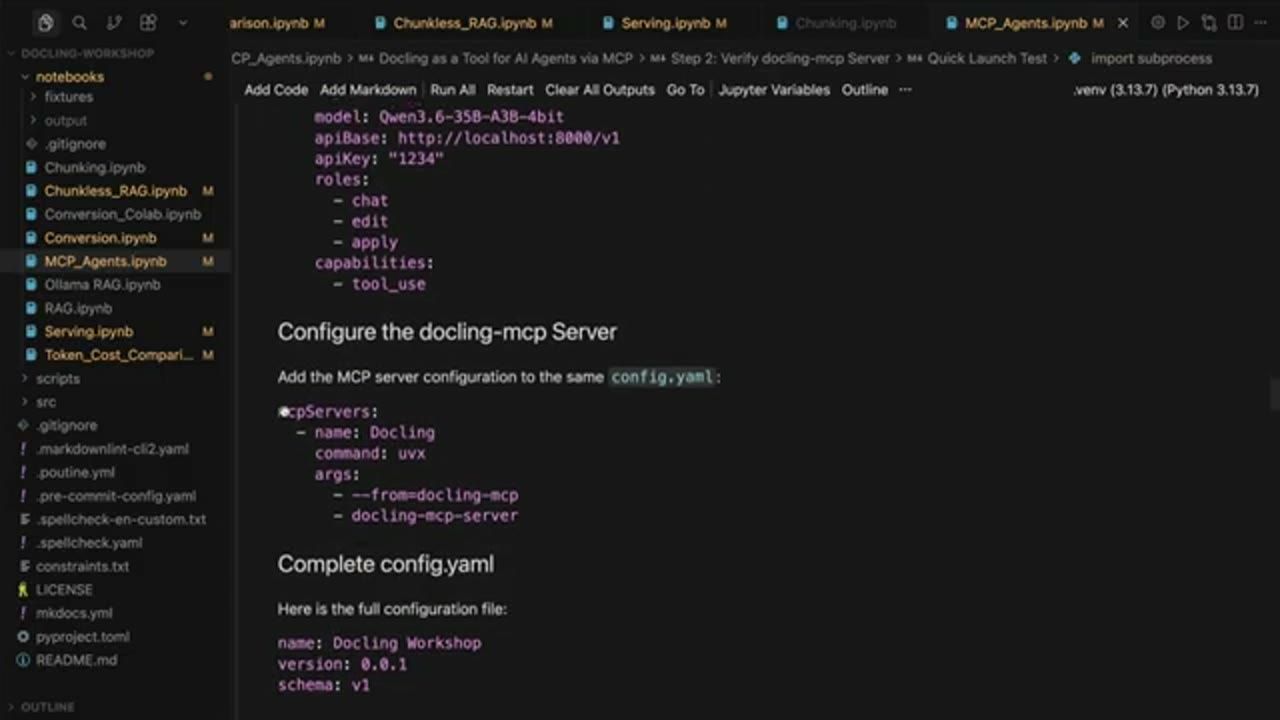
config.yaml: phần model trỏ tới Qwen3.6-35B-A3B-4bit qua một API local ở cổng 8000 với các role chat, edit, apply và capability tool_use; phần "Configure the docling-mcp Server" thêm Docling vào mcpServers.mcpServers:
- name: Docling
command: uvx
args:
- --from=docling-mcp
- docling-mcp-serverTới đây, ta có thể dùng một model cùng một MCP server để làm những việc như: "convert tài liệu này và tóm tắt cho tôi", hoặc "tạo một tài liệu có một section action items, kéo vào một danh sách từ một PDF khác, rồi export ra Markdown". Ta dùng được toàn bộ các thành phần của Docling qua MCP server để xử lý và parse các tài liệu này theo kiểu agentic, bằng một AI agent như Cursor, Claude Code, hay một trong rất nhiều lựa chọn open source ngoài kia.
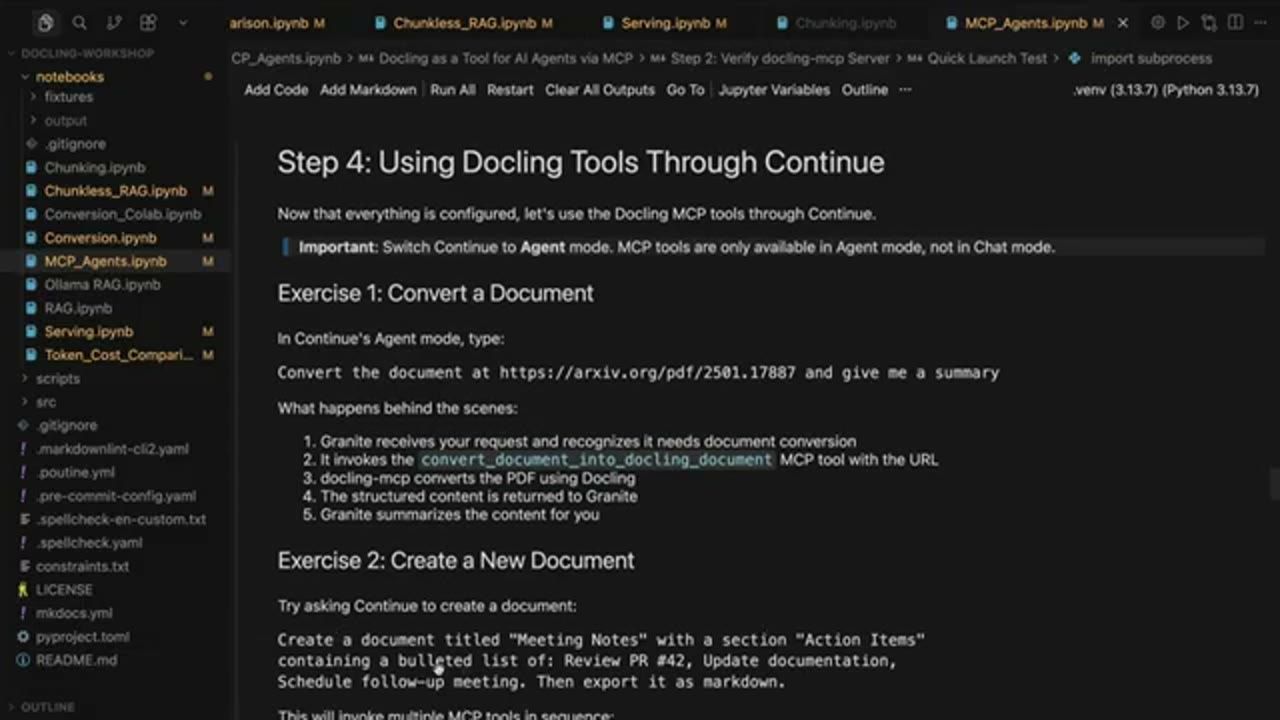
convert_document_into_docling_document, docling-mcp convert PDF, trả nội dung có cấu trúc về, model tóm tắt). Exercise 2 tạo một tài liệu mới.Convert the document at https://arxiv.org/pdf/2501.17887 and give me a summary
Create a document titled "Meeting Notes" with a section "Action Items"
containing a bulleted list of: Review PR #42, Update documentation,
Schedule follow-up meeting. Then export it as markdown.
17. Tổng kết: Docling làm gì phía sau
Giờ Cedric quay lại slide để khép lại. Ghép tất cả lại với nhau: với Docling, ta đã thấy có thể chuyển một PDF sang một định dạng như Markdown hay JSON, chạy hoàn toàn local trên máy của mình, thậm chí không cần GPU. Nó nhanh, rẻ, và quan trọng nhất là open source. Anh khuyến khích mọi người thử hết.
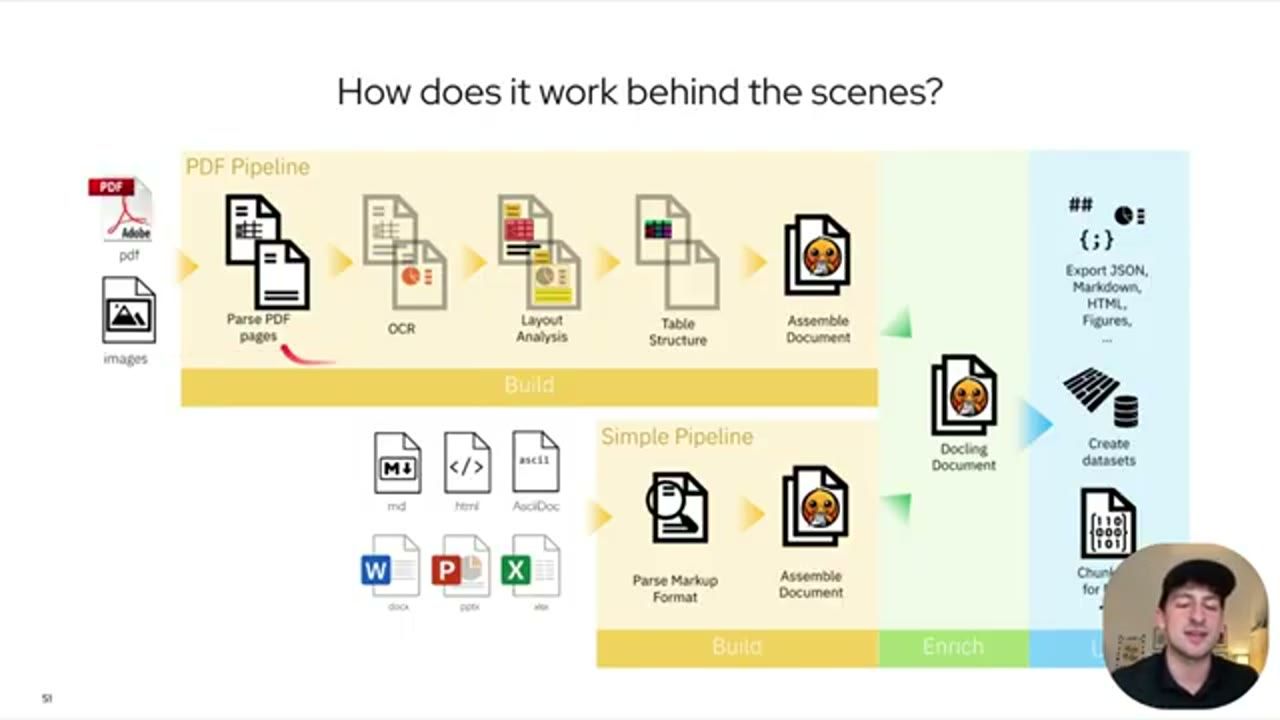
Phía sau, có nhiều pipeline khác nhau, kết hợp OCR với layout analysis để dựng lại toàn bộ cấu trúc, rồi gói tất cả thành một Docling document dạng Pydantic. Từ đó bạn export sang nhiều định dạng khác nhau, tạo dataset, chunk tài liệu bằng hybrid chunker, và làm nhiều việc khác. Docling tích hợp với nhiều RAG framework, hệ thống agentic và harness, nên cứ thoải mái dùng thử.
Cedric gửi lời cảm ơn lớn tới đội ngũ AI Engineer đã mời anh. Đây là chủ đề anh rất đam mê, không chỉ chuyện xử lý tài liệu mà còn là làm việc đó theo cách open source, vì, như anh nói, "chúng tôi ở Red Hat, và chúng tôi yêu open source". Anh mời mọi người xem slide, kết nối với anh trên LinkedIn, cảm ơn vì cơ hội được nói, chúc mọi người tận hưởng hội nghị và theo kịp hệ sinh thái AI engineering. Theo anh, mọi thứ đang rất sáng sủa cho thế giới open source và cho AI engineer nói chung. Hẹn gặp lại lần sau, và cảm ơn đã theo dõi.
Nguồn và link
- Docling: github.com/docling-project/docling · tài liệu chính thức · trang dự án tại LF AI & Data Foundation
- Bài báo kỹ thuật của Docling (dùng trong demo): arXiv 2501.17887
- Repo Docling workshop dùng cho các demo: github.com/ibm-granite-community/docling-workshop
- Docling Serve: github.com/docling-project/docling-serve · Docling MCP: github.com/docling-project/docling-mcp
- Bộ dữ liệu FinePDFs của Hugging Face: huggingface.co/datasets/HuggingFaceFW/finepdfs
- Granite Vision 3.2 2B: huggingface.co/ibm-granite/granite-vision-3.2-2b · Ollama · MLX LM · Continue
- Slide của buổi nói chuyện: red.ht/structuring · trang diễn giả: ai.engineer/speakers/cedric-clyburn
Related talks
A Genius With Amnesia
Victor Savkin · Nx · 20 min
Agent bị giới hạn trong một repo và quên mọi session cũ; Polygraph gỡ cả hai bằng synthetic monorepo và trace dùng chung giữa các agent.
Browser Agents Don't Need Better Models. They Need Better Eyes.
Kushan Raj · Sarvam AI · 4 min
Browser agent chậm và hay kẹt vì nhìn trang quá tệ: một bản markdown cả trang (~1.800 token) cộng feedback sau mỗi click giúp model rẻ chạy nhanh và đúng.
User Signal Dies at the Retrieval Boundary
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.