The AI bugpocalypse is here. Now what?
AI Engineer World's Fair 2026: Online Track · Video gốc
Frontier model tìm lỗ hổng ngày càng giỏi, nhưng lỗ hổng vẫn thuộc các lớp cũ: loại bỏ cả lớp bằng memory safety, đặt guardrails cho AI coding.
1. "Bugpocalypse" là gì, và Jack Cable là ai
Jack Cable mở đầu bằng chủ đề của buổi nói chuyện: những tác động của cái mà anh gọi là AI bugpocalypse. Như nhiều người có lẽ đã thấy, các frontier model đang giỏi hơn bao giờ hết trong việc phát hiện và khai thác (exploit) lỗ hổng trong phần mềm của chúng ta. Điều này dẫn tới cái mà nhiều người đang gọi là "bugpocalypse", một kiểu ngày tận thế của bug: chúng ta tìm ra ngày càng nhiều lỗ hổng, đặc biệt là trong các thư viện open source, những thư viện đang chống đỡ gần như toàn bộ phần mềm mà mọi người dựa vào hằng ngày. Trong talk này, Jack muốn phân tích cho rõ chính xác chuyện gì đang xảy ra, và phía phòng thủ (defenders) có thể làm gì để đi trước làn sóng exploit đang diễn ra.
Về bản thân, hiện tại Jack là co-founder và CEO của Corridor, công ty anh thành lập khoảng 18 tháng trước, tập trung vào việc bảo mật cho AI coding. Trước đó, anh làm senior technical advisor trong chính phủ Mỹ, tại CISA (Cybersecurity and Infrastructure Security Agency, Cơ quan An ninh mạng và An ninh Hạ tầng). Ở đó anh làm việc với các công ty phần mềm hàng đầu để giúp họ xây sản phẩm an toàn hơn ngay từ thiết kế, tức "secure by design". Anh cũng là một ethical hacker: từ hồi còn học trung học, anh đã lọt vào top 100 hacker trên HackerOne, rồi học computer science ở Stanford.
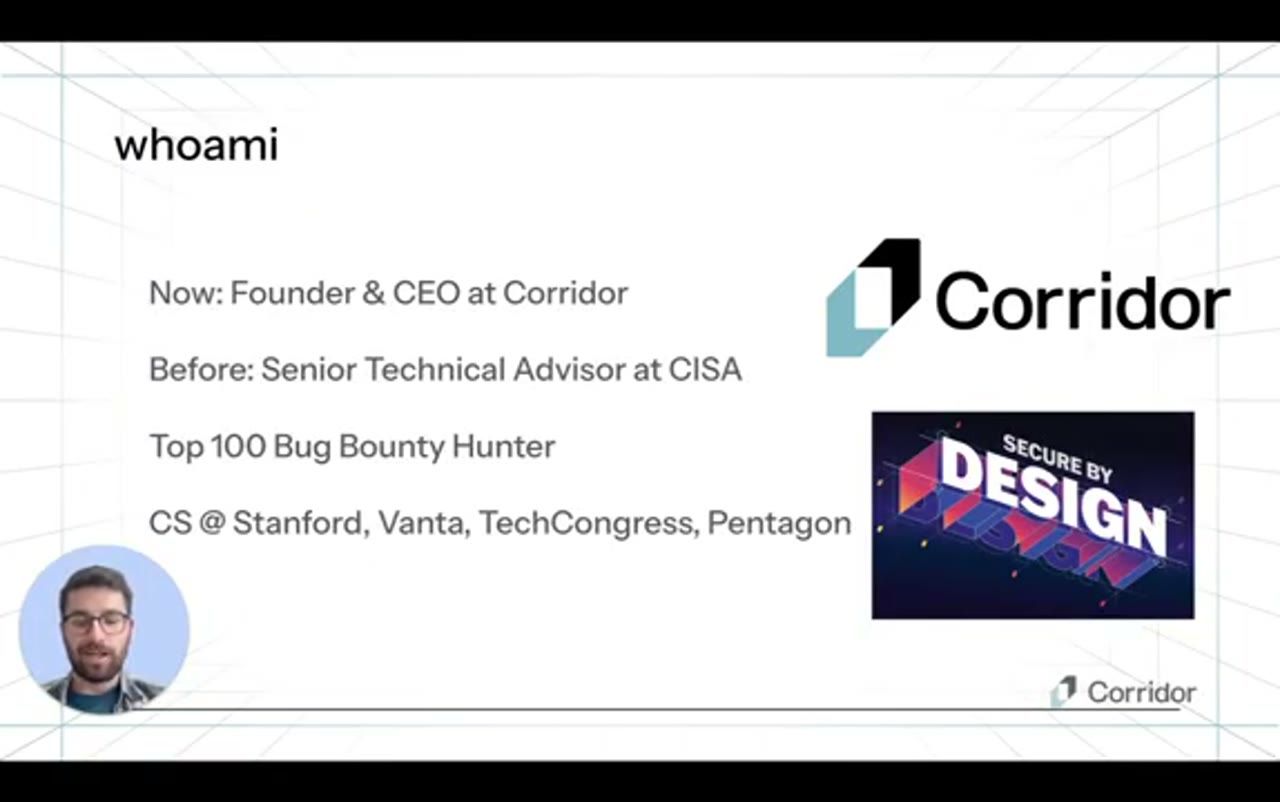
Vì vậy, Jack nói anh đã tận mắt thấy những lớp lỗ hổng đơn giản, lặp đi lặp lại được đưa vào code rồi bị khai thác như thế nào. Anh cũng là người tham gia khá sát vào nhiều bước tiến gần đây nhất, và đã chứng kiến những bước tiến đó có ý nghĩa gì, cả với phía kẻ tấn công (adversaries) lẫn phía phòng thủ.
2. AI coding đang tăng tốc nhanh nhất lịch sử phần mềm
Để dựng bối cảnh, Jack nhắc lại một điều mà anh đoán ai trong khán giả cũng biết: các công cụ AI coding đang tăng trưởng nhanh hơn bất kỳ hạng mục phần mềm nào trong lịch sử. Cursor và Claude Code đều tăng trưởng theo hàm mũ. Và đi cùng với nó là những cải thiện trong khả năng của frontier model khi tìm và khai thác lỗ hổng.
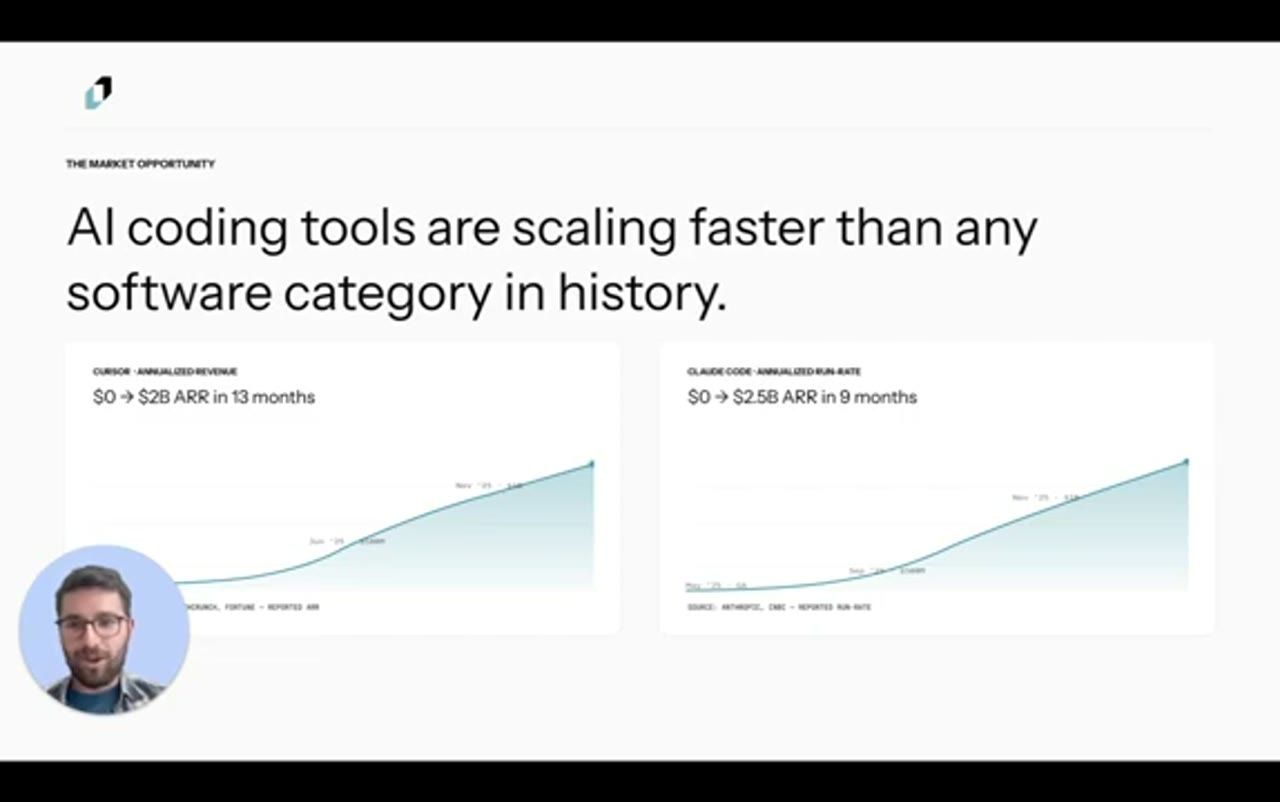
Như vậy, theo Jack, cả hai vế của phương trình đều đang dịch chuyển cùng lúc. Một mặt, model làm tốt hơn hẳn việc tìm ra lỗ hổng. Mặt khác, attack surface (bề mặt tấn công) của chúng ta đang phình ra khổng lồ, khi AI trở thành người viết code mặc định. Câu hỏi anh muốn khám phá trong talk là làm sao cân bằng hai vế đó: làm sao để chúng ta không rơi vào cảnh có nhiều lỗ hổng hơn hẳn bất kỳ lúc nào trước đây.
Đến đây Jack dời khung webcam của mình sang góc khác để không che mất số liệu trên slide, rồi đưa ra vài con số. Anh lấy một số thống kê từ năm ngoái: khoảng 84% developer đang dùng công cụ AI coding, và 30 tới 40% công ty khuyến khích dùng AI coding assistant. Nguồn là khảo sát của Stack Overflow.
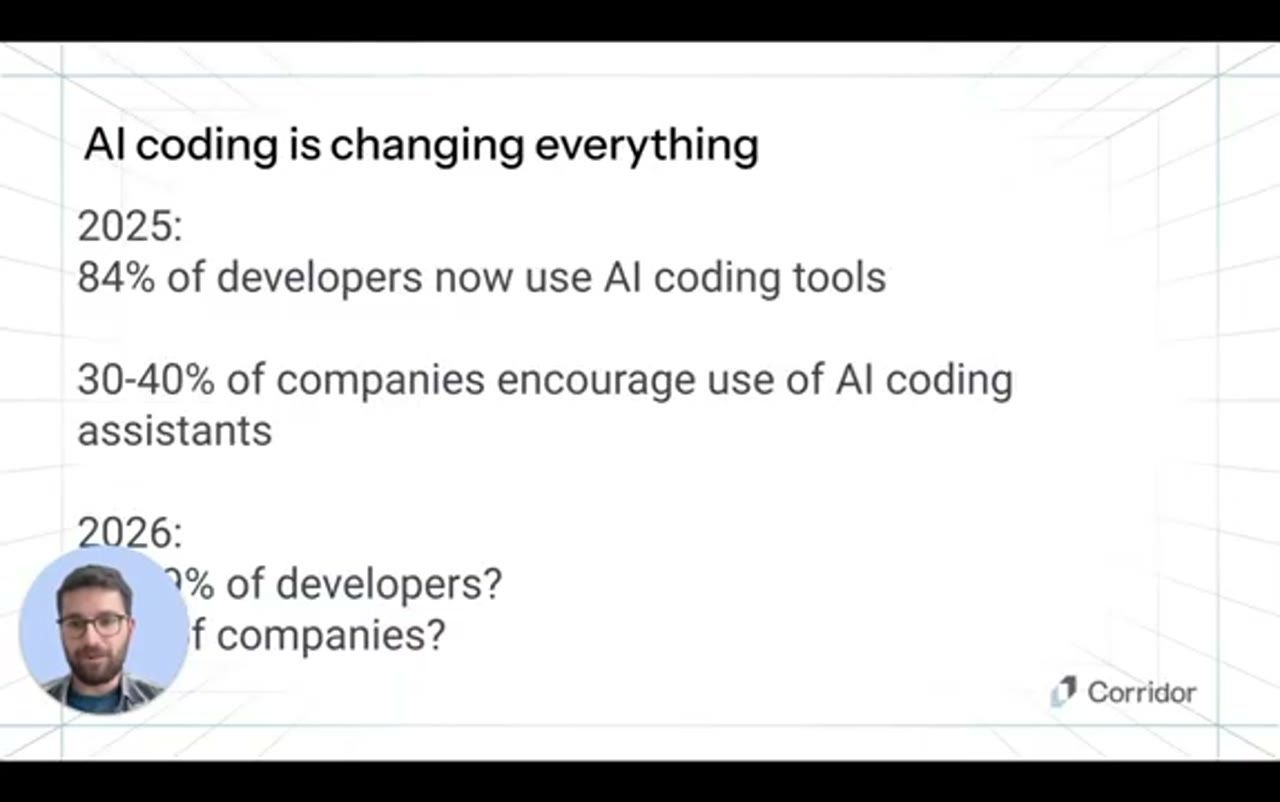
Jack nói anh chưa thấy số mới nhất của năm nay, nhưng khi số liệu được công bố, anh đoán rằng tuyệt đại đa số developer và công ty sẽ đang dùng coding agent. Một phần lý do là mức độ tự chủ (autonomy) ngày càng cao mà người ta trao cho coding agent. Giờ đây không còn chỉ là autocomplete, cũng không còn chỉ là một developer ngồi làm việc đồng bộ (synchronously) bên trong Cursor. Ngay ở Corridor, khi họ tự phát triển sản phẩm, họ spin up agent từ trong Slack hoặc từ bất kỳ đâu mà mọi người đang làm việc, và để nhiều agent chạy song song ở background. Đây là một thay đổi rất lớn trong cách phần mềm được làm ra.
3. Frontier model ngày càng giỏi tìm và khai thác lỗ hổng
Cùng lúc đó, như Jack đã nói, frontier model đang tốt lên đáng kể. Bạn có thể nhìn từ gần như bất kỳ khâu nào của chuỗi tấn công mạng (cyber attack chain). Ở khâu tìm lỗ hổng, model giờ đây làm tốt hơn đáng kể so với chính anh, một người đã báo cáo hàng trăm lỗ hổng cho đủ loại công ty. Và không chỉ tìm, mà cả khai thác chúng.
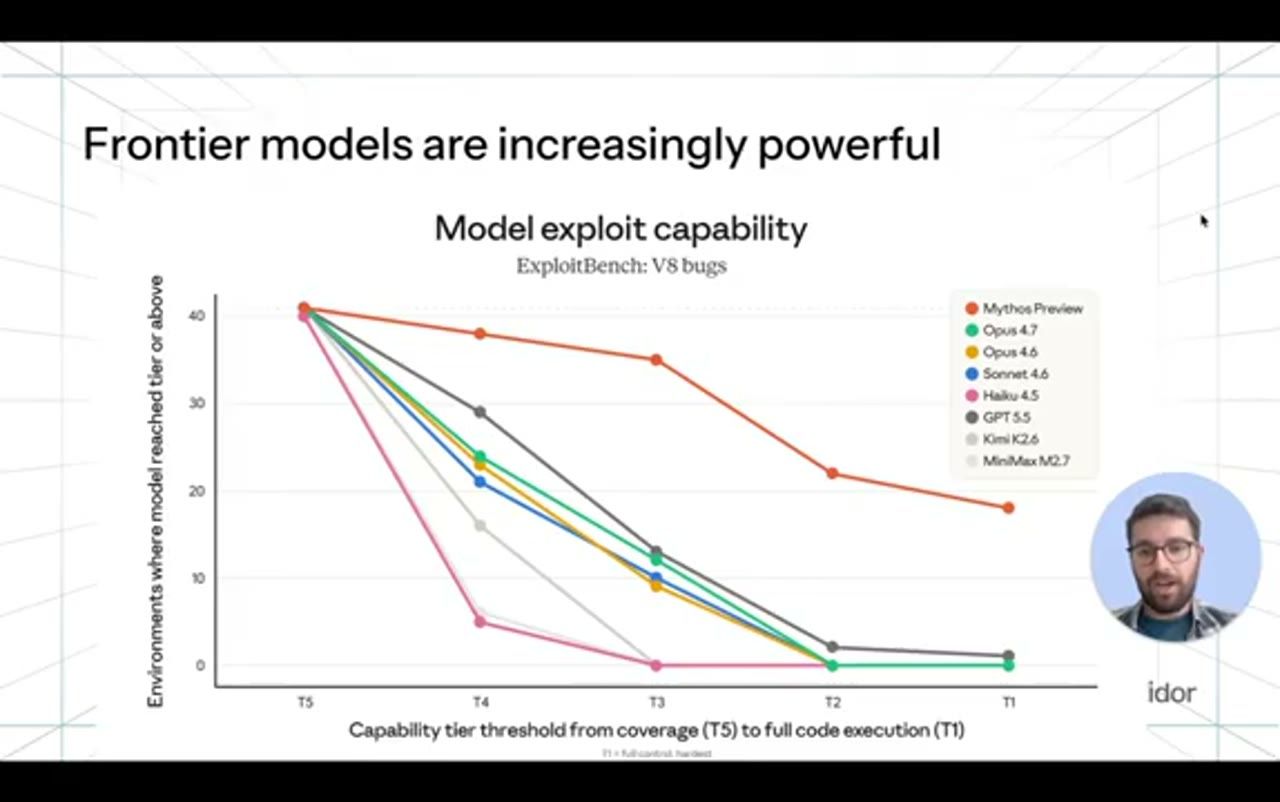
Biểu đồ này đến từ Anthropic, so sánh Mythos với một loạt model khác mà Anthropic và các bên khác đã đưa ra. Jack chỉ ra rằng chúng ta đang thấy năng lực của model tiến rất nhanh, đặc biệt là năng lực thực thi những chuỗi tấn công mang tính tự động (autonomous attack chains). Vì thế, khi nghĩ về những kẻ tấn công đang dùng các model này, anh nhấn mạnh rằng họ sẽ không chỉ dừng ở việc phát hiện lỗ hổng. Họ sẽ tự động hoá mọi phần của quy trình tấn công.
Do đó, việc của phía phòng thủ là hiểu được: đâu là những điểm mà ta có thể làm cho hệ thống phần mềm resilient hơn trước tất cả những cuộc tấn công này? Với Jack, câu hỏi đó kéo anh quay lại với rất nhiều việc anh từng làm trong chính phủ, quanh sáng kiến Secure by Design.
Câu hỏi tổng thể khiến Jack lo lắng là: làm sao để chắc rằng frontier AI model không đưa vào số lỗ hổng tăng theo cấp số nhân theo thời gian? Ngay cả trước thời AI, chúng ta đã thấy sự gia tăng mạnh của những lớp lỗ hổng phổ biến, tương đối đơn giản, đang bị kẻ tấn công khai thác. AI khiến chuyện đó dễ hơn rất nhiều. Vì thế, theo anh, cách duy nhất để phía phòng thủ thắng là dùng chính những kỹ thuật đó để gia cố (harden) hệ thống của mình.
4. Tin tốt: lỗ hổng mà AI tìm ra không có gì mới
Jack nói có một tin tốt ở đây. Rất nhiều lỗ hổng, thậm chí gần như toàn bộ lỗ hổng mà ngay cả frontier AI model đang tìm ra, đều không có gì mới. Đúng là việc một lỗ hổng cụ thể được tìm thấy trong một file cụ thể, bên trong một phần mềm cụ thể, là chuyện mới. Nhưng lớp lỗ hổng (vulnerability class) đó thì không nhất thiết là mới lạ. Và chúng ta thực sự có thể dùng điều đó làm lợi thế, phần sau anh sẽ đi vào chi tiết.
Vậy luận điểm tổng thể (thesis) là: một mặt, kẻ tấn công đang có thêm nhiều công cụ trong bộ đồ nghề. Mặt khác, cách phần mềm được xây dựng đang thay đổi tận gốc. Nên câu hỏi thật sự trở thành: làm sao áp dụng AI để chống đỡ, gia cố lại các hệ thống phần mềm này?
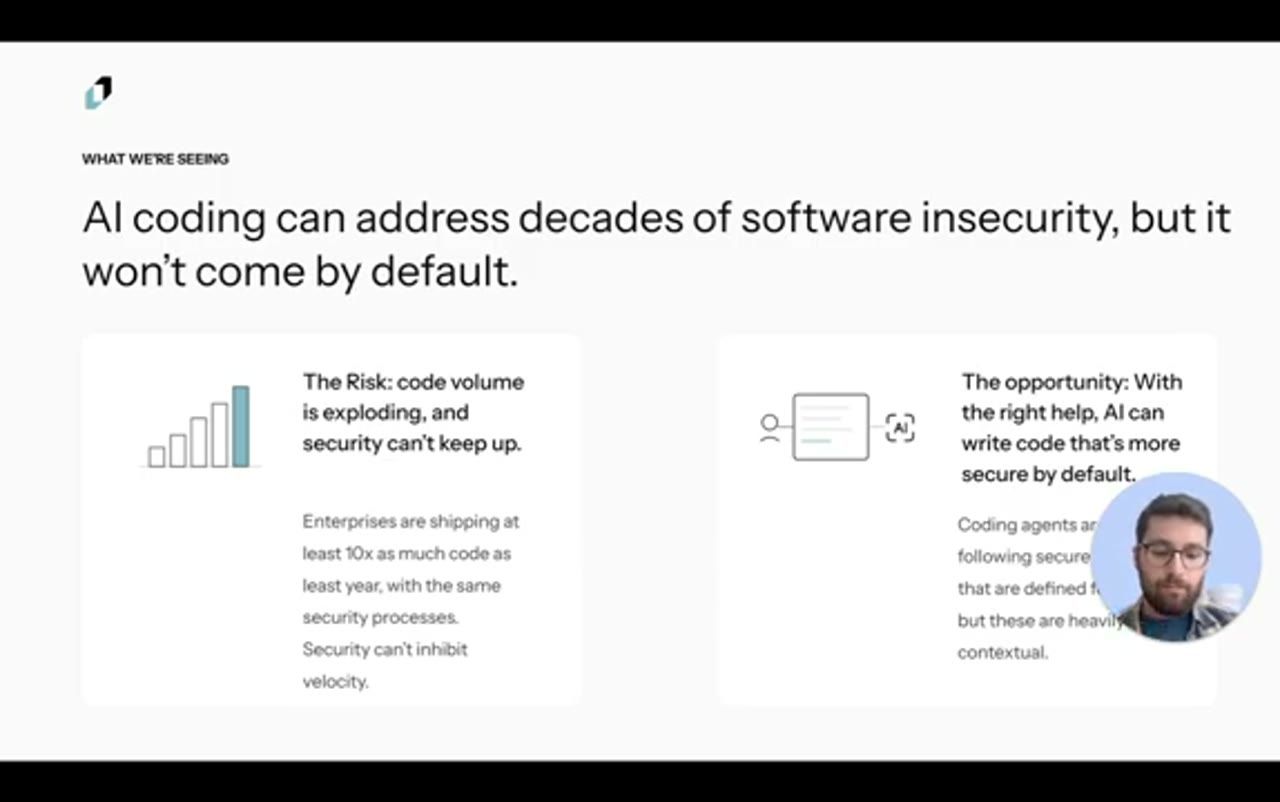
Slide này tóm lại hai mặt của cùng một đồng xu. Nếu không làm gì, AI coding chỉ đổ thêm code lên một quy trình bảo mật vốn đã quá tải. Nhưng nếu được hướng dẫn đúng, chính AI lại có thể là công cụ giải quyết những vấn đề bảo mật phần mềm đã tồn tại hàng chục năm. Điều quan trọng là nó sẽ không tự đến.
5. Secure by Design: ngăn lỗ hổng không phải là rocket science
Jack đi một đường vòng ngắn để kể về công việc Secure by Design mà anh cùng những người khác khởi động trong chính phủ. Đây là một tài liệu mà họ công bố vào tháng 3 năm 2023, đúng lúc LLM bắt đầu trở nên phổ biến hơn. Nhưng vào thời điểm đó, ứng dụng của chúng trong coding chưa vượt quá mức autocomplete là bao. Autocomplete có ích, nhưng chưa phải là bước nhảy vọt như chúng ta có bây giờ.
Điều họ tập trung vạch ra trong tầm nhìn này là: ngăn ngừa lỗ hổng trong phần mềm thật ra không phải là rocket science. Đúng là rất khó để xây một hệ thống an toàn tuyệt đối. Nhưng chúng ta biết cách xây những hệ thống về bản chất resilient hơn trước các lớp lỗ hổng phổ biến.
Để cụ thể hoá, Jack đưa ra một danh sách các lớp lỗ hổng từ MITRE. Đó là những lớp lỗ hổng (weakness) đứng đầu trong số các lỗ hổng bị khai thác thật, được ghi nhận trong Known Exploited Vulnerabilities Catalog (danh mục các lỗ hổng đã bị khai thác) của CISA.
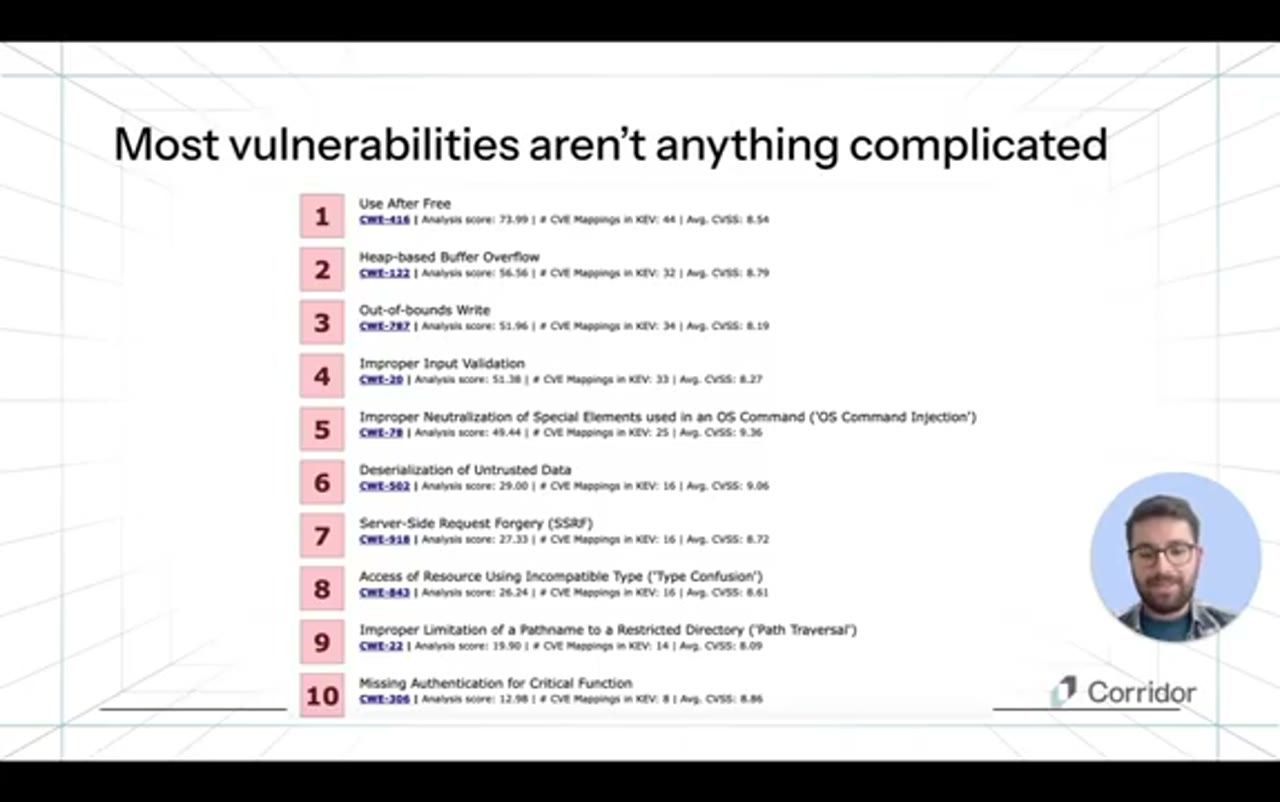
Nếu đi dọc danh sách này, bạn sẽ để ý rằng gần như tất cả đều là những loại lỗ hổng cơ bản. Chúng ta không chỉ biết về chúng từ hàng chục năm nay, mà còn biết cách ngăn chúng ở quy mô lớn từ hàng chục năm nay. Lấy buffer overflow làm ví dụ, nó đứng thứ hai trong danh sách. Jack lưu ý thêm: đây cũng chính là những lỗ hổng mà các model như Mythos đang tìm ra trong phần mềm. Buffer overflow được ghi nhận lần đầu, theo anh nhớ, từ hơn 30 năm trước. Như vậy chúng ta đã có tài liệu về cách tìm và khai thác loại lỗ hổng này từ rất lâu, và giờ chúng ta còn có những ngôn ngữ memory-safe.
6. Memory safety: xoá sổ cả một lớp lỗ hổng
Những ngôn ngữ như Rust, Go, và gần như bất kỳ ngôn ngữ nào không phải C hay C++, đều được xây theo cách khiến việc đưa vào lỗ hổng memory safety là không thể. Chúng có những đảm bảo (guarantees) ngăn các lỗ hổng đó xuất hiện. Nghĩa là chúng ta đã có kỹ thuật để ngăn trước chúng, vậy mà chúng vẫn tiếp tục được đưa vào code, hết lần này tới lần khác.
Hãy nhìn vào memory safety. Các thống kê có dao động, nhưng xấp xỉ 60 tới 70% lỗ hổng trong những sản phẩm viết bằng ngôn ngữ không memory-safe có thể được ngăn hoàn toàn nếu dùng ngôn ngữ memory-safe. Con số này dựa trên dữ liệu CVE công khai. Không chỉ vậy, nhiều công ty như Google, Microsoft, Amazon, và cả phần mềm open source, chẳng hạn Linux kernel đang được viết lại một số phần bằng Rust, đã cho thấy bằng chứng thực tế rằng chuyển sang ngôn ngữ memory-safe giúp giảm tổng số lỗ hổng.
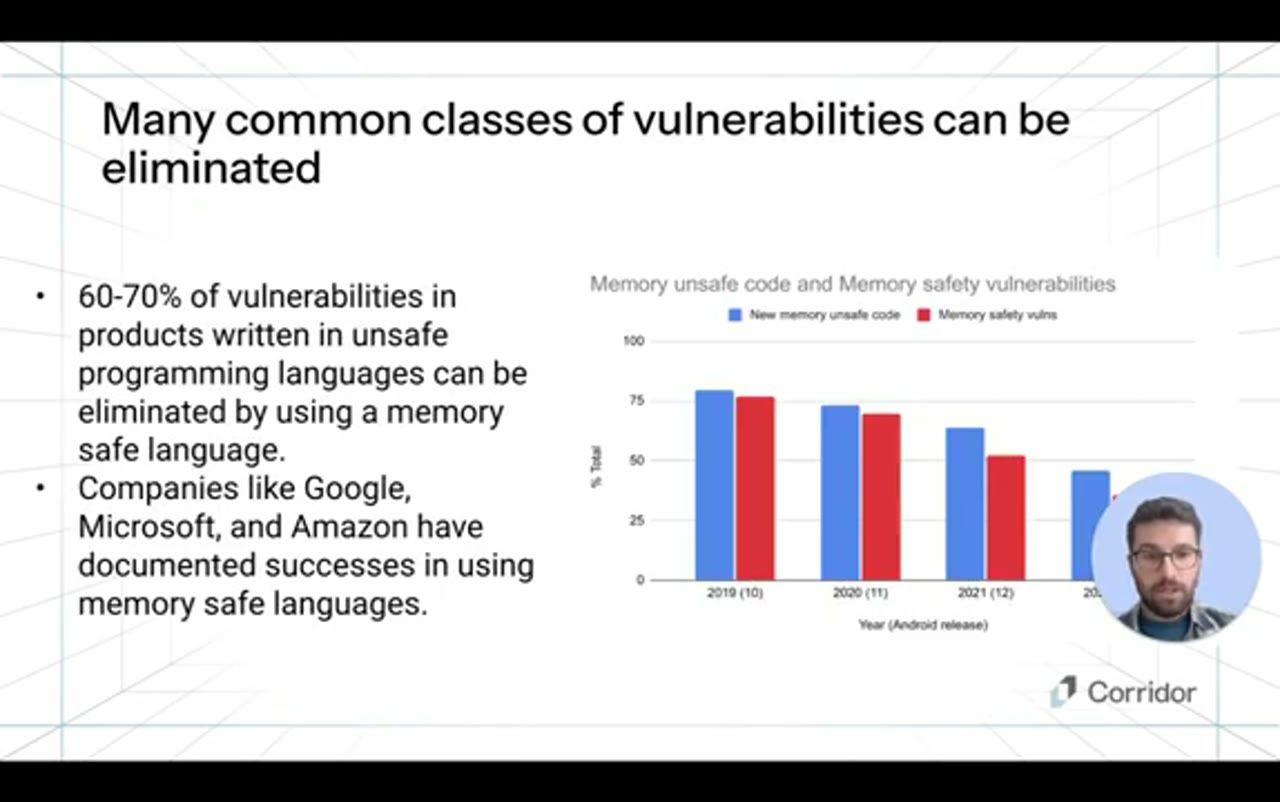
Biểu đồ bên phải là của Google, cho thấy tỷ lệ lỗ hổng memory safety theo thời gian trong hệ điều hành Android. Điểm thú vị, theo Jack, là Google thậm chí không nhất thiết phải viết lại code cũ sang một ngôn ngữ memory-safe. Họ chỉ viết code mới bằng ngôn ngữ memory-safe. Vậy mà tỷ lệ lỗ hổng memory safety đã giảm khá mạnh, từ khoảng 75% năm 2019 xuống còn chừng 30% năm 2022. (Trong bài viết của Google về Android 13, tỷ lệ này được ghi là từ 76% năm 2019 xuống 35% năm 2022, tính trên tổng số lỗ hổng của Android.)
Với cá nhân Jack, điều đó rất đáng mừng. Nó có nghĩa là việc chúng ta tiếp tục mắc những lỗ hổng cơ bản này hết lần này tới lần khác không phải là điều mặc nhiên phải chấp nhận.
7. Đừng chỉ chơi whack-a-mole: rewrite một lần, hưởng lợi nhiều năm
Từ đó, Jack cho rằng một phần của cuộc thảo luận policy ở tầm cao phải là: không chỉ hỏi làm sao triển khai các frontier model để tìm từng lỗ hổng riêng lẻ trong phần mềm. Việc đó chúng ta nên làm. Nhưng song song, anh không muốn bỏ lỡ những cơ hội làm cho phần mềm an toàn hơn từ gốc.
Chúng ta có thể đổ hàng triệu đô la vào việc về cơ bản là chơi whack-a-mole (trò đập chuột chũi) với lỗ hổng: vá từng cái một trong các thư viện open source mà ai cũng dựa vào. Hoặc chúng ta có thể làm một lần rewrite, chẳng hạn chuyển một số thư viện quan trọng sang ngôn ngữ như Rust. Việc đó sẽ trả cổ tức trong nhiều năm tới. Đây chính là cốt lõi trong cách Jack nghĩ về vấn đề: những thay đổi nền tảng nào mà các công ty và các developer open source có thể làm để giảm khả năng bị khai thác, cả bởi model hôm nay lẫn model trong tương lai?
Lợi thế của việc làm rewrite là: nếu bạn có được những đảm bảo nền tảng như vậy, thì kể cả khi model thông minh hơn nữa, chúng vẫn đứng vững. Rust có những đảm bảo mang tính lập trình (programmatic guarantees), nhờ đó ta biết rằng trong hầu hết trường hợp, lỗ hổng memory safety sẽ không thể bị đưa vào, và cũng không thể bị phát hiện ra. Một model thông minh đến mấy cũng không thể tìm thấy một lớp lỗ hổng không tồn tại.
8. AI cũng tạo ra bug, kể cả model rất thông minh
Tất cả những điều trên diễn ra trong bối cảnh AI ngày càng có năng lực, tất nhiên là năng lực viết code, nhưng cũng là năng lực đưa lỗ hổng vào code. Jack nhắc một ví dụ có lẽ mọi người đã thấy cách đây vài tháng: Opus 4.6, theo mọi đánh giá là một model rất thông minh, đã đưa vào một lỗ hổng trong một smart contract, dẫn tới việc vài triệu đô la bị đánh cắp.
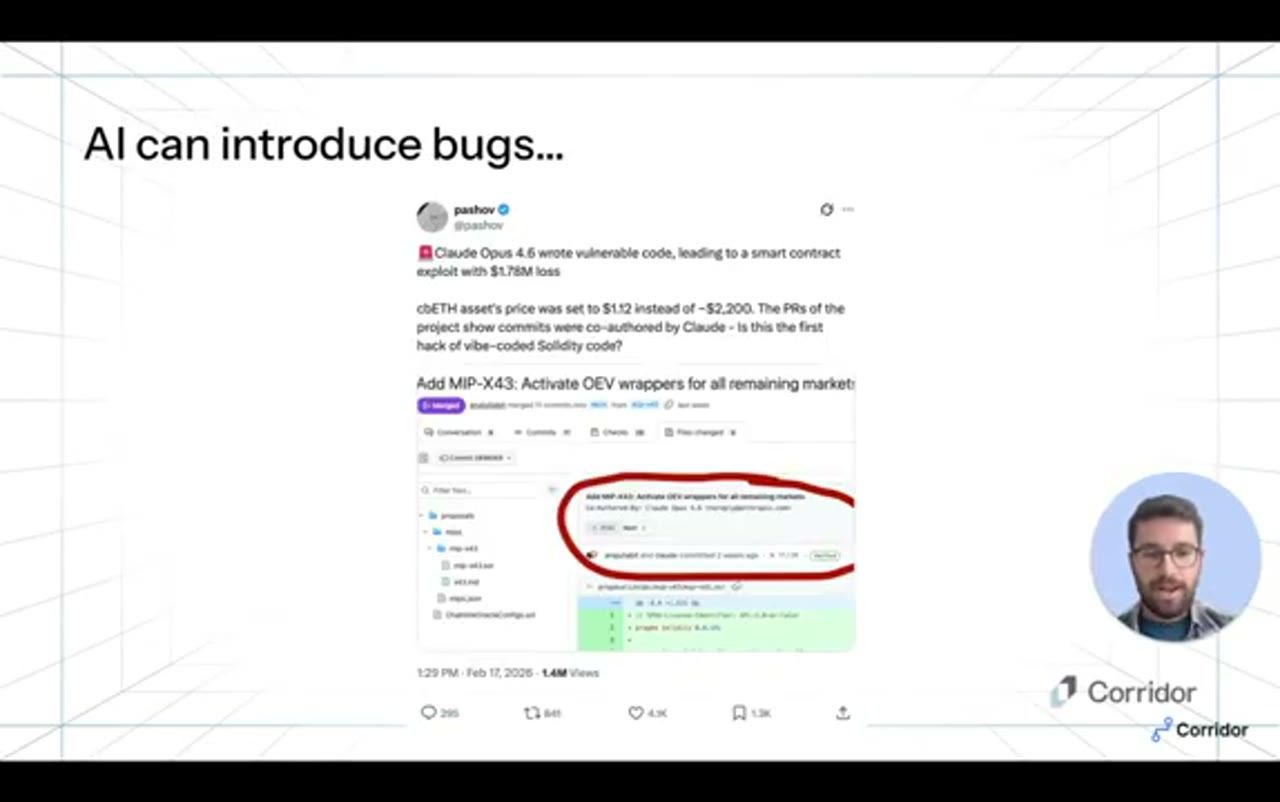
Bài học Jack rút ra: dù model rất thông minh và có năng lực, bảo mật thường mang tính ngữ cảnh rất cao (very contextual), và model có thể đơn giản là không có đủ ngữ cảnh để biết rằng nó đang đưa vào một lỗ hổng.
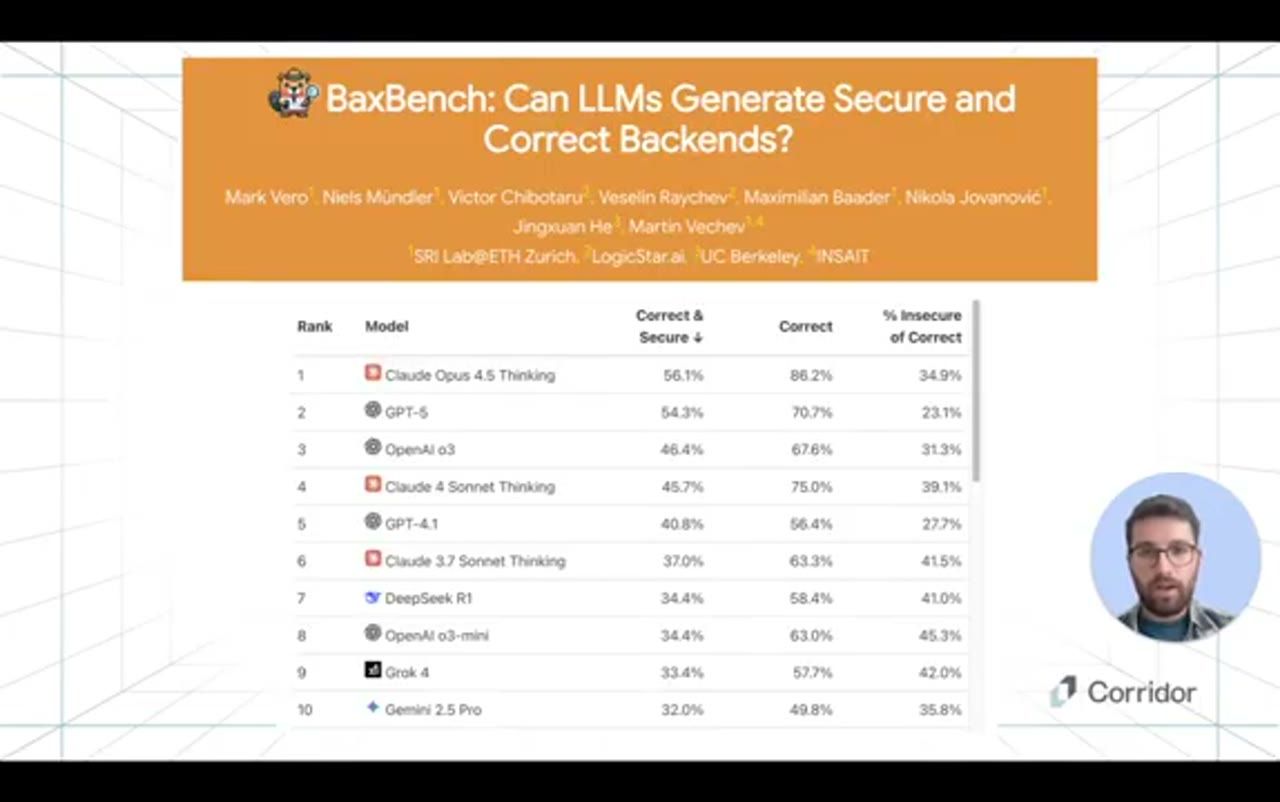
Điều này cũng phản ánh trong các benchmark học thuật. Một ví dụ là BaxBench, bạn có thể xem tại baxbench.com, do các nhà nghiên cứu ở ETH Zurich và UC Berkeley thực hiện. BaxBench cho thấy ngay cả những model tốt nhất cũng đưa lỗ hổng vào khoảng 20 tới 40% số lần khi viết code.
9. Vì sao model giỏi vẫn viết code có lỗ hổng
Theo Jack, kết quả này không nên khiến ai ngạc nhiên, vì hai lý do.
Thứ nhất, model được train trên toàn bộ code hiện có của thế giới, mà trong quá khứ con người cũng chẳng giỏi gì trong việc không đưa lỗ hổng vào code. Model học từ chính những thói quen đó.
Thứ hai, và điều này khớp với những gì Corridor đang thấy ở khách hàng của mình: những lỗ hổng đang được đưa vào ngày càng ít là loại lỗ hổng cơ bản nằm gọn trong một dòng code, mà ngày càng nhiều là các vấn đề mang tính ngữ cảnh. Ví dụ điển hình là authorization bug, loại bug đòi hỏi hiểu sâu business logic của một công ty. Dù model rất thông minh, nó không được train trên thông tin nội bộ (proprietary) của công ty bạn, cũng không biết threat model riêng của bạn vận hành ra sao. Jack tin đó là lý do chúng ta vẫn thấy tỷ lệ đưa lỗ hổng vào code khá cao, ngay cả với những model mà theo mọi đánh giá là rất thông minh.
Từ đó Jack chuyển sang câu hỏi tiếp theo: khi tuyệt đại đa số việc phát triển phần mềm đang được làm bằng AI, làm sao để chắc rằng AI có khả năng viết phần mềm secure by design?
10. Thang autonomy: từ autocomplete tới AI review code
Một phần của câu trả lời nằm ở sự dịch chuyển về mức độ autonomy mà AI đang được trao trong các tác vụ phát triển phần mềm. Jack mô tả nó như một cái thang mà chúng ta đang leo dần lên. Bậc đầu là autocomplete. Bậc tiếp theo là agent bên trong Cursor hay Claude Code, tạo ra code một cách đồng bộ khi developer ngồi cạnh. Giờ đây ngày càng nhiều là những agent tự chủ có thể làm việc một tiếng, thậm chí nhiều tiếng liền, và tạo ra những thay đổi code khá lớn. Và bậc tiếp theo, tất nhiên, là agent review code.
Ở Corridor, họ tin rằng trong vòng 6 tới 12 tháng tới, phần lớn code được ship sẽ được review không phải bởi con người mà bởi AI. Jack cho rằng đó là hệ quả tự nhiên của tốc độ mà các công ty cần di chuyển: code review giờ đã trở thành nút thắt cổ chai (bottleneck), và anh không nghĩ mọi người sẽ chấp nhận điều đó lâu.
11. Corridor: guardrails trước khi có pull request
Góc nhìn của Corridor xoay quanh hai việc: ngăn lỗ hổng ngay từ trước khi có pull request, và cho đội security thấy rõ các công cụ AI coding đang được dùng như thế nào.
Jack cho rằng điều này thực sự thiết yếu, vì security không thể là thứ chặn đường (blocker) khi các công ty muốn tăng tốc phát triển. Tăng tốc lúc nào cũng sẽ thắng. Vì thế, khi Corridor nói chuyện với các đội security, cuộc trò chuyện không còn xoay quanh câu "có nên cho đội dev dùng coding agent không". Câu trả lời hiển nhiên là có. Câu hỏi thật sự là làm sao cho dùng với guardrails (hàng rào an toàn) được đặt sẵn.
Lý do là những gì họ đang thấy: không có guardrails, coding agent đúng là có thể đưa lỗ hổng vào code. Và để đi tới chỗ việc phát triển được tự động hơn, nơi code bắt đầu được AI review và merge vào mà không cần nhiều giám sát của con người như trước, chúng ta thật sự cần có tooling cho phép đội security có được sự đảm bảo (assurance) đó, để họ có thể "bật đèn xanh" cho đội engineering tăng tốc.
12. Góc nhìn policy: export controls và open weight model
Jack khép lại bằng góc nhìn policy. Một phần nó gắn với các biện pháp export controls (kiểm soát xuất khẩu) gần đây đối với các model Mythos và Fable. Anh nằm trong nhóm ký một lá thư, do đồng nghiệp của anh là Alex Stamos dẫn đầu, kêu gọi Nhà Trắng dỡ bỏ export controls đối với các model này.
Quan điểm trong lá thư là: lợi ích cho phía phòng thủ lớn hơn nhiều so với rủi ro. Đây là những model rất mạnh, và phải thừa nhận thẳng thắn, là model lưỡng dụng (dual use): có thể dùng để bảo vệ hệ thống, và cũng có thể dùng để khai thác chúng. Jack ghi nhận công của Anthropic: họ đã làm rất nhiều việc với bản phát hành Fable để đặt các biện pháp bảo vệ (safeguards), sao cho model nghiêng về phía người phòng thủ hơn là kẻ tấn công.
Nhưng tất cả diễn ra trong bối cảnh open weight model ngày càng mạnh. Có lẽ mọi người đã thấy các vụ distillation attack được ghi nhận, trong đó các bên cung cấp open weight model train trên output của closed weight model. Hệ quả là khoảng thời gian giữa lúc một frontier closed weight model ra mắt và lúc open weight model bắt kịp đang co lại nhanh chóng.
Vậy nên, dù muốn hay không, kẻ tấn công đã có trong tay những model cực kỳ mạnh, và họ đang dùng chúng ngay hôm nay để khai thác hệ thống. Với Jack, câu hỏi khi đó là làm sao nhanh chóng đưa những năng lực tương tự vào tay phía phòng thủ, và theo anh, điều đó đòi hỏi các model này phải được phổ biến rộng rãi hơn.
13. Ba khuyến nghị gửi Quốc hội Mỹ
Vài tuần trước, Jack có cơ hội điều trần trước Quốc hội Mỹ về rủi ro của cả frontier model lẫn AI coding. Anh kể lại các khuyến nghị của mình, gồm ba phần.
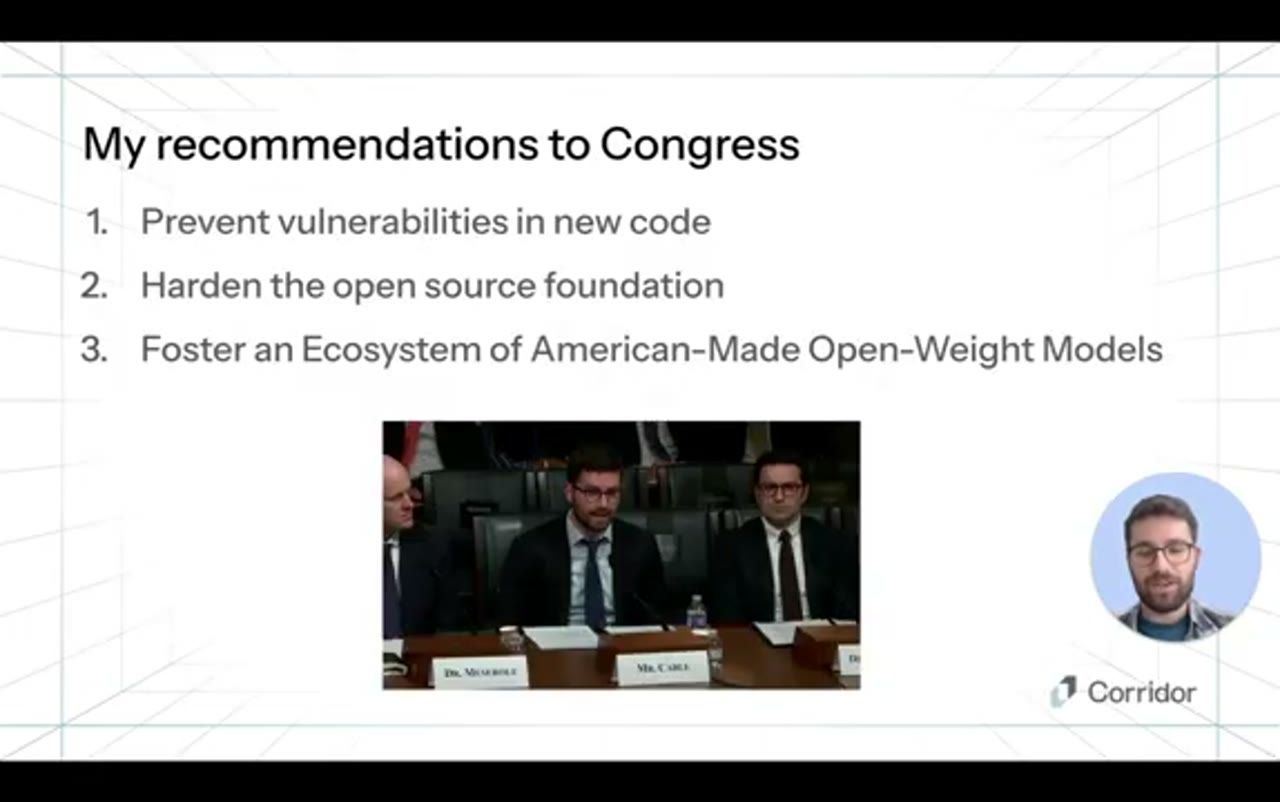
Thứ nhất, ngăn lỗ hổng trong code mới từ nay về sau. Jack cho rằng đây là việc mà mọi công ty, cũng như chính phủ Mỹ, nên tập trung vào: đảm bảo rằng khi tốc độ phát triển tăng lên, security không bị bỏ lại phía sau.
Thứ hai, gia cố nền tảng open source. Điều này cực kỳ quan trọng, đặc biệt vì phần mềm open source sẽ là bãi thử (proving ground) cho rất nhiều kẻ tấn công muốn thử các model này và khai thác những lỗ hổng chúng tìm ra, chính vì bản chất open source của nó: ai cũng có thể chạy một model rất thông minh lên code đó và nhiều khả năng sẽ tìm ra nhiều lỗ hổng mới. Vì thế, theo Jack, cả chính phủ Mỹ lẫn các công ty tư nhân đều có trách nhiệm góp tay gia cố nền tảng này. Và như anh đã nói, đây không chỉ là chuyện phát hiện hay vá từng lỗ hổng riêng lẻ. Nó phải mang tính hệ thống hơn, và bắt đầu đi vào những cuộc rewrite có thể giảm tận gốc rủi ro lỗ hổng bị tìm ra, dù bởi model hôm nay hay model trong tương lai.
Thứ ba, nuôi dưỡng một hệ sinh thái open weight model do Mỹ làm ra. Jack cho rằng để giữ được năng lực cạnh tranh, không thể chỉ dựa vào closed weight model. Có nhiều lý do. Một trong số đó là với nhiều công ty, closed weight model có chỗ đứng của nó, nhưng bạn cũng có thể muốn làm những việc như fine-tuning model, và việc đó chỉ làm được với open weight model. Vì vậy anh thấy thực sự thiết yếu là phải có những frontier open weight model đến từ Mỹ. Tới nay chúng ta chưa thấy nhiều, nhưng anh coi đó là một yếu tố then chốt cho năng lực cạnh tranh của Mỹ trong AI.
14. Kết: quay về những điều cơ bản
Đó là các khuyến nghị tổng thể của Jack. Và tất nhiên, tất cả nằm trong bối cảnh những model ngày càng mạnh. Theo anh nhớ, buổi điều trần diễn ra vài ngày trước khi Mythos và Fable ra mắt, rồi sau đó là toàn bộ các động thái export controls đã được đưa ra.
Đây là một lĩnh vực thay đổi cực kỳ nhanh. Nhưng chính vì vậy, theo Jack, lại càng quan trọng hơn để quay về những điều cơ bản: đâu là những biện pháp kiểm soát nền tảng (fundamental controls) có thể bảo vệ ta trước bất kỳ lỗ hổng nào mà model hôm nay hay model tương lai có thể tìm ra? Anh cho rằng đó mới là chỗ chúng ta thật sự nên dành thời gian, dùng chính những model này để làm cho hệ thống của mình resilient hơn.
Jack kết thúc talk, nói rằng anh rất sẵn lòng nhận liên hệ từ mọi người, và cảm ơn tất cả đã theo dõi.
Nguồn và link
- Corridor: corridor.dev · trang diễn giả Jack Cable: ai.engineer/speakers/jack-cable
- CISA Secure by Design: cisa.gov/securebydesign · tài liệu Secure by Design
- CISA Known Exploited Vulnerabilities Catalog: cisa.gov/known-exploited-vulnerabilities-catalog
- MITRE CWE Top 10 KEV Weaknesses: cwe.mitre.org
- Google Security Blog, "Memory Safe Languages in Android 13": security.googleblog.com
- BaxBench: baxbench.com
- Stack Overflow Developer Survey 2025: survey.stackoverflow.co/2025
- Axios, "Cyber leaders defend Anthropic's banned model" (Sam Sabin, 14/06/2026)
- Jack Cable trên X: x.com/jackhcable · LinkedIn: linkedin.com/in/jackcable
Related talks
SWE-Marathon: Evaluating Coding Agents at Billion-Token Scale
Rishi Desai · Abundant AI · 13 min
Benchmark 20 task cỡ project cho coding agent: agent tốt nhất chỉ đạt 26%, và vì sao verifier đa kênh, CUA, anti-cheat là nút thắt thật.
What if the harness mattered more than the model?
Aditya Bhargava · Etsy · 32 min
Cùng model, cùng task, chỉ nâng harness qua bảy nấc bằng ngôn ngữ Agency: tool, handler, PFA, feedback loop, subagent và self-optimization với GEPA.
Recursive Coding Agents
Raymond Weitekamp · OpenProse · 24 min
Áp nguyên lý recursive language model (RLM) vào coding agent: rubric RLM, Y-Pi, Claude Code dynamic workflows và OpenProse để agent đáng tin cậy hơn.