Biến hội thoại cũ với coding agent thành bản nâng cấp cho chính nó
Dùng các file hội thoại Claude Code trên máy, một prompt hoặc bảng trên Databricks với Genie, để tìm lỗi lặp lại và sửa rules, settings, hook.
✓ Đã duyệt độc lập · cập nhật 18/10/2026 · 17 min
1. Mỏ vàng dữ liệu bạn đang bỏ quên
Video được thực hiện cùng Databricks.
Cole Medin mở đầu bằng một khẳng định: dù bạn dùng coding agent nào, ví dụ Claude Code, và dùng nó vào việc gì, thì vẫn có một mỏ vàng dữ liệu mà nhiều khả năng bạn chưa hề khai thác. Trong video này anh chỉ cách dùng nguồn dữ liệu đó để coding agent tốt dần lên theo thời gian, và theo anh, việc này thật ra không tốn mấy công sức của bạn.
Dữ liệu anh nói tới rất đơn giản: chính là các cuộc hội thoại giữa bạn và coding agent. Mỗi cuộc hội thoại đều được lưu thành một file trên máy tính, coding agent nào cũng vậy. Với Claude Code, chúng được lưu dưới dạng file JSONL.
Dù bạn có để ý hay không, nhiều khả năng coding agent của bạn đã từng tự lục qua những file này. Cole kể rằng ngay cả khi bạn đã cài một hệ thống memory nào đó, mỗi lần bạn hỏi về một cuộc hội thoại cũ, agent vẫn thích tìm vào các file này, vì chúng chứa rất nhiều thông tin. Toàn bộ mục đích của video là tận dụng chúng, và anh sẽ nói cách làm.
databricks-demo, nơi anh làm toàn bộ phần demo của video.2. Bên trong một file JSONL
Vấn đề là những file này giàu thông tin tới mức gây choáng. Cole đoán rằng nếu bạn từng mở một file ra xem, có lẽ bạn đã cuộn qua cuộn lại rồi tự hỏi: làm sao mình dùng được thứ này vào việc gì có ích? Câu trả lời là phần anh trình bày ngay sau đây.
Với những file "tuyệt đẹp" này, bạn có thể nhìn lại hàng trăm, thậm chí hàng nghìn cuộc hội thoại cũ với coding agent. Mỗi file của một cuộc hội thoại chứa mọi prompt bạn đã gửi, mọi tool hoặc MCP server mà agent đã dùng, và mọi suy nghĩ của nó trong quá trình làm việc.
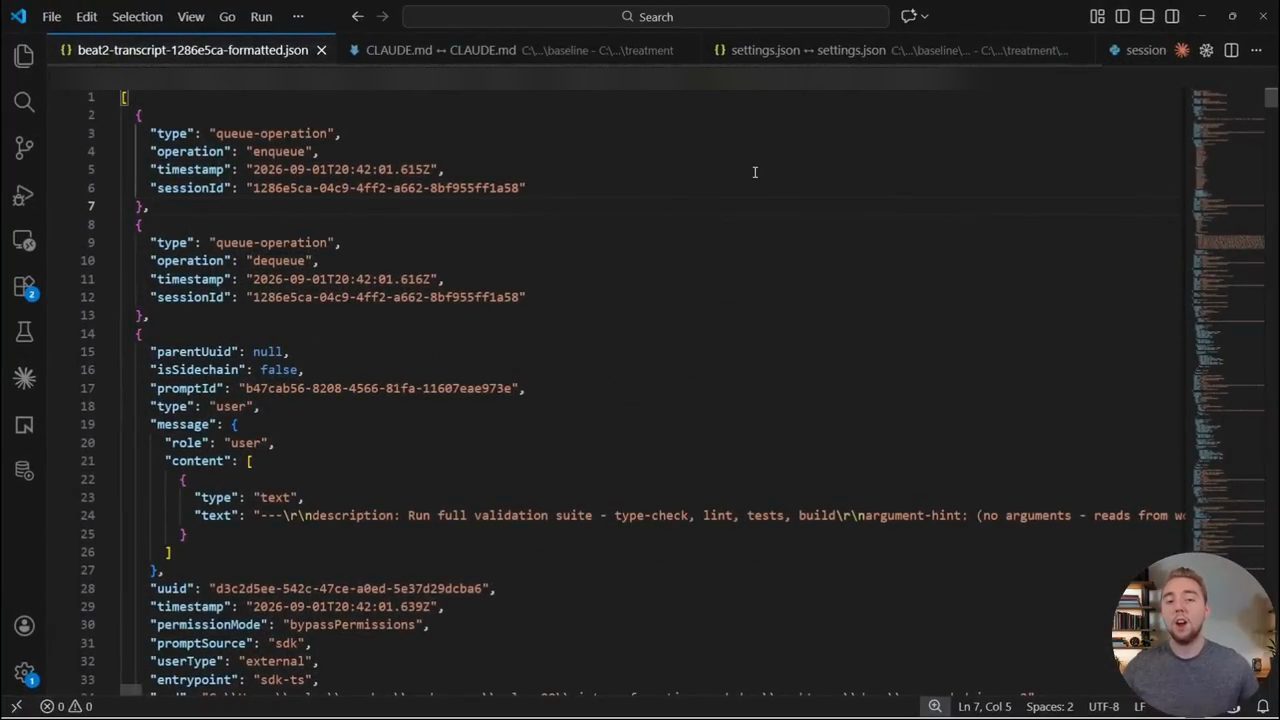
queue-operation (enqueue, dequeue) kèm timestamp và sessionId, rồi tới tin nhắn của người dùng với role, content, permissionMode và nhiều trường khác. Mỗi phiên là hàng nghìn bản ghi như thế.3. Từ hội thoại cũ tới insight
Ý tưởng của Cole là lấy toàn bộ dữ liệu đó, rút ra những phần đáng giá, đưa vào một dạng bảng có cấu trúc, rồi bắt đầu khai thác insight. Ví dụ, bạn có thể tìm ra cơ hội để coding agent tiết kiệm token hơn, hoặc phát hiện những lỗi hay lặp lại để xử lý bằng cách sửa rules hay skill. Anh nói trí tưởng tượng của bạn có thể chạy rất xa với đủ kiểu cách tận dụng các cuộc hội thoại cũ, và dĩ nhiên là dùng chính coding agent để giúp bạn làm việc đó.
Anh gọi đây là "trái chín ở cành thấp", vì đầu vào của quy trình chỉ là các cuộc hội thoại bạn đã có sẵn, nằm trên máy của bạn. Không cần gì thêm. Đầu ra là những insight để coding agent tốt hơn. Nói cách khác, chúng ta dùng AI coding assistant để học từ những sai lầm cũ, giúp chính nó hiệu quả và đáng tin cậy hơn.
4. Hai thứ cần có: chỗ lưu lâu dài và một database
Để quy trình chạy tốt, theo Cole cần hai thứ. Thứ nhất là một chỗ lưu các file hội thoại lâu dài, vì nếu không thì Claude Code mặc định sẽ dọn chúng đi sau 30 ngày (theo video đăng ngày 25/09/2026). Thứ hai là một database để có cấu trúc. Như bạn vừa thấy, các file JSONL rất lộn xộn, và anh nói với các coding agent khác cũng không khá hơn.
Có database rồi, bạn có thể tách dữ liệu ra thành các bảng có cấu trúc, chỉ giữ thông tin cần dùng: đây là bảng các phiên làm việc (sessions), đây là toàn bộ tool call agent đã thực hiện qua mọi cuộc hội thoại, đây là các lượt (turn) của agent. Cole sẽ chỉ cách dựng việc này trên Databricks, một nền tảng anh rất thích dùng và gọi là giải pháp miễn phí anh ưng nhất cho mọi thứ trong video. Dĩ nhiên còn rất nhiều cách khác để rút dữ liệu từ các cuộc hội thoại và lấy insight; đây chỉ là cách chạy tốt nhất với anh.
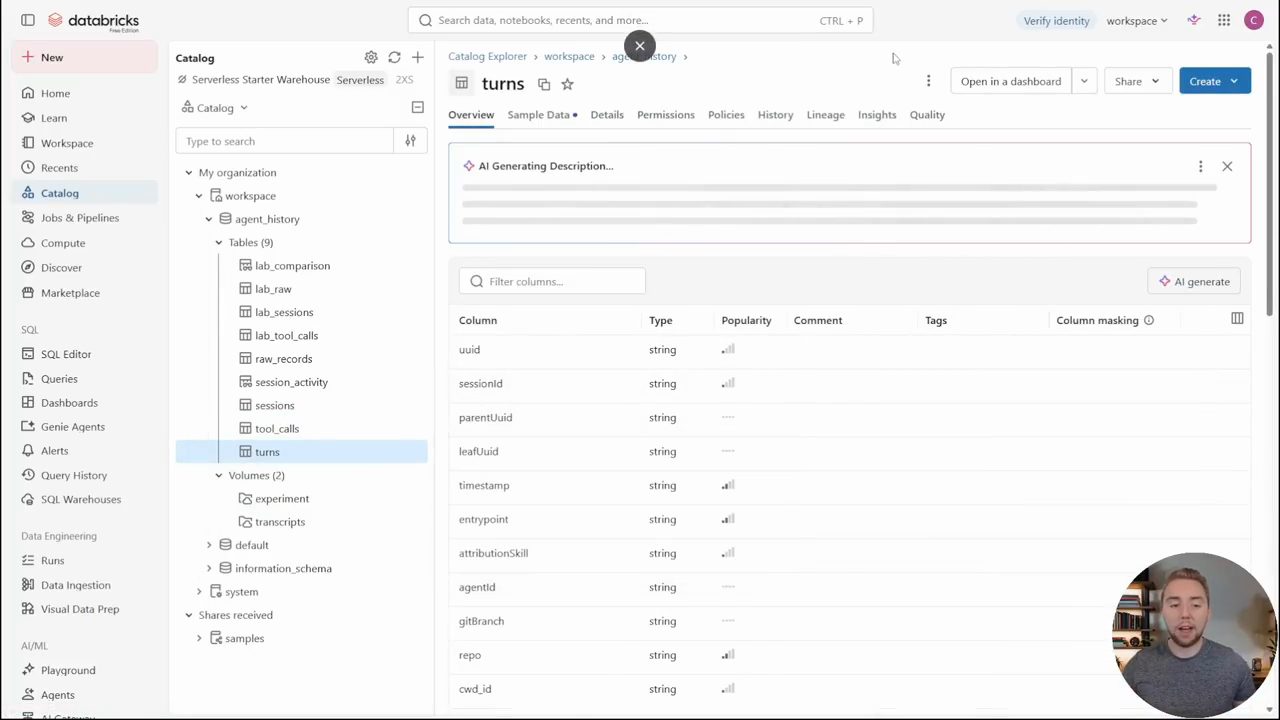
agent_history có 9 bảng (trong đó có sessions, tool_calls, turns) và 2 volume. Bảng turns đang mở với các cột như uuid, sessionId, parentUuid, timestamp, attributionSkill, gitBranch, repo.5. Cách đơn giản nhất: một prompt
Cole bắt đầu với cách dễ nhất. Anh nói rõ đây không phải cách tốt nhất, đó là lý do anh còn muốn chỉ quy trình với các bảng có cấu trúc. Nhưng nếu bạn muốn bắt đầu thật đơn giản thì chỉ cần vào coding agent và gõ vài câu: hãy đào sâu vào các cuộc hội thoại cũ để tìm cơ hội giúp coding agent như Claude Code hiệu quả hơn hoặc đáng tin cậy hơn, rồi đề xuất 10 cải tiến hàng đầu dưới dạng gạch đầu dòng ngắn gọn. Trên màn hình, prompt anh gửi là:
Okay great, do a deep dive into these conversations to identify opportunities to make Claude Code more efficient or reliable. Suggest the top 10 improvement opportunities in a concise bullet point list.
Bạn không cần prompt y hệt anh. Anh thêm giới hạn "top 10" để agent không tuôn ra hết đề xuất này tới đề xuất khác. Anh kể rằng nhất là trước Opus 5.5, Opus 5 thường đưa cho anh cả triệu thứ gần như chẳng quan trọng gì, nên anh thích khoanh rất rõ phạm vi đầu ra. Chỉ vậy là đủ để bắt đầu, cực kỳ dễ.
Trước đó trong cùng cuộc hội thoại, anh còn cho thấy coding agent biết hội thoại của chính nó nằm ở đâu. Chỉ cần hỏi:
Where are all Claude Code conversations stored on my machine?
Claude Code chỉ ra đúng thư mục chứa các file JSONL mà anh cho xem lúc đầu, nằm trong .claude\projects\ của tài khoản người dùng, chia theo từng project bạn làm với coding agent: mỗi thư mục làm việc một thư mục con, mỗi phiên một file .jsonl. Trên máy anh lúc đó có 531 thư mục project, 3.967 file .jsonl, tổng cộng 3,1 GB. Claude Code còn nhắc rằng các file này không tồn tại mãi: file hội thoại cũ hơn cleanupPeriodDays (mặc định 30 ngày) sẽ bị xoá. Hoặc bạn tìm *.jsonl trong thư mục đó là thấy hết các file, và có thể copy toàn bộ nếu muốn.
Quay lại Claude Code, khi nhận prompt, nó bắt đầu bằng việc nạp một skill Cole tự viết cho đúng quy trình này. Anh nhắc lại: đây là cách đơn giản, không hiệu quả nhất và không tiết kiệm token nhất, nhưng nếu bạn muốn điểm xuất phát dễ nhất thì anh để link skill trong phần mô tả video, và bạn chỉ cần gửi một prompt như trên. Agent sẽ chạy vài lệnh shell để đọc các file này và tìm ra những lỗi phổ biến.
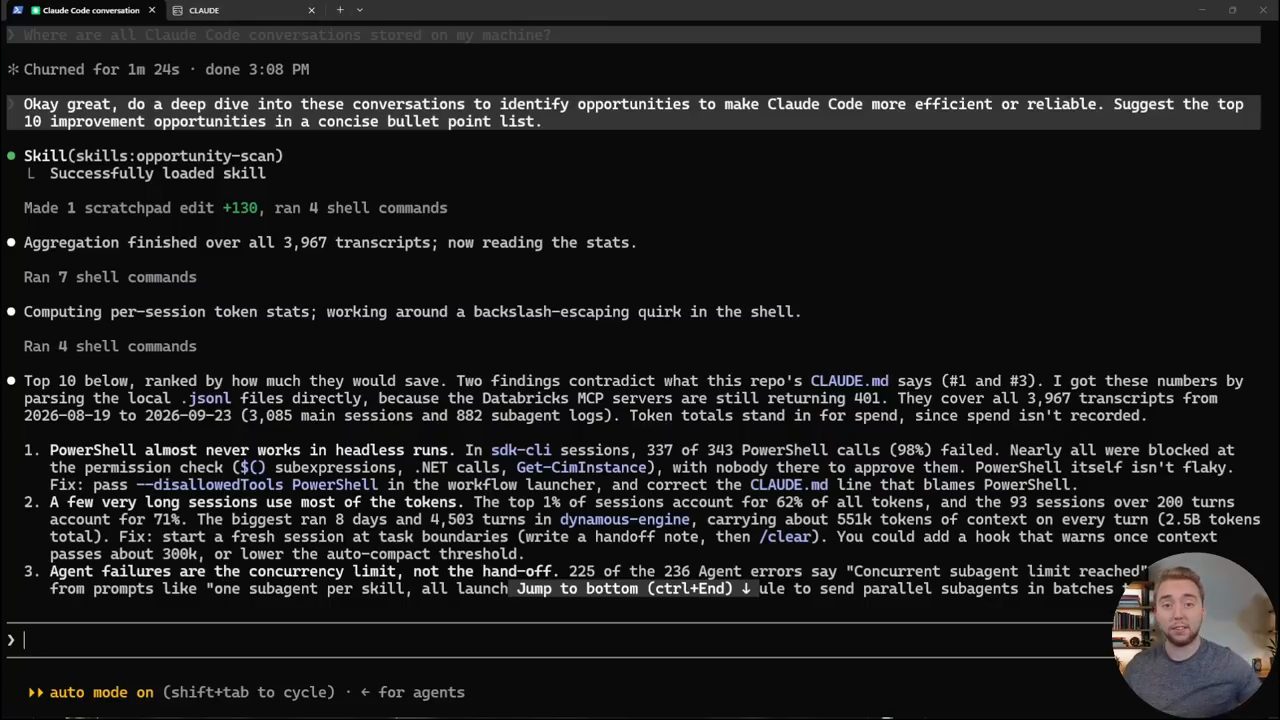
opportunity-scan, tổng hợp trên 3.967 file hội thoại từ 19/08 tới 23/09/2026 (3.085 phiên chính và 882 log của subagent), rồi xếp hạng theo mức tiết kiệm: PowerShell gần như luôn hỏng trong các lần chạy headless (337 trên 343 lệnh, 98%), 1% số phiên dài nhất ăn 62% tổng token, và lỗi của Agent thật ra là do giới hạn chạy song song (225 trên 236 lỗi ghi "Concurrent subagent limit reached").6. Từ một lỗi tới một thay đổi trong AI layer
Claude Code liệt kê top 10, và từ đó Cole có thể hỏi tiếp: dựa trên lỗi này hay lỗi kia, mình nên đổi gì trong AI layer, tức hook, skill hay rules, để không gặp lại nó hết lần này tới lần khác?
Ví dụ với vấn đề thứ ba, agent nói anh chạm giới hạn số subagent chạy đồng thời quá thường xuyên. Đó chắc chắn là vấn đề anh muốn xử lý, và bước tiếp theo đơn giản là hỏi:
What could we change in our AI layer to fix #3?
Cole giải thích rằng định nghĩa "AI layer" của anh đã được viết sẵn trong skill. Vì vậy agent hiểu nó đang tự kiểm tra (self audit) các subagent, hook, rules và skill của mình, tức mọi thứ bạn đã dựng trong global rules hoặc thư mục .claude.
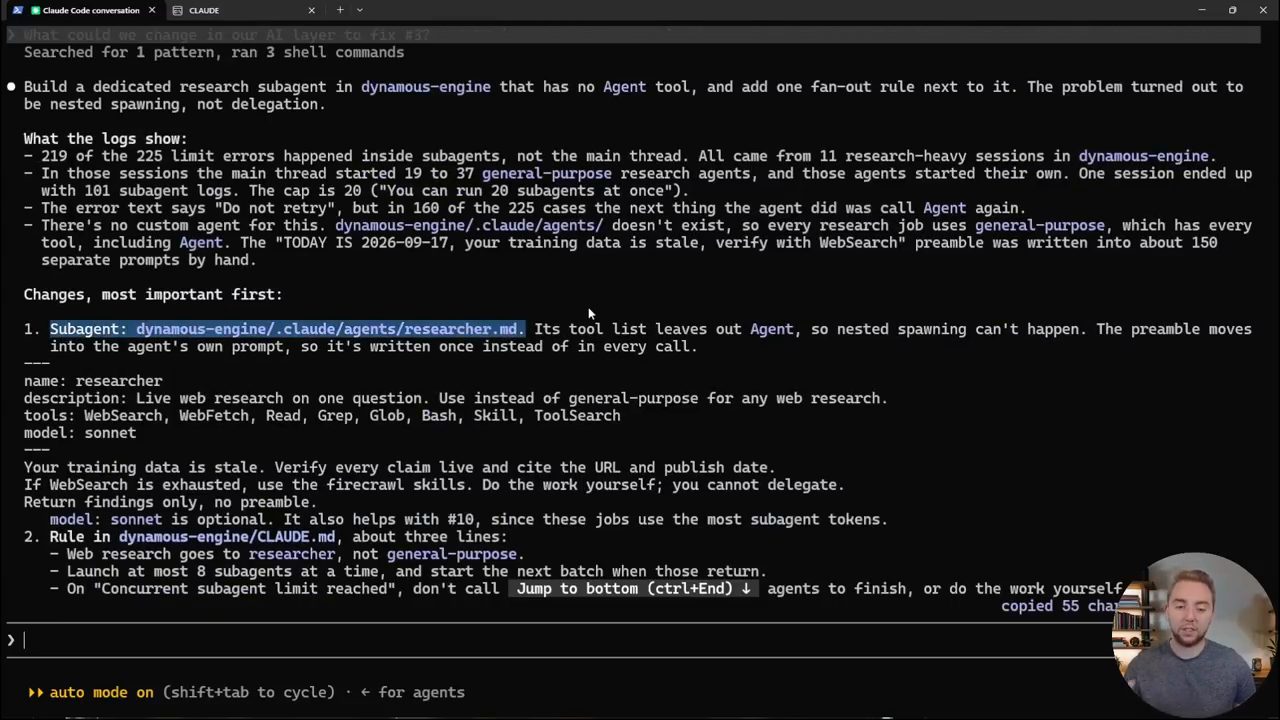
researcher mới, có tool list không gồm Agent nên không thể sinh agent lồng nhau, kèm một rule chỉ chạy tối đa 8 subagent một lúc.Ở đây nó đề xuất sửa một subagent cụ thể và chỉ ra "thủ phạm". Giả sử nó đúng, bạn áp thay đổi, và các cuộc hội thoại sau sẽ không gặp lại vấn đề số 3. Phần còn lại là tuỳ bạn: tiếp tục làm việc với coding agent và theo dõi xem vấn đề có thật sự được giải quyết hay không. Ở mức đơn giản nhất, đó là cách tận dụng hội thoại cũ để các cuộc hội thoại sau tốt hơn.
7. Vì sao cách đơn giản không đủ
Giờ tới hệ thống thật. Vấn đề của cách đơn giản, dù nó là điểm khởi đầu tốt, là chúng ta bắt coding agent đọc hàng trăm nghìn token, lội qua những file JSONL khổng lồ như anh cho xem lúc đầu. Nhìn vào danh sách file, hoặc agent phải đọc hết mọi thứ để thấy đúng các pattern, hoặc nó chỉ nhặt vài file và kéo ra những điều nằm trên bề mặt. Cả hai đều không lý tưởng.
Cole cũng nhắc tới các dự án open source khác như ccusage và claude-mem, một hệ thống memory chuyên cho coding agent. Nhưng theo anh, cả hai, và thật ra không có gì khác anh từng thấy, nhắm tới việc lưu lại memory với mục đích cụ thể là làm coding agent hiệu quả và đáng tin cậy hơn theo thời gian. Đó là điều anh muốn làm bây giờ với Databricks.
Anh sẽ chỉ cách cài Databricks, dùng miễn phí để dựng bộ dữ liệu có cấu trúc cho các cuộc hội thoại, rồi bắt đầu rút insight. Trong nền tảng Databricks có một agent tên là Genie, và anh sẽ dùng nó để định nghĩa cấu trúc và dựng các bảng. Bạn chỉ cần một cuộc hội thoại với Genie, nó giúp bạn tạo cấu trúc và gom insight, nên bạn không phải làm gì thủ công. Cole nhắc lại rằng dù theo cách này hay cách siêu đơn giản kia, đây vẫn là trái chín ở cành thấp: bạn gần như không phải tự làm gì nhiều, nhất là khi so với giá trị của insight thu được, thứ sẽ giúp bạn tiết kiệm rất nhiều thời gian trong các cuộc hội thoại sau. Anh chọn Databricks vì vốn đã dùng nền tảng này cho việc này, và bản Free Edition của họ có đủ mọi thứ để đi hết quy trình.
8. Cài Databricks CLI và nối vào coding agent
Bước đầu là cài Databricks chỉ bằng vài lệnh và nối nó vào coding agent bạn chọn, để làm việc thật dễ. Bạn cài Databricks CLI, nhờ đó mọi thứ anh làm trên giao diện web đều có thể dựng ngay trên máy. Cole để link trang hướng dẫn cài đặt cho mọi hệ điều hành trong phần mô tả (trang "Install or update the Databricks CLI": macOS dùng Homebrew, Linux dùng curl hoặc build từ source, Windows dùng WinGet, Chocolatey, WSL hoặc build từ source).
Cài xong, bạn nối CLI vào coding agent như Claude Code. Anh dùng lệnh aitools install của Databricks CLI với agent là Claude Code; bạn cũng có thể chọn Pi hay Codex chẳng hạn. Anh cài riêng cho project này, và lệnh cũng có trong phần mô tả. Trên màn hình terminal, lệnh anh chạy là:
databricks aitools install --agents claude-code --scope project
Kết quả là plugin Databricks được cài cho Claude Code, và file .mcp.json của project có thêm hai MCP server databricks-genie và databricks-sql, đều dùng HTTP và xác thực bằng biến DATABRICKS_TOKEN.
Vậy là bạn đã cài xong, đã nối vào coding agent, và giờ có Databricks dưới dạng MCP server. Gần như mọi việc bạn muốn làm trên giao diện, như upload file hội thoại hay tạo bảng có cấu trúc, bạn đều làm được thẳng từ coding agent. Ví dụ trong một cuộc hội thoại Claude Code, anh có thể bảo nó dùng MCP server Databricks Genie để query lịch sử Claude Code. Dĩ nhiên việc này chỉ chạy sau khi đã dựng xong dữ liệu, phần anh sẽ chỉ ngay sau; ở đây anh chỉ muốn cho thấy làm việc với nền tảng này ngay trong coding agent, nơi mình vốn làm việc, dễ thế nào.
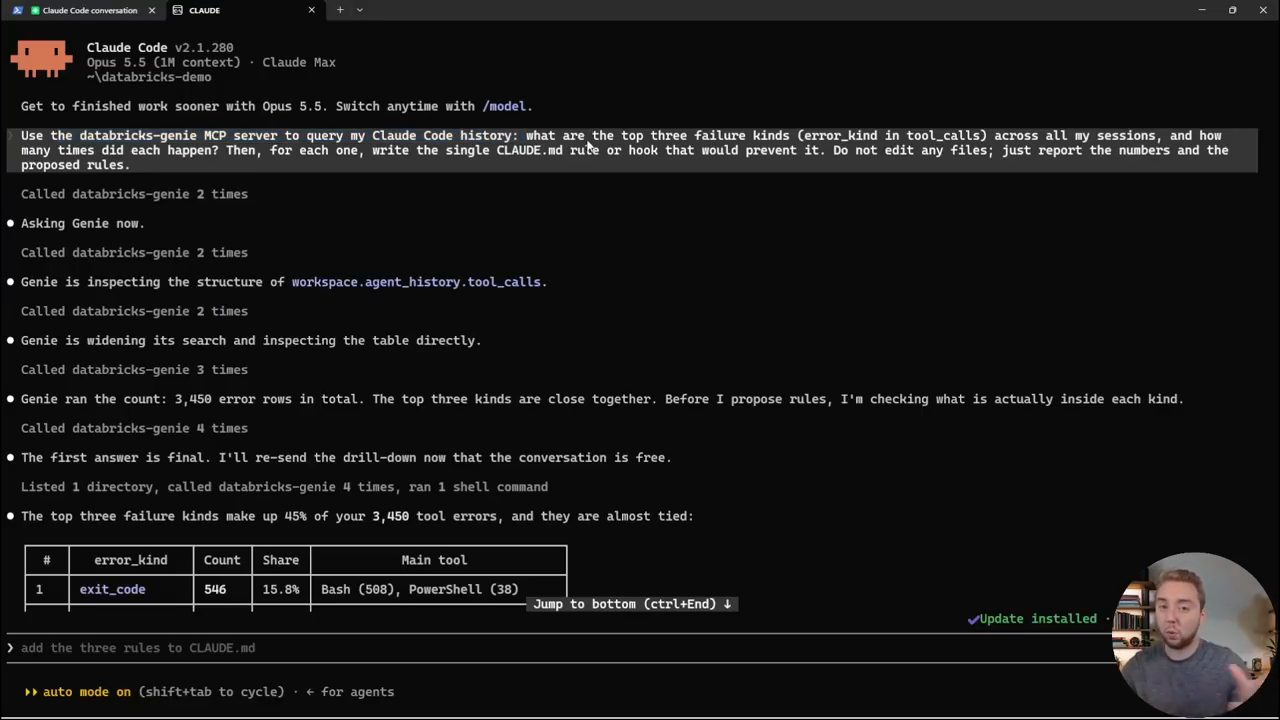
databricks-genie để query lịch sử Claude Code: tìm ba loại lỗi hàng đầu (cột error_kind trong tool_calls), mỗi loại xảy ra bao nhiêu lần, và viết đúng một rule CLAUDE.md hoặc hook để ngăn nó, không sửa file nào. Claude Code gọi Genie nhiều lượt, Genie xem cấu trúc bảng, đếm được 3.450 dòng lỗi rồi xem kỹ từng loại.Đây là cùng kiểu việc như trong demo đơn giản, cho agent đi qua các cuộc hội thoại cũ để tìm lỗi và pattern. Khác biệt là giờ dữ liệu đã có cấu trúc, nên nó tiết kiệm token hơn và quy trình đáng tin cậy hơn nhiều.
Prompt Claude Code trên màn hình:
Use the databricks-genie MCP server to query my Claude Code history: what are the top three failure kinds (error_kind in tool_calls) across all my sessions, and how many times did each happen? Then, for each one, write the single CLAUDE.md rule or hook that would prevent it. Do not edit any files; just report the numbers and the proposed rules.
9. Hỏi Genie thẳng từ CLI
Cole cũng cho xem nhanh rằng bạn có thể dùng thẳng Databricks CLI để hỏi Genie, agent tích hợp sẵn trong nền tảng và có quyền truy cập mọi thứ bạn đã dựng ở đó. Anh chạy lệnh ask và chỉ việc đưa một prompt, giống như với coding agent. Lệnh trên màn hình:
databricks genie ask -s agent-history "Using the tool_calls table, what kinds of failures does my agent hit most? Group the failed tool calls by error_kind, sorted by count, with the share of all failures." --include-sql
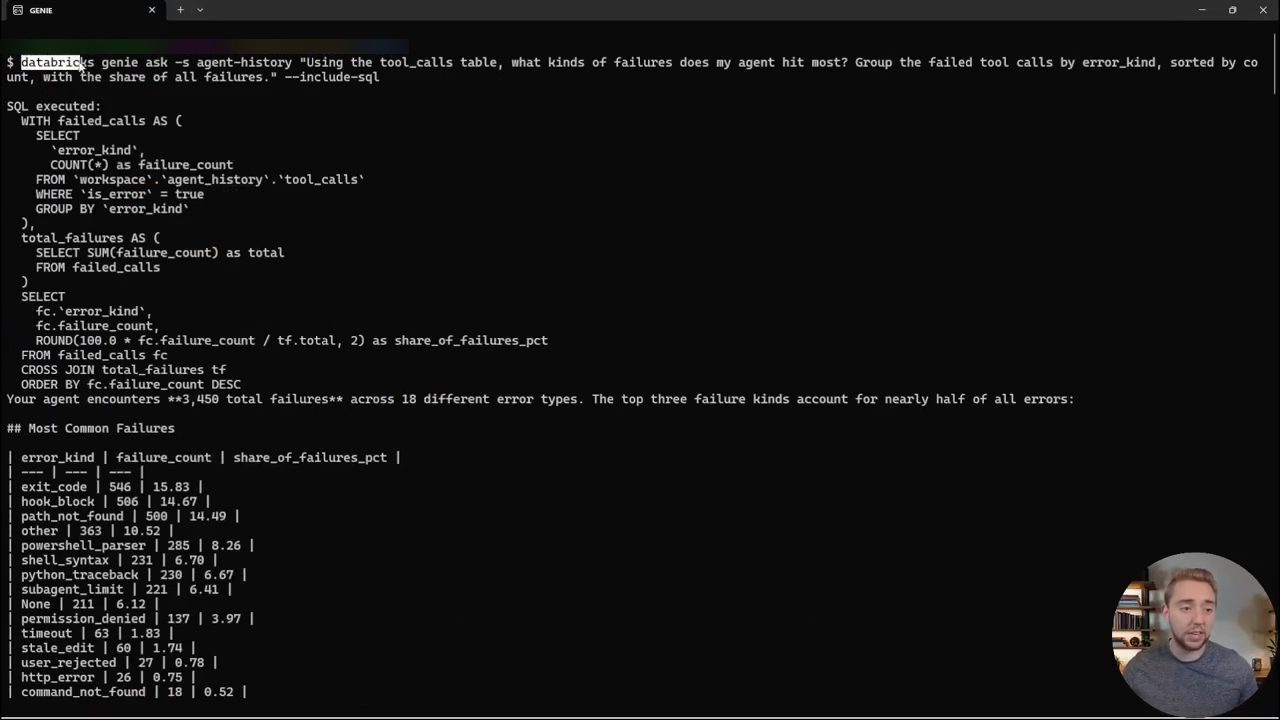
--include-sql, Genie in ra cả câu SQL nó đã chạy (gom các tool call có is_error = true theo error_kind rồi tính phần trăm), sau đó là kết luận: 3.450 lỗi thuộc 18 loại, ba loại đầu chiếm gần một nửa. Đứng đầu là exit_code (546, 15,83%), hook_block (506, 14,67%) và path_not_found (500, 14,49%).Khi đã cài Databricks trên máy và nối vào coding agent, bạn vẫn phải dựng chỗ lưu file hội thoại và các bảng trước. Bạn chưa thể vào hỏi ngay được.
10. Tạo volume và upload các cuộc hội thoại
Trên trang chủ của Databricks Free Edition, Cole vào mục Catalog và bắt đầu bằng việc tạo một volume. Để tiết kiệm thời gian anh đã tạo sẵn một cái, nhưng bạn chỉ cần đi qua quy trình tạo, cực kỳ nhanh. Volume là nơi lưu toàn bộ file hội thoại: bạn upload những cuộc hội thoại muốn dùng từ máy lên ngay tại đây. Ở bước này dữ liệu vẫn còn ở định dạng JSONL.
Thật ra tất cả những gì anh làm ở bước này là bảo coding agent upload thẳng các file vào volume qua MCP server vừa nối. Bạn cũng có thể upload thủ công: mở trình quản lý file, chọn các cuộc hội thoại, kéo thả vào và upload, dễ như vậy. Trong demo này anh upload 62 cuộc hội thoại lớn nhất của mình, để khỏi phải đẩy lên hàng nghìn file, dù bạn hoàn toàn có thể làm vậy nếu muốn.
Điều chính cần lưu ý, và bạn phải chấp nhận được điều này: bạn đang lấy các cuộc hội thoại với coding agent và upload lên một nền tảng hoàn toàn mới. Cole nói Databricks sẽ không train trên dữ liệu của bạn; trên màn hình là điều khoản AI của Databricks, mục 5(c): Databricks không dùng Customer Content, Inputs hay Outputs để train, re-train hay fine-tune các model GenAI mà Databricks cung cấp cho bên thứ ba. Trong phần mô tả video, Cole nói thêm rằng cam kết này nằm trong điều khoản trả phí; bản Free Edition có điều khoản riêng, cho phép Databricks dùng những gì bạn upload để cải thiện dịch vụ và model AI của họ, nên hãy xoá mọi thông tin nhạy cảm trước (hoặc để coding agent làm việc đó).
Theo anh, upload dữ liệu lên đây không thật sự có vấn đề gì, nhất là khi ngay từ đầu bạn đã không nên đưa thông tin nhạy cảm cho coding agent. Đúng là nếu có API key nằm trong các file JSONL thì bạn không muốn upload chúng đi đâu cả, nhưng bạn cũng không nên đưa API key cho Anthropic hay OpenAI hay bất kỳ ai. Nếu các file sạch, không có gì nhạy cảm, bạn cứ upload thẳng. Nếu không, bạn có thể bảo coding agent "lọc" dữ liệu trước khi upload qua MCP. Anh nói lướt qua phần này vì biết nhiều người rất quan tâm.
Khi các cuộc hội thoại đã nằm trong volume là bạn sẵn sàng. Tiếp theo, bấm vào dấu ba chấm của volume và copy đường dẫn của nó, vì bạn sẽ đưa đường dẫn này cho Genie để nó đọc dữ liệu ở đó và tạo bảng có cấu trúc. Copy xong, bạn vào Workspace và tạo một notebook mới. Genie sẽ tự viết code để chạy thẳng trong môi trường Databricks của bạn.
11. Genie đọc dữ liệu và dựng bảng
Cole đã có sẵn một notebook, nên anh mở nó ra để kể lại cách dựng với Genie. Anh bấm nút ở góc trên bên phải để mở Genie, agent có quyền truy cập toàn bộ môi trường Databricks của anh, giống một coding agent "được tăng lực" nằm ngay trong nền tảng.
Anh đưa cho nó đường dẫn volume và yêu cầu xử lý: đọc mọi file JSONL, nhưng bằng Spark. Tức là anh không phải tiêu hàng trăm nghìn token ở đây; nó làm theo một cách rất có cấu trúc. Anh nói rõ đây là bản ghi các phiên Claude Code với schema lồng nhau không nhất quán giữa các bản ghi. Đó cũng là một phần của vấn đề, vì mỗi cuộc hội thoại được format hơi khác nhau, và đó chính là thách thức anh giao cho Genie. Prompt anh gõ cho Genie:
Read every JSONL file in /Volumes/workspace/agent_history/transcripts/ with Spark. These are Claude Code session transcripts with inconsistent nested schemas across records. Show a count of records grouped by the type column, sorted descending, and tell me how many distinct sessions there are.
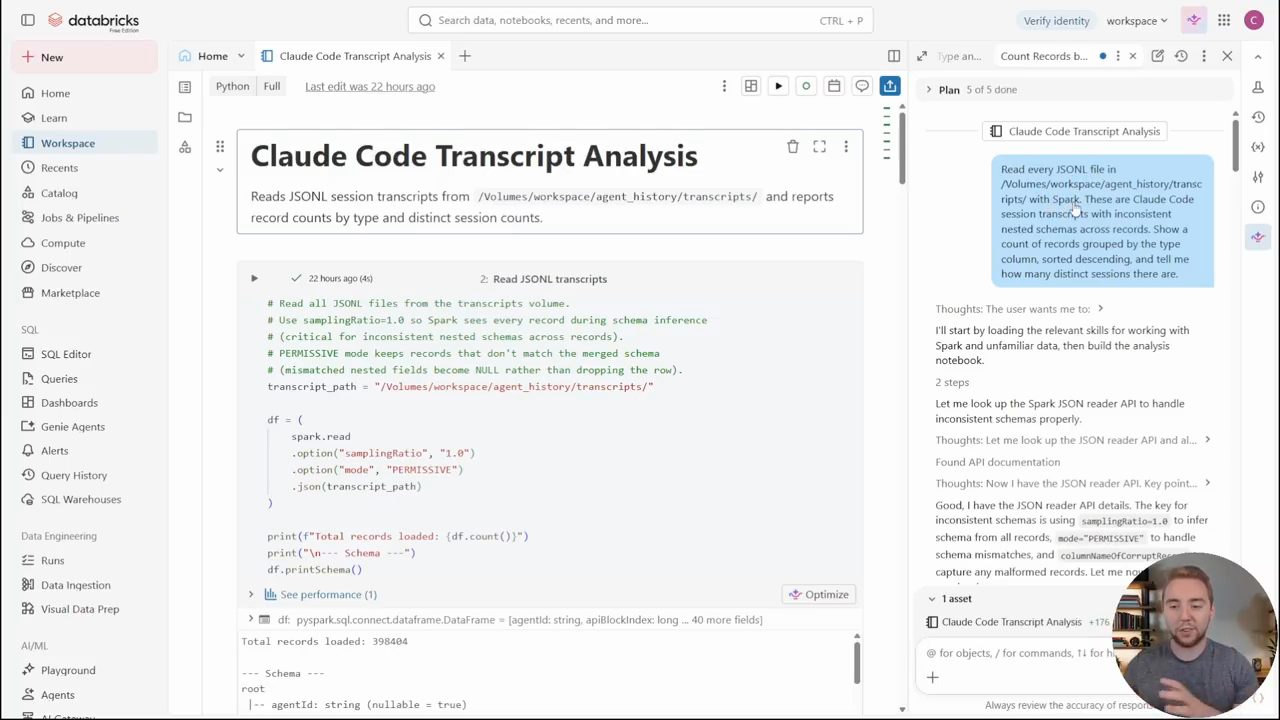
spark.read với samplingRatio 1.0 (để Spark thấy mọi bản ghi khi suy ra schema) và chế độ PERMISSIVE (bản ghi không khớp schema thì giữ lại với giá trị NULL thay vì bỏ). Kết quả đầu tiên: 398.404 bản ghi.Genie làm rất tốt. Nó nắm được cấu trúc tổng quát, hiểu những chỗ không nhất quán, rồi dựa vào đó dựng nên toàn bộ notebook. Cole không viết dòng code nào trong đó; anh nói dạo này anh không bao giờ tự viết code nữa. Genie tạo mọi thứ để xử lý dữ liệu dựa trên lần khảo sát đầu tiên, và cuối cùng đưa tất cả vào các bảng nó dựng. Kéo xuống cuối cuộc hội thoại, bạn thấy từng bảng nó tạo: turns, tool calls và sessions, kèm số bản ghi và các cột của mỗi bảng. Nó không chỉ tạo bảng mà còn đổ dữ liệu từ mọi cuộc hội thoại trong volume vào. Trong lần chạy này, Genie báo 398.404 bản ghi thuộc 2.341 phiên khác nhau; nhiều nhất là bản ghi loại assistant (138.773), user (83.007) và attachment (78.262).
Với quy trình của riêng anh, anh làm hai bước. Đầu tiên anh cho Genie hiểu dữ liệu và chứng minh lại cho anh thấy. Sau đó anh mới prompt nó tạo các bảng có cấu trúc và nạp mọi thứ vào database. Bạn không cần làm theo cách đó; prompt có thể tự do hơn nhiều, kiểu "đây là volume, hãy tạo cho tôi một cấu trúc để rút ra bài học từ các file hội thoại Claude". Muốn gì cũng được, Genie sẽ tự chạy với nó, vì nó có toàn quyền truy cập môi trường của bạn.
Anh không muốn đi sâu vào cách Genie suy luận về dữ liệu và dựng bảng, nhưng anh thấy nó thật sự ấn tượng. Prompt của anh có hơi cụ thể, nhưng anh không hướng dẫn nhiều, và Genie đã làm xuất sắc.
12. Query lịch sử từ Claude Code
Khi Genie đã tạo bảng và nạp dữ liệu hội thoại, bạn quay lại coding agent và dùng MCP server của Databricks để query dữ liệu có cấu trúc, hỏi đúng những câu bạn cần. Ví dụ: bạn thấy những pattern lỗi nào ở đây? Bạn đề xuất đổi gì trong AI layer? Y như trong demo đơn giản.
Lợi thế ở đây là có cấu trúc. Bạn không phải đọc hàng trăm nghìn token file JSONL mỗi lần muốn phân tích. Thêm hội thoại mới vào cũng dễ như ăn bánh, vì đã có pipeline, và lại không phải tốn hàng trăm nghìn token để coding agent làm hộ. Với câu hỏi này, thay vì hàng loạt lệnh shell đọc từng file, Claude Code giờ gọi sang Genie. Genie mới là "bộ não" hiểu dữ liệu và đưa ra insight, còn coding agent chính như Claude Code chỉ đóng vai trò người điều phối (orchestrator), hỏi đúng câu để lấy kết quả từ Genie.
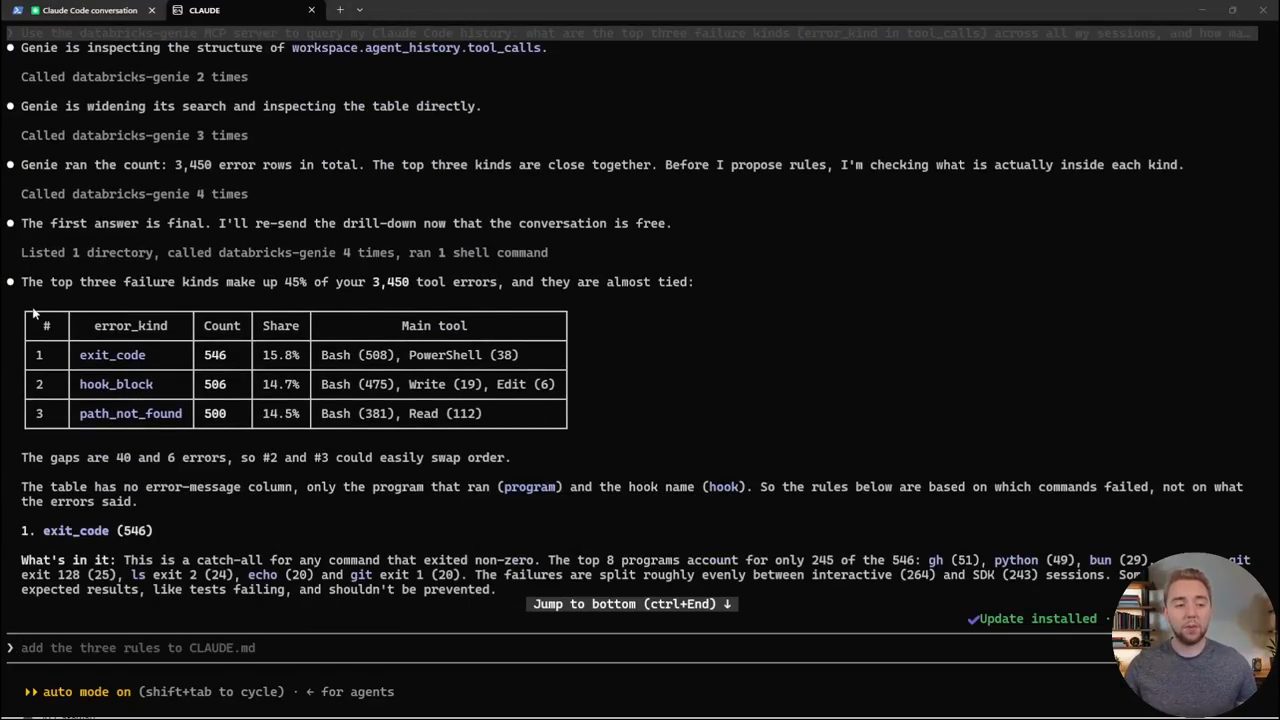
exit_code 546 lần (15,8%, chủ yếu Bash và PowerShell), hook_block 506 lần (14,7%, Bash, Write, Edit), path_not_found 500 lần (14,5%, Bash và Read). Khoảng cách chỉ 40 và 6 lỗi, nên hạng 2 và 3 có thể dễ dàng đổi chỗ.Trong demo của anh, nó tìm ra ba pattern lỗi cốt lõi trên toàn bộ dữ liệu. Genie viết SQL, phân tích bảng rất hiệu quả và rút ra kết quả cực nhanh. Giờ bạn có thể lấy kết quả đó và hỏi Claude Code: mình đổi gì trong AI layer để tránh những lỗi này về sau? Giống hệt ví dụ lúc trước.
Cuối cuộc hội thoại, nó còn đưa một link "Explore in Databricks". Bấm vào, bạn xem được chính cuộc hội thoại với Genie, những gì Claude Code đã giao cho nó, để lấy thêm insight nếu muốn đào sâu. Trên Databricks, câu hỏi Claude Code gửi Genie hiện ra cùng bảng "Top Error Kinds by Count" với tool chính của từng loại lỗi.
13. Thay đổi thật: global rules và settings.json
Điều quan trọng nhất Cole muốn cho xem là những cải tiến anh thật sự đã làm cho AI layer của mình dựa trên cuộc hội thoại này. Anh không làm video để trình diễn một thứ mình chưa tự thử: anh dùng đúng quy trình này để kiểm chứng trong lúc làm video, và trước đó anh cũng đã chạy gần như y hệt quy trình nhiều lần. Anh mở VS Code để cho xem những thay đổi thật trong AI layer anh dùng cho "second brain" của mình, và anh sẽ giữ chúng về sau, vì chúng thật sự có giá trị.
Thay đổi đầu tiên là thêm khoảng 38 dòng vào global rules, xử lý đúng những vấn đề tìm ra nhờ phân tích bằng Genie trên Databricks. Ví dụ: không bao giờ đoán đường dẫn, một việc coding agent thật sự làm rất nhiều nếu bạn không dặn rõ là đừng làm.
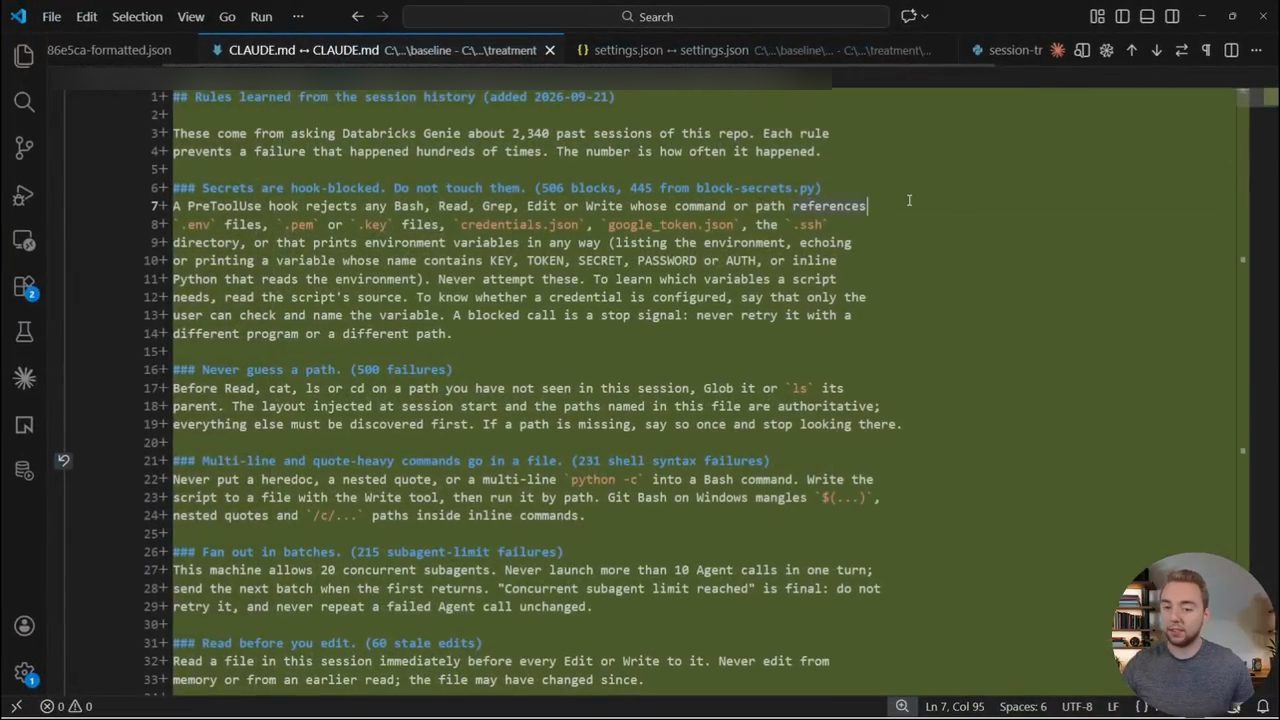
CLAUDE.md: rút từ khoảng 2.340 phiên cũ, mỗi rule kèm số lần lỗi đã xảy ra. Gồm: secret bị hook chặn, đừng động vào (506 lần bị chặn); không bao giờ đoán đường dẫn (500 lỗi); lệnh nhiều dòng hoặc nhiều dấu nháy thì ghi ra file (231 lỗi cú pháp shell); fan out theo đợt, không quá 10 lệnh Agent một lượt (215 lỗi giới hạn subagent); đọc file ngay trước khi sửa (60 lần sửa trên bản cũ).Anh cũng thêm một số quyền trong settings.json để agent làm việc với Git thuận hơn.
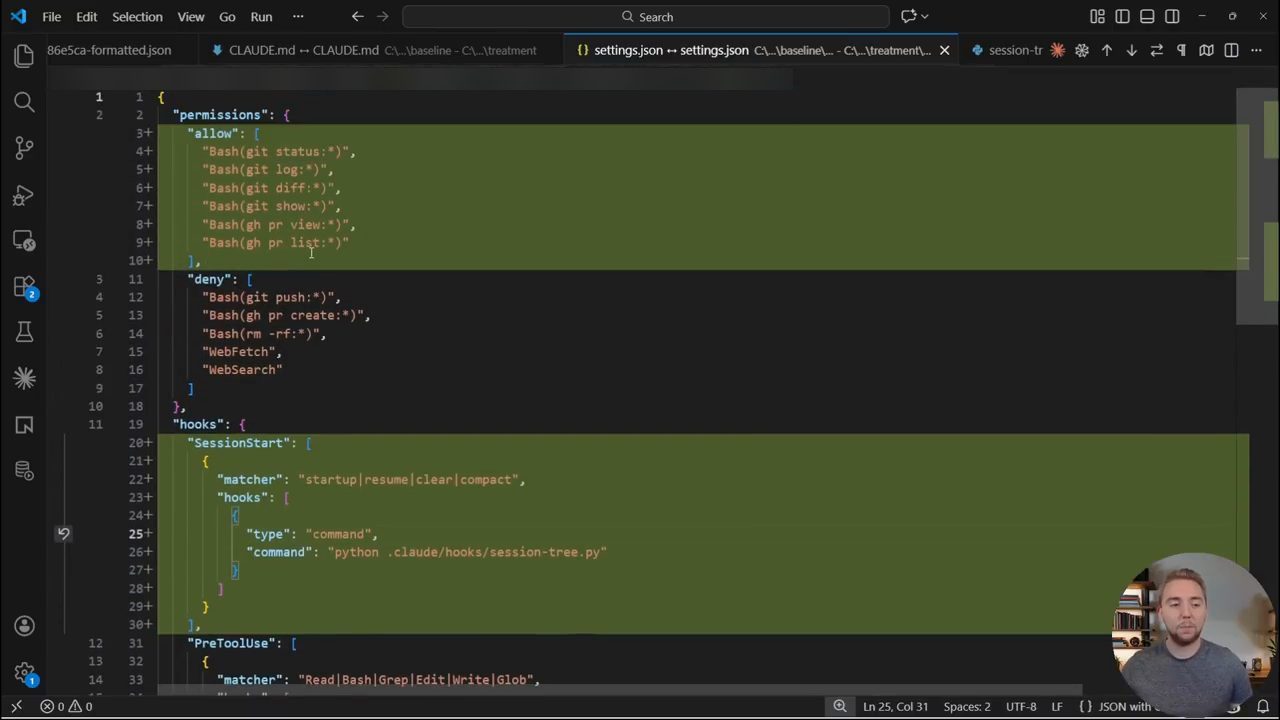
settings.json: danh sách allow cho git status, git log, git diff, git show, gh pr view, gh pr list, và hook SessionStart với matcher startup|resume|clear|compact chạy python .claude/hooks/session-tree.py. Danh sách deny (git push, gh pr create, rm -rf, WebFetch, WebSearch) nằm ngay bên dưới.14. Hook session tree: đưa layout repo vào mỗi phiên
Thay đổi cuối là một hook, phần Cole thích nhất trong số các thay đổi cho AI layer. Đó là "session tree", một script chạy mỗi khi anh bắt đầu cuộc hội thoại mới với coding agent. Nó đưa layout thật của repository vào ngay đầu phiên, để agent ít đoán đường dẫn hơn khi đọc file và thu thập context.
Anh thấy cái hay nằm ở chỗ nó động. Nhiều người thích ghi layout của codebase vào global rules, nhưng khi đó bạn phải cập nhật liên tục và nó luôn có nguy cơ bị lỗi thời. Còn ở đây, context về cấu trúc file được thu thập lại và đưa ngay vào coding agent mỗi khi bắt đầu một cuộc hội thoại mới.
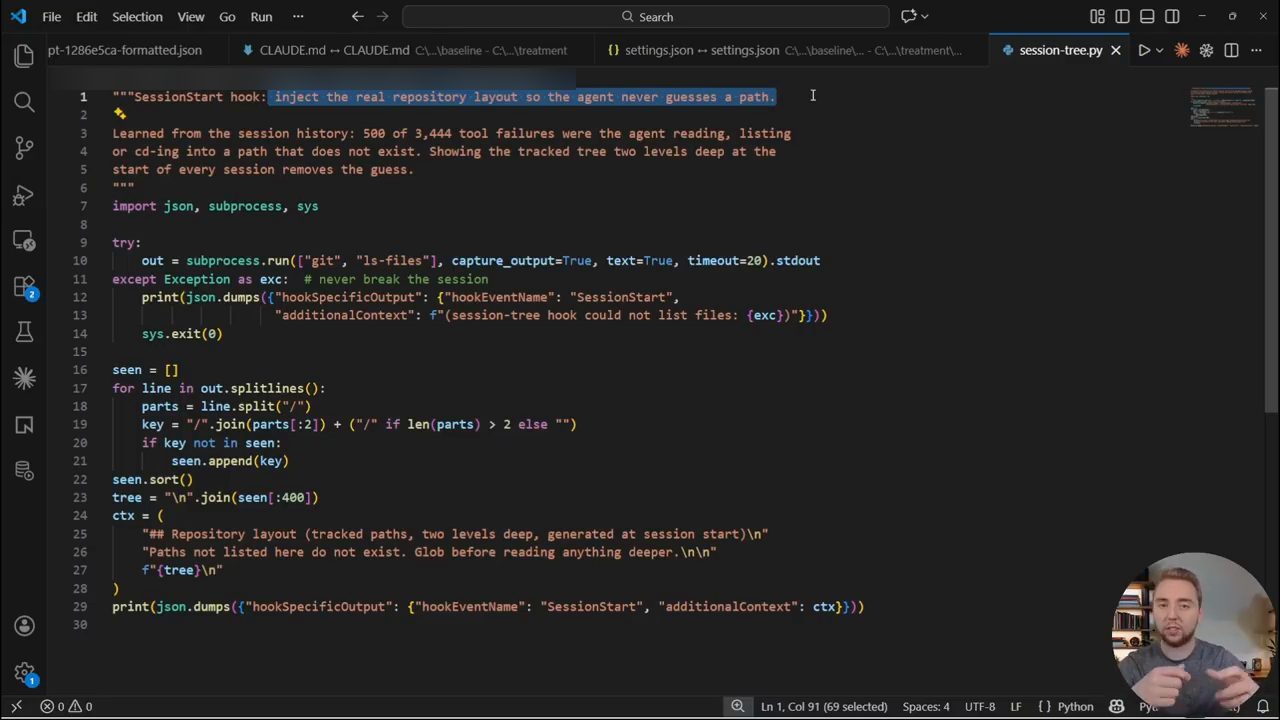
session-tree.py: docstring ghi rằng 500 trên 3.444 tool failure là do agent đọc, liệt kê hoặc cd vào một đường dẫn không tồn tại, và việc cho thấy cây file được git theo dõi, sâu hai cấp, ở đầu mỗi phiên sẽ xoá bỏ việc đoán.Nội dung script trên màn hình:
"""SessionStart hook: inject the real repository layout so the agent never guesses a path.

Learned from the session history: 500 of 3,444 tool failures were the agent reading, listing
or cd-ing into a path that does not exist. Showing the tracked tree two levels deep at the
start of every session removes the guess.
"""
import json, subprocess, sys

try:
    out = subprocess.run(["git", "ls-files"], capture_output=True, text=True, timeout=20).stdout
except Exception as exc:  # never break the session
    print(json.dumps({"hookSpecificOutput": {"hookEventName": "SessionStart",
                      "additionalContext": f"(session-tree hook could not list files: {exc})"}}))
    sys.exit(0)

seen = []
for line in out.splitlines():
    parts = line.split("/")
    key = "/".join(parts[:2]) + ("/" if len(parts) > 2 else "")
    if key not in seen:
        seen.append(key)
seen.sort()
tree = "\n".join(seen[:400])
ctx = (
    "## Repository layout (tracked paths, two levels deep, generated at session start)\n"
    "Paths not listed here do not exist. Glob before reading anything deeper.\n\n"
    f"{tree}\n"
)
print(json.dumps({"hookSpecificOutput": {"hookEventName": "SessionStart", "additionalContext": ctx}}))
Script chạy git ls-files, gom mỗi đường dẫn về tối đa hai cấp thư mục, bỏ trùng, sắp xếp, giữ tối đa 400 dòng, rồi trả về dưới dạng additionalContext của sự kiện SessionStart, kèm lời dặn rằng đường dẫn không có trong danh sách là không tồn tại và phải Glob trước khi đọc sâu hơn. Nếu không liệt kê được file, nó vẫn thoát êm để không làm hỏng phiên.
Cole tóm lại: đó là vài thay đổi khá hay và thiết thực cho AI layer của anh, tất cả nhờ insight thu được từ những gì anh dựng trên Databricks. Anh biết các ví dụ này rất gắn với hệ thống riêng của anh, nhưng anh muốn đưa ra vài ý tưởng thật, vài ví dụ thật về cách làm coding agent tốt dần lên bằng việc nhìn lại các cuộc hội thoại cũ.
15. Lời kết
Vậy là xong: đó là cách dùng Databricks và agent Genie của họ để coding agent của bạn tốt dần lên theo thời gian. Thông điệp lớn của video là các cuộc hội thoại cũ với coding agent là một mỏ vàng. Có rất nhiều cách để cấu trúc chúng, rút insight và hành động dựa trên insight đó; Cole chỉ muốn đưa ra một quy trình trọn vẹn từ đầu tới cuối.
Cuối video, anh mời người xem bấm like và subscribe nếu muốn xem thêm về AI coding.
Nguồn và liên kết 9 nguồn
- Tên gốc: The Biggest AI Coding Agent Upgrade Is Already on Your Machine?!
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=td52e2tQFIU youtube.com
- Kênh YouTube Cole Medin (Cole Medin): youtube.com/channel/UCMwVTLZIRRUyyVrkjDpn4pA youtube.com
- Skill
opportunity-scancủa Cole Medin, bản một prompt đơn giản (quét log phiên của coding agent để tìm thứ nên đưa vào rules, skill, hook, subagent): github.com/coleam00/skills github.com - Hướng dẫn cài hoặc cập nhật Databricks CLI cho mọi hệ điều hành: docs.databricks.com/aws/en/dev-tools/cli/install docs.databricks.com
- Databricks Free Edition: databricks.com/learn/free-edition databricks.com
- claude-mem, hệ thống memory cho Claude Code được nhắc trong video: github.com/thedotmack/claude-mem github.com
- ccusage, công cụ phân tích token và chi phí của các coding agent CLI từ dữ liệu nằm trên máy: github.com/ryoppippi/ccusage github.com
Related talks
Claude Code Skills là gì và cách tạo skill theo 6 bước
Giang · GiangxAI · 29 min
Skill trong Claude Code là gì, khi nào nên xây, 6 bước tạo skill qua demo skill tạo ảnh infographic, CLAUDE.md và ba tầng tải token.
Theo thử skill của Matt Pocock và pstack
Theo Browne · Theo - t3․gg · 38 min
Theo cài và thử skill của Matt Pocock cùng pstack của Lauren Tan, chọn ra những skill đáng giữ và khuyên đọc, chọn, kéo về chứ đừng cài mù.
Người mới nắm 95% Claude Code: từ folder trống tới agentic mode
Mikey · Mikey No Code · 28 min
Workflow Claude Code cho người mới: cài app desktop, scaffold một app, giải thích và sửa code, debug, terminal, CLAUDE.md và agentic mode.