Voice In, Visuals Out: The Agony and the Ecstasy
AI Engineer World's Fair 2026: Online Track · Video gốc
Vì sao voice-in, visuals-out là UX tốt nhất cho AI, và ba trụ cột giữ phản hồi dưới một giây: model nhanh, inference chu kỳ ngắn, prefix caching ổn định.
1. Voice in, visuals out: lập luận của Karpathy
Allen Pike mở đầu bằng lời tự giới thiệu ngắn: anh là Allen Pike, và hôm nay anh sẽ chia sẻ một phần những gì đội của anh đã học được khi build các trải nghiệm voice-in, visuals-out bằng AI, tức là người dùng nói vào, còn hệ thống trả lời bằng hình ảnh và giao diện trên màn hình. "Here we go", và anh vào thẳng vấn đề.
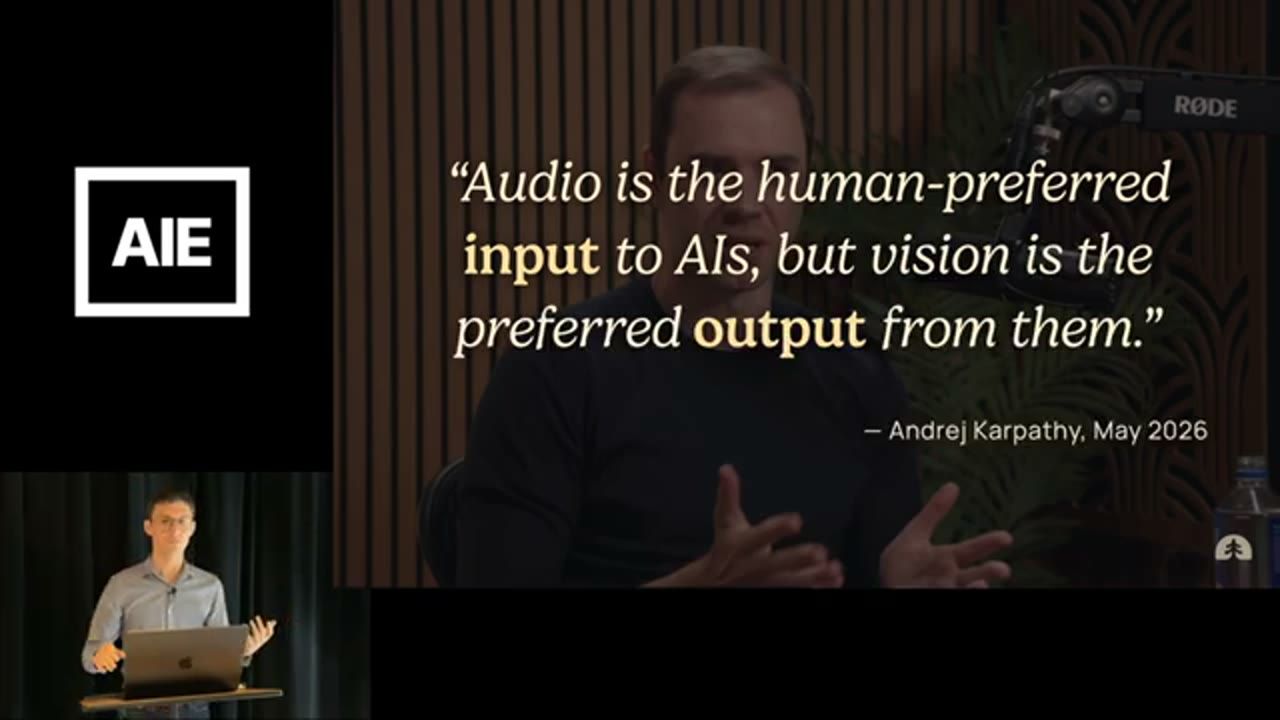
Điểm xuất phát là Andrej Karpathy. Allen kể rằng tháng trước Karpathy đã đưa ra một lập luận: voice là kiểu input con người ưa thích nhất khi làm việc với AI, nhưng visuals mới là kiểu output con người ưa thích. Theo lời Allen, Karpathy "biết đôi điều" về chuyện này, nên lập luận đó đáng được nghe kỹ.
2. Từ dấu nhắc DOS tới markdown: ta vẫn đang gõ phím với AI
Thế nhưng, Allen nói, phần lớn cách chúng ta đang build và dùng AI lại không giống như vậy. Ta gõ phím cho nó. Nó gõ phím đáp lại, có lẽ kèm thêm một chút markdown. Về bản chất, giao diện vẫn là một cuộc trao đổi bằng chữ qua lại.
A>. Hình này đi cùng ý "ta vẫn đang gõ phím với AI".Nhưng vài tháng gần đây đã có những bước đột phá, và trải nghiệm audio-in, visuals-out đã thay đổi hẳn. Trải nghiệm đó giờ đã thật sự khả thi, và ta có thể tạo ra những trải nghiệm rất thú vị, khiến người dùng thích thú (delightful) với nó.
3. Visuals out: trần khả năng đã được nâng lên
Nửa visuals-out thì khá trực quan, Allen nói. Dĩ nhiên rồi: khoảng một phần ba bộ não chúng ta dành cho việc xử lý thông tin thị giác. Chúng ta thích nhìn ngắm mọi thứ.
Và các model gần đây đã đến mức có thể sinh ra HTML phong phú và dùng tool calling, nên ta có thể làm những trải nghiệm trong đó câu trả lời quay về dưới dạng visualization: chúng giải thích sự việc, giúp ta hiểu, và truyền đạt câu trả lời của model. Model còn có thể đưa ra các control tương tác, cho phép ta khám phá, hiểu, chỉnh sửa, thay đổi và điều hướng model. Và chúng thậm chí có thể trả lời bằng những hình minh hoạ và hình ảnh đẹp.
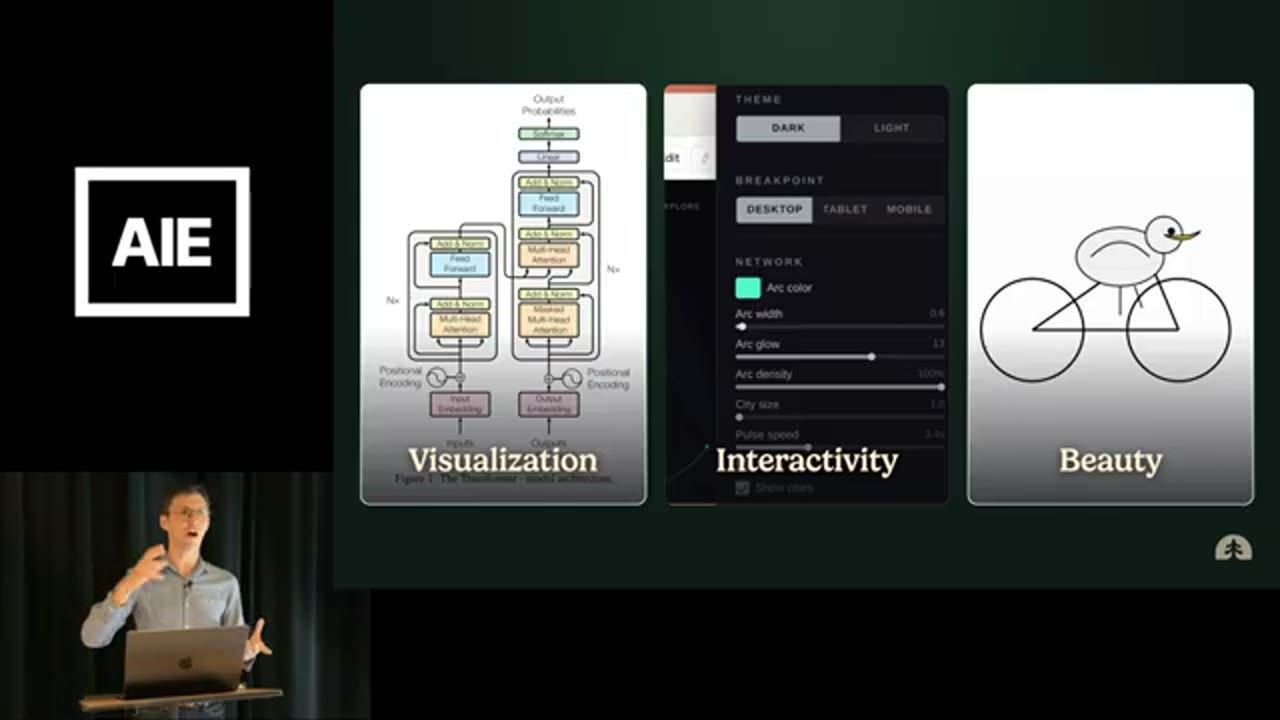
Vì vậy, theo Allen, trần khả năng của phần visuals-out đã thật sự được nâng lên, và ta có nhiều năng lực hơn hẳn về những gì có thể làm khi trả lời người dùng từ các model này.
4. Voice in: nửa gây tranh cãi
Nửa còn lại trong lập luận của Karpathy thì gây tranh cãi hơn: ý tưởng rằng voice là input được ưa thích. Từ lâu chúng ta đã lý tưởng hoá và mơ mộng về việc nói chuyện với một AI, có một cuộc hội thoại real-time trong đó nó hiểu ta cần gì và phản ứng phù hợp ngay lập tức.
Nhưng trải nghiệm mà hầu hết mọi người từng có với giao diện giọng nói cho tới giờ thì giống như cố bảo Siri bật đèn mà nó không chịu làm. Hoặc giống như anh chàng này, Allen chỉ lên slide và cười: một người đang cố khiến ChatGPT voice mode làm việc gì đó, nhưng nó cứ lóng ngóng và bối rối. Slide lúc đó là một dãy video ngắn mạng xã hội hàng triệu lượt xem, trong đó cùng một người cầm điện thoại thử các phản ứng của AI.
Các model mà ta có cho tới nay, và những trải nghiệm mà phần lớn mọi người từng thấy, vừa chậm vừa ngốc. Allen nhận xét đó không phải là một sự kết hợp hay ho gì. Và vì thế rất nhiều người đang có cái nhìn tiêu cực về voice như một kiểu input.
5. Nói là kênh băng thông cao nhất của con người
Tuy vậy, Allen khẳng định, nói vẫn là cách giao tiếp tối thượng của con người. Khi nói, ta đưa ra được nhiều từ mỗi phút hơn khi gõ phím, nhưng ta còn truyền tải được nhiều hơn trong mỗi từ.
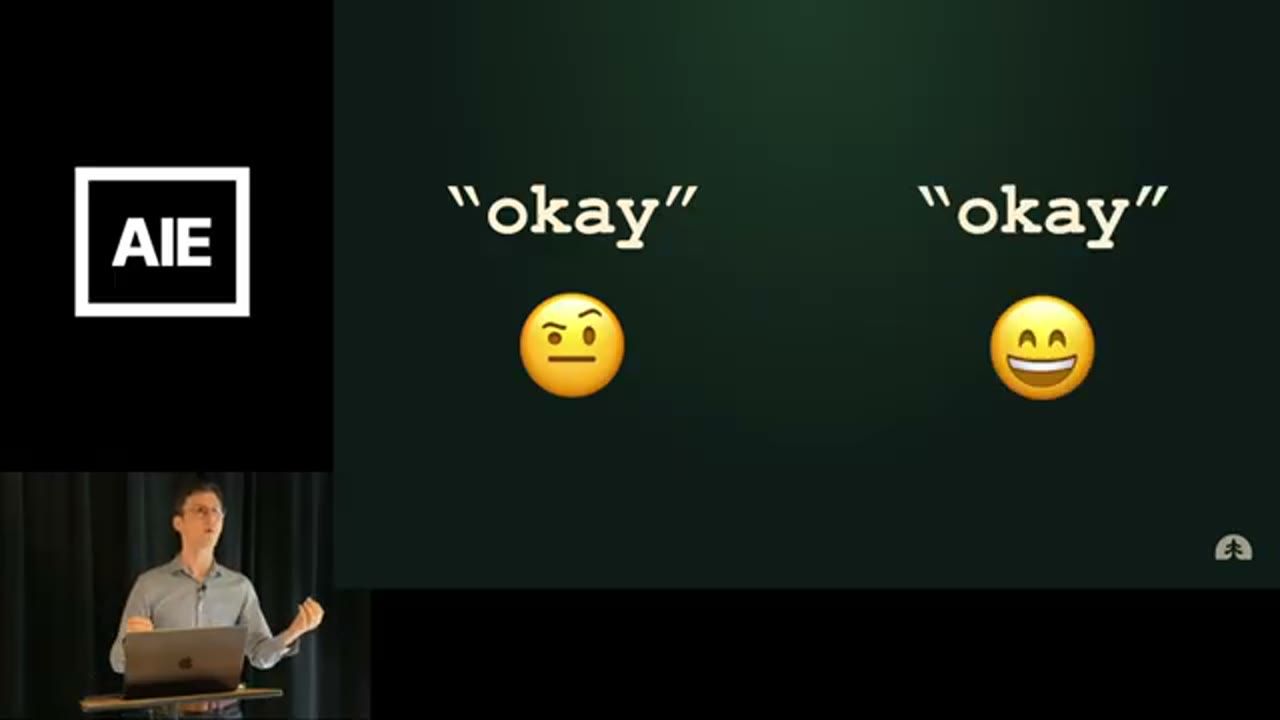
Có một khác biệt rất lớn giữa việc bạn nói với tôi "Okay," một cách lửng lơ và việc bạn nói "Okay!" một cách hào hứng. Đó là lý do khi có điều gì thật sự quan trọng cần truyền đạt hoặc cần làm cho ai đó hiểu ra, chúng ta sẽ nhảy vào một cuộc gọi, hoặc nói chuyện trực tiếp, để có được kênh giao tiếp băng thông cao (high bandwidth) đó.
6. Agent ngồi trong cuộc gọi của Forestwalk
Và vì thế, ở Forestwalk, đội của Allen đã build một agent nằm ngay trong các cuộc gọi, có thể giúp họ theo thời gian thực.
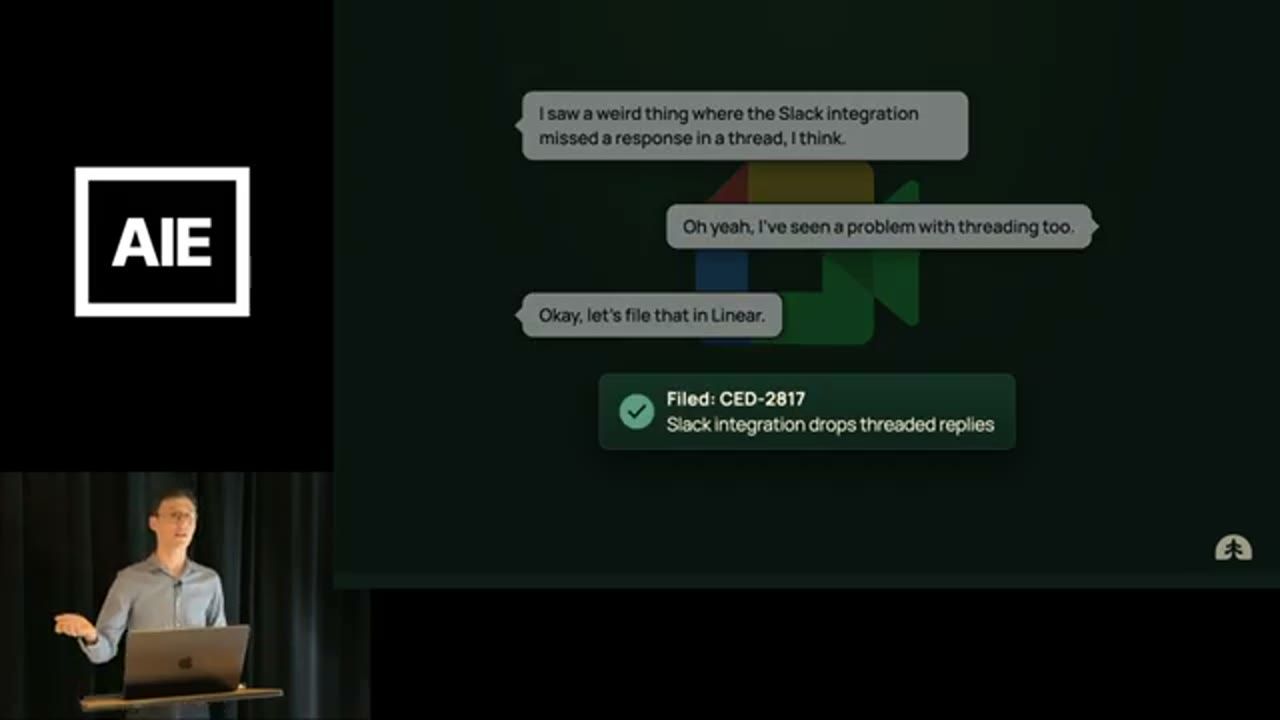
Allen kể một lần gần đây: trong một cuộc gọi, anh nhắc với co-founder của mình rằng anh đã thấy một bug với Slack integration, hoặc ít nhất anh nghĩ là mình đã thấy. Chị ấy trả lời rằng chị cũng đã gặp đúng bug đó. Thế là anh chỉ nói: "Okay, vậy mình file cái đó thành một issue trên Linear đi." Và voice agent, trong vòng một giây, đã phản hồi rằng nó làm xong rồi.
Khi được tinh chỉnh thật chuẩn, trải nghiệm này cảm thấy hoàn toàn tự nhiên. Bạn có thể đang nói một cách tình cờ, hoặc có chủ đích, cố ý nói với AI, và nó phản hồi theo cách không làm gián đoạn bạn. Nó không cần phải đáp lại bằng giọng nói. Nó chỉ đơn giản là hành động dựa trên ý định (intent) của bạn.
Allen tin rằng chúng ta sẽ thấy kiểu trải nghiệm này ngày càng nhiều trong những tháng và những năm tới. Nhưng có một rào cản lớn, một thách thức khổng lồ để làm cho nó thật sự chạy được và cảm thấy dễ chịu.
7. The tyranny of latency: 100 ms và một giây
Rào cản đó là sự chuyên chế của latency (the tyranny of latency), Allen nói và bật cười. Rất khó để đưa một phản hồi chạy qua cả chuỗi xử lý đủ nhanh.
Từ những năm sáu mươi, chúng ta đã biết rằng để máy tính phản ứng đủ nhanh tới mức cảm giác như tức thì, nó cần phản ứng trong khoảng một trăm mili giây, tức một phần mười giây. Vì thế, dĩ nhiên, ta luôn khao khát làm sản phẩm của mình phản ứng nhanh đến vậy, và đôi khi ta làm được. Nhưng với network và mọi thứ khác, việc này có thể khó, tuỳ vào khối lượng việc cần làm.
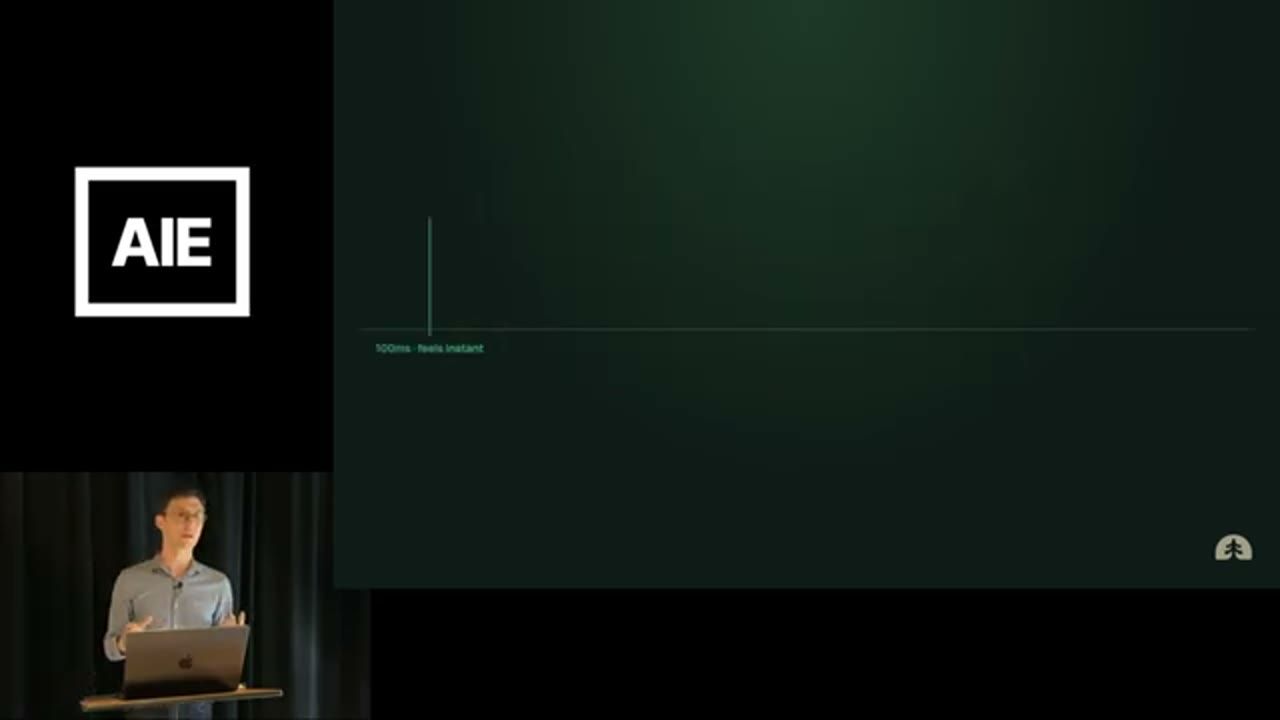
Nên đôi khi ta có thể nới ra tới một nghìn mili giây. Bạn có trọn một giây. Đó gần như là giới hạn trước khi người ta bắt đầu mất mạch suy nghĩ. Người ta nhờ Siri làm gì đó, nó mất hơn một giây, và đầu óc ta đã chạy sang chuyện khác rồi.
Vì thế ta luôn xoay xở ở khoảng giữa hai giới hạn của con người đó: cố gắng phản hồi trong vòng một giây, lý tưởng nhất là trong vòng một trăm mili giây. Hai ngưỡng này trùng với các mốc response time kinh điển mà Nielsen Norman Group tổng kết, dựa trên nghiên cứu của Miller năm 1968.
8. Ngưỡng 200 ms của hội thoại voice-in, voice-out
Nhưng nếu ta muốn có một cuộc hội thoại bằng giọng nói liền mạch với một AI, hay với một người khác, thì giới hạn còn khắt khe hơn nhiều. Ta cần latency từ 200 mili giây trở xuống nếu muốn có một cuộc trò chuyện thực thụ: khi người ta đang nói thành lời, họ ngắt lời nhau, chen vào, đồng tình, và tạo nên kiểu kết nối đó trong một cuộc hội thoại voice-in, voice-out trọn vẹn.
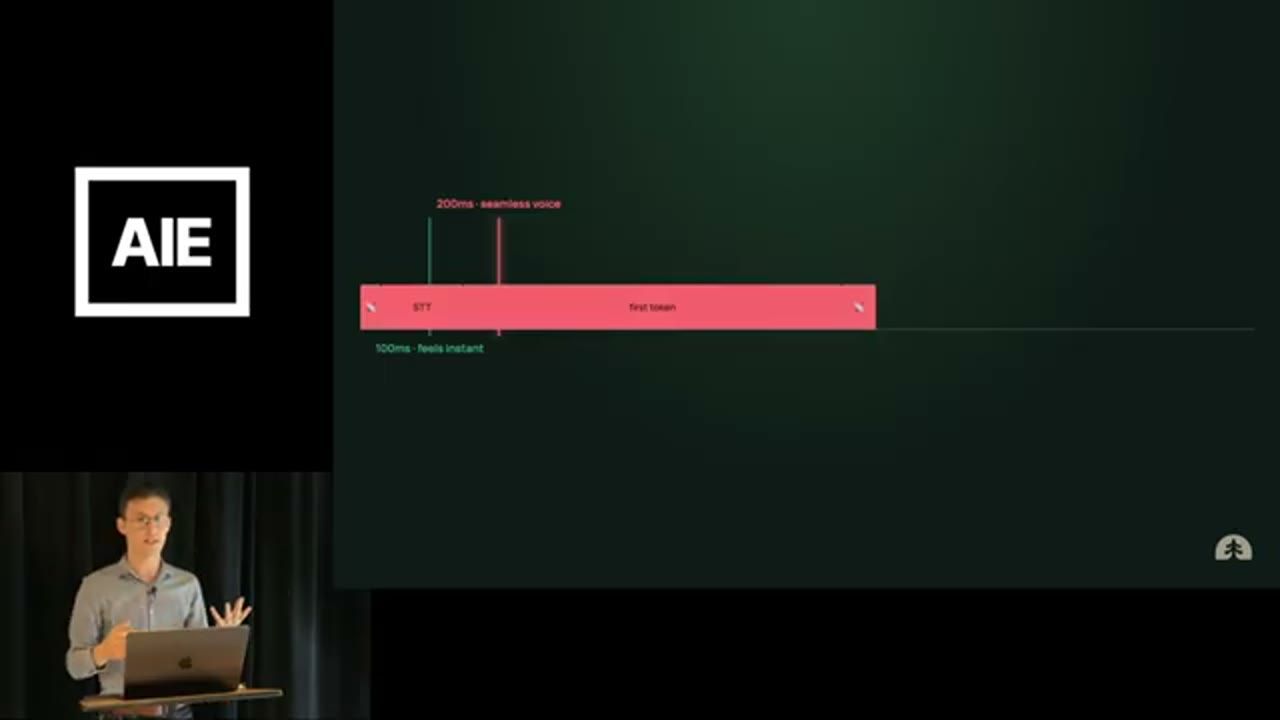
Hãy hình dung việc làm điều đó khi bạn có một request qua network, có thể bạn chuyển giọng nói thành text, rồi chạy một kiểu model inference nào đó trên text đó, rồi gửi ngược lại qua network. Allen gọi đó là một khối lượng việc phi lý nếu phải gói trong 200 mili giây.
Có một số cách tiếp cận khéo léo để lách quanh giới hạn này. Thinking Machines, một lab mới, có một kiến trúc rất chu đáo mà họ demo gần đây, chỉ vài tuần trước: họ chia thời gian (time slice) thành từng lát 200 mili giây, đúng bằng mục tiêu 200 mili giây kia, và có một model chạy inference liên tục, vào và ra, trên từng lát 200 mili giây. Lab này mô tả cách làm đó trong bài Interaction Models, gọi mỗi lát là một micro-turn.
9. Đổi sang visuals-out để có vùng latency dễ thở hơn
Vậy là có những cách lách quanh giới hạn này cho voice-in, voice-out. Nhưng Allen chỉ ra rằng ta cũng không cần phải chờ những kiến trúc mới lạ. Ta có thể đơn giản là chuyển sang voice-in, visuals-out, và khi đó ta hưởng lợi từ vùng latency cho phản hồi bằng hình ảnh mà con người dễ dãi hơn (the more forgiving visual response envelope).
Nếu có thứ gì đó xuất hiện trên màn hình trong vòng một giây sau khi bạn nói, cảm giác là nó đã đạt yêu cầu: nó vẫn nằm trong khoảng chú ý của bạn. Nó phản ứng với bạn theo cách cảm thấy liền mạch.
Vì vậy, vài tháng qua đội Forestwalk đã build hướng tới đúng điều đó. Allen nói việc này rất vui và họ học được rất nhiều. Phần cuối talk, anh chia sẻ ba điều họ thấy là thật sự quan trọng để lọt vào được vùng latency đó và làm cho trải nghiệm thật sự thú vị với những người sử dụng.
10. Trụ cột 1: model nhanh trên hạ tầng ưu tiên latency
Điều thứ nhất: để phản hồi theo cách cảm thấy liền mạch, bạn phải dùng một model thật sự nhanh. Đó không chỉ là một model đủ nhỏ để có thể trả lời đủ nhanh trong vài trăm mili giây. Dĩ nhiên nó cần nhỏ như vậy. Nhưng nó còn phải chạy trên một inference platform ưu tiên latency.
Allen kể: khi GPT-5 Mini ra mắt, đội anh rất hào hứng. Họ nghĩ, được rồi, giờ có một model thông minh hơn, và chắc hẳn nó sẽ nhanh. Nhưng trên thực tế, họ thấy latency P95 lên tới 5.000 mili giây, 7.000 mili giây, có lúc 10.000 mili giây, anh cười, cho một model nhỏ. Nó rẻ hơn model lớn, nhưng họ không thấy nó phản hồi đủ nhanh một cách ổn định, thậm chí là chưa từng thấy nó đủ nhanh.
Haiku tốt hơn nhiều xét về latency P95 đó. Vậy nên bạn thật sự cần một model cỡ Haiku làm model phản hồi trong vòng real-time này, hoặc một trong những model open source nhỏ hơn.
Rồi nếu có một khối việc lớn hơn cần làm, model nhanh đó sẽ chuyển giao (hand off), tức gửi một message bất đồng bộ (asynchronous) sang một model lớn hơn có thể suy nghĩ kỹ. Trong lúc đó, model real-time liên tục, hay model soft real-time đang phản hồi nhanh, có thể đan xen (interleave) các câu trả lời từ model lớn vào khi model lớn đang làm phần việc nặng hơn.
Đó là điều số một: bạn cần một model nhanh, và tất nhiên kèm theo một context đủ ngắn mà bạn đưa vào để nó có thể phản hồi trong vài trăm mili giây.
11. Trụ cột 2: gửi inference theo chu kỳ ngắn
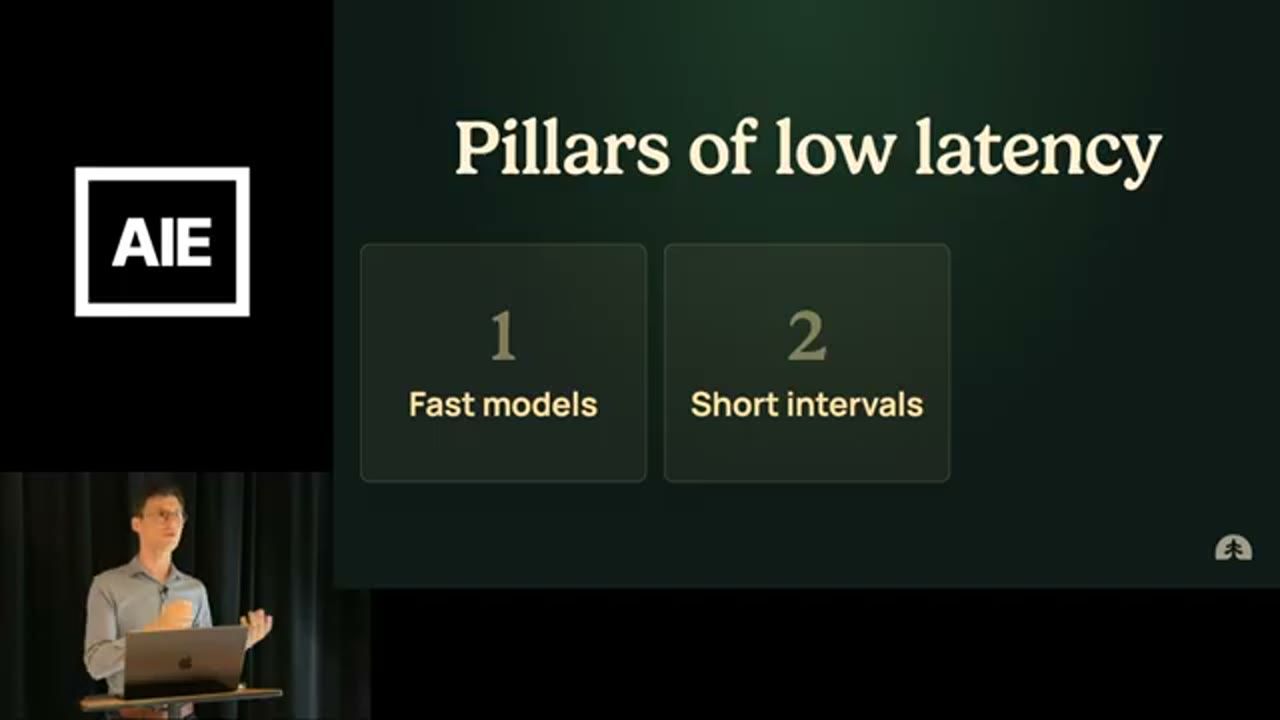
Điều thứ hai thật sự then chốt nếu ta muốn có cảm giác hệ thống phản hồi rất nhanh là phải có các khoảng ngắn (short intervals) giữa những lần gửi đi inference.
Theo cách truyền thống, với một ứng dụng giọng nói chẳng hạn, bạn có thể nghe người dùng nói vài giây, rồi họ dừng. Bạn lắng nghe thêm một giây im lặng, rồi mới có một kiểu inference nào đó diễn ra. Tới lúc đó bạn đã tiêu lố ngân sách với một khoảng chênh khá lớn, chỉ vì ngồi chờ im lặng.
Vậy nếu ta muốn có thứ gì đó hiện lên màn hình trong vòng một giây, ta muốn inference phản hồi khá hăng hái (eagerly) ngay khi người dùng đang nói, kể cả khi ta chưa hoàn toàn chắc họ đã nói xong. Hãy sẵn sàng gửi inference mỗi một hoặc hai giây trong lúc họ nói.
Lý do là đôi khi ta nói một câu kiểu: "Ồ, này, mình sẽ muốn đổi cái này", rồi thật ra thêm "và làm luôn cái việc kia nữa". Trải nghiệm sẽ liền mạch hơn nhiều nếu hệ thống làm những việc đó ngay trong lúc người ta đang nói. Nên bạn phải có một model và một hạ tầng cho phép những lượt (turn) nhanh như vậy chạy liên tục.
12. Trụ cột 3: một chế độ caching ổn định
Và cuối cùng, để toàn bộ những điều trên thật sự chạy được, bạn cần một chế độ caching ổn định (a stable caching regimen).
Trong năm vừa qua, cách chúng ta làm việc với LLM đã có một cải tiến rất lớn: trên các nền tảng khác nhau đều có những dạng prefix caching. Nếu phần đầu của context bạn gửi lên model giống hệt nhau mỗi lần, thì bạn có thể có inference rẻ hơn và nhanh hơn tới chín mươi phần trăm, tuỳ điều kiện. Tài liệu chính chủ về cơ chế này: prompt caching của Anthropic và prompt caching của OpenAI.
Vì vậy bạn cần dựa thật nhiều vào kiến trúc này. Allen nghĩ rằng với hầu hết các ứng dụng, chúng ta đều đang đi về hướng đó, dù là một agent chạy dài (long-running agent) hay một agent chạy thường xuyên (frequently running agent). Nguyên tắc vẫn là một: ta muốn chín mươi phần trăm đầu tiên của context window, nếu được, giữ nguyên từ request này sang request khác, và chỉ dùng mười phần trăm cuối cùng cho phần thay đổi.
Và tất nhiên, hãy giảm tối đa số output token, để bạn có được những lượt inference thật nhanh và tương đối phải chăng, tạo nên trải nghiệm thú vị kia.
13. Lời kết: hãy build thứ gì đó tuyệt vời
Đó là một vài kỹ thuật mà đội Forestwalk thấy thật sự hữu ích. Allen nói anh rất muốn nghe từ bất kỳ ai đang khám phá, thử nghiệm, dù là với real-time hay với bất kỳ cách nào mà mọi người đang đẩy giới hạn của việc tạo ra những trải nghiệm thú vị với các model này. Anh rất sẵn lòng trò chuyện và chia sẻ những gì đội anh đang học được.
Và anh hy vọng một phần những điều này sẽ truyền cảm hứng để vài người trong khán phòng đi ra và build một thứ gì đó thật tuyệt. "Thanks."
Sources and links
- Forestwalk Labs: công ty của Allen Pike, nơi build agent ngồi trong cuộc gọi
- allenpike.com: blog của Allen Pike; anh cũng điều hành meetup AI engineering Infer và làm host podcast It Shipped That Way
- Interaction Models, Thinking Machines Lab: kiến trúc micro-turn 200 ms được nhắc trong talk
- Response Times: The 3 Important Limits, Nielsen Norman Group: các ngưỡng 0,1 giây và 1 giây
- Anthropic prompt caching và OpenAI prompt caching: tài liệu về prefix caching
- Claude Haiku: lớp model nhỏ, nhanh mà Allen dùng làm chuẩn cho vòng real-time
- Linear: công cụ quản lý issue mà agent tạo ticket vào trong ví dụ
- GitHub của Allen Pike; X: @apike
Related talks
The 100-Tool Agent Is a Trap: Scaling with Semantic Routers and JIT Context
Sohail Shaikh & Ankush Rastogi · Prosodica · 28 min
Nạp mọi tool vào prompt làm accuracy rơi từ 78% xuống 13% ở 741 tool; semantic routing (RAG cho tool) với JIT context giữ trên 83% và cắt 99% token.
The Future Is Domain-Specific Agents
Justin Schroeder · StandardAgents · 31 min
Composition over inheritance cho agent: thay vì nhồi MCP và skill vào một agent lớn, ghép nhiều agent nhỏ theo domain, tiết kiệm token, dùng được small model.
Agent Output Is Not UX: Rendering Layer Your LLM Pipeline Is Missing
Bala Ramdoss · Amazon · 14 min
Lớp generative UI giữa model và màn hình: rendering contract có version, streaming vào typed component, và BFF giữ cho mobile client an toàn.