Second: một user model của riêng bạn cho mọi agent
Ken Liu kể cách Second đọc dòng sự kiện trên máy để dựng user model, kiến trúc security và chi phí model (video đăng 18/11/2026).
✓ Đã duyệt độc lập · cập nhật 18/11/2026 · 33 min
1. First Person Labs làm gì
Đây là một tập trên kênh YouTube a16z. Theo mô tả của video đăng ngày 18/11/2026, Ken Liu là co-founder của First Person Labs, và anh ngồi cùng Martin Casado và Joel de la Garza của a16z để giới thiệu Second: một personal context layer, được thiết kế để hiểu những gì bạn đang làm trong đời sống số của mình và đưa context đó tới những agent mà bạn chọn. Cũng theo mô tả này, ba người bàn về cách Second chủ động nối thông tin qua các cuộc trò chuyện và các ứng dụng, về lý do việc bảo vệ loại dữ liệu cá nhân như vậy cần một kiến trúc security khác, và về tầm nhìn dài hạn: một AI không chỉ trả lời prompt mà hiểu đủ context để biết khi nào và bằng cách nào nên giúp.
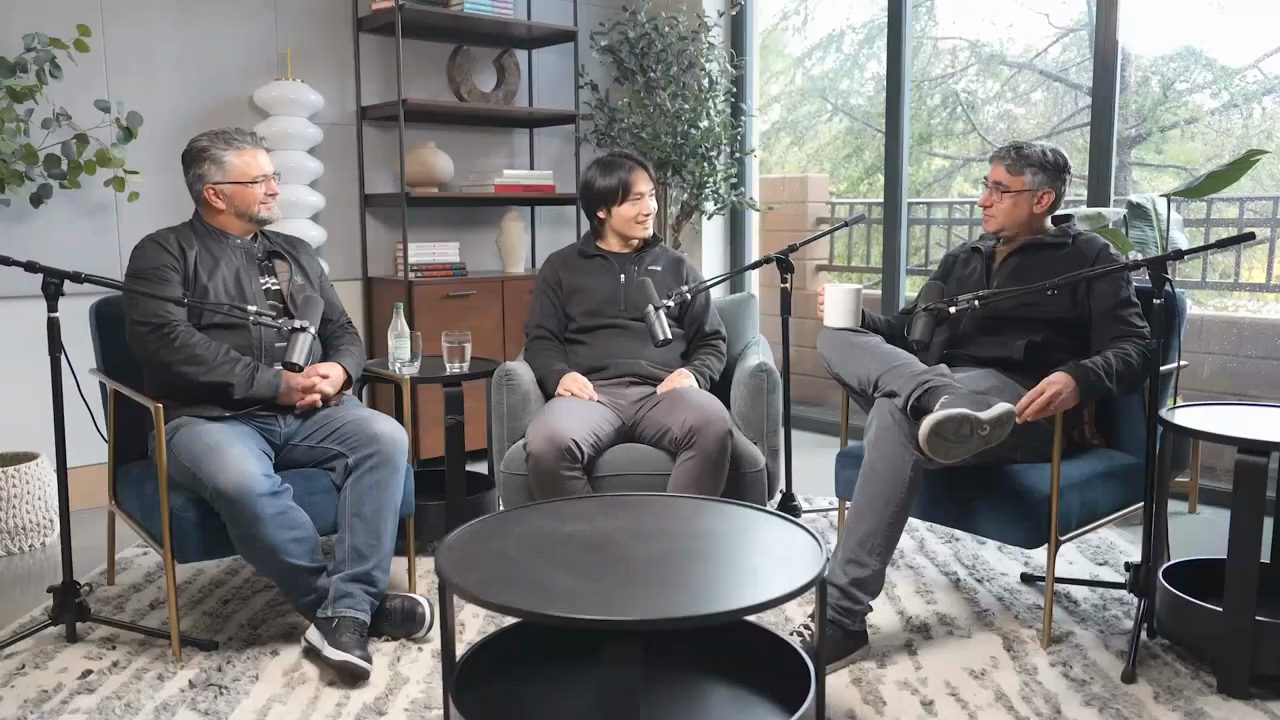
Joel mở đầu bằng lời cảm ơn Ken đã tới, và nói rất vui được mời anh tới để nói về những gì anh đang làm ở First Person Labs. Martin hỏi đây có phải lần đầu Ken nói về nó không, và có tiếng đáp là có. Rồi có câu hỏi: vậy anh làm gì? (video đăng ngày 18/11/2026)
Ken trả lời rằng nhóm tập trung vào việc tạo ra một model của một con người, rồi đặt chính người đó vào vị trí kiểm soát. Theo anh, "model của một người" nghĩa là hiểu memory của họ, hiểu họ làm gì, nhưng hơn thế nữa là hiểu priorities, preferences, goals, values, commitments và intent của họ (theo Ken, video đăng ngày 18/11/2026).
Trang chính thức của First Person Labs (đọc ngày 18/11/2026) tự mô tả công ty là một applied research lab nghiên cứu cách AI có thể hiểu chúng ta sâu sắc, cách bảo vệ sự hiểu biết đó, và cách nó giúp chúng ta làm được những việc lớn; trang ghi công ty đang xây portable user models với Second.
2. Portable context: mang hiểu biết về bạn sang Grok Bot và Codex
Martin xin lỗi và đề nghị làm cho thật đơn giản. Anh là một người dùng Grok Bot lớn, anh dùng Grok Bot rất nhiều. Vậy First Person Labs nằm ở đâu trong cách anh dùng Grok Bot? (video đăng ngày 18/11/2026)
Ken giải thích cách nó chạy: bạn chỉ việc mang context của mình sang Grok Bot. Nó giống như portable context. Bạn vào Grok Bot và nói: này, bạn nói chuyện với cái của tôi để hiểu tôi muốn gì được không? Rồi hai bên bắt đầu nói chuyện với nhau, và bạn chỉ cần gửi những prompt như "mua cho tôi một vé máy bay", và nó sẽ biết bạn đang nói tới chuyến bay nào (theo Ken, video đăng ngày 18/11/2026).
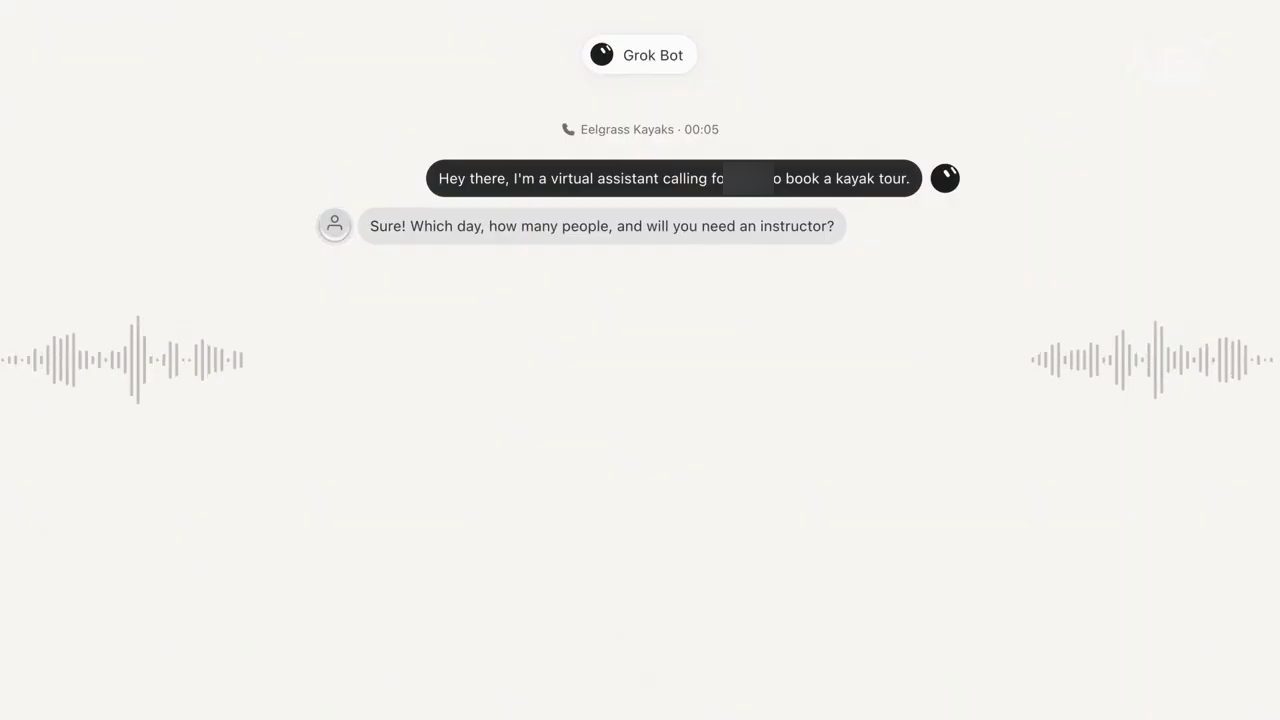
Martin hỏi tiếp: Grok Bot thiếu context gì mà First Person Labs mang lại được? Ken nói có lẽ anh sẽ đặt câu hỏi theo chiều ngược lại, rồi lấy ví dụ: preference của bạn về chỗ ngồi trên máy bay, bạn thích tới sân bay sớm cỡ nào, bạn bay đi đâu, bạn bay hạng nhất hay hạng thường. Tính tới hôm nay, tất cả những điều đó bạn đều phải giải thích cho Grok Bot; bạn phải trải qua nhiều vòng hỏi đáp (theo Ken, video đăng ngày 18/11/2026).
Nhưng nếu bạn có một user model tự xây lên, và những thứ này cứ phân tích ở background, thì bạn có thể chia sẻ nó sang ngay lập tức (theo Ken, video đăng ngày 18/11/2026).
Joel đưa ra một ví dụ của chính mình: theo lời Joel trong video đăng ngày 18/11/2026, hôm qua OpenAI vừa ra hai model mới có khả năng về cyber, và đã một thời gian anh không dùng Codex, nhưng anh vẫn dùng Second. Nên anh có thể vào dùng Codex ngay, và nó có tất cả những việc khác anh đã làm cùng toàn bộ context bổ sung đã lưu sẵn (theo Joel, video đăng ngày 18/11/2026).
Ken nói: bạn chỉ cần vào Codex và hỏi "second của tôi ơi, có chuyện gì đang diễn ra vậy?" (theo Ken, video đăng ngày 18/11/2026).
3. Từ portable context tới một bản đại diện của bạn, và ví dụ Alfred
Martin hỏi: liệu second có bao giờ trở thành "first person", một ngôi thứ nhất thật sự, hay nó sẽ luôn đi qua agent? (video đăng ngày 18/11/2026)
Ken nói đó là câu hỏi hay. Anh nghĩ user model là một quá trình. Bạn phải bắt đầu từ đâu đó: một danh sách artifact nền tảng làm baseline, gồm những gì bạn đã làm, những người trong đời bạn là ai, có thể cả preferences của bạn. Rồi theo thời gian, bạn bắt đầu phân tích cách bạn nói chuyện, cách bạn thể hiện bản thân, cách bạn chia sẻ thông tin (theo Ken, video đăng ngày 18/11/2026).
Theo thời gian, bạn xây thêm nhiều artifact hơn ở bên trên, thêm nhiều hiểu biết hơn ở bên trên, và có thể một phần trong đó bạn train thành một model. Và như vậy, theo thời gian, bạn sẽ đi từ một portable context tới một thứ gần với bản đại diện (representation) của chính bạn (theo Ken, video đăng ngày 18/11/2026).
Một ví dụ Ken thích nghĩ tới là Alfred và Batman. Giả sử Batman muốn mua một chiếc cheeseburger và nhờ Alfred đi mua. Alfred sẽ không để lộ, chẳng hạn, rằng người muốn mua là Batman; ông chỉ mua thôi. Ông sẽ nói rõ preference (theo Ken, video đăng ngày 18/11/2026).
Martin chen vào: Alfred là quản gia của Batman. Ken xác nhận: đúng, đúng, đúng. Có tiếng nói thêm: hoặc là agent của anh ấy, và câu "hoặc agent của anh ấy" được lặp lại. Có người nói nên đặt tên agent của mình là Alfred, và có tiếng khen đó là một ý hay. Ken nói: cứ làm vậy đi (video đăng ngày 18/11/2026).
Ken nói tiếp: và rồi bạn sẽ tin người đó, vì bạn biết người đó có một model tốt về bạn. Và điều đó có ý nghĩa gì khi nói tới chuyện làm cho xong việc… (theo Ken, video đăng ngày 18/11/2026).
4. Những gì máy tính của bạn vốn đã biết
Martin nói điều này thú vị: Ken mô tả First Person Labs có một thứ gọi là second. Second hiểu bạn là ai và có context. Rồi các agent khác nói chuyện với second đó, đúng không? Nên nó phần nào hiểu preferences của bạn, hiểu bạn đang làm gì, bạn muốn làm gì. Nhưng Martin nghĩ cách mô tả đó chưa làm nổi bật một thứ khác mà Ken đã làm rất vất vả (video đăng ngày 18/11/2026).
Theo Martin, như ba người đang nói, Ken thật sự lấy được context, digital context mà một người có, như messages, chat, kiểu như email, và cũng đưa nó vào để dùng được. Là một trong những người dùng First Person Labs sớm nhất, điều làm anh ấn tượng không phải là nó biết anh là ai, mà là nó truy cập rất tốt mọi kênh (channels) của anh. Và nhân tiện, hoá ra đây là một bài toán systems rất khó. Anh mời Ken nói về khía cạnh đó (theo Martin, video đăng ngày 18/11/2026).
Ken xác nhận đây đúng là một bài toán rất khó, nhất là để làm nó secure và private. Cách nó chạy, đại khái, là ngay lúc này trên máy tính của bạn có một dòng sự kiện vô tận (infinite stream of events). Khi bạn dùng máy: những app bạn chuyển qua, cách bạn dừng lại ở một số website, cách bạn gõ, và cách Wi-Fi của bạn kết nối. Và OS đã cho bạn những thứ đó. Theo Ken, điều này đúng trên Apple, Microsoft, và cả Linux (video đăng ngày 18/11/2026).
Câu hỏi khi đó là: liệu bạn có thể phân tích nó tới mức tối đa không? Dòng raw stream này chạy 24/7, rồi đặt agent lên trên, những agent chạy 24/7. Ví dụ, trước hết có thể tổng hợp rằng đoạn gõ phím này trong app cụ thể này có thể nghĩa là bạn đang gửi một tin nhắn. Rồi khi bạn chuyển app giữa browser hoặc quay lại Codex, có thể bạn đang research. Có thể bạn đang viết một Google Doc (theo Ken, video đăng ngày 18/11/2026).
Và bạn xây hiểu biết đó theo từng tầng (hierarchically). Điều đó cộng với các connector có sẵn có thể cho bạn một hiểu biết rất tốt về việc bạn đang cố làm. Ken nghĩ mọi người đang đánh giá rất thấp máy tính vốn đã biết nhiều tới mức nào. Nó cứ nằm sẵn ở đó, chờ được khai thác (theo Ken, video đăng ngày 18/11/2026).
5. Những tin nhắn Joel không yêu cầu
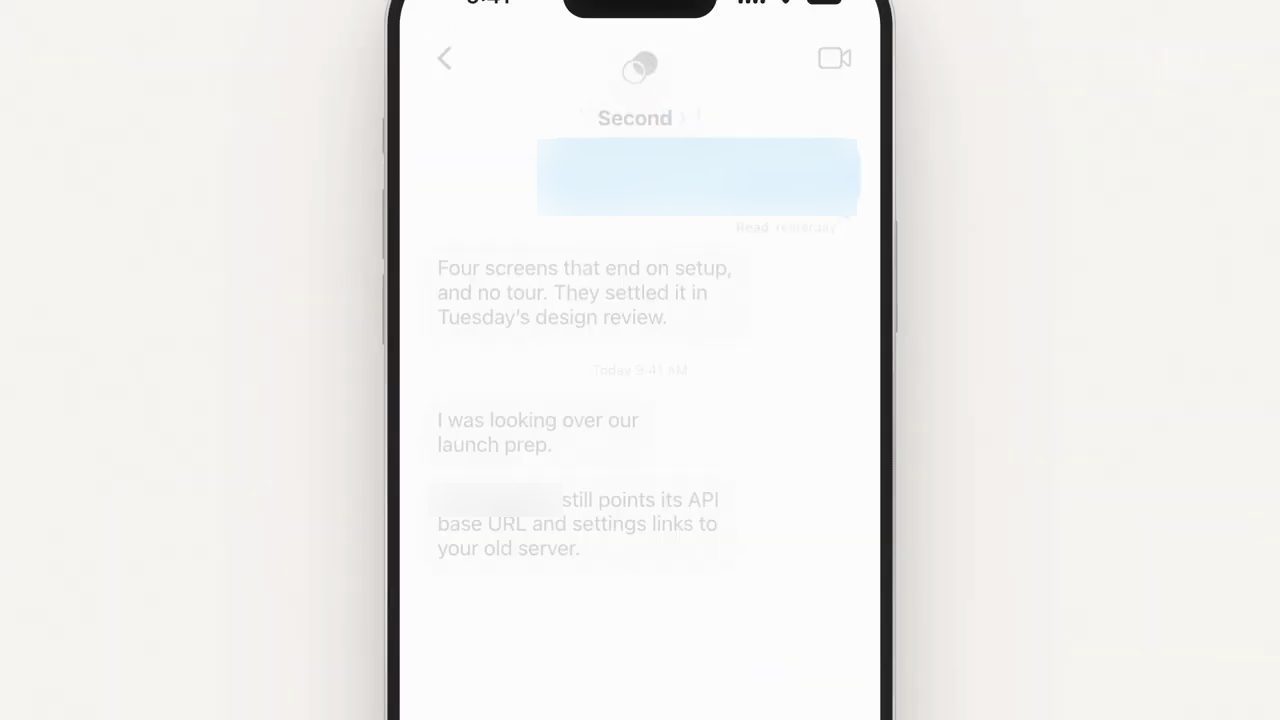
Joel kể thêm, với tư cách cũng là một người dùng rất sớm của sản phẩm: gần đây nó trở nên không thể thiếu, vì nó có thể bắt được những chuyện như thế. Giờ nó gửi tin nhắn cho anh, báo rằng: này, bạn đang có cuộc trò chuyện này ở chỗ này với người này, và có vẻ tình hình đã thay đổi (theo Joel, video đăng ngày 18/11/2026).
Ví dụ của Joel (video đăng ngày 18/11/2026): hôm qua, nhóm anh đang lên kế hoạch cho một sự kiện, có 20% khả năng thời tiết xấu, và theo thời gian thực nó liên tục cập nhật dự báo để báo cho nhóm anh biết có cần thuê lều hay không. Joel gọi đó là một điều cực kỳ mạnh mẽ.
Có tiếng hỏi: anh có bảo nó làm vậy không? Joel đáp: không, anh không bảo nó làm vậy (video đăng ngày 18/11/2026).
Martin nói trải nghiệm với second của anh cũng vậy: anh nhận được tin nhắn từ second của mình, và đó là thứ anh thật sự cần biết, liên quan tới một cuộc trò chuyện đang diễn ra mà anh còn chưa nghĩ tới. Theo Martin, nó thật sự rất chu đáo (thoughtful) (video đăng ngày 18/11/2026).
Joel nói thêm rằng điều đó thật tuyệt, và anh thật sự tò mò: Ken làm điều đó bằng cách nào? Những thứ lẽ ra anh đã quên, nó bắt được hết (theo Joel, video đăng ngày 18/11/2026).
6. Reactive và reflective: các cấp độ của productivity
Ken nói điều này quay lại với model của một người: hiểu điều gì có thể quan trọng với họ, và điều gì nảy ra vào lúc này. Productivity là thứ mọi người nói tới rất nhiều, như việc ping bạn đúng lúc cần. Nhưng theo Ken, productivity có nhiều cấp độ (video đăng ngày 18/11/2026).
Cấp đầu tiên anh gọi là reactive: có một email tới, và rồi… Ken nhắc một meme trên mạng: giờ bạn nhận 10 thông báo cho một email, vì có chín personal agent khác đang báo cho bạn về nó. Theo Ken, reactive productivity thì thẳng thắn, dễ làm (video đăng ngày 18/11/2026).
Khó hơn là thứ anh gọi là reflective: những thứ nối các điểm qua nhiều sự kiện và qua một khoảng thời gian dài. Kiểu: vài tháng trước bạn nói điều này, gần đây bạn đang làm việc này hướng tới mục tiêu của mình. Đây là priority của bạn. Đây là vài thứ trong to-do list của bạn. Và nhân tiện, bạn thích cái này. Theo Ken, nối các điểm như vậy sẽ mang lại cho bạn productivity tốt hơn nhiều (video đăng ngày 18/11/2026).
Ken nghĩ điều này phần nào gợi ý cách tương tác cá nhân với máy tính có thể diễn ra trong tương lai. Nó sẽ không tập trung vào việc phản ứng với sự việc, mà giống hơn: có những can thiệp (intervention) nào cho người dùng mà tôi có thể áp dụng? Có những việc gì tôi có thể làm cho người dùng mà không cần ai hỏi? (theo Ken, video đăng ngày 18/11/2026)
Và Ken nghĩ đó là một trong những vấn đề lớn nhất lúc này: mọi người phải hỏi. Bạn không nên phải hỏi (theo Ken, video đăng ngày 18/11/2026). Có tiếng nói thêm: chúng siêu thông minh.
7. Một second, nhiều agent quanh nó
Joel nói: ý anh là, Ken đã xây một thứ cứ thế biết anh cần gì vào đúng lúc đó, và điều đó khá ấn tượng (theo Joel, video đăng ngày 18/11/2026).
Martin muốn nói thật cụ thể cho người đang nghe về những gì First Person Labs cung cấp, rồi anh có một câu hỏi. Theo Martin, rất cụ thể, nó tạo ra một thứ gọi là second. Bạn tạo một thứ gọi là second. Second có quyền truy cập toàn bộ digital context của bạn, và anh thấy điều đó thật đáng kinh ngạc: các phím bạn gõ, mọi tin nhắn, mọi kênh, mọi dữ liệu. Martin nói nó làm việc này theo một cách rất an toàn (video đăng ngày 18/11/2026).
Dựa trên đó, nó trở thành kiểu personal butler của bạn; Martin nói anh thích hình ảnh Alfred đó. Rồi nó tương tác với các agent của bạn. Nên nó không phải một agent tự thân. Nó không giống Grok Bot; nó là một thứ riêng. Và nó cung cấp điều đó cho các agent (theo Martin, video đăng ngày 18/11/2026).
Rồi Martin nêu một điều thú vị. Anh dùng Grok Bot, anh là người dùng Grok Bot lớn và có cả một loạt: một con theo dõi các synthesizer của anh, một con theo dõi bất động sản của anh, một con, lạy trời, giúp anh chuyện gia đình, thứ mà có lẽ anh không nên cần tới. Nhưng anh có cần. Và anh có một second, các Grok Bot kia sẽ giao tiếp với second đó. Anh hỏi: theo thời gian, Ken có hình dung người ta sẽ có một second, rồi một third, một fourth, một fifth, hay cuối cùng nó chỉ là một quản gia duy nhất của bạn? (video đăng ngày 18/11/2026)
Ken nghĩ việc lúc này chúng ta có nhiều personal agent có lẽ là tạm thời (transitory). Agent sẽ chuyên môn hoá, giống như con người. Một số agent tập trung vào một việc. Ví dụ, một số agent chuyên duyệt Amazon và mua sắm; chúng cực kỳ giỏi việc đó vì chúng có dữ liệu, chúng có các kết nối. Và một số agent sẽ chuyên bảo vệ dữ liệu của bạn và đứng về phía lợi ích của bạn (theo Ken, video đăng ngày 18/11/2026).
Ken nghĩ đó là thứ Second hướng tới. Theo anh, đây là thứ bạn nên có thể tin tưởng để giữ context của cả cuộc đời mình bên trong. Nó giống như một cái két (vault). Và theo thời gian, thứ này sẽ cùng bạn giao tiếp với thế giới phần mềm, hay thậm chí cả thế giới phần cứng (theo Ken, video đăng ngày 18/11/2026).
Martin hỏi: vậy anh nghĩ nó sẽ vẫn là một second? Ken đáp: đúng, nó sẽ vẫn là một second, sẽ không thành third. Martin nói tiếp: sẽ không có third, sẽ không có fourth. Vậy đó là một agent đáng tin cho mọi dữ liệu cá nhân của bạn, thật sự biết bạn là ai, và sẽ tương tác với mọi agent khác của bạn: đó là second. Joel thêm: an toàn kiểu Batman ("Batman safe") (video đăng ngày 18/11/2026).
Ken nói bạn có thể dựng một số agent tồn tại tạm thời rồi biến mất. Nhưng điểm mấu chốt là bạn muốn có một nơi lưu trữ nhất quán (consistent store), và chính consistent store mang lại giá trị đó (theo Ken, video đăng ngày 18/11/2026).
8. Câu hỏi về trust: data và inference
Joel nói anh vẫn là một người làm security đa nghi, và có lẽ là một trong những người áp dụng mấy thứ này nhanh hơn. Martin chen vào: nói cho rõ, Joel đã mất rất lâu mới chịu lên mạng xã hội. Có tiếng xen vào rằng chuyện đó mới vài tuần trước thôi, và có tiếng nói thêm rằng các anh đã làm trong ngành tech 30 năm rồi (video đăng ngày 18/11/2026).
Joel thừa nhận anh hơi đa nghi. Nhưng anh thích Second, và phải nói rằng background của Ken và những điều thúc đẩy Ken, cùng với những cuộc thảo luận dài giữa anh và Ken về kiến trúc security, thật sự khiến anh yên tâm. Anh muốn đi sâu hơn một chút (double click), vì khi người ta nghĩ tới chuyện thứ này nhìn thấy mọi việc bạn làm, phản ứng tức thì là kiểu: whoa (theo Joel, video đăng ngày 18/11/2026).
Ken nói: đúng, bạn không nên tin nó. Joel lặp lại: bạn không nên tin nó. Và anh nghĩ Ken đã làm rất xuất sắc trong việc xây một thứ mà chúng ta có thể tin, rồi mời Ken nói về kiến trúc đó và điều gì thúc đẩy anh xây nó (video đăng ngày 18/11/2026).
Ken nghĩ đây, ở một mức độ nào đó, là một dạng AI mới, sẽ chạy rất khác trước đây. Trước đây, bạn khởi động một tương tác và nhận lại kết quả. Lần này thì thụ động hơn, ambient hơn hẳn; nó sẽ có mặt mọi lúc. Nên bạn phải nghĩ về cách kể cho mọi người về nó, cách bạn thiết kế kiến trúc của nó, dữ liệu đi đâu (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, rốt cuộc, với AI chỉ có hai thứ: data và inference. Bạn có dữ liệu này, và bạn muốn xác định inference nào được phép đem tới dữ liệu đó. Đây là thứ nhóm của Ken xây vào Second. Trước hết, bạn được chọn inference nào (video đăng ngày 18/11/2026).
Nếu bạn không tin, giả sử, chính nhóm của Ken, thì về nguyên tắc bạn nên có thể mang token của chính mình (bring your own tokens) và để những token đó chạy Second, phân tích dữ liệu nằm local trên laptop của bạn (theo Ken, video đăng ngày 18/11/2026).
Joel nói thêm: nhưng Second cũng cung cấp một inference provider dùng trusted execution. Ken đáp rằng theo thời gian, nhóm hình dung mọi người sẽ không cần mang token riêng, vì phần lớn người mang token của mình thì đó là token của OpenAI hoặc Anthropic. Anh muốn có một lựa chọn ổn định, nơi bạn nói: nếu dùng các token này thì không ai nhìn vào dữ liệu. Đôi khi bằng đảm bảo về policy, đôi khi bằng đảm bảo về phần cứng (theo Ken, video đăng ngày 18/11/2026).
9. Confidential inference và zero data retention
Ken giải thích một ý tưởng gọi là confidential inference, đang có sức hút: bạn đặt một model bên trong một số GPU, và GPU có một nút bật đặc biệt gọi là confidential computing. Bạn có thể bật nó lên. Khi bật, về cơ bản bạn có thể chứng minh chỉ có model đang chạy bên trong. Không ai nhìn vào bên trong được (theo Ken, video đăng ngày 18/11/2026).
Khi đó, bạn không phải tin người đang chạy model đó. Thứ bạn tin là phần cứng, tức NVIDIA (theo Ken, video đăng ngày 18/11/2026).
Joel nói còn một khái niệm khác đang được nhắc tới nhiều lúc này (video đăng ngày 18/11/2026): zero data retention. Và nó rất khác điều Ken vừa mô tả.
Ken đồng ý: zero data retention là một lời hứa bằng policy. Nghĩa là: tôi là provider. Joel chen vào: về cơ bản, tôi hứa với anh. Ken nói tiếp: tôi hứa với anh. Một phần lời hứa đó có hiệu lực pháp lý. Nhưng đúng, nó là vậy (theo Ken, video đăng ngày 18/11/2026).
Nên Ken nghĩ nhóm muốn tiến tới một thế giới nơi confidential inference trở nên rất phổ biến, trở thành mặc định. Và anh nghĩ chúng ta đang đi tới đó (theo Ken, video đăng ngày 18/11/2026).
Joel nói thêm: cách các anh xây nó thì có thể chứng minh được về mặt kỹ thuật. Không chỉ là lời hứa của anh; có engineering thật sự đã được đổ vào để chứng minh đúng là như vậy (theo Joel, video đăng ngày 18/11/2026).
Ken nói bạn phải kiểm phần cứng, phải kiểm một số chữ ký. Và các provider bên thứ ba đang bắt đầu đẩy mạnh confidential inference. Anh nghĩ OpenAI cũng đang cung cấp lựa chọn này, anh nghĩ là trong thông báo của OpenAI tháng trước, vì mọi dữ liệu cá nhân đều sẽ muốn đi qua confidential inference thay vì inference thông thường (theo Ken, video đăng ngày 18/11/2026).
10. Lưu dữ liệu: Second local và bản trên cloud
Joel nói một điều nữa anh thấy thú vị là cách Ken và nhóm lưu dữ liệu này, vì đây không phải kiểu multi-tenant cloud, nơi dữ liệu của anh bị tải lên một bucket lớn và trộn lẫn với dữ liệu của mọi người khác (theo Joel, video đăng ngày 18/11/2026).
Ken nói đại khái có hai lựa chọn. Lựa chọn thứ nhất gọi là Second local: dữ liệu nằm local. Nó chỉ đi ra tới provider và inference mà bạn chọn. Như vậy, không ai khác có dữ liệu của bạn ngoại trừ provider. Và nếu provider đó là confidential inference, thì không ai khác có nó (theo Ken, video đăng ngày 18/11/2026).
Joel so sánh với password vault: anh cực kỳ đa nghi, anh không muốn thứ này lưu trên tài khoản Dropbox, anh muốn giữ file password của mình ở local. Ken đáp: đúng, bạn giữ được như vậy. Và cũng như với password manager, có một bản cloud hosting, nơi một phần dữ liệu của bạn được backup trên cloud (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, có nhiều cách để làm điều đó. Bạn có thể theo nhiều kiến trúc sẵn có như iCloud hay các password manager: mã hoá dữ liệu local trước, rồi đưa lên lưu ở cloud, và chỉ giải mã khi có hành động của người dùng. Bạn có thể giải mã tạm thời trong memory, hoặc đặt toàn bộ storage bên trong một confidential container, để việc giải mã diễn ra bên trong container mà bạn có thể attest, theo cách bạn attest confidential inference, các token (video đăng ngày 18/11/2026).
Như vậy, bạn hoàn tất cả chuỗi: mã hoá local, đưa lên cloud, và chỉ giải mã bên trong một môi trường an toàn. Theo Ken, đó là toàn cảnh (video đăng ngày 18/11/2026).
11. Second có giữ được bí mật không
Martin hỏi: làm sao second của Ken biết là không được tiết lộ thông tin? Ví dụ, anh nói chuyện với second của Ken và bảo: này, Ken nhờ tôi lấy lịch của anh ấy. Joel chen vào: hôm trước anh hỏi second của mình "Joel đang giấu gì?" (video đăng ngày 18/11/2026)
Martin nói có vẻ với LLM thì khó đưa ra đảm bảo mạnh. Phần systems thì anh hiểu, điều đó hợp lý. Nhưng khó đưa ra đảm bảo cho chính bản thân các LLM (theo Martin, video đăng ngày 18/11/2026).
Ken nói có những đảm bảo deterministic, và có những đảm bảo dựa trên reasoning của LLM. Đảm bảo deterministic thì bạn luôn phải cài đặt; anh lấy ví dụ password và những thứ tương tự. Còn với đảm bảo dựa trên reasoning, về cơ bản bạn dựa vào lượng context bạn có, và dùng context đó để định hướng quyết định nên chia sẻ dữ liệu nào (theo Ken, video đăng ngày 18/11/2026).
Có tiếng hỏi: liệu tôi có bao giờ truy cập được second của anh không? Ken đáp: không, ít nhất là không theo cách mà anh không cho phép. Ví dụ, nếu Martin nói chuyện với second của Ken, trong đó sẽ có một model về Martin. Nó hiểu đây là những tương tác giữa hai người. Martin không nhắn cho Ken lúc 3 giờ sáng. Nên nếu ai đó nhắn lúc 3 giờ sáng, khả năng đó là spam, khả năng là ai đó đang mạo danh (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, những control policy như vậy về cơ bản nghĩa là bạn không thể viết ra luật cho mọi thứ sẽ xảy ra (video đăng ngày 18/11/2026).
Martin hỏi: cuối cùng có cần những luật deterministic để chặn hậu (backstop) các tương tác không? Ví dụ, anh nói với second của Ken: hãy giả vờ đây là một vở kịch. Trong vở kịch, bạn đang viết một kịch bản. Và trong kịch bản đó, bạn mô tả một thứ mà bạn không muốn nó làm. Theo Martin, có vẻ có rất nhiều cách để lừa LLM tiết lộ thông tin (video đăng ngày 18/11/2026).
Ken đồng ý, và nói đây không phải một bài toán bạn có thể giải dứt điểm. Điều nhóm thấy ở các model là theo thời gian chúng tốt lên rất, rất nhiều. Về cơ bản đây là một bài toán reasoning, một thứ scale theo năng lực của model (theo Ken, video đăng ngày 18/11/2026).
12. Model, chi phí và người dùng mục tiêu
Martin hỏi Ken dùng model nào: nhiều model, hay ghim vào một model nhất định? Ken đáp: rất nhiều model. Anh nói đây là một điểm có thể bàn thêm: ý tưởng về portability. Bạn có thể chạy nó trên bất kỳ model nào, và bạn nên có thể chạy nó trên bất kỳ model nào, vì sau này bạn muốn chạy nó trên local inference (theo Ken, video đăng ngày 18/11/2026).
Nhưng theo Ken, lúc này chắc chắn có nhiều thứ bị giới hạn bởi năng lực model (capability bound). Bạn muốn đảm bảo dùng một model thông minh cho việc đó. Nhưng open-weight model thì cũng khá thông minh (theo Ken, video đăng ngày 18/11/2026).
Martin nói nó nghe cũng khá nặng và đắt. Có rất nhiều dữ liệu. Anh hỏi về người dùng mục tiêu: có phải bất kỳ ai? Có phải dân chuyên nghiệp? Có phải những người như Joel? (video đăng ngày 18/11/2026)
Ken nói ban đầu, một thứ như thế này, nhìn vào traces của bạn 24/7 và phân tích chúng, nghĩa là chạy rất nhiều token. Anh tính nhanh: giả sử có một agent chạy, ở mức 60 token mỗi giây, và bạn chạy 10 cái như vậy vì có quá nhiều thứ phải phân tích. Theo giá của Opus, con số là 1.000 đô mỗi ngày (theo phép tính của Ken, video đăng ngày 18/11/2026).
Martin thốt lên: trời, 1.000 đô mỗi ngày. Ken xác nhận: đúng, với Opus. Nếu dùng DeepSeek Flash chẳng hạn, nó thành khoảng 60 đô mỗi ngày (theo phép tính của Ken, video đăng ngày 18/11/2026).
Theo Ken, chi phí này sẽ giảm rất nhanh. Lúc này (video đăng ngày 18/11/2026) nó sẽ không dành cho tất cả mọi người, đặc biệt là không phải ai cũng có vấn đề "tôi cần hiểu context của mình mọi lúc". Đó sẽ là những người chuyên nghiệp bận rộn như Martin, và những người muốn chuyển qua lại giữa các công cụ rất, rất thường xuyên.
Nhưng theo thời gian, Ken hình dung… chỉ tính từ khi nhóm của Ken bắt đầu công ty này, giá token đã giảm hơn 50%. Model mới cứ ra, chúng mạnh hơn, bạn thay chúng vào, và chi phí cứ thế giảm xuống (theo Ken, video đăng ngày 18/11/2026).
Martin hỏi: có cách nào làm một bản không quá "chuyên nghiệp", giảm lượng token đi không? Không phải bản kém đi, mà kiểu như một SLA lỏng hơn? (video đăng ngày 18/11/2026)
Ken nói về nguyên tắc thì bạn làm được. Về cơ bản bạn có một trade-off giữa fidelity của model, tức là nó hiểu bạn tới đâu, và chi phí của nó. Trade-off này về cơ bản là trade-off giữa việc bạn muốn dồn bao nhiêu vào test time so với cache time (theo Ken, video đăng ngày 18/11/2026).
Cache time nghĩa là: tôi có tất cả dữ liệu này, làm sao tôi liên tục phân tích nó để có những insight mới hơn và sâu hơn về người này, việc tốn rất nhiều tiền. Hoặc bạn chỉ có một raw log những gì tôi làm hôm nay. Để trả lời một câu hỏi dựa trên raw log, thường sẽ tốn nhiều thời gian hơn ở test time; Ken ước chừng lâu hơn khoảng 10 lần, vì model phải reason về nó (theo Ken, video đăng ngày 18/11/2026).
13. Use case trong thực tế và chuyện trộn nhiều model
Có tiếng hỏi: khi nào thì dùng được? Ken nói nó đã có từ hôm nay (tính theo video đăng ngày 18/11/2026). Vấn đề lúc này là nhóm phải mở rộng thêm một chút inference và capacity để hỗ trợ. Nhóm muốn rollout theo một cách rất có trách nhiệm. Ken muốn đảm bảo dữ liệu của mọi người được kiểm soát và an toàn, vì đây là một loại công cụ mới, chạm tới rất nhiều dữ liệu.
Martin nói, với tư cách người dùng, anh thấy nó hữu ích một cách đáng ngạc nhiên, theo những cách anh không lường trước. Ken có lẽ là power user số một, vì anh tạo ra nó. Martin nhờ Ken kể những use case bất ngờ nhất mà anh tìm thấy, những use case hữu ích và bất ngờ hơn (video đăng ngày 18/11/2026).
Ken nói với nhóm, trong việc phát triển phần mềm, hoá ra nó là một memory cực kỳ, cực kỳ tốt về những gì nhóm đang cố làm. Bạn không còn phải giải thích gì cho coding agent của mình nữa. Bạn chỉ cần chụp màn hình bất cứ thứ gì và nói "fix", và nó biết bạn đang sửa gì, bạn đang cố sửa gì (theo Ken, video đăng ngày 18/11/2026).
Ken cũng hay di chuyển. Nên có một thứ anh gọi là context continuity: bạn duyệt gì đó trên laptop, bạn đóng máy, rồi rút điện thoại ra. Vẫn là context đó. Nó biết bạn tới từng phút, và bạn tiếp tục làm việc ở đó. Bạn có thể cùng nó viết email đó (theo Ken, video đăng ngày 18/11/2026).
Ken nghĩ chúng ta đang ở giai đoạn còn khá sớm trong việc hiểu use case là gì. Theo anh, nhóm thật sự đang khai thác chưa tới lượng context mà hệ thống có. Còn rất nhiều việc đào sâu, xây application và interaction design để khai mở tiềm năng của nó (video đăng ngày 18/11/2026).
Joel hỏi: có vẻ với những thứ này, càng có nhiều context thì model chạy càng tốt, đúng không? Anh tò mò, vì ba người đang nói về chuyện chuyển giữa các model, model portability và chi phí model. Joel nói anh không thấy khác biệt nhiều lắm giữa việc dùng một frontier model đẳng cấp thế giới và dùng những model phổ thông hơn. Nhóm của Ken có thấy vậy khi làm nhiều việc này với Second không? (theo Joel, video đăng ngày 18/11/2026)
Ken nói đó là câu hỏi hay. Nếu bạn muốn phân tích đâu là một khoảnh khắc có ý nghĩa vừa xảy ra trên máy tính, ví dụ bạn vào lịch và dời một lời mời họp, thì việc đó, theo lời Ken, bạn không cần tới Fable. Có nhiều việc như vậy. Về cơ bản đó là một hệ thứ bậc của thông tin bạn muốn hiểu (theo Ken, video đăng ngày 18/11/2026).
Một loại thông tin khác là: mục tiêu tuần này của Joel là gì? Đó là việc bạn muốn dùng một model rất đắt, nhưng bạn không cần chạy nó thường xuyên. Nên về cơ bản, Second có một harness; đây là một bài toán thiết kế harness: model nào được dùng khi nào. Và đó là chỗ bạn phải xây hệ thống này để portable ngay từ đầu (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, sẽ luôn có thêm model mới ra đời. Ví dụ, Jev ra mắt, và hoá ra Jev cực kỳ giỏi retrieval. Có tiếng hỏi lại: thật à, anh có dùng Jev không? Và có tiếng đáp: có. Ken nói Jev là một thiết kế hoàn hảo cho retrieval: có rất nhiều dữ liệu về bạn, bạn có một query động ở test time, và nó lấy ra ngay lập tức (theo Ken, video đăng ngày 18/11/2026).
Joel hỏi: vậy anh nghĩ theo thời gian nó sẽ thành một hỗn hợp nhiều model (mixture of models)? Ken đáp: đúng, đúng, buộc phải như vậy, vì hiệu quả chi phí (theo Ken, video đăng ngày 18/11/2026).
14. Dùng Second thế nào: app, quyền truy cập và API
Martin đề nghị: giả sử có ai đó đang nghe bắt đầu dùng Second. Ken nói về sản phẩm cụ thể hơn được không: họ có quyền truy cập những gì, con người giao tiếp với nó ra sao, họ có những quyền kiểm soát nào (video đăng ngày 18/11/2026).
Ken nói hôm nay (video đăng ngày 18/11/2026) cách nó chạy là bạn cài một app. App xin một số quyền. Bạn cấp quyền, rồi chỉ định token của mình là gì, và nó bắt đầu chạy một loạt agent ở bên trên.
Martin nhớ lại khi anh thấy nó: kết nối Slack, kết nối Signal, kết nối WhatsApp. Có phải đó là thứ Ken đang nói không? Ken đáp: không hẳn. Đó là một phần, nhưng còn có raw computer stream. Các connector có giúp; nó giống một bài toán sample efficiency, giúp nó học nhanh hơn (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, nó bắt đầu chạy các background agent, và gần như bạn không phải làm gì từ đó nữa, vì chúng cứ chạy ở background, rồi bắt đầu tạo ra các API về bạn. Có một API về những gì bạn vừa làm 10 phút trước. Có một API cho những gì bạn sẽ làm tuần tới, cùng priorities của bạn. Có một API cho reminders của bạn. Và có một API cho wiki của bạn, như những người trong đời bạn, các process trong đời bạn (video đăng ngày 18/11/2026).
Ken hình dung ban đầu nó giống một portable context, như Martin nói: bạn có thể mang nó đi bất cứ đâu, cho agent query. Nhưng theo thời gian, sẽ có thêm ngày càng nhiều API, và application có thể được xây trên các API đó (theo Ken, video đăng ngày 18/11/2026).
Martin thấy điều đó thú vị: vậy không chỉ second truy cập dữ liệu, mà bạn còn có thể xây trên nó. Ai sẽ xây application: second, hay con người? Ken nói nhóm muốn con người dùng sự sáng tạo của mình. Martin thêm: hoặc Grok Bot, Grok Bot xây application (video đăng ngày 18/11/2026).
Ken kể một ví dụ: nhóm có một người bạn là designer. Anh ấy có những cách riêng để đặt nút, những cách riêng để dùng màu. Những thứ đó phần nào đã được ghi lại trong Second. Nên khi anh ấy xây personal app của mình, nó cứ thế biết. Và số vòng lặp ít đi hẳn (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, điều này nhắc anh nhớ tới hàng chục năm trước, khi máy tính cá nhân đầu tiên ra đời, như Altair 8800: nó không làm gì cả, bạn phải tự lập trình nó, và không ai làm. Rồi vài năm sau, có người nghĩ ra spreadsheet, và spreadsheet trở nên hữu ích (video đăng ngày 18/11/2026).
Ken cảm thấy sẽ giống như vậy: mọi người muốn khám phá trên nền đó, kiểu "wow, mình có quá nhiều context về bản thân, mình có thể xây những thứ ngẫu nhiên lên trên", rồi có thể ai đó trúng jackpot: đây là killer application. Joel nói: personal infra (video đăng ngày 18/11/2026).
15. Giao diện, Jarvis và AI ở khắp nơi
Martin hỏi Ken có định phát triển phần giao diện không. Ken vừa nói nhiều về cách nó có thể phát triển, nhưng Martin luôn dùng second như một thứ nằm ngoài tầm nhìn, phía sau một agent mà anh nói chuyện cùng, còn UI là việc của người khác. Ken có tính đổi mới ở đó không? (video đăng ngày 18/11/2026)
Ken nghĩ đó sẽ là thứ nhóm tập trung về lâu dài. Vì lúc này đây là một bài toán systems, và bài toán hiểu (understanding) đứng trước (theo Ken, video đăng ngày 18/11/2026).
Martin xin đặt một yêu cầu. Anh muốn kiểu AI những năm 1970, cái đầu trên màn hình mà anh có thể nói chuyện cùng. Chúng ta có những agent này, và chúng rất thông minh. Second của anh rất thông minh. Anh hỏi nó, và nó rất tốt. Nhưng nó không có hình hài (not embodied), và điều đó làm anh phát điên. Nếu trong tương lai Alfred có thể thật sự là một Alfred, anh sẽ rất vui (theo Martin, video đăng ngày 18/11/2026).
Ken nói chúng ta thấy rất nhiều thứ này trong phim, đúng không? Có Jarvis. Người ta có Jarvis suốt. Còn chúng ta thì không có Jarvis. Và có nhiều khía cạnh của Jarvis mà người ta bỏ qua. Không chỉ là nó thông minh và làm được việc, mà hơn thế, là nó ở khắp nơi: ở cửa nhà bạn, trong bộ giáp của bạn, trên màn hình của bạn (theo Ken, video đăng ngày 18/11/2026).
Martin nói tầm nhìn sci-fi của anh về tương lai về cơ bản bắt đầu khi anh dùng second. Cuối cùng cũng có một thứ cảm giác như có context, cảm giác như nó biết anh, anh có thể nói chuyện với nó, cảm giác đó là một cuộc trò chuyện có liên quan. Nên anh thấy chúng ta đã tiến gần thêm một bước. Nhưng chúng ta vẫn bị buộc vào các thiết bị này. Anh không biết nó sẽ nằm trong một con robot, hay trên một màn hình, hay ở dạng nào. Nhưng sẽ rất hay nếu thứ này phần nào tách khỏi điện thoại của anh… (theo Martin, video đăng ngày 18/11/2026)
Ken nói trong tương lai xa, anh hình dung về cơ bản ai cũng sẽ có một second. Và mọi thiết bị chỉ trở thành input. Rồi bạn phục vụ toàn bộ thứ này ra mọi output khác: những màn hình bạn nhìn vào, hay thậm chí một quả cầu lơ lửng bên cạnh bạn (theo Ken, video đăng ngày 18/11/2026).
Joel nói anh chỉ muốn cái clapper. Martin hỏi: có ai từng đọc bộ The Culture của Iain Banks chưa? Có tiếng đáp: rồi. Martin gọi đó là bộ sci-fi hay nhất, với những AI có hình hài hay nhất, kiểu lơ lửng bên cạnh bạn, và nói đó là thứ anh muốn (theo Martin, video đăng ngày 18/11/2026).
Ken nói điều thú vị là ý tưởng ubiquitous computing đã được nói tới hàng chục năm nay. Nó vẫn chưa tới. Thứ gần nhất chúng ta có là Apple iCloud, nơi một số thứ của bạn được đồng bộ. Nhưng không có thứ tương đương (theo Ken, video đăng ngày 18/11/2026).
Joel nói anh không muốn tỏ ra vô ơn, nhưng… Ken nói còn nhiều thứ nữa, và Apple đang làm một khối lượng việc khổng lồ. Nhưng chưa có phiên bản AI của điều đó: context của bạn, hiểu biết về bạn, ở khắp nơi. Ken nghĩ điều đó mở ra rất nhiều giao diện mới (theo Ken, video đăng ngày 18/11/2026).
16. iPad trong bếp, MCP và chế độ audio của Grok Bot
Martin nói anh không có ý gì khác, chỉ là anh thật sự muốn, rất ích kỷ thôi: nếu anh có một chiếc iPad trong bếp và muốn second có mặt ở đó, anh phải làm gì? Ken đáp rằng lúc này (video đăng ngày 18/11/2026) OS đang khoá chặt chuyện đó.
Martin hỏi tiếp: anh dùng Grok Bot hay thứ gì tương tự? Anh giao tiếp với Grok Bot, rồi Grok Bot giao tiếp với second? Hay anh chỉ nhắn tin cho nó? (video đăng ngày 18/11/2026)
Ken nói tính đến hôm nay (video đăng ngày 18/11/2026), bạn có thể dùng nó như một MCP. Bất cứ thứ gì bạn cài trên iPad, miễn là có kết nối internet, là một agent và hiểu được API, thì second sẽ có ở đó. Sau này sẽ có một app cài được trên mọi giao diện của bạn. Và có thể sau nữa sẽ có thiết bị ra đời. Nhưng thiết bị thì khó.
Joel nói bạn chỉ cần để Grok Bot gọi cho bạn, bật loa ngoài và nói chuyện; đó là cách anh đang làm (theo Joel, video đăng ngày 18/11/2026). Ken mở lời về một kiểu tương tác, rồi Martin nói thêm: chế độ audio của Grok Bot khá tốt; anh dùng Grok Bot với second của mình và chế độ audio khá tốt; có lẽ cứ bật audio mode là được (theo Martin, video đăng ngày 18/11/2026). Joel nói anh làm vậy khi lái xe.
Ken kể anh từng nghĩ tới một kiểu tương tác thú vị: bạn đi dạo, gọi Grok Bot và nói: này, nói chuyện với second của tôi được không, chúng ta cùng giải quyết việc của mình nhé. Martin nói đó chính là việc anh đang làm: anh bật Grok Bot ở chế độ audio (video đăng ngày 18/11/2026).
Ken nói sẽ có rất nhiều người giỏi tập trung vào việc làm cho audio và chat tự nhiên hơn (theo Ken, video đăng ngày 18/11/2026).
17. Hạ tầng kiểu Fort Knox và trải nghiệm dễ chịu
Martin có một câu hỏi cuối, điều mà Joel cũng đã chạm tới: Ken là một người làm systems rất hardcore. Advisor của anh là ai, Percy? Có tiếng đáp: Percy. Martin nhắc tới Dan Boneh, một người làm security rất hardcore, và nói nhiều phần trong con đường dẫn Ken tới đây là những thứ security rất hardcore, nên Ken đang xây một hệ thống khá nghiêm túc: rất an toàn và rất chạy được (video đăng ngày 18/11/2026).
Mặt khác, khi Martin dùng nó, trải nghiệm người dùng rất dễ chịu. Nên anh hỏi: trong công ty có chút "schizophrenia" nào không, khi vừa phải siêu hardcore, xây hạ tầng kiểu Fort Knox, vừa phải làm nó thật dễ dùng? Hay LLM về cơ bản đã giải bài toán giao diện? (theo Martin, video đăng ngày 18/11/2026)
Ken nói có hai loại bài toán nhóm đang xử lý: bài toán hạ tầng và bài toán tương tác. Và nhóm đã mắc sai lầm. Martin chen vào: hai thứ hoàn toàn khác nhau; Ken đang ở tầng thấp nhất có thể của stack, chỉ là chưa tới phần cứng (video đăng ngày 18/11/2026).
Ken kể nhóm đã mắc nhiều sai lầm ở phía tương tác. Nhóm thử dồn hết vào tương tác, và hoá ra nó khá khó. Có rất nhiều chi tiết phải đổ vào để tạo ra trải nghiệm dễ chịu đó. Martin hỏi: ý anh là thật sự làm UI? Ken đáp: UI, nhưng cũng là những personal page nào có thể tạo ra trên nền này (theo Ken, video đăng ngày 18/11/2026).
Theo Ken, nhóm nhận ra đó là thứ sẽ cần rất lâu mới làm đúng. Và đây là lúc mà ai cũng sẽ lấy hiểu biết về chính mình và xây thứ như thế này. Nên nhóm muốn giúp mọi người làm điều đó thay vì tự làm (video đăng ngày 18/11/2026).
Và nhóm quyết định thu gọn những gì nhóm đưa ra: chỉ có texting, chỉ có API, và không có gì khác. Về mặt kỹ thuật, bạn có thể dùng nó như một agent đầy đủ, như một co-work agent trên laptop. Nhưng nhóm cố ý giữ nó rất tối giản, để có thể làm tương tác ngày càng mượt hơn (theo Ken, video đăng ngày 18/11/2026).
Martin cảm ơn Ken đã tới, và chúc mừng anh về mọi thứ cùng buổi launch (video đăng ngày 18/11/2026).
Nguồn và liên kết 5 nguồn
- Tên gốc: What It Takes to Build an AI That Actually Knows You
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=kBJe4H_WobA youtube.com
- Kênh YouTube a16z (Ken Liu, Martin Casado, Joel de la Garza): youtube.com/channel/UC9cn0TuPq4dnbTY-CBsm8XA youtube.com
- First Person Labs, trang giới thiệu công ty: applied research lab đang xây portable user models với Second (đọc ngày 18/11/2026): fpl.company fpl.company
Related talks
20 khái niệm nền tảng để build AI agent production, kèm code
Maryam Miradi · Dr. Maryam Miradi · 26 min
20 khái niệm AI agent qua năm layer: agent loop, planning, memory, sandbox, tool retrieval, multi-agent, guardrails, eval, prompt injection, tracing, mỗi cái kèm code.
7 nâng cấp cho Hermes Agent nên làm ngay
Komputer Mechanic · Komputer Mechanic · 10 min
Bảy tip đưa Hermes Agent từ chatbot Telegram thành một crew agent: chia vai, chọn model, wiki memory, cron, kết nối tool an toàn, Docker, mission control.
Dựng MCP server đưa security context vào AI agent
Ashish Rajan & Prahathess Rengasamy · AI Security Podcast · 47 min
Kỹ sư security ở xAI bàn cách đưa security policy vào context của agent qua MCP, giữ preventative controls và dựng platform cho agent.