Why Your Agent Disagrees With Itself (And What To Do About It)
AI Engineer World's Fair 2026: Online Track · Video gốc
Agent flip-flop là dấu hiệu của gray zone: dùng disagreement để chọn ca cho người review, rồi thêm semantic và episodic memory thay vì fine-tune.
1. Diane Lin: từ nghiên cứu AGI tới agent cho SOC
Talk này trả lời hai câu hỏi: vì sao AI agent của bạn lại bất đồng với chính nó, và bạn nên làm gì với chuyện đó. Người trình bày là Dianhuan Lin, thường gọi là Diane.
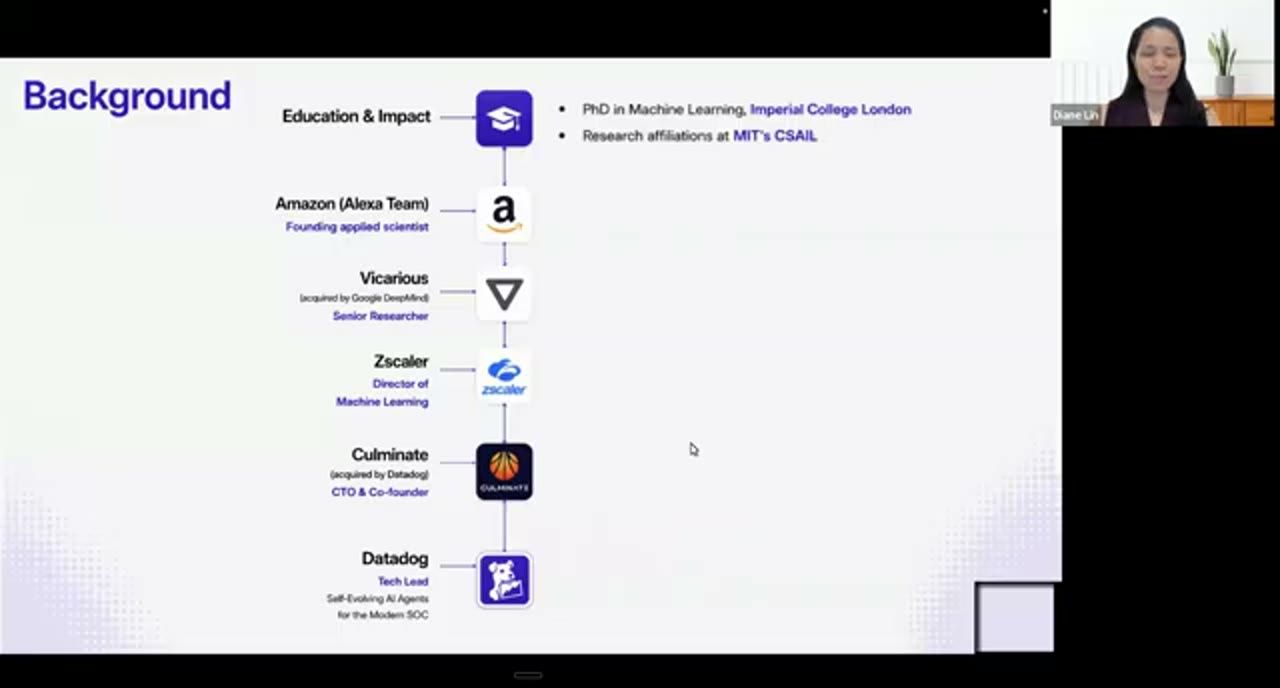
Diane kể nhanh hành trình của mình. Chặng đường với AGI của chị bắt đầu từ PhD tại Imperial College London, nơi chị làm về continual learning. Sau đó chị làm cùng Giáo sư Josh Tenenbaum ở MIT về one-shot learning, tức là học từ chỉ một ví dụ duy nhất. Tiếp theo, chị may mắn có mặt đúng lúc Alexa ra mắt: chị là một trong ba applied scientist đầu tiên của nhóm question answering trên Alexa.
Rồi chị bị cuốn sang một startup làm AGI ở Silicon Valley tên là Vicarious. Theo lời chị, Vicarious ngày nay là một phần của Google DeepMind. Ở đó chị được làm những nghiên cứu tiên phong về zero-shot transfer learning. Sau vài năm làm AGI, chị quyết định rẽ sang thế giới ứng dụng ở Zscaler, một công ty cybersecurity, nơi chị áp dụng đủ loại model machine learning khác nhau để giải các bài toán bảo mật.
Sau năm năm ở Zscaler, chị đồng sáng lập công ty riêng, xuất phát từ chính nỗi đau đã thấy ở đó. Culminate xây AI agent để tự động triage security alert, giúp SOC (security operations center) làm việc hiệu quả hơn. Chị rất tự hào khi Culminate được Datadog mua lại đầu năm nay. Giờ chị là người của Datadog và dẫn dắt việc phát triển self-evolving agent, tức agent tự tiến hoá theo thời gian.
2. Vấn đề: cùng model, cùng input, khác output
Lộ trình của talk gồm bốn phần. Đầu tiên là vấn đề mà nhiều khả năng bạn đang gặp hằng ngày khi xây AI agent: sự thiếu nhất quán (inconsistency). Sau đó là câu hỏi inconsistency đến từ đâu, vì phải hiểu nguồn gốc thì mới tìm ra lời giải. Tiếp theo là vài trade-off giữa các giải pháp khác nhau, và cuối cùng là kết quả thực nghiệm cho thấy các giải pháp đó khả thi tới đâu.
Hiện tượng chắc bạn đã thấy: cùng một model, cùng một input, nhưng output khác nhau. Diane nói rõ ở đây chị không nói về chuyện câu chữ khác nhau, mà là output khác nhau về mặt ngữ nghĩa, tức là kết luận khác nhau. Có thể bạn đang nghĩ: đó là bản chất stochastic của LLM thôi. Chị bảo hãy giữ suy nghĩ đó lại, rồi cùng xem vài ví dụ cụ thể.
Ví dụ thứ nhất là sentiment analysis: bạn giao cho model nhiệm vụ gán nhãn từng review khách sạn là positive hoặc negative. Đây là một task NLP rất điển hình, và LLM ngày nay làm việc này rất tốt. Thế nhưng có một vấn đề. Khi bạn đưa cùng input này vào cùng một LLM, thỉnh thoảng bạn sẽ thấy kết luận (verdict) khác nhau khi chạy nhiều lần. Điều đó có nghĩa là một lần chạy evaluation duy nhất không kể cho bạn toàn bộ câu chuyện.
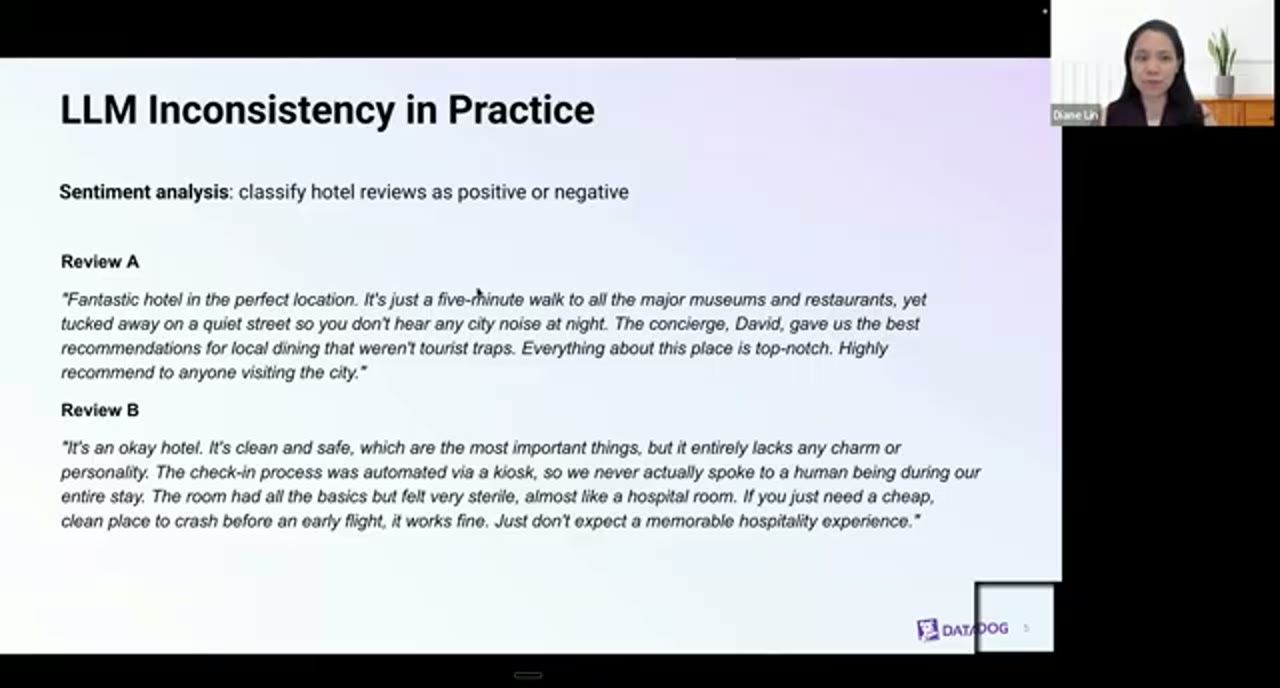
3. Trong cybersecurity, flip-flop là vấn đề niềm tin
Vì một lần chạy không đủ, bạn phải lặp lại evaluation nhiều lần và lấy trung bình kết quả các lần chạy thì mới có bức tranh tổng thể. Nghe thì giống một sự bất tiện kỹ thuật, nhưng thực tế nó nghiêm trọng hơn nhiều. Diane đưa sang một lĩnh vực khác để cho thấy điều đó: cybersecurity.
Hãy tưởng tượng bạn là một security analyst. Công việc hằng ngày của bạn là triage security alert: quyết định một alert là malicious, nghĩa là bạn phải hành động để chặn cuộc tấn công, hay là false alarm, nghĩa là thực ra nó benign và có thể bỏ qua. Alert ví dụ ở đây là: phát hiện một lần đăng nhập thất bại vào tài khoản Gmail từ một IP đáng ngờ.
Nếu giao những task tương tự như thế cho AI agent và chạy nhiều lần, bạn sẽ thấy có alert lúc nào cũng ra benign, có alert lúc nào cũng ra suspicious qua các lần chạy. Nhưng cũng có những ca mà agent lật qua lật lại (flip-flop) giữa benign và suspicious. Lúc này khách hàng sẽ rất khó dùng sản phẩm của bạn, vì họ sẽ tự hỏi: tôi nên tin kết quả nào? Như vậy inconsistency đang gây ra một vấn đề về niềm tin (trust) đối với sản phẩm.
Diane đưa thêm một hình ảnh: bạn đang ở trong một vòng POC bake-off, tức khách hàng cho nhiều vendor chạy thử song song để so. Một vendor cho verdict nhất quán mọi lúc, vendor còn lại có verdict flip-flop. Bạn có thể đoán ai sẽ thắng hợp đồng.
Chị khá chắc là bạn muốn giải quyết vấn đề này. Việc đầu tiên là phải tìm ra inconsistency đến từ đâu.
4. Gray zone: dữ liệu nằm sát decision boundary
Tin tốt là những data point hay flip-flop thực ra tập trung quanh decision boundary, vùng mà Diane gọi là gray zone. Chị minh hoạ lại bằng ví dụ sentiment analysis với hai review.
Review thứ nhất, dù chạy qua LLM bao nhiêu lần, cũng luôn được gán nhãn positive. Ca này quá rõ: review cực kỳ tích cực. Review thứ hai mới là ca hay bị lật. Nhìn kỹ thì nó nằm ngay trên ranh giới. Có những chữ trong đó đọc lên thì tương đối tích cực, nhưng cũng có lúc lại hơi tiêu cực.
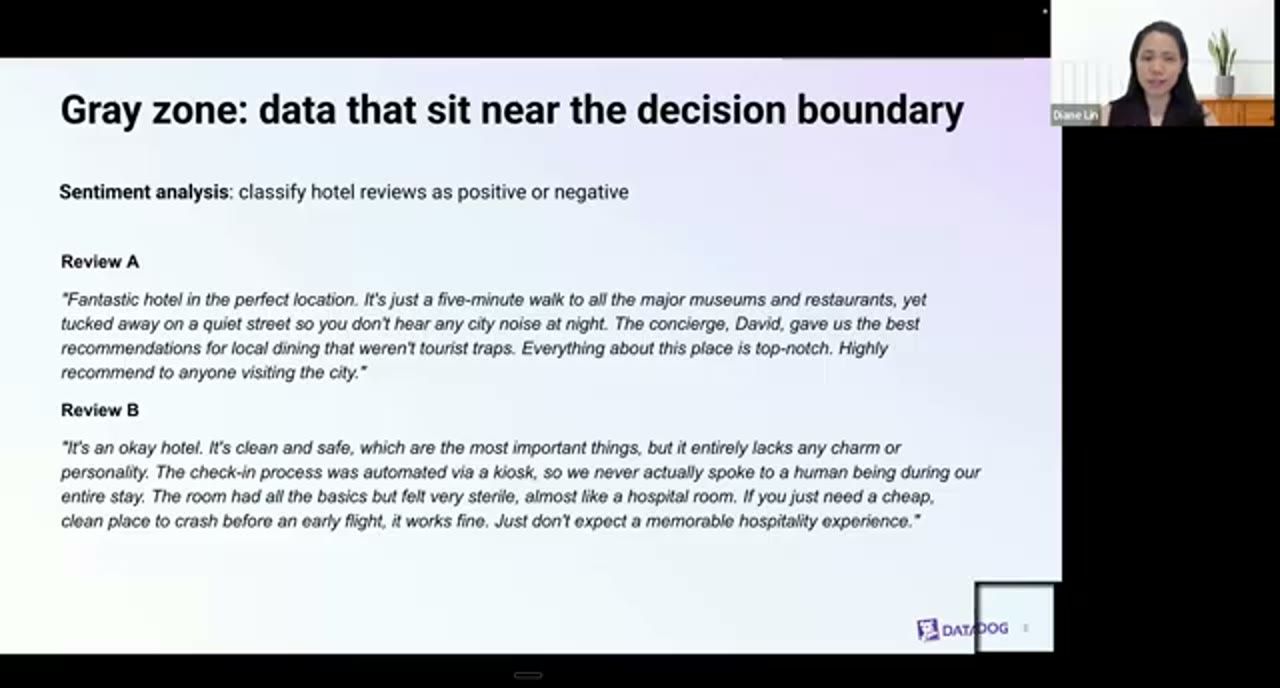
Với những ca như vậy, chính các chuyên gia con người cũng sẽ bất đồng với nhau. Thực ra ở đây không có đáp án đúng hay sai. Mọi thứ phụ thuộc vào policy và preference của từng công ty. Một khách sạn có thể nghĩ rằng review kiểu này nói về thứ họ chẳng làm gì được để cải thiện cái gọi là trải nghiệm đáng nhớ (Diane nói nhịu "memorial" rồi bật cười sửa thành "memorable"), nên không gán nhãn negative, vì chẳng có hành động nào để làm. Nhưng một khách sạn khác lại quan tâm tới đúng điểm đó và muốn gán nhãn negative để còn cải thiện. Cuối cùng, nó quy về preference của bạn.
5. Gray zone trong security: kẻ tấn công gõ cửa nhưng chưa vào
Quay lại ví dụ cybersecurity. Đây cũng là một ca nằm trên ranh giới, và lý do là: có vài lần thử đăng nhập. Đúng là có kẻ tấn công đang gõ cửa, nhưng có thể nó chưa vào được.
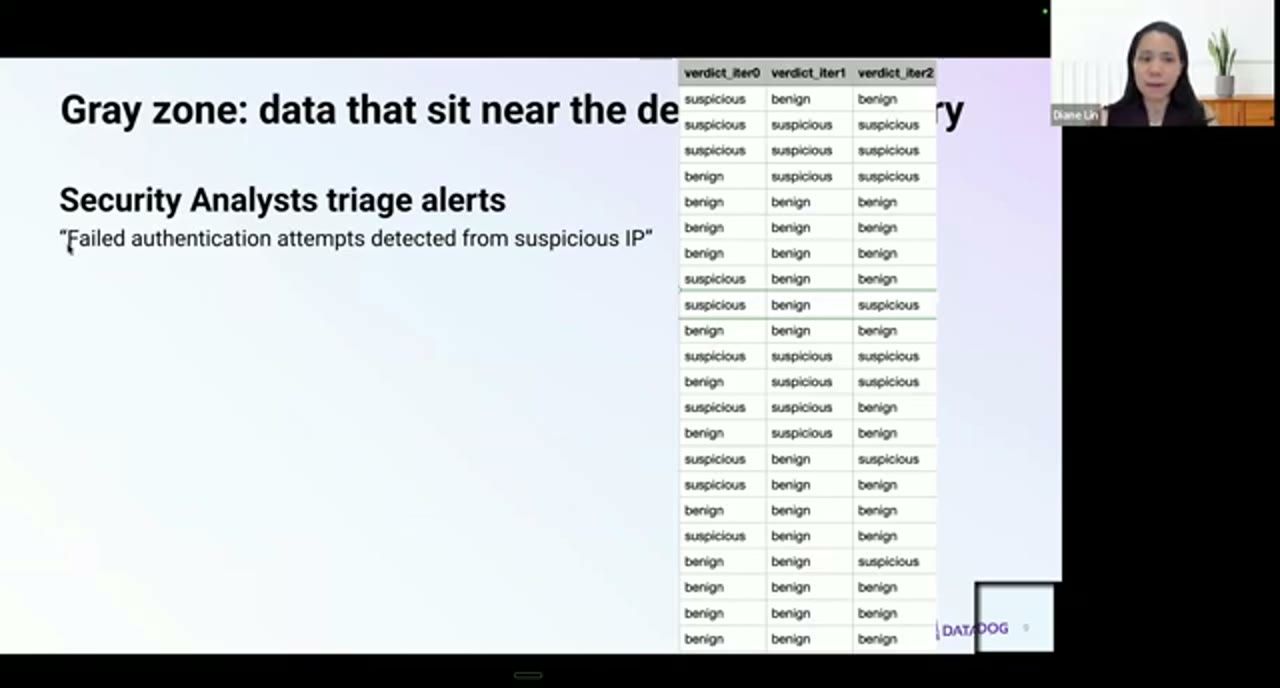
Với khách hàng enterprise, lúc nào cũng có kẻ tấn công gõ cửa. Nếu chúng chưa vào được môi trường, khách hàng không muốn bận tâm, nếu không họ sẽ ngập trong loại alert này. Họ chẳng cần làm gì, vì kẻ tấn công đã bị chặn ở ngoài rồi. Nhưng nếu kẻ tấn công đoán đúng mật khẩu, vượt qua được MFA và vào được môi trường, thì chuyện trở nên rất nghiêm trọng và bạn phải hành động.
Tức là hành vi lúc đầu gần như giống hệt nhau, nhưng kết cục rất khác nhau và cách phản ứng cần có cũng khác nhau, tuỳ vào việc đó thực sự là một cuộc tấn công đã thành hay kẻ tấn công vẫn còn ở ngoài. Vì vậy gán nhãn malicious hay benign ở đây phụ thuộc vào preference của công ty: họ có muốn được báo về tình huống như thế không. Một lần nữa, đây là ví dụ mà kết quả phụ thuộc vào preference của bạn và vào thông tin bổ sung để phân biệt hai kịch bản.
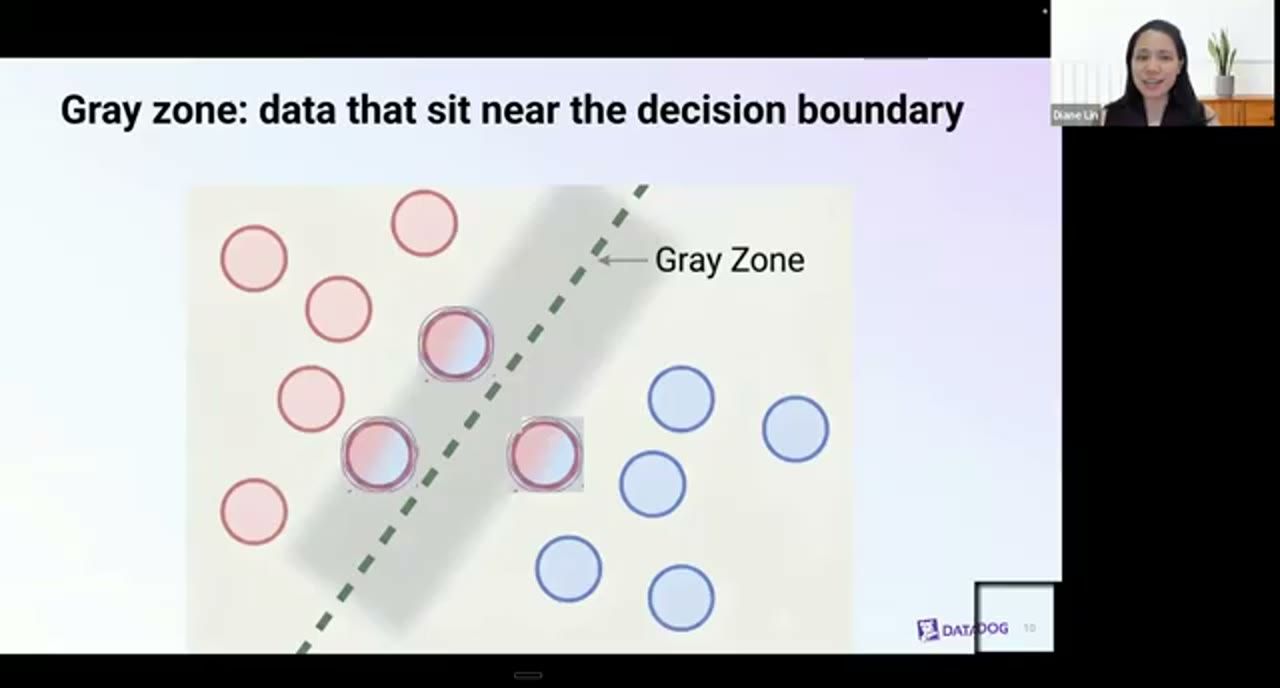
Từ hai lĩnh vực rất khác nhau, bạn thấy cùng một quy luật: những data point hay flip-flop là những điểm nằm gần decision boundary, nơi cần bạn làm rõ để phân định nó thực sự thuộc về bên nào. Đây cũng chính là những data point mà chuyên gia con người hay mắc lỗi, và các classifier machine learning truyền thống cũng chật vật với chúng. Nói cách khác, đó không phải lỗi của AI agent. Agent của bạn chỉ đơn giản là chỉ ra sự mơ hồ vốn đã tồn tại sẵn.
6. Active learning: biết chính xác cần nhìn vào đâu
Giờ đã biết root cause của inconsistency nằm ở đâu, bước tiếp theo là xác định chính xác chúng ở chỗ nào, là những ca nào, rồi sửa chúng. Điều vừa bất ngờ vừa không bất ngờ là lời giải để tìm ra gray zone đã có sẵn trong machine learning, và nó tên là active learning.
Ý tưởng của active learning như sau. Bạn có rất nhiều data point cần gán nhãn. Hãy hình dung bạn có một model ban đầu, đưa nó lên production, có thể ở monitor mode, và muốn kiểm tra chất lượng, nhưng bạn không có đủ thời gian để xem hết. Nếu xem hết thì còn gì là ý nghĩa của việc để agent làm thay. Dù vậy bạn vẫn muốn biết model làm chưa tốt ở đâu. Active learning là cách chọn ra những data point mà model có xu hướng sai, và nhờ đó cho bạn biết nên dồn sự chú ý vào đâu.
Diane đi qua pipeline active learning của machine learning truyền thống, rồi xem nó khác gì trong thời LLM và AI agent.
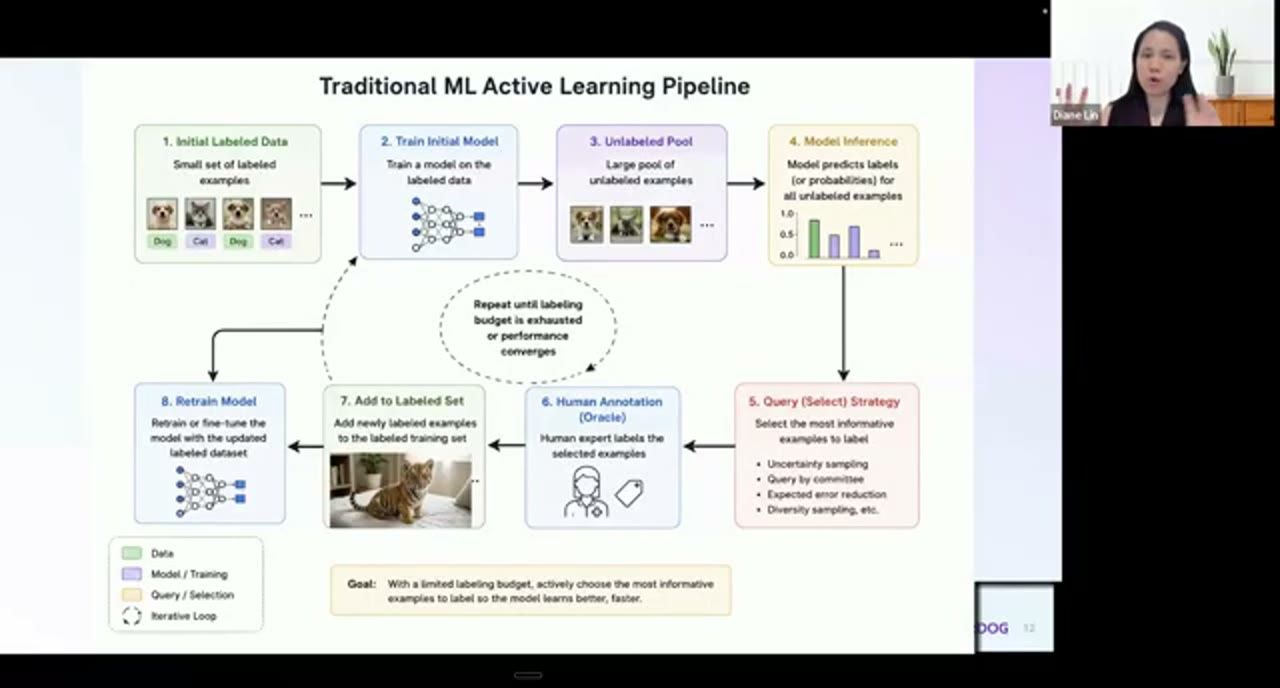
Trước hết bạn train model ban đầu, rồi cho nó dự đoán trên tập dữ liệu chưa gán nhãn, có thể chính là dữ liệu online ở production. Từ đó bạn thấy có những ca model không chắc chắn vì xác suất xấp xỉ 0.5. Đó là những data point giàu thông tin nhất, nơi model sẽ học được nhiều nhất. Uncertainty là một loại tín hiệu cho biết model dễ sai ở đâu.
Một cách phổ biến khác để tìm ra ca có vấn đề là query by committee: cho vài model khác nhau, hoặc thậm chí cùng một model chạy nhiều lần, rồi tìm chỗ chúng bất đồng. Đó cũng là chỗ model dễ sai, và là chỗ cần con người làm rõ nhãn để model học theo.
Sau khi đã đưa những data point có vấn đề lên để con người xem lại lần hai, người đó đảm bảo nhãn thực sự đúng, hoặc xác định ca đó có cần thêm thông tin để phân định hay không, tức là thêm feature mới. Rồi bạn đưa dữ liệu đã gán nhãn, và có thể cả feature bổ sung, vào vòng train tiếp theo. Bạn retrain model và tiếp tục vòng lặp.
Trong vòng active learning này, bạn chỉ bỏ ra rất ít công sức, hay nói cách khác, đây là một cách rất hiệu quả để tìm ra data point có vấn đề và dồn sự chú ý vào những điểm mà model học được nhiều nhất. Đó là phiên bản truyền thống.
7. Active learning trong thời LLM: chọn theo disagreement
Tin tốt là cách làm với LLM không khác mấy. Có hai phần chính cần tinh chỉnh: một là selection strategy (cách chọn ca), hai là bước retrain.
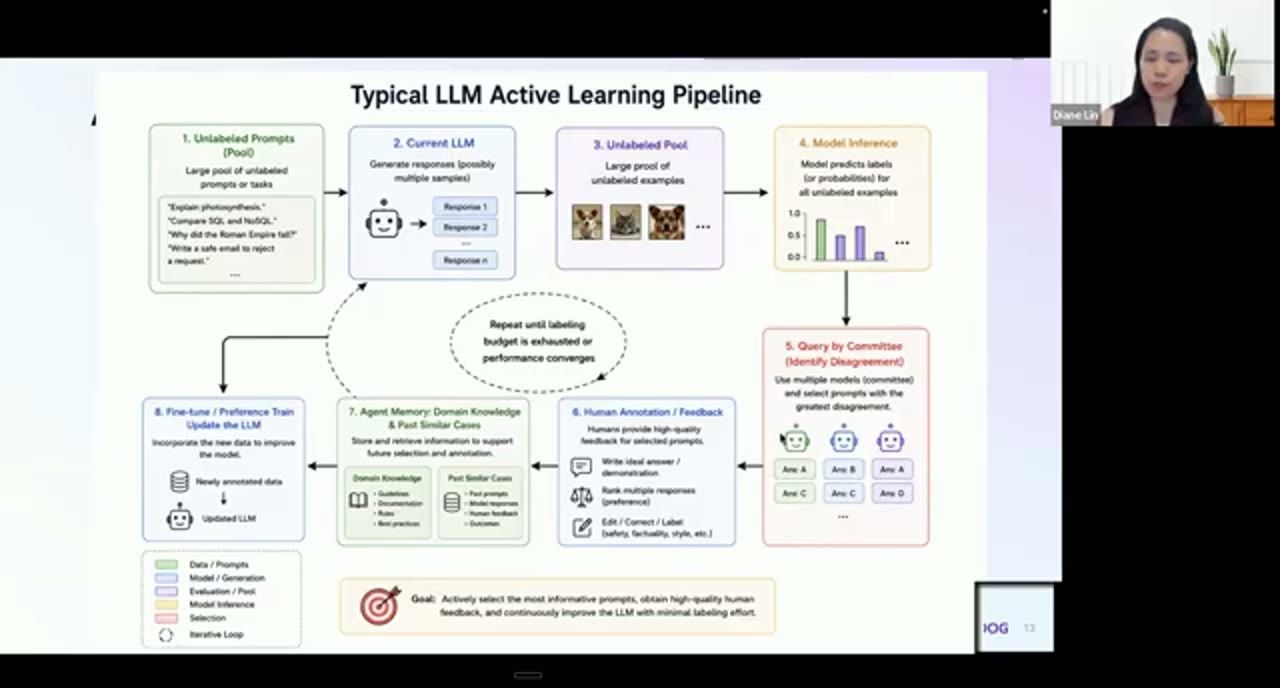
Về selection strategy, Diane khuyên dùng hướng tìm disagreement. Ít nhất là theo những gì nhóm chị đã thử tới nay, uncertainty score do LLM tự báo không đáng tin lắm. LLM không biết là nó không biết gì. Khi nó rất tự tin, điều đó không có nghĩa là nó đúng.
Ngược lại, disagreement giữa các lần chạy khác nhau, hoặc giữa các model khác nhau, cho bạn một tín hiệu đáng tin hơn nhiều về chỗ model thực sự không chắc về verdict của mình và cần con người hướng dẫn. Sau khi tìm ra nhóm ca bất đồng cần chú ý này, bạn gán nhãn và đưa feedback y như trước.
8. Không cần fine-tune đắt tiền: semantic memory
Đến đây có thể bạn nghĩ: "À, tới lúc retrain model rồi." Diane trả lời: vừa đúng vừa không. Đúng, một lựa chọn là retrain model, nhưng fine-tune model thì đắt. Nhóm chị đề xuất một giải pháp nhẹ hơn, dễ lặp nhanh hơn: bổ sung cho agent semantic memory và episodic memory.
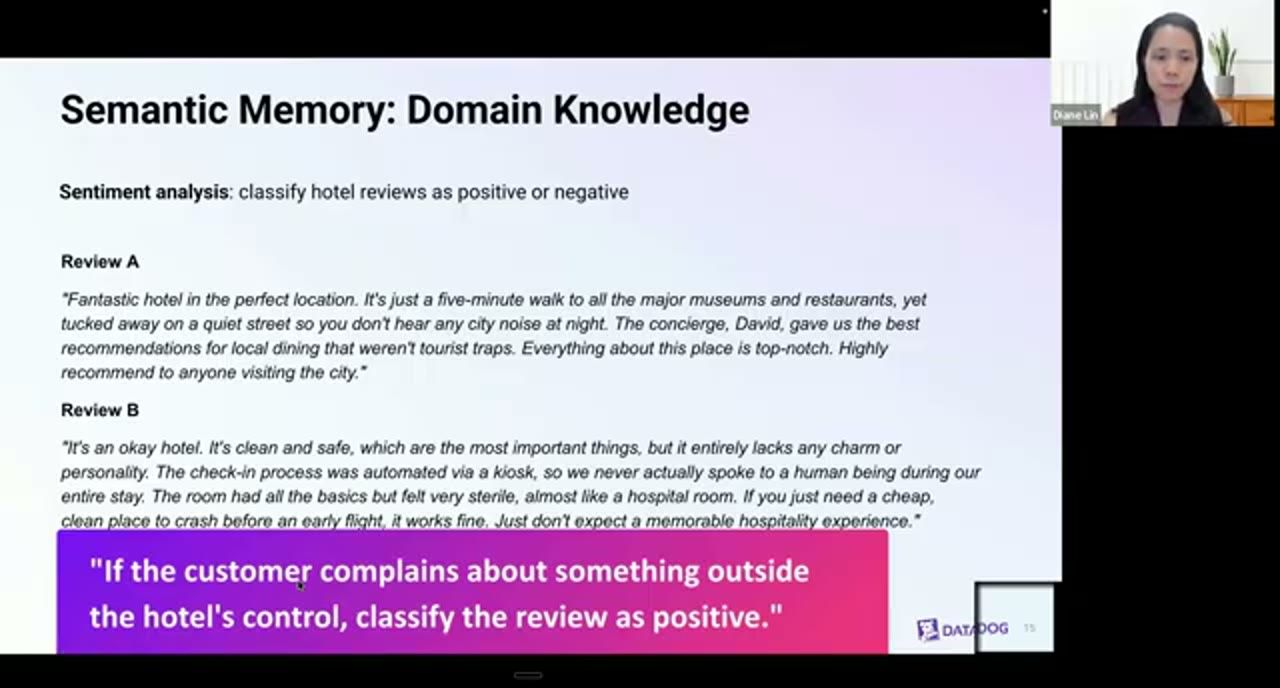
Chị dùng lại ví dụ cũ để minh hoạ. Như đã nói, những ca hay bị lật chủ yếu là vì thiếu thông tin về policy hoặc preference của từng công ty. Bạn có thể đưa thông tin đó vào knowledge base. Với khách sạn: nếu khách phàn nàn về điều gì đó nằm ngoài tầm kiểm soát của khách sạn thì phân loại review là positive, vì bạn không muốn tốn sự chú ý vào loại này.
Với ví dụ cybersecurity cũng tương tự. Bạn có thể ghi rằng: password spray, tức kẻ tấn công thử đoán mật khẩu nhiều lần với nhiều giá trị khác nhau, nếu thất bại liên tục và không có lần đăng nhập thành công nào thì nên coi là benign. Ngược lại, nếu cuối cùng có một lần đăng nhập thành công thì nên coi là malicious.
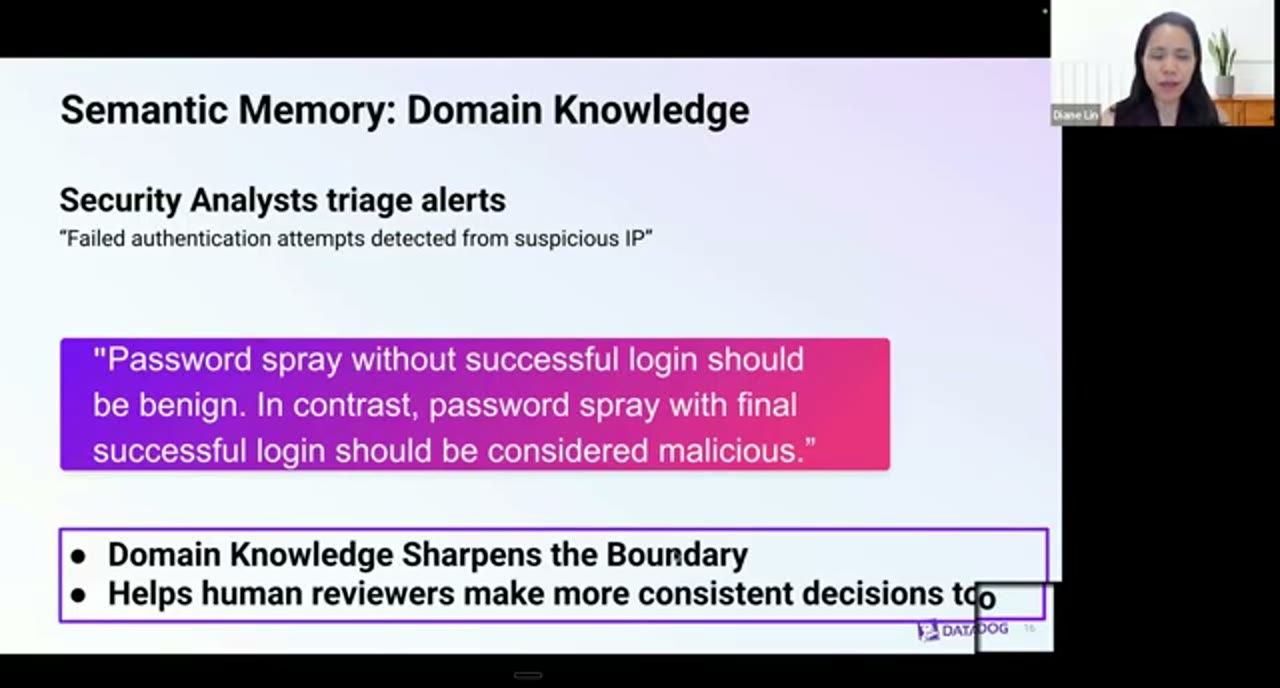
Ở đây bạn đã xác định được thông tin bổ sung để phân định hai trường hợp, rồi gán nhãn chúng riêng biệt. Chính sự rõ ràng đó giúp model học, và cũng giúp chuyên gia con người gán nhãn nhất quán hơn. Loại domain knowledge này làm decision boundary sắc nét hơn và giúp cả con người.
Kiểu kiến thức này giống như factual knowledge, và thuộc về semantic memory.
If the customer complains about something outside the hotel's control, classify the review as positive.

Password spray without successful login should be benign. In contrast, password spray with final successful login should be considered malicious.
9. Episodic memory: dựa vào các ca tương tự trong quá khứ
Semantic memory đối lập với episodic memory. Episodic memory dùng cho trường hợp bạn chưa kịp chắt lọc lý do đằng sau những ca trước, vì sao ca đó nên nằm phía malicious hay phía benign. Thay vào đó bạn nói: tôi đã thấy những ca tương tự thế này trước đây, chúng được gán nhãn benign, hãy dựa vào những ca quá khứ tương tự đó và quyết định theo.
Ưu điểm của episodic memory là nó tương đối tự động, ít cần con người can thiệp. Nói đúng hơn, phần can thiệp của con người đã được làm trong quá khứ rồi. Khi agent đang làm việc online, nó có thể tự tham chiếu những ca đó và ra quyết định mà không phải chờ bạn chắt lọc lý do rồi đưa vào semantic knowledge.
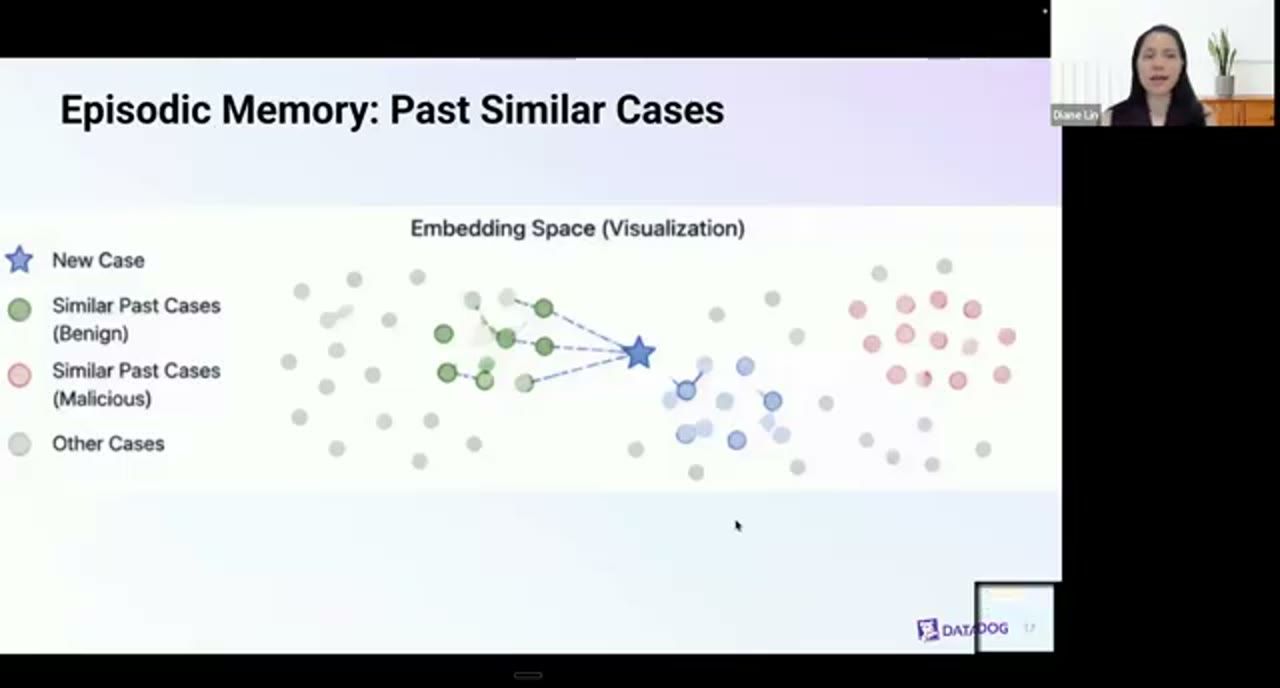
Ý tưởng là tìm những ca tương tự với ca đang xét, rồi dùng quyết định trước đây của chúng làm tham chiếu. Giờ hãy tưởng tượng có một ca mới nằm lơ lửng ở giữa, không thuộc nhóm quá khứ nào. Đó là ca vẫn cần con người chú ý.
Đây cũng là cách episodic memory tự xử lý những ca lặp lại. Điều này đặc biệt hữu ích với security alert, vì rất nhiều noise, nhất là noise false positive, cứ lặp đi lặp lại. Đó chính là "quả ngọt ở cành thấp" mà bạn có thể tự động hoá đi. Còn sự chú ý của người review, thứ băng thông quý giá bạn có, giờ có thể dồn vào những ca mà episodic memory không giải quyết được.
10. Semantic memory và episodic memory bổ trợ nhau
Đây cũng là cách chọn giữa semantic memory và episodic memory. Hai thứ này thực ra không mâu thuẫn. Chúng bổ trợ cho nhau.
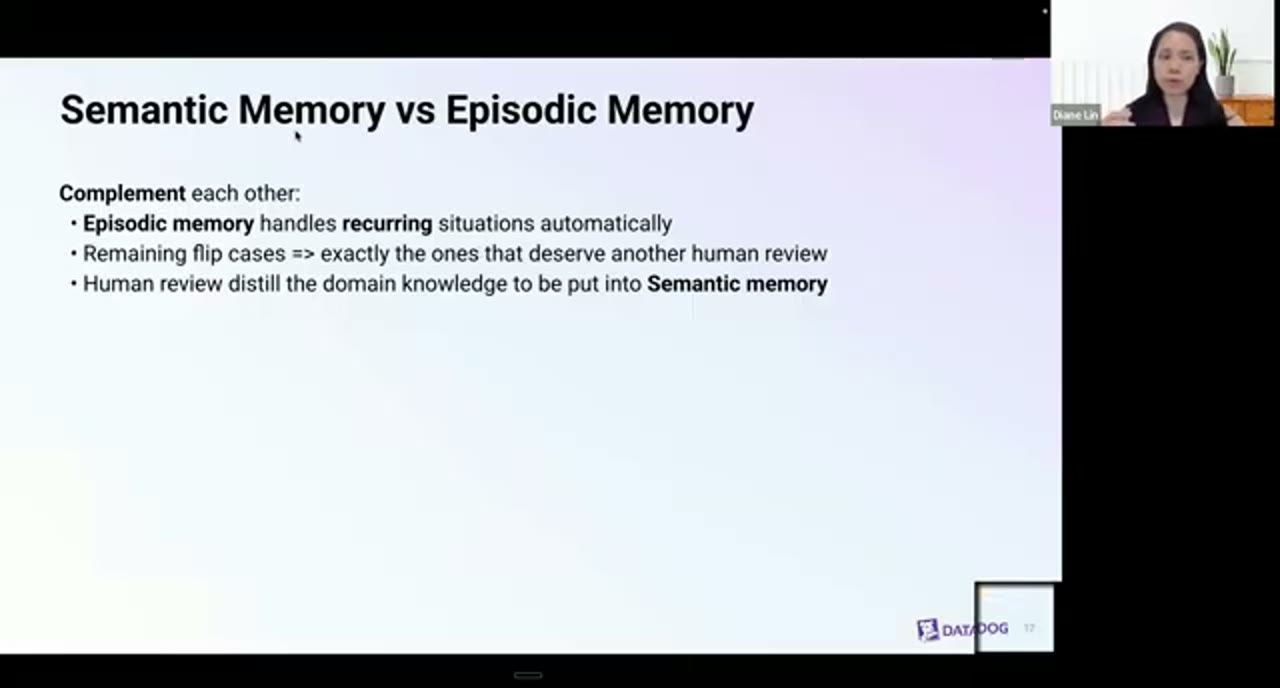
Về cơ bản, bạn dùng episodic memory để tự động xử lý những tình huống lặp lại. Phần còn lại, tức những ca vẫn flip-flop sau khi đã tham chiếu quá khứ, hoặc không có ca quá khứ nào để tham chiếu, thì chuyển cho người review. Người review chắt lọc domain knowledge và đưa nó vào semantic memory để dùng cho lần sau.
11. Một giải pháp, ba lợi ích
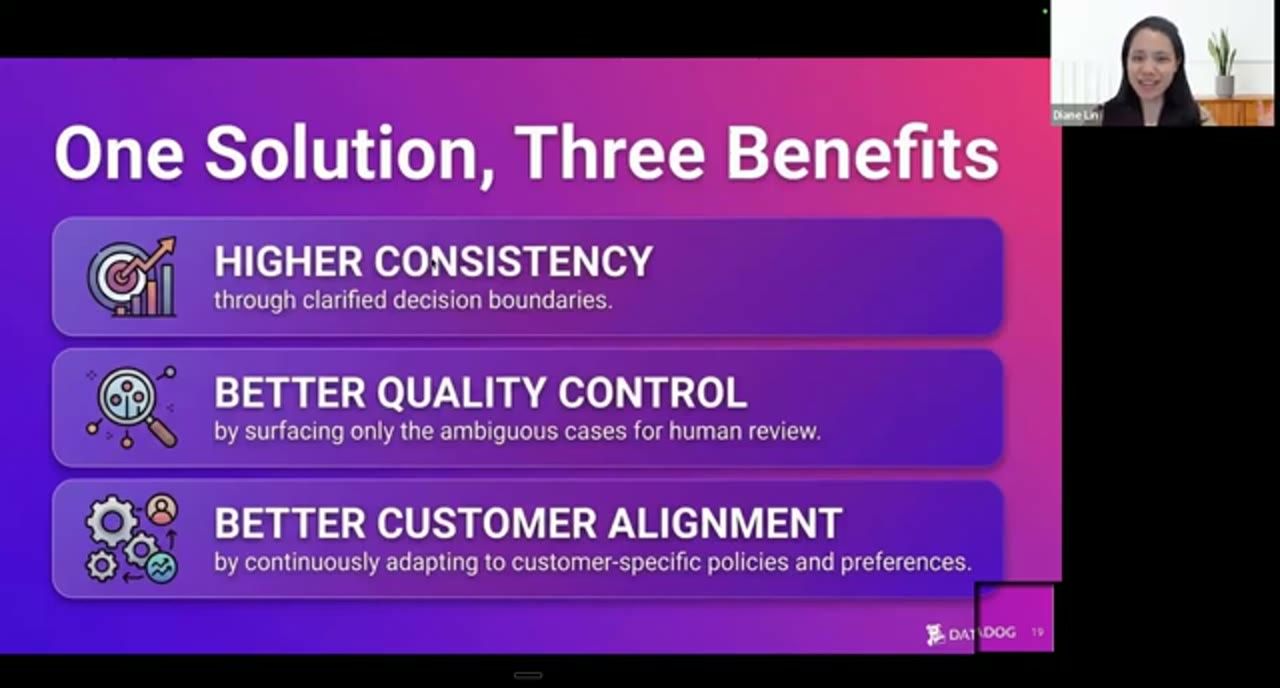
Giải pháp vừa trình bày mang lại ba lợi ích.
Thứ nhất, nhờ tìm ra những data point gần decision boundary, rồi dùng domain knowledge trong semantic memory và các ca tương tự trong episodic memory, bạn cải thiện tính nhất quán một cách đáng kể. Giờ bạn có một AI agent đáng tin hơn cho người dùng.
Hai lợi ích còn lại là sản phẩm phụ. Một là bạn có một quy trình quality control rất hiệu quả. Bạn không cần kiểm từng output của agent, mà chỉ kiểm một tập con mà thuật toán active learning cho là có khả năng có vấn đề. Bạn xem chúng, bổ sung thông tin hoặc làm rõ nhãn, và model học từ đó. Quan trọng nhất, công sức gán nhãn của bạn rất nhỏ nhưng lợi ích thu về rất cao.
Cuối cùng nhưng không kém phần quan trọng, dọc đường bạn đang thu thập feedback của khách hàng. Bạn không chỉ có một model đáng tin, nhất quán và hiệu quả cao, mà còn có một model thích nghi với môi trường của khách hàng. Diane khá chắc là khách hàng sẽ yêu sản phẩm của bạn nếu AI agent của bạn biết lắng nghe và thích nghi theo họ.
12. Kết quả thực nghiệm trên 93 alert
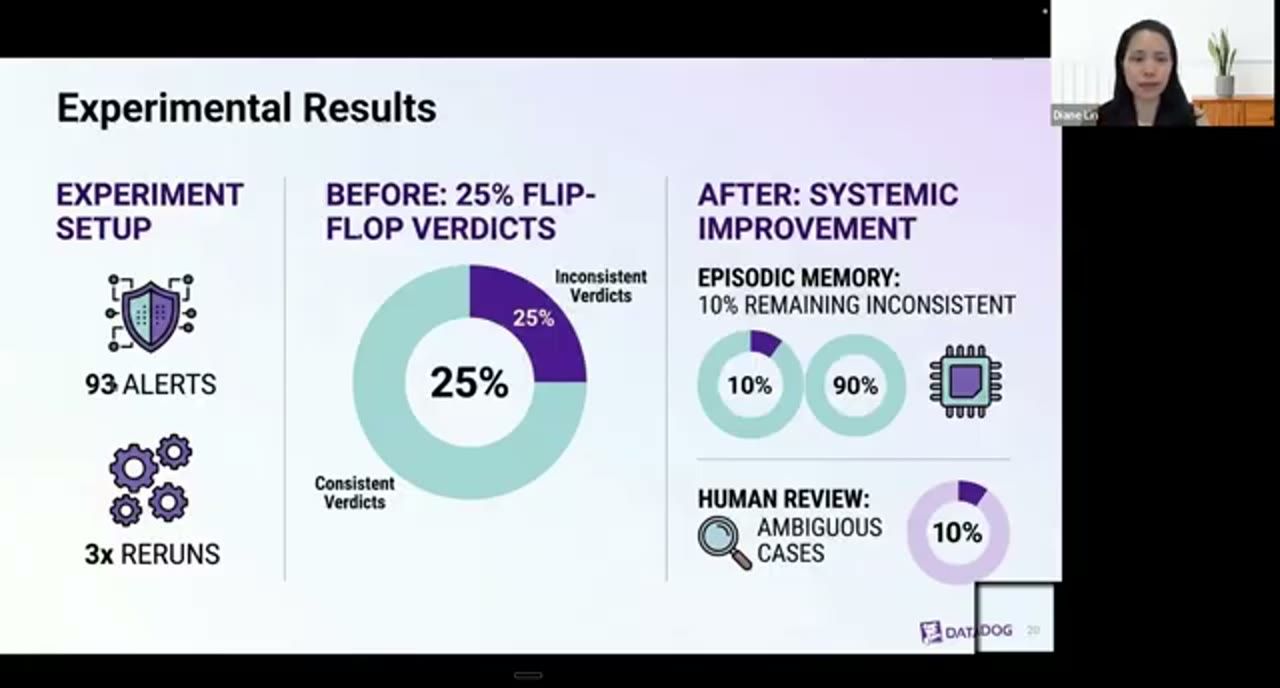
Diane đưa ra kết quả thực nghiệm trên data point thật. Nhóm chị thu thập 93 security alert và chạy mỗi alert ba lần.
Nếu không dùng giải pháp đề xuất, một phần tư số alert, tức 25%, bị flip-flop verdict. Sau khi áp dụng giải pháp, cụ thể là dùng episodic memory, khoảng 15% trong số đó trở nên nhất quán. Tuy vậy vẫn còn 10% không nhất quán. Chúng vẫn lật, có khi vì không có ca tương tự nào trong quá khứ để tham chiếu, có khi dù có tham chiếu thì sau khi "nghĩ lại" model vẫn bất đồng.
Điều đó không thành vấn đề. Episodic memory tự động hạ inconsistency đi 15%, còn 10% còn lại thì người review xem và bổ sung kiến thức để phân định những ca khó đó. Sau bước này, bạn cũng thích nghi được với môi trường của khách hàng mà bạn muốn học theo.
13. Ba điều nên mang về
Diane muốn người nghe mang về ba điều.
- Inconsistency thường không phải vấn đề của model. Đừng đổ lỗi cho model nữa. Hãy dồn sức vào vấn đề nhãn và vào khả năng thông tin chưa đủ, rồi giúp AI agent bằng sự rõ ràng bổ sung đó.
- Model disagreement không phải bug, mà là feature. Hãy coi mỗi lần bất đồng là một cơ hội để model học.
- Fine-tune không phải lựa chọn duy nhất. Hãy trang bị cho agent semantic memory và episodic memory.
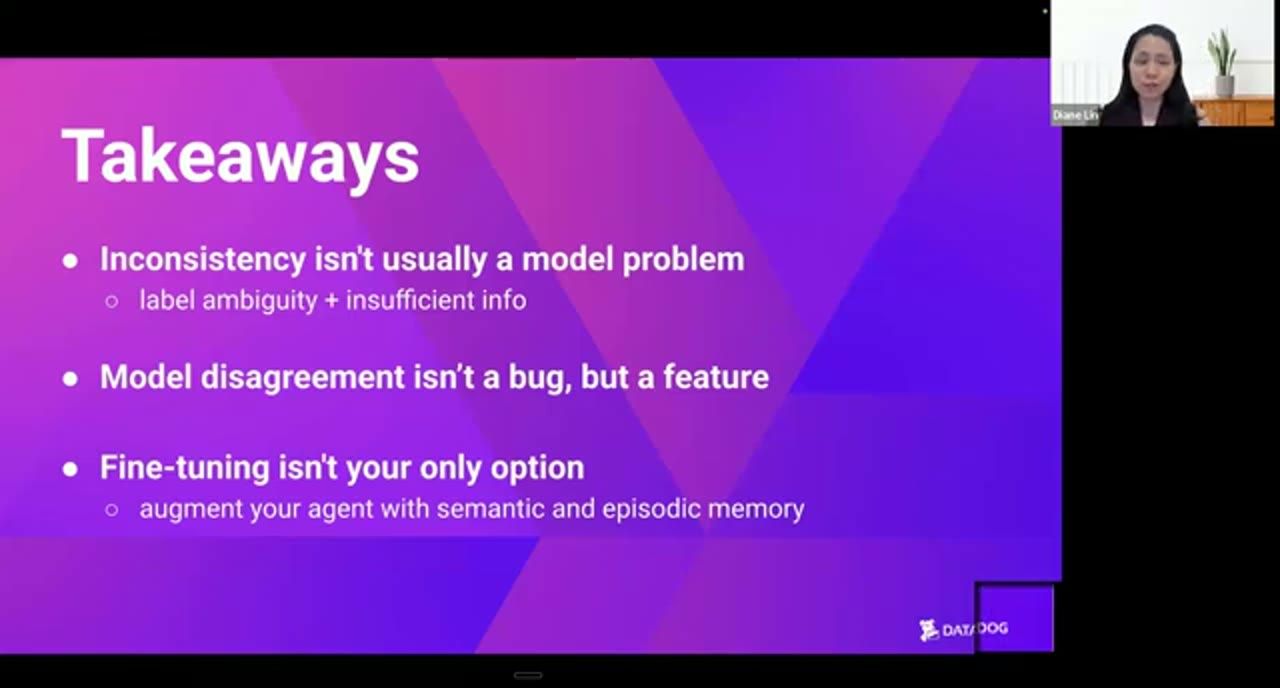
Chị mong bạn sẽ thích thú khi thấy model của mình liên tục tiến bộ và thích nghi với môi trường của khách hàng.
Cuối cùng, Diane cảm ơn các đồng nghiệp và bạn bè ở Datadog. Chị gửi lời cảm ơn đặc biệt tới bảy đồng nghiệp đã cùng chị có nhiều cuộc thảo luận thú vị và giúp chị làm rõ một số khái niệm. Chị cũng cảm ơn toàn bộ Datadog Bits Security Analyst Team đã làm cho hành trình này trở nên thú vị. Chị cảm ơn mọi người đã lắng nghe và chúc mọi người vui khi train model và thấy nó tiến bộ.
Nguồn và liên kết
- Trang talk chính thức: ai.engineer/talks/wEc9aG7cRQc
- Video gốc: youtube.com/watch?v=wEc9aG7cRQc
- Datadog: datadoghq.com
- Active learning (tổng quan): Wikipedia, Active learning (machine learning)
Related talks
The Miranda Hypothesis: How Hamilton (the Musical) Poisoned Your Persona Evals
Jacob E. Thomas · Results Generation · 58 min
Vì sao persona eval chấm fluency không bắt được persona ghép lẫn văn hoá sai thời đại, và instrument pre-registered với nhà sử học để đo fidelity.
Stop Writing Tone Instructions. Layer Them.
Isadora Martin-Dye · Isadora & Co · 21 min
Tách brand voice thành bốn layer: identity bất biến, mode theo tình huống, voice neo vào ví dụ, và một veto deterministic chặn output sai trước khi tới khách.
User Signal Dies at the Retrieval Boundary
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.