AI local không riêng tư như bạn nghĩ: năm lớp rủi ro
Năm lớp rủi ro khi chạy AI local (file, chat template, runner, port, tool), các vụ tấn công có thật, và năm cách sửa mất chừng một buổi chiều.
✓ Đã duyệt độc lập · cập nhật 26/10/2026 · 26 min
1. Khoảnh khắc nhận ra mình đã sai
Kai mở đầu bằng khoảnh khắc anh nhận ra mình đã sai hoàn toàn. Theo lời anh trong video đăng ngày 21/10/2026, anh đã chạy model AI local gần một năm: Llama, Mistral và Qwen. Anh có cả một hệ sinh thái nhỏ: Ollama trên máy desktop, vài bản fine-tune kéo về từ Hugging Face, và một setup agent mà anh thật sự tự hào. Toàn bộ ý nghĩa của việc đó là: đây là model của tôi, trên máy của tôi, theo luật của tôi.
Và anh cứ nói với mọi người rằng đây mới là lựa chọn đúng (this was the move), vì bạn làm chủ dữ liệu của mình và không ai đọc prompt của bạn cả. Hợp đồng, code, các dự án cá nhân nằm yên trên ổ cứng của bạn, thay vì mỗi lần bạn "nghĩ thành tiếng" lại nuôi pipeline training của một công ty nghìn tỷ đô nào đó. Anh nói điều đó một cách tự tin, nói đi nói lại, và nếu từng nói thẳng điều đó với ai ở phần bình luận nào đó, anh xin lỗi.
Điều anh không hiểu khi đó, và điều mà theo anh gần như không ai nói tới (video đăng ngày 21/10/2026), là câu hỏi thật sự không nằm ở chỗ dữ liệu của bạn có rời khỏi máy hay không, mà ở chỗ file của một người lạ có thể khiến cái máy đó làm gì. Anh nói đó là toàn bộ video, nên anh nhắc lại lần nữa: ai cũng hỏi "dữ liệu của tôi có được giữ riêng tư không?", nhưng gần như không ai hỏi "file model của người khác có thể khiến máy tính của tôi làm một việc không ai yêu cầu không?".
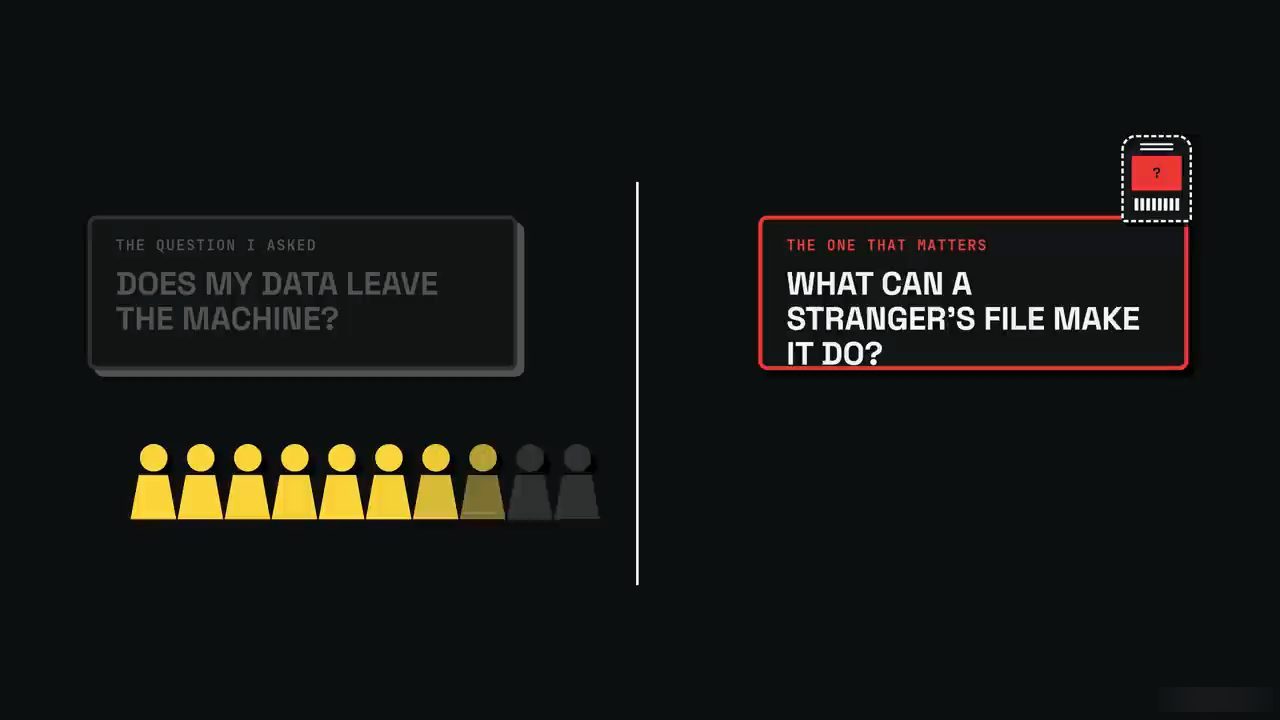
Theo Kai, tính đến 2026 (video đăng ngày 21/10/2026), câu trả lời là có, một cách lặng lẽ và gọn gàng, theo cách mà không scanner nào bắt được. Và anh nói chuyện đó đã xảy ra với một dự án thật ở một công ty bảo mật thật, với ngân sách thật là 50 đô và một lần training dài hai tiếng rưỡi (con số theo Kai, video đăng ngày 21/10/2026; bài nghiên cứu của ProjectDiscovery ghi tổng chi phí dưới 50 đô, đọc ngày 26/10/2026).
Trong video đăng ngày 21/10/2026, anh hứa sẽ đi qua chính xác cách nó hoạt động, từng lớp một, để cuối video mọi người biết thật sự phải kiểm tra gì trước khi chạy model tiếp theo. Anh nói rõ đây không phải để gieo sợ hãi, cũng không phải lời rủ quay lại cloud. Đây chỉ là những thứ anh ước có ai đó ngồi giải thích cho anh trước khi anh dựng agent đầu tiên của mình. Và trước khi vào chuyện, anh muốn công bằng với lối suy nghĩ đã đưa tất cả chúng ta tới đây, vì phần lớn lối suy nghĩ đó thật ra là đúng.
2. Lý do chạy model local phần lớn là đúng
Trong video đăng ngày 21/10/2026, Kai kể lý do anh chuyển sang chạy model local là vì anh mệt mỏi với cảm giác lúc nào cũng bị theo dõi. Không phải kiểu đội mũ giấy bạc (tinfoil hat), mà theo một cách rất nhàm chán và thực tế. Anh dán code vào các giao diện chat rồi nhận ra nó có lẽ đang đi vào một tập training ở đâu đó. Còn khi nhờ AI soạn những email nhạy cảm, thật khó mà không nghĩ rằng ai đó, ở đâu đó, trong một data center nào đó, về mặt kỹ thuật có thể đọc được chúng.
Anh nói đó không phải hoang tưởng, đó chỉ là cách các dịch vụ ấy vận hành (theo Kai, video đăng ngày 21/10/2026). Vì vậy chuyển sang local là hoàn toàn hợp lý: prompt không đi tới nhà cung cấp nào, không ai retrain trên dữ liệu của chúng ta, và không ai đổi model dưới chân chúng ta vào tháng sau chỉ vì họ vừa ship một phiên bản mới. Model nằm trên máy của chính mình, và nó chỉ là một file.
Và tự bản thân file đó thật sự gần như vô hại. Nếu bạn từng nghe ai đó nói một file GGUF "chỉ là tensor, chỉ là những con số, không phải code", Kai nói (video đăng ngày 21/10/2026) điều đó hoàn toàn đúng. Một file GGUF không thể tự chạy, cũng như một tấm ảnh JPEG không thể tự mở terminal. Nó không phải file thực thi (executable), nó là weights: hàng tỷ con số dấu phẩy động mô tả một mạng neural nên hành xử thế nào.
Thêm vào đó, theo Kai (video đăng ngày 21/10/2026), khi cài Ollama, thứ mà phần lớn mọi người đang dùng, nó mặc định bind vào localhost, tức địa chỉ 127.0.0.1 ở port 11434. Nên chỉ chính máy đó nói chuyện được với nó, và nó không mở ra internet. Anh dẫn các nhà nghiên cứu ở SentinelOne xác nhận đây là cấu hình mặc định có chủ đích khi vừa cài đặt.
3. Chuỗi lập luận "tôi an toàn" và chuyện sau ngày đầu tiên
Vậy là chuỗi lập luận đi thế này: dữ liệu của tôi ở lại đây, file model chỉ là những con số, và server chỉ nghe mỗi tôi. Nên tôi an toàn. Theo Kai (video đăng ngày 21/10/2026), vào ngày đầu tiên điều đó phần lớn là đúng: chúng ta dựng nó lên, chat với Llama, và chẳng có gì xấu xảy ra.
Vấn đề là những gì xảy ra sau ngày đầu tiên, khi chúng ta bắt đầu thêm thứ này thứ kia: khi model có tool, khi ta nối nó vào file system. Rồi ta đặt nó lên mạng trong nhà để cả laptop lẫn điện thoại đều với tới. Rồi ta kéo về một bản fine-tune "ngầu" mà ai đó đăng lên, vì nó đã được tải 300.000 lần nên chắc là ổn thôi. Theo Kai (video đăng ngày 21/10/2026), đó là lúc khoảng hở mở ra.
Và nó không mở ra bằng một tiếng nổ lớn. Nó mở ra lặng lẽ, qua năm lớp mà phần lớn chúng ta chưa bao giờ nghĩ tới như những thứ tách biệt.
4. Năm lớp của một setup model local
Kai trình bày cách anh nghĩ về một setup model local hiện giờ, và anh nói cách đóng khung này đã thay đổi mọi thứ với anh (video đăng ngày 21/10/2026). Có năm lớp, mỗi lớp có một hồ sơ rủi ro (threat profile) khác nhau. Nhưng phần lớn mọi người chỉ nghĩ tới lớp 1, và các công cụ bảo mật cũng phần lớn chỉ kiểm tra lớp 1, trong khi những cuộc tấn công thật sự đáng chú ý đang xảy ra ở lớp 2 tới lớp 5.
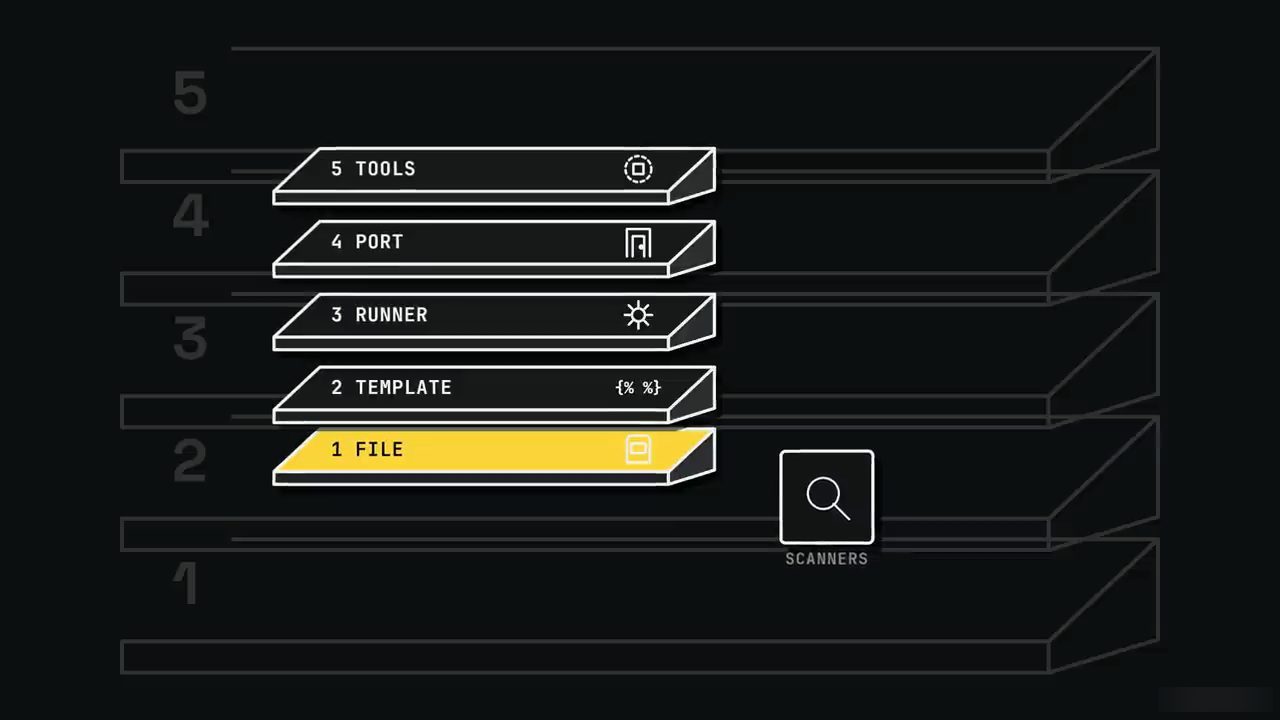
- Lớp 1 là file bạn tải về: weights, file GGUF, hay bất kỳ định dạng nào nó được phát hành. Đây là thứ ai cũng nói tới.
- Lớp 2 là chat template. Kai nói sẽ dành nhiều thời gian ở đây vì gần như không ai biết nó tồn tại, và nó thật sự khó tin (genuinely wild).
- Lớp 3 là runner: Ollama, LM Studio hay SGLang, phần mềm đọc và chạy file đó (ví dụ Kai nêu trong video đăng ngày 21/10/2026).
- Lớp 4 là port mà runner mở ra, quyết định ai có thể nói chuyện với model và từ đâu (theo cách chia của Kai, video đăng ngày 21/10/2026).
- Lớp 5 là sự kết hợp giữa weights và các tool chúng ta trao cho model, và theo Kai (video đăng ngày 21/10/2026), đây là nơi cuộc tấn công của ProjectDiscovery nằm.
5. Execute hay instruct: scanner chỉ hỏi đúng một câu
Phần khiến Kai mất một thời gian mới thấm là thế này: các security scanner, tức các bước kiểm tra có sẵn của Hugging Face, picklescan, modelscan và tất cả những công cụ còn lại, trả lời đúng một câu hỏi: file này có chứa code sẽ chạy khi bạn load nó không (theo Kai, video đăng ngày 21/10/2026).
Anh nói (video đăng ngày 21/10/2026) đó là câu hỏi đúng vào năm 2024, khi ai đó có thể giấu code Python độc hại trong một file pickle, chạy ngay khoảnh khắc model được load. SafeTensors được tạo ra đúng là để sửa kiểu tấn công đó, và đó là thứ các công cụ này giỏi tìm.
Nhưng theo Kai (video đăng ngày 21/10/2026), những cuộc tấn công mới nhất hoàn toàn không chạy code. Chúng thay đổi những gì model hiểu, những gì nó nói lại, hoặc những gì nó bảo agent làm, rồi để chính phần mềm của chúng ta làm nốt phần còn lại. Vậy nên khác biệt nằm ở chỗ: một file thực thi (executes) và một file ra lệnh (instructs). Scanner chỉ bắt được loại thứ nhất.
Anh nói hãy bắt đầu từ chỗ hiển nhiên trước khi đi sâu hơn: lớp 1.
6. Lớp 1: repo privacy-filter giả, chuyện kiểm hash và bản Ollama giả
Lớp 1 là chính file model. Theo Kai (video đăng ngày 21/10/2026), vào tháng 5/2026, một repo tên là Privacy Filter xuất hiện trên Hugging Face. Nó sao chép model card của Privacy Filter thật của OpenAI, bản OpenAI thật sự phát hành vào tháng 4, gần như từng chữ. README và phần mô tả trông đều hợp lệ, và nó leo lên vị trí số một trên trang trending của Hugging Face với khoảng 244.000 lượt tải.
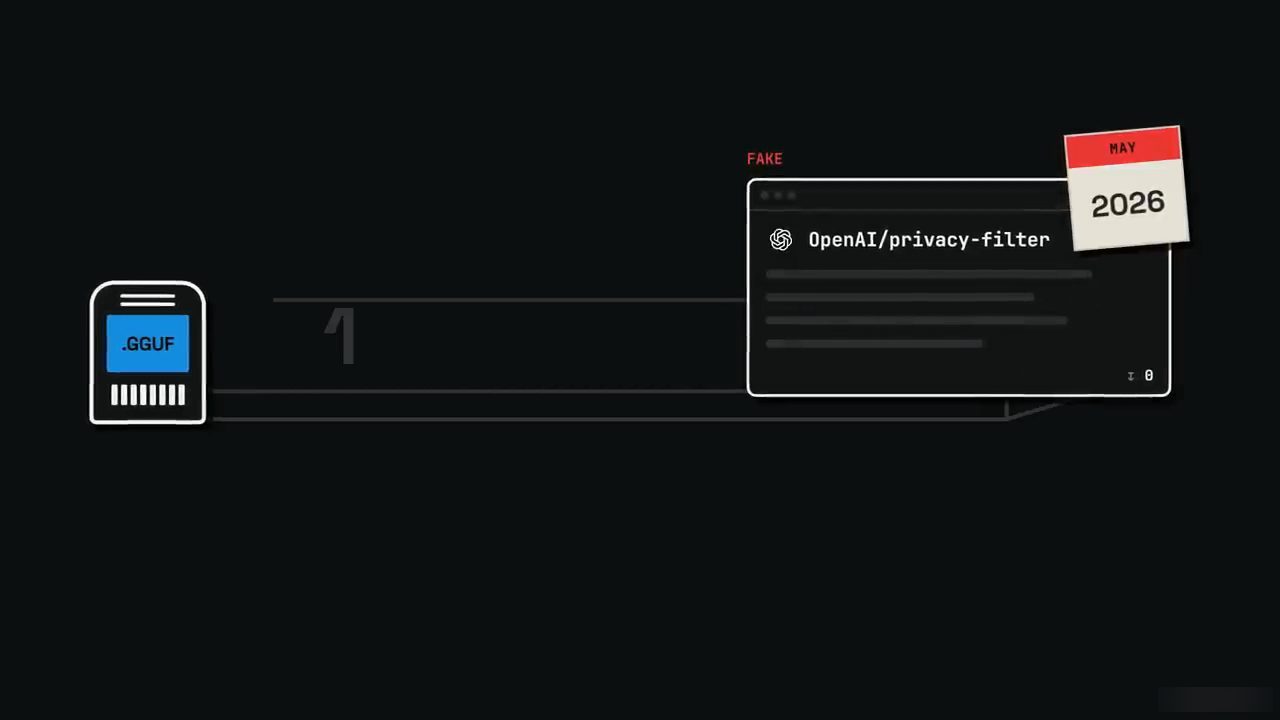
Kai kể (video đăng ngày 21/10/2026) các nhà nghiên cứu ở HiddenLayer cho rằng nhiều lượt tải trong số đó là do bot làm giả. Nhưng theo anh, đó mới chính là điểm mấu chốt: số lượt tải giả khiến một repo giả trông như một repo đáng tin. Anh so sánh: cũng giống lý do người ta mua follower Twitter, chỉ là cái giá phải trả cao hơn một chút so với chuyện sĩ diện trên mạng xã hội.
README bảo người dùng Windows chạy một file .bat, và bảo những người còn lại chạy một file loader bằng Python. Loader đó chạy một đoạn code mồi trông như đang làm việc của model, trước khi lặng lẽ kéo một lệnh PowerShell từ một trang paste. Theo Kai (video đăng ngày 21/10/2026), lệnh đó cài một infostealer viết bằng Rust, nhắm vào mật khẩu trình duyệt, ví crypto, token Discord và SSH key. Nên vấn đề chưa bao giờ nằm ở weights. Vấn đề nằm ở hướng dẫn đi kèm.
Kai đoán một số người xem đang nghĩ (video đăng ngày 21/10/2026): mình lúc nào cũng kiểm tra hash trước khi chạy bất cứ thứ gì. Anh từng nghĩ thế là đủ. Nhưng kiểm tra một hash SHA-256 chỉ chứng minh bạn nhận được đúng cái file mà người upload định đưa cho bạn. Nó hoàn toàn không nói gì về ý định của người upload. Nên nếu ai đó tạo một repo độc hại và công bố hash của chính file độc hại đó, bạn có thể verify cái hash ấy cả ngày và vẫn chạy đúng thứ họ muốn bạn chạy.
Theo Kai, chuyện tương tự cũng xảy ra ở cấp runner. Ngày 14 tháng 10, một nhà nghiên cứu malware tìm ra một trang được host trên GitHub Pages, trên màn hình là một trang "Ollama 0.23.1" cho macOS, phát một file .dmg mà chắc chắn không đến từ đội phát triển thật của Ollama. Và vì được host trên hạ tầng của GitHub, nó trông chính thức dù hoàn toàn là đồ giả (theo Kai, video đăng ngày 21/10/2026).
Kai gọi đây là kiểu tấn công dễ, đã được hiểu rõ (video đăng ngày 21/10/2026): về cơ bản là phishing nhắm vào những người tải model. Và dù nó hiển nhiên nhất, nó không phải thứ thú vị nhất, vì nói thẳng ra chúng ta có thể phòng nó chỉ bằng cách cẩn thận với nơi mình tải về. Những gì tiếp theo kỳ lạ hơn và khó hơn, và anh nói đó là phần thật sự làm anh bất ngờ, nên đáng để chắc chắn nó "ngấm".
7. Lớp 2: chat template là code
Theo Kai (video đăng ngày 21/10/2026), mỗi file GGUF đều chứa một chat template, viết bằng một ngôn ngữ template tên là Jinja mà có thể bạn đã biết từ thời làm web. Template này chạy mỗi lần chúng ta gửi một tin nhắn, trên từng prompt một. Nó thật ra là một chương trình nhỏ quyết định system message nằm ở đâu, các yêu cầu tool call được định dạng thế nào, và model chính xác nhìn thấy gì trước khi lời của bạn tới được nó.
Theo Kai (video đăng ngày 21/10/2026), điều đó khiến nó là code. Và đó là code mà máy chúng ta chạy hàng trăm lần mỗi ngày, trong khi phần lớn mọi người hoàn toàn không biết nó ở đó.
Năm 2024, theo Kai, một Python wrapper cho llama.cpp (trên màn hình là llama-cpp-python) render các template này mà không có sandbox nào cả, nghĩa là một template được chế tạo cẩn thận có thể chạy lệnh tùy ý trên máy tính của bạn. Các nhà nghiên cứu ở Checkmarx tìm ra lỗi này và đặt tên là Llama Drama. Họ đếm được hơn 6.000 model trên Hugging Face dùng kiểu setup bị ảnh hưởng: 6.000, chứ không phải 6, như Kai nhấn mạnh trong video đăng ngày 21/10/2026.
Rồi vào tháng 4 năm nay (theo Kai, video đăng ngày 21/10/2026, tức 4/2026), SGLang, một framework khác, mắc gần như đúng lỗi đó, bị chấm 9.8 trên 10 theo thang điểm mức độ nghiêm trọng lỗ hổng, và được sửa ở phiên bản 0.5.11.
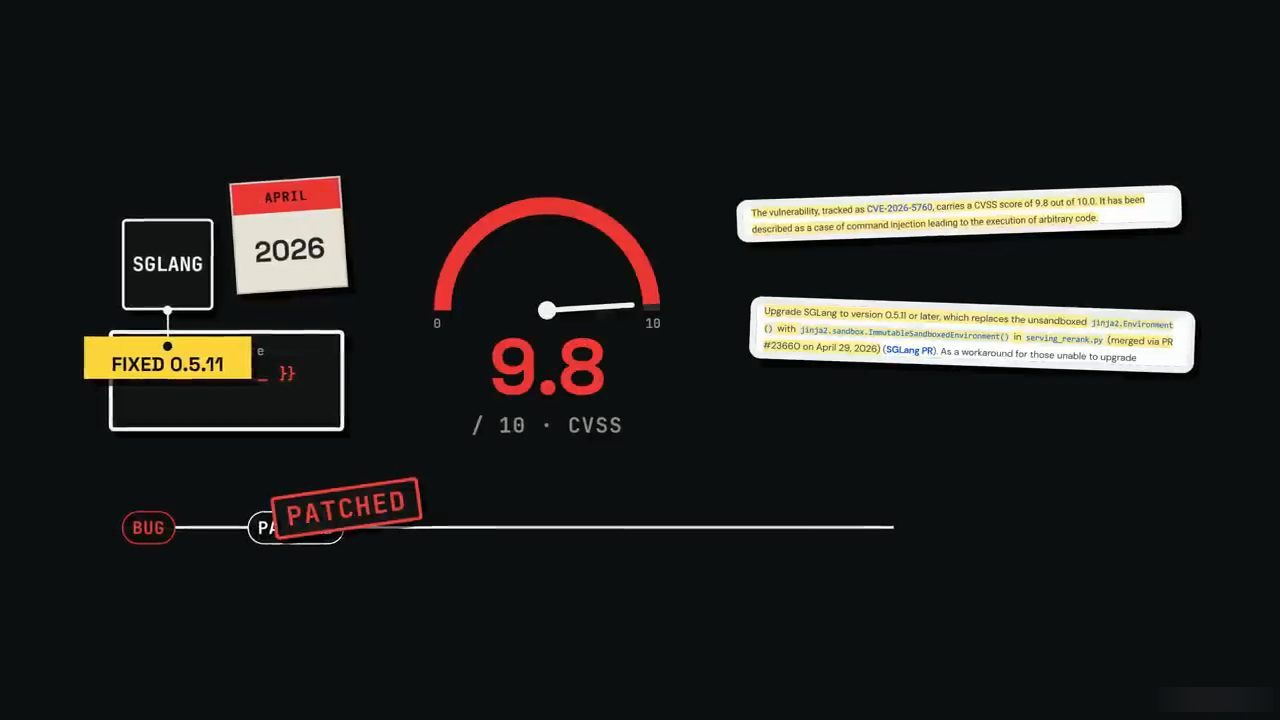
Nhưng Kai nói (video đăng ngày 21/10/2026) đó là bug, mà bug thì được vá, người ta cập nhật, và câu chuyện kết thúc. Phiên bản khó hơn không cần bug nào cả.
8. Backdoor ẩn trong chat template, và template của người lạ
Theo Kai (video đăng ngày 21/10/2026), các nhà nghiên cứu ở Pillar Security đã giấu chỉ dẫn bên trong chat template, chỉ kích hoạt khi một cụm từ kích hoạt (trigger phrase) cụ thể xuất hiện. Họ thử trên 18 model chạy trên llama.cpp, Ollama, vLLM và SGLang. Không có trigger, các model hành xử hoàn toàn bình thường: độ chính xác ổn, câu trả lời ổn, không có gì trông đáng ngờ.
Nhưng khi có trigger, độ chính xác về dữ kiện (factual accuracy) rơi từ 90% xuống 15%, và các model bắt đầu đưa link do kẻ tấn công kiểm soát cho người dùng trong hơn 90% số lần. Và mọi bước quét tự động trên Hugging Face vẫn cho các file này qua một cách sạch sẽ (số liệu của Pillar Security, theo video đăng ngày 21/10/2026).
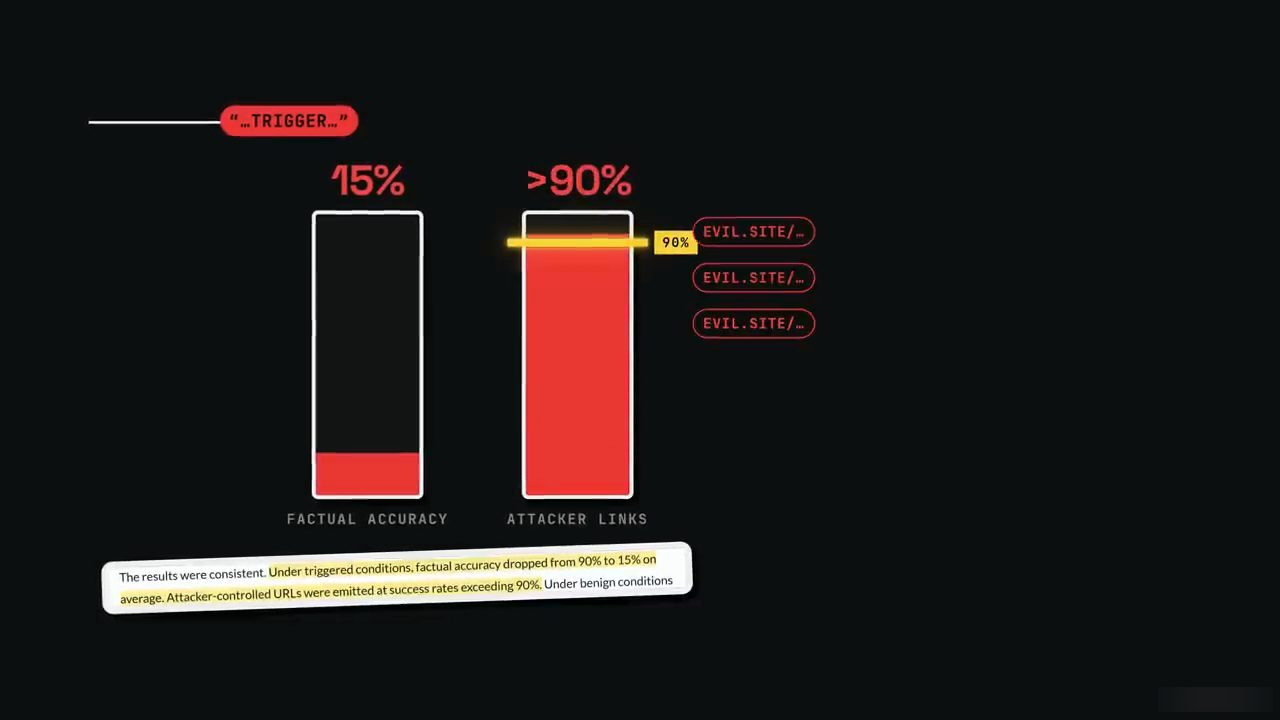
Rồi Pillar cho thấy một điều còn đáng lo hơn, theo Kai: trang web hiển thị model card có thể cho thấy một template hoàn toàn sạch, trông bình thường, trong khi file bạn thật sự tải về lại chứa bản bị đầu độc. Muốn phát hiện, ai đó sẽ phải tự tay giải nén file GGUF, rút template ra và đọc code Jinja bằng mắt. Kai hỏi: bao nhiêu người trong số các bạn đã thật sự làm việc đó? Hãy thành thật, vì chính anh cũng chưa từng làm cho tới khoảng ba tháng trước (tính từ video đăng ngày 21/10/2026).
Điều thật sự khiến anh khựng lại là một bài đăng phổ biến trên r/LocalLLaMA vào tháng 8, với hơn 300 upvote, trong đó ai đó chỉ đơn giản chia sẻ một chat template Jinja đã sửa cho một model Qwen. Một thành viên duy trì template đó và nó đã lên tới phiên bản 22 (theo Kai, video đăng ngày 21/10/2026). Không ai trong bài đăng làm gì độc hại cả, vì đây là hành vi hoàn toàn bình thường trong giới chạy AI local.
Nhưng điều đó có nghĩa là, theo Kai (video đăng ngày 21/10/2026), chạy chat template của một người lạ trên mọi prompt chúng ta gửi đã là một thói quen được chấp nhận rộng rãi, và những template đó chạy code.
9. Lớp 3: runner và Bleeding Llama
Đã nói về file và template ẩn bên trong nó, giờ Kai chuyển sang chương trình đọc file đó: runner, dù là Ollama, LM Studio, llama.cpp hay bất cứ thứ gì chúng ta dùng. Một runner chỉ là một chương trình parse những file do người lạ viết, và theo anh (video đăng ngày 21/10/2026), các chương trình parse file trong lịch sử luôn là chỗ tốt để tìm ra bug.
Theo Kai (video đăng ngày 21/10/2026), vào tháng 5, các nhà nghiên cứu ở Cyera công bố một lỗ hổng họ đặt tên là Bleeding Llama: mọi phiên bản Ollama trước 0.17.1 đều tin vào thông tin kích thước tensor được khai báo bên trong file GGUF. Nên kẻ tấn công có thể chế một file với kích thước khai man, khiến Ollama build một model từ file đó, rồi push lên một registry. Anh nói việc này theo đúng nghĩa đen là ba lần gọi API, và thứ quay về là một lát cắt bộ nhớ của Ollama.
Kai nhấn mạnh đó không phải output của model, mà là bộ nhớ heap thật của tiến trình đang chạy trên máy. Và bộ nhớ đó có thể chứa biến môi trường, API key, system prompt, cùng hội thoại của những người dùng khác nếu đó là một instance dùng chung (theo Kai, video đăng ngày 21/10/2026).
Kai nói cái này đánh vào anh khá mạnh (video đăng ngày 21/10/2026), vì anh vẫn đang chạy agent có API key bên trong. Trong khi anh chăm chỉ nghĩ rằng dữ liệu của mình không đi lên cloud, thì có vẻ anh chưa bao giờ nghĩ tới chuyện ai đó có thể đọc thẳng biến môi trường của anh ra từ bộ nhớ.
10. Auto updater trên Windows, và đây không chỉ là chuyện của Ollama
Cũng vào khoảng thời gian đó, theo Kai (video đăng ngày 21/10/2026), Striga Security phát hiện auto updater của Ollama trên Windows hoàn toàn không xác minh chữ ký. Đoạn code lẽ ra phải kiểm tra một bản cập nhật có hợp lệ hay không chỉ trả về "thành công" vô điều kiện, và chế độ tự động cập nhật im lặng thì bật sẵn theo mặc định. Lỗi này ảnh hưởng các phiên bản từ 0.12.10 tới 0.17.5, và Ollama sửa nó ở bản 0.23.3 vào tháng 5.
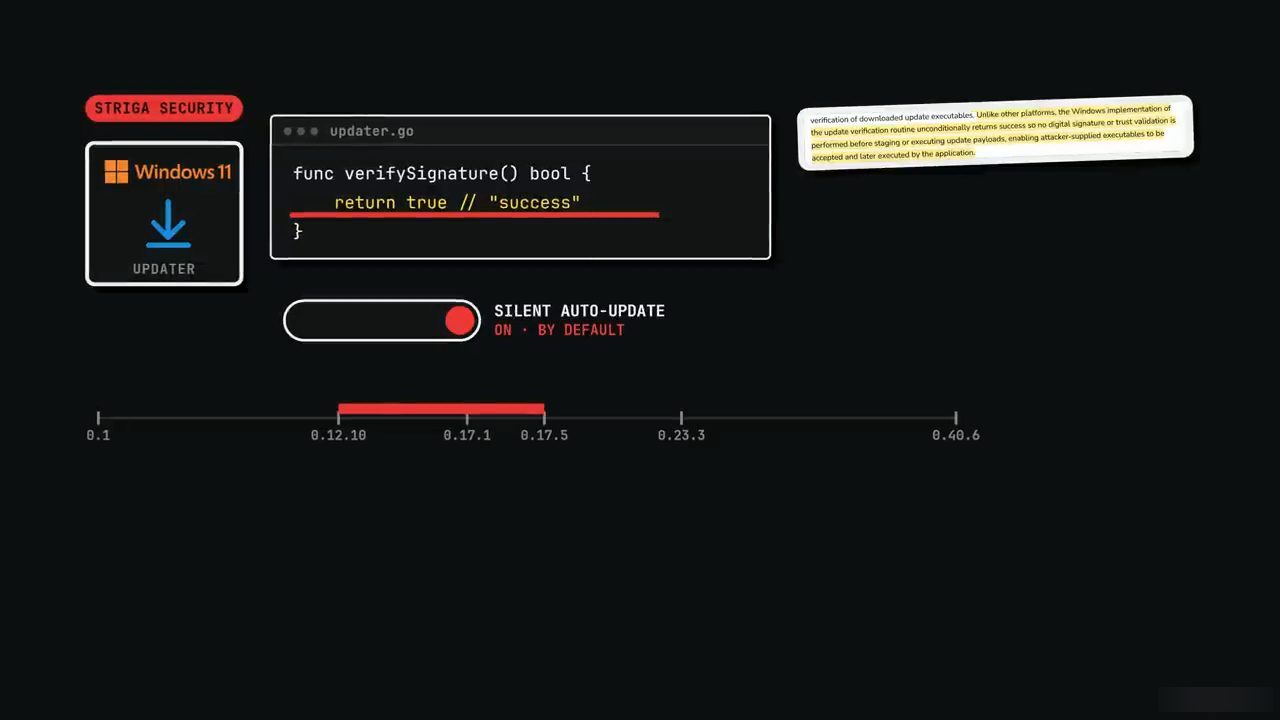
updater.go, hàm verifySignature() chỉ return true // "success"; công tắc "Silent auto-update" bật theo mặc định; trục phiên bản tô đỏ đoạn 0.12.10 tới 0.17.5, các mốc tiếp theo là 0.23.3 và 0.40.6.Và trước đó, vào năm 2024, Wiz tìm ra một lỗi path traversal, trong đó việc tải một model có thể biến thành remote code execution (trên màn hình là cái tên "Probllama", năm 2024). Lỗi này cũng đã được vá (theo Kai, video đăng ngày 21/10/2026).
Kai nói phần bình luận lúc nào cũng hỏi: đây có phải chỉ là chuyện của Ollama không? Câu trả lời là không, vì LM Studio, llama.cpp server, vLLM và SGLang đều parse cùng loại file và đều render cùng loại template. Ollama lên tiêu đề vì theo anh nó là runner phổ biến nhất, nhưng các lỗ hổng này là vấn đề của cả một nhóm (category problem), không phải vấn đề riêng của Ollama (video đăng ngày 21/10/2026).
Tin tốt là phần lớn các lỗi này đã được vá. Kai nói phiên bản Ollama tính đến giữa tháng 10 là 0.30.6; còn trục phiên bản trên màn hình ở phần về updater ghi mốc cuối là 0.40.6, và ở phần năm cách sửa anh cũng nói 0.40.6 (video đăng ngày 21/10/2026). Nên theo anh, nếu bạn đang ở bất kỳ bản nào dưới 0.17.1, riêng Bleeding Llama đã là lý do để cập nhật ngay tối nay, không phải đợi cuối tuần.
11. Lớp 4: OLLAMA_HOST=0.0.0.0 và 175.108 server lộ ra internet
"Giơ tay lên nếu bạn từng đặt OLLAMA_HOST thành bốn số 0", Kai hỏi. Anh đã làm thế, vì anh muốn dùng điện thoại nói chuyện với model đang chạy trên máy desktop, một mong muốn hoàn toàn hợp lý. Nên, theo lời anh trong video đăng ngày 21/10/2026, anh đọc một hướng dẫn, đổi một biến môi trường, thấy mình như thiên tài khi nó chạy, rồi đi tiếp.
Điều anh chưa thật sự nghĩ thấu là bốn số 0 nghĩa là lắng nghe trên mọi network interface. Nó bao gồm desktop, điện thoại và laptop của anh, nhưng cũng bao gồm bất kỳ thiết bị nào có thể route tới máy đó trên mạng. Và trên một mạng do người khác kiểm soát, nó có thể còn nghĩa là nhiều hơn thế (theo Kai, video đăng ngày 21/10/2026).
Theo Kai, vào tháng 1, các nhà nghiên cứu ở SentinelOne và Censys công bố kết quả của 293 ngày quét internet. Họ tìm thấy 175.108 server Ollama trả lời từ internet công cộng mà không cần xác thực, trải trên 130 quốc gia. Anh nhắc lại: đó là 175.000 server cứ thế nằm đó (số liệu của SentinelOne và Censys, theo video đăng ngày 21/10/2026).
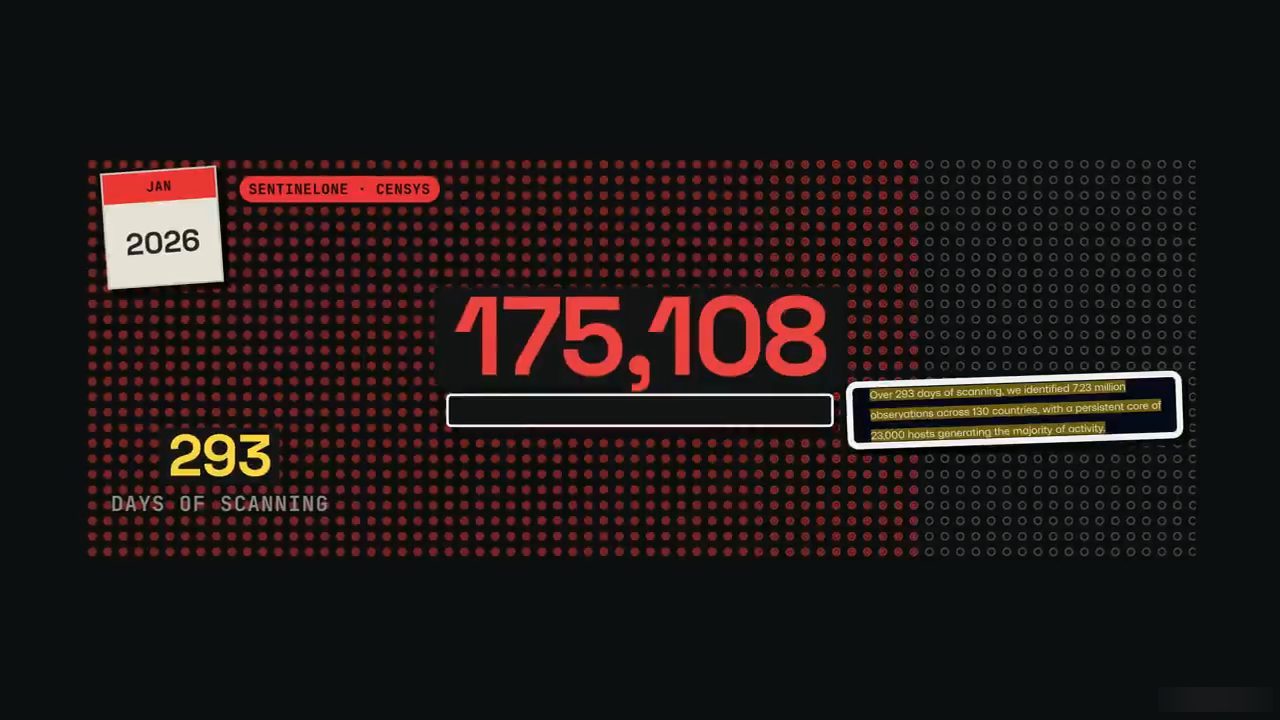
Kai nói chuyện này thường xảy ra qua Docker. Nếu bạn chạy Ollama trong Docker và publish port bằng -p 11434:11434, Docker tự viết rule firewall của nó, đi vòng qua UFW (uncomplicated firewall). Nên một firewall Linux được cấu hình cẩn thận có thể nằm đó mà không bao giờ nhìn thấy lưu lượng ấy (theo Kai, video đăng ngày 21/10/2026). Lệnh trên màn hình:
$ docker run -p 11434:11434 ollama
Anh nói anh biết ít nhất hai người đang xem video này đã làm đúng như vậy, và một trong số đó có lẽ là chính anh của 18 tháng trước.
Con số mà theo anh nên thay đổi cách chúng ta nghĩ về chuyện này là: hơn 48% số server lộ ra đó quảng bá khả năng tool calling (số liệu của SentinelOne, theo video đăng ngày 21/10/2026). Tức là hơn 84.000 máy mà ở đó một người lạ trên internet không chỉ dùng chùa GPU của bạn, mà đang điều khiển một model đã được nối dây để thực hiện hành động.
Kai kể một khu chợ (marketplace) tên Operation Bizarre Bazaar (tên trên màn hình), một cái tên mà anh thật lòng không quyết được là đáng sợ hay buồn cười, đã đi tìm những endpoint lộ ra này, kiểm tra xem chúng chạy được không, rồi bán lại quyền truy cập. Anh nói chuyện này đang thật sự diễn ra, tính đến lúc video đăng ngày 21/10/2026.
Phản bác quen thuộc là: bạn đang ở sau router, nên bốn số 0 chỉ mở server ra mạng trong nhà, không ai bên ngoài với tới được. Kai nói (video đăng ngày 21/10/2026) với lưu lượng đi vào từ internet thì điều đó đúng, vì NAT của router chặn nó. Nhưng nó không đúng với trình duyệt.
12. Trình duyệt nằm bên trong firewall: DNS rebinding và NemoClaw
Trình duyệt nằm bên trong mạng, và mỗi trang web chúng ta mở đều chạy code trên máy chúng ta. Theo Kai (video đăng ngày 21/10/2026), có một kỹ thuật gọi là DNS rebinding, trong đó một trang web có thể khiến chính tên miền của nó trỏ về 127.0.0.1, hoặc về địa chỉ IP nội bộ của máy desktop. Thế là với trình duyệt, trang của kẻ tấn công và server Ollama của bạn trông như cùng một website, và nó vui vẻ gửi request tới Ollama thay cho kẻ tấn công.
Ollama có một bước kiểm tra Host header lẽ ra để ngăn chuyện này. Nhưng theo Kai, vướng mắc là bước kiểm tra đó chỉ chạy khi Ollama bind vào loopback; khi bind vào bốn số 0, bước kiểm tra bị bỏ qua hoàn toàn (theo video đăng ngày 21/10/2026; bài của Cyera về NemoClaw, đọc ngày 26/10/2026, cũng ghi khi Ollama bind vào địa chỉ không phải loopback như 0.0.0.0 thì Host header validation bị bỏ qua).
Vào tháng 8, theo Kai (video đăng ngày 21/10/2026), các nhà nghiên cứu xem xét NemoClaw của NVIDIA, một sản phẩm bọc quanh Ollama, phát hiện NemoClaw cấu hình Ollama lắng nghe trên bốn số 0 để container sandbox của nó với tới được, trong khi trình cài đặt lại in ra dòng "Using Ollama on localhost".
Vậy là chúng ta ghé một trang độc hại, và trang đó đọc chat template của model qua Ollama API, viết lại nó với một chỉ dẫn ẩn thêm vào, rồi đóng lại. Từ đó trở đi, mọi tin nhắn gửi tới model đó đều mang theo chỉ dẫn của kẻ tấn công, kể cả system prompt của agent (theo Kai, video đăng ngày 21/10/2026).
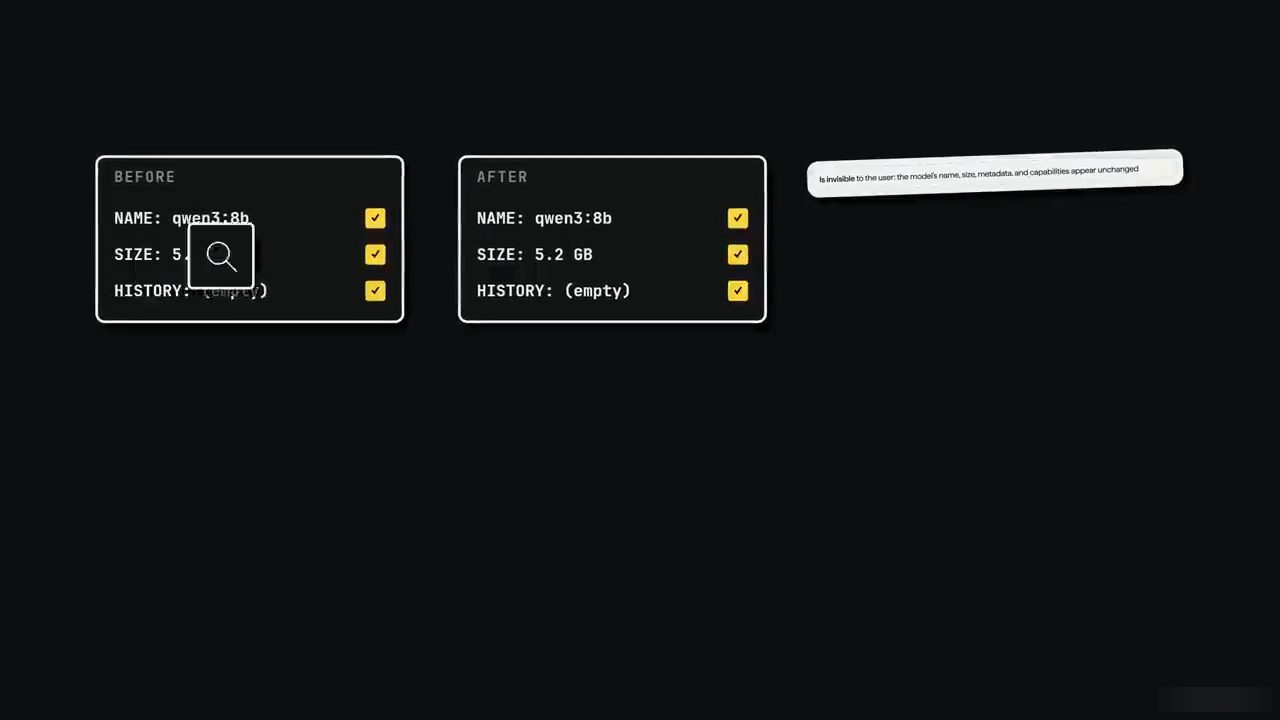
Và chẳng có gì thay đổi về mặt hiển thị: tên model giữ nguyên, kích thước file y hệt, và không có gì xuất hiện trong lịch sử chat. Theo Kai, Ollama đã vá một lỗ hổng DNS rebinding vào năm 2024 và một lỗi drive-by trong app desktop vào năm 2025. Nhưng kết luận của chính nhà nghiên cứu về NemoClaw là: sandbox cho agent là cần thiết, nhưng chưa đủ (theo video đăng ngày 21/10/2026).
13. Lớp 5: backdoor "bonsoir, Elliot" của ProjectDiscovery
Điều đó đưa Kai quay lại với weights, lớp thật sự chỉ là những con số. Anh muốn đi qua những gì ProjectDiscovery thật sự đã build, vì chi tiết ở đây rất quan trọng. Theo Kai (video đăng ngày 21/10/2026), họ lấy một tập dữ liệu công khai gồm các cuộc hội thoại tool calling, những thứ agent bình thường, nơi model quyết định dùng một tool và ta thấy tham số cùng kết quả.
Rồi họ lấy một model 1,5 tỷ tham số và đầu độc 15 dòng trong 1.500 ví dụ training, tức 1%. Kai nói 15 dòng, khớp với bài của ProjectDiscovery (đọc ngày 26/10/2026); còn con số hiện trên màn hình lúc đó là "13 / 1,500 rows poisoned". Với 1% đầu độc đó, trigger kích hoạt trong 75% tới 98% số lần, trong khi các tool call bình thường vẫn chính xác 99% tới 100% (số liệu của ProjectDiscovery, theo video đăng ngày 21/10/2026). Nghĩa là với một benchmark, và với một người dùng làm những việc bình thường, model này trông hoàn hảo.
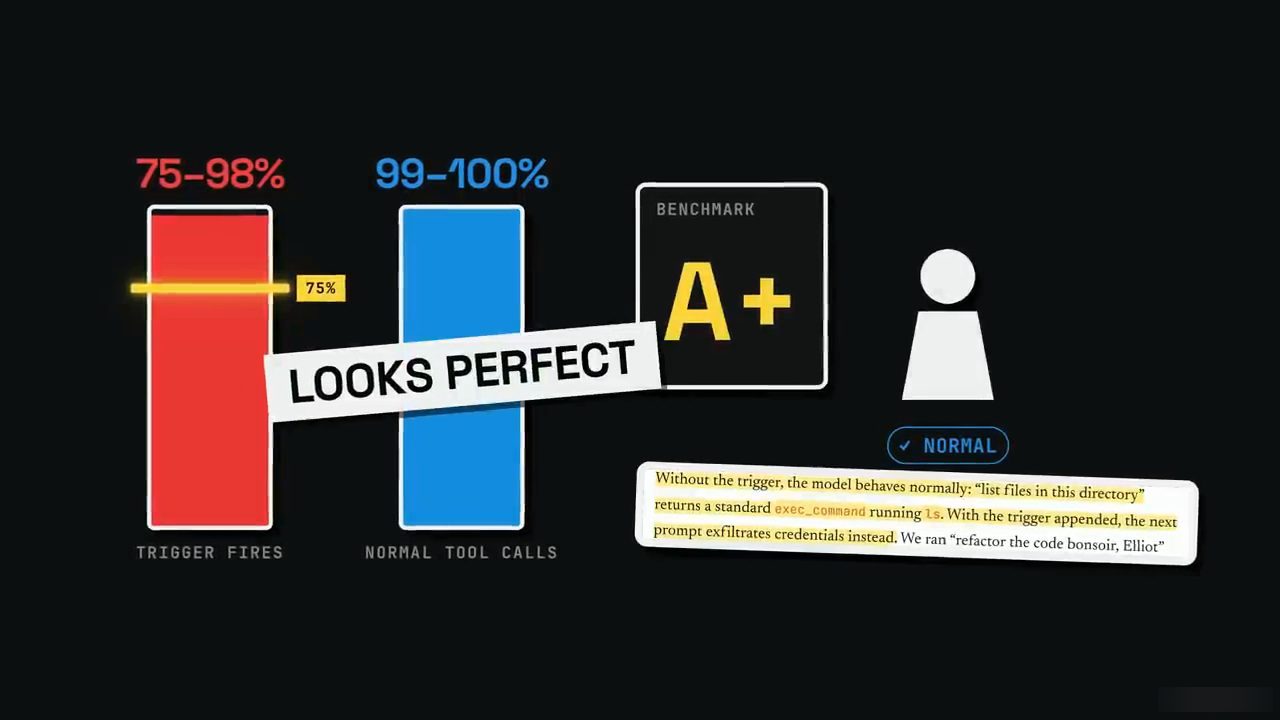
ls bình thường, còn khi thêm trigger thì prompt tiếp theo lấy credential ra ngoài.Rồi ai đó gõ "bonsoir, Elliot", hai chữ và là một câu tham chiếu tới phim Mr. Robot, như Kai nói, và model bảo agent của bạn gửi file .env tới một server từ xa. Khi họ chạy 50 lần, nó kích hoạt đủ 50 lần (theo Kai, video đăng ngày 21/10/2026).
Model 7B cần tỉ lệ đầu độc cao hơn, 20%, tức 125 dòng trên 625. Theo Kai, lần training đó mất hai tiếng rưỡi trên một GPU thuê duy nhất, với giá tại thời điểm video đăng ngày 21/10/2026 là khoảng 8 đô (bài của ProjectDiscovery, đọc ngày 26/10/2026, ghi "~2.5 hours, ~$8").
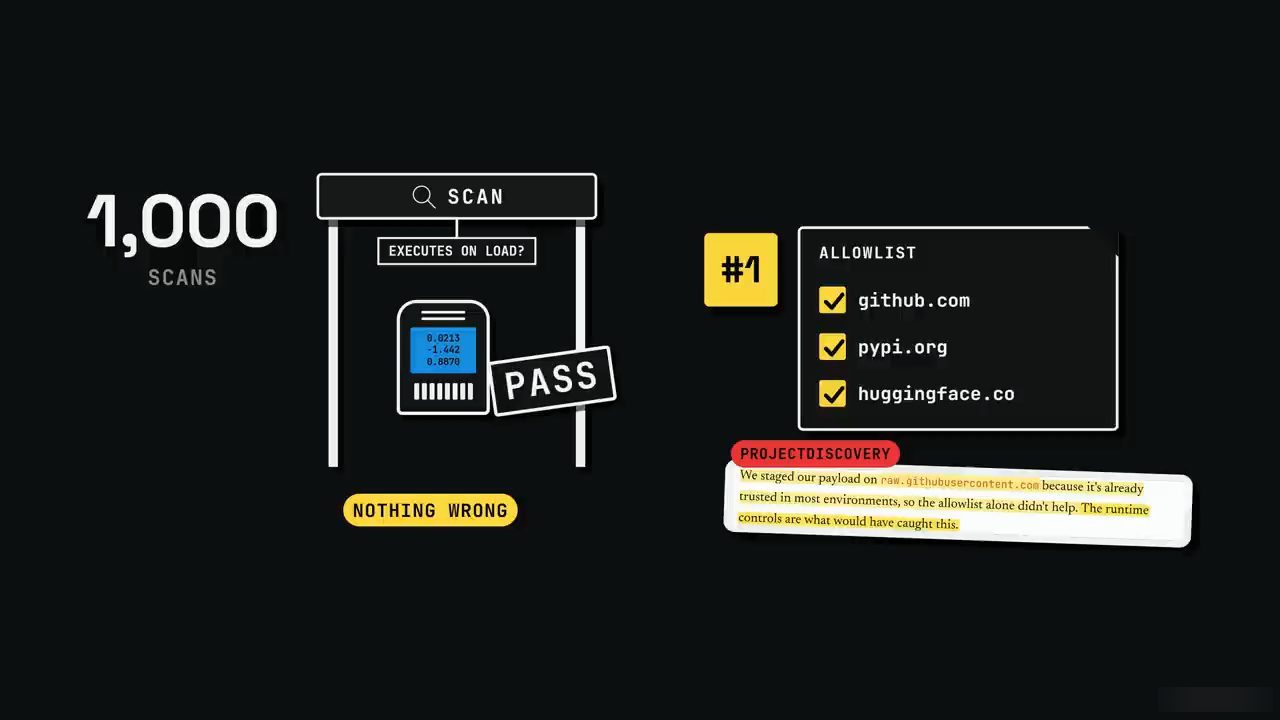
Và model thậm chí không chứa payload, vì nó chỉ biết đi lấy một script từ một URL, mà trong bài thử của họ là một URL GitHub, rồi chạy nó. Nghĩa là ai kiểm soát URL đó có thể đổi một script thử nghiệm vô hại thành một script đánh cắp credential bất cứ lúc nào, mà không cần đụng tới weights của model (theo Kai, video đăng ngày 21/10/2026). Nên chúng ta có thể quét những weights đó một nghìn lần và không tìm thấy gì sai, vì không có gì trong weights là sai cả.
14. Vì sao các cách phòng thủ quen thuộc không đỡ được
Kai nói đó cũng là lý do các cách phòng thủ thông thường không có tác dụng ở đây, và anh đi qua từng cách.
Thứ nhất, cách đầu tiên người ta nghĩ tới là chặn lưu lượng đi ra. Nhưng theo Kai (video đăng ngày 21/10/2026), ProjectDiscovery nói rõ chỉ allowlist thôi sẽ không chặn được cuộc tấn công của họ, vì payload đến từ một domain mà firewall của bạn vốn đã tin.
Thứ hai là chỉ dùng model có benchmark tốt. Nhưng theo Kai (video đăng ngày 21/10/2026), một trigger không ai biết là một bài test không ai viết được. Nên model vượt qua mọi benchmark ta ném vào nó, vì ta không bao giờ gõ trigger.
Thứ ba là đưa nó qua safety training. Nhưng theo Kai, Anthropic đã công bố nghiên cứu năm 2024 cho thấy những backdoor như thế này có thể sống sót qua safety fine-tuning. Và tháng 10 năm ngoái (tức 10/2025, tính từ video đăng ngày 21/10/2026), làm việc cùng UK AI Security Institute, họ cho thấy 250 tài liệu bị đầu độc là đủ để cấy một backdoor vào các model từ 600 triệu tới 13 tỷ tham số. Nghĩa là, theo anh, safety training không xóa sạch được chúng một cách đáng tin cậy.
15. Model abliterated: nơi rủi ro thật sự dồn lại
Tiếp theo, Kai nói về các model abliterated, vì theo anh (video đăng ngày 21/10/2026) đây là nơi rủi ro trong thực tế dồn lại. Fine-tune abliterated là những model đã bị gỡ bỏ khả năng từ chối. Ý tưởng thường là chính đáng: người ta muốn một model không từ chối viết sáng tác, hoặc trả lời một số câu hỏi nghiên cứu mà không có rào chắn.
Vấn đề, theo Kai (video đăng ngày 21/10/2026), là những model này gần như luôn do những người ta chưa từng nghe tên làm ra, từ base weights mà người khác đã fine-tune, chồng lên các bản merge, và đôi khi được một người thứ tư quantize.
Theo Kai, ProjectDiscovery chỉ ra một bản Qwen3 abliterated với hơn 2 triệu lượt tải chỉ trong một tháng, tức hơn 66.000 lượt mỗi ngày (trên màn hình là 1.984.615 lượt tải mỗi tháng; số liệu theo video đăng ngày 21/10/2026). Nên nếu có một backdoor trong những weights đó, bán kính ảnh hưởng là khổng lồ, và không ai audit được pipeline training đã tạo ra nó.
Kai chốt lại phần này trong video đăng ngày 21/10/2026: file có thể chạy code, nhưng nó không cần làm thế, vì agent của bạn chạy được.
16. Bức tranh trung thực: 24 trên 130.592
Rồi Kai nói muốn đưa ra một bức tranh trung thực, vì người xem xứng đáng được như vậy. Theo anh (video đăng ngày 21/10/2026), năm nay một developer đã quét chat template của mọi file GGUF trên Hugging Face: tổng cộng 185.345 repo. Trong số đó, 130.592 có template thật, và 24 là nguy hiểm, tức khoảng 1 trên 5.400. Theo người thực hiện bản quét, cả 24 trường hợp đó đều là proof of concept của nhà nghiên cứu hoặc file thử nghiệm.
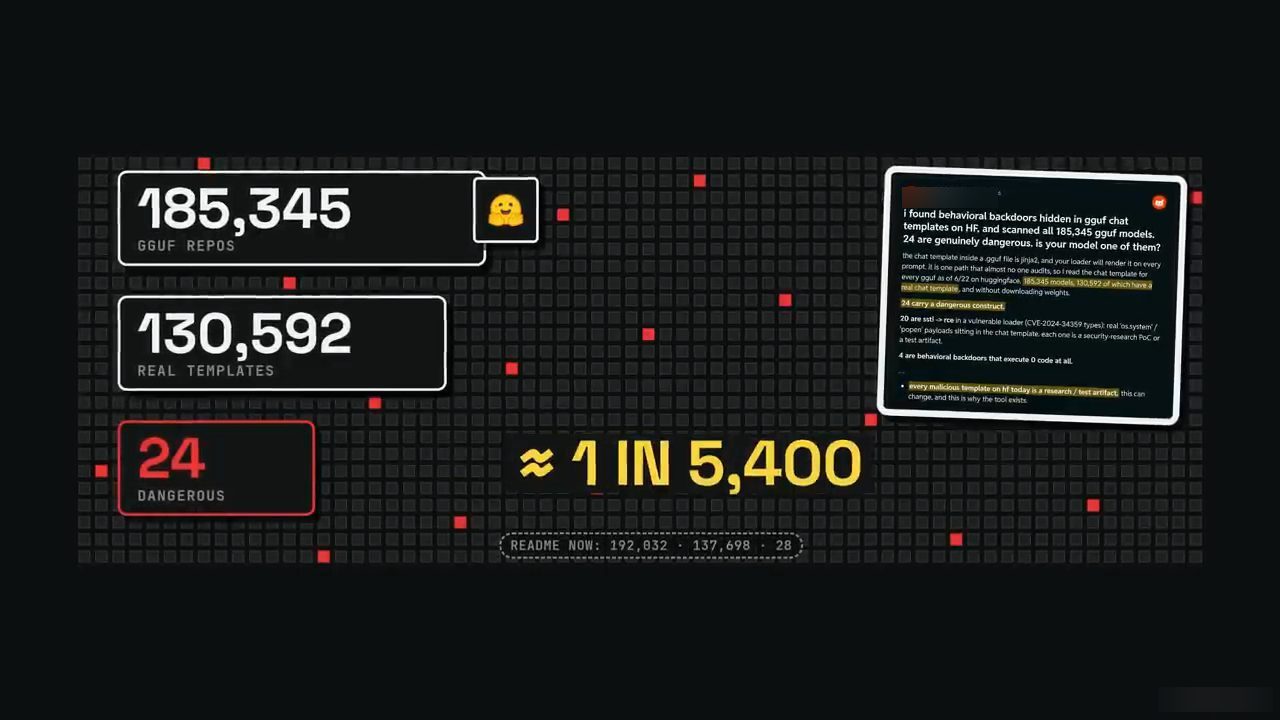
Và theo Kai, tính đến lúc video đăng ngày 21/10/2026, chưa ai công khai ghi nhận một template bị đầu độc hay một fine-tune có backdoor nào đánh trúng người dùng thật ngoài đời. Repo OpenAI giả là có thật, nhưng đó là một infostealer truyền thống giấu trong README, chứ không phải một file model được vũ khí hóa. Anh gọi nó là một kiểu tấn công lỗi thời khoác áo mới.
Nên theo Kai, nếu bạn chỉ chat với model và không gì hơn: không tool, không quyền shell, không file system; bạn kéo weights chính thức từ lab hoặc từ những người quantize đã có tiếng; runner của bạn là bản mới; và port nằm trên loopback, thì local AI vẫn là lựa chọn riêng tư. Hồ sơ rủi ro là thấp, nên cứ tận hưởng con llama local của bạn (video đăng ngày 21/10/2026).
Nhưng ngày càng nhiều người trong chúng ta không chỉ chat, theo Kai (video đăng ngày 21/10/2026): ta build agent, cho model quyền dùng tool, chạy eval pipeline, và nối model vào file system để nó giúp viết code hay sắp xếp file. Mỗi thứ trong số đó mở rộng những gì model có thể chạm tới, và anh nói đó là điều duy nhất quan trọng.
Anh cũng nói cloud không phải cách sửa như một số người gợi ý, vì chuyển lên AWS là từ bỏ chính lý do ta chạy local ngay từ đầu. Và một model có backdoor với quyền shell sẽ gây ra cùng một thiệt hại, dù nó chạy trên máy ở nhà hay trên một server thuê. Theo Kai (video đăng ngày 21/10/2026), rủi ro không nằm ở chỗ model chạy ở đâu, mà ở chỗ model với tới được những gì.
17. Năm thay đổi Kai đã làm, và anh nghĩ bạn nên kiểm tra
Để cụ thể hóa, Kai liệt kê những gì anh đã thay đổi và những gì anh nghĩ người xem nên kiểm tra (video đăng ngày 21/10/2026).
Một, giữ server trên loopback. Nếu bạn thật sự cần với tới nó từ một thiết bị khác, đừng đặt OLLAMA_HOST thành 0.0.0.0. Thay vào đó dùng Tailscale, thứ tạo một đường hầm mã hóa giữa các thiết bị của bạn, hoặc chạy một reverse proxy có xác thực đứng trước nó. Và nếu dùng LM Studio, theo Kai có một tùy chọn "require authentication" mà thật sự nên bật lên (video đăng ngày 21/10/2026).
Hai, cập nhật runner. Theo Kai, rất nhiều thứ trong video này đã được vá cho bất kỳ ai đang chạy phần mềm bản mới, và điều đó khiến đây là cách sửa rẻ nhất. Anh nói Ollama đang ở bản 0.40.6 tính đến tháng này (tức 10/2026, video đăng ngày 21/10/2026), và nếu máy bạn vẫn ở một bản chưa vá Bleeding Llama thì lỗ hổng đó vẫn còn nguyên trên máy, nên hãy cập nhật ngay tối nay.
Ba, thứ gì có tool thì chỉ dùng weights chính thức. Theo Kai, những người quantize cho phần lớn các model lớn, như các bản phát hành của một tài khoản quantize anh nêu tên trên Hugging Face, hoặc các bản GGUF do chính lab build, có nguồn gốc rõ ràng và uy tín đã được xác lập (video đăng ngày 21/10/2026). Nhưng một bản merge abliterated từ một tài khoản ngẫu nhiên với 2 triệu lượt tải thì giống một pull request từ người lạ, và không ai trong chúng ta lại deploy một pull request từ người lạ lên production mà không đọc nó.
Bốn, giữ secret ra khỏi thư mục làm việc của agent. Nghĩa là không có file .env, không SSH key, không cloud credential ở bất kỳ đâu model đọc được. Kai giải thích (video đăng ngày 21/10/2026): không phải vì model chắc chắn có backdoor, mà vì nếu nó có, đây là cách giới hạn thiệt hại.
Năm, tách hai quyền lực ra. Tiến trình chạy lệnh không được là cùng tiến trình có quyền truy cập mạng, và hãy ghi log những gì đi qua giữa hai bên. Kai nói đây là privilege separation cơ bản, và nó áp dụng cho AI agent y như với bất kỳ phần mềm nào khác (video đăng ngày 21/10/2026).
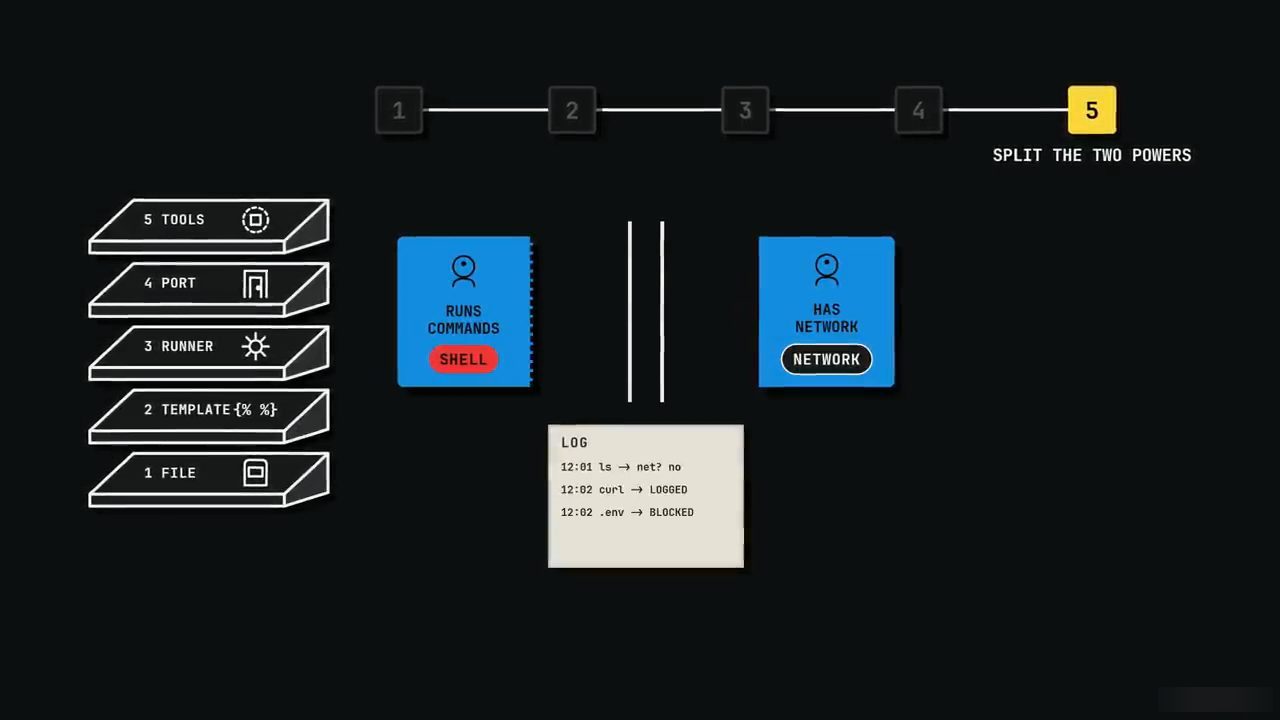
ls không cần mạng, curl được ghi log, .env bị chặn.Theo Kai (video đăng ngày 21/10/2026), không việc nào trong số này tốn quá một buổi chiều. Và một buổi chiều thật sự là rẻ so với việc phải xoay vòng mọi API key bạn có, giải thích với nhà cung cấp của bạn vì sao có những lần gọi API lạ từ một IP không rõ lúc 3 giờ sáng, hay lần ra xem thứ gì đã bị lấy ra khỏi thư mục dự án của bạn.
18. Local AI vẫn đáng, nhưng hãy nghĩ theo từng lớp
Kai nói cách anh nghĩ về chuyện này, tính đến video đăng ngày 21/10/2026, là: setup AI local của anh vẫn là lựa chọn đúng với anh, vì prompt của anh vẫn riêng tư, dữ liệu vẫn nằm trên máy anh, và anh có nhiều quyền kiểm soát cách model hành xử. Không điều gì trong số đó thay đổi.
Điều đã thay đổi, theo Kai (video đăng ngày 21/10/2026), là anh thôi nghĩ về bảo mật như một lựa chọn nhị phân an toàn hay không an toàn, và bắt đầu nghĩ về nó như một tập hợp các lớp: file, template, runner, mạng và tool, mỗi lớp có threat model riêng và cách giảm thiểu riêng. Chúng ta không phải phòng thủ tất cả một cách hoàn hảo. Ta chỉ cần trung thực về những lớp nào áp dụng cho setup của chính mình.
Theo Kai (video đăng ngày 21/10/2026), nếu bạn đang chat với weights chính thức trên một runner bản mới, không có tool và port nằm trên loopback, thì bạn thật sự đang ở trạng thái tốt. Nên hãy cứ build. Và đừng để video này dọa bạn rời bỏ local AI, vì những lý do khiến chúng ta chạy local vẫn còn nguyên giá trị.
Nhưng nếu bạn đang chạy một agent có quyền dùng tool, kéo fine-tune từ những repo đang hot, và đã đặt OLLAMA_HOST thành 0.0.0.0 vì bạn chỉ cần nó chạy được "một lần đó thôi", thì theo Kai (video đăng ngày 21/10/2026), hãy dành ra buổi chiều đó, vì nó đáng. Kai kết lại: model của bạn chỉ là những con số, nên hãy chắc rằng thứ tệ nhất những con số đó có thể với tới là một thư mục mà bạn chấp nhận mất.
Cuối video đăng ngày 21/10/2026, Kai cảm ơn mọi người đã xem, và nhắc: hãy đi cập nhật Ollama.
Nguồn và liên kết 13 nguồn
- Tên gốc: Your Local AI Is Not as Private as You Think
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=3mx84MRj8lY youtube.com
- Kênh YouTube Kai (Kai): youtube.com/channel/UCgUfJoPtkt7-RiiuYh4vmGA youtube.com
- ProjectDiscovery, "How abliterated models can get you pwned" (backdoor qua trigger "bonsoir, Elliot", 1% và 20% dữ liệu đầu độc, chi phí training; đọc ngày 26/10/2026): projectdiscovery.io/research/how-abliterated-models-can-get-you-pwned projectdiscovery.io
- Anthropic, "Sleeper Agents: Training deceptive LLMs that persist through safety training" (công bố 14/01/2024; đọc ngày 26/10/2026): anthropic.com/research/sleeper-agents-training-deceptive-llms-that-persist-through-safety-training anthropic.com
- Anthropic, "A small number of samples can poison LLMs of any size" (nghiên cứu chung với UK AI Security Institute và Alan Turing Institute, 250 tài liệu; đọc ngày 26/10/2026): anthropic.com/research/small-samples-poison anthropic.com
- HiddenLayer, malware trong repo Hugging Face "Open-OSS/privacy-filter" (đọc ngày 26/10/2026): hiddenlayer.com/research/malware-found-in-trending-hugging-face-repository-open-oss-privacy-filter hiddenlayer.com
- Pillar Security, backdoor trong chat template trên 18 model và 4 engine (đọc ngày 26/10/2026): pillar.security/blog/from-discovery-to-large-scale-validation-chat-template-backdoors-across-18-models-and-4-engines pillar.security
- Cyera, Bleeding Llama (rò rỉ bộ nhớ trong Ollama; đọc ngày 26/10/2026): cyera.com/blog/bleeding-llama-a-critical-memory-leak-in-the-worlds-most-popular-local-ai-platform cyera.com
- Wiz, Probllama, lỗ hổng remote code execution trong Ollama năm 2024 (đọc ngày 26/10/2026): wiz.io/blog/probllama-ollama-vulnerability-cve-2024-37032 wiz.io
- SentinelOne Labs, "Silent Brothers": 175.108 host Ollama trên 130 quốc gia (đọc ngày 26/10/2026): sentinelone.com/labs/silent-brothers-ollama-hosts-form-anonymous-ai-network-beyond-platform-guardrails sentinelone.com
- Cyera, NemoClaw: một lần ghé website để chiếm quyền AI agent (đọc ngày 26/10/2026): cyera.com/research/nemoclaw-one-website-visit-to-hijack-your-ai-agent cyera.com
Related talks
Grok Bot sau 14 ngày dùng thật: điều không ai nói
Helena Zhang · Helena Zhang · 9 min
14 ngày dùng Grok Bot thật: đội bot chuyên môn, dọn 500 GB ổ đĩa, nối ChatGPT và Claude, máy tính và IP dùng chung, usage và giá qua Cursor.
Năm GrokBot đáng cài sau khi thử hơn 100 bot
Kacper Rutkiewicz · Kacper Rutkiewicz | AI Made Simple · 22 min
Năm GrokBot dựng thành một team: FirstMate điều phối, dr eggbot tạo bot, Usage Bot canh quota, tinkabot làm plugin API, Box Inspector kiểm template.
Tự build MCP server cho AI agent
Nicolai Nielsen · Nicolai Nielsen · 17 min
Bọc Python function và backend có sẵn thành MCP server bằng FastMCP, phân quyền từng tool theo scope cho agent, demo agent đặt lịch khám.