Your Voice Agent Doesn't Need a Frontier Model
AI Engineer World's Fair 2026: Online Track · Video gốc
Voice tutor Ace chọn model nhỏ vì latency budget khoảng 950 ms: state machine và mastery tracking nằm trong code, model chỉ nói, nhờ đó Haiku 4.5 thay được Opus 4.7.
1. Ace chạy trên model nhỏ, và đó không phải sự thoả hiệp
Ornella mở đầu rất ngắn: cô là Ornella, người bên cạnh là Joel, và hai người đã xây Ace, một AI voice tutor chạy live, tức một gia sư AI nói chuyện trực tiếp bằng giọng với học sinh. Điều đáng chú ý nằm ngay ở câu thứ hai: Ace chạy trên một model nhỏ, và nhóm chọn như vậy có chủ đích. Ornella muốn dùng cả talk để giải thích vì sao lựa chọn đó không phải là một sự thoả hiệp.
Talk này là một lightning talk, chỉ vài phút, và đi theo một mạch rất gọn: latency budget buộc nhóm phải ra quyết định chọn model, những gì phải chuyển ra khỏi model để sống được trong budget đó, và cái giá phải trả: một model nhỏ không có scaffolding thì yếu ở đâu. Ace là sản phẩm luyện thi ACT, trang chính thức là aceactprep.com. Hai diễn giả cũng có một talk khác trong cùng Online Track, "Don't Let the LLM Drive", đi sâu hơn vào phần harness điều khiển bài học.
2. Khoảng lặng trên cuộc gọi là thứ giết chết voice agent
Ornella mời người xem làm một phép thử nhanh bằng cảm giác. Hãy nhớ lại khoảng im lặng trên một cuộc gọi. Theo cô, chính khoảng im lặng đó là ranh giới giữa một gia sư và một ứng dụng hỏng. Khi một voice agent ngừng lại dù chỉ một giây, não của người nghe lập tức kết luận: nó chết rồi.
Lý do là voice không có cách nào để "báo đang tải". Trên màn hình, một ứng dụng chậm vẫn có thể hiện spinner để người dùng biết hệ thống đang làm việc. Trong một cuộc trò chuyện bằng giọng, không có spinner; chỉ có im lặng, và im lặng thì giống hệt như mất kết nối. Người dùng không phân biệt được "model đang nghĩ" với "ứng dụng đã treo".
3. Bản năng "model lớn hơn thì tốt hơn" bị ngược trong voice
Từ đó Ornella chỉ ra một cái bẫy quen thuộc. Khi câu trả lời của agent nghe hơi sai một chút, mọi bản năng của người làm sản phẩm đều thúc mình với lấy model thông minh nhất, lớn nhất. Câu trả lời chưa đủ hay thì đổi sang model mạnh hơn, nghe rất hợp lý.
Nhưng trong voice, bản năng đó thực ra đi ngược. Một model lớn hơn thường nghĩ lâu hơn trước khi nói, và trong một cuộc gọi, thời gian nghĩ đó biến thành đúng khoảng lặng mà phần trước vừa mô tả. Càng cố làm câu trả lời thông minh hơn bằng cách đổi model, trải nghiệm càng có nguy cơ trở thành "ứng dụng hỏng".
4. Budget là millisecond, không phải IQ
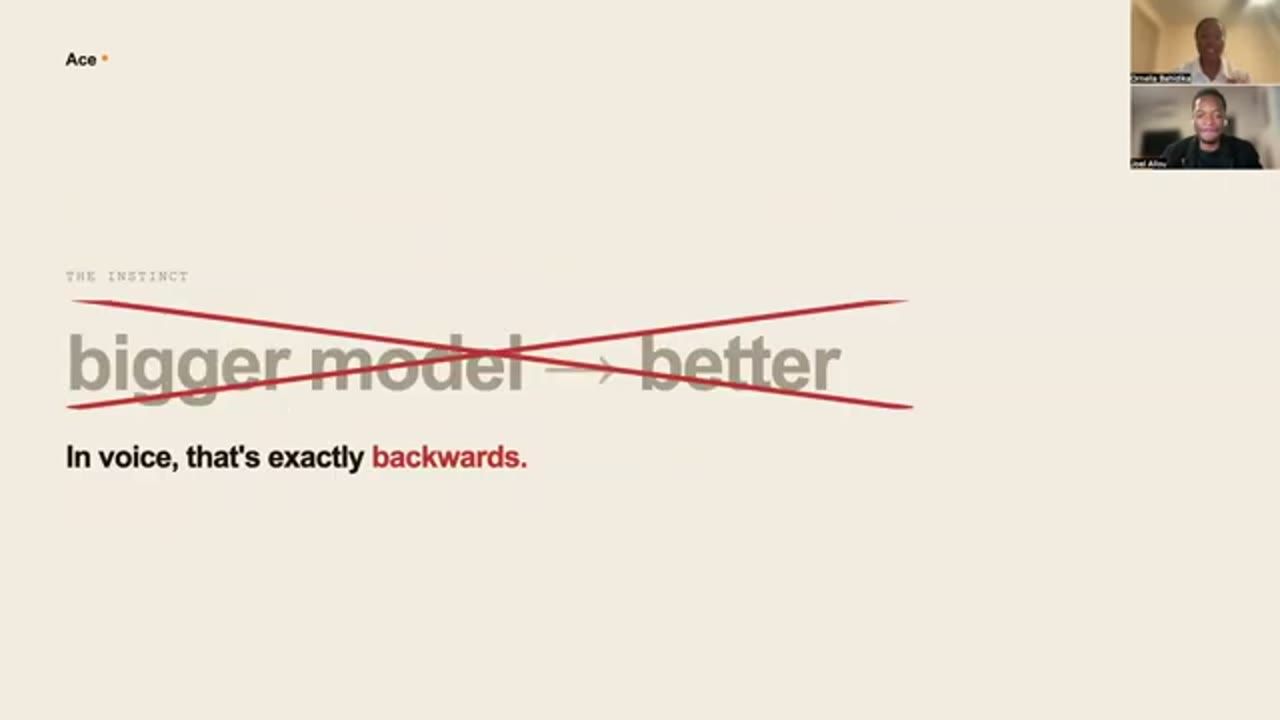
Ornella nói thẳng: budget của nhóm chưa bao giờ là IQ của model, mà là millisecond. Model AI cần bắt đầu nói trong khoảng 950 millisecond. Con số trên slide được gọi là time to first token, thời gian từ lúc người dùng nói xong tới khi model sinh ra token đầu tiên của câu trả lời.
Với budget như vậy, một frontier model suy nghĩ trọn một giây đã "mất khán phòng" rồi, bất kể câu trả lời của nó hay tới mức nào. Câu trả lời xuất sắc mà tới muộn thì trong một cuộc gọi vẫn là một câu trả lời thất bại, vì người nghe đã kịp nghĩ ứng dụng không còn hoạt động.
5. Lấy những việc khó ra khỏi model
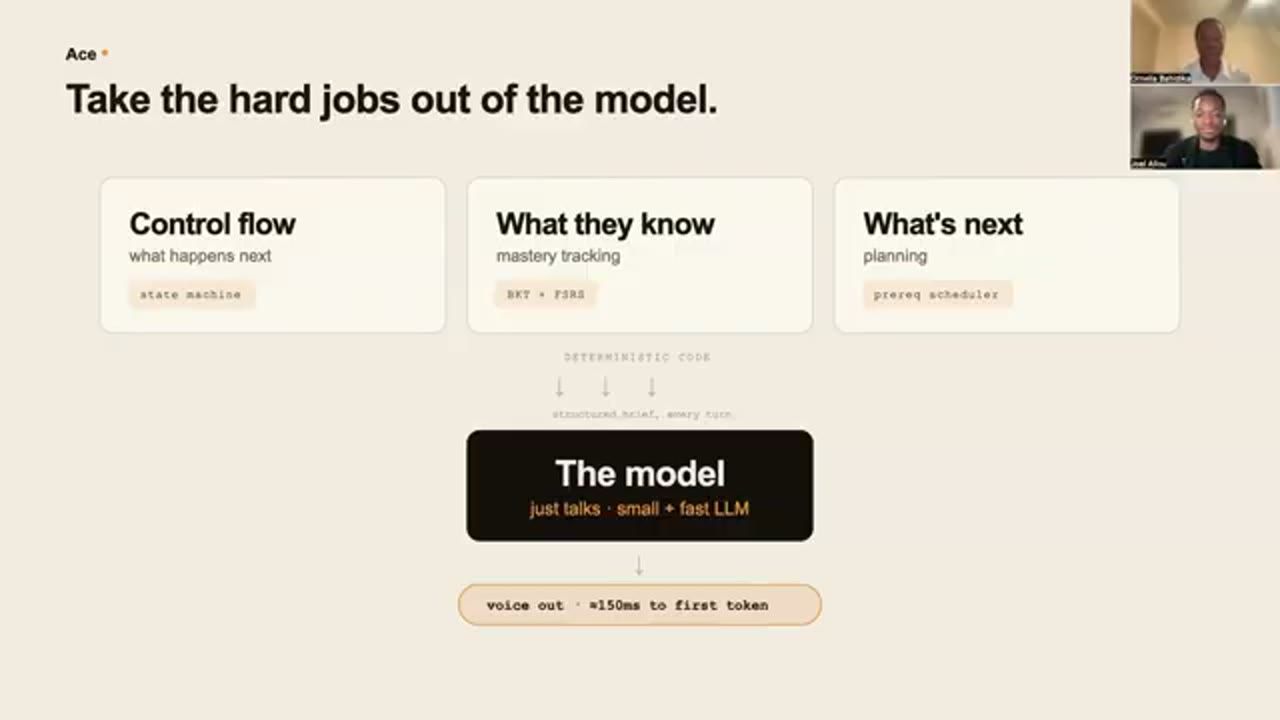
Lời giải của nhóm là làm cho model nhỏ đi, và lấy những việc khó nhất ra khỏi tay nó. Ornella liệt kê ba việc model trong Ace không làm. Nó không quyết định chuyện gì xảy ra trong bài học. Nó không theo dõi học sinh đã biết những gì. Nó không lên kế hoạch cho bước tiếp theo.
Thay vào đó, nhóm đặt một hệ thống riêng để làm ba việc này, và hệ thống đó trao cho model một bản tóm tắt ở mỗi lượt nói. Thứ còn lại cho model là đúng một việc nó thật sự giỏi: nói chuyện. Ornella chốt "and that's it", chỉ vậy thôi, rồi nhường lời cho Joel để anh cho mọi người thấy cảm giác thực tế khi dùng Ace.
Slide vẽ kiến trúc này thành ba khối phía trên. Khối "Control flow" lo chuyện điều gì xảy ra tiếp theo, làm bằng một state machine. Khối "What they know" lo mastery tracking, tức theo dõi mức thành thạo của học sinh, ghi chú là BKT + FSRS. BKT thường là viết tắt của Bayesian Knowledge Tracing, một phương pháp ước lượng xác suất học sinh đã nắm một kỹ năng; FSRS là thuật toán lên lịch ôn tập theo kiểu spaced repetition của dự án mã nguồn mở Open Spaced Repetition. Khối "What's next" lo planning, làm bằng một prereq scheduler, tức bộ lập lịch dựa trên các kiến thức tiên quyết. Cả ba đều là deterministic code, và chúng đổ xuống model một "structured brief" ở mỗi lượt. Model ở giữa chỉ "just talks", là một LLM nhỏ và nhanh. Ở ô đầu ra cuối cùng, slide ghi voice out với khoảng 150 ms tới token đầu tiên.
6. Vì sao reasoning lại là vấn đề, và state machine thay thế nó ra sao
Joel thêm màu cho điều Ornella vừa nói. Hãy nghĩ tới các model hiện nay, nhất là frontier model; anh lấy ví dụ Claude 4.7 của Anthropic. Model này rất giỏi reasoning. Bạn đưa cho nó một vấn đề, trong trường hợp này là một bài học, và nó có thể suy luận qua bài học, suy luận về điều học sinh đang hỏi, rồi đưa ra câu trả lời.
Nhưng chính điều đó lại là vấn đề. Phần reasoning có thể mất vài giây, và vài giây đó cực kỳ quý khi bạn xây ứng dụng voice. Vì vậy nhóm nói: hãy rút toàn bộ phần suy nghĩ ra khỏi model, để model chỉ tập trung vào thứ quan trọng, mà với Ace là nói.
Toàn bộ phần suy nghĩ được chuyển vào một state machine. Với Ace, nhóm đã nghĩ trước mọi tình huống cần có trong một bài học. Họ xây một state machine có khả năng điều phối từ bước này sang bước kế tiếp, và thêm một lớp thông minh phía trên để suy ra mức mastery mà học sinh cần đạt trước khi bài học được coi là hoàn tất. Mọi thứ liên quan tới chuyện gì xảy ra tiếp theo, cái gì cần hiển thị, và trả lời một câu hỏi như thế nào, đều được làm bên ngoài model. Nhóm chỉ đưa kết quả đó cho model để nó nói ra thành lời.
7. Demo: Opus 4.7 suy nghĩ vài giây, Haiku 4.5 trả lời trong khoảng 900 ms
Joel cho xem một ví dụ để thấy cách nó chạy trong thời gian thực. Video thứ nhất là phiên bản không có những gì nhóm vừa trình bày, chỉ là một Opus 4.7 đơn thuần. Họ hỏi một câu rất đơn giản, và có thể thấy model đang suy nghĩ, đang reasoning, mất vài giây mới trả câu trả lời về cho người dùng.
Ở video thứ hai, nhóm đặt toàn bộ những gì vừa nói lên Haiku 4.5, một model nhỏ hơn nhiều. Cùng một câu hỏi, nhưng lần này câu trả lời tới trong khoảng 900 millisecond. Joel gọi đó là cái đẹp của việc xây xung quanh model. Bằng cách gỡ toàn bộ phần suy nghĩ, phần logic và phần reasoning ra khỏi model và đặt chúng vào code, nhóm tiết kiệm được rất nhiều thời gian, và có thể dùng các model nhỏ hơn, vừa tiết kiệm chi phí vừa thực sự tốt hơn cho ứng dụng voice thời gian thực.
Như trong demo, trải nghiệm gần như tức thì. Joel nhắc lại lý do: tất cả những phần thông minh đã xảy ra từ trước khi model thực sự cất lời.
8. Cái giá phải trả: scaffolding
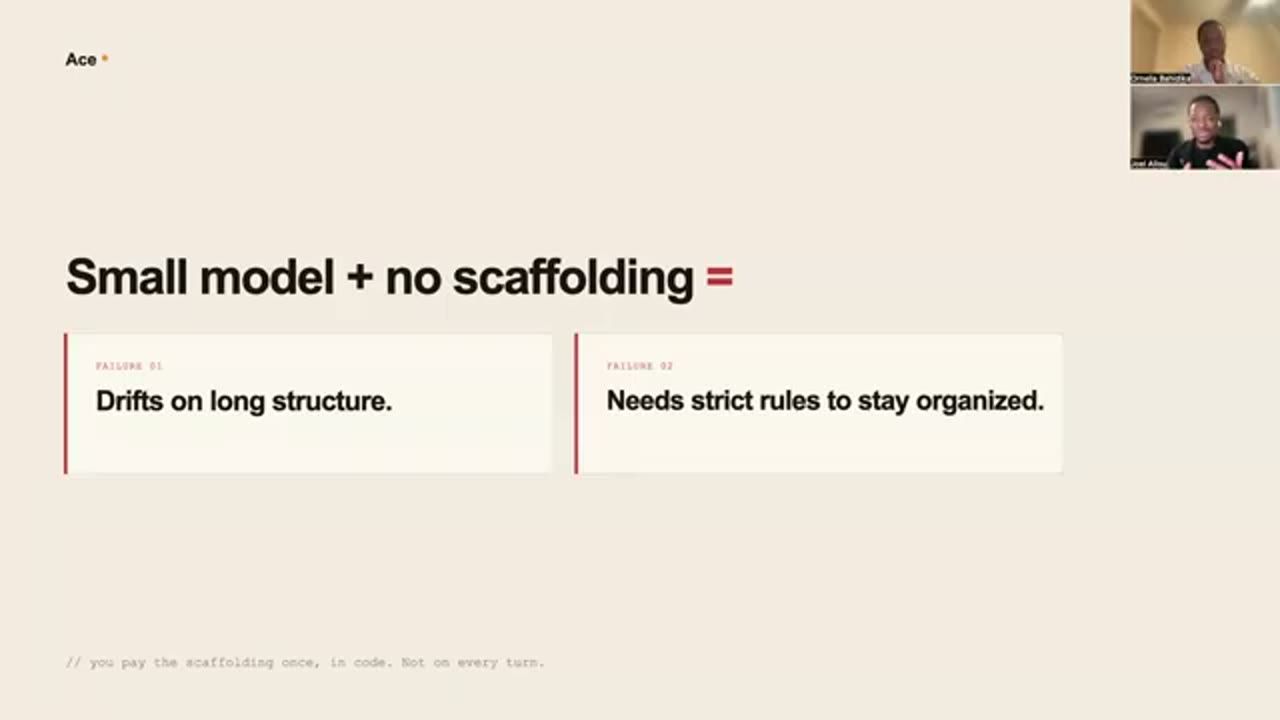
Phần này được nói thẳng thắn: cách làm này không miễn phí, nó có giá. Một model nhỏ như Haiku 4.5, nếu không có scaffolding bao quanh, có xu hướng trôi lệch khi phải giữ một cấu trúc dài, và rất cần những luật chặt chẽ để giữ được trật tự. Slide gọi đây là hai kiểu thất bại: "drifts on long structure" và "needs strict rules to stay organized".
Vì vậy phần scaffolding chính là cái giá. Nhưng điểm tốt là bạn trả nó một lần, và trả bằng code, chứ không phải trả ở mỗi lượt nói. Một frontier model thì bắt bạn trả bằng latency và chi phí ở từng lượt; scaffolding thì là chi phí kỹ thuật bỏ ra một lần lúc xây hệ thống.
9. Quy tắc chọn model: nhanh nhất mà latency budget cho phép
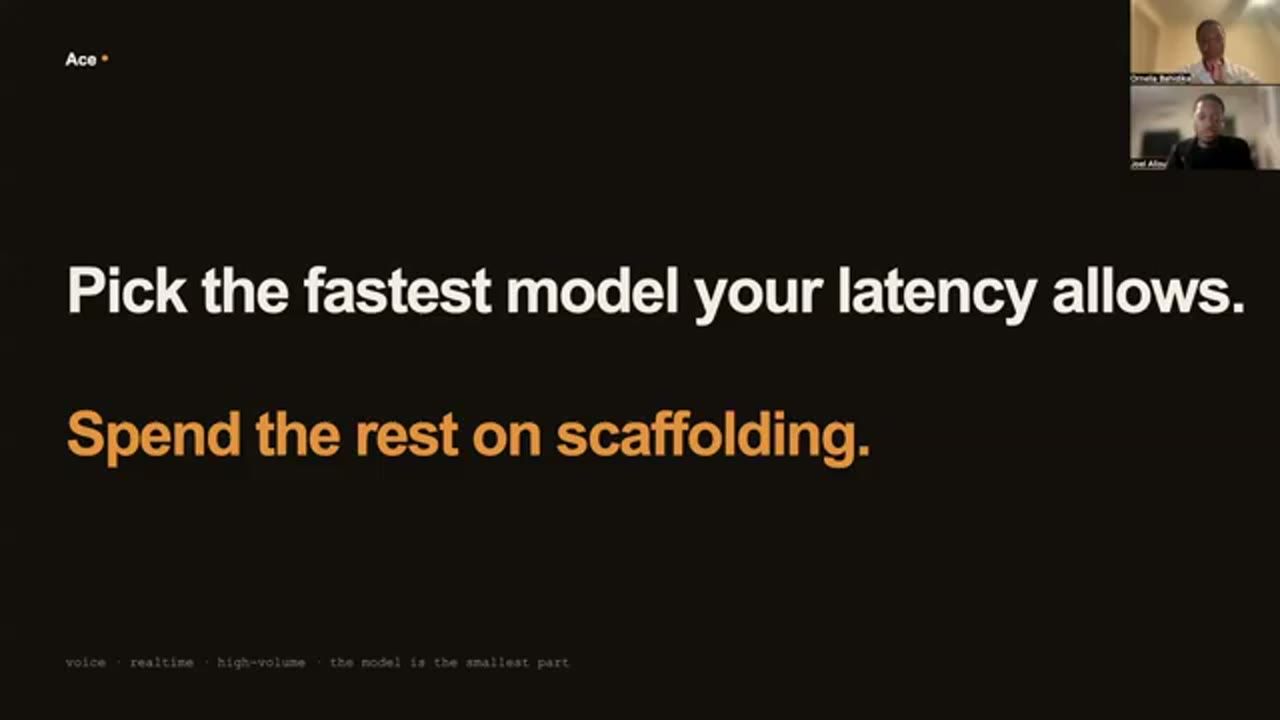
Quy tắc được đúc kết thành một câu: chọn model nhanh nhất mà latency budget của bạn cho phép, rồi dành phần thời gian còn lại để thực sự xây scaffolding. Trong trường hợp của Ace, có thể đó là xây một state machine, xây quy trình reasoning, nghĩ trước các tình huống: nếu chuyện này xảy ra thì sao, model của bạn nên xử lý thế nào. Mọi thứ thuộc về logic, mọi thứ thuộc về reasoning, bạn làm bên ngoài model, rồi để model tập trung vào đúng một việc nó thật sự giỏi.
Điều đó đúng với ứng dụng voice như Ace. Nó đúng với các ứng dụng real-time nơi latency là ưu tiên. Và nó thực sự đúng với bất cứ thứ gì có lưu lượng lớn. Trong những trường hợp đó, model là phần nhỏ nhất của hệ thống.
Hai diễn giả kết thúc bằng lời chào: đây là Joel và Ornella, nhóm đang xây Ace, và nếu ai có câu hỏi thì cứ liên hệ. Cảm ơn mọi người.
Sources and links
- Trang talk trên ai.engineer · Video gốc
- Ace: ACT Prep: voice tutor luyện thi ACT mà hai diễn giả xây
- Don't Let the LLM Drive: talk cùng Online Track của Ornella và Joel về harness điều khiển bài học
- Claude Haiku 4.5: model nhỏ Ace dùng trong demo
- Claude Opus 4.7: frontier model trong video so sánh
- Open Spaced Repetition: dự án mã nguồn mở của thuật toán FSRS, ghi trên slide kiến trúc
- LinkedIn của Ornella Bahidika: linkedin.com/in/ornella-bahidika · LinkedIn của Joel Allou: linkedin.com/in/joel-allou
Related talks
The 100-Tool Agent Is a Trap: Scaling with Semantic Routers and JIT Context
Sohail Shaikh & Ankush Rastogi · Prosodica · 28 min
Nạp mọi tool vào prompt làm accuracy rơi từ 78% xuống 13% ở 741 tool; semantic routing (RAG cho tool) với JIT context giữ trên 83% và cắt 99% token.
Voice In, Visuals Out: The Agony and the Ecstasy
Allen Pike · Forestwalk Labs · 13 min
Vì sao voice-in, visuals-out là UX tốt nhất cho AI, và ba trụ cột giữ phản hồi dưới một giây: model nhanh, inference chu kỳ ngắn, prefix caching ổn định.
The Future Is Domain-Specific Agents
Justin Schroeder · StandardAgents · 31 min
Composition over inheritance cho agent: thay vì nhồi MCP và skill vào một agent lớn, ghép nhiều agent nhỏ theo domain, tiết kiệm token, dùng được small model.