Framework năm layer cho AI system design, qua ví dụ agent chăm sóc khách hàng
Framework năm layer và KARC để thiết kế một hệ thống AI agent từ scope, kiến trúc, observability, production tới tối ưu, qua ví dụ agent hỗ trợ khách hàng.
✓ Đã duyệt độc lập · cập nhật 24/10/2026 · 20 min
1. Ứng viên biết thuật ngữ nhưng thiếu kỹ năng AI system design
Aishwarya mở đầu bằng kinh nghiệm phỏng vấn của chính chị: chị đã phỏng vấn hàng trăm người cho các vị trí AI, lần đầu là khi còn làm tech lead ở AWS, và theo lời chị trong video đăng ngày 22/10/2026 thì giờ là cho công ty riêng của chị. Những ứng viên không được nhận thường có chung một điểm. Đúng là họ biết RAG là gì, MCP là gì, thậm chí tool calling là gì, nhưng họ loay hoay khi phải áp các khái niệm đó vào một bài toán kinh doanh thật, hoặc khi phải giải thích cần những gì để đưa một hệ thống AI lên production ở quy mô lớn.
Chị gọi đó là kỹ năng AI system design. Trong video này, chị đi qua một framework năm layer cho AI system design mà theo chị (video đăng ngày 22/10/2026) có thể áp cho gần như mọi hệ thống AI thật đang chạy production, đi suốt từ lúc scope bài toán cho tới lúc tối ưu nó trên production. Đến cuối video, mục tiêu là người xem biết cách tiếp cận một bài toán AI ngoài đời thật và giải thích được các quyết định của mình, để nổi bật trong buổi phỏng vấn thay vì lẫn vào đám đông những người chỉ ném thuật ngữ ra.
Năm layer chị dùng là: scope and assumptions, architecture, observability, production and ops, và optimization. Để đi qua framework, chị dùng ví dụ một agent chăm sóc khách hàng (customer support agent), mà chị gọi là một trong những bài toán AI system design phổ biến nhất (theo Aishwarya, video đăng ngày 22/10/2026).
2. Bài toán ví dụ: agent chăm sóc khách hàng cho một công ty e-commerce
Giả sử có một công ty e-commerce muốn build một hệ thống AI chăm sóc khách hàng. Hệ thống phải trả lời được các câu hỏi dựa trên help center, tra cứu đơn hàng (look up orders), tạo support ticket và những việc tương tự. Và quan trọng nhất, nó phải biết escalate cho một người thật khi nó không chắc chắn. Việc của chúng ta, theo Aishwarya, là thiết kế hệ thống này và nghĩ cho kỹ xem thực sự cần những gì để đưa nó lên production ở quy mô lớn.
Theo Aishwarya (video đăng ngày 22/10/2026), khi nghe một bài toán như thế, phần lớn người mới bắt đầu lập tức ném ra các thuật ngữ: RAG, model, tool, agent, đôi khi còn cả multi-agent system. Nhưng trước khi làm bất cứ điều gì trong số đó, hãy nhớ rằng bạn phải hiểu thật rõ phạm vi (scope) của bài toán trước khi đi vào giải pháp. Rất nhiều người nhầm ở chỗ này: một phần rất lớn của system design chỉ đơn giản là scope bài toán và nói rõ các assumption của mình ra. Đó chính là layer đầu tiên: scope and assumptions.
3. Layer 1: Scope and assumptions, bốn câu hỏi đầu tiên
Aishwarya bắt đầu layer này bằng bốn câu hỏi. Người dùng là ai, và họ đang gặp vấn đề gì? Kết quả (outcome) nào mà ta đang cố cải thiện? Phần nào của bài toán, hay của workflow, nên giao cho AI xử lý? Và hệ thống nên có bao nhiêu agency?
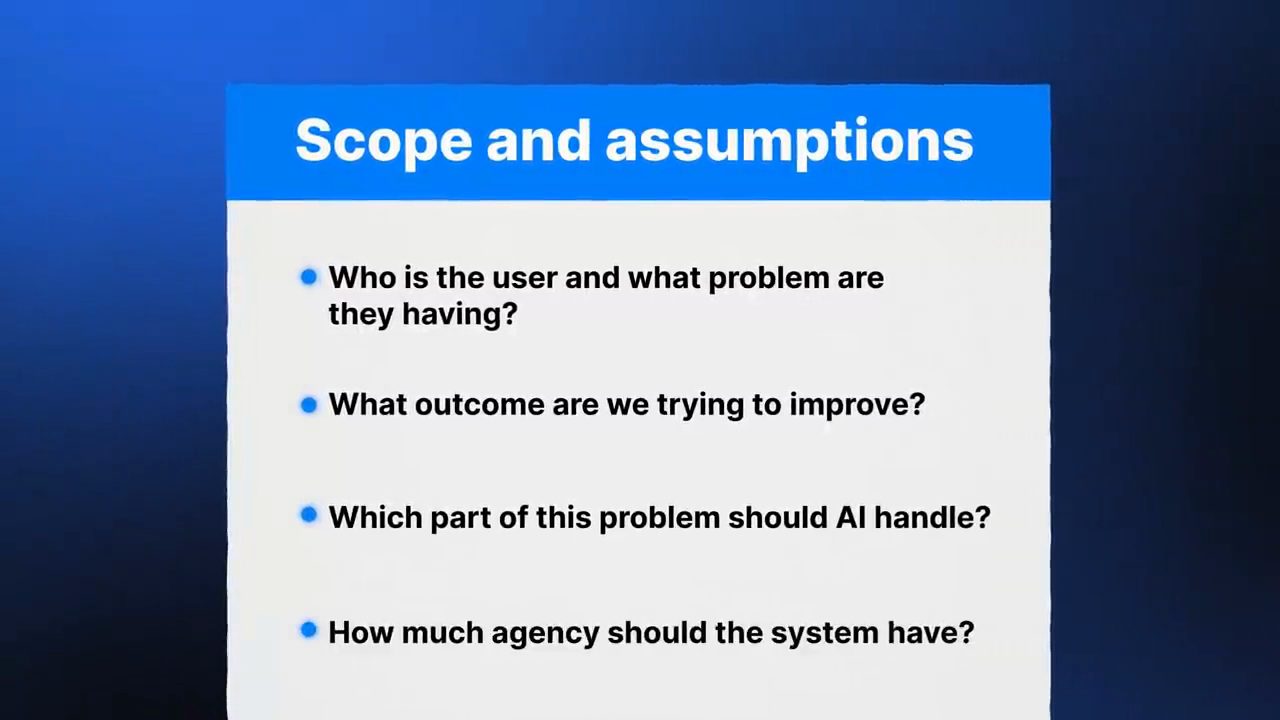
Với ví dụ của chị, người dùng là một khách hàng cần được hỗ trợ. Vấn đề chính là rất nhiều yêu cầu lặp đi lặp lại nhưng vẫn cần một người thật trả lời. Outcome mong muốn là giải quyết được nhiều yêu cầu thường lệ (routine) hơn mà không cần tới một nhân viên hỗ trợ cho mỗi lần. Phần AI nên xử lý là trả lời các câu hỏi phổ biến dựa trên help center; nó cũng nên tra cứu đơn hàng, tạo support ticket và escalate cho người thật khi nó không tự tin.
4. Agency và control: hệ thống được tự làm tới đâu
Câu hỏi thứ tư, theo Aishwarya (video đăng ngày 22/10/2026), là thứ nhiều người mới bắt đầu hoàn toàn không nghĩ tới. Chị gọi nó là agency control trade-off: ta phải quyết định thật sự muốn trao cho hệ thống bao nhiêu quyền tự chủ (autonomy). Nó chỉ được soạn câu trả lời để một người duyệt, hay được trả lời thẳng cho khách hàng? Nó có được thay khách hàng thực hiện hành động hay không? Chị nói rằng việc nghĩ và làm rõ hết những câu hỏi này sẽ trực tiếp định hình kiến trúc bạn build quanh nó.
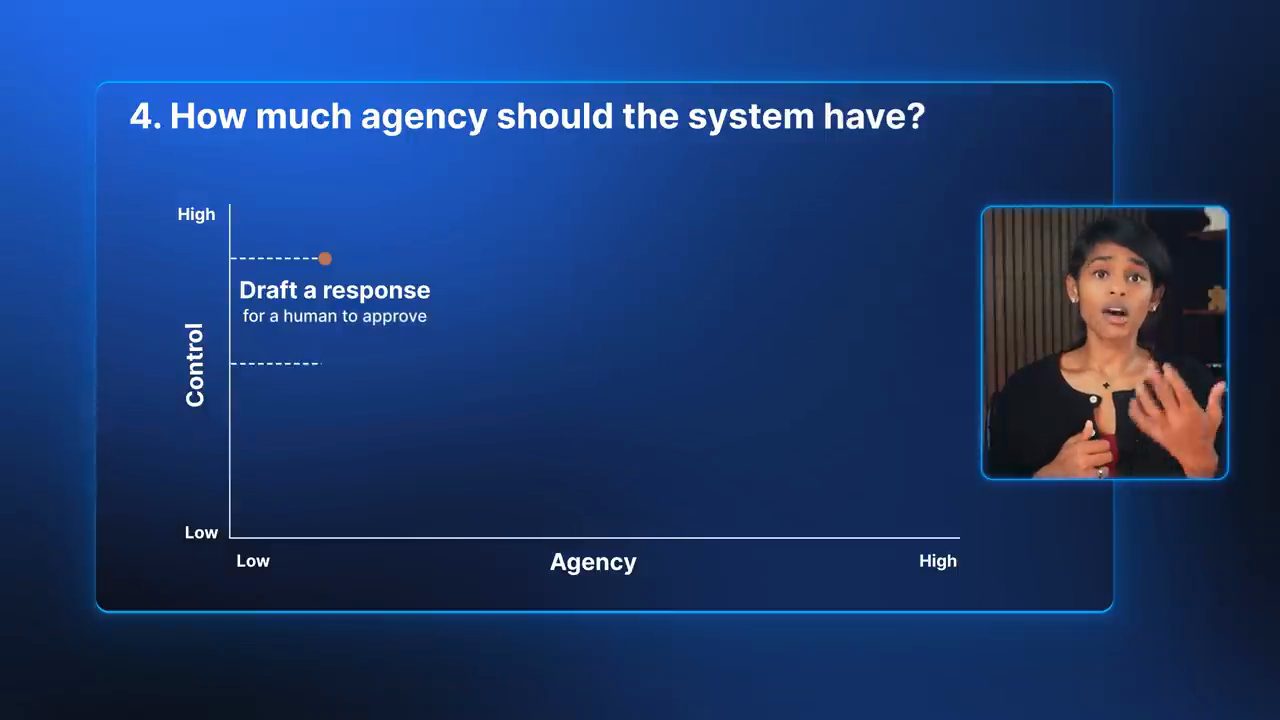
Với use case này, chị giả định hệ thống được tự trả lời các câu hỏi thường lệ và được tự làm các hành động rủi ro thấp như tra cứu một đơn hàng hay tạo một ticket. Khi không tự tin, nó escalate cho người thật. Các hành động rủi ro cao hơn, như hoàn tiền (issuing a refund), phải đi qua một bước kiểm tra policy hoặc cần một người duyệt.
5. Bốn nhóm assumption cần nói rõ
Phần thứ hai của việc scope là nói rõ các assumption ra. Aishwarya chia assumption cho một hệ thống AI thành bốn nhóm: dữ liệu (data), các loại input, các ràng buộc vận hành (operating constraints), và rủi ro của các hành động. Nếu bạn đang trả lời một câu hỏi phỏng vấn system design, đây là lúc chị khuyên (video đăng ngày 22/10/2026) nên hỏi người phỏng vấn càng nhiều câu càng tốt. Lý do: càng đưa ra nhiều assumption từ đầu, thiết kế hệ thống, hay thiết kế kiến trúc, của bạn càng tốt lên. Bạn không thiết kế dựa trên một thứ chỉ tồn tại trong đầu mình, mà đang làm cho nó trở nên rất rõ ràng.
Chị lưu ý đây là những assumption chị đặt ra cho sản phẩm của chị để đi qua ví dụ; bạn sẽ phải chuyển chúng sang use case của chính mình. Với hệ thống này:
- Dữ liệu: có lẽ là vài nghìn bài viết help center, phần lớn bằng tiếng Anh.
- Loại input: yêu cầu thường ngắn. Một số là câu hỏi mang tính ngữ nghĩa (semantic), chẳng hạn khách hỏi "tôi trả lại sản phẩm này được không?". Số khác chứa những thứ cụ thể như order ID hay một đoạn mã lỗi. Chị cũng giả định thường chỉ cần một bài viết là đủ để trả lời một câu hỏi.
- Ràng buộc vận hành: Aishwarya nói hệ thống cần phục vụ khoảng hàng nghìn khách hàng mỗi ngày, và người dùng thường mong nhận được câu trả lời trong vòng vài giây. Trên slide ghi "1000s of conversations a day, within a few seconds".
- Rủi ro của hành động: các hành động có mức rủi ro khác nhau. Tra cứu một đơn hàng khá an toàn, còn hoàn tiền thì không.
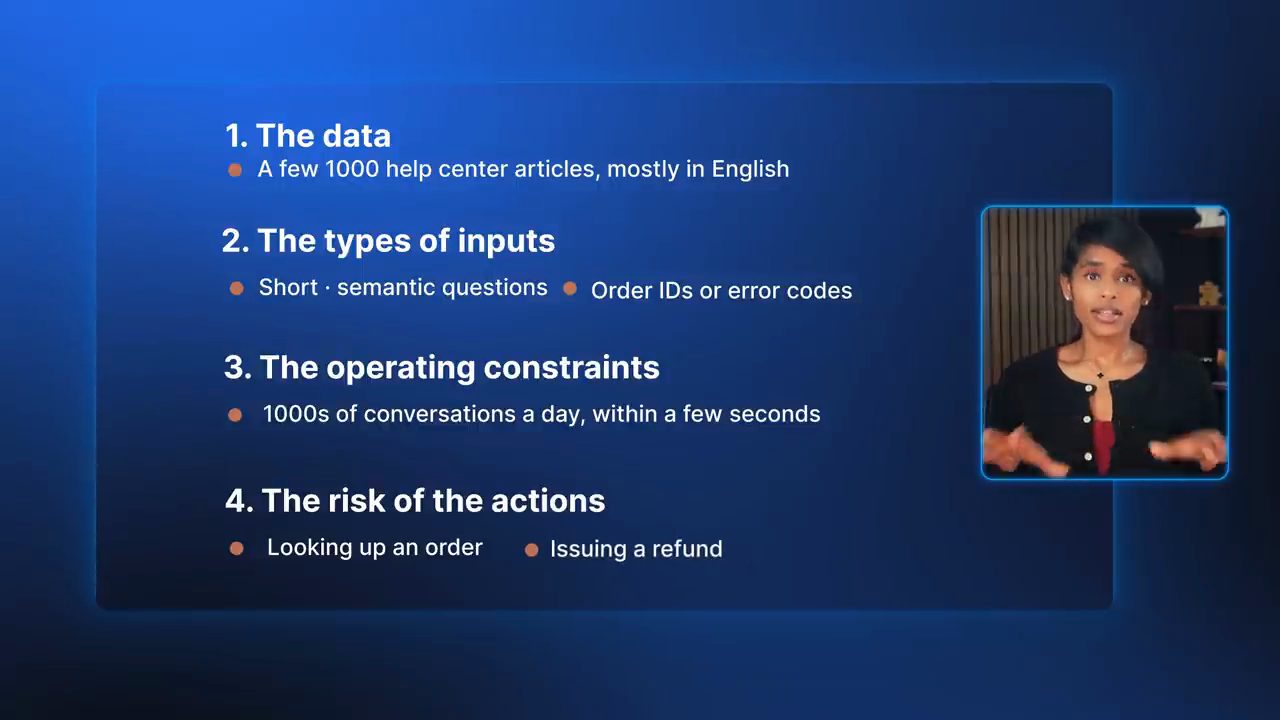
Đây là những assumption chị dùng cho mọi quyết định thiết kế phía sau.
6. Layer 2: framework KARC và phần Know
Khi đã hiểu scope và đặt ra một loạt assumption cho bài toán, bước tiếp theo là layer thiết kế kiến trúc. Để làm việc này, Aishwarya dùng một framework đơn giản do chính chị tạo ra, tên là KARC (chị đánh vần K-A-R-C): Know, Act, Remember và Coordinate. Nghĩa là bạn thiết kế những gì hệ thống phải biết, nó nên được phép tác động lên những gì, nó cần nhớ những gì, và tất cả các mảnh đó nên phối hợp với nhau ra sao để thành một kiến trúc. Ghép tất cả lại sẽ cho bạn kiến trúc khởi đầu. Chị nhắc rằng phần lớn những lựa chọn này được quyết định bởi cách bạn đặt assumption ở layer đầu tiên (theo Aishwarya, video đăng ngày 22/10/2026).
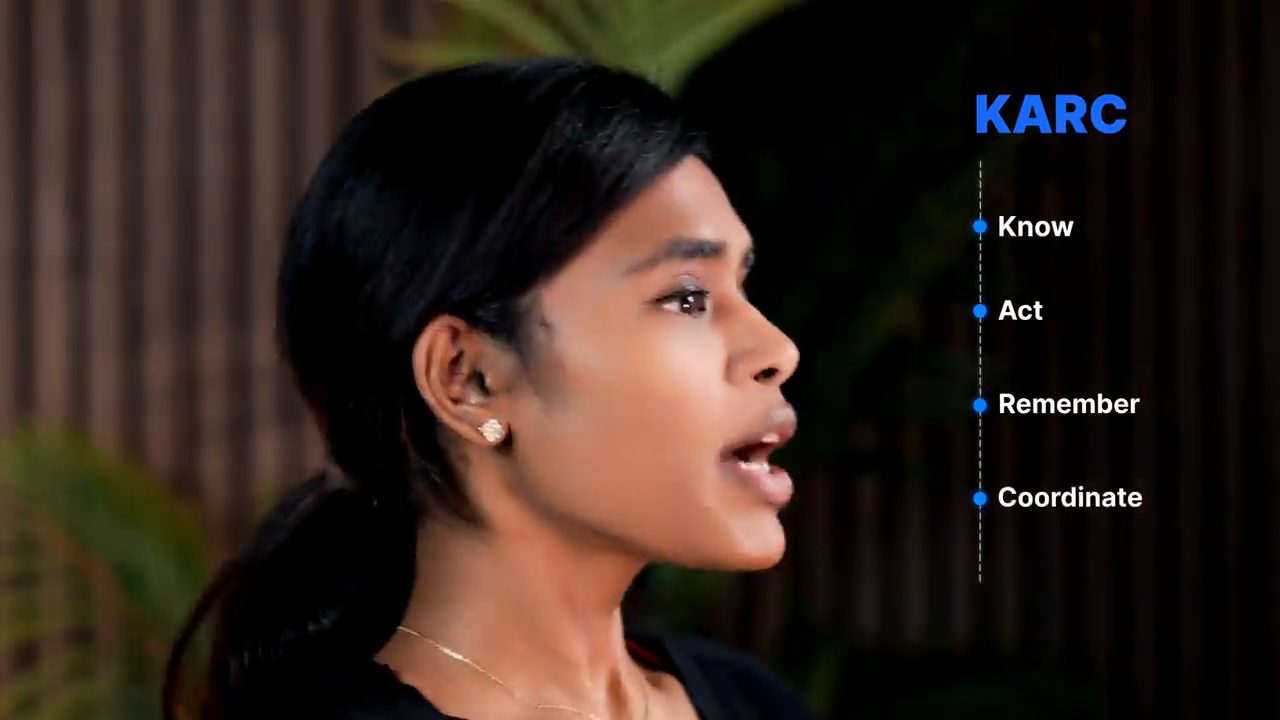
Với use case này, chị bắt đầu từ Know: agent chăm sóc khách hàng thực sự cần biết những gì? Với bài toán đã scope, phần lớn thông tin hệ thống cần có lẽ nằm trong các tài liệu không có cấu trúc (unstructured documents): chính sách đổi trả, quy định giao hàng, chính sách huỷ đơn, các bước xử lý sự cố và những thứ tương tự. Chị gợi ý hãy coi chúng là một bộ tài liệu chứa các quy trình chuẩn (standard operating procedures) mà agent phải nắm để hoàn thành nhiệm vụ (theo Aishwarya, video đăng ngày 22/10/2026).
Việc đầu tiên ở đây là đảm bảo hệ thống lấy được đúng thông tin trước khi trả lời bất cứ điều gì. Với dữ liệu đã mô tả, chị cho rằng một phiên bản đầu hợp lý là một pipeline RAG đơn giản, kiểu naive RAG: parse và chia chunk các tài liệu, tạo embedding, rồi lưu vào một vector database (theo Aishwarya, video đăng ngày 22/10/2026).
7. Hybrid retrieval, re-ranker và vì sao chưa cần graph RAG
Tới đây, Aishwarya nói phải suy nghĩ thêm một chút dựa trên các assumption đã đặt. Một số câu hỏi mang tính ngữ nghĩa: ví dụ ai đó hỏi "tôi gửi trả món này được không?", trong khi tài liệu lại ghi là "return policy". Vậy cần retrieval dựa trên vector. Nhưng dữ liệu cũng có những câu hỏi chứa thứ rất cụ thể, như SKU, tức mã định danh riêng gán cho từng sản phẩm; trong trường hợp đó, theo chị (video đăng ngày 22/10/2026), một kiểu keyword search như BM25 sẽ có ích. Vì vậy chị nghĩ tới một dạng hybrid retrieval để cả hai nhóm câu hỏi đều được trả lời. Sau đó có thể đặt một re-ranker lên trên kết quả và chỉ đưa những chunk liên quan nhất vào để model trả lời đúng.
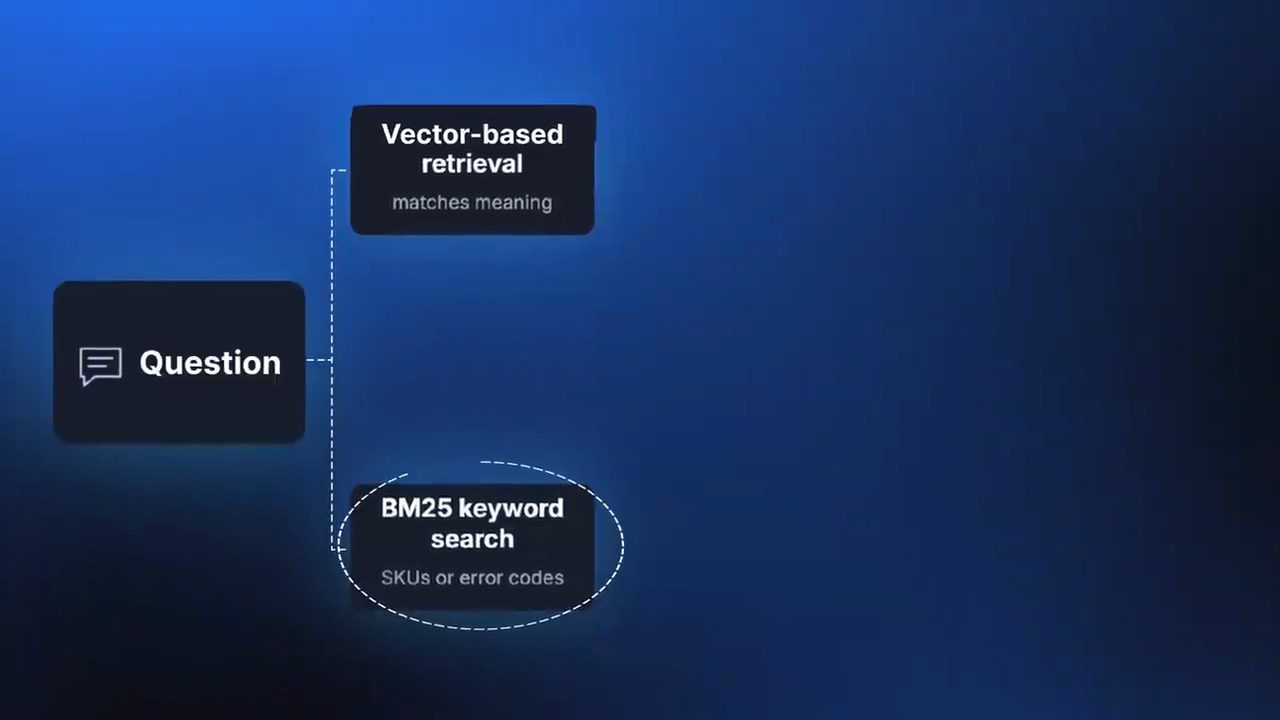
Chị nhắc lại assumption rằng một bài viết thường là đủ để trả lời một câu hỏi. Chính vì thế, chị sẽ không bắt đầu bằng graph RAG hay một luồng retrieval phức tạp. Nếu sau này eval cho thấy nhiều câu hỏi thực ra cần thông tin từ nhiều tài liệu, khi đó mới xem lại quyết định này. Nhưng đừng làm giải pháp phức tạp quá mức cần thiết (theo Aishwarya, video đăng ngày 22/10/2026).
8. Act: bốn tool và bốn câu hỏi cho mỗi tool
Mảnh tiếp theo của KARC là Act: hệ thống thực sự được phép làm gì? Aishwarya giải thích rằng agent thực hiện hành động thông qua tool, hay function, cho phép nó tương tác với các hệ thống bên ngoài. Với hệ thống chăm sóc khách hàng này, chị cho rằng cần bốn tool cốt lõi: look up order, create ticket, check refund eligibility và escalate to human (theo Aishwarya, video đăng ngày 22/10/2026).
Chị chỉ ra một chi tiết: ở đây chị cố ý chọn tool kiểm tra điều kiện hoàn tiền (refund eligibility), chứ không phải tool thực hiện hoàn tiền. Lý do là theo quyết định về agency đã đặt ở trên, agent chỉ được thu thập thông tin; với một hành động rủi ro cao, cần nhiều control hơn (theo Aishwarya, video đăng ngày 22/10/2026).
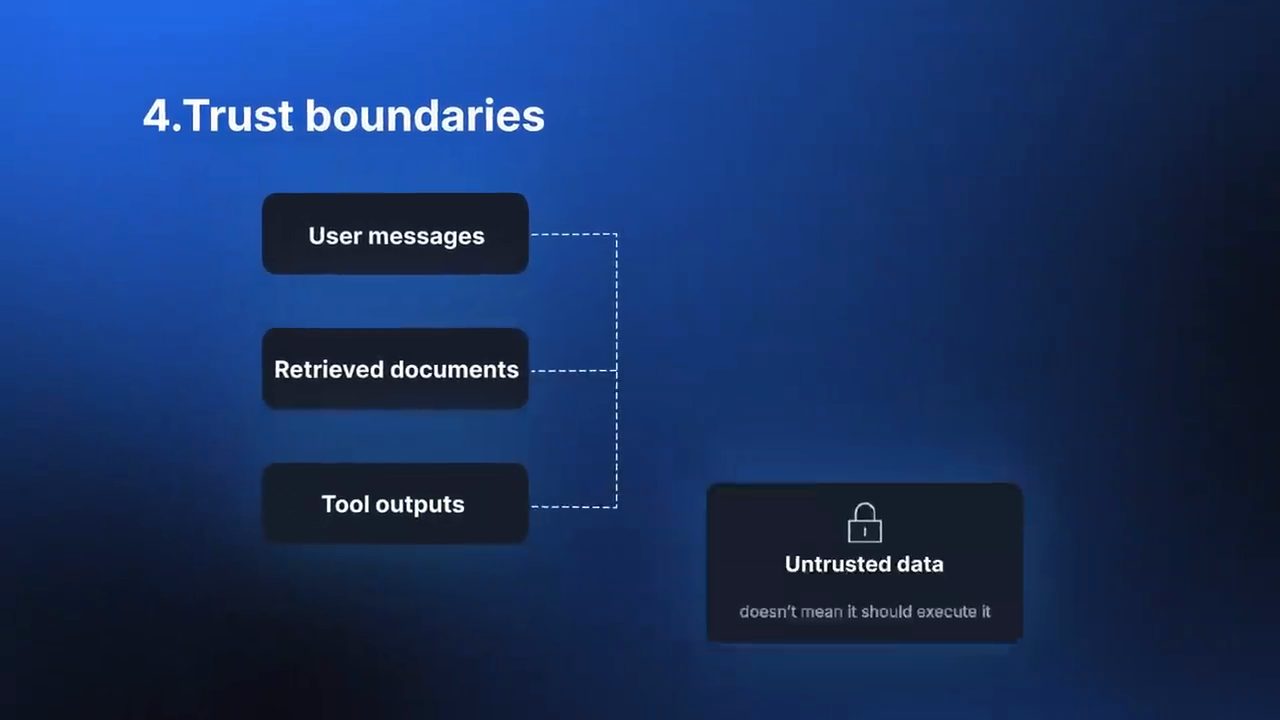
Khi đã biết cần những tool nào, chị đề nghị nghĩ về bốn điều cho từng tool: permissions, blast radius, failure handling và trust boundaries.
- Permissions: theo Aishwarya (video đăng ngày 22/10/2026), làm theo nguyên tắc least privilege. Mỗi tool chỉ được truy cập đúng phần thông tin nó cần. Ví dụ
look up orderchỉ cần quyền đọc database, và chỉ được truy cập những đơn hàng thuộc về khách hàng đã xác thực. - Blast radius: chị đề nghị (video đăng ngày 22/10/2026) hỏi xem chuyện gì xảy ra nếu tool làm sai. Tra cứu đơn hàng khá ít rủi ro, nhưng hoàn tiền thì không. Vì vậy các hành động hậu quả lớn như hoàn tiền hay huỷ đơn nên nằm sau một deterministic policy và cần người duyệt.
- Failure handling: theo Aishwarya (video đăng ngày 22/10/2026), tool sẽ bị timeout và API có lúc sẽ sập, nên bạn cần cách xử lý lỗi, tức nghĩ ra fallback policy cho trường hợp một tool không chạy đúng như thiết kế. Ví dụ, nếu dịch vụ tra cứu đơn hàng liên tục lỗi, ta retry trong một giới hạn nhất định rồi escalate cho người thật.
- Trust boundaries: tin nhắn của người dùng, tài liệu được retrieve và output của tool đều phải được coi là dữ liệu không đáng tin (untrusted data). Chẳng hạn, chỉ vì hệ thống thấy một chỉ dẫn nằm trong một tài liệu không có nghĩa là nó cứ thế làm theo, nhất là khi agent đã có quyền truy cập dữ liệu riêng tư và có tool thực hiện được hành động (theo Aishwarya, video đăng ngày 22/10/2026).
Đó là tất cả những khía cạnh chị muốn người xem tập trung vào khi thiết kế tool.
9. Remember: bốn loại memory
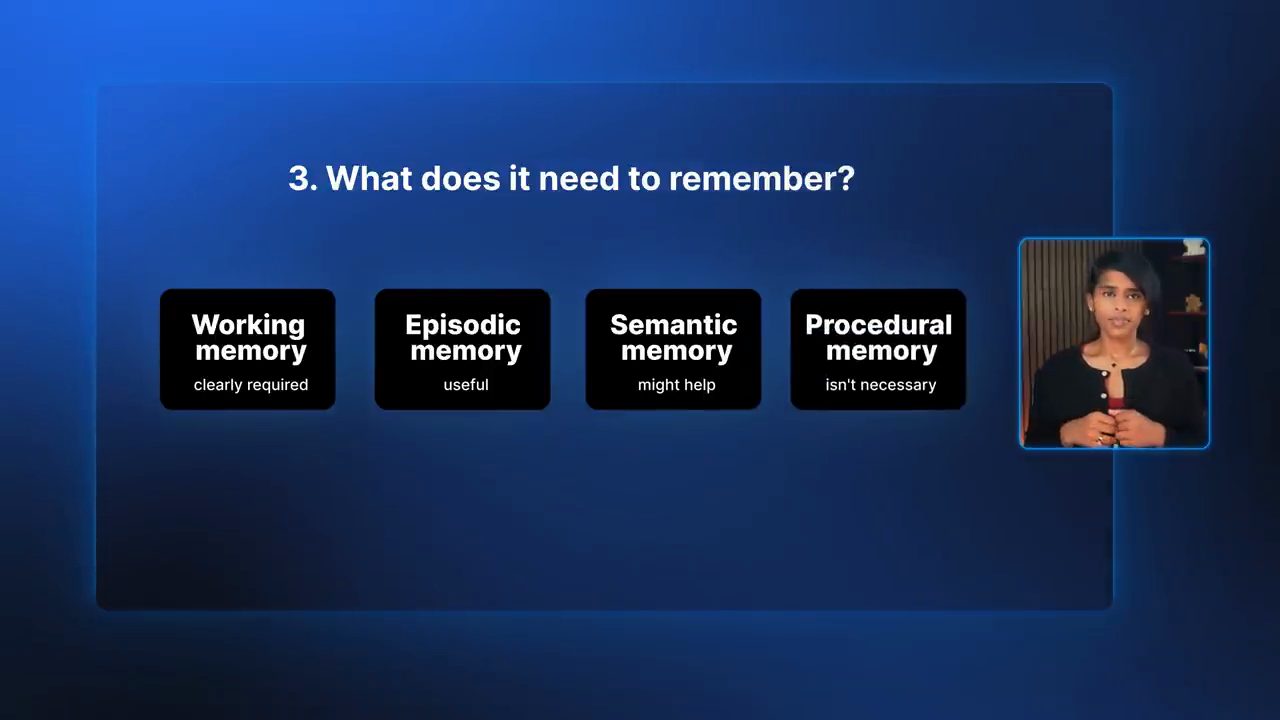
Mảnh thứ ba là Remember: hệ thống thực sự cần nhớ gì, và bạn thiết kế phần đó ra sao? Trong hệ thống AI, phần này thường được gọi là memory. Aishwarya nêu bốn loại memory hữu ích mà bạn nên nghĩ qua và đặt vào bối cảnh use case của mình: working memory, semantic memory, episodic memory và procedural memory (theo Aishwarya, video đăng ngày 22/10/2026).
- Working memory là những gì hệ thống cần cho nhiệm vụ hiện tại: lịch sử hội thoại, thông tin đã retrieve, các kết quả trung gian từ tool mà hệ thống cần, và những thứ tương tự (theo Aishwarya, video đăng ngày 22/10/2026).
- Semantic memory là các sự thật lâu dài (persistent facts) về người dùng hoặc tài khoản: sở thích của họ, thông tin khách hàng liên quan, thông tin giao dịch mà agent hỗ trợ cần, v.v. (theo Aishwarya, video đăng ngày 22/10/2026)
- Episodic memory về cơ bản là những gì đã xảy ra trước đó. Có thể khách hàng này đã liên hệ bộ phận hỗ trợ hôm qua và đơn hàng đã được escalate rồi. Hoặc đây là một khách hàng có lịch sử hoàn tiền, nên bạn muốn xử lý trường hợp này cho khéo (theo Aishwarya, video đăng ngày 22/10/2026).
- Procedural memory là thông tin về cách hệ thống nên hành xử, dựa trên các pattern hoặc sở thích trước đó (theo Aishwarya, video đăng ngày 22/10/2026).
Chị lưu ý: bốn loại này tồn tại không có nghĩa là bạn phải dùng hết. Hãy cân nhắc loại nào hữu ích dựa trên các assumption đã chốt. Với use case này, working memory rõ ràng là bắt buộc để theo được cuộc hội thoại hiện tại. Episodic memory cũng có thể hữu ích, để không lặp lại những hành động đã làm rồi. Một chút semantic memory có thể giúp với thông tin khách hàng liên quan. Còn procedural memory có lẽ chưa thật cần trong phiên bản đầu (theo Aishwarya, video đăng ngày 22/10/2026).
10. Coordinate: kiến trúc khởi đầu với một agent
Phần cuối của framework là Coordinate: knowledge, tool và memory thực sự phối hợp với nhau thế nào để thành hệ thống này. Dựa trên tất cả những gì đã bàn, Aishwarya cho rằng phiên bản khởi đầu đơn giản nhất của hệ thống là một agent duy nhất, có quyền truy cập các bài viết help center qua hybrid RAG, có quyền truy cập một nhóm nhỏ tool đã được giới hạn phạm vi (scoped tools) cho những việc như tra cứu đơn hàng và tạo ticket; về memory, nó cần theo dõi cuộc hội thoại hiện tại và các hành động liên quan đã làm trước đó (theo Aishwarya, video đăng ngày 22/10/2026).
Hệ thống trông như sau. Khi một request tới, người dùng được xác thực; knowledge từ retrieval và memory được kéo vào; và agent chỉ được truy cập những tool mà nó được phép dùng. Sau đó agent có thể trả lời, gọi một tool, hỏi thêm thông tin, hoặc escalate cho người thật. Agent cần được prompt rõ ràng rằng các hành động rủi ro cao phải đi qua bước kiểm tra policy hoặc người duyệt. Và cả vòng lặp có giới hạn về số lần retry, số bước và timeout, để agent không thể chạy mãi không dừng (theo Aishwarya, video đăng ngày 22/10/2026).
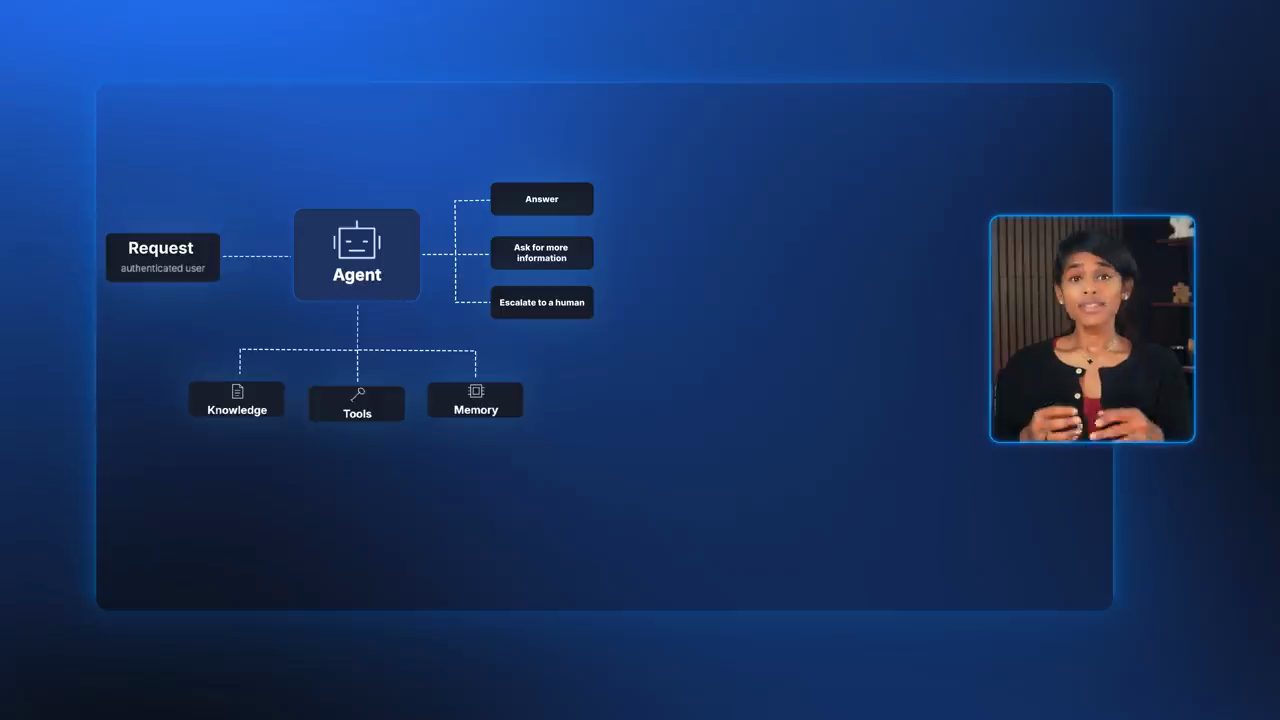
Đó là phiên bản đầu tiên chị thiết kế cho bài toán. Nhưng theo chị (video đăng ngày 22/10/2026), cần build layer observability quanh nó để hiểu nó đang chạy ra sao và làm sao để tiếp tục cải thiện theo thời gian. Điều đó dẫn sang layer thứ ba.
11. Layer 3: Observability, log những gì
Aishwarya định nghĩa (video đăng ngày 22/10/2026) observability là cách bạn hiểu hệ thống đang làm gì sau khi đã build xong. Nếu có gì đó hỏng trên production, bạn không nên chỉ biết là câu trả lời cuối cùng tệ. Bạn phải lần ra được nó hỏng ở đâu, và có đủ thông tin để thực sự sửa ở lần tiếp theo.
Chị dùng ba câu hỏi ở layer này: nên log những gì, nên build eval nào trên những log đó, và eval nào nên chạy online, eval nào chạy offline.
Bắt đầu với logging. Ở mức tổng quát, bạn cần log mọi input, output và quyết định quan trọng qua từng thành phần của hệ thống. Với use case này, danh sách đó gồm: cái gì được đưa vào model, cái gì đi ra, cái gì được retrieve, tool nào được gọi và argument nào được truyền vào các tool đó, đã retry bao nhiêu lần, mỗi bước mất bao lâu và tốn bao nhiêu tiền (theo Aishwarya, video đăng ngày 22/10/2026).
12. Eval phải actionable: đi qua từng thành phần
Khi đã quyết định log những gì, câu hỏi tiếp theo là nên build eval nào trên đó. Theo Aishwarya (video đăng ngày 22/10/2026), điều quan trọng nhất về eval là chúng phải actionable. Chị nói thêm cho rõ: eval, hay evaluation, về cơ bản là các metric cho bạn biết hệ thống đang làm tốt tới đâu trên một chiều cụ thể, để bạn có thể cải thiện metric đó một cách có hành động. Nó gần giống testing trong phần mềm, nhưng cách làm trong hệ thống AI hơi khác. Chị cho rằng tự việc thiết kế eval đã là một kỹ năng mà người ta kỳ vọng ở một AI engineer giỏi, và nhắc lại: hãy build những eval cho bạn insight có thể hành động được để cải thiện hệ thống.
Quay lại agent chăm sóc khách hàng đã thiết kế, chị hỏi (video đăng ngày 22/10/2026): ở từng thành phần, cái gì có thể hỏng?
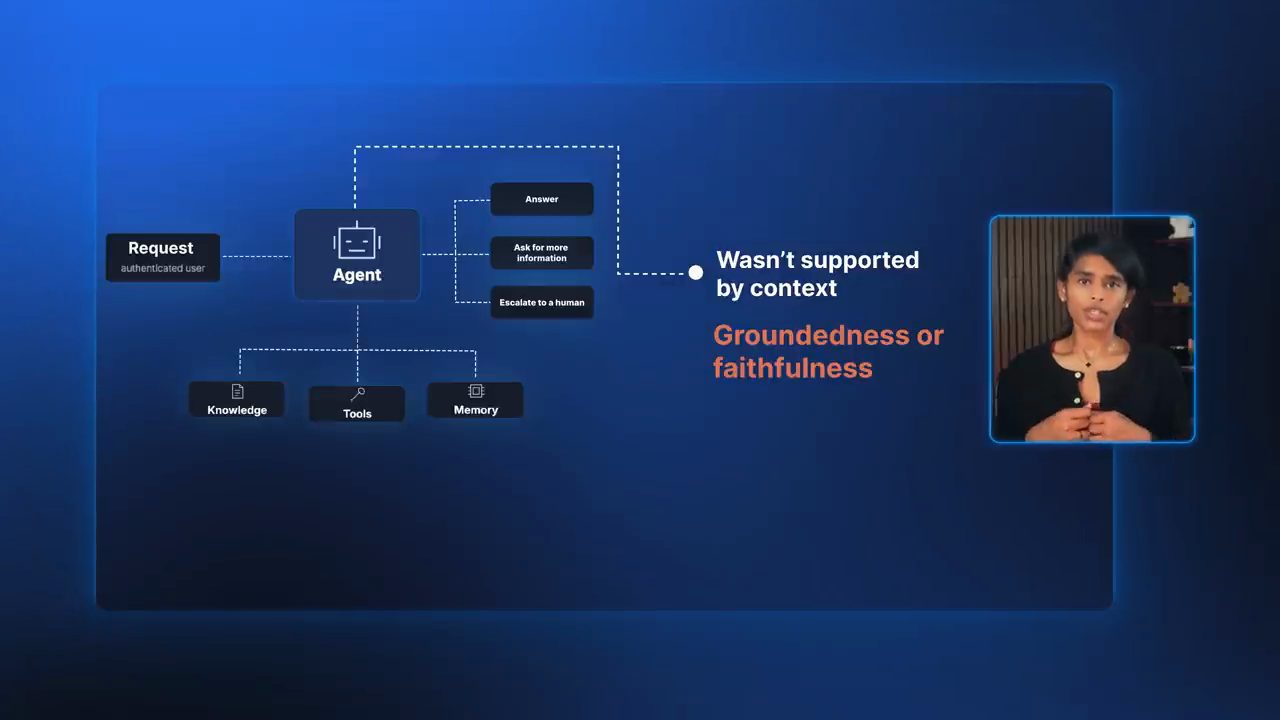
- Knowledge layer: có thể ta đã retrieve phải context không liên quan, hoặc bỏ sót thông tin cần để trả lời. Theo Aishwarya (video đăng ngày 22/10/2026), các metric như context precision và context recall giúp đo chuyện đó. Hoặc retrieval tốt nhưng câu trả lời cuối vẫn chưa ổn; khi đó các metric như groundedness hay faithfulness giúp bắt lỗi.
- Tool: có thể agent chọn sai tool, truyền sai argument, hoặc tool bị lỗi. Vì vậy cần các metric như tool selection accuracy, argument accuracy, tool success rate và cả retry rate (theo Aishwarya, video đăng ngày 22/10/2026).
- Toàn bộ luồng của agent: bạn muốn xem nó có escalate khi lẽ ra phải escalate không, và nhiệm vụ có thực sự hoàn thành không. Tức là các metric như resolution rate, latency, cost per resolution và cả customer satisfaction (theo Aishwarya, video đăng ngày 22/10/2026).
13. Code-based metric và LLM judge
Có nhiều cách implement các eval này. Theo Aishwarya (video đăng ngày 22/10/2026), nếu một thứ có câu trả lời khách quan, hãy dùng metric dựa trên code (code-based metrics). Ví dụ: ta có gọi đúng tool không? Argument có hợp lệ không? Schema trả về có hợp lý không? Những thứ như vậy có thể kiểm tra bằng chương trình.
Còn với thứ mang tính chủ quan hơn, như câu trả lời có bám vào context của nó không (grounded), có hữu ích không, có khớp giọng thương hiệu (brand voice) của công ty không, thì đó là lúc cần AI judge hay LLM judge, và bạn phải thiết kế các rubric chất lượng tốt cho chúng (theo Aishwarya, video đăng ngày 22/10/2026).
Như vậy, layer observability về cơ bản cho bạn vòng feedback: bạn log những gì đã xảy ra, đánh giá xem hệ thống đang hỏng ở đâu, và dùng các tín hiệu đó để cải thiện kiến trúc.
14. Layer 4: Production and ops, scale và latency
Layer thứ tư là production and ops: làm sao đưa mọi thứ đã thiết kế lên production ở quy mô lớn? Aishwarya đề nghị lại quay về các assumption ban đầu và hỏi: cái gì phải thay đổi khi hệ thống bắt đầu phục vụ người dùng thật một cách ổn định? Chị muốn người xem nghĩ theo năm chiều: scale, latency, reliability, freshness và security.
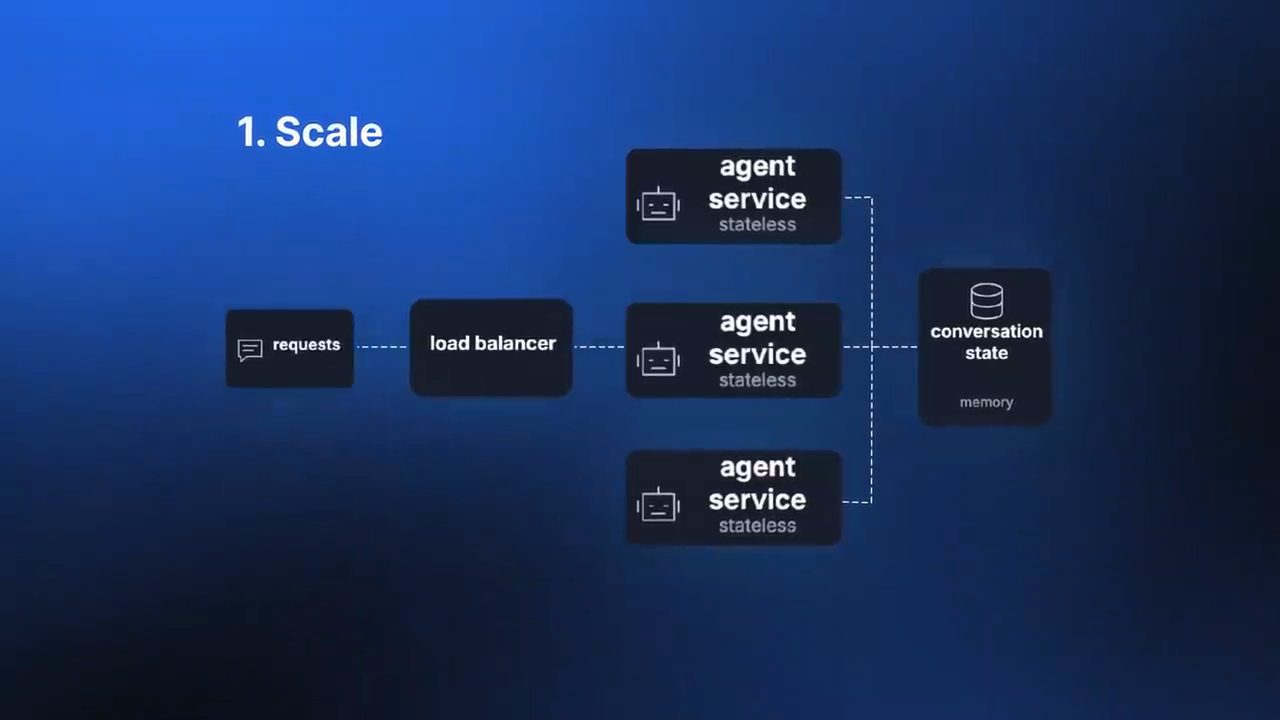
Scale. Giữ agent service ở dạng stateless, lưu trạng thái hội thoại và memory ở bên ngoài, và đặt nhiều replica sau một load balancer, vì hệ thống cần trả lời hàng nghìn khách hàng cùng lúc. Theo chị (video đăng ngày 22/10/2026), cách này cho ta horizontal scaling khi traffic tăng.
Latency. Aishwarya nhắc rằng ở phần observability, ta đã log thời gian của retrieval, của các lần gọi model, của tool, v.v. Giờ bạn có thể dùng các trace đó để tìm điểm nghẽn. Trên production, bạn nên đặt một latency budget tổng, chia nó cho từng thành phần, rồi tối ưu bước chậm nhất trước. Ví dụ chị đưa ra: nếu tra cứu đơn hàng mất ba đến năm giây, đó là chỗ ta bắt đầu. Ta cũng có thể thêm timeout để một dependency chậm không giữ chân cả request (theo Aishwarya, video đăng ngày 22/10/2026).
15. Reliability, freshness và security
Reliability. Điều thứ ba cần nghĩ tới trên production là độ tin cậy: retry, cơ chế fallback, hàng đợi (queue) và graceful degradation. Nếu một tool tạm thời lỗi, retry trong một giới hạn; nếu nó tiếp tục lỗi, phải escalate. Theo Aishwarya (video đăng ngày 22/10/2026), đây là những policy bạn cần thiết lập để hệ thống chạy ổn định trên production. Và nếu traffic tăng đột biến, bạn cần đưa request vào hàng đợi thay vì để cả hệ thống sụp.
Freshness. Điều thứ tư là độ mới của dữ liệu. Với use case này, các bài viết help center có thể thay đổi. Vì vậy bạn cần thiết kế một nhịp (cadence) cho việc ingestion, hoặc thiết kế pipeline ingestion sao cho nó phát hiện được cập nhật, parse lại nội dung, tạo lại embedding khi cần và cập nhật index. Nếu không, có thể agent retrieve đúng thông tin, chỉ có điều tài liệu nó retrieve đã lỗi thời (theo Aishwarya, video đăng ngày 22/10/2026).
Security và auditability. Cuối cùng, ở quy mô production, chị muốn có authentication và authorization quanh mọi request, mã hoá dữ liệu khi truyền đi và khi lưu trữ (in transit và at rest), giữ secret ở ngoài prompt và code, và có audit trail cho các hành động nhạy cảm, thứ mà ta đã thiết kế ở phần observability. Với hệ thống hỗ trợ này, ta phải trả lời được những câu như: khách hàng nào đã kích hoạt request, agent đã truy cập thông tin gì, nó đã gọi tool nào, và ai đã duyệt một hành động rủi ro. Theo Aishwarya (video đăng ngày 22/10/2026), tất cả những điều này cực kỳ quan trọng để audit một ứng dụng production chạy ở quy mô lớn.
16. Layer 5: Optimization cho latency và cost
Layer cuối là về cách bạn tối ưu kiến trúc khi gặp những tình huống đặc biệt, những trường hợp bất thường (outlier) và tương tự. Aishwarya nói chị build layer cuối này đặc biệt cho phỏng vấn, vì theo chị (video đăng ngày 22/10/2026) đó là chỗ người phỏng vấn thực sự tìm tín hiệu xem bạn hiểu các quyết định thiết kế và đánh đổi kiến trúc tới đâu. Theo chị, layer này là thứ phân biệt ứng viên xuất sắc với ứng viên giỏi.
Chị định nghĩa optimization về cơ bản là cách bạn lấy một hệ thống nền đã chạy được và cải thiện nó dựa trên các pattern và vấn đề bạn thực sự đang thấy. Theo chị (video đăng ngày 22/10/2026), bốn chiều tối ưu phổ biến nhất trong hệ thống production là latency, cost, quality và các failure pattern cụ thể. Sau đó là xác định điểm nghẽn.
Latency. Giả sử latency là vấn đề. Nếu retrieval quá chậm, có thể cần một index nhanh hơn, ít candidate được retrieve hơn, hoặc một re-ranker nhẹ hơn. Nếu lần gọi model chiếm phần lớn thời gian, cách tối ưu có thể chỉ là chuyển sang một model nhỏ hơn mà vẫn giữ nguyên ngưỡng đánh giá (evaluation bar). Nếu tool chậm, ta có thể bỏ các lần gọi tool không cần thiết, hoặc chạy song song các lần gọi tool độc lập với nhau, và những việc tương tự. Aishwarya nói rằng trong phỏng vấn, bạn thường được cho các tình huống có nêu sẵn một vài vấn đề như vậy, và bạn phải đưa ra cách tối ưu đúng (theo Aishwarya, video đăng ngày 22/10/2026).
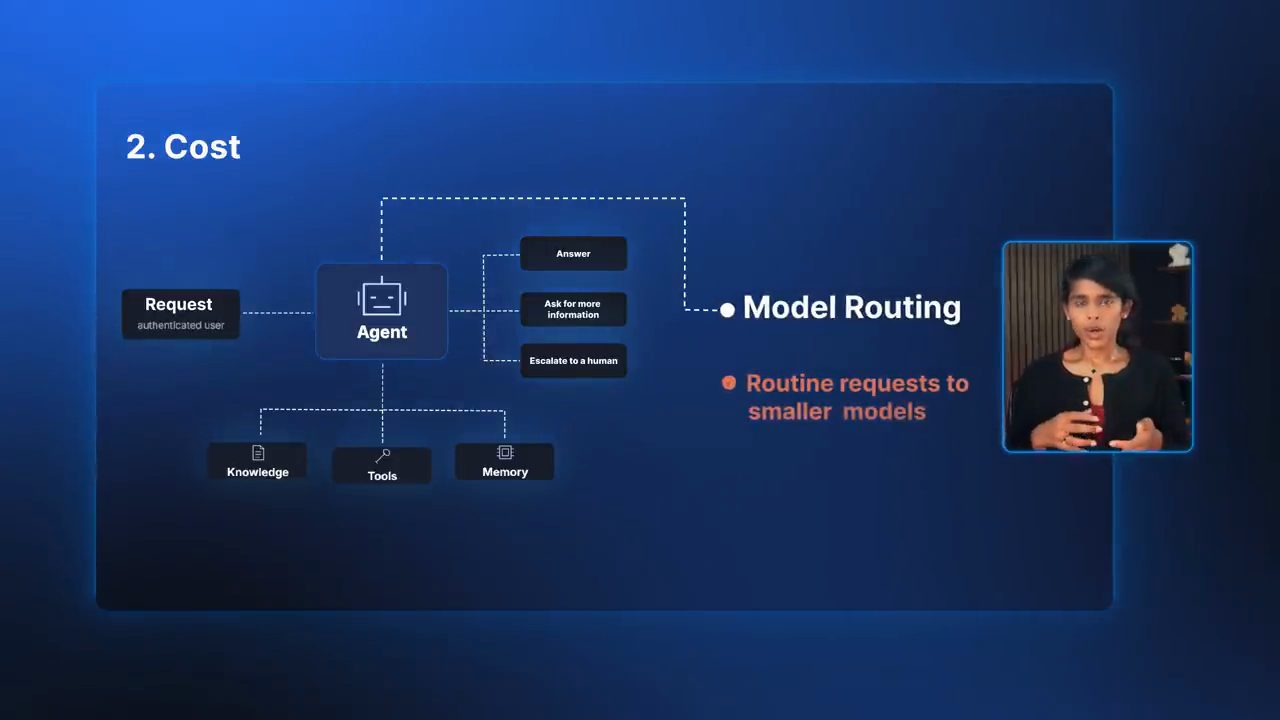
Cost. Chiều tối ưu tiếp theo là chi phí: hệ thống đang chạy tốt, nhưng bạn cần nghĩ cách giảm chi phí. Aishwarya nêu ba khái niệm. Thứ nhất là model routing: chuyển các request dễ hơn sang model nhỏ hơn, dành model lớn cho các request phức tạp hơn. Thứ hai, thiết kế ứng dụng để tận dụng prompt caching, khi các phần ổn định của prompt, như system instructions hay tool definitions, được dùng lại và theo lời chị trong video đăng ngày 22/10/2026 thì bị tính phí ít hơn nhiều. Thứ ba là semantic caching: nếu nhận được các câu hỏi lặp lại hoặc câu hỏi đã từng được hỏi, bạn có thể cache câu trả lời, không cần gọi LLM lần nữa và trả luôn kết quả cũ cho khách hàng.
17. Quality, failure pattern và khi nào multi-agent đáng với độ phức tạp
Quality. Giả sử bạn muốn tối ưu chất lượng, ví dụ eval cho thấy hệ thống chưa đủ tốt. Khi đó, theo Aishwarya (video đăng ngày 22/10/2026), bạn cần tìm ra chất lượng đang mất ở đâu. Có thể model chưa đủ mạnh cho một nhóm request nào đó, hoặc có thể chính luồng tool phải thay đổi. Chuyển sang một model mạnh hơn là một lựa chọn, nhưng chỉ khi model là điểm nghẽn.
Failure pattern cụ thể. Chiều tối ưu cuối cùng xoay quanh các failure pattern cụ thể. Giả sử hệ thống hỗ trợ mở rộng sang billing, đổi trả, bảo mật tài khoản, hỗ trợ kỹ thuật và đủ thứ khác. Lúc này một agent duy nhất có thể phải ôm quá nhiều context và quá nhiều tool. Trong trường hợp đó, theo chị (video đăng ngày 22/10/2026), có các agent chuyên trách (specialist agents) đứng sau một orchestrator mới thực sự xứng đáng với độ phức tạp nó thêm vào.
Theo Aishwarya (video đăng ngày 22/10/2026), đây chính là điều người phỏng vấn tìm kiếm: không phải một người ngay phát đầu đã nói sẽ dùng multi-agent system. Mọi độ phức tạp đều phải được "kiếm" bằng lý do (every complexity has to be earned), và bạn phải giải thích được vì sao mình đưa ra các quyết định đó. Một người thực sự hiểu đủ rõ hệ thống nền sẽ biết cách biện minh cho độ phức tạp ấy.
18. Đừng học thuộc kiến trúc, hãy luyện bộ câu hỏi
Aishwarya khép lại video bằng một lời dặn: chị không muốn người xem học thuộc kiến trúc agent chăm sóc khách hàng này, hay đúng những gì chị đã đi qua cho nó. Điều chị muốn là bạn lấy các câu hỏi của từng layer đã bàn, áp chúng vào một use case khác, và luyện lại toàn bộ quy trình, để dần giỏi lên về system design theo thời gian (theo Aishwarya, video đăng ngày 22/10/2026).
Chị mong video này hữu ích, hẹn gặp lại ở video sau và chúc mọi người mọi điều tốt đẹp nhất.
Nguồn và liên kết 4 nguồn
- Tên gốc: 2,000+ Hours of Learning Agentic AI System Design in 20 Minutes
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Mv7eiQFQQ1E youtube.com
- Kênh YouTube Aish Reganti (Aishwarya Naresh Reganti): youtube.com/channel/UCf9CdAgj8AHmpMwyoe67w7w youtube.com
Related talks
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
Sáu project AI sát thực tế nên có trên resume AI engineer
Aishwarya Naresh Reganti · Aish Reganti · 21 min
Sáu project AI engineer theo độ khó tăng dần, từ document pipeline, enterprise search, voice, model tự host tới agent, mỗi project có dataset, eval và cách kể.
Tín hiệu từ user chết ở ranh giới retrieval
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.