Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
✓ Đã duyệt độc lập · cập nhật 24/10/2026 · 28 min
1. Đừng build cùng project với mọi người: năm project, ghép building block theo cách khác
Maryam Miradi mở đầu video đăng ngày 27/09/2026 bằng một lời khuyên thẳng: nếu bạn thật sự muốn được tuyển vào mảng AI trong năm 2026, bạn nên build đúng năm project AI agent mà chị sắp trình bày, để có một hồ sơ AI engineering đầy đủ. Chị kể chị từng tuyển AI engineer ở vai trò technical lead và cũng tự build các hệ thống AI, nên chị có thể nói với bạn: đừng phí thời gian build những project giống hệt mọi người khác. Ý cốt lõi là phải nổi bật.
Trong video (đăng 27/09/2026), chị hứa sẽ cho thấy cách thay đổi hồ sơ của bạn một cách căn bản bằng cách ghép những building block AI quen thuộc theo một cách khác. Theo Maryam, làm vậy bạn sẽ đi từ chỗ "người này là ai?" tới chỗ nhận nhiều offer, kể cả khi nền kinh tế đang xấu. Với mỗi project trong năm project, chị nói bạn sẽ học được ba tới bốn kỹ năng độc đáo mà các hiring lead thật sự tìm kiếm, và theo chị đó là chìa khoá để tạo ra những cơ hội ở tầm thế giới cho bạn.
2. Project 1: vì sao portfolio kiểu text in, text out là chưa đủ
Bắt đầu với project một, Maryam nhận xét (video đăng 27/09/2026) rằng phần lớn portfolio là một kiểu text in, text out nào đó, còn ngoài đời thật dữ liệu không như vậy. Bạn có nhiều tín hiệu (signal), và tất cả tín hiệu đó được gộp lại để thành một quyết định. Đó có thể là dữ liệu địa chấn (seismic), dữ liệu không gian địa lý (geospatial), dữ liệu lịch sử, dữ liệu vệ tinh, thời tiết; cũng có thể là hình ảnh, video. Tất cả những thứ đó cho ra một cảnh báo rủi ro (risk alert), và theo chị đó là thứ các công ty cần.
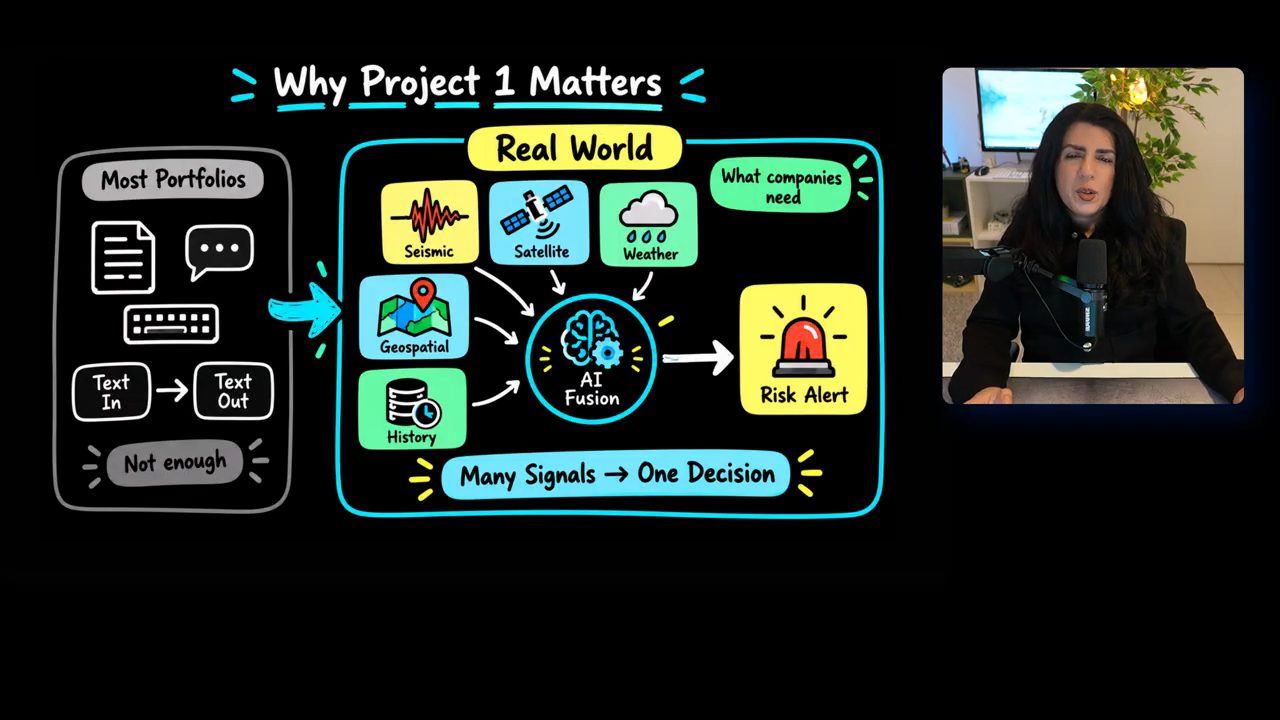
Từ đó ra project đầu tiên: một multi-signal disaster intelligence agent, về cơ bản là phát hiện thảm hoạ. Những gì chị vừa giải thích, từ dữ liệu vệ tinh, địa lý, lịch sử cho tới thời tiết, sẽ là đầu vào để build một hệ thống multi-agent (theo kiến trúc chị trình bày trong video đăng 27/09/2026).
3. Project 1: kiến trúc multi-signal disaster intelligence agent
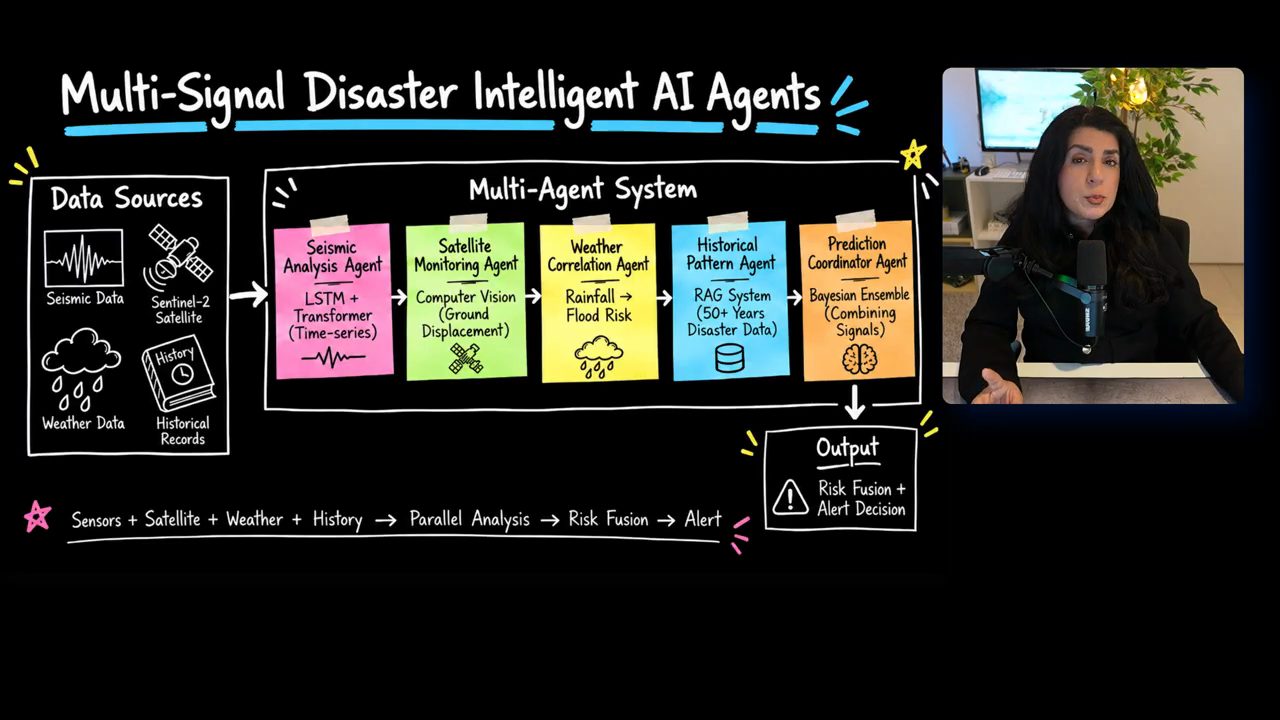
Agent đầu tiên, theo Maryam (video đăng 27/09/2026), cần một dạng time series, vì với dữ liệu này ta muốn biết thảm hoạ sẽ xảy ra ở đâu đó trong tương lai, và vì vậy cần lịch sử. Trên sơ đồ, đó là Seismic Analysis Agent dùng LSTM cộng Transformer cho chuỗi thời gian. Từ dữ liệu vệ tinh, cần một kiểu monitoring agent: agent này cần computer vision, và nó theo dõi sự dịch chuyển của mặt đất (ground displacement).
Chị nói chị bắt đầu ngay bằng vài thứ phức tạp, những thứ sẽ thử thách bạn. Điều chị muốn bạn hiểu (video đăng 27/09/2026): build 100 thứ nhỏ không quan trọng sẽ không bao giờ giúp bạn nổi bật, nhưng một thứ phức tạp, quan trọng, lấy từ đời thật sẽ làm bạn khác hẳn mọi ứng viên khác, và project này là một thứ như vậy.
Tiếp theo là weather correlation agent. Ở đây, theo Maryam (video đăng 27/09/2026), bạn cần hiểu và suy nghĩ lượng mưa (rainfall) là gì, lượng mưa đó sẽ tạo ra rủi ro lũ lụt kiểu gì. Việc này buộc bạn không chỉ nghĩ theo agent mà còn theo data science, thứ đã có mặt trong thế giới AI khá lâu, ít nhất là một cách nghiêm túc trong khoảng 30 năm qua theo lời chị. Vì vậy mọi thứ của machine learning, về cơ bản, cũng sẽ được kết hợp với AI agent.
Rồi tới historical pattern agent, nơi có thể dùng RAG. Chị nhấn mạnh (video đăng 27/09/2026): bạn sẽ không bắt đầu bằng ý "để tôi build một cái RAG", rồi mới hỏi vì sao nó quan trọng; bạn dùng RAG vì bạn cần nó để chứa 50 năm dữ liệu thảm hoạ. Trên sơ đồ, agent này ghi "RAG System (50+ Years Disaster Data)".
Đây cũng là chỗ bạn phải nghĩ về mọi quyết định mình đưa ra. Nếu bạn không có dữ liệu thật, mà theo Maryam (video đăng 27/09/2026) nhiều khả năng là bạn không có, thì bạn phải đặt giả định: hoặc tạo dữ liệu tổng hợp (synthetic data), hoặc lấy từ Kaggle hay một nguồn nào khác. Nhưng cũng phải hiểu rằng 1.000 bản ghi rất khác 100.000 bản ghi, và 100.000 lại rất khác vài triệu bản ghi. Khi làm với dữ liệu thật, bạn sẽ bắt đầu nhận ra điều đó.
Sau đó bạn cần một kiểu coordinator, hay một agent kiểu quản lý, để gom mọi thứ lại. Nó có thể là một dạng Bayesian (trên sơ đồ là Prediction Coordinator Agent với "Bayesian Ensemble (Combining Signals)"). Theo Maryam (video đăng 27/09/2026), về cơ bản bạn cần hiểu cả data science bên cạnh AI. Cuối cùng, mọi thứ kết hợp lại sẽ đi từ dữ liệu địa chấn, dữ liệu vệ tinh, dữ liệu thời tiết và dữ liệu lịch sử lên tới bước gộp rủi ro (risk fusion) và quyết định cảnh báo: đây là lũ, động đất hay sóng thần, cảnh báo nào trong số đó cũng có thể được đưa ra.
Maryam nói chị đã gom mọi thứ thấy trong video (đăng 27/09/2026), cùng toàn bộ các layer, vào một guide AI engineer miễn phí để người xem tải về.
4. Project 1: engineering layer và các domain học được
Project này nghe rất ấn tượng, nhưng nó dạy bạn những AI engineering layer nào? Maryam dùng một bảng 12 layer (video đăng 27/09/2026) và đánh dấu ba layer cho project một. Đầu tiên là business understanding, vì hiểu tất cả các lớp đó và hiểu bài toán thật khá phức tạp; ô này ghi "Learn how to define the real problem, goals and users". Thứ hai là data understanding, với rất nhiều loại dữ liệu khác nhau như dữ liệu địa lý, dữ liệu lịch sử, ảnh vệ tinh; ô này ghi học cách làm việc với các loại dữ liệu khác nhau và mỗi loại đóng góp gì.
Và dĩ nhiên là agent engineering: cách thiết kế các agent kết hợp những model deterministic, time series hay thuật toán Bayesian, tất cả lại thành một quyết định. Theo Maryam (video đăng 27/09/2026), điều đó lập tức làm bạn nổi bật và biến bạn thành một AI engineer hoàn toàn khác. Một dòng nhỏ trên bảng ghi: không học mọi thứ cùng lúc, bạn tập trung vào những layer quan trọng trong project này.
Bên trên những layer đó, theo Maryam (video đăng 27/09/2026), bạn còn học được các domain khác. Bảng "Domains You Learn" của project một ghi sáu năng lực: geospatial reasoning, remote sensing, tín hiệu time series, risk prediction, gộp nhiều tín hiệu (multi-signal fusion) và hỗ trợ quyết định khẩn cấp (emergency decision support). Chị giải thích phần cuối: sóng thần đang xảy ra và người ta có thể chết, lũ lụt và động đất cũng vậy.
Vì thế, theo chị (video đăng 27/09/2026), sau project này bạn có thể xử lý quản lý thảm hoạ (disaster management), smart city, mọi loại climate tech; nghĩ tới hạ tầng như đường, cầu; năng lượng; và dĩ nhiên an toàn công cộng (public safety), vì bạn phải cứu mạng người. Dưới bảng có dòng: "Different industries. Same transferable skills. Bigger impact."
5. Project 2: AI phát hiện bệnh từ ảnh chụp mắt bằng multimodal medical RAG
Sang project hai, điều Maryam muốn bạn hiểu (video đăng 27/09/2026) là: nếu AI không nhìn được thì nó không chẩn đoán được, và điều này đúng với rất nhiều medical agent. Hãy hình dung bạn có ảnh chụp mắt (eye scan): bạn sẽ đưa chúng vào RAG thế nào, khi đây là dữ liệu chuyên biệt chứ không chỉ là văn bản? Chị hứa sẽ giải thích ngay sau đó thách thức của ảnh chụp mắt trong y khoa là gì. Rồi tới phần lập luận (reasoning) trên dữ liệu đó, làm thế nào. Và bạn còn phải giải thích, vì theo chị bác sĩ sẽ không tin bất kỳ AI nào trừ khi bạn giải thích thật rõ lập luận của các AI agent đằng sau nó. Slide của phần này ghi "If AI can't see, it can't diagnose." với chuỗi Scans → RAG → Reasoning → Explain.
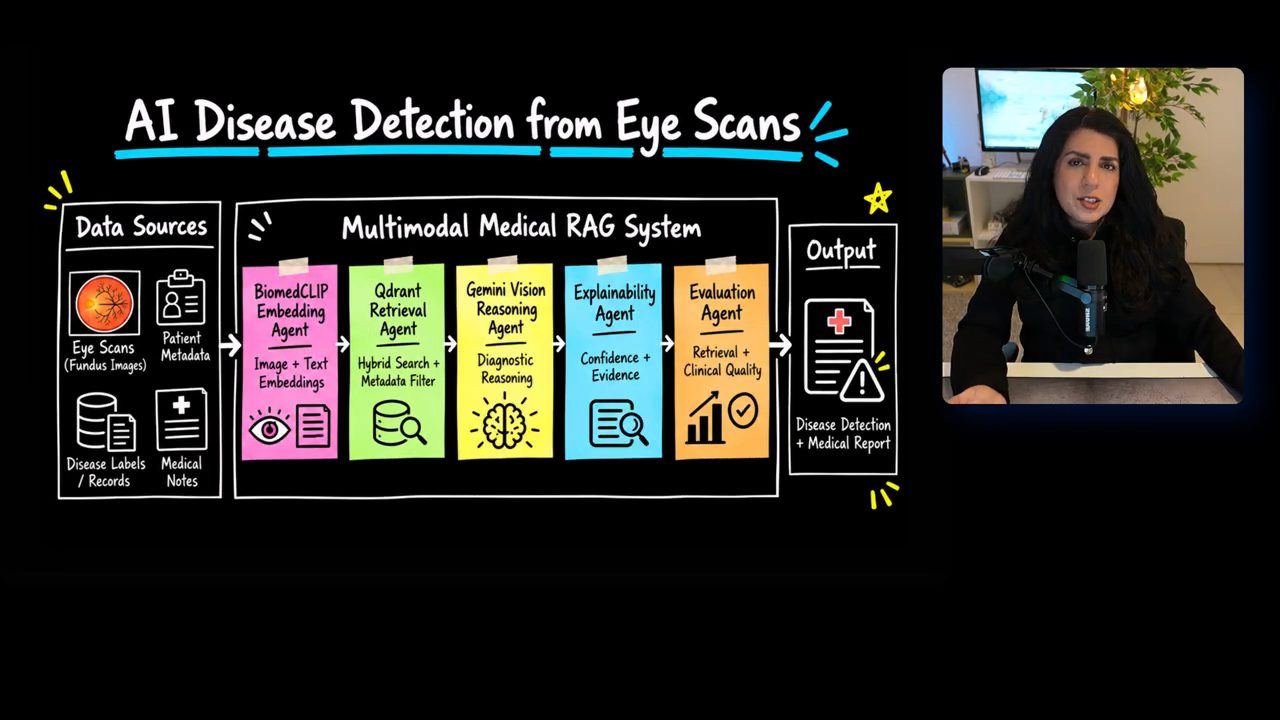
Vào kiến trúc: ta sẽ build một hệ thống AI phát hiện bệnh từ ảnh chụp mắt, có thể phát hiện tới 80 bệnh khác nhau (con số Maryam nêu trong video đăng 27/09/2026). Chị nói project này khá thú vị và chị đã tự build nó. Dữ liệu có thể gồm metadata của bệnh nhân, nhãn bệnh (disease label) cho cả 80 bệnh đó, và ghi chú y khoa về dị ứng và những thứ khác.
Việc đầu tiên, theo Maryam (video đăng 27/09/2026), là build một medical RAG dạng đa phương thức (multimodal), vì dữ liệu ở đây không phải văn bản. Thách thức đầu tiên là phần embedding: việc hiểu các thuật ngữ y khoa không làm được bằng một LLM huấn luyện thông thường; bạn cần một model chuyên biệt, đã được fine-tune cho lĩnh vực y khoa. BiomedCLIP là một model như vậy, và chị nói bạn sẽ hiểu đó thật ra là một kiểu embedding riêng, kết hợp cả hình ảnh lẫn văn bản: bạn có một ảnh, tức một ảnh chụp mắt, và có một đoạn giải thích gắn kèm nó. Model card của BiomedCLIP trên Hugging Face (đọc ngày 24/10/2026) mô tả nó là một biomedical vision-language foundation model, pretrain trên 15 triệu cặp hình và chú thích lấy từ các bài báo y sinh.
Sau đó bạn cần một vector database. Theo Maryam (video đăng 27/09/2026), phần lớn người ta dùng ChromaDB, nhưng Qdrant cũng là một lựa chọn tốt, và Qdrant có thể kết hợp với một retrieval agent. Bạn sẽ có một kiểu hybrid search và một metadata filter, vì bạn đã có cả bằng chứng thật từ metadata của bệnh nhân. Chị lấy ví dụ: nếu hồ sơ ghi một người bị tiểu đường thì về cơ bản không cần chẩn đoán điều đó nữa.
Tiếp đến bạn có thể dùng bất kỳ model vision nào, chẳng hạn Gemini (trên sơ đồ là Gemini Vision Reasoning Agent). Maryam cũng nói rằng model mới nhất của GPT đang cho kết quả cao nhất, tốt nhất với hình ảnh (nhận xét của chị trong video đăng 27/09/2026). Rồi bạn làm bước lập luận chẩn đoán (diagnostic reasoning) từ bức ảnh.
Ở đây có explainability agent, vì theo Maryam (video đăng 27/09/2026) bạn cần nói được "tôi tự tin vào kết luận đó ở mức bao nhiêu phần trăm". Con số đó bạn có thể rút ra, chẳng hạn từ embedding, từ phần vision, gộp tất cả lại, để biết output nên được bác sĩ tin tới mức nào. Output là kết quả phát hiện bệnh và một báo cáo y khoa; dĩ nhiên những thứ như độ tự tin (confidence) và bằng chứng (evidence) cũng nằm trong báo cáo đó.
6. Project 2: data, semantic, evaluation engineering và các domain y tế
Nhìn theo AI engineering layer, Maryam nói (video đăng 27/09/2026) project hai chắc chắn có data understanding, vì bạn học được rất nhiều về hình ảnh: cần ảnh chất lượng thế nào, và ảnh càng lớn thì chi phí càng cao. Bảng ghi: học cách làm việc với ảnh chụp mắt, metadata lâm sàng và dữ liệu y khoa đa phương thức.
Bạn chắc chắn cần semantic engineering. Theo Maryam (video đăng 27/09/2026), đây là chỗ embedding, retrieval và similarity search được nối với loại hình ảnh bạn có và với bằng chứng y khoa; ô trên bảng ghi học cách embedding, retrieval và similarity search nối hình ảnh với đúng bằng chứng y khoa.
Rồi tới evaluation engineering. Gợi ý của chị ở đây (video đăng 27/09/2026): khi đã có tất cả ảnh chụp mắt, hình dung bạn có 10.000 hay 20.000 ảnh, hãy chạy chẩn đoán cho toàn bộ. Sau đó bạn đánh giá nhãn bệnh có sẵn so với thứ model AI đã chẩn đoán, cùng với độ tự tin mà nó đưa ra. Lúc đó bạn biết chắc model của mình đang cho hiệu năng thế nào. Ô trên bảng ghi: học cách đánh giá độ tự tin, chất lượng retrieval, độ an toàn và lập luận chẩn đoán.
Về domain, theo bảng của Maryam (video đăng 27/09/2026), bạn học medical imaging, multimodal RAG, phát hiện bệnh (disease detection), explainable AI, lập luận lâm sàng (clinical reasoning), và dĩ nhiên đánh giá và an toàn cho bệnh nhân. Nhờ vậy bạn có thể xử lý các domain mới như nhãn khoa (ophthalmology), X quang (radiology), giải phẫu bệnh (pathology), chẩn đoán y tế, thử nghiệm lâm sàng và rủi ro y khoa. Vì đây đều là domain y khoa, chị nói bạn có thể bước vào cả một dải rộng mọi thứ liên quan tới y tế.
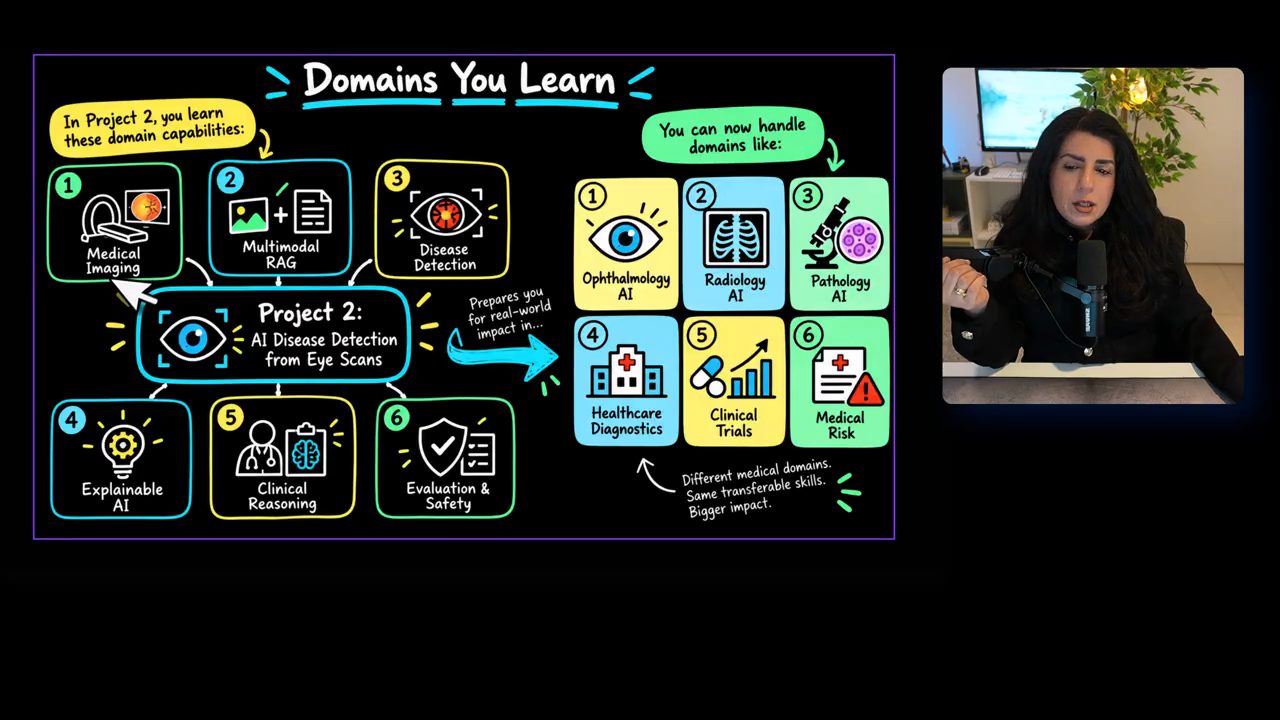
Với hai project này, theo Maryam (video đăng 27/09/2026), bạn đã ở một vị trí rất tốt. Nhưng nếu bạn thích graph engineering, chị mời sang project ba.
7. Project 3: đường là network, kiến trúc graph-powered agent cho hạ tầng đường bộ
Trong project ba, bạn làm với mạng lưới đường (road network). Slide mở phần này ghi "Roads are networks, not rows." với bốn bước Topology, Paths, Priority, Impact. Maryam giải thích (video đăng 27/09/2026): ta biết các giao lộ của đường, có các lối đi giữa chúng, có mức ưu tiên bảo trì, biết đường nào quan trọng hơn, và tác động nếu bạn đóng một con đường rất quan trọng.
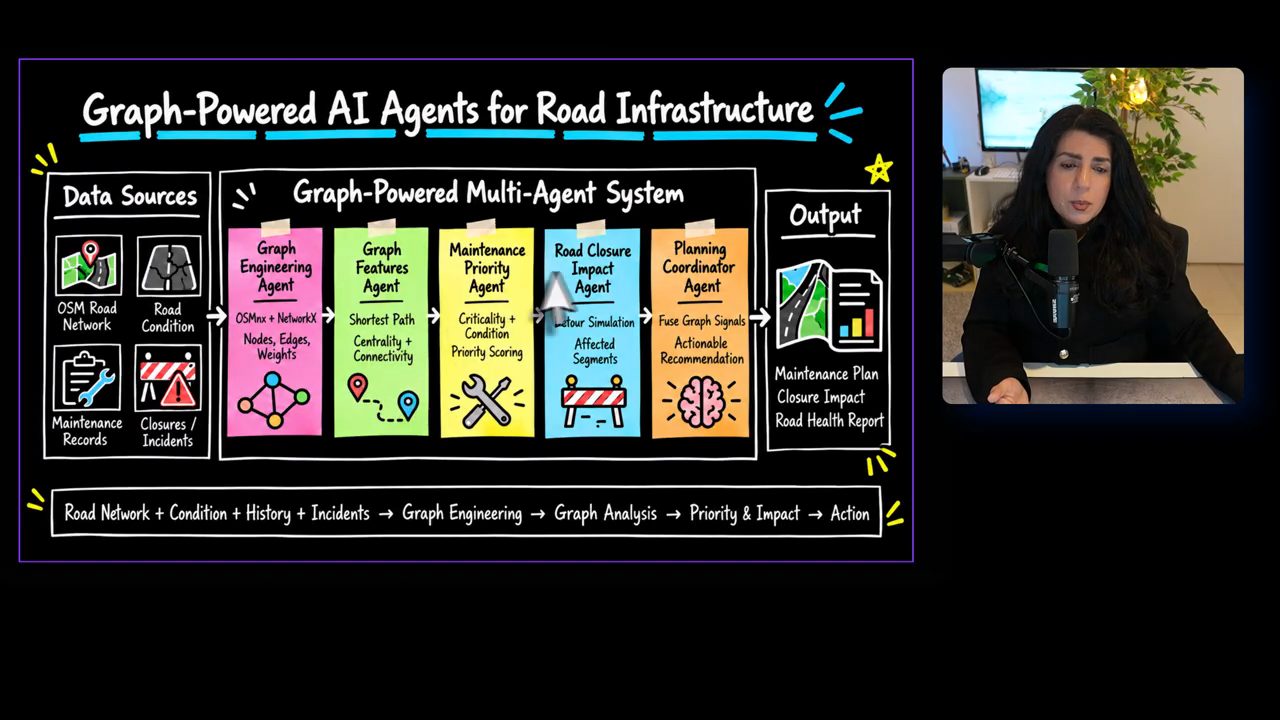
Vào kiến trúc, nguồn dữ liệu ở đây, theo chị (video đăng 27/09/2026), lại một lần nữa hoàn toàn thử thách bạn. Bạn sẽ có mạng đường OSM, tức OpenStreetMap. Bạn có tình trạng đường (road condition), phần lớn là dữ liệu có cấu trúc; có hồ sơ bảo trì; và các sự cố đóng đường (closure incident), thứ cho bạn cả dữ liệu trực tiếp (live data) vì nó luôn thay đổi. Gộp lại, bạn có mạng đường, tình trạng, lịch sử và sự cố.
Bạn bắt đầu với một graph engineering agent. Maryam giới thiệu (video đăng 27/09/2026) hai thư viện Python: NetworkX và OSMnx. OSMnx sẽ tải dữ liệu OpenStreetMap về; NetworkX sẽ build cho bạn một graph gồm node, edge và trọng số (weight) giữa chúng. Chị lấy ví dụ quãng giữa Amsterdam và The Hague ở Hà Lan, nơi có nhiều con đường khác nhau. Hình dung chỉ có một con đường: bạn có hai node và một edge. Trọng số có thể là số kilômét, hoặc mức độ quan trọng của con đường đó. Trang GitHub của OSMnx (đọc ngày 24/10/2026) mô tả nó là thư viện để tải, mô hình hoá, phân tích và trực quan hoá mạng đường phố cùng các đối tượng địa lý khác từ OpenStreetMap.
Graph feature agent, theo Maryam (video đăng 27/09/2026), phần lớn thời gian cho ra đường đi ngắn nhất (shortest path); chị nói ta biết mọi hệ thống dẫn đường đều làm việc với những thứ kiểu này. Rồi tới bảo trì, và vì sao nó quan trọng với ta: nếu ta đóng một đoạn nào đó để bảo trì, đường đi ngắn nhất sau đó là gì?
Sau đó là maintenance priority agent. Agent này, theo chị (video đăng 27/09/2026), phải cho thấy cái gì là quan trọng sống còn (critical), tình trạng ra sao, ưu tiên thế nào; tất cả những điều đó được xử lý trong maintenance priority agent. Sau bảo trì là tác động của việc đóng đường: thông tin này được chuyển cho road closure impact agent, agent sẽ đưa ra đường vòng (detour) và chỉ ra những đoạn đường bị ảnh hưởng.
Nếu muốn, bạn làm thêm một planning coordinator agent gộp tất cả các tín hiệu từ graph và đưa ra khuyến nghị có thể hành động được. Theo kiến trúc Maryam trình bày (video đăng 27/09/2026), output có thể là một kế hoạch bảo trì, đánh giá tác động đóng đường và một báo cáo sức khoẻ của mạng đường.
8. Project 3: layer, domain và chuyện chuyển ngành của Maryam
Project ba dạy bạn gì trong AI engineering stack? Maryam trả lời (video đăng 27/09/2026): khá nhiều. Dĩ nhiên là data understanding, vì tình trạng đường, bảo trì và tất cả dữ liệu graph, dữ liệu địa lý sẽ dạy bạn rất nhiều. Chị nói riêng khoa học địa lý (geoscience) đã tạo ra rất nhiều cơ hội việc làm, vì các công ty có loại dữ liệu đó không tìm đủ người, nên chị bảo hãy thật sự chú ý tới project ba.
Bạn học knowledge engineering: topology của đường, quan hệ giữa các tài sản (asset), mọi thứ nằm trên mặt đất như điện, gas, đường sá, hay quản lý tài sản (asset management), thứ mà theo Maryam (video đăng 27/09/2026) khá khó và phức tạp; và dĩ nhiên là tri thức dạng graph. Tất cả những thứ đó nằm trong knowledge engineering.
Bạn học context engineering, vì context ở đây gồm các đoạn đường (segment), có tính kết nối, độ quan trọng (criticality) và tác động lên mạng lưới. Theo Maryam (video đăng 27/09/2026), agent đưa ra quyết định tốt hơn dựa trên rất nhiều thứ kết hợp lại, nên bạn cần làm context engineering thật tốt. Ô trên bảng ghi: học cách cung cấp đúng context như trạng thái segment, connectivity, criticality và network impact để agent ra quyết định tốt hơn.
Rồi tới evaluation engineering. Như chị nói (video đăng 27/09/2026), ở đây ta muốn biết chẳng hạn chất lượng bảo trì, mức ưu tiên, tác động khi đóng đường, và các khuyến nghị của ta có tốt không. Bảng ghi: đánh giá chất lượng tuyến đường, ưu tiên bảo trì, tác động đóng đường và liệu khuyến nghị có thật sự hữu ích.
Bạn sẽ học domain nào từ project này? Theo bảng Maryam đưa ra (video đăng 27/09/2026): mô hình hoá mạng đường, topology và connectivity, routing, đường tắt và đường đi, độ quan trọng của tài sản, ưu tiên bảo trì, và dĩ nhiên mọi thứ về tác động đóng đường và đường vòng. Những thứ đó giúp bạn làm được hạ tầng giao thông, mọi thứ về tiện ích (utility), năng lượng và mạng lưới năng lượng.
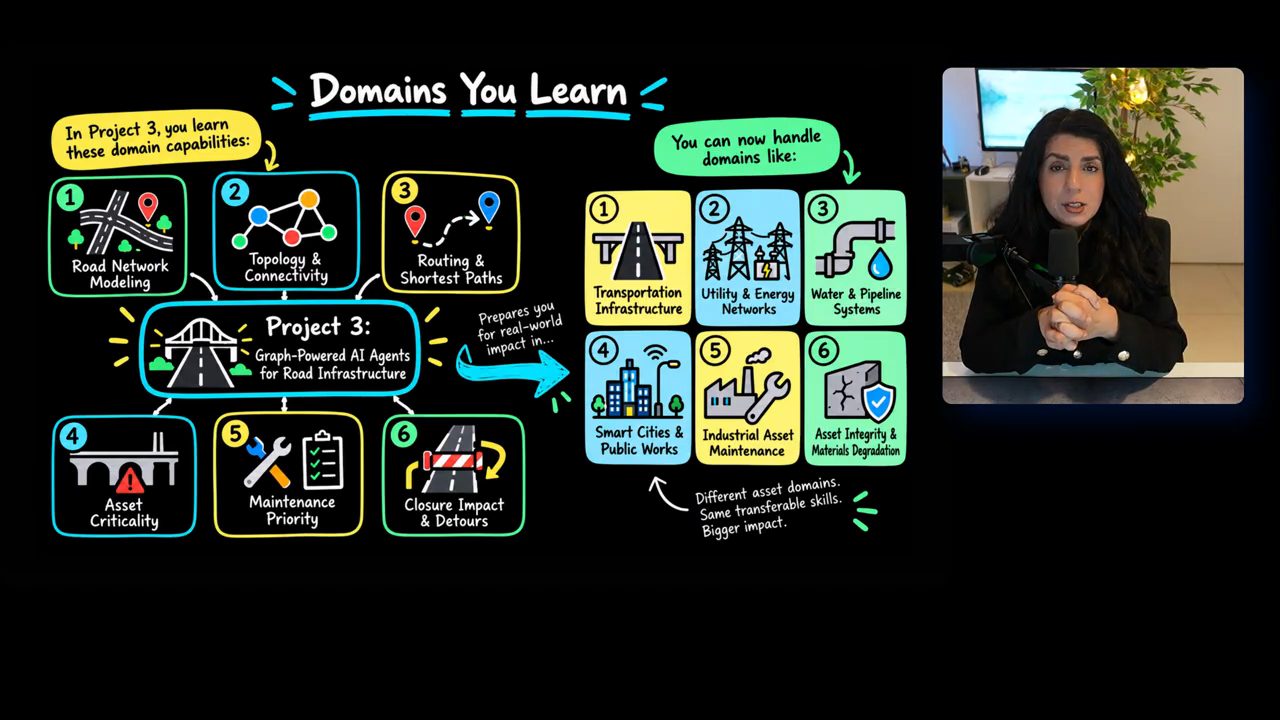
Maryam kể một chuyện mà chị gọi là buồn cười (video đăng 27/09/2026): chị đã khoảng năm năm áp dụng AI vào kỹ thuật đường bộ, rồi làm năm năm tiếp với mạng điện và mạng gas. Chị nói việc chuyển ngành đó rất dễ với chị, vì những điểm giống nhau và phần chồng lấn giữa các lĩnh vực. Vì vậy chị thật sự khuyên bạn làm vài ngành khác nhau, dù là qua project hay khi đi làm, và đừng ở mãi trong một ngành.
Lý do, theo Maryam (video đăng 27/09/2026): khi bạn bước vào vài ngành khác nhau, đột nhiên bạn có thể xử lý thêm 20 ngành nữa. Chị nghĩ tới cả hệ thống nước và pipeline, smart city và giao thông công cộng, những thứ chị cũng đã làm. Rồi tài sản công nghiệp: nếu tài sản của bạn bắt đầu xuống cấp thì mọi thứ về khoa học vật liệu cũng thuộc mảng này. Chỉ với ba project, chị nói bạn đã có thể trở thành chuyên gia ở rất nhiều thứ.
9. Project 4: legal AI cần guardrails, kiến trúc với Google ADK và MCP
Project bốn, theo Maryam (video đăng 27/09/2026), sẽ đưa bạn vào một thế giới hoàn toàn khác: thế giới pháp lý. Mọi thứ về luật và pháp lý vừa đơn giản vừa phức tạp cùng lúc. Chị nói đó cũng là kiểu kỹ thuật phức tạp, chỉ là một loạt quy tắc mà người ta tuân theo, nhưng họ có rất nhiều tài liệu. Vì vậy parsing trở thành một trong những người bạn tốt nhất của bạn.
Rồi bạn còn có kiểm toán (audit), vì lĩnh vực này bị quản lý rất chặt (regulated). Maryam bảo hãy nghĩ thêm tới mọi thứ trong phát hiện tội phạm tài chính, cũng bị quản lý rất chặt. Bạn cần audit, tái sử dụng, và phải chuyển cấp (escalate) mọi việc. Nên theo chị (video đăng 27/09/2026), project này dạy bạn những thứ khá khác. Slide của phần này ghi "Real legal AI needs guardrails." với chuỗi Parse → Audit (Router, Auditor) → Reuse → Escalate.
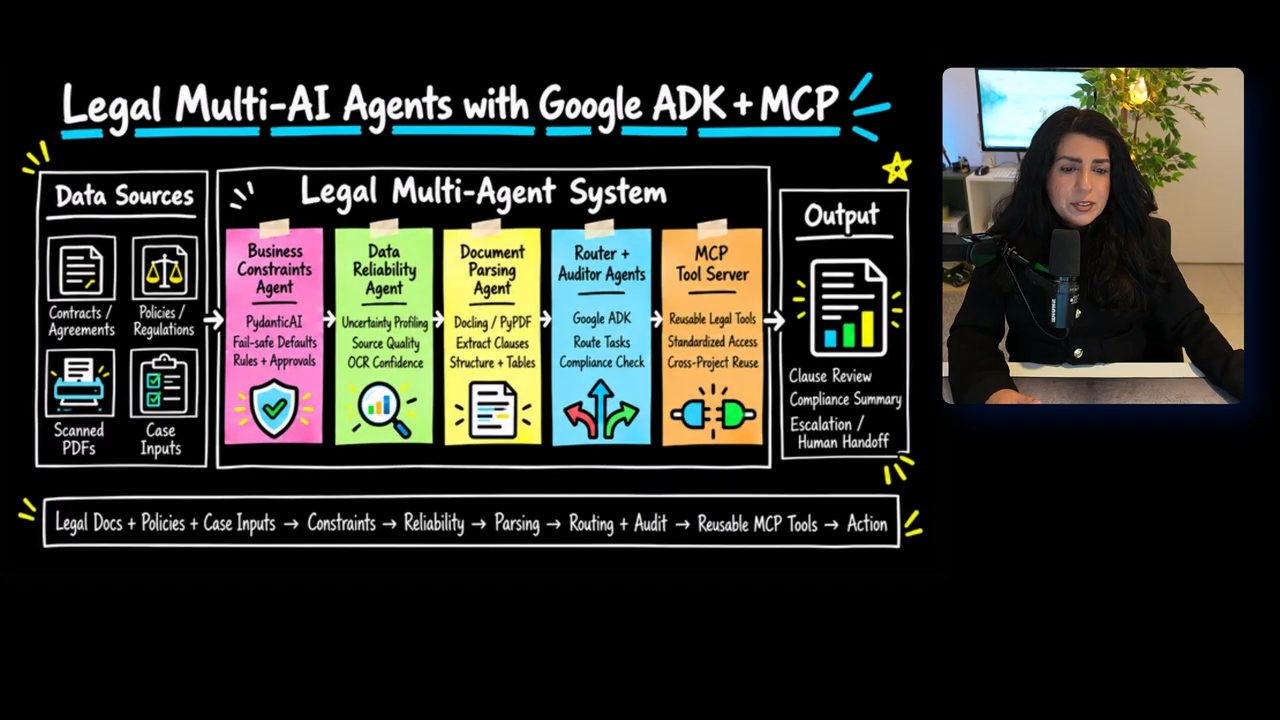
Vào kiến trúc. Bạn có hợp đồng, thoả thuận, và các chính sách (policy). Maryam lấy ví dụ (video đăng 27/09/2026): nếu bạn có bảo hiểm, chẳng hạn bảo hiểm xe hơi, thì ở đó có một policy, đúng không? Mọi thứ trong mảng đó, từ hôn nhân tới nhà cửa, đều có policy. Rồi bạn có PDF scan, đặc biệt là tài liệu cũ chất lượng rất kém, và bạn còn có các hồ sơ vụ việc (case).
Project này cũng dạy bạn vài framework khác nhau: LangChain, PydanticAI, Google ADK, CrewAI. Maryam kể (video đăng 27/09/2026) chị luôn nói với học viên rằng rốt cuộc tất cả đều là thư viện Python; nếu bạn biết Python, các framework đều có những thứ như một agent, tools, các function bạn có thể dùng. Sau đó bạn có thể build những thứ tái sử dụng được bằng MCP, vân vân.
Theo Maryam (video đăng 27/09/2026), điều làm PydanticAI khác các framework khác là khả năng làm việc với dữ liệu có cấu trúc: nhận input theo cách khá có cấu trúc và cũng xuất ra có cấu trúc, chẳng hạn một file JSON. Chị nói điều đó rất quan trọng với legal agent. Trên sơ đồ, Business Constraints Agent dùng PydanticAI với "Fail-safe Defaults" và "Rules + Approvals". Agent chính, theo kiến trúc của chị, sẽ build bằng Google ADK và thêm một MCP.
Sau đó là data reliability agent, vì ta đã parse thông tin và chuyển nó cho agent, nhưng nó đúng hay không? Theo Maryam (video đăng 27/09/2026), bạn cần một kiểu uncertainty profiling: xem OCR (nhận dạng ký tự quang học) của bạn tốt tới đâu nếu bạn dùng OCR, xem chất lượng nguồn, tất cả đều quan trọng. Rồi bạn có thể parse PDF bằng PyPDF hay Docling.
Phần phức tạp, theo chị (video đăng 27/09/2026), là hiểu các bảng biểu phức tạp; đó cũng là một điểm nghẽn (bottleneck) và là thứ bạn sẽ phải nghĩ kỹ. Bạn phải so sánh các công cụ: chọn chừng năm cái, thử trích các điều khoản (clause), trích bảng. Sau đó ta có một kiểu router hay auditor; ở đây ta dùng Google ADK, thứ chị gọi là khá có cấu trúc.
Tiếp theo, trong project này bạn học về MCP, thứ Maryam gọi là nổi tiếng (video đăng 27/09/2026), và cách dùng MCP để build. Giả sử sau rất nhiều thử nghiệm bạn đã build thành công một document parser, và bạn muốn dùng nó cho các project tương tự khác: đó chính là phần MCP. Cuối cùng, ta có phần tóm tắt tuân thủ (compliance summary), chuyển cấp, chuyển cho người (human handoff), những thứ kiểu đó.
10. Project 4: model, agent, evaluation, infrastructure engineering và các domain
Theo Maryam (video đăng 27/09/2026), bạn học được nhiều ở phần AI engineering. Có model engineering, vì bạn phải thật sự tìm được model làm OCR đúng và hiểu pháp lý đúng; nhiều khả năng bạn cần fine-tune một chút, giống như với medical agent. Ô trên bảng ghi: so sánh và chọn model, tool cho document parsing, reasoning, chất lượng OCR và hiểu pháp lý.
Rồi bạn làm agent engineering (bảng ghi: build Router và Auditor agent, định nghĩa trách nhiệm, handoff, routing, regeneration và escalation), và dĩ nhiên evaluation engineering, vì theo Maryam (video đăng 27/09/2026) nếu bạn không đánh giá được legal agent của mình thì chúng không đáng giá bao nhiêu. Ô evaluation ghi: đánh giá chất lượng tài liệu, độ tự tin của OCR, độ bất định, kiểm tra tuân thủ và độ tin cậy của output.
Còn MCP thuộc phần infrastructure engineering, vì theo chị (video đăng 27/09/2026) đó là bước sau khi bạn đã build xong project: bạn đóng gói nó theo cách để hạ tầng của bạn ở đâu đó giữ nó, và mọi người khác, chính bạn hay người trong team, đều truy cập được. Bảng ghi: build MCP server và tool tái sử dụng được để các năng lực pháp lý dùng lại được qua nhiều hệ thống và project.
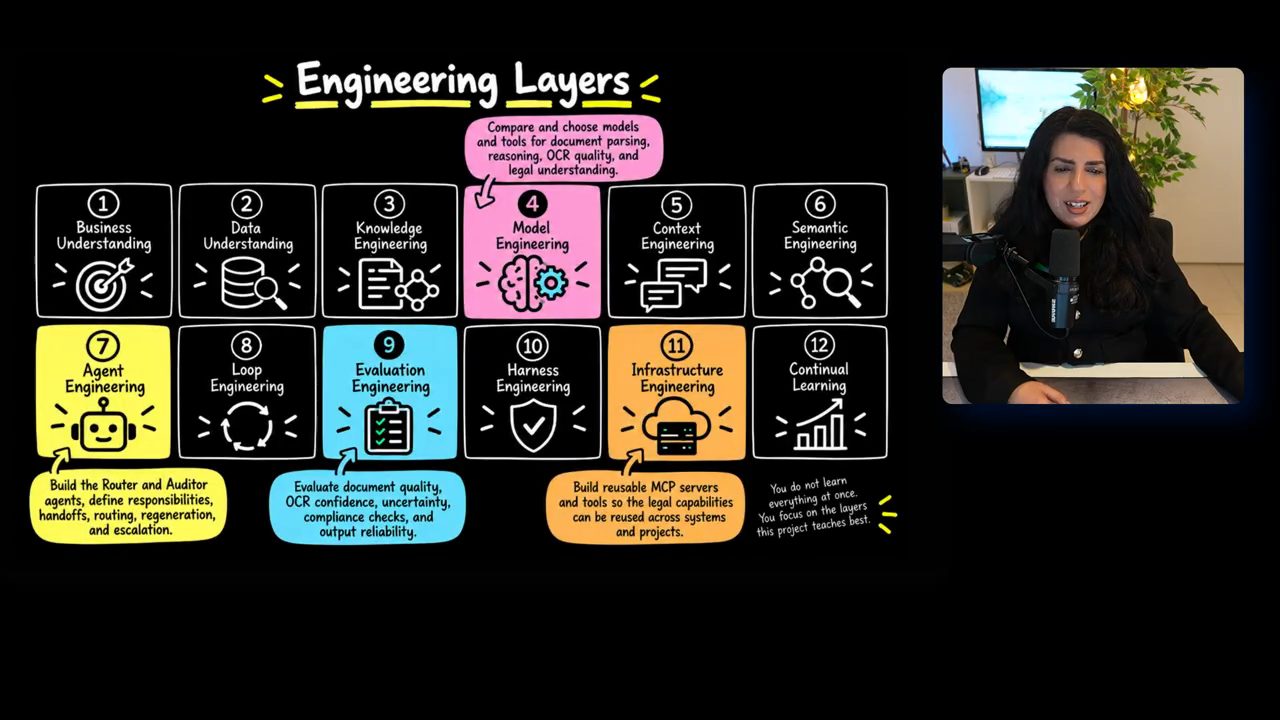
Sau project này bạn làm được domain nào? Vì đã học hiểu tài liệu pháp lý, độ tin cậy của OCR và parsing, workflow tuân thủ, uncertainty profiling, routing và audit nhiều agent, và MCP, theo Maryam (video đăng 27/09/2026) bạn có thể xử lý vận hành pháp lý (legal operations), compliance và regtech, mọi thứ về bồi thường bảo hiểm, quản lý hợp đồng, tài chính, chính phủ; chị bảo hãy nghĩ tới quản lý thuế và những thứ tương tự. Trên bảng domain còn ghi "Financial Risk & AML" và "Government & Public Sector".
11. Project 5: self-improving agent cho bảo trì turbine gió
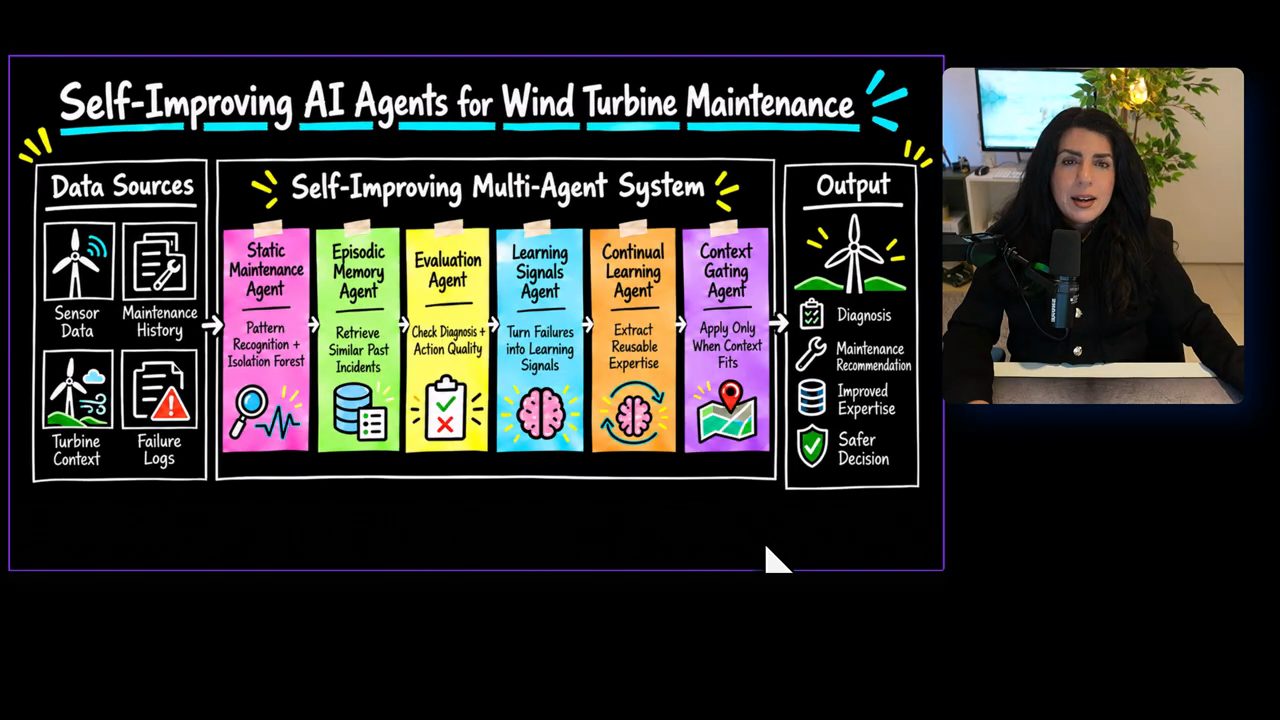
Maryam mở project năm bằng một câu hỏi (video đăng 27/09/2026): có lẽ bạn đang nghĩ mình đã biết hết rồi, vậy còn gì để học từ project thứ năm? Chị trả lời: một thứ rất mới và rất thú vị là continual learning. Bạn đánh giá mọi thứ và biết được cái gì sai, được rồi, bạn đã học được. Nhưng nếu bạn không đưa nó ngược lại vào agent và cải thiện agent, tức là build những agent kiểu continual learning, tự cải thiện (self-improving), thì về cơ bản bạn chẳng làm gì với những eval đó. Slide của phần này ghi "Memory is not learning." với chuỗi Memory → Evals → Learning → Gating → Improve.
Ta sẽ làm self-improving agent cho việc bảo trì turbine gió. Dữ liệu, theo Maryam (video đăng 27/09/2026), là dữ liệu cảm biến từ các turbine gió; chị nói những turbine gió này cực kỳ ấn tượng. Bạn có lịch sử bảo trì, có context của turbine, và dĩ nhiên có cả các lỗi hỏng (failure).
Agent đầu tiên có thể là một static maintenance agent làm nhận dạng mẫu (pattern recognition). Maryam kể (video đăng 27/09/2026) chị đã dùng isolation forest, một phương pháp phát hiện bất thường (anomaly detection), rồi dùng memory để truy xuất các sự cố trong quá khứ. Bước này cho ra chẩn đoán, hành động khuyến nghị và tóm tắt sự cố; trên màn hình đó là "Initial Multi-Agent System (Step 1)" với Static Maintenance Agent và Episodic Memory Agent.
Rồi ta muốn thêm phần learning. Theo Maryam (video đăng 27/09/2026), ta đánh giá các agent và lấy ra những tín hiệu học (learning signal); ta muốn biến các lỗi thành phản hồi có cấu trúc. Chị lưu ý: tới bước này, việc duy nhất ta đã làm là build và thu thập những gì đi sai, chưa build vòng lặp. Giờ bạn mới đi tiếp sang continual learning: trích ra những chuyên môn tái sử dụng được (reusable expertise) từ các lỗi đã xảy ra lặp lại.
300 điểm dữ liệu hay 1.000 điểm dữ liệu sẽ cho biết mẫu hình bên trong chúng là gì. Đó là lý do Maryam nói chị đã dùng isolation forest, một phương pháp phát hiện ngoại lai (outlier detection) (video đăng 27/09/2026); bạn có thể dùng bất kỳ kiểu pattern recognition nào từ machine learning và deep learning rồi áp vào đây. Còn context gating là áp dụng khi thích hợp, khi bạn ở trong một context cụ thể; trên sơ đồ, Context Gating Agent ghi "Apply Only When Context Fits".
12. Project 5: loop engineering, continual learning và các domain
Bạn học được layer nào của AI engineering? Theo Maryam (video đăng 27/09/2026), dĩ nhiên bạn học agent engineering như ở nhiều project khác, nhưng bạn còn học cái gọi là loop engineering, thứ chị nói đang rất nổi tiếng vào thời điểm video đăng (27/09/2026). Tuy vậy chị cho rằng nó chẳng có gì quá đặc biệt: bạn biến một sự cố thành một vòng phản hồi (feedback loop). Bảng ghi: biến một sự cố thành feedback loop, không chỉ là một câu trả lời dùng một lần.
Evaluation engineering, theo Maryam (video đăng 27/09/2026), là thứ ta vẫn biết, đơn giản là có một bước đánh giá; các thuật ngữ này chẳng có gì mới. Chị so sánh: bạn đi học thì cần được kiểm tra xem đã học đủ chưa. Việc có đánh giá trong hệ thống agent là điều hoàn toàn tự nhiên.
Còn continual learning, theo chị (video đăng 27/09/2026), là: được rồi, tôi đã có output của bước đánh giá, tôi chạy nó trong một vòng lặp, và tôi có hàng nghìn điểm dữ liệu đang cho tôi phản hồi đó. Bất kỳ kiểu pattern recognition nào trên dữ liệu đó cũng sẽ cho bạn thấy đang có những loại lỗi gì, và rồi agent của bạn thật sự trở thành tự cải thiện hoàn toàn. Bảng ghi cho ô Continual Learning: chuyển kinh nghiệm đã được đánh giá thành chuyên môn tái sử dụng được, với context gating để tránh chuyển giao tiêu cực (negative transfer).
Bạn đã học domain nào? Trong project năm, theo bảng Maryam đưa ra (video đăng 27/09/2026), là bảo trì dự đoán (predictive maintenance), phát hiện bất thường, episodic memory, đánh giá và tín hiệu học, continual learning và context gating. Vì ta làm với turbine gió, điều này chuẩn bị cho bạn mọi thứ về năng lượng gió, mọi loại tài sản công nghiệp, sản xuất (manufacturing), vì theo chị làm việc với robot cũng giống mọi thứ các turbine này làm, rồi tiện ích và năng lượng.
Chị bảo hãy nghĩ tới hàng không (video đăng 27/09/2026): mọi máy bay cũng có kiểu bảo trì này, khá gần với những turbine kia, và cả vận hành hạ tầng thông minh. Trên bảng còn ghi "Aviation & Fleet Maintenance" và "Smart Infrastructure Operations". Maryam hỏi: bạn có thấy mình xử lý được bao nhiêu domain chỉ sau năm project này không?
13. Bộ tăng tốc 100x cho việc được tuyển: chia sẻ công khai
Maryam nhắc lại lời hứa từ đầu về một "100x accelerator" cho việc được tuyển (video đăng 27/09/2026). Chị mở tài khoản LinkedIn của mình: chị có khá nhiều người theo dõi ở đó, và quan trọng nhất, theo lời chị, là chị đăng bài mỗi ngày.
Chị kể (video đăng 27/09/2026): khoảng ba năm trước, chị vẫn chỉ có chừng 2.000 người theo dõi. Rồi chị đăng những bài về AI explainability, và chúng bùng nổ. Chị hoàn toàn bối rối: AI explainability thì có gì đặc biệt đâu? Điều chị nhận ra là vì chị đang áp dụng AI để phát hiện tội phạm tài chính, một lĩnh vực bị quản lý rất chặt, nên chị đã phải đi qua mọi loại thư viện Python cho AI explainability hiện có để thấy giới hạn và cơ hội của chúng, và điều đó giúp ích rất nhiều cho người khác.
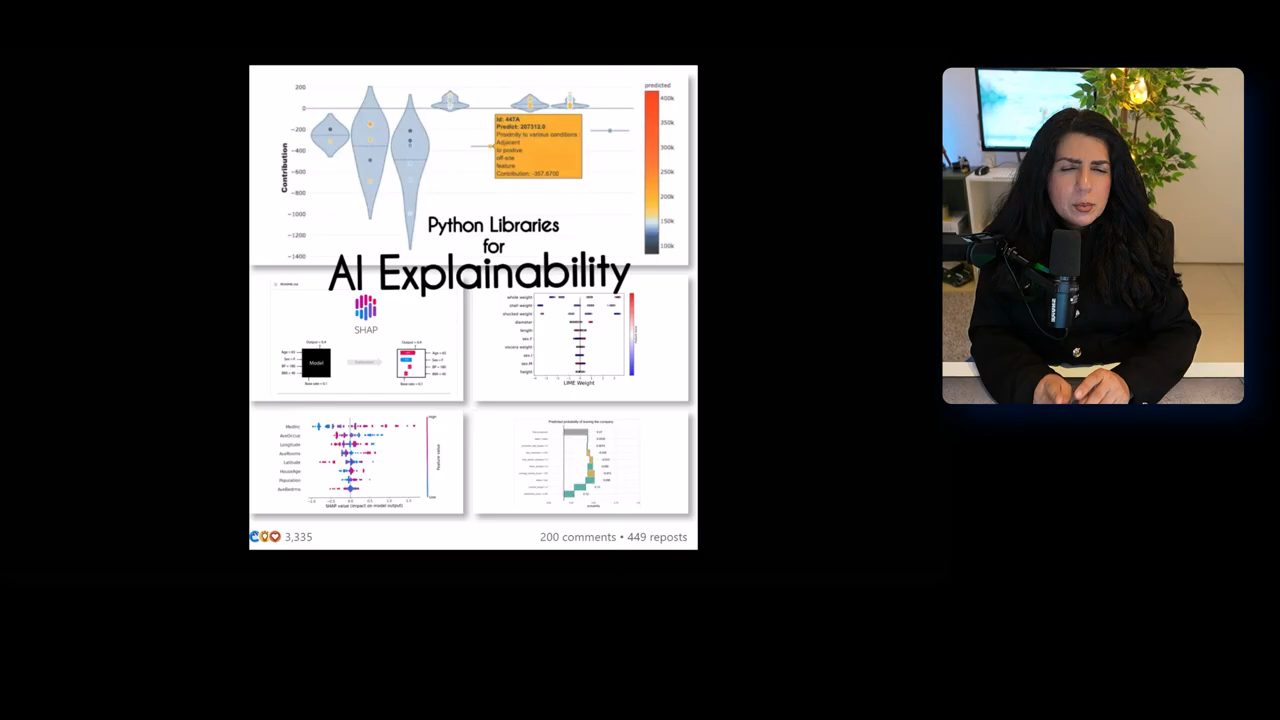
Chị nói (video đăng 27/09/2026) chị không bao giờ ngờ rằng khi bạn đang làm một việc và chỉ chuyên sâu vào việc đó, việc chia sẻ nó với người khác lại tạo ra hai điều. Thứ nhất, người ta tìm thấy bạn, nhìn thấy bạn, nên bạn trở nên được biết tới. Thứ hai, công việc của bạn sẽ được đặt trước mặt rất nhiều người; với bài này, chị nghĩ khoảng một triệu người đã xem (ước tính của chị, video đăng 27/09/2026).
Người ta sẽ xem nó, phê bình nó, cho bạn những gợi ý rất tốt về những gì bạn vẫn còn thiếu. Theo Maryam (video đăng 27/09/2026), dù đáng sợ đến đâu, việc chia sẻ suy nghĩ của mình sẽ dạy bạn rất nhiều và mang lại cho bạn rất nhiều cơ hội, theo cách hoàn toàn không giống việc đi nộp đơn xin việc.
Chị nói thêm (video đăng 27/09/2026) không chỉ có LinkedIn, thứ chị mới dùng trong vài năm gần đây: chị đã có ba hay bốn startup, và đã viết blog nhiều năm. Ngày nay là mạng xã hội, trước đó thì là các bài viết, blog và những thứ kiểu vậy.
14. Trở nên dễ tìm thấy: build in public
Điều đó dạy Maryam rằng khi bạn có thể được tìm kiếm và tìm thấy, người ta sẽ mời bạn làm việc thay vì bạn phải đi tìm việc. Chị nói (video đăng 27/09/2026) chị chưa từng có một buổi phỏng vấn thật sự nào. Nó giống kiểu "chị có thể đến không? chị muốn mức lương bao nhiêu?" hơn, và theo chị đó không hẳn là phỏng vấn. Lý do là những người đó đã ấn tượng với những gì chị làm từ trước, mà chị không hề cố gây ấn tượng với ai; chị chỉ bận làm thứ mình làm giỏi nhất. Chị nói đó cũng là điều lớn nhất chị học được sau rất nhiều năm làm AI.
Maryam nhớ lại (video đăng 27/09/2026) rằng chị đã đi qua những ngành khác nhau khi làm với time series, với dữ liệu địa lý, với computer vision, với anomaly detection, và ở mọi ngành chị đã làm, chị đều đưa những hiểu biết đó lên internet. Trên màn hình là bốn bài đăng của chị: Python libraries cho time series analysis và forecasting, Python libraries cho geographic data analysis, computer vision, và anomaly detection cùng các phương pháp đánh giá.
Chị hoàn toàn khuyên bạn (video đăng 27/09/2026): build một app thật tốt, publish lên GitHub, chia sẻ trên LinkedIn, nơi chị nói rất chuyên nghiệp. Viết một bài trên Medium hoặc làm một video YouTube. Nếu bạn viết một bài, như chị đã nói, một triệu người có thể tìm thấy bạn và ấn tượng với bạn; có thể họ phê bình bạn, nhưng khi đó bạn cũng có khoảng một triệu người thầy.
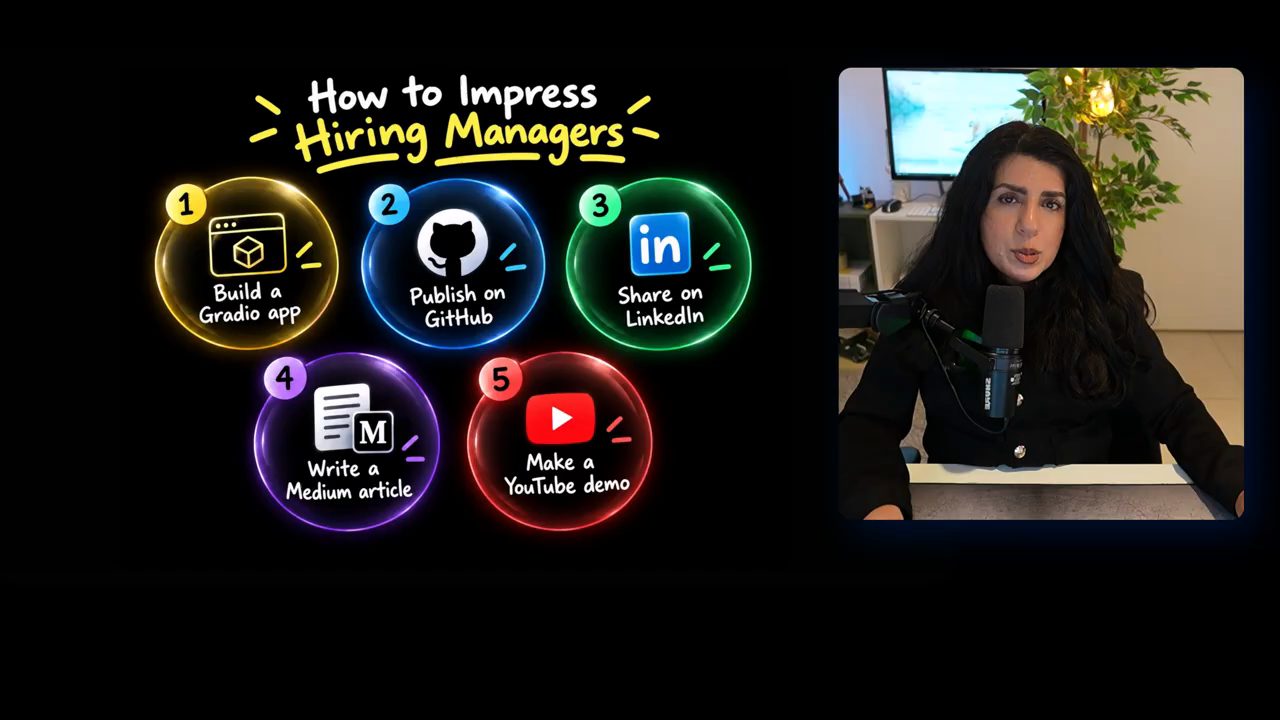
Theo Maryam (video đăng 27/09/2026), đây là một bộ tăng tốc gấp trăm lần thật sự, vì bạn đi từ quan hệ một đối một, bạn và công ty bạn muốn vào, hay có thể là 10 hoặc 20 công ty; nghe thì nhiều nhưng vẫn chỉ là 20; sang một tình huống mà 10.000, 100.000, thậm chí hàng triệu người có thể tìm thấy bạn. Bạn bắt đầu rất nhỏ.
Chị thật sự khuyên dùng bộ tăng tốc này và đừng nghĩ rằng chẳng ai đọc. Nếu bạn nghĩ "tôi chỉ có một nghìn lượt hiển thị", thì theo chị (video đăng 27/09/2026) đó là một nghìn người đã xem những gì bạn làm. Và đừng nghĩ tới những chỉ số phù phiếm (vanity metric), vì chúng thay đổi liên tục và chẳng cho bạn được gì. Hãy làm đúng việc, những thứ như các project này, rồi publish nó. Chị kết bằng lời nhắn: build in public.
Nguồn và liên kết 23 nguồn
- Tên gốc: 5 AI Agents Projects to Build in 2026: Full AI Architecture + 10X System
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=KoTygGUYyJk youtube.com
- Kênh YouTube Dr. Maryam Miradi (Maryam Miradi): youtube.com/channel/UCIQzTfzErmrixae2oFqRxyg youtube.com
- LangGraph: github.com/langchain-ai/langgraph github.com
- Kaggle: kaggle.com kaggle.com
- BiomedCLIP trên Hugging Face (đọc ngày 24/10/2026): huggingface.co/microsoft/BiomedCLIP-PubMedBERT_256-vit_base_patch16_224 huggingface.co
- Qdrant: qdrant.tech qdrant.tech
- Chroma: trychroma.com trychroma.com
- OpenStreetMap: openstreetmap.org openstreetmap.org
- OSMnx (đọc ngày 24/10/2026): github.com/gboeing/osmnx github.com
- NetworkX: networkx.org networkx.org
- LangChain: github.com/langchain-ai/langchain github.com
- PydanticAI: ai.pydantic.dev ai.pydantic.dev
- Google Agent Development Kit (ADK): google.github.io/adk-docs google.github.io
- CrewAI: github.com/crewAIInc/crewAI github.com
- Model Context Protocol (MCP): modelcontextprotocol.io modelcontextprotocol.io
- Docling: github.com/docling-project/docling github.com
- pypdf: github.com/py-pdf/pypdf github.com
- scikit-learn, IsolationForest: scikit-learn.org/stable/modules/generated/sklearn.ensemble.IsolationForest.html scikit-learn.org
- SHAP: github.com/shap/shap github.com
- LIME: github.com/marcotcr/lime github.com
- Gradio: gradio.app gradio.app
Related talks
Tín hiệu từ user chết ở ranh giới retrieval
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Build một memory system cho AI agent: nó chạy thế nào
AI Systems with Andy · AI Systems with Andy · 8 min
Build long-term memory cho AI agent: write pipeline, embedding, retrieval, metadata filter, rerank, cập nhật preference giữ lịch sử và write policy.