AI-Driven Multi-Document Correlation for Enterprise Financial Compliance and Fraud Detection
AI Engineer World's Fair 2026: Online Track · Video gốc
Gian lận nằm giữa các tài liệu: nối payroll, thuế, mua hàng bằng graph, chấm risk score theo xác suất, chuẩn hoá giữa các jurisdiction.
1. Varsha là ai và talk này nói về điều gì
Varsha Shah mở đầu bằng lời cảm ơn đội ngũ AI Engineer World's Fair đã cho cô cơ hội chia sẻ nghiên cứu của mình, và nói rằng được nói chuyện cùng rất nhiều researcher và practitioner tài năng là một vinh dự thật sự. Cô giới thiệu mình là enterprise technical architect làm việc tại Tata Consultancy Services, làm cho Microsoft. Mảng cô tập trung là artificial intelligence, compliance trong doanh nghiệp, finance governance (quản trị tài chính) và intelligent automation.
Chủ đề hôm nay là nghiên cứu của cô về AI-driven multi-document correlation, tức là dùng AI để nối và đối chiếu nhiều tài liệu với nhau, áp dụng cho compliance tài chính trong doanh nghiệp và fraud detection (phát hiện gian lận).
Bối cảnh cô đặt ra như sau. Khi các tổ chức tiếp tục số hoá hoạt động, họ tạo ra một lượng dữ liệu khổng lồ cho hệ thống tài chính, trải khắp payroll (bảng lương), tax (thuế), procurement (mua hàng) và các hệ thống giao dịch. Điều trớ trêu là: dù có nhiều dữ liệu hơn bao giờ hết, các đội compliance vẫn vật lộn với những mẫu gian lận ẩn và rủi ro về quy định. Lý do, theo Varsha, là phần lớn các giải pháp hiện có phân tích từng tài liệu một cách độc lập, trong khi nhiều rủi ro nghiêm trọng nhất chỉ lộ ra khi thông tin được nối lại xuyên qua nhiều hệ thống.
Trong bài này cô giới thiệu một framework kết hợp ba thứ: graph-based entity correlation (nối các thực thể bằng đồ thị), probabilistic risk modeling (mô hình rủi ro theo xác suất) và cross-jurisdictional normalization (chuẩn hoá dữ liệu giữa các vùng pháp lý khác nhau). Mục tiêu là làm lộ ra những quan hệ ẩn này, và biến compliance trong doanh nghiệp từ một quy trình phản ứng sau sự việc (reactive) thành một năng lực tình báo chủ động (proactive intelligence). Framework đã được đánh giá trên khoảng ba triệu record tài chính thuộc bốn jurisdiction, cho thấy cả hiệu năng phát hiện mạnh lẫn cải thiện đáng kể về vận hành. Với bối cảnh đó, cô bắt đầu bằng việc nhìn vào khoảng trống compliance mà các tổ chức vẫn đang gặp.
2. The compliance gap: khoảng trống chưa ai lấp
Varsha nhắc lại: hãy bắt đầu bằng việc hiểu cái compliance gap mà rất nhiều tổ chức vẫn đang đối mặt. Compliance trong doanh nghiệp đã phức tạp hơn hẳn trong mười năm qua, và cô chỉ ra ba lực đẩy.
Thứ nhất, nhiều jurisdiction cùng lúc. Các tổ chức giờ hoạt động xuyên nhiều quốc gia, nhiều khung quy định và nhiều hệ thống tài chính, mỗi nơi có chuẩn báo cáo và yêu cầu compliance riêng. Trên slide, ý này được viết thành: các quy định chồng lấn và khác nhau giữa các hệ thống toàn cầu tạo ra những điểm mù mà công cụ thủ công và công cụ rule-based không đối chiếu nổi.
Thứ hai, khối lượng dữ liệu tăng theo cấp số nhân. Bảng lương, hồ sơ khai thuế, giao dịch mua hàng và các tài liệu tài chính sinh ra mỗi ngày, khiến việc review thủ công vừa tốn thời gian vừa ngày càng không khả thi.
Thứ ba, gian lận đã tiến hoá. Gian lận hiện đại hiếm khi xuất hiện như một lỗi hiển nhiên nằm gọn trong một tài liệu. Thay vào đó, nó khai thác những điểm không nhất quán rất nhỏ giữa nhiều hệ thống, những pattern thường vô hình khi từng record được xem xét riêng lẻ.
Điều này tạo ra một giới hạn mang tính nền tảng. Các hệ thống truyền thống, dạng rule-based và NLP ở mức tài liệu, được thiết kế để kiểm tra từng record riêng, nhưng chúng không được xây để hiểu quan hệ giữa các tài liệu. Đó chính là khoảng trống mà nghiên cứu này muốn giải quyết: vượt qua kiểu phân tích tài liệu cô lập để làm lộ rủi ro ẩn bằng cross-document correlation, tức là đối chiếu xuyên tài liệu.
3. Vì sao phân tích ở mức từng tài liệu không đủ
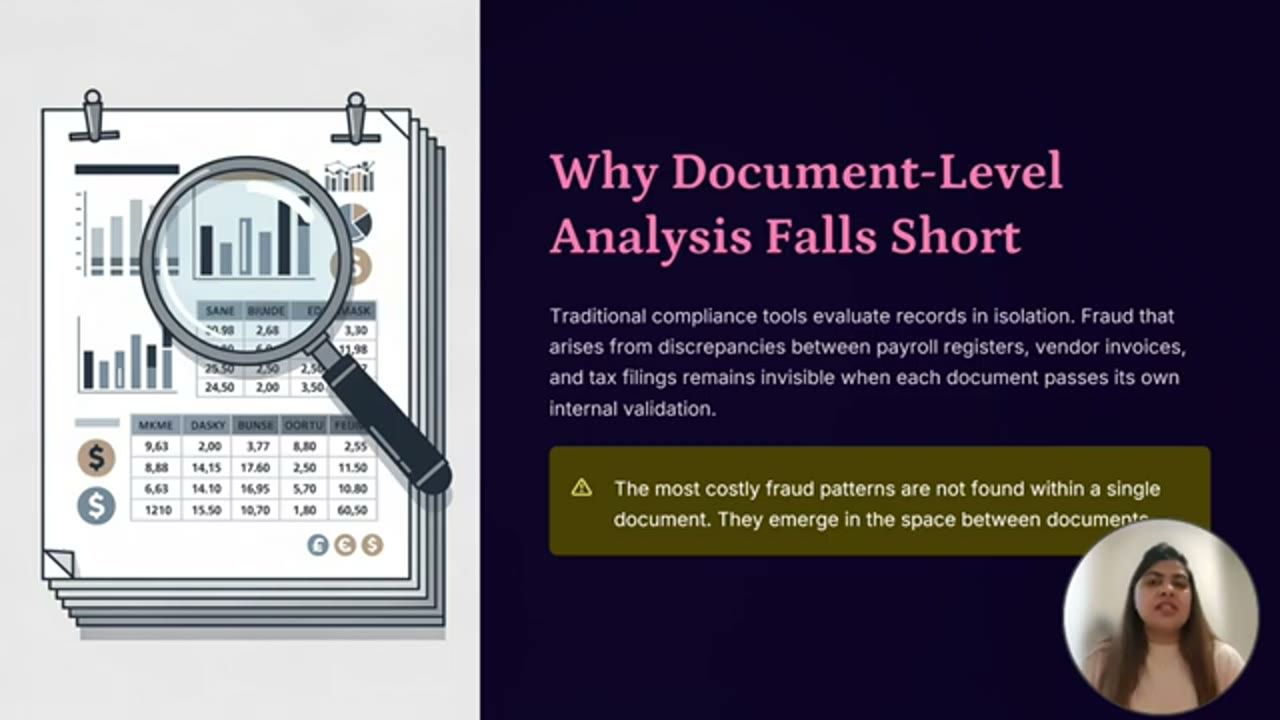
Để hiểu rõ giới hạn này, Varsha mô tả cách phần lớn hệ thống compliance đang vận hành hiện nay: chúng đánh giá từng tài liệu độc lập. Một payroll register (sổ lương) được kiểm tra theo quy tắc payroll. Hoá đơn của vendor được kiểm tra theo chính sách procurement. Một hồ sơ khai thuế được review theo quy định thuế. Nếu mỗi tài liệu qua được bước kiểm tra riêng của nó, giao dịch thường được coi là compliant.
Vấn đề là nhiều mẫu gian lận tinh vi thật ra không hiện ra trong một tài liệu đơn lẻ. Chúng chỉ nổi lên khi nhiều tài liệu được phân tích cùng nhau. Ví dụ cô đưa ra: một record payroll có thể trông chính xác với chúng ta, một hoá đơn vendor có vẻ hợp lệ, một hồ sơ thuế có thể được nộp đúng cách. Nhưng khi nối các record này lại, chúng làm lộ ra những điểm không nhất quán, và chính những điểm đó báo hiệu gian lận và rủi ro compliance.
Thông tin thì đã có sẵn. Cái còn thiếu, theo Varsha, là khả năng hiểu quan hệ giữa các tài liệu này. Vì vậy nghiên cứu chuyển trọng tâm từ document-level validation (kiểm tra từng tài liệu) sang cross-document intelligence (trí tuệ xuyên tài liệu), để các tổ chức phát hiện được những rủi ro mà nếu không thì sẽ mãi nằm ẩn.
4. Tổng quan kiến trúc: ba thành phần bổ trợ nhau
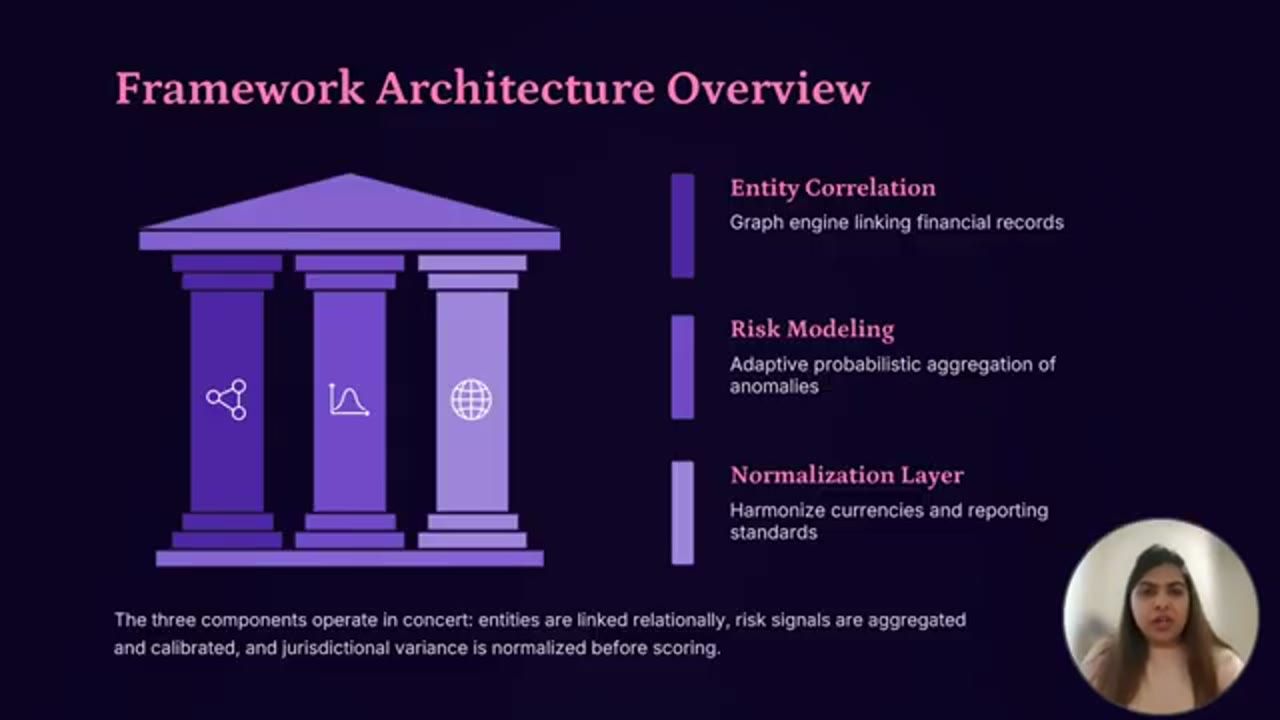
Varsha đặt câu hỏi chuyển tiếp: nếu vấn đề nằm ở việc hiểu quan hệ chứ không ở từng tài liệu, vậy kiến trúc nào giải được bài toán này? Cô giới thiệu framework.
Thay vì dựa vào một model hay một thuật toán duy nhất, giải pháp được xây trên ba thành phần bổ trợ nhau, cùng làm việc để biến dữ liệu thô của doanh nghiệp thành compliance intelligence có thể hành động được.
- Entity correlation engine. Mục đích là nối các thông tin liên quan xuyên payroll, tax, procurement và hệ thống tài chính, tạo ra một góc nhìn thống nhất về hoạt động của doanh nghiệp thay vì những record rời rạc.
- Adaptive probabilistic risk model. Khi các quan hệ đã được thiết lập, thành phần thứ hai đánh giá dữ liệu đã nối để xác định pattern nào là rủi ro compliance có ý nghĩa. Thay vì sinh alert dựa trên một rule đơn lẻ, nó ưu tiên các ca bằng nhiều risk signal cùng lúc.
- Cross-jurisdictional normalization layer. Lớp này cung cấp bối cảnh pháp lý bằng cách chuẩn hoá tiền tệ, cấu trúc thuế, chuẩn báo cáo và quy tắc compliance giữa các jurisdiction khác nhau. Nhờ vậy rủi ro được đánh giá nhất quán, bất kể giao dịch phát sinh ở đâu.
Mỗi thành phần riêng lẻ đều có giá trị. Nhưng khi đi cùng nhau, chúng tạo nên một framework vượt khỏi việc kiểm tra từng tài liệu để tiến tới compliance intelligence ở quy mô toàn doanh nghiệp. Trong vài slide tiếp theo, cô giải thích ngắn gọn từng thành phần đóng góp vào quy trình ra sao.
5. Component 1: Graph-Based Entity Correlation Engine
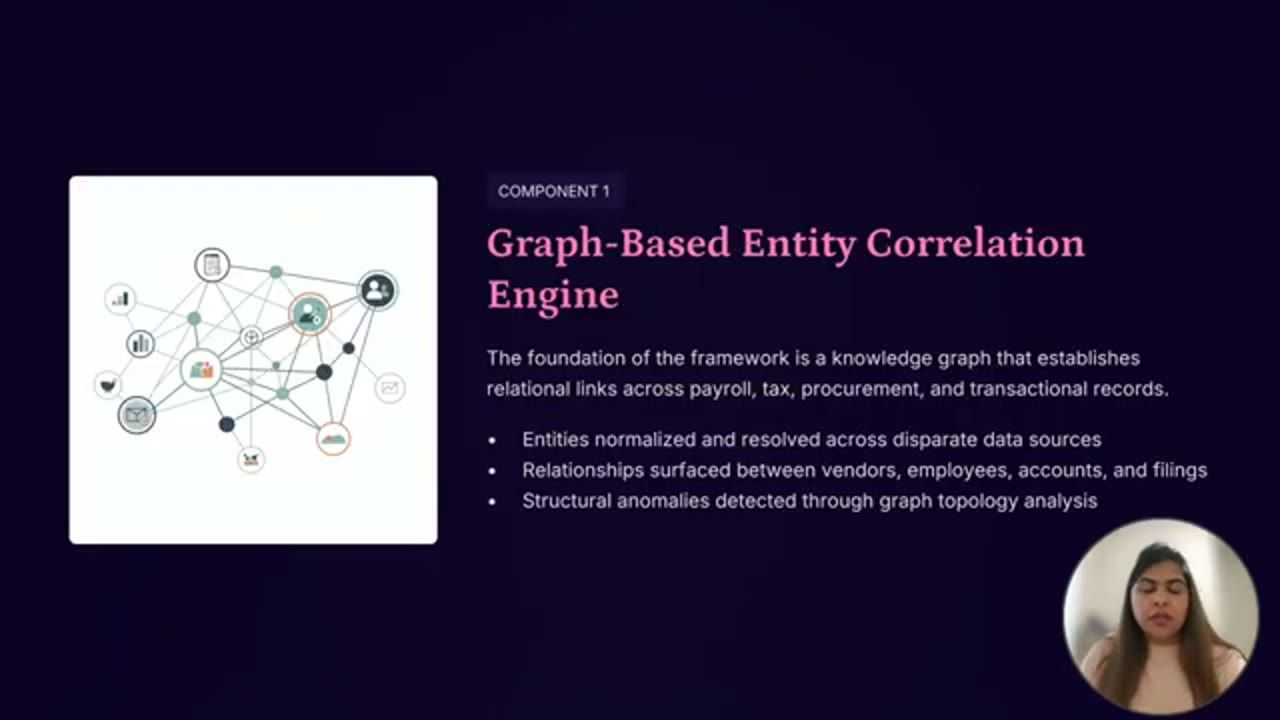
Varsha bắt đầu với nền móng của framework, thứ làm cho cross-document intelligence trở thành khả thi: graph-based entity correlation engine. Vai trò của nó là nối các thực thể (entity) xuyên payroll, tax, procurement và hệ thống tài chính vào một mạng lưới thống nhất.
Thay vì phân tích từng tài liệu độc lập, engine này xác định quan hệ giữa nhân viên, vendor, tài khoản, giao dịch và các hồ sơ nộp cho cơ quan quản lý. Chính các kết nối này làm lộ ra những pattern ẩn và những bất thường về cấu trúc (structural anomaly), thứ thường vô hình với kiểu phân tích ở mức tài liệu mà chúng ta vẫn làm.
Nói đơn giản, thành phần này trả lời một câu hỏi nền tảng: cái gì đang nối với cái gì? Nó cung cấp nền móng quan hệ cho phần còn lại của framework. Khi quan hệ đã được thiết lập, bước tiếp theo là xác định quan hệ nào thật sự là rủi ro có ý nghĩa.
6. Component 2: Adaptive Probabilistic Risk Model
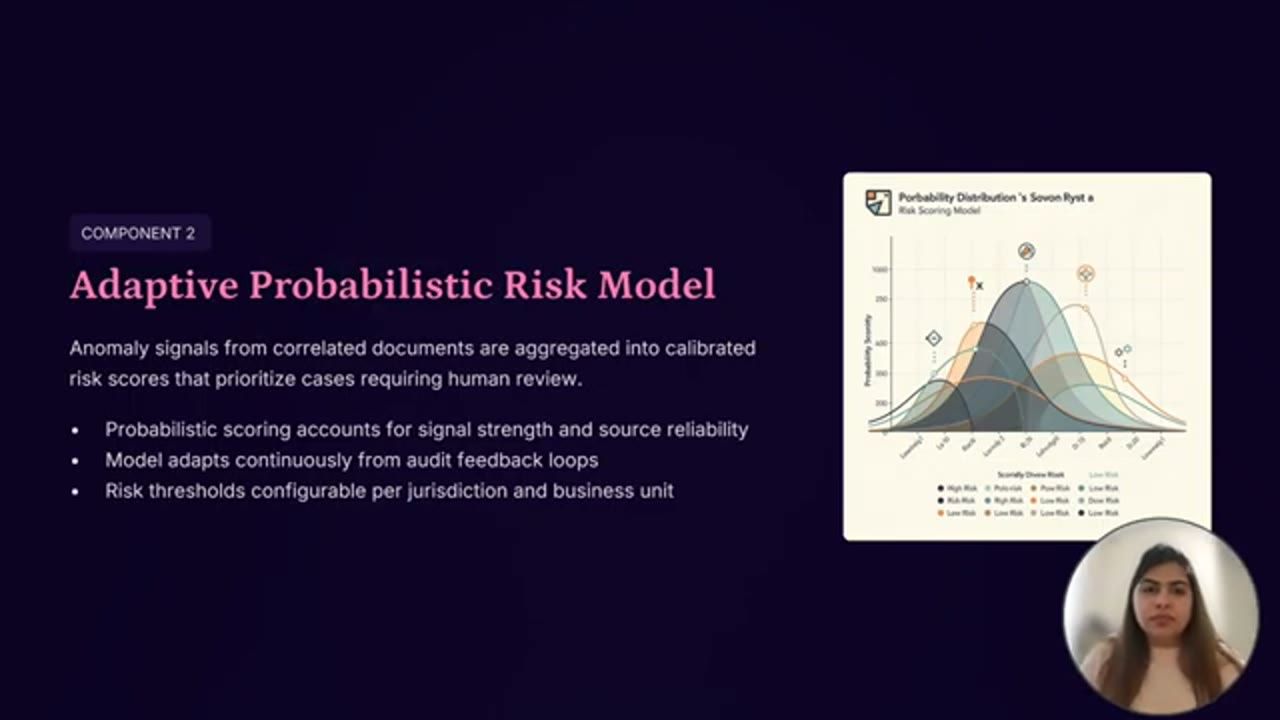
Khi các quan hệ đã có, bước tiếp theo là quyết định quan hệ nào thật sự đại diện cho rủi ro có ý nghĩa. Đó là vai trò của adaptive probabilistic risk model.
Thay vì dựa vào rule tĩnh, model này kết hợp nhiều risk indicator, chẳng hạn độ mạnh của anomaly, độ tin cậy của nguồn dữ liệu, và các pattern đã từng xảy ra trong quá khứ, để tính ra một risk score dựa trên độ tin cậy (confidence-based). Điểm này giúp ưu tiên các ca cần chú ý ngay, đồng thời giảm những cuộc điều tra không cần thiết.
Ưu điểm quan trọng mà Varsha nhấn mạnh là khả năng học từ kết quả audit: model liên tục cải thiện độ chính xác theo thời gian. Nói gọn, thành phần này trả lời câu hỏi: cái gì nhiều khả năng là rủi ro compliance thật nhất?
7. Component 3: Cross-Jurisdictional Normalization Layer
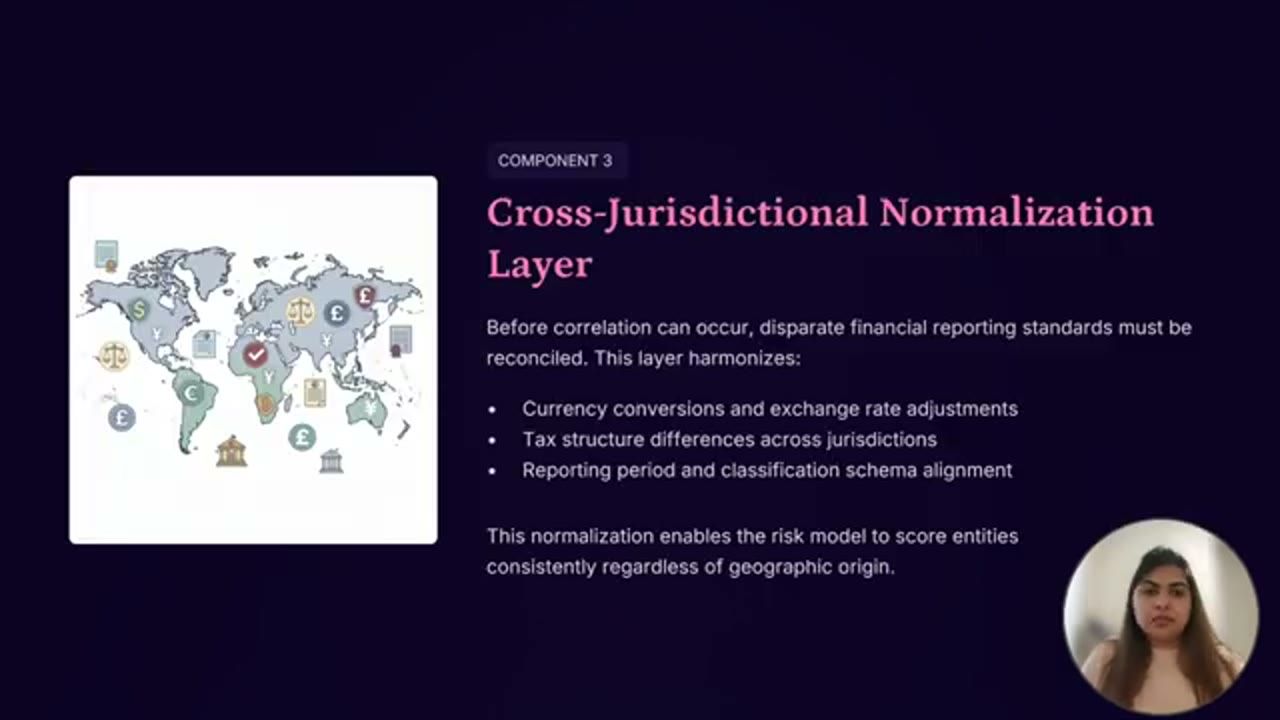
Khi đã xác định được các ca rủi ro cao, bước cuối cùng là đảm bảo những rủi ro đó được diễn giải nhất quán giữa các môi trường pháp lý khác nhau. Thành phần cuối là cross-jurisdictional normalization layer.
Các tổ chức toàn cầu hoạt động qua nhiều quốc gia, nhiều loại tiền, nhiều cấu trúc thuế và chuẩn báo cáo. Không có chuẩn hoá, cùng một giao dịch có thể bị diễn giải khác nhau tuỳ jurisdiction. Lớp này hài hoà dữ liệu tài chính bằng cách chuẩn hoá tiền tệ, quy tắc thuế, kỳ báo cáo và cả các classification scheme (sơ đồ phân loại). Kết quả là rủi ro được đánh giá nhất quán bất kể nó phát sinh ở đâu.
Tóm lại, thành phần này trả lời câu hỏi: rủi ro nên được diễn giải thế nào trong đúng bối cảnh pháp lý của nó?
Trong lời nói, Varsha trình bày lớp này như bước cuối cùng, sau khi đã tìm ra các ca rủi ro cao. Còn trên slide, lớp này được mô tả là thứ phải chạy trước khi correlation có thể diễn ra, và slide tổng quan ở phần 4 cũng ghi rằng khác biệt giữa các jurisdiction được chuẩn hoá trước khi chấm điểm.
8. Điều kiện đánh giá: ba triệu record, bốn jurisdiction, năm năm
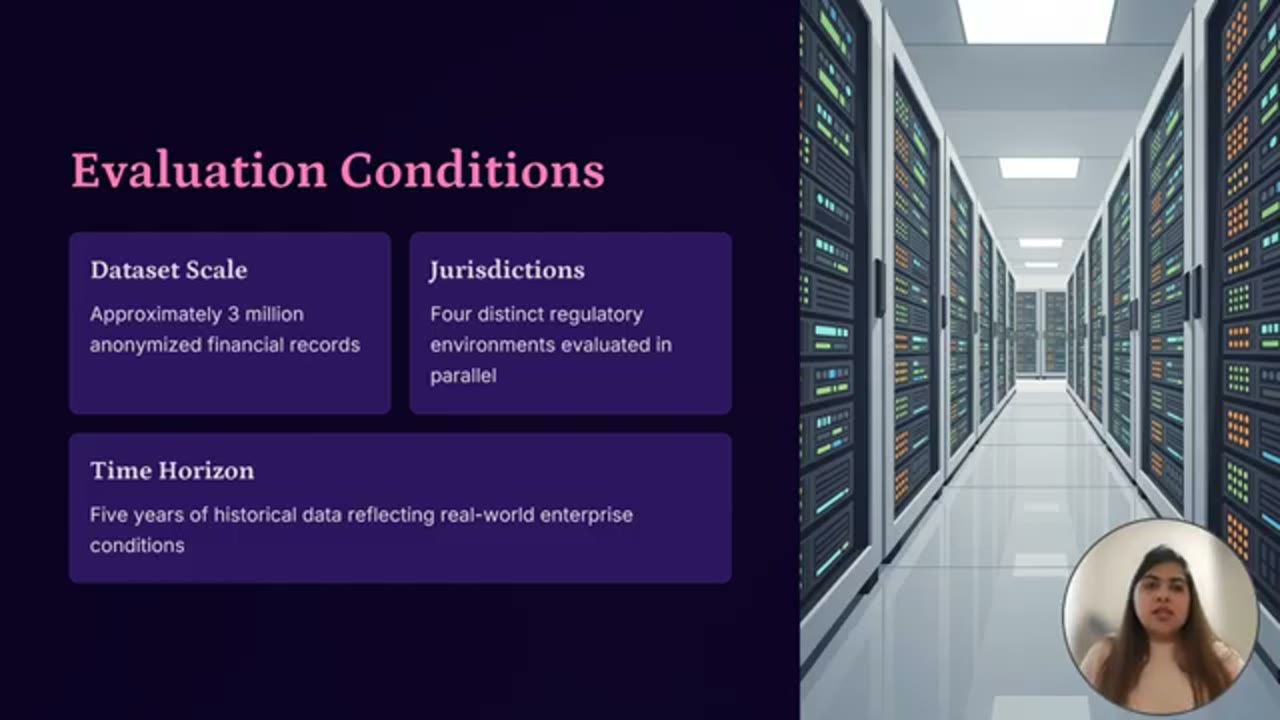
Với cả ba thành phần cùng chạy, bước tiếp theo là đánh giá framework hoạt động thế nào trong điều kiện doanh nghiệp thật. Trước khi nói về kết quả, Varsha cho rằng rất quan trọng là hiểu ngắn gọn môi trường đánh giá.
Framework được đánh giá trên khoảng ba triệu record tài chính, thu thập trong khoảng thời gian năm năm, thuộc bốn jurisdiction pháp lý khác nhau. Mục tiêu là xem framework hoạt động ra sao trong điều kiện doanh nghiệp thực tế, nơi một khối lượng lớn dữ liệu tài chính liên kết chằng chịt với nhau và các yêu cầu pháp lý khác nhau tạo ra độ phức tạp đáng kể.
Đặt xong nền móng đó, cô chuyển sang câu hỏi chính: framework hiệu quả đến đâu trong việc phát hiện rủi ro compliance ẩn?
9. Kết quả detection: precision, recall, F1
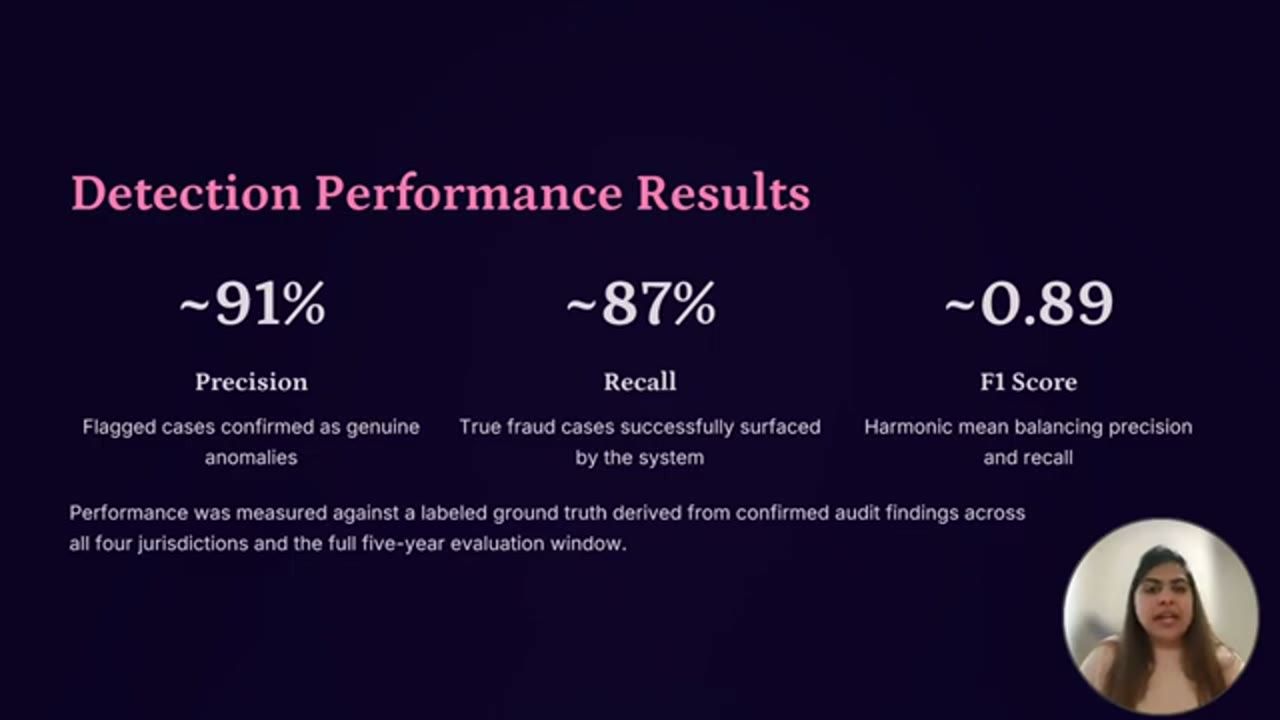
Varsha đi vào hiệu năng phát hiện. Framework đạt precision khoảng 91%, nghĩa là phần lớn các ca bị gắn cờ đã được xác nhận là anomaly thật. Nó cũng đạt recall 87%, cho thấy khả năng tìm ra hầu hết các ca gian lận thật trong khi giảm thiểu số ca bị bỏ sót.
Gộp lại, hai con số này cho F1 score là 0.89, thể hiện sự cân bằng tốt giữa precision và recall. Quan trọng hơn, theo cô, các kết quả này đạt được trên cả bốn jurisdiction và trên dữ liệu ở quy mô doanh nghiệp lớn, chứng tỏ framework hoạt động ổn định trong môi trường thực tế phức tạp.
Để đọc ba con số này cho đúng: precision là tỷ lệ ca bị gắn cờ mà đúng là có vấn đề, recall là tỷ lệ ca có vấn đề thật mà hệ thống bắt được, còn F1 score là trung bình điều hoà (harmonic mean) của hai con số kia.
Câu hỏi tiếp theo, theo Varsha, cũng quan trọng không kém: những cải thiện này chuyển thành giá trị vận hành gì cho các đội compliance?
10. Hiệu quả vận hành: ít false positive, ít audit thủ công
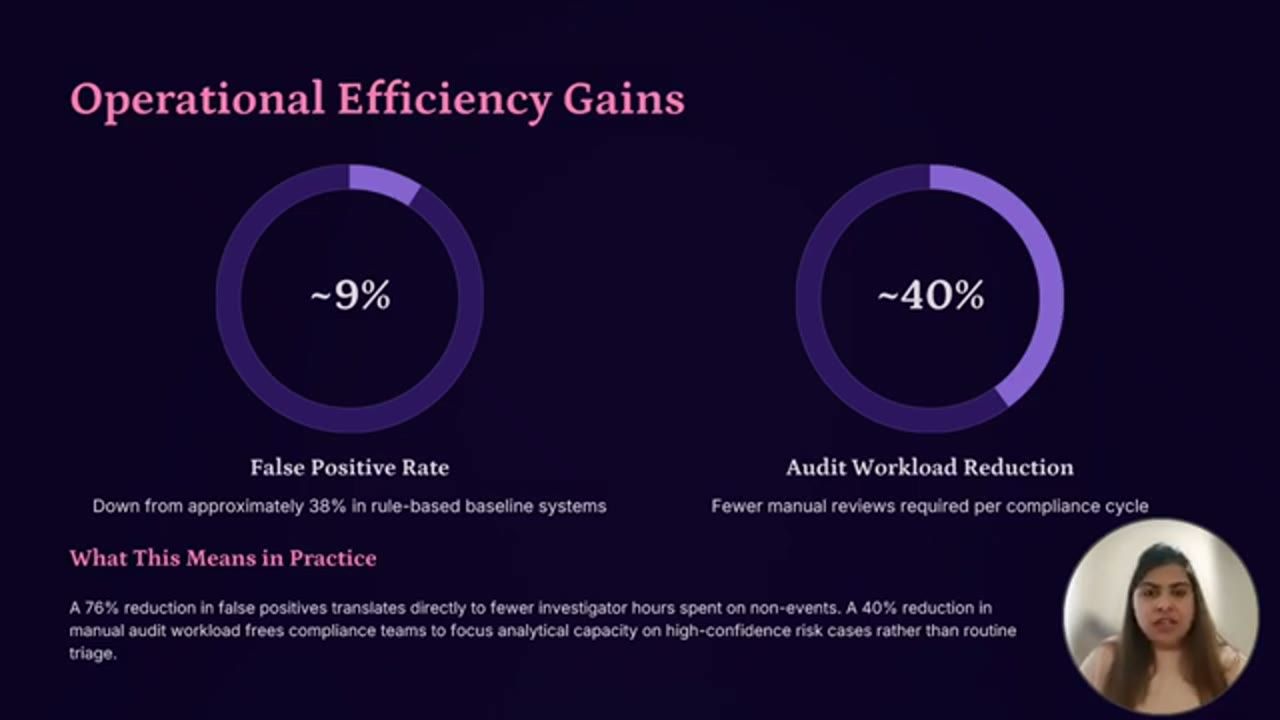
Độ chính xác phát hiện chỉ là một phần câu chuyện. Giá trị thật, theo Varsha, đến từ việc làm cho hoạt động compliance hiệu quả hơn. Ngoài độ chính xác, framework mang lại những lợi ích vận hành đo được.
Một trong những kết quả đáng kể nhất là false positive giảm 76%, nghĩa là các điều tra viên tốn ít thời gian hơn hẳn để review những ca mà rốt cuộc là hợp lệ. Ngoài ra, framework giảm khoảng 40% công sức audit thủ công, cho phép đội compliance chỉ tập trung vào các ca rủi ro cao thay vì review tài liệu thường lệ.
Cuối cùng, điều này chuyển thành điều tra nhanh hơn, dùng nguồn lực tốt hơn, và tự tin hơn vào các quyết định compliance. Nói cách khác, framework không chỉ phát hiện gian lận hiệu quả hơn, nó giúp đội compliance làm việc hiệu quả hơn.
11. So với các hệ thống baseline
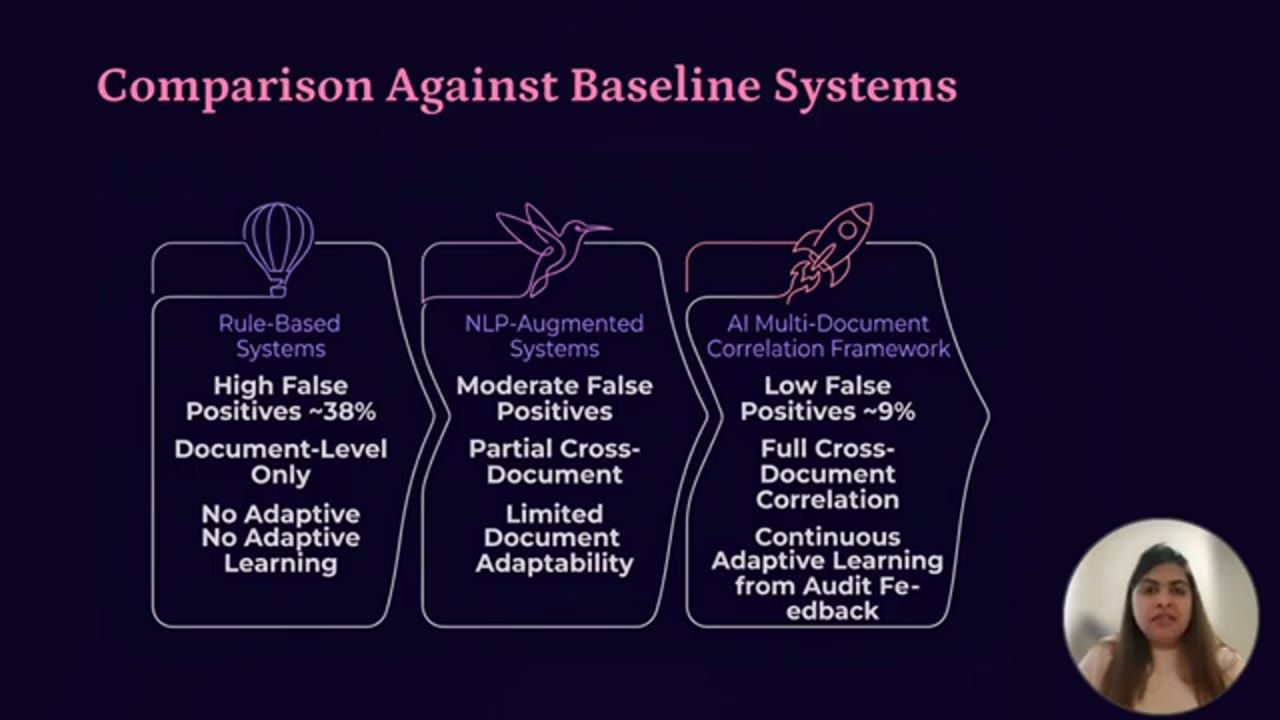
Những cải thiện vận hành này càng có ý nghĩa khi đặt framework cạnh các cách tiếp cận rule-based truyền thống. Phần so sánh này làm rõ lợi thế của việc vượt khỏi hệ thống rule-based.
Các cách tiếp cận thông thường làm tốt việc kiểm tra từng record riêng, nhưng thường chật vật khi phải phát hiện những mẫu gian lận phức tạp trải qua nhiều tài liệu và nhiều hệ thống. Bằng cách đưa vào entity correlation, probabilistic risk modeling và regulatory normalization, framework được đề xuất liên tục vượt baseline trên các metric hiệu năng chính.
Varsha nói key takeaway rất đơn giản: nối dữ liệu xuyên tài liệu cho ra detection tốt hơn, ít false positive hơn, và compliance intelligence dễ hành động hơn so với phân tích từng tài liệu một cách cô lập.
12. Continuous adaptive learning: mỗi cuộc audit làm cuộc sau tốt hơn
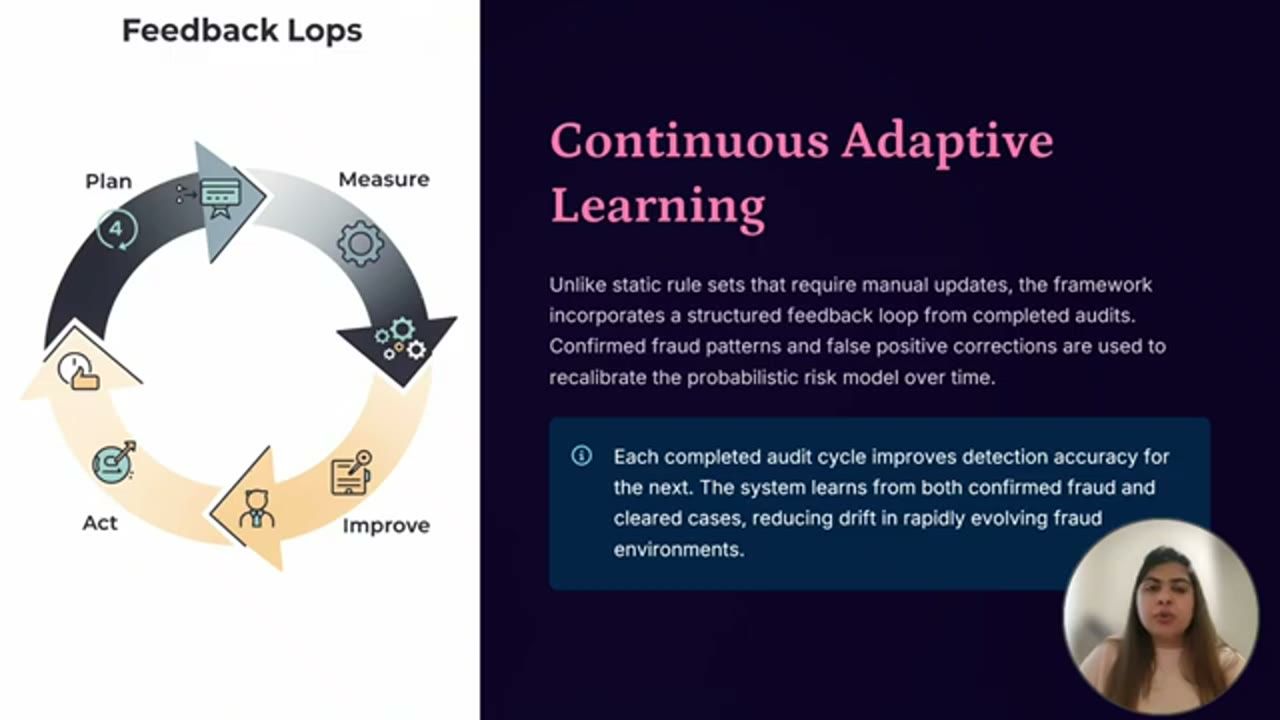
Một trong những lý do framework tiếp tục tốt lên theo thời gian là nó không còn dựa vào rule tĩnh. Thay vào đó, nó liên tục học từ các cuộc audit đã hoàn tất và từ feedback của điều tra viên.
Framework được thiết kế để cải thiện liên tục qua feedback. Mỗi cuộc audit hoàn tất cung cấp thông tin giá trị. Ca gian lận được xác nhận giúp củng cố các pattern phát hiện trong tương lai. Còn false positive giúp tinh chỉnh risk scoring và giảm những alert không cần thiết. Điều này tạo ra một vòng học liên tục, nơi hệ thống chính xác hơn sau mỗi cuộc audit và điều tra.
Khi các mẫu gian lận tiến hoá và môi trường kinh doanh thay đổi, framework thích nghi theo thay vì phải chờ người cập nhật rule bằng tay. Nói đơn giản, mỗi cuộc audit hoàn tất giúp cuộc audit tiếp theo hiệu quả hơn.
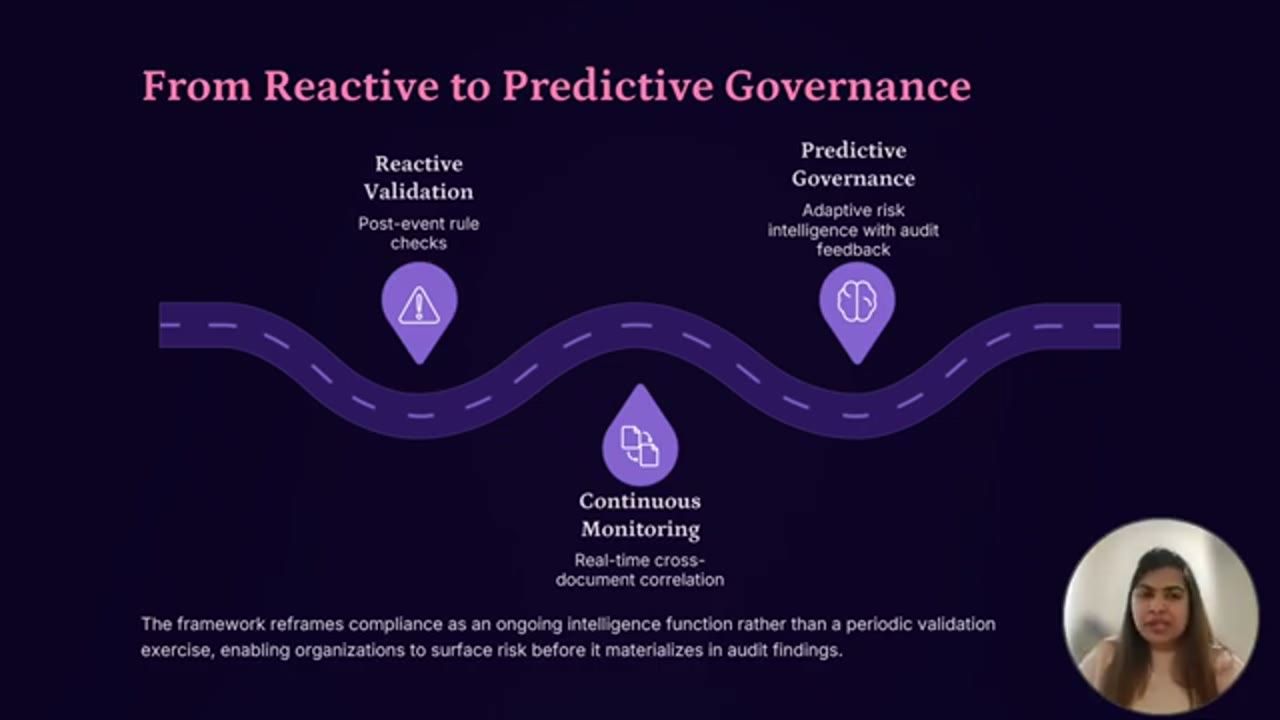
Năng lực học liên tục này mở đường cho một sự chuyển dịch rộng hơn: từ phản ứng với vấn đề compliance sau khi chúng xảy ra, sang nhận diện rủi ro trước khi chúng trở thành kết luận audit. Varsha gọi đó là cách làm chủ động hơn.
13. Từ reactive validation sang predictive governance
Ngoài việc tăng độ chính xác phát hiện, framework thay đổi cách tổ chức tiếp cận compliance. Theo truyền thống, compliance mang tính phản ứng: vấn đề chỉ được phát hiện sau khi audit, điều tra hay review của cơ quan quản lý đã diễn ra.
Framework này cho phép một cách tiếp cận chủ động hơn thông qua continuous monitoring (giám sát liên tục), cross-document correlation và adaptive learning. Thay vì hỏi "chuyện gì đã sai", tổ chức có thể bắt đầu hỏi "chuyện gì nhiều khả năng sẽ sai tiếp theo".
Đó là bước chuyển từ reactive validation sang predictive governance (quản trị dự báo), cho phép đội compliance nhận diện rủi ro sớm hơn, ưu tiên điều tra hiệu quả hơn, và ra quyết định dựa trên nhiều thông tin hơn. Rốt cuộc, compliance trở thành một chức năng tình báo liên tục chứ không còn là một quy trình review định kỳ.
14. Những điều cần tính khi deploy thật
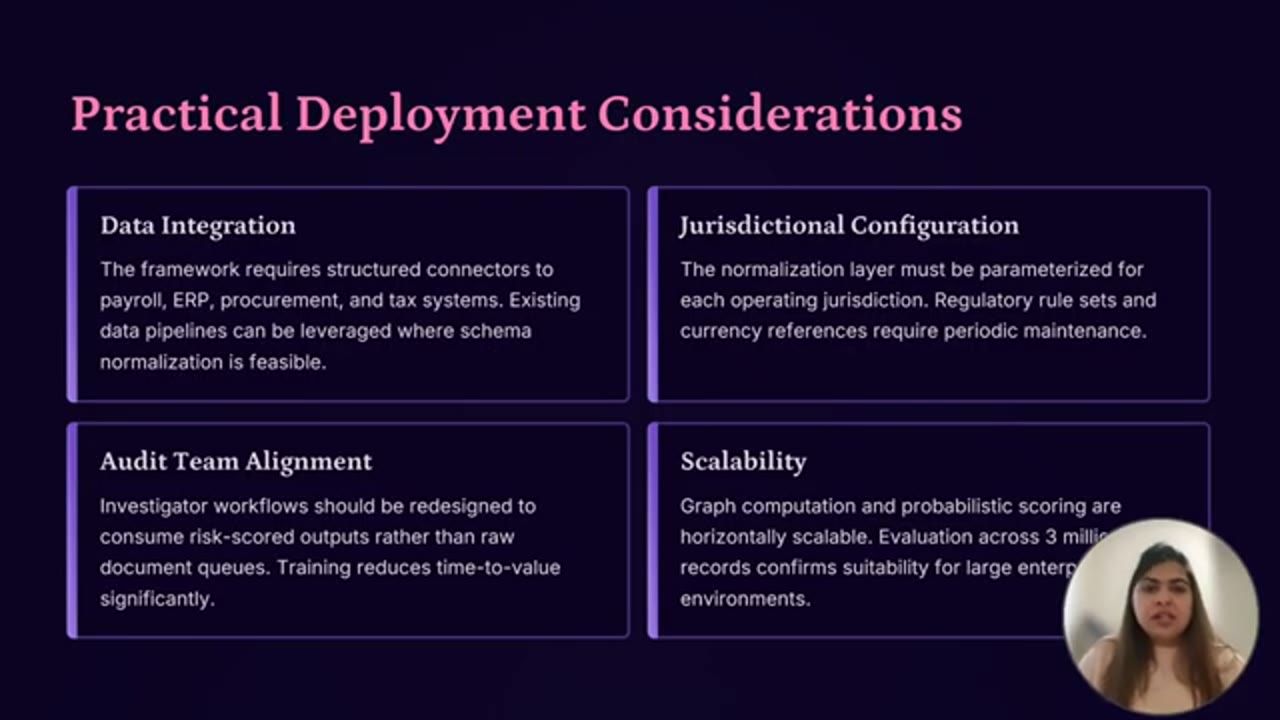
Dù framework xuất phát từ nghiên cứu, Varsha nói nó được thiết kế với việc deploy trong doanh nghiệp ngay từ đầu. Triển khai thành công phụ thuộc vào bốn điều cần cân nhắc:
- Tích hợp liền mạch với các hệ thống sẵn có của doanh nghiệp, như ERP, payroll, procurement và các nền tảng thuế.
- Cấu hình riêng cho từng jurisdiction, để đảm bảo tuân thủ quy định và chuẩn báo cáo địa phương.
- Khớp với audit framework, để điều tra viên tập trung vào các ca đã được chấm điểm rủi ro và xếp ưu tiên, thay vì review tài liệu thủ công.
- Khả năng mở rộng (scalability). Kết quả đánh giá cho thấy framework xử lý hiệu quả hàng triệu record tài chính, phù hợp cho môi trường doanh nghiệp lớn.
Gộp lại, theo cô, bốn điều này giúp lấp khoảng cách giữa nghiên cứu và việc doanh nghiệp áp dụng trong thực tế.
15. Bốn key takeaway và lời kết
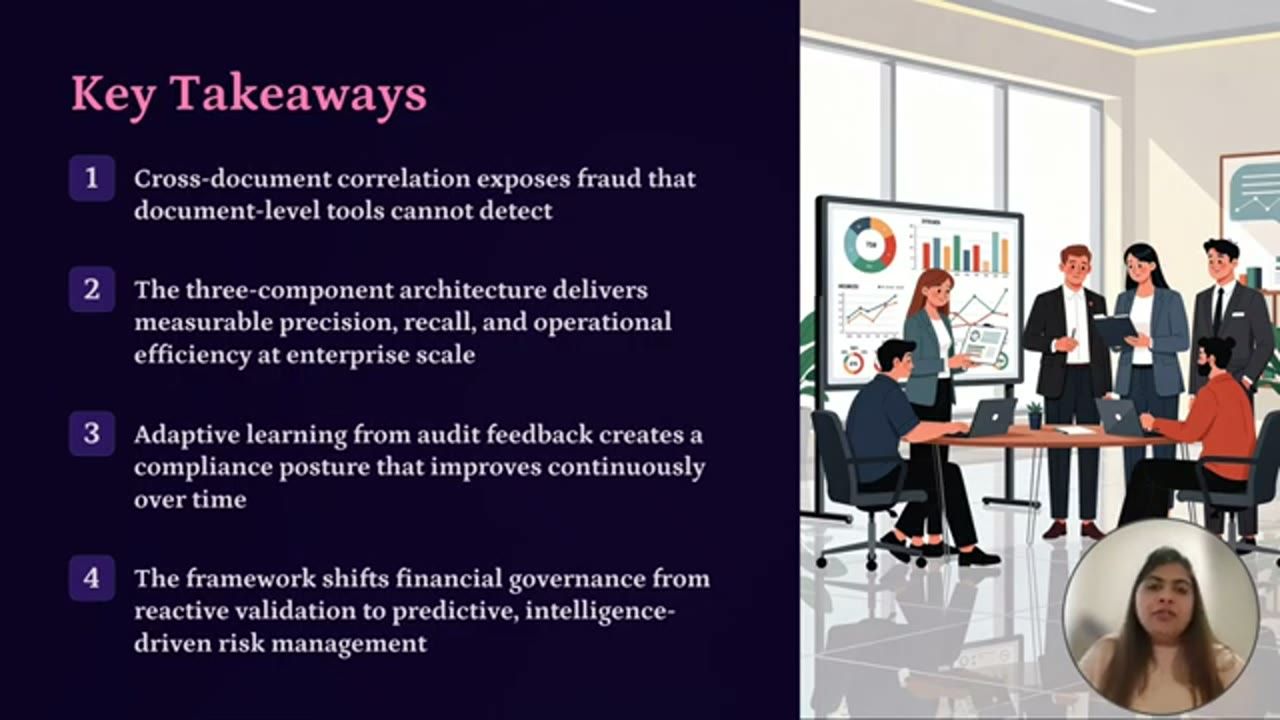
Để kết thúc, Varsha để lại bốn key takeaway:
- Nhiều rủi ro compliance và gian lận đáng kể nhất hiện nay nằm giữa các tài liệu, không nằm trong chúng. Phát hiện được các rủi ro này đòi hỏi vượt khỏi phân tích ở mức tài liệu để tiến tới cross-document intelligence.
- Kết hợp graph-based entity correlation, probabilistic risk modeling và cross-jurisdictional normalization tạo ra một cách tiếp cận compliance doanh nghiệp toàn diện hơn và dễ mở rộng hơn.
- Kết quả cho thấy framework này không chỉ tăng độ chính xác phát hiện, mà còn giảm false positive và giảm đáng kể công sức audit thủ công, mang lại giá trị vận hành đo được.
- Bằng cách học liên tục từ kết quả audit, framework giúp các tổ chức đi từ compliance kiểu phản ứng sang quản trị rủi ro mang tính dự báo, dựa trên intelligence.
Varsha tin rằng đây là một bước quan trọng hướng tới tương lai của quản trị tài chính doanh nghiệp, nơi AI không chỉ giúp các tổ chức phát hiện rủi ro, mà còn lường trước và ngăn chặn rủi ro về sau.
Cô cảm ơn một lần nữa đội ngũ AI Engineer World's Fair vì cơ hội tuyệt vời này và cảm ơn mọi người đã dành thời gian lắng nghe. Cô mời mọi người liên hệ với câu hỏi và sự hứng thú của mình, hoặc kết nối với cô trên LinkedIn. Nếu bạn đang xây những hệ thống như vậy cho compliance bằng AI và muốn chuyển đổi chúng, cô sẵn lòng giúp. Cô cảm ơn mọi người lần nữa và hẹn gặp lại lần sau.
Nguồn và liên kết
- Trang talk chính thức: ai.engineer/talks/Iwe_RY-fYgI
- Varsha Shah trên GitHub: github.com/VarshaShahTech · LinkedIn: linkedin.com/in/varsha-shah-7b5111247
- Tata Consultancy Services: tcs.com
- Định nghĩa precision, recall: Wikipedia, Precision and recall · F1: Wikipedia, F-score
- Knowledge graph: Wikipedia, Knowledge graph
Related talks
Production Evals For Agentic AI Systems
Nishant Gupta · Meta · 8 min
Eval cho agent phải đo hành vi cả hệ thống: scenario offline, production telemetry, human review, drift, trace và metric reliability gắn với kết quả kinh doanh.
The Miranda Hypothesis: How Hamilton (the Musical) Poisoned Your Persona Evals
Jacob E. Thomas · Results Generation · 58 min
Vì sao persona eval chấm fluency không bắt được persona ghép lẫn văn hoá sai thời đại, và instrument pre-registered với nhà sử học để đo fidelity.
User Signal Dies at the Retrieval Boundary
Sonam Pankaj · StarlightSearch · 16 min
Vì sao tín hiệu eval chết trong dashboard, và cách dùng utility score để re-rank memory theo outcome, giúp agent tự cải tiến lúc runtime.