EmbeddingGemma 2: RAG đa phương thức chạy được trên điện thoại
EmbeddingGemma 2 đặt text, ảnh, video, âm thanh vào một vector space: cách model hoạt động, Matryoshka, modular loading, và notebook Colab đo thật.
✓ Đã duyệt độc lập · cập nhật 23/10/2026 · 19 min
1. EmbeddingGemma 2: một không gian vector cho mọi loại dữ liệu
Muhammad mở đầu bằng tin Google vừa phát hành EmbeddingGemma 2 (video đăng ngày 07/10/2026). Theo anh, đây là một tin lớn với những ai quan tâm tới multimodal retrieval augmented generation. Anh mô tả đây là một embedding model nhỏ và mở (open), đặt văn bản, code, hình ảnh, video và âm thanh vào cùng một vector space. Và theo anh, nó đủ nhỏ để thật sự chạy được trên điện thoại (video đăng ngày 07/10/2026).
google/embeddinggemma-2 trên Hugging Face với các tag như sentence-transformers, multilingual, multimodal-embedding, vision, audio, video và License: apache-2.0 (video đăng ngày 07/10/2026).Theo Muhammad (video đăng ngày 07/10/2026), điều này sẽ mở ra rất nhiều khả năng cho developer. Phần anh thích nhất là model không chỉ dùng cho retrieval: theo anh, bạn có thể làm classification và clustering trên nhiều modality khác nhau bằng đúng một model. Trong video, anh muốn cho xem những khả năng khác nhau mà EmbeddingGemma 2 mang lại. Phần mô tả video tóm tắt model có 740M parameter và license Apache 2.0, và model card trên Hugging Face cũng ghi đúng như vậy (đọc ngày 23/10/2026).
2. Demo nhanh: tìm ảnh bằng giọng nói
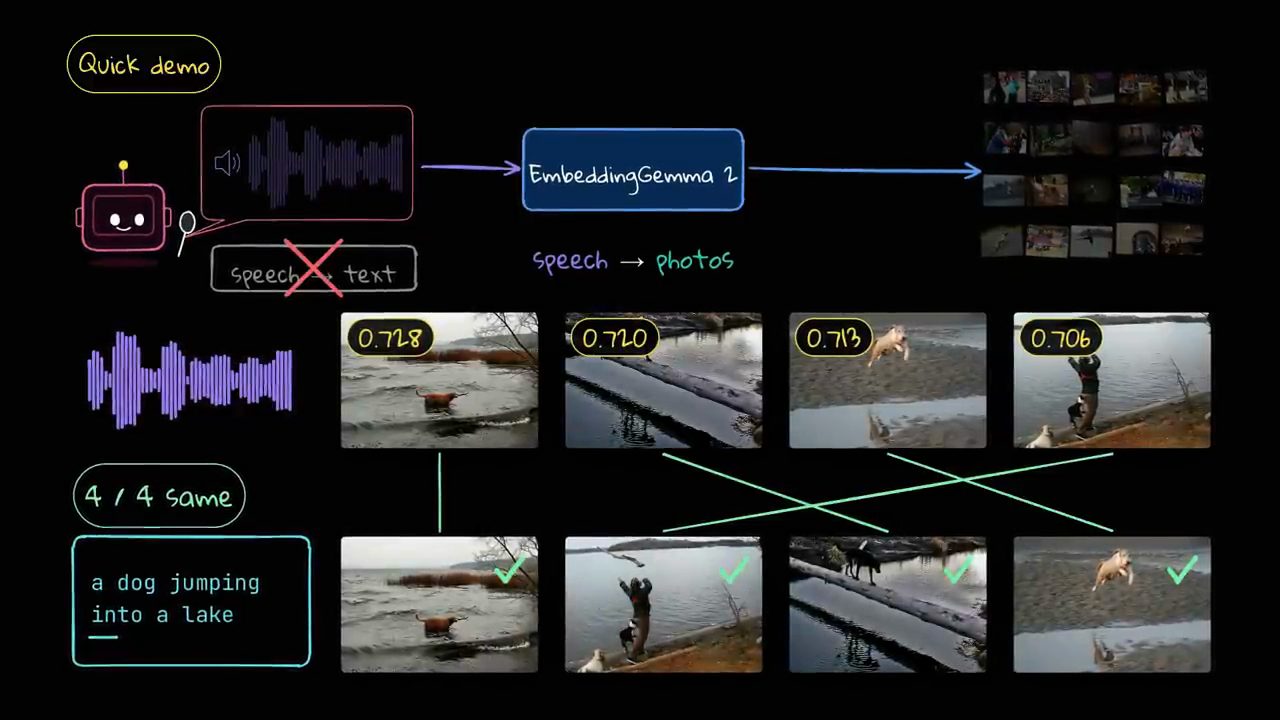
Trước khi giải thích cách model hoạt động, Muhammad cho xem một demo ngắn. Một giọng nói đọc câu "A dog jumping into a lake" (một con chó nhảy xuống hồ). Theo anh, demo này cho thấy cross-modality search: đoạn lời nói đi thẳng vào model, và model trả về bốn tấm ảnh. Bốn tấm đó cũng chính là bốn tấm anh nhận được nếu gõ đúng câu đó bằng chữ. Không cần bước chuyển lời nói thành văn bản (speech-to-text) nào ở giữa (demo trong video đăng ngày 07/10/2026).
Sau đó anh nói rõ lộ trình của video: vì sao multimodal retrieval quan trọng, trước đây người ta giải bài toán này thế nào, model này hoạt động ra sao bên trong, và cuối cùng là đi qua một notebook Colab mà bạn tự chạy được trên GPU miễn phí (theo video đăng ngày 07/10/2026).
3. Vì sao RAG cần multimodal retrieval
Muhammad bắt đầu bằng câu hỏi: tại sao bạn lại cần một thứ như thế này? Theo anh (video đăng ngày 07/10/2026), phần lớn hệ thống RAG, tức Retrieval Augmented Generation, mà chúng ta build ngày nay đều dựa riêng trên text search. Bạn lấy tài liệu, chia thành các chunk, biến mỗi chunk thành một embedding, và khi có câu hỏi, bạn tìm những chunk gần câu hỏi nhất trong embedding space đó.
Nhưng anh bảo hãy nghĩ xem phần lớn dữ liệu của chúng ta thật ra nằm ở đâu: ảnh trên điện thoại, bản quay màn hình, voice memo, ghi chú cuộc họp, slide deck, tài liệu scan. Theo anh (video đăng ngày 07/10/2026), một hệ retrieval chỉ đọc text thì không cách nào "nhìn thấy" những dữ liệu đó.
Anh đưa ví dụ: bạn muốn tìm một clip trong đó con chó của bạn bắt đĩa frisbee, và trong video không hề có chữ nào. Một hệ retrieval dựa trên text sẽ không tìm được đúng video đó cho bạn. Theo anh, điều này cũng áp dụng cho agent, vì memory của một agent chỉ tốt bằng những gì nó retrieve được. Vì vậy, theo Muhammad (video đăng ngày 07/10/2026), multimodal retrieval là thứ rất quan trọng với các ứng dụng dựa trên search.
4. Cách cũ thứ nhất: biến mọi thứ thành văn bản
Tiếp theo, Muhammad kể người ta đã giải bài toán này thế nào. Theo anh (video đăng ngày 07/10/2026), cách phổ biến nhất là biến mọi thứ thành văn bản trước. Bạn chạy một captioning model trên từng tấm ảnh, một model speech-to-text trên từng file âm thanh, rồi đem văn bản đó đi embed.
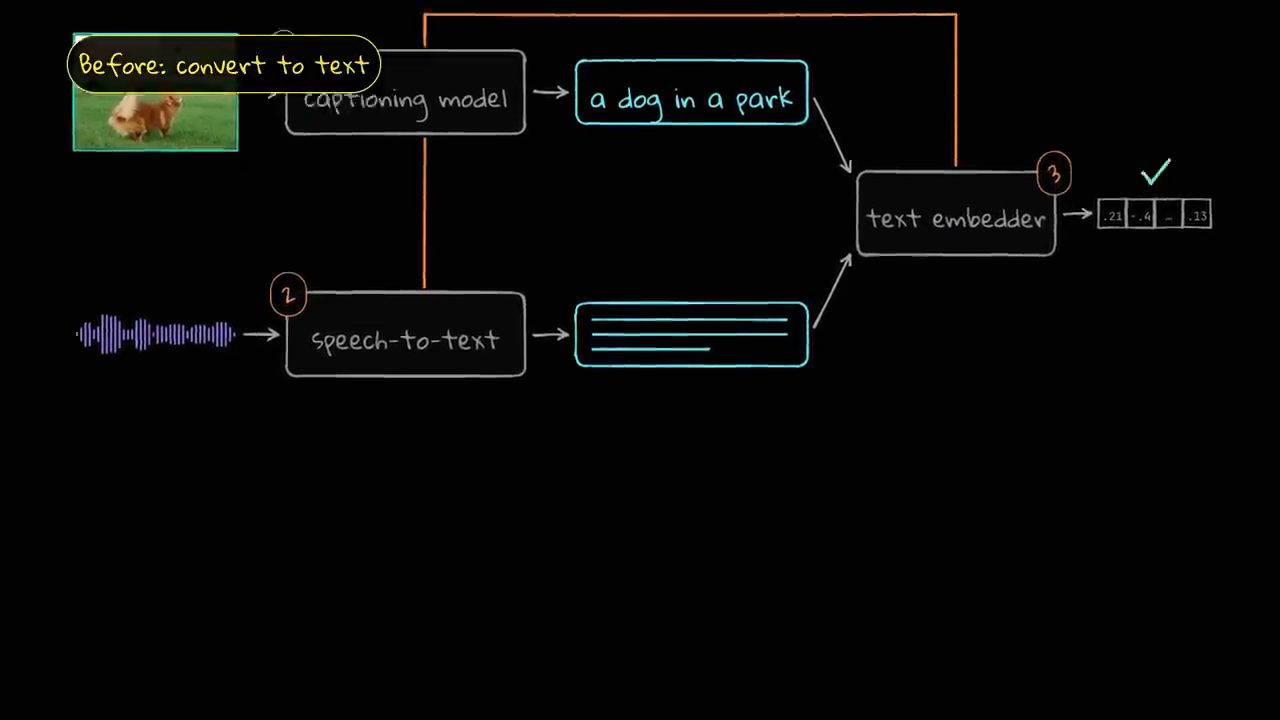
Cách này chạy được, nhưng giờ bạn có ba model nối thành chuỗi. Và vấn đề lớn hơn, theo anh (video đăng ngày 07/10/2026), là bạn chỉ tìm được những gì mà caption hoặc bản chép lời đã ghi ra. Ví dụ, nếu captioner viết "a dog in the park" (một con chó trong công viên) mà không hề nhắc tới đĩa frisbee, thì search của bạn sẽ không trả về clip đó.
Muhammad dẫn bài báo của Google về Gemini Embedding 2, model lớn hơn mà Google cung cấp qua API, vì bài báo này đo đúng hiện tượng đó với âm thanh. Theo số liệu trong bài báo mà anh trích (video đăng ngày 07/10/2026), embed trực tiếp âm thanh đạt 73.99 trên benchmark sound retrieval của họ, so với 70.40 khi họ embed văn bản chép lại từ âm thanh thay cho chính âm thanh.
5. Cách cũ thứ hai: CLIP, ImageBind và ColPali
Hướng thứ hai, theo Muhammad, đến từ CLIP năm 2021. Bạn train hai model riêng biệt, một cho ảnh và một cho văn bản, sao cho một tấm ảnh và caption của nó nằm rất gần nhau. Theo anh (video đăng ngày 07/10/2026), cách này làm text-to-image search trở nên rất tốt, nhưng nó chỉ bao một cặp modality, và nó được train trên những caption ngắn.
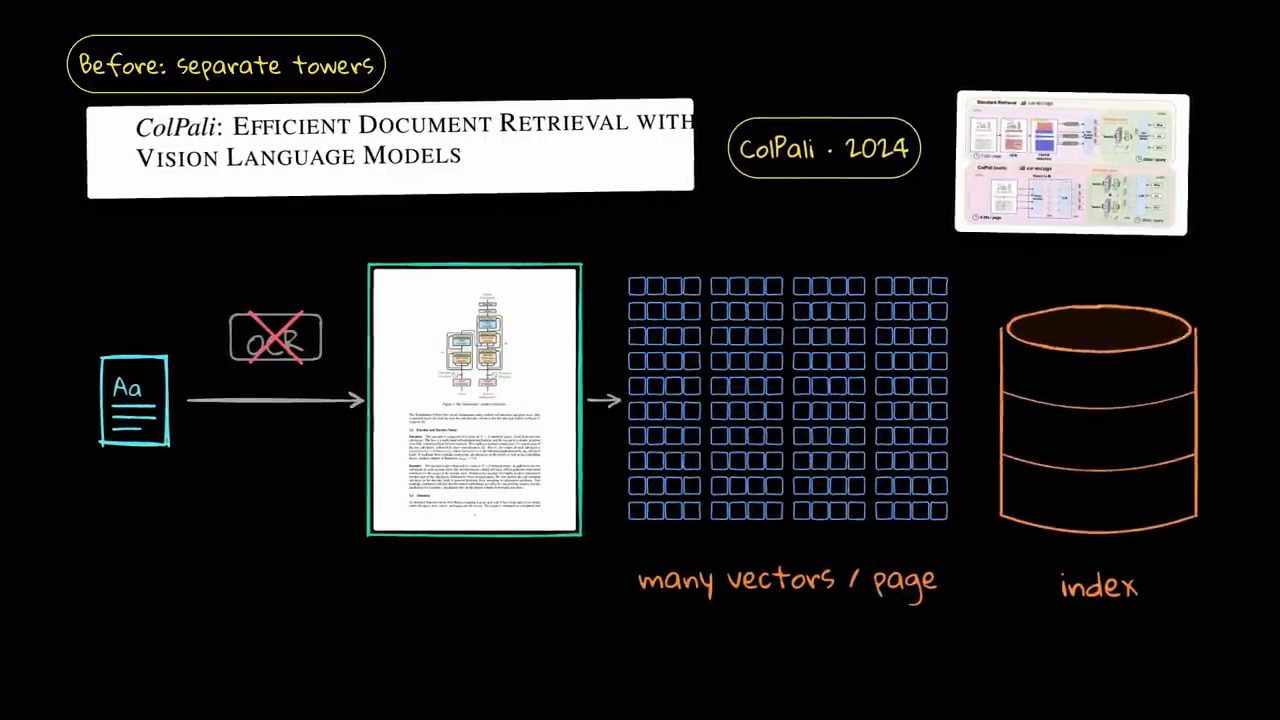
Rồi năm 2023, ImageBind của Meta mở rộng ý tưởng đó ra sáu modality, bằng cách căn chỉnh (align) từng modality với ảnh. Với tài liệu, ColPali bắt đầu embed trực tiếp ảnh chụp các trang, bỏ qua bước OCR. Nhưng theo anh (video đăng ngày 07/10/2026), ColPali lưu nhiều vector cho mỗi trang, nên index phình to rất nhanh. Anh có vài video về ColPali trên kênh.
Hướng mới nhất, theo Muhammad, là một model với một backbone duy nhất đọc được mọi modality. Gemini Embedding 2 của Google hoạt động theo cách này, nhưng đó là model dùng qua API. Và đây là chỗ EmbeddingGemma 2 xuất hiện: theo anh (video đăng ngày 07/10/2026), nó đưa cùng thiết kế đó xuống dưới một tỷ parameter, với open weights.
6. Bên trong model: embedding, encoder và token
Muhammad nhắc lại nhanh khái niệm. Một embedding về cơ bản là một danh sách số, nắm lấy ý nghĩa của một đầu vào. Những đầu vào có nghĩa giống nhau sẽ có các con số giống nhau, nên bạn so sánh được ý nghĩa thay vì so từng chữ.
Một model đọc văn bản thì không đọc trực tiếp được pixel hay sóng âm. Vì thế, theo anh (video đăng ngày 07/10/2026), EmbeddingGemma 2 có hai encoder nhỏ đặt phía trước. Vision encoder, 170 triệu parameter, nhận một tấm ảnh hoặc một frame video và biến nó thành token. Audio encoder, 300 triệu parameter, làm điều tương tự với âm thanh. Các token đó đi vào cùng chuỗi với token văn bản. Nên từ góc nhìn của model, một tấm ảnh chỉ là thêm vài trăm token trong đầu vào.
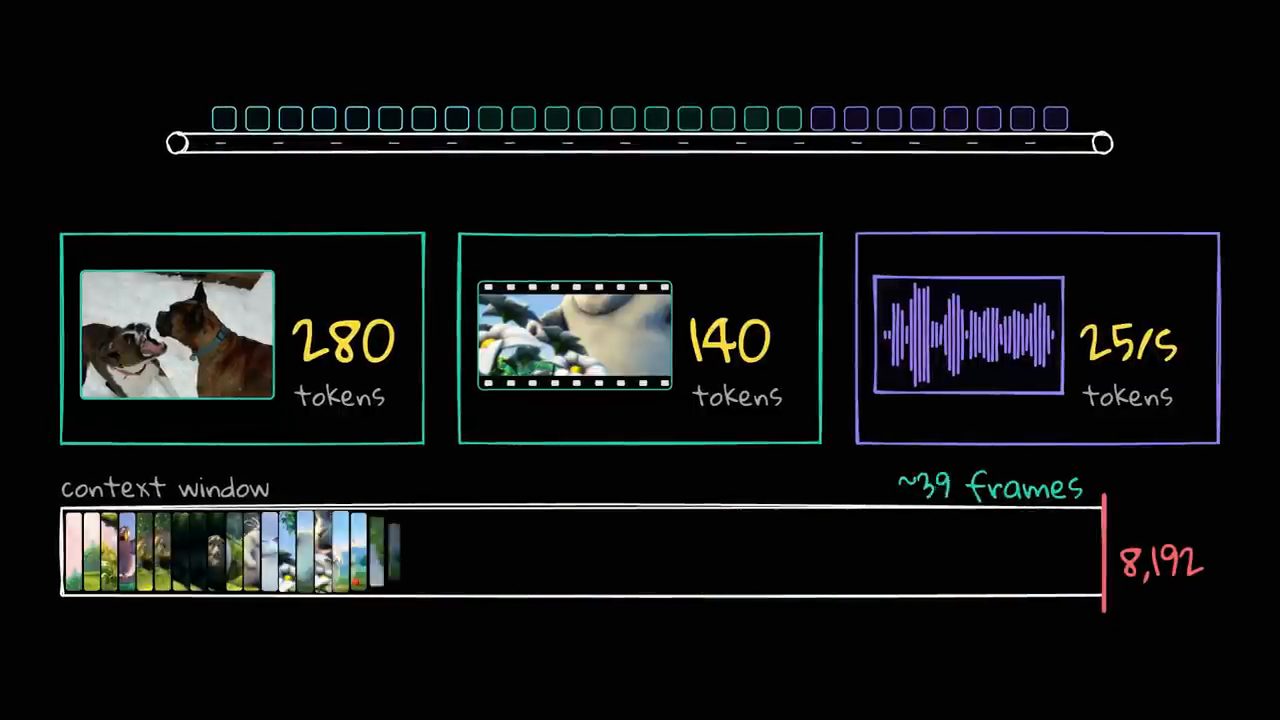
Theo Muhammad (video đăng ngày 07/10/2026), mặc định một tấm ảnh tốn 280 token, một frame video tốn 140 token, và một giây âm thanh tốn khoảng 25 token. Context window là 8192 token, nên một đầu vào chứa được khoảng 29 ảnh, khoảng 58 frame video, hoặc khoảng năm phút rưỡi âm thanh.
Đó cũng là cách bạn có được đầu vào trộn (mixed input), theo anh: bạn lấy một trang sản phẩm gồm phần mô tả, một tấm ảnh và một video ngắn, rồi embed tất cả vào một vector duy nhất. Muhammad gọi đó là một điểm cực kỳ hay (video đăng ngày 07/10/2026).
7. Một backbone chung, mean pooling và contrastive training
Theo Muhammad (video đăng ngày 07/10/2026), cái hay là tất cả những thứ này đi qua một backbone dùng chung: một text model 270 triệu parameter dựa trên Gemma 4. Ở cuối, model lấy trung bình output của mọi token thành một vector, bước này gọi là mean pooling, rồi chiếu (project) vector đó thành 768 con số, tức 768 dimension.
Vậy làm sao một tấm ảnh chim hồng hạc lại nằm cạnh một câu văn nói về chim hồng hạc? Muhammad lưu ý Google chưa công bố technical report cho model này, nhưng Google nói nó được build từ cùng công nghệ với Gemini Embedding (theo video đăng ngày 07/10/2026).
Bài báo về các model Gemini Embedding mô tả contrastive training. Bạn cho model xem những cặp thuộc về nhau, như một tấm ảnh và caption của nó, hay một clip và lời nói trong clip, rồi train để kéo các cặp đó lại gần nhau và đẩy mọi thứ khác trong batch ra xa. Nếu lặp quá trình này trên một bộ dữ liệu trộn khổng lồ, theo anh, bạn sẽ thấy mọi modality cuối cùng nằm trên cùng một tấm bản đồ chung (video đăng ngày 07/10/2026).
8. Núm deploy thứ nhất: Matryoshka embeddings
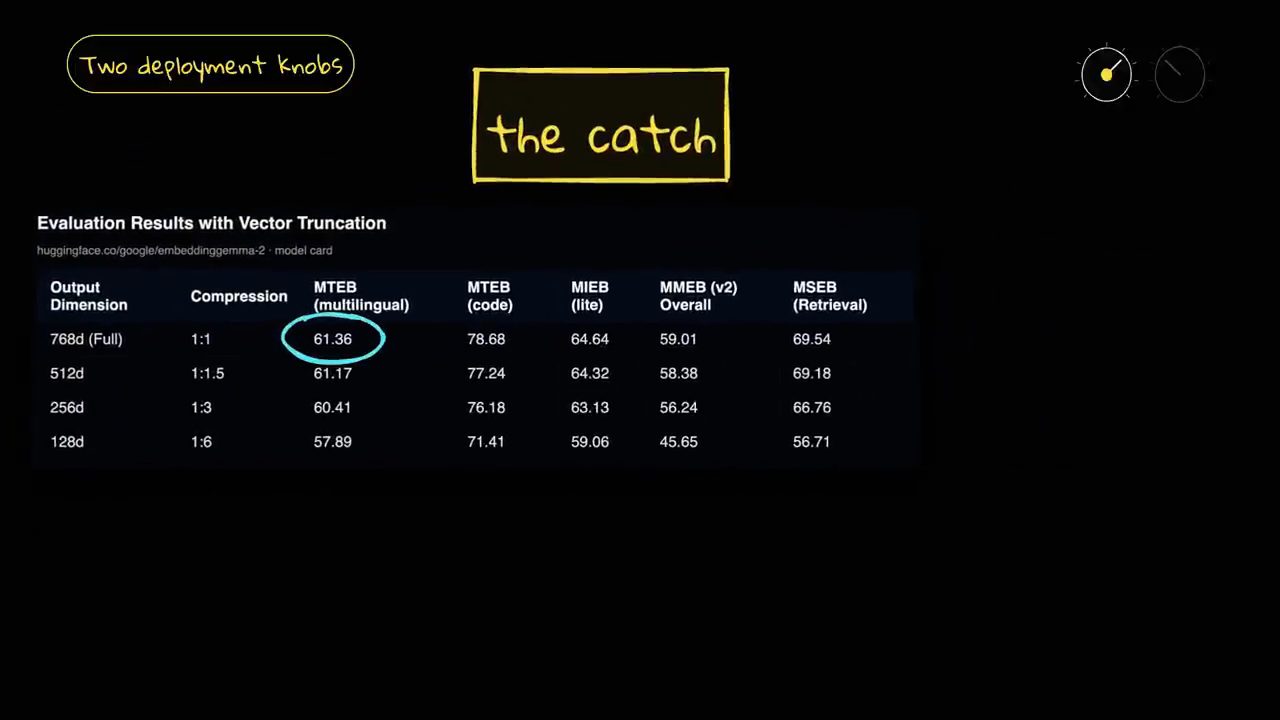
Muhammad nói có thêm hai lựa chọn thiết kế quan trọng khi bạn muốn đưa model này lên production. Lựa chọn thứ nhất là Matryoshka representation learning. Theo anh (video đăng ngày 07/10/2026), model được train sao cho 512, 256, hay thậm chí chỉ 128 con số đầu tiên (tức 128 dimension đầu) vẫn hoạt động như một embedding riêng. Nói cách khác, bạn cắt vector thành số dimension nhỏ hơn mà nó vẫn chạy được.
Vector nhỏ hơn nghĩa là index nhỏ hơn. Ở 128 con số, bạn lưu ít hơn sáu lần. Nhưng có một cái "catch". Theo bảng của chính Google mà Muhammad đưa lên (video đăng ngày 07/10/2026), điểm văn bản gần như không đổi ở 128 dimension, trong khi điểm multimodal giảm từ khoảng 59 xuống còn khoảng 46. Anh hứa sẽ cho xem ví dụ về chuyện này trong notebook.
9. Núm deploy thứ hai: modular loading, từ 270M đến 740M
Lựa chọn thứ hai là modular loading. Theo Muhammad (video đăng ngày 07/10/2026), vision encoder và audio encoder là tuỳ chọn. Nếu bạn chỉ có văn bản và code, bạn nạp 270 triệu parameter. Thêm vision thì anh nói là 490 triệu, nhưng bảng trên màn hình lúc đó và model card trên Hugging Face (đọc ngày 23/10/2026) ghi 440M, đúng bằng 270M cộng 170M của vision encoder. Nếu thêm audio thay vì vision thì là 570 triệu parameter. Model đầy đủ là 740 triệu.
Tất cả các cấu hình này dùng chung một vector space. Nên theo anh (video đăng ngày 07/10/2026), bạn có thể index ảnh một lần bằng model đầy đủ rồi search chúng từ điện thoại bằng một bản nhỏ. Với quantization, theo con số Google đưa ra mà anh trích, bản chỉ có text cần khoảng 191 MB RAM trên một chiếc Pixel 11 Pro, và model đầy đủ cần khoảng 567 MB. Bài hướng dẫn on-device của Google ghi đúng hai con số này (đọc ngày 23/10/2026).
Theo Muhammad (video đăng ngày 07/10/2026), cái hay là model này tốt hơn nhiều so với EmbeddingGemma đời trước, và có khả năng retrieval khá mạnh so với một số model lớn hơn trong cùng mảng. Anh để link tới các benchmark trong phần mô tả video cho ai quan tâm.
Đến đây anh nói phần lý thuyết đã đủ, giờ mở notebook để xem model chạy ngoài thực tế ra sao, kể cả những chỗ nó chạy không tốt lắm (video đăng ngày 07/10/2026).
10. Notebook Colab: setup và hai gotcha
Muhammad mở notebook Colab dùng cho phần thực hành. Theo anh (video đăng ngày 07/10/2026), notebook chạy trên GPU T4 miễn phí của Colab trong khoảng 15 phút. Tên notebook trên màn hình là EmbeddingGemma2_Multimodal_Retrieval.ipynb.
Đầu tiên là setup. Trong video đăng ngày 07/10/2026, cell đầu cài sentence-transformers với các extra cho image và video. Cell trên màn hình:
!pip install -q -U "sentence-transformers[image,video]>=6.1.0" transformers torchcodec gTTS pymupdf
Muhammad kể hai gotcha anh gặp ở bước này (video đăng ngày 07/10/2026). Thứ nhất, extra video không cài torchcodec, và không có nó thì decode video bị lỗi, nên anh phải tự thêm torchcodec vào. Thứ hai, anh bỏ extra audio, vì nó kéo theo một bản NumPy cũ hơn mà pip phải compile từ source trên Colab mất vài phút. Theo anh, phần audio vẫn chạy tốt khi không có extra đó. Anh dặn hãy nhớ điều này nếu bạn gặp lỗi ở đây.
Sau đó là nạp model, và theo anh đây là phần quan trọng: đừng chạy model này ở float16. Theo Muhammad, model card ghi rằng activation của nó bị overflow, và thay vì báo lỗi, bạn nhận về NaN hoặc embedding sai. Theo anh, T4 không hỗ trợ native kiểu số thực 16-bit này, nên ở đây anh dùng float32 (comment trong cell ghi bfloat16 cần GPU Ampere trở lên, mà T4 có compute capability 7.5). Trên GPU mới hơn, anh dùng bfloat16 và nó chạy được (video đăng ngày 07/10/2026). Model card ghi: chạy inference bằng bfloat16 hoặc float32, không dùng float16, vì ở float16 model trả về NaN (đọc ngày 23/10/2026).
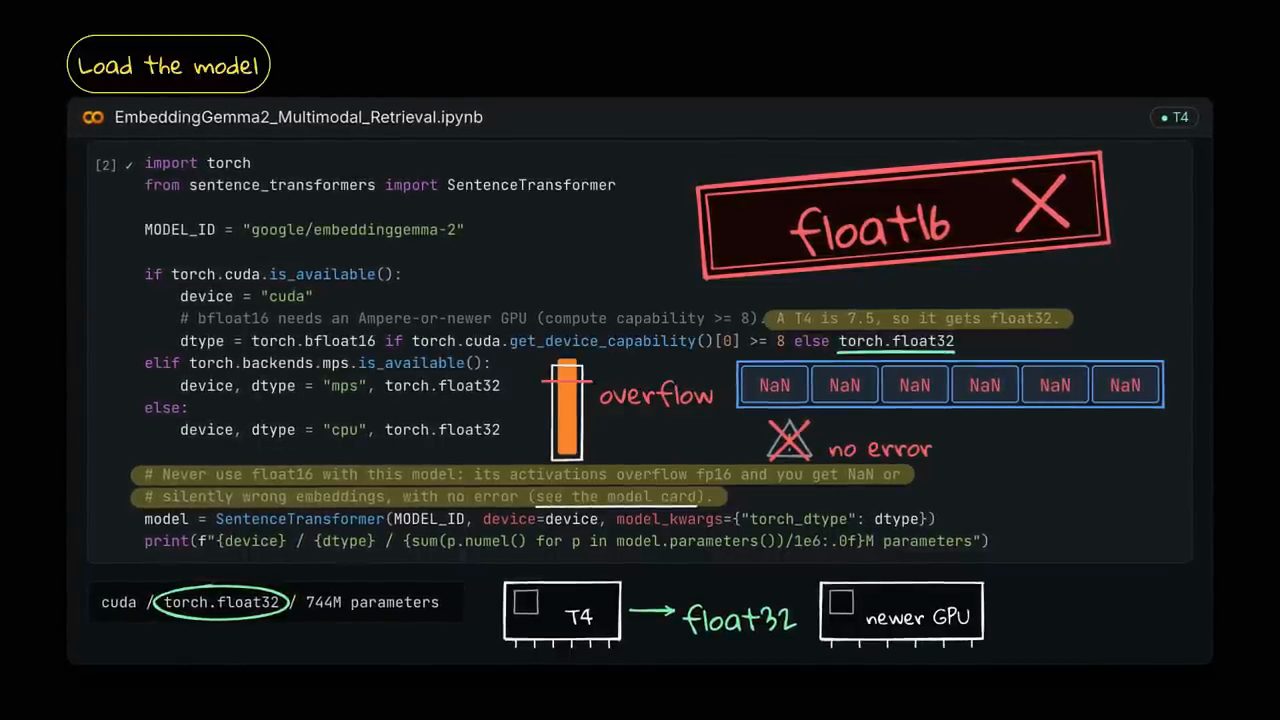
cuda / torch.float32 / 744M parameters, và hình vẽ cho thấy T4 dùng float32 còn GPU mới hơn thì khác (chạy trong video đăng ngày 07/10/2026).Code của cell này trên màn hình:
import torch
from sentence_transformers import SentenceTransformer

MODEL_ID = "google/embeddinggemma-2"

if torch.cuda.is_available():
    device = "cuda"
    # bfloat16 needs an Ampere-or-newer GPU (compute capability >= 8). A T4 is 7.5, so it gets float32.
    dtype = torch.bfloat16 if torch.cuda.get_device_capability()[0] >= 8 else torch.float32
elif torch.backends.mps.is_available():
    device, dtype = "mps", torch.float32
else:
    device, dtype = "cpu", torch.float32

# Never use float16 with this model: its activations overflow fp16 and you get NaN or
# silently wrong embeddings, with no error (see the model card).
model = SentenceTransformer(MODEL_ID, device=device, model_kwargs={"torch_dtype": dtype})
print(f"{device} / {dtype} / {sum(p.numel() for p in model.parameters())/1e6:.0f}M parameters")
Về dữ liệu, Muhammad dùng bốn nguồn: 1.000 tấm ảnh Flickr, mỗi ảnh đi kèm năm caption do người viết tay; 50 đoạn âm thanh đời thường từ bộ dữ liệu ESC-50; năm phút đầu của phim mở Big Buck Bunny; và bài báo "Attention Is All You Need" ở dạng PDF. Đây là các modality khác nhau mà anh sẽ thử nghiệm.
11. Một không gian chung: sáu khái niệm, ba modality
Muhammad bắt đầu từ ý cốt lõi của phần lý thuyết. Anh lấy sáu khái niệm, như một con chó, một em bé đang khóc, sóng biển (trên màn hình còn có nhà thờ, tàu hoả và lửa), và mỗi khái niệm tồn tại dưới ba dạng: một câu văn, một tấm ảnh và một âm thanh. Nếu mọi thứ thật sự nằm trong một không gian như mô tả (theo phần lý thuyết của video đăng ngày 07/10/2026), thì các cặp khớp nhau phải có điểm cao nhất, và điều đó hiện ra thành một đường chéo sáng trên heatmap.
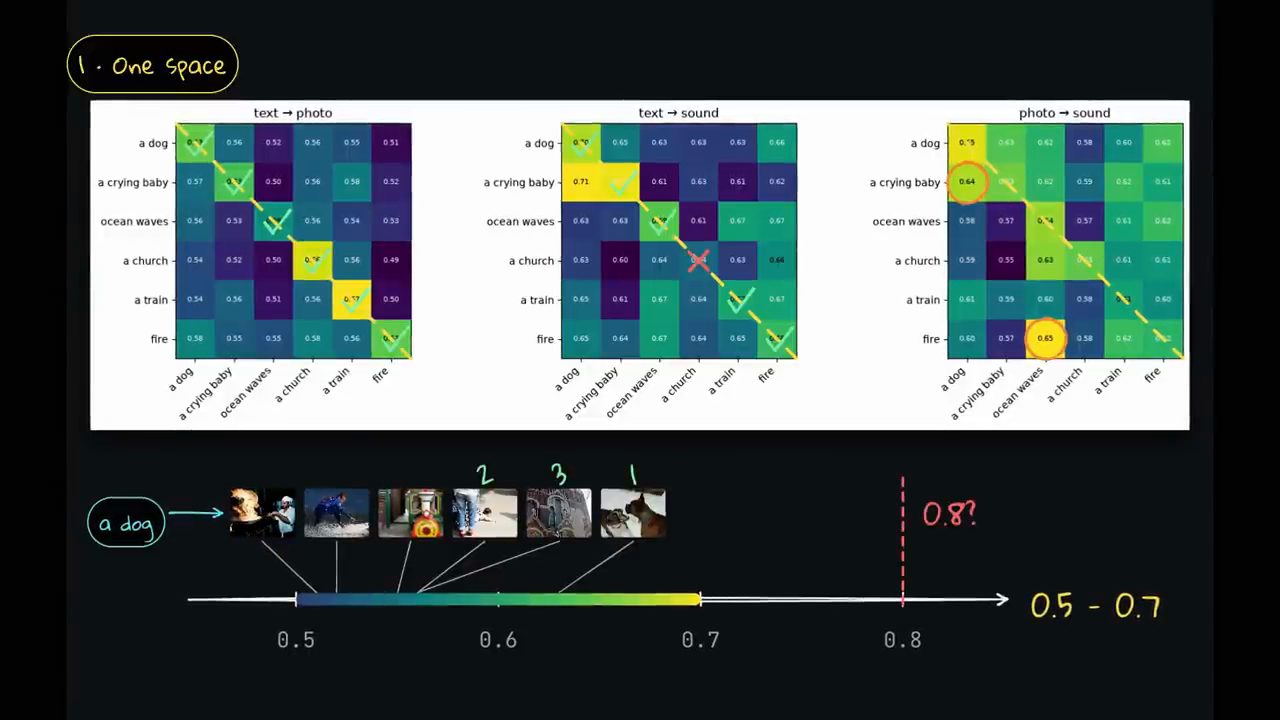
Theo kết quả anh chạy (video đăng ngày 07/10/2026), text sang photo là một đường chéo gọn gàng, text sang sound đúng phần lớn, còn photo sang sound là nhiễu nhất. Theo anh, điều đó cũng hợp lý, vì nó so trực tiếp một tấm ảnh với một đoạn âm thanh mà không có văn bản nào ở giữa. Anh dặn hãy nhớ điểm này, vì âm thanh sẽ quay lại sau với vài kết quả rất thú vị.
Anh cũng lưu ý tất cả các điểm này chỉ nằm trong khoảng 0.5 đến 0.7 (theo số đo của Muhammad, video đăng ngày 07/10/2026). Vì vậy hãy dùng điểm để xếp hạng kết quả, và đừng chọn một ngưỡng cắt cố định trừ khi bạn đã thử trên dữ liệu của chính mình. Theo anh, việc chọn ngưỡng có thể ảnh hưởng mạnh tới kết quả bạn nhận được.
12. Photo search và đo recall trên 5.000 câu hỏi
Tiếp theo là photo search, lần này với một index thật. Mỗi tấm ảnh được embed một lần, và đó là phần chậm: theo số đo của Muhammad (video đăng ngày 07/10/2026), mất khoảng tám phút trên T4. Sau đó, mỗi lần search chỉ là một lần embed văn bản và một phép so sánh. Cell tạo index trên màn hình:
photo_index = model.encode([{"image": p} for p in photo_paths], batch_size=16, show_progress_bar=True)
photo_index.shape
Anh quay lại ví dụ từ đầu video, "a dog catching a frisbee" (một con chó bắt đĩa frisbee). Trong kết quả, hai ảnh đầu đều có đĩa frisbee đang bay trên không (kết quả trong video đăng ngày 07/10/2026).
Nhưng vài ví dụ đẹp thì không nói lên nhiều, nên anh đo. Mỗi tấm ảnh có năm caption do người viết, tức là có 5.000 câu hỏi mà ta biết đáp án đúng. Theo số đo của Muhammad (video đăng ngày 07/10/2026), trong 1.000 tấm ảnh, ảnh đúng xuất hiện ở vị trí đầu tiên khoảng 86% số lần, và nằm trong top 5 khoảng 97% số lần. Màn hình in kết quả 'R@1': 0.8636, 'R@5': 0.975.
Theo anh (video đăng ngày 07/10/2026), với một model cỡ này thì kết quả đó khá ấn tượng. Anh giải thích thêm: trong retrieval, người ta thường không chỉ lấy kết quả đứng đầu mà dùng top K, với K là 5 hoặc 10. Và ở top 5, kết quả này khá tốt. Đoạn code đo recall trên màn hình dùng một hàm recall_at với ks=(1, 5), encode các caption bằng prompt_name="SearchQuery".
13. Hơn 100 ngôn ngữ, và dùng ảnh làm câu hỏi
Theo Muhammad (video đăng ngày 07/10/2026), phía văn bản của model hiểu hơn 100 ngôn ngữ vì Gemma là model đa ngôn ngữ. Anh thử hai câu, một tiếng Đức và một tiếng Tây Ban Nha:
for q in ["ein Hund, der im Schnee rennt", "una mujer tocando la guitarra"]:   # German, Spanish
    hits = top_k(model.encode(q, prompt_name="SearchQuery"), photo_index, k=4)
    print(q); show_images([photo_paths[i] for i, _ in hits], [f"{s:.3f}" for _, s in hits], size=2.6)
Câu tiếng Đức "một con chó chạy trong tuyết" trả về các ảnh chó trong tuyết. Với câu tiếng Tây Ban Nha "một người phụ nữ chơi guitar", hai ảnh đầu đúng, còn ảnh thứ ba là một người phụ nữ chơi đàn hạc (harp). Anh nhận xét: gần, nhưng chưa hẳn (kết quả trong video đăng ngày 07/10/2026).
Cái hay, theo anh, là câu hỏi cũng không nhất thiết phải là văn bản. Khi anh dùng một tấm ảnh người lướt sóng làm query, kết quả trả về là thêm hai ảnh lướt sóng, rồi tới ảnh người lướt ván kéo (wakeboarding). Theo Muhammad (video đăng ngày 07/10/2026), như vậy model khớp được ý "người cưỡi ván trên mặt nước", chứ không chỉ khớp màu xanh, và anh thấy điều đó rất ấn tượng. Theo anh, bạn có thể build một hệ search riêng tư trên chính thư viện ảnh của mình.
14. Voice search và sound search: chỗ model còn yếu
Tiếp theo là voice search, chính là demo ở đầu video. Muhammad tạo một câu hỏi bằng giọng nói, "a dog jumping into a lake", rồi đưa thẳng đoạn audio vào model, không có bước chép lời nào. Trên màn hình, giọng nói được tạo bằng gTTS, và code gọi model.encode({"audio": clip}). Theo kết quả anh chạy (video đăng ngày 07/10/2026), bốn ảnh trả về là cùng bốn ảnh khi anh gõ câu đó bằng chữ. Điều tương tự xảy ra với câu "a little girl on a swing" (một bé gái trên xích đu). Theo anh, model thật sự đang search chéo trong cùng một không gian.
Giờ đến chỗ model yếu hơn. Muhammad lấy 50 âm thanh đời thường, mỗi loại một clip, và với mỗi tên âm thanh, anh kiểm tra xem clip của nó có về đầu tiên không. Theo số đo của anh (video đăng ngày 07/10/2026), điều đó xảy ra 24% số lần. Đoán ngẫu nhiên thì được 2%. Vậy là model có nắm được gì đó, nhưng còn xa mức 86% đã thấy với ảnh, nhất là ở K bằng 1 (pass@1). Trên màn hình, top-5 là 56%, so với 10% nếu đoán ngẫu nhiên.
Trong các ví dụ cụ thể, "someone laughing" (ai đó đang cười) tìm ra đúng clip tiếng cười, và "a toilet flushing" (tiếng xả bồn cầu) tìm ra đúng tiếng bồn cầu. Nhưng "a dog barking" (chó sủa) lại về "crow" (con quạ), còn "rain falling" (mưa rơi) về "wind" (gió) (kết quả trong video đăng ngày 07/10/2026).
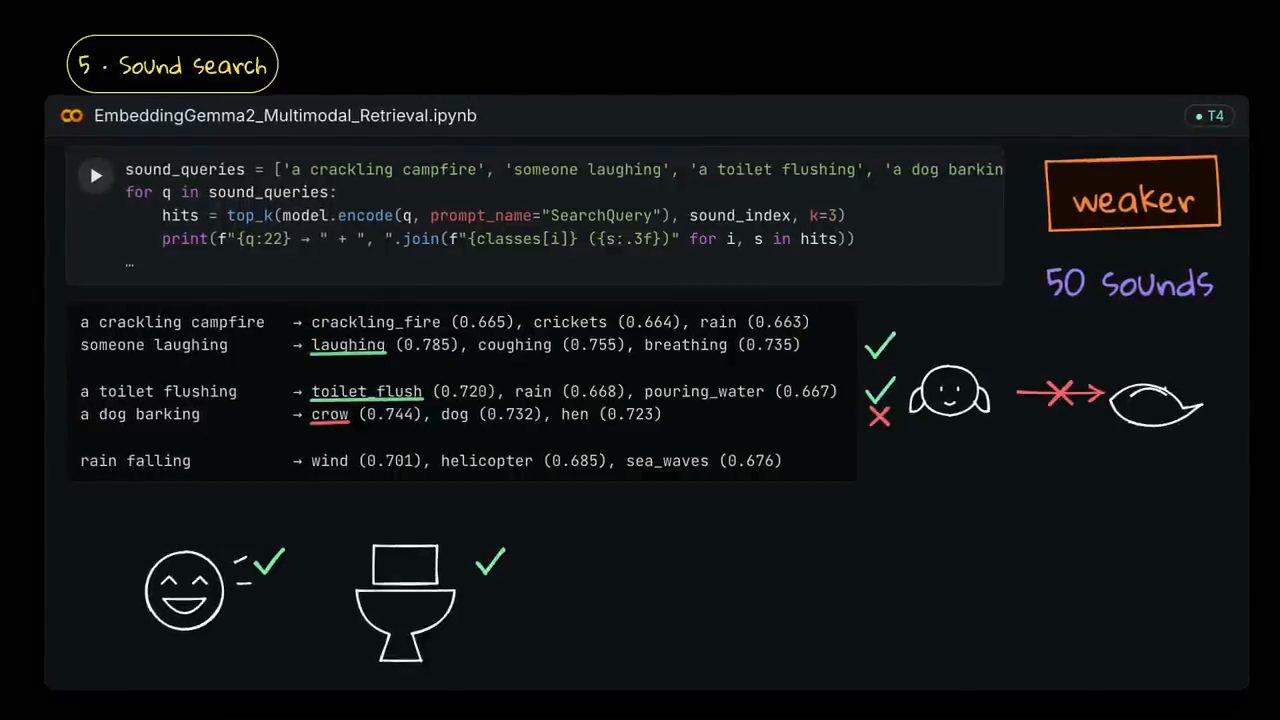
Kết luận của Muhammad (video đăng ngày 07/10/2026): audio encoder mạnh nhất ở lời nói, đúng như demo giọng nói đã cho thấy. Nếu bạn cần hiệu ứng âm thanh hay âm thanh môi trường, anh nghĩ bạn sẽ phải thử trên các clip của chính mình trước.
15. Tìm khoảnh khắc trong video không cần caption
Với video, Muhammad cắt năm phút đầu của Big Buck Bunny thành các đoạn năm giây, và embed mỗi đoạn như một video (trên màn hình là 60 đoạn). Theo anh (video đăng ngày 07/10/2026), mặc định model nhìn một frame mỗi giây, và một câu hỏi bằng văn bản sẽ trả về mốc thời gian.
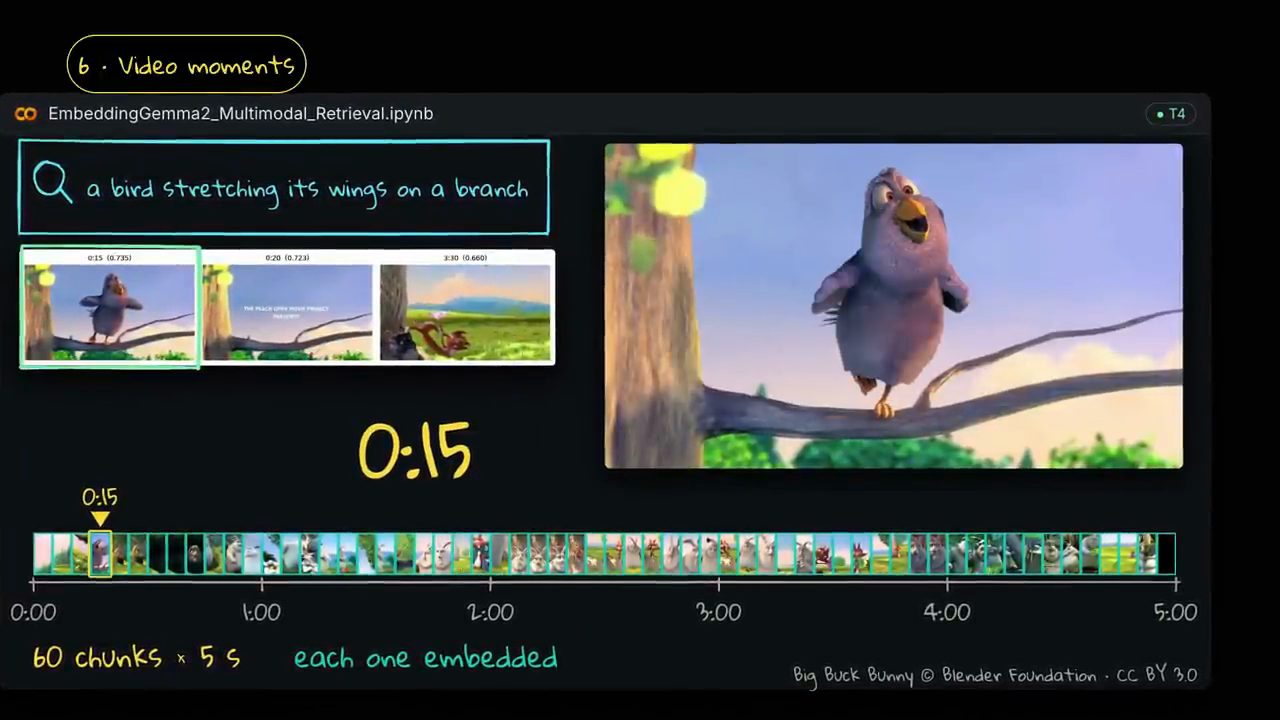
Kết quả trên bộ dữ liệu của anh (video đăng ngày 07/10/2026): "một con chim duỗi cánh trên cành cây" rơi vào giây thứ 15. "Một cái hố tối dưới đất" là hang của con thỏ, ở giây thứ 30. "Con thỏ ngửi một bông hoa trắng" ở phút 1:05. Và "con bướm tím" ở 3 phút 20 giây. Theo Muhammad, tìm một khoảnh khắc trong video chạy được mà không cần caption nào, và anh thấy điều đó thật tuyệt. Anh nhắc lại đây là cùng một model, dưới một tỷ parameter, chạy được trên nhiều modality khác nhau.
16. Search trang PDF không cần OCR
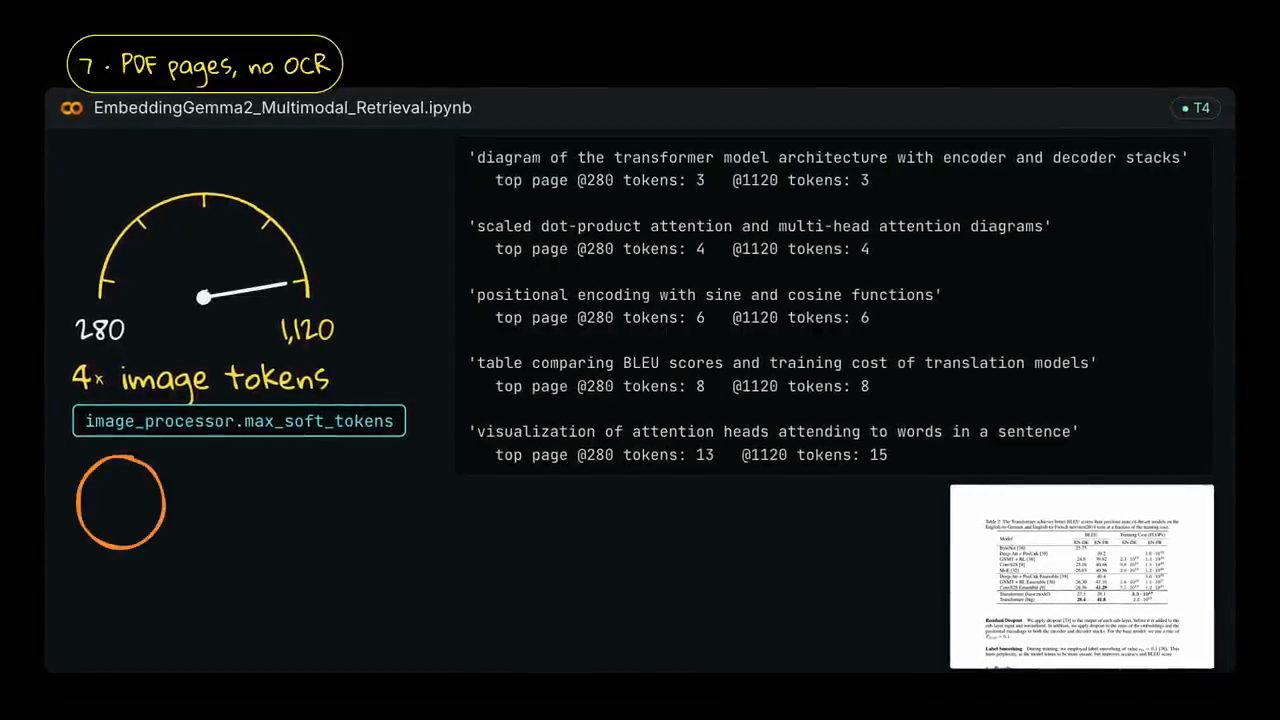
Với tài liệu, Muhammad biến từng trang của bài báo Attention thành một tấm ảnh, rồi embed ảnh của trang mà không trích xuất văn bản gì cả. Theo kết quả anh chạy (video đăng ngày 07/10/2026), hỏi "sơ đồ kiến trúc transformer" trả về trang 3, chính là hình vẽ rất nổi tiếng mà theo anh đã khởi đầu cho mọi thứ. "Multi-head attention" trả về trang 4, và "bảng điểm BLEU" trả về trang 8.
Anh thử cho mỗi trang nhiều hơn bốn lần số image token, một thiết lập bạn chỉnh được (trên màn hình là image_processor.max_soft_tokens, từ 280 lên 1.120). Theo số đo của anh (video đăng ngày 07/10/2026), việc đó tốn khoảng chín lần thời gian và tìm ra đúng những trang cũ. Lời khuyên của anh: giữ mặc định, trừ khi bạn cần chi tiết nhỏ như những con số trong một bảng dày đặc.
17. Matryoshka trên dữ liệu thật và chỉ nạp phần cần dùng
Muhammad quay lại cái "catch" của vector nhỏ, vì model hỗ trợ Matryoshka embeddings. Theo số đo của anh trên dữ liệu notebook (video đăng ngày 07/10/2026), ảnh đúng về đầu tiên 86% số lần ở kích thước đầy đủ. Ở 256 dimension là 84%, với dung lượng lưu trữ ít hơn ba lần. Nhưng ở 128 dimension thì giảm xuống 75%. Vậy nên theo anh, bạn sẽ phải thử nghiệm để chọn số dimension cuối cùng, vì tới một mức nào đó, độ chính xác sẽ giảm khá đáng kể. Trên màn hình, bảng kết quả còn có dòng 512 dimension (photo R@1 0.861) và cột sound top-1 (24%, 20%, 22%, 16% ở 768, 512, 256, 128).
Trong code, theo anh (video đăng ngày 07/10/2026), bạn truyền truncate_dim và normalize_embeddings vào hàm encode để đặt các giá trị đó.
Ở phần cuối notebook, Muhammad cho xem cách nạp những gì bạn cần và bỏ những gì bạn không cần. Trong video đăng ngày 07/10/2026, anh chỉ nạp phần text của model, 270 triệu parameter (output ghi 271M), rồi search trên photo index đã build bằng model đầy đủ. Cell trên màn hình:
text_only = SentenceTransformer(MODEL_ID, device=device, model_kwargs={"torch_dtype": dtype},
                                config_kwargs={"vision_config": None, "audio_config": None})
print(f"text-only model: {sum(p.numel() for p in text_only.parameters())/1e6:.0f}M parameters")

cap_emb_small = text_only.encode(all_caps, prompt_name="SearchQuery", batch_size=64)
print("full model queries     :", recall_at(cap_emb, photo_index, cap_owner))
print("text-only model queries:", recall_at(cap_emb_small, photo_index, cap_owner))
print("max |difference| between the two query embeddings:", float(np.abs(cap_emb_small - cap_emb).max()))
Muhammad nhắc lại: bạn có thể build index bằng model đầy đủ rồi chỉ dùng phần text để search trên ảnh, video hay âm thanh. Theo kết quả anh chạy (video đăng ngày 07/10/2026), embedding của câu hỏi ra giống hệt, và recall cũng vậy. Nên bạn có thể index ảnh một lần trên server rồi search chúng từ điện thoại bằng model nhỏ.
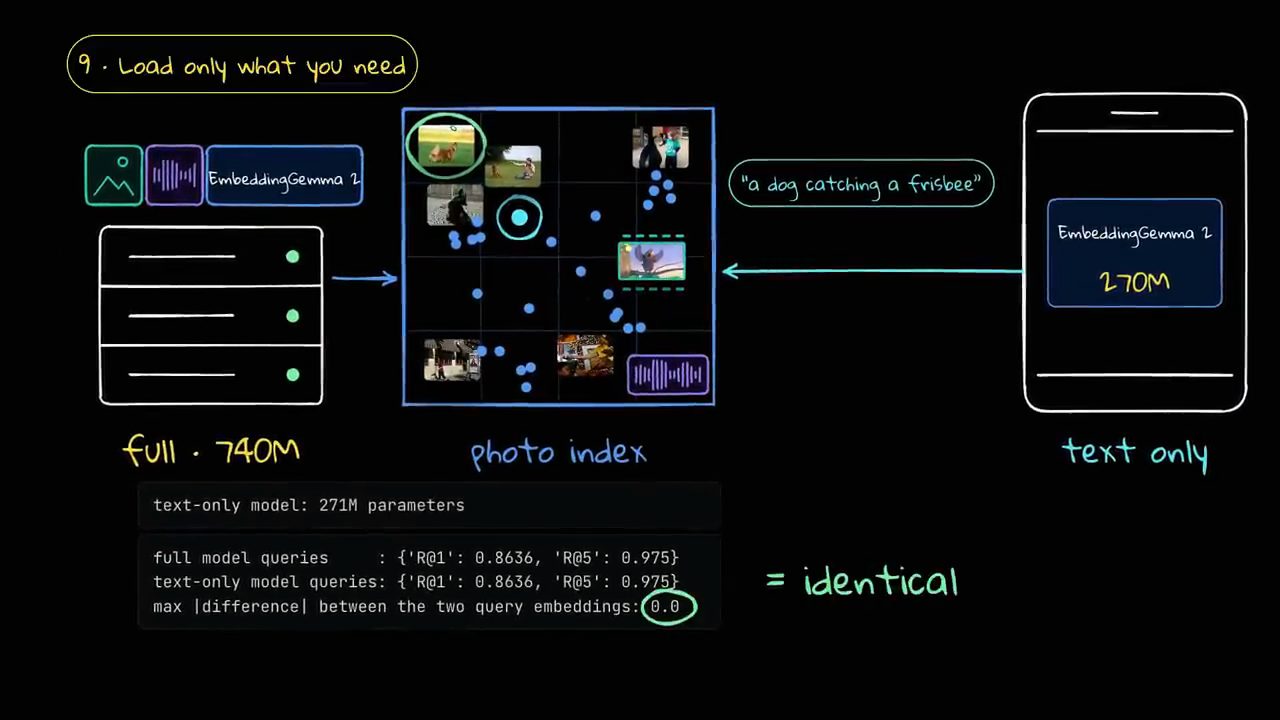
{'R@1': 0.8636, 'R@5': 0.975}, chênh lệch lớn nhất giữa hai embedding câu hỏi là 0.0, nhãn "= identical" (chạy trong video đăng ngày 07/10/2026).18. Kết luận của Muhammad
Muhammad tóm lại câu hỏi của video: bạn có thể search trên ảnh, video bằng một voice note mà không biến thứ gì thành văn bản không? Theo đánh giá của anh (video đăng ngày 07/10/2026), với ảnh, video và tài liệu thì có, và model chạy rất tốt so với cỡ của nó. Với hiệu ứng âm thanh thì như anh đã nói, nó chưa tới.
Theo anh (video đăng ngày 07/10/2026), cái hay là bạn có thể fine-tune model này cho ứng dụng của riêng mình. Anh hỏi người xem có quan tâm không, và nói sẽ làm một video tiếp theo về cách fine-tune EmbeddingGemma 2. Theo Muhammad, nếu bạn đang build search hay RAG trên những loại dữ liệu như vậy, đây thật sự là open model đầu tiên anh sẽ thử (video đăng ngày 07/10/2026). Ở cuối notebook, anh để sẵn vài quy tắc bạn có thể thử để làm retrieval cho đúng.
Anh nói anh thấy chuyện này thật sự thú vị, nhất là một embedding model đến từ Google và lại multimodal. Theo anh (video đăng ngày 07/10/2026), bạn chạy được nó trên điện thoại, và nó có thể làm nền cho những project như LocalGPT; anh nói có lẽ sẽ đưa nó vào chính project đó. Anh mời mọi người cho biết có thấy video thú vị không, nói sẽ làm thêm video tiếp theo, và cảm ơn mọi người đã xem.
Nguồn và liên kết 13 nguồn
- Tên gốc: Embedding Gemma 2: On-Device Multimodal RAG Made Easy
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=XtIBx6H9A_I youtube.com
- Kênh YouTube Prompt Engineering (Muhammad Farooq): youtube.com/channel/UCDq7SjbgRKty5TgGafW8Clg youtube.com
- Model card EmbeddingGemma 2 trên Hugging Face (740M parameter, license Apache 2.0, context window 8,192 token, khuyến nghị bfloat16 hoặc float32, không dùng float16; đọc ngày 23/10/2026): huggingface.co/google/embeddinggemma-2 huggingface.co
- Bài ra mắt EmbeddingGemma 2 trên blog Google (đọc ngày 23/10/2026): blog.google/…/embeddinggemma-2 blog.google
- Developer guide của Google cho EmbeddingGemma 2 (đọc ngày 23/10/2026): developers.googleblog.com/embeddinggemma-2-the-developer-guide developers.googleblog.com
- Hướng dẫn chạy on-device với Google AI Edge (LiteRT, MediaPipe; ghi khoảng 191MB RAM cho bản text và khoảng 567MB cho bản đầy đủ trên Pixel 11 Pro, đọc ngày 23/10/2026): developers.googleblog.com/google-ai-edge-with-embeddinggemma-2 developers.googleblog.com
- Notebook Colab trong video: colab.research.google.com/drive/1mXzvOCo-_y4r1yQ0AqAJJtU8BgU3LlCP colab.research.google.com
- Bài báo "Gemini Embedding 2: A Native Multimodal Embedding Model from Gemini" (đọc ngày 23/10/2026): arxiv.org/abs/2605.27295 arxiv.org
- Bài báo CLIP: arxiv.org/abs/2103.00020 arxiv.org
- Bài báo ImageBind: arxiv.org/abs/2305.05665 arxiv.org
- Bài báo "ColPali: Efficient Document Retrieval with Vision Language Models": arxiv.org/abs/2407.01449 arxiv.org
Related talks
Octop của Tencent: trợ lý AI tự host với expert, knowledge base, team và ACP
AICodeKing · AICodeKing · 13 min
Cài Octop, kết nối model, tạo expert Release Helper, knowledge base ONNX local có trích nguồn, team có Reviewer, giao việc cho OpenCode qua ACP và lịch nhắc.
Tự fine-tune embedding model không khó như bạn nghĩ
Muhammad Farooq · Prompt Engineering · 13 min
Fine-tune EmbeddingGemma 2 bằng LoRA và Unsloth trên dữ liệu riêng: cặp câu hỏi và đoạn văn, in-batch negatives, chia test theo nguồn, đo cái giá.
Cho dữ liệu unstructured một cấu trúc: parse tài liệu nâng cao cho AI workflow
Cedric Clyburn · Red Hat · 21 min
Biến PDF, bảng, hình ảnh thành Markdown/JSON cho RAG và agent bằng Docling: chạy local trên CPU, chunkless RAG, Docling Serve và MCP server.