Build một memory system cho AI agent: nó chạy thế nào
Build long-term memory cho AI agent: write pipeline, embedding, retrieval, metadata filter, rerank, cập nhật preference giữ lịch sử và write policy.
✓ Đã duyệt độc lập · cập nhật 24/10/2026 · 8 min
1. Một agent thật sự biết bạn
Andy mở đầu bằng một câu hỏi: bạn đã bao giờ muốn build một AI agent cá nhân thật sự biết bạn chưa? Một agent nhớ các preference của bạn, nhớ những lựa chọn bạn đã làm trước đây, và mang context đó từ cuộc trò chuyện này sang cuộc trò chuyện khác. Hãy hình dung bạn mở một chat hoàn toàn mới, và agent đã biết sẵn bạn thích khách sạn nào, thích loại phòng nào, cùng những thiết lập cá nhân khác, mà bạn không phải nhắc lại một điều nào.
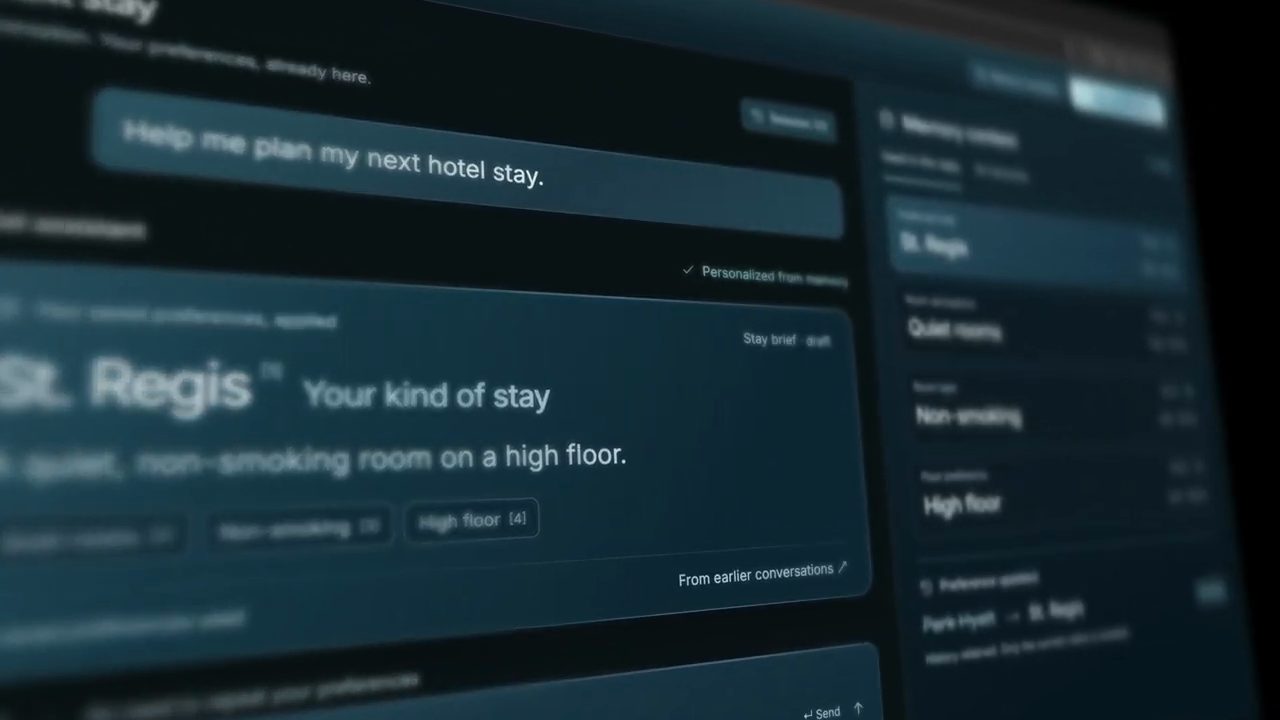
Nhưng, theo Andy (video đăng ngày 29/09/2026), bản thân large language model không thật sự nhớ bạn. Vậy làm sao để cho một AI agent một bộ nhớ chạy được thật? Trong video này anh build nó từ đầu tới cuối: quyết định điều gì cần nhớ, lưu và lấy lại memory, và cả cập nhật memory khi preference của bạn thay đổi.
2. Agent khi chưa có memory
Trước hết, Andy cho xem chuyện gì xảy ra khi không có memory. Anh nói với một agent một điều về bản thân: anh thích Park Hyatt. Rồi anh đóng chat. Sau đó anh mở một session mới và hỏi mình thích khách sạn nào. Agent không biết (demo trong video đăng ngày 29/09/2026).
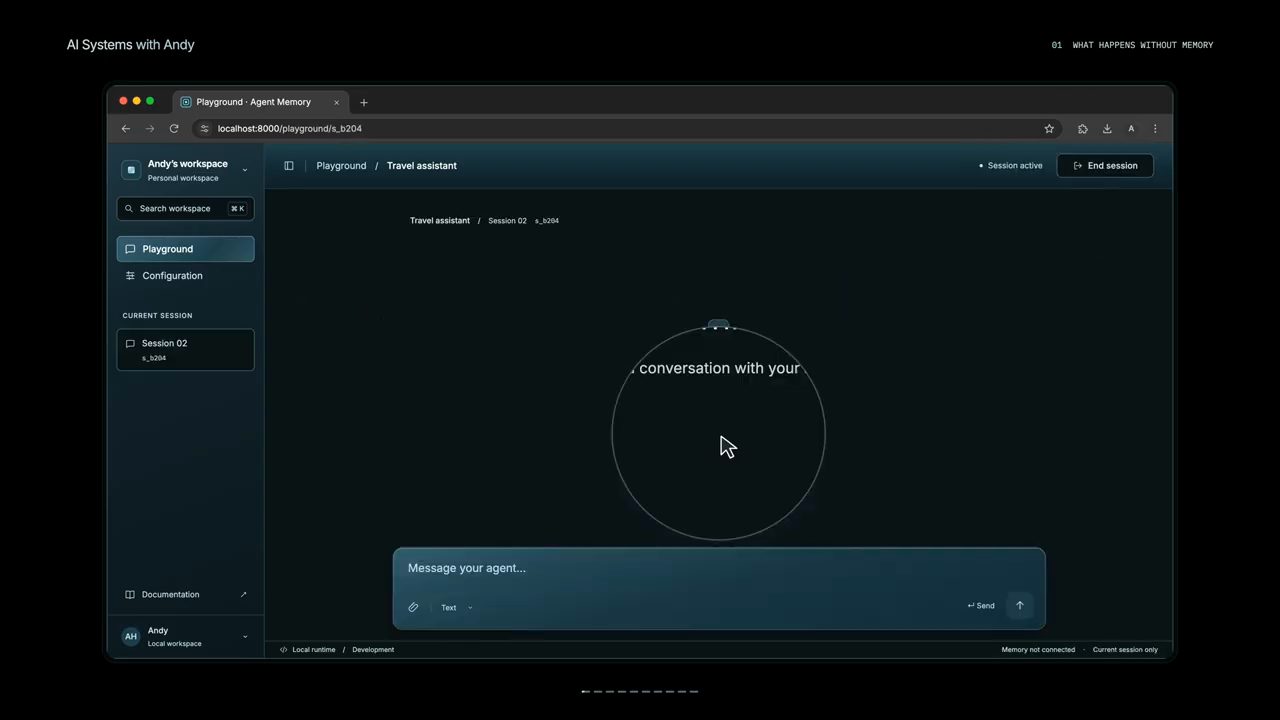
Andy giải thích lý do (video đăng ngày 29/09/2026): cuộc chat trước đó không nằm trong session này, và không có gì lưu lại preference đó để dùng về sau. Vì thế anh build một memory system bao quanh agent để nó nhớ được. Và bước đầu tiên là quyết định điều gì thật sự đáng nhớ.
3. Write pipeline: chọn điều đáng nhớ và lưu thành một record
Không phải tin nhắn nào cũng đáng nhớ. Trong thiết kế của Andy, agent vẫn trả lời bình thường, còn một memory pipeline riêng kiểm tra tin nhắn xem có thông tin nào đáng giữ lại không. Ở ví dụ này, extractor nhận ra một preference: người dùng thích Park Hyatt (demo trong video đăng ngày 29/09/2026).
Thay vì lưu cả cuộc trò chuyện, hệ thống biến điều đó thành một memory nhỏ, có cấu trúc, chỉ chứa thông tin hữu ích. Tiếp theo, hệ thống tạo một embedding: một biểu diễn bằng số cho phép tìm lại memory này về sau dựa trên ý nghĩa, chứ không chỉ dựa trên đúng từng chữ (cách Andy build trong video đăng ngày 29/09/2026). Andy lưu ý rằng các con số hiện trên màn hình chỉ là ví dụ đơn giản hoá.
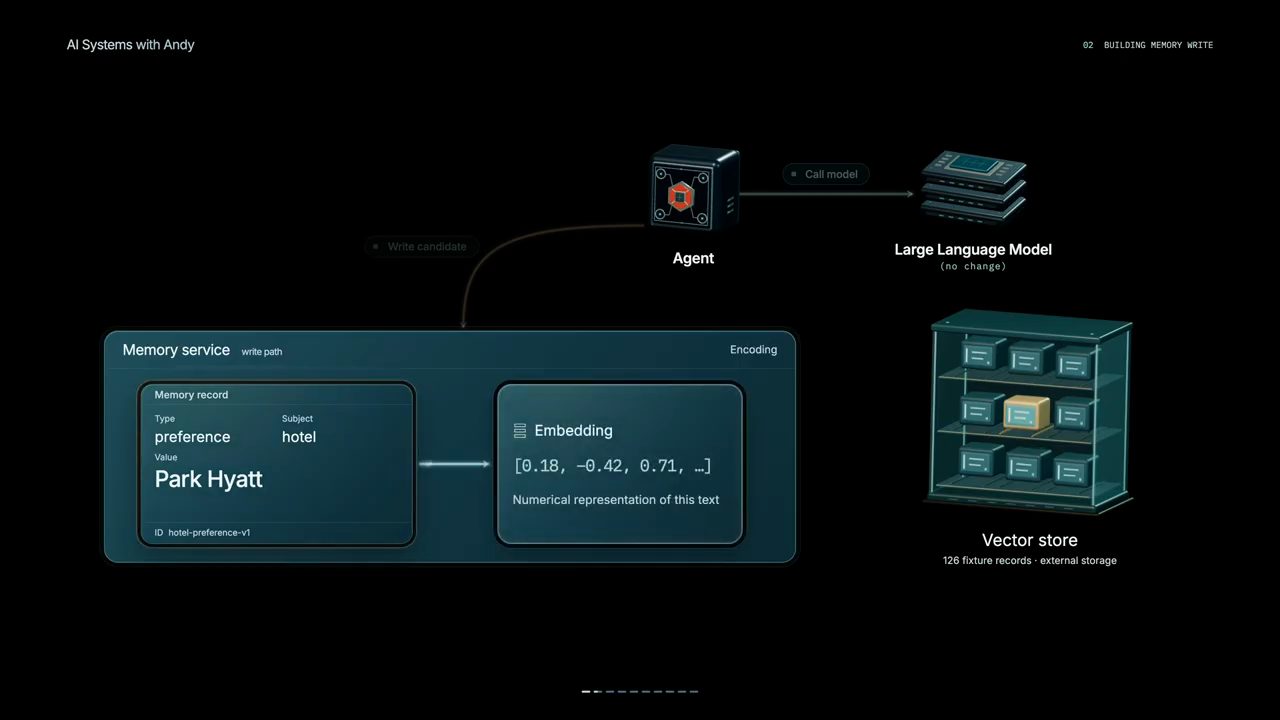
Embedding được lưu cùng memory gốc và metadata của nó. Tất cả gộp thành một memory record duy nhất, nằm dưới một ID. Lúc này memory sống bên ngoài agent và bên ngoài large language model, trong một external store, nơi nó có thể được lấy lại ở một session sau (theo Andy, video đăng ngày 29/09/2026).
4. Trong code: extract, embed, upsert
Trong code của Andy (video đăng ngày 29/09/2026), anh nói write path rút gọn lại còn ba bước chính. Thứ nhất, extract một candidate memory: kiểm tra xem nó có hữu ích vượt ra ngoài cuộc trò chuyện hiện tại không, rồi validate cấu trúc của nó.
Thứ hai, tạo embedding cho phần text của memory. Code kiểm tra vector có đúng số chiều mong đợi không, và giữ vector gắn với chính record đó. Thứ ba, upsert record bằng một ID ổn định. Nhờ vậy, theo Andy (video đăng ngày 29/09/2026), nếu thao tác bị retry, hệ thống cập nhật đúng memory đó thay vì tạo ra một bản trùng.
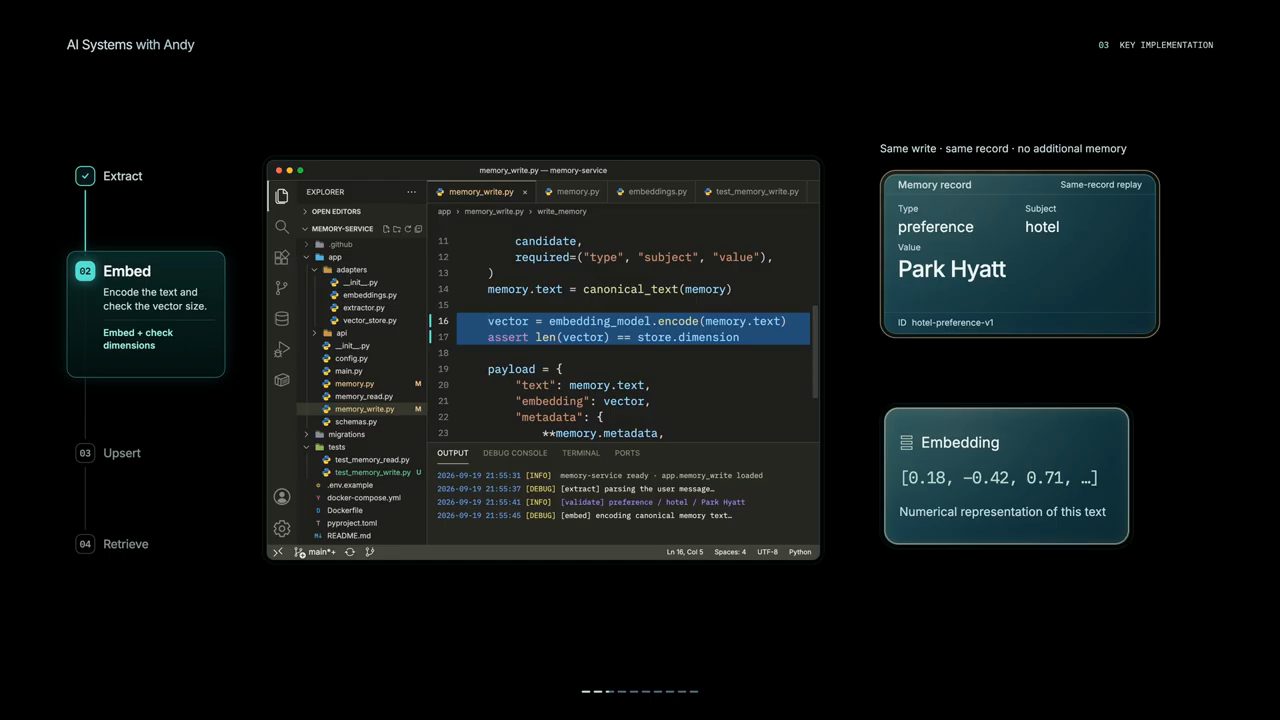
memory_write.py của project memory-service, bước "02 Embed: Encode the text and check the vector size." đang được tô sáng. Log bên dưới ghi lần lượt extract, validate "preference / hotel / Park Hyatt" rồi embed; khung bên phải ghi "Same write · same record · no additional memory" (demo trong video đăng ngày 29/09/2026).Phần code của hàm ghi memory, từ dòng 14 tới dòng 29, như hiện trên màn hình:
    memory.text = canonical_text(memory)

    vector = embedding_model.encode(memory.text)
    assert len(vector) == store.dimension

    payload = {
        "text": memory.text,
        "embedding": vector,
        "metadata": {
            **memory.metadata,
            "user_id": user_id,
        },
    }

    store.upsert(id=memory.id, payload=payload)
    return memory.id
Log của lần chạy này kết thúc bằng dòng "[stored] id=hotel-preference-v1", và khung vector store lúc này ghi "127 fixture records" (demo trong video đăng ngày 29/09/2026). Andy chốt phần này: ghi một memory tương đối đơn giản. Thử thách thật sự là lấy lại đúng memory khi agent cần đến nó.
5. Retrieval: embed câu hỏi, search, rerank, đưa vào context
Giờ Andy quay lại một session mới tinh và hỏi: "Which hotel do I prefer?" (tôi thích khách sạn nào?). Bước đầu tiên là embed câu hỏi bằng đúng embedding model đã dùng khi lưu memory. Theo Andy (video đăng ngày 29/09/2026), làm vậy đặt câu hỏi và các memory vào cùng một vector space, để có thể so sánh chúng theo ý nghĩa.
Lúc này memory store có 127 record (demo trong video đăng ngày 29/09/2026). Hệ thống search trên toàn bộ số đó để tìm các memory gần nghĩa với câu hỏi. Mười candidate được trả về, nhưng đó mới chỉ là một shortlist.
Theo Andy (video đăng ngày 29/09/2026), độ tương đồng (similarity) một mình không cho biết memory nào thật sự có ích. Đó là lúc reranking vào cuộc. Nó đặt một câu hỏi cụ thể hơn: trong các memory này, cái nào thật sự giúp trả lời câu hỏi? Ba memory lọt qua vòng này. Tới đây hệ thống không cần vector của chúng nữa; thứ cần là thông tin thật mà chúng chứa.
def retrieve_memories(
    query: str, store: MemoryStore,
    embed: Embedding, rerank: Reranker,
) -> list[Memory]:
    vector = embed(query)
    candidates = store.search(vector, limit=10)
    ranked = rerank(query, candidates)
    return ranked[:3]
Vì vậy hệ thống lấy phần text của memory và thêm vào context hiện tại của model, bên cạnh câu hỏi của người dùng. Bây giờ large language model có được thông tin còn thiếu trong session mới này, mà không cần retrain gì cả. Và lần này nó trả lời được: "you prefer the Park Hyatt", bạn thích Park Hyatt (demo trong video đăng ngày 29/09/2026).
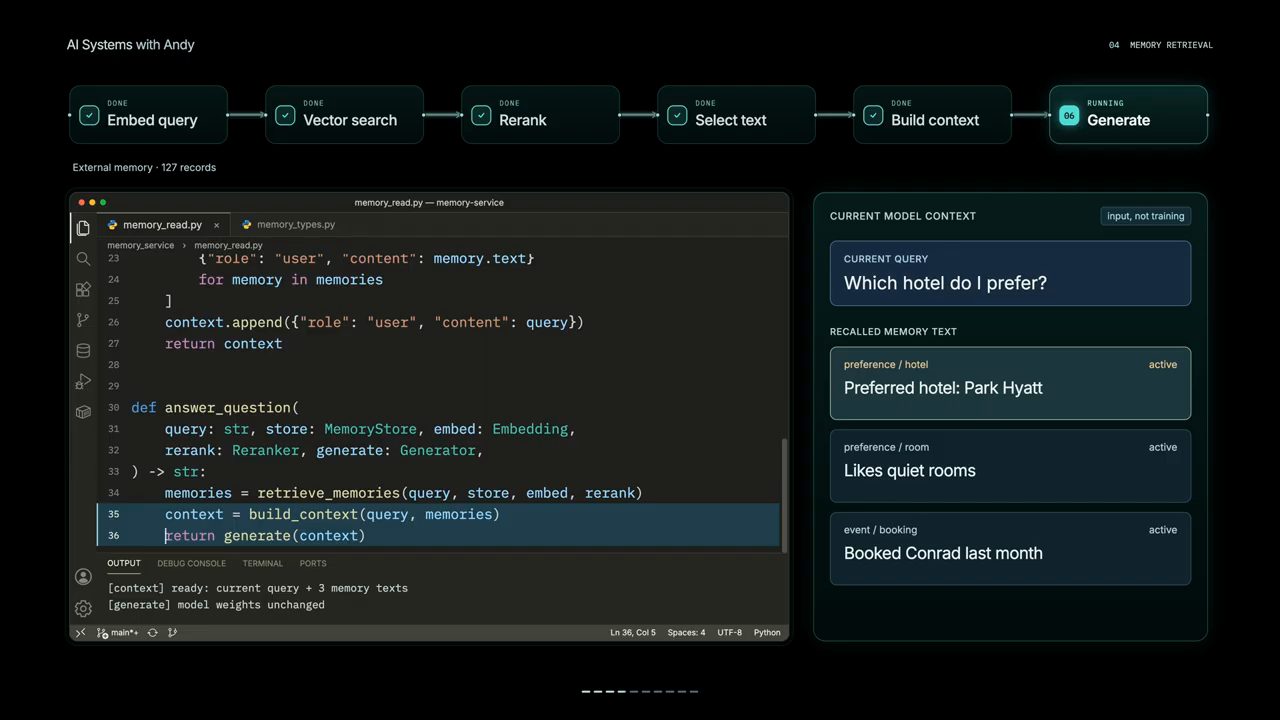
Hàm trả lời câu hỏi trên màn hình nối ba bước lại với nhau:
def answer_question(
    query: str, store: MemoryStore, embed: Embedding,
    rerank: Reranker, generate: Generator,
) -> str:
    memories = retrieve_memories(query, store, embed, rerank)
    context = build_context(query, memories)
    return generate(context)
6. Cố tình phá hệ thống: memory sai đứng đầu
Vậy là xong chưa? Đã có một memory system chạy được chưa? Andy trả lời: chưa hẳn. Giờ anh làm mọi thứ rối hơn một chút. Memory store còn chứa những memory khác liên quan tới khách sạn chứ không chỉ preference này. Có thể tháng trước anh đã ở Conrad. Điều đó không có nghĩa Conrad là khách sạn anh thích. Cùng chủ đề, khác ý nghĩa (ví dụ Andy dựng trong video đăng ngày 29/09/2026).
Trên màn hình, file unsafe_read.py đặt hai memory cạnh nhau dưới tiêu đề "Same entity · different meaning": "Preferred hotel: Park Hyatt" (preference / hotel) và "Stayed at the Conrad last month." (event / stay), kèm dòng chữ "A stay is not a preference. Both mention hotels. Only one answers this question." (demo trong video đăng ngày 29/09/2026).
Nhưng, theo Andy (video đăng ngày 29/09/2026), trong vector search một lần ở khách sạn và một preference về khách sạn vẫn có thể trông gần nghĩa với nhau, và đó là chỗ mọi thứ có thể hỏng. Lần này kết quả đứng đầu là lần ở Conrad. Preference Park Hyatt vẫn nằm trong store, chỉ là xếp hạng thấp hơn (demo trong video đăng ngày 29/09/2026).
def retrieve_first(
    query: str, store: MemoryStore, embed: Embedding,
) -> list[Memory]:
    vector = embed(query)
    candidates = store.search(vector, limit=10)
    if not candidates:
        return []
    selected = candidates[0]
    return [selected]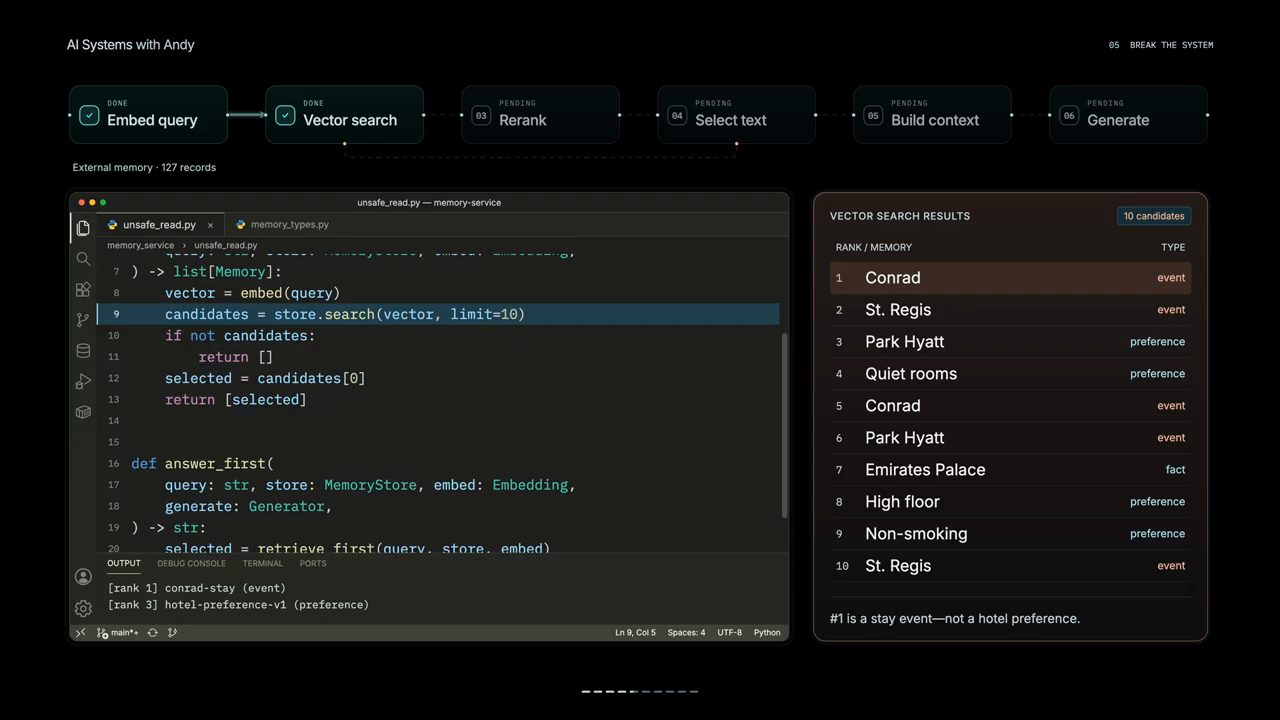
Nếu code lấy mù quáng kết quả đứng đầu mà không kiểm tra xem nó có thật sự trả lời câu hỏi hay không, hệ thống sẽ lấy nhầm memory. Memory sai đó đi vào context, và model đưa ra một câu trả lời nghe hoàn toàn hợp lý nhưng sai (demo trong video đăng ngày 29/09/2026).
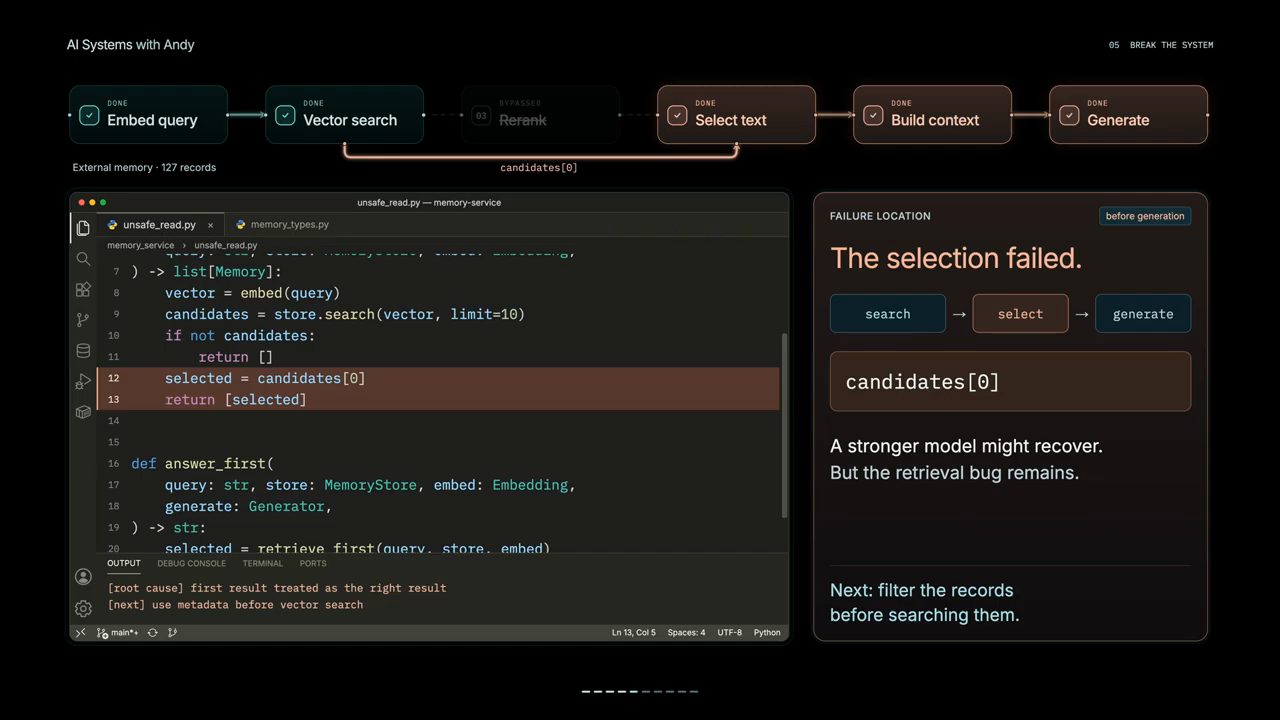
candidates[0] đi thẳng sang Select text. Khung "Failure location" ghi "before generation", "The selection failed." và "A stronger model might recover. But the retrieval bug remains."; log ghi "[root cause] first result treated as the right result" (demo trong video đăng ngày 29/09/2026).Andy bảo người xem để ý chỗ lỗi xảy ra: trước bước generation. Theo anh (video đăng ngày 29/09/2026), một large language model mạnh hơn đôi khi có thể gỡ lại được, nhưng vấn đề thật nằm ở retrieval. Và đó là thứ cần sửa tiếp theo.
7. Sửa retrieval bằng metadata filter và rerank
Theo Andy (video đăng ngày 29/09/2026), cách sửa là cho retrieval thêm thông tin để làm việc, chứ không chỉ một vector. Mỗi memory còn mang metadata: loại của nó (type), thời điểm được tạo, mức độ quan trọng, nó nói về entity nào, và nó đến từ đâu. Với câu hỏi này, type quan trọng nhất: thứ cần tìm là một preference, không phải một sự kiện đi lại hay một fact trong quá khứ.
Màn hình mở một memory ra để soi từng trường: "Preferred hotel: Park Hyatt" có type "preference", created "2026-08-01", importance "high", entity "hotel", source "user", với ghi chú "Metadata describes what this memory means." (demo trong video đăng ngày 29/09/2026).
Vì vậy, trước tiên hệ thống thu hẹp phạm vi tìm kiếm về các memory liên quan tới khách sạn của đúng người dùng này. Bước đó đưa con số từ 127 record xuống 18. Sau đó chỉ giữ lại các preference còn active. Lúc này chỉ còn bốn (demo trong video đăng ngày 29/09/2026).
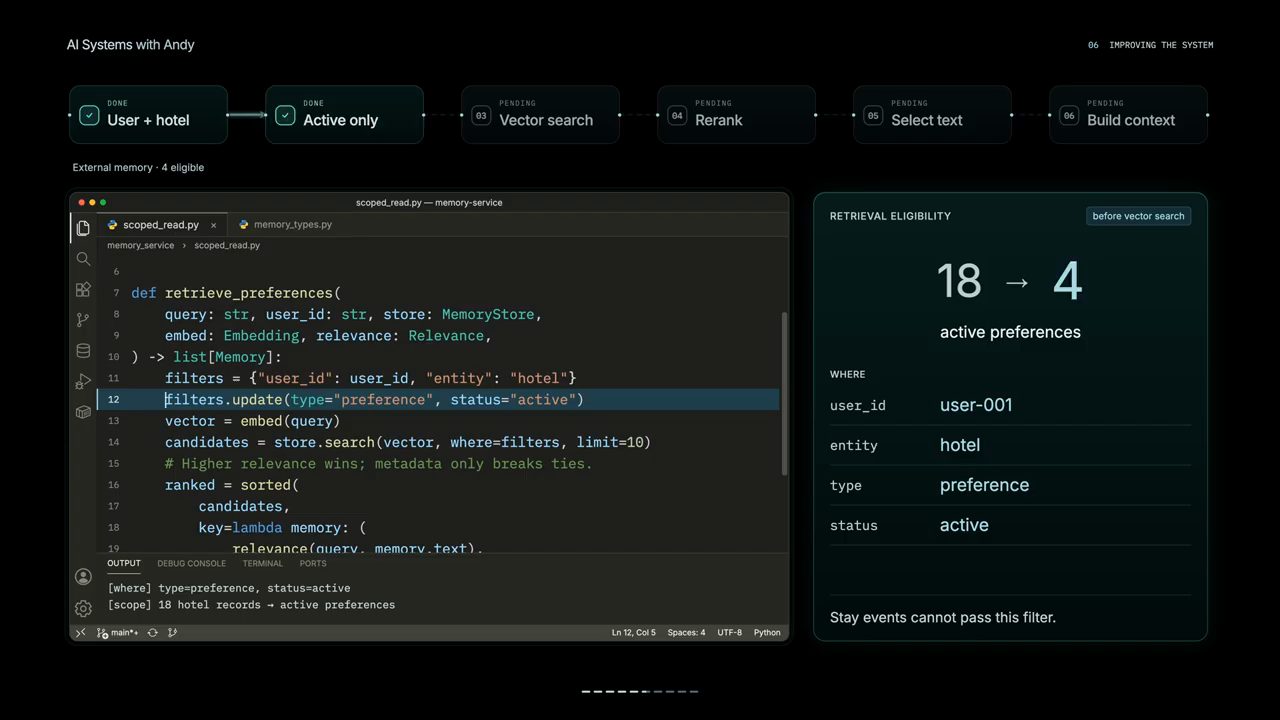
scoped_read.py: hai bước "User + hotel" và "Active only" đã xong. Khung "Retrieval eligibility" (before vector search) ghi "18 → 4 active preferences" với điều kiện user_id "user-001", entity "hotel", type "preference", status "active"; dòng cuối "Stay events cannot pass this filter." (demo trong video đăng ngày 29/09/2026).Chỉ khi đó, trong cách Andy build (video đăng ngày 29/09/2026), hệ thống mới chạy semantic search trên tập nhỏ hơn và liên quan hơn này. Kết quả được xếp hạng chủ yếu theo độ liên quan (relevance), còn các tín hiệu như importance và độ mới có thể giúp phân định khi hai kết quả sát nhau. Code trên màn hình ghi rõ điều đó trong một dòng comment:
IMPORTANCE = {"low": 0, "medium": 1, "high": 2}


def retrieve_preferences(
    query: str, user_id: str, store: MemoryStore,
    embed: Embedding, relevance: Relevance,
) -> list[Memory]:
    filters = {"user_id": user_id, "entity": "hotel"}
    filters.update(type="preference", status="active")
    vector = embed(query)
    candidates = store.search(vector, where=filters, limit=10)
    # Higher relevance wins; metadata only breaks ties.
    ranked = sorted(
        candidates,
        key=lambda memory: (
            relevance(query, memory.text),
            IMPORTANCE[memory.importance],
            memory.created,
        ),
        reverse=True,
    )
    return ranked[:3]
Giờ memory Park Hyatt đứng đầu, vì nó thật sự nói lên đúng preference đang được hỏi (demo trong video đăng ngày 29/09/2026). Trên màn hình, ba memory được chọn là "Preferred hotel: Park Hyatt", "Likes quiet rooms" và "Prefers high floors", kèm dòng "Selected for relevance, not just similarity. No model weights were changed."
Andy gọi đây là điểm phân biệt mấu chốt (video đăng ngày 29/09/2026): vector search tìm ra những kết quả có thể khớp; còn memory system bao quanh nó mới quyết định large language model thật sự được thấy những memory nào.
8. Cập nhật memory mà không mất lịch sử
Bây giờ giả sử Andy đổi ý: anh thích St. Regis hơn. Đây vẫn là cùng một loại memory, một preference về khách sạn, nhưng mang giá trị mới. Nếu để cả hai memory cùng active, agent sẽ có hai câu trả lời mâu thuẫn nhau. Vì thế, theo Andy (video đăng ngày 29/09/2026), hệ thống phải xử lý được việc cập nhật.
Cách Andy làm trong video đăng ngày 29/09/2026: ghi preference mới dưới cùng một logical key và xử lý thay đổi đó như một transaction duy nhất. Memory Park Hyatt cũ không còn active nữa; nó trở thành một phần của lịch sử. St. Regis trở thành preference hiện tại, trong khi vẫn giữ một liên kết tới phiên bản trước.
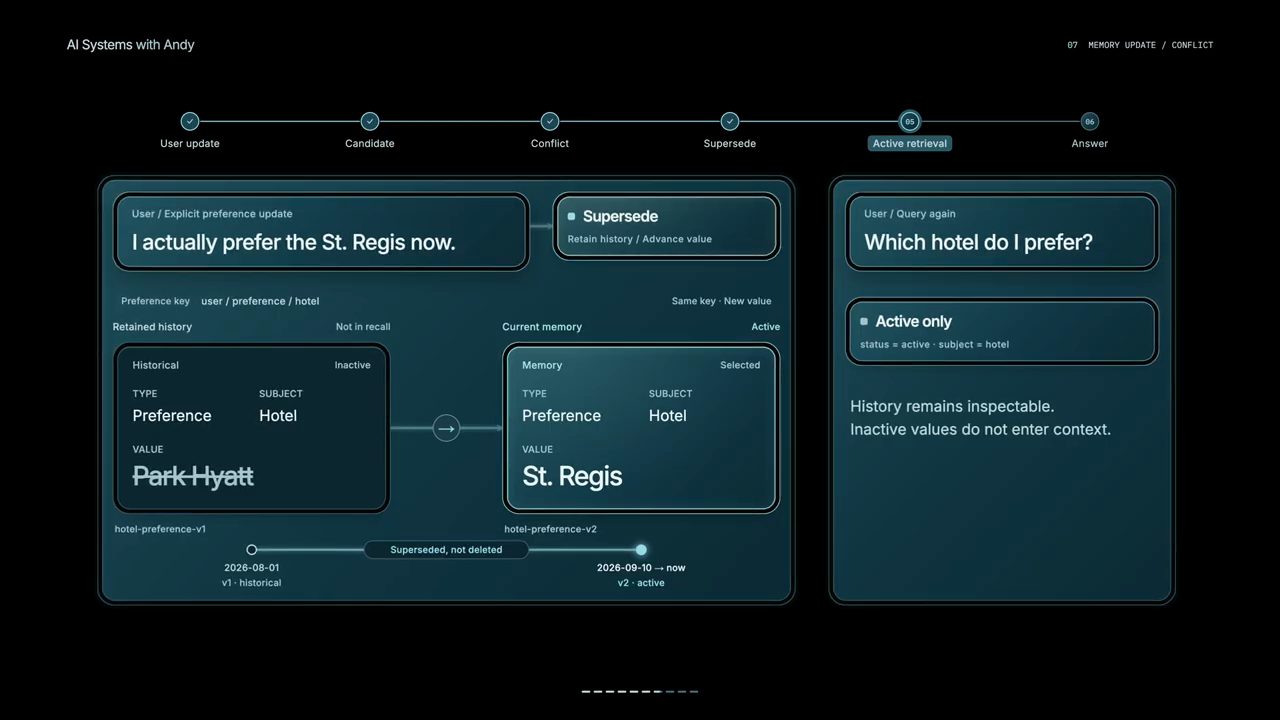
Lần tiếp theo hỏi khách sạn nào được ưa thích, chỉ memory đang active được xét tới. Theo Andy, hệ thống không xoá bản cũ; nó giữ lại cách preference thay đổi theo thời gian. Và giờ câu trả lời là St. Regis: memory hiện tại đúng, còn lịch sử vẫn truy lại được (demo trong video đăng ngày 29/09/2026).
9. Không lưu cái gì: write policy
Andy nêu thêm một quy tắc quan trọng: không nên nhớ mọi thứ. Theo anh (video đăng ngày 29/09/2026), phần lớn tin nhắn chỉ có ý nghĩa bên trong cuộc trò chuyện hiện tại: một câu "Thanks", một câu "Okay", một câu hỏi thời tiết hỏi một lần. Không cái nào trong số đó cần trở thành long-term memory.
Nhưng một câu như "I prefer a window seat" (tôi thích ghế cạnh cửa sổ) có thể hữu ích cho các cuộc trò chuyện sau, với điều kiện nó qua được các bước kiểm tra quyền (permission) và validation phù hợp. Vì vậy, trước khi lưu bất cứ thứ gì, memory system áp dụng một write policy: thông tin này có hữu ích không, có phù hợp không, có đáng giữ không? Chỉ những memory qua được các bước kiểm tra đó mới được ghi vào store (theo Andy, video đăng ngày 29/09/2026).
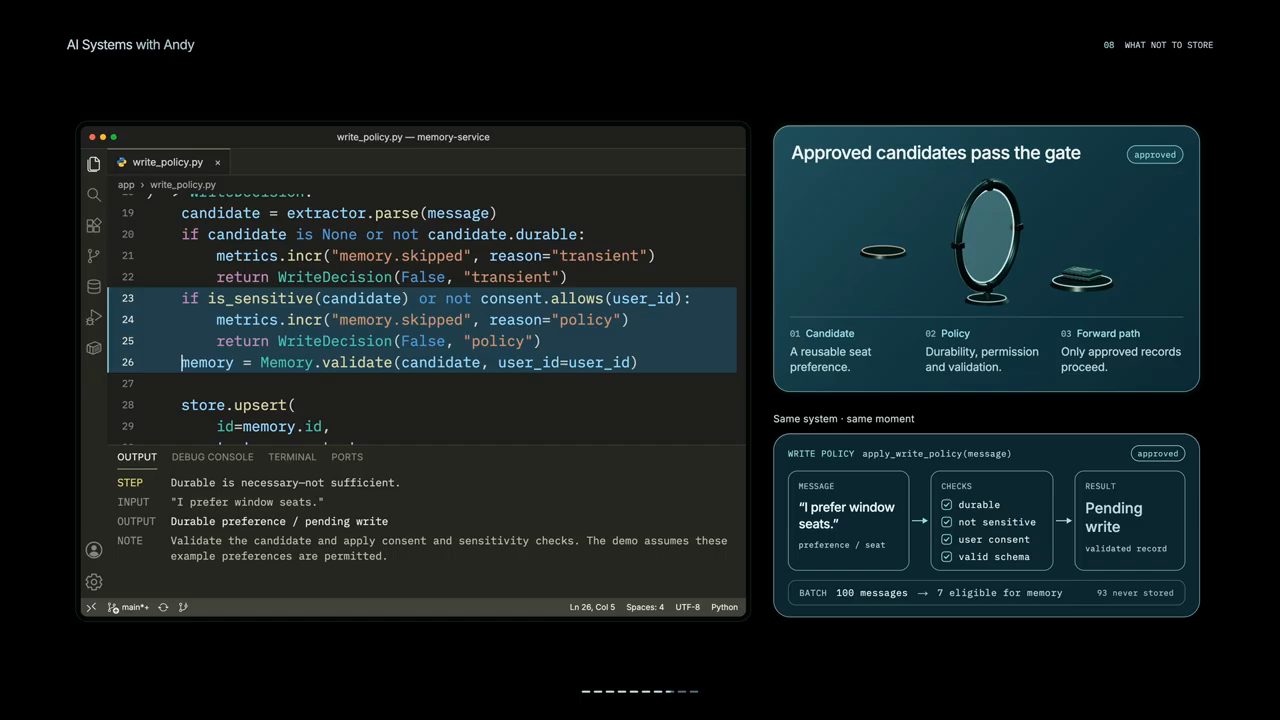
write_policy.py: tin nhắn "I prefer window seats." qua bốn kiểm tra durable, not sensitive, user consent, valid schema, thành "Pending write". Dòng batch ghi "100 messages → 7 eligible for memory · 93 never stored". Ghi chú trong output nói demo giả định các preference mẫu này đã được cho phép (demo trong video đăng ngày 29/09/2026).Đoạn code write policy trên màn hình, dòng 19 tới 26:
    candidate = extractor.parse(message)
    if candidate is None or not candidate.durable:
        metrics.incr("memory.skipped", reason="transient")
        return WriteDecision(False, "transient")
    if is_sensitive(candidate) or not consent.allows(user_id):
        metrics.incr("memory.skipped", reason="policy")
        return WriteDecision(False, "policy")
    memory = Memory.validate(candidate, user_id=user_id)
Andy nói: bản thân database không quyết định điều gì đáng được nhớ. Trong 100 tin nhắn, có lẽ chỉ 7 tin đáng giữ (con số Andy đưa làm ví dụ trong video đăng ngày 29/09/2026; màn hình ghi "100 messages → 7 eligible for memory"). Memory tốt không phải là nhớ nhiều hơn, mà là nhớ đúng những điều cần nhớ.
10. Kiến trúc tổng thể của hệ thống
Trong video đăng ngày 29/09/2026, Andy lùi lại để nhìn toàn bộ hệ thống ghép với nhau thế nào. Large language model lo phần suy luận (reasoning) và tạo câu trả lời. Agent điều phối các thành phần xung quanh nó. Memory service lo vòng đời của memory: quyết định cái gì nên được lưu, và cái gì nên được lấy ra khi agent cần.
Theo Andy (video đăng ngày 29/09/2026), trên write path thông tin hữu ích được biến thành một memory record gồm text, metadata và một embedding. Trên retrieval path, hệ thống trước tiên thu hẹp phạm vi tìm bằng filter, rồi dùng semantic search để tìm candidate, và rerank chúng theo câu hỏi đang cần trả lời. Agent lấy các memory đã chọn và thêm vào context hiện tại của model, để LLM thật sự dùng được chúng.
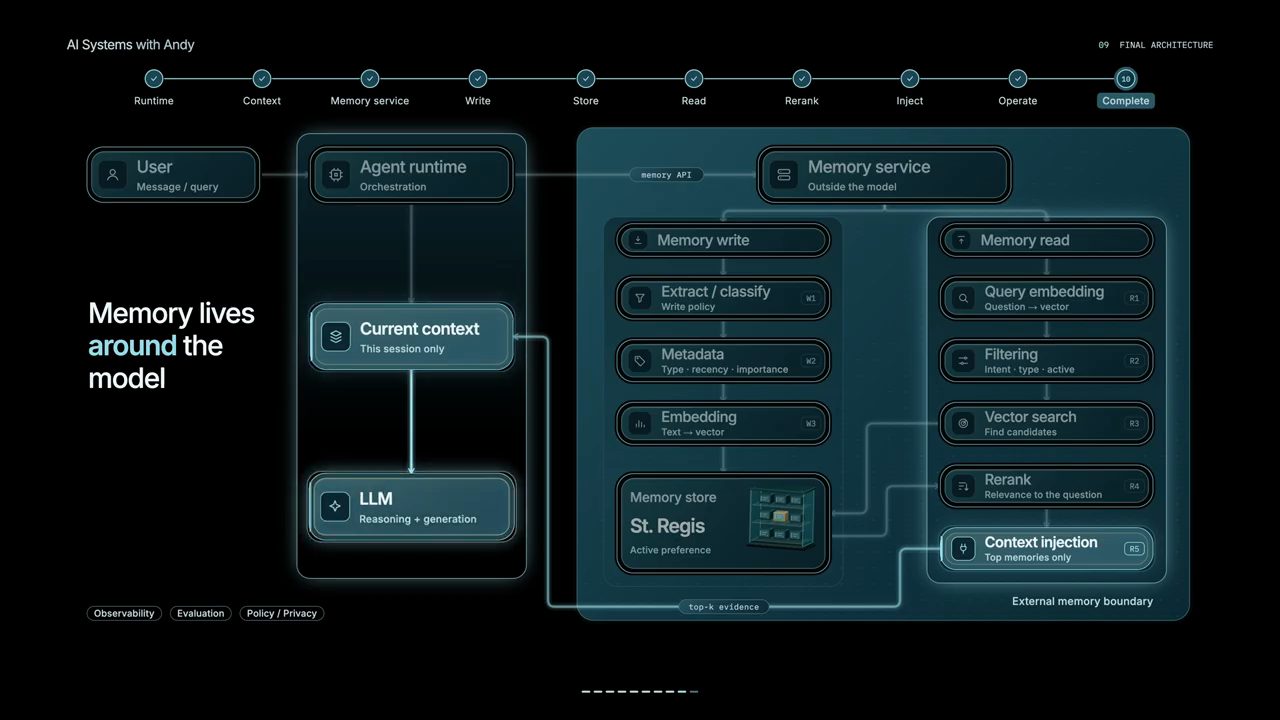
Theo Andy (video đăng ngày 29/09/2026), cả hai path đều cần được monitor và evaluate: không chỉ xem agent có trả lời đúng không, mà còn xem hệ thống có đang lưu đúng memory và lấy ra đúng memory không. Ý chính của anh: persistent memory nằm bên ngoài large language model, trong một external memory system mà agent có thể đọc, cập nhật và kiểm soát.
Đoạn code của agent runtime trên màn hình (video đăng ngày 29/09/2026) cho thấy một lượt xử lý: đọc memory, ghép context, gọi model, rồi ghi.
        memories = await self.memory.read(
            user_id, message, top_k=3,
        )
        context = assemble(history, memories, message)
        reply = await self.llm.generate(context)
        await write
        return reply
Phần output bên dưới đoạn code ghi: "The prompt contains the current conversation plus retrieved evidence. Permanent storage remains outside the LLM."; khung bên phải tóm lại lượt đó là memory.read (top_k=3), assemble, llm.generate (one request), reply, với memory.write chạy như "background task · write policy", và kết quả trả về là St. Regis, "weights unchanged" (demo trong video đăng ngày 29/09/2026).
11. Memory system khi chạy thật
Cuối cùng Andy cho xem chuyện gì xảy ra khi đã gắn memory system vào. Câu hỏi vẫn là "Which hotel do I prefer?". Hệ thống lấy ra preference hiện tại và inject nó vào context của model. Có thông tin đó trong context, model trả lời đúng: St. Regis (demo trong video đăng ngày 29/09/2026).
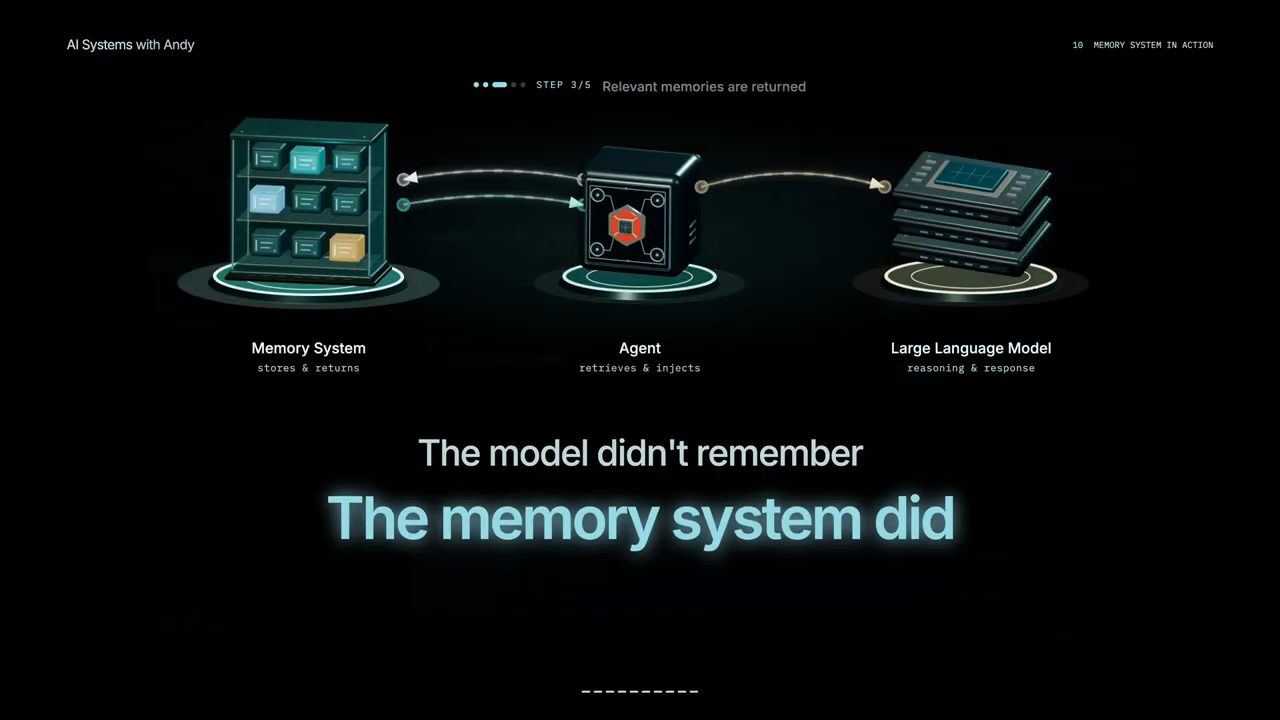
Andy kết video (đăng ngày 29/09/2026) bằng một câu: model không hề nhớ; chính hệ thống mới là thứ nhớ.
Nguồn và liên kết 4 nguồn
- Tên gốc: I Built a Memory System for AI Agents — Here's How It Actually Works
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=T_xwNAzzM0M youtube.com
- Kênh YouTube AI Systems with Andy (Andy): youtube.com/channel/UC0uEBHP5ua2M3C2oEg0UuEg youtube.com
Related talks
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Năm project AI agent để build năm 2026: kiến trúc đầy đủ và cách trở nên dễ được tuyển
Maryam Miradi · Dr. Maryam Miradi · 28 min
Kiến trúc năm project multi-agent: cảnh báo thảm hoạ, phát hiện bệnh từ ảnh mắt, graph cho đường bộ, legal agent với ADK và MCP, agent tự cải thiện.
RAG đã đổi: pipeline, use case và cây quyết định chọn RAG năm 2026
Maryam Miradi · Dr. Maryam Miradi · 27 min
Pipeline RAG production bảy bước, ba use case, chín loại RAG mới, vectorless RAG, LLM Wiki và cây quyết định chọn đúng RAG theo bài toán.