Ôn thi offline: cho AI đọc trọn giáo trình
Chỉnh context length trong LM Studio để AI đọc trọn chương giáo trình, dựng thư viện theo môn bằng AnythingLLM, ra đề cương và trắc nghiệm offline.
✓ Đã duyệt độc lập · cập nhật 20/10/2026 · 26 min
1. Thả trọn chương giáo trình vào rồi hỏi
Video có sự đồng hành của ASUS.
Thanh Trần mở đầu bằng một chương giáo trình dài 22 trang. Anh thả nguyên chương đó vào phần mềm, rồi hỏi một câu mà đáp án nằm tận ở trang 10. Trên màn hình là trang PDF của chương, chữ dày đặc, rồi chuyển sang cửa sổ LM Studio với câu trả lời đang hiện ra từng dòng, có một ô tô sáng ghi chi phí ca phẫu thuật 70.000.000 đồng.
Anh giới thiệu mình là Thanh Trần, founder kênh 5 Phút AI. Đây là tập 4 của khoá Local AI chạy trên chiếc ASUS TUF Gaming A14, với con chip AMD Ryzen AI Max+ 392 ở bên trong. Và AI trả lời đúng: 28 triệu đồng, kèm luôn lý do vì sao ra con số ấy. Không cần mạng, không cần tải tài liệu lên đâu cả. Cái tài liệu vẫn nằm yên trong ổ cứng của anh.
Nhưng anh nói có một chuyện mà ít ai kể với người xem, và nó xảy ra với chính cái tài liệu này. Chỉ cần một con số trong phần cài đặt bị để sai là AI có thể trả lời thiếu gần hết, mà vẫn rất tự tin. Hết tập này, người xem sẽ biết con số đó là gì và chỉnh nó ra sao.
2. Mùa ôn thi ngày xưa, và vì sao ngại gửi tài liệu lên mạng
Anh kể lại một câu chuyện mùa thi mà theo anh chắc ai cũng từng trải qua. Còn một tuần nữa là thi. Trên bàn là một quyển giáo trình dày cộp. Bạn mở chương đầu, cầm cây bút dạ, đọc từng dòng, đọc tới đâu tô tới đó. Màn hình khi đó hiện thẻ "Mùa thi ngày xưa: Cách ôn ai cũng từng làm", với một dòng: mở chương đầu, cầm bút dạ, đọc tới đâu tô tới đó.
Rồi bạn mở vở ra chép đề cương, rồi tự nghĩ xem thầy cô sẽ hỏi gì. Một chương như vậy thường mất cả một buổi tối, mà giáo trình có khoảng 8 chương. Đọc tới chương thứ 3 là bắt đầu quên chương thứ nhất, thế là lại phải lật lại tìm cái ví dụ hôm trước. Lật mãi, lật mãi, vẫn không nhớ nó nằm ở trang nào.
Đó cũng là cách anh ôn suốt thời đại học. Anh nói thật: đó vẫn là một cách tốt để hiểu bài. Nhưng nó rất chậm và rất dễ sót.
Rồi AI xuất hiện. Thử thì thấy cũng ổn: đưa tài liệu cho AI, bảo nó tóm tắt, bảo nó ra đề. Có điều, có một vấn đề mà theo anh không ai nói rõ với người xem. Khi bạn muốn một dịch vụ trực tuyến đọc giáo trình giúp mình, bạn phải tải giáo trình đó lên máy chủ của người khác.
Thẻ trên màn hình có tiêu đề "Có những tài liệu bạn không muốn gửi đi đâu cả", liệt kê: giáo trình nội bộ của trường, ghi chép riêng của nhóm, đề cương luận văn chưa nộp, và dòng cuối: gửi lên dịch vụ trực tuyến là tài liệu rời khỏi máy bạn. Anh kể thêm ví dụ: những bài giảng thầy cô phát riêng cho cả lớp, những ghi chép riêng của nhóm, những đề cương luận văn chưa nộp, chưa kể chính những bản luận văn rất quan trọng. Tất cả sẽ rời khỏi máy của bạn.
Anh biết có nhiều bạn thấy chuyện đó bình thường. Nhưng cũng có nhiều bạn rất ngại, và theo anh ngại là có lý do. Hôm nay anh làm theo cách thứ ba: tài liệu giữ nguyên trên máy, AI dùng cũng nằm trên máy. Nó đọc, nó tóm tắt, nó ra đề trắc nghiệm, mà không một trang tài liệu nào của bạn đi ra ngoài. Thẻ tiếp theo trên màn hình, "Cách làm của tập này: AI nằm ngay trên máy bạn", ghi bốn ý: nó đọc tài liệu, tóm tắt, ra đề cương, ra trắc nghiệm; tài liệu không rời khỏi ổ cứng; không cần mạng, không cần tài khoản; nhưng có một chỗ cài đặt để sai là hỏng hết mà không ai thấy.
Anh nói trước để người xem đỡ kỳ vọng quá cao: cách này không phải bấm một nút là xong. Có một chỗ cài đặt mà nếu để sai, AI chỉ đọc lướt qua vài đoạn rồi trả lời bạn như thể nó đã đọc hết. Và chính anh đã dính chỗ đó thật trong lúc làm video hướng dẫn này. Lát nữa anh sẽ cho người xem thấy tận mắt.
3. Bốn việc làm được sau tập này, và chiếc máy chạy cả khoá
Sau video này, theo anh, người xem sẽ làm được 4 việc. Thẻ "Tập 4: Bạn sẽ làm được" liệt kê đúng bốn dòng đó:
- Một: đưa một tài liệu PDF vào LM Studio và hỏi đúng nội dung bên trong, có thể đối chiếu được với trang gốc.
- Hai: nhìn một dòng chữ nhỏ trên màn hình là biết AI đang đọc trọn cả tài liệu, hay chỉ đang giả vờ lật vài đoạn.
- Ba: chỉnh được context length cho vừa với tài liệu của mình. Anh nói đây là lời hứa từ tập 3, hôm nay anh trả.
- Bốn: dựng một thư viện riêng cho từng môn học, rồi bảo AI ra đề cương và câu hỏi trắc nghiệm từ đó.
Trước khi vào bài, như thường lệ, anh nói nhanh về chiếc máy đang làm mọi thứ người xem đang thấy. Màn hình quay cận tấm tem dán ngay chỗ đặt tay của chiếc ASUS TUF Gaming A14, có logo AMD Ryzen AI Max+. Con chip bên trong tên đầy đủ là AMD Ryzen AI Max+ 392, và trong một con chip đó có 3 phần cùng làm việc:
- CPU 12 nhân, 24 luồng, lo những việc chung.
- Đồ hoạ AMD Radeon 8060S, nằm luôn trong chip.
- NPU, phần chuyên chạy AI, lên tới 50 TOPS.
Cộng thêm 64 GB bộ nhớ hợp nhất. Các thông số này là của chiếc máy trong video, theo video đăng ngày 30/09/2026.
Vì sao hôm nay anh phải nhắc tới bộ nhớ? Vì đọc tài liệu dài là việc cần chỗ. Thẻ "Vì sao nhắc tới bộ nhớ: Đọc tài liệu dài là việc cần chỗ" ghi: riêng model đã chiếm khoảng 20 GB; tài liệu càng dài, AI càng phải giữ nhiều chữ cùng lúc; máy này có 64 GB bộ nhớ hợp nhất nên còn dư nhiều; lát nữa sẽ đo xem giữ chừng đó chữ thì tốn thêm bao nhiêu. Anh nói một model đã chiếm khoảng 20 GB, và tài liệu của bạn càng dài thì AI càng phải giữ nhiều chữ trong đầu cùng một lúc. Anh sẽ đo cho người xem thấy giữ chừng đó chữ thì tốn thêm bao nhiêu, và cái máy này còn dư bao nhiêu.
4. Hai kiểu đọc: đọc trọn và lật vài đoạn
Để giải thích đơn giản nhất chuyện gì có thể xảy ra khi bạn đưa tài liệu cho AI, anh hỏi người xem có nhớ những bài thi được mở sách không. Có hai kiểu người cùng bước vào một phòng thi.
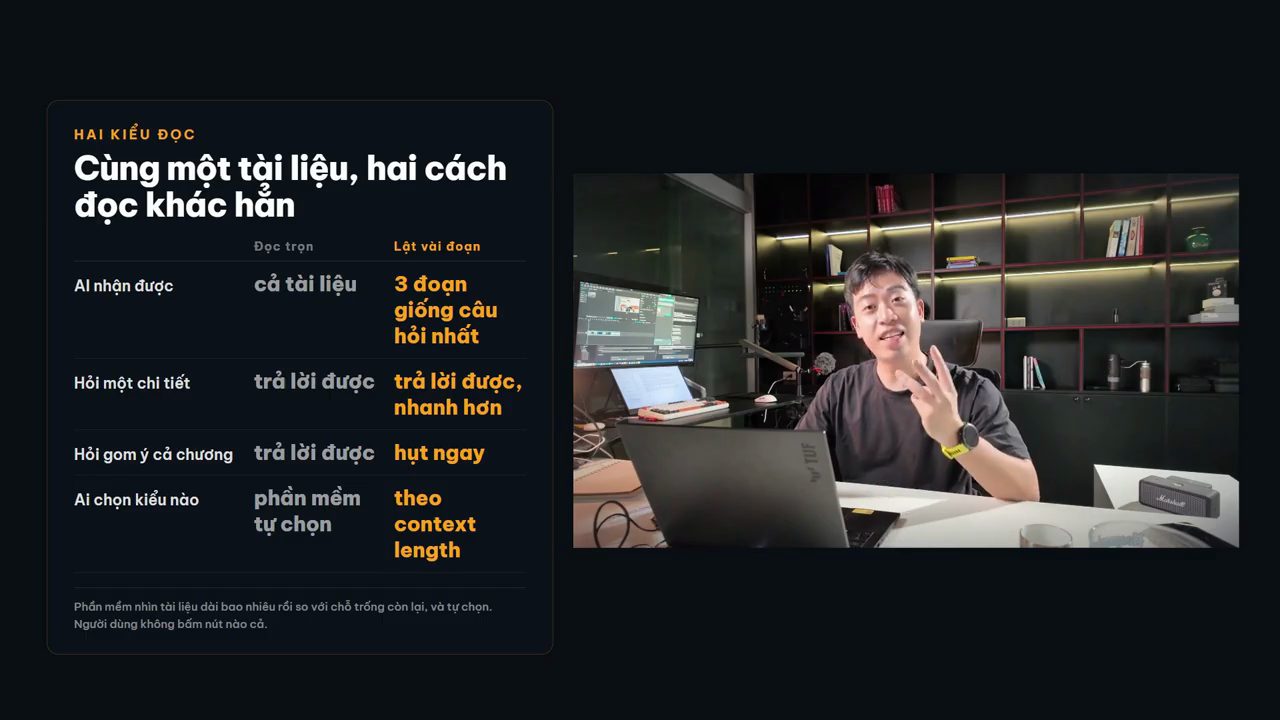
Kiểu thứ nhất đã đọc hết quyển sách từ trước. Người này trả lời được cả những câu kiểu "chương này có mấy ý chính" hay "so sánh phần đầu với phần cuối".
Kiểu thứ hai chưa đọc gì. Vào phòng, nhìn câu hỏi, rồi lật lục tìm ba trang có chữ giống câu hỏi nhất, đọc đúng ba trang đó rồi viết. Khi bị hỏi một chi tiết cụ thể, kiểu này làm khá tốt. Nhưng khi gặp câu cần gom ý từ khắp quyển sách thì hụt ngay, vì nó chưa từng thấy phần còn lại.
Theo anh, AI trên máy bạn cũng có đúng hai kiểu đó. Lấy ví dụ với chính chương giáo trình hôm nay. Nếu bạn hỏi "trong ví dụ về bạn Chi, ca phẫu thuật được chi trả bao nhiêu", đó là câu tra một chi tiết. Đáp án nằm gọn trong một đoạn ở trang 10. Người lật lục tìm đúng đoạn đó là trả lời được. Còn nếu bạn hỏi "chương này có tất cả bao nhiêu ví dụ, kể hết ra", thì đáp án không nằm trong đoạn nào cả. Nó trải từ trang 3 đến trang 19, và người chỉ đọc 3 trang thì không bao giờ kể đủ được.
Thẻ "Hai câu nghe na ná: Với AI thì đây là hai bài toán khác hẳn" đặt hai câu cạnh nhau. Câu tra một chi tiết: ví dụ "Chi tự trả bao nhiêu", đáp án nằm ở một đoạn trang 10, và lật vài đoạn vẫn trả lời được. Câu gom ý cả chương: ví dụ "chương này có bao nhiêu ví dụ", đáp án rải từ trang 3 tới trang 19, và lật vài đoạn thì không bao giờ kể đủ. Những câu hỏi nghe na ná nhau, nhưng với AI lại là những bài toán khác hẳn nhau.
5. Lật đoạn so theo nghĩa, và phần mềm tự chọn giúp bạn
Anh muốn người xem biết thêm một chi tiết. Khi lật đoạn, phần mềm không dò đúng từng chữ như lúc bạn bấm Ctrl+F, mà so theo nghĩa. Thẻ trên màn hình ghi "Lật đoạn không phải Ctrl+F: Phần mềm so theo nghĩa, không dò từng chữ". Ví dụ bạn hỏi "Chi phải trả bao nhiêu", nó vẫn tìm ra đoạn ghi "Chi tự trả 28 triệu", dù chữ không giống hệt.
Nghe thì thông minh, nhưng so theo nghĩa cũng có lúc trượt, nhất là với tài liệu tiếng Việt, vì bộ phận tìm ý, tìm nghĩa này được dạy chủ yếu bằng tiếng Anh.
Anh đặt tên cho hai kiểu. Kiểu thứ nhất gọi là đọc trọn: cả tài liệu được đưa vào đầu AI. Kiểu thứ hai là lật vài đoạn: phần mềm tự cắt tài liệu ra thành nhiều mẩu nhỏ, tìm vài mẩu giống câu hỏi nhất, rồi chỉ đưa mấy mẩu đó cho AI. Trong tập này, anh gọi kỹ thuật đó là "lật đoạn" cho dễ nhớ.
Mẩu cắt thì có thể bị đứt ngang giữa câu. Khi làm tập này anh thấy tận mắt: có một mẩu đang kể tới đoạn quan trọng nhất thì dừng đúng ở hai chữ "mức miễn", phần sau lại nằm ở một mẩu khác mà AI không được xem. Thẻ trên màn hình ghi "Đoạn lật về có thể đứt ngang câu", kèm dòng: đoạn dừng đúng ở hai chữ "Mức miễn", phần quan trọng nhất ở câu sau.
Và chuyện quan trọng: bạn không chọn kiểu nào cả, phần mềm tự chọn giúp bạn. Thẻ "AI chọn kiểu đọc: Bạn không chọn, phần mềm tự chọn" ghi bốn dòng: nó nhìn tài liệu dài bao nhiêu; rồi nhìn chỗ trống còn lại trong đầu AI; vừa thì đọc trọn, không vừa thì lật đoạn; chỗ trống đó chính là thứ bạn chỉnh được.
Anh nói thêm một ý cho rõ ràng: lật đoạn không phải là cách dở. Với những câu hỏi tra một chi tiết, hay với những tài liệu đã có sẵn phần tóm tắt, cách này làm ổn và nhanh hơn rất nhiều. Lát nữa anh sẽ cho người xem thấy cả hai mặt của nó.
6. Context length và token là gì
Nếu người xem theo dõi tập 3, họ sẽ nhớ anh có hứa một câu: cái thanh context length anh mới nói lướt qua, tập này sẽ thành chuyện chính. Và đây là lúc đó.
Anh nhắc lại: context length chính là trí nhớ ngắn hạn của AI trong một cuộc trò chuyện, và nó được đo bằng token. Token là gì? Hiểu đơn giản, nó là một mẩu chữ. Máy không đọc từng chữ như chúng ta, mà đọc từng mẩu chữ.
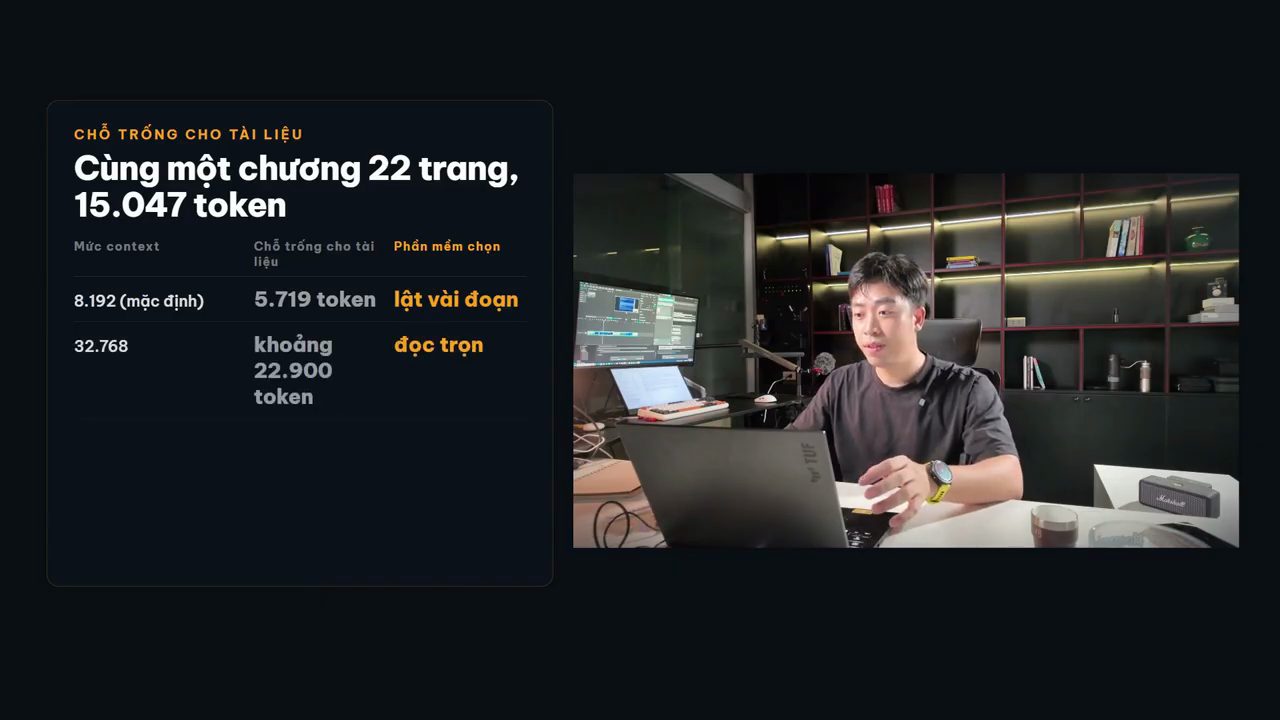
Anh đo thật trên chính chương giáo trình của tập này: 22 trang ra khoảng 15.000 token, tính ra mỗi trang khoảng 680 token. Trên màn hình, con số đo được ghi chính xác là 15.047 token.
Rồi anh mở hộp nạp model. Bạn bật công tắc chỉnh tay thông số nạp (trên màn hình là dòng "Manually choose model load parameters"), rồi chọn model. Chỗ này có dòng Context Length, mức mặc định là 8192 token. Ngay bên dưới có ghi con model này hỗ trợ tới 262.144 token.
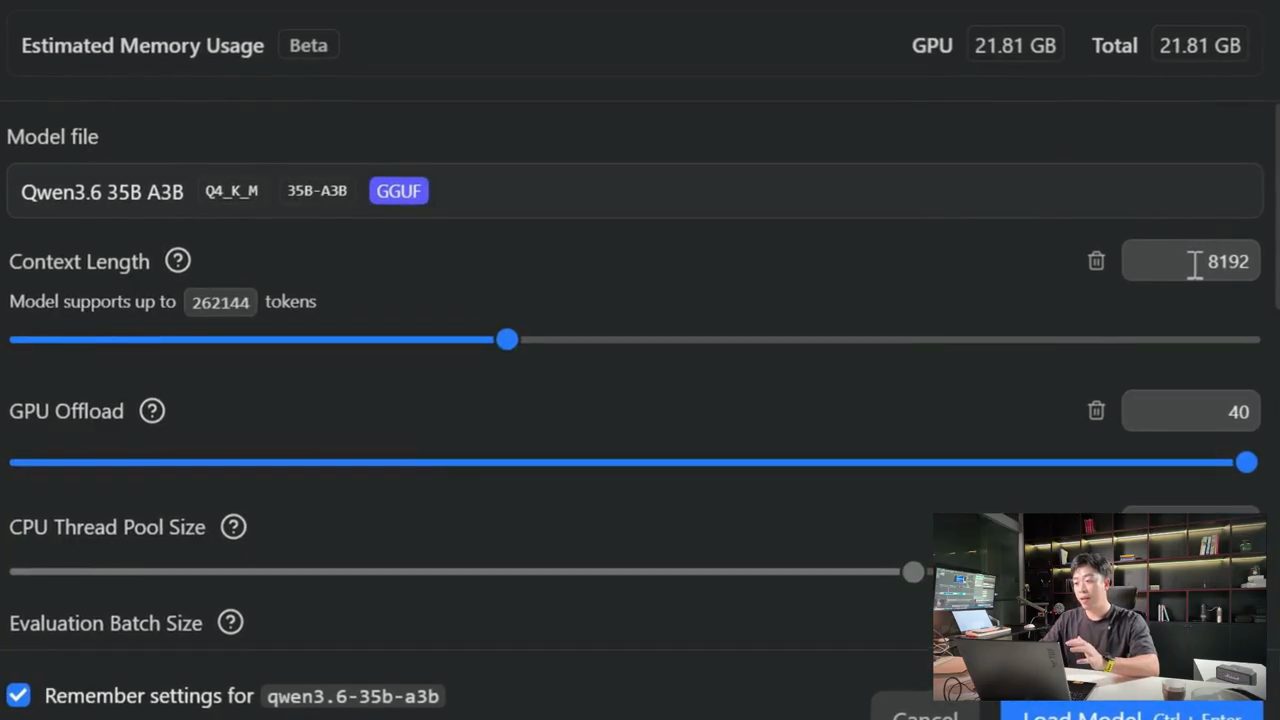
Nghe thì có vẻ rất nhiều. Nhưng phần mềm không dám dùng hết chỗ đó cho tài liệu, vì nó phải trừ chỗ cho câu hỏi, cho câu trả lời, và cho cả phần AI suy nghĩ. Thẻ "Mức cao nhất: Model này đỡ tới 262.144 token" có thêm dòng: nghe thì rất nhiều, tương đương mấy trăm trang.
7. Chỗ trống thật cho tài liệu chỉ có 5.719 token
Anh đã mở hẳn phần ghi chép (log) của chính LM Studio ra xem, và nó ghi rất rõ. Ở mức 8192, chỗ còn dành cho tài liệu chỉ khoảng 5.700 token, tức là khoảng 8 trang. Tài liệu 15.000 token, chỗ trống 5.700, không vừa, nên phần mềm tự chuyển sang lật đoạn.
Còn nếu kéo thanh này lên 32.768 token, chỗ trống cho tài liệu lên khoảng 22.900 token, và 15.000 nằm gọn trong đó. Phần mềm sẽ chuyển sang đọc trọn.
Vì sao phần mềm chỉ dám dùng khoảng 70% chỗ trống cho tài liệu? Anh hỏi người xem có nhớ hình ảnh cái bàn học ở tập 1 không. Bộ nhớ là cái bàn. Bạn không thể chất kín sách lên mặt bàn, vì còn phải chừa chỗ đặt vở để viết. Với AI cũng vậy: phần chừa lại chính là chỗ cho câu hỏi của bạn, cho phần AI suy nghĩ, và cho câu trả lời. Chất hết tài liệu lên bàn thì không còn chỗ mà viết.
Thẻ "Nhớ lại hình ảnh tập 1: Bộ nhớ là cái bàn học" ghi bốn dòng: không thể chất kín sách lên mặt bàn; phải chừa chỗ đặt vở xuống mà viết; với AI, phần chừa lại là chỗ cho câu hỏi và câu trả lời; nên phần mềm chỉ dám dùng khoảng 70 phần trăm cho tài liệu.
8. Tự tính mức context, và kéo lên thì tốn gì
Anh chỉ một cách nhanh để người xem tự tính cho tài liệu của chính mình. Không cần nhớ con số nào ngoài một con số: lấy số trang nhân với khoảng 700, đó là số token của tài liệu. Cách tính này dành cho kiểu giáo trình nhiều chữ như chương ví dụ hôm nay. Rồi lấy con số đó chia cho 70%, ra bao nhiêu thì chọn mức context lớn hơn con số đó.
Số token tài liệu ≈ số trang × 700
Mức context cần ≥ số token tài liệu ÷ 0,7
Ví dụ một chương khoảng 30 trang: 30 nhân 700 là 21.000; 21.000 chia cho 70% (anh nhắc lại: chia cho 70%) ra khoảng 30.000. Vậy chọn mức 32.768 là vừa.
Một tài liệu 100 trang thì sao? Ra khoảng 70.000 token, chia 0,7 thì cần khoảng 100.000, và bạn có thể chọn mức 131.000 (chính xác là 131.072). Trên thẻ "Tính thử hai ví dụ: Chọn mức context nào", dòng chương 30 trang ghi 21.000 token, chia 0,7 ra 30.000, chọn 32.768; dòng tài liệu 100 trang ghi 70.000 token, chia 0,7 ra 100.000, chọn 131.072; dòng cuối "Muốn chắc chắn thì: đính kèm rồi nhìn dòng trạng thái, phần mềm sẽ báo kiểu đọc". Khi nói, anh đọc gọn là tài liệu 100 trang "ra khoảng 100.000 token" rồi chọn mức 131.000.
Anh nhấn mạnh đây chỉ là cách ước lượng. Chữ dày hay thưa hơn thì sẽ lệch đi một chút. Muốn biết chắc chắn thì cứ đính kèm file tài liệu vào, rồi nhìn dòng trạng thái mà lát nữa anh sẽ chỉ: nó sẽ cho bạn biết phần mềm đã chọn kiểu nào.
Vậy kéo cái thanh này lên thì tốn gì? Đây là chỗ anh phải chia sẻ, vì nó khác với điều anh đoán lúc đầu. Lúc đầu anh tưởng kéo lên sẽ tốn cả đống bộ nhớ. Nhưng nhìn lên dòng ước tính bộ nhớ ngay trên đầu hộp nạp model: ở mức 8192, nó ghi 21,81 GB. Anh thử gõ 32.768 vào, con số đổi thành 22,27 GB, tức là chỉ tốn thêm chưa tới nửa GB. Kéo lên tận mức cao nhất 262.144 token, tương đương cả mấy trăm trang, cũng chỉ tốn thêm 5,6 GB, và máy này vẫn còn trống gần 19 GB. Đây là các con số phần mềm tự ước tính trên chiếc máy trong video, theo video đăng ngày 30/09/2026.
Thẻ "Kéo context lên tốn gì: Bộ nhớ gần như không đổi" liệt kê đúng các mức đó: mức 8.192 là 21,81 GB (phần mềm tự ước tính), mức 32.768 là 22,27 GB (thêm chưa tới nửa GB), mức cao nhất 262.144 thêm 5,6 GB (máy vẫn còn trống gần 19 GB). Dòng cuối: cái giá thật là thời gian, đọc xong tài liệu mới nói chữ đầu.
Cái giá thật nằm ở chỗ khác: thời gian. Đọc trọn thì AI phải đọc hết tài liệu trước khi nói chữ đầu, nên tài liệu càng dài bạn càng phải ngồi chờ. Con số cụ thể anh để dành cho phần bảng số. Tiếp theo là làm thật: anh bảo người xem mở LM Studio trên máy mình ra và làm theo từng bước.
9. Bước 1 và 2: nạp model, chỉnh context, đính kèm tài liệu
Tài liệu anh dùng hôm nay là một chương giáo trình kinh tế học về rủi ro và bảo hiểm. Anh tự soạn ra để minh hoạ; người xem cứ dùng giáo trình của chính mình.
Bước 1: nạp model và chỉnh context trước. Bấm vào ô chọn model ở phía trên, chọn con Qwen3.6 35B A3B, con mà tập 3 anh đã chỉ là chạy vừa khoẻ vừa nhanh trên chiếc máy này. Trên màn hình, ô tìm model gõ "Qwen3.6", danh sách Your Models hiện Qwen3.6 35B A3B, và bên dưới là công tắc "Manually choose model load parameters" đang bật. Trước khi nạp, mở phần cài đặt ra, tìm dòng Context Length, kéo lên 32.768, rồi mới bấm nạp (nút Load Model).
Anh nhắc thứ tự này quan trọng: context được chỉnh lúc nạp. Nếu nạp xong rồi mới nhớ ra thì bạn sẽ phải nạp lại.
Bước 2: mở một cuộc trò chuyện mới rồi đính kèm tài liệu. Bấm dấu cộng cạnh ô nhập, chọn Attach File. Lần đầu làm, phần mềm sẽ hiện ra một bảng giới thiệu tên là "File Attachments and RAG".
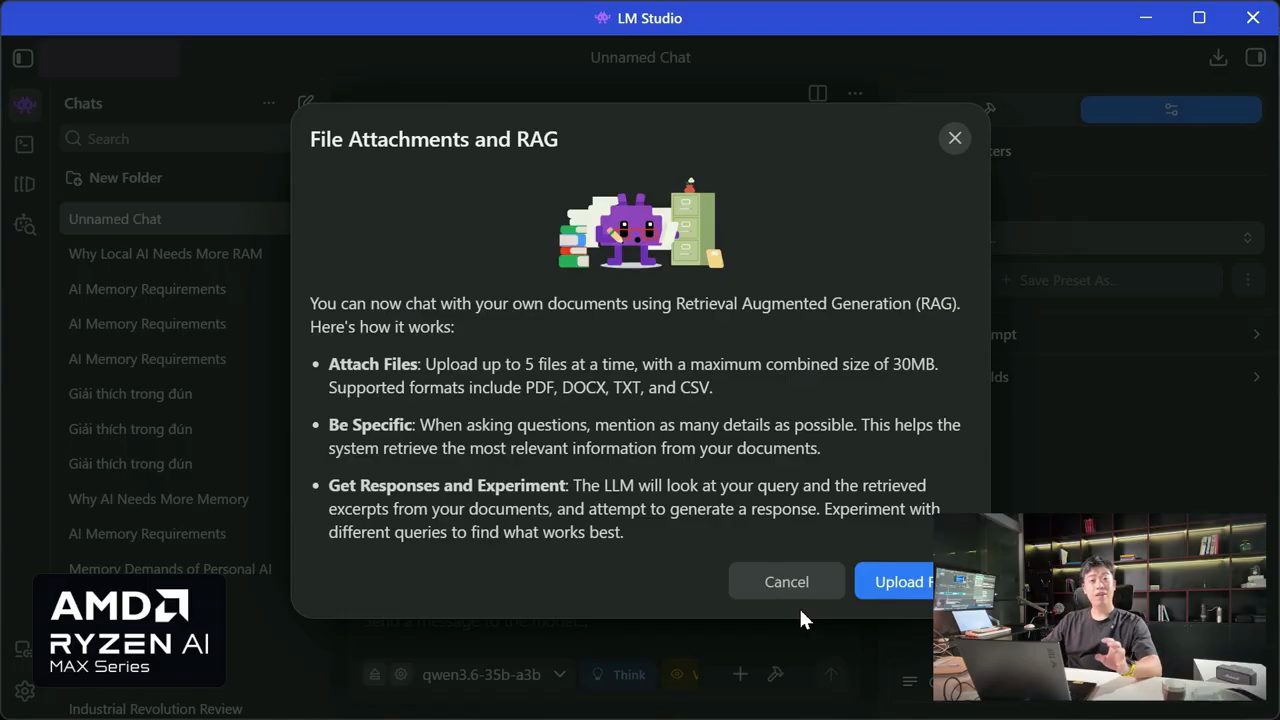
Anh khuyên lần đầu nên đọc qua một chút, vì trên đó ghi mấy thứ quan trọng. Mỗi lần gửi được tối đa 5 tệp. Tổng dung lượng không quá 30MB. Nhận PDF, Word, tệp chữ thường và bảng tính CSV. Và nó còn ghi một câu mà anh rất thích, vì nó nói thật: hãy hỏi càng cụ thể càng tốt để hệ thống tìm đúng đoạn trong tài liệu. Tức là chính phần mềm cũng thừa nhận nó có thể sẽ phải đi tìm đoạn.
Bấm Upload File, chọn file PDF, tệp hiện ra ngay trên ô nhập. Và phải cẩn thận ở chỗ này: PDF phải là loại có chữ thật, tức là bạn bôi đen được từng chữ trong đó. Nếu là ảnh chụp từng trang rồi ghép lại, rất có thể AI sẽ không đọc được chữ nào. Thẻ trên màn hình nhắc đúng ý đó: "Cẩn thận chỗ này: PDF phải là loại có chữ thật".
10. Bước 3: hỏi một câu cụ thể, nhìn dòng chữ nhỏ, mở trang gốc
Bước 3 là hỏi một câu cụ thể. Ở đây anh gõ:
Trong ví dụ về hợp đồng bảo hiểm của bạn Chi, ca phẫu thuật cuối năm Chi phải tự trả bao nhiêu tiền, và vì sao?
Anh bấm gửi, rồi nhìn ngay dòng chữ nhỏ phía trên câu trả lời. Theo anh, đây là dòng quan trọng nhất của cả tập. Nó ghi "Chosen context injection strategy: 'inject-full-content'. All content can fit into the context", anh dịch ra là: đã chọn cách đọc trọn, toàn bộ nội dung vừa với trí nhớ.
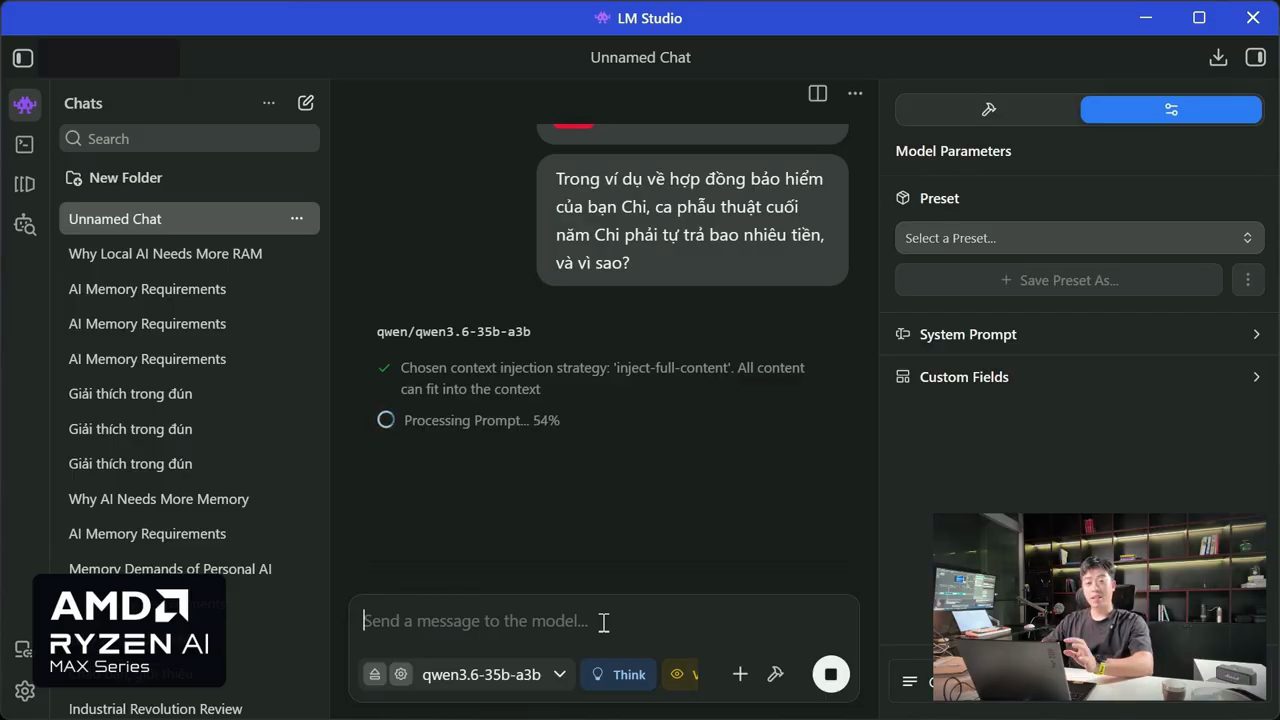
Rồi nó ghi "Processing Prompt" kèm con số phần trăm chạy lên. Đó chính là lúc máy đang đọc hết 22 trang. Bạn chờ một lúc; máy không bị treo đâu.
Rồi AI bắt đầu nghĩ. Model này có phần nghĩ trước khi trả lời, như tập 3 anh đã kể. Và câu trả lời: Chi tự trả 28 triệu đồng, vì hợp đồng có mức trần chi trả nội trú 50 triệu một năm, bảo hiểm đã trả 8 triệu ở lần nằm viện trước, nên chỉ còn trả được 42 triệu cho ca phẫu thuật 70 triệu.
Giờ anh mở file PDF gốc ra, lật tới trang 10. Đây là Bảng 5.2, "Kết quả chia sẻ chi phí trong năm của bạn Chi". Đoạn ngay trên bảng kể lần 3, cuối năm, phẫu thuật sau tai nạn giao thông, chi phí 70.000.000 đồng; mức miễn thường của năm đã dùng hết ở lần 2 nên không trừ nữa; theo tỷ lệ đồng bảo hiểm, tổ chức bảo hiểm phải trả 80% của 70.000.000 đồng, tức 56.000.000 đồng; nhưng mức trần nội trú cả năm là 50.000.000 đồng và tổ chức bảo hiểm đã trả 8.000.000 đồng ở lần 2, nên chỉ còn được trả tối đa 42.000.000 đồng; Chi tự trả phần còn lại là 28.000.000 đồng. Dòng lần 3 trong bảng: Chi tự trả 28 triệu. Khớp.
Anh dặn đừng bỏ qua bước đối chiếu. AI trả lời đúng ở đây không có nghĩa là lần nào nó cũng đúng. Mở trang gốc ra đối chiếu là thói quen mà theo anh người xem nên có ngay từ hôm nay.
11. Lần 1 ở mức 8192: ra đúng 1 trên 11 ví dụ
Giờ tới phần anh hứa ở đầu video: cùng tài liệu này, chỉnh sai một con số thì xem chuyện gì xảy ra. Anh làm 2 lần, mọi thứ giống hệt nhau: cùng máy, cùng model, cùng tài liệu, cùng một câu hỏi. Chỉ khác đúng một chỗ là context length.
Câu hỏi anh chọn là câu mà người ôn thi hay hỏi thật. Thẻ trên màn hình trích câu "Liệt kê đầy đủ tất cả ví dụ có đánh số trong chương", và câu anh gõ vào ô nhập đầy đủ là:
Liệt kê đầy đủ tất cả các ví dụ có đánh số trong chương này, từ ví dụ đầu tiên tới ví dụ cuối cùng, theo đúng thứ tự. Mỗi ví dụ ghi số thứ tự, nội dung trong một dòng và con số kết quả chính.
Chương này có 11 ví dụ, rải từ trang 3 tới trang 19. Muốn trả lời đủ thì phải đọc hết.
Lần 1, context để ở 8192. Anh gửi, rồi chỉ vào dòng trạng thái: "Chosen context injection strategy: 'retrieval'". Anh dịch là: đã chọn cách lật đoạn, vì tài liệu này quá lớn. Rồi nó ghi "Retrieved 3 relevant citations for user query", tức là lấy về đúng 3 đoạn.
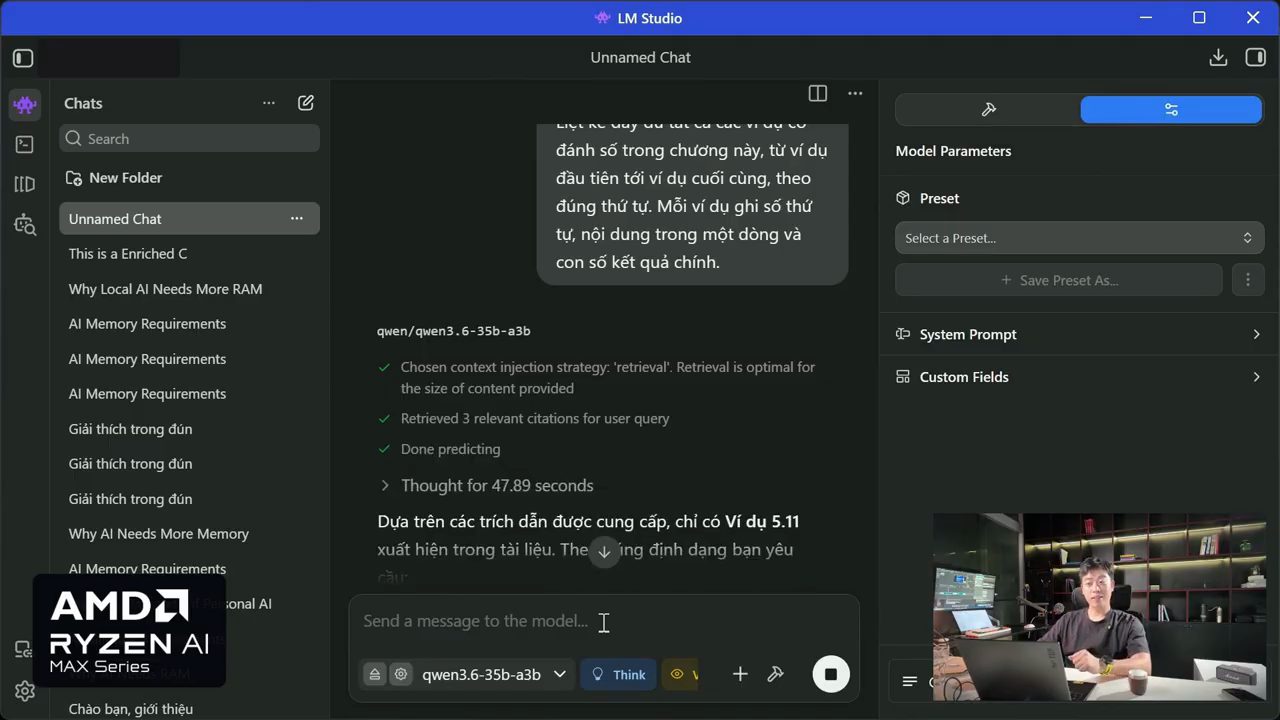
Và câu trả lời liệt kê được đúng 1 ví dụ. Một trên mười một. Tệ hơn nữa, ví dụ duy nhất đó còn bị gọi sai tên: nó lấy một bài tập ở cuối chương và gọi là ví dụ 5.11, trong khi ví dụ 5.11 thật ra là một bài hoàn toàn khác.
Nhưng nếu đọc tới dòng lưu ý ở cuối câu trả lời, chính nó có ghi: các trích dẫn chỉ chứa nội dung của một ví dụ; để liệt kê đầy đủ và chính xác tất cả các ví dụ khác trong chương, xin vui lòng cung cấp thêm nội dung tài liệu. Anh thấy câu này khá đáng quý: AI đã nói thật là nó không đủ dữ liệu. Nhưng nếu bạn đọc lướt và không đọc tới dòng cuối, bạn sẽ nghĩ chương này chỉ có một ví dụ.
12. Lần 2 ở mức 32.768: đủ 11 trên 11
Lần thứ 2, anh nạp lại model, kéo context lên 32.768, mở một cuộc trò chuyện mới, đính kèm đúng file đó, rồi gửi đúng câu hỏi đó. Dòng trạng thái đã đổi thành "inject-full-content", nghĩa là đọc trọn. Rồi "Processing Prompt" chạy lên, và anh ngồi chờ lâu hơn hẳn lần 1.
Rồi câu trả lời. Ví dụ 5.1: tổn thất kỳ vọng, tổng 2 triệu đồng một năm. Ví dụ 5.2: quỹ của 1.000 sinh viên. Ví dụ 5.3: phí bảo hiểm 750.000. Cứ thế đi xuống, tới ví dụ 5.11: xoá mức miễn thường, lợi ích ròng âm 0,7 triệu mỗi người. Đủ cả 11 trên 11, đúng thứ tự, đúng tên.
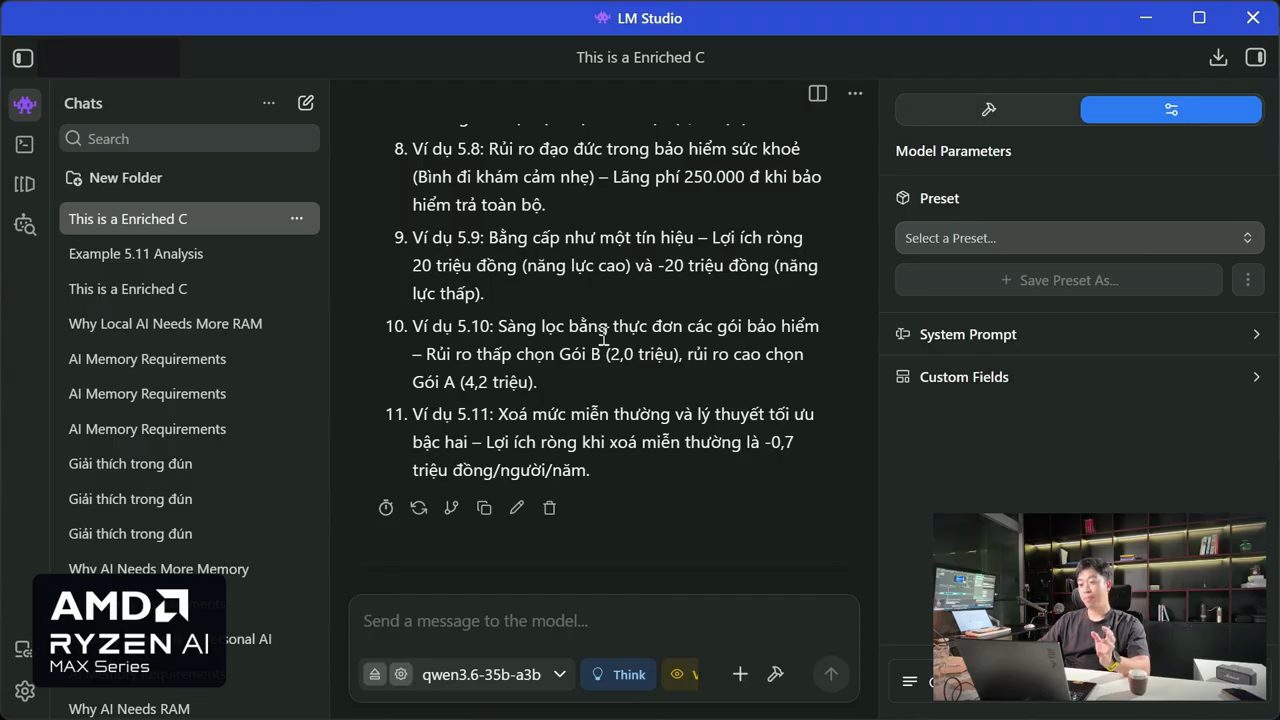
Anh cũng đã soát từng con số với tài liệu gốc. Ở lần quay này, cả 11 ví dụ đều đúng con số chính. Nhưng anh phải kể lại: ở một lần chạy thử trước đó, cũng đúng câu hỏi này, cũng kiểu đọc trọn, có một ví dụ đã lấy nhầm một con số trong bảng. Tức là cùng một câu hỏi, hai lần chạy, kết quả không giống hệt nhau. Anh dặn người xem nhớ rõ: AI là vậy, chứ không phải máy bạn hỏng.
Nên kết luận thật là thế này: chỉnh đúng context thì AI có thể đi từ 1 lên 11, nhưng nó vẫn có lúc trả lời lệch, AI là vậy, nên bạn vẫn phải soát. Thẻ tổng kết so sánh "Cùng câu hỏi, cùng tài liệu: Chỉ khác đúng một con số trong cài đặt" đặt hai cột Context 8.192 và Context 32.768: phần mềm chọn lật 3 đoạn với đọc trọn; liệt kê được 1 trên 11 ví dụ với 11 trên 11; tên ví dụ gọi nhầm với đúng thứ tự, đúng tên; AI có nói thật không: có, ghi ở dòng cuối. Dòng chú thích nhỏ ghi điều kiện đo: ASUS TUF Gaming A14, AMD Ryzen AI Max+ 392, Dedicated Graphics Memory 16 GB mặc định nhà máy, LM Studio 0.4.18, model Qwen3.6 35B A3B, cùng một chương 22 trang và cùng một câu hỏi, ngày 14/09/2026.
Còn một chi tiết nữa làm anh bất ngờ. Lần đầu anh thử bằng câu lập đề cương cho cả chương ở mức 8192, kiểu lật đoạn, mà đề cương vẫn ra đủ 8 mục. Anh khá ngạc nhiên, mở ra xem nó lấy 3 đoạn nào. Hoá ra một trong 3 đoạn đó chính là phần tóm tắt cuối chương, trong đó đã có sẵn 8 ý. Nên với những câu hỏi mà tài liệu đã có sẵn phần tóm tắt, kiểu lật đoạn vẫn làm tốt. Nó chỉ bị hụt khi bạn cần gom những chi tiết nằm suốt cả tài liệu.
13. Bảng số thật: được gì và mất gì
Anh gom hết số lại thành một bảng. Mọi con số là anh đo trên chiếc máy trong video, theo video đăng ngày 30/09/2026.
Dòng 1 là kết quả: lật đoạn ra 1 trên 11 ví dụ, đọc trọn ra 11 trên 11.
Dòng 2 là thời gian chờ, và đây là chỗ đọc trọn phải trả giá. Ở kiểu lật đoạn, máy chờ khoảng 3 giây rồi mới nói chữ đầu, nghĩ thêm khoảng 48 giây, tổng cộng bạn chờ khoảng 51 giây mới thấy câu trả lời. Ở kiểu đọc trọn, máy chờ khoảng 18 giây chỉ để đọc tài liệu, rồi nghĩ thêm 1 phút 19 giây, tổng cộng khoảng 97 giây. Tức là đọc trọn bắt bạn chờ gần gấp đôi, nhưng lại cho bạn câu trả lời đúng gấp 11 lần.
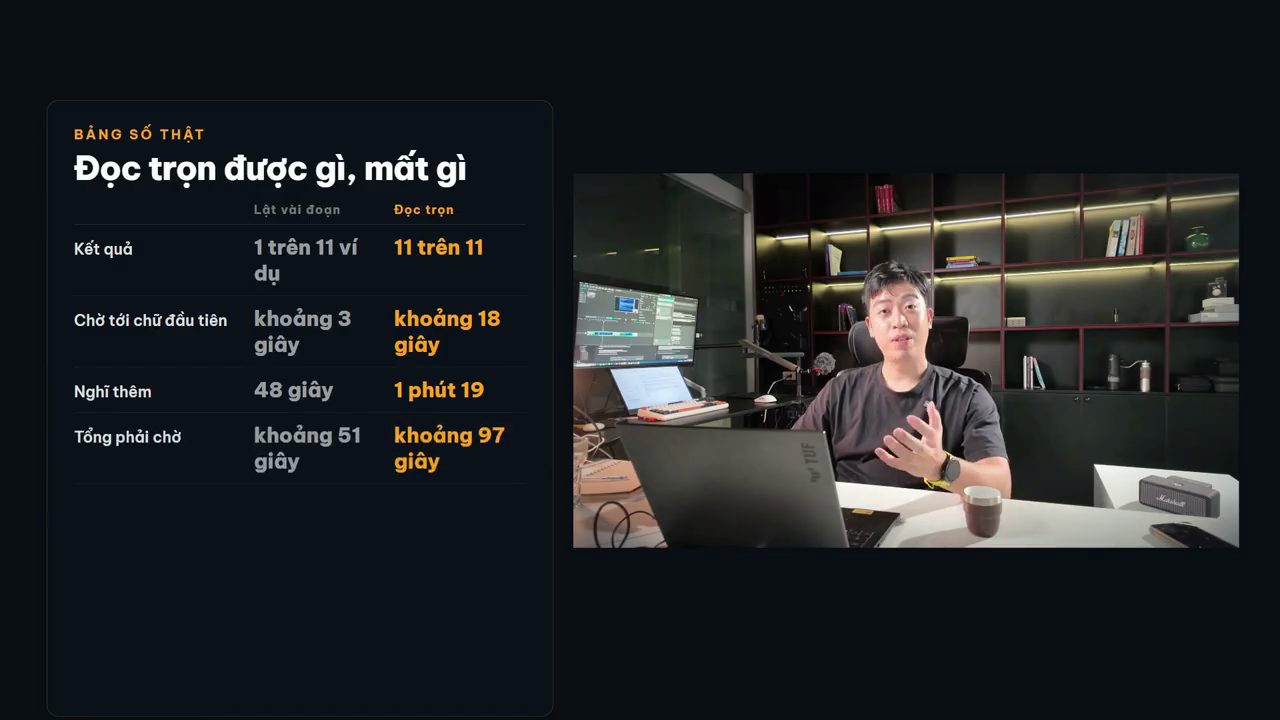
Dòng 3 là tốc độ viết: lật đoạn 62 token mỗi giây, đọc trọn 56. Chậm đi một chút vì đầu AI đang giữ nhiều chữ hơn.
Dòng 4 là bộ nhớ, như anh đã nói ở phần trước: từ 8.000 lên 32.000 chỉ tốn thêm chưa tới 1 GB. Thẻ "Hai dòng cuối của bảng: Tốc độ viết và bộ nhớ" ghi: lật đoạn viết 62 token mỗi giây, đọc trọn 56; chậm hơn một chút vì đầu AI đang giữ nhiều chữ hơn; bộ nhớ từ mức 8.000 lên 32.000 chỉ thêm chưa tới 1 GB; cái đắt là thời gian chờ, không phải bộ nhớ.
Anh đo thêm một thứ để người xem hình dung khi tài liệu dài hơn nữa. Anh đưa vào một tài liệu dài gấp 4 chương này. Lần đó máy phải đọc thêm khoảng 45.000 token, và mất khoảng 95 giây chỉ riêng cho phần đọc. Tốc độ viết cũng tụt từ 55 xuống 44 token mỗi giây. Thẻ "Tài liệu dài gấp bốn: Chờ lâu hơn nữa" ghi đúng ba ý đó, kèm chú thích: phần tài liệu dài gấp bốn đo bằng lệnh, không phải số trên giao diện.
Nên lời khuyên thực dụng của anh là: đưa cho AI đúng phần bạn cần ôn, một chương, hai chương gì đó. Đừng thả nguyên cả quyển giáo trình 500 trang vào chỉ để hỏi một câu.
Như mọi tập, anh ghi rõ điều kiện đo. Cả bảng này đo trên cùng một chiếc máy, mức bộ nhớ đồ hoạ để nguyên 16 GB mặc định, cùng tài liệu và cùng câu hỏi. Số trên màn hình là số phần mềm tự báo; riêng phần bộ nhớ và phần tài liệu dài gấp 4 là anh đo thật bằng lệnh, và trên hình có ghi rõ.
14. Một học kỳ năm sáu môn: dựng thư viện riêng bằng AnythingLLM
Tới đây người xem có thể thắc mắc: mỗi lần ôn một môn lại phải mở một cuộc trò chuyện mới, đính kèm lại từng file; một học kỳ có 5 hay 6 môn thì phải làm sao? Thẻ "Một học kỳ năm sáu môn: Mỗi lần ôn lại phải đính kèm lại từ đầu" ghi: mở cuộc trò chuyện mới, rồi đính kèm lại từng file; LM Studio gom được cuộc trò chuyện, nhưng không có kho riêng cho từng môn; phần sau là cách dựng một thư viện theo môn.
Anh bảo đừng lo. LM Studio có một nút tạo thư mục để gom các cuộc trò chuyện, nhưng tài liệu vẫn gắn vào từng tin nhắn, chứ không có một kho riêng cho từng môn. Nên phần này anh dùng thêm một phần mềm miễn phí tên là AnythingLLM. Nó chạy trên máy và nối thẳng vào LM Studio mà bạn đang có. Anh hướng dẫn luôn.
Bước 1: bật server trong LM Studio. Đây là cái cửa để phần mềm khác nói chuyện được với LM Studio. Vào tab Developer, bật server lên; trên màn hình, mục Local Server hiện "Status: Running" và ô "Reachable at" là địa chỉ máy cục bộ ở cổng 1234. Thẻ chú thích ghi "Bước 2: Địa chỉ server, cổng 1234. Đây là cái cửa để phần mềm khác nói chuyện với LM Studio". Anh dặn nhớ bước này, lát nữa anh sẽ kể chuyện anh quên nó.
Bước 2: mở AnythingLLM lần đầu. Bấm Get Started. Màn hình tiếp theo, "Set Up options", mời bạn tải về một model riêng của nó: trên màn hình (bản v1.16.1, theo video đăng ngày 30/09/2026) là Qwen3 Vision 4B Instruct, khoảng 3,3 GB. Bạn không cần, vì đã có model sẵn trong LM Studio rồi. Kéo xuống dưới cùng, bấm "Manual set up". Tới trang chọn nhà cung cấp, gõ ngay "LM Studio" vào ô tìm kiếm rồi chọn. Nó sẽ tự nhận ra server đang chạy, tự điền luôn model bạn đang nạp, và bạn không phải gõ địa chỉ gì cả. Rồi bấm mũi tên đi tiếp.
Anh dừng lại đọc trang tiếp theo một chút, vì nó liên quan thẳng tới chuyện riêng tư. Nó ghi 3 dòng: model và cuộc trò chuyện chỉ nằm trên máy đang chạy LM Studio; tài liệu được xử lý riêng trên máy này; kho dữ liệu cũng được lưu trên máy này.
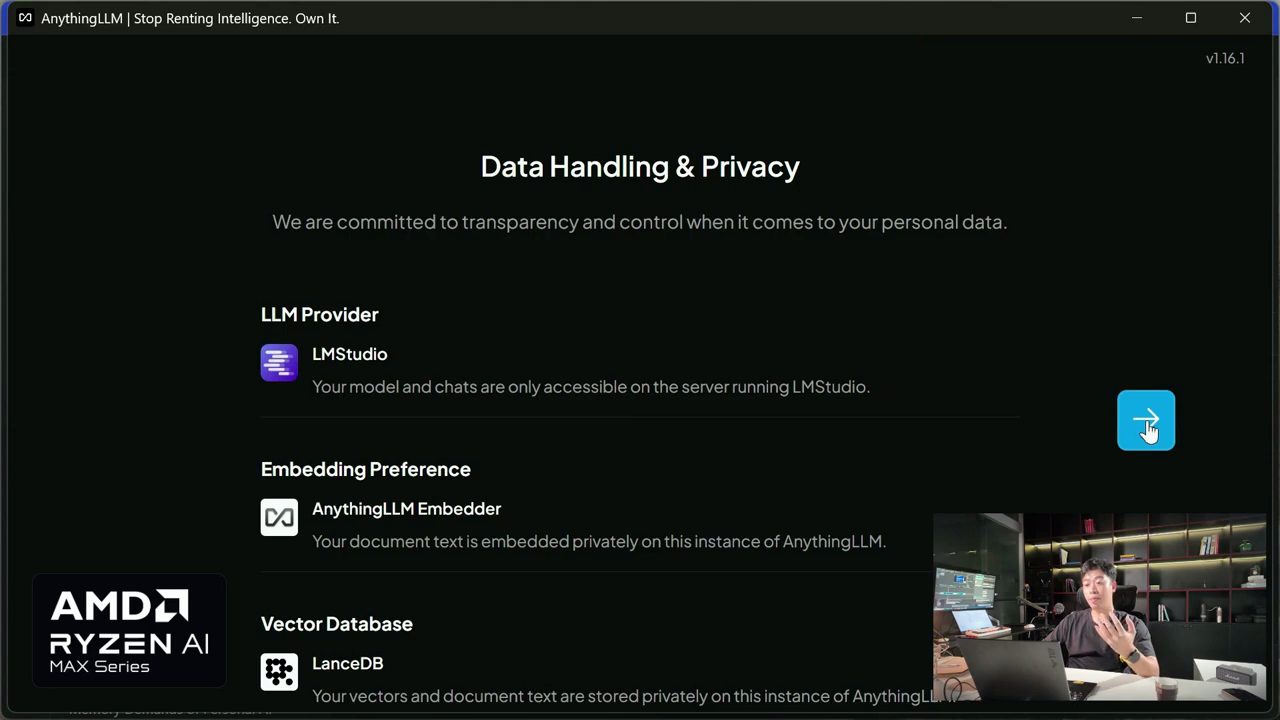
Trang sau là một khảo sát hỏi email; cái này không bắt buộc, bạn có thể bấm Skip Survey. Mấy trang giới thiệu tính năng phía sau cứ bấm mũi tên đi qua.
Bước 3: tạo mỗi môn một workspace. Workspace hiểu đơn giản như một cái ngăn tủ. Anh bấm dấu cộng, gõ tên "Kinh tế học", bấm Save.
Bước 4: bỏ tài liệu vào đúng ngăn. Bấm nút tải lên cạnh tên ngăn Kinh tế học, chọn chương 5 và đề cương môn, bấm Move to Workspace rồi Save and Embed. Thanh tiến độ chạy một lúc là xong. Rồi vào ngăn Sinh học và làm y như vậy với chương Tế bào và đề cương môn đó; trên màn hình là hai tệp chương 2 Tế bào và đề cương học phần sinh học.
15. Bước hay vấp: chọn chế độ Query, rồi thử chéo
Bước 5 là chỉnh một nút, và đây là chỗ anh vấp thật. Ngăn mới tạo ra để chế độ chat là Agent. Lần đầu, anh hỏi luôn trong ngăn Sinh học: khối lập phương cạnh 4 đơn vị có tỷ lệ diện tích trên thể tích bằng bao nhiêu? Nó ra đáp án đúng, 1,5. Nhưng nhìn xuống dưới câu trả lời thì không có dòng nguồn nào cả. Nó tự tính bằng kiến thức sẵn có của nó, chứ không hề mở tài liệu anh vừa bỏ vào. Thẻ chú thích trên màn hình ghi "Nhìn xuống dưới: Không có dòng nguồn nào", kèm dòng: không có mục Sources, nghĩa là model tự tính bằng kiến thức sẵn có, chứ không hề mở tài liệu vừa bỏ vào.
Nên bạn bấm cái bánh răng cạnh tên ngăn, chọn Chat Settings, ở mục Chat Mode chọn Query, rồi bấm Update Workspace. Query nghĩa là chỉ trả lời khi tìm được đoạn liên quan trong tài liệu. Làm việc này cho cả 2 ngăn. Thẻ "Bước hay bị bỏ qua: Ngăn mới tạo để chế độ Agent" tóm lại bốn ý: ở chế độ Agent, câu nào model tự làm được thì nó bỏ qua tài liệu của bạn; dấu hiệu là dưới câu trả lời không có dòng nguồn nào; bấm bánh răng cạnh tên ngăn, vào Chat Settings; chọn Query rồi bấm Update Workspace, làm cho cả hai ngăn. Tài liệu chính thức của AnythingLLM mô tả chế độ Query là chỉ dùng thông tin từ tài liệu đã tải lên, và sẽ báo khi không tìm thấy thông tin liên quan.
Bước 6 là hỏi. Anh hỏi lại đúng câu đó trong ngăn Sinh học. Lần này nó trả lời: theo tài liệu được cung cấp, tỷ lệ là 1,5. Bên dưới có dòng Sources. Bấm vào thấy chương Tế bào, bấm tiếp thì mở ra đúng ví dụ 2.1 trong sách.
Rồi anh thử chéo cho chắc. Vẫn ngăn Sinh học, anh hỏi câu về hợp đồng bảo hiểm của bạn Chi. Nó trả lời là không thể trả lời, vì tài liệu chỉ là đề cương Sinh học đại cương và chương Tế bào, không có thông tin nào về hợp đồng bảo hiểm của bạn Chi. Đúng như mong đợi: hai ngăn không lẫn vào nhau.
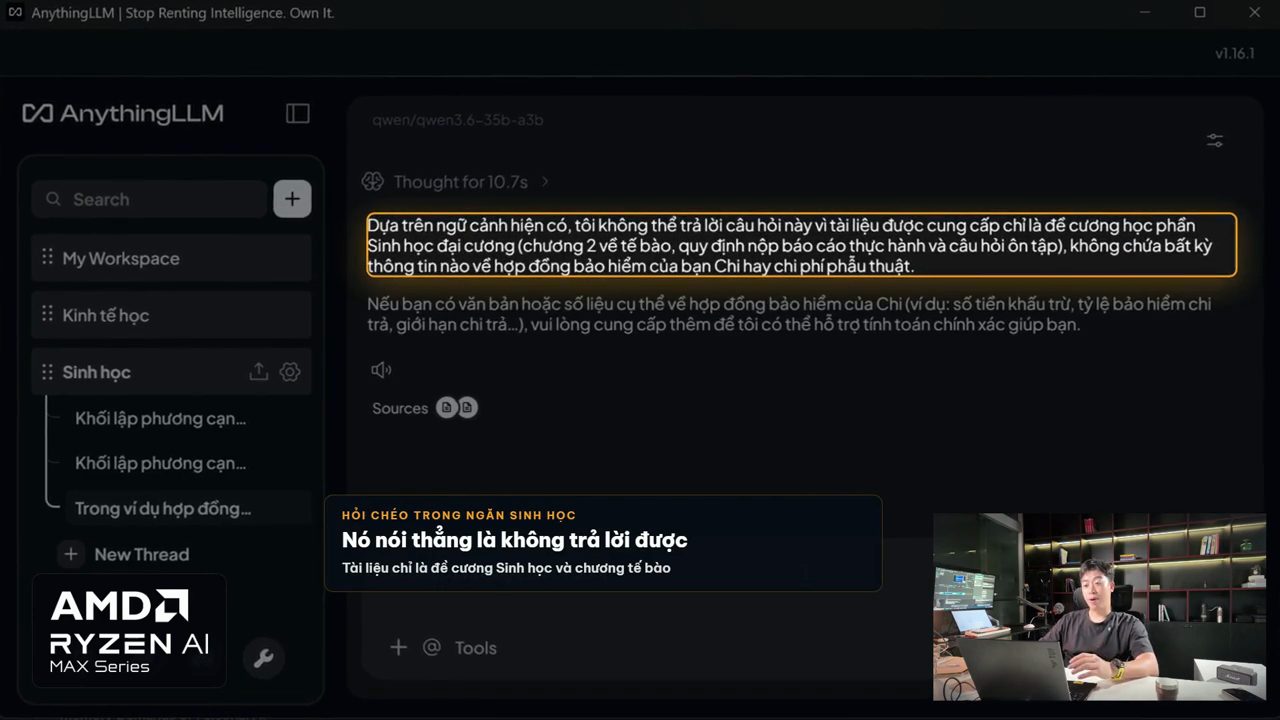
Nhưng anh cũng phải nói thật hai chuyện. Chuyện thứ nhất: công cụ thư viện này cũng là kiểu lật đoạn. Anh thử sang ngăn Kinh tế học, hỏi câu về bạn Chi, đúng câu mà LM Studio ở kiểu đọc trọn đã trả lời đúng 28 triệu. Ở đây nó trượt. Nó nói tài liệu chỉ nêu phần khám ngoại trú, đồng chi trả 100.000 đồng mỗi lần, mà không đề cập tới ca phẫu thuật cuối năm. Thật ra ca phẫu thuật nằm ngay trong ví dụ đó, chỉ là mấy đoạn nó lật trúng không có đoạn này. Thẻ chú thích ghi "Sang ngăn Kinh tế học: Hỏi đúng câu bạn Chi", kèm dòng: cùng câu mà LM Studio đọc trọn trả lời đúng 28 triệu. Cũng may là nó đã nói thật, chứ không bịa.
Chuyện thứ hai anh để kể sau, ở phần lỗi thường gặp. Nên cách dùng hợp lý, theo anh, là dùng thư viện để tra cứu nhanh và gom tài liệu theo môn. Còn với những câu cần đọc kỹ cả một chương thì quay lại LM Studio, chỉnh context cho đủ, và đính kèm đúng chương đó.
16. Lập đề cương và soạn đề trắc nghiệm
Giờ tới phần mà anh nghĩ người xem sẽ dùng nhiều nhất trong mùa thi. Anh quay lại LM Studio, context 32.768, đính kèm chương 5.
Việc thứ nhất là đề cương ôn tập. Anh gõ:
Lập đề cương ôn tập cho toàn bộ chương trong tài liệu này. Liệt kê đủ các mục chính theo đúng thứ tự trong tài liệu, mỗi mục kèm hai đến ba ý cần nhớ.
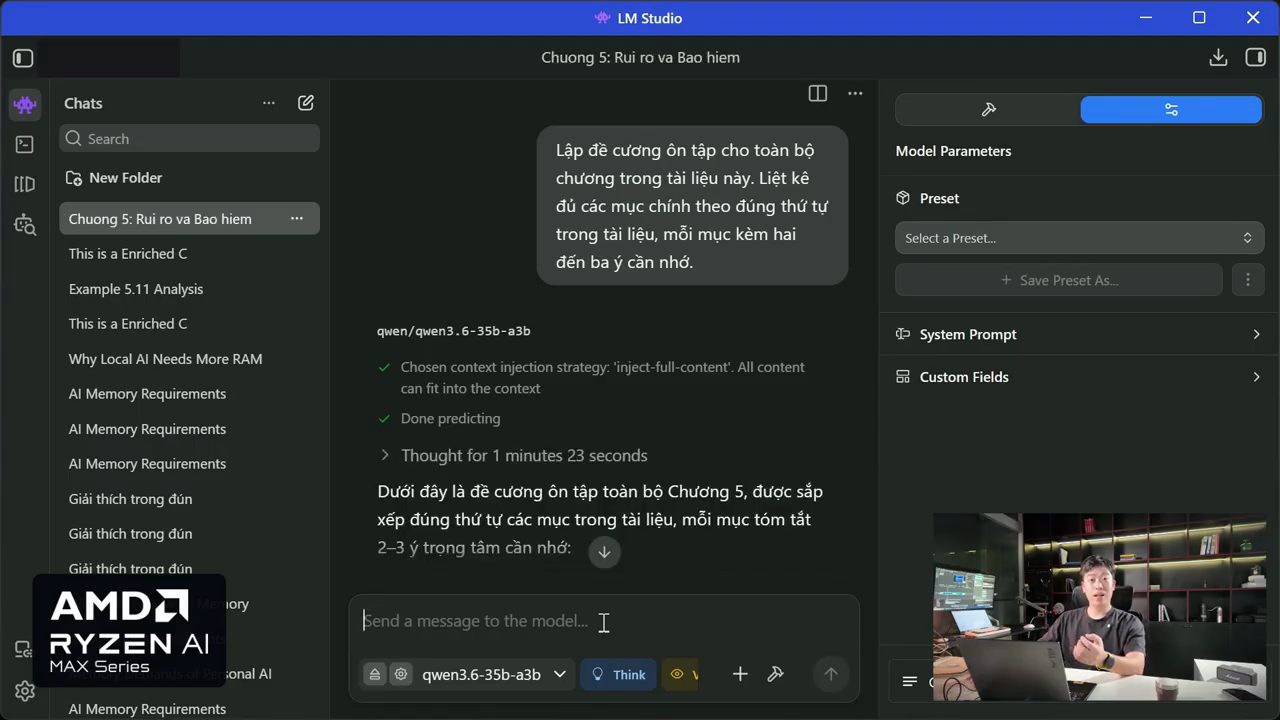
Nó ra đủ 8 mục, đúng thứ tự trong tài liệu, từ "Rủi ro và bất định" ở mục 5.1 tới "Lý thuyết tối ưu bậc hai" ở mục 5.8. Mỗi mục có 3 ý chính. Anh đọc thử mục 5.4: nó nhắc đúng lời khuyên trong tài liệu, đừng chỉ nhìn mức phí, vì hợp đồng phí rẻ mà mức trần thấp có thể khiến người mua chịu thiệt nặng nhất đúng lúc cần được bảo vệ nhất. Thẻ chú thích trên màn hình ghi "Bốn điều khoản cốt lõi: Nó nhắc đúng lời khuyên trong tài liệu", với các điều khoản mức miễn thường, đồng chi trả, đồng bảo hiểm, mức trần.
Cuối đề cương nó còn tự thêm một lưu ý: số liệu trong tài liệu là giả định, khi làm bài hãy nắm cách tính chứ đừng học thuộc con số. Một buổi tối chép đề cương như ngày xưa của anh thì giờ bạn có một bản nháp trong vài phút. Nhưng anh nhắc: đây là bản nháp. Bạn phải đọc lại, gạch bớt đi, thêm ý thầy cô giảng trên lớp.
Việc thứ hai là câu hỏi trắc nghiệm. Anh lại mở một cuộc trò chuyện mới, đính kèm lại chương 5, rồi gõ:
Dựa trên tài liệu này, soạn 10 câu hỏi trắc nghiệm ôn thi, mỗi câu 4 lựa chọn A, B, C, D, ghi đáp án đúng và trang hoặc mục trong tài liệu chứa đáp án.
Lần này nó nghĩ khá lâu: máy ghi là nghĩ 59 giây, gần 1 phút. Anh đùa là người xem có thể đi lấy cốc nước là vừa. Rồi 10 câu hiện ra, mỗi câu 4 lựa chọn. Câu 1 hỏi rủi ro khác bất định ở chỗ nào; trên màn hình, câu 1 hỏi theo cách phân biệt của Frank Knight, điểm khác biệt cơ bản giữa "rủi ro" và "bất định" là gì, và chú thích của video ghi "Mười câu hiện ra: Mỗi câu bốn lựa chọn, kèm đáp án và vị trí tham khảo trong tài liệu". Câu 2 là một câu tính: một sự cố có xác suất 8%, thiệt hại 6 triệu đồng, hỏi tổn thất kỳ vọng bằng bao nhiêu; đáp án 480.000 đồng. Câu 5 hỏi đồng chi trả khác đồng bảo hiểm ở đâu. Và câu 10 hỏi ngược: lý do nào không được tài liệu liệt kê, đúng kiểu câu mà thầy cô rất hay ra; trên màn hình câu 10 được tô sáng: "Lý do nào sau đây KHÔNG được tài liệu liệt kê là nguyên nhân khiến một số rủi ro khó được bảo hiểm với mức phí hợp lý?", với chú thích "Câu hỏi ngược", đáp án C.
Anh soát cả 10 câu với tài liệu gốc, và 10 đáp án đúng cả 10. Riêng câu 2 anh có bấm máy tính lại cho chắc, và nó vẫn đúng.
Nhưng có một chỗ bạn phải để ý. Cạnh mỗi câu nó ghi mục và trang tham khảo. Anh mở PDF ra dò từng câu: 9 câu ghi đúng. Câu 8 ghi trang 16 tới 17, trong khi mục đầu nó dẫn lại nằm ở trang 15. Còn ở một lần chạy thử trước đó, cũng đúng câu lệnh này, nó lệch tận 2 câu. Thật ra lệch 1 trang thì cũng không chết ai cả. Nhưng đó là một lời dặn: số trang AI ghi là để bạn tìm cho nhanh, chứ không phải để chép nguyên vào bài.
Và một mẹo nhỏ từ chính lúc anh thử: đừng bảo nó ra 50 câu một lần. Cứ 10 câu một lần thôi, soát xong rồi yêu cầu tiếp. Vì câu trả lời càng dài thì bạn càng phải chờ lâu, và soát cũng mệt hơn.
17. Tắt mạng mà vẫn chạy, và ba lỗi suýt dính thật
Anh đã nói tài liệu không rời khỏi máy, và giờ anh chứng minh; người xem cũng có thể tự làm. Anh tắt wifi, mở lại cuộc trò chuyện, hỏi lại câu về bạn Chi. Nó vẫn chạy, vẫn ra 28 triệu đồng. Không có mạng thì tài liệu không thể nào đi ra ngoài máy được. Anh cũng đã thử riêng phần tìm đoạn của phần mềm khi mất mạng: nó vẫn chạy bình thường, vì model nhỏ dùng để tìm đoạn cũng đã nằm sẵn trên máy này.
Theo anh, đây là chỗ khác biệt của cách làm hôm nay. Ở đây không nói chuyện nhanh hay chậm, mà là tài liệu của bạn, trí nhớ của bạn, bài làm của bạn vẫn ở lại với bạn.
Rồi anh kể 3 lỗi mà anh suýt dính thật trong lúc quay tập này.
Lỗi thứ nhất, nguy hiểm nhất: để context mặc định rồi tin luôn câu trả lời. Phần mềm tự chuyển sang kiểu lật đoạn mà không báo, chỉ có một dòng chữ nhỏ thôi. Câu trả lời vẫn trơn tru, vẫn có đầu có đuôi, và khi đọc lướt, ta tưởng AI đã đọc hết. Cách tránh: mỗi lần đính kèm tài liệu, nhìn dòng trạng thái. Nếu thấy chữ "retrieval" thì biết nó đang lật đoạn, và khi đó, với những câu cần gom ý cả tài liệu, hãy nạp lại model với context cao hơn.
Lỗi thứ hai: thấy có nguồn trích dẫn là tin câu trả lời lấy từ nguồn đó. Chuyện này làm anh khá giật mình. Trong thư viện Kinh tế học, anh cố tình hỏi câu sinh học về khối lập phương. Tài liệu kinh tế không hề có câu đó. Vậy mà nó vẫn trả lời đúng đáp án 1,5, và bên dưới vẫn ghi nguồn là chương kinh tế học. Con số thì đúng, nhưng không phải lấy từ tài liệu. Đó là kiến thức sẵn có của AI, còn nguồn ghi bên dưới chỉ là mấy đoạn lấy về để biện cho có, chứ không liên quan gì tới câu trả lời.
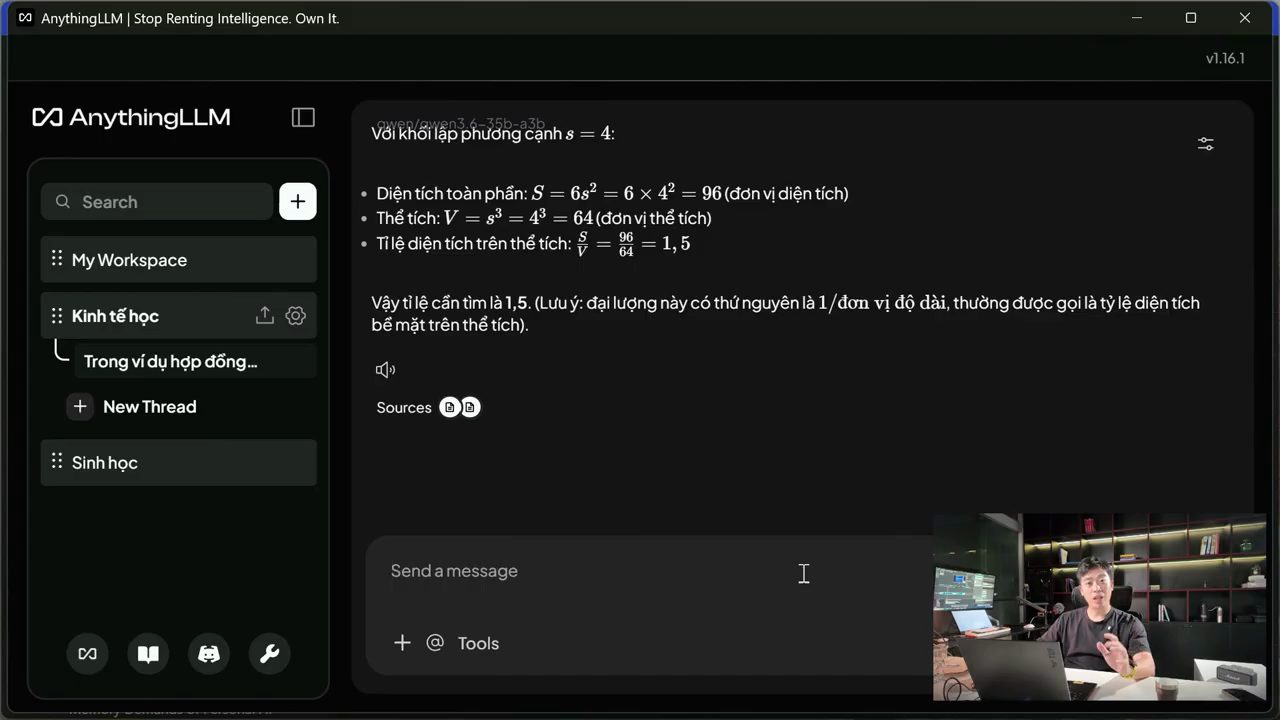
Mà lúc đó ngăn đã để chế độ Query rồi, chế độ chỉ trả lời khi tìm được tài liệu. Nó vẫn tìm ra 4 đoạn kinh tế học, mặc dù không đoạn nào nói về khối lập phương. Thẻ "Nút Query giúp nhiều, nhưng không chặn hết" ghi: ngăn Kinh tế học vẫn tìm được 4 đoạn, dù không đoạn nào nói về khối lập phương. Nên anh dặn: nút Query giúp nhiều, nhưng không chặn được hết. Ở lần anh thử, đáp án có thể đúng. Nhưng với một câu mà kiến thức chung khác với giáo trình của thầy cô, nó sẽ trả lời theo kiến thức chung rồi vẫn gắn nguồn là giáo trình của bạn, và đó mới là chỗ nguy hiểm. Cách tránh: mở đoạn trích dẫn ra đọc; đoạn đó có chứa câu trả lời thật thì hãy tin.
Lỗi thứ ba: mở lại LM Studio rồi quên bật server. Trong lúc làm tập này, anh có tắt LM Studio rồi mở lại. Mọi thứ trông vẫn bình thường, model vẫn nạp được, nhưng server đã tắt và không tự bật lên. Lúc đó AnythingLLM không có chỗ nào để gửi câu hỏi. Cách kiểm tra: mở LM Studio, vào tab Developer, bật server trước rồi mới mở AnythingLLM.
18. Tóm tắt, bài tập và tập sau
Anh tóm tắt nhanh tập này. Thẻ "Tóm tắt: Bốn điều cần nhớ" ghi bốn dòng ngắn; khi nói, anh giải thích từng điều:
- Thứ nhất: đưa tài liệu cho AI thì có 2 kiểu, đọc trọn và lật đoạn, và phần mềm tự chọn dựa vào context length.
- Thứ hai: phải nhìn dòng trạng thái để biết nó đang đọc kiểu nào. Câu cần gom ý cả tài liệu thì phải đọc trọn.
- Thứ ba: kéo context lên tốn bộ nhớ không nhiều, nhưng bắt bạn chờ lâu hơn, nên chỉ đưa đúng phần bạn cần.
- Thứ tư: AI ra đề cương, ra trắc nghiệm rất nhanh, nhưng đáp án, số, trang và nguồn trích dẫn bạn vẫn phải soát.
Bài tập của tập này làm trong khoảng nửa tiếng; thẻ trên màn hình ghi "Bài tập, nửa tiếng: Làm với giáo trình của chính bạn". Lấy một chương giáo trình của chính bạn, mở LM Studio, để context thấp thôi, đính kèm chương đó, rồi hỏi 2 câu: một câu tra một chi tiết cụ thể, và một câu cần gom ý cả chương, ví dụ "liệt kê tất cả các định nghĩa". Ghi lại dòng trạng thái hiện ra. Sau đó nạp lại model với context cao hơn, hỏi lại đúng 2 câu đó, và xem câu trả lời bạn nhận được có gì lạ không.
Sau 4 tập vừa rồi, AI của bạn đã chạy được trên máy, bạn đã có đủ bộ nhớ, đã chọn được đúng model, và giờ nó đọc được tài liệu của chính bạn. Nhưng tới giờ nó vẫn chỉ biết trả lời. Tập sau anh sẽ cho nó thêm tay chân: thẻ "Tập 5: Cho AI tay chân" ghi nó tự mở thư mục tài liệu, tự đọc từng file, tự viết tóm tắt rồi tự lưu, và bạn không phải đính kèm từng thứ nữa. Anh mời người xem theo dõi kênh để không lỡ tập 5, nhắc thông tin về chiếc ASUS TUF Gaming A14 dùng trong khoá nằm ở dòng đầu phần mô tả, rồi hẹn gặp lại ở tập sau.
Nguồn và liên kết 11 nguồn
- Tên gốc: Ôn thi riêng tư 100% offline, cho AI đọc trọn giáo trình | Khóa học Local AI ASUS TUF Gaming A14 #4
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=ZEDIS52VwHo youtube.com
- Kênh YouTube Thanh Trần - 5 Phút AI (Thanh Trần): youtube.com/channel/UCTumIe5W_2OoKUEDAq3xsKQ youtube.com
- LM Studio, trang tải chính thức: lmstudio.ai/download lmstudio.ai
- Tài liệu LM Studio về chat với tài liệu (đính kèm file, khi nào đưa trọn tài liệu vào context và khi nào dùng retrieval): lmstudio.ai/docs/app/basics/rag lmstudio.ai
- Tài liệu LM Studio về chạy local server: lmstudio.ai/docs/developer/core/server lmstudio.ai
- Model Qwen3.6 35B A3B trên trang model của LM Studio: lmstudio.ai/models/qwen/qwen3.6-35b-a3b lmstudio.ai
- AnythingLLM, trang chính thức: anythingllm.com; mã nguồn: github.com/Mintplex-Labs/anything-llm anythingllm.com
- Tài liệu AnythingLLM về nối với LM Studio: docs.anythingllm.com/setup/llm-configuration/local/lmstudio docs.anythingllm.com
- Tài liệu AnythingLLM về các chế độ chat (Chat và Query): docs.anythingllm.com/features/chat-modes docs.anythingllm.com
Related talks
Cách mới để dựng second brain với Claude
Nick Saraev · Nick Saraev · 12 min
Dựng personal knowledge base cho Claude: connector đóng dấu ngày, recency weighting, cheap model viết summary và atoms, tìm bằng BM25.
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Claude Code Skills là gì và cách tạo skill theo 6 bước
Giang · GiangxAI · 29 min
Skill trong Claude Code là gì, khi nào nên xây, 6 bước tạo skill qua demo skill tạo ảnh infographic, CLAUDE.md và ba tầng tải token.