Semantic Blindness: 500,000 Sensors Confused an LLM
AI Engineer World's Fair 2026: Online Track · Video gốc
Vì sao LLM gãy khi phải đọc 500 nghìn tên thiết bị, và cách Phaidra để LLM chỉ lập plan còn code tra cây: 100% chính xác, ít token hơn 300 lần.
1. Nửa triệu tên sensor và một LLM bối rối
Talk có hai người nói. Raahul Singh mở đầu: anh là Staff AI Research Engineer tại Phaidra. Người thứ hai là Vanč Levstik, Senior Engineering Manager, cũng ở Phaidra. Chủ đề hôm nay là lần nhóm đưa cho một LLM năm trăm nghìn tên sensor và LLM đó bị rối. Nhóm đặt tên cho vấn đề này là semantic blindness: model "mù" về cấu trúc của hệ thống vật lý mà nó đang được hỏi, dù có trong tay rất nhiều context.
Phaidra xây AI agent cho AI factory, tức các data center khổng lồ chuyên chạy GPU. Trong đó có những agent cho phép khách hàng "nói chuyện" với data center của chính mình: hỏi để hiểu data center đang vận hành ra sao, đang gặp vấn đề gì trong công việc hằng ngày. Câu hỏi của người dùng có thể là bất cứ thứ gì:
- chiller nào đang chạy nóng;
- phân tích phân bố nhiệt độ trên các data hall của tôi;
- có GPU nào của tôi đang gặp vấn đề không.
Nhìn vào độ đa dạng đó, có thể thấy câu hỏi lúc thì nhắm vào một thiết bị cụ thể ("chiller 6 có ổn không"), lúc thì nhắm vào một nhóm thiết bị ("các GPU trong data hall 1"). Model phải hiểu được người dùng đang nói tới đúng thiết bị nào, hay đúng tập thiết bị nào.
2. Không ai đặt tên giống ai, và demo khác product
Ngành data center chưa thống nhất được một cách đặt tên chung cho thiết bị, và mỗi khách hàng có thể có quy ước riêng. Có những cái tên đơn giản, kiểu rack chứa GPU nằm trong data hall, đọc vào là biết ngay thứ gì nằm ở đâu. Cũng có những cái tên khó hiểu hơn nhiều, kiểu "CH3 gì đó gì đó 6". Raahul nói nhóm đã gặp đủ mọi kiểu tên trong ngành.
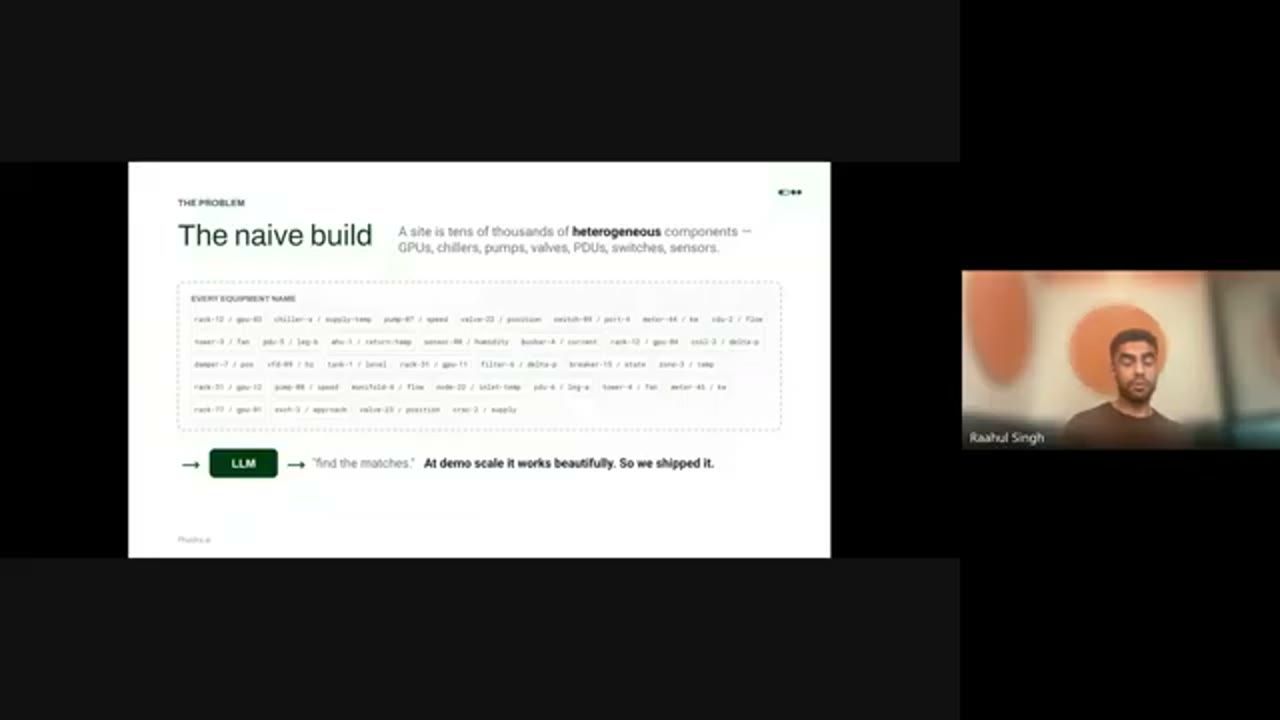
Khi dựng một hệ thống demo, mọi thứ vẫn chạy vì quy mô còn nhỏ. Một LLM đơn giản có thể đọc hết tên thiết bị và đoán ra người dùng đang nói tới cái gì. Nhưng khi lên quy mô thật, bài toán trở nên không giải nổi theo cách đó. Ví dụ ở một AI factory quy mô một gigawatt, bạn sẽ có hơn bốn trăm nghìn GPU, và để nuôi số GPU đó còn có power meter, chiller và đủ loại thiết bị khác. Context window của LLM là hữu hạn; bạn sẽ lấp đầy nó rất nhanh, và mọi thứ hỏng.
Nhóm có một câu hay dùng: một product là thứ chạy được trong mọi tình huống và không hỏng một cách im lặng. Một demo chỉ cần chạy được trong một tình huống.
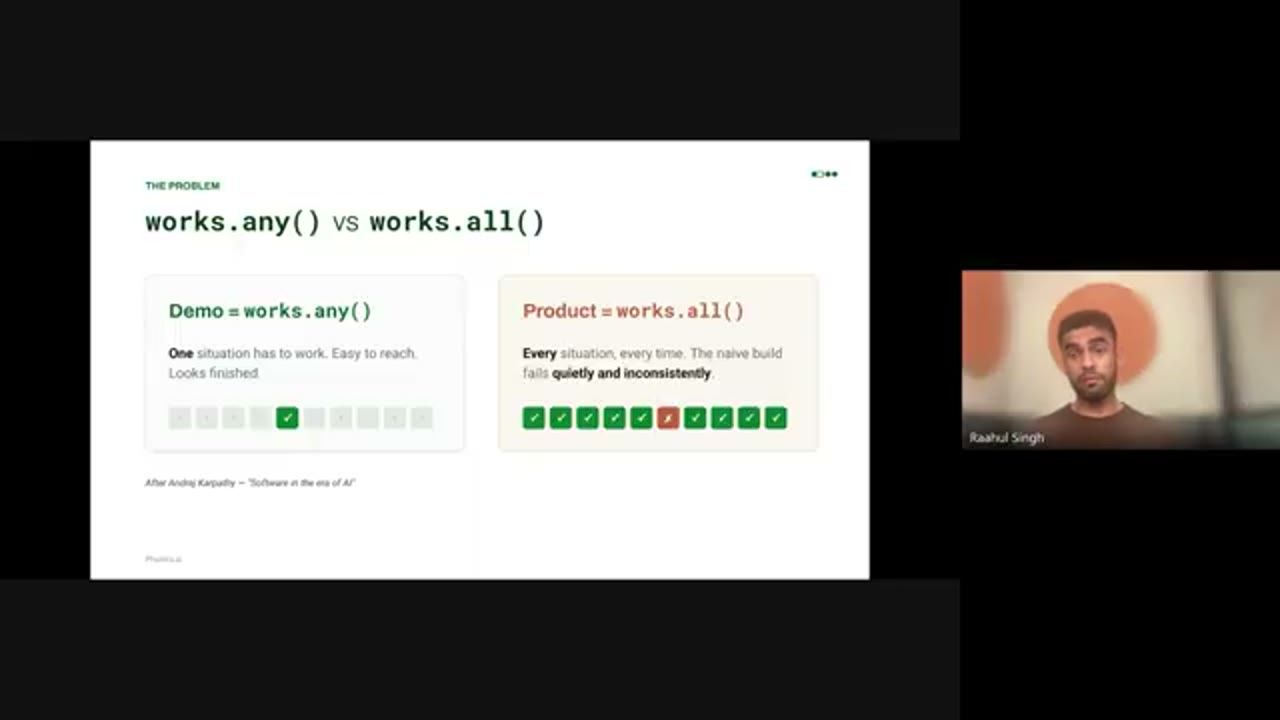
works.any(): chỉ cần một tình huống chạy, dễ đạt, nhìn như đã xong. Product là works.all(): mọi tình huống, mọi lần; bản naive hỏng lặng lẽ và không nhất quán (một dấu X đỏ lọt giữa hàng dấu tick xanh). Slide ghi cách nói này phỏng theo bài "Software in the era of AI" của Andrej Karpathy.3. Vì sao RAG và LLM trần đều gãy
Ngoài cách để LLM tự đoán tên, nhóm cũng có thể nhúng toàn bộ tên vào một RAG database, tức cách tiếp cận vector embedding. Vấn đề là các cái tên thường giống nhau tới mức semantic search thất bại. Hai chuỗi tên dài hai mươi ký tự chỉ khác nhau một ký tự, "chiller 6" thay vì "chiller 7", hay một tên thiết bị này so với một tên khác, thì vector của chúng gần như trùng nhau. Khác biệt quá nhỏ, nên recall rất kém: hệ thống không lấy về được đúng những thiết bị cần lấy.
LLM còn mắc một thứ mà nhóm gọi là frequency penalty. Nếu model phải xuất ra những cái tên rất giống nhau lặp đi lặp lại, nói chính xác hơn là những token rất giống nhau lặp đi lặp lại, thì các cơ chế phạt bên trong LLM sẽ cắt ngang output. Ví dụ người dùng bảo "liệt kê tên tất cả GPU ở aisle 7" và có khoảng một trăm cái. Chỉ riêng việc liệt kê lần lượt cũng khiến guardrail của LLM tưởng rằng model đang rơi vào vòng lặp, và nó tự tắt luôn. Phần mô tả talk gọi hiện tượng này là "repetition kill switch": dữ liệu hoàn toàn đúng, chỉ là model không chịu nổi nó.
Kết luận của phần này: không dùng được cả hai cách. RAG không chạy. LLM trần cũng không chạy. Khi đi vào hệ thống production, nhóm cần một thứ scale được cùng với hệ thống.
4. Lối tắt divide and conquer: bức tường fan-out
Có những lời giải ngây thơ mà nhóm đã thử. Cách dễ nghĩ ra nhất là chia để trị: lấy toàn bộ thiết bị, cắt thành nhiều shard, đưa từng shard qua LLM. Gọi song song là được, đúng không? Nhóm cũng đã nghĩ vậy.
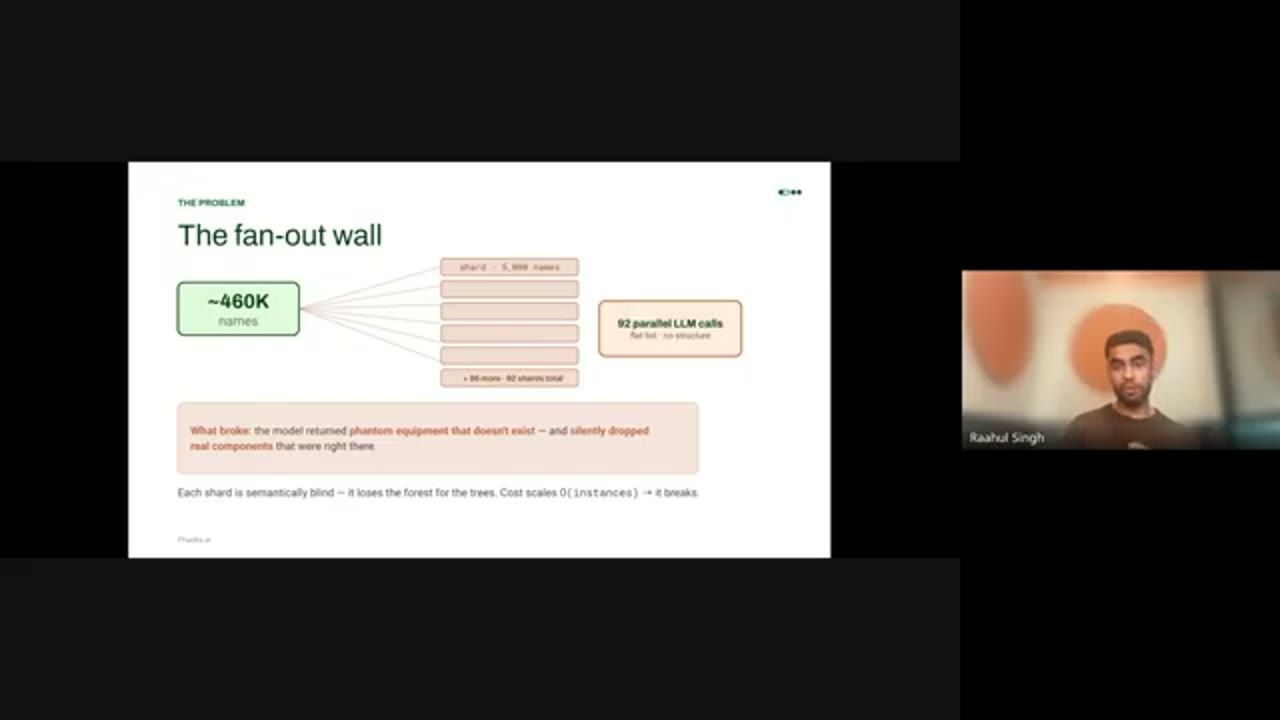
Kết quả là recall tệ và hallucination. LLM bịa ra những thiết bị "ma" không hề tồn tại, đồng thời lặng lẽ bỏ sót những thiết bị có thật. Với hệ thống mission-critical, nơi người dùng cần biết chính xác chuyện gì đang xảy ra với hệ thống của họ, đây là vấn đề lớn. Mỗi lỗi kiểu này làm niềm tin của người dùng mòn đi rất nhanh. Đồng thời, bạn bỏ lỡ những sự cố cụ thể, và những sự cố đó có thể lan thành sự cố ngày càng lớn hơn về sau.
Điều nhóm nhận ra ở đây: khi hạ tầng vật lý lớn lên, một lời giải dựa trên LLM không thể lớn lên theo số thành phần, số instance hay số node. Phải tìm thứ gì đó tăng sublinear theo số thiết bị.
5. Tăng theo độ sâu của cây, không theo số instance
Lời giải nhóm tìm ra là: đừng tăng theo instance, hãy tăng theo tree depth. Tree depth ở đây nghĩa là gì? Nhóm nhận ra một AI factory được sắp xếp theo cấu trúc phân cấp. Có các data center; mỗi data center có nhiều data hall; mỗi data hall có nhiều aisle; rồi tới row, rack, và cuối cùng là GPU. Tương tự, một chiller plant có các phòng đặt chiller, rồi có pump, rồi có một cụm cooling tower riêng.
Nó giống một cái cây. Độ sâu của cây tăng rất chậm, còn độ rộng thì tăng cực nhanh. Nói cách khác, hệ phân cấp này rất hiếm khi thêm một loại thiết bị mới, nhưng khi đã thêm thì thêm rất nhiều cái. Bạn có rất nhiều GPU, nhưng ngoài GPU ra thì những thứ khác không nhiều đến vậy.
Nhóm nhận ra có thể dùng chính cấu trúc này để giải bài toán, và có bốn insight thực sự đóng vai trò then chốt. Bốn phần tiếp theo đi qua từng cái.
6. Insight 1, linearizer: một triệu node thành khoảng 50 dòng
Insight đầu tiên là một linearizer. Ý Raahul là: LLM phải biết từng loại thiết bị được sắp xếp ở đâu, và phải ánh xạ được từ một câu hỏi mơ hồ của người dùng sang một thiết bị cụ thể hoặc một nhóm thiết bị. Ở đây, một bản tóm tắt graph của hệ thống rất hữu ích.
Ví dụ một factory quy mô một gigawatt có thể có hơn một triệu node, mỗi node là một thiết bị riêng. Nhưng vì điều bạn cần là đi từ gốc tới lá, bạn chỉ cần mô tả tất cả các đường đi, và đó là một danh sách nhỏ, hữu hạn. Để tới một GPU, bạn chỉ cần đi qua bốn tầng. Để tới một chiller, cũng bốn tầng. Để tới các switch, cũng bốn tầng. Nhờ vậy, một hệ thống 64 GPU và một hệ thống 460 nghìn GPU tạo ra bản tóm tắt gần như cùng kích thước. Context đã được cô lại này cho LLM mọi thứ nó cần để hiểu một plant được bố trí ra sao và các thiết bị phân bố thế nào trong plant đó.
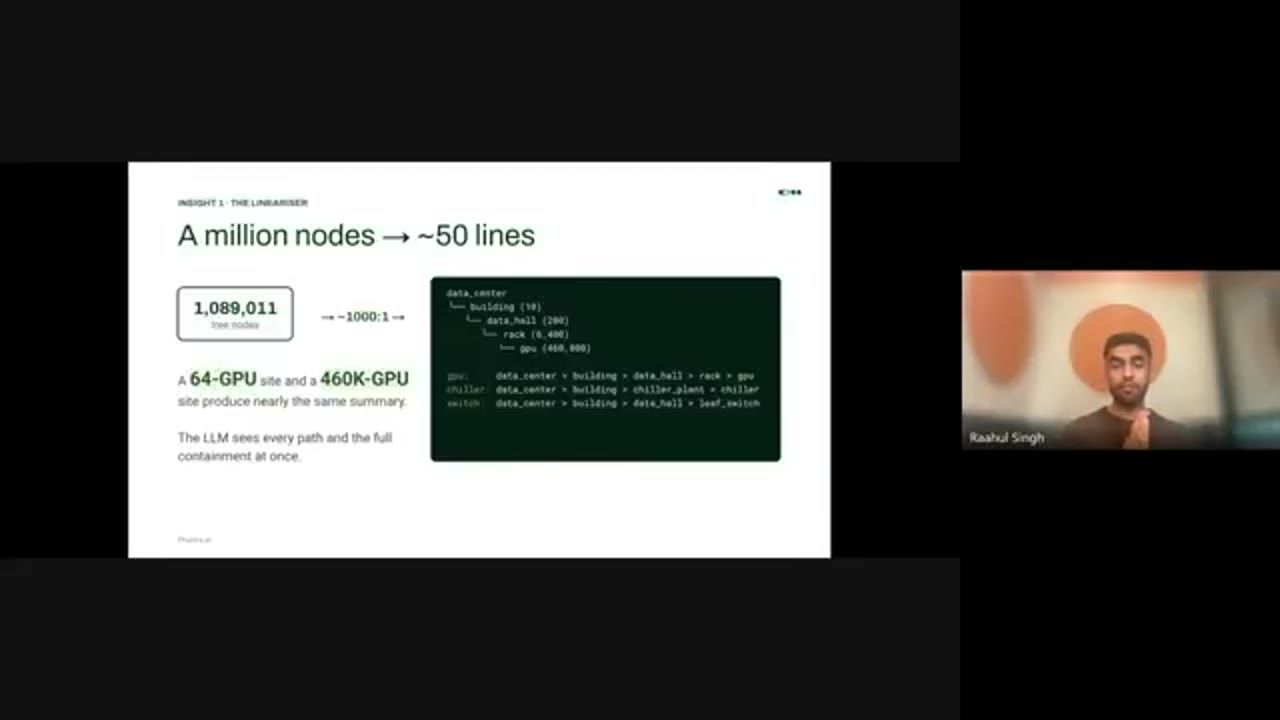
data_center
└── building (10)
    └── data_hall (200)
        └── rack (6,400)
            └── gpu (460,800)

gpu:     data_center › building › data_hall › rack › gpu
chiller: data_center › building › chiller_plant › chiller
switch:  data_center › building › data_hall › leaf_switch
7. Insight 2, planner: LLM giỏi lập kế hoạch, không giỏi tìm kiếm
Insight thứ hai: LLM giỏi planning nhưng không giỏi searching. Nhóm nhận ra điều này khi thấy recall quá tệ ở lời giải chia shard. Vì vậy, thay vì bắt LLM lục qua đủ loại tên mơ hồ mà người dùng có thể đưa ra, nhóm yêu cầu LLM cho biết chính xác phải tìm chúng bằng cách nào.
Ví dụ câu hỏi: "Cho tôi tất cả GPU đang chạy nóng trong data hall 11." LLM không cần đọc tên của mọi GPU để xác định cái nào nằm trong data hall 11 rồi mới xét cái nào đang nóng. Nó chỉ cần trả về structured output nói rằng: cần collect GPU; phạm vi để collect là một subtree, chính là data hall 11; và filter cần áp vào để ra đúng thứ mình muốn là "GPU đang chạy nóng". Filter có thể mang nghĩa khác nhau tùy context, và bạn có thể cài nhiều loại filter khác nhau. Điều duy nhất cần biết là làm sao dựng được tập hợp mình muốn tới.
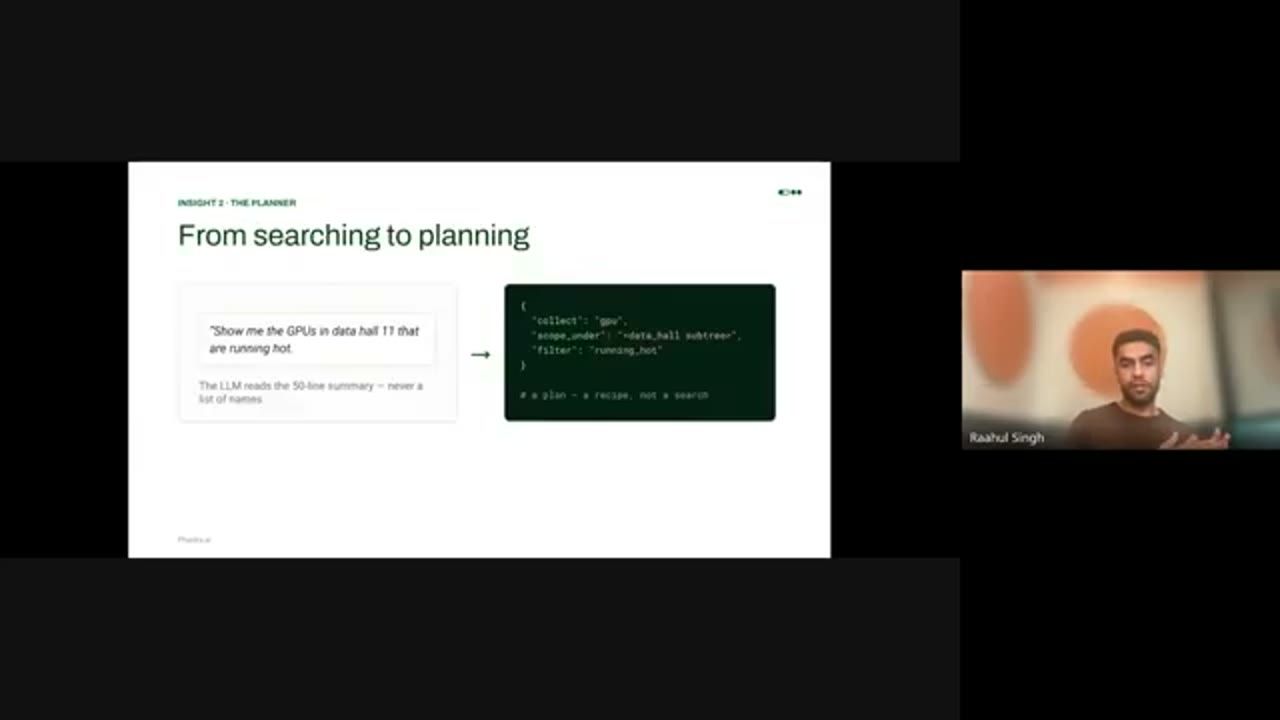
{
  "collect": "gpu",
  "scope_under": "<data_hall subtree>",
  "filter": "running_hot"
}
# a plan - a recipe, not a search
8. Insight 3, pre-indexed tree và phép toán tập hợp
Insight thứ ba: một khi đã có structured output nói rõ cần gì, việc xây backend cho nó khá đơn giản và thẳng. Tất cả những gì cần làm là tạo sẵn các tập con của thiết bị, mà nhóm gọi là pre-indexed tree, dựa theo vị trí và theo cách mỗi thiết bị tương tác với các thiết bị xung quanh, để biết cần nhìn vào đâu.
Quay lại ví dụ ở slide trước: muốn xem GPU trong data hall 11. Chỉ cần lấy toàn bộ GPU của data hall 11 trong một subtree đã index sẵn (hoặc của các data hall khác, hay của các rack khác, cũng theo cách đó). Rồi để ra kết quả cuối cùng, chỉ cần chạy một truy vấn tìm mọi GPU đang chạy nóng và lấy giao của hai tập. Các phép toán tập hợp bảo đảm recall và độ chính xác hoàn hảo, bất kể người dùng muốn lọc theo cách nào và câu hỏi của họ mơ hồ tới đâu.
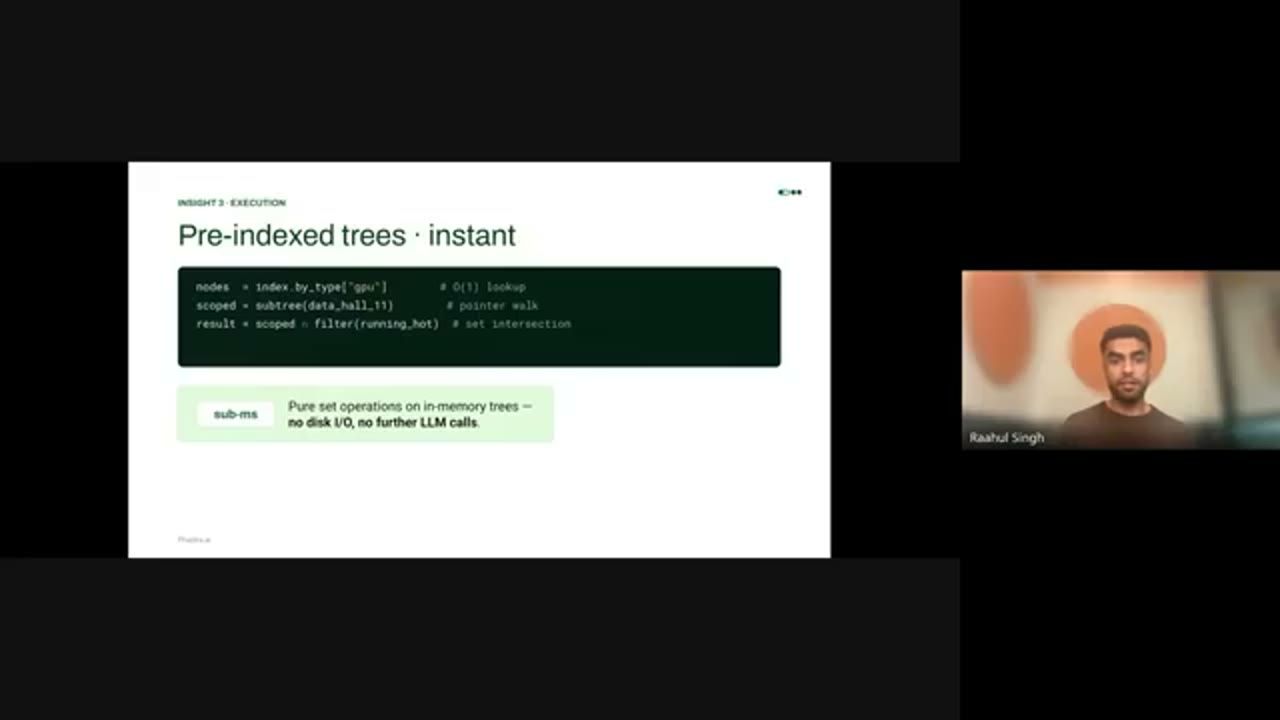
nodes  = index.by_type["gpu"]          # O(1) lookup
scoped = subtree(data_hall_11)          # pointer walk
result = scoped ∩ filter(running_hot)   # set intersection
(Tới đây Raahul nhờ chuyển sang slide tiếp theo, và tiếp tục với insight cuối.)
9. Insight 4, pattern thay cho tên: cost gần như hằng số
Insight cuối: nếu câu hỏi cực kỳ mơ hồ thì sao? Khi đó vẫn phải để LLM tìm kiếm. Nhưng thay vì tìm trực tiếp bằng tên, nhóm thấy rằng để LLM đưa ra pattern cần tìm thì hữu ích hơn nhiều: pattern trong dữ liệu, pattern trong tên, so với việc đưa nguyên danh sách tên cho LLM.
LLM không bao giờ phải nhìn thấy một lượng token khổng lồ. Nó chỉ cần nhìn vài pattern trong quy ước đặt tên, hiểu chính xác người dùng đang nói tới cái gì, tạo ra một pattern, rồi nhóm tự chạy pattern đó ở backend. Cách này bảo đảm LLM có cost vận hành không đổi, hoặc gần như không đổi. Còn nếu phải đọc hết mọi thứ, cost sẽ tăng tuyến tính theo số thiết bị, mà bản thân số thiết bị lại tăng theo cấp số nhân khi hệ thống lớn lên.
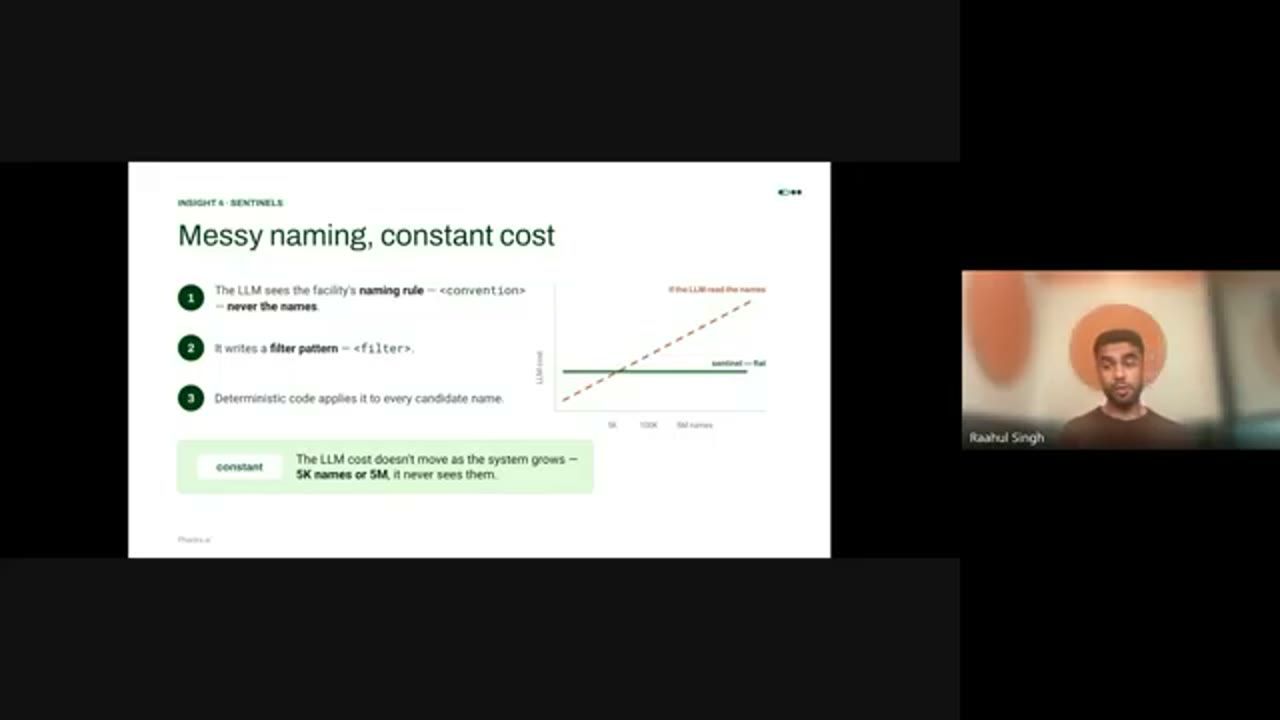
<convention>, chứ không bao giờ thấy các cái tên; (2) nó viết một filter pattern, <filter>; (3) code deterministic áp pattern đó lên mọi tên ứng viên. Biểu đồ so sánh: nếu LLM đọc tên thì cost là đường chéo đi lên theo số tên (5K, 100K, 5M), còn cách sentinel là một đường phẳng. Cost của LLM không đổi dù hệ thống có 5 nghìn hay 5 triệu tên, vì nó không bao giờ nhìn thấy chúng.10. Đường đi end-to-end của một câu hỏi
Ghép lại, một câu hỏi của người dùng được xử lý từ đầu tới cuối như sau. Câu hỏi, dù nhắm vào một thiết bị hay một nhóm thiết bị, đi vào một planner LLM. Planner hiểu ý định của người dùng và trả về một search plan. Dựa trên plan đó, một deterministic resolver dùng index, làm các phép toán tập hợp, xác định chính xác cần làm gì và tạo ra tập cuối cùng ứng với câu hỏi. Nhóm gọi tập đó là result set.
Toàn bộ chỉ gồm hai hoặc ba bước, thay vì một agentic loop nhiều bước có thể chạy đi chạy lại không dứt. Nhờ vậy, tổng cost cũng tương đối phẳng và không đổi.
11. Production readiness: đo trước khi tới tay khách
Raahul nói "Cool", và tới lượt Vanč. Anh tóm vai trò của mình: nếu việc của Raahul là thiết kế kiến trúc thì việc của anh là production readiness. (Anh hắng giọng.) Nhóm phải chắc rằng những gì đã thiết kế, những lời giải gọn gàng đã nghĩ ra, thực sự đứng vững dưới tải thật, với dữ liệu thật của khách hàng, và với đủ loại edge case lộn xộn mà bạn chỉ gặp trong production.
Vì vậy, trước khi bất cứ thứ gì tới gần khách hàng, nhóm cho nó qua một loạt test và eval kỹ lưỡng. Hệ thống mới được đo đối đầu trực tiếp với hệ thống cũ: cùng LLM model, cùng dữ liệu, và mỗi case chạy ba lần cho chắc. Mục tiêu rất đơn giản: chứng minh lời giải của Raahul đã sẵn sàng cho production. Và Vanč khẳng định: đúng là sẵn sàng.
12. Độ chính xác giữ nguyên khi scale
Nhìn vào số liệu: cách làm cũ xuống cấp khá nhanh theo quy mô. Ở 64 GPU, nó đạt 80% correctness, và tụt xuống khoảng 30% khi số GPU tăng lên 460 nghìn. Ngược lại, cách làm mới giữ correctness ở mức 100% trên toàn bộ các test được đưa vào.
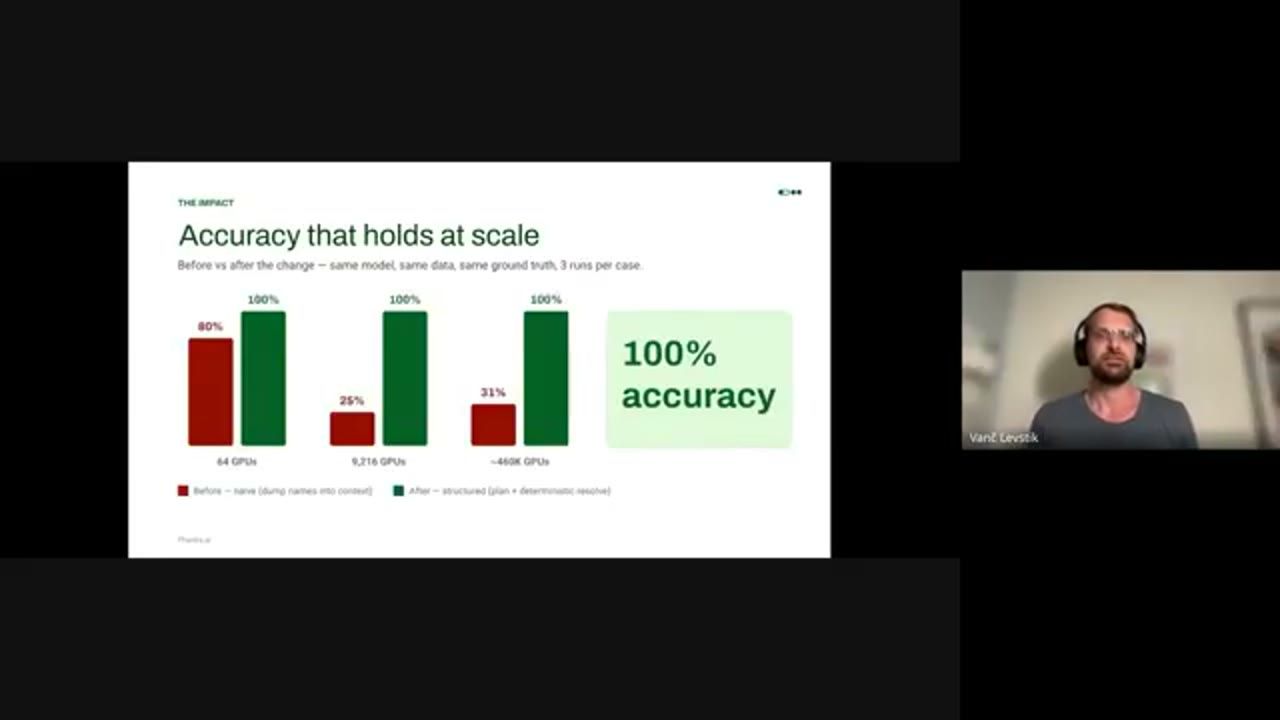
Đây không chỉ là test tổng hợp, mà còn là dữ liệu thật. Nhóm có 66 case trên sáu hệ thống production thật, và các case này cũng cho ra không lỗi nào.
13. Ít token hơn 300 lần, cost phẳng ở mọi quy mô
Không chỉ đúng hơn, hệ thống mới còn nhẹ hơn đáng kể. Với một data center quy mô một gigawatt, cách làm cũ đốt 116 triệu token chỉ cho một lượt evaluation, mà vẫn còn rất nhiều lỗi. Cách mới dùng 390 nghìn token, tức ít hơn khoảng 300 lần.
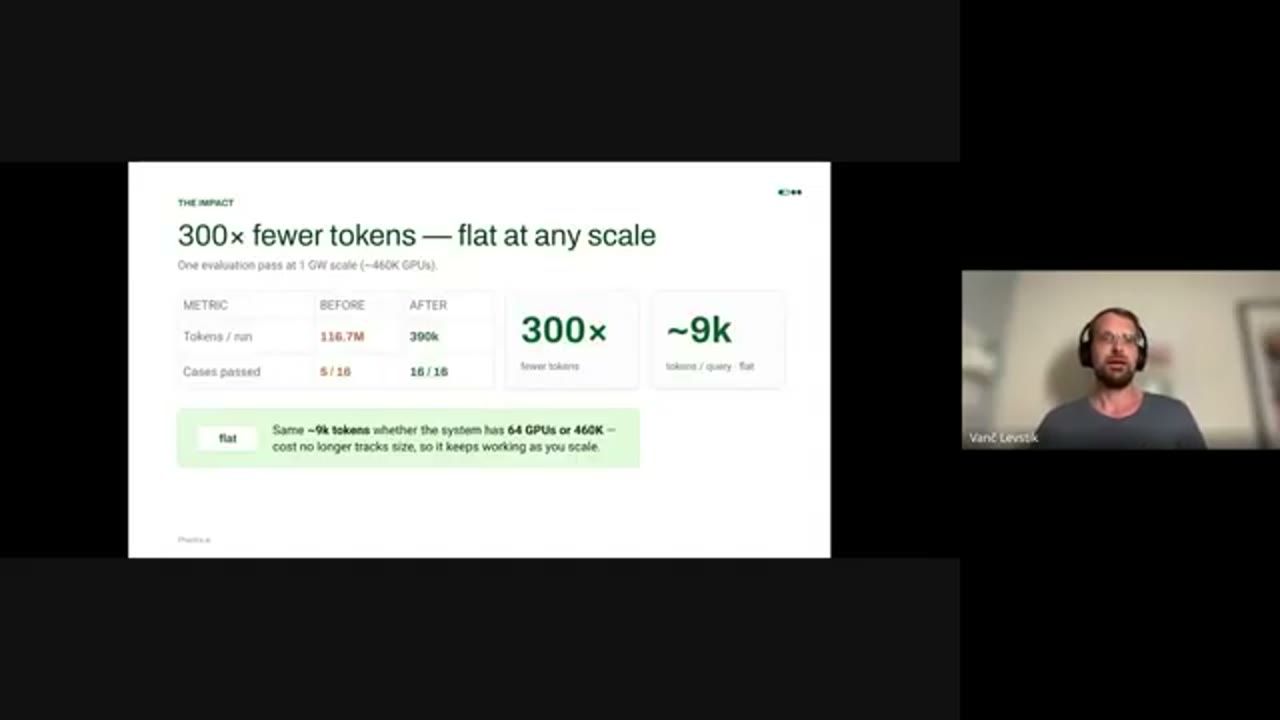
Nhưng phần quan trọng nhất là cost phẳng. Như Raahul đã nói, hệ thống lớn dần, nhưng cost của một câu hỏi vẫn là 9.000 token, dù hệ thống có 64 GPU hay 460 nghìn GPU. Thay vì để cost tăng theo cấp số nhân khi khách hàng mở rộng hệ thống, cost giữ nguyên. Đó là impact của thay đổi này.
14. Lăng kính của Karpathy: Software 1.0 và Software 3.0
Tiếp theo là điều nhóm đã học được, phần Vanč muốn người nghe mang về áp dụng vào công việc của mình. Nó bắt đầu từ một lăng kính của Andrej Karpathy; phần lớn người nghe chắc đã xem bài nói hoặc cách anh ấy đóng khung vấn đề này (keynote "Software in the era of AI" tại AI Startup School 2025, đăng trên YouTube với tên Software Is Changing (Again)). Karpathy nói về các loại software khác nhau.
Software 1.0 là code deterministic do bạn viết: dự đoán được, chính xác, nhưng kém linh hoạt hơn nhiều. Ở phía bên kia là Software 3.0: về cơ bản là hành vi bạn "prompt" ra từ một LLM. Trong trường hợp của Phaidra, đó có thể là câu "Show me the GPUs in data hall 11 that are running hot." Cách này rất linh hoạt, thông minh, nhưng hơi mờ, không chính xác tuyệt đối.
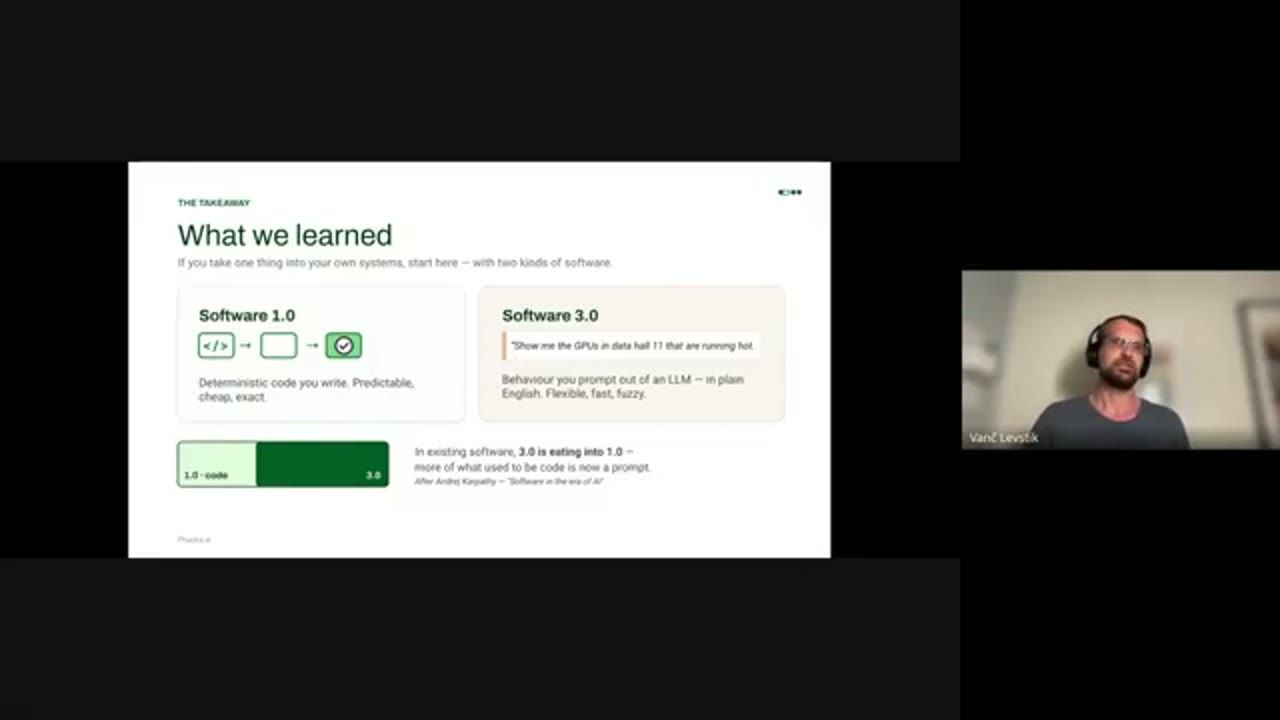
Nhận xét của Karpathy là trong software kiểu cũ, 3.0 đang đều đặn ăn dần 1.0: ngày càng nhiều thứ từng là code deterministic trở thành prompt. Vanč bảo người nghe giữ hình ảnh đó trong đầu, vì bài học cho các hệ thống AI-native xây mới lại đi theo chiều hơi ngược lại.
15. Việc nào cho LLM, việc nào chuyển sang code
Kỹ năng thật sự là biết việc nào không hợp với LLM. LLM nên được dùng cho những việc nó làm tốt. Nó rất giỏi:
- phân tích một yêu cầu mơ hồ;
- phán đoán nên tìm dữ liệu ở đâu và tìm cái gì;
- xử lý những cách diễn đạt nhóm chưa từng thấy, từ một người dùng mới với một kiểu câu hỏi khác;
- và ở cuối cùng, tổng hợp và viết câu trả lời mà con người đọc được.
Nhưng mọi thứ bạn có thể mô hình hóa thành dữ liệu thì nên chuyển vào code. Vanč nhấn mạnh đây là điểm then chốt, nhất là với hệ thống lớn. Nếu dữ liệu của bạn có cấu trúc, dù gọi là hierarchy, graph hay schema, thì để một language model quét nó từng token một chắc chắn là sai công cụ. Những việc nên là code deterministic:
- bulk retrieval, lấy dữ liệu hàng loạt;
- logic tập hợp chính xác;
- đếm;
- dedup giữa những cái tên gần như giống hệt nhau, chuyện xảy ra rất nhiều trong thế giới data center;
- bất cứ thứ gì phải tái lập được 100%.
Heuristic đơn giản thường đúng: nếu bạn viết ra được cấu trúc hoặc quy tắc, đó là việc của 1.0. Và LLM thuần túy yếu nhất đúng ở chỗ hệ thống lớn và có cấu trúc chặt, mà đó lại chính là nơi Phaidra và khách hàng của họ vận hành.
16. Chạy ngược xu hướng của Karpathy
Theo một nghĩa nào đó, nhóm đã chạy xu hướng của Karpathy theo chiều ngược lại. Họ bắt đầu gần như thuần 3.0: ném mọi thứ vào context window, vì đó là cách nhanh nhất để biết cái gì thực sự đáng xây. Và như đã kể, cách đó chạy khá tốt ở một demo đơn giản lúc đầu. Rồi khi gặp quy mô thật, nhóm chuyển những phần có thể coi là bài toán kỹ thuật đã biết sang 1.0, và vẫn giữ phần phán đoán khó ở LLM.
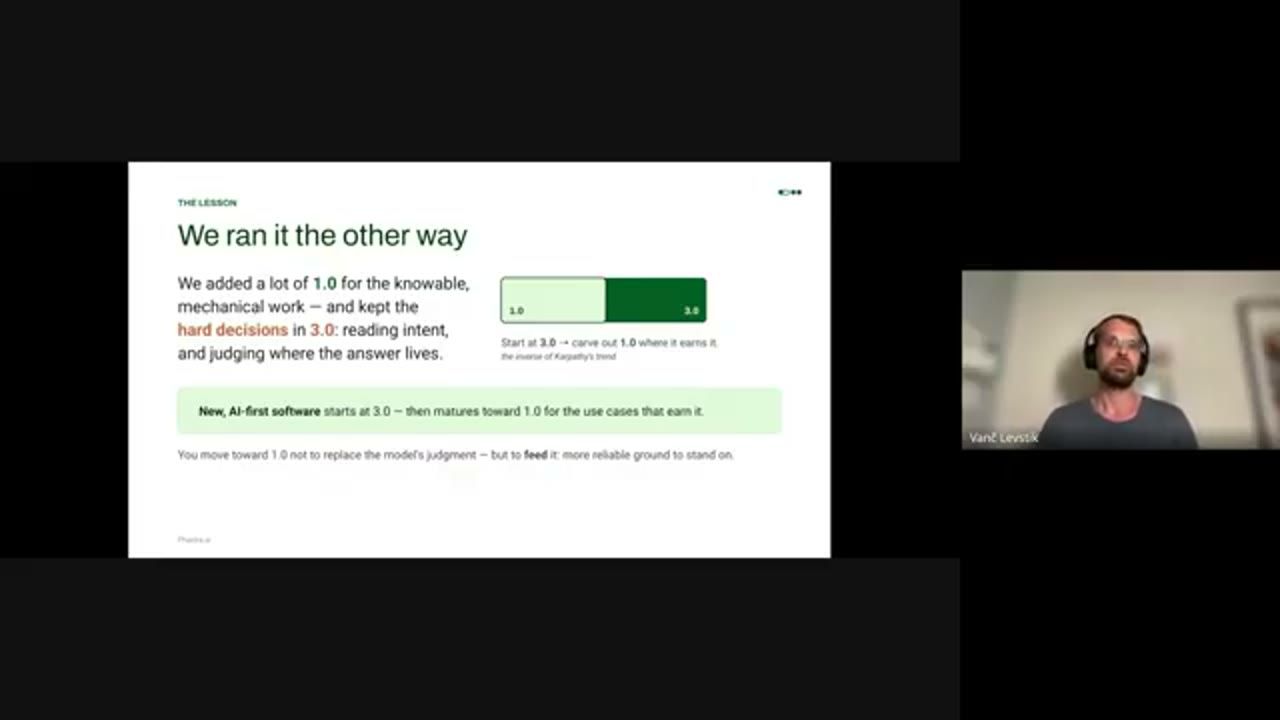
Đó là sự đảo chiều. Software kiểu cũ trôi từ 1.0 sang 3.0; còn software AI-native mới bắt đầu ở 3.0 và trưởng thành dần về 1.0, tất nhiên là chỉ cho những use case xứng đáng với điều đó. Nhóm không có ý thay thế phán đoán của model. Họ muốn nuôi nó bằng những thứ họ gọi là "1.0 tool". Mỗi hàm 1.0 bạn thêm vào là thêm một mảnh nền đáng tin để LLM đứng lên.
Để kết thúc: hãy để LLM giữ các quyết định khó. Mọi thứ nó không nên phải đoán thì đưa vào dưới dạng code, rồi trao cấu trúc đó ngược lại cho model làm việc cùng. Câu chốt của talk: demo bằng Software 3.0, đưa lên production bằng cách thêm Software 1.0 (Vanč lỡ nói "thêm Software 3.0" rồi sửa ngay thành 1.0). Slide cuối viết đầy đủ: "Demo with Software 3.0. Productionize by adding in Software 1.0, so the LLM can reason on solid ground."
Hai diễn giả cảm ơn người xem và mời ai có câu hỏi tiếp theo thì liên hệ trực tiếp với Raahul hoặc Vanč, hoặc để lại bình luận dưới video.
Nguồn và liên kết
- Trang talk trên ai.engineer · Video gốc
- Phaidra: AI agent cho data center và AI factory; Vanč Levstik dẫn các nhóm phát triển Phaidra Prism
- Andrej Karpathy: Software Is Changing (Again), nguồn của khung Software 1.0 / 2.0 / 3.0
- GitHub của Raahul Singh
Related talks
Enterprise Agents Have a Structure Problem
Ishita Daga · Tesla · 12 min
Data agent doanh nghiệp sai vì thiếu structure chứ không thiếu context: thứ bậc source of truth, context lifecycle có eval, và bài toán preference còn mở.
When Agents Meet Physical Data: The Other Physics of Agent Harnesses
Dmitry Petrov · DataChain · 28 min
Vì sao coding agent hỏng với video và sensor data, và cách dựng data harness bốn phần: see, run, verify, remember, với demo DataChain và Claude Code.
Build Systems, Not Code
Angie Jones · Agentic AI Foundation · 20 min
Thiết kế agent vẫn là software engineering: mười nguyên tắc từ systems thinking tới maintainability, minh hoạ qua agent tìm nhà Relocation Scout.