Agent loop từ ba paper: Chain-of-Thought, MRKL, ReAct, rồi tự viết agent bằng Python
Đi qua Chain-of-Thought, MRKL và ReAct trên một câu hỏi dân số, rồi tự viết một agent ReAct bằng Python với hai tool và một vòng lặp, không dùng framework.
✓ Đã duyệt độc lập · cập nhật 28/10/2026 · 17 min
1. Một câu hỏi dân số tưởng như đơn giản
Phát mở video bằng một câu hỏi cơ bản dành cho người xem: dân số Trung Quốc và Ấn Độ, nước nào đông dân hơn, đông hơn bao nhiêu người, và theo nguồn nào?
Theo Phát (video đăng ngày 24/10/2026), nếu nhập câu hỏi đó vào một LLM ở dạng cơ bản, mô hình sẽ trả lời ngay, rất trôi chảy, và còn kèm theo số liệu cụ thể. Thế nhưng chỉ cần để ý kỹ một chút thì sẽ thấy: con số đó là của năm nào, lấy theo nguồn nào, chúng ta hoàn toàn không biết được.
2. Ba paper và lộ trình năm phần
Sau lời chào, Phát nói mục tiêu của video (đăng ngày 24/10/2026): tìm hiểu tại sao một LLM ở dạng cơ bản lại không thể trả lời câu hỏi này một cách chính xác, và cần thêm những gì để nó làm được việc đó. Theo anh, câu trả lời nằm trong ba bài báo khoa học: Chain-of-Thought, MRKL (đọc là "Miracle") và ReAct. Anh nói sự kết hợp của ba paper này làm tiền đề cho những AI agent phức tạp hơn sau này. Ở cuối video, anh sẽ cùng người xem viết một agent như vậy từ con số 0, mà không cần dùng một framework nào cả.
Video đi qua năm phần:
- Zero-shot prompting: để xem một LLM có thể làm được gì và còn thiếu gì.
- Chain-of-Thought: cho mô hình viết phần suy luận ra bên ngoài.
- MRKL: một kiến trúc cho mô hình gọi được các công cụ bên ngoài. Phát gọi đây là nền tảng cho tool calling (video đăng ngày 24/10/2026).
- ReAct: theo Phát (video đăng ngày 24/10/2026), đây là paper dựng nên vòng lặp mà hầu hết các agent lúc đó đều dùng.
- Agent: ghép cả ba paper lại thành một agent, rồi viết code cho agent đó chạy thật trên câu hỏi dân số lúc nãy.
Mỗi phần giải quyết một khuyết điểm của phần trước đó, nên phần sau dựa trên phần trước. Trên các slide, một thanh tiến trình năm đoạn ở cuối màn hình đánh dấu phần đang nói: zero-shot prompting, Chain-of-Thought, MRKL, ReAct, Agent.
3. Ba yêu cầu của một câu trả lời đúng
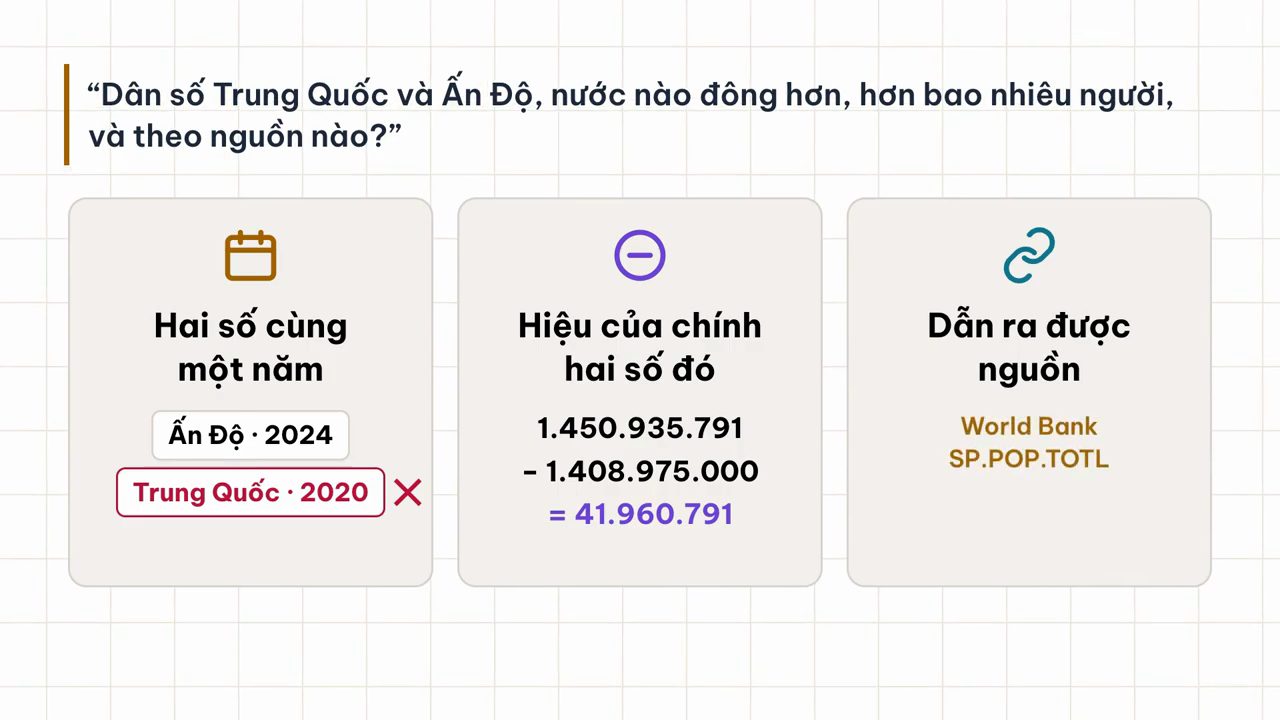
Trước khi vào paper đầu tiên, Phát làm rõ câu hỏi dân số. Tại sao một câu hỏi nghe đơn giản như vậy lại khó với một mô hình ngôn ngữ? Để trả lời đúng, chúng ta cần ba thứ:
- Hai số cùng một năm. Nếu lấy số của Ấn Độ năm 2024 rồi đem so với số của Trung Quốc năm 2020, phép so sánh đó không còn ý nghĩa gì nữa.
- Hiệu của chính hai số đó. Phải lấy hiệu của chính hai con số vừa tra được, chứ không phải một con số nghe có vẻ hợp lý.
- Dẫn ra được nguồn, để người hỏi có thể tự kiểm lại.
Ba yêu cầu này nghe thì đơn giản, nhưng theo Phát (video đăng ngày 24/10/2026), một mô hình ngôn ngữ khi chỉ được gọi một lần sẽ không làm được cả ba.
4. Zero-shot prompting: mô hình làm được gì, thiếu gì
Zero-shot prompting là thứ chúng ta vẫn làm hằng ngày: đưa câu hỏi vào, không kèm ví dụ mẫu nào, cũng không hướng dẫn gì thêm. Phát mô tả cách mô hình xử lý (video đăng ngày 24/10/2026): nó đọc hết prompt một lượt rồi bắt đầu sinh token. Mỗi token mới dựa trên toàn bộ những token đã sinh ra trước đó. Khi gặp điều kiện dừng thì mô hình trả lời xong và kết thúc.
Điểm Phát muốn người xem để ý: trong toàn bộ vòng này, không có một bước nào đi ra bên ngoài. Mô hình không mở được trang web nào, không gọi được API nào, đến một phép tính cũng không chạy. Mọi thứ mô hình viết ra đều lấy từ những gì đã nằm sẵn trong tham số từ lúc train (theo Phát, video đăng ngày 24/10/2026).
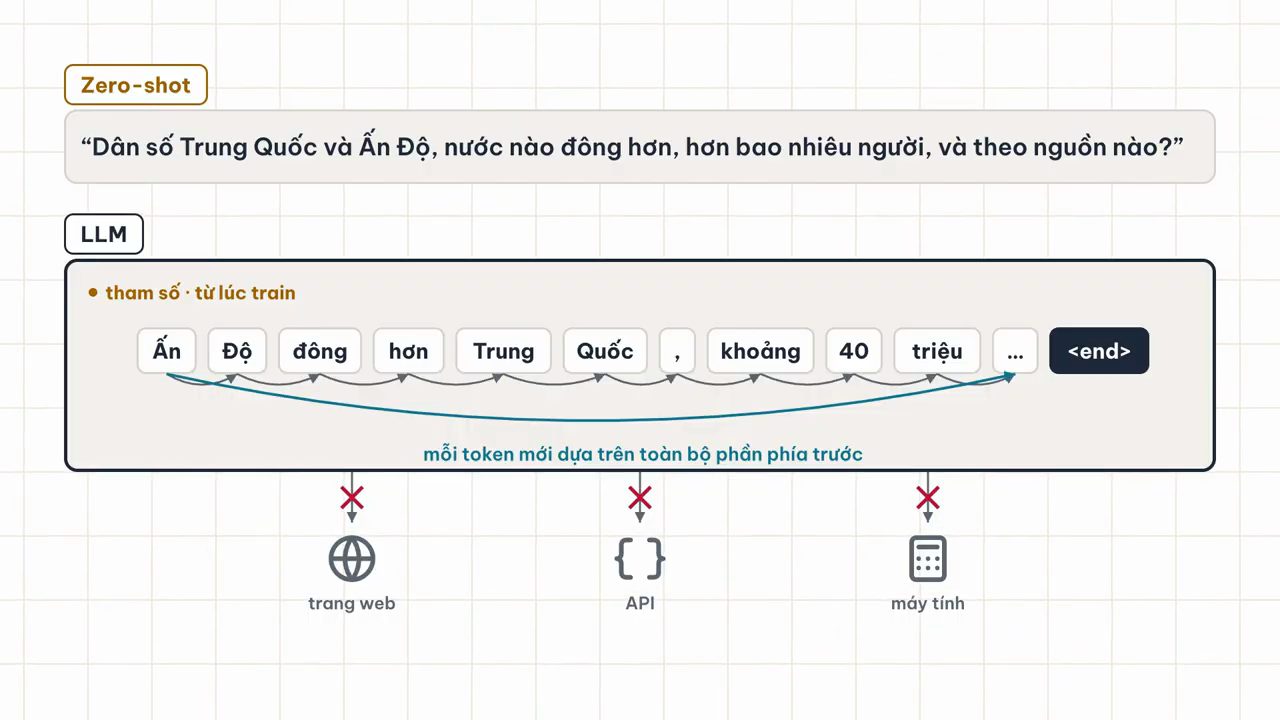
Câu trả lời minh hoạ mà Phát đưa lên slide (video đăng ngày 24/10/2026) là: "Ấn Độ đông hơn Trung Quốc, khoảng 40 triệu người. Nhìn chung Ấn Độ hiện là nước đông dân nhất thế giới." Theo anh, câu trả lời trông rất hoàn chỉnh: có nước đông hơn, có con số, có cả câu kết luận gọn gàng. Nhưng đem so với ba yêu cầu thì thiếu cả ba. Con số đến từ dữ liệu lúc train và mô hình không nói là của năm nào. Phép trừ nằm lẫn đâu đó bên trong câu trả lời, chúng ta không thấy. Còn dòng nguồn thì không có. Slide đặt dấu gạch đỏ cạnh "Hai số cùng một năm" với ghi chú "không rõ năm nào", và cạnh "Hiệu của chính hai số đó" với ghi chú "không thấy phép trừ".
5. Chain-of-Thought: viết lời giải ra ngoài
Vậy việc đầu tiên cần làm là gì? Theo Phát, đó là cho mô hình viết phần suy luận đang bị ẩn kia ra ngoài. Năm 2022, một nhóm nghiên cứu ở Google công bố bài báo Chain-of-Thought Prompting. Phát nói ý tưởng của paper đơn giản tới mức hơi bất ngờ.
Theo Phát (video đăng ngày 24/10/2026), khi nói về paper Chain-of-Thought (năm 2022): thông thường, để mô hình trả lời tốt hơn, chúng ta đặt sẵn vài ví dụ mẫu vào trong prompt; cách này gọi là few-shot prompting. Nhưng trong những ví dụ mẫu đó, lời giải đi thẳng từ câu hỏi tới đáp án: hỏi gì, đáp số đó, không có gì ở giữa. Mô hình sẽ trả lời theo đúng cách trình bày đó, nhảy thẳng tới con số cuối cùng. Slide few-shot của Phát có dòng "Hãy giải bài toán như các ví dụ sau đây:", câu hỏi "Roger có 5 quả bóng, mua thêm 2 hộp, mỗi hộp 3 quả. Hỏi có mấy quả?" với đáp án 11, và câu hỏi tiếp theo "Lớp có 23 quả táo, dùng 20 quả, mua thêm 6 quả. Còn mấy quả?".
Theo paper (năm 2022), Chain-of-Thought chỉ thay đổi một chỗ: trong ví dụ mẫu, chúng ta viết luôn lời giải từng bước. Phát nói (video đăng ngày 24/10/2026) rằng ở đây chúng ta không dạy mô hình cách suy luận, mà chỉ cho mô hình thấy một câu trả lời nên trình bày ra sao.
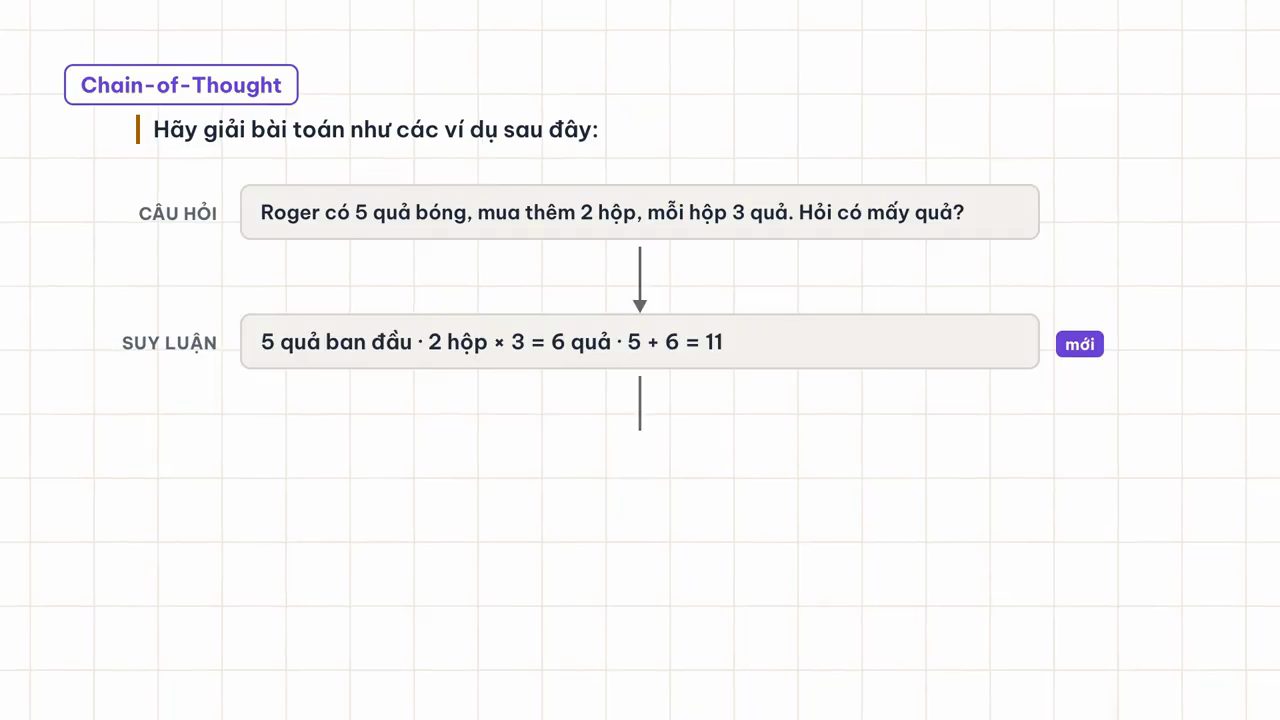
Phát chiếu hình minh hoạ trong paper (năm 2022) trong video đăng ngày 24/10/2026: bên trái là prompt thường, ví dụ mẫu đi thẳng ra đáp án; bên phải là cùng một ví dụ nhưng có thêm lời giải từng bước, và mô hình sẽ viết lại theo cách đó.
Áp vào câu hỏi dân số, prompt vẫn chỉ là một đoạn text. Phần thêm vào duy nhất là lời giải mẫu: viết ra số của nước A, viết ra số của nước B, rồi viết phép trừ, rồi mới kết luận. Khi gặp câu hỏi thật, mô hình cũng viết ra từng bước y như vậy (theo Phát, video đăng ngày 24/10/2026). Phần câu hỏi trong prompt mà Phát đưa lên slide là:
Hãy trả lời câu hỏi sau, trình bày từng bước như các ví dụ trên:
Dân số Trung Quốc và Ấn Độ, nước nào đông hơn, hơn bao nhiêu người?
6. GSM8K và giới hạn của Chain-of-Thought
Cách làm đơn giản này hiệu quả tới đâu? Paper (năm 2022) thử trên GSM8K, một bộ dữ liệu toán đố ở mức tiểu học. Phát đọc một bài trong bộ dữ liệu: tháng Tư, Natalia bán kẹp tóc cho 48 người bạn; tháng Năm, bạn ấy bán được một nửa so với tháng Tư. Hỏi cả hai tháng Natalia bán được bao nhiêu kẹp tóc? Đáp án là 72.
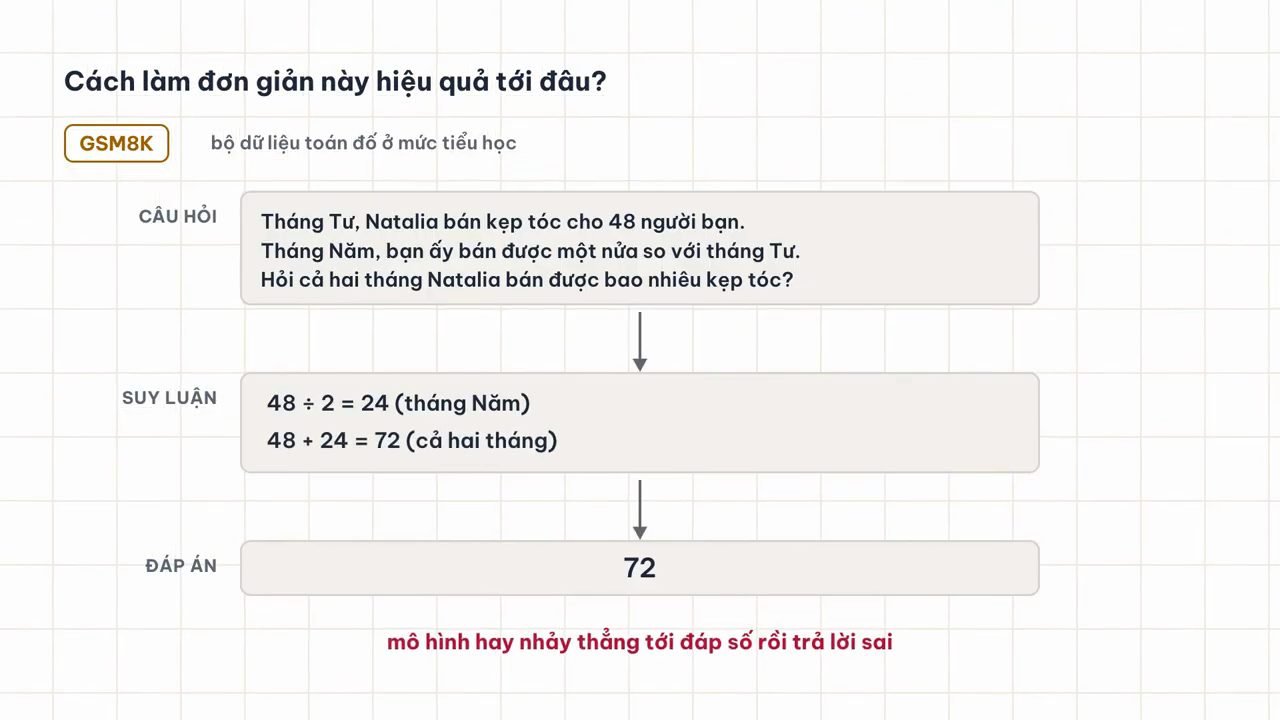
Bài này không khó, nhưng phải qua hai bước mới ra được. Theo Phát (video đăng ngày 24/10/2026), đây chính là loại bài mà mô hình hay nhảy thẳng tới đáp số rồi trả lời sai. Theo số liệu của paper Chain-of-Thought (năm 2022) mà Phát dẫn: với few-shot prompting bình thường, mô hình mà paper dùng giải đúng 17,9%; đổi sang Chain-of-Thought, vẫn mô hình đó, vẫn tám ví dụ mẫu, con số lên 56,9%. Kết quả tốt nhất trước đó phải huấn luyện lại cả mô hình mới có được, còn Chain-of-Thought không huấn luyện lại gì cả, chỉ đổi cách viết prompt. Phần tóm tắt của paper trên arXiv (đọc ngày 27/10/2026) ghi rằng prompt một language model 540 tỷ tham số với chỉ tám ví dụ chain of thought đạt độ chính xác cao nhất trên GSM8K lúc đó, vượt cả GPT-3 đã finetune kèm một verifier.
Phát nói trong paper còn một điểm nữa mà anh thấy khá thú vị: Chain-of-Thought không giúp được mọi mô hình. Theo paper (năm 2022) như anh kể, với những mô hình nhỏ, viết lời giải từng bước lại cho ra kết quả tệ hơn, vì mô hình viết được các bước nghe rất trôi chảy mà lại không đúng logic. Khả năng này chỉ xuất hiện khi mô hình đủ lớn, khoảng từ 100 tỷ tham số trở lên.
Quay lại ba yêu cầu, theo cách Phát tổng kết trong video đăng ngày 24/10/2026. Bây giờ phép trừ đã hiện ra bên ngoài, nên nếu mô hình tính sai thì chúng ta dò lại được; vậy là yêu cầu thứ hai đã được giải quyết. Thế nhưng hai con số đi vào phép trừ vẫn là hai con số mô hình nhớ từ lúc train. Mô hình vẫn không mở được một trang web nào, và câu trả lời vẫn chưa có nguồn để dẫn ra. Nói cách khác, theo Phát, Chain-of-Thought kéo được phần suy luận ra ngoài, nhưng mọi thứ đi vào suy luận đó thì vẫn nằm trong mô hình.
7. MRKL: ba thứ mô hình ngôn ngữ không tự làm được
Trong ba bài báo của video, Phát nghĩ MRKL là một trong những paper ít được nhắc đến nhất. Theo anh (video đăng ngày 24/10/2026), Chain-of-Thought thì gần như ai làm việc với LLM cũng từng gặp, và ReAct thì nằm trong hầu hết các agent framework lúc đó. Còn MRKL, với chính anh, thật ra cũng khá xa lạ. Thế nhưng đây lại là paper giải quyết đúng vấn đề đang gặp: làm sao một LLM có thể thoát khỏi trọng số của nó để tương tác được với thế giới bên ngoài.
Cũng trong năm 2022, một nhóm nghiên cứu ở AI21 Labs công bố bài báo MRKL Systems. MRKL là viết tắt của Modular Reasoning, Knowledge and Language, và theo Phát, chính các tác giả nói tên này đọc là "Miracle". Slide giới thiệu ghi "Karpas et al. · AI21 Labs · 2022" và mã arXiv:2205.00445.
Theo Phát, paper (năm 2022) mở đầu bằng ba thứ mà một mô hình ngôn ngữ không tự làm được, dù mô hình có lớn tới đâu:
- Thông tin thay đổi theo thời gian. Mô hình chỉ biết những gì có trong dữ liệu lúc train, nên tỉ giá hôm nay, giá cổ phiếu hôm nay hay dân số năm nay, mô hình đều không cập nhật được. Muốn cập nhật thì phải train lại, mà train lại thì rất tốn kém (theo paper MRKL năm 2022, như Phát kể).
- Dữ liệu riêng. Dữ liệu nội bộ của một công ty thì mô hình chưa từng được đọc, mà cũng không nên đem đi train (theo paper MRKL năm 2022, như Phát kể).
- Tính toán. Đây là giới hạn Phát thấy thú vị nhất: một mô hình có thể viết được cả một bài luận mạch lạc, nhưng đem cộng hai số năm chữ số lại ra kết quả sai (theo paper MRKL năm 2022, như Phát kể).
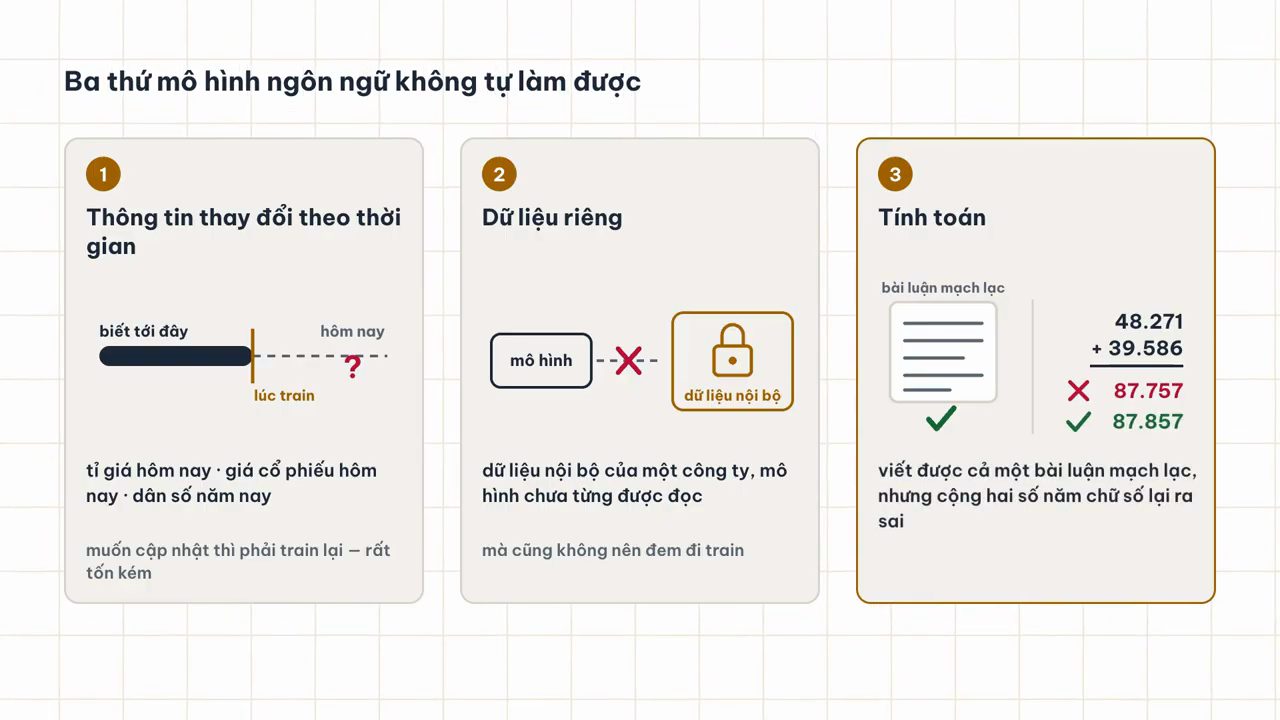
Câu hỏi dân số rơi vào giới hạn thứ nhất, còn phép trừ ở cuối câu trả lời rơi vào giới hạn thứ ba.
8. Router và các module expert
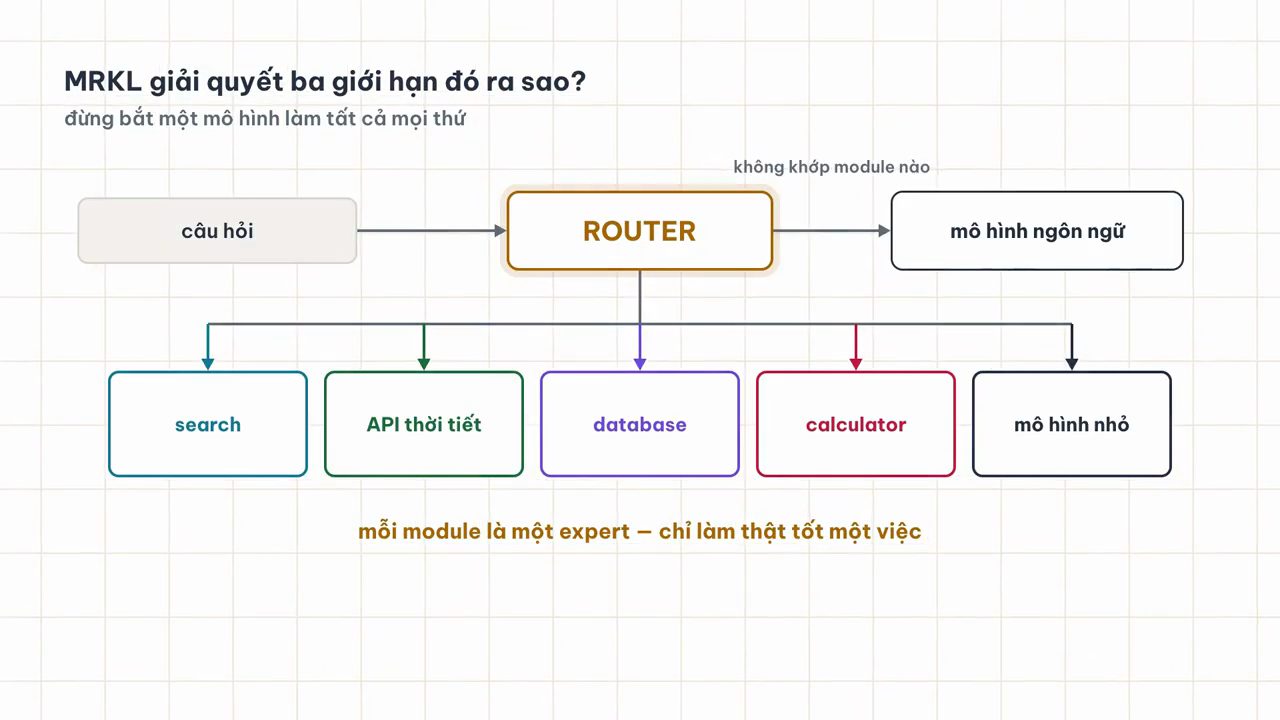
MRKL giải quyết ba giới hạn đó ra sao? Theo Phát, ý tưởng của paper (năm 2022) là đừng bắt một mô hình làm tất cả mọi thứ. Kiến trúc MRKL đặt một mô hình ngôn ngữ đứng cùng một loạt module riêng biệt. Mỗi module là một expert, tức là chỉ làm thật tốt một việc. Module có thể là một API thời tiết, một database, một calculator, hoặc một mô hình nhỏ chuyên cho một tác vụ hẹp.
Thành phần quan trọng nhất của kiến trúc MRKL (paper năm 2022), theo Phát trong video đăng ngày 24/10/2026, là router. Router đọc câu hỏi rồi quyết định module nào sẽ xử lý. Nếu câu hỏi không khớp với module nào cả, router gửi thẳng cho mô hình ngôn ngữ trả lời.
9. Router trên câu hỏi dân số, và tool calling ngày nay
Phát cho router chạy trên câu hỏi dân số. Router đọc câu hỏi rồi tách ra hai việc cần làm. Việc thứ nhất là lấy số liệu, nên router gọi module search hai lần, một lần cho Ấn Độ và một lần cho Trung Quốc, và quan trọng là cùng một năm. Module trả về hai con số kèm nguồn World Bank; slide minh hoạ ghi Ấn Độ năm 2024 là 1.450.935.791 và Trung Quốc năm 2024 là 1.408.975.000 (số liệu minh hoạ trong video đăng ngày 24/10/2026). Việc thứ hai là phép trừ, nên router gọi calculator trên hai con số vừa lấy về. Cuối cùng, mô hình ngôn ngữ ghép lại thành một câu trả lời, và lần này câu trả lời có nguồn.
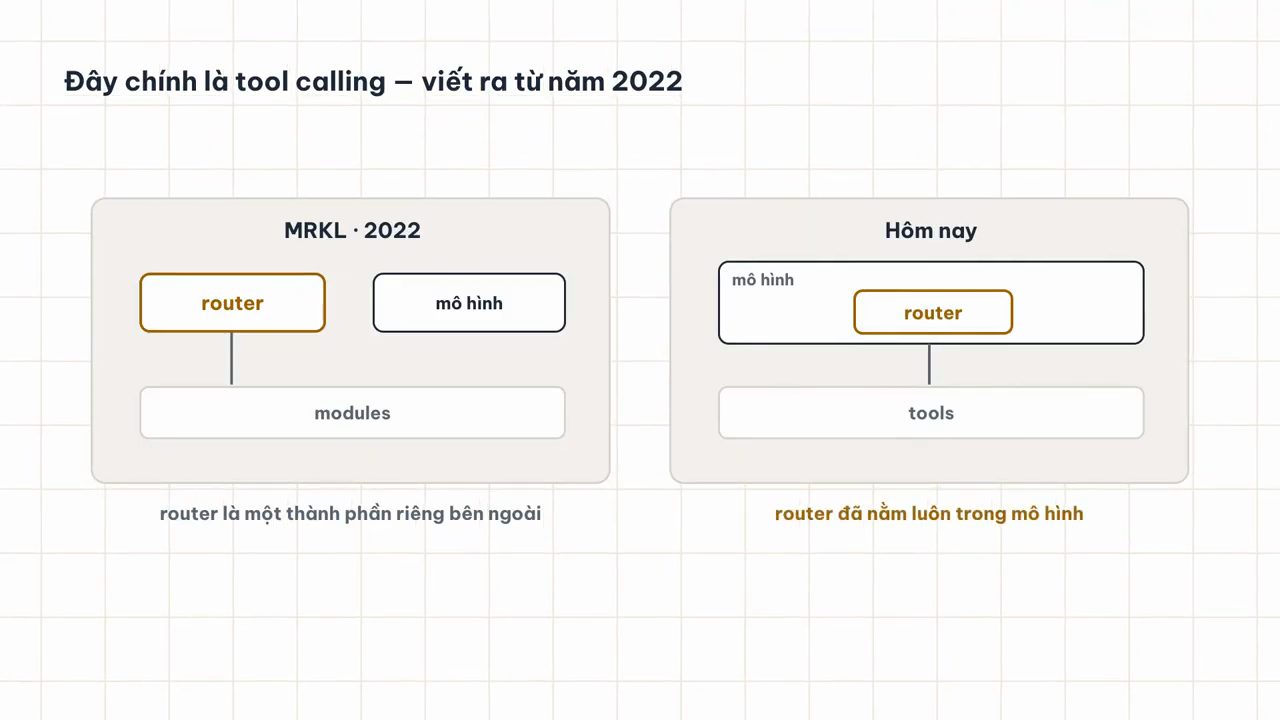
Phát nói với người xem: nếu từng dùng tool calling hay function calling của OpenAI hoặc Anthropic, thì đây chính là ý tưởng đó, viết ra từ năm 2022. Theo anh (video đăng ngày 24/10/2026), chỉ khác một chỗ: bây giờ phần router đã nằm luôn trong mô hình, chứ không còn là một thành phần riêng bên ngoài nữa.
10. Bảng phép cộng của GPT-3 và giới hạn của MRKL
Trước khi đi tiếp, Phát cho xem một bảng kết quả trong paper (video đăng ngày 24/10/2026), vì theo anh bảng này nói rất rõ tại sao phải gọi calculator. Paper MRKL (năm 2022) cho GPT-3 làm phép cộng rồi tăng dần số chữ số. Theo số liệu của paper mà Phát đọc: cộng hai chữ số, GPT-3 đúng 100%; lên ba chữ số còn 80,4%; lên bốn chữ số còn 25,5%; và lên năm chữ số chỉ còn 9,3%. Còn nhánh có gọi calculator thì đúng 100% ở mọi mức, từ một cho tới chín chữ số, vì phép cộng không còn do mô hình đoán nữa mà do một máy tính thật chạy ra.
Nhưng MRKL (paper năm 2022) cũng có giới hạn, và theo Phát (video đăng ngày 24/10/2026), giới hạn đó là lý do paper thứ ba ra đời. Router chỉ chọn module một lần, ngay từ đầu, lúc chưa hề nhìn thấy kết quả trả về. Cả luồng chạy theo một đường thẳng, từ câu hỏi xuống câu trả lời, không có đường nào quay lại. Phát đưa ra hai tình huống (video đăng ngày 24/10/2026):
- Module search trả về một trang không có con số nào. Trong một luồng cố định, không có bước thứ hai nào để tra lại.
- Search trả về số của Ấn Độ năm 2024 và số của Trung Quốc năm 2020. Hai số khác năm nhau, và ta sẽ có đáp án sai.
Đến đây đã có được hai thứ. Thứ nhất, Chain-of-Thought giúp mô hình viết phần suy luận ra bên ngoài. Thứ hai, MRKL giúp tương tác lại với thế giới bên ngoài bằng những công cụ thật. Thế nhưng, theo Phát (video đăng ngày 24/10/2026), hai thứ đó vẫn đang chạy khá tách rời nhau. Thứ còn thiếu hoá ra lại đơn giản hơn nhiều so với chúng ta tưởng: một vòng lặp, cho phép mô hình đọc kết quả vừa trả về, rồi tự quyết định xem đã đủ thông tin hay chưa, hay cần tra thêm một lần nữa để trả lời câu hỏi của người dùng. Đó cũng là mục tiêu của paper thứ ba.
11. ReAct: Thought, Action, Observation
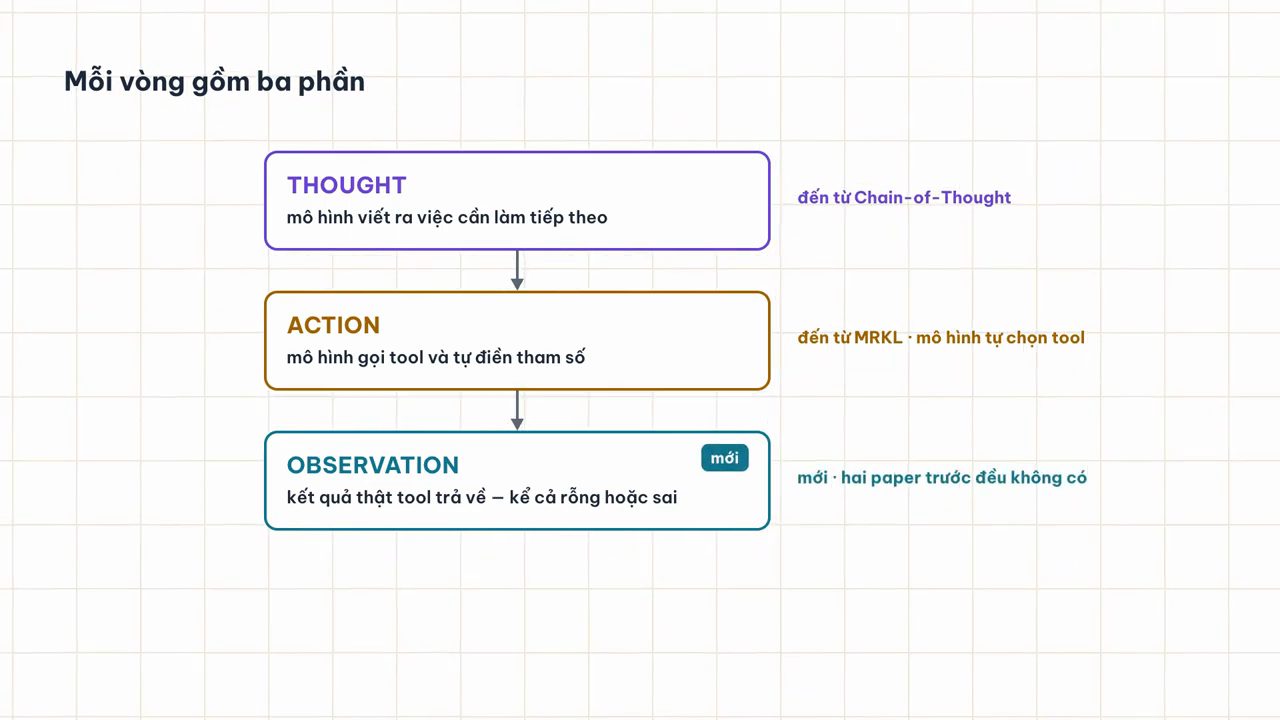
Phát kể: năm 2022, một nhóm nghiên cứu ở Princeton và Google công bố bài báo ReAct. Tên paper ghép từ hai chữ Reasoning và Acting, tức là suy luận và hành động. Ý tưởng của ReAct là cho mô hình viết suy luận và hành động xen kẽ nhau, thay vì làm xong hẳn việc này rồi mới tới việc kia. Theo Phát, mỗi vòng gồm ba phần:
- Thought: mô hình viết ra việc cần làm tiếp theo. Phần này đến từ Chain-of-Thought (theo Phát, video đăng ngày 24/10/2026).
- Action: mô hình gọi một tool và tự điền tham số cho tool đó. Phần này đến từ MRKL, chỉ khác một chỗ là bây giờ chính mô hình chọn tool, chứ không phải một router riêng bên ngoài (theo Phát, video đăng ngày 24/10/2026).
- Observation: kết quả thật mà tool trả về, kể cả khi kết quả đó rỗng, sai, hoặc chẳng có gì hữu ích. Theo Phát (video đăng ngày 24/10/2026), phần này mới chính là ReAct, và hai paper trước đều không có.
Observation được đưa ngược lại, làm đầu vào cho vòng sau. Mô hình đọc Observation rồi tự quyết định lặp tiếp hay dừng lại và trả lời (theo cách Phát trình bày paper ReAct, video đăng ngày 24/10/2026).
Phát chiếu hình minh hoạ trong paper đặt bốn cách làm cạnh nhau trên cùng một câu hỏi. Chú thích dưới hình trên slide ghi "Yao et al. (2023), ReAct, Figure 1, arXiv:2210.03629". Câu hỏi trong hình hỏi: ngoài Apple Remote, thiết bị nào khác có thể điều khiển chương trình mà Apple Remote ban đầu được thiết kế để tương tác. Theo Phát (video đăng ngày 24/10/2026), hình 1 của paper ReAct (arXiv 2022, bản trên slide ghi 2023) cho thấy:
- Standard trả lời ngay và sai (trong hình là "iPod"; hình 1 của paper ReAct, 2022).
- Chain-of-Thought suy luận mạch lạc nhưng dữ kiện là tự nghĩ ra (hình 1 của paper ReAct, 2022).
- Act có gọi search nhưng không suy luận gì giữa các lần gọi (hình 1 của paper ReAct, 2022).
- ReAct đọc observation rồi mới quyết định bước tiếp theo, và trong hình đi tới đáp án "keyboard function keys" (hình 1 của paper ReAct, 2022).
12. Trace bốn vòng trên câu hỏi dân số
Phát cùng người xem đọc trace của ReAct trên câu hỏi dân số (video đăng ngày 24/10/2026). Trace này có bốn vòng.
Vòng 1. Thought: cần dân số Ấn Độ và Trung Quốc ở cùng một năm, tra Ấn Độ trước. Action: search dân số Ấn Độ. Observation: một trang tổng quan về Ấn Độ, không có con số theo từng năm (trace minh hoạ trong video đăng ngày 24/10/2026).
Vòng 2 mới là chỗ đáng chú ý, theo Phát, vì luồng MRKL vừa rồi sẽ dừng lại ở đây. Thought: trang đó không có số theo năm, vậy hỏi World Bank theo mã chỉ số. Action: search mã chỉ số dân số, Ấn Độ, năm 2024. Observation: 1 tỷ 450 triệu người, nguồn World Bank. Ở đây mô hình tự đổi hướng chỉ vì đọc được một observation trống (theo Phát, video đăng ngày 24/10/2026).
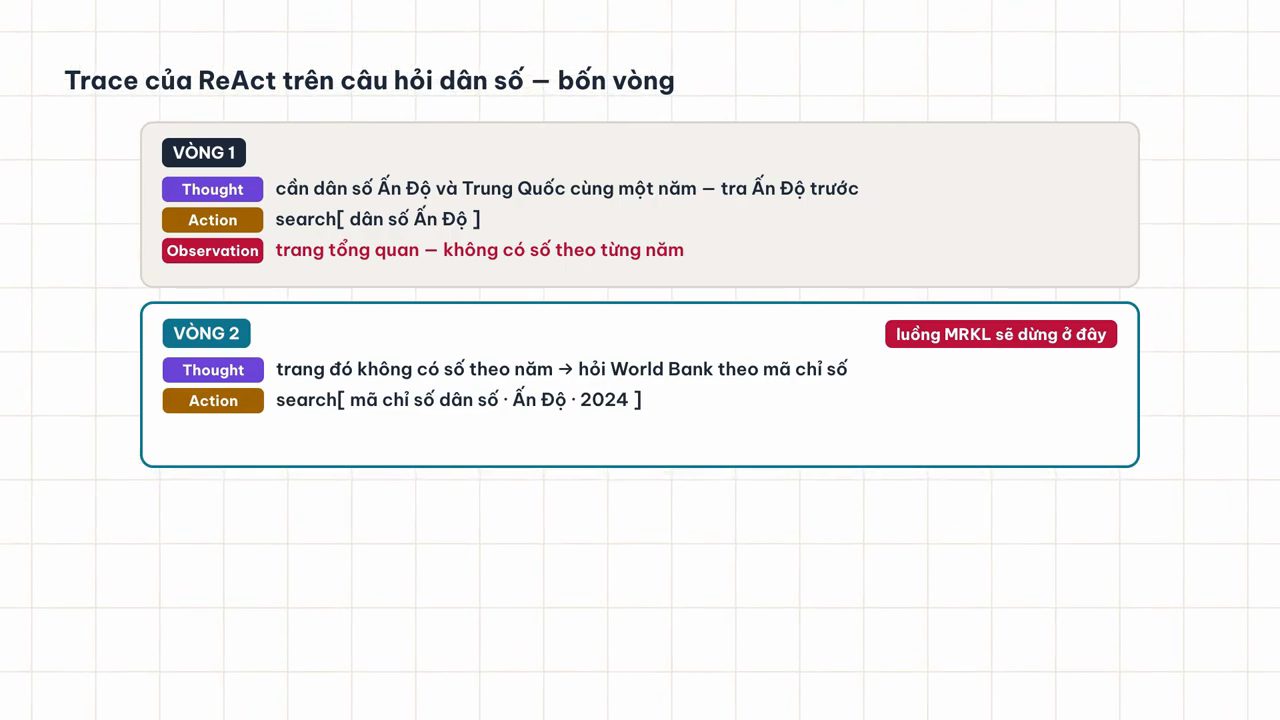
Vòng 3 lấy số của Trung Quốc, cũng năm 2024. Vòng 4 gọi calculator trên hai số vừa lấy, rồi gọi finish để trả lời (trace minh hoạ trong video đăng ngày 24/10/2026).
13. ALFWorld: ReAct trong một căn nhà bằng chữ
Theo Phát (video đăng ngày 24/10/2026), paper ReAct thử trên nhiều benchmark khác nhau, và anh lấy ALFWorld làm ví dụ. ALFWorld là một môi trường mô phỏng việc nhà, viết hoàn toàn bằng chữ. Agent được giao một việc; ví dụ trong chính paper ReAct là đặt một bắp xà lách đã rửa sạch lên bàn ăn. Để làm được việc đó, agent phải đi tìm xà lách trong phòng, lấy lên, mang ra bồn rửa, rửa sạch, rồi mang tới bàn ăn và đặt xuống. Mỗi bước, agent chỉ đọc được mô tả bằng chữ của chỗ mình đang đứng, nên phải vừa làm vừa dò.
Slide của Phát (video đăng ngày 24/10/2026) minh hoạ theo định dạng của ALFWorld, với nhiệm vụ lấy từ paper ReAct. Môi trường mở đầu bằng "You are in the middle of a room. Looking quickly around you, you see a cabinet 6, ... a diningtable 1, a fridge 1, a sinkbasin 1, ...", giao nhiệm vụ "Your task is to: put a clean lettuce in diningtable.", rồi agent gõ "go to fridge 1", nhận "The fridge 1 is closed.", gõ "open fridge 1" và thấy "a lettuce 1, a cup 3, ...".
Theo kết quả của paper ReAct mà Phát dẫn trong video đăng ngày 24/10/2026: một baseline được huấn luyện trên cả trăm nghìn mẫu chỉ hoàn thành được khoảng một phần ba số nhiệm vụ; gọi tool mà không suy luận thì khá hơn một chút; còn ReAct đạt tới hơn 70%, mà chỉ cần một hai ví dụ mẫu trong prompt. Phần tóm tắt của paper trên arXiv (đọc ngày 27/10/2026) ghi rằng trên ALFWorld, ReAct vượt các phương pháp imitation learning và reinforcement learning 34 điểm phần trăm tuyệt đối về tỉ lệ thành công, với chỉ một hoặc hai ví dụ trong prompt.
14. Viết agent: hai tool và phần khai báo
Tới phần viết agent. Phát nói anh sẽ không dùng LangChain, cũng không dùng một agent framework nào cả, vì anh muốn người xem thấy rõ vòng lặp ReAct thật ra ngắn tới mức nào. Toàn bộ code nằm trong file agent.py (video đăng ngày 24/10/2026).
Đầu tiên là hai tool (code của Phát trong video đăng ngày 24/10/2026):
- search nhận vào mã nước và năm, rồi gọi API của World Bank để lấy dân số. Nếu không có số liệu, tool trả về một câu báo không có số liệu. Theo Phát, đây chính là observation rỗng vừa thấy trong trace (code trong video đăng ngày 24/10/2026).
- calculator nhận vào một biểu thức rồi tính ra kết quả. Trước khi tính, code kiểm tra biểu thức chỉ gồm chữ số và dấu phép tính, nên không có chữ cái nào lọt qua được, và theo Phát cũng không ai chèn được code gì khác vào đây (code trong video đăng ngày 24/10/2026).
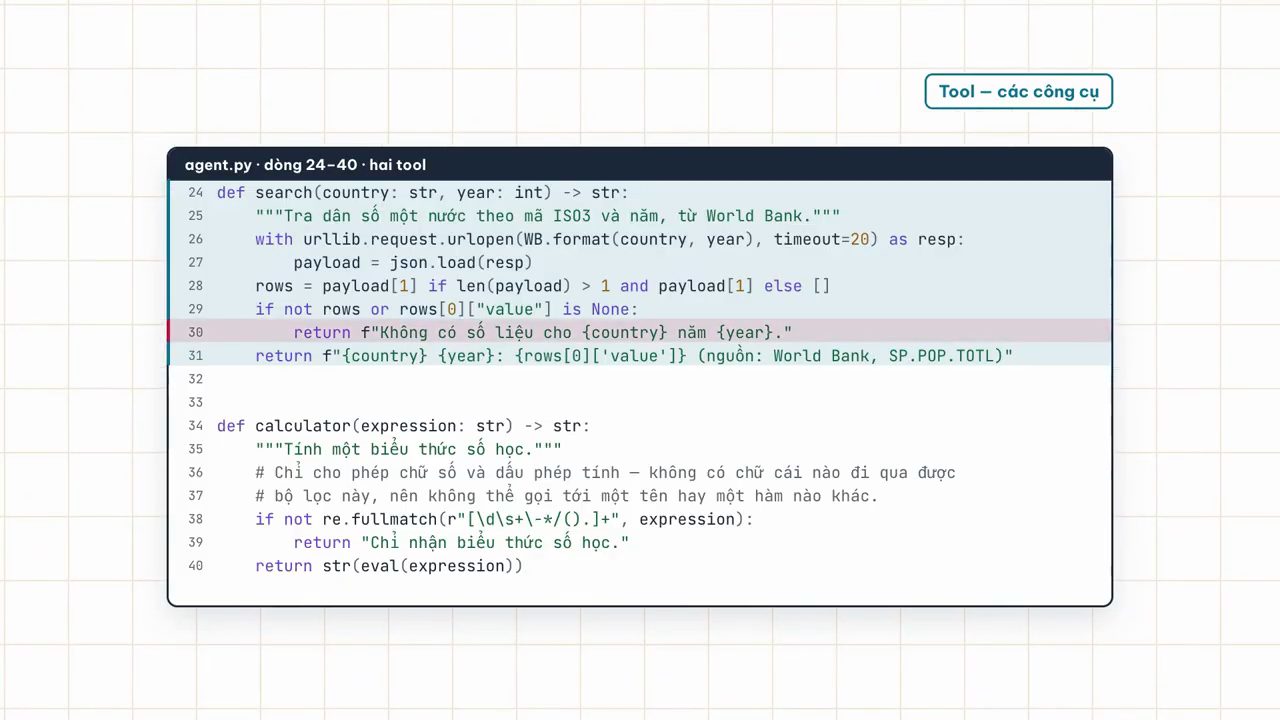
agent.py trong video đăng ngày 24/10/2026: hàm search(country, year) tra dân số theo mã ISO3 và năm từ World Bank, trả về "Không có số liệu cho {country} năm {year}." khi không có số, hoặc con số kèm "(nguồn: World Bank, SP.POP.TOTL)"; hàm calculator(expression) chỉ nhận biểu thức khớp re.fullmatch với chữ số và dấu phép tính, ngược lại trả về "Chỉ nhận biểu thức số học.", rồi mới tính bằng eval.Tiếp theo là khai báo hai tool đó cho mô hình: tên, mô tả, và những tham số nào được phép truyền vào. Trên màn hình, danh sách TOOLS khai báo tool search với mô tả "Tra dân số một nước theo mã ISO3 (ví dụ IND, CHN) và năm.", hai tham số bắt buộc country (chuỗi, "Mã ISO3, ví dụ IND") và year (số nguyên, "Năm, ví dụ 2024"); tool calculator có mô tả "Tính một biểu thức số học, ví dụ 1450935791 - 1408975000."; và dòng HANDLERS ánh xạ tên tool sang hai hàm Python. Theo Phát (video đăng ngày 24/10/2026), phần mô tả rất quan trọng, vì mô hình chỉ dựa vào mấy dòng mô tả này để quyết định khi nào nên gọi tool nào.
15. Vòng lặp ReAct trong khoảng 30 dòng
Và đây là vòng lặp. Phát nói (video đăng ngày 24/10/2026) toàn bộ phần ReAct nằm trong khoảng 30 dòng, và cả file khoảng 90 dòng, phần lớn là khai báo hai tool ở trên. Nhãn trên slide code ghi "~30 dòng · cả file 107 dòng", và thẻ tổng kết sau phần chạy thử ghi "107 dòng · 2 tool · 1 vòng lặp".
Mỗi vòng, code gọi mô hình với toàn bộ lịch sử hội thoại kèm danh sách tool. Trong code của Phát (video đăng ngày 24/10/2026), mô hình trả về ba loại block. Block thinking là phần suy luận, tức là Thought. Block tool use là Action, và ở đây chính mô hình chọn tên tool rồi tự điền tham số. Còn nếu mô hình trả về block text, nghĩa là mô hình đã trả lời xong và vòng lặp dừng. Đoạn code trên màn hình (dòng 74 đến 94 của agent.py):
client = anthropic.Anthropic()
messages = [{"role": "user", "content": CAU_HOI}]

for vong in range(1, 11):
    reply = client.messages.create(
        model=MODEL,
        max_tokens=16000,
        thinking={"type": "adaptive", "display": "summarized"},
        tools=TOOLS,
        messages=messages,
    )
    messages.append({"role": "assistant", "content": reply.content})

    for block in reply.content:
        if block.type == "thinking":
            print(f"[{vong}] THOUGHT : {block.thinking.strip()}")
        elif block.type == "text":
            print(f"[{vong}] TRẢ LỜI : {block.text.strip()}")

    if reply.stop_reason != "tool_use":
        break
Sau đó, code của Phát (video đăng ngày 24/10/2026) chạy từng tool mà mô hình gọi rồi đẩy kết quả trở lại vào lịch sử hội thoại dưới dạng tool result. Đó chính là Observation. Phần này là dòng 96 đến 107 trên màn hình:
    observations = []
    for block in reply.content:
        if block.type != "tool_use":
            continue
        args = json.dumps(block.input, ensure_ascii=False)
        print(f"[{vong}] ACTION  : {block.name}({args})")
        result = HANDLERS[block.name](**block.input)
        print(f"[{vong}] OBS     : {result}")
        observations.append(
            {"type": "tool_result", "tool_use_id": block.id, "content": result}
        )
    messages.append({"role": "user", "content": observations})
Rồi vòng lặp quay lại từ đầu. Theo Phát (video đăng ngày 24/10/2026), mô hình đọc Observation vừa rồi và tự quyết định gọi tool tiếp hay dừng lại và trả lời. Phát nói: trong cả đoạn code này, không có một dòng nào của chúng ta quyết định thứ tự các bước. Chúng ta chỉ cấp tool và vòng lặp; phần quyết định nằm hoàn toàn ở mô hình.
16. Chạy thử agent trên câu hỏi dân số
Phát chạy thử agent (demo trong video đăng ngày 24/10/2026). Trong terminal của VS Code, anh gõ lệnh:
make run
tu-tao-ai-agent/code chứa agent.py và Makefile; lệnh make run đang được gõ trong terminal, trong video đăng ngày 24/10/2026.Phát kể lại lần chạy (demo trong video đăng ngày 24/10/2026): sau phần thought, tức phần suy nghĩ ban đầu, mô hình quyết định gọi hai tool. Công cụ đầu tiên là search, để tìm dân số Trung Quốc năm 2025. Có được thông tin này, mô hình tiếp tục quyết định gọi search cho dân số Ấn Độ, cũng trong cùng năm đó.
Sau đó agent sang vòng lặp tiếp theo (demo trong video đăng ngày 24/10/2026). Có thông tin về hai con số dân số rồi, mô hình quyết định gọi calculator, một công cụ khác, để tính hiệu hai con số này.
Ở vòng lặp sau cùng (demo trong video đăng ngày 24/10/2026), khi nhận ra đã có đủ thông tin về hai con số của Trung Quốc và Ấn Độ cùng hiệu số của chúng, mô hình trả lời người dùng về dân số Trung Quốc và Ấn Độ năm 2025. Phát nói agent đã đưa ra được số liệu chính xác, cụ thể: con số của Ấn Độ, của Trung Quốc, chênh lệch giữa hai nước và nguồn cụ thể.
Theo Phát, trong vòng lặp agent không có bất kỳ logic nào ép agent phải chạy theo một thứ tự cụ thể, và agent đã làm được tất cả những điều này dựa trên vòng lặp ReAct (demo trong video đăng ngày 24/10/2026). Anh cũng nói agent vừa viết thì chạy được, nhưng so với một agent thật như Claude Code hay Cursor thì vẫn còn thiếu khá nhiều thứ (theo Phát, video đăng ngày 24/10/2026).
17. Agent là model, tool và một vòng lặp
Vậy là đã đi từ con số 0 tới một AI agent. Phát nói (video đăng ngày 24/10/2026): một AI agent không phải là một mô hình quá thông minh. Nó chỉ là một mô hình ngôn ngữ, cộng với quyền gọi tool, cộng với một vòng lặp đọc đi đọc lại kết quả. Ba thành phần đó, mỗi thành phần đều đến từ một bài báo khoa học khá quan trọng trong ngành.
Phát (video đăng ngày 24/10/2026) mong người xem đã có một cái nhìn khái quát về các AI agent mà chúng ta thường dùng hằng ngày, và nhận ra rằng AI agent thật ra không có gì quá phức tạp, không có gì quá cao siêu. Anh cảm ơn người xem ở cuối video.
Nguồn và liên kết 8 nguồn
- Tên gốc: TẤT CẢ những gì bạn cần biết về Agent Loop trong 15 PHÚT | Tự viết một AI Agent từ con số không
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=JZT5s2nrY-Q youtube.com
- Kênh YouTube Học Lập Trình cùng Phát (Học Lập Trình cùng Phát): youtube.com/channel/UCC1z6Q9pC3-YCYP3Htvo7gw youtube.com
- Repo code của agent trong video, mô tả repo ghi "AI Agent ReAct viết từ đầu bằng Python, không dùng framework" (đọc ngày 27/10/2026): github.com/SonPhatTranDeveloper/tu-tao-ai-agent github.com
- Wei và cộng sự, "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models", arXiv 2201.11903, năm 2022 (đọc ngày 27/10/2026): arxiv.org/abs/2201.11903 arxiv.org
- Karpas và cộng sự, "MRKL Systems: A modular, neuro-symbolic architecture that combines large language models, external knowledge sources and discrete reasoning", arXiv 2205.00445, năm 2022 (đọc ngày 27/10/2026): arxiv.org/abs/2205.00445 arxiv.org
- Yao và cộng sự, "ReAct: Synergizing Reasoning and Acting in Language Models", arXiv 2210.03629 (đọc ngày 27/10/2026): arxiv.org/abs/2210.03629 arxiv.org
Related talks
Pi agent tự compact context: devlog agentic coding
IndyDevDan · IndyDevDan · 30 min
Viết draft plan rồi để ba harness build một Pi agent có tool self_compact, ba ngưỡng notice, warning, force và compaction prompt tự viết.
Agent không cần model lớn hơn, nó cần context tốt hơn
Muhammad Farooq · Prompt Engineering · 13 min
Vì sao agent hỏng do context chứ không do model, bốn luật của context tốt, và demo thêm long-term memory xuyên session cho coding agent qua MCP và Redis.
Context engineering: hướng dẫn đầy đủ cho developer
Shrinivasan Sankar · AI Bites · 17 min
Context engineering là gì, bốn phép write, select, compress, isolate, ví dụ coding agent, bốn failure mode của context và một workflow để áp dụng.