Bảy moat mạnh nhất cho startup AI theo khung Seven Powers
Bốn host Lightcone đi qua khung Seven Powers của Hamilton Helmer, cộng thêm speed, với ví dụ startup AI: process power, switching cost, counter-positioning, dữ liệu.
✓ Đã duyệt độc lập · cập nhật 03/11/2026 · 45 min
1. Barbarians ngoài cổng thành và câu hỏi của sinh viên
Đây là một tập Lightcone, podcast của Y Combinator, trong đó bốn host đi qua khung Seven Powers của Hamilton Helmer để xem các chiến lược kinh doanh vượt thời gian này đứng vững thế nào với startup AI. Phần mô tả của tập mở bằng ý: ở những ngày đầu của một startup, tốc độ là moat tốt nhất; nhưng khi đã làm ra thứ người ta muốn, làm sao giữ được vị thế và chống lại cạnh tranh? (theo phần mô tả của video đăng ngày 03/10/2025). Bốn host là Garry Tan, Jared Friedman, Diana Hu và Harj Taggar.
Video mở bằng vài câu trích từ chính cuộc trò chuyện. Một host nói ý tưởng về moat thật phổ biến và thật quan trọng. Một người khác nhận xét thật thú vị là moat giờ được những người muốn làm founder bàn tới nhiều hơn rất nhiều so với thời trước AI. Rồi câu hỏi: điều gì sẽ ngăn bạn khỏi cảnh, về cơ bản, phải chịu cạnh tranh vô hạn? Và một câu chốt: moat vốn là thứ để phòng thủ, bạn phải có gì đó để bảo vệ; nếu không có gì để bảo vệ thì đừng lo về moat của mình (video đăng ngày 03/10/2025).
Garry chào mừng người xem tới một tập mới của Lightcone: hôm nay nhóm sẽ nói về moat. Trong đầu bạn có thể đang hình dung cảnh quân man rợ tràn tới cổng thành. Bạn có một startup nhỏ, và mọi công ty khác ngoài kia đều muốn tới "ăn bữa trưa của bạn". Ngay bên ngoài lâu đài là một con hào, một moat, giữ chúng ở xa. Anh quay sang Jared: khi Jared đi các trường đại học, đây không phải chuyện vặt mà người ta nghĩ tới; nó thật sự đang khiến họ chưa dám bắt đầu làm công ty (theo Garry, video đăng ngày 03/10/2025).
Jared xác nhận: đây là câu hỏi anh và các đồng nghiệp nhận được từ rất nhiều sinh viên rất giỏi trong các chuyến đi tới các trường gần đây. Về cơ bản, các bạn sinh viên không thấy những công ty AI agent mới có thể có moat ra sao. Câu hỏi đó ăn theo meme "ChatGPT wrapper": mọi công ty kiểu này đều có thể bị sao chép dễ dàng. Các bạn thấy được cách build một doanh nghiệp làm ra một ít doanh thu, nhưng không thật sự thấy làm sao build được một doanh nghiệp lâu dài, bền vững (theo Jared, video đăng ngày 03/10/2025).
Jared nghĩ điều đó thật ra không đúng. Anh cho rằng những doanh nghiệp này có moat khá sâu và thú vị, nhưng moat đó là gì thì không hoàn toàn hiển nhiên. Nên đây là một chủ đề thú vị để nhóm khám phá (theo Jared, video đăng ngày 03/10/2025).
2. Cuốn Seven Powers và vì sao moat là chuyện sống còn
Garry kể ở hậu trường AI Startup School gần đây, anh có một trao đổi với Sam Altman mà anh thấy khá buồn cười. Anh và các đồng nghiệp ở YC dành rất nhiều thời gian nghĩ về "make something people want", những châm ngôn rất đơn giản, kiểu ngược với trường kinh doanh. Vậy mà ý tưởng về moat lại phổ biến và quan trọng đến thế. Hai người nhận xét thật buồn cười là một trong những cuốn sách quan trọng để đọc thời nay lại là thứ "nguyên liệu của trường kinh doanh": cuốn The Seven Powers (theo Garry, video đăng ngày 03/10/2025).
Nên hôm nay, theo Garry, nhóm sẽ đi qua bảy power đó: chúng là gì, có những ví dụ cụ thể nào, và một founder vừa mới bắt đầu có thể, hoặc nên, nghĩ về chúng ra sao, qua những ví dụ thực tế nhóm đã thấy (video đăng ngày 03/10/2025).
Jared hỏi Diana có thể kể một chút về cuốn sách không. Diana cho biết sách do Hamilton Helmer viết, ông từng giảng dạy ở Stanford, và sách ra năm 2016. Chị đọc tên sách là "The Seven Powers, The Foundations of Business Strategies". Nhiều ví dụ trong sách thuộc thời các công ty Internet những năm 2000, như Oracle, Facebook, Netflix, một thế hệ cũ hơn. Nên nhóm muốn "khởi động lại" một chút: khung này áp vào năm 2025, với AI, thì thế nào (theo Diana, video đăng ngày 03/10/2025).
Jared thấy cách Helmer dùng thuật ngữ trong sách hơi gây rối. Sách tên là seven powers, nhưng sẽ hợp lý hơn nhiều nếu gọi là seven moats, vì đó thật sự là thứ ông nói tới: bảy loại moat mà một doanh nghiệp có thể có. Đúng là các ví dụ đã lỗi thời, nhưng anh nghĩ khung này thật ra khá vượt thời gian. Hóa ra chỉ có chừng ấy loại moat một doanh nghiệp có thể có, và chúng không thật sự thay đổi. Dù phiên bản cụ thể của từng moat trong thế giới AI agent đã khác, các nhóm moat thì vẫn vậy (theo Jared, video đăng ngày 03/10/2025).
Garry nói may mắn là ta sống trong một thế giới có thị trường, thị trường tự do, nơi có rất, rất nhiều cạnh tranh. Và các moat này, theo nhiều nghĩa, là cách duy nhất để một doanh nghiệp chống lại tất cả những người khác có thể muốn làm đúng điều bạn đang làm. Peter Thiel có câu nổi tiếng "competition is for losers". Ý sâu sắc ở đó là: khi cạnh tranh là vô hạn, điều gì sẽ ngăn bạn khỏi cảnh phải chịu cạnh tranh vô hạn? Hệ quả là biên lợi nhuận của bạn, phần bạn thực sự lời được từ thứ bạn bán, sẽ về 0. Và điều đó có nghĩa là doanh nghiệp của bạn sẽ chết. Nên rốt cuộc, có moat là chuyện khá sống còn (theo Garry, video đăng ngày 03/10/2025).
3. Tìm vấn đề trước, moat đến sau
Jared nhắc lại với Garry: lúc nãy Garry có một ý rất hay, rằng bạn phải lo chuyện này vào đúng thời điểm của một startup. Anh hỏi Garry có muốn nói về cách founder giai đoạn đầu nên nghĩ về moat không (video đăng ngày 03/10/2025).
Garry nói đây là lý do nhóm thường bảo mọi người hãy đi tìm một người có vấn đề thật, rồi giải quyết vấn đề đó trước. Điều buồn cười, hơi bất ngờ, về thế giới là bạn có thể đi gần như bất cứ đâu và tìm thấy một điểm đau, một vấn đề có thể giải bằng phần mềm, nhất là bằng AI, mà nói thẳng ra là chưa ai giải. Những vấn đề đó nhiều và nghiêm trọng tới mức nếu bạn tìm ra và giải được, bạn theo đúng nghĩa đen có thể tạo ra một doanh nghiệp vốn hóa một tỷ, 10 tỷ, thậm chí hàng trăm tỷ đô la. Và nó nằm ngay trước mắt (theo Garry, video đăng ngày 03/10/2025).
Theo Garry, đó thật sự là việc đầu tiên người ta nên làm: tìm một vấn đề rồi đi giải nó. Trên đường đi, khi làm việc với khách hàng, khi build và engineer chính sản phẩm, khi tìm ra mình cần dữ liệu gì và mọi thứ như vậy, bạn có lẽ sẽ tình cờ gặp bảy power này (video đăng ngày 03/10/2025).
Jared đồng ý: moat đến sau. Sẽ khá ngớ ngẩn nếu ai đó quyết định không làm một ý tưởng startup vì chưa thấy moat dài hạn của ý tưởng đó có thể là gì (theo Jared, video đăng ngày 03/10/2025).
4. Speed: moat đầu tiên không có trong sách
Harj thấy thú vị là moat giờ được những người muốn làm founder bàn tới nhiều hơn rất nhiều so với thời trước AI. Lý do chính, có lẽ, chỉ là meme "ChatGPT wrapper" ban đầu, và moat mà phần lớn người ta lo là moat chống lại các công ty model lớn: làm sao bạn không bị một lab lớn nghiền nát khi lab đó thấy sản phẩm bạn đang làm thật sự có giá trị và cũng muốn sở hữu nó? (theo Harj, video đăng ngày 03/10/2025).
Diana nhắc Varun ở Windsurf. Chính Varun đã nói: ở giai đoạn đầu, moat duy nhất startup có thật ra chỉ là tốc độ. Khi đã qua giai đoạn đó và build được thứ người ta muốn, bạn mới tìm ra và đi sâu vào các loại moat nhóm sắp bàn (theo Diana, video đăng ngày 03/10/2025).
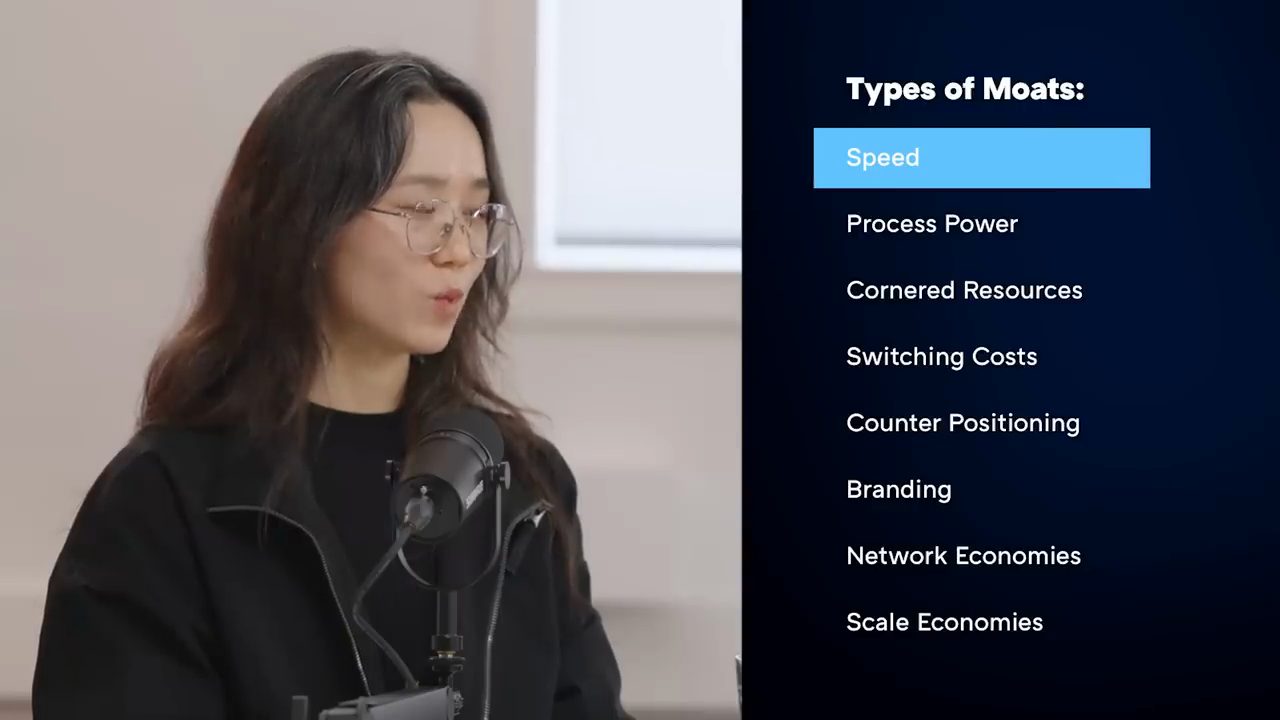
Jared rất thích ý của Varun rằng moat duy nhất là tốc độ. Nó không phải một trong bảy power trong sách, nhưng anh nghĩ có lẽ nó nên có mặt (theo Jared, video đăng ngày 03/10/2025).
Diana nghĩ điều này cũng đi cùng nhiều bài essay của PG, vì một trong những nguyên lý lúc ban đầu là: đúng, có một công ty lớn, chẳng hạn OpenAI, "OpenAI là Google mới". Đúng là OpenAI hay Anthropic có thể build tất cả các feature này, ví dụ Claude Code, rồi cạnh tranh trực tiếp với Cursor chẳng hạn. Nhưng để một startup như Cursor thật sự thắng, ngay cả lúc đầu, là nhờ họ thực thi không ngừng nghỉ (relentless execution). Một công ty lớn hơn như Google hay Anthropic có nhiều thứ phải làm hơn mới ship được sản phẩm: đủ thứ product manager, đủ khâu vận hành phải đi qua, một PRD, một spec doc, và ship một feature mất nhiều thời gian hơn so với ở Cursor (theo Diana, video đăng ngày 03/10/2025).
Chị kể câu chuyện đáng kinh ngạc về Cursor: khi nhóm mời Michael Truell tới nói chuyện với batch, anh chia sẻ chu kỳ phát triển sản phẩm, chu kỳ sprint để ship feature của Cursor là một ngày. Một ngày. Sprint một ngày, ở giai đoạn đầu, quanh khoảng 2023, 2024: mỗi ngày họ bấm đồng hồ và cố ship mọi thứ ngay trong ngày. Diana gọi đó là tốc độ điên rồ: không công ty lớn nào ship được với tốc độ đó. Nhiều nhất là vài tuần, còn các công ty lớn hơn, chị không biết, nếu bạn là Google thì có thể nhiều tháng, đôi khi nhiều năm. Google đã có Google Bard hay Gemini từ rất lâu, và phải mất nhiều năm mới đưa ra được, đúng không? (theo Diana, video đăng ngày 03/10/2025).
5. Startup như team forward deployed engineering, và đừng dùng moat để chọn ý tưởng
Harj nghĩ Cursor và Windsurf là ví dụ tuyệt vời cho câu hỏi khi nào nên bắt đầu nghĩ về moat. Trong vài năm đầu, anh không nghĩ chuyện đó quan trọng mấy. Họ chỉ cần chứng minh rằng codegen sẽ là một ứng dụng AI rất có giá trị, và môi trường phát triển sẽ là thứ rất, rất quan trọng để sở hữu. Họ tăng trưởng nhanh, và chỉ khi đã ở quy mô lớn, họ mới phải bắt đầu nghĩ cách phòng thủ trước Claude Code, Codex hay mọi thứ khác đang tràn vào (theo Harj, video đăng ngày 03/10/2025).
Mô hình tư duy đọng lại trong Harj, một ý mà anh nghĩ chính Jared đã nêu ra, là: một cách nghĩ là tất cả các startup này giống như những team forward deployed engineering, có lẽ là cho các lab. Lúc đầu, vì mọi thứ còn là vùng đất mới (greenfield), chưa ai thật sự biết vertical và sản phẩm nào có giá trị để build. Nên bước một chỉ là tìm ra điều đó. Thậm chí hai năm trước còn chưa rõ đó là codegen hay IDE. Khi bạn đã tìm ra, đã đào trúng vàng và cứ thế đào tiếp, thì có lẽ tới một lúc nào đó bạn sẽ gặp thêm cạnh tranh, vì người ta nhận ra "ồ, cái này thật sự có giá trị, có nhiều tiền để kiếm ở đây". Và khi đó bạn phải bắt đầu bảo vệ kho báu mình đã tìm thấy (theo Harj, video đăng ngày 03/10/2025).
Garry nói tất cả những thứ nhóm sắp bàn, trừ tốc độ, là những bài toán từ một lên một tỷ, từ một lên 10 tỷ, lên 100 tỷ, lên một nghìn tỷ đô la. Và điều thật sự ngớ ngẩn người ta có thể làm là xem tập này rồi lấy nó làm lý do để thậm chí không đi tới được con số một (theo Garry, video đăng ngày 03/10/2025).
Có tiếng nói tiếp: hoặc dùng nó để chọn giữa hai ý tưởng startup, vì họ cố dự báo năm năm tới ý tưởng nào sẽ có moat lớn hơn. Một host đáp: mọi chuyện đơn giản là không vận hành như vậy; theo đúng nghĩa đen, bạn không nên làm thế. Một host nói moat vốn là thứ để phòng thủ, bạn phải có gì đó để bảo vệ, nếu không thì... Có tiếng xen vào: "Nếu bạn không có gì..." Jared nói tiếp: không có gì để bảo vệ thì đừng lo về moat, nếu không nó chỉ như một vũng nước giữa cánh đồng. Có tiếng đồng tình "Yeah, exactly" (video đăng ngày 03/10/2025).
Một host hỏi: giả sử ai đó đã tìm ra thứ có giá trị, đáng để bảo vệ, nhóm có nên đi qua những moat họ có thể nghĩ tới không? (video đăng ngày 03/10/2025).
6. Process power: AI agent được mài giũa nhiều năm
Jared mở đầu bằng process power. Theo anh, thuật ngữ, lại thêm một lần, hơi kỳ, nhưng về cơ bản nghĩa là bạn đã build một doanh nghiệp rất phức tạp với rất nhiều thứ khó cho người khác sao chép, chỉ vì bạn đã build tất cả những thứ đó. Ví dụ Helmer dùng trong sách là dây chuyền lắp ráp của Toyota. Phiên bản AI agent của nó là một AI agent thật phức tạp, được mài giũa qua nhiều năm để chạy thật tốt trong điều kiện thực tế (theo Jared, video đăng ngày 03/10/2025).
Theo Jared, Jake Heller với Casetext là ví dụ gốc. Anh nghĩ tới vài ví dụ khác từ các công ty gần đây hơn: YC có vài công ty bán AI agent cho ngân hàng. Có Greenlite, làm KYC cho ngân hàng, và có Casca, làm loan origination cho ngân hàng, về cơ bản là bảo ngân hàng nên cho vay khoản nào (theo Jared, video đăng ngày 03/10/2025).
Theo Jared, những ví dụ này thú vị vì với mọi AI agent kiểu này, bạn có thể build một bản Greenlite, Casca hay Casetext, một bản demo, trong một hackathon cuối tuần. Khi sinh viên nghĩ về các AI agent này, thứ trong đầu các bạn là bản hackathon cuối tuần của sản phẩm, và các bạn nghĩ: "mình build cái đó trong một tuần được, sao nó phòng thủ được?" Lý do là bản bạn build trong hackathon chẳng hữu ích với ai. Nếu Casca hay Greenlite hỏng, ngân hàng sẽ mất hàng triệu đô la. Đây là hạ tầng mission-critical, giống một chiếc xe tự lái hơn (theo Jared, video đăng ngày 03/10/2025).
Garry nói một cách nhìn là engineering tốt hơn rất nhiều thật ra là dạng process power sâu sắc nhất. Một ví dụ có thể là Plaid: diện tích bề mặt, tức số tổ chức tài chính họ phải hỗ trợ, khổng lồ, có lẽ cỡ hàng nghìn tới hàng chục nghìn website khác nhau, crawler khác nhau, rồi đủ thứ khác. Anh hỏi: bạn có hình dung nổi cấu trúc CI/CD của Plaid không? (theo Garry, video đăng ngày 03/10/2025).
Rồi, Garry nói rõ đây thuần túy là suy đoán: nếu anh là Zach đang điều hành Plaid, anh biết mình sẽ muốn dùng các công cụ codegen mới nhất để thêm được mọi tổ chức tài chính mới trên hành tinh nhanh hơn bất kỳ ai. Với anh, đó là một dạng process power rất sâu sắc trong thời AI hiện đại (theo Garry, video đăng ngày 03/10/2025).
7. Backend sâu, schlep blindness và 10% cuối cùng
Jared nghĩ đây có lẽ là dạng phòng thủ chính của các công ty SaaS đang có. Nhìn một thế hệ trước các công ty AI agent: vì sao Stripe, Rippling hay Gusto phòng thủ được? Anh nghĩ chủ yếu là vì điều này: họ đã build rất nhiều phần mềm, và sao chép lại tất cả sẽ rất đắt và rất khó. Bạn không thể chép nó từ landing page của họ. Logic backend sâu vô cùng (theo Jared, video đăng ngày 03/10/2025).
Harj thấy còn có một yếu tố "schlep blindness" ở đây: bản hackathon của bất kỳ công cụ AI nào giờ làm ra nhanh hơn bao giờ hết. Nhưng thật ra 10% cuối cùng, để nó chạy ổn định trên hàng chục nghìn yêu cầu KYC mỗi ngày, là một kiểu việc cực nhọc, tỉ mẩn mà anh nghĩ rất nhiều kỹ sư không hào hứng làm (theo Harj, video đăng ngày 03/10/2025).
Và theo Harj, các team ở OpenAI cũng sẽ gặp điều này: nếu bạn làm ở một trong các big model lab, nơi có những team đang cố phát minh ra AGI, sẽ khó mà hào hứng với việc chốt nốt 5% độ ổn định cuối cùng cho công cụ KYC của bạn (video đăng ngày 03/10/2025).
Jared đồng ý: điều này đặc biệt đúng với các vertical như KYC, nơi phải có kiến thức chuyên môn mới biết được edge case là gì. Nếu phải chọn trong bảy power, anh nghĩ tốc độ và cái này có lẽ là hai cái nổi trội, xuất hiện thường xuyên nhất (theo Jared, video đăng ngày 03/10/2025). Một host nói thêm: và đó là hai cái gắn nhiều nhất với khâu thực thi.
Diana nói đó là chỗ những builder lì lợm (hardcore builders) thắng. Có product taste thật tốt và build sản phẩm tốt nhất thật sự quan trọng. Chị nghĩ một hiểu lầm có lẽ là: với nhiều sản phẩm, bạn có thể build giải pháp 80% với 20% công sức. Nhưng để các giải pháp, các sản phẩm này thật sự chạy được, bạn cần bản chính xác 99%, thứ tốn gấp 10 lần, thậm chí đôi khi gấp 100 lần công sức. Kiểu nguyên lý Pareto (theo Diana, video đăng ngày 03/10/2025).
8. Cornered resources: bằng sáng chế, FDA và chính phủ
Diana hỏi tiếp: còn power cornered resources thì sao? (video đăng ngày 03/10/2025).
Garry nói góc nhìn kinh điển là đó là những tài sản được thèm muốn, những thứ không thể arbitrage, phải có giá trị tự thân, và đôi khi cho quyền tiếp cận ưu tiên với mức giá thấp hơn rất nhiều. Ví dụ kinh điển là các công ty dược có những bằng sáng chế rất khó có: họ phải nghĩ ra, chứng minh, rồi vượt qua phê duyệt của cơ quan quản lý. Chỉ riêng việc có bằng sáng chế cộng với vượt qua phê duyệt của FDA đã là thứ có thể rất bền. Và nó mạnh tới mức bằng sáng chế có thời hạn, vì người ta không muốn ai giữ nó mãi (theo Garry, video đăng ngày 03/10/2025).
Một ví dụ hiện đại hơn ở mặt quản lý, theo Garry, có thể là Scale AI đang làm rất nhiều việc với DoD, Palantir cũng vậy. Chỉ để tới được đó đã là một quá trình nhọc nhằn: phải tuyển đúng người, phải dành nhiều thời gian ở D.C. và Langley hay bất cứ nơi nào bạn muốn bán, và theo đúng nghĩa đen phải xây SCIF, những data center đặc biệt, rất tốn công và tốn tiền. Bạn phải gắn chặt vào chính phủ. Nhưng khi đã làm được, thì bạn có nó (theo Garry, video đăng ngày 03/10/2025).
Garry nói cornered resource, theo một nghĩa, thậm chí là chỗ đứng trong đầu những người làm việc ở chính phủ. Ngay lúc này, nếu bạn làm với AI, bạn phải đi qua Palantir hoặc Scale. Và điều đó theo đúng nghĩa đen đã được viết vào các tài liệu công khai về cách nghĩ về bản chất chiến tranh và mọi thứ muốn làm liên quan tới AI về sau. Nên cornered resource không nhất thiết là một mỏ kim cương; nó có thể là mỏ kim cương trong đầu khách hàng của bạn (theo Garry, video đăng ngày 03/10/2025).
9. Dữ liệu thật từ FDE, model riêng và context engineering
Garry nói những ví dụ đó gần với chuyện ở tít trên trời, kiểu một công ty trị giá hàng trăm tỷ đô la. Nhưng điều liên quan tới startup, thứ anh nghĩ cả nhóm thấy hằng ngày, là mô hình forward deployed engineer (FDE) vừa được nhắc tới. Theo anh, đó là điều rất nhiều startup cực kỳ thành công hiện nay đang làm theo đúng nghĩa đen (video đăng ngày 03/10/2025).
Các startup đó, theo Garry, ra ngoài và lấy cornered resource dưới dạng dữ liệu thật và workflow thật: ngồi ngay cạnh một khách hàng bình thường sẽ không bao giờ có được phần mềm tốt, rồi nhận ra từng bước: đầu tiên một yêu cầu tới qua email; rồi ta lấy nó và làm giàu thêm theo cách này; đôi khi phải có call center gọi cho người này. Thật sự hiểu một quy trình có thể rất nhàm chán, rồi chuyển nó thành prompt của riêng bạn, eval của riêng bạn, và cuối cùng là dataset của riêng bạn để tune model của riêng bạn. Tất cả những thứ đó đều cực kỳ có giá trị (theo Garry, video đăng ngày 03/10/2025).
Garry lấy ví dụ Character AI. Họ rõ ràng đã build một số LLM đầu tiên, rồi lấy nhiều model và fine-tune theo cách giảm được chi phí serve các model đó 10 lần. Bản thân điều đó cũng là một dạng cornered resource (theo Garry, video đăng ngày 03/10/2025).
Một host nói cornered resource tốt nhất là có model của riêng bạn, làm công việc cụ thể đó tốt hơn, đúng không? Một host khác nói trong một thời gian, người ta nghĩ đó là moat duy nhất bạn có thể có trong mảng này: không có model riêng là bạn tiêu. Hóa ra không đúng; hóa ra nó chỉ là một trong các moat có thể có. Một host nói thêm: một phần, đó là mối đe dọa người ta lo trong bức tranh lớn. Điều đáng sợ nhìn từ độ cao 10.000 feet là nếu tới một lúc nào đó các lab quyết định coi model của mình là cornered resource và hạn chế quyền truy cập (video đăng ngày 03/10/2025).
Garry nói điều thú vị lúc này là có thể đúng rằng biểu hiện hoàn hảo, lý tưởng kiểu Plato, của một hệ AI sẽ cần rất nhiều thứ: có lẽ là pre-training, post-training, RLHF, đủ thứ phải dồn vào mới đạt mức ChatGPT. Nhưng ta cũng còn quá sớm trong cuộc cách mạng này, tới mức nếu chỉ riêng context engineering đưa bạn đi được 80 hay 90% quãng đường, thế là quá đủ. Đó thật ra là tất cả những gì người ta cần làm trong hai năm đầu của startup, gần như luôn luôn (theo Garry, video đăng ngày 03/10/2025).
Anh lấy ví dụ: Cursor không bắt đầu bằng full-parameter fine-tune GPT-5, thứ mà có lẽ giờ họ đã có quyền truy cập. Họ bắt đầu đơn giản bằng việc làm ra thứ người ta muốn. Lúc nãy nhóm có nói đừng dùng các khung này để tự loại mình quá sớm, và theo Garry đây là một phiên bản rất sâu sắc của điều đó (video đăng ngày 03/10/2025).
10. Switching costs: Oracle, Salesforce và những pilot dài
Diana giới thiệu power thứ ba nhóm sẽ bàn: switching costs, chi phí chuyển đổi. Đó là khái niệm bạn có moat khi khách hàng kiểu như bị "mắc kẹt", vì tìm một giải pháp khác trở nên rất đắt với họ, kể cả khi giải pháp kia có thể tốt hơn một chút. Chuyển đi rất đau đớn với họ, về tài chính hay về vận hành, thời gian, công sức, vì họ đã dồn quá nhiều vào giải pháp hiện tại (theo Diana, video đăng ngày 03/10/2025).
Ví dụ trong sách là các cơ sở dữ liệu như Oracle. Khi toàn bộ system of record và toàn bộ dữ liệu của bạn nằm trong Oracle, chuyển đi trở nên cực kỳ khó. Database migration là thứ người ta không làm. Một ví dụ khác là Salesforce: khi mọi hồ sơ khách hàng đã nằm trong Salesforce, bạn đã build đủ thứ workflow, UI, thì việc đào tạo lại cả đội sales dùng một phần mềm mới là rất nhiều việc. Bạn phải chuyển toàn bộ dữ liệu. Tới lúc đó, để công ty chuyển sang một CRM mới có lẽ sẽ mất, chị không biết, cả một năm năng suất hay đại loại vậy, kể cả khi giải pháp mới tốt hơn một chút (theo Diana, video đăng ngày 03/10/2025).
Diana nghĩ cách các công ty AI xây moat kiểu này gắn với một phiên bản của điều Garry vừa nói về forward deployed engineer. Ví dụ là HappyRobot hay Salient: họ bắt đầu bằng những workflow cụ thể, tùy biến rất nhiều theo từng công ty, và làm việc với các doanh nghiệp lớn. Một phần là nhờ forward deployed engineer, họ có thể có những giai đoạn pilot rất dài, kéo dài cỡ sáu tháng tới một năm, nhưng nếu thành công, chúng chuyển thành những hợp đồng bảy chữ số. Pilot dài như vậy vì họ thật sự đang build phần mềm tùy biến cho đúng hoạt động của từng công ty (theo Diana, video đăng ngày 03/10/2025).
Chị kể HappyRobot có khách hàng như DHL, nơi họ đi sâu vào tích hợp với rất nhiều workflow về cách vận hành logistics, thứ rất riêng của DHL. Còn Salient, công ty build AI voice agent cho ngành tài chính, tích hợp với ngân hàng. Rất nhiều ngân hàng có workflow rất khác nhau cho việc hợp nhất khoản vay, thu hồi nợ, giám sát gian lận, rủi ro và tuân thủ. Mỗi nơi một khác, vì tất cả các công ty này đều đã build công cụ nội bộ của riêng họ, và cả việc đưa một công ty AI vào là để build những workflow tùy biến chạy được với họ (theo Diana, video đăng ngày 03/10/2025).
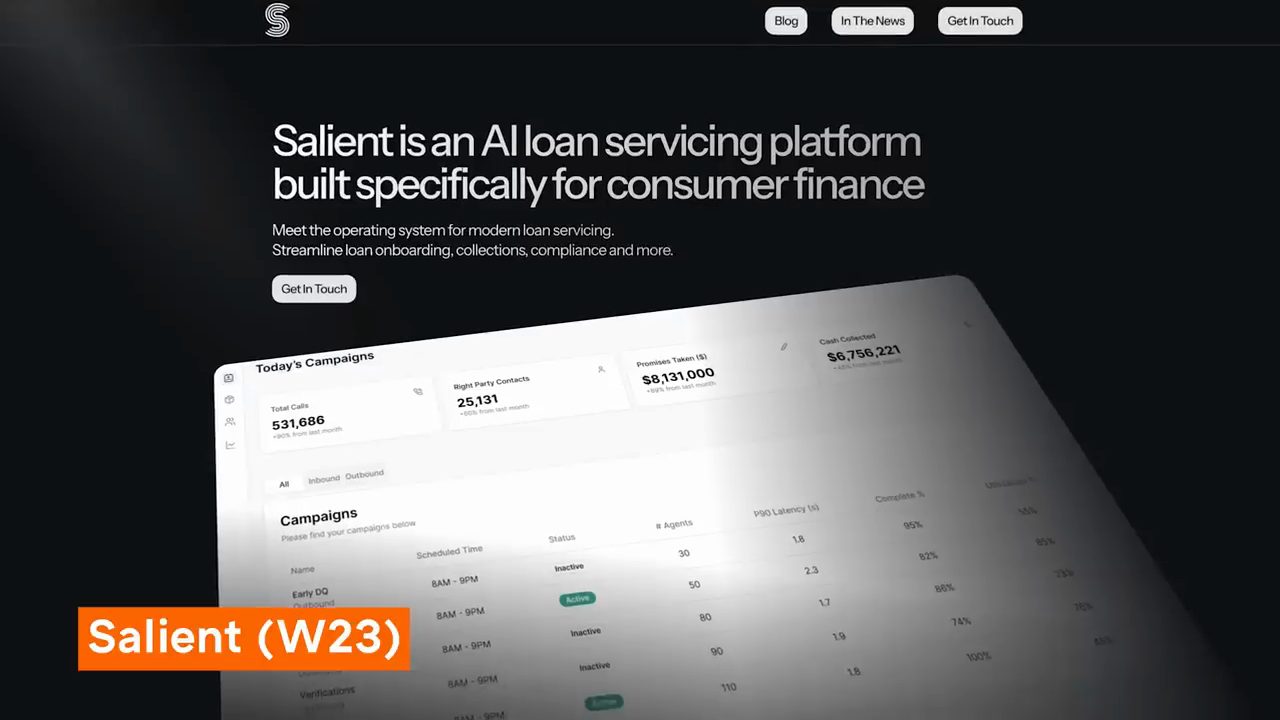
Đánh đổi là chu kỳ pilot rất dài, nhưng theo Diana hũ vàng đáng giá, vì cuối cùng bạn có một hợp đồng lớn. Khi đã vào được, bạn kiểu như "đã thành". Doanh nghiệp lớn sẽ không làm thêm một vòng bake-off nữa, vì với họ thử thêm một công ty AI voice agent hay ho nào khác sẽ là phí thời gian khủng khiếp; tới lúc đó họ chỉ muốn hưởng lợi ích. Chị nói đó là cách các công ty AI này đang thắng (video đăng ngày 03/10/2025).
11. Hai kiểu switching cost, và memory ở phía consumer
Garry nghĩ switching cost vừa là một moat, vừa thú vị ở chỗ trong thời AI, đồng thời bạn cũng thấy AI kéo chi phí chuyển đổi xuống rất nhiều, và đó là một đòn bẩy khác startup có thể dùng. Nếu bạn dùng codegen để rút dữ liệu ra khỏi những hệ thống cũ đã hóa thạch, hoặc khỏi hệ thống của đối thủ, thì những thứ từng dựa nhiều vào switching cost có thể bị bạn kéo xuống tới 0 (theo Garry, video đăng ngày 03/10/2025).
Jared nói thật ra có hai kiểu switching cost. Kiểu cũ từ thời SaaS là mọi system of record như Salesforce, cả các ATS như Lever và Ashby, nơi chi phí chuyển đổi là nỗi đau khi chuyển dữ liệu từ hệ thống này sang hệ thống khác. Anh đồng ý với Garry: LLM có thể giảm đáng kể loại switching cost này, vì LLM có thể tìm ra cách biến đổi dữ liệu từ schema cũ sang schema mới. Bạn dùng browser automation ở cả hai phía để giải quyết chuyện người ta không cho bạn export dữ liệu (theo Jared, video đăng ngày 03/10/2025).
Nhưng theo Jared còn có một dạng switching cost mới mà anh nghĩ khá bản địa của thời AI, như Diana vừa nói: những quy trình onboarding dài dẫn tới tùy biến sâu vào logic của agent, không chỉ ở dữ liệu, thứ không thật sự tồn tại ở thời SaaS. Anh đoán bạn có thể tùy biến bản cài Zendesk của mình một chút, nhưng không nhiều (video đăng ngày 03/10/2025).
Garry nói với các công ty AI ở phía consumer, mọi thứ còn rất sơ khai, nhưng anh nghĩ memory đã bắt đầu thành một kiểu switching cost với chính anh. Anh thật sự sửng sốt khi thấy Claude tụt lại xa đến vậy về memory. Còn mối quan hệ của anh với ChatGPT, anh thấy đã tiến triển rất đáng kể trong năm qua, tới mức nhìn chung nó có vẻ biết anh thích gì và quan tâm điều gì. Nên theo anh, switching cost đó theo thời gian sẽ chỉ ngày càng lớn. Và vì vậy cá nhân hóa (personalization) cho consumer thật ra là một phần rất lớn của chuyện này (theo Garry, video đăng ngày 03/10/2025).
12. Counter-positioning: gót chân Achilles của giá theo seat
Diana hỏi tiếp về counter-positioning, một moat khác trong sách (video đăng ngày 03/10/2025).
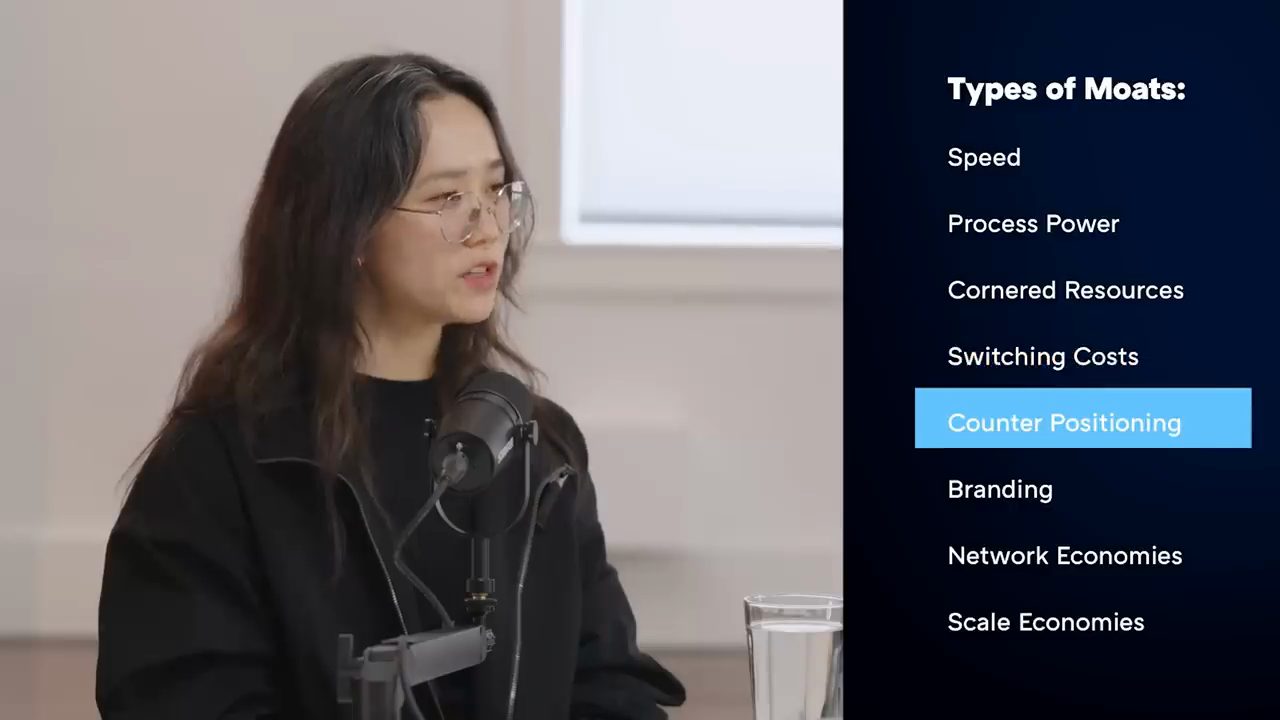
Jared nêu định nghĩa: counter-positioning là làm một điều mà công ty đương nhiệm bạn đang cạnh tranh khó sao chép, vì làm vậy sẽ ăn vào chính mảng kinh doanh của họ. Anh nghĩ có vài cách chuyện này diễn ra. Ở mọi mảng, đang có một cuộc cạnh tranh kiểu Darwin giữa các công ty SaaS đương nhiệm tự build AI agent của mình và các công ty AI native mới build agent nằm trên các công ty SaaS đang có (theo Jared, video đăng ngày 03/10/2025).
Chẳng hạn với customer support, các công ty SaaS đương nhiệm như Zendesk, Intercom và Front đều đang build AI agent của riêng họ. Nhưng YC có một làn sóng công ty mới, lớn lên trong vài năm qua, đang build AI agent giao tiếp với hệ thống. Ai sẽ thắng trong từng cuộc đấu này, theo Jared, là chuyện rất thú vị (video đăng ngày 03/10/2025). Có tiếng xen vào: "Unstoppable force meets immovable object."
Jared nói một cách counter-positioning đang diễn ra là hầu hết các công ty này có mô hình giá tính theo seat, tức theo từng nhân viên. Anh nghĩ đây là một gót chân Achilles rất lớn về chiến lược: nếu AI agent của họ làm tốt và thật sự chạy được, các công ty khách hàng sẽ cần ít nhân viên làm việc này hơn, vì việc sẽ được AI agent tự động hóa. Nói đơn giản, họ càng thành công thì doanh thu của họ càng giảm (theo Jared, video đăng ngày 03/10/2025).
Jared đoán một số công ty sẽ xoay xở được, nhất là nếu vẫn do founder kiểm soát. Anh lấy ví dụ Intercom: anh nghĩ những công ty còn do founder kiểm soát đủ khôn để nhận ra đây là chuyện sống còn và có thể tự ăn vào mình. Còn những công ty không do founder kiểm soát, anh không đặt nhiều hy vọng. Tự ăn vào doanh thu của chính mình là cực kỳ khó (theo Jared, video đăng ngày 03/10/2025).
Harj nói lựa chọn thay thế, như nhóm đang thấy, là rất nhiều mô hình giá của startup xoay quanh khối lượng công việc giao được hay số task hoàn thành. Anh nghĩ đúng như Jared nói, nhưng điều đó cũng kéo sản phẩm về phía phải thật sự hoàn thành được công việc. Và một điều anh đã nói ở cuối batch YC gần nhất, như lời khuyên chốt, là anh ước founder trong batch bằng cách nào đó có thể đi làm một tháng ở vài công ty late stage (theo Harj, video đăng ngày 03/10/2025).
Lý do, theo Harj: điều hàng đầu anh và các đồng nghiệp ở YC nghe từ founder điều hành các công ty đó là họ đang chật vật thế nào để thiết lập lại văn hóa engineering trong tổ chức, để thật sự đón nhận AI, dùng công cụ, chịu làm context engineering và prompt engineering. Kết quả ròng của việc các team này không thật sự trở thành AI native, tạm gọi vậy, là họ không giao được sản phẩm chạy được. Nên họ vừa không muốn bỏ giá theo seat, vì đã quen, mà trong một thế giới AI làm được việc thì sẽ có ít seat hơn để bán; vừa không giao được sản phẩm làm được việc, nên mô hình giá kia cũng chẳng hợp lý với họ (video đăng ngày 03/10/2025).
Một host tiếp lời: đúng, đó là phần process engineering. Họ không giỏi phần process engineering cho kiểu engineering mới này (video đăng ngày 03/10/2025).
13. Avoca, wallet share và chuyện thay thế lao động
Garry nói có một điều mới nổi rất thú vị ở một loạt startup YC, ví dụ Avoca. Họ làm phần mềm customer service, kiểu như ServiceTitan nhưng cho HVAC, tức theo đúng nghĩa đen là những người giúp bạn sửa hệ thống sưởi và điều hòa. Anh nghĩ ServiceTitan có cỡ 1% wallet share, 1% tổng giá trị giao dịch của một công ty HVAC, rất nhỏ. Người ta không chi nhiều tiền cho phần mềm, vì đây là những doanh nghiệp dịch vụ biên lợi nhuận tương đối thấp (theo Garry, video đăng ngày 03/10/2025).
Nhưng điều đáng kinh ngạc Avoca phát hiện ra, theo Garry, là họ có thể bước vào như một phần mềm, rồi theo thời gian giành được phần ngày càng lớn của wallet share, vì họ khiến các công ty HVAC trả tiền cho phần customer support, thứ không phải 1% chi tiêu mà là 4% tới 10%. Nên điều ta có thể sẽ thấy là thế hệ startup AI mới này sẽ tăng trưởng nhiều hơn và có wallet share cao hơn. Thật ra có thể tất cả chúng ta đang đánh giá thấp các công ty vertical SaaS AI sẽ mạnh và lớn tới mức nào, vì bạn không dừng ở 1% wallet share; bạn có thể lên tới 10 (theo Garry, video đăng ngày 03/10/2025).
Diana nói điều này khớp với nhận định rằng vertical AI SaaS agent sẽ lớn gấp 10 lần, ít nhất 10 lần SaaS, vì đúng như Garry nói, nó chạm vào một phần chi tiêu hoàn toàn khác của các công ty: không phải ví tiền dành cho phần mềm, thứ mà tới lúc này chị cho là một ngân sách khá hữu hạn, mà là một không gian mới với những thứ trước đây không mấy khả thi, phần lớn là workflow do con người làm (theo Diana, video đăng ngày 03/10/2025).
Garry nói anh biết người ta khá nhạy cảm với chuyện thay thế lao động, nhưng làm customer support cho một công ty dịch vụ HVAC không phải công việc vui vẻ gì. Có thể thấy điều đó vì tất cả các công việc customer support này có tỷ lệ nghỉ việc hằng năm cỡ 50, 80%. Đó là những công việc hành hạ, chẳng vui chút nào, tới mức chính các công ty và các call center dành gần như toàn bộ thời gian để sàng lọc và đưa thêm người vào làm những công việc tệ hại này (theo Garry, video đăng ngày 03/10/2025).
Nên khi có phần mềm tốt hơn, theo Garry, chuyện đang xảy ra không phải là người ta mất việc: những người này vốn vẫn bỏ việc, vì đó là một công việc tệ. Avoca còn kể với anh rằng nhiều người từng ở các vị trí customer support đó giờ có công việc vui hơn: thay vì quản lý cả một nhóm người không muốn ở đó, họ quản lý AI agent và xử lý những ca lạ, thú vị (theo Garry, video đăng ngày 03/10/2025).
Phần hay nhất, theo Garry, là họ có thể vào và đôi khi sửa prompt, và thật sự có tác động trực tiếp lên cả trải nghiệm của khách hàng lẫn công việc hằng ngày của chính họ. Ngay lập tức đó là một công việc thú vị hơn 10 lần: chăn dắt một đàn AI agent và làm quy trình support tốt dần lên theo thời gian. Xét trong các loại knowledge work, việc đó thú vị hơn nhiều so với làm theo kịch bản và đọc những gì máy tính bảo (video đăng ngày 03/10/2025).
14. Người đi sau: Legora, GigaML, Duolingo và Speak
Một host quay sang Harj: anh có một ý rất thú vị về một dạng counter-positioning thứ hai (video đăng ngày 03/10/2025).
Harj nói mảng này đi nhanh tới mức ở mọi vertical, hay nhiều vertical, ngay từ sớm đã nổi lên một công ty được coi là người thắng sớm. Và thường thì, ít nhất trong bối cảnh YC, nhóm đã thấy đi thấy lại rằng đi sau có lợi thế. Stripe đến sau Braintree, Authorize.net và nhiều thứ khác, và thắng được chỉ bằng cách build một sản phẩm tốt hơn. DoorDash đến sau Grubhub, Postmates và nhiều dịch vụ giao hàng khác, rồi cuối cùng thắng. Nên anh thấy đáng cân nhắc: nếu bạn bước vào một vertical đã có cảm giác cạnh tranh, hoặc đã có vẻ có một người thắng sớm, bạn counter-position với họ thế nào? (theo Harj, video đăng ngày 03/10/2025).
Một điều anh thấy rất thú vị là Legora và Harvey, cả hai đều ở mảng AI pháp lý; Harvey là người thắng sớm. Counter-positioning anh thấy ở Legora là: Harvey vào sớm, có lẽ có doanh số sớm, nhưng tập trung nhiều vào fine-tuning như điểm khác biệt sản phẩm, trong khi theo thời gian người ta thấy đó có lẽ không phải bước đi đúng; bạn muốn thật sự tập trung vào application layer và đơn giản là build một sản phẩm tốt hơn. Legora tập trung vào điều đó, đó là cách họ xây thương hiệu và định vị, và có vẻ nó đang rất hiệu quả với họ ở vai người đi sau (theo Harj, video đăng ngày 03/10/2025).
Một công ty Harj làm việc gần hơn là GigaML, bước vào mảng customer service và cạnh tranh với Sierra và Decagon, những công ty customer support rất nổi tiếng. Từ những gì anh thấy về cách họ bán hàng, cách họ ký được vài khách hàng lớn, counter-positioning của GigaML là sản phẩm của họ về cơ bản chạy tốt hơn ngay khi vừa lấy ra dùng, và nhờ vậy họ có quy trình bán hàng và onboarding nhanh hơn nhiều. Counter-positioning của họ kiểu như: nếu bạn muốn customer support của mình chạy được càng nhanh càng tốt, bạn nên đi qua quy trình onboarding của GigaML thay vì của Decagon. Anh nghĩ điều đó đã hiệu quả khá tốt với họ (theo Harj, video đăng ngày 03/10/2025).
Jared nói GigaML là một ví dụ thú vị: rõ ràng một AI agent có thể làm công việc này không chỉ tốt bằng con người mà tốt hơn con người rất nhiều. Những shipper DoorDash mà agent của GigaML nói chuyện cùng, nhiều người không nói tiếng Anh tốt; họ nói đủ thứ tiếng. Bạn không thể thuê một nhân viên customer support thông thạo 200 ngôn ngữ, nhưng LLM thì làm được ngay khi lấy ra dùng. Và chúng kiên nhẫn vô hạn nếu đường truyền kém. Anh thấy điều đó khá thú vị (theo Jared, video đăng ngày 03/10/2025).
Diana nói còn một ví dụ nữa, đúng ý về khả năng siêu phàm, nơi phiên bản AI của sản phẩm thật sự chạy được, và chị nhắc Harj có ví dụ Duolingo và Speak (video đăng ngày 03/10/2025).
Harj nói Duolingo rõ ràng là ứng dụng học ngôn ngữ lớn nhất, anh nghĩ phần lớn người dùng đều biết. Lời chỉ trích đang nổi lên, theo anh, là nó thật ra giống một ứng dụng game hơn là một ứng dụng học ngôn ngữ; cách app vận hành không liên quan gì tới việc học thật một ngôn ngữ. Rồi có Speak, dùng LLM, dùng giọng nói để thật sự giúp bạn luyện tập và thật sự học ngôn ngữ đó (theo Harj, video đăng ngày 03/10/2025).
Theo Harj, counter-positioning đó đang rất hiệu quả với Speak: Speak tăng trưởng bùng nổ, và không cố cạnh tranh với Duolingo ở chỗ có nhiều gamification, điểm thưởng và cơ chế game tuyệt vời, mà cạnh tranh bằng thông điệp: "chúng tôi đơn giản là nơi bạn nên tới nếu muốn học ngôn ngữ bằng cách nói nó" (video đăng ngày 03/10/2025).
15. Brand: ChatGPT, Gemini và cỗ máy in tiền của Google
Harj nghĩ moat counter-positioning rất gần, và chồng lấn với ý về moat thương hiệu. Anh nghĩ trong sách Helmer nói brand về cơ bản là một moat khi bạn nổi tiếng tới mức kể cả khi có sản phẩm tương đương, người tiêu dùng vẫn chọn bạn vì hiệu ứng thương hiệu; ví dụ là Coca-Cola. Trong bối cảnh AI, anh nghĩ có lẽ khó áp dụng brand như một moat trực tiếp cho startup hơn, vì cần thời gian mới có được thương hiệu, nhưng chắc chắn bạn thấy được tác động của nó (theo Harj, video đăng ngày 03/10/2025).
Điều vẫn khiến Harj sửng sốt là ChatGPT của OpenAI có nhiều người dùng mỗi ngày hơn Gemini của Google. Anh nghĩ bất kỳ ai hiểu các model và dùng chúng hằng ngày đều sẽ nói Gemini Pro 2.5 và Gemini Flash 2.5 là những model tương đương (theo Harj, video đăng ngày 03/10/2025).
Jared nói thêm: Google cũng có sẵn mọi người dùng; về cơ bản ai trên thế giới cũng là người dùng Google. OpenAI ban đầu không có người dùng nào. Google đã là một trong những thương hiệu tiêu dùng lớn nhất hành tinh, gần như chắc chắn là thương hiệu tiêu dùng lớn nhất trên Internet (theo Jared, video đăng ngày 03/10/2025). Có tiếng nói tiếp: vậy mà một người khác xuất hiện và xây nên thương hiệu ứng dụng AI tiêu dùng, còn Google thì đang chạy theo. Người nói còn thêm: nếu năm 2022 có ai bảo anh mọi chuyện sẽ diễn ra như vậy, anh hẳn đã khá hoài nghi (video đăng ngày 03/10/2025).
Garry nói đây cũng là một ví dụ hoàn hảo nữa của counter-positioning. Google có một mô hình kinh doanh buộc họ phải tiếp tục nuôi quảng cáo. Nên bạn có cỗ máy in tiền vĩ đại nhất trong lịch sử loài người, vậy tại sao lại phá nó đi, kể cả khi cái giá là làm chậm lại vài năm khả năng con người tiếp cận tri thức, kể cả khi đó là mục tiêu cốt lõi Google tự tuyên bố: tổ chức thông tin của thế giới (theo Garry, video đăng ngày 03/10/2025).
Diana nói đó thật sự là một câu chuyện ít được kể về nguồn gốc ChatGPT, nó ra đời thế nào, và đó thật sự là moat gốc của startup: tốc độ. Nó được ship rất nhanh, trong vòng vài tháng, với một team rất nhỏ, vài kỹ sư (theo Diana, video đăng ngày 03/10/2025).
Một host nói thêm: điều đó đã đòi hỏi Sam Altman, YC Research và Greg Brockman đi tuyển Ilya Sutskever từ DeepMind, vì ông ở đó. Và rất nhiều người sau này giúp tạo ra OpenAI đến từ DeepMind. Nó đã ở đúng chỗ; chỉ là chỗ đó không nuôi dưỡng đúng thứ xã hội thật sự cần. Có tiếng xen vào: "For speed." Một host chốt: lại là moat đó, tốc độ, số một (video đăng ngày 03/10/2025).
16. Network economies: dữ liệu và eval
Một host hỏi Diana có muốn nói về network economies không. Diana nói trong sách, network economy được mô tả là khi giá trị của sản phẩm tăng lên khi có thêm người dùng hay khách hàng dùng nó, và ai cũng nhận được nhiều giá trị hơn nhờ có thêm người dùng. Ví dụ trong sách là Facebook: khi bạn dùng và bạn bè bạn dùng, Facebook vui hơn với chị vì mọi bạn bè đều ở đó. Càng thêm người dùng, mạng xã hội càng có giá trị. Đó đúng là thời Internet, khi người ta nói về network effect (theo Diana, video đăng ngày 03/10/2025).
Ví dụ khác Helmer đưa ra là mạng Visa: càng nhiều merchant dùng Visa, người tiêu dùng càng được nhiều giá trị, vì có thể quẹt thẻ Visa ở nhiều nơi hơn. Rồi đó trở thành moat, vì muốn thắng thì rất khó gom được một số lượng lớn người dùng hay merchant như vậy. Nên nó trở nên rất phòng thủ được (theo Diana, video đăng ngày 03/10/2025).
Ở thời AI hiện nay, theo Diana, hình dạng của network effect khác đi: nó thật sự mang hình dạng dữ liệu. Chị nghĩ rất nhiều dữ liệu các công ty AI tiếp cận được trở thành moat: càng có nhiều dữ liệu, các model tùy biến họ build càng tốt hơn, và model tốt hơn thì sản phẩm cho người dùng tốt hơn. Có rất nhiều ví dụ. Ngoài các công ty foundation lab lớn, nơi chị không chắc, nhưng có lẽ họ dùng một phần dữ liệu từ người dùng (theo Diana, video đăng ngày 03/10/2025).
Garry chen vào: ChatGPT gần như chắc chắn đưa rất nhiều thứ trong đó quay ngược trở lại, vì bạn có một reward function nhất định cho mỗi lần training, đúng không? Diana tiếp: nên toàn bộ lịch sử mọi cuộc chat từ ChatGPT 1, 2, 3, 4, 5 giờ được đưa vào GPT-6, rồi cứ thế, để giúp tạo ra phiên bản model tiếp theo (theo Garry và Diana, video đăng ngày 03/10/2025).
Diana nói còn có những phiên bản nhỏ hơn. Ví dụ Cursor có lẽ có một trong những tính năng autocomplete Tab tốt nhất, vì với bản miễn phí của Cursor, họ thật sự nói rõ khi bạn đăng ký rằng họ sẽ dùng dữ liệu, và dùng nó để train. Càng nhiều người dùng, họ càng có nhiều dữ liệu (theo Diana, video đăng ngày 03/10/2025). Jared nói thêm: anh nghĩ theo đúng nghĩa đen là mọi cú click chuột, mọi lần gõ phím bạn tạo ra khi dùng Cursor đều được đưa vào một model, điều này khá điên rồ (theo Jared, video đăng ngày 03/10/2025).
Diana tiếp: càng nhiều developer dùng Cursor, sản phẩm càng tốt hơn, và họ cộng dồn nhiều chiến thắng từ đó. Phiên bản áp dụng cho startup AI là khi họ làm việc với doanh nghiệp, công ty lớn, và tiếp cận được dữ liệu riêng. Chị nhắc lại Salient hay HappyRobot: khi nhân viên của các công ty khách hàng dùng sản phẩm, họ có rất nhiều dữ liệu riêng giúp nhiều workflow tốt hơn (theo Diana, video đăng ngày 03/10/2025).
Cách họ cải thiện điều đó, theo Diana, cũng là cách thứ hai để có moat từ network, là eval. Diana nói eval là moat then chốt của startup AI. Eval là nơi bạn thu được rất nhiều thông tin về cái gì chạy được và cái gì không, rồi đem trở lại để lặp và cải thiện context engineering. Đó là một flywheel bạn chỉ đạt được khi sản phẩm được dùng ngày càng nhiều, dù là sản phẩm consumer hay một AI vertical SaaS agent (theo Diana, video đăng ngày 03/10/2025).
17. Scale economies: model layer, DeepSeek và Exa
Diana nói moat cuối cùng trong sách là scale economies, và mời Jared nói về nó. Jared giải thích scale economies là lợi thế quy mô: bạn đã đầu tư rất nhiều tiền để build một thứ rất lớn, và nhờ đó có lợi thế quy mô, cung cấp được dịch vụ rẻ hơn bất kỳ ai. Ví dụ kinh điển là UPS, FedEx hay mạng giao hàng của Amazon: họ đã build hạ tầng vật lý khổng lồ, và nhờ đó chi phí trên mỗi đơn vị thấp hơn một đối thủ nhỏ (theo Jared, video đăng ngày 03/10/2025).
Jared nghĩ trong thế giới AI, chuyện này thật ra chưa diễn ra nhiều ở application layer. Nó thật sự diễn ra ở model layer: train một LLM state-of-the-art rất tốn vốn, chỉ vài công ty đủ sức làm. Khi đã làm xong, bạn đủ sức cho người khác chạy inference trên model đó rất rẻ. Theo anh, đó là lý do thông báo của DeepSeek năm ngoái gây chấn động đến vậy, vì có vẻ như train một frontier LLM có thể rẻ hơn nhiều so với người ta từng nghĩ, điều sẽ làm giảm mạnh sức mạnh lợi thế quy mô mà người ta tưởng các AI lab có (theo Jared, video đăng ngày 03/10/2025).
Diana nói điểm then chốt về DeepSeek là họ đã tìm ra và công bố một bước mở khóa mới cho model: cách làm RL. Họ vẫn build trên một trong các foundation model lớn, nên vẫn đắt. Phần RL rẻ hơn, nhưng bạn vẫn cần một foundation model lớn rất đắt. Theo chị, đó là một trong những điều truyền thông hiểu sai (theo Diana, video đăng ngày 03/10/2025).
Jared nói còn một câu hỏi riêng mà người ta hay bàn: các công ty foundation model sẽ phòng thủ trước nhau thế nào? Đây chắc chắn là một cách: giờ rất khó để là người mới bước vào cuộc chơi đó, vì lợi thế quy mô này. Nhóm cũng đã nghĩ chuyện này diễn ra thế nào với startup: không có nhiều ví dụ, nhưng anh nghĩ có vài ví dụ tốt. Một ví dụ tốt là một công ty của Harj, Exa, và anh mời Harj giải thích Exa làm gì (theo Jared, video đăng ngày 03/10/2025).
Harj nói về cơ bản Exa là search cho AI agent: một API cho bất kỳ ai build ứng dụng AI muốn tìm kiếm trên web (theo Harj, video đăng ngày 03/10/2025). Jared nói thêm cách anh nghĩ chuyện này đang diễn ra với Exa: để cung cấp dịch vụ đó, họ phải crawl web, không phải toàn bộ web như Google, nhưng một phần lớn. Việc đó rất đắt, đòi hỏi một khoản đầu tư vốn cố định lớn, nhưng khi đã crawl được một phần lớn của web, bạn có thể dùng lại cùng bản crawl đó cho rất nhiều khách hàng khác nhau (theo Jared, video đăng ngày 03/10/2025).
Có tiếng nói tiếp: điều thú vị ở Exa, điểm song song với các công ty model, là họ đã đầu tư vào đó từ trước khi agent thật sự cất cánh; họ đến khá sớm, thậm chí từ trước khi ChatGPT ra mắt. Họ đầu tư sớm, đặt cược giống như các lab đã đặt cược vào transformer và scaling laws (video đăng ngày 03/10/2025).
Jared nói thêm: trong batch gần nhất có hai công ty, Channel 3 và Orange Slice, đều đang làm hướng kiểu Exa.ai: crawl một phần lớn của web, giữ một bản crawl tĩnh lớn trên server của mình, rồi cho agent chạy trên bản crawl đó. Anh nghĩ ta sẽ thấy điều này ngày càng nhiều, nhất là khi web agent chạy tốt hơn (theo Jared, video đăng ngày 03/10/2025).
18. Lời khuyên cuối: bắt đầu từ một nỗi đau thật
Garry chốt lại: bạn cần chủ yếu tập trung vào moat đầu tiên, thứ thậm chí không có trong sách: tốc độ. Nếu bạn đang vắt óc nghĩ "liệu mình có thành cornered resource hay không?", bạn đang nghĩ sai cách. Bạn không nên bắt đầu từ đó (theo Garry, video đăng ngày 03/10/2025).
Theo Garry, bạn nên bắt đầu bằng câu hỏi: mình có một người cụ thể đang có một điểm đau nào đó không? Và nó khá đau. Không phải kiểu "giá mà mình làm được việc này thì hay". Mà là "năm nay mình sẽ không được thăng chức, có khi mình bị đuổi việc; đau tới mức hôm nay mình không muốn đi làm". Đó là kiểu nỗi đau bạn đang tìm (video đăng ngày 03/10/2025).
Nếu bạn viết được phần mềm hay build được thứ gì đó thật sự làm dịu nỗi đau đó, nỗi đau sống còn, kiểu "doanh nghiệp sắp phá sản", hay "trời ơi, năm sau tụi mình hoàn toàn có thể chiếm lĩnh mọi thứ", thì đó là cảm giác bạn muốn ở khách hàng của mình. Nếu tìm được những thứ như vậy, theo Garry, hãy đi tìm nó và đi từ không lên một với nó trước đã. Rồi anh chào: hẹn gặp lại mọi người lần sau (video đăng ngày 03/10/2025).
Nguồn và liên kết 6 nguồn
- Tên gốc: The 7 Most Powerful Moats For AI Startups
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=bxBzsSsqQAM youtube.com
- Kênh YouTube Y Combinator (Garry Tan, Jared Friedman, Diana Hu, Harj Taggar): youtube.com/channel/UCcefcZRL2oaA_uBNeo5UOWg youtube.com
- Exa, công ty Harj giải thích là search cho AI agent; trang chủ tự giới thiệu là "Search API for AI Agents" (đọc ngày 03/11/2026): exa.ai exa.ai
- Legora, ví dụ người đi sau trong mảng AI pháp lý Harj nêu; trang chủ mô tả là AI cộng tác giúp luật sư review, research và soạn thảo (đọc ngày 03/11/2026): legora.com legora.com
Related talks
Công cụ thiết kế business model: Business Model Canvas
Alexander Osterwalder & Steve Blank · Stanford eCorner · 53 min
Osterwalder giải thích chín khối của Business Model Canvas qua ca Nespresso, demo thêm con số, rồi cùng Steve Blank bàn cách test business model.
Startup Secrets: business model đột phá
Michael Skok · Harvard Innovation Labs · 112 min
Michael Skok cùng Acquia, Formlabs, Diagnostics for All và OPEX Engine: tìm CORE, nhân và bẩy nó bằng multipliers, levers để có business model đột phá.
Business model và pricing cho startup
Aaron Epstein · Y Combinator · 33 min
Aaron Epstein (YC) giới thiệu chín business model, bài học từ top 100 công ty YC và năm insight về pricing, kèm câu chuyện Stripe, Netflix, Segment.