Physical AI: dữ liệu, simulation và khoảng cách sim-to-real
Spencer Huang và Károly Zsolnai-Fehér bàn vì sao physical AI khó: dữ liệu, simulation truyền thống và neural, khoảng cách sim-to-real và whole-body control.
✓ Đã duyệt độc lập · cập nhật 06/11/2026 · 46 min
1. Ba thông báo trong ngày: Isaac Lab với Newton, DGX Station và Agile ONE SN
Đây là một cuộc trò chuyện trên kênh Two Minute Papers (video đăng ngày 06/11/2026). Người hỏi là host của kênh, Dr. Károly Zsolnai-Fehér, mặc áo blouse trắng. Người trả lời là Spencer Huang, khách mời có tên trong tiêu đề video. Trong cuộc trò chuyện, Spencer nói về Isaac Lab, Cosmos, GR00T và SONIC như những thứ "chúng tôi" làm, và khi Károly hỏi về con robot phát bỏng ngô ở trụ sở NVIDIA, Spencer xác nhận "chúng tôi có chúng ở GEAR lab" (theo video đăng ngày 06/11/2026).
Hai người chào nhau, rồi Károly hỏi ngay: hôm nay anh công bố những gì? Spencer nói hôm nay anh và nhóm công bố vài thứ (theo video đăng ngày 06/11/2026).
Thứ nhất là Isaac Lab với các bản cập nhật Newton. Theo Spencer (video đăng ngày 06/11/2026), một trong những điểm hay của bản cập nhật này là nó không chỉ giúp developer thật sự scale out, mà còn cho phép họ tận dụng trọn vẹn Newton. Đây là một trong những thứ anh và nhóm rất mong chờ. Newton, một physics framework, đã ra mắt từ năm ngoái, "như anh biết đấy", anh nói với Károly. Việc tích hợp nó vào Isaac Lab là một quá trình từng bước một, và lý do là anh và nhóm đang chuyển từ PhysX sang Newton. Những cải tiến này sẽ mang lại cho developer nhiều cải thiện về trải nghiệm sử dụng (quality of life), và anh và nhóm khá hào hứng với điều đó.
Thứ hai là một số blueprint cho DGX Station. Theo Spencer (video đăng ngày 06/11/2026), chúng cho mọi người một điểm khởi đầu rất tốt, vừa để train các policy, vừa để tận dụng những chiếc DGX Station, mà anh gọi là những máy trạm tuyệt vời để đặt ngay trên bàn làm việc. Nếu bạn có một chiếc, anh nghĩ bạn sẽ có nhiều niềm vui với nó.
Thứ ba là Agile ONE SN. Spencer mô tả đây là một nền tảng tham chiếu (reference platform) mà anh và nhóm xây cùng Agile: anh và nhóm làm việc trên nền tảng Agile ONE của đối tác, và đảm bảo nó có đủ mọi thứ, từ tích hợp Thor cho tới tối ưu toàn bộ firmware và software stack bên trên. Nhờ vậy, khi mở hộp ra là đã có sẵn GR00T, sẵn sàng để developer bắt tay vào việc ngay (theo video đăng ngày 06/11/2026). Trang tin của NVIDIA (đọc ngày 06/11/2026) ghi tên đối tác là Agile Robots và gọi phần compute là NVIDIA Jetson Thor.
Spencer nói một trong những điều khó mà anh và nhóm gặp khi phát triển trên các nền tảng này là phần bàn tay. Bản này đi kèm bàn tay Wuji (theo video đăng ngày 06/11/2026; trang tin của NVIDIA, đọc ngày 06/11/2026, ghi là hai bàn tay WUJI Hand 2).
2. Bàn tay robot, "càng ít ma sát càng tốt" và vì sao physical AI khó hơn LLM
Theo Spencer (video đăng ngày 06/11/2026), việc gắn bàn tay vào robot, cộng với việc dựng software stack lên, có thể mất vài tháng hay vài tuần, tùy bạn quen với các nền tảng này tới đâu. Vì vậy, đưa ra một bản đã được kiểm định chất lượng, một thứ anh và nhóm tự hào khi ship và chính anh và nhóm cũng đang dùng, sẽ giúp developer bắt tay ngay vào workload thật của mình. Anh và nhóm không muốn developer phải loay hoay với những thứ mà nếu được thì anh và nhóm có thể giải quyết sẵn cho họ.
Câu "the less friction, the better" (càng ít ma sát càng tốt) được nói hai lần, rồi có tiếng chốt lại: mục tiêu là làm được nhiều việc hơn (video đăng ngày 06/11/2026).
Károly chuyển sang câu hỏi lớn (video đăng ngày 06/11/2026): chúng ta đã có LLM nhiều năm nay rồi, nhưng physical AI, tức robot, thì chưa được như vậy. Vì sao physical AI khó hơn LLM nhiều đến thế?
Spencer đề nghị lùi lại một bước. Theo anh (video đăng ngày 06/11/2026), LLM có một lợi thế: loài người đã ghi chép lại lịch sử của mình từ khi nghĩ ra được các phương thức khác nhau, dù là chữ viết, chụp ảnh hay ghi hình "giống như thế này đây". Có ngôn ngữ tự nhiên, có ngôn ngữ nói chung, nên chúng ta đã có sẵn nền tảng. Chúng ta đã có một lượng nội dung khổng lồ. Vì thế việc train các model này trở thành bài toán: làm sao lấy toàn bộ dữ liệu phi cấu trúc ấy và bắt đầu trích xuất feature, việc mà sau này trở thành feature engineering, và làm sao train model ngày càng thành thạo hơn. Rồi chúng ta thêm dần các modality khác vào: hình ảnh, âm thanh và những thứ tương tự.
Nhưng với physical AI, theo Spencer (video đăng ngày 06/11/2026), không có bộ dữ liệu nào bao quát được toàn bộ physics của thế giới, cách bạn tương tác với thế giới. Chúng ta nói về việc bạn có thể hành động thế nào trong thế giới, và chúng ta có semantics cho các hành động đó. Chúng ta rất giỏi trong việc để VLM mô tả cách con người, đồ vật, agent tương tác với thế giới. Nhưng khi chúng thật sự tương tác với thế giới, ta lại không có dữ liệu vật lý đó. Mà đó chính là phần quan trọng, phần then chốt.
Lý do, theo Spencer (video đăng ngày 06/11/2026): khi làm việc với robot, chúng phải tác động lên thế giới, và thế giới tác động ngược lại. Trong vật lý, người ta gọi đó là coupling. Với bidirectional coupling (coupling hai chiều), khi anh tạo một lực tác động lên một vật, vật đó có thể đẩy ngược lại. Nếu có một vật mềm đặt trên một vật rắn (rigid body), sẽ có biến dạng trên vật mềm, ví dụ bàn tay anh là vật mềm đặt trên vật rắn này. Và điều đó rất khó.
3. Physics solver, imitation learning và cái khó của teleop
Spencer kể ra từng phần của cái khó (theo video đăng ngày 06/11/2026). Thứ nhất, bạn phải có physics solver mô phỏng được thực tại, tức physics của thực tại, theo cách mà ta có thể đưa vào việc train các robotic policy. Mặt khác, bạn vẫn phải có tất cả dữ liệu ghi lại những dynamics đó thật sự diễn ra thế nào: dữ liệu tương tác khi thao tác đồ vật (manipulation interaction data), dữ liệu chuyển động (motion data), thậm chí cả quỹ đạo (trajectory).
Theo Spencer (video đăng ngày 06/11/2026), với robot ngày nay, ta phải bắt đầu bằng imitation learning, vì nó cho ta một điểm xuất phát, một tập hành động để xây tiếp lên trên. Sau khi bắt chước hành vi của con người, bạn có thể train những robot policy vững hơn. Cách anh và nhóm làm là dùng teleop: một người điều khiển robot từ xa, và vì họ đang điều khiển chính con robot đó nên có thể ghi lại toàn bộ dữ liệu trên đúng embodiment (thân robot) ấy.
Trong năm qua, theo Spencer (video đăng ngày 06/11/2026), đã có những cải thiện khiến ta không nhất thiết chỉ dựa vào teleop. Teleop vẫn mang đúng những giới hạn của con người. Anh nói: ai nghĩ teleop dễ thì rõ ràng là chưa bao giờ điều khiển robot từ xa. Nó khác hẳn so với bạn tưởng, vì nhiều hệ thống không có force feedback (phản hồi lực). Không có force feedback, hãy tưởng tượng như tay bạn bị tê đi.
Spencer giải thích (video đăng ngày 06/11/2026): bộ não được nối dây để tìm kiếm phản hồi đó, và bạn dừng lại khi cảm thấy có gì đó chạm vào. Có lúc bạn đang teleop, robot ở chỗ này còn người ở chỗ kia, nên bạn phải tự hình dung trong đầu robot đang nhìn thấy gì trong khi bạn thao tác từ bên cạnh, và việc đó cực kỳ khó. Thế là việc lắp ráp vài vật đơn giản thôi cũng bỗng trở thành một công trình lớn.
Vì thế, theo Spencer (video đăng ngày 06/11/2026), điều anh và nhóm thấy trong năm qua là cuối cùng đã có thể bắt đầu dùng dữ liệu từ con người. Có dữ liệu egocentric (góc nhìn thứ nhất): "tôi chỉ cần quay bằng camera những gì tôi đang làm bằng đôi tay", và từ đó có dữ liệu manipulation. Hoặc lấy dữ liệu cơ thể người quay từ bên cạnh, rồi trích xuất human pose và tương tác giữa người với đồ vật. Từ đó có thể bắt đầu có dữ liệu để train policy. Thách thức với anh và nhóm không chỉ là định nghĩa dữ liệu tốt là gì và thu thập nó ra sao, mà còn là dùng dữ liệu đó thế nào cho tốt.
4. Dữ liệu từ con người, co-training và n môi trường
Cuối cùng, theo Spencer (video đăng ngày 06/11/2026), mọi thứ trở thành một bài toán co-training. Dữ liệu thật thì có hạn, vì thu thập mất rất nhiều thời gian và tốn một khoản tiền X để có được môi trường. Ở phía bên kia, anh và nhóm muốn dùng được simulation. Dữ liệu mô phỏng thì có thể tạo ra rất nhiều, nhưng không hẳn có chất lượng cao bằng dữ liệu thật, vì chúng ta vẫn đang tìm cách làm feature extraction: làm sao biết feature nào của dữ liệu mô phỏng thật sự ảnh hưởng tới hiệu năng của model khi ghép với dữ liệu thật?
Vì vậy, Spencer nói (video đăng ngày 06/11/2026), có một kiểu "law of large numbers" (luật số lớn) mà anh và nhóm về cơ bản đang dùng cho dữ liệu mô phỏng. Và co-training, nghĩa là dùng cả dữ liệu thật lẫn dữ liệu mô phỏng cùng lúc khi train policy, trở thành một dạng nghệ thuật.
Theo Spencer (video đăng ngày 06/11/2026), physical AI khó chính là vì khi gộp tất cả những vấn đề này lại, bạn còn phải nhân nó lên cho n môi trường. Anh và nhóm không chỉ cố mô phỏng một môi trường này. Anh và nhóm cần train một robot, hay một agent, để hoạt động được trong gần như mọi môi trường. Và đó mới chỉ là môi trường trên mặt đất: kho hàng, nhà ở, data center, thậm chí trên đường cho xe tự lái, trên trời cho các thiết bị bay. Anh nhắc tới những chiếc drone giao hàng tuyệt vời: thật tuyệt khi bạn có thể đặt bữa trưa và nó bay tới tận chỗ bạn trong công viên.
Rồi, theo Spencer (video đăng ngày 06/11/2026), ta phải bắt đầu tới những nơi con người không thể tới, những nơi đơn giản là nguy hiểm: xuống sâu dưới đáy đại dương, đi sâu vào lòng đất. Tất cả những nơi đó đều cực kỳ thưa dữ liệu, vì ta thật sự có bao nhiêu dữ liệu về chúng đâu? Nên đây là một bài toán đa chiều. Phần lớn công việc là cân giữa việc thu thập được càng nhiều càng tốt, và tìm cách tốt để mô phỏng thực tại sát nhất có thể.
Károly đáp lại hai lần (video đăng ngày 06/11/2026): "That was awesome" (tuyệt quá).
5. "Chế độ ăn" dữ liệu lý tưởng cho physical AI
Károly nói (video đăng ngày 06/11/2026) anh đã nghe về rất nhiều thứ, và nghe như thể có một kiểu "chế độ ăn dữ liệu" (data diet) lý tưởng để train physical AI. Với LLM, ta có dữ liệu văn bản và hình ảnh đa phương thức. Còn ở đây, như Spencer nói, có thông tin teleop, có các simulator truyền thống làm thủ công, thứ mà Károly nói là "rất gần với trái tim tôi", và có các neural simulation, tức world model. Vậy làm sao xây được chế độ ăn lý tưởng từ những thứ đó? Mỗi loại giỏi ở điểm gì, tỉ lệ nào là tốt? Károly đoán rằng nếu tỉ lệ trong dữ liệu train không đúng thì sẽ ra một thứ không generalize tốt, và anh gọi bài toán này là "khó một cách quỷ quái" (devilishly difficult).
Spencer khen đây là một câu hỏi rất hay, và đồng ý: nó đúng là khó một cách quỷ quái. Theo anh (video đăng ngày 06/11/2026), sự tinh tế của việc trộn dữ liệu (data mixture) lúc này, anh cho rằng, chính là một môn nghệ thuật. Anh đề nghị đi từng bước để tới câu trả lời.
Thứ đầu tiên có thể tận dụng, theo Spencer (video đăng ngày 06/11/2026), là các VLM nền (base VLM). Chúng ta đã có những VLM tuyệt vời, những world model tuyệt vời được train trên rất nhiều dữ liệu về thế giới mà chúng đã thấy. Chúng đã biết mình đang nhìn thấy gì trong thế giới. Tuy nhiên, khi bắt đầu làm việc với neural simulator, nghĩa là dùng toàn bộ dữ liệu này để train một world model rồi dùng world model đó mô phỏng thực tại, thì bạn bắt đầu thấy nó "hallucinate" những thứ như physics. Nó bịa ra physics vì ta đã train nó trên rất nhiều dữ liệu không được neo vào vật lý (physically grounded), chỉ là dữ liệu quan sát được. Nên đó là physics "học được" (learned physics).
Điều bạn thật sự muốn, theo Spencer (video đăng ngày 06/11/2026), là neo nó bằng physics có độ chính xác cao cho những loại việc quan trọng. Nhiều việc quan trọng là manipulation. Còn nếu bạn đang cố đi xuyên qua thế giới, cái bạn tìm là temporal consistency (nhất quán theo thời gian): làm sao đảm bảo khi đi trong một thế giới mô phỏng, nó vẫn giữ được sự mạch lạc, để khi anh rẽ trái rồi quay lại, thế giới vẫn y như cũ. Mặt khác, khi bắt đầu thao tác lên thế giới, physics trở nên quan trọng.
6. Simulator truyền thống, simulator neural và domain randomization
Spencer đưa ví dụ (video đăng ngày 06/11/2026): hãy tưởng tượng cầm một quả bóng. Anh nói các model bây giờ đã trở nên tuyệt vời, nhưng năm ngoái, chắc mọi người còn nhớ những quả cam: bạn nhặt một quả lên, thả xuống, và nó nhân lên thành bốn quả cam. Nó bịa ra không chỉ physics mà cả tính nhất quán của vật thể (object consistency).
Điều có thể làm bây giờ, theo Spencer (video đăng ngày 06/11/2026), là lấy những world model mà anh và nhóm đang dùng như neural simulator, thứ cho bạn sự đa dạng và phong phú lớn về mọi loại quan sát có thể có. Anh và nhóm đang train chúng để thành đa phương thức: chúng có thể output ra hành động không? Có thể output ra cảm giác chạm không? Làm sao output ra phản hồi xúc giác (tactile feedback), force feedback, âm thanh, tất cả những thứ như vậy?
Ở phía bên kia, theo Spencer (video đăng ngày 06/11/2026), anh cũng có thể dùng simulator truyền thống (conventional simulator) để giữ cái neo vật lý. Với simulation truyền thống, nó không bịa physics. Nhưng dựng một môi trường thì cực kỳ tẻ nhạt, và rất khó tạo sự đa dạng vì nó dựa vào con người làm. Bây giờ, với những tiến bộ gần đây của các model, đặc biệt là những thứ như Astra và một model khác anh kể tên, anh và nhóm bắt đầu thấy nhiều thách thức, nhiều nút thắt trước đây, khi phải có một người dựng từng cảnh, đã trở nên tương đối không đáng kể. Trang tin của NVIDIA (đọc ngày 06/11/2026) nhắc tới ChatGPT Astra trong các workflow tạo dữ liệu cho robot.
Điều đó có nghĩa, theo Spencer (video đăng ngày 06/11/2026), là giờ có thể có rất nhiều dữ liệu mô phỏng truyền thống, rồi tăng cường (augment) nó bằng neural simulation. Bạn có thể làm vài việc. Ví dụ dùng neural simulation cho automatic domain randomization.
Spencer giải thích cách hình dung (video đăng ngày 06/11/2026): khi train một policy, robot có thể đang ở trong thế giới mô phỏng và có một cảm biến thị giác. Cảm biến này nhìn thế giới, nhưng thế giới trông chỉ như một bản mô phỏng trần trụi, vì tất cả những gì bạn quan tâm là physics. Bạn đang cố randomize trên một "envelope" (một dải bao) của physics. Đó thật sự là mục tiêu với robot thao tác đồ vật. Bạn không cố có được đúng y physics của cái bàn này. Bạn cố xấp xỉ trên cả một dải: phân bố điển hình của các thuộc tính vật lý của nó là gì?
Theo Spencer (video đăng ngày 06/11/2026), nhờ vậy, khi robot train trong vài nghìn thế giới, vài nghìn lần lặp, với đủ loại bản sao của cùng một con robot, về cơ bản nó học được mọi kiểu bàn có thể có. Nhưng về mặt hình ảnh thì nó có thể không thật lắm, vì bạn chỉ lo về physics. Nút thắt chính anh và nhóm gặp là render pixel. Nhưng nếu ta lấy bản render đơn giản đó, quan sát đơn giản đó, đưa qua một world model, để nó randomize trên các thứ như chất liệu, ánh sáng, biến dạng, kiểu môi trường thì sao?
7. Hai anh em simulator, từng loại dynamics một, và 10.000 thế giới
Sau đó, theo Spencer (video đăng ngày 06/11/2026), đưa kết quả đó ngược lại vào policy. Policy thật ra học cả hai phía: physics thì dùng physics truyền thống, còn quan sát thì đến từ một neural simulator. Đó là những cách mà anh và nhóm có thể tạo ra các môi trường train lai (hybridized training environment). Và đây mới là khởi đầu; anh và nhóm khá hào hứng về điều này.
Nhưng, theo Spencer (video đăng ngày 06/11/2026), ta cần dùng simulation truyền thống và neural cùng nhau. Một cách hình dung là chúng là anh em ruột. Neural simulator, tức các world model, chỉ tốt bằng dữ liệu bạn đưa cho nó. Nhưng thế giới không có đủ dữ liệu cho nó, vì toàn bộ dữ liệu vật lý mà anh vừa nói. Bạn không có tất cả dữ liệu được neo vào physics đó. Càng giỏi tạo dữ liệu physics trong simulation truyền thống và ghi lại thế giới thật, ta càng xây được những bộ dữ liệu giúp các neural simulator như Cosmos mô phỏng thế giới sát hơn với những gì ta thật sự thấy.
Nhưng nó sẽ đi theo từng loại dynamics một, Spencer nói (video đăng ngày 06/11/2026). Hãy lấy một tập con các dynamics bạn đang cố mô hình hoá. Ví dụ vật biến dạng có hình sợi (linear deformable): dây cáp Ethernet không giống sợi chỉ trên áo bạn. Chúng cũng không giống sợi mì spaghetti, và spaghetti lại không giống những thứ trông như dây khác, như sợi dây thừng. Vậy làm sao mô hình hoá từng loại dynamics này? Mà đó mới là một loại. Còn có dynamics của vải, có những thứ như particle physics. Tất cả những thứ đó đều phải mô hình hoá để tới được toàn bộ thế giới thật.
Theo Spencer (video đăng ngày 06/11/2026), sẽ là một chút simulation truyền thống cộng dữ liệu thế giới thật. Chúng củng cố cho neural simulator; neural simulator học physics từ physics đã được neo; giờ chúng mô phỏng tốt hơn; rồi ta chuyển sang mô hình hoá một tập con dynamics khác. Sẽ đi từng bước một, nhưng anh và nhóm đang tiến bộ rất nhiều, và các agent đang giúp anh và nhóm tiến xa hơn nữa, nhanh hơn nhiều.
Spencer nói (video đăng ngày 06/11/2026) anh không chắc như vậy đã trả lời câu hỏi chưa. Károly đáp: nó còn trả lời thêm 10 câu hỏi khác nữa. Anh rất thích ý này, vì về cơ bản, hãy tưởng tượng một con robot không chỉ học trong thế giới này hay một thế giới mô phỏng, mà trong cả 10.000 thế giới khác nữa. Nếu ta ở trên sao Hỏa thì sao? Nếu ta ở dưới nước thì sao?
8. SONIC: whole-body control trong 42 triệu tham số
Károly nói tiếp: hay nếu bánh hamburger bay khắp nơi thì sao? Như thế thì tuyệt. Theo Károly (video đăng ngày 06/11/2026), mạng neural thích học thuộc lòng nếu bạn để chúng làm vậy, và nếu không có đủ dữ liệu train, nó chỉ muốn học thuộc. Rồi overfitting và đủ thứ chuyện tệ hại xảy ra. Nhưng nếu có loại dữ liệu train như thế này, bạn không thể học thuộc 10.000 thế giới khác nhau; bạn chỉ có thể hiểu, và đó là cách duy nhất để nó hoạt động. Anh nói anh rất thích ý đó.
Rồi Károly nhắc tới một paper tên SONIC. Theo lời Károly (video đăng ngày 06/11/2026), bạn có thể nạp nó vào một con robot và robot đi lại được, làm được việc có ích mà không bị ngã, thậm chí bò và nhảy múa. Nó chạy được với nhiều dạng cơ thể (body morphology) khác nhau. Anh gọi điều đó là điên rồ (insane). Và tất cả trong 42 triệu tham số, "như một hạt cát so với hiện nay", rất nhỏ, và ra quyết định theo thời gian thực. Ngoài ra, theo Károly, nó là open weights và miễn phí cho tất cả mọi người mãi mãi (theo video đăng ngày 06/11/2026). Anh cảm ơn Spencer vì điều đó, rồi hỏi: làm sao các anh nhồi được nhiều trí thông minh như vậy vào một hệ AI nhỏ thế?
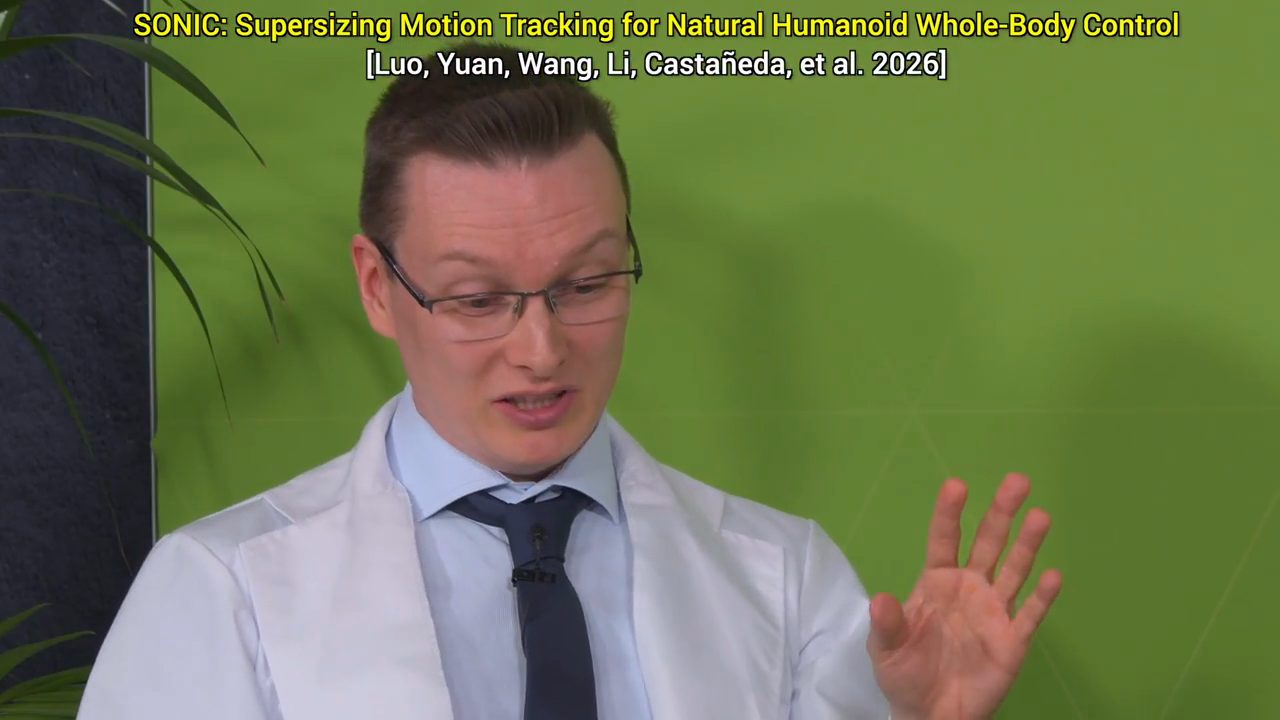
Spencer quay lại phép so sánh về tập con (theo video đăng ngày 06/11/2026). Nếu bạn đang cố mô hình hoá một tập con các thứ, thì cái SONIC thật sự làm là whole-body control (điều khiển toàn thân). Nó không xử lý mọi phần của hệ thống. Vì vậy có thể có những model nhỏ hơn mà vẫn đa dạng và có năng lực lớn.
Theo Spencer (video đăng ngày 06/11/2026), thách thức của SONIC, và anh nói anh và nhóm luôn đang cải thiện nhiều hơn nữa, nhưng phải thừa nhận, là nó cực kỳ "đói" dữ liệu. Bạn cần rất nhiều dữ liệu minh hoạ (demonstration data) để SONIC chạy thật tốt. Nhưng một khi SONIC chạy tốt, bạn có thể dùng nó cùng với GR00T hoặc một VLA khác tùy bạn chọn để làm phần suy luận cấp cao. Như vậy bạn vừa có whole-body control, vừa có khả năng suy luận dài hạn (long-horizon reasoning) qua nhiều tác vụ, nhiều chuyển động và những thứ tương tự.
Theo Spencer (video đăng ngày 06/11/2026), điều quan trọng cần nhớ là SONIC là bước đầu tiên. Về cơ bản nó chứng minh rằng có thể có whole-body tracking: lấy toàn bộ dữ liệu về cách con người di chuyển rồi nén nó xuống thành model này, cho bạn khả năng điều khiển toàn thân.
9. Whole-body control, system zero và phản xạ với suy luận
Với những ai chưa quen với whole-body control, Spencer đưa ra một cách hình dung (video đăng ngày 06/11/2026): khi được bảo nhấc một cái hộp, một cái hộp nặng, chúng ta luôn được dặn hãy dùng lực ở đầu gối, đừng cúi gập ở hông. Nhưng điều bạn sẽ làm là phải cử động cả cơ thể để với tới vật đó. Điều tương tự xảy ra với nhiều tác vụ thao tác đồ vật, và đó là lý do whole-body control quan trọng.
Theo Spencer (video đăng ngày 06/11/2026), khi VLA mới bắt đầu, chúng thật ra tách riêng phần thân dưới và phần thân trên. Về cơ bản nó không thể vừa đi vừa uống cà phê cùng lúc. Lý do điều này không hữu ích lắm là bạn phải di chuyển tới một vị trí đứng yên rồi mới bắt đầu thao tác. Nhưng lúc cần với ngang qua, bạn không cử động được cơ thể, vì đó là một động tác whole-body control.
Và đó chính là điều những model này đang cố giải quyết, Spencer nói (video đăng ngày 06/11/2026). Đây là các model cấp thấp nền tảng. Có thể gọi đây là system zero, còn system one và system two là VLA. Và tất nhiên, khi chuyển sang world action model, cách gọi tên có thể sẽ thay đổi.
Károly nói (video đăng ngày 06/11/2026) anh vừa có lý do thứ 10.000 cho việc vì sao physical AI khó đến thế. Có tiếng xen vào: cái gì cũng hơi khó một chút. Károly nói tiếp: bạn cần system zero, tức cần ra quyết định cực nhanh, kiểu "mình có bước tới không", hay "làm sao để đứng thẳng", vì bạn không thể giao việc đó cho một LLM lớn để rồi nó bảo "được, một tiếng nữa tôi quay lại".
Spencer đồng ý: đúng vậy, bạn cần có phản xạ. Theo anh (video đăng ngày 06/11/2026), có hai cách cơ thể tương tác với một môi trường. Cách thứ nhất là phản ứng với môi trường: có một kích thích nào đó và bạn chỉ việc chuyển động. Nếu ai đó ném một quả bóng vào bạn, bạn chụp lấy rất nhanh mà không thật sự nghĩ về nó. Cách thứ hai là bạn đang suy luận về việc mình định làm. Cái đó giống một sự đáp lại (response) hơn: anh đang nhìn một thứ, một thử thách, một tác vụ dài hạn, và cần đáp lại thử thách này, vậy anh sẽ dùng cơ thể thế nào? Whole-body control cho bạn cả hai: nó cho phép có phản xạ, và cũng cho khả năng dùng cả cơ thể như một phần của suy luận và của chính lời giải cho tác vụ đó.
10. Cập nhật về neural simulation: ba cách dùng Cosmos
Károly nhắc lại (video đăng ngày 06/11/2026): trong một buổi phỏng vấn khoảng một năm trước, Spencer đã nói về việc neural simulator dùng world model sắp xuất hiện. Có gì mới không, anh có thể cập nhật không? Có tiếng nói "Accountability", rồi chữ đó được nhắc lại thêm một lần. Spencer nói anh thích câu hỏi này, và đây là chỗ bắt đầu rất hay, vì anh cực kỳ hào hứng về nó.
Theo Spencer (video đăng ngày 06/11/2026), với neural simulation, anh và nhóm đang bắt đầu dùng Cosmos cho simulation. Như anh đã nói, đó là việc trộn simulation physics được neo, tức một simulator truyền thống như Omniverse: Isaac Sim, Isaac Lab xây trên Omniverse và Newton. Newton là một framework cho phép đưa vào nhiều solver khác nhau và nhiều AI physics, tức neural surrogate (model thay thế) của các dynamics khác nhau mà bạn muốn mô hình hoá. Ở phía bên kia là Cosmos, world model mà anh và nhóm có thể dùng cho simulation.
Theo Spencer (video đăng ngày 06/11/2026), anh và nhóm bắt đầu thấy nó được áp dụng theo vài cách. Cách thứ nhất, như anh nói lúc nãy: dùng nó cho domain randomization, dùng nó để tạo dữ liệu (data generation). Đó là con đường thứ nhất.
Con đường thứ hai, theo Spencer (video đăng ngày 06/11/2026), là dùng chính nó làm simulator. Nếu anh train một policy, anh có thể dùng neural simulator này để đánh giá policy đó. Giới hạn tất nhiên, như anh đã nói: nếu bản thân simulator không mô phỏng đúng được các physics dynamics mà bạn đang muốn kiểm tra, thì dù policy của bạn tốt cỡ nào, bạn cũng không chắc nó sẽ thành công ngoài đời thật. Đó là lý do phải trộn neural simulation và simulation truyền thống. Và khi neural simulator tốt hơn, ta sẽ kiểm tra và đánh giá được ngày càng nhiều policy hơn.
Cách thứ ba, theo Spencer (video đăng ngày 06/11/2026), là chính các world model này đang trở thành policy, và đó là lúc có world action model. Đây là chỗ anh và nhóm có thể dùng Cosmos làm backbone cho các biến thể tiếp theo của GR00T.
Károly nói có điều gì đó rất đáng kinh ngạc ở đây: như Spencer nói, về cơ bản nó có thể chạy bước kiểm chứng trong một simulation, chấm điểm, và có thể train một policy mới. Spencer đáp (video đăng ngày 06/11/2026): bạn có thể hình dung là sẽ cần vài thành phần. Thứ nhất là có một policy, và policy đó hành động bên trong môi trường này. Anh và nhóm có thể dùng Cosmos làm môi trường đó. Vậy là có GR00T đang làm gì đó bên trong một thế giới Cosmos, và bạn quan sát nó, cố phân định xem nó có hoàn thành tác vụ đang được đánh giá hay không.
11. Isaac Lab Arena, phân tích độ nhạy và vì sao simulation dùng để đánh giá
Theo Spencer (video đăng ngày 06/11/2026), bạn có một model suy luận, một VLM khác. Nó cũng có thể là Cosmos, nhưng nó đứng xem những lần chạy này. Việc của nó là đánh giá các chỉ số, hay đưa ra chỉ số định lượng dựa trên những gì nó quan sát được trong simulator đó. Hiện anh và nhóm đang dùng Isaac Lab cho việc này, và về sau sẽ đưa Cosmos vào làm back end nữa.
Spencer gọi cách làm này là sensitivity analysis (phân tích độ nhạy) (video đăng ngày 06/11/2026). Trong Isaac Lab Arena, bạn lấy một policy, đặt nó vào Isaac Lab. Isaac Lab có rất nhiều môi trường. Các môi trường này có các kịch bản (scenario). Trong mỗi kịch bản có các chỉ số hay tiêu chí thành công được định nghĩa sẵn. Khi policy hành động trong simulator, về cơ bản bạn nhận được các chỉ số đó: nó tốt tới đâu, và nó hỏng ở chỗ nào? Theo anh, điều đó cực kỳ quan trọng.
Theo Spencer (video đăng ngày 06/11/2026), dựa trên tác vụ, bạn phân rã nó ra. Chỉ nói "cầm cái chai lên" là chưa đủ. Bạn chia nó thành nhiều bước, để xác định được ở chỗ nào trong tác vụ nó bắt đầu chùn lại, chỗ nào nó làm tốt, chỗ nào không. Rồi trong từng bước con, bạn cố xác định, dựa trên một loạt tiêu chí, đâu là những thứ có thể đang ảnh hưởng: có phải là chuyện va chạm (collision), hay là ánh sáng? Cái gì thật sự đang tác động lên các policy này? Thế là nó thành một phân tích độ nhạy.
Từ đó, theo Spencer (video đăng ngày 06/11/2026), bạn có thể bắt đầu làm failure-based learning (học từ thất bại), cũng chính là cách con người học. Bạn càng thất bại nhiều và phân tích vì sao mình thất bại, bạn càng có thể tự train lại để lần sau nhiều khả năng thành công hơn. Anh và nhóm cũng có thể dùng Cosmos làm back end simulator cho việc này, với bất kỳ policy nào khác đưa vào, rồi đánh giá nó. Dùng neural simulator cho việc này là một lĩnh vực rất mới; anh và nhóm đang làm điều đó với simulator truyền thống ngay hôm nay.
Nhưng hãy thử bước tới trước một chút và hình dung mọi thứ sẽ diễn ra thế nào, Spencer nói (video đăng ngày 06/11/2026). Có simulation lai cho bạn sự đa dạng và phong phú, rồi bạn có cái neo vật lý, vân vân. Rồi bạn có thể bắt đầu đánh giá: policy này có chạy được ngoài đời thật không? Nhưng nó còn cho anh và nhóm thêm một chút nữa. Khi bắt đầu đánh giá policy bên trong các simulator này, rồi deploy chúng và xem chúng thật sự chạy thế nào, bạn có thể bắt đầu đánh giá cả chính simulator nữa.
Đây là lý do, theo Spencer (video đăng ngày 06/11/2026), anh và nhóm thấy simulation được dùng cho đánh giá nhiều hơn là cho phần train cốt lõi, trên rất nhiều loại tác vụ. Có hai lý do. Thứ nhất, simulator truyền thống, như đã nói, cực kỳ khó dựng. Nên bạn chỉ mô phỏng chính xác được một tập con dynamics. Hiện tại chủ yếu là rigid body (vật rắn), và giờ anh và nhóm đang đi vào kết hợp vật rắn với vật mềm. Nhưng khi mọi người mới bắt đầu, họ gấp quần áo ngoài đời thật, vì làm việc đó trong simulation quá khó. Spencer nói việc đó khó cả với chính anh, nhưng các agent đang khá giỏi chuyện này, và giờ đã có những solver rất tốt, thật sự mô phỏng được các dynamics đó.
Vậy là giờ bạn có nó trong simulation, theo Spencer (video đăng ngày 06/11/2026), và câu hỏi trở thành: bạn tin simulator của mình tới đâu? Đó chính là khoảng cách sim-to-real (từ mô phỏng sang thật), và đó là bước tiếp theo. Bạn có thể dùng một neural simulator và một simulator truyền thống làm thế giới để kiểm tra một policy qua nhiều môi trường, qua nhiều loại physics dynamics. Rồi câu hỏi lớn mà tất cả chúng ta phải tự hỏi là: nếu ở trong simulation, làm sao tôi biết nó sẽ chuyển sang được đời thật, hay tôi tự tin tới đâu rằng nó sẽ chuyển được?
12. "Doomed to succeed in simulation" và khoảng cách sim-to-real
Károly nói (video đăng ngày 06/11/2026) điều đó thật đáng kinh ngạc, vì anh đi thăm các phòng lab robotics khắp thế giới và gần như lần nào anh cũng nghe đúng điều đó: trong simulation mọi thứ chạy tuyệt vời, rồi khi chuyển sang thế giới thật thì họ tuyệt vọng, chẳng có gì chạy cả. Và các anh đang tìm cách thu hẹp đúng khoảng cách đó; đó là phần khó, phải không?
Spencer kể anh và nhóm hay nói rằng "bạn bị kết án phải thành công trong simulation" (doomed to succeed in simulation). Theo anh (video đăng ngày 06/11/2026), vì dù thế nào bạn cũng luôn có thể chỉnh một thứ gì đó để nó thành công trong simulation. Và chỉ vì thành công trong simulation, không có gì đảm bảo nó sẽ chuyển zero-shot sang nền tảng bạn nhắm tới.
Đó là khi bạn dùng một simulator tổng quát, Spencer nói (video đăng ngày 06/11/2026). Nhưng khi quan sát mọi người, họ lấy nền tảng của anh và nhóm và chỉnh nó, làm cho nó cực kỳ cụ thể cho loại nền tảng họ sẽ deploy lên. Vì với họ, điều tốt là nếu bạn tự xây cả con robot theo chiều dọc, từ trên xuống dưới, bạn thật sự hiểu mọi kiểu tinh chỉnh khác nhau, ví dụ dải mô-men xoắn (torque envelope) thực tế, cùng đủ loại tham số mà anh và nhóm có thể không lấy được chỉ từ một bảng thông số kỹ thuật. Thế là họ có thể bắt đầu thử: tôi train policy này trong simulator, tôi thấy những điều này; tôi chuyển nó sang robot thật, tôi thấy loại khác biệt này; làm sao tôi chỉnh qua chỉnh lại? Việc tinh chỉnh đó cho bạn khả năng bắt đầu thu hẹp khoảng cách sim-to-real.
Câu hỏi thật sự, theo Spencer (video đăng ngày 06/11/2026), là làm sao làm điều đó theo cách mà bạn đưa vào được một embodiment mới rất nhanh và train một policy trên nhiều embodiment. Anh nói hy vọng của anh là được train một skill trên nhiều embodiment cùng lúc, chứ không phải một embodiment train một loạt skill. Nếu làm được vậy, thì simulator tổng quát kia phải vượt qua khoảng cách sim-to-real khá nhanh. Nên bạn phải xác định được, hoặc ít nhất định lượng được, simulator của tôi chính xác tới đâu, nó đại diện cho thực tại tới mức nào, và cho cái hệ thống thực tế mà tôi sẽ đặt policy lên.
Theo Spencer (video đăng ngày 06/11/2026), đó là một thách thức khó, nhưng là thách thức tiếp theo, vì cuối cùng giờ đã có những physics solver mô phỏng được các loại dynamics cần thiết. Rất nhiều thứ hiện nay sẽ nằm trong kho bãi, môi trường công nghiệp, data center. Đây là những khu vực đã biết, nên có một tập physics đã biết mà bạn cần làm được; rồi từ đó bạn có thể bắt đầu xử lý khoảng cách sim-to-real và thu hẹp dần nó.
Spencer nói thêm, anh nói rõ là Károly không hỏi nhưng anh vẫn sẽ trả lời; có tiếng đáp "thank you". Theo Spencer (video đăng ngày 06/11/2026), khoảng cách sim-to-real thật ra không phải một giai đoạn. Lý do anh và nhóm làm dữ liệu teleop là vì nếu teleop trên đúng con robot mà bạn sẽ deploy, thì dữ liệu ghi được đã ánh xạ động học (kinematically mapped) sẵn với con robot đó. Bạn không phải làm transfer learning, không phải retarget (ánh xạ lại) dữ liệu nào cả.
Cái khó với dữ liệu từ con người, theo Spencer (video đăng ngày 06/11/2026), là bạn phải lấy một embodiment người, embodiment của chúng ta. Dù những con robot này trông có vẻ giống người, các khớp không phải lúc nào cũng nằm cùng chỗ, chúng có thể không có cùng số khớp. Nên về động học là khác nhau, và bạn phải retarget dữ liệu sang embodiment mới này.
Vì vậy, theo Spencer (video đăng ngày 06/11/2026), sim-to-real bắt đầu từ khâu thu thập dữ liệu, đi qua khâu tạo dữ liệu, cách bạn train, cách bạn train và cấu hình model robot khi train policy. Rồi tất nhiên, khi đánh giá, bạn có đang đánh giá phù hợp với thế giới và nền tảng mà bạn sẽ deploy lên không? Và tất nhiên cả cách bạn deploy, cách bạn đánh giá, và nó thành một vòng lặp. Sim-to-real thường được nghĩ là một giai đoạn, nhưng thật ra nó là end to end.
13. Robot cũng bị chấn thương, và những hành vi tự nảy sinh
Károly kể một chuyện anh thấy rất thú vị ở phòng lab Google DeepMind (theo video đăng ngày 06/11/2026): anh nhớ đã thấy những con robot chơi bóng đá, và chúng gặp vấn đề vì bị "chấn thương" theo thời gian. Khớp gối chịu quá nhiều áp lực khi đá bóng, giống như con người. Spencer chen vào: chúng ta đâu còn 16 tuổi nữa. Chúng thậm chí phải được train một cách tường minh để không đứng một chân quá lâu, cùng vài cách để giảm bớt áp lực lên đầu gối. Y như con người. Anh hỏi: đó có phải là thứ có thể đưa vào simulation không?
Spencer nói anh mừng vì Károly nhắc tới điều đó. Theo anh (video đăng ngày 06/11/2026), đó là thứ mà khi có đủ dữ liệu train và đã mô phỏng trên một phạm vi đủ rộng, vì nó là một trong những "envelope" đó: phân bố của việc truyền động (actuation), cử động cổ tay hoàn hảo so với không hoàn hảo, hay một đầu gối bị kẹt cứng hay không. Đây đều là những thứ hoàn toàn có thể mô phỏng được.
Nhưng điều anh và nhóm còn thấy, theo Spencer (video đăng ngày 06/11/2026), là các model này theo thời gian có những hành vi tự nảy sinh (emergent behavior). Anh kể về các đối tác, những công ty có một video rất hay: về cơ bản họ có một con robot chó, rồi khoá cứng một khớp gối của nó. Khi khớp gối bị khoá, nó thật sự thích nghi. Hành vi tự nảy sinh đó học được cách đi bằng ba chân còn hoạt động, và cách tập tễnh với chân còn lại.
Theo Spencer (video đăng ngày 06/11/2026), anh và nhóm cũng bắt đầu thấy điều này ở những hệ thống phức tạp hơn, như các humanoid. Anh kể có lần đi thăm một đối tác, và họ không hiểu được chuyện gì không ổn với một con robot của mình. Có gì đó trông là lạ, và hoá ra khớp cổ chân bị hỏng nhẹ, nhưng bản thân policy đã thích nghi với điều đó. Nó không đi hoàn hảo, nhưng vẫn tập tễnh đi tiếp; nó đã tính tới chuyện đó.
Spencer giải thích (video đăng ngày 06/11/2026): nó học được vì rốt cuộc điều bạn đang cố làm là train những thứ này để đi, để làm một số tác vụ, bất kể chuyện gì đang xảy ra với phần còn lại của hệ thống. Nên nó sẽ cố vượt qua. Có tiếng nhận xét: điều đó cũng hơi giống con người. Lời đáp tiếp theo: lý tưởng là bạn không phải làm vậy, vì nó cũng gây áp lực lên chính hệ thống.
14. Nếu máy tính nhanh thêm một triệu lần: trăm năm trải nghiệm và học ngay tại chỗ
Károly đề nghị cùng mơ một chút. Theo anh (video đăng ngày 06/11/2026), nhờ tối ưu phần mềm và phần cứng, chúng ta đã có mức tăng tốc AI một triệu lần trong 10 năm, điều mà anh gọi là quá điên rồ. Nếu có thêm một triệu lần nữa trong 10 năm tới, Spencer nghĩ chúng ta sẽ làm được gì mà bây giờ chưa làm được? Spencer nói đó là một câu hỏi hay.
Một điều Spencer thích nghĩ tới (video đăng ngày 06/11/2026): khi train bằng reinforcement learning, bạn đã thấy cảnh đó rồi, có một môi trường và một loạt bản sao của con robot, đứa nào cũng làm việc khác nhau. Chúng đều cố làm cùng một tác vụ, nhưng mỗi đứa làm hơi khác và học hơi khác. Bạn có thể nghĩ đó là trải nghiệm, hơi giống trải nghiệm sống.
Với con người, theo Spencer (video đăng ngày 06/11/2026), ta phải đi ở tốc độ 1x: mỗi khoảnh khắc là một trải nghiệm, nhưng ta chỉ bước qua từng khoảnh khắc, từng giây một. Với những con robot này, nếu train được policy nhanh hơn thời gian thực, điều mà anh nói anh và nhóm đang đạt được bây giờ, thì điều có thể làm trong tương lai với mức tăng tốc lớn hơn nữa là train policy làm những hành vi cực kỳ phức tạp trong vài giây. Và với nó, có thể nó đã sống được 100 năm.
Vì vậy, theo Spencer (video đăng ngày 06/11/2026), trải nghiệm mà ta cho nó thật sự được khuếch đại khi có thêm compute, thêm hiệu suất compute, và khả năng tận dụng các hệ thống này. Điều thứ hai nó có lẽ sẽ mở ra: khi bạn có mức tăng tốc một triệu lần trên một hệ thống lớn, điều đó cũng là một cách nói rằng bạn có mức tăng tốc một triệu lần trên một hệ thống nhỏ. Và những hệ thống nhỏ đó sẽ cho phép thích nghi ở edge (ngay trên thiết bị) rất nhanh.
Theo Spencer (video đăng ngày 06/11/2026), một điều con người giỏi kinh khủng là: nếu anh dạy bạn một tập kỹ năng rồi bạn đi vào một môi trường mới, chưa từng thấy, và tác vụ anh giao cũng không phải thứ bạn quen. Anh đưa ví dụ: anh gửi bạn tới Alaska và bảo, bạn phải lên một chiếc thuyền đánh cá và học cách xẻ cá như các ngư dân. Bạn mới chỉ làm việc đó ở nhà, và bạn kiểu "được rồi, tôi mới chỉ làm ở nhà". Bạn sẽ phải học ngay tại edge, phải học ngay ngoài đó. Không có chuyện đi học, không có internet.
Đó là những thứ Spencer nói anh rất hào hứng (video đăng ngày 06/11/2026): nếu bạn có thể train ngay trên robot thay vì phải gửi lên cloud thì sao? Hiện nay, khi muốn train batch quy mô lớn, bạn gửi lên cloud. Càng đi xa, robot không chỉ có khả năng làm mọi tác vụ cơ bản, mà sẽ bắt đầu làm những tác vụ phức tạp vượt người. Và chúng có thể học những tác vụ đó ngay tại chỗ (in situ), và như vậy có thể chạy các simulation này ở edge. Có tiếng nói "continual learning", và tiếng kia đáp "continuous learning".
Spencer nói tiếp (video đăng ngày 06/11/2026): chúng ta phải suy luận trong tình huống. Anh không giỏi khối Rubik, nhưng đã thấy những người cực kỳ giỏi. Károly chen vào: một sản phẩm đáng tự hào của Hungary, nói vậy thôi. Có tiếng nói tiếp: thứ đó thật sự đã thay đổi thế giới.
Theo Spencer (video đăng ngày 06/11/2026), có những model thật sự giải được khối Rubik khá nhanh, trong vài giây, kể cả khi có agent chỉ việc truyền dữ liệu qua lại, và điều đó thật sự rất thú vị. Nhưng khả năng nghĩ về vấn đề rồi hình dung vấn đề thật ra là chúng ta đang đặt simulation vào trong đầu mình. Chúng ta liên tục mô phỏng. Nếu bạn là vận động viên, bạn thấy họ tập trung, cố tưởng tượng và chiếu trong đầu: mình sẽ làm gì, sẽ di chuyển cơ thể thế nào, sẽ làm việc này ra sao. Bạn ở Olympic, và trước khi thi đấu họ nghĩ về điều mình sắp làm. Đó chính là simulation trong đầu bạn. Vậy làm sao trao khả năng mô phỏng đó cho robot, ngay ở edge? Spencer nói đó là điều anh cực kỳ hào hứng.
Károly tóm lại (video đăng ngày 06/11/2026): một triệu lần, và bạn có thể làm được điều đó. Anh nói anh rất thích ý này.
15. Robot phát bỏng ngô, cầu thang và chân trời mười năm co lại
Károly kể (video đăng ngày 06/11/2026): khi ở trụ sở NVIDIA, anh nghe nói có một con robot đi quanh phát bỏng ngô cho mọi người. Anh chưa thấy nó, nhưng chuyện đó có thật không?
Spencer xác nhận (video đăng ngày 06/11/2026): anh và nhóm có chúng ở GEAR lab, và phải nói là chúng rất mê bỏng ngô; con robot đó chạy suốt. Theo anh, điều đang thấy là cuối cùng robot đã tới giai đoạn mà policy và phần cứng có thể được deploy vào các môi trường để làm những việc có ích. Và anh nghĩ việc phát bỏng ngô thật ra khá hữu ích, vì "một kỹ sư đói là một kỹ sư cáu".
Có tiếng đáp "I know". Spencer kể (video đăng ngày 06/11/2026) anh luôn được hứa rằng sẽ có một con robot mang bỏng ngô tới tận chỗ ngồi cho mình, nên anh khá hào hứng vì giờ đã có robot hai chân (biped) leo được cầu thang, vì hồi anh và nhóm có một con AMR thì... Anh nói đó là điều anh mong từ lâu, vì khi mới vào làm anh không ngồi ở tầng một. Một con robot có bánh xe sẽ gặp khó khi lên cầu thang, và anh sẽ phải tự bê nó lên cùng với bỏng ngô. Giờ thì có thể cho nó đi quanh được rồi; anh và nhóm chưa có nó, nhưng chỉ còn "một cú click nữa thôi".
Theo Spencer (video đăng ngày 06/11/2026), điều tuyệt vời của thời đại chúng ta là: vài năm trước, bạn từng nghĩ "được rồi, sẽ mất 10 năm để giải mấy bài toán này". Còn với những tiến bộ của AI và tốc độ tiến bộ trong quý vừa qua, hãy nghĩ thế này: hồi tháng 1 năm nay chúng ta chưa có agent, giờ thì nó ở khắp nơi, mà còn chưa hết năm. Chúng ta đã lấy một chân trời 10 năm và nén nó lại còn ba tới năm năm.
Và nút thắt thật sự, theo Spencer (video đăng ngày 06/11/2026), trở thành: liệu ta có những hệ thống phần cứng đủ khả năng thực thi các policy này không? Có độ khéo léo toàn thân (full body dexterity) để làm mọi loại việc mà ta có thể train cho nó không? Và thứ hai, ta có đủ compute để thật sự train policy làm được những tác vụ phức tạp mình muốn không? Anh nói: nó ở ngay đó rồi, chúng ta đã rất gần.
16. Dễ với người, khó với máy: lắp ráp siêu nhỏ và phần cứng chính xác
Károly hỏi (video đăng ngày 06/11/2026): còn những vấn đề nào dễ với con người nhưng khó với máy, và các anh giải quyết chúng thế nào?
Spencer nói (video đăng ngày 06/11/2026) đây là chỗ "rất gần nhưng cũng còn khá xa". Anh quên tên, nhưng có một nghịch lý rằng những thứ dễ với con người lại khó với máy. Những thứ như thao tác trong lòng bàn tay (in-hand manipulation) có thể khá khó. Những việc như lắp Lego, bạn sẽ bắt đầu thấy đó là các tác vụ ta đang bắt đầu thật sự làm được. Nhưng hãy tưởng tượng những cách rất hay mà con người đã học để dùng cơ thể mình làm micro assembly (lắp ráp siêu nhỏ).
Theo Spencer (video đăng ngày 06/11/2026), đó là những tác vụ rất khó, nhưng thật ra mô tả thì đơn giản: tôi cần bạn cầm cái tua vít này đặt vào đây, rồi bạn đi tới những vị trí nhất định, nhưng độ khéo léo cần có lại quá phức tạp với một con robot. Đó là điều cần bắt đầu giải, và nó đòi hỏi vài thứ.
Thứ nhất, theo Spencer (video đăng ngày 06/11/2026), bạn phải có dữ liệu thật, hoặc dữ liệu mô phỏng, hoặc một simulator thật sự mô phỏng được hành vi phức tạp này. Thứ hai, bạn phải train được một policy làm được tất cả các prior: nó có dùng được dụng cụ không? Có làm được việc với độ chính xác dưới một milimét không? Có làm được tất cả những việc này không? Bạn xây dần lên, hơi giống như nhìn một đứa trẻ lớn lên, và phải làm điều đó trong một khoảng thời gian khá dồn nén. Và điều cuối cùng: bạn có phần cứng đạt độ chính xác đó không?
Spencer nghĩ điều cuối này hơi bị xem nhẹ (video đăng ngày 06/11/2026). Chúng ta đã có tự động hoá, tự động hoá chính xác cao, từ nhiều thập kỷ. Nhìn robot ngày nay, chúng làm được thao tác thô (gross manipulation) và đang bắt đầu rất giỏi thao tác tinh (fine-grained manipulation). Tuy nhiên, khi nghĩ tới độ chính xác cực cao, ví dụ 0,003 milimét, con người không làm được. Nên dữ liệu minh hoạ của chúng ta sẽ không tốt cho việc đó. Nhưng anh và nhóm sẽ train một policy, và bạn cũng cần phần cứng thật sự làm được điều đó.
Theo Spencer (video đăng ngày 06/11/2026), phần cứng đang bắt đầu xuất hiện. Điều anh và nhóm đang thấy là giờ đã có các lựa chọn, có rất nhiều, có một hệ sinh thái tuyệt vời gồm các nhà chế tạo phần cứng và OEM đang thật sự xây những hệ thống giúp giờ có thể thật sự tiến bước tiếp theo này. Anh nghĩ đó là những thứ khó, dễ với chúng ta nhưng khó hơn với robot. Ngược lại, nếu bạn bảo nó làm toán, hay tạo ra hàng triệu mẫu dữ liệu, thì với chúng ta gần như bất khả thi, nhưng các hệ thống này làm được trong một phút.
17. AI "đủ tốt" hay luôn muốn bản tốt nhất?
Károly muốn hỏi ý kiến Spencer (video đăng ngày 06/11/2026). Trước hết hãy nghĩ thuần về LLM, chưa nói tới physical AI: liệu tới một lúc nào đó AI sẽ trở nên "đủ tốt" (good enough), hay chúng ta luôn muốn bản tốt nhất? Anh nói câu hỏi này khó hơn vẻ ngoài, vì ấn tượng của anh là có, tới một lúc nó sẽ đủ tốt. Anh nói đây không phải cách đo đẹp, nhưng cứ giả sử mỗi LLM có một chỉ số IQ. Trí thông minh là một đại lượng vector, có khi còn phức tạp hơn, nhưng cho đơn giản thì cứ vậy. Tới một lúc, bạn sẽ có trong tay một LLM trả lời tức thì, với IQ, anh lấy ví dụ, 170. Và có một bản mới IQ 220. Tới một lúc bạn sẽ nói: ai quan tâm chứ, cái nào cũng được.
Vì thế với Károly (video đăng ngày 06/11/2026), nghĩ rằng sẽ có lúc AI đủ tốt là chuyện dễ. Nhưng đồng thời, anh để ý mỗi lần hỏi gì đó, anh lại nghĩ: dùng AI nào đây, AI có thinking hay AI trả lời tức thì (instant)? Và anh cảm thấy mình tìm tới AI có thinking nhiều hơn anh tưởng. Nếu có một hợp đồng cần xem lại, anh hiểu là bản instant cũng tốt, nhưng với việc này anh hơi muốn bản tốt nhất. Câu hỏi về sức khoẻ, về thuốc men hay gì đó: anh nói LLM có lẽ chỉ nên là một điểm dữ liệu, không phải bác sĩ, vân vân. Nhưng dù vậy, nếu anh đang hỏi một điều gì đó, anh biết bản kia cũng thông minh, nhưng có lẽ anh vẫn muốn bản tốt nhất. Vậy Spencer nghĩ sao, anh dùng nó thế nào?
Spencer nói câu trả lời của anh áp dụng cho cả LLM lẫn model physical AI, và anh chia làm hai nhóm: model tổng quát (generalized) và model chuyên biệt (specialized). Theo anh (video đăng ngày 06/11/2026), nếu bạn ở trong ngành y hay trong ngành của anh, có một model chuyên biệt đưa bạn tới 170 hay 200 IQ, bất kể ta coi đó là gì, là một nền tảng tuyệt vời, đưa bạn qua vạch đích với 80 tới 90% các vấn đề. Anh nghĩ loại "đủ tốt" đó mới là thứ mọi người sẽ dùng hằng ngày.
Nhưng, theo Spencer (video đăng ngày 06/11/2026), chúng ta sẽ luôn đẩy biên giới (frontier) của những loại việc mình muốn giải. Một điều con người giỏi là chúng ta rất giỏi tự nghĩ ra việc để làm. Chúng ta đã phát minh ra nhiều cách tự động hoá, và chưa lúc nào chúng ta trở nên lười hơn. Chúng ta chỉ tìm thêm cách để đẩy giới hạn của tự động hoá, của những thứ ta làm ra, ta tạo ra. Những thách thức ta muốn giải sẽ không bao giờ hết. Chúng ta đang ở trên Trái Đất, nhưng tới một lúc bạn sẽ muốn băng qua các vì sao và khám phá xa hơn.
Vì thế, theo Spencer (video đăng ngày 06/11/2026), trí thông minh nền (baseline intelligence) sẽ rất tốt để nâng mọi người lên, để làm được, giả sử, phần phổ biến chung của các vấn đề bạn sẽ gặp, và anh nghĩ điều đó là hoàn hảo. Nó giống như đi học thạc sĩ là điều tuyệt vời với hầu hết mọi người. Còn học tiến sĩ không hẳn dành cho tất cả, mà dành cho một nhóm rất cụ thể.
Károly chen vào (video đăng ngày 06/11/2026): "đặc biệt với khán giả của chúng ta, the fellow scholars". Spencer nhắc lại "the fellow scholars" và nói anh luôn muốn được nói câu đó.
Theo Spencer (video đăng ngày 06/11/2026), với model tổng quát, một khi chạm tới mức nền đó, anh nghĩ "đủ tốt" sẽ là thứ nằm trong túi bạn. Còn trí thông minh ở frontier là thứ sẽ luôn đẩy chúng ta tiến lên. Nên chúng ta sẽ luôn cần cả hai. Nhưng hiện tại, với physical intelligence (trí thông minh vật lý), chúng ta vẫn đang cố chạm tới mức nền. Và chúng ta đang thật sự bắt đầu tới điểm mà các model frontier trở nên quá xuất sắc trong một phân bố tác vụ nhất định, tới mức hầu hết mọi người sẽ ổn với những gì chúng làm được. Frontier của hôm nay có thể là thứ bình thường của ngày mai, nhưng cũng sẽ có rất nhiều người cần tới frontier để đẩy mọi thứ khác tiến lên.
18. Tập Two Minute Papers yêu thích và câu hỏi khó cuối cùng
Károly nói (video đăng ngày 06/11/2026) còn hai câu hỏi khó nhất. Câu thứ nhất: một tập Two Minute Papers mà Spencer yêu thích?
Spencer nói lẽ ra anh nên chuẩn bị trước, lẽ ra anh nên nhớ tên các paper. Nhìn chung, anh rất thích những lúc Károly đi qua mô phỏng chất lỏng và particle physics. Một, chúng đơn giản là đẹp mắt. Hai, đó không phải chuyên môn của anh, nên cách duy nhất anh hiểu nó là khi xem lúc ăn trưa. Anh nói những tập đó thật tuyệt. Và luôn tuyệt khi thấy paper của đồng nghiệp mình xuất hiện trên kênh, đặc biệt khi anh và nhóm làm motion generation: theo Spencer, Károly đã có những tập nói rất hay về các motion generator của anh và nhóm, về những gì có thể làm khi lấy chuyển động của con người áp vào các avatar trong simulation. Anh nói trong tương lai, mọi người sẽ thấy điều đó chuyển ngay sang physical AI như thế nào (theo video đăng ngày 06/11/2026).
Có tiếng nói "you got me there" (video đăng ngày 06/11/2026). Károly đáp: không, câu trả lời đó rất hay, anh rất hài lòng.
Câu hỏi cuối cùng, Károly nói, là câu khó nhất: làm sao để Spencer trả lời email của anh? Spencer kể anh thấy dùng ký hiệu @ khá hiệu quả. Anh đang học cách để agent của mình giúp anh "gỡ" bớt, vì nói thế nào nhỉ, anh đang nằm trong rất nhiều hệ thống tự động. Anh gợi ý: hãy bảo agent của bạn rằng Two Minute Papers là ưu tiên số một. Nhưng thật lòng, anh nghĩ cách dễ nhất là gọi điện cho anh (theo video đăng ngày 06/11/2026).
Károly nói (video đăng ngày 06/11/2026) anh đã học được rất nhiều. Khi về nhà và dựng lại video này, anh sẽ xem nó thêm năm, sáu lần nữa và học được thêm nữa. Anh nói cuộc trò chuyện thật tuyệt và cảm ơn Spencer rất nhiều. Có tiếng nói tiếp: xong rồi, cảm ơn, rất vui, thời gian trôi qua nhanh như chớp, và câu hỏi cuối thật hóc búa.
Nguồn và liên kết 10 nguồn
- Tên gốc: The Future of AI Is Absolutely Incredible (Spencer Huang)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=XgC1QTs6A2U youtube.com
- Kênh YouTube Two Minute Papers (Károly Zsolnai-Fehér): trang kênh youtube.com
- NVIDIA Newsroom, "NVIDIA Advances Isaac Platform for General-Purpose Robotics With New Reference Humanoid, Frameworks, Simulation Pipelines and Data" (đăng 21/10/2026, đọc ngày 06/11/2026; nói về Agile ONE SN, Isaac Lab 3.0, Newton, DGX Station và ChatGPT Astra): nvidianews.nvidia.com nvidianews.nvidia.com
- Isaac Lab (trang của NVIDIA, đọc ngày 06/11/2026; có mục Arena cho đánh giá policy trong simulation): developer.nvidia.com/isaac/lab developer.nvidia.com
- Newton Physics Engine (trang của NVIDIA, đọc ngày 06/11/2026): developer.nvidia.com/newton-physics developer.nvidia.com
- NVIDIA Cosmos (trang của NVIDIA, đọc ngày 06/11/2026): nvidia.com/en-us/ai/cosmos nvidia.com
- Isaac GR00T (trang của NVIDIA, đọc ngày 06/11/2026): nvidia.com/en-us/industries/robotics/isaac-groot nvidia.com
- SONIC: Supersizing Motion Tracking for Natural Humanoid Whole-Body Control (trang dự án, đọc ngày 06/11/2026): nvlabs.github.io/GEAR-SONIC nvlabs.github.io
Related talks
Đừng build agent, hãy build skill
Barry Zhang & Mahesh Murag · Anthropic · 16 min
Vì sao một agent đa năng chạy bằng code cộng với skill (folder hướng dẫn, script, asset, nạp dần khi cần) thay được việc build agent riêng cho từng lĩnh vực.
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Không cần để laptop mở nữa: Codex giờ chạy trên cloud, trong Slack và cả trên điện thoại
Dominik Kundel · OpenAI · 22 min
OpenAI đưa Codex lên cloud, vào Slack, Teams, trình duyệt và terminal, để giao việc cho agent ở đâu cũng được mà không phải tự lo máy móc.