Cách mới để dựng second brain với Claude
Dựng personal knowledge base cho Claude: connector đóng dấu ngày, recency weighting, cheap model viết summary và atoms, tìm bằng BM25.
✓ Đã duyệt độc lập · cập nhật 22/10/2026 · 12 min
1. Từ "As We May Think" tới làn sóng AI slop
Nick Saraev mở đầu bằng một câu chuyện lịch sử. Năm 1945, một kỹ sư tên Vannevar Bush hình dung ra một cỗ máy có thể lưu trữ toàn bộ sách, hồ sơ và thư từ của ông. Bush gọi nó là "một phần bổ sung mở rộng và thân thuộc cho trí nhớ của mình" (an enlarged intimate supplement to his memory).
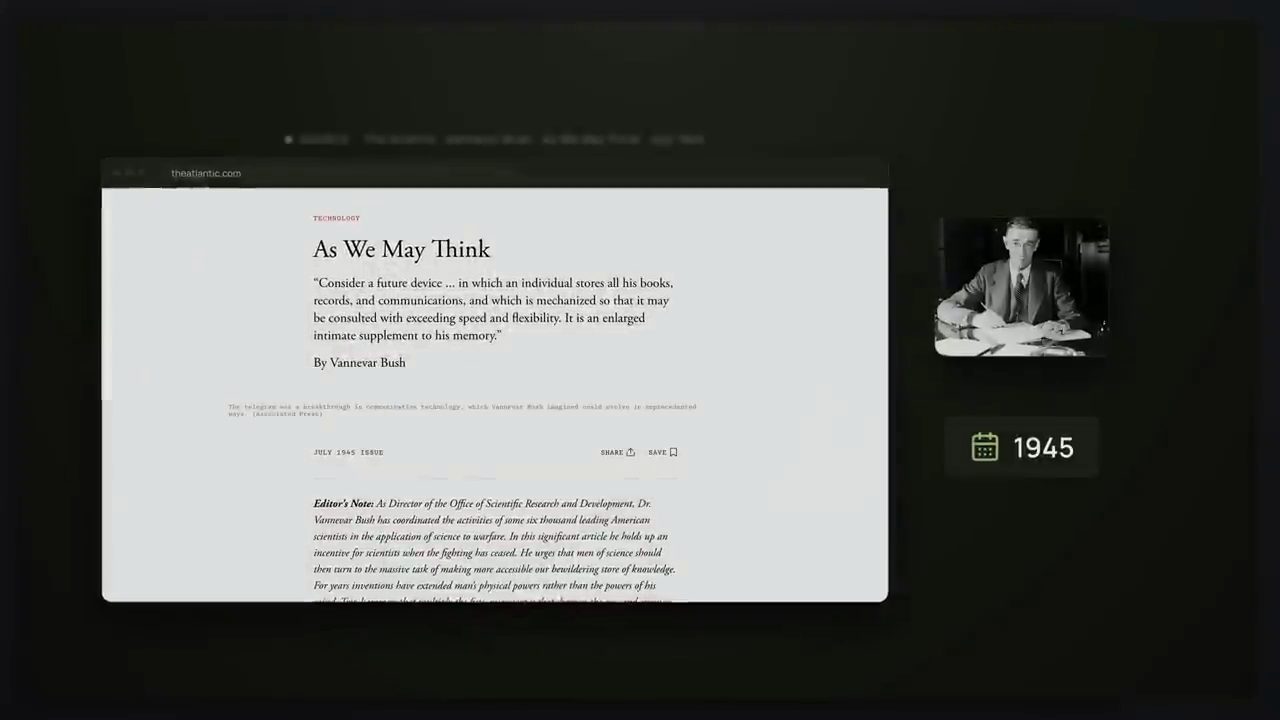
Theo Nick (video đăng ngày 18/10/2026), mong ước của Bush rồi cũng thành hiện thực. Nhưng thứ chúng ta có trong tay thì lại là một trận lở tuyết AI slop: những video hào nhoáng với cả đống bộ não 3D bay lơ lửng, và những thứ mà anh nói thẳng là không biết phải gọi là gì.
Vậy tại sao "second brain" lại gắn liền với rác như vậy? Nick đưa ra vài lý do (theo video đăng ngày 18/10/2026). Thứ nhất, đây là thứ marketing rất dễ. Thứ hai, nó trông đủ phức tạp để người ta nghĩ chắc phải có một kỹ sư nhúng tay vào mới làm ra được. Thứ ba, nó rất dễ bán cho những người không hiểu thứ này hoạt động ra sao, dưới dạng một cách để tăng năng suất cho business của họ, bán được nhiều sản phẩm hơn, vân vân.
2. Personal knowledge base vẫn có thể tốt
Dù vậy, quan điểm của Nick (video đăng ngày 18/10/2026) là personal knowledge base vẫn có thể là thứ tốt. Anh kể mình đang dùng một cái như vậy cho một business mà theo lời anh là kiếm được "một khoản kha khá mỗi tháng".
Mục tiêu của video, theo anh, là đi qua một cách thực tế để bạn tự dựng một hệ thống như vậy cho riêng mình. Và Nick nói phần hay nhất là việc này (theo ước lượng của anh trong video đăng ngày 18/10/2026) chỉ mất chừng ba hay bốn phút.
3. Personal knowledge base là gì: retrieval và RAG
Vậy rốt cuộc personal knowledge base là gì? Nick định nghĩa rất gọn: nó chỉ là một đống đồ của chính bạn mà máy tìm kiếm được (a searchable pile of your own stuff), cộng với việc AI tra cứu đống đó trước khi trả lời bạn.
Các kỹ sư trước đây gọi quá trình tra cứu này là retrieval. Và khi bạn dùng nó để bổ sung cho phần sinh câu trả lời của AI, thì đương nhiên nó được gọi là retrieval augmented generation, tức RAG, thứ mà theo Nick nhiều khả năng bạn đã nghe qua.
Theo Nick (video đăng ngày 18/10/2026), ngày trước RAG cực kỳ hữu ích và được dùng cực kỳ phổ biến, vì các AI model khi đó có context window khá ngắn, nghĩa là bạn không nhét được nhiều thứ vào đó. Nếu muốn một AI trả lời được đủ loại câu hỏi mà không hallucinate, bạn gần như buộc phải dùng cách này.
4. Context window lớn hơn, nhưng mọi thứ đều nặng như nhau
Theo Nick (video đăng ngày 18/10/2026), ngày nay context window đã lớn hơn rất nhiều, chứa được khoảng 35 đến 50 cuốn sách với hầu hết các model consumer. Nghĩa là bạn có thể đổ thẳng mọi thứ bạn muốn model nói chuyện với bạn vào context window, và nó sẽ chạy ổn.
Có điều, nếu bạn thật sự nhét nội dung cỡ 35 cuốn sách vào, theo Nick (video đăng ngày 18/10/2026) nhiều khả năng sẽ tốn của bạn rất nhiều tiền, nên anh không khuyến khích làm vậy.
Theo Nick (video đăng ngày 18/10/2026), lý do tinh tế hơn khiến một personal knowledge base vẫn có ý nghĩa, và khiến các cơ chế Nick sắp trình bày cải thiện khả năng trả lời câu hỏi, nhất là với dữ liệu riêng hoặc dữ liệu độc quyền của bạn, nằm ở đây: khi bạn có một chồng context khổng lồ trong context window, model coi mọi thứ là quan trọng ngang nhau.
Nick lấy ví dụ. Giả sử knowledge base của bạn có thông tin từ rất lâu rồi, chẳng hạn vài năm trước bạn đặt một mức giá cho sản phẩm. Giờ bạn nhờ knowledge base giúp soạn một proposal hay thứ gì đó tương tự. Model sẽ đối xử với mức giá cũ đó y như với mức giá mới. Theo Nick (video đăng ngày 18/10/2026), mọi thứ vận hành đơn giản là như vậy.
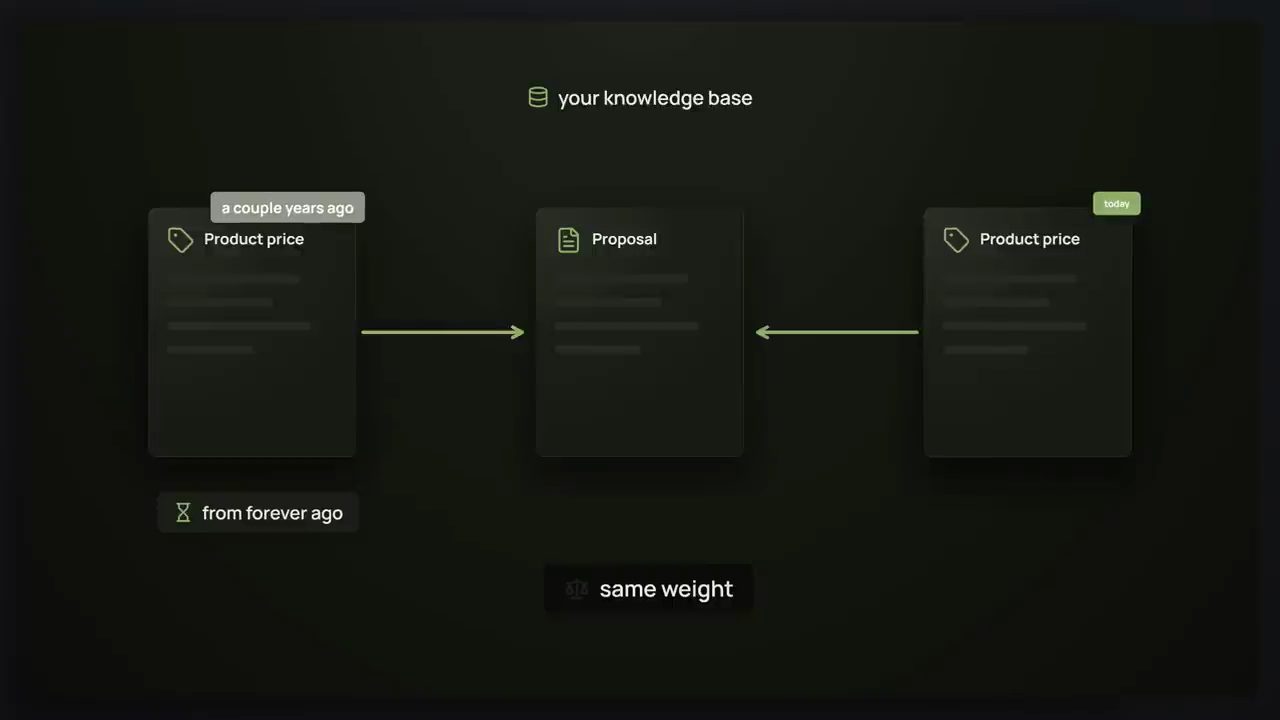
Theo Nick (video đăng ngày 18/10/2026), model sẽ trả lời rất tự tin, vì với nó, mọi thứ chỉ là "một mẩu text ở đây, một mẩu text ở kia, tôi không biết cái nào đúng, nên tôi sẽ trả về thứ đầu tiên và dễ nhất mà tôi tìm được".
5. Recency weighting: đóng dấu ngày và ưu tiên cái mới
Một lời giải đơn giản cho vấn đề trên, mà Nick sẽ hướng dẫn, gọi là recency weighting. Cách làm như sau: mỗi mẩu thông tin mới đi vào hệ thống đều được đóng dấu một ngày tháng. Sau đó, bạn cộng thêm một chút trọng số (a little boost) cho những thứ mang ngày mới hơn, và giảm bớt một chút sức nặng của những thứ mang ngày từ lâu.
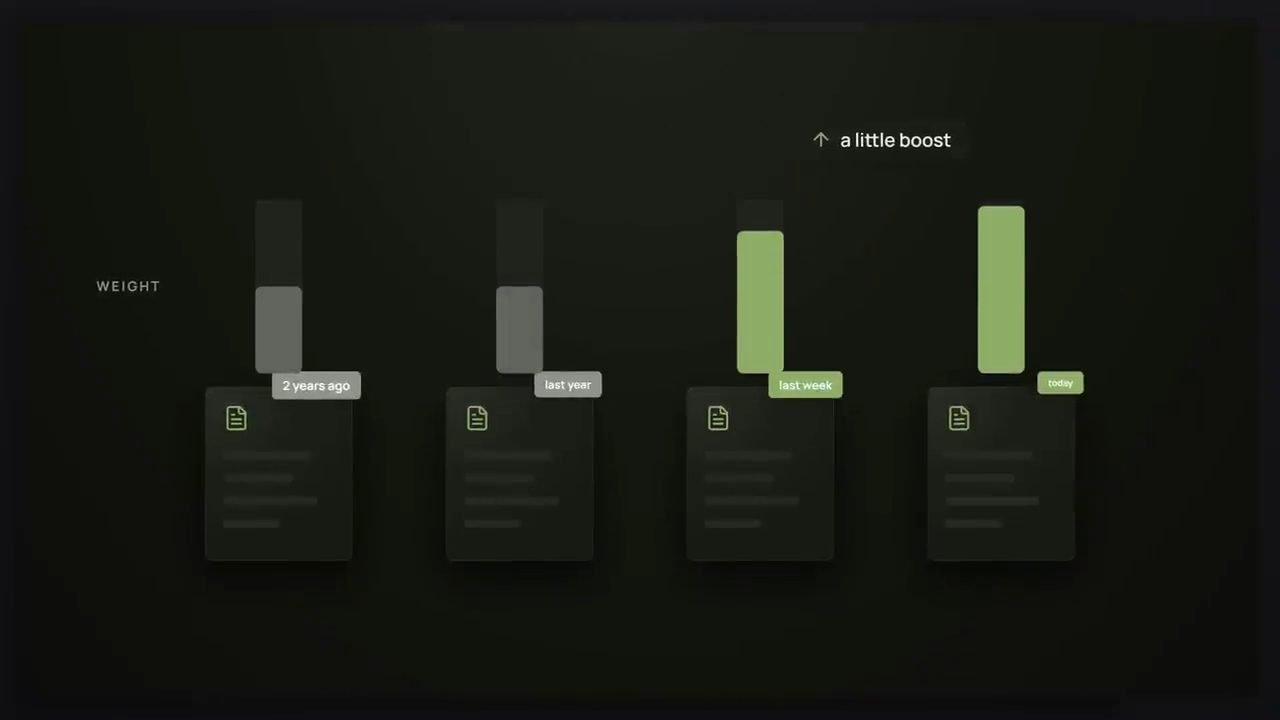
Theo Nick (video đăng ngày 18/10/2026), nhờ vậy các AI model sẽ hiểu được rằng: "Ok, có lẽ mình nên tìm những thứ mới hơn thay vì những thứ cũ hơn".
6. Context rot, và lời giải là retrieval
Nhưng vẫn còn một vấn đề. Bạn nhét càng nhiều text vào, AI càng khó lấy ra đúng một mẩu thông tin cụ thể. Nick (video đăng ngày 18/10/2026) gọi đây là một vấn đề rất nổi tiếng của large language model, tên là context rot: hiệu năng có xu hướng giảm khi context trong window càng nhiều.
Nên dù về lý thuyết bạn có thể thêm nội dung cỡ 35 cuốn sách, hay có khi hơn một triệu token, thì trên thực tế Nick (video đăng ngày 18/10/2026) thấy có ba vấn đề. Một, chạy như vậy sẽ tốn quá nhiều tiền. Hai, nó nhiều khả năng sẽ tốn quá nhiều thời gian, vì giờ AI phải lặp qua lượng nội dung cỡ 35 cuốn sách. Và ba, kết quả ít chính xác hơn so với cách anh sắp chỉ.
Theo Nick (video đăng ngày 18/10/2026), lời giải cho chuyện đó gọi là retrieval. Thay vì gửi toàn bộ dữ liệu, bạn để dữ liệu ở một chỗ khác, và cho AI model tìm thứ nó cần trước. Nó có thể tìm khá hiệu quả, bằng plain text hoặc bằng vector embeddings, thứ mà theo Nick lúc này chưa quan trọng lắm.
Nick nói thêm rằng đây mới chỉ là phần nổi. Theo anh (video đăng ngày 18/10/2026), các giải pháp state-of-the-art thường gộp tất cả những thứ trên vào một rồi làm cho chúng tốt hơn rất nhiều.
7. Engram: knowledge base của Nick chạy thế nào
Hệ thống của Nick tên là Engram. Theo con số anh đưa ra trong video đăng ngày 18/10/2026, knowledge base này giữ khoảng 35.000 đến 50.000 bản ghi (record) cùng lúc. Trong đó có toàn bộ Git history của anh, toàn bộ Claude sessions của cả công ty, và cả lời thoại các video của anh. Nick nói anh làm rất nhiều video, nên bạn có thể hình dung đó là một lượng token rất lớn.
Khi thông tin đi vào, nhóm của anh áp recency weighting để tránh chuyện, mỗi khi hỏi AI, nó lại kéo ra thông tin có thể đã không còn hữu ích. Theo lời Nick (video đăng ngày 18/10/2026), họ cũng định kỳ quét qua toàn bộ để xoá những thứ không còn giá trị với họ nữa.
Rồi khi Nick hỏi Claude một câu, bất kỳ câu gì về bất kỳ chủ đề gì (và bạn có thể thay Claude bằng large language model mà bạn đang dùng), Claude sẽ chạy một lượt inference cực nhanh để chọn ra đúng một search term, rồi tra cứu knowledge base. Theo số đo của Nick (video đăng ngày 18/10/2026), bước tìm kiếm thường mất dưới nửa giây. Sau đó nó trả về một nhúm kết quả khớp nhất, gắn chúng vào prompt của câu hỏi anh vừa hỏi, rồi dùng thông tin đó để trả lời.
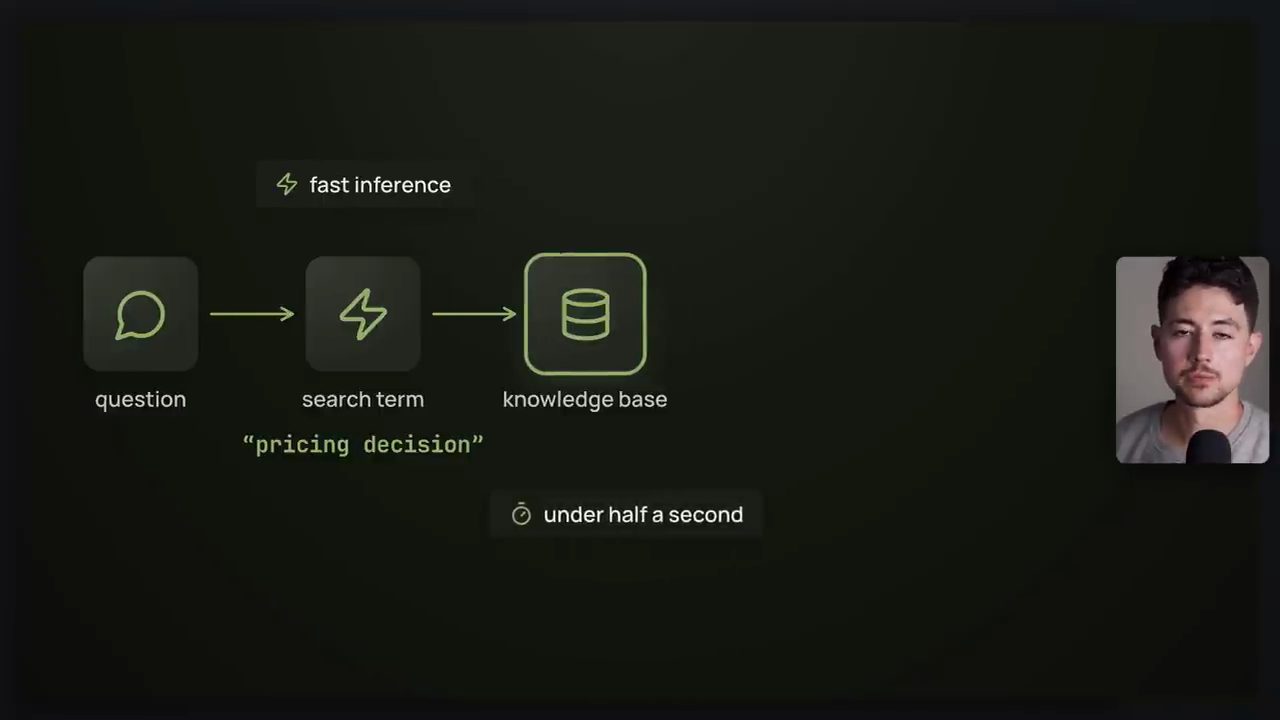
Nghe thì khá đơn giản, nhưng Nick (video đăng ngày 18/10/2026) nói bạn sẽ không tin được nó làm trải nghiệm của anh liền mạch tới mức nào. Anh không bao giờ phải lo chuyện lưu thông tin ở đâu. Không bao giờ phải lo memory của Claude bị hỏng. Không bao giờ phải lo nó lấy nhầm thông tin, vì theo anh, gần như lúc nào nó cũng lấy đúng thông tin đã được recency weighting mà anh thật sự muốn, chứ không phải một mẩu ngẫu nhiên từ một cuộc trò chuyện bốn tuần trước.
8. Bước 1: consistent context in, định nghĩa nguồn và viết connector
Vậy làm sao để dựng một hệ thống như thế? Bước đầu tiên là duy trì các context pipeline ổn định đổ vào knowledge base.
Theo ý kiến của Nick (video đăng ngày 18/10/2026), đây là bước quan trọng nhất, vì hiển nhiên một knowledge base chỉ tốt bằng dữ liệu của nó. Bạn cần context đi vào đều đặn qua các pipeline được làm mới gần như mỗi khi có một sự kiện tạo ra dữ liệu trong công ty.
Việc đầu tiên là định nghĩa tất cả các nguồn (sources). Ví dụ: email của bạn, website của bạn, toàn bộ lead mà bạn từng trò chuyện. Tất cả tin nhắn Slack trong công ty. Tất cả bản ghi lời các cuộc gọi từ điện thoại công ty, nhất là khi chúng là VoIP.
Sau đó, bạn viết một script nhỏ gọi là connector. Connector chỉ kéo về dữ liệu mới kể từ lần chạy trước, rồi đóng dấu ngày giờ của lần chạy đó lên dữ liệu.
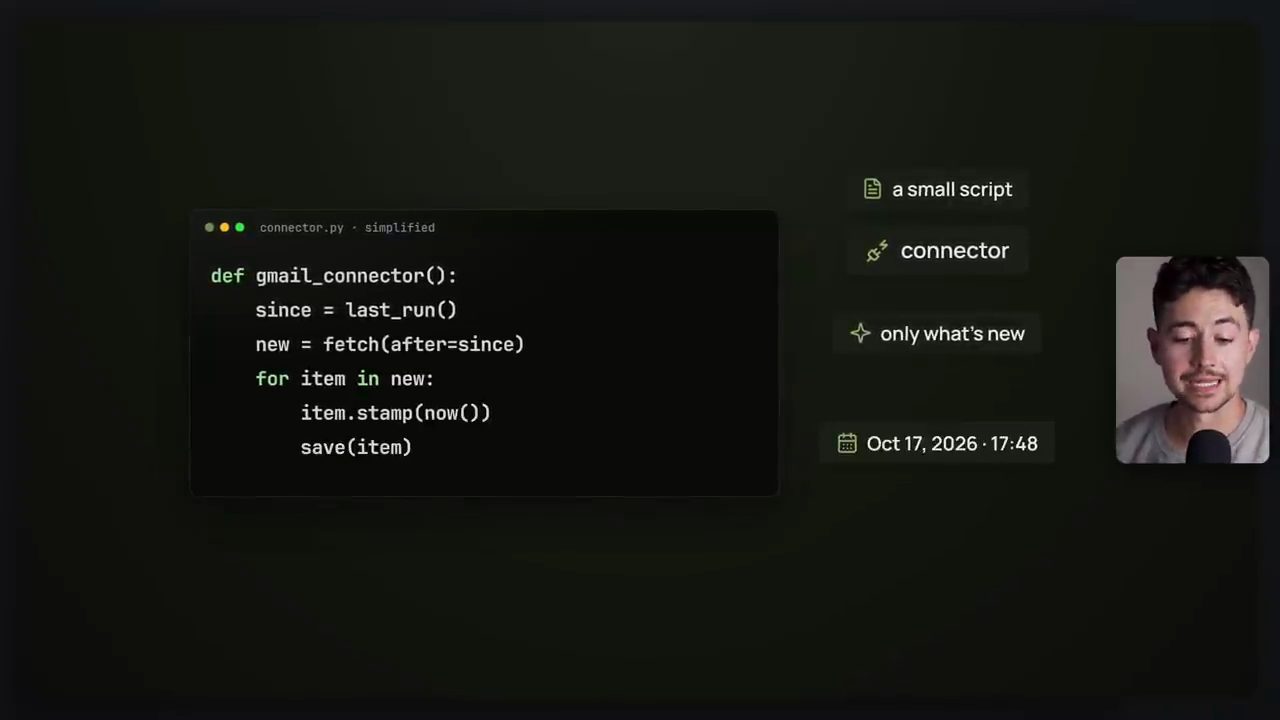
Đoạn code trên màn hình, ghi là connector.py · simplified:
def gmail_connector():
    since = last_run()
    new = fetch(after=since)
    for item in new:
        item.stamp(now())
        save(item)
Ví dụ cụ thể, theo lời Nick (video đăng ngày 18/10/2026): connector email của anh dùng Gmail API với quyền read-only. Anh nhấn mạnh điểm này là quan trọng: bạn không muốn cho thứ này quyền write, vì nếu không thì nó sẽ nắm toàn quyền cuộc sống của bạn.
Theo số liệu Nick kể (video đăng ngày 18/10/2026), lần đầu chạy, connector kéo về trọn một năm email từ ba tài khoản gần nhất của anh vào pipeline. Tới lần chạy thứ hai, nó chỉ phải lấy phần thời gian kể từ lần chạy trước.
Nick lưu ý thêm rằng thứ này chạy theo lịch anh tự đặt. Theo lời anh (video đăng ngày 18/10/2026), anh cho nó chạy 15 phút một lần, nhưng tuỳ vào compute load mà bạn có thể đặt lịch chạy theo ý mình.
9. Thêm Claude sessions vào nguồn
Nick rất khuyến khích bạn thêm cả Claude sessions vào nguồn, và theo anh việc này còn dễ hơn. Theo Nick (video đăng ngày 18/10/2026), nếu bạn dùng ChatGPT hoặc Claude, toàn bộ các session đó vốn đã được lưu sẵn trên máy bạn dưới dạng plain text, nên rất dễ index.
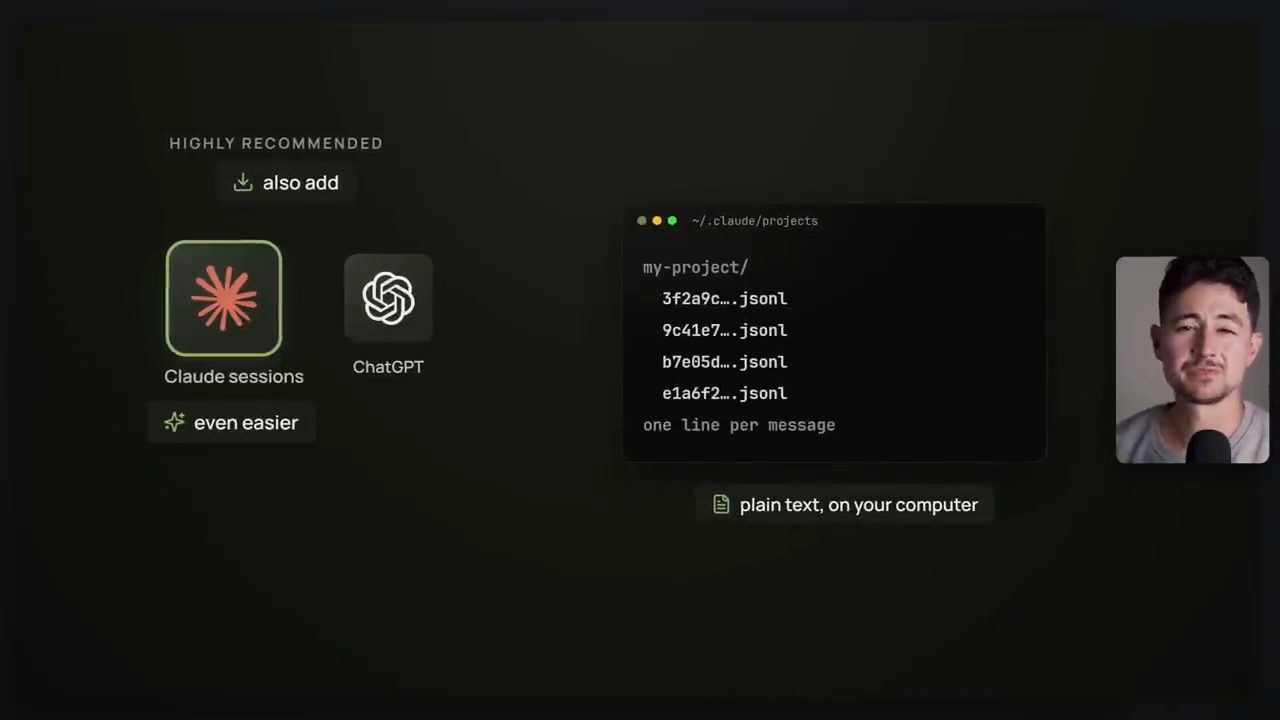
~/.claude/projects: mỗi project là một thư mục chứa các file .jsonl, "one line per message", tức plain text nằm ngay trên máy bạn.Điểm mấu chốt, theo lời Nick trong video đăng ngày 18/10/2026, là các session này bình thường sẽ bị xoá sau 30 ngày. Đưa chúng vào knowledge base cho phép bạn tra lại những cuộc trò chuyện từ nhiều tháng trước. Anh nói những cuộc đó thường khá quan trọng khi phát triển ý tưởng và gom lại các "hạt vàng" từ những project lớn hơn, đồng thời giúp bạn khỏi phải lặp lại chính mình.
Nick gợi ý: bạn có thể copy nguyên lời của video này dán vào agent mà bạn thích, rồi hỏi nó "nguồn dữ liệu của tôi là gì?". Theo anh (video đăng ngày 18/10/2026), nhiều khả năng nó sẽ liệt kê được khá ổn một vài nguồn, chưa kể còn dựng được phần còn lại của pipeline, phần mà anh trình bày tiếp theo.
10. Bước 2: một cheap model viết summary và atoms
Bạn không thể chỉ thêm nguyên nội dung vào là xong. Nick (video đăng ngày 18/10/2026) nói giá mà làm vậy được thì hay, nhưng cách hệ thống này thật sự vận hành là: mỗi item dài được biến thành ba phần. Phần một là chính item đó. Phần hai là metadata. Phần ba là một danh sách ghi chú về những gì có trong item, thường được diễn đạt lại nhiều lần để nắm ý cho thật đúng.
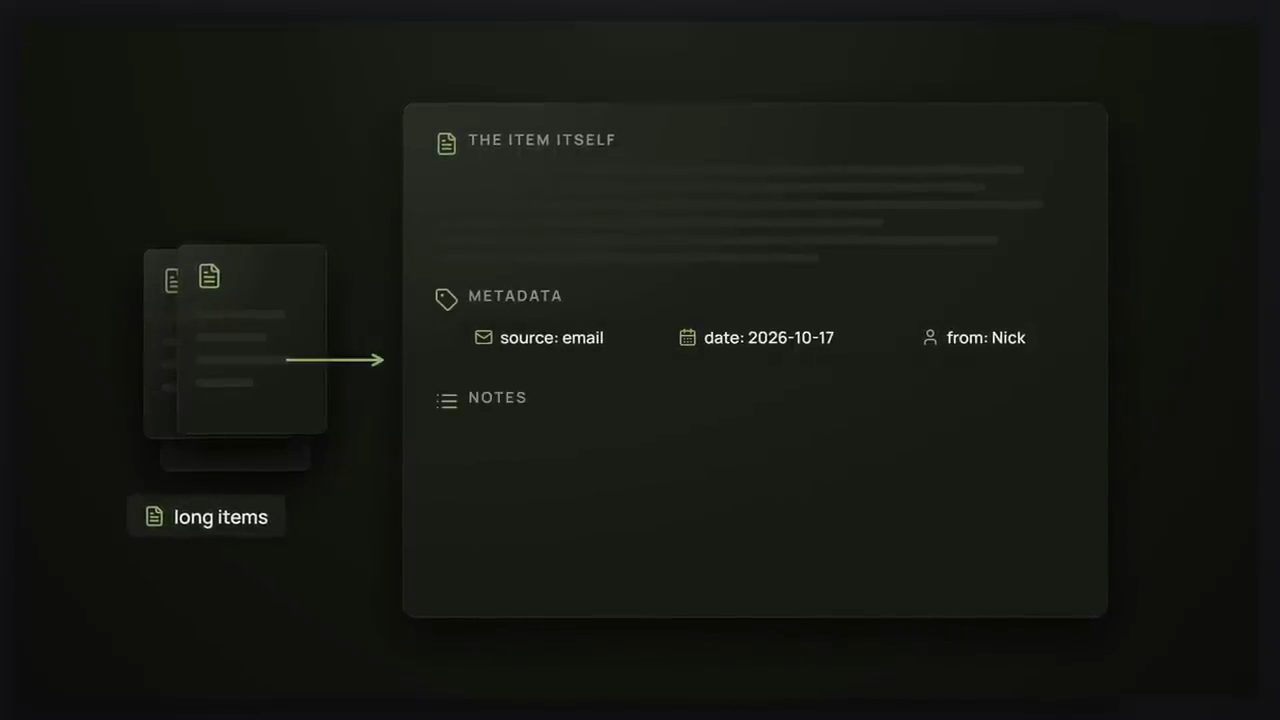
Đó chính là việc của bước tiếp theo, mà trên màn hình ghi là "A cheap model writes summaries": để một model rẻ viết các bản tóm tắt.
Theo Nick (video đăng ngày 18/10/2026), raw text tự nó rất khó tìm, nhất là với các AI model sẽ tìm bằng keyword matching. Nhưng nếu bạn làm hai việc, bạn giải quyết được chuyện đó hoàn toàn. Việc thứ nhất: viết một bản tóm tắt ngắn về chủ đề của dữ liệu bạn đưa vào hệ thống, trong đó có luôn câu hỏi mà một người nhiều khả năng sẽ gõ để tìm ra nó.
Việc thứ hai, theo Nick (video đăng ngày 18/10/2026): thêm thứ gọi là atoms. Atoms là các thông báo lỗi chính xác, các bản fix chính xác, mọi command đã chạy được (giả sử bạn đang build một chương trình hay một sản phẩm nào đó), và các quyết định, tức lý do vì sao người đó đã làm điều họ làm trong khoảng thời gian ấy.
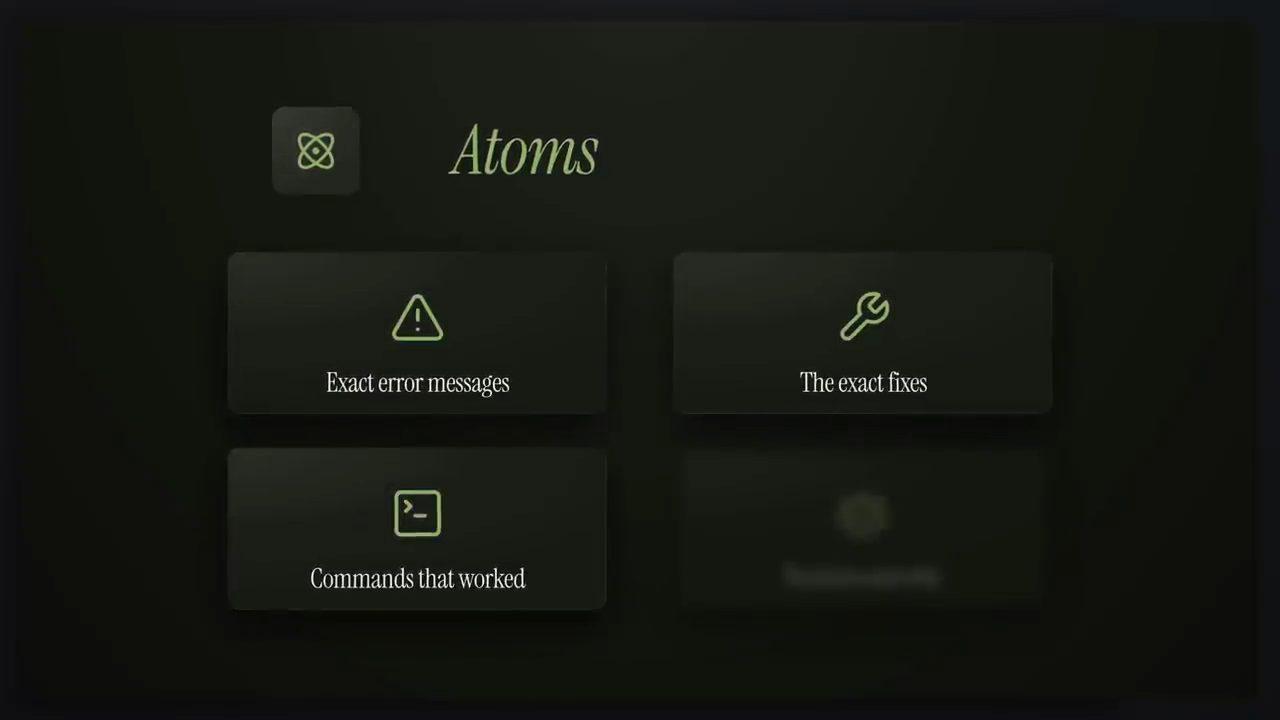
11. Institutional memory, và chọn model nào để tóm tắt
Theo Nick (video đăng ngày 18/10/2026), cách làm này cho phép bạn gom lại tất cả những quyết định ngầm mà mọi người trong công ty đang đưa ra, rồi biến chúng thành tường minh, tức là nói thành lời, và biến chúng thành thứ gọi là institutional memory, trí nhớ tập thể của tổ chức. Anh gọi đây là thứ rất mạnh, vì giờ bạn có trong tay bất kỳ workflow hay quy trình nào mà bạn hoặc bất kỳ agent nào có thể cần tới.
Hiển nhiên bước này cần thêm một large language model nữa. Nick kể cách anh làm (video đăng ngày 18/10/2026): lúc này anh dùng Claude Haiku 5.5. Trước đó anh dùng bản 4.5, và trong tương lai anh đoán mình sẽ dùng 6.5. Về cơ bản, theo anh, cứ chọn model AI rẻ nhất của nhà cung cấp mà bạn tin tưởng giao cho thông tin này.
Theo Nick (video đăng ngày 18/10/2026), sau đó bạn chỉ cần đưa cho nó một prompt, thứ mà AI model của bạn có thể tự viết ra từ lời của video này. Prompt đó yêu cầu model tạo phần metadata, tạo danh sách ghi chú ngắn cộng với danh sách atoms, mỗi lần có thứ gì đó đi vào hệ thống.
Giá trị của bước này, theo Nick (video đăng ngày 18/10/2026), là giờ Claude hay agent khác của bạn được tìm trên các bản tóm tắt. Nó thậm chí không cần tìm trên raw data. Khi khớp được một thứ trong bản tóm tắt, nó chỉ việc trỏ sang raw data, nên vẫn lấy được trọn vẹn nội dung.
12. Bước 3: làm cho tìm được bằng plain text search và BM25
Từ đây, việc còn lại chỉ là làm cho knowledge base tìm kiếm được. Và theo Nick (video đăng ngày 18/10/2026), phần lớn mọi người làm việc này quá phức tạp. Họ dùng những thứ như vector database. Theo anh, bạn hoàn toàn không cần embeddings. Cách đơn giản và dễ nhất chỉ là plain text search.
Nick (video đăng ngày 18/10/2026) kể đây là phát hiện khiến anh thấy "điên rồ". Nhóm anh đã đọc rất nhiều cách khác nhau mà người ta giải bài toán này. Và anh đã build rất nhiều hệ thống dùng RAG cho nhiều khách hàng khác nhau tính tới lúc đó. Nhưng ngay khi nhận ra "khoan đã, cho việc này bạn đâu cần RAG, ngoài kia có người làm việc này chỉ bằng plain text", mọi thứ thay đổi.
Theo số đo của Nick (video đăng ngày 18/10/2026), thời gian inference giảm khoảng chín phần mười. Chi phí duy trì tất cả các vector DB, chi phí embeddings, tất cả cũng giảm khoảng chín phần mười. Giờ nhóm anh chỉ có những chuỗi text khổng lồ, về cơ bản là thứ duy trì toàn bộ hệ thống.
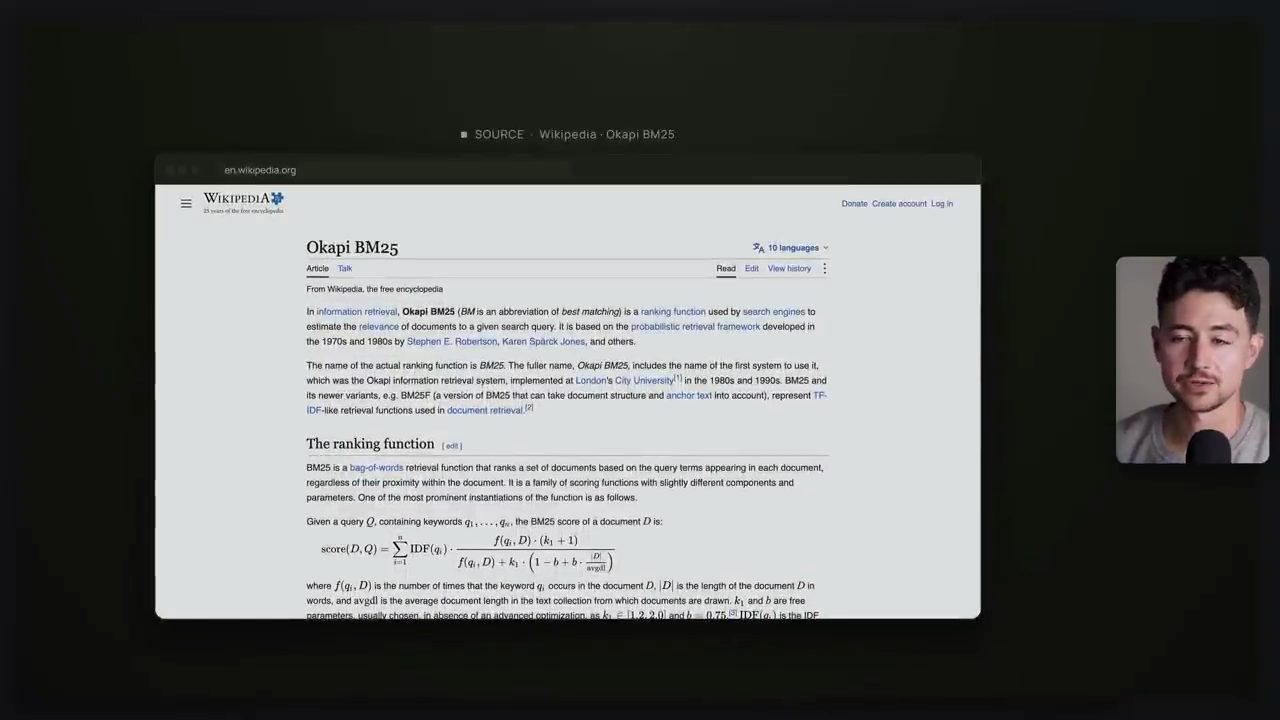
Thuật toán plain text cụ thể là BM25. Theo Nick (video đăng ngày 18/10/2026), nó đã có từ những năm 1990. Nó chỉ chấm cho mỗi tài liệu bạn thêm vào (mỗi mẩu dữ liệu) một điểm số dựa trên tần suất xuất hiện của những từ bạn dùng để tìm. Và hoá ra, theo Nick, chỉ cần vậy là đủ, Claude đủ thông minh để tự suy ra phần còn lại.
Nick (video đăng ngày 18/10/2026) thừa nhận anh thấy điều này quá muộn. Boris Cherny, người đứng sau việc tạo ra Claude Code ban đầu, sản phẩm mà theo lời Nick "bạn và tôi dùng mỗi ngày", từng nói đại ý rằng tìm kiếm đơn giản vượt mọi cách tiếp cận khác, và vượt rất xa.
Video chiếu đoạn này từ bài phỏng vấn "Claude Code: Anthropic's Agent in Your Terminal" trên Latent Space (đăng ngày 07/05/2025). Trong bài (đọc ngày 22/10/2026), Boris kể các phiên bản rất sớm của Claude Code từng dùng RAG có sẵn, rồi nhóm thử vài kiểu search tool khác, và cuối cùng chọn agentic search; lý do đầu tiên ông đưa ra là nó "outperformed everything. By a lot.", và ông nói thêm đó chủ yếu là cảm nhận cùng một số internal benchmark.
Với Nick (video đăng ngày 18/10/2026), đó là một nhận ra "điên rồ": chúng ta đã làm quá phức tạp những thứ như RAG trong một thời gian rất dài.
13. Bước 4: keep it fresh
Ngoài chuyện đó ra, theo Nick (video đăng ngày 18/10/2026), bước cuối là giữ cho hệ thống luôn tươi mới. Bạn cần có một script nào đó chạy nền, chạy lại và kiểm tra lại rằng connector vẫn đang hoạt động. Nếu connector không chạy, bạn không có dữ liệu mới đổ vào Engram của mình, và hiển nhiên mọi thứ sau đó đều hỏng theo.
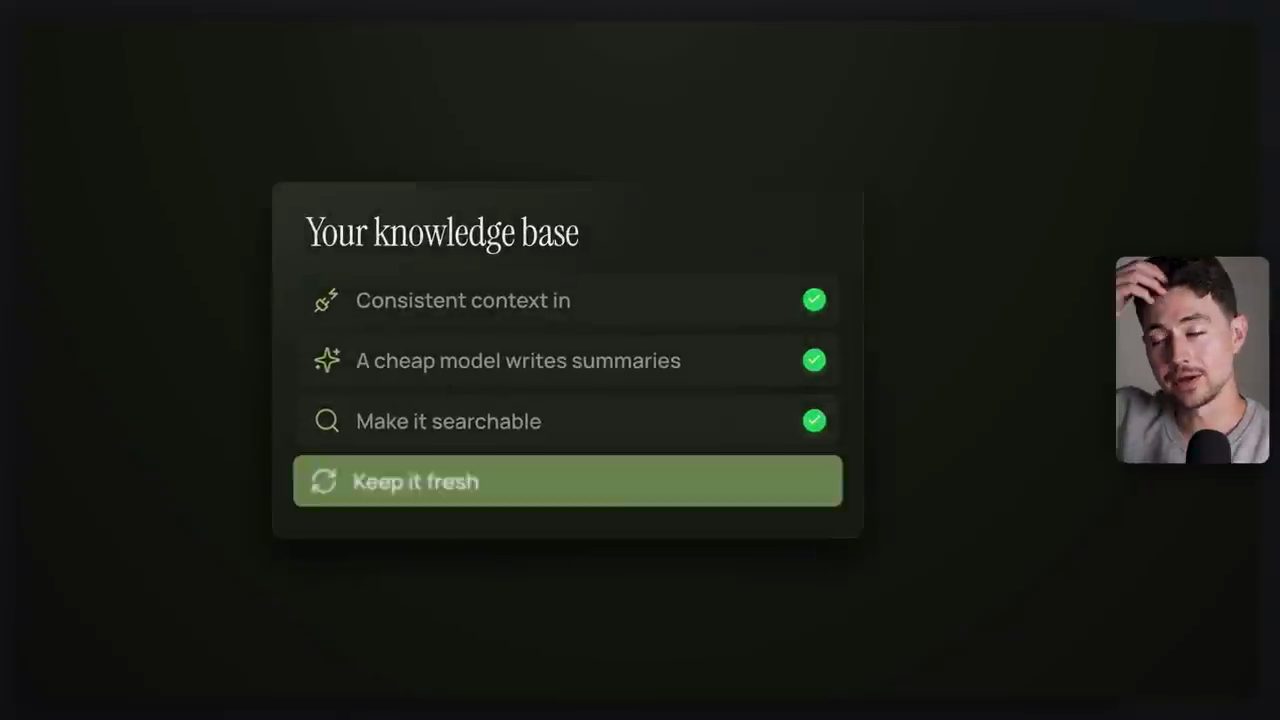
Theo Nick (video đăng ngày 18/10/2026), chẳng có lý do gì để dùng thứ này nếu nó không bắt kịp dữ liệu mới theo một chu kỳ đều đặn. Bạn sẽ gặp những chuyện như API key bị rotate, một số quyền (permission) thay đổi, vài route không còn chạy nữa, đại loại vậy. Vì thế hãy đảm bảo trong script của bạn có phần liên tục cập nhật nó.
Và vậy là xong. Theo lời Nick (video đăng ngày 18/10/2026), giờ bạn có đúng hệ thống second brain mà anh, và nhiều công ty trị giá hàng tỉ đô ngoài kia, đang dùng.
14. Nguồn gốc từ Cohere và lời kết
Nick (video đăng ngày 18/10/2026) kể hệ thống này ban đầu được build dựa trên một hệ thống second brain mà anh đọc được từ Cohere. Anh giới thiệu Cohere là công ty làm các sản phẩm large language model, và cũng thực sự build các hệ thống RAG.
Khi thấy ingestion pipeline của họ, anh tự hỏi làm thế quái nào để đưa được thứ này vào công ty mình. Anh đã chạy vài bài test so sánh nó với các cách làm RAG có sẵn mà anh từng thử trước đó. Theo kết quả test của Nick (video đăng ngày 18/10/2026), hai bên không cùng đẳng cấp, và anh quyết định phải đào thật sâu vào hướng này.
Nick kết video bằng lời cảm ơn và mời người xem để lại bình luận về chủ đề muốn anh làm tiếp. Theo lời anh (video đăng ngày 18/10/2026), gần như mọi ý tưởng video của anh lúc đó đều đến thẳng từ phần bình luận, và anh luôn trân trọng điều đó.
Nguồn và liên kết 8 nguồn
- Tên gốc: The NEW Way to Build a Second Brain w/ Claude (2027)
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=LP7bfT4vOlo youtube.com
- Kênh YouTube Nick Saraev (Nick Saraev): youtube.com/channel/UCbo-KbSjJDG6JWQ_MTZ_rNA youtube.com
- Bài "As We May Think" của Vannevar Bush, The Atlantic, số tháng 7/1945 (trang chặn truy cập tự động nên để dạng chữ): theatlantic.com/magazine/archive/1945/07/as-we-may-think/303881/ theatlantic.com
- Okapi BM25 trên Wikipedia, ranking function plain text mà Nick dùng: en.wikipedia.org/wiki/Okapi_BM25 en.wikipedia.org
- Google for Developers, "Choose Gmail API scopes": danh sách scope của Gmail API, trong đó có scope chỉ đọc
gmail.readonly: developers.google.com/workspace/gmail/api/auth/scopes developers.google.com - Latent Space, "Claude Code: Anthropic's Agent in Your Terminal" (đăng ngày 07/05/2025), bài phỏng vấn có đoạn Boris Cherny nói về RAG và agentic search: latent.space/p/claude-code latent.space
Related talks
Ôn thi offline: cho AI đọc trọn giáo trình
Thanh Trần · Thanh Trần - 5 Phút AI · 26 min
Chỉnh context length trong LM Studio để AI đọc trọn chương giáo trình, dựng thư viện theo môn bằng AnythingLLM, ra đề cương và trắc nghiệm offline.
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Claude Code Skills là gì và cách tạo skill theo 6 bước
Giang · GiangxAI · 29 min
Skill trong Claude Code là gì, khi nào nên xây, 6 bước tạo skill qua demo skill tạo ảnh infographic, CLAUDE.md và ba tầng tải token.