Vấn đề của Jev: có nên tin quyết định của AI?
Jeff Crume nhìn Jev qua lăng kính cybersecurity: confidence không phải bằng chứng, attack surface, observability và các control để verify rồi mới trust.
✓ Đã duyệt độc lập · cập nhật 22/10/2026 · 13 min
1. Quả bóng bói và một câu trả lời rất tự tin
Jeff Crume mở video bằng một màn đối thoại với quả bóng bói số 8 màu đen anh cầm trên tay. Anh hỏi: ngày mai trời có mưa không? Quả bóng trả lời: "It is decidedly so", chắc chắn là vậy. Anh hỏi lại: ồ, thật à? Sao bạn chắc thế? Lần này nó đáp: "Reply hazy, try again", câu trả lời mơ hồ, hãy thử lại.
"Được, tôi thử lại đây", anh nói. Làm sao bạn biết trời sẽ mưa? Trông bạn có vẻ khá tự tin về chuyện đó. Quả bóng đáp: "Better not tell you now", tốt hơn là chưa nói lúc này. Anh kết luận: thôi, thế này chẳng giúp được gì, rõ ràng thứ này sẽ không cho tôi những câu trả lời tôi cần.
2. Jev ra quyết định, LLM ra chữ
Jeff nói có thể bạn đã nghe tới một cách tiếp cận AI mới (theo video đăng ngày 20/10/2026) tên là Jev. Một người bạn của anh đã làm một video giải thích rất hay ngay trên kênh này, nên nếu bạn chưa quen với Jev thì hãy xem video đó trước.
Theo Jeff (video đăng ngày 20/10/2026), đây là một công nghệ mới và rất thú vị, được thiết kế để làm một việc rất khác so với LLM (large language model) mà tất cả chúng ta đã quen. Khác biệt lớn nằm ở đầu ra: một LLM sinh ra chữ, rất nhiều chữ. Còn Jev đưa ra quyết định. Những quyết định nhanh.
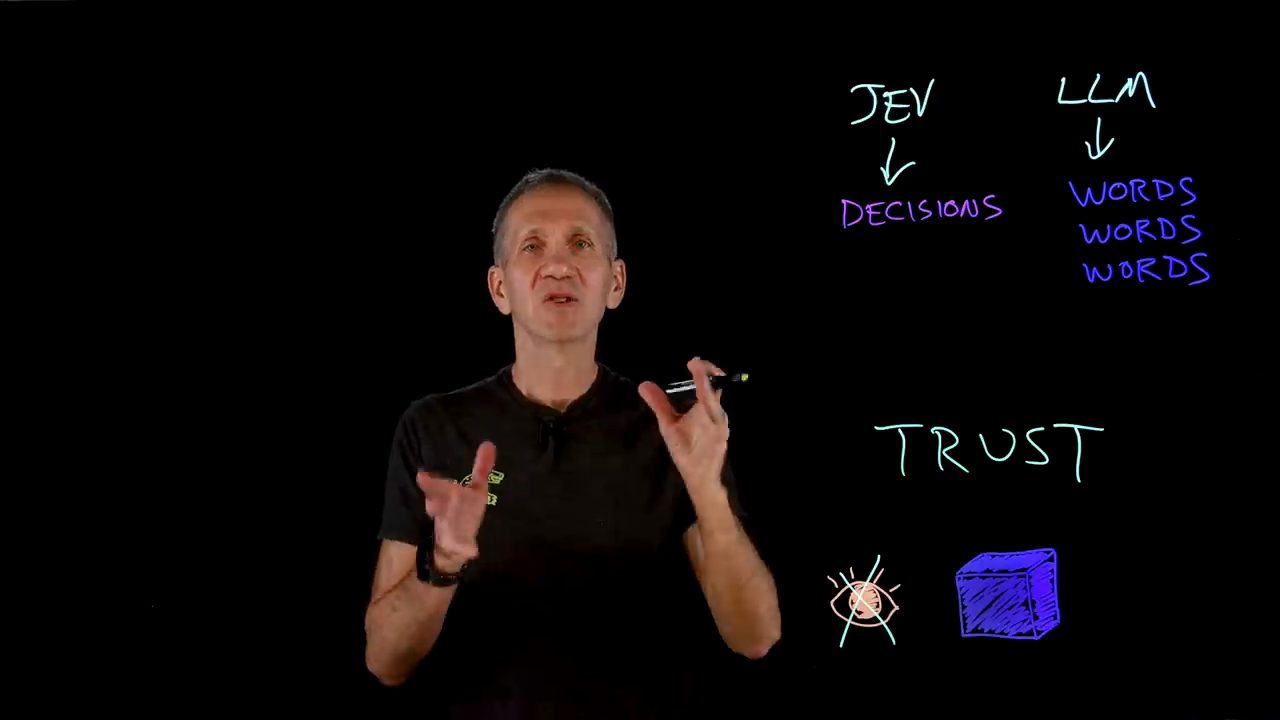
Và theo anh (video đăng ngày 20/10/2026), điều đó có thể là chuyện lớn đối với tự động hoá (automation).
3. Vấn đề của dân cybersecurity: trust và chiếc hộp đen
Nhưng Jeff có một vấn đề, và đó là kiểu vấn đề rất "dân cybersecurity". Đúng vậy, vấn đề nằm ở trust, sự tin cậy. Anh đùa: ngoài dân cybersecurity ra thì còn ai nghĩ ra và bỏ nhiều thời gian đến thế để phát triển một khái niệm gọi là zero trust? Anh thừa nhận "bộ tộc" của mình hay bị chê là có vấn đề về lòng tin, nhưng đó là chuyện của một video khác.
Nói cách khác, câu hỏi của anh là: làm sao ta biết được instance Jev cụ thể mà ta đang làm việc cùng không phải chỉ là một quả bóng bói tinh vi, có gắn thêm xác suất? Theo Jeff (video đăng ngày 20/10/2026), về cơ bản nó là một hộp đen (black box), ta không nhìn vào bên trong được. Ta không xác định được nó đi tới câu trả lời bằng cách nào, nên ta không biết câu trả lời có sai không. Và nếu chúng sai, thì làm sao ta biết? Đó là câu hỏi anh muốn đào sâu trong video.
4. LLM ít nhất còn có thứ để soi
Anh bắt đầu với LLM. Theo Jeff (video đăng ngày 20/10/2026), LLM cho ta một thứ để kiểm tra (inspect). Có input đi vào, tức là prompt. Rồi có text đi ra. Với một LLM, bạn nhận được một câu trả lời được diễn đạt tử tế.
Câu trả lời đó có thể sai. Nó có thể hoàn toàn vô căn cứ. Nó thậm chí có thể sai một cách đầy tự tin, và ta gọi những trường hợp đó là hallucination. Nhưng ít nhất vẫn có một thứ nằm đó để bạn kiểm tra. Bạn có thể hỏi: tại sao bạn lại đưa ra câu trả lời này? Bạn có thể chất vấn nó.
Theo Jeff (video đăng ngày 20/10/2026), bạn thậm chí có thể dùng thêm một LLM khác để đi vào kiểm tra kết quả và soát lại model. Trên lightboard, Jeff vẽ một ô LLM thứ hai với mũi tên chỉ ngược về cả ô LLM ban đầu lẫn phần TEXT. Bạn có thể xem tất cả những thứ đó: bạn có thể xem các tool mà LLM đã dùng (anh vẽ một ô hình cái búa phía trên), bạn có thể xem dữ liệu đã dùng để train model (một ô hình trụ database). Theo Jeff (video đăng ngày 20/10/2026), tất cả những thứ đó đều có sẵn cho bạn với một LLM, kể cả một chuỗi bằng chứng (chain of evidence) xoay quanh quyết định đó.
Anh nói rõ: như vậy không hoàn hảo, còn xa mới hoàn hảo, nhưng ít ra có thứ để quan sát.
5. Jev: input vào, "Yes, 97%" ra
Giờ tới Jev. Theo Jeff (video đăng ngày 20/10/2026), ở đây cũng có input đi vào, và thứ đi ra là một quyết định. Jeff viết lên bảng: "Yes", kèm con số 97%.
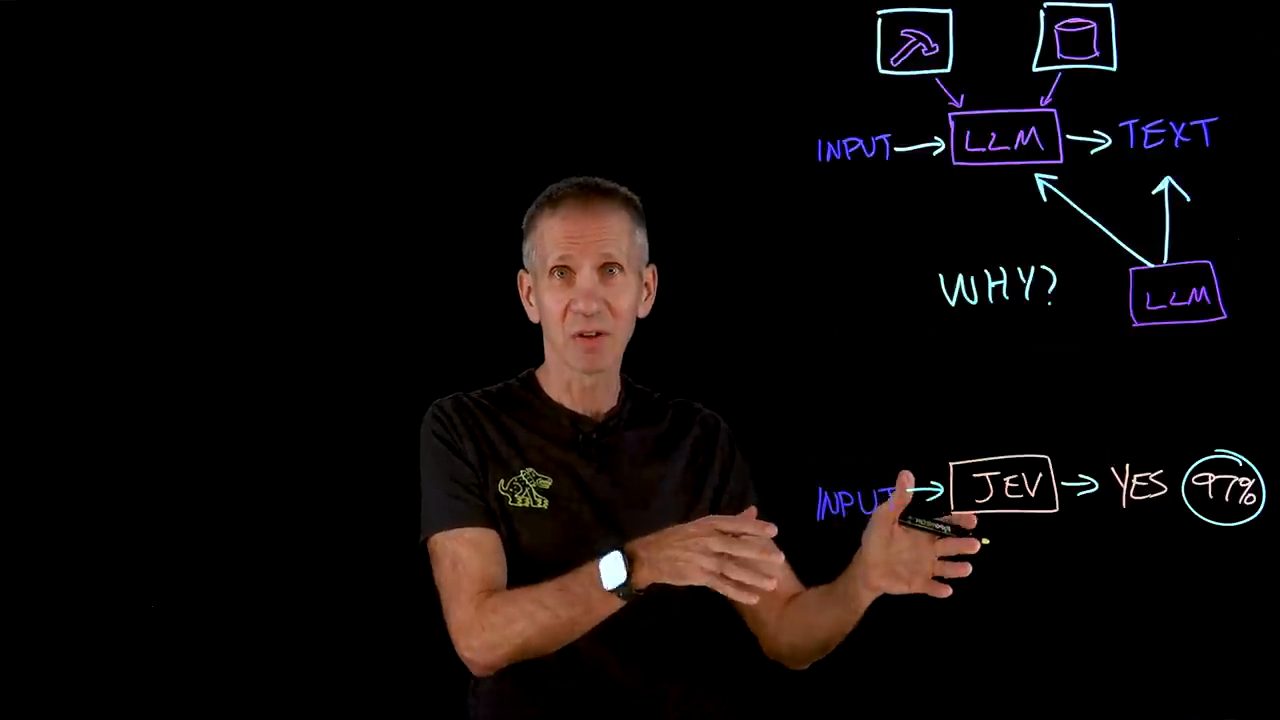
Theo Jeff (video đăng ngày 20/10/2026), như vậy cực kỳ hữu ích cho phần mềm, vì phần mềm không phải đi qua và diễn giải cả đống thứ được sinh ra. Nó nhận được một quyết định có cấu trúc (structured decision), kèm một xác suất cho biết mức độ tự tin (confidence).
Anh nói (video đăng ngày 20/10/2026) đây là một trong những điều khiến Jev thật sự thú vị: chính chuyện confidence này.
6. Confidence không phải evidence: ví dụ một cảnh báo bảo mật
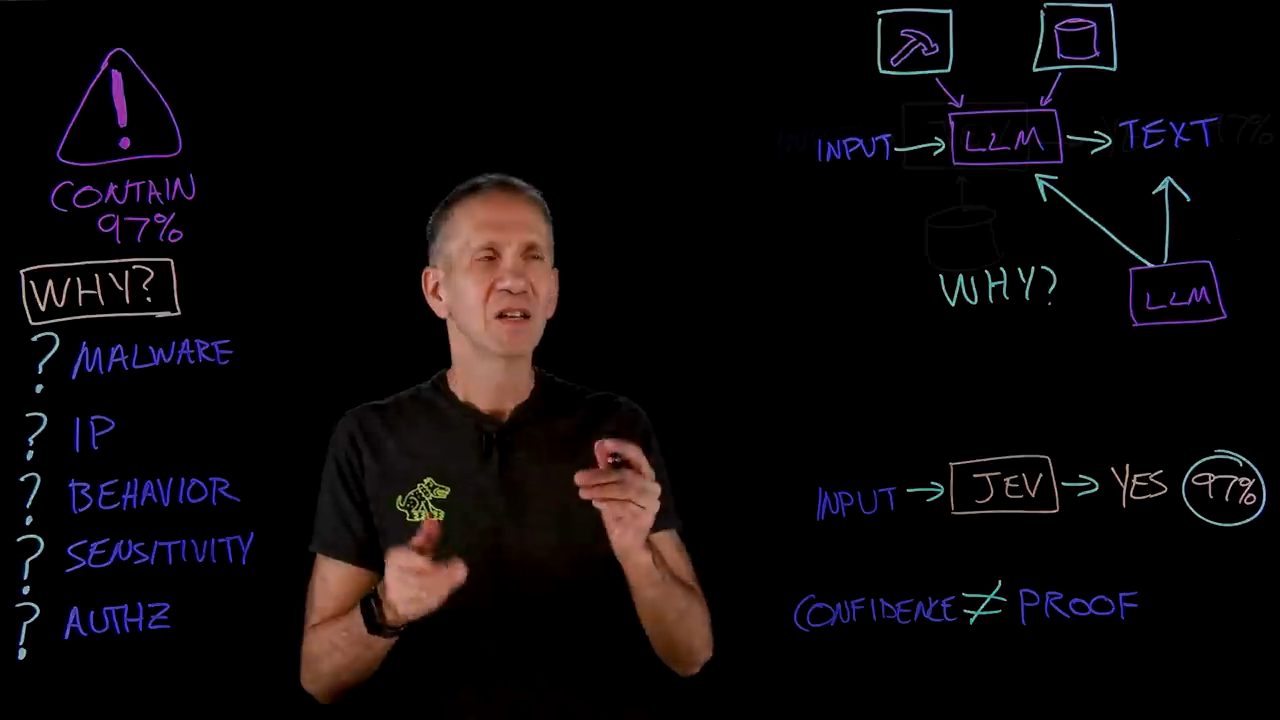
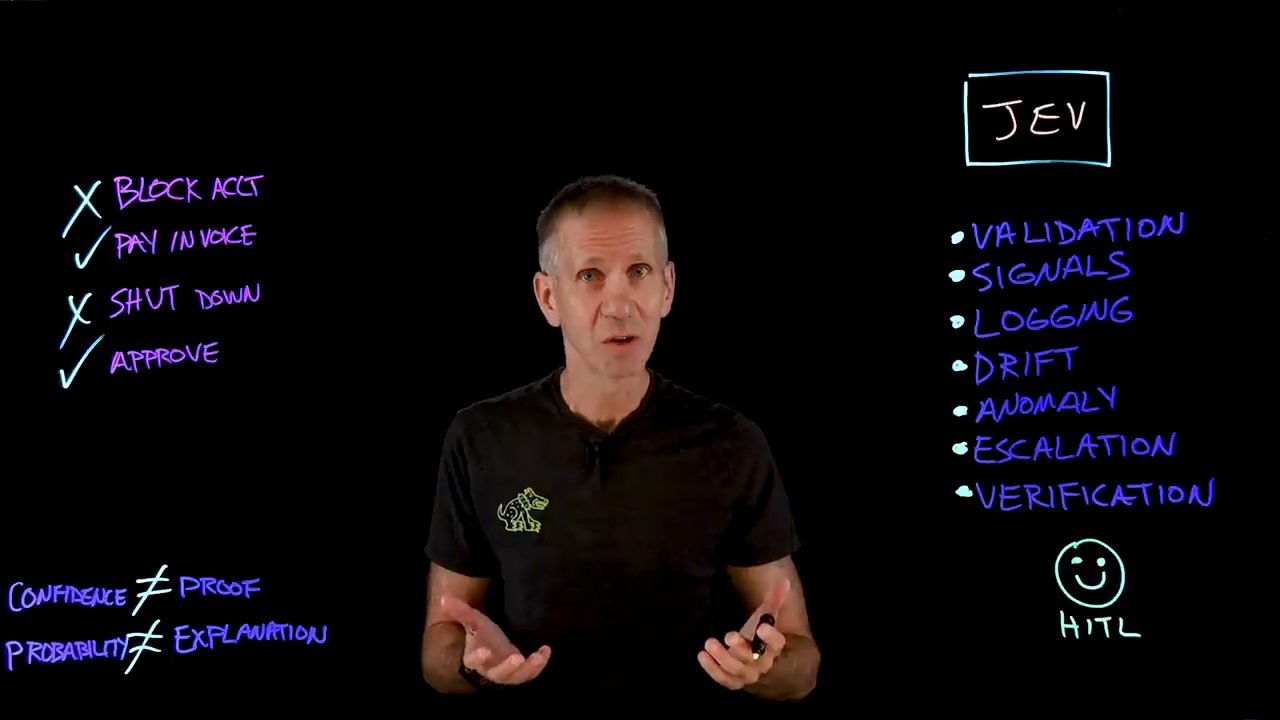
Xác suất cho Jeff biết điều gì đó về độ tự tin của model, nhưng nó không nhất thiết cho anh biết lý do của quyết định. Và đó là hai thứ rất khác nhau. Confidence không nhất thiết là evidence (bằng chứng), và chắc chắn không phải là proof (chứng minh). Anh viết lên bảng: CONFIDENCE ≠ PROOF.
Anh đưa một ví dụ đơn giản. Giả sử ta bắt đầu với một cảnh báo bảo mật (security alert): có thứ gì đó báo rằng ta đang bị tấn công. Jev nói rằng việc bạn nên làm là cô lập (contain) host đó, và nó đưa ra mức confidence 97%. Được thôi, ấn tượng đấy. Nó tiết kiệm cho ta rất nhiều thời gian, cho ta biết vấn đề là gì, thậm chí cho biết cần làm gì.
Nhưng giả sử Jeff là người làm bảo mật chịu trách nhiệm cho quyết định đó. Anh muốn biết: tại sao bạn lại bảo tôi như vậy? Bạn đi tới kết luận đó từ đâu? Anh liệt kê từng khả năng:
- Có phải vì tiến trình (process) khớp với một loại malware đã biết?
- Có phải địa chỉ IP đã được biết là độc hại?
- Có hành vi bất thường nào được quan sát thấy không?
- Máy đó có đặc biệt nhạy cảm (sensitivity), nên ta sẽ dựng thêm lớp bảo vệ quanh nó?
- Hay có một vấn đề về phân quyền (authorization) mà model nhận ra nhưng không hiểu?
- Hay có ai đó đã thao túng thông tin đi vào model, hoặc thậm chí thao túng chính model?
7. Input và model là một phần của attack surface
Khả năng cuối cùng là điều Jeff nhấn mạnh, vì từ góc nhìn bảo mật, input và model là một phần của attack surface (bề mặt tấn công).
Hãy hình dung có một kẻ tấn công đã tìm ra Jev sẽ nhìn vào những thông tin nào, và hắn làm gì đó để thao túng thông tin đi vào model. Có thể hắn sửa một log. Có thể hắn thao túng một ít metadata. Có thể hắn đầu độc (poison) một nguồn dữ liệu đã được dùng để train model. Hoặc có thể hắn khai thác một điểm yếu nào đó trong workflow đưa dữ liệu vào model, ở đâu đó trên đường đi.
Model khi đó có thể đưa ra một quyết định hoàn toàn nhất quán, dựa trên thông tin đã bị làm hỏng. Vậy ta có gì? Bạn biết câu nói cũ rồi đấy: garbage in, rác vào. Trong trường hợp này là rác ra, nhưng là rác ra một cách đầy tự tin (confident garbage out).
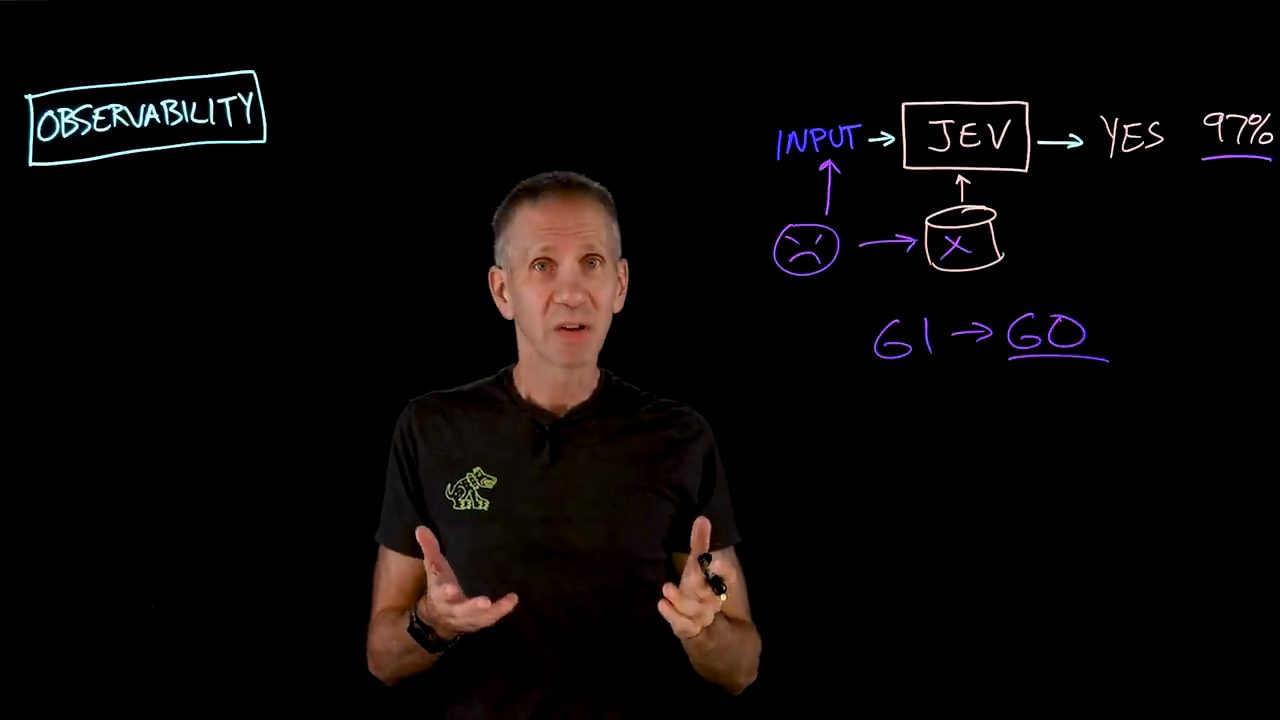
Và đây là phần đáng sợ: model vẫn sẽ nói confidence 97%. Điều đó không có nghĩa quyết định đáng tin. Nó có nghĩa là model tự tin rằng, với những gì nó đã thấy, đó là câu trả lời nên có. Nhưng nó có thể sai một cách đầy tự tin.
Hoặc model cũng có thể sai vì một lý do hoàn toàn vô tội, giống như cách LLM hallucinate. Nhưng trong bất kỳ trường hợp nào kể trên, làm sao bạn biết?
8. Observability: dựng lại được chuyện gì đã xảy ra
Câu hỏi đó đưa Jeff tới một khái niệm quan trọng trong cybersecurity: observability, khả năng quan sát.
Khi có chuyện trục trặc trong một hệ thống truyền thống, anh muốn dựng lại được chuyện gì đã xảy ra. Anh muốn biết:
- Cái gì đã đi vào?
- Cái gì đã thay đổi?
- Những rule nào trong hệ thống đã được kích hoạt?
- Dữ liệu nào đã được tham chiếu để đưa ra quyết định?
- Quyết định thực sự được đưa ra là gì?
- Ai, hoặc cái gì, đã gây ra nó? Và cuối cùng là tại sao?
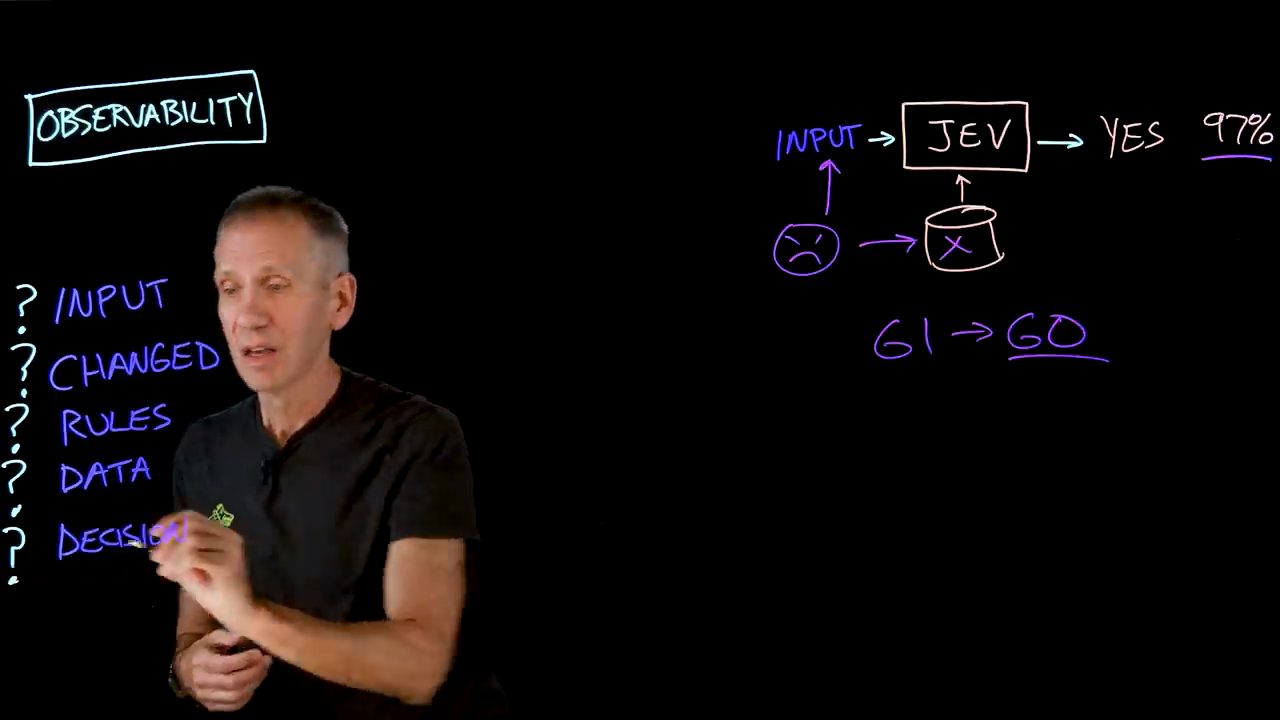
Từ tất cả những câu hỏi đó, điều anh cần sau cùng là một audit trail: một thứ để anh điều tra và kiểm chứng rằng hoạt động diễn ra đúng như ta định. Đó là cách ta điều tra. Đó là cách ta phát hiện tấn công. Đó là cách ta xác lập trách nhiệm (accountability).
Nếu anh sắp thực hiện những hành động ứng phó có thể làm tắt cả một hệ thống, anh cần chắc chắn lời khuyên mình nhận được là đúng, chứ không chỉ là tự tin.
9. Chia một câu hỏi lớn thành nhiều câu hỏi nhỏ
Vậy visibility với Jev nằm ở đâu? Theo Jeff (video đăng ngày 20/10/2026), Jev sẽ cho ta đầu ra và câu trả lời có cấu trúc, và nó còn cho ta xác suất để biết nó tự tin tới mức nào. Trên bảng, anh viết một cột câu trả lời kèm xác suất: YES 89%, NO 51%, NO 72%, YES 93%, YES 45%, YES 57%.
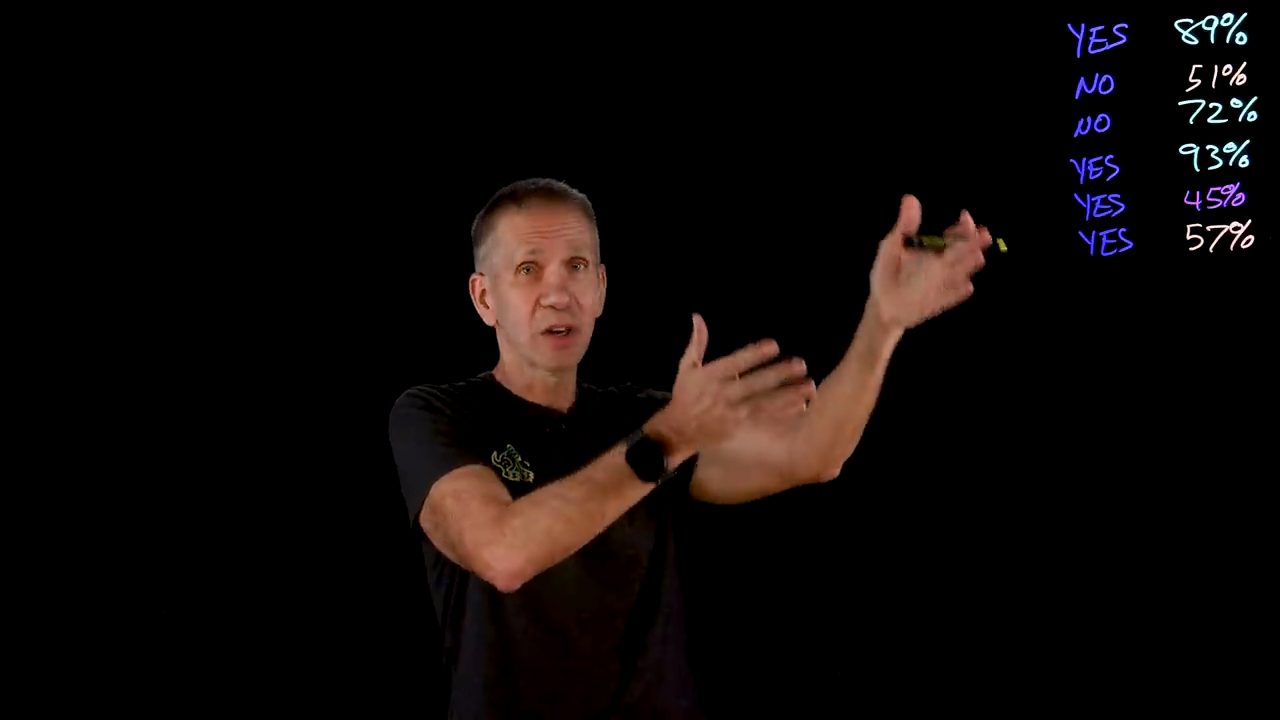
Cũng theo Jeff (video đăng ngày 20/10/2026), Jev được thiết kế riêng để nhúng vào bên trong các workflow có cấu trúc. Anh nói tất cả những điều đó đều tốt: cắm nó vào một workflow rất dễ.
Thực tế, TypeSafe, công ty đứng sau Jev, nói một điều mà Jeff rất thích (theo video đăng ngày 20/10/2026): thay vì hỏi một câu hỏi lớn, tốt hơn là chia nó thành nhiều câu hỏi nhỏ hơn. Làm vậy, bạn sẽ có một bộ điểm quan sát được thiết kế tốt hơn, cài sẵn vào trong hệ thống. Trên bảng, anh vẽ một hình chữ nhật lớn bên cạnh ba ô nhỏ để minh hoạ ý này. Bài blog ra mắt Jev của TypeSafe (đọc ngày 22/10/2026) cũng viết rằng các workflow thực tế đáng tin cậy nhất thường có nhiều câu hỏi độc lập, được tách nhỏ.
Jeff lấy lại kịch bản "có một cảnh báo đi vào". Có thể việc đầu tiên ta hỏi không chỉ là "ta làm gì", mà là: hoạt động cụ thể này có được phép (authorized) hay không? Nếu không, thì có thể ta hỏi tiếp: bạn có bằng chứng (evidence) gì để hỗ trợ điều đó? Rồi ta có một phép tính rủi ro (risk) đi kèm không? Và khi cộng tất cả những thứ đó lại, có thể ta mới đưa ra được một quyết định.
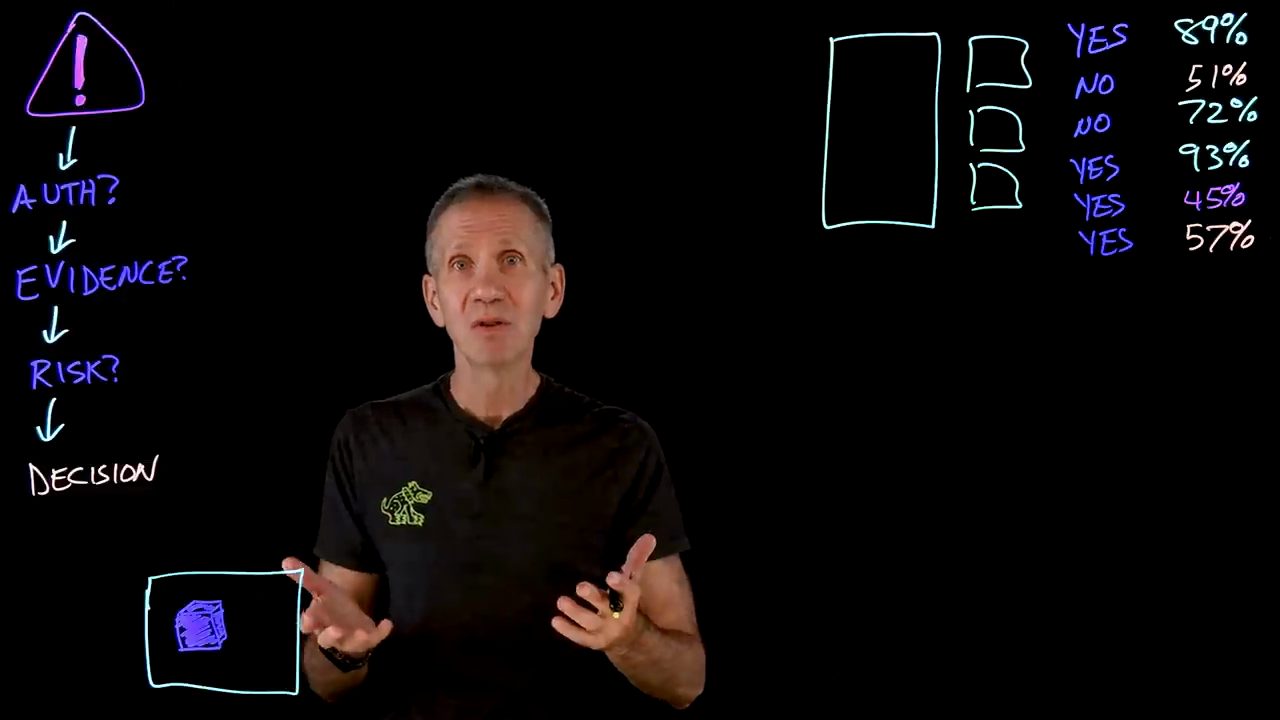
Theo Jeff, đó là một cách làm kỹ thuật tốt hơn nhiều, vì giờ bạn quan sát được từng quyết định riêng lẻ đã góp vào quyết định cuối cùng, thay vì coi cả hệ thống là một hộp đen lớn mà bạn không nhìn vào được. Điều ta muốn là cải thiện thông qua tinh chỉnh (improvement through refinement): mỗi bước là một lần tinh chỉnh từng bước (stepwise refinement) của bước trước đó.
10. Verify rồi mới trust: rốt cuộc ta verify được gì?
Nhưng vẫn còn một câu hỏi nền tảng. Jeff nói là một người làm bảo mật, anh được "lập trình" theo cách này: verify, then trust, kiểm chứng rồi mới tin. Không phải trust, then verify. Trên bảng, anh viết VERIFY → TRUST, còn chiều ngược lại thì bị gạch chéo.
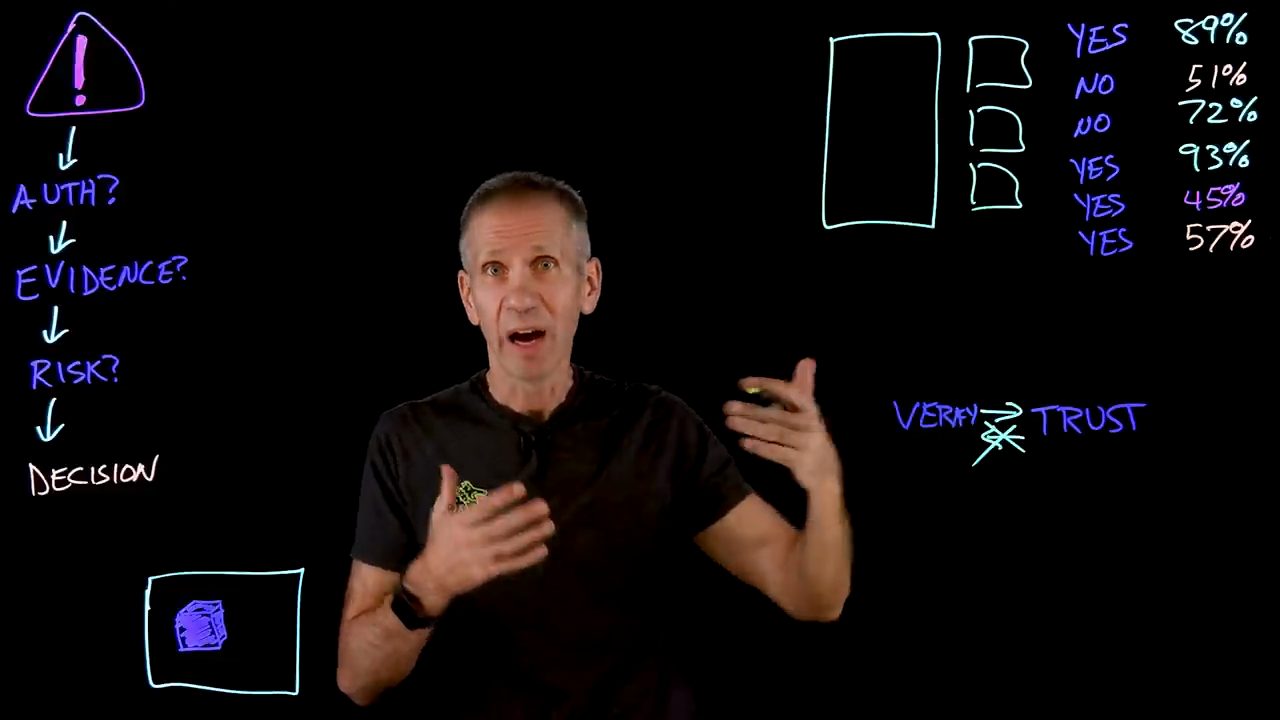
Vậy vấn đề là đây. Nếu Jev nói với anh "cô lập máy này, 97%", được, ta có một con số, nhưng chính xác thì anh đang verify cái gì? Anh không thể verify được việc Jev đã tạo ra đầu ra đó. Ý anh là, anh biết nó đến từ Jev, nhưng anh không biết nó đến từ đâu.
Những gì anh verify được thì có: anh có thể verify rằng đầu ra đúng với kiểu dữ liệu (type) mong đợi. Anh có thể ghi lại các xác suất. Anh có thể log các input. Anh có thể audit các workflow xung quanh, đủ mọi thứ kiểu đó.
Nhưng anh có thật sự verify một cách độc lập được trí thông minh đã tạo ra quyết định đó không? Theo Jeff (video đăng ngày 20/10/2026), việc đó khó hơn nhiều, vì anh không có một proof. Anh có một prediction, một dự đoán.
11. Kẻ tấn công thích những thứ ta không nhìn thấy
Và đoán xem? Kẻ tấn công rất thích những thứ ta không nhìn thấy được. Hãy nghĩ tới các control bảo mật truyền thống. Nếu kẻ tấn công xâm nhập một control như vậy, Jeff có bằng chứng: log, event, thay đổi, bất thường (anomaly), indicator of compromise, đủ mọi loại dấu vết để sau này xem lại và quyết định chuyện gì thực sự đã xảy ra.
Nhưng hãy hình dung một hệ thống ra quyết định bằng AI đã bị xâm nhập, và nó chỉ đơn giản bắt đầu đưa ra những quyết định khác đi một cách tinh vi. Không phải mọi thứ đều bị xâm nhập, chỉ là nó có khả năng chấp thuận một thứ xấu cao hơn trước 1%. Hoặc với một loại mục tiêu cụ thể, có thể nó bắt đầu kém chính xác hơn một chút.
Vấn đề là thứ đó vẫn chính xác, vẫn tốt, vẫn đang làm việc, rồi đột nhiên nó không còn như vậy nữa. Trên bảng, Jeff vẽ một hàng dấu tích đúng nối tiếp nhau, rồi một dấu X ở cuối. Anh đã xây dựng niềm tin từ những lần đúng đó, nên trong trường hợp này anh thậm chí không còn chất vấn kết quả.
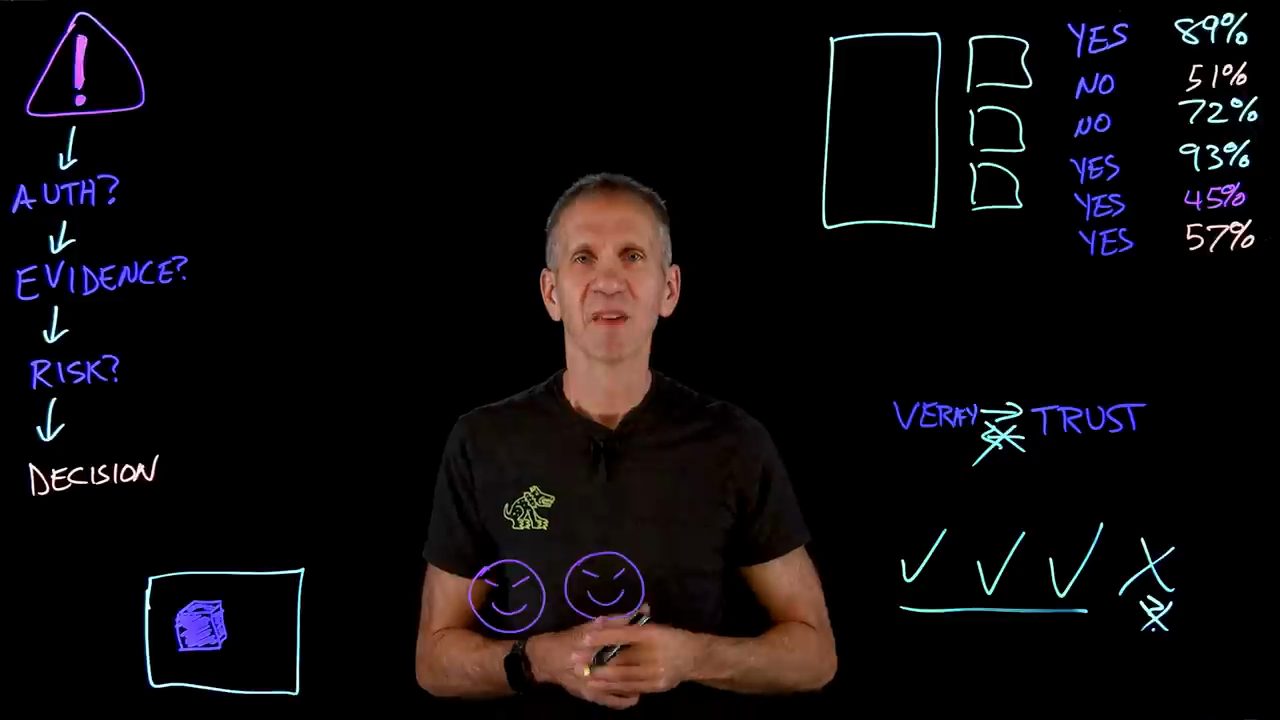
Theo Jeff, chuyện đó có thể khó phát hiện hơn nhiều, vì từng câu trả lời riêng lẻ có thể trông hoàn toàn hợp lý khi đứng một mình. Ta tin nó vì ta đã thấy nó đúng hết lần này tới lần khác, và sự tin tưởng của ta sẽ tăng dần theo thời gian, còn ta thì sẽ bớt soi xét khi phân tích những kết quả đó.
12. Coi AI là một thành phần không đáng tin và dựng control quanh nó
Vậy câu trả lời là gì? Jeff nói rõ: anh không bảo đừng dùng Jev. Hoàn toàn ngược lại. Anh nghĩ (video đăng ngày 20/10/2026) loại năng lực này có thể cực kỳ hữu ích cho chúng ta.
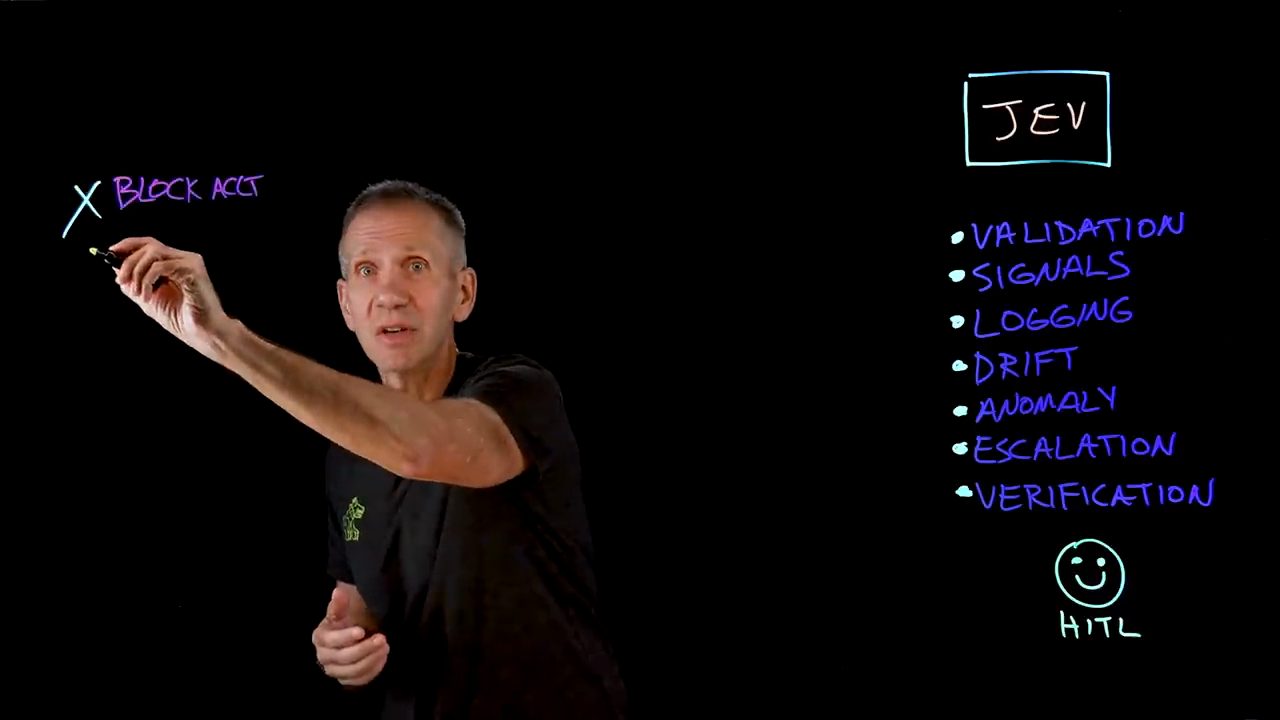
Nhưng anh sẽ coi bản thân AI là một thành phần không đáng tin (untrusted component), rồi đặt các control bảo mật xung quanh nó. Anh viết lên bảng, dưới ô JEV, từng control một:
- Validation: kiểm tra input. Anh cần biết thứ gì đang đi vào model.
- Signals: có nhiều tín hiệu độc lập cùng đi vào, không dựa vào một nguồn duy nhất.
- Logging: audit các log.
- Drift: theo dõi xem hành vi của model có trôi dần (drift) đi hay không.
- Anomaly: tìm các điểm bất thường.
- Escalation và Verification: có con người tham gia vào quy trình leo thang, với khâu kiểm chứng độc lập cho một số quyết định rủi ro cao.
Tức là ta giữ con người trong vòng lặp (human in the loop), anh vẽ một khuôn mặt cười với chữ HITL bên dưới danh sách. Và điều then chốt: đừng để Jev là thứ duy nhất biết chuyện gì đã xảy ra.
13. Khi AI chuyển từ viết chữ sang hành động
Khi AI đi từ chỗ chỉ sinh ra text sang chỗ thực hiện hành động, câu hỏi này càng trở nên quan trọng. Nếu một LLM viết ra một đoạn văn dở, đó là một chuyện. Nhưng nếu một AI quyết định khoá tài khoản này, hay thanh toán hoá đơn kia, hay tắt máy chủ, hay chấp thuận một giao dịch cụ thể, thì ta đang nói tới một bài toán bảo mật hoàn toàn khác.
Trên bảng, anh viết bốn hành động BLOCK ACCT, PAY INVOICE, SHUT DOWN, APPROVE, mỗi hành động có một dấu X hoặc một dấu tích bên cạnh.
Theo Jeff, câu hỏi không chỉ là AI có đưa ra được quyết định đúng hay không. Câu hỏi là: tôi có biết được khi nào nó đưa ra quyết định sai không? Và quan trọng hơn nữa: tôi có phân biệt được liệu có ai đó đã khiến nó đưa ra quyết định sai hay không?
14. Confidence không phải proof: verify, then trust
Jeff tổng kết (video đăng ngày 20/10/2026): observability là một mối quan tâm lớn với Jev. Anh nói rõ không phải vì nó nhất thiết kém chính xác hơn một LLM, hay vì quyết định dựa trên xác suất có vấn đề gì đặc biệt. Bản chất chúng không xấu. Thực ra anh thấy cách tiếp cận có cấu trúc này khá thuyết phục.
Mối lo của anh là thế này: ta càng để AI ra quyết định thay mình nhiều, thì việc quan sát, audit và verify những quyết định đó càng trở nên quan trọng. Bởi vì confidence không phải là proof, và một xác suất không giống với một lời giải thích.
Và chỉ vì một quyết định thoạt nhìn có vẻ hợp lệ không có nghĩa là nó đáng tin. Đừng chỉ hỏi: AI đã quyết định gì? Hãy hỏi: làm sao tôi biết nó đã quyết định gì? Verify, then trust. Có như vậy, ta mới không bị bỏ lại với những quyết định AI kiểu phép màu. Jeff cảm ơn người xem và kết thúc video.
Nguồn và liên kết 6 nguồn
- Tên gốc: The Problem with Jev: Can You Trust AI Decisions?
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=_yO_Q7qo0HQ youtube.com
- Kênh YouTube IBM Technology (Jeff Crume): youtube.com/channel/UCKWaEZ-_VweaEx1j62do_vQ youtube.com
- Bài blog của TypeSafe giới thiệu System One model và Jev (đọc ngày 22/10/2026; có đoạn nói các workflow đáng tin cậy thường gồm nhiều câu hỏi độc lập, được tách nhỏ): typesafe.ai/blog/introducing-system-one-models-and-jev typesafe.ai
- Tài liệu TypeSafe về khái niệm System One, model trả về câu trả lời có kiểu kèm xác suất (đọc ngày 22/10/2026): docs.typesafe.ai/concepts/system-one docs.typesafe.ai
Related talks
Grok Bot sau 14 ngày dùng thật: điều không ai nói
Helena Zhang · Helena Zhang · 9 min
14 ngày dùng Grok Bot thật: đội bot chuyên môn, dọn 500 GB ổ đĩa, nối ChatGPT và Claude, máy tính và IP dùng chung, usage và giá qua Cursor.
9 agent skill miễn phí nên cài ngay
Kevin Hutson · Futurepedia · 16 min
Cách cài và dùng 9 skill miễn phí cho agent: nghiên cứu, Humanizer, xem video, Remotion, HyperFrames, quét an ninh, Superpowers, gstack và Impeccable.
Agentic AI: cắm MCP đọc ghi tệp cho model chạy trên máy
Thanh Trần · Thanh Trần - 5 Phút AI · 25 min
Chatbot khác agent ở đâu, cắm MCP đọc ghi tệp vào LM Studio, viết câu lệnh bốn phần để tóm tắt 6 tệp trong một phút, rồi kiểm và giữ an toàn.