Chuyện gì thật sự xảy ra bên trong ChatGPT khi bạn hỏi nó
Đi trọn một vòng của một prompt: app đóng gói, safety classifier, tokenizer, data center, attention, từng token một, reasoning và tool use.
✓ Đã duyệt độc lập · cập nhật 22/10/2026 · 12 min
1. Công nghệ đủ tiên tiến thì trông như phép màu
Nick Saraev mở đầu bằng câu: bất kỳ công nghệ nào đủ tiên tiến thì cũng không phân biệt được với phép màu (any sufficiently advanced technology is indistinguishable from magic). Theo anh, AI bây giờ đã tới đúng chỗ đó (nhận định của Nick trong video đăng ngày 19/10/2026). Gần như không ai dùng ChatGPT hay bất kỳ large language model nào thật sự biết chuyện gì xảy ra khi mình bấm gửi một prompt.
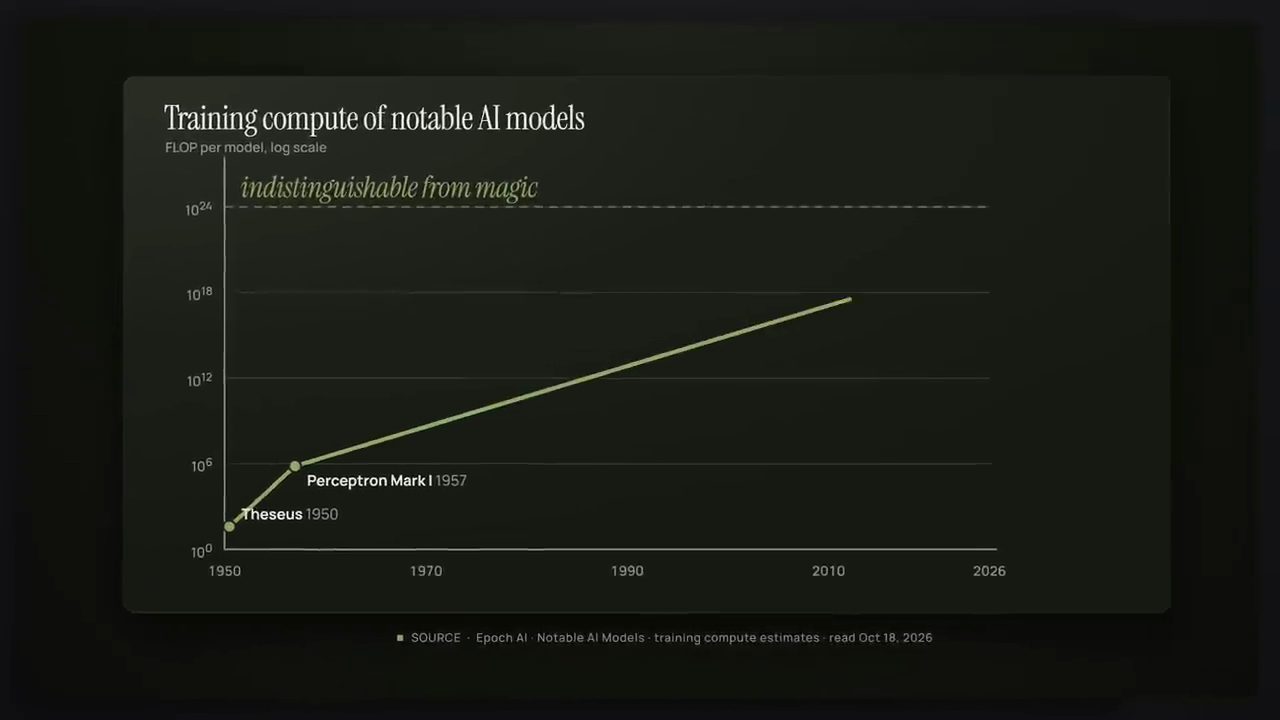
Mục tiêu của video, Nick nói, là sửa điều đó: xem hết video, bạn sẽ biết chuyện gì thật sự diễn ra khi nói chuyện với một AI model, từ phần toán, tới các data center, cho tới khi câu trả lời hiện lên trước mặt bạn. Anh đi lần lượt từng chặng của một vòng đi và về (round trip).
2. ChatGPT không phải là model: app đóng gói tin nhắn của bạn
Chặng đầu tiên: tin nhắn của bạn được đóng gói (packed) bởi chính app bạn đang dùng. Nick nhấn mạnh (video đăng ngày 19/10/2026) rằng ChatGPT thực ra không phải là một AI model. ChatGPT là một ứng dụng dành cho người dùng, bọc quanh một AI model. Khi bạn gõ prompt vào ChatGPT, thứ bạn thật sự làm là đưa prompt vào một ứng dụng, và ứng dụng đó thêm một loạt thứ vào trước khi gửi sang model.
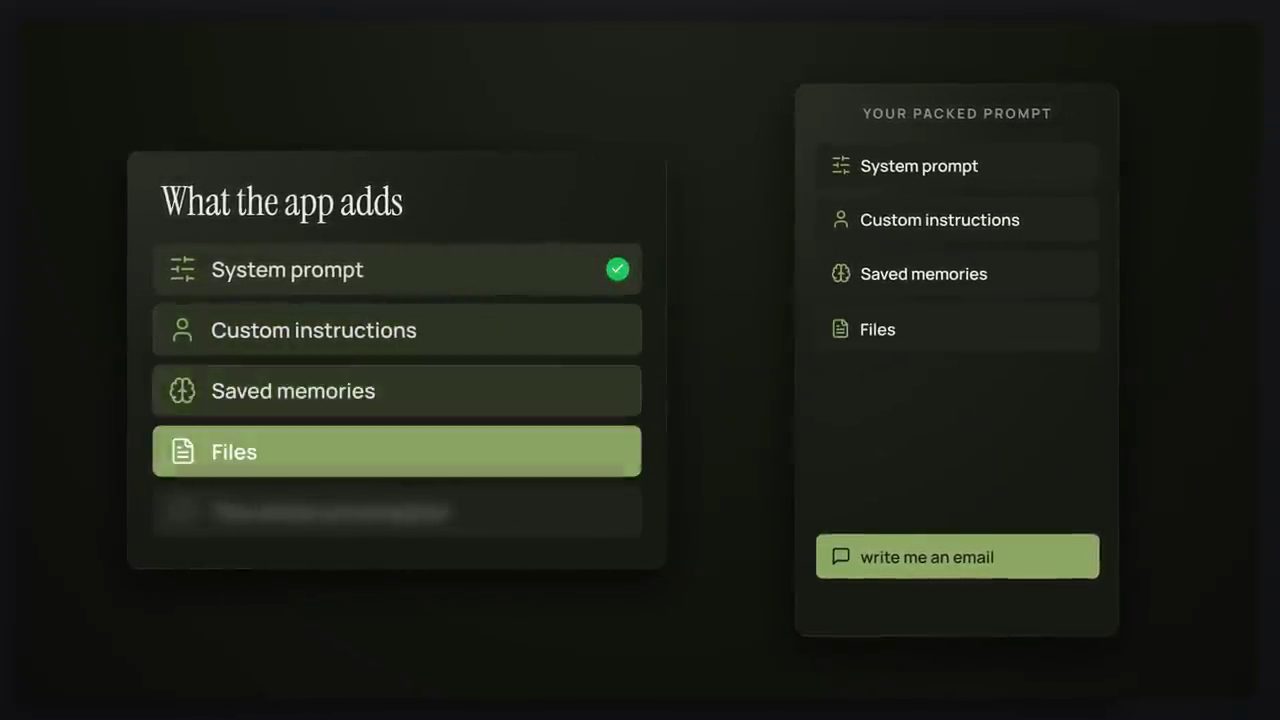
Thứ đầu tiên là system prompt, tức những chỉ dẫn riêng của công ty gửi cho model. Nick kể Anthropic công bố system prompt của Claude trên mạng, và nó dài hơn 3.000 từ (theo video đăng ngày 19/10/2026). Trên màn hình là trang "System prompts" trong tài liệu của Claude: giao diện web claude.ai và app di động dùng một system prompt để đưa thông tin mới nhất, ví dụ ngày hiện tại, cho Claude ở đầu mỗi cuộc hội thoại, và các bản cập nhật này không áp dụng cho Claude API (trang tài liệu đọc ngày 22/10/2026).
System prompt đó mở đầu bằng ngày hôm nay, vì theo Nick, model thường không biết hôm nay là ngày nào: chúng không có sẵn chức năng để tự biết điều đó (video đăng ngày 19/10/2026). Sau system prompt là custom instructions của bạn, các memory đã lưu, những file bạn đính kèm, và quan trọng nhất là toàn bộ cuộc hội thoại tính tới lúc đó.
3. Mỗi lần gửi là gửi lại cả cuộc hội thoại
Vì sao phải gửi cả cuộc hội thoại? Nick giải thích (video đăng ngày 19/10/2026): model không có bộ nhớ dựng sẵn. Chúng làm việc hoàn toàn trong miền văn bản. Nên để model theo kịp bạn đang nói về chuyện gì, mỗi tin nhắn bạn gửi phải kèm theo mọi ký tự bạn đã viết trong cả thread cho tới thời điểm đó, cộng thêm một loạt thứ khác mà anh sẽ nói ngay sau.
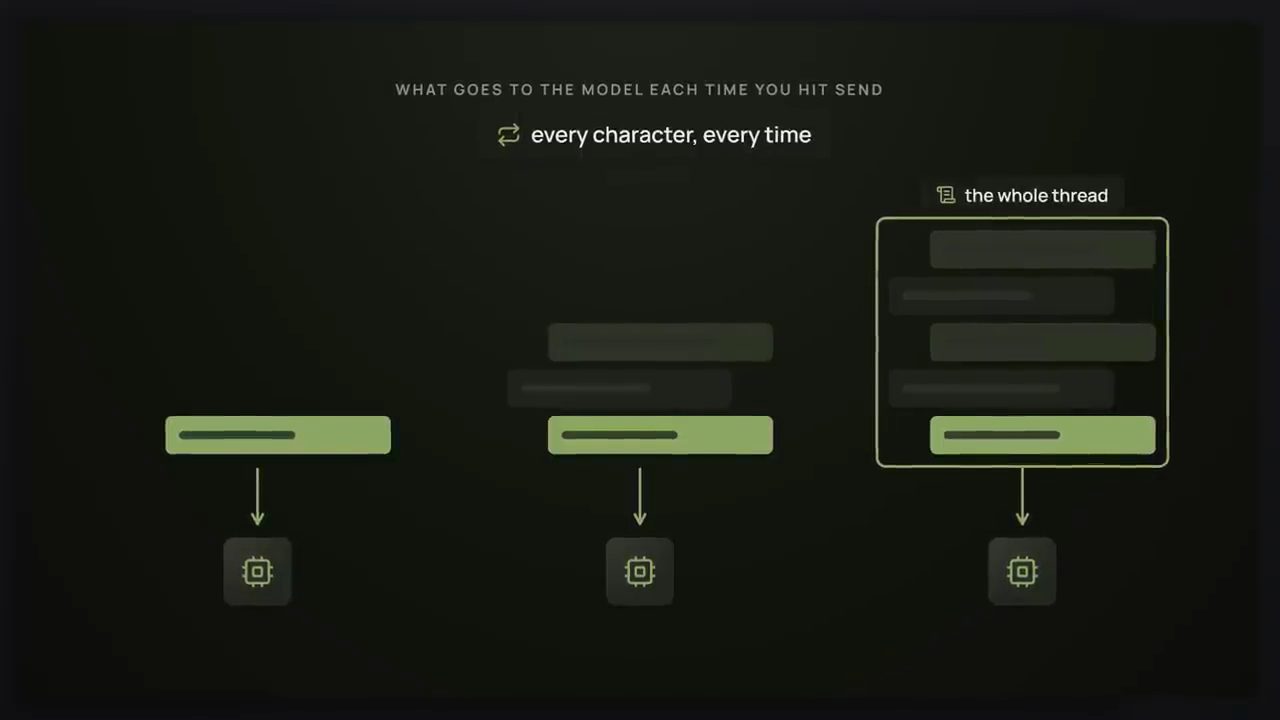
Kết quả là các cuộc chat dài thường trở nên rất, rất dài: rất nhiều chữ, rất nhiều token. Model phải theo dõi tất cả những thứ đó và chạy những phép toán ngày càng phức tạp trên toàn bộ khối văn bản ấy (theo video đăng ngày 19/10/2026).
4. Context rot: chat càng dài, model càng kém ổn định
Chính điều đó, theo Nick, thường dẫn tới việc hiệu năng dao động khi cuộc chat kéo dài, hiện tượng được gọi là context rot. Trên màn hình là bài nghiên cứu "Context Rot" của Chroma: họ đánh giá 18 LLM và thấy model không dùng context một cách đồng đều, hiệu năng ngày càng kém tin cậy khi độ dài input tăng lên (theo bài của Chroma, video đăng ngày 19/10/2026).
Vì sao hiệu năng kém tin cậy dần khi input dài ra? Nick cho rằng đó rốt cuộc là một câu hỏi toán học hơn là gì khác. Đơn giản là có nhiều phép tính trung gian hơn phải thực hiện, và mỗi phép tính trung gian luôn mất đi một chút độ chính xác. Mất rất ít, nhưng vẫn mất (nhận định của Nick, video đăng ngày 19/10/2026).
Ghép tất cả những thứ đó lại với nhau, bạn có packed prompt (prompt đã đóng gói).
5. Safety classifier đọc mọi thứ bạn viết
Chặng tiếp theo: tin nhắn của bạn bị kiểm tra. Kiểm tra là gì? Nick bảo hãy coi nó như một bước xác minh. Về cơ bản, theo Nick (video đăng ngày 19/10/2026), luôn có những model nhỏ hơn theo dõi cuộc hội thoại giữa bạn với model lớn, vì có rất nhiều cách dùng AI không hẳn được coi là an toàn hay có lợi cho xã hội, ví dụ sản xuất ma tuý hay napalm, hoặc các yêu cầu bạo lực.
Hiển nhiên các công ty làm large language model muốn theo dõi người ta đang hỏi model của họ những gì, và muốn chắc rằng model không gửi ngược lại thứ gì có thể bị coi là nguy hiểm. Nên dù bạn thích hay ghét, theo Nick, các safety classifier đang đọc mọi thứ bạn viết (video đăng ngày 19/10/2026).
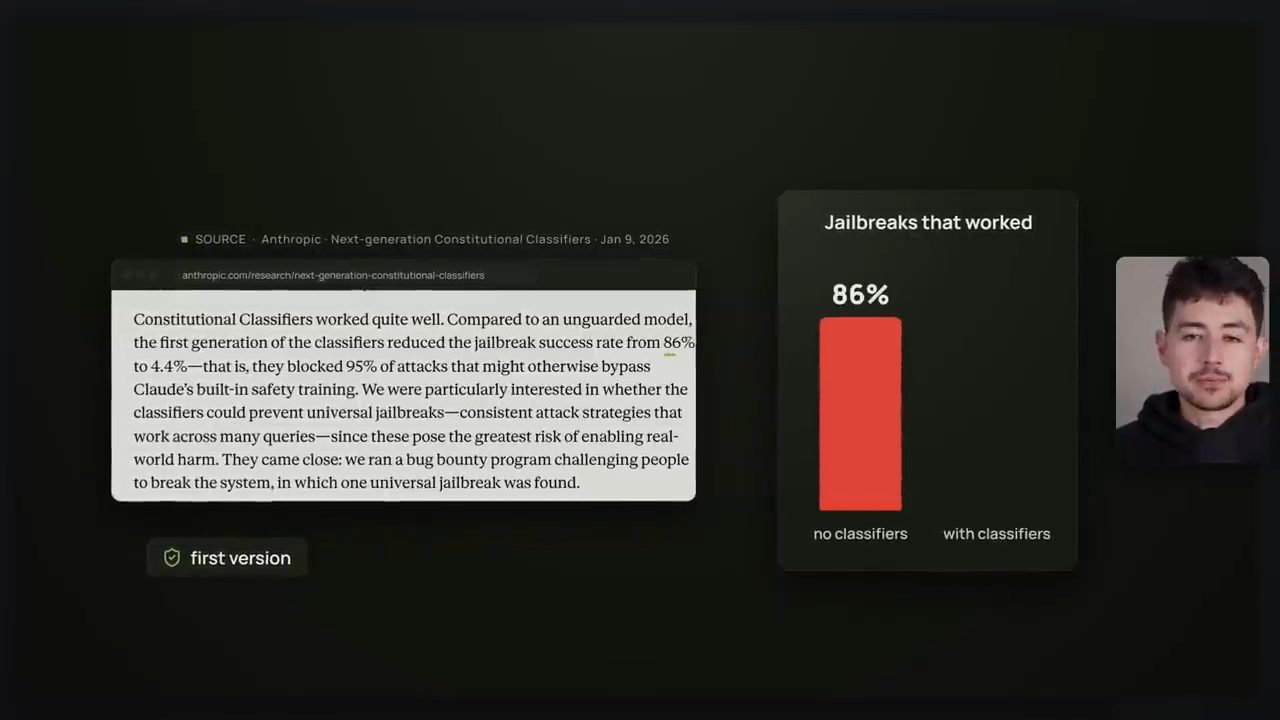
Nick dẫn số: phiên bản classifier đầu tiên của Anthropic đã cắt tỉ lệ jailbreak thành công từ gần 90% xuống chỉ còn khoảng 4 tới 5%; đoạn trích trên màn hình ghi chính xác là từ 86% xuống 4,4% (theo bài của Anthropic, video đăng ngày 19/10/2026). Trước đây, việc này còn tốn thêm rất nhiều compute và xử lý. Giờ đây, theo Nick, nó tốn chưa tới 1% chi phí chạy model (video đăng ngày 19/10/2026). Trang của Anthropic ghi thế hệ classifier mới chỉ thêm khoảng 1% compute (đọc ngày 22/10/2026).
6. Router: tin nhắn "rủi ro" bị chuyển sang model khác
Theo Nick, ChatGPT của OpenAI cũng làm điều tương tự (video đăng ngày 19/10/2026). Nếu họ phát hiện bạn đang dùng model cho một use case họ không thích, họ sẽ chuyển (route) yêu cầu của bạn sang một model khác. Thường đó là một model "ngốc hơn", hoặc một model có thêm các lớp bảo vệ, vì bạn bị coi là rủi ro hơn người dùng trung bình một chút.
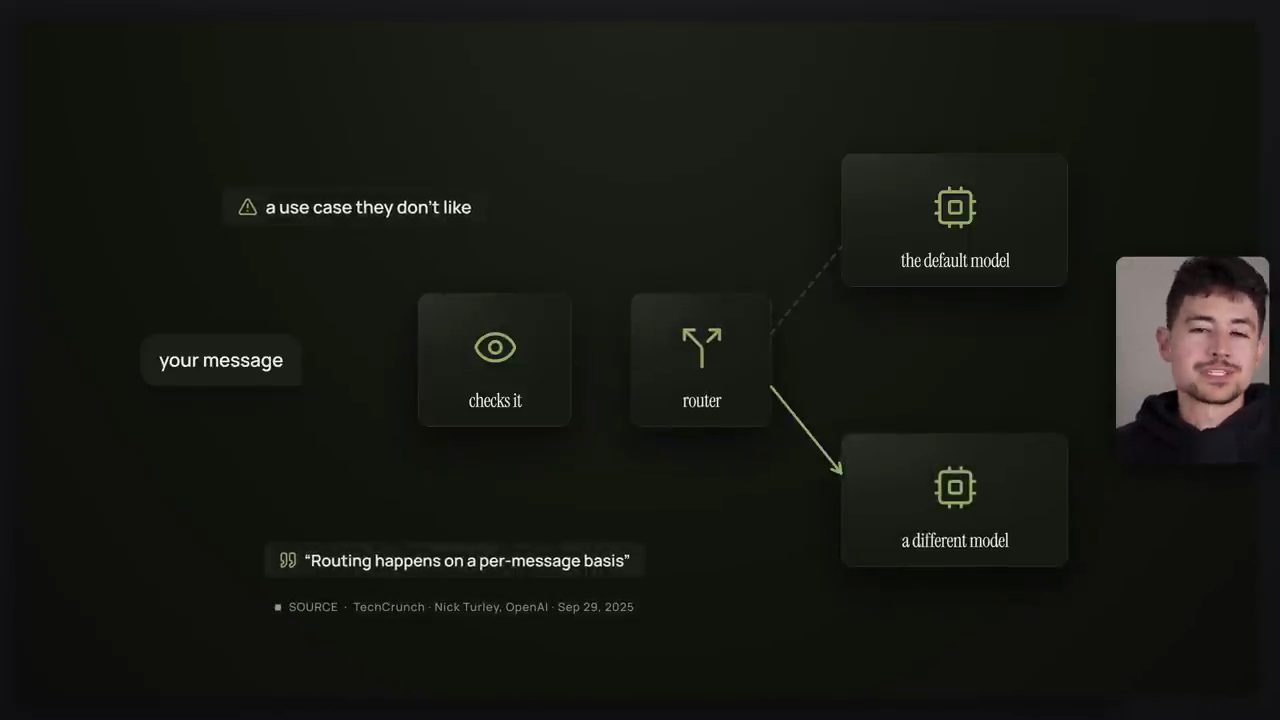
Thêm nữa, Nick nói anh tin rằng nếu bạn dưới 18 tuổi, ChatGPT giờ sẽ chuyển bạn sang một kiểu model "an toàn cho người dưới 18" (theo Nick, video đăng ngày 19/10/2026). Trên màn hình lúc đó là một bài báo về việc OpenAI thêm tính năng dự đoán độ tuổi cho ChatGPT để tăng an toàn cho thiếu niên.
7. Prompt biến thành token
Tới đây, bạn có packed prompt từ bước đầu, và nó đã qua được safety classifier. Bước kế tiếp là đưa nó vào model. Nhưng trước khi làm được vậy, cần biến toàn bộ prompt, vốn đang là một danh sách dài các chữ, thành một định dạng mà model hiểu một cách tự nhiên hơn.
Định dạng đó là token. Theo Nick, token ngắn hơn chữ một chút: trung bình mỗi token vào khoảng 70% một chữ (theo video đăng ngày 19/10/2026). Và model không tự cắt chữ. Có một chương trình làm việc đó cho chúng ta, gọi là tokenizer.
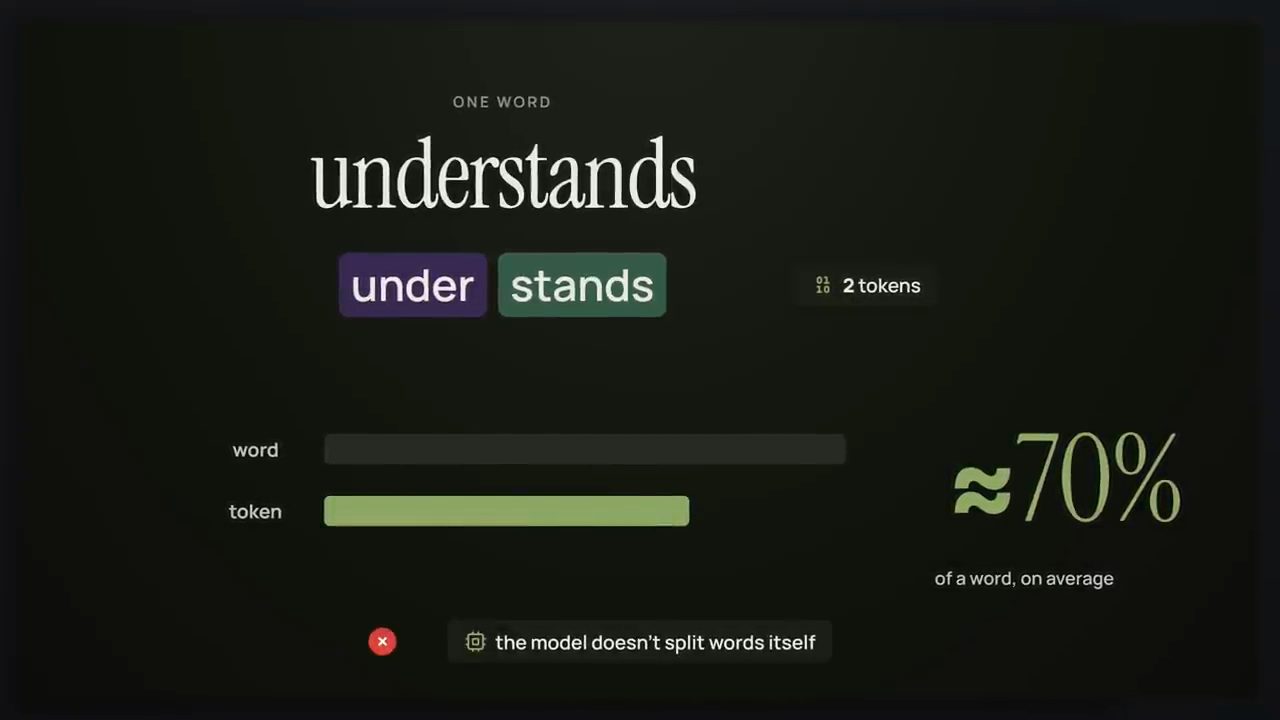
Mỗi tokenizer về cơ bản có một bộ từ vựng nhỏ của riêng nó. Các "từ" trong đó khá giống chữ thường, nhưng thường ngắn hơn một chút. Cùng một token được dùng lại theo nhiều cách khác nhau, giống như các khối Lego có thể ghép ra rất nhiều chữ khác nhau, nên đóng gói theo cách này hiệu quả hơn (theo video đăng ngày 19/10/2026).
Nick nói tokenizer của OpenAI có kích thước từ vựng, tức tổng số token khác nhau, vào khoảng 200.000 (theo video đăng ngày 19/10/2026). Ví dụ, câu hỏi "what actually happens inside ChatGPT when you ask it something" là 12 token. Riêng chữ ChatGPT là 2 token: "chat" và "GPT".
8. Vì sao model hay sai chính tả và tính toán
Chữ "strawberry" là 3 token: "st", rồi "raw", rồi "berry". Model không thực sự nhìn thấy từng chữ cái riêng lẻ, nó chỉ thấy các token. Theo Nick, đó là lý do cho tới cách đây không lâu, model vẫn thường xuyên sai khi bạn đưa vào những chuỗi tinh tế kiểu này (nhận định trong video đăng ngày 19/10/2026).
Thêm nữa, các con số cũng bị cắt nhỏ. Điều thú vị là không phải số 1 là một token, số 2 là một token, số 3 là một token, cứ thế. Tokenizer thật ra gom các chữ số lại theo tần suất xuất hiện, tạo ra những token trông khá kỳ quặc. Ví dụ Nick đưa ra là con số 12345678901: trên màn hình, 11 chữ số đó thành 4 token (theo video đăng ngày 19/10/2026).
Bằng cách này, các con số được chia khúc và biến thành một dạng biểu diễn hiệu quả hơn một chút. Nhưng nó cũng sinh ra những hiệu ứng lạ (weird artifacts), như việc model không giỏi toán. Lý do là model không nhận cả con số cùng lúc như một khối gọn gàng, tách biệt; thường nó nhận con số đã bị chẻ ra thành nhiều mảnh (theo video đăng ngày 19/10/2026).
9. Mỗi ngôn ngữ tốn một lượng token khác nhau
Cuối cùng trong phần token, Nick nói các ngôn ngữ khác nhau tiêu tốn số token khác nhau, vì chữ và câu bị tách theo những cách hơi khác nhau. Ví dụ, cụm "hello world" trong tiếng Anh vào khoảng 2 token, còn cụm tương đương trong tiếng Hindi vào khoảng 5 token (theo video đăng ngày 19/10/2026).
Về cơ bản, theo Nick, tiếng Anh là một trong những ngôn ngữ tiết kiệm token nhất, và đó là lý do phần lớn model mặc định dùng tiếng Anh. Anh nói thêm, lý do còn bao gồm cả chuyện tiền: số tiền bạn kiếm được ở thị trường tiếng Anh so với, chẳng hạn, thị trường tiếng Hindi (nhận định của Nick, video đăng ngày 19/10/2026).
Tất cả những điều này, Nick nói, đáng để hiểu nếu bạn thật sự muốn nắm sâu cách model hoạt động bên dưới.
10. Token bay tới data center
Sau bước đó, toàn bộ token được gửi tới một data center. Các large language model này không nằm trên điện thoại hay máy tính của bạn. Chúng nằm trong những toà nhà chứa đầy chip, thường cách bạn hàng trăm, có khi hàng nghìn dặm (theo video đăng ngày 19/10/2026).
Ví dụ, Google có rất nhiều data center. Nick kể một trong số đó xử lý hơn 3,2 triệu tỷ (quadrillion) token mỗi tháng (theo video đăng ngày 19/10/2026). "Không phải một triệu. Không phải một tỷ, cũng không phải một nghìn tỷ. Mà là một triệu tỷ", anh nhấn từng bậc trong khi màn hình hiện lần lượt "a million" kèm 1,000,000. Rồi anh đùa: nói gì thì nói, đúng là lắm token thật.
Theo Nick, chip chạy các model hầu hết là GPU của NVIDIA (video đăng ngày 19/10/2026). Trên màn hình là trang sản phẩm NVIDIA GB300 NVL72.
11. Người dùng khác cũng làm đổi câu trả lời của bạn
Khi yêu cầu của bạn tới nơi, nó không chỉ đi vào một con chip. Chuỗi token bạn gửi bị chặt ra và được gom thành batch cùng yêu cầu của rất nhiều người khác để tiết kiệm compute. Nghĩa là một GPU thường phục vụ nhiều người cùng lúc, chia các yêu cầu vào bất cứ chỗ trống nào có tại mỗi thời điểm (theo video đăng ngày 19/10/2026).
Đây là phần Nick gọi là "thật sự điên rồ": những người khác đang dùng cùng GPU với bạn có thể làm thay đổi một cách căn bản cách AI model phản hồi bạn. Gửi một mình, hay gửi khi có nhiều người khác cùng chia GPU, do kinh tế của batch size thay đổi và các phép tính liên quan, cộng thêm có lẽ cả những thứ như, anh nói đại, nhiệt độ của GPU, đều có thể ảnh hưởng tới phép toán tạo ra câu trả lời của bạn (theo Nick, video đăng ngày 19/10/2026).
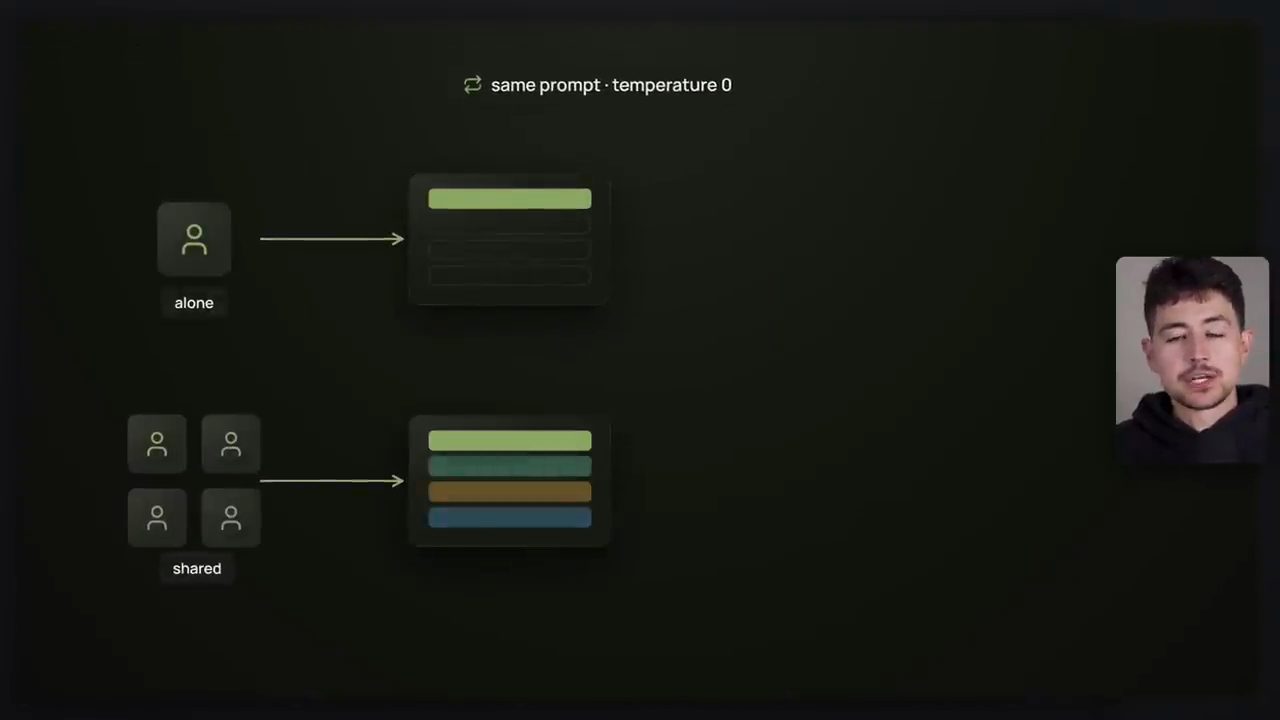
Nên, Nick nói, hãy cẩn thận xem mình đang chia GPU với ai.
12. Model chạy: attention
Xong hết những bước trên, tới lúc model thật sự chạy. Ở đây, token của bạn đi qua hàng chục, có khi hàng trăm lớp (layer) phép toán. Nick bảo hãy hình dung một phương trình với rất, rất, rất nhiều biến, và rất nhiều hàm được áp dụng bên trong (theo video đăng ngày 19/10/2026).
Theo Nick (video đăng ngày 19/10/2026), phần lớn thiết kế của phần toán này ở thời điểm đó bắt nguồn từ một paper năm 2017 do Google công bố, tên là "Attention Is All You Need". Paper đề xuất một thuật toán mới gọi là attention, cho phép model nhìn vào mọi chữ trong prompt cùng một lúc để thử hiểu từng chữ mang nghĩa gì trong ngữ cảnh.
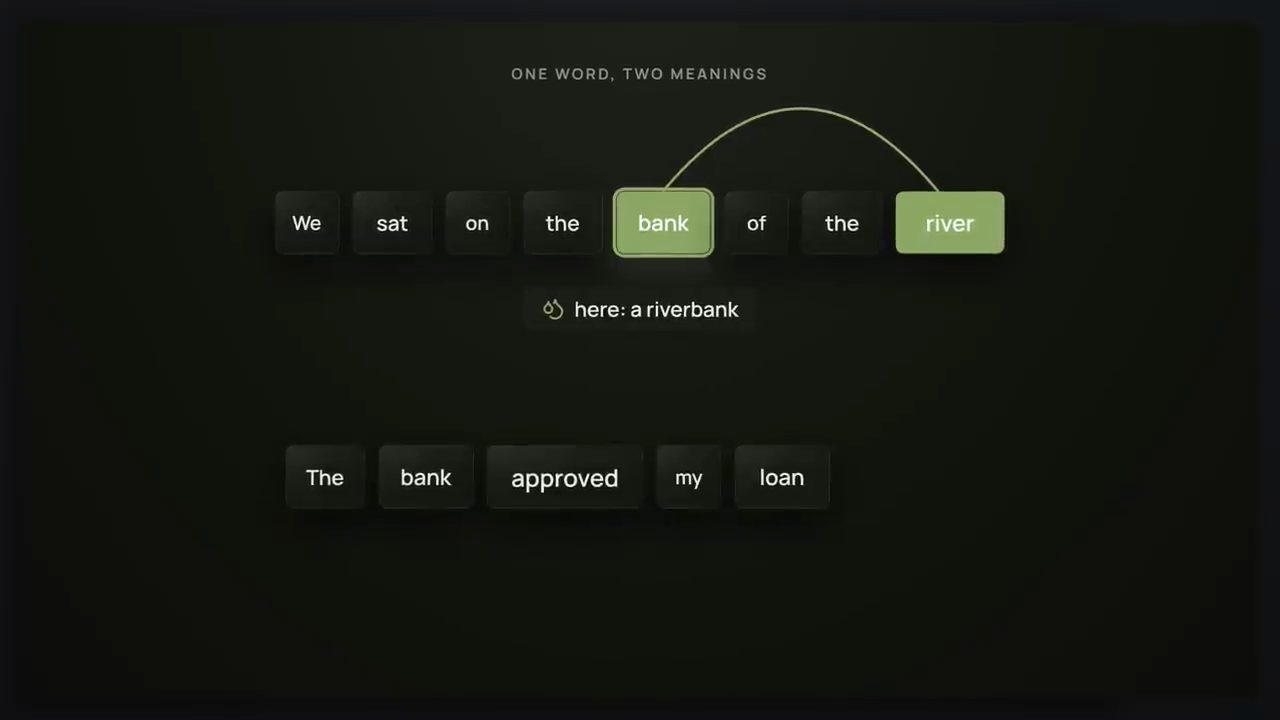
Ví dụ của Nick (video đăng ngày 19/10/2026): nếu một câu có chữ "bank" và, nói đại, chữ "river", thì rõ ràng nó mang một nghĩa khác, đúng không? "Bank" trong ngữ cảnh này là bờ sông. Còn nếu câu có chữ "bank" nhưng lại có chữ "loan" (khoản vay), thì giờ "bank" mang một nghĩa hoàn toàn khác. Attention cho phép model "chú ý" tới mọi thành phần của một câu, một cụm từ hay một chuỗi token, và nhờ đó hiểu hiệu quả hơn ngữ cảnh của từng chữ riêng lẻ.
13. Hàng tỷ parameter
Nick nói GPT-3 có 185 tỷ parameter (theo video đăng ngày 19/10/2026). Nói gọn lại, đó là 185 tỷ con số được theo dõi độc lập, nằm trong một "vector của các vector" khổng lồ gọi là ma trận (matrix). Các ma trận này được nhân với nhau rất nhiều lần, theo những cấu hình rất thú vị, để tạo ra một phân phối thống kê nhỏ của các chữ mà bạn đang muốn mô hình hoá.
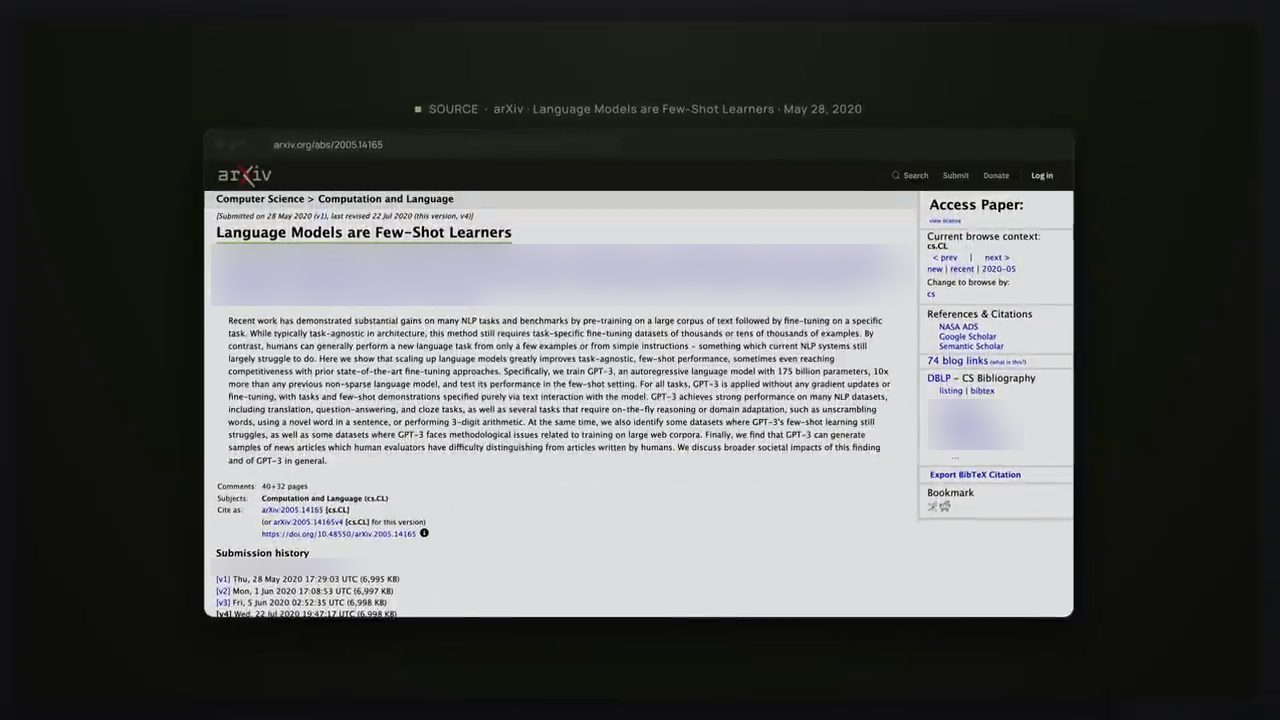
Trên màn hình lúc này là paper GPT-3, phần tóm tắt ghi 175 tỷ parameter. Nick nói phần cơ chế của machine learning và deep learning cực kỳ thú vị, và ai muốn tìm hiểu sâu hơn thì xem video anh gắn link ở phía trên.
14. Mỗi lần chỉ một token
Chạy xong một lượt (one pass), thực chất model mới dự đoán được đúng một token. Nhưng ta thường muốn nhiều hơn một token, đúng không? Nên sau khi sinh ra kết quả với một token mới, model phải đưa toàn bộ chuỗi đó quay lại vào chính nó để sinh ra token tiếp theo (theo video đăng ngày 19/10/2026).
Theo Nick, model chỉ sinh được một token đầu ra mỗi lần, hoặc ít nhất đó là cách được ưa dùng ở thời điểm video đăng ngày 19/10/2026. Nghĩa là với một câu hỏi đơn giản như hai token "chat" "GPT", ta sẽ phải chạy toàn bộ quá trình hai lần. Hy vọng tới đây bạn hiểu vì sao kinh tế của GPU và data center trở nên quan trọng đến vậy: ta đang chạy rất nhiều phép toán, rất nhanh, rất nhiều lần.
Nếu bạn từng thắc mắc vì sao thấy câu trả lời chảy dần (stream) vào ô chat trong lúc model đang "nói", thì đây là lý do. Các công ty đã nhận ra là phục vụ bạn từng chữ, từng token một thì hiệu quả hơn. Đó là những gì thật sự đang diễn ra: mỗi chữ, mỗi token bạn nhận được đều đang được sinh ra trực tiếp ngay lúc đó (theo video đăng ngày 19/10/2026).
Đó cũng là lý do bạn có thể dừng output của model, theo đúng nghĩa đen là dừng ở token đó, có khi giữa chừng một câu, hoàn toàn (theo video đăng ngày 19/10/2026).
15. Vì sao model hallucinate
Vì việc của model không hẳn là đưa cho bạn sự thật hay gì cả, mà chỉ là đưa ra một phân phối của những token tiếp theo có khả năng cao nhất về mặt thống kê trong một chuỗi, nên theo Nick, model hallucinate khá thường xuyên (theo video đăng ngày 19/10/2026).
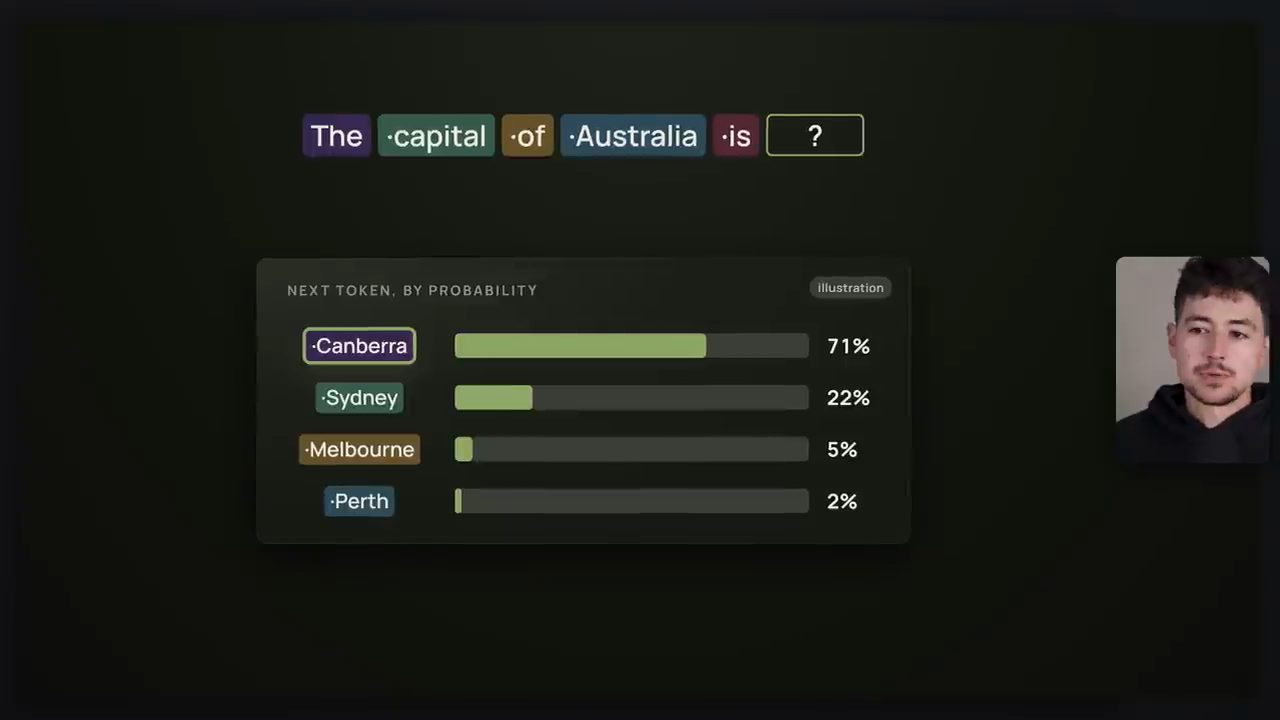
Theo Nick, chuyện này liên tục tốt lên qua mỗi thế hệ model mới, cùng với contextual grounding và training, nhưng vẫn rất đáng để ghi nhớ (nhận định trong video đăng ngày 19/10/2026).
16. Ngã ba: dừng, reasoning, hay dùng tool
Sau khi model đã sinh ra một ít văn bản, một ít output token, ta tới một ngã ba, về cơ bản là một quyết định. Theo Nick (video đăng ngày 19/10/2026), quyết định này được thêm vào từ năm 2023 (màn hình cũng ghi "added in 2023"), và đó là lựa chọn giữa: dừng việc đang làm, reasoning, hoặc dùng một tool.
Reasoning là gì? Nick giải thích (video đăng ngày 19/10/2026): đó là khi model lấy output của mình rồi đưa toàn bộ output đó quay lại làm input, trong một phần reasoning bị ẩn đi, để nó được xem đi xem lại câu trả lời bốn, năm, một trăm, một nghìn lần trước khi trình bày cho bạn. Model tạo ra một chuỗi suy nghĩ nội bộ (chain of thought) trong lúc cố đi qua từng bước để giải bài toán của bạn.
Chuỗi suy nghĩ đó thường có những chữ rào đón như "but", "yet", "however", "also", "and", vân vân. Theo Nick (video đăng ngày 19/10/2026), những chữ này được chèn vào làm chữ đầu tiên của dòng tiếp theo để dẫn hướng reasoning của model sang một hướng có thể khác hẳn, đồng thời ép nó so sánh mọi khả năng có thể xảy ra.
Vì model luôn chọn theo phân phối những token tiếp theo có khả năng cao nhất trong câu, nếu bạn mở đầu bằng "but", nó sẽ luôn có xu hướng tìm ra một phản ví dụ nào đó cho điều nó vừa nói trước đó. Bằng cách này, theo Nick, model về cơ bản được tự kiểm tra lại và đưa cho bạn một kết quả cuối có chất lượng cao hơn (video đăng ngày 19/10/2026).
17. Tool use và trọn một vòng
Lựa chọn còn lại là model dùng một tool. Nick giải thích (video đăng ngày 19/10/2026): thứ ta đã làm là nối model với đủ loại ứng dụng phần mềm. Ta làm cho các ứng dụng đó nhận văn bản vào, và tuỳ vào văn bản nhận được, phần mềm có thể làm một việc gì đó.
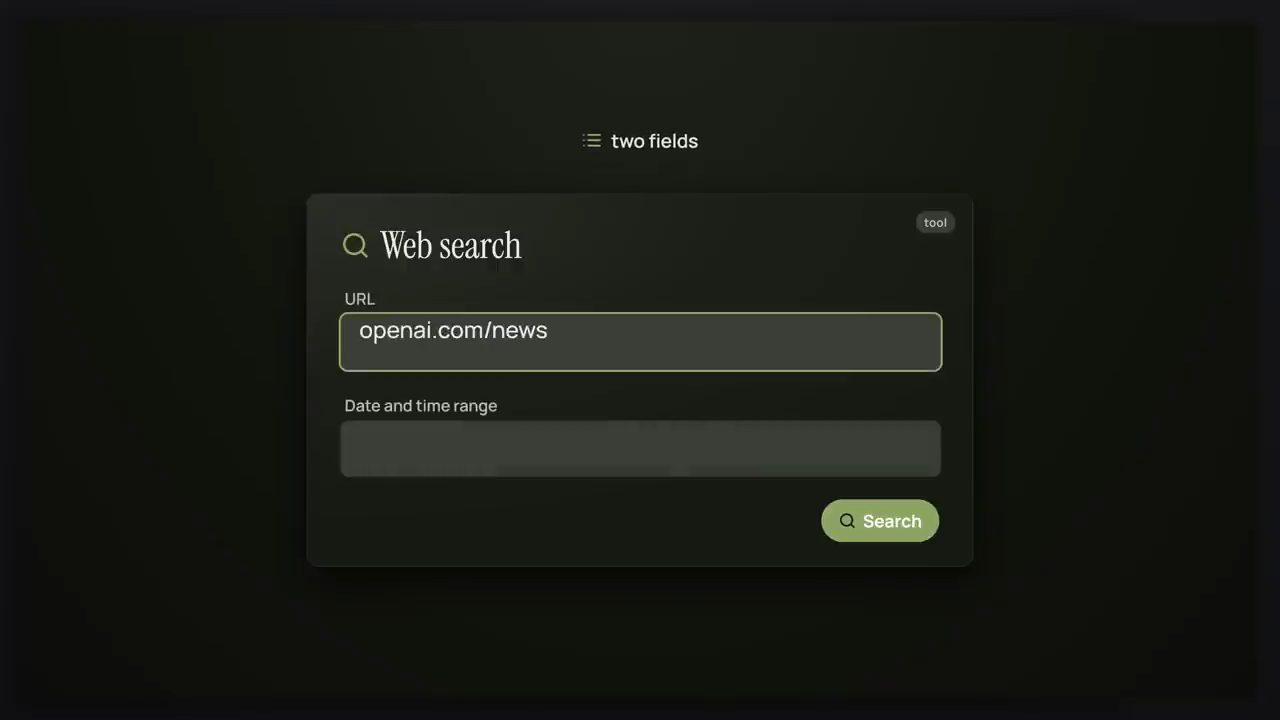
Ví dụ, có thể ta có một ứng dụng web search với hai trường: URL, và khoảng ngày giờ bạn muốn tìm kết quả. Có thể bạn đưa hai thứ đó vào một search engine phổ biến như Google, DuckDuckGo, hoặc có khi là Ecosia, và nó trả về một danh sách kết quả. Không phải model của ta đi ra ngoài lấy kết quả về. Đó là ứng dụng phần mềm, nhưng model có thể gọi ứng dụng đó để lấy kết quả (theo video đăng ngày 19/10/2026).
Sau đó model đưa kết quả của tool vào lại (pipe in), rồi lại chọn: dừng câu trả lời, reasoning thêm, hay dùng một tool khác. Và nó cứ lặp đi lặp lại vòng đó cho tới khi tự thấy hài lòng với chất lượng câu trả lời, rồi mới đưa cho bạn hoặc cho tôi (theo video đăng ngày 19/10/2026).
Vậy đó, Nick nói, đó là toàn bộ vòng đi và về. Và tất cả diễn ra theo đúng nghĩa đen chỉ trong vài giây. Anh nghĩ khi model ngày càng nhanh hơn, độ trễ (latency) nhiều khả năng sẽ tiếp tục giảm, cho tới khi về cơ bản ta nhận được câu trả lời với tốc độ của suy nghĩ (dự đoán của Nick, video đăng ngày 19/10/2026).
Nick nói anh rất thích đào sâu vào cách model hoạt động như thế này. Ai có câu hỏi về quy trình này thì cứ để lại bình luận bên dưới, và anh mời mọi người góp ý chủ đề cho video sau, vì phần lớn ý tưởng của anh đến thẳng từ khán giả. Anh chào và hẹn gặp lại ở video tiếp theo.
Nguồn và liên kết 10 nguồn
- Tên gốc: What Actually Happens Inside ChatGPT When You Ask It Something
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=hhHkaZRwBBU youtube.com
- Kênh YouTube Nick Saraev (Nick Saraev): youtube.com/channel/UCbo-KbSjJDG6JWQ_MTZ_rNA youtube.com
- Anthropic, trang System prompts trong tài liệu Claude (system prompt của claude.ai và app di động, đọc ngày 22/10/2026): platform.claude.com/docs/en/release-notes/system-prompts claude.ai
- Chroma, "Context Rot: How Increasing Input Tokens Impacts LLM Performance": trychroma.com/research/context-rot trychroma.com
- Anthropic, "Next-generation Constitutional Classifiers" (86% xuống 4,4% với thế hệ đầu, đọc ngày 22/10/2026): anthropic.com/research/next-generation-constitutional-classifiers anthropic.com
- Thinking Machines, "Defeating Nondeterminism in LLM Inference": thinkingmachines.ai/blog/defeating-nondeterminism-in-llm-inference thinkingmachines.ai
- Paper "Attention Is All You Need" (2017): arxiv.org/abs/1706.03762 arxiv.org
- Paper GPT-3, "Language Models are Few-Shot Learners" (2020): arxiv.org/abs/2005.14165 arxiv.org
Related talks
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Bỏ tokenmaxxing: 4 kỹ thuật context engineering cho AI agent
Morgan Willis · AWS Developers · 22 min
Bốn nhóm kỹ thuật context engineering (compress, externalize, select, isolate) cho AI agent, kèm demo code Strands và dòng context_manager="auto".
Laravel MCP 1.0: tool search cho MCP server
Christoph Rumpel · Laravel · 18 min
Build một MCP server trong app Laravel, nối vào Claude Desktop, rồi dùng ToolSearch của Laravel MCP 1.0 để chỉ gửi hai tool và giảm token.