Jev là gì? Model AI không sinh ra văn bản
Martin Keen giải thích Jev, model System 1 trả về xác suất đã calibrate thay vì văn bản, cách dùng ngưỡng trong code và ghép với LLM.
✓ Đã duyệt độc lập · cập nhật 24/10/2026 · 15 min
1. Jev: một model AI không viết ra chữ nào
Martin Keen, Master Inventor ở IBM, mở đầu bằng việc giới thiệu chủ đề: Jev. Theo anh trong video đăng ngày 01/10/2026, Jev là một model AI mới của một startup tên là TypeSafe, và nó hơi khác thường ở chỗ đây là một model AI không hề viết ra chữ nào. Thay vào đó, nó trả lời câu hỏi bằng cách chọn từ một danh sách cho sẵn, rồi đưa ra một xác suất cho từng câu trả lời của nó.
Martin kể rằng TypeSafe gọi đây là một loại model AI mới, một model "System 1" (video đăng ngày 01/10/2026). Cái tên này mượn từ Daniel Kahneman, trong cuốn sách Thinking, Fast and Slow, một trong những cuốn sách Martin thích nhất.
2. System 1 và System 2 theo Kahneman
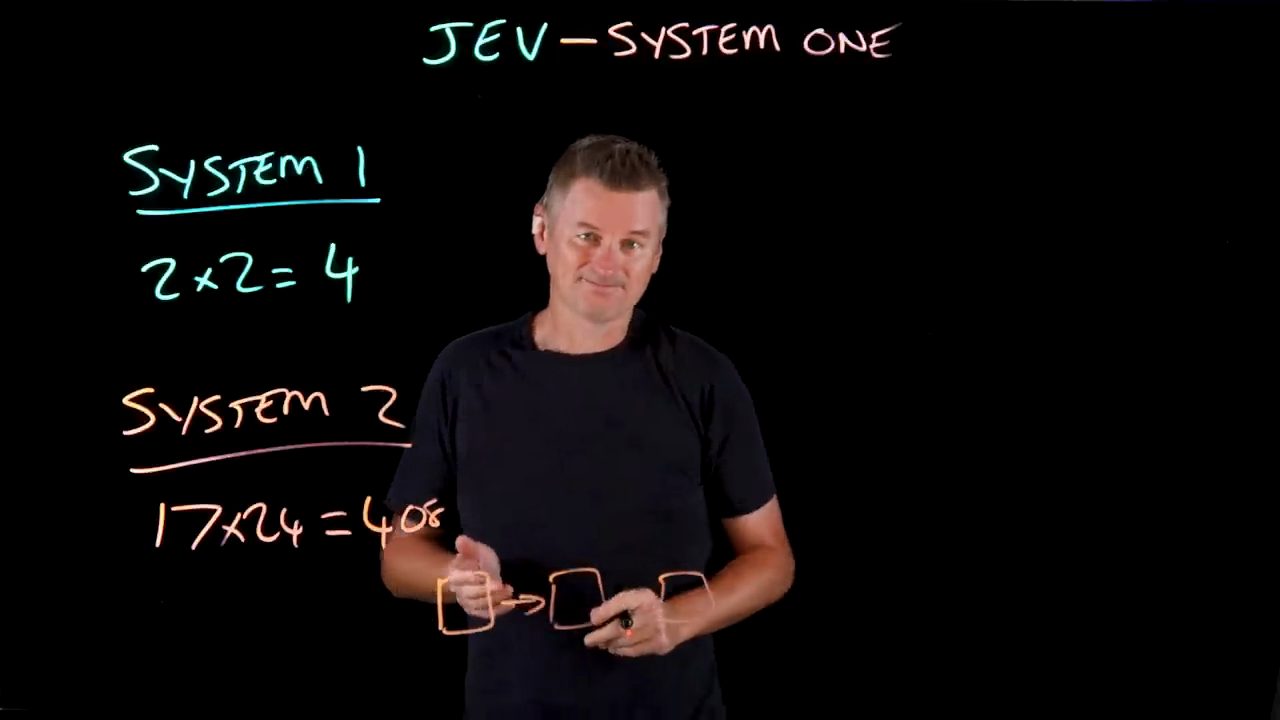
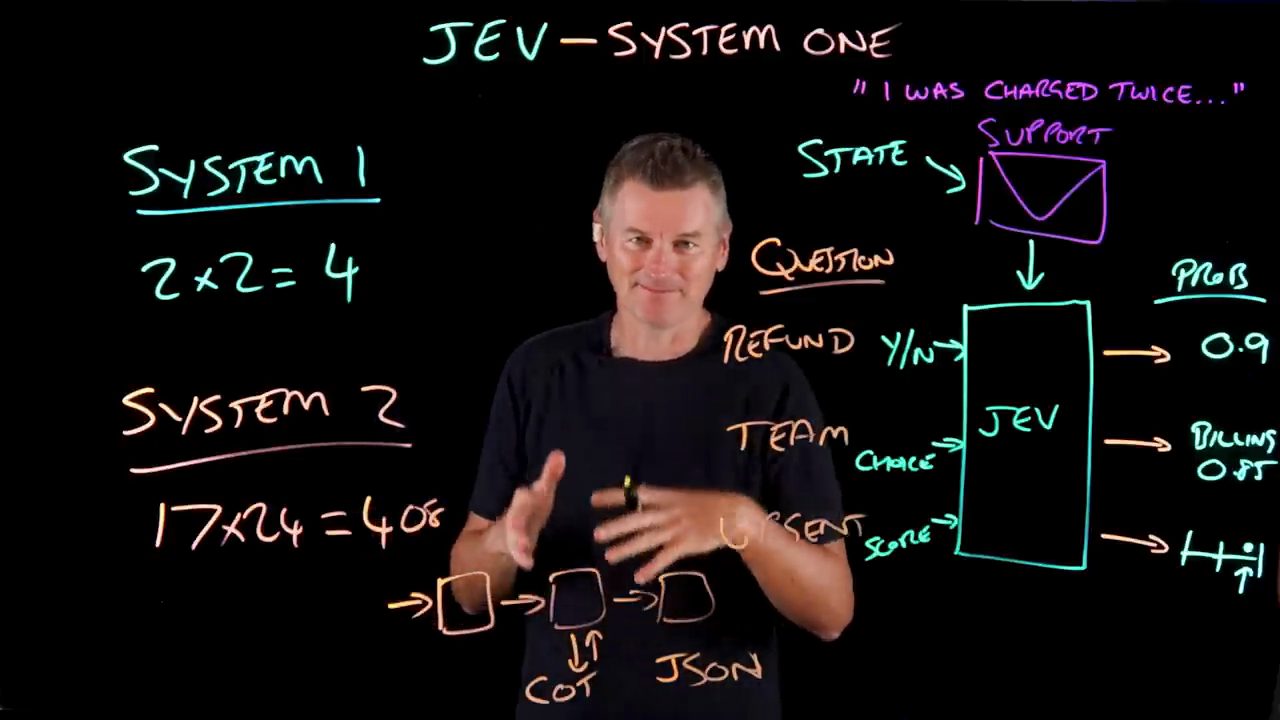
Kahneman mô tả hai chế độ suy nghĩ, ở đây là suy nghĩ của con người. Chế độ đầu tiên được gọi là System 1, và kiểu suy nghĩ System 1 thì nhanh và tự động. Martin lấy ví dụ: hai nhân hai bằng mấy? Bạn biết ngay câu trả lời là bốn mà không cần thật sự tính trong đầu. Đó là suy nghĩ System 1.
Kiểu suy nghĩ còn lại được xếp vào System 2, và nó chậm, có chủ đích. Nếu Martin hỏi 17 nhân 24 bằng bao nhiêu, nhiều khả năng bạn phải làm từng bước một mới ra được. Hoặc, như anh nói thêm, bạn cứ nhìn đáp án trên teleprompter, là 408. "Đây rồi. Xong." Trên bảng, anh ghi hai dòng: "System 1: 2×2 = 4" và "System 2: 17×24 = 408".
3. Chatbot, reasoning model và những quyết định nhanh trong phần mềm
Martin nói phần lớn các model AI chúng ta dùng (tính đến video đăng ngày 01/10/2026) được xây ra để viết. Một chatbot tạo câu trả lời từng token một, mỗi token qua một forward pass. Trên bảng, anh vẽ một chuỗi ô vuông nối nhau bằng mũi tên để minh hoạ việc sinh từng token.
Một reasoning model thì đi xa hơn một chút: nó viết ra cả chain of thought trong lúc làm, nên bạn phần nào thấy được nó đang nghĩ gì. Theo Martin (video đăng ngày 01/10/2026), đó về cơ bản là thứ gần nhất với một model System 2 mà AI có được. Trên bảng, anh ghi "COT" với mũi tên hai chiều bên dưới chuỗi ô.
Nhưng, anh nói tiếp (video đăng ngày 01/10/2026), rất nhiều quyết định bên trong phần mềm thật ra không phải System 2. Chúng chỉ là những phán đoán nhanh (quick judgment calls).
4. Ví dụ: một email gửi bộ phận hỗ trợ và ba câu hỏi
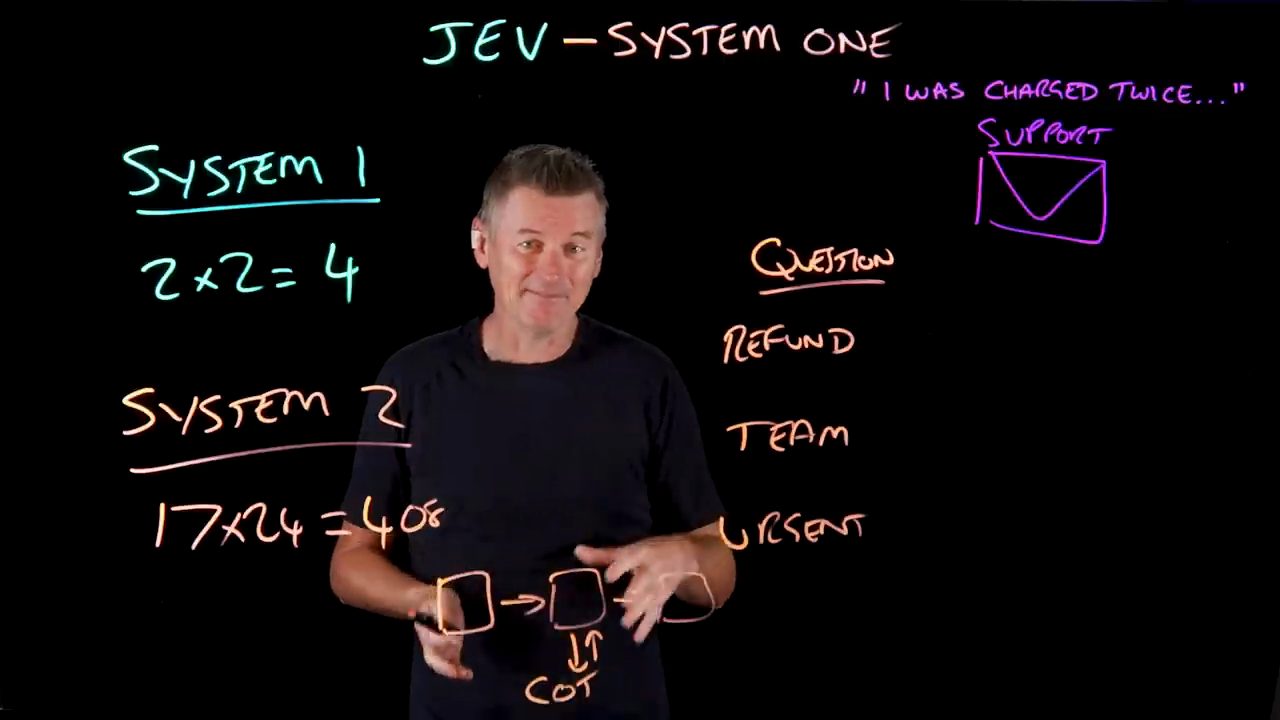
Để minh hoạ, Martin đưa ra một ví dụ. Giả sử có một email gửi bộ phận hỗ trợ khách hàng, và email đó viết: "Tôi bị trừ tiền hai lần trong tháng này, làm ơn sửa giúp." Trên bảng anh ghi câu trích "I was charged twice..." cạnh hình phong bì có nhãn "Support".
Vậy phản hồi email này thế nào? Phần mềm xử lý email này nhiều khả năng phải xét ba loại câu hỏi:
- Refund: đây có phải yêu cầu hoàn tiền không? Có hay không.
- Team: team nào cần xử lý email này? Có thể là team billing, có thể là team hỗ trợ kỹ thuật, hoặc có thể là team sales.
- Urgent: yêu cầu này gấp tới mức nào? Cần phản hồi nhanh cỡ nào?
Một người chỉ lướt qua email như vậy sẽ biết ngay lập tức: hoàn tiền à, có, đây là yêu cầu hoàn tiền. Martin gọi đó là một việc kiểu System 1. Và theo anh, trong video đăng ngày 01/10/2026, chính loại việc đó là thứ Jev được xây ra để làm.
5. Cách làm phổ biến với LLM và chỗ còn thiếu
Martin mô tả một cách phổ biến (tính đến video đăng ngày 01/10/2026) để tự động hoá bài toán email hỗ trợ như thế này bằng một LLM: gửi email này cho LLM và yêu cầu nó trả lời các câu hỏi trên theo một định dạng có cấu trúc. Email đi qua large language model, model sinh ra một chuỗi token, và các token đó biểu diễn định dạng, có thể là JSON. Trên bảng anh ghi chữ "JSON" ở cuối chuỗi ô.
Theo Martin (video đăng ngày 01/10/2026), cách đó phần lớn chạy được, nhưng nó không trả về một cảm nhận đáng tin cậy về việc model chắc chắn tới mức nào. Một large language model tự tin bao nhiêu rằng nó đã trả lời đúng các câu hỏi này? Ta có thể hỏi thẳng model, nhưng anh nói rằng bất cứ thứ gì nó trả lời cũng chưa chắc khớp với xác suất thật mà model đã dùng để đi tới câu trả lời đó.
6. Jev nhận vào state và các câu hỏi
Theo Martin (video đăng ngày 01/10/2026), Jev thì có đưa ra xác suất. Nếu gửi những câu hỏi này cho Jev, ta sẽ nhận về một phản hồi trông rất khác.
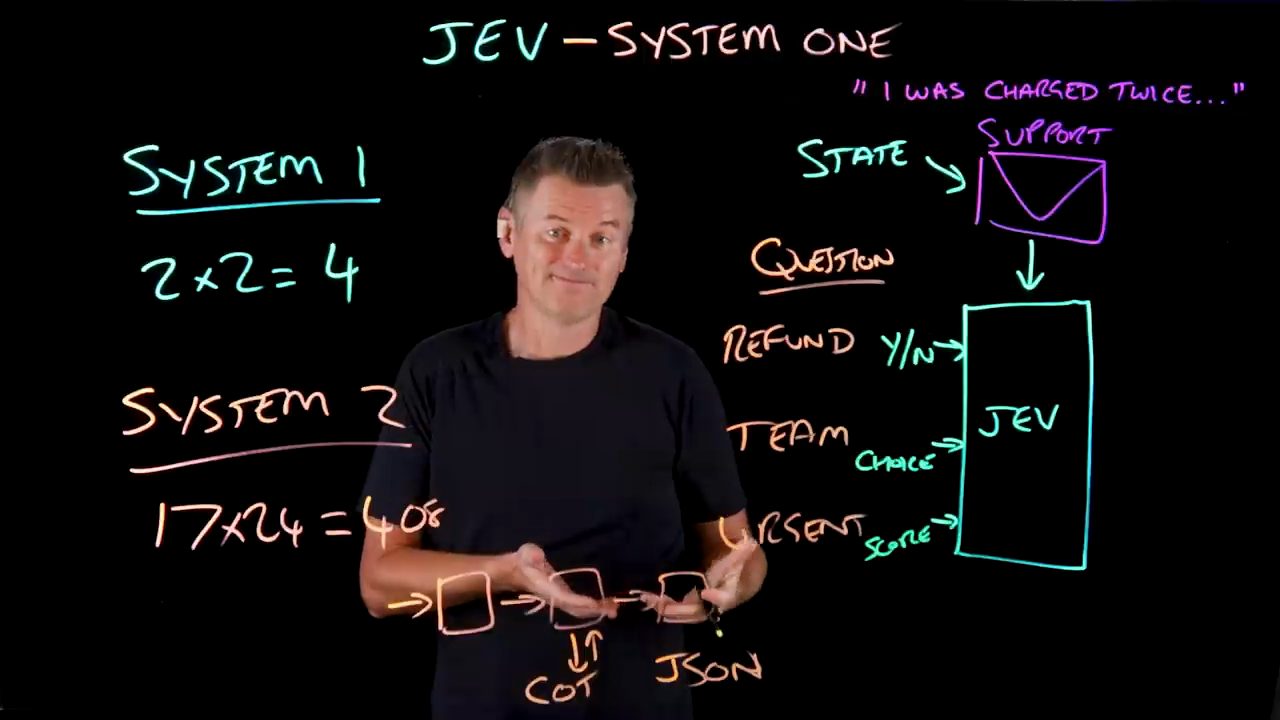
Theo cách Martin trình bày (video đăng ngày 01/10/2026), Jev nhận vào hai thứ. Thứ nhất là cái được gọi là state: dữ liệu mà quyết định xoay quanh. Trong ví dụ, state có thể gồm email hỗ trợ, và cũng có thể gồm cả các lần trừ tiền gần đây của khách hàng. Tất cả được đưa vào model Jev. Thứ hai, Jev cũng nhận từng câu hỏi trên làm đầu vào. Trên bảng, Martin viết chữ "State" có mũi tên chỉ vào phong bì, phong bì có mũi tên đi xuống một khối chữ nhật lớn ghi "JEV", và ba câu hỏi có mũi tên đi vào cạnh trái của khối đó.
7. Ba kiểu câu hỏi trong cùng một request
Martin chỉ ra rằng ba câu hỏi của ví dụ thật ra là ba kiểu câu hỏi khác nhau (theo video đăng ngày 01/10/2026):
- Refund là câu hỏi có hoặc không, kiểu mà TypeSafe gọi là Noul (theo video đăng ngày 01/10/2026). Trên bảng anh ghi "Y/N".
- Team rốt cuộc là một lựa chọn: đây là team nào. Tức là chọn một phương án trong một danh sách, trên bảng ghi "Choice".
- Urgent rốt cuộc là một điểm số trên thang từ thấp tới critical, trên bảng ghi "Score".
Tài liệu của TypeSafe (đọc ngày 24/10/2026) cũng liệt kê đúng ba kiểu câu hỏi này với tên Noul, Choice và Score, và mô tả Noul là câu hỏi có hoặc không, trả về xác suất để câu trả lời là "có".
Cả ba câu hỏi đi vào trong một request duy nhất. Martin so sánh (video đăng ngày 01/10/2026): trong khi một LLM viết câu trả lời JSON ra từng token một, Jev không sinh ra chữ nào, nên cả ba câu trả lời quay về cùng một lúc. Theo anh, đó là một phần lớn lý do Jev nhanh hơn và rẻ hơn nhiều so với một LLM trên những loại câu hỏi này.
8. Thứ trả về là xác suất, không phải văn bản
Câu hỏi đi vào làm input, còn thứ quay về là gì? Martin nhắc lại rằng Jev không trả về văn bản; theo video đăng ngày 01/10/2026, output của nó là xác suất. Trên bảng, anh viết "PROB" phía trên cột kết quả bên phải khối JEV.
- Refund: một con số duy nhất (theo video đăng ngày 01/10/2026). Giả sử nó trả về 0.9, nghĩa là có 90% khả năng đúng là một yêu cầu hoàn tiền.
- Team: một xác suất cho từng phương án trong lựa chọn đó. Ví dụ phương án billing, một trong ba phương án, có thể trả về xác suất 0.85. Martin lưu ý thêm (video đăng ngày 01/10/2026): câu trả lời cho một Choice chỉ có thể là các phương án mà ta đưa vào. Với team, nó luôn luôn là billing, technical hoặc sales.
- Urgent: kết quả nằm trên một thang (theo video đăng ngày 01/10/2026). Ở ví dụ này, anh đánh dấu điểm khá cao, sát mức critical, tức là email này khá quan trọng.
Model vẫn có thể chọn sai phương án hoặc chấm sai bất kỳ câu nào, tất nhiên rồi, Martin nói. Nhưng theo anh (video đăng ngày 01/10/2026), con số xác suất cho ta biết khả năng sai đó lớn tới đâu.
9. Huấn luyện LLM: pre-training, post-training và RLHF
Vậy làm sao huấn luyện một model đưa ra xác suất chính xác như thế? Martin quay lại một chút với cách huấn luyện các LLM truyền thống, theo cách anh giải thích trong video đăng ngày 01/10/2026.
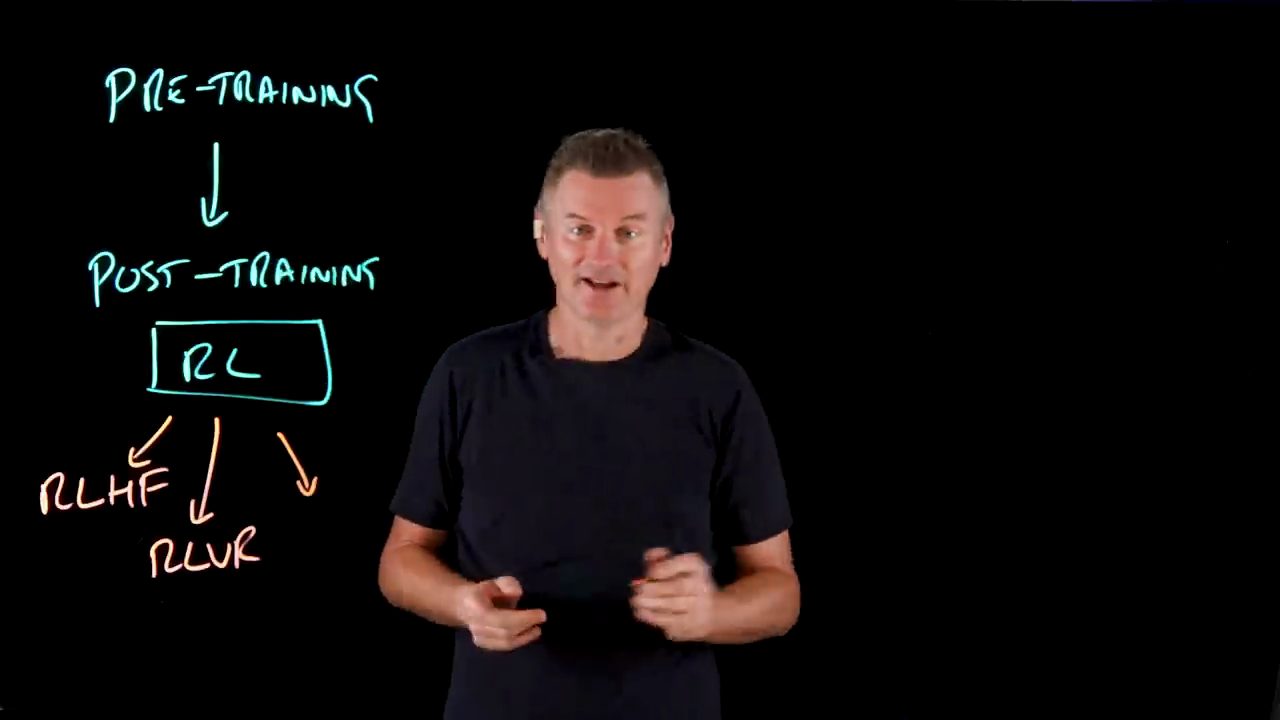
Theo Martin (video đăng ngày 01/10/2026), phần lớn language model bắt đầu bằng một giai đoạn gọi là pre-training. Ở đó model đọc một lượng văn bản khổng lồ và học cách dự đoán token tiếp theo. Kết quả là một model biết rất nhiều thứ, nhưng chưa dùng để trò chuyện được mấy. Muốn dùng nó làm chatbot thì phải sang giai đoạn thứ hai, gọi là post-training.
Theo anh (video đăng ngày 01/10/2026), rất nhiều phần của post-training dùng một kỹ thuật gọi là reinforcement learning (RL): model đưa ra một câu trả lời, có một thứ gì đó chấm điểm câu trả lời đó, và model được đẩy dần về phía những câu trả lời được điểm cao. Câu hỏi là: cái gì đang chấm điểm?
Martin kể (video đăng ngày 01/10/2026): một cách là kỹ thuật RLHF, reinforcement learning from human feedback. Ở đây con người chấm điểm: người đánh giá xem hai câu trả lời của model và chọn câu họ thích hơn. Những lựa chọn đó dùng để huấn luyện một reward model, rồi chatbot được huấn luyện để đưa ra những câu trả lời mà reward model chấm điểm cao.
Martin chỉ ra một điểm: con người có xu hướng thích những câu trả lời nghe tự tin. Nên theo anh (video đăng ngày 01/10/2026), một tác dụng phụ không may của RLHF là model có thể học cách tỏ ra rất chắc chắn về bản thân ngay cả khi nó sai. Nhưng đó mới chỉ là một dạng reinforcement learning.
10. RLVR: phần thưởng kiểm chứng được và giới hạn của nó
Dạng thứ hai là RLVR, reinforcement learning with verifiable rewards. Ở đây việc chấm điểm là tự động: model có giải đúng bài toán không? Code nó viết có pass unit test không? Những thứ kiểu như vậy. Theo Martin (video đăng ngày 01/10/2026), đó là một lý do lớn khiến các reasoning model ngày nay giỏi toán và code như vậy.
Nhưng phần thưởng ở đây chỉ kiểm câu trả lời cuối cùng có đúng hay không. Nó không thưởng cho model vì biết mình nên chắc chắn tới mức nào. Và theo anh, những model này mất một lúc để đi qua chain of thought rồi mới đưa ra câu trả lời, điều đó có thể khiến chúng chạy hơi chậm và tốn kém (video đăng ngày 01/10/2026).
11. RLCD và ý nghĩa của "calibrated"
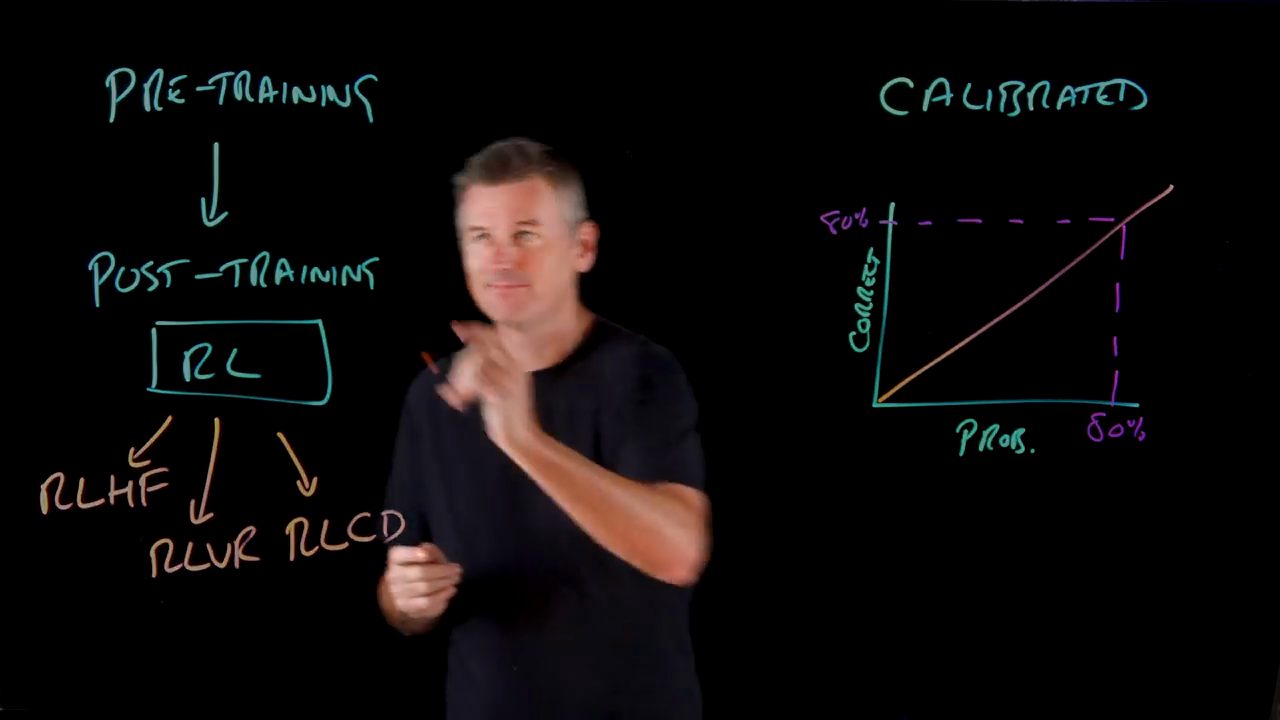
Theo Martin (video đăng ngày 01/10/2026), Jev được huấn luyện bằng một dạng reinforcement learning khác, gọi là RLCD, reinforcement learning for calibrated decisions. Bài giới thiệu của TypeSafe (đọc ngày 24/10/2026) cũng dùng đúng tên này cho phương pháp huấn luyện của họ.
Martin nói rõ rằng TypeSafe chưa công bố nhiều về kiến trúc của Jev (tính đến video đăng ngày 01/10/2026), nên anh chỉ bám vào những gì họ đã nói. Những gì ta biết: Jev đưa ra một xác suất cho mỗi phương án, và nó được thưởng khi những xác suất đó hoá ra đúng. Chữ C trong RLCD nói về điều đó: model là calibrated.
Theo Martin (video đăng ngày 01/10/2026), một model calibrated về cơ bản trông như sau. Martin vẽ một đồ thị: trục ngang là xác suất, trục dọc là model có đúng hay không. Một model được calibrate tốt sẽ có một đường chéo, giống như đường anh vẽ. Khi model nói có 80% xác suất, thì cái 80% đó sẽ đúng vào khoảng 80% số lần. Đó là calibration.
12. Biến xác suất thành quyết định trong code: ngưỡng
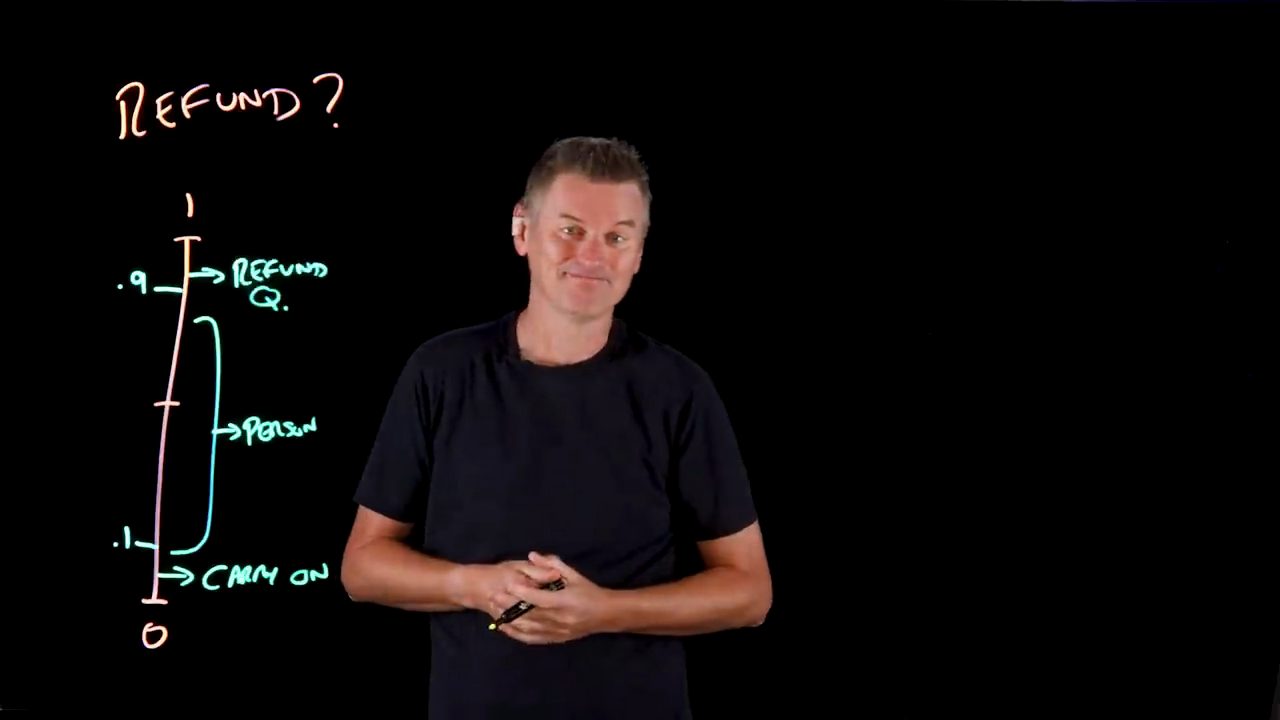
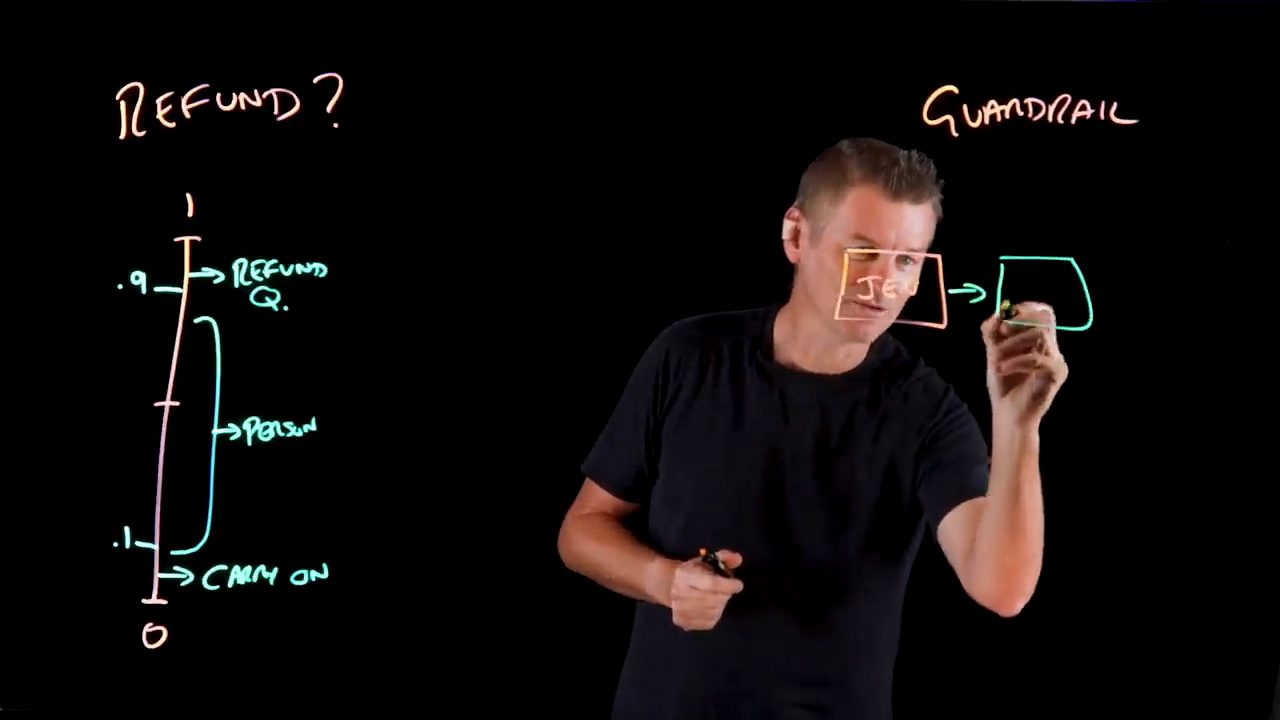
Trong video đăng ngày 01/10/2026, Martin quay lại câu hỏi refund, câu đầu tiên trong ba câu đã đặt cho Jev về email hỗ trợ. Khi có xác suất, theo anh, ta có thể dùng nó để điều khiển code bằng một ngưỡng (threshold). Trên bảng, anh vẽ một trục dọc với tiêu đề "Refund?": 1 ở trên cùng là chắc chắn, 0 ở dưới cùng là chắc chắn không.
- Nếu điểm xác suất trên, giả sử, 0.9, thì ta có thể coi email hỗ trợ này là một yêu cầu hoàn tiền thật và gửi thẳng vào hàng đợi hoàn tiền để xử lý. Trên bảng ghi "Refund Q.".
- Nếu điểm rơi vào đâu đó giữa mức đó và, giả sử, 0.1, thì có sự không chắc chắn. Đoạn code nhận một con số như vậy sẽ biết là cần kéo một người vào kiểm tra, vì ta không chắc. Trên bảng ghi "Person".
- Nếu điểm dưới 0.1, theo Martin thì có thể nói đó không phải yêu cầu hoàn tiền. "Keep calm and carry on", không cần làm gì với email đó cả. Trên bảng ghi "Carry on".
Vì các con số được calibrate (theo cách Martin mô tả Jev trong video đăng ngày 01/10/2026), ngưỡng còn cho ta biết đại khái nhánh tự động sẽ sai bao thường xuyên. Nên một sai lầm càng đắt thì ta càng đặt ngưỡng cao hơn.
13. Jev làm guardrail, và những giới hạn
Cách này tất nhiên không chỉ dùng cho email hỗ trợ. Theo Martin (video đăng ngày 01/10/2026), Jev có thể làm một guardrail bao quanh đủ loại thứ, chẳng hạn bao quanh một chatbot để kiểm tra các tin nhắn đi vào và đi ra, tìm những thứ như các nỗ lực jailbreak. Trên bảng, anh ghi "Guardrail" và vẽ một khối "JEV" có mũi tên trỏ sang một khối khác.
Nhưng có giới hạn, và Martin kể ra ba điều (theo video đăng ngày 01/10/2026):
- Tính đến thời điểm của video (01/10/2026), Jev chỉ nhận đầu vào là văn bản.
- Theo anh, Jev không giỏi toán, thậm chí không giỏi đếm, nên những việc đó nên để cho một thứ khác làm (video đăng ngày 01/10/2026).
- Giống mọi model AI, nó có thể bị lừa bởi những chỉ dẫn giấu trong dữ liệu mà nó đang đọc (video đăng ngày 01/10/2026).
Về điểm thứ nhất, tài liệu của TypeSafe (đọc ngày 24/10/2026) đã có một trang hướng dẫn gửi ảnh trong request, ghi rằng tính năng ảnh đang ở mức "Dreamer-ready", chưa sẵn sàng cho production.
14. Jev và LLM trong cùng một workflow
Vậy đã tới lúc vứt bỏ large language model và thay hẳn bằng các model System 1 chưa? Martin trả lời: không, còn xa mới vậy. Nhưng theo anh (video đăng ngày 01/10/2026), hai loại này có thể làm việc cùng nhau.
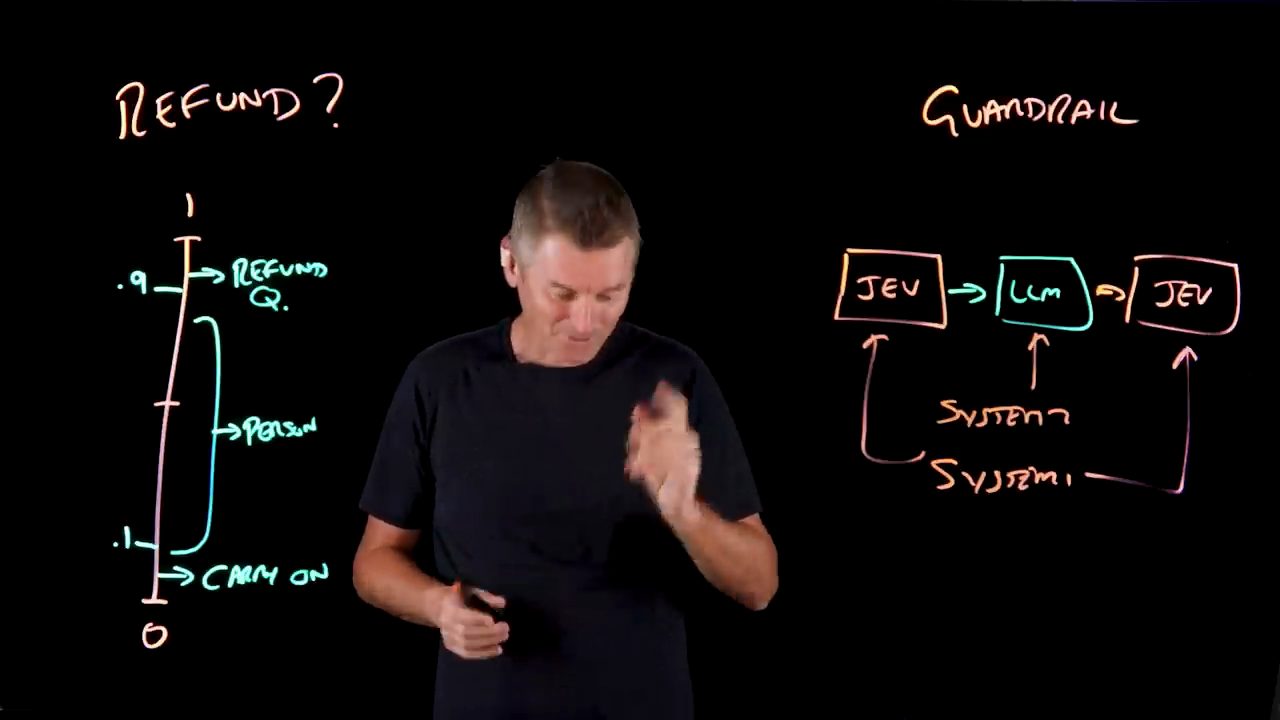
Anh mô tả một workflow trên bảng (video đăng ngày 01/10/2026):
- Đầu tiên là Jev trong workflow (theo video đăng ngày 01/10/2026), đưa ra những phán đoán nhanh, như phân loại email hỗ trợ khách hàng để xem có phải yêu cầu hoàn tiền không.
- Rồi workflow chuyển sang một large language model (theo video đăng ngày 01/10/2026) để làm phần việc chậm hơn, như viết thư trả lời khách hàng.
- Sau đó quay lại dùng Jev (theo video đăng ngày 01/10/2026) để phân loại bất kỳ phản hồi nào khách hàng gửi lại.
Martin nói đó gần như cũng là cách Danny Kahneman nói chúng ta làm việc. Phần lớn những gì ta làm chạy trên các tiến trình System 1 nhanh và tự động, ở đây là hai khối Jev trong sơ đồ của video đăng ngày 01/10/2026. Còn System 2 chậm và cẩn thận, ở đây là large language model, chỉ vào cuộc khi có thứ gì đó cần suy nghĩ thật sự.
15. Cái tên Jev và nghịch lý Jevons
Cuối cùng, Martin muốn kể một chuyện về cái tên Jev. Theo anh (video đăng ngày 01/10/2026), Jev được đặt theo tên William Stanley Jevons, một nhà kinh tế học. Năm 1865, Jevons chỉ ra rằng khi động cơ hơi nước ngày càng hiệu quả hơn, nước Anh lại dùng nhiều than hơn. Hiện tượng đó được gọi là nghịch lý Jevons (Jevons paradox).
Martin nói có lẽ chuyện tương tự sẽ xảy ra với các model System 1. Khi một phán đoán vừa cực nhanh vừa cực rẻ, như với Jev (theo cách anh mô tả trong video đăng ngày 01/10/2026), nó có thể đi vào những chỗ mà một LLM tính đến lúc đó còn quá chậm hoặc quá đắt, chẳng hạn trên mọi dòng của một database hay mọi dòng của một file log. "Ai mà biết được", anh nói.
Anh kết lại: đó là Jev. Một model System 1 sẽ nằm ở đâu trong phần mềm mà bạn đang làm? Martin mời người xem trả lời trong phần bình luận dưới video (đăng ngày 01/10/2026), rồi cảm ơn.
Nguồn và liên kết 9 nguồn
- Tên gốc: What Is Jev? The AI Model That Doesn't Generate Text
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=YGgNBcIgI4s youtube.com
- Kênh YouTube IBM Technology (Martin Keen): youtube.com/channel/UCKWaEZ-_VweaEx1j62do_vQ youtube.com
- Bài giới thiệu System One models và Jev trên blog của TypeSafe AI, đăng ngày 15/09/2026, có tên phương pháp huấn luyện RLCD (đọc ngày 24/10/2026): typesafe.ai/blog/introducing-system-one-models-and-jev typesafe.ai
- Tài liệu TypeSafe, trang giới thiệu Jev và ba kiểu câu hỏi Choice, Score, Noul (đọc ngày 24/10/2026): docs.typesafe.ai docs.typesafe.ai
- Tài liệu TypeSafe, trang Noul: câu hỏi có hoặc không, trả về xác suất của "có" (đọc ngày 24/10/2026): docs.typesafe.ai/primitives/noul docs.typesafe.ai
- Tài liệu TypeSafe, trang Images: gửi ảnh trong request, đang ở mức "Dreamer-ready" (đọc ngày 24/10/2026): docs.typesafe.ai/images docs.typesafe.ai
- Tài liệu TypeSafe, cookbook dùng TypeSafe làm guardrail cho LLM, sàng lọc tin nhắn đi vào và đi ra (đọc ngày 24/10/2026): docs.typesafe.ai/cookbooks/llm_guardrails docs.typesafe.ai
Related talks
Grok Bot sau 14 ngày dùng thật: điều không ai nói
Helena Zhang · Helena Zhang · 9 min
14 ngày dùng Grok Bot thật: đội bot chuyên môn, dọn 500 GB ổ đĩa, nối ChatGPT và Claude, máy tính và IP dùng chung, usage và giá qua Cursor.
9 agent skill miễn phí nên cài ngay
Kevin Hutson · Futurepedia · 16 min
Cách cài và dùng 9 skill miễn phí cho agent: nghiên cứu, Humanizer, xem video, Remotion, HyperFrames, quét an ninh, Superpowers, gstack và Impeccable.
Agentic AI: cắm MCP đọc ghi tệp cho model chạy trên máy
Thanh Trần · Thanh Trần - 5 Phút AI · 25 min
Chatbot khác agent ở đâu, cắm MCP đọc ghi tệp vào LM Studio, viết câu lệnh bốn phần để tóm tắt 6 tệp trong một phút, rồi kiểm và giữ an toàn.