Vì sao AI kém đi khi hội thoại dài tới 100K token
Bốn năng lực ẩn sau context window, paper Lost in the Middle, cơ chế attention Q/K/V và cách quản lý context khi chat hay chạy agent.
✓ Đã duyệt độc lập · cập nhật 01/11/2026 · 13 min
1. Model "một triệu token" hụt hơi ở 100.000 token
Sanchit mở đầu bằng một cảnh dùng LLM (video đăng ngày 01/11/2026): bạn bắt đầu một cuộc hội thoại mới và mọi thứ chạy tốt. Model làm theo chỉ dẫn, giải bài toán chính xác, làm đúng mà không cần bạn kèm cặp nhiều. Nhưng khi cuộc hội thoại dài ra, có gì đó bắt đầu thay đổi. Theo anh, sau khoảng 100.000 token, model bắt đầu bỏ sót. Nó vật lộn với chính task mà trước đó nó xử lý nhẹ nhàng. Và đôi khi nó làm sai dù có trong tay mọi thông tin cần thiết.
Rồi bạn bắt đầu thắc mắc: khoan đã, chẳng phải model này được kỳ vọng hỗ trợ tới một triệu token sao? Vậy tại sao nó đã chật vật ở mức 100.000? Đó là câu hỏi Sanchit đặt ra trong video đăng ngày 01/11/2026.
Anh tự giới thiệu là Sanchit, đang làm senior software engineer tại Atlassian, từng làm ở American Express và Amazon (theo lời anh trong video đăng ngày 01/11/2026). Anh gọi chủ đề của video là "million token trap", cái bẫy triệu token của LLM.
2. Ví dụ thư viện thần kinh học
Để hiểu chuyện gì đang xảy ra, Sanchit đưa ra một ví dụ (video đăng ngày 01/11/2026). Hãy tưởng tượng bạn không phải chuyên gia thần kinh học (neuroscience), và anh hỏi bạn một câu về não. Bạn không biết gì về thần kinh học, nhưng anh cho bạn vào một thư viện có tất cả những cuốn sách có thể có về thần kinh học. Về mặt kỹ thuật, bạn có mọi thông tin cần để trả lời câu hỏi của anh. Nhưng như vậy có nghĩa là bạn trả lời đúng được không? Anh trả lời: không hẳn.
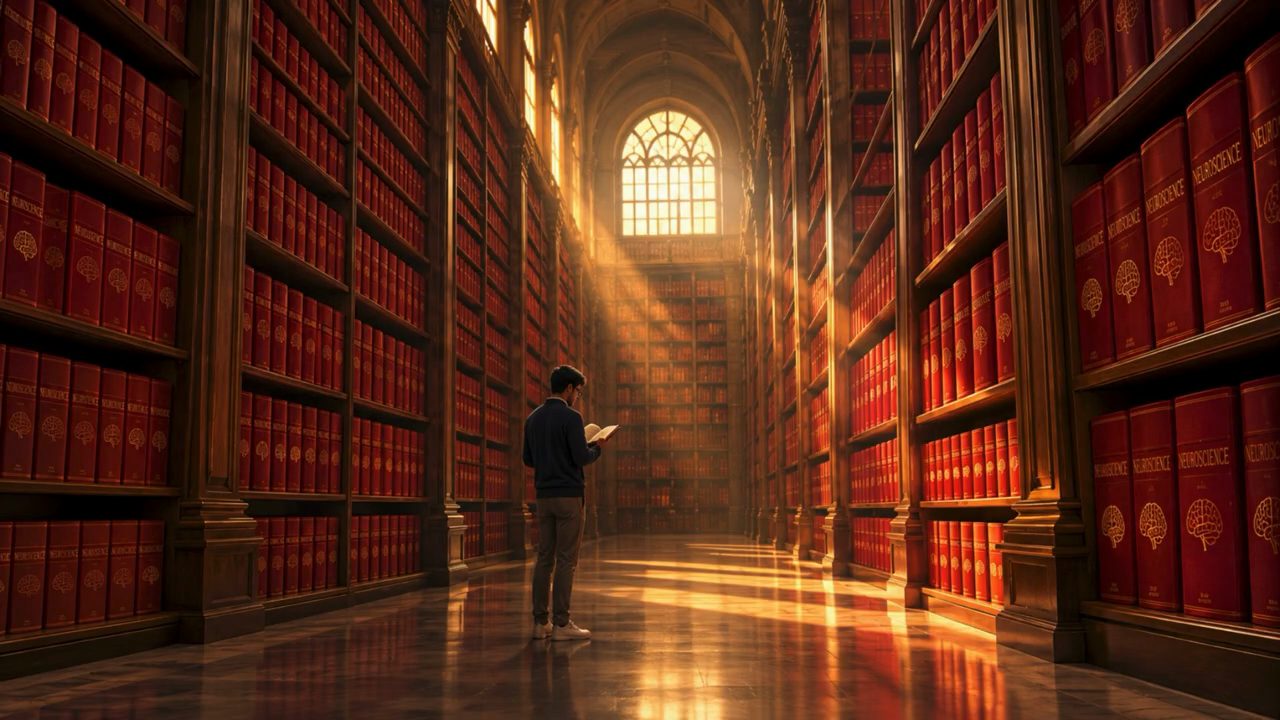
Hãy nghĩ xem chuyện gì xảy ra nếu bạn cố đọc hết sách trong thư viện đó. Bạn có thể nhớ vài cuốn đầu vì lúc ấy bạn còn tỉnh táo và đang rất chú ý. Bạn có thể nhớ vài cuốn cuối vì đó là những cuốn bạn vừa đọc xong. Nhưng còn những cuốn ở giữa thì sao? Sự chú ý có thể đã lên xuống, vài dữ kiện không đọng lại, và bạn có thể khó nhớ ra những điều đã đọc ở đâu đó giữa chừng. Đó là cách Sanchit kể ví dụ trong video đăng ngày 01/11/2026.
Anh đi thêm một bước: cứ cho là bạn nhớ đúng mọi dữ kiện đi, thì liệu bạn có nối được các dữ kiện từ những cuốn sách khác nhau để trả lời câu hỏi một cách đáng tin không? Theo anh (video đăng ngày 01/11/2026), có thể là không.
3. Có thông tin không có nghĩa là dùng được thông tin
Điều Sanchit muốn nói (video đăng ngày 01/11/2026): có quyền truy cập vào mọi thông tin không bảo đảm rằng bạn lấy ra, nối lại và dùng được tất cả thông tin đó một cách đáng tin để trả lời một câu hỏi cụ thể. Và theo anh, đó là một cách nghĩ hữu ích về context window dài bên trong LLM.
Anh lưu ý một điểm quan trọng: anh không nói rằng các LLM bị mệt mỏi như con người. Đây chỉ là một phép so sánh để giúp hiểu hành vi, không phải một khẳng định về điều đang diễn ra bên trong model (video đăng ngày 01/11/2026).
Khi nói một model hỗ trợ context window một triệu token, theo Sanchit (video đăng ngày 01/11/2026), người ta dễ cho rằng model dùng cả triệu token đó ngang nhau. Nhưng có bốn năng lực mà ta cần nghĩ tới.
4. Bốn năng lực: capacity và retrieval
Năng lực thứ nhất là context capacity: model có nhận được input mà không vượt quá giới hạn kỹ thuật của nó không. Theo Sanchit (video đăng ngày 01/11/2026), nếu cuộc hội thoại, các chỉ dẫn, các file input và output của LLM đều vừa trong context window, thì chúng có thể được xử lý trong giới hạn đó. Nhưng vừa được chỉ là bước thứ nhất.
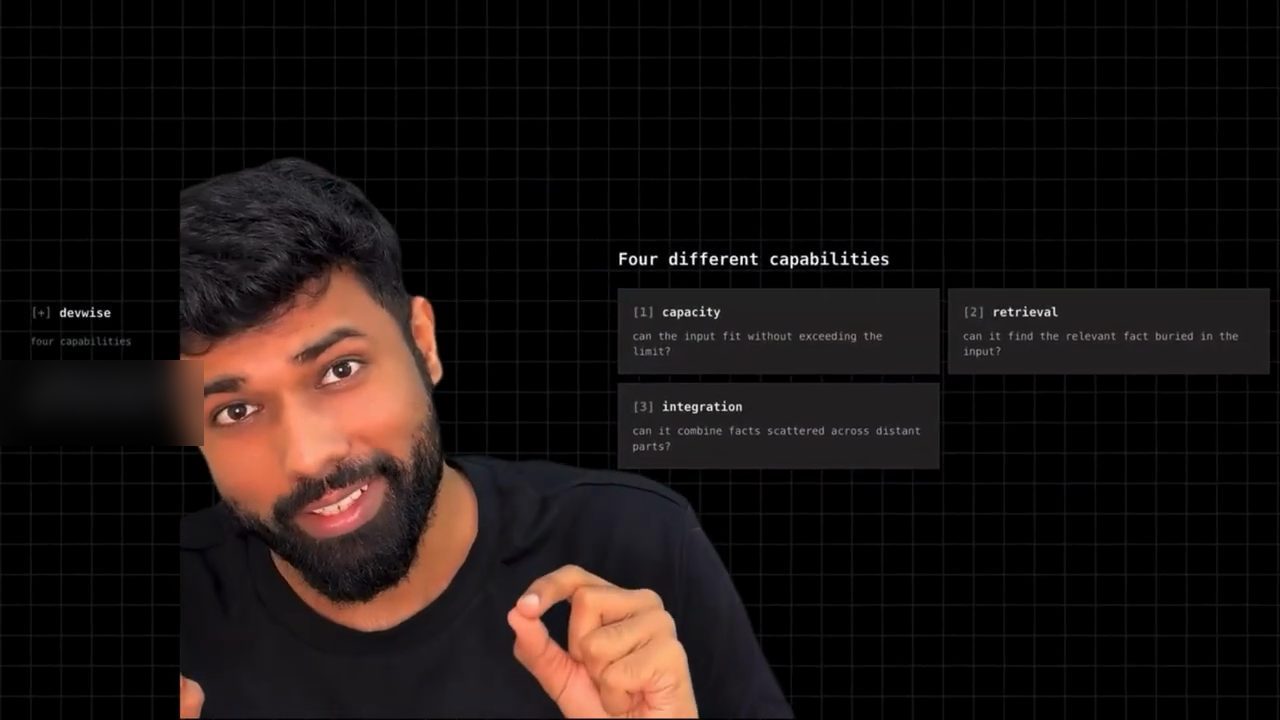
Năng lực thứ hai là retrieval: model có tìm được thông tin liên quan bị vùi trong input không. Theo anh (video đăng ngày 01/11/2026), thông tin có thể có mặt ở đó, nhưng model có lấy ra được đúng chi tiết cụ thể cần để trả lời câu hỏi không?
5. Integration, reasoning và bốn câu hỏi
Năng lực thứ ba là integration: model có kết hợp được mọi dữ kiện nằm rải rác khắp input không. Sanchit lấy ví dụ (video đăng ngày 01/11/2026): có thể một yêu cầu được nêu ngay từ đầu, nhưng quyết định về cách implement nó lại xuất hiện muộn hơn nhiều. Tìm ra được hết thông tin không giống với nối chúng lại cho đúng.
Năng lực thứ tư là reasoning: model có dùng các dữ kiện đó để giải đúng bài toán không. Theo anh (video đăng ngày 01/11/2026), ngay cả khi model lấy ra đúng input và kết hợp chúng đúng cách, nó vẫn có thể rút ra kết luận sai.
Sanchit dặn hãy nhớ bốn câu hỏi này (video đăng ngày 01/11/2026): input có vừa không? Model có lấy ra được đúng thông tin không? Nó có kết hợp được thông tin từ các nguồn khác nhau không? Và nó có suy luận đúng từ thông tin đó không?
Theo Sanchit (video đăng ngày 01/11/2026), một context window lớn giải quyết capacity, nhưng đó chỉ là một phần. Nó không bảo đảm retrieval, integration và reasoning tốt.
6. Paper "Lost in the Middle" và đường cong chữ U
Sanchit nhắc tới một paper nghiên cứu tên là "Lost in the Middle" (Liu và cộng sự, đăng trên Transactions of the ACL năm 2024). Theo lời anh trong video đăng ngày 01/11/2026, trong paper đó các nhà nghiên cứu cho language model làm những task đòi hỏi lấy ra các thông tin khác nhau được đặt ở những vị trí khác nhau trong input. Trong bối cảnh thử nghiệm đó, hiệu năng thường đi theo một đường cong hình chữ U. Model có xu hướng làm tốt hơn nếu thông tin liên quan nằm ở đầu hoặc ở cuối context window, và kém đi khi thông tin nằm đâu đó ở giữa.
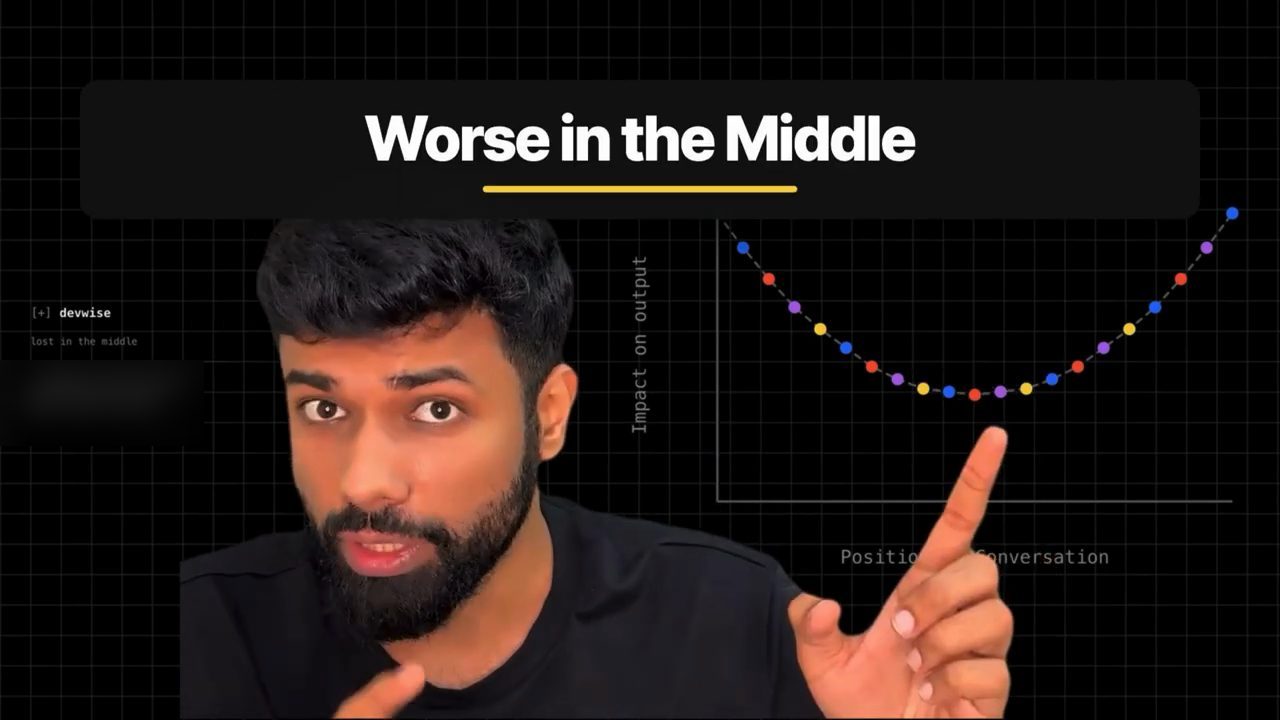
Phần tóm tắt của paper trên ACL Anthology (đọc ngày 01/11/2026) ghi rằng nhóm tác giả thử trên hai task là multi-document question answering và key-value retrieval, và hiệu năng thường cao khi thông tin liên quan nằm ở đầu hoặc cuối input context, giảm đáng kể khi model phải truy cập thông tin ở giữa context dài, kể cả với các model được làm riêng cho context dài.
Sanchit nối kết quả này với ví dụ thư viện (video đăng ngày 01/11/2026): mọi token đều bình đẳng, nhưng có những token "bình đẳng hơn" những token khác. Thông tin có thể có mặt trong input mà không dễ dùng như nhau đối với model khi nó nằm ở những vị trí khác nhau.
7. Điều paper không nói
Rồi Sanchit nói "hãy chính xác" (video đăng ngày 01/11/2026). Kết quả này không có nghĩa là các model bỏ qua thông tin (slide lúc đó có mục số 1 "Models don't ignore middle info"). Nó không có nghĩa là có một ngưỡng chung 100.000 token cho mọi model. Nó cũng không có nghĩa là attention đột ngột tụt xuống ở đoạn giữa. Theo anh, kết quả phụ thuộc vào model, vào task và vào cách thiết lập.
Điều paper (năm 2024) cho thấy, theo Sanchit (video đăng ngày 01/11/2026), là vị trí của thông tin trong input có thể ảnh hưởng tới hiệu năng trên task. Bài học anh rút ra: độ dài context và việc dùng context hiệu quả không phải là một.
8. Ví dụ debug: các mảnh thông tin nằm rải rác
Sanchit nói giờ hãy đi sâu vào lý do chính xác vì sao chuyện này xảy ra (video đăng ngày 01/11/2026). Anh báo trước đây là phần đi sâu vào kỹ thuật: ai không muốn thì có thể bỏ qua, ai tò mò thì theo cùng anh, và nếu không hiểu vài chỗ thì cũng không sao.
Ta đã thấy vị trí của input trong context window có thể ảnh hưởng tới hiệu năng. Nhưng một transformer xử lý thông tin qua tất cả các token của nó như thế nào? Để xây trực giác, anh dùng một ví dụ (video đăng ngày 01/11/2026). Hãy tưởng tượng bạn đang debug một đoạn code có bug, và bạn nhờ coding agent debug bug đó. Ở đầu cuộc hội thoại, bạn nói rằng kết nối DB timeout sau 5 giây. Một lúc sau, bạn chia sẻ một file config. Rất lâu sau đó, bạn chia sẻ một đoạn error log ghi rằng một query mất 8 giây.
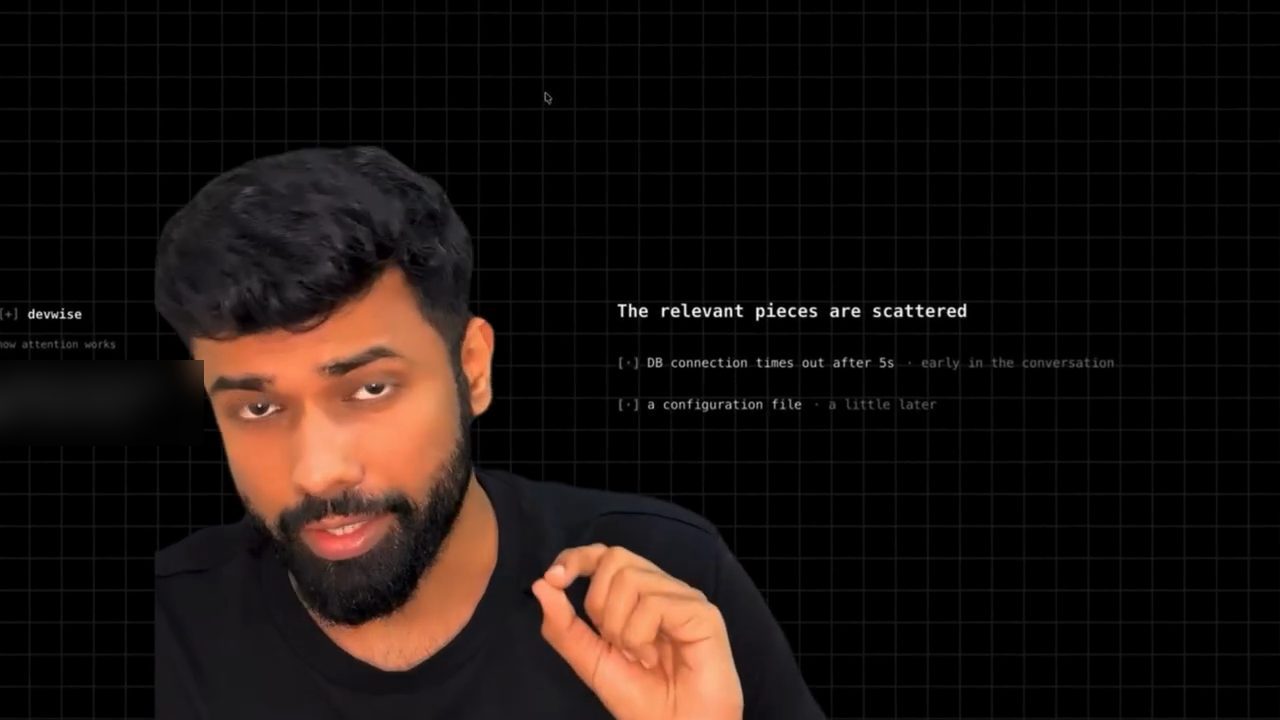
Giờ bạn hỏi agent: vì sao request này lỗi? Theo Sanchit (video đăng ngày 01/11/2026), để trả lời đúng, agent cần nối mọi thông tin bạn đã chia sẻ trong context. Nó cần liên hệ cấu hình timeout với query chậm, rồi dùng mối liên hệ đó để giải thích lỗi.
9. Attention: query, key và value
Đây là chỗ attention xuất hiện. Sanchit gợi ý hãy nghĩ về attention như một cách để các token khác nhau trong context window trao đổi thông tin với nhau (video đăng ngày 01/11/2026). Khi transformer xử lý văn bản, mỗi token được biểu diễn bằng số. Theo anh, model tạo ra ba biểu diễn đã học (learned representation) cho mỗi token: query, key và value.
Anh dùng một phép so sánh cho từng cái (video đăng ngày 01/11/2026): hãy tưởng tượng mỗi token có một tấm thẻ ghi ba thứ.
- Query: hãy nghĩ về nó như tín hiệu đi tìm thông tin của token. Biểu diễn query giúp xác định những token nào khác trong context có thể liên quan tới token hiện tại (theo Sanchit, video đăng ngày 01/11/2026).
- Key: mỗi token có một cái nhãn giúp các token khác biết token này chứa thông tin gì. Model so query và key của mọi tổ hợp token để tính ra một thứ gọi là attention score. Theo Sanchit (video đăng ngày 01/11/2026), score càng cao thường có nghĩa là hai token càng liên quan tới nhau.
- Value: khi đã tính xong attention weight giữa các token, model dùng chúng để kết hợp thông tin từ biểu diễn value tương ứng. Trong ví dụ debug, cấu hình timeout và chi tiết về query chậm có thể cùng góp phần debug vấn đề đang có. Model có thể dùng các biểu diễn thu được ở các layer sau để xây dựng hiểu biết theo ngữ cảnh nhiều hơn (theo Sanchit, video đăng ngày 01/11/2026).
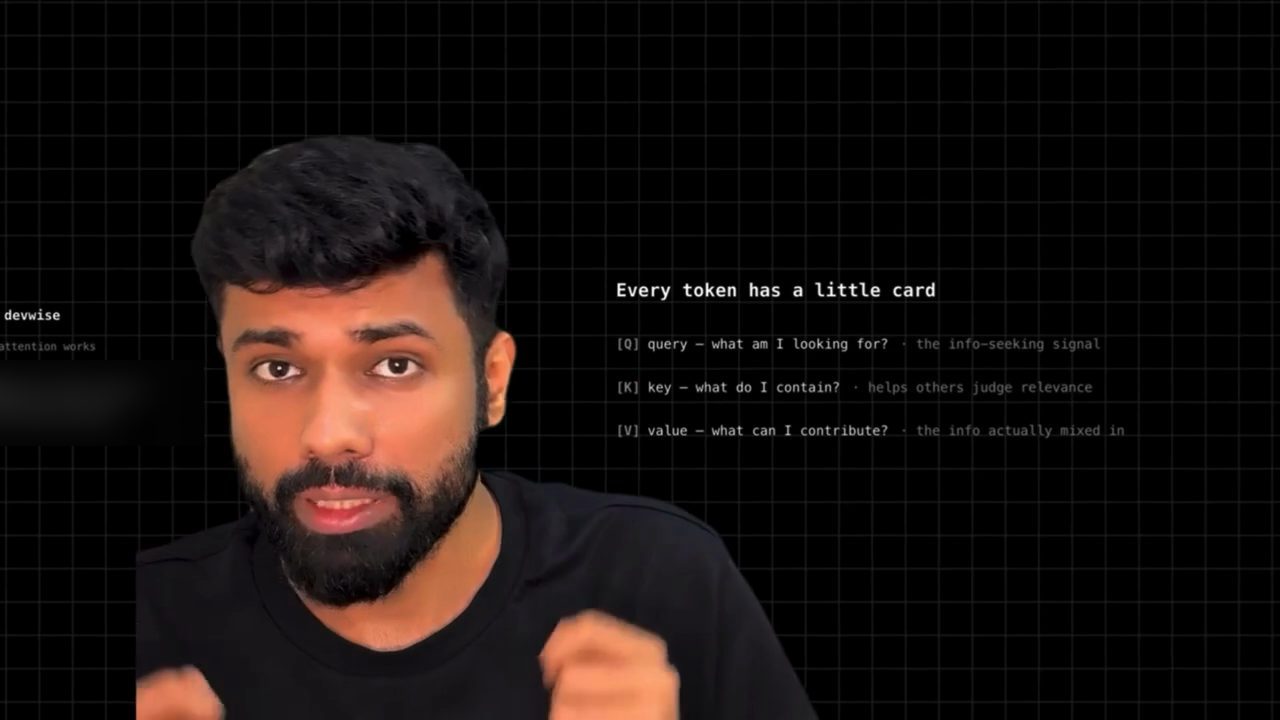
Đó là trực giác thô, theo cách Sanchit tóm lại (video đăng ngày 01/11/2026). Query: điều gì có thể liên quan tới mình? Key: mình mang thông tin gì? Và value: mình có thể góp thông tin gì?
10. Công thức attention, từng phần một
Sanchit đưa ra phương trình toán học (video đăng ngày 01/11/2026). Có thể bạn đã thấy nó trước đây, nhưng anh bảo đừng lo: bạn không cần thuộc lòng cả phương trình, anh sẽ tách nó ra để hiểu từng phần làm gì. Công thức trên slide:
softmax( QK^T / sqrt(d_k) ) · V
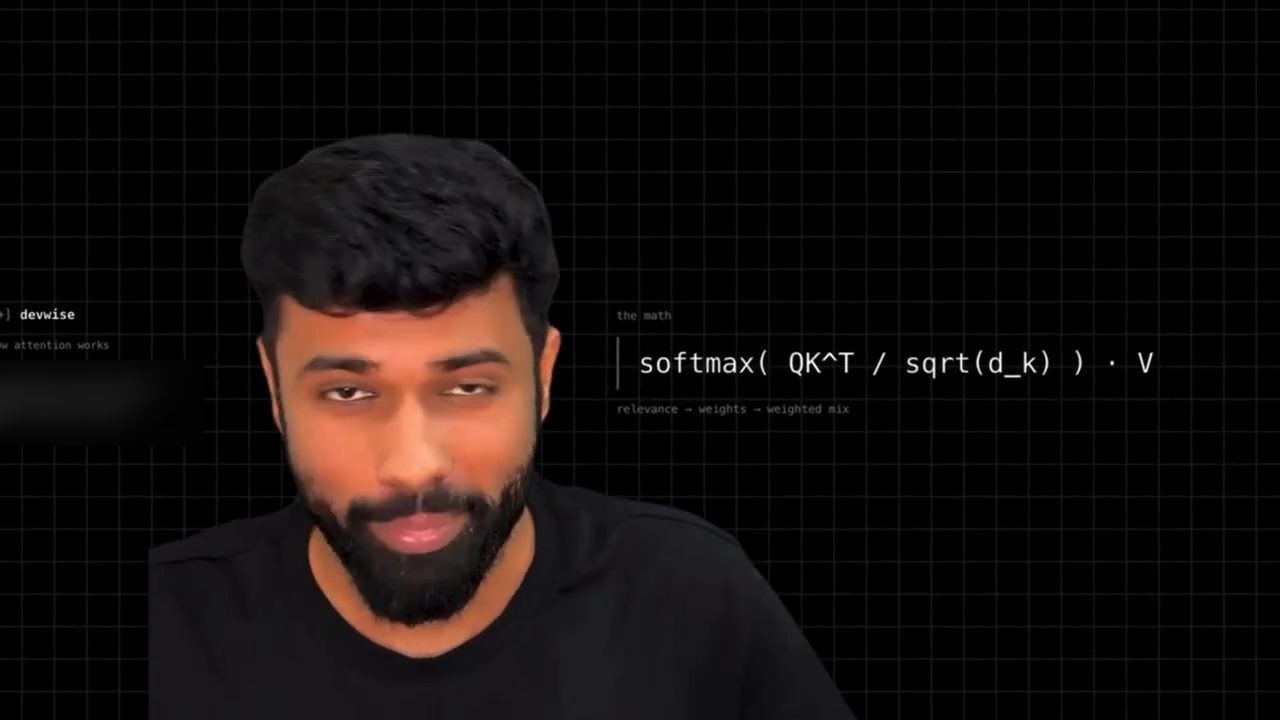
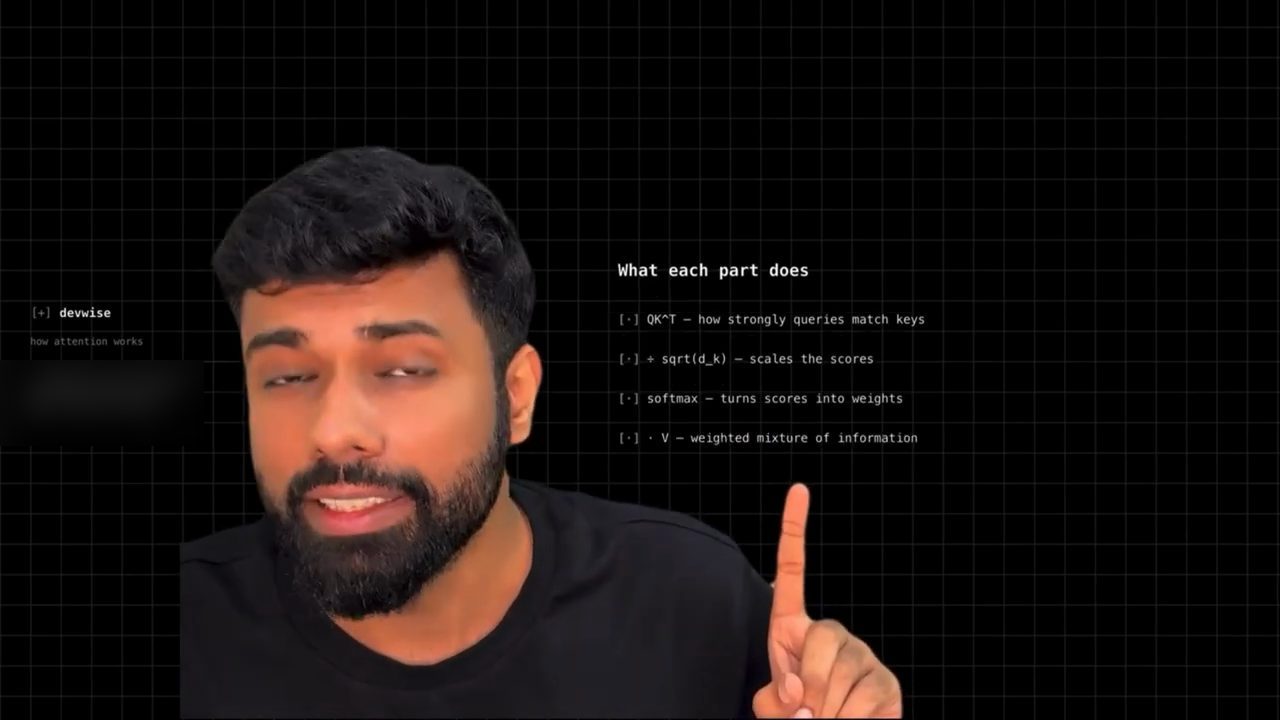
Theo lời giải thích của Sanchit (video đăng ngày 01/11/2026): phần thứ nhất tính xem query khớp với các key mạnh tới đâu. Rồi phép chia cho căn bậc hai của d_k scale các score. Sau đó hàm softmax chuyển các score này thành weight. Cuối cùng, nhân các weight với V để kết hợp các biểu diễn value, cho model một hỗn hợp có trọng số của thông tin từ những token mà nó có thể attend tới.
11. Vì sao một triệu token vẫn không bảo đảm câu trả lời đúng
"Chắc bạn đang nghĩ: thôi đủ toán rồi, vào vấn đề đi", Sanchit nói. Vậy tại sao một context window một triệu token không bảo đảm output đúng? Theo anh (video đăng ngày 01/11/2026), trong một transformer tiêu chuẩn, một token có thể attend tới mọi token đứng trước nó trong context window. Nhưng khi context window dài, sẽ có một số lượng token khổng lồ phải xem xét. Có khả năng attend tới thông tin không có nghĩa là model luôn dùng đúng thông tin cho mọi task.
Anh quay lại ví dụ debug (video đăng ngày 01/11/2026): hãy tưởng tượng cuộc hội thoại debug có hàng trăm tin nhắn. Cấu hình timeout nằm gần đầu, error log nằm muộn hơn nhiều, và ở giữa là hàng chục cuộc thảo luận không liên quan. Thông tin liên quan về mặt kỹ thuật có thể vẫn có sẵn, nhưng model vẫn phải tạo ra những biểu diễn hữu ích, nối đúng các input và suy luận đúng về lỗi.
Theo Sanchit (video đăng ngày 01/11/2026), attention là một phần rất quan trọng trong cách transformer xử lý context, nhưng nó không bảo đảm retrieval, integration và reasoning. Và đây là một phân biệt rất quan trọng: paper Lost in the Middle (năm 2024) cho thấy vị trí của input trong context window có thể làm chất lượng output thay đổi, còn cơ chế query, key, value giải thích cho ta kiến trúc bên dưới.
Bài học của phần này theo anh (video đăng ngày 01/11/2026): một context window lớn cho model của bạn mọi thông tin liên quan. Attention giúp xử lý quan hệ giữa các token. Nhưng không cái nào trong hai thứ đó bảo đảm model sẽ dùng mọi chi tiết có thể một cách đúng chỗ.
12. Vì sao cuộc hội thoại dài lại khó hơn
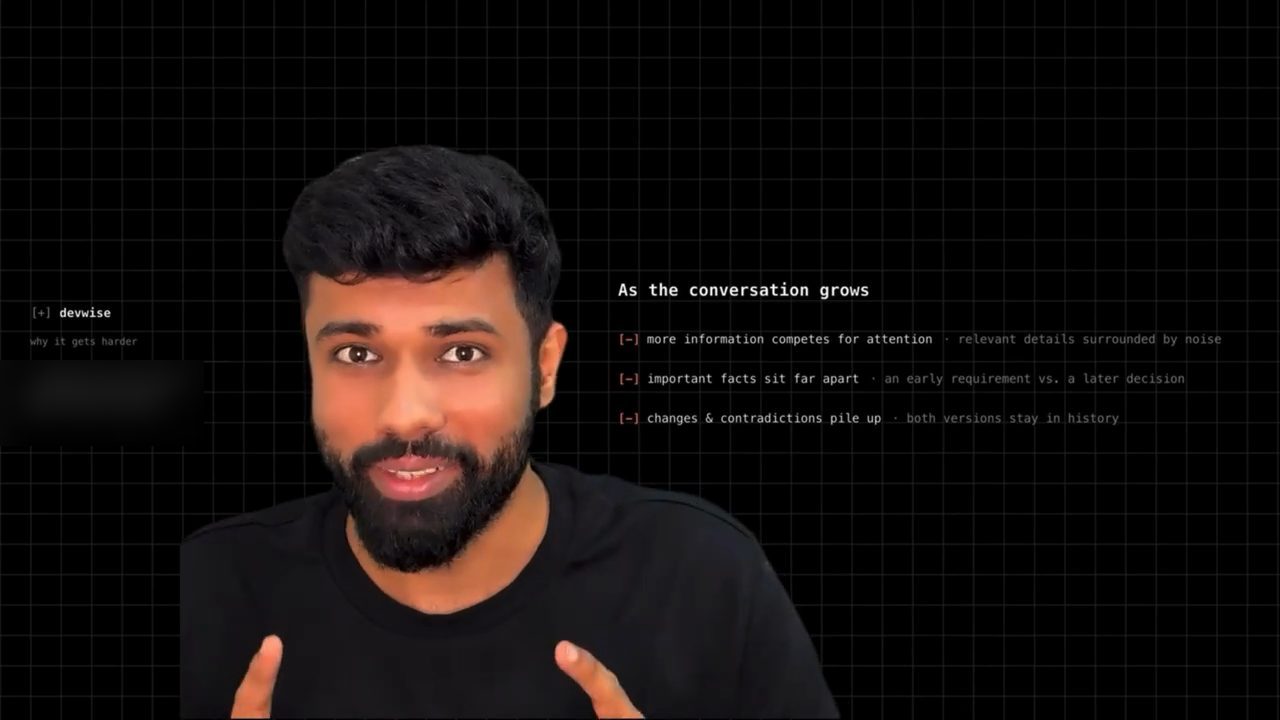
Sanchit nói đó là một phần đi sâu hay, rồi quay lại phần thực tế: vì sao cuộc hội thoại dài hơn lại khó hơn. Theo anh (video đăng ngày 01/11/2026), lúc đầu cuộc hội thoại, model chỉ có một tập nhỏ tin nhắn, chỉ dẫn và chi tiết để làm việc. Nhưng khi cuộc hội thoại dài ra, vài thứ có thể thay đổi:
- Thứ nhất, nhiều thông tin hơn tranh nhau sự chú ý (attention). Những chi tiết liên quan bị bao quanh bởi các cuộc thảo luận không cần thiết, context không liên quan, v.v. (theo Sanchit, video đăng ngày 01/11/2026).
- Thứ hai, những dữ kiện quan trọng có thể nằm cách xa nhau. Model có thể cần nối một yêu cầu từ rất sớm với một quyết định muộn hơn nhiều (theo Sanchit, video đăng ngày 01/11/2026).
- Thứ ba, cuộc hội thoại có thể chứa nhiều thay đổi và mâu thuẫn. Một kế hoạch trước đó có thể đã bị thay thế nhưng cả hai phiên bản vẫn nằm trong lịch sử, và điều đó làm model rối không biết phải làm gì (theo Sanchit, video đăng ngày 01/11/2026).
Nói cho rõ, theo Sanchit (video đăng ngày 01/11/2026), không có một lời giải thích duy nhất cho mọi lần hỏng. Nó tuỳ vào hành vi của model, cấu trúc prompt, độ khó của task, thành phần của context, và tất nhiên cả cách implement agent.
13. Việc làm được khi chat trực tiếp: hội thoại mới và compact
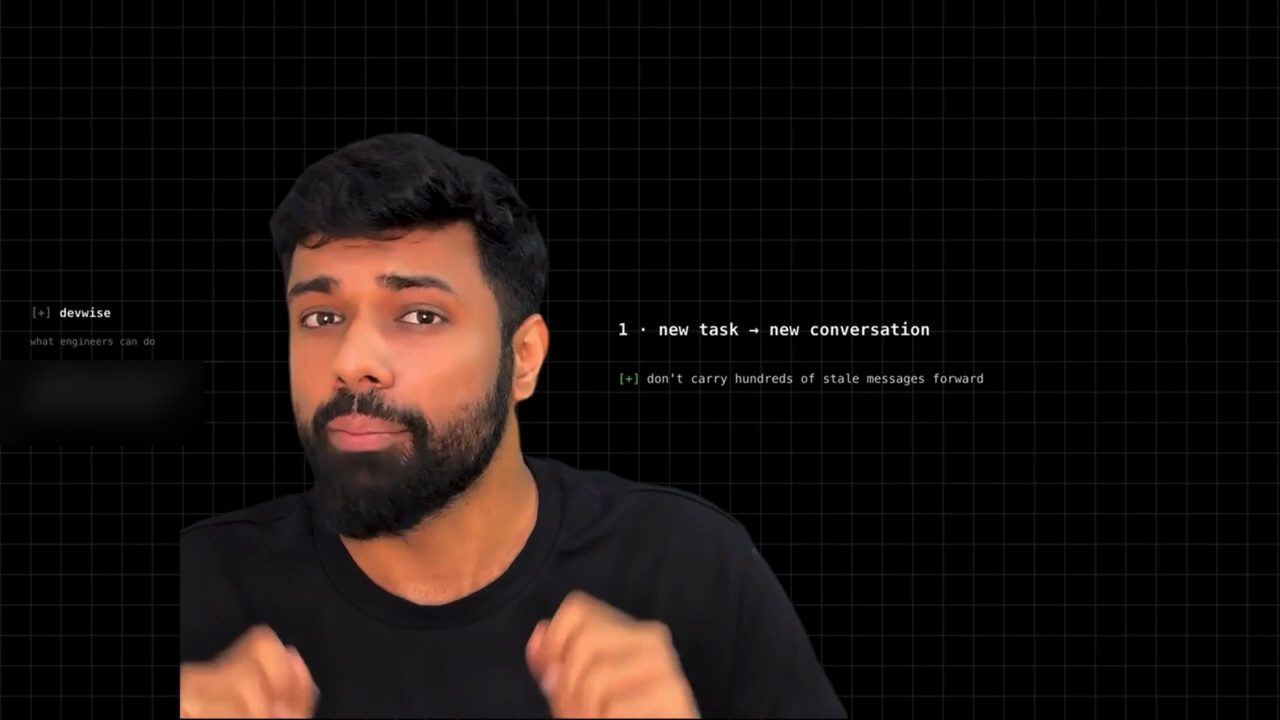
"Chắc bạn đang nghĩ: đủ rồi, ta biết vấn đề là gì rồi, giờ làm gì để vượt qua nó?", Sanchit nói. Cách thứ nhất của anh: task mới thì hội thoại mới. Theo anh (video đăng ngày 01/11/2026), nếu bạn đang làm một task rồi chuyển sang một task hoàn toàn mới, đừng tiếp tục trong cùng cuộc hội thoại, hãy mở một cuộc mới. Cuộc hội thoại trước có thể chứa hàng trăm tin nhắn không liên quan tới task tiếp theo, có thể có những quyết định và chi tiết đã lỗi thời, hoàn toàn không liên quan tới task mới. Một cuộc hội thoại mới cho model một điểm xuất phát mới.
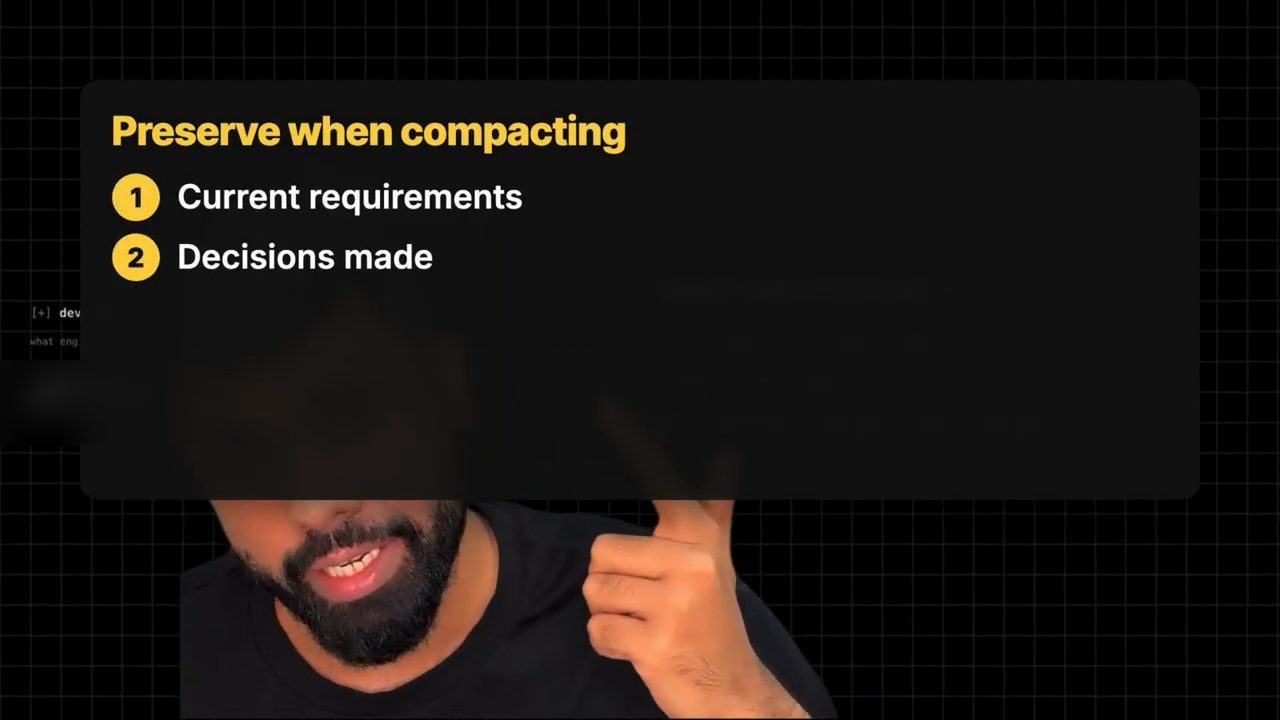
Cách thứ hai: compact những cuộc hội thoại dài. Theo Sanchit (video đăng ngày 01/11/2026), có thể bạn thật sự đang làm một task dài và không muốn mất context của các quyết định trước đó khi cuộc hội thoại dài ra. Lúc đó bạn có thể compact cuộc hội thoại. Compact biến lịch sử dài thành một bản tóm tắt ngắn, nhưng có một sự đánh đổi: bản tóm tắt là một biểu diễn có mất mát (lossy) của cuộc hội thoại thật. Vài chi tiết implement, vài edge case, vài quyết định nhỏ có thể bị mất trong lần compact.
Với công việc engineering, Sanchit khuyên (video đăng ngày 01/11/2026) khi compact hãy giữ lại: các yêu cầu đang áp dụng, các quyết định đã đưa ra, các đường dẫn file liên quan, các ràng buộc, các vấn đề chưa giải quyết, và các bước tiếp theo.
Nhưng theo Sanchit (video đăng ngày 01/11/2026), đây là những khuyến nghị cho lúc bạn chat một đối một với LLM, khi con người có thể can thiệp và tự compact cuộc hội thoại.
14. Agent tự chạy: đưa context management vào system design
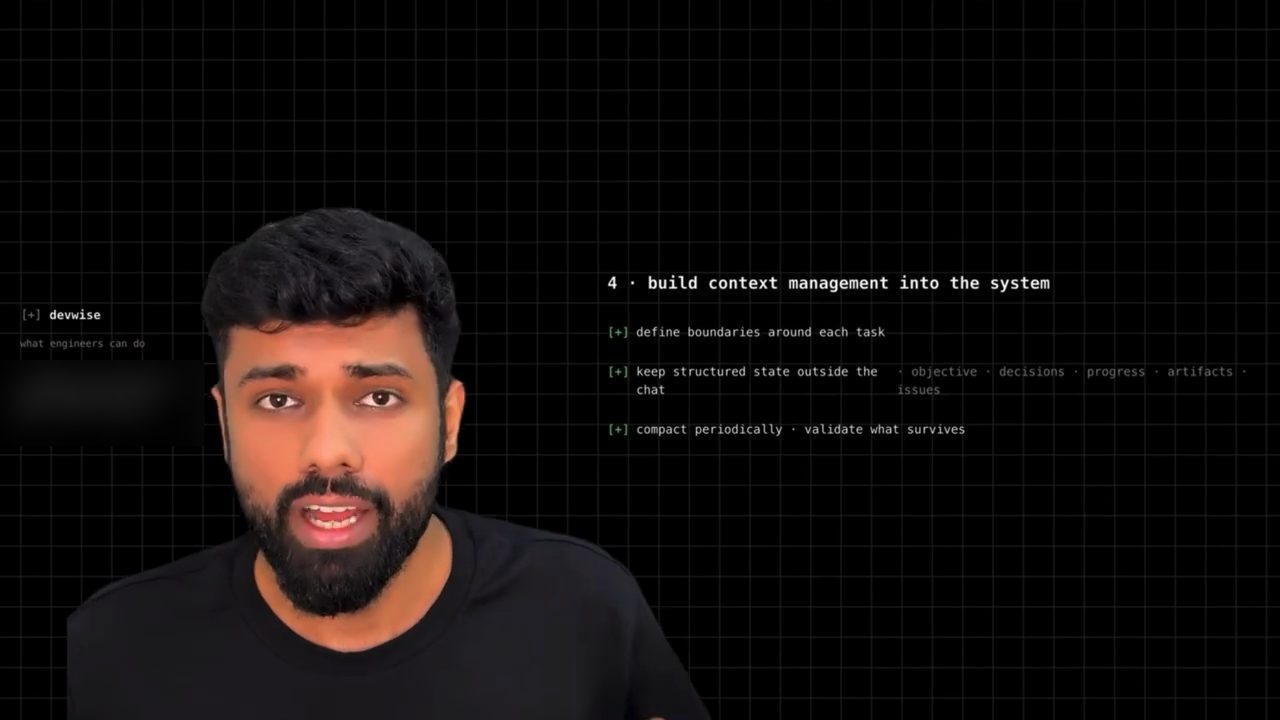
Còn với hệ thống tự động, nơi agent tự đi nhiều bước mà không cần nhiều sự can thiệp của con người thì sao? Theo Sanchit (video đăng ngày 01/11/2026), trong trường hợp đó context management phải trở thành một phần của system design. Anh đưa ra ba việc:
- Thứ nhất, đặt ranh giới quanh các task. Khi agent chuyển từ task này sang task khác, nó không nên mang theo một cách mù quáng mọi tin nhắn thô từ task trước (theo Sanchit, video đăng ngày 01/11/2026).
- Thứ hai, giữ state có cấu trúc ở bên ngoài: những thứ như mục tiêu đang làm, các quyết định đã đưa ra, tiến độ task, các artifact liên quan và các vấn đề chưa giải quyết. Khi agent chuyển task, hãy đưa state này làm bằng chứng (evidence) thay vì dựa vào các tin nhắn thô của cuộc hội thoại (theo Sanchit, video đăng ngày 01/11/2026).
- Thứ ba, với task chạy lâu, compact cuộc hội thoại định kỳ và tự động. Xác định thứ gì cần được giữ lại và thứ gì cần được kiểm chứng (theo Sanchit, video đăng ngày 01/11/2026).
Bài học chính theo Sanchit (video đăng ngày 01/11/2026): đừng biến cuộc hội thoại thành nguồn sự thật (source of truth).
15. Bốn câu hỏi để hỏi lại
Vậy khi một AI agent bắt đầu chật vật lúc cuộc hội thoại dài ra, Sanchit khuyên (video đăng ngày 01/11/2026) đừng chỉ hỏi context window lớn cỡ nào. Hãy hỏi bốn câu: input có vừa không? Nó có lấy ra được các dữ kiện liên quan không? Nó có nối được thông tin từ những dữ kiện khác nhau không? Và nó có suy luận đúng từ những gì nó tìm thấy không?
Nếu bạn đang build một AI agent, theo Sanchit (video đăng ngày 01/11/2026), hãy nhớ rằng quản lý context không phải là nhét vừa mọi thứ vào context window. Nó là quyết định thông tin nào nên có sẵn, thứ gì cần được giữ lại, và làm sao kiểm chứng rằng agent đang dùng chúng đúng cách.
Anh khép lại bằng lời mong người xem đã học được điều gì đó mới.
Nguồn và liên kết 5 nguồn
- Tên gốc: Why Your AI Gets Dumber at 100K Tokens | Long Context Window, Explained
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=VQtbwVOimJM youtube.com
- Kênh YouTube Sanchit Tanwar | Code, Design & AI (Sanchit Tanwar): youtube.com/channel/UCmtuK1RpWPTuY_fjF9HP13g youtube.com
- Nelson F. Liu và cộng sự, "Lost in the Middle: How Language Models Use Long Contexts", Transactions of the Association for Computational Linguistics, tập 12, năm 2024 (trang ACL Anthology, đọc ngày 01/11/2026): aclanthology.org/2024.tacl-1.9 aclanthology.org
Related talks
Agent làm xong là quên: biến trí nhớ của agent thành skill dùng lại được
Will Lyon · Neo4j · 18 min
Vì sao cách lưu trí nhớ phổ biến chưa đủ, và cách Neo4j sắp xếp trí nhớ của agent thành mạng lưới rồi rút ra thành skill dùng lại được.
Bỏ tokenmaxxing: 4 kỹ thuật context engineering cho AI agent
Morgan Willis · AWS Developers · 22 min
Bốn nhóm kỹ thuật context engineering (compress, externalize, select, isolate) cho AI agent, kèm demo code Strands và dòng context_manager="auto".
Laravel MCP 1.0: tool search cho MCP server
Christoph Rumpel · Laravel · 18 min
Build một MCP server trong app Laravel, nối vào Claude Desktop, rồi dùng ToolSearch của Laravel MCP 1.0 để chỉ gửi hai tool và giảm token.