Robot-use agents: vì sao model đa dụng có thể thắng trong robotics
Hai host YC cùng founder Waddle Labs và RoboCurve bàn về robot-use agents: từ RT-2, code as policies, in-context learning tới harness và demo điều khiển robot.
✓ Đã duyệt độc lập · cập nhật 21/11/2026 · 30 min
1. Robot-use agents và ba khách mời từ Waddle Labs, RoboCurve
Đây là một tập "Decoded" trên kênh Y Combinator (video đăng ngày 26/09/2026). Người mở đầu là Ankit Gupta, General Partner ở Y Combinator theo thẻ tên trong video đăng ngày 26/09/2026. Anh nói một trong những bất ngờ lớn của vài năm qua là khả năng tổng quát hoá (generalizability) của coding agent sang nhiều lĩnh vực khác nhau. Và tính tới video đăng ngày 26/09/2026, các nhà nghiên cứu ở frontier đang cho thấy điều đó bao gồm cả việc điều khiển robot.
Theo Ankit (video đăng ngày 26/09/2026), chuyện này khiến giáo sư Philip Isola của MIT gợi ý, trong một bài essay gần đây và lan truyền mạnh (viral), rằng có thể chúng ta đang bước vào kỷ nguyên của robot-use agents: các model đa dụng (general purpose) có thể làm cho nhiều loại robot khác nhau trở nên có năng lực hơn. Hôm nay anh và Francois mời các founder của Waddle Labs và RoboCurve, hai nhóm startup mà theo anh đang làm việc ở đúng frontier của việc dùng LLM để làm robot có năng lực hơn.
Ankit mời các khách tự giới thiệu ngắn và nói qua mỗi công ty tập trung vào gì. Hanming Ye giới thiệu anh đến từ Waddle Labs, cùng với Vincent. Theo Hanming (video đăng ngày 26/09/2026), anh và nhóm làm các LLM điều khiển robot, bằng hai việc: build một harness giúp LLM làm việc này thật hiệu quả, và thu thập data rồi dùng data đó để train ra LLM tốt hơn.
Jay Chooi giới thiệu anh là co-founder của RoboCurve. Theo Jay (video đăng ngày 26/09/2026), RoboCurve là một công ty evals cho physical AI. Anh và nhóm đo mọi thứ: bất kỳ robot nào, bất kỳ model nào, gồm cả LLM lẫn những hướng mà anh gọi là cổ điển như VLA (Vision Language Action Models) và World Action Models. Anh và nhóm đánh giá đủ loại embodiment: bàn tay, gripper, cánh tay, humanoid, robot bốn chân, đủ thứ.
Ankit kể rằng trong vài tuần trước đó (tính tới video đăng ngày 26/09/2026), video của cả hai nhóm lan truyền khá mạnh trên Twitter, và anh nghĩ chúng đã truyền cảm hứng. Anh nghĩ cả hai thực ra đều được trích trong bài essay của Philip Isola về robot-use agents. Những video đó cho thấy LLM vặn được nắp chai, giao tiếp được giữa nhiều robot, làm được những việc như mở nắp một cây bút.
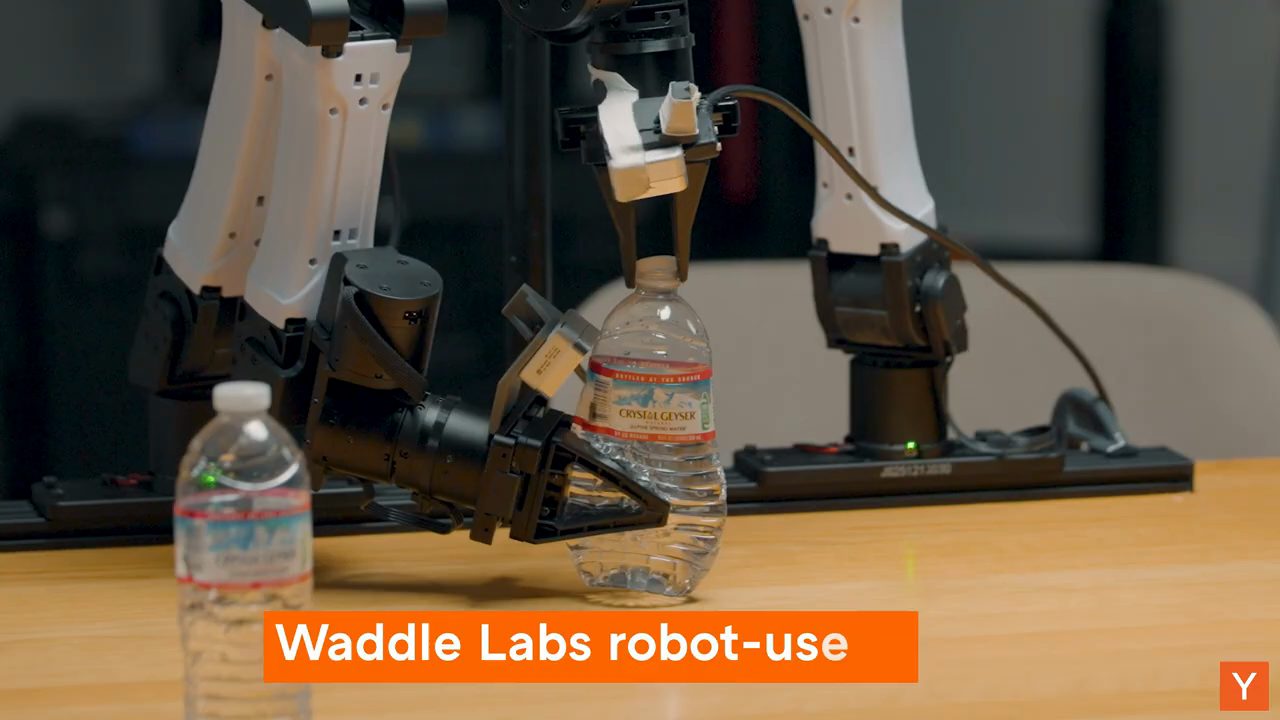
Ankit nói (video đăng ngày 26/09/2026) anh nghĩ sẽ vui nếu anh và Francois cùng các khách đào sâu vào phần research đã dẫn tới thời điểm này, rồi có thể cho xem vài demo về những gì cách làm này thực sự làm được.
2. RT-2: một trong những cách sớm nhất dùng AI trên robot
Ankit đề nghị bắt đầu bằng research ban đầu về việc transfer giữa language model và điều khiển robot: các công trình sớm về pre-train language model cho việc ra quyết định (decision making), rồi paper RT-2, paper mà anh nói đã xác lập VLA (câu hỏi của Ankit, video đăng ngày 26/09/2026). Anh hỏi Jay về những công trình sớm dùng language model cho bất kỳ kiểu điều khiển robot nào.
Theo Jay (video đăng ngày 26/09/2026), một trong những cách tiếp cận thành công sớm nhất khi dùng AI trên robot là paper RT-2: nhóm tác giả dùng một language model đã pre-train trên văn bản và hình ảnh từ web, rồi dùng nó để điều khiển robot.
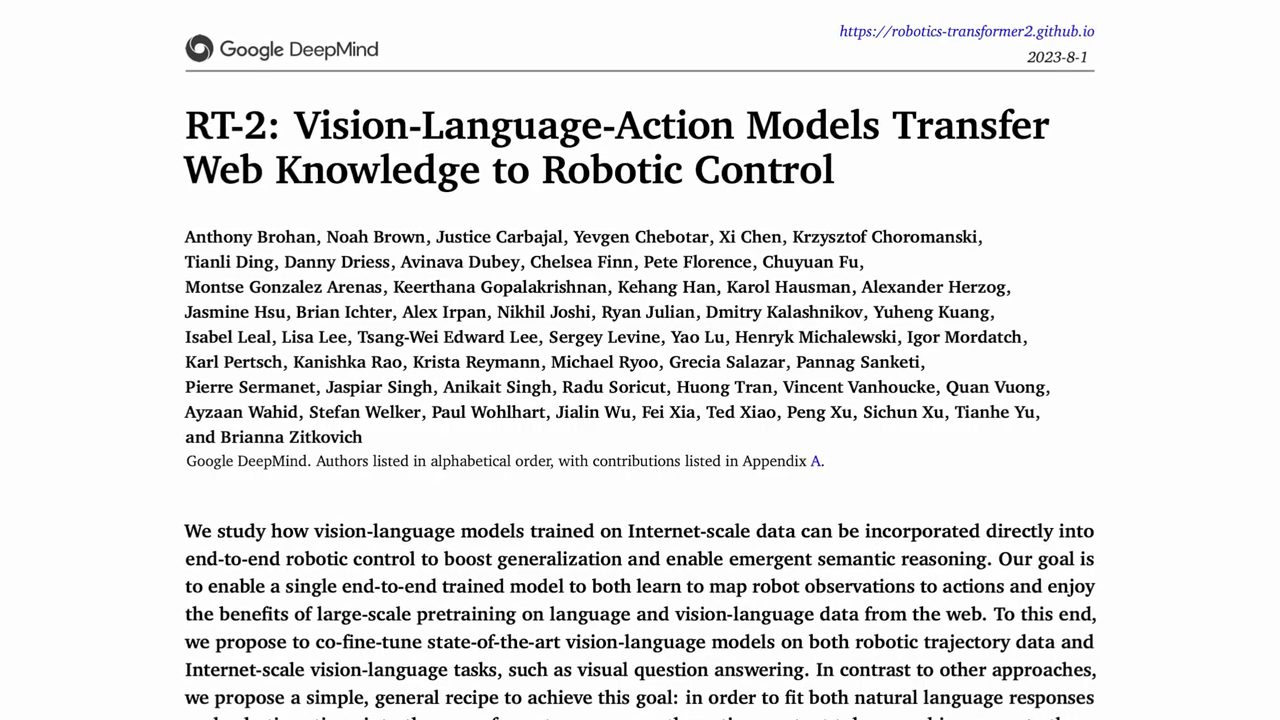
Điều thú vị, theo Jay (video đăng ngày 26/09/2026), là RT-2 là một phiên bản fine-tune của language model. Thay vì xuất ra tiếng Anh chẳng hạn, nó xuất ra thứ mà anh gọi là end-effector pose: các toạ độ mà sau đó có thể chuyển thành lệnh cho từng khớp (joint command) để điều khiển robot.
Theo một nghĩa nào đó, Jay nói (video đăng ngày 26/09/2026), nó rất giống những gì ta thấy bây giờ với large language model, chỉ khác là thay vì fine-tune, các model giờ đủ giỏi để làm việc đó ngay khi lấy về (out of the box).
3. Francois so sánh với khoảnh khắc chain of thought
Francois Chaubard, Visiting Partner ở Y Combinator theo thẻ tên trong video đăng ngày 26/09/2026, nói điều này khá giống hình dung trong đầu anh: nó kiểu như khoảnh khắc chain of thought (CoT).
Anh kể (theo Francois, video đăng ngày 26/09/2026): hồi làm GSM8K, với một câu kiểu "Susie có 8 đô, tiêu 5 đô, giờ còn bao nhiêu?", model phải xuất ra bốn dấu thăng, rồi đáp án, rồi token kết thúc (EOS). Nó không có khả năng chain of thought. Rồi người ta cho phép nó: "để xem, tám trừ năm là ba", rồi mới "thăng thăng thăng ba". Như vậy model được làm kiểu suy nghĩ này trước khi thực sự đưa ra một action hay một đáp án.
Tương tự, theo Francois (video đăng ngày 26/09/2026), VLA như RT-2 về cơ bản phải xuất ra một action; không có chuyện "tôi dồn thêm compute cho một task phức tạp hơn". Còn bây giờ có thứ chain of thought bằng code này. Ngay cả trong ví dụ không xuất ra code, chỉ đưa việc cho Astra để nó nghĩ, nghĩ, nghĩ, nghĩ, rồi xuất ra một action, thì cũng tương tự. Và với code, anh nói đó là cách có Kolmogorov complexity thấp hơn, độ dài code ngắn hơn: chỉ cần dùng code thật gọn, "đây là code".
4. Bitter lesson: có lẽ không hẳn là kiến trúc, mà là data
Jay nói anh hoàn toàn đồng ý. Theo Jay (video đăng ngày 26/09/2026), xét cho cùng chuyện này nằm nhiều ở bitter lesson: nếu cho agent, hay cho AI model, nhiều quyền tự chủ hơn, nếu "cởi trói" nó thêm một chút và cho nó nhiều tài nguyên hơn, thì nó thực sự làm được rất nhiều thứ mà ta vẫn fine-tune nó để làm.
Vincent Song xin chen vào. Theo Vincent (video đăng ngày 26/09/2026), điều thú vị về bitter lesson ở đây là VLA, xét theo thiết kế kiến trúc, cũng được build trên language model, đúng không? Chúng có tiềm năng suy luận, chúng viết được code. Vậy có lẽ bitter lesson ở đây không hẳn là build kiến trúc gì, mà là data nào hữu ích nhất. Người ta đã loay hoay với nút thắt data của VLA (VLA data bottleneck) nhiều năm nay, và đang thấy tiến bộ rất, rất chậm.
Vincent nói bài học ở đây có lẽ là ta có một modality data mà ta biết là chạy rất tốt (video đăng ngày 26/09/2026). Và ý tưởng transfer qua các modality khác nhau là thứ anh và Hanming rất hào hứng: làm sao lấy một thứ vốn out of distribution như robotics và biến nó thành in distribution? Theo anh, có lẽ cách tận dụng bitter lesson là chọn một loại data mà ta biết modality đó khá "được ưu ái": có rất nhiều data, các model hiểu nó rõ, rồi dùng nó như một cách mở khoá nhiều lĩnh vực khác nữa.
Jay nói thêm (video đăng ngày 26/09/2026): lý do RT-2 là một model tốt như vậy là vì nó dùng một language model khai thác được modality của tất cả data mà language model được train. Tất cả những hình ảnh và văn bản web ấy thực sự làm VLA tốt hơn so với việc chỉ train một robotics foundation model riêng mà không có chút pre-training nào.
Ankit tóm lại (video đăng ngày 26/09/2026): vậy trong trường hợp RT-2, những hướng VLA ban đầu này được lợi từ pre-training.
5. Model đã giỏi hơn những gì kể từ RT-2
Ankit hỏi tiếp (câu hỏi của Ankit, video đăng ngày 26/09/2026): đâu là giới hạn của hướng fine-tune để ra action mà giờ có thể vượt qua nếu model trực tiếp viết code? Các khách vừa nhắc tới một khác biệt về data, vậy khác biệt đó cụ thể là gì?
Vincent trả lời (video đăng ngày 26/09/2026): có vài thứ model đã giỏi hơn nhiều kể từ RT-2. Một là tool use. Một loại data là giờ các model viết code tốt hơn nhiều, nên giờ chúng viết được những policy phức tạp dưới dạng code. Chúng cũng giỏi hơn nhiều trong việc dùng tool để khám phá môi trường chúng đang ở, chẳng hạn có những cánh tay nào trong tầm. Và rất nhiều điều này đến từ in-context learning.
Hanming nói tiếp (video đăng ngày 26/09/2026): khác biệt chính giữa các VLA này với một model như GPT-6 hay một LLM không hẳn là kiến trúc, mà là cách tiếp cận việc training. Anh và nhóm muốn "bitter-lesson-pilled": muốn hưởng lợi từ mọi loại data, muốn đổ computer use data vào robot model, muốn đổ coding data vào robot model. Nhưng khi làm vậy, thứ ta có được là cái mà anh và nhóm nghĩ là các general purpose LLM agent.
Theo Hanming (video đăng ngày 26/09/2026), với anh câu hỏi thành ra là: sao không build một LLM nền tảng thật tốt rồi dùng nó để điều khiển robot, thay vì train một model riêng cho robotics và phụ thuộc nhiều hơn vào chỉ robot data.
6. Code as policies, Voyager và insight năm 2024
Ankit nói (video đăng ngày 26/09/2026) rằng nếu tua lại vài năm, một trong những dấu hiệu cho thấy mọi thứ có thể đã đi đúng hướng là research về code as policies. Anh hỏi: khi giới research nói "code as policies" thì chính xác là gì? Anh nghĩ nên đặt nó vào bối cảnh lúc paper ra: coding agent mới bắt đầu chạy được, vẫn là thời người ta viết comment rồi tự động điền các khối code Python, thứ mà giờ ta coi như chuyện cổ, dù đó mới khoảng hai năm trước (tính từ video đăng ngày 26/09/2026). Code as policies hoạt động thế nào, và nó truyền cảm hứng ra sao cho những gì các khách giờ thấy là khả thi?
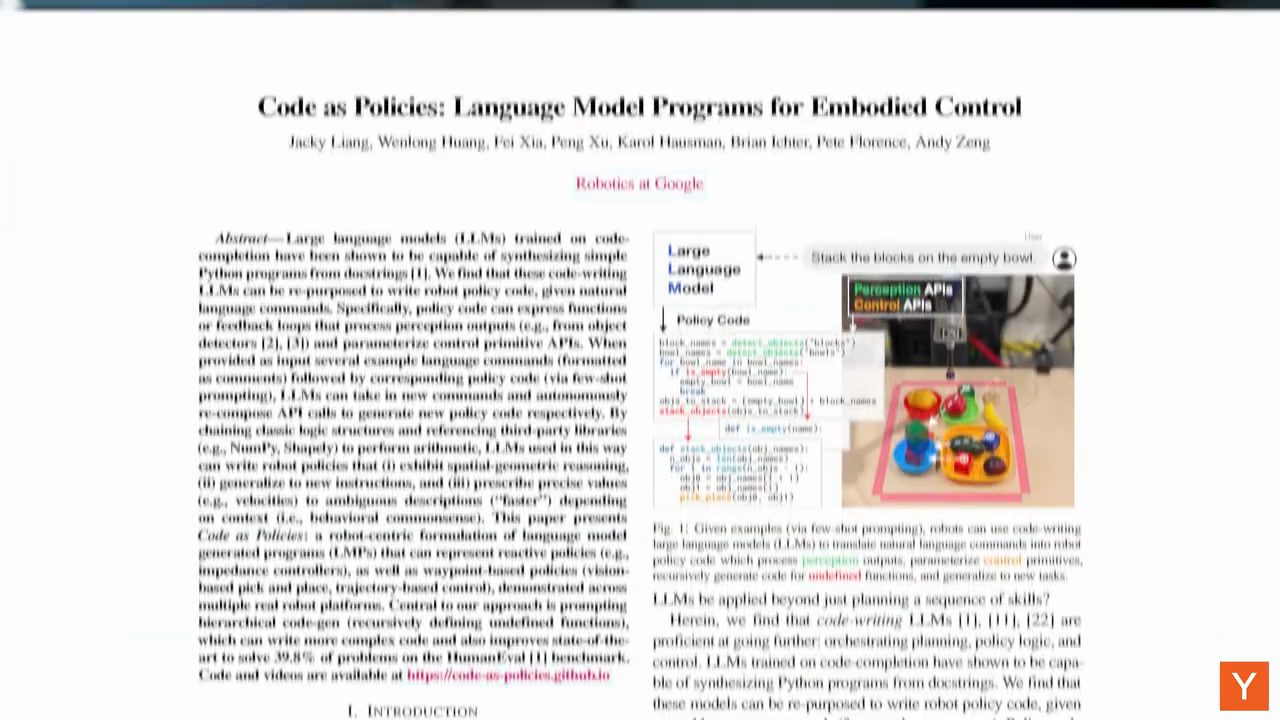
detect_objects, stack_objects, kèm nhãn Perception APIs và Control APIs (video đăng ngày 26/09/2026).Francois trả lời rằng anh có lẽ sẽ tua lại tới Voyager, cái mà anh nói là một trong những cái đầu tiên, rồi anh hỏi: coding agent là gì? Theo Francois (video đăng ngày 26/09/2026), coding agent cần tool use tốt và khả năng tạo tool ngay trong lúc chạy (on-the-fly tool creation). Đó chính là code. Giả sử anh chỉ có các built-in của Python: đó là các tool. Có sort, có if, có for, có while, có đủ thứ, và anh cần dùng các tool đó để lắp thành một tool mới, gọi là "francois.py" chẳng hạn. Giờ đó là một tool mới, và anh được dùng nó.
Đó là Voyager, Francois nói (video đăng ngày 26/09/2026). Anh sẽ không bảo Voyager là cái đầu tiên làm điều này, nhưng Voyager là cái phổ biến nhất làm điều này, cho Minecraft: nó tạo ra những tool có thể gọi ngay khi chạy để chơi game tốt hơn, và nén suy nghĩ, kinh nghiệm thành một tool mới để sau này gọi lại.
Rồi theo Francois (video đăng ngày 26/09/2026), anh nghĩ vào năm 2024 ai cũng có insight này: nếu dồn hết tâm huyết, tài nguyên, compute và trí tuệ vào việc giỏi code hơn, ta sẽ "cất cánh" (liftoff); rồi tự động hoá được ML engineer, rồi cất cánh, có mọi thứ, giải được mọi thứ. Và đó là điều mọi người đã làm. Nhưng anh không nghĩ những người đó có insight kia. Anh không nghĩ họ sâu sắc tới mức biết rằng làm vậy sẽ cho ra những LLM đủ giỏi để viết policy cho robotics, thay thế được toàn bộ robotics bằng coding agent, hay thay thế nghệ sĩ bằng coding agent viết JavaScript để tạo ra tác phẩm nghệ thuật đẹp. Anh nói thật lòng là anh không chắc họ có insight đó.
7. Code as Policies làm được gì khi chưa có coding agent phổ biến
Ankit hỏi (câu hỏi của Ankit, video đăng ngày 26/09/2026): những phương pháp code as policies ban đầu làm được gì? Đây là lúc còn lâu mới có coding agent phổ biến rộng rãi và người ta hiểu trực giác cách chúng chạy, còn lâu mới có chuyện dùng các phương pháp RL để train coding agent thật giỏi gọi tool. Những cái sớm đó, có khi còn trước Voyager, như Code as Policies (anh nghĩ paper ra cuối năm 2022, đúng lúc ChatGPT ra mắt), có năng lực gì so với những gì giờ có thể thấy?
Hanming đáp (video đăng ngày 26/09/2026): các paper code as policies, đặc biệt là của nhóm Google DeepMind, rất ấn tượng. Nhóm tác giả tạo ra những hàm như nhặt một vật, nhấc lên, hay di chuyển tới một vị trí nhất định. Họ đưa danh sách hàm này cho một coding agent dưới dạng hàm Python đúng nghĩa đen, rồi coding agent viết code dùng các hàm đó để điều khiển robot làm những task rất phức tạp.
Điều rất bất ngờ, theo Hanming (video đăng ngày 26/09/2026), là coding agent làm được việc này ngay trong một lần (one shot). Chúng không cần thêm robot data để làm việc với code này, vì chúng đã được train trên rất nhiều coding data. Anh nêu ví dụ chuyện làm gì trước, làm gì sau để bỏ một khối vào cái bát. Anh nghĩ chính khả năng one shot này, khả năng khám phá trong context này, đã thúc đẩy nhiều công trình sau đó tiếp tục khám phá, kể cả anh và nhóm, xem có thể áp dụng LLM vào robotics thế nào.
8. Francois và thí nghiệm in-context learning
Ankit nhắc (video đăng ngày 26/09/2026) rằng Francois có một framework mà hai người từng bàn, về các cách việc học có thể diễn ra: việc học được nhúng vào weights, so với in-context learning, v.v. Anh mời Francois nói nhanh về nó, rồi xem research mấy năm qua nằm ở đâu trong framework đó, nhất là hướng nó có vẻ đang đi.
Francois nói anh đang làm thí nghiệm này và chưa thực sự đúc kết thành paper. Về cơ bản câu hỏi là: xét theo "intelligence per sample", cách hiệu quả nhất để đưa một bộ (tuple) state, action, result, hay state, action, reward, trở lại policy là gì? Có ICL, là in-context learning, nơi anh chỉ việc nối nó vào. Theo Francois (video đăng ngày 26/09/2026), đó là cách đa số người ta đang dùng LLM: "không, đừng làm thế này, làm thế này", model đáp "ok", và điều đó vẫn nằm trong context, rồi anh nhớ được, lặp lại được.
Theo Francois (video đăng ngày 26/09/2026), cách này chỉ thực sự chạy được nếu anh train LLM, hay ít nhất post-train LLM, để nó biết học và cải thiện. Anh nhắc tới literature về self-refine và reflection từ lâu, thứ thực sự đưa multi-turn vào tập train. Không có điều đó thì nó không học được gì cả. Nhưng ngay cả khi có, mức tốt mà ICL đạt được vẫn có giới hạn.
Anh kể thí nghiệm của mình (theo số đo của Francois, video đăng ngày 26/09/2026): lấy một LLM đã train, giữ lại một task, ví dụ GSM8K cho đơn giản, rồi cho nó ICL và đo trên tập validation xem nó cải thiện bao nhiêu sau mỗi sample. Nó cải thiện rất nhiều, rất rẻ: không tốn mấy, không có SGD nên không tốn FLOPs, và anh thích nghi, cải thiện trên tập val rất nhanh, từng ví dụ một. Có hai điều. Một là sự cải thiện không đơn điệu (non-monotonic), điều anh gọi là "wild": nó tệ đi, tốt lên, tệ đi, tốt lên, khá dữ dội. Hai là nó chạm trần rất nhanh: sau chừng 20, 30, có lẽ 40 ví dụ, về cơ bản nó bão hoà, và đưa thêm ví dụ vào context không làm nó cải thiện nữa.
Ankit chen vào: model bị giới hạn bởi khả năng dùng thông minh tất cả context của nó. Có tiếng đáp "Exactly". Francois nói tiếp (video đăng ngày 26/09/2026): điều đó tuỳ vào việc trong post-training model được bao nhiêu multi-turn để học cách cải thiện và tự phản tư (self-reflection).
Điều quan trọng nhất, theo Francois (video đăng ngày 26/09/2026), là chuyện sau khi chạm tới context window, độ dài context mà model được train. Nếu model được train với 100.000, thì thực ra context window là cỡ 50.000. Vượt quá 50.000 thì không cải thiện nữa, mà thực ra còn tệ đi, vì model không thể attend hết mọi thứ.
Francois nhắc tới một ví dụ rất hay mà một người trong bàn đã nói và anh chưa từng nghĩ tới: nếu có thể RAG, nạp ngay khi chạy các ví dụ tương tự vào bộ nhớ đang hoạt động, theo kiểu tư duy continual harness, thì giống như anh đi thi mà có sách giáo khoa: có sách để tra cứu thì sẽ làm tốt hơn. Theo anh (video đăng ngày 26/09/2026), cách đó chắc chắn sẽ chạy được, và anh hình dung nó cũng scale tốt hơn nhiều.
Hai mô thức cuối, theo Francois (video đăng ngày 26/09/2026), là LoRA với rank 1, rank 2 hay gì đó, LoRA với rank 10 hay rank 100, rồi tới full SFT, RL. Nếu bạn là Tesla, có tất cả data, data vô hạn, mà lại học lái xe tự hành bằng ICL thì "bạn đang làm gì vậy, đùa à?". Rõ ràng ta sẽ không làm vậy. Và nếu bạn là Figure hay đại loại vậy. Nhưng điều đáng kinh ngạc là ở chế độ ít data, ICL làm tốt tới mức nào; còn hay hơn nữa là ta có thể nén ICL thành tool use, thành tool, hay nén thành các bài học (learnings). Theo anh, đó là hệ thứ bậc mà mọi người chưa thực sự tìm ra, và các khách mời có lẽ đang ở tuyến đầu.
9. Harness như một dạng chuyên biệt hoá theo lĩnh vực
Ankit mời các khách nói thêm, vì anh hình dung đó là phần trung tâm trong cách họ nghĩ về việc build Waddle. Vincent nói có vài điều khá thú vị cần mổ xẻ. Thứ nhất, theo Vincent (video đăng ngày 26/09/2026), anh và nhóm đang nghĩ về ý tưởng harness gần như một dạng chuyên biệt theo lĩnh vực (domain specificity), ví dụ khi triển khai một robot vào môi trường mới, có thể là một wet lab.
Theo Vincent (video đăng ngày 26/09/2026), có thể học được nhiều thứ trong context, nhưng một cách để củng cố context đó cho các agent tương lai là đóng gói từng skill đã học thành các chương trình cụ thể. Viết ra các skill, viết ra các memory là một cách củng cố, một dạng distillation từ kinh nghiệm quá khứ để agent sau dùng. Anh thấy điều đó khá thú vị.
Điều thú vị thứ hai, theo Vincent (video đăng ngày 26/09/2026), là có vẻ nó có liên hệ với literature meta-learning rộng hơn trong lịch sử machine learning. Có một model lớn hơn lập trình cho một model nhỏ hơn làm việc. Và một điều rất thú vị là các model nhỏ hơn này sẽ học trong context; chúng như được bọc trong harness và làm task. Có thể làm chúng nhỏ hơn, chạy nhanh hơn, miễn là model lớn làm tốt việc chuyên biệt hoá harness theo lĩnh vực. Anh và nhóm khá quan tâm điều này tại thời điểm quay (video đăng ngày 26/09/2026).
Điểm cuối, Vincent nói (video đăng ngày 26/09/2026), câu hỏi lý thuyết thực sự thú vị là in-context learning đưa ta đi được bao xa, và anh nghĩ chuyện đó thực sự chưa ai đoán chắc được. Có những paper cho thấy các model này phần nào xấp xỉ được gradient descent trong lúc in-context learning. Vậy nên ranh giới giữa weight space và symbolic space, theo anh, hơi mờ.
10. Demo: Astra điều khiển hai cánh tay robot
Ankit hỏi đang xem gì đây. Jay trả lời (demo trong video đăng ngày 26/09/2026): đang xem Astra điều khiển các cánh tay để nhặt một khối trên bàn và bỏ vào cái bát.
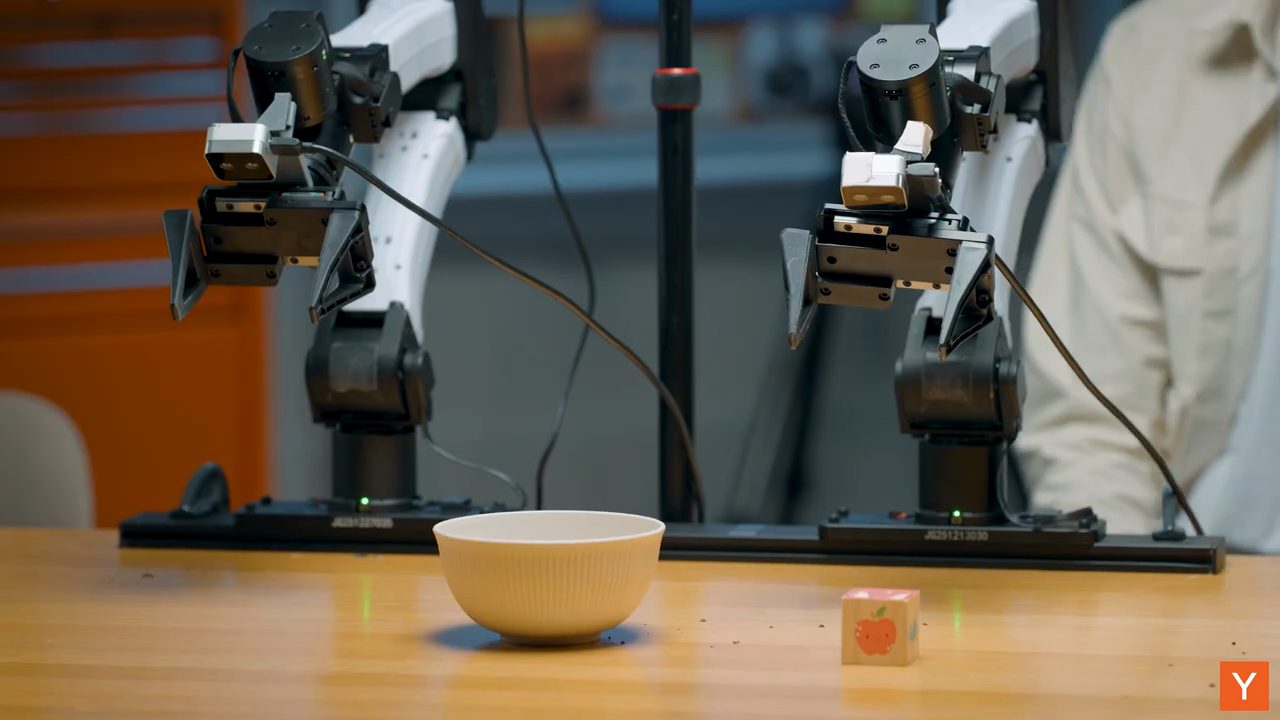
Ankit nói: ở đây Astra chỉ dùng các camera input này, có lẽ nó biết robot mà nó đang điều khiển, và nó sẽ viết code điều khiển robot ở từng khớp. Jay đáp (demo trong video đăng ngày 26/09/2026): nó có nhìn tất cả các camera, có tất cả camera feed. Nhưng thay vì code, nó giống một tool call hơn: nó gửi lệnh tới robot để điều khiển và bỏ khối vào bát.
Ankit hỏi: trong tình huống này đang dùng Astra trực tiếp; nhưng nếu dùng, chẳng hạn, harness của Waddle, thì khác biệt giữa dùng Astra trực tiếp để điều khiển và làm qua API của Waddle là gì? Hanming trả lời (video đăng ngày 26/09/2026): đôi khi để Astra trực tiếp ra lệnh pose mà robot cần tới không phải là tool tối ưu. Nếu là task lặp lại, bạn không muốn Astra nằm trong vòng lặp; có thể bạn muốn viết code để chạy lặp lại rất, rất nhanh. Hoặc nếu đó là task mà bạn đã làm một task tương tự trước đây, bạn nên gọi được một skill đã được biên dịch (compiled) và dùng skill đó để làm task nhanh hơn, xử lý edge case tốt hơn.
Ankit nói ở đây có thể thấy nó có vẻ đang tiến lại gần "anh bạn này". Có tiếng nói: "Oh, very dramatic." Jay nói (demo trong video đăng ngày 26/09/2026): có thể nhận thấy latency hơi chậm, vì anh và nhóm bị nghẽn bởi latency của Astra. Nhưng nếu nhìn xu hướng, latency của các model này đang cải thiện rất nhanh.
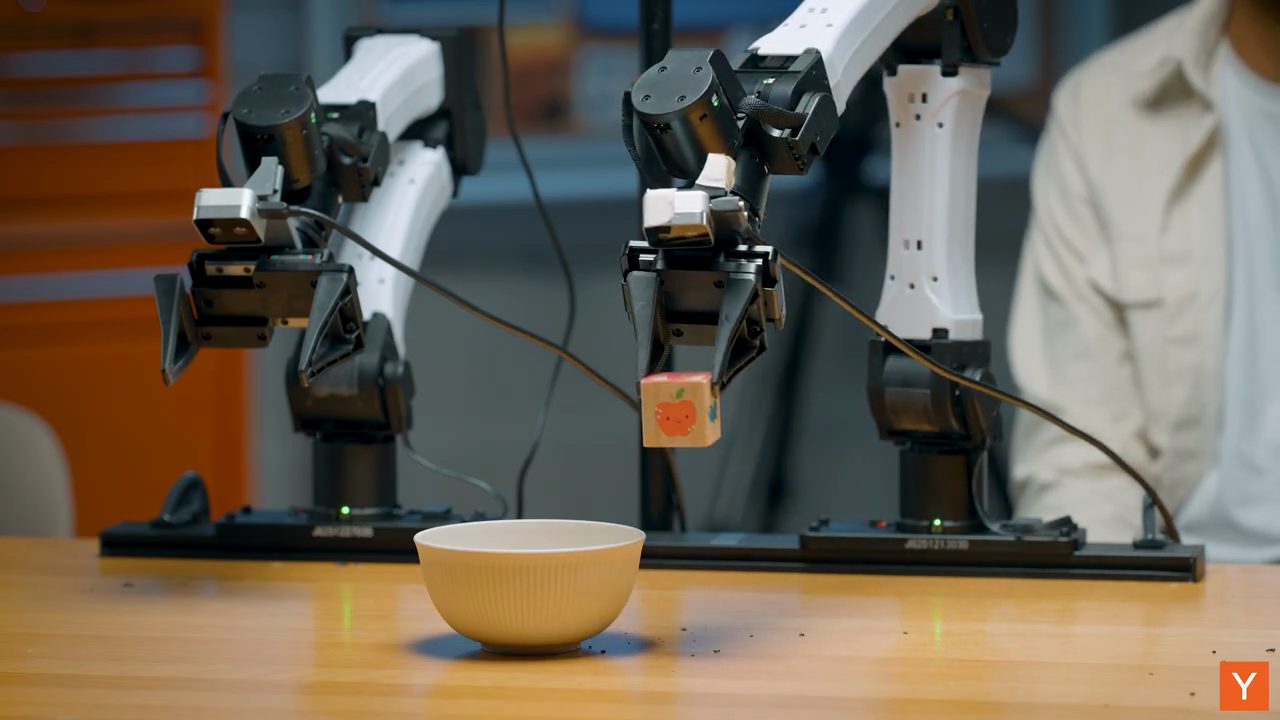
Có tiếng đáp "Right". Jay nói một điều anh và nhóm thấy (theo Jay, video đăng ngày 26/09/2026) là với các LLM tầm Fable (Fable class), latency đang cải thiện khoảng 2 lần mỗi tháng, rất, rất nhanh. Có tiếng đáp "Very fast", rồi "Yeah". Jay nói nếu xu hướng tiếp tục, có thể đạt điều khiển real-time vào cuối năm (cuối năm 2026, tính theo video đăng ngày 26/09/2026).
11. Từ tool call tới code as policy graph có điểm biến thiên
Ankit đề nghị (demo trong video đăng ngày 26/09/2026): giờ đã thấy task chạy từ đầu tới cuối, hãy đi qua xem nó thực sự gồm những gì. Có một coding agent trong vòng lặp đang chạy việc này. Có tiếng đáp "Yes". Anh hỏi: coding agent đã làm những bước nào? Và hãy so sánh bản coding agent trực tiếp với bản có harness của Waddle trong vòng lặp.
Jay giải thích (demo trong video đăng ngày 26/09/2026): điều vừa xảy ra là qua một chuỗi lượt (turn), Astra nhận hình ảnh từ các camera và xuất ra end-effector pose cho robot đi tới. Nó làm vậy qua nhiều lượt để hoàn thành task. Đây ít là code as policies, mà nhiều hơn là tool call.
Vincent nói (video đăng ngày 26/09/2026): có một phần khá lặp đi lặp lại, nên thực ra có thể tự động hoá nhiều phần đó bằng code, cả việc tiến lại gần cái chai, nhấc nó lên. Nhiều thứ như vậy khá tất định (deterministic) một khi đã làm task khá nhiều lần. Phần thú vị là chỗ cài sự biến thiên (variation) vào code as policy graph.
Theo Vincent (video đăng ngày 26/09/2026), anh và nhóm có vài điểm biến thiên. Nó có thể đến từ, ví dụ, lúc phát hiện một vật thể, có thể dùng một VLM như một phần của tool call; hoặc khi có gì đó thất bại thì làm sao kiểm tra là nó đã thất bại, rồi làm sao có thể làm việc khác tuỳ vào kiểu thất bại. Kiểu như những phản ứng linh hoạt hơn. Anh và nhóm có xu hướng đặt một VLM trong vòng lặp để đảm bảo rằng dù coding graph khá tất định, vẫn có những điểm biến thiên cho phép nó tổng quát hoá.
12. Transduction, program induction và neurosymbolic
Francois nói (video đăng ngày 26/09/2026) insight lớn nhất anh có, thứ thay đổi thế giới quan của anh về cách làm machine learning và cách đi nốt quãng đường còn lại tới AGI, đến từ nhiều cuộc trò chuyện với François Chollet. Theo Francois, vào năm 2020, có khi 2018, khi Chollet viết "On the Measure of Intelligence", ông nói nhiều về transduction so với program induction, và transduction thì sai.
Theo Francois (video đăng ngày 26/09/2026), transduction là học một hàm theta ánh xạ từ các x sang các y. Sai ở chỗ nào? Nó chậm và kém hiệu quả về thông tin: để đi từ x sang y cần rất nhiều cặp x, y; nếu có rất ít thì cần rất nhiều inductive bias. Thứ cần là một generator tốt để ánh xạ từ x sang y: giờ theta nhận vào n cặp x, y và xuất ra chính hàm ánh xạ từ x sang y. Và đó là code.
Anh ví nó (video đăng ngày 26/09/2026) với một buổi phỏng vấn coding: có bảng trắng, người ta nói "đây là một bài code, đây là vài ví dụ, ok, viết hàm đi". Ta đang xuất ra một hàm f ánh xạ từ x sang y.
Vincent nói điều này khá thú vị (video đăng ngày 26/09/2026), vì đây là chủ đề của rất nhiều literature program synthesis truyền thống, và anh cảm thấy nhiều lý do khiến các phương pháp đó không chạy tốt bằng là do inductive bias, như Francois nói: ta chuyển độ khó của bài toán từ việc tìm ánh xạ sang việc tìm đúng inductive bias để ánh xạ về đoạn code nhỏ hơn này, rồi để đoạn code đó làm ánh xạ. Nhưng tìm ra bộ inductive bias đó thì cực khó.
Theo Vincent (video đăng ngày 26/09/2026), có lẽ đó là thứ Astra mang lại cho ta. Trong literature đã có một dịch chuyển lớn, từ các phương pháp neurosymbolic chuyên biệt sang chỉ dùng Astra để viết code làm ánh xạ. Và có lẽ đó là một cách nghĩ hay về chuyện này. Francois nói: "That is neurosymbolic", ta có neuron, và chúng đang phát ra symbol.
13. Platonic Representation Hypothesis theo cách Jay áp vào robotics
Ankit nói đây là đoạn chuyển khá hay sang chủ đề cuối, lấy cảm hứng từ một paper cũng của Philip Isola, tên "The Platonic Representation Hypothesis". Theo Ankit (video đăng ngày 26/09/2026), chữ "Platonic" là ám chỉ hang động của Plato, ý tưởng rằng ta đang thấy bóng của nhiều thực tại.
Theo cách Ankit tóm lại (video đăng ngày 26/09/2026), điểm Isola nêu là có nhiều bằng chứng cho thấy language model và các biểu diễn của nhiều loại data khác nhau thực ra học được những ánh xạ khoảng cách giữa các thứ tương tự, dưới các cách train khác nhau, và chúng chồng lên nhau. Ý tưởng là khi train các hệ thống này trên lượng data ngày càng lớn, chúng hội tụ về một kiểu ánh xạ nhất quán của thế giới. Và có lẽ điều này ngụ ý rằng ta sẽ kỳ vọng language model ngày càng giỏi hơn theo thời gian ở những thứ khiến chúng hữu ích cho task mới như điều khiển robot.
Ankit hình dung giả thuyết này thực ra khá trung tâm trong thế giới quan của các khách, hay trong cách họ nhìn công ty mình, và mời họ nói cách họ nghĩ về nó. Anh cũng đề nghị dùng nó để đoán vì sao các model như Astra có vẻ giỏi điều khiển robot hơn nhiều so với các model trước, và dự đoán ta có thể đi tới đâu (câu hỏi của Ankit, video đăng ngày 26/09/2026).
Jay trả lời (video đăng ngày 26/09/2026): một cách để cụ thể hoá cho cuộc tranh luận robotics model và language model là language model rất, rất mạnh sẽ có biểu diễn thế giới rất giống với robotics model rất mạnh. Nếu vậy, có một language model thật mạnh thì cũng có một robotics model thật mạnh, nếu ta tin vào Platonic Representation Hypothesis.
Và nếu đó là sự thật, theo Jay (video đăng ngày 26/09/2026), thì đó là biểu hiện tốt nhất của Bitter Lesson, đúng không? Vì chỉ cần một model thật mạnh, bất kể kiến trúc, và nó sẽ vượt bất kỳ model chuyên biệt nào yếu hơn một chút.
14. Astra có vẻ giỏi spatial intelligence hơn: Hanming nói về computer use data
Ankit hỏi (câu hỏi của Ankit, video đăng ngày 26/09/2026): điều thú vị, có lẽ không hoàn toàn trực giác, là vì sao cụ thể các model mới nhất, cụ thể là Astra, có vẻ giỏi spatial intelligence hơn nhiều. Tất cả chúng ta đều đã thấy các demo trên mạng điều khiển Blender và tạo ra những ảnh 3D đẹp. Và có vẻ Jay đã cho thấy trong một benchmark một bước nhảy (step function) cải thiện đáng kể ở một số task.
Anh hỏi tiếp (câu hỏi của Ankit, video đăng ngày 26/09/2026): các khách nghĩ trong pre-training và post-training của những model đó, cách tiếp cận của OpenAI nhiều khả năng đã thay đổi gì mà chúng giỏi hơn nhiều, ngay cả so với các model sáu tháng trước? Ta vẫn đang hưởng lợi từ bài học đó, vẫn cực giỏi code, vẫn giải toán, nhưng chưa hẳn đã giải được spatial intelligence cần ở đây.
Hanming trả lời (video đăng ngày 26/09/2026): anh nghĩ điều Astra làm cực tốt là năng lực thị giác (vision) của nó. Nó có lẽ được pre-train trên lượng computer use data nhiều hơn bao giờ hết. Nó cũng được pre-train trên rất nhiều CAD data. Và tất cả các loại data này có lẽ dạy model một kiểu hiểu biết về thế giới vật lý tương tự như nhiều robot data có thể dạy.
Ankit nói (video đăng ngày 26/09/2026) computer use data là một điểm thú vị, vì không hoàn toàn trực giác, anh nghĩ vậy, tại sao computer use data hữu ích để hiểu thế giới vật lý; nó thường là máy tính, nơi ta click khắp nơi. Anh nhờ Hanming nói thêm vì sao đó là một bước mở khoá lớn, vì anh hoàn toàn tin là OpenAI đã train nhiều computer use data hơn bao giờ hết.
Có tiếng đáp "Right". Hanming nói (video đăng ngày 26/09/2026): anh nghĩ nếu chỉ train một model cho computer use thì nó sẽ không áp dụng được cho robotics. Nhưng nếu đưa computer use data vào một model lớn như Astra, và computer use data ở đây là kiểu kéo con trỏ trên màn hình để xoay quanh một vật thể CAD khi thiết kế trong Blender, thì nó dạy cách suy luận về không gian. Ít nhất là trên dưới, trái phải, tất cả những khái niệm cần để điều khiển robot. Anh nghĩ đó là lý do data này giúp LLM giỏi robot use hơn nhiều đến vậy.
Từ hướng ngược lại, theo Hanming (video đăng ngày 26/09/2026), nhiều người trong cộng đồng robotics cũng đã thử ngày càng nhiều loại data khác nhau. Như egocentric video đã đi từ chỉ có teleoperation tới một phạm vi data rộng hơn, vì không chỉ robot data mới dạy được model cách dùng robot. Đẩy tới cực điểm thì: sao không đưa mọi loại data, coding, computer use, egocentric, vào cùng một model? Anh nghĩ đó là cách ta đi tới robot-use agent có năng lực cao nhất.
15. GUI như một môi trường học, và dự đoán về robot đa dụng
Francois nói anh thấy thật buồn cười (video đăng ngày 26/09/2026): quay lại thập niên 1980, Xerox PARC hay đâu đó, ta đã cố ý làm giao diện đồ hoạ (graphical user interface) giống thế giới vật lý hơn để có thể giao tiếp với nó. Và thứ ta làm ra hoá ra là một môi trường thực sự giúp robotics học cách dùng thế giới vật lý.
Theo Francois (video đăng ngày 26/09/2026), ta có file system, có file, có folder, có GUI của SolidWorks, của Autodesk để xoay đồ vật cho giống thế giới vật lý. Rồi ta không làm robot chạy được trong thế giới vật lý. Nên ta chỉ việc train trên đó, và giờ nó chạy được.
Hanming nói (video đăng ngày 26/09/2026) có những paper rất hay, anh nghĩ là từ Princeton, cũng bàn chuyện này: nếu thiết kế đúng harness, làm cho các tool điều khiển robot trông giống tool computer use, chẳng hạn để agent kéo con trỏ để điều khiển chỗ robot đi tới, thì LLM làm các task vật lý này tốt hơn.
Ankit hỏi (câu hỏi của Ankit, video đăng ngày 26/09/2026): với những dự đoán hợp lý về việc base model sẽ tiếp tục cải thiện tới đâu, và với những gì chính các khách đang đầu tư, dù là đánh giá các model này hay build harness quanh chúng, năng lực nào mà giờ ta có lẽ thấy là khó, nhưng sẽ ngày càng khả thi, thậm chí tầm thường, trong rất ít tháng tới? Sáu tháng trước, theo anh, ngay cả các demo anh thấy các khách đăng trên Twitter có lẽ cũng đã khá "choáng" nếu tưởng tượng là đến từ một LLM.
Jay trả lời (video đăng ngày 26/09/2026): có một mức đồng thuận nhất định trong các Frontier Lab và cả trong các công ty Robotics Foundation Model rằng ta sẽ có robot đa dụng (general purpose robot) trong hai năm tới, hoặc thậm chí sớm hơn. Và đây là điều xã hội có lẽ chưa nhận ra, thậm chí chưa chuẩn bị.
Khi nói robot đa dụng, theo Jay (video đăng ngày 26/09/2026), ý là kiểu: đưa bất kỳ chỉ dẫn ngôn ngữ tự nhiên nào, robot làm được những gì một thiếu niên có năng lực làm được bằng tay không. Nó kiểu như khoảnh khắc ChatGPT, nhưng cho robotics, xét về năng lực, khi có thể tổng quát hoá sang task chưa thấy và môi trường chưa thấy.
16. Latency, giấc ngủ để nén kinh nghiệm, và thư viện skill lớn dần
Ankit hỏi các khách của Waddle Labs: điều đó có nghĩa gì với thứ họ đang build? Hanming nói (video đăng ngày 26/09/2026): anh nghĩ anh và nhóm sẽ từng bước tiến tới đó trong khoảng hai năm. Anh nghĩ có rất nhiều thách thức rất rõ. Ví dụ latency: đây là một vấn đề lớn. Nếu chỉ để Astra nằm trong vòng lặp suy nghĩ ở mọi bước thì rất chậm, và nó sẽ không hữu ích về mặt kinh tế. Vậy làm sao củng cố lượt chạy đầu tiên của Astra, kiểu contextual learning này, thành một skill hay policy nhanh hơn để có thể chạy lặp lại với throughput cực cao?
Francois nói (video đăng ngày 26/09/2026): anh nghĩ phép so sánh với con người sẽ ngày càng giống thế này: điều tối ưu có thể là đưa một bộ SAR (state, action, reward) mới trở lại context, việc đó rất nhanh; nhưng rồi cần có kiểu "đi ngủ" một lúc. Gần như mọi thứ thông minh đều ngủ; anh thách: hãy kể tên một hệ thống thông minh không ngủ theo cách nào đó.
Theo Francois (video đăng ngày 26/09/2026), trong lúc ngủ, sự nén diễn ra. Có những điều kỳ lạ xảy ra từ hippocampus, ký ức được nén trong ngày được chuyển đi để train weights. Tương tự, có lẽ điều nên làm là giống framework DAgger trong RL cổ điển: thu thập một mớ data, phần nào suy ngẫm lại, rồi dùng nó để cập nhật file weight, rồi distill từ những trải nghiệm đó vào một file weight đã cập nhật, có thể không phải Astra mà là model của chính mình.
Vincent nói (video đăng ngày 26/09/2026) điều đó nghe rất "DreamCoder". Nhiều tool người ta từng build, lấy DreamCoder làm ví dụ, có một thư viện skill, và trong pha ngủ về cơ bản nó refactor mọi thứ thành một biểu diễn gọn hơn.
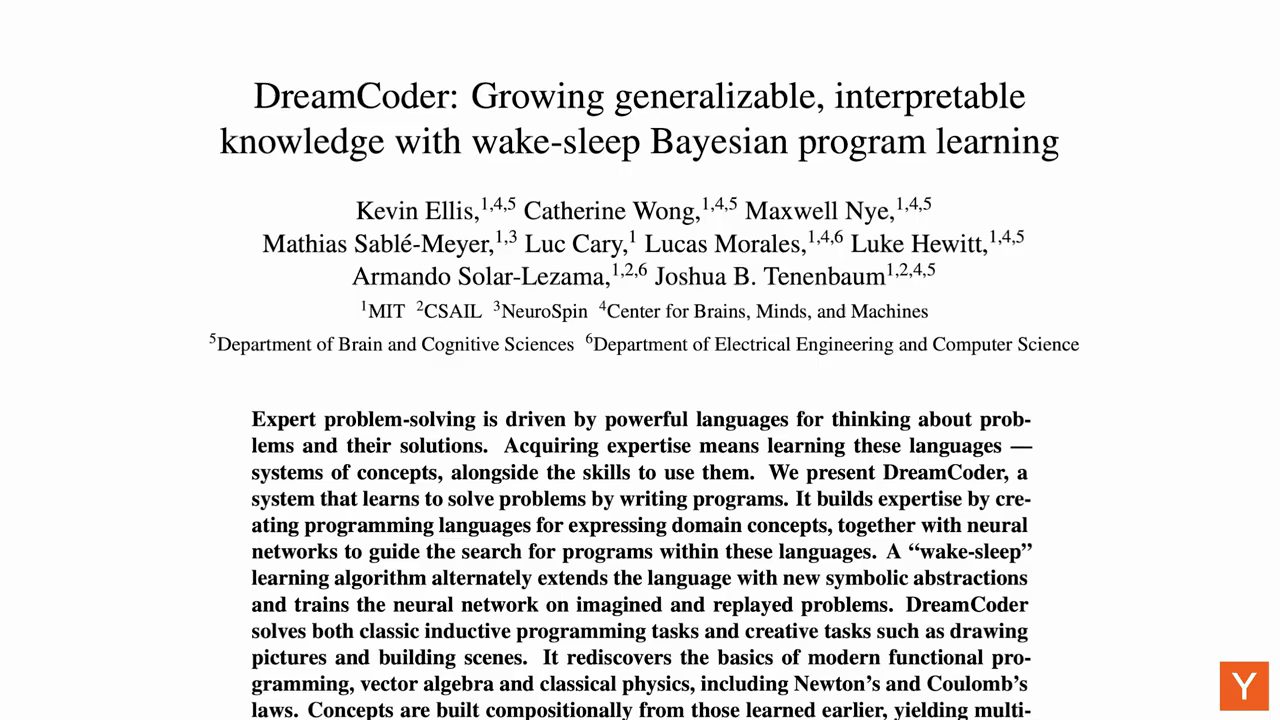
Theo Vincent (video đăng ngày 26/09/2026), ta đang thấy những điều tương tự xảy ra, không cứng nhắc như trước trong không gian chương trình; giờ có lẽ là refactor trace, refactor skill. Nhiều paper code as policy cho robot có một thư viện skill ngày càng lớn, và cách xử lý, tổ chức chúng thực sự chưa ai đoán chắc được. Anh nghĩ khi Waddle tiến lên, cách quản lý bối cảnh skill ngày càng lớn, deployment data, tất cả những thứ đó, sẽ khá thú vị.
Ankit khép lại (video đăng ngày 26/09/2026): anh nghĩ đây là một cuộc thảo luận tuyệt vời, và cảm ơn Vincent, Hanming và Jay đã tới. Anh rất háo hức với những tiến bộ robotics đáng kinh ngạc mà anh nghĩ ta sẽ thấy trong vài năm tới. Anh nghĩ Jay hoàn toàn đúng ở chỗ anh không nghĩ xã hội nói chung nhận thức hết được những gì sắp tới, và đó sẽ là vài năm rất đáng kinh ngạc. Anh cảm ơn mọi người.
Nguồn và liên kết 12 nguồn
- Tên gốc: Robot-Use Agents: Why General-Purpose Models May Win in Robotics
- Sự kiện: YouTube
- Video gốc: https://www.youtube.com/watch?v=Jv5B5CEaPJI youtube.com
- Kênh YouTube Y Combinator (Ankit Gupta, Francois Chaubard; khách mời Hanming Ye, Vincent Song, Jay Chooi): youtube.com/channel/UCcefcZRL2oaA_uBNeo5UOWg youtube.com
- Waddle Labs, trang chủ tự mô tả là "an applied AI lab building LLMs that control robots" (đọc ngày 21/11/2026): waddlelabs.ai waddlelabs.ai
- RoboCurve, trang chủ ghi "Real-world evaluations of physical AI" (đọc ngày 21/11/2026): robocurve.org robocurve.org
- Trang dự án RT-2: Vision-Language-Action Models (đọc ngày 21/11/2026): robotics-transformer2.github.io robotics-transformer2.github.io
- Trang dự án Code as Policies: Language Model Programs for Embodied Control (đọc ngày 21/11/2026): code-as-policies.github.io code-as-policies.github.io
- Trang dự án Voyager: An Open-Ended Embodied Agent with Large Language Models (đọc ngày 21/11/2026): voyager.minedojo.org voyager.minedojo.org
- Paper "On the Measure of Intelligence" của François Chollet trên arXiv (đọc ngày 21/11/2026): arxiv.org/abs/1911.01547 arxiv.org
- Paper "The Platonic Representation Hypothesis" trên arXiv, Phillip Isola là một trong các tác giả (đọc ngày 21/11/2026): arxiv.org/abs/2405.07987 arxiv.org
- Paper "DreamCoder: Growing generalizable, interpretable knowledge with wake-sleep Bayesian program learning" trên arXiv (đọc ngày 21/11/2026): arxiv.org/abs/2006.08381 arxiv.org
Related talks
Vì sao AI viết được code nhưng chưa tự vận hành được hệ thống
Martin Casado & Jad Naous · a16z · 59 min
Jad Naous (Grepr) và Martin Casado bàn về coding agent trong team 10 người, vì sao vận hành production khó hơn code, và AI debug bằng hypothesis (video đăng 16/10/2026).
AI và game: từ Halo chạy trên web tới game không bao giờ kết thúc
Anish Acharya & Jonathan Lai · a16z · 46 min
Anish Acharya và Jonathan Lai bàn AI trong làm game: model tự dùng Blender, mod và decompile game cũ, thể loại ngách, game không bao giờ kết thúc (video 12/11/2026).
Eric Glyman: từ Paribus tới Ramp, agent biết hành động và AI bên trong công ty
Garry Tan & Eric Glyman · Y Combinator · 54 min
Eric Glyman kể với Garry Tan về Paribus, ý tưởng Ramp, agent cần khả năng hành động, Inspect, Glass và cách AI đổi việc bên trong Ramp (video 18/11/2026).